首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

python-进程之间通信、多线程介绍

一、进程之间通信 进程的任务有三种状态:运行,就绪,阻塞。 加锁可以让多个进程修改同一块数据时,同一时间只能由一个任务可以进行修改,即串行的修改。牺牲了速度,保证了数据安全。 虽然可以使用文件共享数据实现进程间的通信,但是效率太低,还需要自己加锁处理。为了解决这些问题,便使用到了multiprocessing模块为我们提供的基于消息的IPC通信机制:队列和管道 1.队列和管道都是将数据存放于内存中 2.队列是基于管道+锁的机制实现的。 我们应该尽量避免使用共享数据,多使用队列。 队列: 创建队列的类: Queue([maxsize]):创建共享的进程队列,Queue是多进程安全的队列,可以使用Queue实现多进程之间的数据传递。 maxsize是队列中允许的最大项数,省略则无大小限制 q = Queue() q.put() 括号里可以是任意类型,不能是大数据 主要方法: 1 q.put方法用以插入数据到队列中,put方法还有两个可选参数:blocked和timeout。如果blocked为True(默认值),并且timeout为正值,该方法会阻塞timeout指定的时间,直到该队列有剩余的空间。如果超时,会抛出Queue.Full异常。如果blocked为False,但该Queue已满,会立即抛出Queue.Full异常。没有参数时,q.put的个数大于队列数时,会一直阻塞住。 2 q.get方法可以从队列读取并且删除一个元素。同样,get方法有两个可选参数:blocked和timeout。如果blocked为True(默认值),并且timeout为正值,那么在等待时间内没有取到任何元素,会抛出Queue.Empty异常。如果blocked为False,有两种情况存在,如果Queue有一个值可用,则立即返回该值,否则,如果队列为空,则立即抛出Queue.Empty异常。没有参数时,q.get的个数大于队列数时,会一直阻塞住。 3.q.put_nowait()等价于q.put(block=False)队列满时再存也会抛异常 q.get_nowait()等价于q.get(block=False)队列为空取不出时会抛异常 from multiprocessing import Queue q=Queue(3) #1.不应该放大数据 2.可以任意类型 q.put(['first',]) q.put({'x':2,}) q.put(3) # q.put(6)#阻塞在存放的时候,当有内容被取出时才推出阻塞模式 print(q.get()) print(q.get()) print(q.get()) # print(q.get())#阻塞在取的时候,当有新内容添加进去才退出阻塞状态 test 生产者消费者模型: 在并发编程中使用生产者和消费者模式能够解决绝大多数并发问题。该模式通过平衡生产线程和消费线程的工作能力来提高程序的整体处理数据的速度。通俗的讲就是当程序中出现明显的两类任务,一类负责生产数据,一类负责处理数据,就可以引入这个模型来实现生产者与消费者的解耦合,平衡生产力与消费能力,从而提升效率。 初级版本: import time import random from multiprocessing import Process,Queue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() # if res ==None:break time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) if __name__ == '__main__': q = Queue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) p1.start() p2.start() p3.start() c1.start() c2.start() print('主') test1 这个时候就有一个问题,主进程一直在阻塞状态,永远不会结束。这是因为消费者在取空以后 还一直在原地阻塞着。 解决方法:让生产者在生产完毕后再往队列中发送一个结束信号,这样消费者在收到结束信号后跳出循环 版本二: import time import random from multiprocessing import Process,Queue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() if res ==None:break time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) if __name__ == '__main__': q = Queue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) p1.start() p2.start() p3.start() c1.start() c2.start() p1.join() p2.join() p3.join() q.put(None) q.put(None) q.put(None) print('主') test2 但是有几个生产者我们就要发送几个None,这不够优雅,于是我们导入了JoinableQueue模块 #JoinableQueue([maxsize]):这就像是一个Queue对象,但队列允许项目的使用者通知生成者项目已经被成功处理。通知进程是使用共享的信号和条件变量来实现的。 #参数介绍: maxsize是队列中允许最大项数,省略则无大小限制。 #方法介绍: JoinableQueue的实例p除了与Queue对象相同的方法之外还具有: q.task_done():使用者使用此方法发出信号,表示q.get()的返回项目已经被处理。如果调用此方法的次数大于从队列中删除项目的数量,将引发ValueError异常 q.join():生产者调用此方法进行阻塞,直到队列中所有的项目均被处理。阻塞将持续到队列中的每个项目均调用q.task_done()方法为止 版本三: import time import random from multiprocessing import Process,JoinableQueue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) q.task_done() if __name__ == '__main__': q = JoinableQueue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) c1.daemon=True c2.daemon=True p1.start() p2.start() p3.start() c1.start() c2.start() p1.join() p2.join() p3.join() q.join()#主进程等q结束,即q内数据被取干净了。 print('主') View Code 二、线程理论 进程是资源单位,由若干线程组成的,一个进程至少有一个线程,线程是操作系统直接支持的执行单元。一个进程相当于一块空间,空间内有若干的线程,就好比进程是一个车间,线程就是车间的流水线。同一个进程之间的线程是资源共享的。进程是程序执行的过程,那么线程就是程序执行的代码。 线程相比进程的优点:1.同一进程下,多个线程共享进程内的资源 2.创建线程的开销远远小于进程 三、线程的使用 (一).创建线程的两种方式(和进程类似) from threading import Thread import time def task(name): print('%s is running'%name) time.sleep(2) print('%s is done'%name) if __name__ == '__main__': t = Thread(target=task,args=('进程一',)) t.start() print('主') 方式一 直接导入threading模块 from threading import Thread import time class Mythead(Thread): def __init__(self,name): super().__init__() self.name = name def run(self): print('%s is running' % self.name) time.sleep(0.1) print('%s is done' % self.name) if __name__ == '__main__': t = Mythead('线程一') t.start() print('主') 方式二 继承Therad类重写run方法 (二).线程特性介绍 os模块下的getpid()线程也适用 current_thread#查看当前线程 active_count#查看线程的活跃个数(线程已结束的不是活跃状态) current_thread().name查看线程名字 略 (三).守护线程 无论是进程还是线程都遵循 某线程/进程等待 主线程/进程 运行完毕后才会被销毁。强调:运行完毕并非终止运行 #1.对主进程来说,运行完毕指的是主进程代码运行完毕。 主进程在其代码结束后就已经算运行完毕了(守护进程在此时就被回收),然后主进程会一直等非守护的子进程都运行完毕后回收子进程的资源(否则会产生僵尸进程),才会结束, #2.对主线程来说,运行完毕指的是主线程所在的进程内所有非守护线程统统运行完毕,主线程才算运行完毕。 主线程在其他非守护线程运行完毕后才算运行完毕(守护线程在此时就被回收)。因为主线程的结束意味着进程的结束,进程整体的资源都将被回收,而进程必须保证非守护线程都运行完毕后才能结束。 from threading import Thread from multiprocessing import Process import time def foo(): print(123) time.sleep(1) print("end123") def bar(): print(456) time.sleep(3) print("end456") if __name__ == '__main__': t1=Thread(target=foo) t2=Thread(target=bar) # t1=Process(target=foo) # t2=Process(target=bar) t1.daemon=True t1.start() t2.start() print("main-------") 进程与线程的区别 (四).线程的互斥锁 不加锁的情况 from threading import Thread,Lock import time mutex=Lock() n=100 def task(): global n # mutex.acquire() temp=n time.sleep(0.1) n=temp-1 # mutex.release() if __name__ == '__main__': t_l=[] for i in range(100): t=Thread(target=task) t_l.append(t) t.start() for t in t_l: t.join() print(n) View Code 结果永远为99,因为线程速度太快了,并发的时候都读到了n=100,所以需要给他加上锁 加上锁的情况 from threading import Thread,Lock import time mutex=Lock() n=100 def task(): global n mutex.acquire() temp=n time.sleep(0.1) n=temp-1 mutex.release() if __name__ == '__main__': t_l=[] for i in range(100): t=Thread(target=task) t_l.append(t) t.start() for t in t_l: t.join() print(n) View Code 焚膏油以继晷,恒兀兀以穷年。


优秀的个人博客,低调大师

python爬取电影和美食数据实战

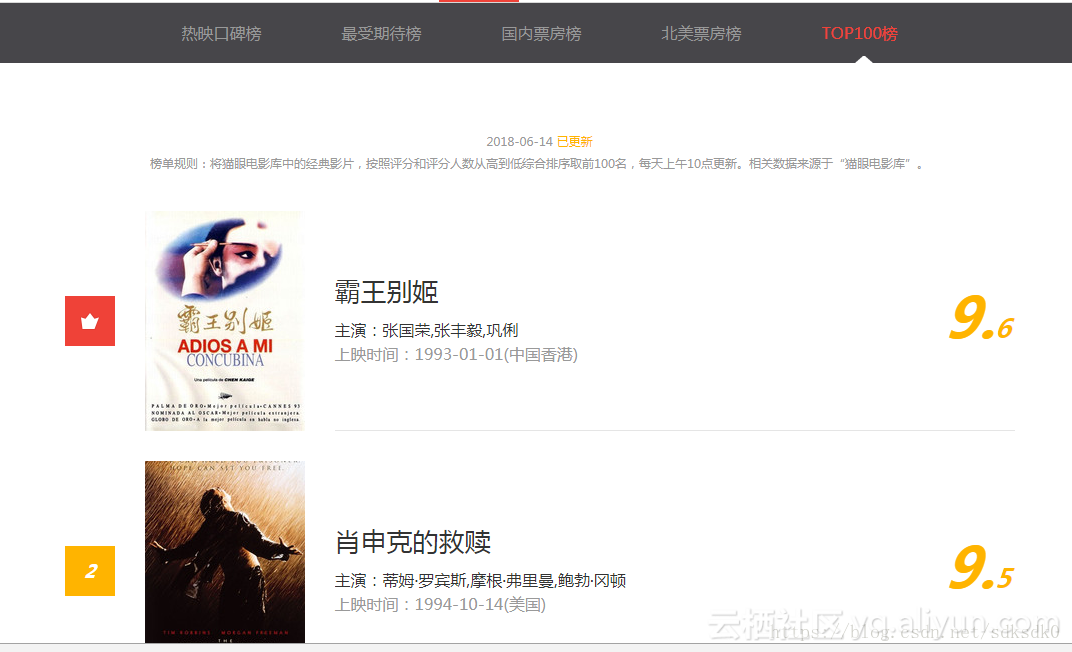
本文使用的是requests+正则来匹配网页内容,对于数据量较多的采用了多线程抓取的方法,共3个案例,分别是抓取猫眼电影TOP100榜单和淘票票正在热映的电影信息、以及美团的美食数据。这几个案例采用的方法大同小异。 1、首先选择想要爬取的网站 2、确定要用的模块,requests,json,re三个模块,如果想加快爬取速度可以加一个Pool 3、 网页请求,先得到整个页面,需要加一个headers来进行请求,否则会被网站拦截 4、格式化整个页面,通过patter的正则来匹配,找出我们需要的内容, 5、 获取数据,findall,然后通过yield将数据返回,yield 是一个类似 return 的关键字,迭代一次遇到yield时就返回yield后面(右边)的值 6、遍历获取到的数据 7、保存到相应的文档中 8、关闭文档, 9、提示数据保存成功。 一、爬取猫眼电影Top100榜单的数据 importrequests frommultiprocessing importPool fromrequests.exceptions importRequestException importre importjson def get_one_page(url): try: headers = { "user-agent": 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36'} 11response = requests.get(url , headers=headers) ifresponse.status_code == 200: returnresponse.text return None exceptRequestException: return None def parse_one_page(html): pattern = re.compile( '<dd>.*?board-index.*?>(\d+)</i>.*?data-src="(.*?)".*?name"><a'+ '.*?>(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>'+ '.*?integer">(.*?)</i>.*?fraction">(.*?)</i>.*?</dd>' ,re.S) items =re.findall(pattern ,html) foritem initems: yield{ 'index':item[ 0] , 'image':item[ 1] , 'title':item[ 2] , 'actor':item[ 3].strip()[ 3:] , 'time': item[ 4].strip()[ 5:] , 'score': item[ 5] + item[ 6] } def write_to_file(content): with open( 'result.txt' , 'a' , encoding= 'utf-8') asf: f.write(json.dumps(content , ensure_ascii= False) + ' \n ') f.close() def main(offset): url = 'http://maoyan.com/board/4?offset='+ str(offset) html = get_one_page(url) foritem inparse_one_page(html): #print(item)write_to_file(item) if__name__ == '__main__': #for i in range(10): # main(i*10)pool = Pool() pool.map(main ,[i* 10 fori in range( 10)]) 结果:将爬取的数据存放到文本文件中, 因为我这边采用的是线程池爬取的,所以有时候是不按顺序进行存储的,如果采用非多线程方式,就会按照顺序进行存储。 二、爬取淘票票正在热映的电影 可以看到网页结构如下,我这边使用了正则匹配的方法进行查找: 代码如下: importrequests fromrequests.exceptions importRequestException importre importjson def get_one_page(url): try: headers={ "user-agent": 'Mozilla/5.0(WindowsNT10.0;WOW64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/62.0.3202.94Safari/537.36'} 11 response=requests.get(url , headers=headers) ifresponse.status_code== 200: returnresponse.text returnNone exceptRequestException: returnNone def parse_one_page(html): pattern=re.compile( '<divclass="movie-card-poster">.*?data-src="(.*?)".*?<spanclass="bt-l">(.*?)</span>.*?<spanclass="bt-r">(.*?)</span>.*?<divclass="movie-card-list">.*?<span>(.*?)</span>' + '.*?<span>(.*?)</span>.*?<span>(.*?)</span>.*?<span>(.*?)</span>.*?<span>(.*?)</span>.*?<span>(.*?)</span>' ,re.S) items=re.findall(pattern ,html) foritem initems: yield{ 'image':item[ 0] , 'title':item[ 1] , 'score':item[ 2] , 'director':item[ 3].strip()[ 3:] , 'actor':item[ 4].strip()[ 3:] , 'type':item[ 5].strip()[ 3:] , 'area':item[ 6].strip()[ 3:] , 'language':item[ 7].strip()[ 3:] , 'time':item[ 8].strip()[ 3:] } def write_to_file(content): with open( 'movie-hot.txt' , 'a' , encoding= 'utf-8') asf: f.write(json.dumps(content , ensure_ascii= False)+ ' \n ') f.close() def main(): url= 'https://www.taopiaopiao.com/showList.htm' html=get_one_page(url) foritem inparse_one_page(html): print(item) write_to_file(item) if__name__== '__main__': main() 结果: 三、爬取美团(深圳)美食店铺信息,评分大于4.0分的店铺 做为一名吃货,想知道我所在是城市的美食店,所以爬取评分较高的店铺信息: 美团的这个网页的不同之处在于,全部是通过js渲染生成的,所以我这边是拿到页面后,在js里面查找到的数据,然后用正则来匹配。 importrequests frommultiprocessing importPool fromrequests.exceptions importRequestException importre importjson """ author 朱培 title 爬取美团(深圳)美食店铺信息,评分大于4.0分的店铺 """ def get_one_page(url): try: headers={ "user-agent": 'Mozilla/5.0(WindowsNT10.0;WOW64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/62.0.3202.94Safari/537.36'} response=requests.get(url , headers=headers) ifresponse.status_code== 200: returnresponse.text returnNone exceptRequestException: returnNone def parse_one_page(html): pattern=re.compile( '"poiId":(.*?),"frontImg":"(.*?)","title":"(.*?)","avgScore":(.*?),"allCommentNum":(.*?)' + ',"address":"(.*?)","avgPrice":(.*?),' ,re.S) items=re.findall(pattern ,html) foritem initems: if float(item[ 3])>= 4.0: yield{ 'poiId':item[ 0] , 'frontImg':item[ 1] , 'title':item[ 2] , 'avgScore':item[ 3] , 'allCommentNum':item[ 4] , 'address':item[ 5] , 'avgPrice':item[ 6] } def write_to_file(content): with open( 'food-meituan.txt' , 'a' , encoding= 'utf-8') asf: f.write(json.dumps(content , ensure_ascii= False)+ ' \n ') f.close() def main(n): url= 'http://sz.meituan.com/meishi/pn'+ str(n)+ '/' html=get_one_page(url) foritem inparse_one_page(html): print(item) write_to_file(item) if__name__== '__main__': #foriinrange(32): # main(i) pool=Pool() pool.map(main ,[ 1 fori in range( 32)]) 结果如下: 对于后期,可以选择把这个数据落库,常用的可以放在mongodb或者mysql数据库中进行存储。

优秀的个人博客,低调大师

python:教学工具:随机点名提问答卷

说多都是泪,姑且这么办吧. import random as rd 人数=11 题数=30 已经提问过的人=[] 没有提问过的人=[] 提问日志=[] for i in range(人数): 没有提问过的人.append(i) for i in range(题数): if len(没有提问过的人)==0: 没有提问过的人=sorted(已经提问过的人.copy()) 已经提问过的人.clear() num=rd.randint(0,len(没有提问过的人)-1) #print(没有提问过的人[num]) 人=没有提问过的人.pop(num) 已经提问过的人.append(人) 提问日志.append(人) elif len(没有提问过的人)>0: num=rd.randint(0,len(没有提问过的人)-1) #print(没有提问过的人[num]) 人=没有提问过的人.pop(num) 已经提问过的人.append(人) 提问日志.append(人) print('提问序列如下:') print(提问日志) print(len(提问日志)) 标识符的汉语见谅吧,没办法,要开源给学生,毕竟英语不是这门课的核心考察能力

优秀的个人博客,低调大师

python:小心类实例的属性动态绑定机制

class Test: def __init__(self): self.__key='init' def get_key(self): return self.__key def set_key(self,key): self.__key=key if __name__ == '__main__': obj = Test() print(obj.get_key())#输出初始值init obj.set_key('通过set方法设置的值') print(obj.get_key())#输出set方法修改之后的值 obj.__key = 'Should not use in this way'#动态绑定上去的属性 print(obj.get_key())#类的实例私有属性的值 print(obj.__key) #注意这个地方↑其实输出的是动态绑定到实例obj上面的属性,不是类里面的私有属性!

优秀的个人博客,低调大师

Python基础系列-列表交集并集差集

版权声明:如需转载,请注明转载地址。 https://blog.csdn.net/oJohnny123/article/details/81979449 比如,现在有两个list类型: a = [1,2,3,4] b = [1,2,3] 一. 差集 很明显结果是[4],下面我们说一下具体方法。 ret_list = [item for item in a if item not in b] 还有一种方法 ret_list = list(set(a)^set(b)) 二. 并集 很明显结果是[1,2,3,4],下面是具体方法: ret_list = list(set(a).union(set(b))) 三. 交集 很明显结果是[1,2,3],下面是具体方法: ret_list = list((set(a).union(set(b)))^(set(a)^set(b)))

优秀的个人博客,低调大师

python骚操作,指定微信好友发送消息

指定好友发送消息 大家在测试的时候尽量使用微信小号 不要不改代码就测试 这里调用了金山词霸的每日一句,你也可以指定文字信息发送,七夕快到了,你懂得。 from threading import Timer from wxpy import * import requests bot = Bot()#连接微信,会出现一个登陆微信的二维码 def get_news(): '''获取金山词霸每日一句''' url = 'http://open.iciba.com/dsapi' r = requests.get(url) content = r.json()['content'] note = r.json()['note'] return content,note def send_news(): try: contents = get_news() my_friend =bot.friends().search(u'小明')[0]#这里是你微信好友的昵称 my_friend.send(contents[0]) my_friend.send(contents[1]) my_friend.send(u'来自自动回复') t = Timer(86400,send_news)#这里是一天发送一次,86400s = 24h t.start() except: my_friend = bot.friends().search('sixkery')[0]#这里是你的微信昵称 my_friend.send(u'今天消息发送失败了') if __name__ == '__main__': send_news()

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册