RWKV Runner 超详细 API 指南
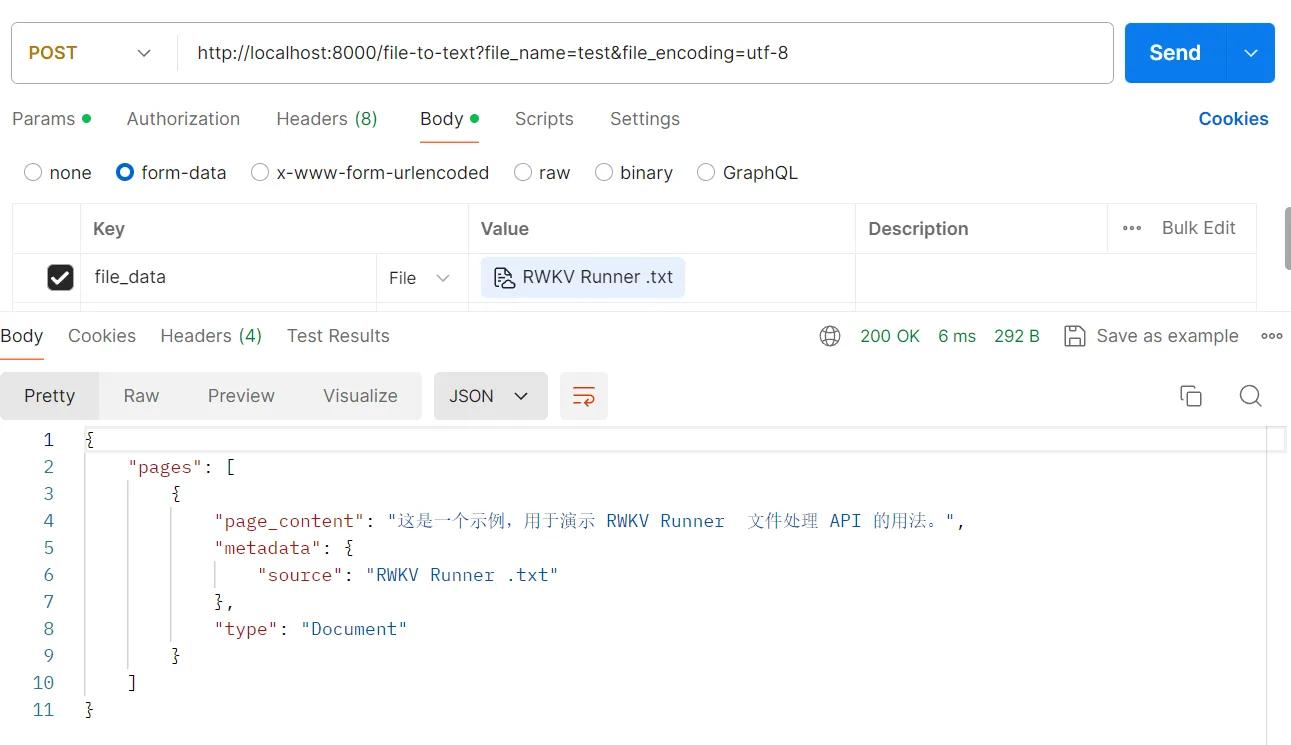
大家好,今天我们带来 RWKV Runner API 的详细用法。 本文会列出 RWKV Runner 每一个 API 的作用、请求主体的参考结构、必需字段和可选字段等内容,帮助大家更轻松、更灵活地调用 RWKV Runner 的 API 。 如果你还不了解 RWKV Runner ,我们建议你从 RWKV 中文官网- RWKV Runner 简介开始阅读。 接下来,让我们先从一些 RWKV 模型的基础知识开始吧! RWKV 模型解码参数(预备知识) 你可能注意到了,很多 RWKV 部署/体验工具都支持调整 Temperature、Top_P、Presence penalty 和 Frequency Penalty 等 RWKV 模型解码参数。 这些主要解码参数对应的效果如下: 参数 效果 Temperature 采样温度,就像给模型喝酒,数值越大随机性越强,更具创造力,数值越小则越保守稳定。 Top_P 就像给模型喂镇静剂,优先考虑前 n% 概率质量的结果。如设置成 0.1 则考虑前 10% , 生成内容质量更高但更保守。如设置成 1 ,则考虑所有质量结果,内容质量降低但更多样。 Presence penalty 存在惩罚,根据“新 token 在至今的文本中是否出现过”来对其进行惩罚。值越大,模型涉及新话题的可能性越高。 Frequency Penalty 频率惩罚,根据“新 token 在至今的文本中出现的频率/次数”来进行惩罚。值越大,模型重复相同短语/句子的可能性越低。 max_tokens 模型生成文本时的最大 token 数。如果你在对外提供服务,建议限制单个请求的 max_tokens,太高可能导致极端情况下单个响应消耗大量的服务器资源。 续写小说和对话这一类需要创造性的任务,需要高 Temperature + 低 Top_P 的参数组合,可以尝试以下四种参数搭配: Temperature 1.2 ,Top_P 0.5 Temperature 1.4 ,Top_P 0.4 Temperature 1.4 ,Top_P 0.3 Temperature 2 ,Top_P 0.2 举个例子,续写小说可以尝试将 Temperature 设为 2 ( Temperature 增加会提高文采,但逻辑会下降),然后将 Top_P 设为 0.1 ~ 0.2 (Top_P 越低,逻辑能力越强),这样生成的小说内容逻辑和文采都很好。 完成相对机械的任务,例如材料问答、文章摘要等,则可将参数设为: Temperature 1 ,Top_P 0.2 Temperature 1 ,Top_P 0.1 Temperature 1 ,Top_P 0 举个例子,如果你正在执行像关键词提取之类的机械任务,不需要模型进行任何开放性思考,则可以将 Temperature 设为 1 ,Top_P、Presence penalty、Frequency Penalty 都设为 0 。 现在,你应该对 RWKV 模型最主要的四个解码参数有所了解了,现在我们开始了解 RWKV Runner 的所有 API 具体用法! Completions (续写) API RWKV Runner 的续写 API 分为聊天续写和基础续写两种,其中聊天续写 API 拥有“role - 角色”参数,因此支持角色扮演等进阶任务。 /chat/completions v1/chat/completions 和 /chat/completions 是相同的 API,用于 RWKV 的聊天续写模式,也就是和模型对话。 必需参数 "messages": 消息对象列表,包含两个元素: * "content": 提供给模型的 prompt ,即对话内容 * "role": 扮演的角色名称,可以从"user", "assistant" 和 "system"选一个。 因此,聊天 API 的基础请求主体如下: { "messages": [ { "content": "hello", "role": "user" } ] } 注意,上面是一个最简单的聊天续写请求,如果你希望控制模型的创作风格、回答的最大字数等细节,请按需添加以下参数: 可选参数 下面列出了聊天续写 API 的所有可选参数: 参数名称 类型 参数解释 max_tokens integer 生成文本的最大token数,最大 102400,对外部署时建议限制文本长度。 temperature number 解码参数之一,具体效果参考前文,范围[0, 3] top_p number 解码参数之一,具体效果参考前文,范围 [0, 1] presence_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] frequency_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] penalty_decay number 频率的衰减参数,范围 [0.99, 0.999],不建议修改 top_k integer 模型生成内容的候选词数量,范围 [0, 25] 不建议修改 global_penalty boolean 是否应用全局惩罚,不建议修改 state string 指定使用的 RWKV state 文件路径 model string | null 指定使用的 RWKV 模型路径 stream boolean 是否以流模式生成文本。 stop string | array | null 指定生成文本时的停止词。 user_name string | null 聊天模式的用户名,不建议修改 assistant_name string | null 聊天模式的助手名,不建议修改 system_name string | null 聊天模式的系统名,不建议修改 /completions /completions和 v1/completions是相同的续写 API,对应的是 RWKV Runner 的基础续写模式,也就是让模型接着你的 prompt 继续生成内容。 必需参数 "prompt": 你提供给模型的续写 prompt 。 因此,聊天 API 的基础请求主体如下: { "prompt": "那一天,人们又想起来被暴雨支配的恐惧..." } 可选参数 下面列出了续写 API 的所有可选参数: 参数名称 类型 参数解释 max_tokens integer 生成文本的最大token数,最大 102400,对外部署时建议限制文本长度。 temperature number 解码参数之一,具体效果参考前文,范围[0, 3] top_p number 解码参数之一,具体效果参考前文,范围 [0, 1] presence_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] frequency_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] penalty_decay number 频率的衰减参数,范围 [0.99, 0.999],不建议修改 top_k integer 模型生成内容的候选词数量,范围 [0, 25] 不建议修改 global_penalty boolean 是否应用全局惩罚,不建议修改 state string 指定使用的 RWKV state 文件路径 model string | null 指定使用的 RWKV 模型路径 stream boolean 是否以流模式生成文本。 stop string | array | null 指定生成文本时的停止词。 RWKV Runner 默认使用 \n\nUser 作为停止词,如果你希望修改默认的模型停止词,则可以指定 stop 字段(一个字符串或者是一个字符串列表)。可参考以下停止词: ["\n\nUser", "\n\nQuestion", "\n\nQ", "\n\nHuman", "\n\nBob", "\n\nAssistant", "\n\nAnswer", "\n\nA", "\n\nBot", "\n\nAlice"] Embeddings API RWKV Runner 的 Embeddings API 还停留在 RWKV-4,未针对 RWKV5/6 架构更新,因此不建议使用。 Configs(配置类) API /switch-model 这个 API 用于切换并重新部署 RWKV 模型。 必需字段 "model":用于切换 RWKV 模型,填 RWKV 模型文件的路径 "strategy":模型部署的方法,如"cuda fp16" 。 可选字段 参数名称 类型 参数解释 model string | null 指定使用的 RWKV 模型路径 strategy string 驱动 RWKV 模型的方法 tokenizer string | nulls 指定使用的 RWKV 分词器路径,不建议修改 customCuda boolean 是否启用自定义 cuda 算子,如果是比较新的 Nvidia 显卡,建议改成 true deploy boolean 是否启用部署模式,启用部署模式会屏蔽掉会屏蔽掉/switch-model、 /exit和其他有风险的 API /update-config /update-config API 用于用于更新模型默认配置,或者说缺省参数,包括解码参数、是否挂载 state 文件等。 当调用续写 API ( /chat/completions 或者 /completions) 且没有传递参数时,将使用 /update-config 设置的默认参数。 可选字段 参数名称 类型 参数解释 max_tokens integer 生成文本的最大token数,最大 102400,对外部署时建议限制文本长度。 temperature number 解码参数之一,具体效果参考前文,范围[0, 3] top_p number 解码参数之一,具体效果参考前文,范围 [0, 1] presence_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] frequency_penalty number 解码参数之一,具体效果参考前文,范围 [-2, 2] penalty_decay number 频率的衰减参数,范围 [0.99, 0.999],不建议修改 top_k integer 模型生成内容的候选词数量,范围 [0, 25] 不建议修改 global_penalty boolean 是否应用全局惩罚,不建议修改 state string 指定使用的 RWKV state 文件路径 参考的请求主体: { "frequency_penalty": 1, "global_penalty": false, "max_tokens": 1000, "penalty_decay": 0.996, "presence_penalty": 0, "state": "models/", "temperature": 1, "top_p": 0.3 } /status 这个 API 用于获取 RWKV Runner 及运行设备的状态,比如运行状态、进程 ID 、GPU 型号。 参考的 **响应结构: ** { "status": 3, # 模型工作的状态码 "pid": 34776, # 模型的进程ID(Process ID) "device_name": "NVIDIA GeForce RTX 3080 Laptop GPU" #模型工作的 GPU 型号 } RWKV Runner 状态码:0 是模型离线,2 是模型正在载入,3 是模型正常工作中 MIDI 相关 API RWKV Runner 的 MIDI API 用于处理 midi 乐谱文件(.mid),比如文本转 MIDI 、MIDI 转 WAV 音频文件等。 /text-to-midi 这个 API 用于将 MIDI 格式的文本(text)转换为 MIDI 乐谱文件(.mid)。 必需字段 "text": 提供给模型的 MIDI 乐谱文本,即 MIDI 乐谱内容。 参考的请求主体: { "text": "p:24:a p:2a:a p:31:a p:39:a p:3b:a p:45:a b:26:a g:3e:a g:3e:a g:42:a g:42:a g:45:a g:45:a pi:3e:a pi:42:a pi:45:a t14 p:24:0 p:2a:0 p:31:0 p:39:0 p:3b:0 p:45:0 t2 p:2a:a p:3b:a p:45:a t14 p:2a:0 p:3b:0 p:45:0 b:26:0 g:3e:0" } /midi-to-text 这个 API 用于将 MIDI 乐谱文件(.mid) 转换为 MIDI 格式的文本(text)。 必需字段 file_data:提供给模型的 MIDI 乐谱文件,也可以是 string($binary) - 字符串格式的二进制数据。 参考的响应结构: { "text": " p:24:a p:2a:a " } /txt-to-midi 这个 API 用于将 MIDI 内容的文本文件(.txt)转换为 MIDI 乐谱文件(.mid)。 必需字段 "midi/sample.mid": 转化完毕的 MIDI 文件保存路径 "midi/sample.txt":需要转化的 TXT 文件路径 参考的请求主体: { "midi_path": "midi/sample.mid", "txt_path": "midi/sample.txt" } /midi-to-wav 这个 API 用于将 MIDI 乐谱文件(.mid) 转换为 WAV 音频文件(.wav)。 这个 API 与 RWKV 模型无关,且需要先安装 fluidsynth 。 必需字段 "midi_path": 需要转换的 MIDI 文件路径 "wav_path": WAV 文件保存路径 可选字段 "sound_font_path":影响 MIDI 音色和合成参数的 SoundFont 文件路径 参考的请求主体 { "midi_path": "midi/sample.mid", "sound_font_path": "assets/default_sound_font.sf2", "wav_path": "midi/sample.wav" } /text-to-wav 这个 API 用于将 MIDI 乐谱文本(text)转换为 WAV 音频文件(.wav)。 必需字段 "text": 提供给模型的 MIDI 乐谱文本,即 MIDI 乐谱内容。 "wav_name": 转化后返回的 WAV 文件名称 可选字段 sound_font_path:影响 MIDI 音色和合成参数的 SoundFont 文件路径 参考的请求主体 { "sound_font_path":"assets/default_sound_font.sf2", "text":"p:24:a p:2a:a p:31:a", "wav_name":"sample" } 文件处理 API 文件处理 API 目前只有 /file-to-text,用于解析 PDF 和 txt 文件。 API 查询参数 file_name(必需参数):指定需要解析的文件名称,如 ?file_name=233.PDF 。这里必须正确填写你上传的文件类型后缀(.txt 或者 .pdf),因为 PDF 文件需要特殊处理。 file_encoding:指定解析的文件编码,如 &file_encoding=utf-8 必需字段 file_data:类型 *string($binary),上传一个 txt 或者 PDF 的二进制数据 MISC API 这部分 API 主要用于兼容 OpenAI API ,以便开发者能将 RWKV 模型用在 ChatGPT 客户端中。 State Cache 相关 API State 缓存相关 API 没有请求主体,下面是几个 State API 的作用: /disable-state-cache:禁用 state 缓存 /enable-state-cache:启用 state 缓存 /reset-state-cache:重置 state 设置 有关 State 文件是什么,以及它的详细用法,请参考RWKV State 介绍文章。 常见疑问 问题 1:我要去哪里查看 RWKV Runner 的 API 文档? 本地启动 RWKV Runner 并启动一个模型,你将可以在 http://localhost:8000/docs 中查看 RWKV Runner 的 API 文档。 问题 2: deploy 模式下,哪些 API 会因“危险权限”而被屏蔽? 在部署模式下,一切会影响服务器系统和硬件的 API 都会被屏蔽掉,这是为了安全起见。 比如:/switch-model 、 /exit 以及 State Cache 相关的 API 都会被屏蔽。 问题 3:为什么我本地部署 RWKV Runner 默认开启了 deploy 模式? 在 RWKV Runner 中,如果你勾选了 “启用 WebUI“ ,那么默认开启了 deploy 模式。 你可以通过关闭此选项,来解除部署模式,进而使用一些危险权限的 API 。 问题 4 :为什么 RWKV Runner 的 embaddings API 用不了? 截至目前(2023-07-05,RWKV Runner V 1.8.4) 不建议使用 RWKV Runner 文档中提供的 embaddings API 。 文档中的 embaddings API 目前停留在 RWKV-4,未针对 RWKV5/6 架构进行重构,因此会报错。 更多 RWKV Runner 及 API 使用问题,欢迎加入 QQ 群交流: RWKV Runner 交流群:818930736 RWKV 模型交流群:224287095