首页 文章 精选 留言 我的

精选列表

搜索[读写分离],共10000篇文章
优秀的个人博客,低调大师

分离式皮肤资源解决方案探索

前言: 在App开发中,通常需要涉及到皮肤/主题的逻辑,以保证程序风格的多样化,保证符合大多数用户的不同口味。而一个优秀的皮肤管理框架不仅有利于开发者优雅的coding,同时需要做到能够动态切换皮肤,动态更换下载皮肤。 本篇内容从公司产品当前主题管理器的设计引入一种新型的皮肤管理方案。以期解决现有多主题编程时的各种难受,同时能够带来更好的皮肤动态性。 正题: 一. 皮肤/主题资源有哪些? 常用的主题资源有:背景色彩,文字色彩,图片背景,控件样式,字体样式,字体大小,控件尺寸,控件margin-padding.等。 二. 常见的皮肤切换方案有哪些? 1. 对于小型APP来说,设计一套功能完善的皮肤管理框架 稍显多余,因此通常都是以系统自带的 styleable主题切换方式为主。 此种方式,优

优秀的个人博客,低调大师

从读写角度,带你了解数仓的IO基本框架

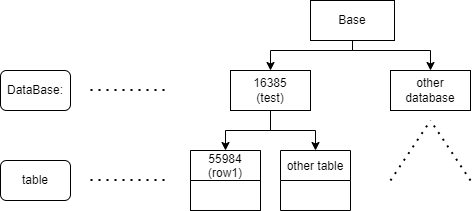
摘要:本文从读取和写入的角度分别描述了行存和列存的IO模型,并对文件结构做了简单介绍。 本文分享自华为云社区《GaussDB(DWS)基本IO框架》,作者: Naibaoofficial。 行存IO管理框架 存储结构 OID(Object identifiers):对象的唯一标识。 每个表存在对应数据库的文件夹中,用relfilenode标识。 例如表row1,可以直接查询对应的文件 test=# select pg_relation_filepath('row1'); pg_relation_filepath ---------------------- base/16385/55984 (1 row) 每个表的读取写入以页(文件块)为基本单位,页的大小是一个BLCKSZ,默认8KB,其结构如下: Tuple保存了当前一行的数据,分为Header和Data两块,头部保存元组的相关信息(列数,事务信息,是否有Toast表等)。 每个Tuple最大为2kb,若Data过大无法压缩至2KB,则采用额外的Toast表存储,此时Tuple内的Data保存Toast表的相关信息。 GaussDB 行存框架: 这里面涉及到几个比较大的内核机制: 本地缓存: 这里面的本地缓存介绍了三个比较常用的缓存结构,这里直接引用了官方的英文解释。 temp_buffers: Sets the maximum number of temporary buffers used by each database session. These are session-local buffers used only for access to temporary tables. work_mem: Specifies the amount of memory to be used by internal sort operations and hash tables before writing to temporary disk files. maintenance_work_mem: Specifies the maximum amount of memory to be used by maintenance operations, such as VACUUM, CREATE INDEX, and ALTER TABLE ADD FOREIGN KEY. 共享内存:可由整个Gaussdb共享 包括shared_buffer和wal_buffer, 分别用来存放Page和Clog,Wal Segment。 WalWriter,BgWriter: 主要是将共享内存的内容落盘,WalWriter一般是在事务提交时就需要落盘,但是有时候可以放弃一定的事务一致性原则,从而让WalWriter异步落盘加快速度。BgWriter负责将shared_buffer中的内容落盘。 外存管理: 负责上层与外存之间的文件交互。 IO管理框架:读取 读取的过程相对简单,就是从物理文件先装到shared_buffer中,然后从shared_buffers返回相关的结果。 shared_buffers中就是以Page为单位进行存储的,因为每个Page的大小是固定的,所以shared_buffers能存放的page个数也就是确定的。这里面就需要考虑一个问题,因为这个资源是共享的,如果一个线程读取了大量的文件,这样势必会使得其他线程的缓存命中率下降。 GaussDB在这里引入了Ringbuffer的机制,可以限制一个线程所使用的shared_buffers的大小,从而解决掉这个问题。 IO管理框架:写入 写入操作是增加的新的元组,Update操作相当于先Delete,再Insert。 INSERT UPDATE 将旧元组标记为Dead,然后插入新的元组,由Vacuum负责清理。当然,这里面Data变为DELETE只是用来描述删除的是此Tuple,实际上Data当中的值是不变的。 写入的整体逻辑: GaussDB行存在写入时,将元组信息先写入到shared_buffers,然后用bgwriter刷入磁盘,这样在事务提交时就可以避免磁盘的IO开销,提升性能,为了保证一致性和恢复,使用wal日志和checkpoints可以实现日志先落盘(也可以异步)和redo等操作。 列存的IO管理框架 列存的存储单元 列存的存储单元为CU(CStore Unit) CU的大小为8k对齐 适合大批量导入的场景 同一列的CU存在一个新文件中,大于1GB时,切换到新文件中。 列存用一个CUDesc的行存表描述CU的相关信息,可以理解成为一个Toast表。 CUDesc:行存表,记录CU的相关信息, 主要属性如下: col_id,cu_id: 第col_id列,第cu_id个CU min, max, row_count, size cu_mode: information mask(RLE,LZ4,Delta表等) cu_pointer:指向每一个CU,记录delete bitmap magic:和CU头部的magic相同,校验使用 CU结构 列存索引 这里介绍两个索引,C-Btree和Psort,这里不做过多介绍。 主要涉及的是IO相关的内容。 C-Btree 索引结构和行存无差别,同样以行存形式存储 C-Btree可以提升点查效率 存储key->ctid(cu_id, offset) 过程: 根据B-tree索引找到ctid集合 对集合进行批量排序(减少IO开销) 在CUDesc找到对应的cu_id,根据offset找到数据 举例,等值查询 n=49, 范围查询 23<n<64。 PSort PSort是一个聚簇索引,对索引进行排序,然后将排序后的索引和行号存入一个新的表,用单独的列存表存储。 简单示意如下,图片来源:https://www.modb.pro/db/108155 IO管理框架:读取 读取过程: 根据where条件,做MIN/MAX过滤的谓词条件 加载CUDesc MIN/MAX过滤 读取CU到CU Cache中 解析并填充 CacheMgr: 用来缓存CU到内存中,可以提高重复查询的性能。 CU的物理文件: 1. CStore_1.0: 当前基本不怎么实用 2. CStore_2.0: 重整了CU的文件结构,避免列数过多导致文件结构复杂。 IO管理框架:写入 列存的插入要分两种情况,少量的插入和大量的插入,列存主要是对大批量数据设计的,因此为了弥补小量插入的打包CU性能开销,设计了一个delta行存表,用来记录插入结果,可以减少膨胀和提升性能,最后定期的整理。 写入框架如下 列存的删除比较简单,如果是delta表,先从delta表中删除满足谓词条件的记录,然后在CUDesc表中更新待删除CU的delete_bitmap。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Android开发8——利用pull解析器读写XML文件

一、基本介绍 对XML解析有SAX和DOM等多种方式,Android中极力推荐xmlpull方式解析xml。xmlpull不仅可用在Android上同样也适用于javase,但在javase环境中需自己获取xmlpull所依赖的类库,kxml2-2.3.0.jar,xmlpull_1_1_3_4c.jar。 jar包下载网址http://www.xmlpull.org/http://kxml.sourceforge.net/ 二、例子 读取到xml的声明返回数字0 START_DOCUMENT; 读取到xml的结束返回数字1 END_DOCUMENT ; 读取到xml的开始标签返回数字2 START_TAG 读取到xml的结束标签返回数字3 END_TAG 读取到xml的文本返回数字4 TEXT <?xmlversion="1.0"encoding="UTF-8"?> <people> <personid="001"> <name>XY1</name> <age>22</age> </person> <personid="002"> <name>XY2</name> <age>22</age> </person> </people> packagecn.xy.service; importjava.io.InputStream; importjava.io.OutputStream; importjava.util.ArrayList; importjava.util.List; importorg.xmlpull.v1.XmlPullParser; importorg.xmlpull.v1.XmlSerializer; importandroid.util.Xml; importcn.xy.model.Person; publicclassPersonService { publicListgetPeople(InputStreamxml)throwsException { Listlst=null; Personperson=null; //利用ANDROID提供的API快速获得pull解析器 XmlPullParserpullParser=Xml.newPullParser(); //设置需要解析的XML数据 pullParser.setInput(xml,"UTF-8"); //取得事件 intevent=pullParser.getEventType(); //若为解析到末尾 while(event!=XmlPullParser.END_DOCUMENT)//文档结束 { StringnodeName=pullParser.getName(); switch(event) { caseXmlPullParser.START_DOCUMENT://文档开始 lst=newArrayList(); break; caseXmlPullParser.START_TAG://标签开始 if("person".equals(nodeName)) { Stringid=pullParser.getAttributeValue(0); person=newPerson(); person.setId(id); } if("name".equals(nodeName)) { Stringname=pullParser.nextText(); person.setName(name); } if("age".equals(nodeName)) { intage=Integer.valueOf(pullParser.nextText()); person.setAge(age); } break; caseXmlPullParser.END_TAG://标签结束 if("person".equals(nodeName)) { lst.add(person); person=null; } break; } event=pullParser.next();//下一个标签 } returnlst; } publicvoidsaveDataToXML(OutputStreamos,Listlst)throwsException { XmlSerializerxs=Xml.newSerializer(); xs.setOutput(os,"UTF-8"); xs.startDocument("UTF-8",true); xs.startTag(null,"people"); for(Personp:lst) { xs.startTag(null,"person"); xs.attribute(null,"person",p.getId()); xs.startTag(null,"name"); xs.text(p.getName()); xs.endTag(null,"name"); xs.startTag(null,"age"); xs.text(p.getAge().toString()); xs.endTag(null,"age"); xs.endTag(null,"person"); } xs.endTag(null,"people"); xs.endDocument(); os.flush(); os.close(); } } publicclassTestClassextendsAndroidTestCase { publicvoidtestPeople()throwsException { PersonServiceps=newPersonService(); InputStreamxml=this.getClass().getClassLoader().getResourceAsStream("person.xml"); Listlst=ps.getPeople(xml); Assert.assertEquals("XY1",lst.get(0).getName()); } publicvoidtestSave()throwsException { PersonServiceps=newPersonService(); Listlst=newArrayList(); lst.add(newPerson("0001","XY0001",20)); lst.add(newPerson("0002","XY0002",20)); FilexmlFile=newFile(this.getContext().getFilesDir(),"xy.xml");//data/data/packagename/files OutputStreamos=newFileOutputStream(xmlFile); ps.saveDataToXML(os,lst); } } 本文参考自金旭亮老师的《.NET 4.0面向对象编程漫谈》有关代理的内容 本文转自IT徐胖子的专栏博客51CTO博客,原文链接http://blog.51cto.com/woshixy/1079595如需转载请自行联系原作者 woshixuye111

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册