首页 文章 精选 留言 我的

精选列表

搜索[千问小酒窝],共10000篇文章
优秀的个人博客,低调大师

报告称苹果应用商店逾千款应用存在漏洞

一家行业领先的网络安全公司发布研究报告称,苹果应用商店有超过1000款应用程序存在安全漏洞,容易受到黑客的攻击。 一款名为JSPatch的用于帮助开发者修改应用程序的软件,存在一个安全漏洞,这使得它很容易成为黑客的攻击目标。这个安全漏洞相当于在设备上留了一个后门。一旦黑客发现和利用这个后门,他们就能够访问到设备中的照片、麦克风和剪贴板数据以及其他涉及个人隐私的功能。 该漏洞是网络安全公司FireEye发现的。该公司称,在苹果iOS应用商店中有1220款应用程序可能会受到影响。 “狡猾的攻击者可能会先编写一款合法的、没有恶意的应用程序,然后提交苹果应用商店审核。一旦它通过审核,正式进入苹果应用商店,它就能够给设备发送非法的、恶意的指令。”FireEye公司新兴科技主管乔希 高德法布(Josh Goldfarb)说。 开源工具JSPatch给了开发者更大的自主权,但却不符合苹果试图坚持的安全标准。 JSPatch并不是恶意软件,但是它的安全漏洞一旦被人利用,用户设备里的数据,甚至是用户允许该软件访问的其他应用程序,就很容易遭到非法入侵。 如果这款软件可以访问Apple Pay或其他移动钱包,那么问题就会变得非常严重了。 FireEye公司并未指明哪些应用程序是用JSPatch开发的,但是它重申苹果应用商店中已有1000多款应用程序受到影响。 高德法布给担心恶意应用程序的iOS用户提供了一些安全方面的建议。 “我们的建议是:仅下载你需要的、你了解的和你相信的应用程序。”他说,“提防那些不断向你提出请求并要求你批准的应用程序,只批准那些必要的请求。” 这并不是安全漏洞第一次出现在苹果的“封闭式花园”中。尽管如此,苹果的应用商店仍然要比谷歌应用商店Google Play安全得多。 在去年9月,数百款iPhone应用程序被发现感染恶意程序XcodeGhost。这算得上是苹果应用商店遭到的第一次较大的攻击。苹果当时立即行动,撤下了几款应用程序。 在被“越狱”的iOS设备中,这种攻击就常见得多。 “攻击者们一直在寻找进入苹果封闭式花园的途径。”FireEye公司的首席技术官布莱斯 博兰(Bryce Boland)说。 FireEye公司与《福布斯》杂志全球2000强企业中的650家企业均建立有合作关系。它预计,针对移动设备的恶意攻击还会增加。 “移动设备是攻击者比较青睐的攻击目标,因为相对于笔记本电脑和台式电脑来说,它们的安全防护措施比较薄弱。”高德法布说,“我们将会看到移动环境下的恶意攻击越来越多。哪里有铜臭味,攻击者就会飞向哪里。因此,我们将会看到更多针对移动设备的攻击。” 苹果拒绝对此发表评论。 本文转自d1net(转载)

优秀的个人博客,低调大师

答开源创业 15 问:选协议、维权、公关、找钱······

11 月 8 日 19:00,OSCHINA 直播 ——【开源漫谈】第 5 期,邀请了三位大咖,请他们来聊一聊开源创业遇到的一些难题。他们分别是: 高春辉,中国第一个人站长,卓越网、手机之家、ECSHOP 软件、《爱壁纸 HD》应用创始人,全球领先级 ip 库 http://ipip.net 创始人 王春生,禅道软件公司的创始人,二十年的 IT 老兵,14 年的创业者 朱峰,津津乐道播客网络创始人、主播。连续创业者,商业经验丰富;有多年社区运营经验;资深开发者 这次直播,将尽可能地回答这15个问题: 开源软件有漏洞,跟作者没关系? 怎么判断自己的项目能不能拿来创业? 开源软件协议应当选择最宽松的? 应该努力地将软件捐献给基金会? 项目捐给了基金会,比如 Apache 基金会,需要作者将“版权授权 + 专利授权 + 商标转让”给基金会,那作者还能掌控项目代码吗? 用户量增长最快的时候,当时采取了什么推广方式? 开源是怎么挣钱的? 软件被侵权了怎么办? 网上出现了负面舆论,怎么“公关”? 如何看待免费用户提出的一些功能改进、BUG修复、技术支持等要求? 要创业,去哪里找钱? 要不要接受投资?因为哪些原因拒绝有些投资?哪些条件不能妥协? 技术人员怎么转型做管理? 怎么做到连续创业成功的?有什么可供其他创业者借鉴的经验? 作为创业者,时间和精力怎么分配?最重要的角色是什么? 直播主题:关于开源创业的 15 件小事 直播时间:11 月 8 日(周三) 19:00-20:30 直播平台:“OSC 开源社区” 视频号 主办方:开源中国 微信扫码预约直播,欢迎加入 OSC 直播交流群,一起唠嗑~ 直播福利 互动抽奖:在直播评论区提问,被直播嘉宾回复的用户可获 OSC T 恤 1 件,名额不限。 福袋抽奖:直播中将有多轮抽奖,参与就有机会获得 OSC T 恤、笔记本、马克杯 、前沿技术书籍等。 我们直播间见吧~ 另外,本次直播得到了诸多社区或组织的大力支持,在此特别表示感谢: 渠成开源社区 渠成开源社区由禅道项目管理软件团队发起,社区的经营主体为青岛渠成开源计算机网络技术研究中心,是非营利性社会服务活动的社会组织。 渠成开源社区主要面向一线开源软件生产者、贡献者、组织者、赞助商和用户,以解决具体实际问题为宗旨,旨在打造以开源软件为核心纽带的开源生态系统,真正做到让每一个优秀的开源软件都能实现商业化。 官网:www.qucheng.cc 禅道 禅道是一款开源的全生命周期项目管理软件,基于敏捷和 CMMI 管理理念进行设计,集产品管理、项目管理、质量管理、文档管理、组织管理和事务管理于一体,完整地覆盖了项目管理的核心流程。 禅道自 2009 年发布至今,累计为国内数十万计的公司或团队提供了专业的项目管理工具。 官网:https://www.zentao.net/ 津津乐道博客 津津乐道播客成立于 2016 年 2 月,是天津猿行天下科技有限公司旗下的播客品牌。津津乐道播客主创团队由多位行业资深人士组成,本着分享体验、传播经验的原则,团队在 IT、科技、旅游、教育等领域,制作了多档播客节目,并获得市场好评。 官网:https://dao.fm/ IPIP.net IPIP 专注 IP 地理位置以及 IP 画像数据的研究、整理与发行,我们的主力产品 IP 地理位置数据库主要基于 BGP/ASN 数据以及遍布全球的网络监测点进行城市级 IP 地域数据标注,准确度远高于国内国外同类产品。 官网:https://www.ipip.net/ GreatSQL 社区 GreatSQL 社区成立于 2021 年,由万里数据库发起,致力于通过开放的社区合作,构建国内自主开源数据库版本及开源数据库技术,推动中国开源数据库及应用生态繁荣发展。GreatSQL 是适用于金融级应用的国内自主开源数据库,具备高性能、高可靠、高易用性、高安全等多个核心特性,可以作为 MySQL 或 Percona Server 的可选替换,用于线上生产环境,且完全免费并兼容 MySQL 或 Percona Server。 官网链接:https://greatsql.cn/ Gitee 仓库:https://gitee.com/GreatSQL 爱可生开源社区 爱可生开源社区,一个有深度的 MySQL 开源社区。社区成立于 2017 年,以开源高质量的运维工具、日常分享技术干货内容、数据库技术布道为己任;目前开源的产品有:SQL 审核工具 SQLE、分布式中间件 DBLE 和数据传输组件 DTLE。在这里,你将收获:高质量的技术内容,企业级数据库工具及服务,丰富的社区活动。 链接:https://opensource.actionsky.com/ PG 中文社区 PostgreSQL 中文社区是一个非盈利的民间组织,目前成员都以志愿者身份加入,成立的目的在于构建 PG 数据库技术生态圈子 (内核、用户培训机构、厂商、服务商、软件开发商、高校形成 “业务与利益双向驱动” 的良性发展生态圈);帮助企业解决人才培养和企业商用数据库成本问题,社区会在各运营平台发布 PostgreSQL 最新信息和 PostgreSQL 相关技术文章,推动 PG 技术在中国的发展。 官网链接:http://www.postgres.cn/index.php/v2/home 凹语言 凹语言是一个面向 WebAssembly 设计的静态类型编译型语言,目标是简化 WASM 应用的开发。目前已经发布 MVP 版本,并提供了在线的纯浏览器 Playground 和贪吃蛇案例实现。 主页:https://wa-lang.org KCL 社区 KCL是一个开源的基于约束的记录及函数语言,作为沙盒项目托管在 CNCF 基金会。KCL 通过成熟的编程语言技术和实践来改进对大量繁杂配置比如云原生 Kubernetes 配置场景的编写,致力于构建围绕配置的更好的模块化、扩展性和稳定性,更简单的逻辑编写,以及更简单的自动化和生态工具集成。 官网链接:https://kcl-lang.io GitHub 仓库:https://github.com/kcl-lang AllData AllData 大数据产品是可定义数据中台,以数据平台为底座,以数据中台为桥梁,以机器学习平台,GPT 平台为框架,提供全链路数字化解决方案。 项目地址:https://github.com/alldatacenter/alldata 社区官网:https://alldata.readthedocs.io/zh/master/ 得物技术 得物技术一直以 "上海最好的技术团队" 为目标,现已建立上海、北京、杭州三地研发协同与管理机制,实现研发过程数据化、自动化;覆盖供应链、业务支撑、算法、前端等领域,是得物业务背后强有力的技术力量支撑。 官网链接:https://tech.dewu.com/ 重庆软件园 重庆软件园位于重庆经开区,占地 110 万平方米,布局四大组团,是重庆市首批软件产业园 (综合型)、A 区入选重庆市软件和信息服务业 “满天星” 示范楼宇 (首批),于 2019 年 9 月 16 日正式开园,坚持 “做生态 = 做产业,做人才 = 做产业,做服务 = 做产业” 的发展理念,建设集科技、人文、生态、智慧为一体的领军型软件园区。聚焦 “3+2” 产业布局,实现新一代信息技术产业集群发展。 园区聚集软件类企业近 2000 家,软件人才近 3 万人,已登记 4000 多项软件著作权,研发投入超 50 亿,40 余项专利将获得科技奖,营收上亿企业近 20 家。立足南岸区、重庆经开区优质产业资源,聚焦软件信息服务业、智能制造、绿色环保 、汽车软件汽车电子、大健康等产业,推动软件产业高质量发展,重庆软件园将全面贯彻落实 “满天星” 计划,力争到 2026 年成功建成中国软件名园。 园区官网:http://www.chongqingpark.com/ 东方瑞通 东方瑞通成立于 1998 年,是国内较早的 IT 高级技术培训企业之一,拥有华为、红帽、微软、PMI、VMware、Oracle 等 33 余家国际厂商授权资质,以培养 it 人才为主,目前覆盖领域:虚拟化、操作系统、网络、安全、数据库、IT 管理、软件开发等细分领域,提供线上,线下交流培训课程与活动。 官网链接:www.easthome.co 秦派软件 北京秦派软件科技有限公司(Pulsarware® Technologies Ltd.)是一家致力于开发生产力工具软件的技术公司,成立之初立志要在工具软件领域深耕,践行精益求精的研发精神,努力推出优质的生产力工具软件服务国内外的开发者,提升开发者的工作效率,同时创造出商业价值和社会价值。 ATOMDB™ 数据库管理客户端是秦派软件研发的一款服务广大开发者的工具软件。可以让开发者方便地执行查询,创建和管理数据库,支持管理市场上主流的数据库管理系统。例如: TIDB, PolarDB, GreatDB, 人大金仓, 神舟通用, TDengine, MySQL, PostgreSQL, Microsoft SQL Server, Oracle 等等。软件设计支持 Windows、MacOS、Linux 等操作系统,软件采用插件扩展的方式对多数据库进行支持。 官网链接:atomdb.com

优秀的个人博客,低调大师

TCP 5连问,你能抗到第几轮?

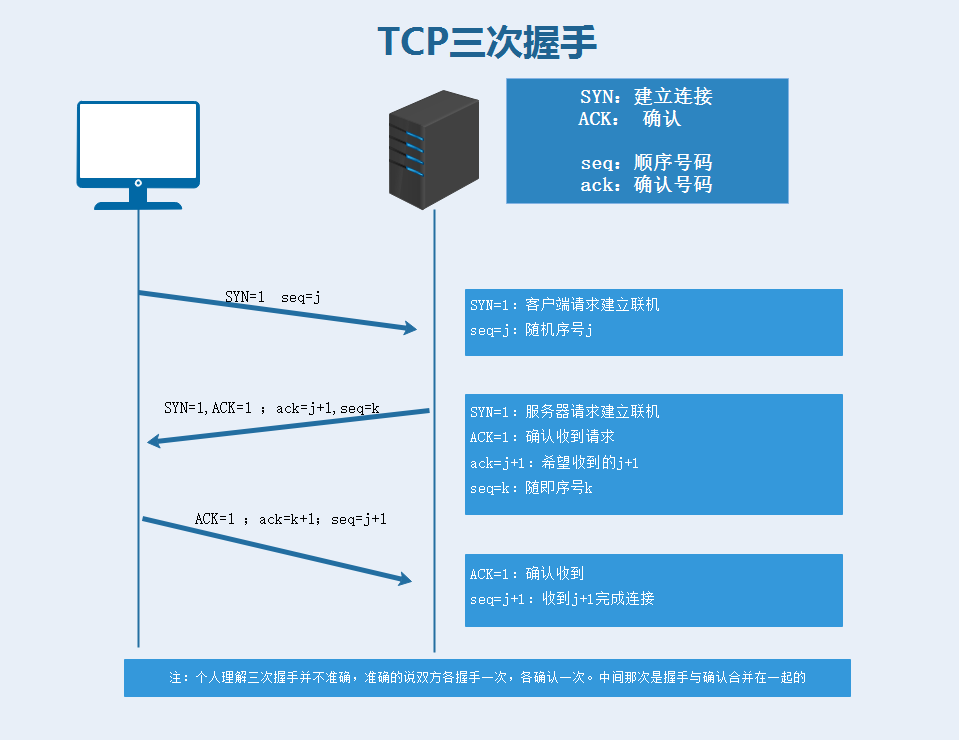
1,TCP3次握手具体过程 2,请聊聊SYN攻击 3,CLOSE-WAIT 和 TIME-WAIT的作用 4,TCP如何保证可靠性 5,TCP如何进行拥塞控制 答案解析 ​ TCP是面向连接的通信协议,通过三次握手建立连接,通讯完成时要拆除连接,由于TCP是面向连接的所以只能用于端到端的通讯。 ​ TCP提供的是一种可靠的数据流服务,采用“带重传的肯定确认”技术来实现传输的可靠性。TCP还采用一种称为“滑动窗口”的方式进行流量控制,所谓窗口实际表示接收能力,用以限制发送方的发送速度。 ​ 如果IP数据包中有已经封好的TCP数据包,那么IP将把它们向‘上’传送到TCP层。TCP将包排序并进行错误检查,同时实现虚电路间的连接。TCP数据包中包括序号和确认,所以未按照顺序收到的包可以被排序,而损坏的包可以被重传。 ​ TCP将它的信息送到更高层的应用程序,例如Telnet的服务程序和客户程序。应用程序轮流将信息送回TCP层,TCP层便将它们向下传送到IP层,设备驱动程序和物理介质,最后到接收方。 ​ 面向连接的服务(例如Telnet、FTP、rlogin、[X Windows](https://baike.baidu.com/item/X Windows)和SMTP)需要高度的可靠性,所以它们使用了TCP。DNS在某些情况下使用TCP(发送和接收域名数据库),但使用UDP传送有关单个主机的信息。 TCP三次握手 为什么需要三次握手 ​ 主机建立连接为什么需要三次握手?为了防止已经是失效连接突然又重新回到了服务端而产生的错误。“比如一个客户端发出一个连接请求报文虽然没有丢失,但是由于一些原因在在某个网络节点中长时间滞留,以至于在断开连接后才到达服务端。这本身就是一个已经失效的报文。但是服务器误以为是客户端的又一个新的请求。假设没有三次握手那么只要服务端发出确认链接就建立了。由于客户端也没有给服务端发请求,因此也不回复服务端的确认。但是服务端确认为新的连接开始了,等待客户端发数据。这样就容易造成服务端的资源的浪费。采用三次握手可以防止这种情况发生。 ​ TCP 提供面向有连接的通信传输。面向有连接是指在数据通信开始之前先做好两端之间的准备工作。 ​ 所谓三次握手是指建立一个 TCP 连接时需要客户端和服务器端总共发送三个包以确认连接的建立。在socket编程中,这一过程由客户端执行connect来触发。 第一次握手 ​ 客户端将标志位SYN置为1,随机产生一个值seq=J,并将该数据包发送给服务器端,客户端进入SYN_SENT状态,等待服务器端确认。 第二次握手 ​ 服务器端收到数据包后由标志位SYN=1知道客户端请求建立连接,服务器端将标志位SYN和ACK都置为1,ack=J+1,随机产生一个值seq=K,并将该数据包发送给客户端以确认连接请求,服务器端进入SYN_RCVD状态。 第三次握手 ​ 客户端收到确认后,检查ack是否为J+1,ACK是否为1,如果正确则将标志位ACK置为1,ack=K+1,并将该数据包发送给服务器端,服务器端检查ack是否为K+1,ACK是否为1,如果正确则连接建立成功,客户端和服务器端进入ESTABLISHED状态,完成三次握手,随后客户端与服务器端之间可以开始传输数据了。 TCP的三次握手的漏洞 ​ 但是在TCP三次握手中是有一个缺陷的,就是如果我们利用三次握手的缺陷进行攻击。这个攻击就是SYN洪泛攻击。三次握手中有一个第二次握手,服务端向客户端应道请求,应答请求是需要客户端IP的,服务端是需要知道客户端IP的,攻击者就伪造这个IP,往服务器端狂发送第一次握手的内容,当然第一次握手中的客户端IP地址是伪造的,从而服务端忙于进行第二次握手但是第二次握手当然没有结果,所以导致服务器端被拖累,死机。 ​ 当然我们的生活中也有可能有这种例子,一个家境一般的IT男去表白他的女神被拒绝了,理由是他家里没矿,IT男为了报复,采用了洪泛攻击,他请了很多人伪装成有钱人去表白那位追求矿的女神,让女生每次想交往时发现表白的人不见了同时还联系不上了。 面对这种攻击,有以下的解决方案,最好的方案是防火墙。 无效连接监视释放 ​ 这种方法不停监视所有的连接,包括三次握手的,还有握手一次的,反正是所有的,当达到一定(与)阈值时拆除这些连接,从而释放系统资源。这种方法对于所有的连接一视同仁,不管是正常的还是攻击的,所以这种方式不推荐。 延缓TCB分配方法 ​ 一般的做完第一次握手之后,服务器就需要为该请求分配一个TCB(连接控制资源),通常这个资源需要200多个字节。延迟TCB的分配,当正常连接建立起来后再分配TCB则可以有效地减轻服务器资源的消耗。 使用防火墙 ​ 防火墙在确认了连接的有效性后,才向内部的服务器(Listener)发起SYN请求, TCP四次挥手(断开连接) ​ 四次挥手即终止TCP连接,就是指断开一个TCP连接时,需要客户端和服务端总共发送4个包以确认连接的断开。在socket编程中,这一过程由客户端或服务端任一方执行close来触发。 ​ 由于TCP连接是全双工的,因此,每个方向都必须要单独进行关闭,这一原则是当一方完成数据发送任务后,发送一个FIN来终止这一方向的连接,收到一个FIN只是意味着这一方向上没有数据流动了,即不会再收到数据了,但是在这个TCP连接上仍然能够发送数据,直到这一方向也发送了FIN。首先进行关闭的一方将执行主动关闭,而另一方则执行被动关闭。 客户端进程发出连接释放报文,并且停止发送数据。释放数据报文首部,FIN=1,其序列号为seq=u(等于前面已经传送过来的数据的最后一个字节的序号加1),此时,客户端进入FIN-WAIT-1(终止等待1)状态。 TCP规定,FIN报文段即使不携带数据,也要消耗一个序号。 服务器收到连接释放报文,发出确认报文,ACK=1,ack=u+1,并且带上自己的序列号seq=v,此时,服务端就进入了CLOSE-WAIT(关闭等待)状态。TCP服务器通知高层的应用进程,客户端向服务器的方向就释放了,这时候处于半关闭状态,即客户端已经没有数据要发送了,但是服务器若发送数据,客户端依然要接受。这个状态还要持续一段时间,也就是整个CLOSE-WAIT状态持续的时间。 客户端收到服务器的确认请求后,此时,客户端就进入FIN-WAIT-2(终止等待2)状态,等待服务器发送连接释放报文(在这之前还需要接受服务器发送的最后的数据)。 服务器将最后的数据发送完毕后,就向客户端发送连接释放报文,FIN=1,ack=u+1,由于在半关闭状态,服务器很可能又发送了一些数据,假定此时的序列号为seq=w,此时,服务器就进入了LAST-ACK(最后确认)状态,等待客户端的确认。 客户端收到服务器的连接释放报文后,必须发出确认,ACK=1,ack=w+1,而自己的序列号是seq=u+1,此时,客户端就进入了TIME-WAIT(时间等待)状态。注意此时TCP连接还没有释放,必须经过2∗∗MSL(最长报文段寿命)的时间后,当客户端撤销相应的TCB后,才进入CLOSED状态。 ​ ​ 服务器只要收到了客户端发出的确认,立即进入CLOSED状态。同样,撤销TCB后,就结束了这次的TCP连接。可以看到,服务器结束TCP连接的时间要比客户端早一些。 为什么挥手比握手多一次 ​ 因为tcp连接是全双工的,因此每个方向都必须单独的断开连接客户端申请断开连接,只是不再发送数据,还能接收数据。需要等待服务端将数据发送完毕后,等待服务端申请断开连接。 TCP/IP中的数据包 ​ 每个分层中,都会对所发送的数据附加一个首部,在这个首部中包含了该层必要的信息,如发送的目标地址以及协议相关信息。通常,为协议提供的信息为包首部,所要发送的内容为数据。在下一层的角度看,从上一层收到的包全部都被认为是本层的数据。 ​ 网络中传输的数据包由两部分组成:一部分是协议所要用到的首部,另一部分是上一层传过来的数据。首部的结构由协议的具体规范详细定义。在数据包的首部,明确标明了协议应该如何读取数据。反过来说,看到首部,也就能够了解该协议必要的信息以及所要处理的数据。 应用程序处理 ​ 首先应用程序会进行编码处理,这些编码相当于 OSI 的表示层功能; 编码转化后,邮件不一定马上被发送出去,这种何时建立通信连接何时发送数据的管理功能,相当于 OSI 的会话层功能。 TCP 模块的处理 ​ TCP 根据应用的指示,负责建立连接、发送数据以及断开连接。TCP 提供将应用层发来的数据顺利发送至对端的可靠传输。为了实现这一功能,需要在应用层数据的前端附加一个 TCP 首部。 IP 模块的处理 ​ IP 将 TCP 传过来的 TCP 首部和 TCP 数据合起来当做自己的数据,并在 TCP 首部的前端加上自己的 IP 首部。IP 包生成后,参考路由控制表决定接受此 IP 包的路由或主机。 网络接口(以太网驱动)的处理 ​ 从 IP 传过来的 IP 包对于以太网来说就是数据。给这些数据附加上以太网首部并进行发送处理,生成的以太网数据包将通过物理层传输给接收端。 网络接口(以太网驱动)的处理 ​ 主机收到以太网包后,首先从以太网包首部找到 MAC 地址判断是否为发送给自己的包,若不是则丢弃数据。 如果是发送给自己的包,则从以太网包首部中的类型确定数据类型,再传给相应的模块,如 IP、ARP 等。这里的例子则是 IP 。 IP 模块的处理 ​ IP 模块接收到 数据后也做类似的处理。从包首部中判断此 IP 地址是否与自己的 IP 地址匹配,如果匹配则根据首部的协议类型将数据发送给对应的模块,如 TCP、UDP。这里的例子则是 TCP。 另外吗,对于有路由器的情况,接收端地址往往不是自己的地址,此时,需要借助路由控制表,在调查应该送往的主机或路由器之后再进行转发数据。 TCP 模块的处理 ​ 在 TCP 模块中,首先会计算一下校验和,判断数据是否被破坏。然后检查是否在按照序号接收数据。最后检查端口号,确定具体的应用程序。数据被完整地接收以后,会传给由端口号识别的应用程序。 应用程序的处理 ​ 接收端应用程序会直接接收发送端发送的数据。通过解析数据,展示相应的内容。 TCP的通讯原理 Socket套接字 ​ Socket 的原意是“插座”,在计算机通信领域,socket 被翻译为“套接字”,它是计算机之间进行通信的一种约定或一种方式。通过 socket 这种约定,一台计算机可以接收其他计算机的数据,也可以向其他计算机发送数据。TCP用主机的IP地址加上主机上的端口号作为TCP连接的端点,这种端点就叫做套接字(socket)。 ​ 区分不同应用程序进程间的网络通信和连接,主要有3个参数:通信的目的IP地址、使用的传输层协议(TCP或UDP)和使用的端口号。通过将这3个参数结合起来,与一个“插座”Socket绑定,应用层就可以和传输层通过套接字接口,区分来自不同应用程序进程或网络连接的通信,实现数据传输的并发服务。 ​ 套接字对是一个定义该连接的两个端点的四元组:本地IP地址、本地TCP端口号、外地IP地址、外地TCP端口号。套接字对唯一标识一个网络上的每个TCP连接。 TCP缓冲区 ​ 每个TCP的Socket的内核中都有一个发送缓冲区和一个接收缓冲区。现在我们假设用write()方法发送数据,使用 read()方法接收数据。 ​ write()并不立即向网络中传输数据,而是先将数据写入缓冲区中,再由TCP协议将数据从缓冲区发送到目标机器。一旦将数据写入到缓冲区,函数就可以成功返回,不管它们有没有到达目标机器,也不管它们何时被发送到网络,这些都是TCP协议负责的事情。 ​ TCP协议独立于 write()函数,数据有可能刚被写入缓冲区就发送到网络,也可能在缓冲区中不断积压,多次写入的数据被一次性发送到网络,这取决于当时的网络情况、当前线程是否空闲等诸多因素,不由程序员控制。 ​ read()也是如此,也从输入缓冲区中读取数据,而不是直接从网络中读取。 总得来说,I/O缓冲区在每个TCP套接字中单独存在;I/O缓冲区在创建套接字时自动生成; TCP 的可靠性 ​ 在 TCP 中,当发送端的数据到达接收主机时,接收端主机会返回一个已收到消息的通知。这个消息叫做确认应答(ACK)。当发送端将数据发出之后会等待对端的确认应答。如果有确认应答,说明数据已经成功到达对端。反之,则数据丢失的可能性很大。 ​ 在一定时间内没有等待到确认应答,发送端就可以认为数据已经丢失,并进行重发。由此,即使产生了丢包,仍然能够保证数据能够到达对端,实现可靠传输。 ​ 未收到确认应答并不意味着数据一定丢失。也有可能是数据对方已经收到,只是返回的确认应答在途中丢失。这种情况也会导致发送端误以为数据没有到达目的地而重发数据。 ​ 此外,也有可能因为一些其他原因导致确认应答延迟到达,在源主机重发数据以后才到达的情况也屡见不鲜。此时,源主机只要按照机制重发数据即可。 ​ 对于目标主机来说,反复收到相同的数据是不可取的。为了对上层应用提供可靠的传输,目标主机必须放弃重复的数据包。为此我们引入了序列号。 ​ 序列号是按照顺序给发送数据的每一个字节(8位字节)都标上号码的编号。接收端查询接收数据 TCP 首部中的序列号和数据的长度,将自己下一步应该接收的序列号作为确认应答返送回去。通过序列号和确认应答号,TCP 能够识别是否已经接收数据,又能够判断是否需要接收,从而实现可靠传输。 TCP中的滑动窗口 ​ 发送方和接收方都会维护一个数据帧的序列,这个序列被称作窗口。发送方的窗口大小由接收方确认,目的是控制发送速度,以免接收方的缓存不够大导致溢出,同时控制流量也可以避免网络拥塞。 ​ 在TCP 的可靠性的图中,我们可以看到,发送方每发送一个数据接收方就要给发送方一个ACK对这个数据进行确认。只有接收了这个确认数据以后发送方才能传输下个数据。 ​ 存在的问题:如果窗口过小,当传输比较大的数据的时候需要不停的对数据进行确认,这个时候就会造成很大的延迟。 ​ 如果窗口过大,我们假设发送方一次发送100个数据,但接收方只能处理50个数据,这样每次都只对这50个数据进行确认。发送方下一次还是发送100个数据,但接受方还是只能处理50个数据。这样就避免了不必要的数据来拥塞我们的链路。 ​ 因此,我们引入了滑动窗口。滑动窗口通俗来讲就是一种流量控制技术。 ​ 它本质上是描述接收方的TCP数据报缓冲区大小的数据,发送方根据这个数据来计算自己最多能发送多长的数据,如果发送方收到接收方的窗口大小为0的TCP数据报,那么发送方将停止发送数据,等到接收方发送窗口大小不为0的数据报的到来。 固定窗口大小的问题 我们可以看下面一张图来分析一下固定窗口大小有什么问题。 ​ 这里我们可以看到假设窗口的大小是1,也是就每次只能发送一个数据只有接受方对这个数据进行确认了以后才能发送第2个数据。我们可以看到发送方每发送一个数据接受方就要给发送方一个ACK对这个数据进行确认。只有接受到了这个确认数据以后发送方才能传输下个数据。 滑动窗口如何工作 ​ 这样我们考虑一下如果说窗口过小,那么当传输比较大的数据的时候需要不停的对数据进行确认,这个时候就会造成很大的延迟。如果说窗口的大小定义的过大。我们假设发送方一次发送100个数据。但是接收方只能处理50个数据。这样每次都会只对这50个数据进行确认。发送方下一次还是发送100个数据,但是接受方还是只能处理50个数据。这样就避免了不必要的数据来拥塞我们的链路。所以我们就引入了滑动窗口机制,窗口的大小并不是固定的而是根据我们之间的链路的带宽的大小,这个时候链路是否拥护塞。接受方是否能处理这么多数据了。 ​ 首先是第一次发送数据这个时候的窗口大小是根据链路带宽的大小来决定的。我们假设这个时候窗口的大小是3。这个时候接受方收到数据以后会对数据进行确认告诉发送方我下次希望手到的是数据是多少。这里我们看到接收方发送的ACK=3。这个时候发送方收到这个数据以后就知道我第一次发送的3个数据对方只收到了2个。就知道第3个数据对方没有收到。下次在发送的时候就从第3个数据开始发。这个时候窗口大小就变成了2 。 这个时候发送方发送2个数据。 ​ 看到接收方发送的ACK是5就表示他下一次希望收到的数据是5,发送方就知道我刚才发送的2个数据对方收了这个时候开始发送第5个数据。 ​ 这就是滑动窗口的工作机制,当链路变好了或者变差了这个窗口还会发生变话,并不是第一次协商好了以后就永远不变了。 ​ 所以滑动窗口协议,是TCP使用的一种流量控制方法。该协议允许发送方在停止并等待确认前可以连续发送多个分组。由于发送方不必每发一个分组就停下来等待确认,因此该协议可以加速数据的传输。 ​ 只有在接收窗口向前滑动时(与此同时也发送了确认),发送窗口才有可能向前滑动。 ​ 收发两端的窗口按照以上规律不断地向前滑动,因此这种协议又称为滑动窗口协议。 本文由传智教育博学谷教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

优秀的个人博客,低调大师

9个常用的Shell脚本,面试也常问!

1、Dos 攻击防范(自动屏蔽攻击 IP) #!/bin/bash DATE=$(date+%d/%b/%Y:%H:%M) LOG_FILE=/usr/local/nginx/logs/demo2.access.log ABNORMAL_IP=$(tail-n5000$LOG_FILE|grep$DATE|awk'{a[$1]++}END{for(iina)if(a[i]>10)printi}') forIPin$ABNORMAL_IP;do if[$(iptables-vnL|grep-c"$IP")-eq0];then iptables-IINPUT-s$IP-jDROP echo"$(date+'%F_%T')$IP">>/tmp/drop_ip.log fi done 2、Linux 系统发送告警脚本 #yuminstallmailx #vi/etc/mail.rc setfrom=baojingtongzhi@163.comsmtp=smtp.163.com setsmtp-auth-user=baojingtongzhi@163.comsmtp-auth-password=123456 setsmtp-auth=login 3、MySQL 数据库备份单循环 #!/bin/bash DATE=$(date+%F_%H-%M-%S) HOST=localhost USER=backup PASS=123.com BACKUP_DIR=/data/db_backup DB_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"showdatabases;"2>/dev/null|egrep-v"Database|information_schema|mysql|performance_schema|sys") forDBin$DB_LIST;do BACKUP_NAME=$BACKUP_DIR/${DB}_${DATE}.sql if!mysqldump-h$HOST-u$USER-p$PASS-B$DB>$BACKUP_NAME2>/dev/null;then echo"$BACKUP_NAME备份失败!" fi done 4、MySQL 数据库备份多循环 #!/bin/bash DATE=$(date+%F_%H-%M-%S) HOST=localhost USER=backup PASS=123.com BACKUP_DIR=/data/db_backup DB_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"showdatabases;"2>/dev/null|egrep-v"Database|information_schema|mysql|performance_schema|sys") forDBin$DB_LIST;do BACKUP_DB_DIR=$BACKUP_DIR/${DB}_${DATE} [!-d$BACKUP_DB_DIR]&&mkdir-p$BACKUP_DB_DIR&>/dev/null TABLE_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"use$DB;showtables;"2>/dev/null) forTABLEin$TABLE_LIST;do BACKUP_NAME=$BACKUP_DB_DIR/${TABLE}.sql if!mysqldump-h$HOST-u$USER-p$PASS$DB$TABLE>$BACKUP_NAME2>/dev/null;then echo"$BACKUP_NAME备份失败!" fi done done 5、Nginx 访问访问日志按天切割 #!/bin/bash LOG_DIR=/usr/local/nginx/logs YESTERDAY_TIME=$(date-d"yesterday"+%F) LOG_MONTH_DIR=$LOG_DIR/$(date+"%Y-%m") LOG_FILE_LIST="default.access.log" forLOG_FILEin$LOG_FILE_LIST;do [!-d$LOG_MONTH_DIR]&&mkdir-p$LOG_MONTH_DIR mv$LOG_DIR/$LOG_FILE$LOG_MONTH_DIR/${LOG_FILE}_${YESTERDAY_TIME} done kill-USR1$(cat/var/run/nginx.pid) 6、Nginx 访问日志分析脚本 #!/bin/bash #日志格式:$remote_addr-$remote_user[$time_local]"$request"$status$body_bytes_sent"$http_referer""$http_user_agent""$http_x_forwarded_for" LOG_FILE=$1 echo"统计访问最多的10个IP" awk'{a[$1]++}END{print"UV:",length(a);for(vina)printv,a[v]}'$LOG_FILE|sort-k2-nr|head-10 echo"----------------------" echo"统计时间段访问最多的IP" awk'$4>="[01/Dec/2018:13:20:25"&&$4<="[27/Nov/2018:16:20:49"{a[$1]++}END{for(vina)printv,a[v]}'$LOG_FILE|sort-k2-nr|head-10 echo"----------------------" echo"统计访问最多的10个页面" awk'{a[$7]++}END{print"PV:",length(a);for(vina){if(a[v]>10)printv,a[v]}}'$LOG_FILE|sort-k2-nr echo"----------------------" echo"统计访问页面状态码数量" awk'{a[$7""$9]++}END{for(vina){if(a[v]>5)printv,a[v]}}' 7、查看网卡实时流量脚本 #!/bin/bash NIC=$1 echo-e"In------Out" whiletrue;do OLD_IN=$(awk'$0~"'$NIC'"{print$2}'/proc/net/dev) OLD_OUT=$(awk'$0~"'$NIC'"{print$10}'/proc/net/dev) sleep1 NEW_IN=$(awk'$0~"'$NIC'"{print$2}'/proc/net/dev) NEW_OUT=$(awk'$0~"'$NIC'"{print$10}'/proc/net/dev) IN=$(printf"%.1f%s""$((($NEW_IN-$OLD_IN)/1024))""KB/s") OUT=$(printf"%.1f%s""$((($NEW_OUT-$OLD_OUT)/1024))""KB/s") echo"$IN$OUT" sleep1 done 8、服务器系统配置初始化脚本 #/bin/bash #设置时区并同步时间 ln-s/usr/share/zoneinfo/Asia/Shanghai/etc/localtime if!crontab-l|grepntpdate&>/dev/null;then (echo"*1***ntpdatetime.windows.com>/dev/null2>&1";crontab-l)|crontab fi #禁用selinux sed-i'/SELINUX/{s/permissive/disabled/}'/etc/selinux/config #关闭防火墙 ifegrep"7.[0-9]"/etc/redhat-release&>/dev/null;then systemctlstopfirewalld systemctldisablefirewalld elifegrep"6.[0-9]"/etc/redhat-release&>/dev/null;then serviceiptablesstop chkconfigiptablesoff fi #历史命令显示操作时间 if!grepHISTTIMEFORMAT/etc/bashrc;then echo'exportHISTTIMEFORMAT="%F%T`whoami`"'>>/etc/bashrc fi #SSH超时时间 if!grep"TMOUT=600"/etc/profile&>/dev/null;then echo"exportTMOUT=600">>/etc/profile fi #禁止root远程登录 sed-i's/#PermitRootLoginyes/PermitRootLoginno/'/etc/ssh/sshd_config #禁止定时任务向发送邮件 sed-i's/^MAILTO=root/MAILTO=""/'/etc/crontab #设置最大打开文件数 if!grep"*softnofile65535"/etc/security/limits.conf&>/dev/null;then cat>>/etc/security/limits.conf<<EOF *softnofile65535 *hardnofile65535 EOF fi #系统内核优化 cat>>/etc/sysctl.conf<<EOF net.ipv4.tcp_syncookies=1 net.ipv4.tcp_max_tw_buckets=20480 net.ipv4.tcp_max_syn_backlog=20480 net.core.netdev_max_backlog=262144 net.ipv4.tcp_fin_timeout=20 EOF #减少SWAP使用 echo"0">/proc/sys/vm/swappiness #安装系统性能分析工具及其他 yuminstallgccmakeautoconfvimsysstatnet-toolsiostatif 9、监控 100 台服务器磁盘利用率脚本 #!/bin/bash HOST_INFO=host.info forIPin$(awk'/^[^#]/{print$1}'$HOST_INFO);do USER=$(awk-vip=$IP'ip==$1{print$2}'$HOST_INFO) PORT=$(awk-vip=$IP'ip==$1{print$3}'$HOST_INFO) TMP_FILE=/tmp/disk.tmp ssh-p$PORT$USER@$IP'df-h'>$TMP_FILE USE_RATE_LIST=$(awk'BEGIN{OFS="="}/^\/dev/{print$NF,int($5)}'$TMP_FILE) forUSE_RATEin$USE_RATE_LIST;do PART_NAME=${USE_RATE%=*} USE_RATE=${USE_RATE#*=} if[$USE_RATE-ge80];then echo"Warning:$PART_NAMEPartitionusage$USE_RATE%!" fi done done

优秀的个人博客,低调大师

面试官常问的HTTP知识点

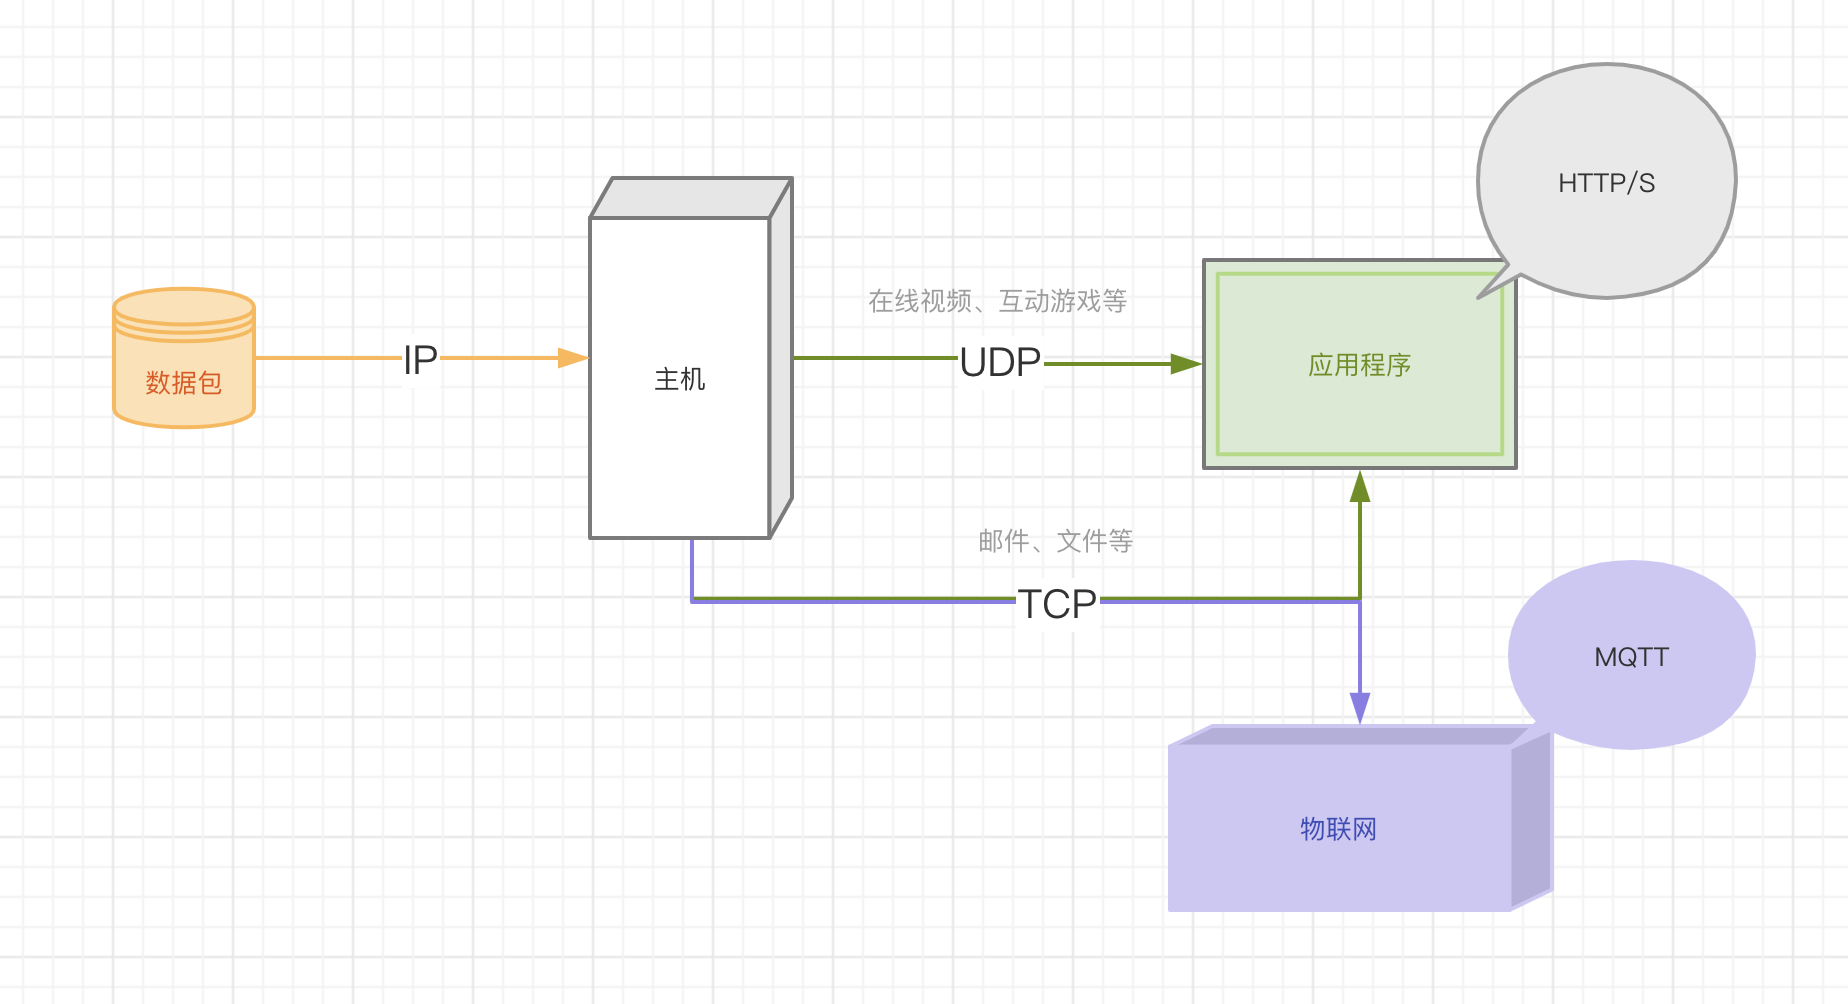
互联网中的数据是通过数据包来传输的,IP通过DNS查询IP地址进而把数据包送达目的主机,UDP接过数据包,通过端口号把数据包送往具体的应用,而使用TCP可保证数据的完整性 当传输层TCP/IP协议将数据传输到网络上时,浏览器可通过HTTP协议进行文本传输,物联网可通过MQTT协议进行交互 一、UDP UDP传输非常快,适合在线视频、互动游戏这类强交互的场景 对于数据可靠性有要求的场景则不太适合,它有个大缺点:不能保证数据可靠性 不提供重发机制,直接丢弃当前的包 发送之后不售后,无法确认是否到达目的地 无法还原数据包成完整的文件 但它的兄弟TCP可以代劳 二、TCP TCP是一种面向连接的、可靠的、基于字节流的传输层通信协议。解决了丢失数据包的问题,并且提供了组装数据包的能力。这不得不感谢发送端不仅给它提供了源端口号和目标端口号,还提供了序列号,引入了数据包排列机制 1、连接过程 1.1、建立连接 TCP是面向连接的,在数据通信之前就做好两端的准备工作,在客户端和服务端通过三个数据包来确认连接的建立 一开始,客户端和服务端都处于 close状态,接着服务端主动监听某个端口,处于listen状态 客户端生成初始序列号client_isn置于TCP首部的序列号中,同时更改SYN标志为1向服务器发起连接,之后处于SYN-SENT状态 服务端收到SYN报文同样生成初始序列号server_isn置于TCP首部的序列号中,并将客户端序列号+1置于TCP首部的确认应答号中,同时更改SYN和ACK标志为1,发送SYN + ACK报文并更改状态为SYN_RCVD 客户端收到SYN + ACK报文,将服务端序列号+1填入确认应答号并回复ACK应答报文变更状态为established 服务器收到应答后也进入established状态 只有第三次握手可以携带数据,前面两次是不可携带数据的 1.2、为什么三次握手? 通过三次握手能防止历史连接的建立,能减少双方不必要的资源开销,能帮助双方同步初始化序列号 两次握手无法仿制历史连接的建立,会造成双方资源的浪费,也无法可靠的同步双方序列号 四次握手:三次握手就已经理论上最少可靠连接建立,因此不需要使用更多的通信次数 2、传输数据 TCP是可靠的,接收端必须对每个数据包进行确认操作,即重发机制 当发送端发送了一个数据包之后,在规定时间内没有接收到反馈的确认信息,则判断数据包丢失,触发重发机制 TCP是基于字节流的,接收端可通过TCP提供的序号进行排序,进而保证数据的完整性,即排列机制 3、断开过程 3.1、断开连接 客户端主动关闭连接,发送FIN报文,即更改FIN标志为1同时进入FIN_WAIT_1状态 服务端收到报文后发出ACK应答报文,接着进入CLOSED_WAIT状态 客户端收到报文后,进入FIN_WAIT_2状态 服务器处理完成后发出FIN报文,并进入LAST_ACK状态 客户端收到报文后发出ACK应答报文,接着进入TIME_WAIT状态 服务器收到ACK应答报文后完成连接关闭 客户端 等待两倍报文最大生存时间(MSL)后 自动进入close状态,完成连接关闭 主动关闭连接的,才有TIME_WAIT状态 3.2、为什么四次挥手? 关闭连接时,客户端向服务端发送FIN时,仅代表客户端不再发送数据但能接收数据 服务端接收到FIN时,回复一个ACK,仅代表收到报文,但服务器可能还有数据需要处理和发送,确保不再发送数据时才发送FIN给到客户端表示同意现在关闭连接 三、HTTP HTTP 协议以 ASCII 码传输,构建于 TCP/IP 协议之上的应用层协议,默认端口号是 80,它是无连接无状态的超文本传输协议 1、HTTP 报文 1.1、请求报文 规范把 HTTP 请求分为三个部分:请求行、请求头 和 消息主体 [method] [url] [version] [headers] [body] HTTP 中的GET、POST、PUT、DELETE对应着资源的查、增、改、删4个操作 1.1.1、GET 只读操作,是安全且幂等的 安全:请求方法不会破坏服务器上的资源 幂等:多次执行相同的操作,结果都是相同的 1.1.2、POST 读写操作,是不安全且不幂等的 1.1.3、PUT 不同于POST,PUT是幂等的 1.1.4、OPTIONS 用以从服务器获取更多信息 1.2、响应报文 同样HTTP响应分为三个部分:状态行、响应头 和 响应正文 [version] [status code] [status msg] [headers] [body] 常见的状态码有 状态码 状态描述 备注 206 Partial Content 范围响应,主体包含所请求的数据区间<br/>断点续传时通过 Range 指定区间 301 Moved Permanently 请求永久重定向 302 Moved Temporarily 请求临时重定向 304 Not Modified 未修改,使用缓存文件(协商缓存) 400 Bad Request 客户端请求有语法错误 401 Unauthorized 请求未经授权(同WWW-Authenticate一起使用)<br/>在后续请求中携带 Authorization用于验证用户代理身份的凭证 403 Forbidden 服务器拒绝提供服务,通常在响应正文给出原因 404 Not Found 请求资源不存在 500 Internal Server Error 服务器发生不可预期的错误 503 Service Unavailable 服务器当前无法处理请求,需等待服务器恢复正常 2、HTTP 演变 版本 核心诉求 新增特性 HTTP/1.0 支持多种类型的文件下载 引入请求头、响应头、状态码 HTTP/1.1 提高对带宽的利用率 1、持久连接(每个域名最多同时维护 6 个 TCP 持久连接) 2、使用 CDN 实现域名分片机制 3、提供虚拟主机的支持(Host 字段) 4、增加缓存策略 5、安全机制(CORS) HTTP/2.0 提升网络速度 1、多路复用 2、设置请求的优先级 3、服务器推送 4、头部压缩 5、二进制格式 HTTP/3.0 构建高效网络 1、甩掉TCP、TLS 的包袱,使用UDP协议 2、QUIC协议 HTTPS 构建安全HTTP 引入SSL 、混合加密、摘要算法 、数字证书 2.1、持久连接 HTTP/1.1 中增加了持久连接的方法,即在一个 TCP 连接上可以传输多个 HTTP 请求,只要浏览器或者服务器没有明确断开连接,那么该 TCP 连接会一直保持,提升了整体 HTTP 的请求时长。目前浏览器中对于同一个域名,默认允许同时建立 6 个 TCP 持久连接 Connection: Keep-Alive; // HTTP/1.1默认使用持久连接,如需关闭,请求头Connection设置为close Keep-Alive: timeout=5, max=100; // HTTP 长连接不可能一直保持,timeout=5 表示这个TCP通道可以保持5秒,max=100,表示这个长连接最多接收100次请求就断开 2.2、使用 CDN 实现域名分片机制 2.3、提供虚拟主机的支持 Host表示当前的域名地址,服务器可以根据不同的 Host 值做不同的处理 Host: <host>:<port>; // host: 服务器的域名(用于虚拟主机) port: 服务器监听的 TCP 端口号 2.4、缓存策略 2.5、安全机制 2.5.1、会话跟踪 HTTP是无状态协议,即浏览器对于事务的处理没有记忆能力,可通过Cookie和JWT机制来进行会话跟踪 Cookie机制 服务端第一次收到请求时创建session对象生成对应的sessionID,将其放进Set-Cookie发送给客户端,下一次访问时,客户端携带sessionID请求服务端,服务端可通过sessionID识别用户信息 Cookie 的过期时间、域、路径、有效期、适用站点都可以根据需要来指定 功能 属性 例子 补充说明 定义 Cookie 的生命周期 Expires <br/> Max-Age Set-Cookie: key=value; Expires=Wed, 21 Oct 2022 07:28:00 GMT 设定的日期和时间只与客户端相关,会话期 Cookie 仅在会话期内有效 限制访问 Cookie HttpOnly<br/>Secure Set-Cookie: key=value; Secure; HttpOnly HttpOnly:仅作用于服务器<br/>Secure仅适用于 HTTPS 协议加密过的请求 Cookie 的作用域 Domain<br/>Path Set-Cookie:Domain=mozilla.org;Path=/docs Domain 指定了哪些主机可以接受 Cookie<br/>Path 指定了主机下的哪些路径可以接受 Cookie SameSite None<br/>Strict<br/>Lax Set-Cookie: key=value; SameSite=Strict None:浏览器会在同站请求、跨站请求下继续发送 cookies(旧版本浏览器默认选项)<br/>Strict:浏览器将只在访问相同站点时发送 cookie<br/>Lax:与 Strict 类似,但用户从外部站点导航至URL时除外(新版本浏览器默认选项) JWT机制 (JSON Web Token) Cookies 只适用于单节点的域 或 节点的子域,若通过第三个节点访问会被禁止。而JWT机制则支持跨域认证,可通过多个节点进行用户认证 服务端第一次收到请求时,进行认证后生成一个 Token(签名后的JSON 对象)发送给客户端。客户端可将收到的jwt存储在Cookie或localStorage上,之后每次与服务端通信都携带上,可通过Cookie自动发送,但这种方式不能跨域,比较推荐通过 POST 请求的数据体 或 Authorization进行传递 注意喔,JWT 的 Cookie 信息存储在客户端,即服务端是无状态的 2.5.2、跨源资源共享(CORS) 规范要求那些可能产生副作用的请求,浏览器必须首先使用OPTIONS方法发起一个预检请求,从而获知服务端是否允许跨域请求。服务器确认允许后才发起实际的HTTP请求。在预检请求的返回中,服务端可通知客户端是否需要携带身份凭证 简单请求 若请求满足下述所有条件,则称之为简单请求,它不会触发预检请求 1、使用GET、HEAD和POST请求方法 2、Content-Type的值仅限于text/plain、multipart/form-data和application/x-www-form-urlencoded 3、请求中没有注册任何事件监听器,没有使用 ReadableStream 对象 // 附带身份凭证的简单请求 withCredentials:true; // 向服务器发送 Cookies Access-Control-Allow-Credentials: true; // 服务端允许附带身份凭证 复杂请求 响应头 例子 说明 Access-Control-Allow-Origin Access-Control-Allow-Origin: <origin>/* Vary: Origin origin:指定允许访问该资源的URI<br/>若指定了具体的域名,则Vary的值必须包含Origin,表明服务端按URI返回对应内容 Access-Control-Expose-Headers Access-Control-Expose-Headers: X-My-Custom-Header 服务器把允许浏览器访问的头放入白名单 Access-Control-Allow-Credentials Access-Control-Allow-Credentials: true 指定了credentials:true时是否允许浏览器读取 response 的内容<br/>在预检请求的响应时,指定实际的请求是否可以使用 credentials Access-Control-Max-Age Access-Control-Max-Age: 86400 预检请求的结果在多少秒内有效 Access-Control-Allow-Methods Access-Control-Allow-Methods: <method>[, <method>]* 预检请求的响应,指明了实际请求所允许使用的 HTTP 方法 Access-Control-Allow-Headers Access-Control-Allow-Headers: <field-name>[, <field-name>]* 预检请求的响应,指明了实际请求中允许携带的首部字段 2.6、支持动态生成内容 服务器会将数据分割成若干个任意大小的数据块,每个数据块发送时会附上上个数据块的长度,最后使用一个零长度的块作为发送数据完成的标志,因此对于下载请求来说,是没有办法实现进度的 Transfer-Encoding: gzip, chunked; // 分块:chunked 压缩算法:compress、deflate、gzip 2.7、多路复用 一个域名只使用一个TCP长连接来传输数据,这样整个页面资源的下载过程只需要一次慢启动,避免了多个 TCP 连接竞争带宽的问题。移除了串行请求,顺应的解决了队头阻塞问题 2.8、设置请求的优先级 每个数据流都标记着独一无二的编号,客户端可以指定数据流的优先级 2.9、服务器推送 服务端主动向客户端发送消息,即:当用户请求一个 HTML 页面之后,服务器知道该 HTML 页面会引用几个重要的 JavaScript 文件和 CSS 文件,那么在接收到 HTML 请求之后,附带将要使用的 CSS 文件和 JavaScript 文件一并发送给浏览器,这样当浏览器解析完 HTML 文件之后,就能直接拿到需要的 CSS 文件和 JavaScript 文件,大大提升了页面首次渲染速度 2.10、头部压缩 HTTP/2.0引入HPACK算法:在客户端和服务器同时维护一张头信息表,所有字段都会存入这个表生成一个索引号,相同字段只发送对应的索引号,即:同时发出多个请求,请求头一样或相似,则协议会将重复部分消除 2.11、二进制格式 HTTP/2.0 全面采用二进制格式,头信息和数据体都是二进制,统称为「帧」提高了数据传输的效率 2.12、QUIC协议 实现了类似 TCP 的流量控制、传输可靠性的功能 集成了 TLS 加密功能,减少了握手所花费的 RTT 个数 实现了 HTTP/2 中的多路复用功能 不同于 TCP,QUIC 实现了在同一物理连接上可以有多个独立的逻辑数据流,实现了数据流的单独传输,避免了 TCP 中队头阻塞的问题 实现了快速握手功能,基于 UDP 的 QUIC 可使用 0-RTT|1-RTT 来建立连接 3、HTTPS HTTPS在HTTP和TCP之间加了一层用于加解密的SSL/TLS协议,通过信息加密、校验机制 和 身份证书 保证通信的安全性 客户端 发送 对称加密套件列表、非对称加密套件列表 和 客户端随机数 给到服务端 服务端 保存 客户端随机数 和 私钥,回复 选中的对称加密套件、非对称加密套件 和 服务端随机数 以及 数字证书 客户端向 CA机构验证数字证书,证实服务端身份并获取公钥 客户端利用两端的随机数计算出pre-master,并用获取到的公钥进行加密,发送加密后的pre-master 服务端拿出私钥进行解密,得到pre-master 服务端和客户端使用这三组随机数生成会话密钥,并返回确认消息 之后使用对称加密进行通讯 3.1、混合加密 HTTPS通过非对称加密交换「会话密钥」后续通信使用对称加密,这是由于 非对称加密使用两个密钥:公钥和私钥,公钥可保存在CA机构同时保存私钥。可以安全的进行密钥交换,但速度慢 对称加密只使用一个密钥,无法做到安全的密钥交换,但速度快 3.2、摘要算法 摘要算法通过生成唯一的指纹,用于校验数据的完整性。客户端在进行通信前会通过摘要算法得出明文的指纹,请求时将指纹和明文一并加密,服务端收到密文后进行解密,比对携带的指纹和当前计算的指纹是否一致,一致则说明数据完整 3.3、数字证书 权威机构CA签发认证的数字证书【包含了公钥、组织信息、CA信息、有效时间、证书序列号、CA生成的数字签名等】这些信息是明文的,同时可向浏览器证明服务器的身份 四、MQTT MQTT是基于二进制消息的发布/订阅编程模式的消息协议,非常适合需要低功耗和网络带宽有限的IoT场景 设备连接 设备通过MQTT协议连接到物联网云服务,进而可以进行设备管理及数据管理 消息类型 MQTT拥有14种不同的消息类型,比如CONNECT表示客户端连接到MQTT代理,CONNACK表示连接确认 主题 MQTT提供了主题对消息进行分类,消息是一个UTF-8的字符串,通过类似正则的规则进行匹配分类,比如:+可以过滤一个层级,*可以过滤任意级别的层级(必须在主题最后) 服务质量 MQTT提供级别0、级别1和级别2三种服务质量 服务质量 消息可靠性 解释 级别0 尽力而为 不提供重发 级别1 至少一次 提供重发,并发可能造成重复消息 级别2 恰好一次 不丢失不重复,但增加延时减少并发

优秀的个人博客,低调大师

5 分钟搞懂面试官必问 React 题

说说对 React Hooks 的理解?解决了什么问题? 一、是什么 Hook是 React 16.8 的新增特性。它可以让你在不编写class的情况下使用state以及其他的React特性 至于为什么引入hook,官方给出的动机是解决长时间使用和维护react过程中常遇到的问题,例如: 难以重用和共享组件中的与状态相关的逻辑 逻辑复杂的组件难以开发与维护,当我们的组件需要处理多个互不相关的 local state 时,每个生命周期函数中可能会包含着各种互不相关的逻辑在里面 类组件中的this增加学习成本,类组件在基于现有工具的优化上存在些许问题 由于业务变动,函数组件不得不改为类组件等等 在以前,函数组件也被称为无状态的组件,只负责渲染的一些工作 因此,现在的函数组件也可以是有状态的组件,内部也可以维护自身的状态以及做一些逻辑方面的处理 二、有哪些 上面讲到,Hooks让我们的函数组件拥有了类组件的特性,例如组件内的状态、生命周期 最常见的hooks有如下: useState useEffect 其他 useState 首先给出一个例子,如下: import React, { useState } from 'react'; function Example() { // 声明一个叫 "count" 的 state 变量 const [count, setCount] = useState(0); return ( <div> <p>You clicked {count} times</p > <button onClick={() => setCount(count + 1)}> Click me </button> </div> ); } 复制代码 在函数组件中通过useState实现函数内部维护state,参数为state默认的值,返回值是一个数组,第一个值为当前的state,第二个值为更新state的函数 该函数组件等价于的类组件如下: class Example extends React.Component { constructor(props) { super(props); this.state = { count: 0 }; } render() { return ( <div> <p>You clicked {this.state.count} times</p > <button onClick={() => this.setState({ count: this.state.count + 1 })}> Click me </button> </div> ); } } 复制代码 从上述两种代码分析,可以看出两者区别: state声明方式:在函数组件中通过 useState 直接获取,类组件通过constructor 构造函数中设置 state读取方式:在函数组件中直接使用变量,类组件通过this.state.count的方式获取 state更新方式:在函数组件中通过 setCount 更新,类组件通过this.setState() 总的来讲,useState 使用起来更为简洁,减少了this指向不明确的情况 useEffect useEffect可以让我们在函数组件中进行一些带有副作用的操作 同样给出一个计时器示例: class Example extends React.Component { constructor(props) { super(props); this.state = { count: 0 }; } componentDidMount() { document.title = `You clicked ${this.state.count} times`; } componentDidUpdate() { document.title = `You clicked ${this.state.count} times`; } render() { return ( <div> <p>You clicked {this.state.count} times</p > <button onClick={() => this.setState({ count: this.state.count + 1 })}> Click me </button> </div> ); } } 复制代码 从上面可以看见,组件在加载和更新阶段都执行同样操作 而如果使用useEffect后,则能够将相同的逻辑抽离出来,这是类组件不具备的方法 对应的useEffect示例如下: import React, { useState, useEffect } from 'react'; function Example() { const [count, setCount] = useState(0); useEffect(() => { document.title = `You clicked ${count} times`; }); return ( <div> <p>You clicked {count} times</p > <button onClick={() => setCount(count + 1)}> Click me </button> </div> ); } 复制代码 useEffect第一个参数接受一个回调函数,默认情况下,useEffect会在第一次渲染和更新之后都会执行,相当于在componentDidMount和componentDidUpdate两个生命周期函数中执行回调 如果某些特定值在两次重渲染之间没有发生变化,你可以跳过对 effect 的调用,这时候只需要传入第二个参数,如下: useEffect(() => { document.title = `You clicked ${count} times`; }, [count]); // 仅在 count 更改时更新 复制代码 上述传入第二个参数后,如果count的值是5,而且我们的组件重渲染的时候count还是等于5,React 将对前一次渲染的[5]和后一次渲染的[5]进行比较,如果是相等则跳过effects执行 回调函数中可以返回一个清除函数,这是effect可选的清除机制,相当于类组件中componentwillUnmount生命周期函数,可做一些清除副作用的操作,如下: useEffect(() => { function handleStatusChange(status) { setIsOnline(status.isOnline); } ChatAPI.subscribeToFriendStatus(props.friend.id, handleStatusChange); return () => { ChatAPI.unsubscribeFromFriendStatus(props.friend.id, handleStatusChange); }; }); 复制代码 所以,useEffect相当于componentDidMount,componentDidUpdate和componentWillUnmount这三个生命周期函数的组合 其它 hooks 在组件通信过程中可以使用useContext,refs学习中我们也用到了useRef获取DOM结构...... 还有很多额外的hooks,如: useReducer useCallback useMemo useRef 三、解决什么 通过对上面的初步认识,可以看到hooks能够更容易解决状态相关的重用的问题: 每调用useHook一次都会生成一份独立的状态 通过自定义hook能够更好的封装我们的功能 编写hooks为函数式编程,每个功能都包裹在函数中,整体风格更清爽,更优雅 hooks的出现,使函数组件的功能得到了扩充,拥有了类组件相似的功能,在我们日常使用中,使用hooks能够解决大多数问题,并且还拥有代码复用机制,因此优先考虑hooks 结语 创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源独尊 ” ,链接: https://ym.baisou.ltd/post/852.html

优秀的个人博客,低调大师

JVM面试必问:G1垃圾回收器

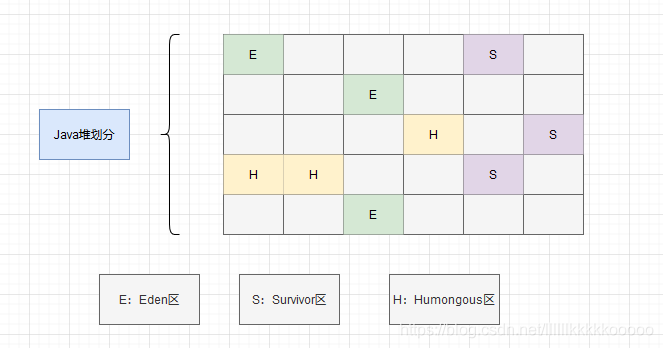
摘要:G1垃圾回收器是一款主要面向服务端应用的垃圾收集器。 本文分享自华为云社区《JVM面试高频考点:由浅入深带你了解G1垃圾回收器!!!》,原文作者:Code皮皮虾 。 G1垃圾回收器介绍 G1垃圾回收器是一款主要面向服务端应用的垃圾收集器。作为垃圾回收器技术发展史上里程碑的成果,G1垃圾回收器不同于以往的垃圾回收器,首先是思想上的转变,如下图: G1对于Java堆的划分 上面的图,小伙伴们第一次看可能不咋明白,因为各位还不了解G1,看看下面的话,应该就差不多了。 G1垃圾回收器对于Java堆区域的划分不同于以往我们对Java对区域划分的认知 以往对于Java堆区域的划分为:新生代和老年代,新生代又划分为 Eden区和 Survivor区,Survivor区又分为 from区和 to区。 但是现在,G1不再坚持固定大小以及固定数量的分代区域划分,而是把连续的Java堆空间划分为多个大小相等的独立区域(Region),每个Region都可以成为 Eden空间、Survivor空间、老年代空间。 这种思想上的转变和设计,使得G1可以面向堆内存任何部分来组成回收集来进行回收,衡量标准不再是它属于哪个分代,而是哪块内存存放的垃圾最多,回收收益最大,这就是G1收集器的 Mixed GC模式,即混合GC模式。 Region还有一类特殊的 Humongous 区域,专门用来存储大对象。G1认为只要大小超过了一个Region容量一半的对象即可判定为大对象。如果是那些超过了整个Region容量的超大对象,将会放在连续 N 个 Humongous Region区域。 Region的取值范围为 1M ~ 32M Region的默认个数为 2048个 -XX:G1HeapRegionSize = N G1这么做看起来是由一种焕然一新的感觉,但细心的小伙伴可能已经发现,如果 Region之间存在跨区引用对象,那这些对象如何解决? 不管是G1还是其他分代收集器,JVM都是使用 记忆集(Remembered Set) 来避免全局扫描。 每个Region都有一个对应的记忆集。 每次Reference类型数据写操作时,都会产生一个 写屏障(Write Barrier)暂时去终止操作 然后检查将要写入的引用 指向的对象是否和该Reference类型数据在不同的 Region(其他收集器:检查老年代对象是否引用了新生代对象) 如果不同,通过 卡表(Card Table)把相关引用信息记录到引用指向对象的所在Region对应的记忆集(Remembered Set) 中 当进行垃圾收集时,在GC Roots枚举范围加上记忆集;就可以保证不进行全局扫描了。 G1的记忆集可以理解为一个哈希表,Key就是别的Region的起始地址,Value就是卡表的索引号集合。 因为G1将Java堆划分为一个个Region的缘故,而Region数量相比于传统分代数量明显多得多,所以G1相比于传统的垃圾回收器来说,需要消耗相当于Java堆容量 10%~ 20%的额外空间来维持收集器的工作。 G1 垃圾回收器工作流程 初始标记(Initial Marking):这阶段仅仅只是标记GC Roots能直接关联到的对象并修改TAMS(Next Top at Mark Start)的值,让下一阶段用户程序并发运行时,能在正确的可用的Region中创建新对象,这阶段需要停顿线程,但是耗时很短。而且是借用进行Minor GC的时候同步完成的,所以G1收集器在这个阶段实际并没有额外的停顿。 并发标记(Concurrent Marking):从GC Roots开始对堆的对象进行可达性分析,递归扫描整个堆里的对象图,找出存活的对象,这阶段耗时较长,但是可以与用户程序并发执行。当对象图扫描完成以后,还要重新处理SATB记录下的在并发时有引用变动的对象。 最终标记(Final Marking):对用户线程做另一个短暂的暂停,用于处理并发阶段结束后仍遗留下来的最后那少量的 SATB 记录。 筛选回收(Live Data Counting and Evacuation):负责更新 Region 的统计数据,对各个 Region 的回收价值和成本进行排序,根据用户所期望的停顿时间来制定回收计划。可以自由选择多个Region来构成会收集,然后把回收的那一部分Region中的存活对象==复制==到空的Region中,在对那些Region进行清空。 除了并发标记外,其余过程都要 STW G1和CMS的区别 G1从整体上来看是 标记-整理 算法,但从局部(两个Region之间)是复制算法。而CMS是 标记-清除算法 所以说,G1不会产生内存碎片,而CMS会产生内存碎片 CMS使用了 写后屏障来维护卡表,而G1不仅使用了写后屏障来维护卡表,还是用了 写前屏障来跟踪并发时的指针变化情况(为了实现原始快照)。 CMS对Java堆内存使用的是传统的 新生代和老年代划分方法,而G1使用的全新的划分方法。 CMS收集器只收集老年代,可以配合新生代的Serial和ParNew收集器一起使用。G1收集器收集范围是老年代和新生代。不需要结合其他收集器使用 CMS使用 增量更新解决并发标记下出现的错误标记问题,而G1使用原始快照解决 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

『假如我是面试官』RabbitMQ我会这样问

1. 为什么你们公司选择RabbitMQ作为消息中间件 在消息队列选型时,我们调研了市场上比较常用ActiveMQ,RabbitMQ,RocketMQ,Kafka。 RabbitMQ相对成熟稳定,这是我们选择它最主要的原因。 社区比较活跃,有完善的资料可以参考。 Rabbitmq的吞吐量可以达到万级,完全满足我们系统的要求。 RabbitMQ是Erlang语言开发的,性能比较好。 有完善的可视化界面,方便查看。 2. 消息队列的优点和缺点有哪些 优点有: 异步处理 - 相比于传统的串行、并行方式,提高了系统吞吐量。 应用解耦 - 系统间通过消息通信,不用关心其他系统的处理。 流量削锋 - 可以通过消息队列长度控制请求量;可以缓解短时间内的高并发请求。 缺点有: 系统可用性降低 系统复杂度提高 3. RabbitMQ常用的工作模式有哪些 2.1 简单模型 p:生成者 C:消费者 红色部分:quene,消息队列 2.2 工作模型 这种模式下一条消息只能由一个消费者进行消费,默认情况下,每个消费者是轮询消费的。 p:生成者 C1、C2:消费者 红色部分:quene,消息队列 2.3 发布订阅模型(fanout) 这种模型中生产者发送的消息所有消费者都可以消费。 p:生成者 X:交换机 C1、C2:消费者 红色部分:quene,消息队列 2.4 路由模型(routing) 这种模型消费者发送的消息,不同类型的消息可以由不同的消费者去消费。 p:生成者 X:交换机,接收到生产者的消息后将消息投递给与routing key完全匹配的队列 C1、C2:消费者 红色部分:quene,消息队列 2.5 主题模型(topic) 这种模型和direct模型一样,都是可以根据routing key将消息路由到不同的队列,只不过这种模型可以让队列绑定routing key 的时候使用通配符。这种类型的routing key都是由一个或多个单词组成,多个单词之间用.分割。 通配符介绍: *:只匹配一个单词 #:匹配一个或多个单词 4. 如何保证消息不丢失(如何保证消息的可靠性) 一条消息从生产到消费经历了三个阶段,分别是生产者,MQ和消费者,对于RabbitMQ来说,消息的传递还涉及到交换机。因此RabbitMQ出现消息丢失的情况有四个 分别是 消息生产者没有成功将消息发送到MQ导致消息丢失 交换机未路由到消息队列导致消息丢失 消息在MQ中时,MQ发生宕机导致消息丢失 消费者消费消息时出现异常导致消息丢失 针对上面提到的四种情况,分别进行处理 amqp协议提供了事务机制,在投递消息时开启事务,如果消息投递失败,则回滚事务,很少有人去使用事务。除了事务之外,RabbitMQ还提供了生产者确认机制(publisher confirm)。生产者将信道设置成confirm(确认)模式,一旦信道进入confirm模式,所有在该信道上面发布的消息都会被指派一个唯一的ID(从1开始),一旦消息被投递到所有匹配的队列之后,RabbitMQ就会发送一个确认(Basic.Ack)给生产者(包含消息的唯一ID),这就使得生产者知晓消息已经正确到达了目的地了。 # 开启生产者确认机制, # 注意这里确认的是是否到达交换机 spring.rabbitmq.publisher-confirm-type=correlated @RestController public class Producer { @Autowired private RabbitTemplate rabbitTemplate; @GetMapping("send") public void sendMessage(){ /** * 生产者确认消息 */ rabbitTemplate.setConfirmCallback(new RabbitTemplate.ConfirmCallback() { @Override public void confirm(CorrelationData correlationData, boolean ack, String cause) { System.out.println(correlationData); System.out.println(ack); System.out.println(cause); } }); rabbitTemplate.convertAndSend("s","error","这是一条错误日志!!!"); } } 消息从交换机未能匹配到队列时将此条消息返回给生产者 spring.rabbitmq.publisher-returns=true @RestController public class Producer { @Autowired private RabbitTemplate rabbitTemplate; @GetMapping("send") public void sendMessage(){ /** * 消息未达队列时返回该条消息 */ rabbitTemplate.setReturnsCallback(new RabbitTemplate.ReturnsCallback() { @Override public void returnedMessage(ReturnedMessage returnedMessage) { System.out.println(returnedMessage); } }); rabbitTemplate.convertAndSend("s","error","这是一条错误日志!!!"); } } 消息在交换机或队列中发生丢失,我们只需要将交换机和队列进行持久化。 /** * 定义一个持久化的topic交换机 * durable 持久化 * @return */ @Bean public Exchange exchangeJavatrip(){ return ExchangeBuilder.topicExchange(EXCHANGE).durable(true).build(); } /** * 定义一个持久化的队列 * durable 持久化 * @return */ @Bean public Queue queueJavatrip(){ return QueueBuilder.durable(QUEUE).build(); } 消费者开启手动签收模式,消费完成后进行ack确认。 spring.rabbitmq.listener.simple.acknowledge-mode=manual @RabbitListener(queues = MqConfig.QUEUE) public void receive(String body, Message message, Channel channel) throws Exception{ long deliveryTag = message.getMessageProperties().getDeliveryTag(); System.out.println(deliveryTag); // 系统业务逻辑判断是否签收 if(deliveryTag % 2 == 0){ channel.basicAck(deliveryTag,false); }else{ // 第二个参数是否批量确认,第三个参数是否重新回队列 channel.basicNack(deliveryTag,false,true); } } 5. 如何保证消息不重复消费(如何保证消息的幂等性) 消息重复的原因有两个: 生产时消息重复 由于生产者发送消息给MQ,在MQ确认的时候出现了网络波动,生产者没有收到确认,实际上MQ已经接收到了消息。这时候生产者就会重新发送一遍这条消息。 消费时消息重复。 消费者消费成功后,在给MQ确认的时候出现了网络波动,MQ没有接收到确认,为了保证消息被消费,MQ就会继续给消费者投递之前的消息。这时候消费者就接收到了两条一样的消息。 由于消息重复是网络波动等原因造成的,无法避免,我们能做的的就是保证消息的幂等性,以防业务重复处理。具体处理方案为: 让每个消息携带一个全局的唯一ID,即可保证消息的幂等性,具体消费过程为: 消费者获取到消息后先根据id去查询redis/db是否存在该消息。 如果不存在,则正常消费,消费完毕后写入redis/db。 如果存在,则证明消息被消费过,直接丢弃。 @RabbitListener(queues = MqConfig.QUEUE) public void receive(Message message, Channel channel){ String messageId = message.getMessageProperties().getMessageId(); String body = new String(message.getBody()); String redisId = redisTemplate.opsForValue().get(messageId)+""; // 如果redis中存有当前消息的消息id // 则证明消费过 if(messageId.equals(redisId)){ return; } redisTemplate.opsForValue().set(messageId, UUID.randomUUID()); } 6. 消息大量堆积应该怎么处理 消息堆积的原因有两个 网络故障,消费者无法正常消费 消费方消费后未进行ack确认 解决方案如下: 检查并修复消费者故障,使其正常消费 编写临时程序将堆积的消息发送到容量更大的MQ集群,增加消费者快速消费 堆积消息消费完毕后,停止临时程序,恢复正常消费 7. 死信是什么?死信如何处理 当一条消息在队列中出现以下三种情况的时候,该消息就会变成一条死信。 消息被拒绝(basic.reject / basic.nack),并且requeue = false 消息TTL过期 队列达到最大长度 当消息在一个队列中变成一个死信之后,如果配置了死信队列,它将被重新publish到死信交换机,死信交换机将死信投递到一个队列上,这个队列就是死信队列。 一条消息成为死信后,一般会通过死信队列进行存库,然后定时将库中的死信进行重新投递到消息队列上。 8. 如果我有一笔订单,30分钟未支付则关闭订单,使用RabbitMQ如何来实现 RabbitMQ可以使用死信队列来实现延时消费,用户下单之后,将订单信息投递到消息队列中,并且设置消息过期时常为30分钟。如果用户支付则正常关闭订单,如果用户未支付,消息达到过期时间,消息会进入死信交换,由消费者进行消费死信队列来关闭订单。 9. RabbitMQ如何保证高可用 RabbitMQ有两种集群模式,分别是普通集群和镜像集群,普通模式无法保证RabbitMQ的高可用。 普通集群 假如有三个节点,rabbitmq1、rabbitmq2、rabbitmq3,消息实际上只存在于其中一个节点,三个节点仅有相同的元数据,即队列的结构,当消息进入rabbitmq2节点的queue后,consumer从rabbitmq1的节点进行消费,rabbitmq1和rabbitmq2会进行临时通信,从rabbitmq2中获取消息然后返回给consumer。 这种模式存在以下两个问题: 当rabbitmq2宕机后,消息无法正常消费,没有做到真正的高可用 实际数据还是在单个实例上,存在瓶颈问题 镜像集群 假如有三个节点,rabbitmq1、rabbitmq2、rabbitmq3,每个实例之间都可以相互通信,每次生产者写消息到queue的时候,每个rabbitmq节点上都有queue的消息数据和元数据。这种模式使用于可靠性要求较高的场景。 点关注、不迷路 如果觉得文章不错,欢迎关注、点赞、收藏,你们的支持是我创作的动力,感谢大家。 如果文章写的有问题,请不要吝惜文笔,欢迎留言指出,我会及时核查修改。 如果你还想看到更多别的东西,可以微信搜索「Java旅途」进行关注。回复“手册”领取Java面试手册!


优秀的个人博客,低调大师

面试必问:如何实现Redis分布式锁

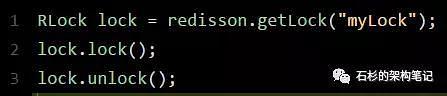
摘要:今天我们来聊聊分布式锁这块知识,具体的来看看Redis分布式锁的实现原理。 一、写在前面 现在面试,一般都会聊聊分布式系统这块的东西。通常面试官都会从服务框架(Spring Cloud、Dubbo)聊起,一路聊到分布式事务、分布式锁、ZooKeeper等知识。 所以咱们这篇文章就来聊聊分布式锁这块知识,具体的来看看Redis分布式锁的实现原理。 说实话,如果在公司里落地生产环境用分布式锁的时候,一定是会用开源类库的,比如Redis分布式锁,一般就是用Redisson框架就好了,非常的简便易用。 大家如果有兴趣,可以去看看Redisson的官网,看看如何在项目中引入Redisson的依赖,然后基于Redis实现分布式锁的加锁与释放锁。 下面给大家看一段简单的使用代码片段,先直观的感受一下: 怎么样,上面那段代码,是不是感觉简单的不行! 此外,人家还支持redis单实例、redis哨兵、redis cluster、redis master-slave等各种部署架构,都可以给你完美实现。 二、Redisson实现Redis分布式锁的底层原理 好的,接下来就通过一张手绘图,给大家说说Redisson这个开源框架对Redis分布式锁的实现原理。 (1)加锁机制 咱们来看上面那张图,现在某个客户端要加锁。如果该客户端面对的是一个redis cluster集群,他首先会根据hash节点选择一台机器。 这里注意,仅仅只是选择一台机器!这点很关键! 紧接着,就会发送一段lua脚本到redis上,那段lua脚本如下所示: 为啥要用lua脚本呢? 因为一大坨复杂的业务逻辑,可以通过封装在lua脚本中发送给redis,保证这段复杂业务逻辑执行的原子性。 那么,这段lua脚本是什么意思呢? KEYS[1]代表的是你加锁的那个key,比如说: RLock lock = redisson.getLock("myLock"); 这里你自己设置了加锁的那个锁key就是“myLock”。 ARGV[1]代表的就是锁key的默认生存时间,默认30秒。 ARGV[2]代表的是加锁的客户端的ID,类似于下面这样: 8743c9c0-0795-4907-87fd-6c719a6b4586:1 给大家解释一下,第一段if判断语句,就是用“exists myLock”命令判断一下,如果你要加锁的那个锁key不存在的话,你就进行加锁。 如何加锁呢?很简单,用下面的命令: hset myLock 8743c9c0-0795-4907-87fd-6c719a6b4586:1 1 通过这个命令设置一个hash数据结构,这行命令执行后,会出现一个类似下面的数据结构: 上述就代表“8743c9c0-0795-4907-87fd-6c719a6b4586:1”这个客户端对“myLock”这个锁key完成了加锁。 接着会执行“pexpire myLock 30000”命令,设置myLock这个锁key的生存时间是30秒。 好了,到此为止,ok,加锁完成了。 (2)锁互斥机制 那么在这个时候,如果客户端2来尝试加锁,执行了同样的一段lua脚本,会咋样呢? 很简单,第一个if判断会执行“exists myLock”,发现myLock这个锁key已经存在了。 接着第二个if判断,判断一下,myLock锁key的hash数据结构中,是否包含客户端2的ID,但是明显不是的,因为那里包含的是客户端1的ID。 所以,客户端2会获取到pttl myLock返回的一个数字,这个数字代表了myLock这个锁key的剩余生存时间。比如还剩15000毫秒的生存时间。 此时客户端2会进入一个while循环,不停的尝试加锁。 (3)watch dog自动延期机制 客户端1加锁的锁key默认生存时间才30秒,如果超过了30秒,客户端1还想一直持有这把锁,怎么办呢? 简单!只要客户端1一旦加锁成功,就会启动一个watch dog看门狗,他是一个后台线程,会每隔10秒检查一下,如果客户端1还持有锁key,那么就会不断的延长锁key的生存时间。 (4)可重入加锁机制 那如果客户端1都已经持有了这把锁了,结果可重入的加锁会怎么样呢? 比如下面这种代码: 这时我们来分析一下上面那段lua脚本。 第一个if判断肯定不成立,“exists myLock”会显示锁key已经存在了。 第二个if判断会成立,因为myLock的hash数据结构中包含的那个ID,就是客户端1的那个ID,也就是“8743c9c0-0795-4907-87fd-6c719a6b4586:1” 此时就会执行可重入加锁的逻辑,他会用: incrby myLock 8743c9c0-0795-4907-87fd-6c71a6b4586:1 1 通过这个命令,对客户端1的加锁次数,累加1。 此时myLock数据结构变为下面这样: 大家看到了吧,那个myLock的hash数据结构中的那个客户端ID,就对应着加锁的次数 (5)释放锁机制 如果执行lock.unlock(),就可以释放分布式锁,此时的业务逻辑也是非常简单的。其实说白了,就是每次都对myLock数据结构中的那个加锁次数减1。 如果发现加锁次数是0了,说明这个客户端已经不再持有锁了,此时就会用:“del myLock”命令,从redis里删除这个key。 然后呢,另外的客户端2就可以尝试完成加锁了。 这就是所谓的分布式锁的开源Redisson框架的实现机制。 一般我们在生产系统中,可以用Redisson框架提供的这个类库来基于redis进行分布式锁的加锁与释放锁。 (6)上述Redis分布式锁的缺点 其实上面那种方案最大的问题,就是如果你对某个redis master实例,写入了myLock这种锁key的value,此时会异步复制给对应的master slave实例。 但是这个过程中一旦发生redis master宕机,主备切换,redis slave变为了redis master。接着就会导致,客户端2来尝试加锁的时候,在新的redis master上完成了加锁,而客户端1也以为自己成功加了锁。 此时就会导致多个客户端对一个分布式锁完成了加锁。这时系统在业务语义上一定会出现问题,导致各种脏数据的产生。 所以这个就是redis cluster,或者是redis master-slave架构的主从异步复制导致的redis分布式锁的最大缺陷:在redis master实例宕机的时候,可能导致多个客户端同时完成加锁。 本文分享自华为云社区《redis分布式锁实现原理学习》,原文作者:minjie 。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册