首页 文章 精选 留言 我的

精选列表

搜索[数据库监控],共10000篇文章
优秀的个人博客,低调大师

Vitals —— GNOME Shell 系统监控扩展

Vitals 是一个 GNOME Shell 扩展,用于在 GNOME Shell 的顶部菜单栏中显示计算机的温度、电压、风扇速度、内存使用情况、处理器负载、系统资源、网络速度和存储统计信息。Vitals 使用异步轮询来提供流畅的用户体验。 安装 1. 安装支持包 Ubuntu / Debian sudo apt install gir1.2-gtop-2.0 lm-sensors Fedora sudo dnf install libgtop2-devel lm_sensors Arch / Manjaro sudo pacman -Syu libgtop lm_sensors gnome-icon-theme-symbolic gnome-icon-theme git 2. 安装扩展 Ubuntu/Debian/Fedora 访问 Gnome Extensions 网站 ,搜索 Vitals 并单击 switch 图标 Arch/ Manjaro git clone https://aur.archlinux.org/gnome-shell-extension-vitals-git.git/ cd gnome-shell-extension-vitals-git # always verify content before installing less PKGBUILD makepkg # example filename, different each release pacman -U gnome-shell-extension-vitals-git-v52.0.4.r0.gb446cfc-1-any.pkg.tar.zst

优秀的个人博客,低调大师

开源日志监控平台 0.6.2 发布

### Feature * 移除spi模块,相关功能移至monitor [2022-04-05] * 微信机器人、钉钉机器人和http报警消息格式支持markdown * 增加用户密码设置功能,方便没有部署ldap的团队使用。配置了ldap的将优先使用ldap认证。 * 移除xxl-job依赖,内置实现分布式调度,减小部署难度 * elasticsearch数据源https支持pkcs12证书 * 数据预览前端增加参数校验提示 * 数据源增加Elasticsearch8支持 * [0.6.2] Elasticsearch数据配置支持数据分桶,分桶类型支持:1. 按字段值分组,相当于ES里的Terms Aggregation. * [0.6.2] Elasticsearch数据配置支持数据分桶,分桶类型支持:2. 按时间分组,相当于ES里的DateHistogramAggregation. ### Bugfix * 解决查询elasticsearch索引字段查询报错的问题 [2022-04-27] ### Document * 增加0.5升级0.6的说明文档 * 增加markdown格式消息使用文档说明 * 增加0.6升级0.6.1的说明文档 * 增加k8s环境部署说明 * 增加项目代码规范说明文档 ### Others * 优化frostmourne-vue模块,支持较新版本node和npm支持; 引入frontend-maven-plugin插件,打包自动管理node和yarn使用特定版本

优秀的个人博客,低调大师

Prometheus监控神器-Kubernetes篇(三)

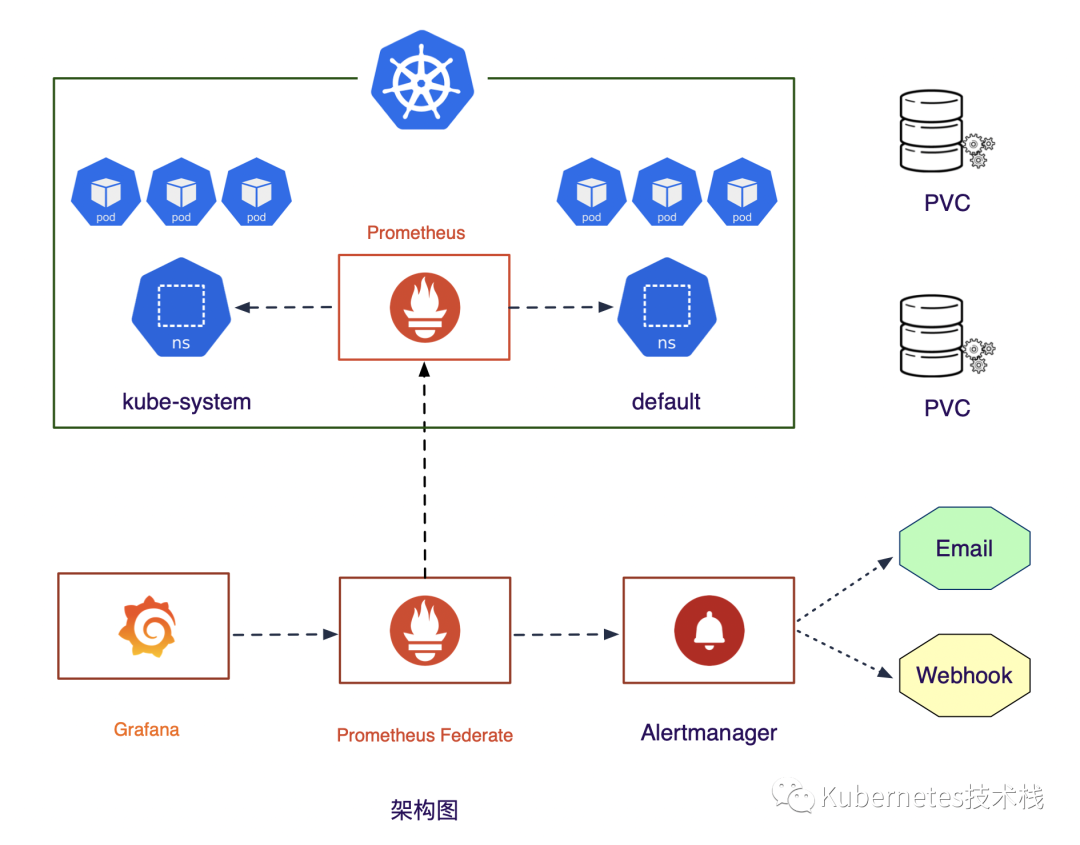
在Kubernetes中手动方式部署Prometheus联邦. monitor-prom 当我们有多个Kubernetes集群的时候,这个时候就需要需要指标汇总的需求了,如上图一样,我们假定在外部部署一个Prometheus的Federate,然后去采集当前k8s中的kube-system与default俩个 namespace。 环境 我的本地环境使用的 sealos 一键部署,主要是为了便于测试。 OS Kubernetes HostName IP Service Ubuntu 18.04 1.17.7 sealos-k8s-m1 192.168.1.151 node-exporter prometheus-federate-0 Ubuntu 18.04 1.17.7 sealos-k8s-m2 192.168.1.152 node-exporter grafana alertmanager-0 Ubuntu 18.04 1.17.7 sealos-k8s-m3 192.168.1.150 node-exporter alertmanager-1 Ubuntu 18.04 1.17.7 sealos-k8s-node1 192.168.1.153 node-exporter prometheus-0 kube-state-metrics Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.154 node-exporter prometheus-1 Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.155 node-exporter prometheus-2 部署 Prometheus联邦集群 创建prometheus-federate数据目录 #在m1上执行mkdir/data/prometheus-federate/chown-R65534:65534/data/prometheus-federate/ 创建Prometheus联邦 StorageClass 配置文件 cd/data/manual-deploy/prometheus/catprometheus-federate-storageclass.yamlapiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:prometheus-federate-lpvprovisioner:kubernetes.io/no-provisionervolumeBindingMode:WaitForFirstConsumer 创建Prometheus联邦pv配置文件 apiVersion:v1kind:PersistentVolumemetadata:name:prometheus-federate-lpv-0spec:capacity:storage:10GivolumeMode:FilesystemaccessModes:-ReadWriteOncepersistentVolumeReclaimPolicy:RetainstorageClassName:prometheus-federate-lpvlocal:path:/data/prometheus-federatenodeAffinity:required:nodeSelectorTerms:-matchExpressions:-key:kubernetes.io/hostnameoperator:Invalues:-sealos-k8s-m1 创建Prometheus联邦configmap配置文件 catprometheus-federate-configmap.yamlapiVersion:v1kind:ConfigMapmetadata:name:prometheus-federate-confignamespace:kube-systemdata:alertmanager_rules.yaml:|groups:-name:examplerules:-alert:InstanceDownexpr:up==0for:1mlabels:severity:pageannotations:summary:"Instance{{$labels.instance}}down"description:"{{$labels.instance}}ofjob{{$labels.job}}hasbeendownformorethan1minutes."-alert:NodeMemoryUsageexpr:(node_memory_MemTotal_bytes-(node_memory_MemFree_bytes+node_memory_Buffers_bytes+node_memory_Cached_bytes))/node_memory_MemTotal_bytes*100>80for:1mlabels:team:opsannotations:summary:"cluster:{{$labels.cluster}}{{$labels.instance}}:HighMemoryusagedetected"description:"{{$labels.instance}}:Memoryusageisabove55%(currentvalueis:{{$value}}"prometheus.yml:|global:scrape_interval:30sevaluation_interval:30salerting:alertmanagers:-static_configs:-targets:-alertmanager-0.alertmanager-operated:9093-alertmanager-1.alertmanager-operated:9093rule_files:-"/etc/prometheus/alertmanager_rules.yaml"scrape_configs:-job_name:'federate'scrape_interval:30shonor_labels:truemetrics_path:'/federate'params:'match[]':-'{job=~"kubernetes.*"}'-'{job="prometheus"}'static_configs:-targets:-'prometheus-0.prometheus:9090'-'prometheus-1.prometheus:9090'-'prometheus-2.prometheus:9090' 创建Prometheus联邦的statefulse文件 catprometheus-federate-statefulset.yamlapiVersion:apps/v1kind:StatefulSetmetadata:name:prometheus-federatenamespace:kube-systemlabels:k8s-app:prometheus-federatekubernetes.io/cluster-service:"true"spec:serviceName:"prometheus-federate"podManagementPolicy:"Parallel"replicas:1selector:matchLabels:k8s-app:prometheus-federatetemplate:metadata:labels:k8s-app:prometheus-federateannotations:scheduler.alpha.kubernetes.io/critical-pod:''spec:affinity:podAntiAffinity:requiredDuringSchedulingIgnoredDuringExecution:-labelSelector:matchExpressions:-key:k8s-appoperator:Invalues:-prometheus-federatetopologyKey:"kubernetes.io/hostname"priorityClassName:system-cluster-criticalhostNetwork:truednsPolicy:ClusterFirstWithHostNetcontainers:-name:prometheus-federate-configmap-reloadimage:"jimmidyson/configmap-reload:v0.4.0"imagePullPolicy:"IfNotPresent"args:---volume-dir=/etc/config---webhook-url=http://localhost:9091/-/reloadvolumeMounts:-name:config-volumemountPath:/etc/configreadOnly:trueresources:limits:cpu:10mmemory:10Mirequests:cpu:10mmemory:10MisecurityContext:runAsUser:0privileged:true-image:prom/prometheus:v2.20.0imagePullPolicy:IfNotPresentname:prometheuscommand:-"/bin/prometheus"args:-"--web.listen-address=0.0.0.0:9091"-"--config.file=/etc/prometheus/prometheus.yml"-"--storage.tsdb.path=/prometheus"-"--storage.tsdb.retention=24h"-"--web.console.libraries=/etc/prometheus/console_libraries"-"--web.console.templates=/etc/prometheus/consoles"-"--web.enable-lifecycle"ports:-containerPort:9091protocol:TCPvolumeMounts:-mountPath:"/prometheus"name:prometheus-federate-data-mountPath:"/etc/prometheus"name:config-volumereadinessProbe:httpGet:path:/-/readyport:9091initialDelaySeconds:30timeoutSeconds:30livenessProbe:httpGet:path:/-/healthyport:9091initialDelaySeconds:30timeoutSeconds:30resources:requests:cpu:100mmemory:100Milimits:cpu:1000mmemory:2500MisecurityContext:runAsUser:0privileged:trueserviceAccountName:prometheusvolumes:-name:config-volumeconfigMap:name:prometheus-federate-configvolumeClaimTemplates:-metadata:name:prometheus-federate-dataspec:accessModes:["ReadWriteOnce"]storageClassName:"prometheus-federate-lpv"resources:requests:storage:5Gi 创建Prometheus联邦的svc文件 catprometheus-service-statefulset.yamlapiVersion:v1kind:Servicemetadata:name:prometheusnamespace:kube-systemspec:ports:-name:prometheusport:9090targetPort:9090selector:k8s-app:prometheusclusterIP:None 部署 cd/data/manual-deploy/prometheus/prometheus-federate-configmap.yamlprometheus-federate-pv.yamlprometheus-federate-service-statefulset.yamlprometheus-federate-statefulset.yamlprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-pv.yamlkubectlapply-fprometheus-federate-configmap.yamlkubectlapply-fprometheus-federate-statefulset.yamlkubectlapply-fprometheus-federate-service-statefulset.yaml 验证 #pvkubectl-nkube-systemgetpvc|grepfederateprometheus-federate-data-prometheus-federate-0Boundprometheus-federate-lpv-010GiRWOprometheus-federate-lpv4hkubectl-nkube-systemgetpod|grepfederateprometheus-federate-02/2Running02d4h 对此,联邦的配置就完成了,可以在浏览器中访问192.168.1.151:9091查看相应的targets信息,以及配置的rules规则,触发下警报,看看Alertmanager集群已经部署成功了。 k8s-federate 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Prometheus监控神器-Alertmanager篇(四)

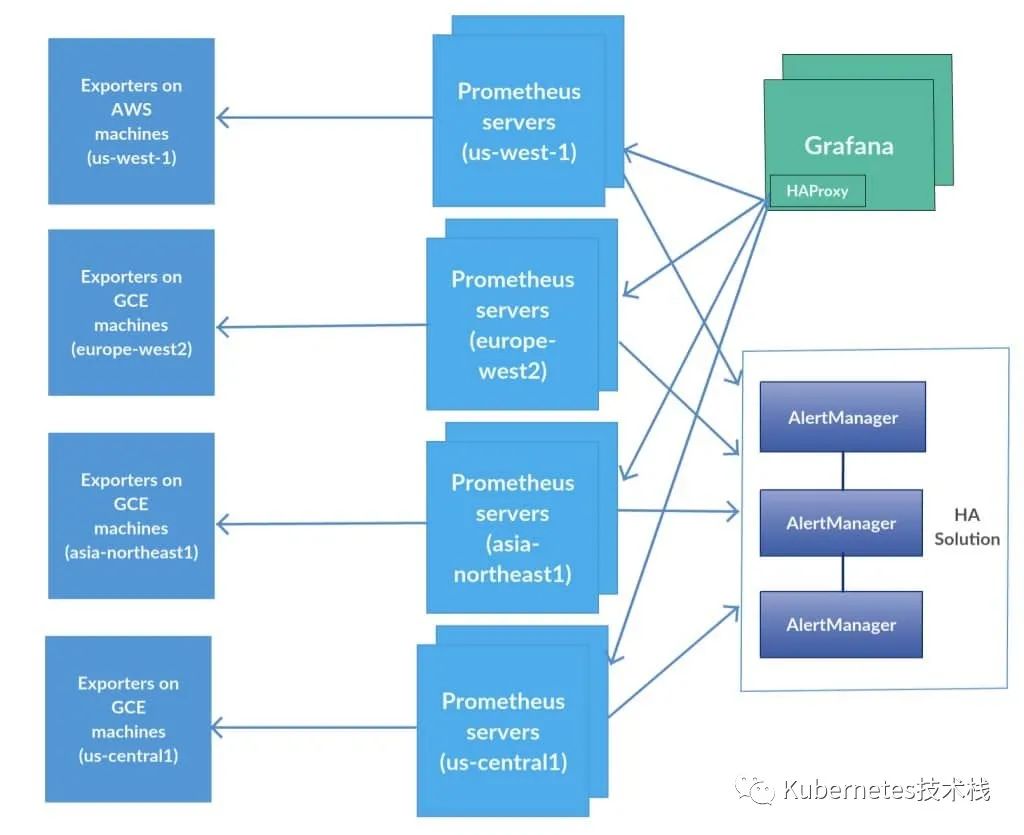
本章节主要讲解Alertmanager高可用的搭建与配置的详细的内容。 为了提升Prometheus的服务可靠性,我们会部署两个或多个的Prometheus服务,两个Prometheus具有相同的配置(Job配、告警规则、等),当其中一个Down掉了以后,可以保证Prometheus持续可用。 AlertManager自带警报分组机制,即使不同的Prometheus分别发送相同的警报给Alertmanager,Alertmanager也会自动把这些警报合并处理。 去重 分组 路由 Daduplicates Groups Route 将相同的警报合并成一个 根据定义的分组 经过路由分发给指定的receiver 虽然Alertmanager 能够同时处理多个相同的Prometheus的产生的警报,如果部署的Alertmanager是单节点,那就存在明显的的单点故障风险,当Alertmanager节点down机以后,警报功能则不可用。 解决这个问题的方法就是使用传统的HA架构模式,部署Alertmanager多节点。但是由于Alertmanager之间关联存在不能满足HA的需求,因此会导致警报通知被Alertmanager重复发送多次的问题。 alertmanager-ha Alertmanager为了解决这个问题,引入了Gossip机制,为多个Alertmanager之间提供信息传递机制。确保及时的在多个Alertmanager分别接受到相同的警报信息的情况下,不会发送重复的警报信息给Receiver. Gossip 机制 要知道什么是Gossip机制,必须了解清楚Alertmanager中的每一次警报通知是如何产生的,下面一图很详细的阐述了警报个流程: alertmanager-ha 阶段 描述 Silence 在这个阶段中Alertmanager会判断当前通知是否匹配任何静默规则;如果没有则进入下一个阶段,否则会中断流程不发送通知。 Wait Alertmanager 会根据当前集群中所处在的顺序[index],等待 index * 5s 的时间。 Dedup 当等待结束完成,进入 Dedup 阶段,这时会判断当前Alertmanager TSDB中警报是否已经发送,如果发送则中断流程,不发送警报。 Send 如果上面的未发送,则进入 Send 阶段,发送警报通知。 Gossip 警报发送成功以后,进入最后一个阶段 Gossip ,通知其他Alertmanager节点,当前警报已经发送成功。其他Alertmanager节点会保存当前已经发送过的警报记录。 Gossip俩个关键: Alertmanager 节点之间的Silence设置相同,这样确保了设置为静默的警报都不会对外发送 Alertmanager 节点之间通过Gossip机制同步警报通知状态,并且在流程中标记Wait阶段,保证警报是依次被集群中的Alertmanager节点读取并处理。 搭建本地 Alertmanager 集群 启动Alertmanager集群之前,需要了解一些集群相关的参数 参数 说明 --cluster.listen-address="0.0.0.0:9094" 集群服务监听端口 --cluster.peer 初始化关联其他节点的监听地址 --cluster.advertise-address 广播地址 --cluster.gossip-interval 集群消息传播时间,默认 200s --cluster.probe-interval 各个节点的探测时间间隔 # 直接复制之前已经安装过的Alertmanager文件夹cp -r alertmanager/ /usr/local/alertmanager01cp -r alertmanager/ /usr/local/alertmanager02cp -r alertmanager/ /usr/local/alertmanager03# 复制完成以后,写入启动脚本,# Alertmanager01cat << EOF> /lib/systemd/system/alertmanager01.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager01/bin/alertmanager \--config.file=/usr/local/alertmanager01/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager01/data \--web.listen-address=":19093" \--cluster.listen-address=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager02cat << EOF> /lib/systemd/system/alertmanager02.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager02/bin/alertmanager \--config.file=/usr/local/alertmanager02/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager02/data \--web.listen-address=":29093" \--cluster.listen-address=192.168.1.220:29094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager03cat <<EOF > /lib/systemd/system/alertmanager03.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager03/bin/alertmanager \--config.file=/usr/local/alertmanager03/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager03/data \--web.listen-address=":39093" \--cluster.listen-address=192.168.1.220:39094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# 开启systemd脚本启动systemctl enable alertmanager01 alertmanager02 alertmanager03systemctl start alertmanager01 alertmanager02 alertmanager03 启动完成后,就可以访问http://192.168.1.220:19093可以看到以下集群状态了,我这里是为了测试,本地启动了多个端口,如果是实际生产环境中,是不同节点以及不同的IP,这些根据自己的需求设计即可。 alert-gossip Prometheus中的配置: alerting: alert_relabel_configs: - source_labels: [dc] regex: (.+)\d+ target_label: dc alertmanagers: - static_configs: #- targets: ['127.0.0.1:9093'] - targets: ['192.168.1.220:19093','192.168.1.220:29093','192.168.1.220:39093'] 配置完成以后,重启或者reloadPrometheus服务,访问http://192.168.1.220:19090/config就可以看到具体的配置信息了。 prom-config 到此,Alertmanager集群配置就完成了,对于进群中的警报测试很简单,直接down掉一个端口,然后触发警报,看看警报是否可以正常发送。 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册