首页 文章 精选 留言 我的

精选列表

搜索[思考控制],共10000篇文章
优秀的个人博客,低调大师

对deepseek harness初步使用洞察与深度思考

DeepSeek Harness 以“一切皆插件”的单容器架构,实现了 AI agent 能力的极致可组合与可定制。初步使用可见其模型无关、工具插件化、配置驱动等优势,但也暴露出记忆机制薄弱、多租户隔离缺失、核心服务层空白等关键短板。类比安卓发展史,DSH 若仅停留在开放插件生态,将难免碎片化与体验割裂;唯有在开放内核之上构建统一记忆、身份、消息总线等“GMS 式”服务层,才能在自由与秩序间取得平衡,从技术极客的玩具进化为可商业化的智能体基础设施。其命运不取决于代码优雅,而取决于能否在开放中定义边界。

优秀的个人博客,低调大师

一个索引创建错误引发的思考

MySQL 创建索引的操作提示失败,这是什么原因导致的?字段类型和索引创建之间有什么关系? 作者:刘晨,网名 bisal ,具有十年以上的应用运维工作经验,目前主要从事数据库应用研发能力提升和技术管理相关的工作,公众号”bisal的个人杂货铺”。 爱可生开源社区出品,原创内容未经授权不得随意使用,转载请联系小编并注明来源。 本文约 800 字,预计阅读需要 3 分钟。 背景 同事反馈说某个 MySQL 数据库创建索引提示错误,模拟报错如下: CREATE INDEX t_reg_code_idx USING BTREE ON t(reg_code) BLOB/TEXT column 'reg_code' used in key specification without a key length 从该提示可知,给 T 表的 reg_code 列创建一个 BTREE 索引,而这个 reg_code 列的字段类型是 BLOB 或 TEXT。 需要在键的说明中有长度定义,这是什么意思? 表索引前缀长度限制 MySQL 8.0 从 MySQL 8.0 的官方手册可以找到这段对 Index Prefixes 的说明。意思是如果对 BLOB 或者 TEXT 列创建索引,必须指定索引的前缀长度。对于使用 REDUNDANT 或者 COMPACT 行格式的 InnoDB 表,索引前缀最多 767 个字节,对于使用 DYNAMIC 或者 COMPRESSED 行格式的 InnoDB 表,索引前缀的上限最多是 3072 个字节,如果是 MyISAM 表,前缀长度最多可以达到 1000 个字节。 MySQL 5.7 而 MySQL 5.7 官方手册中,对索引前缀的限制有所不同,InnoDB 表的索引前缀最多可以达到 1000 个字节(此处我认为是错误的,应该是 3072),但前提是设置了 innodb_large_prefix(只对 DYNAMIC 或者 COMPRESSED 行格式生效,对 REDUNDANT 或者 COMPACT 行格式无效),否则只能达到 767 个字节。 因此可知,MySQL 8.0 在 InnoDB 表的索引前缀长度限制的设置上有所调整,但是限制还是有,这是和 Oracle 等数据库有所不同的一个特性。 验证 通过实验,验证 MySQL 8.0 对于前缀长度的限制。 创建一张 row format 是 COMPACT 的 InnoDB 表,指定前缀长度 10000,提示最大键的长度只能是 767 个字节。 create table test01 ( id int(30) not null auto_increment, t_a text, primary key(id), index idx_t_a(t_a(10000)) ) COLLATE='gbk_chinese_ci' ENGINE=InnoDB ROW_FORMAT=COMPACT; SQL 错误 [1071] [42000]: Specified key was too long; max key length is 767 bytes 创建一张 row format 是 COMPRESSED 的 InnoDB 表,指定前缀长度 10000,提示最大键的长度只能是 3072 个字节。 create table test01 ( id int(30) not null auto_increment, t_a text, primary key(id), index idx_t_a(t_a(10000)) ) COLLATE='gbk_chinese_ci' ENGINE=InnoDB ROW_FORMAT=COMPRESSED; SQL 错误 [1071] [42000]: Specified key was too long; max key length is 3072 bytes 总结 抛开技术问题,和同事追问了下这个操作的背景。原始需求是某个厂商的 ETL 任务需要从源库将数据导入目标库,源库字段是 VARCHAR 类型,目标库定义为 TEXT,才间接引起的这个问题。推测一种可能的原因,因为 VARCHAR、TEXT 都可以存储字符串类型的数据,所以没做区分,另一种可能,为了图省事儿,不用关注源库和目标库字符串类型定义的长度,直接设置了 TEXT 类型,保证肯定能存下。 无论是何种原因,TEXT 这种大字段类型,一般不推荐作为索引检索字段,因为往往它存储了很多字符,索引存储空间会占用更多,索引的区分度也会有影响。 因此,虽然这个问题表象是个技术问题,但实际上来源于不合理的设计,我们在进行应用设计、数据库设计时,如果能多考虑一些合理性,避免一些所谓的省事儿,可能在实际使用过程中,就会更顺畅,相辅相成的。 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE 爱可生开源社区的 SQLE 是一款面向数据库使用者和管理者,支持多场景审核,支持标准化上线流程,原生支持 MySQL 审核且数据库类型可扩展的 SQL 审核工具。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

优秀的个人博客,低调大师

一次网络不通“争吵”引发的思考

为啥争吵,吵什么? "你到底在说什么啊,我K8s的ecs节点要访问clb的地址不通和本地网卡有什么关系..." 气愤语气都从电话那头传了过来,这时电话两端都沉默了。过了好一会传来地铁小姐姐甜美的播报声打断了刚刚的沉寂「乘坐地铁必须全程佩戴口罩,下一站西湖文化广场...」。 pod需要访问clb的443的监听, 但是如果是集群内(集群内后面都指的K8s的节点或者POD)访问就会出现如下报错Connection refused: 所以就捋了一下客户链路如下: 具体现象是什么 无论是节点node还是pod里访问192.168.1.200:443都是不通的,但是访问192.168.1.200:80却是正常的。同时集群外的ECS192.168.3.100访问192.168.1.200:443和192.168.1.200:80都是正常的。 进一步分析看看 CLB1的IP192.168.1.200被绑定到了K8s的node节点的kube-ipvs0网卡上,这个是一张dummy 网卡,参考dummy interface。由于 SVC1 是LoadBalancer类型的,同时复用了这个CLB1,关联endpoint是POD1192.168.1.101:80,那么就可以解释为何访问192.168.1.200:80是正常,是由于kube-proxy根据SVC1的配置创建ipvs规则同时挂载了可被访问的后端服务。而集群里访问192.168.1.200:443都是不通的,因为IP被绑定到dummy网卡后,就不会再出节点去访问到CLB1,同时没有443对应ipvs规则,所以直接是拒绝的。 这个时候如果节点里没有ipvs规则(ipvs优先于监听)但是又能访问通的话, 可以检查一下是否本地有监听0.0.0.0:443的服务,那么这个时候所有网卡IP+443都能通,但是访问的是本地服务,而不是真正的CLB后端的服务。 是否有办法解决呢 最建议的方式 最好的方式拆分, 集群内和集群外的服务分开两个CLB使用。 阿里云svc注解的方式 SVC1使用这个注解http://service.beta.kubernetes.io/alibaba-cloud-loadbalancer-hostname,进行占位,这样就不会绑定CLB的IP到kube-ipvs0的网卡上,集群内访问CLB的IP就会出集群访问CLB,但是需要注意如果监听协议为TCP或UDP,集群内访问CLB IP时将会存在回环访问问题。详细信息,请参见客户端无法访问负载均衡CLB[1]。 需要CCM版本在 v2.3.0及以上版本才支持这个注解, 具体参考:通过Annotation配置传统型负载均衡CLB [2] demo: apiVersion: v1 kind: Service metadata: annotations: service.beta.kubernetes.io/alibaba-cloud-loadbalancer-hostname: "${your_service_hostname}" name: nginx-svc namespace: default spec: ports: - name: http port: 80 protocol: TCP targetPort: 80 selector: app: nginx type: LoadBalancer 集群内访问 ExternalTrafficPolicy 策略有影响吗? 我们都知道K8s的nodeport和loadbalancer模式是可以调整外部流量策略的,那么图中的「外部策略为Local/Cluster,所有集群节点创建IPVS规则是有区别的」该如何解释呢, 以及集群内访问nodePort/CLBIP的时候会发生什么。 以下都是针对svc的internalTrafficPolicy都是Cluster或者缺省的情况,这个ServiceInternalTrafficPolicy特性在1.22的K8s中默认开启,具体参考service-traffic-policy [3] 此处我们只讨论ipvs TrafficPolicy Local在Kubernetes 从1.22升级到1.24的行为变化。 Kubernetes 1.24 IPVS的变化 以下均以kube-proxy的IPVS模式为例: 当externalTrafficPolicy为Cluster模式或缺省的时候,ipvs规则里的nodePort/CLBIP后端会挂载所有的Endpoint的IP,这时候集群内访问会丢失源IP,因为节点会做一层SNAT。 当externalTrafficPolicy是Local的时候 当节点上有对应service的Endpoint的时候,ipvs规则里的nodePort/CLBIP后端只挂载自己节点的Endpoint的IP,集群内访问会保留源IP。 当节点上没有对应service的Endpoint的时候 在1.24之前的版本是会挂空的后端的,集群内访问会拒绝。 在1.24之后的K8s集群里,当节点上没有对应service的Endpoint的时候,ipvs规则里的nodePort/CLB IP后端会挂载所有的Endpoint的IP,这时候集群内访问会丢失源IP,因为节点会做一层SNAT。社区调整了Local策略后端服务的规则挂载策略,具体参考社区PR[4]。 https://github.com/kubernetes/kubernetes/pull/97081/commits/61085a75899a820b5eebfa71801e17423c1ca4da 集群外访问SLB 集群外访问SLB的话,CCM只会挂载Local类型的节点,情况跟1.24 kubernetes前一样,这里不做过多阐述,请见上面连接。 集群外访问NodePort 1.24 Kubernetes之前版本 访问有Endpoint的节点的NodePort,可以通,可以保留源IP Nginx分布在cn-hongkong.10.0.4.174和cn-hongkong.10.0.2.84节点。 从外部10.0.3.72节点访问有后端pod所在节点的cn-hongkong.10.0.2.84的30479端口,可以访问。 cn-hongkong.10.0.0.140节点上是有相关的IPVS的规则的,但是只有该节点上后端Pod IP。 通过conntrack表可以到,这是由于在cn-hongkong.10.0.0.140节点上,相关的链路被dnat,最后是由pod cn-hongkong.10.0.2.84节点上的 的nginx-7d6877d777-tzbf7 10.0.2.87返回源,所有的相关转化都在该节点上,所以TCP四层建连可以成功。 访问没有Endpoint的节点的NodePort,不能通,因为节点上没有相关的ipvs转发规则 从外部10.0.3.72节点访问无后端pod所在节点的cn-hongkong.10.0.0.140的30479端口,不可以访问。 查看该cn-hongkong.10.0.0.140节点,并没有相关的ipvs转发规则,所以无法进行dnat,访问会失败。 1.24 Kubernetes版本之后(含) 访问有Endpoint节点的NodePort,可以通,可以保留源IP 访问没有Endpoint节点的NodePort: terway ENIIP or host网络:不通 Nginx分布在cn-hongkong.10.0.2.77和cn-hongkong.10.0.0.171 节点。 从外部10.0.3.72节点访问无后端pod所在节点的cn-hongkong.10.0.5.168的30745端口,可以看到,访问失败。 cn-hongkong.10.0.5.168节点上是有相关的IPVS的规则的,并且会把所有的后端Pod IP加到IPVS规则中。 通过conntrack表可以到,这是由于在cn-hongkong.10.0.5.168节点上,相关的链路被dnat,最后是由pod cn-hongkong.10.0.2.77节点上的nginx-79fc6bc6d-8vctc 10.0.2.78返回源,源在接受这个链路后,会发现和自己的五元组不匹配,直接丢弃,三次握手必然失败,所以建连失败。 flannel网络:可以通,但是保留不了源IP Nginx分布在cn-hongkong.10.0.2.86。 从外部访问cn-hongkong.10.0.4.176的31218端口,可以访问成功。 cn-hongkong.10.0.4.176记录了src是10.0.3.72,并做了dnat为172.16.160.135,期望它返回给10.0.4.176的58825端口。 后端ep所在节点cn-hongkong.10.0.2.86,conntrack表记录了src是10.0.4.176,sport是58825。所以可以看到应用pod是记录的源IP是10.0.4.176,丢失了源IP。 集群内访问SLB或者NodePort 1.24 Kubernetes之前版本 有Endpoint的节点上访问,可以通,可以保留源IP Nginx分布在ap-southeast-1.192.168.100.209和ap-southeast-1.192.168.100.208节点,ap-southeast-1.192.168.100.210节点没有Nginx pod。 从集群任意节点(本例就在209节点)访问有后端pod所在节点的ap-southeast-1.192.168.100.209的NodePort 31565端口,可以访问。 从有后端pod所在节点ap-southeast-1.192.168.100.209访问SLB 8.222.252.252 的80端口,可以访问。 ap-southeast-1.192.168.100.209节点上是有NodePort 和SLB 的IPVS的规则的,但是只有该节点上后端Pod IP。 通过conntrack表可以到,这是由于在ap-southeast-1.192.168.100.209 节点上,相关的链路被dnat,最后是由pod 在ap-southeast-1.192.168.100.209 节点上的 的nginx-7d6877d777-2wh4s 192.168.100.222返回源,所有的相关转化都在该节点上,所以TCP四层建连可以成功。 没有Endpoint的节点上访问,不能通,因为节点上没有相关的ipvs转发规则 从集群任意节点(本例就在210节点)访问没有后端pod所在节点的ap-southeast-1.192.168.100.210 的NodePort 31565端口或者SLB,不可以访问。 也进一步证实,集群内访问关联svc的SLB不出节点,即使SLB有其他监听端口,访问SLB其他端口也会拒绝。 查看该ap-southeast-1.192.168.100.210 节点,并没有相关的ipvs转发规则,所以无法进行dnat,访问会失败。 1.24 Kubernetes版本之后(含) 有Endpoint节点上访问,可以通,可以保留源IP 与上文的1.24 Kubernetes之前版本集群内访问一致,可以参考上文描述。 没有Endpoint节点上访问: Nginx分布在cn-hongkong.10.0.2.77和cn-hongkong.10.0.0.171节点,所以在没有Nginx的cn-hongkong.10.0.4.141节点上测试。 分别有以下几种情况: terway或后端为hostNetwork 节点访问的通 NodePort(源 IP 是 ECS IP,不需要做 SNAT),无法保留源IP 可以看到没有Endpoint的节点的NodePort 110.0.4.141:30745 的IPVS 的规则添加的Nginx的所有后端POD nginx-79fc6bc6d-8vctc 10.0.2.78 和 nginx-79fc6bc6d-j587w 10.0.0.172。 集群内节点自身访问没有后端pod所在节点的cn-hongkong.10.0.4.141 的NodePort 30745/TCP端口,可以访问。 通过conntrack表可以到,在cn-hongkong.10.0.4.141节点上,相关的链路被dnat,最后是由后盾Nginx pod nginx-79fc6bc6d-8vctc 10.0.2.78返回源。 而在nginx-79fc6bc6d-8vctc 10.0.2.78 所在的节点cn-hongkong.10.0.2.77上的conntrack表记录的是10.04.141访问10.0.2.78,并期望10.0.2.78直接返回10.0.4.141的的39530端口。 集群内有endpoint 节点访问没有后端pod所在节点的ap-southeast-1.192.168.100.131 的NodePort 32292端口,不可以访问,与上文1.24 Kubernetes版本之后(含) 集群外访问一致,可以参考上文描述。 节点访问不通 SLB IP(源 IP 是 SLB IP,没有人做 SNAT) 可以看到没有Endpoint的节点的SLB IP 的IPVS 的规则添加的Nginx的所有后端POD nginx-79fc6bc6d-8vctc 10.0.2.78 和 nginx-79fc6bc6d-j587w 10.0.0.172。 没有Endpoint的节点上访问 SLB 47.243.247.219,访问确是超时。 通过conntrack表可以到,在没有ep的节点访问SLB的IP,可以看到期望的是后端pod返回给SLB IP。而SLB IP 在节点上已经被kube-ipvs虚拟占位了,所以没有做snat,造成无法访问。 flannel并且后端为普通pod,可以访问通,但是保留不了源IP Nginx分布在cn-hongkong.10.0.2.86。 在cn-hongkong.10.0.4.176访问SLB 47.242.86.39 是可以访问成功的。 cn-hongkong.10.0.4.176节点的conntrack表可以看到是src和dst都是47.242.86.39,但是期望的是 nginx pod172.16.160.135 返回给 10.0.4.176 的54988端口,47.242.86.39 snat成10.0.4.176。 后端ep所在节点cn-hongkong.10.0.2.86,conntrack表记录了src是10.0.4.176,sport是54988。所以可以看到应用pod是记录的源IP是10.0.4.176,丢失了源IP。 相关链接: [1] 客户端无法访问负载均衡CLB https://help.aliyun.com/document_detail/55206.htm [2] 通过Annotation配置传统型负载均衡CLB https://www.yuque.com/r/goto?url=https%3A%2F%2Fhelp.aliyun.com%2Fzh%2Fack%2Fack-managed-and-ack-dedicated%2Fuser-guide%2Fadd-annotations-to-the-yaml-file-of-a-service-to-configure-clb-instances [3] service-traffic-policy https://kubernetes.io/zh-cn/docs/concepts/services-networking/service-traffic-policy/ [4] 社区PR https://github.com/kubernetes/kubernetes/pull/97081/commits/61085a75899a820b5eebfa71801e17423c1ca4da 作者: 郑明泉、余凯 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载

优秀的个人博客,低调大师

关于自动限流的思考 | 京东云技术团队

目标 保证系统不因流量过载而挂。 现状:人工限流 正常的微服务限流工具都需要人工配置:支持应用负责人事先配置限流规则(接口+调用方+限流阈值),流量在阈值以下可以正常响应,超过阈值的流量会快速失败。这种方案存在如下问题: 问题1. 接口多,无法全面覆盖 要想保证系统不因流量过载而挂,那就需要对所有中高频接口进行流量管控,不然任意接口的流量上升都可能成为“压倒骆驼的最后一根稻草”。假设存在a个应用,按每个应用平均b个中高频接口, 每个接口对应c个调用方,限流规则配置那数量为(axbxc),稍微有点规模的部门这个数量就能上万, 要想全面覆盖靠人工基本不可行。 问题2.限流阈值无法准确评估 当前限流阈值评估主要有2类: 历史流量峰值:比如近7天系统正常提供服务的流量峰值。但是这个值偏低,容易产生误杀。 压测:通过压测演练得出接口的容量上限。但是压测的方式很难模拟真实的线上环境,无论是数据质量,流量的参数质量,依赖方的性能,亦或同应用内不同接口的流量分布都很难与真实环境保持一致。 问题3. 限流阈值无法长期有效 限流阈值会随着环境的变化而变化。例如流程中新增了一个依赖、或者数据库的数据量增多、热点数据增多、其他接口流量上升占用了更多系统资源、底层的基础设施发生变化等都会导致真实容量降低,限流阈值失效。在这种情况下,持续评估阈值来匹配系统的最新状态根本无法通过人工进行保证。 解决方案:自动限流 针对如上问题解法如下: 问题1. 接口多,无法全面覆盖 解:系统自动配置 问题2.限流阈值无法准确评估 解:系统自动评估 问题3. 限流阈值无法长期有效 解:系统动态调整 具体方案如下: 系统资源到达使用率到达预警线的时候, 系统自动触发系统进行全面限流, 各接口的限流值根据应用当前的流量状态以及历史的流量状态而定。 什么时候限流:应用的容量取决于系统的资源瓶颈,当资源的使用率到达某一水平的时候才需要限流。资源包括数据库、缓存、应用服务器等。 谁来限:系统自动 限哪些接口:由于同一个应用不同接口都共享了数据库、缓存等、应用服务器等资源,接口之间的容量会相互影响,所以需要全部接口都限制才能保证资源的使用率不再上升。 各接口限多少?在资源使用率到达瓶颈的时候,所有的接口性能都会下降,对应的限流阈值也应该下调。具体的限流计算有两种方式: 可以把系统在当前状态下各接口能够正常完成的请求量作为限流的参考值,来保证资源利用率不在上升。比如接口A接受到的请求速率为100,其中50排队,20报错,30正常完成,那么该接口限流值可以参考30(为排除正常抖动,具体的值可以通过滑动窗口进行平滑)。 可以把上一同比周期的同时间(比如昨天的同一时间)的各接口的请求量作为限流的参考值。 可以看着一种回滚:我不知道问题出在哪个接口,但是按照上个周期同时刻的流量来是没问题的。 落地实践: 为防止自动限流的不可控性,可同时使用自动限流和人工限流两种方式,具体方法如下: 系统分为正常状态和戒严状态:正常状态下使用人工限流,戒严状态下使用自动限流。 正常情况下系统使用人工限流,开发人员可以针对重点接口进行限流配置。 当限流值失效或者未配置限流的时候导致系统资源到达预警值时,系统进入戒严状态,此时系统由自动限流接管,并通知开发人员。 开发人员收到通知后进行排查,确定导致资源利用率上升的原因,并针对相关接口进行人工限流值的调整(可以参考到达瓶颈前的qps),并使系统重新切换到正常状态。 备注 该方案还需更多场景验证,如有疏漏还请指出,欢迎有兴趣的小伙伴共同探讨。 作者:京东零售马坚 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 了解 Transformers 是如何 “思考” 的

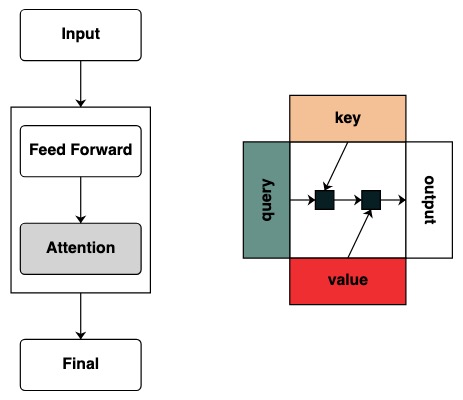
Transformer 模型是 AI 系统的基础。已经有了数不清的关于 "Transformer 如何工作" 的核心结构图表。 但是这些图表没有提供任何直观的计算该模型的框架表示。当研究者对于 Transformer 如何工作抱有兴趣时,直观的获取他运行的机制变得十分有用。 Thinking Like Transformers 这篇论文中提出了 transformer 类的计算框架,这个框架直接计算和模仿 Transformer 计算。使用 RASP 编程语言,使每个程序编译成一个特殊的 Transformer。 在这篇博客中,我用 Python 复现了 RASP 的变体 (RASPy)。该语言大致与原始版本相当,但是多了一些我认为很有趣的变化。通过这些语言,作者 Gail Weiss 的工作,提供了一套具有挑战性的有趣且正确的方式可以帮助了解其工作原理。 !pip install git+https://github.com/srush/RASPy 在说起语言本身前,让我们先看一个例子,看看用 Transformers 编码是什么样的。这是一些计算翻转的代码,即反向输入序列。代码本身用两个 Transformer 层应用 attention 和数学计算到达这个结果。 def flip(): length = (key(1) == query(1)).value(1) flip = (key(length - indices - 1) == query(indices)).value(tokens) return flip flip() 文章目录 第一部分:Transformers 作为代码 第二部分:用 Transformers 编写程序 Transformers 作为代码 我们的目标是定义一套计算形式来最小化 Transformers 的表达。我们将通过类比,描述每个语言构造及其在 Transformers 中的对应。(正式语言规范请在本文底部查看论文全文链接)。 这个语言的核心单元是将一个序列转换成相同长度的另一个序列的序列操作。我后面将其称之为 transforms。 输入 在一个 Transformer 中,基本层是一个模型的前馈输入。这个输入通常包含原始的 token 和位置信息。 在代码中,tokens 的特征表示最简单的 transform,它返回经过模型的 tokens,默认输入序列是 "hello": tokens 如果我们想要改变 transform 里的输入,我们使用输入方法进行传值。 tokens.input([5, 2, 4, 5, 2, 2]) 作为 Transformers,我们不能直接接受这些序列的位置。但是为了模拟位置嵌入,我们可以获取位置的索引: indices sop = indices sop.input("goodbye") 前馈网络 经过输入层后,我们到达了前馈网络层。在 Transformer 中,这一步可以对于序列的每一个元素独立的应用数学运算。 在代码中,我们通过在 transforms 上计算表示这一步。在每一个序列的元素中都会进行独立的数学运算。 tokens == "l" 结果是一个新的 transform,一旦重构新的输入就会按照重构方式计算: model = tokens * 2 - 1 model.input([1, 2, 3, 5, 2]) 该运算可以组合多个 Transforms,举个例子,以上述的 token 和 indices 为例,这里可以类别 Transformer 可以跟踪多个片段信息: model = tokens - 5 + indices model.input([1, 2, 3, 5, 2]) (tokens == "l") | (indices == 1) 我们提供了一些辅助函数让写 transforms 变得更简单,举例来说,where 提供了一个类似 if 功能的结构。 where((tokens == "h") | (tokens == "l"), tokens, "q") map 使我们可以定义自己的操作,例如一个字符串以 int 转换。(用户应谨慎使用可以使用的简单神经网络计算的操作) atoi = tokens.map(lambda x: ord(x) - ord('0')) atoi.input("31234") 函数 (functions) 可以容易的描述这些 transforms 的级联。举例来说,下面是应用了 where 和 atoi 和加 2 的操作 def atoi(seq=tokens): return seq.map(lambda x: ord(x) - ord('0')) op = (atoi(where(tokens == "-", "0", tokens)) + 2) op.input("02-13") 注意力筛选器 到开始应用注意力机制事情就变得开始有趣起来了。这将允许序列间的不同元素进行信息交换。 我们开始定义 key 和 query 的概念,Keys 和 Queries 可以直接从上面的 transforms 创建。举个例子,如果我们想要定义一个 key 我们称作 key。 key(tokens) 对于 query 也一样 query(tokens) 标量可以作为 key 或 query 使用,他们会广播到基础序列的长度。 query(1) 我们创建了筛选器来应用 key 和 query 之间的操作。这对应于一个二进制矩阵,指示每个 query 要关注哪个 key。与 Transformers 不同,这个注意力矩阵未加入权重。 eq = (key(tokens) == query(tokens)) eq 一些例子: 选择器的匹配位置偏移 1: offset = (key(indices) == query(indices - 1)) offset key 早于 query 的选择器: before = key(indices) < query(indices) before key 晚于 query 的选择器: after = key(indices) > query(indices) after 选择器可以通过布尔操作合并。比如,这个选择器将 before 和 eq 做合并,我们通过在矩阵中包含一对键和值来显示这一点。 before & eq 使用注意力机制 给一个注意力选择器,我们可以提供一个序列值做聚合操作。我们通过累加那些选择器选过的真值做聚合。 (请注意:在原始论文中,他们使用一个平均聚合操作并且展示了一个巧妙的结构,其中平均聚合能够代表总和计算。RASPy 默认情况下使用累加来使其简单化并避免碎片化。实际上,这意味着 raspy 可能低估了所需要的层数。基于平均值的模型可能需要这个层数的两倍) 注意聚合操作使我们能够计算直方图之类的功能。 (key(tokens) == query(tokens)).value(1) 视觉上我们遵循图表结构,Query 在左边,Key 在上边,Value 在下面,输出在右边 一些注意力机制操作甚至不需要用到输入 token 。举例来说,去计算序列长度,我们创建一个 " select all " 的注意力筛选器并且给他赋值。 length = (key(1) == query(1)).value(1) length = length.name("length") length 这里有更多复杂的例子,下面将一步一步展示。(这有点像做采访一样) 我们想要计算一个序列的相邻值的和,首先我们向前截断: WINDOW=3 s1 = (key(indices) >= query(indices - WINDOW + 1)) s1 然后我们向后截断: s2 = (key(indices) <= query(indices)) s2 两者相交: sel = s1 & s2 sel 最终聚合: sum2 = sel.value(tokens) sum2.input([1,3,2,2,2]) 这里有个可以计算累计求和的例子,我们这里引入一个给 transform 命名的能力来帮助你调试。 def cumsum(seq=tokens): x = (before | (key(indices) == query(indices))).value(seq) return x.name("cumsum") cumsum().input([3, 1, -2, 3, 1]) 层 这个语言支持编译更加复杂的 transforms。他同时通过跟踪每一个运算操作计算层。 这里有个 2 层 transform 的例子,第一个对应于计算长度,第二个对应于累积总和。 x = cumsum(length - indices) x.input([3, 2, 3, 5]) 用 transformers 进行编程 使用这个函数库,我们可以编写完成一个复杂任务,Gail Weiss 给过我一个极其挑战的问题来打破这个步骤:我们可以加载一个添加任意长度数字的 Transformer 吗? 例如: 给一个字符串 "19492+23919", 我们可以加载正确的输出吗? 如果你想自己尝试,我们提供了一个 版本 你可以自己试试。 挑战一:选择一个给定的索引 加载一个在索引 i 处全元素都有值的序列 def index(i, seq=tokens): x = (key(indices) == query(i)).value(seq) return x.name("index") index(1) 挑战二:转换 通过 i 位置将所有 token 移动到右侧。 def shift(i=1, default="_", seq=tokens): x = (key(indices) == query(indices-i)).value(seq, default) return x.name("shift") shift(2) 挑战三:最小化 计算序列的最小值。(这一步开始变得困难,我们版本用了 2 层注意力机制) def minimum(seq=tokens): sel1 = before & (key(seq) == query(seq)) sel2 = key(seq) < query(seq) less = (sel1 | sel2).value(1) x = (key(less) == query(0)).value(seq) return x.name("min") minimum()([5,3,2,5,2]) 挑战四:第一索引 计算有 token q 的第一索引 (2 层) def first(q, seq=tokens): return minimum(where(seq == q, indices, 99)) first("l") 挑战五:右对齐 右对齐一个填充序列。例:"ralign().inputs('xyz___') ='—xyz'" (2 层) def ralign(default="-", sop=tokens): c = (key(sop) == query("_")).value(1) x = (key(indices + c) == query(indices)).value(sop, default) return x.name("ralign") ralign()("xyz__") 挑战六:分离 把一个序列在 token "v" 处分离成两部分然后右对齐 (2 层): def split(v, i, sop=tokens): mid = (key(sop) == query(v)).value(indices) if i == 0: x = ralign("0", where(indices < mid, sop, "_")) return x else: x = where(indices > mid, sop, "0") return x split("+", 1)("xyz+zyr") split("+", 0)("xyz+zyr") 挑战七:滑动 将特殊 token "<" 替换为最接近的 "<" value (2 层): def slide(match, seq=tokens): x = cumsum(match) y = ((key(x) == query(x + 1)) & (key(match) == query(True))).value(seq) seq = where(match, seq, y) return seq.name("slide") slide(tokens != "<").input("xxxh<<<l") 挑战八:增加 你要执行两个数字的添加。这是步骤。 add().input("683+345") 分成两部分。转制成整形。加入 “683+345” => [0, 0, 0, 9, 12, 8] 计算携带条款。三种可能性:1 个携带,0 不携带,< 也许有携带。 [0, 0, 0, 9, 12, 8] => “00<100” 滑动进位系数 “00<100” => 001100" 完成加法 这些都是 1 行代码。完整的系统是 6 个注意力机制。(尽管 Gail 说,如果你足够细心则可以在 5 个中完成!)。 def add(sop=tokens): # 0) Parse and add x = atoi(split("+", 0, sop)) + atoi(split("+", 1, sop)) # 1) Check for carries carry = shift(-1, "0", where(x > 9, "1", where(x == 9, "<", "0"))) # 2) In parallel, slide carries to their column carries = atoi(slide(carry != "<", carry)) # 3) Add in carries. return (x + carries) % 10 add()("683+345") 683 + 345 1028 完美搞定! 参考资料 & 文内链接: 如果你对这个主题感兴趣想了解更多,请查看论文:Thinking Like Transformers 以及了解更多 RASP 语言 如果你对「形式语言和神经网络」(FLaNN) 感兴趣或者有认识感兴趣的人,欢迎邀请他们加入我们的 线上社区! 本篇博文,包含库、Notebook 和博文的内容 本博客文章由 Sasha Rush 和 Gail Weiss 共同编写 <hr> 英文原文:Thinking Like Transformers 译者:innovation64 (李洋)

优秀的个人博客,低调大师

Module Proxy (一) B/S架构的新思考

前后端分离是现代流行的Web架构模型,例如Vue+Spring Boot是很多软件公司常用的开发模型,对比传统的C/S模型会发现有趣之处: 在前后端分离后,后端程序员不再面对html、js、css,也不再研究forward和redirect的区别,HTTP服务端弱化了HTTP功能而更趋向于“服务”,这点和传统的C/S服务端非常相似。 例如认证服务都可以定义requet json: {"login":"admin","passwd":"admin@123"} 服务端返回response josn应答: {"status":true, "userid":2,"username":"管理员"} 两者的区别是:一个是HTTP接口协议,另一个是TCP Socket接口协议。 博主在这里提出以下问题: 问题一: B/S服务端能否使用C/S服务端采技术,例如采用C++语言做服务端? 问题二: HTTP协议和Socket协议哪个性能好,开发效率高,更能装逼? 问题三: 博主费心画的这个对比,提出这些问题,究竟想干嘛? 问题一 解答: 不能,起码不能简单替换。 原因会逐步说明,先看前后端B/S程序常见的部署和运行方式: 1)富客户端运行在浏览器中,沙箱安全机制不允许富客户端程序启用TCP Socket网络通讯 2)富客户端程序只能访问同一个Nginx HTTP服务,否则会引起跨域问题。 3)Nginx反向代理仍然使用HTTP协议,因此后端程序必须是HTTP服务。 前两点是浏览器标准,我们无法改变,第三点倒是可以想想办法。 问题二 解答: 1)性能肯定是socket好,HTTP协议是在socket基础上封装HTTP头,需要进行一些特殊处理的TCP协议。 2)开发效率不好判定。如果都不用轮子(框架),socket要简单一些,但spring boot大神的出现就很难说了,更多是个人喜好和主观的争论。 3)先发布个定理:”小众语言方可装逼“。你看看Java和.Net程序员能装逼的吗?会的人太多了,没有装逼的上下文。扩展一下这个问题,Socket编程能用哪些语言,HTTP编程又能用哪些语言? 几乎所有能独立运行的语言(不包括Javascript、SQL这些依赖运行环境的)都支持Socket编程,因为Socket是Linux、Windows系统提供的内核功能,各语言只是把这些内核接口封装后即可;而HTTP操作系统内核并未提供,需要各语言按照HTTP协议去实现的,支持Socket的语言远远多于支持HTTP的语言,因此从语言选择角度Socket更能装逼。 你明天可以向周边童鞋们不经意地提一下:”我准备用Eiffel语言搭建后端服务“,然后坐等崇拜吧:) 问题三 解答: 在说出博主的最终目的前,我们再次观察经典的Vue+Nginx+Spring Boot架构: 上图中如果Nginx反向代理支持socket协议,即可支持后端Socket服务程序,因此需要一个能将http协议代理为socket协议的中间件,见下图: 博主的最终目的:实现一个能将http协议反向代理为socket协议的中间件产品,产品名称Module Proxy,详细介绍请看后续章节。

优秀的个人博客,低调大师

轻量化模型训练加速的思考(Pytorch实现)

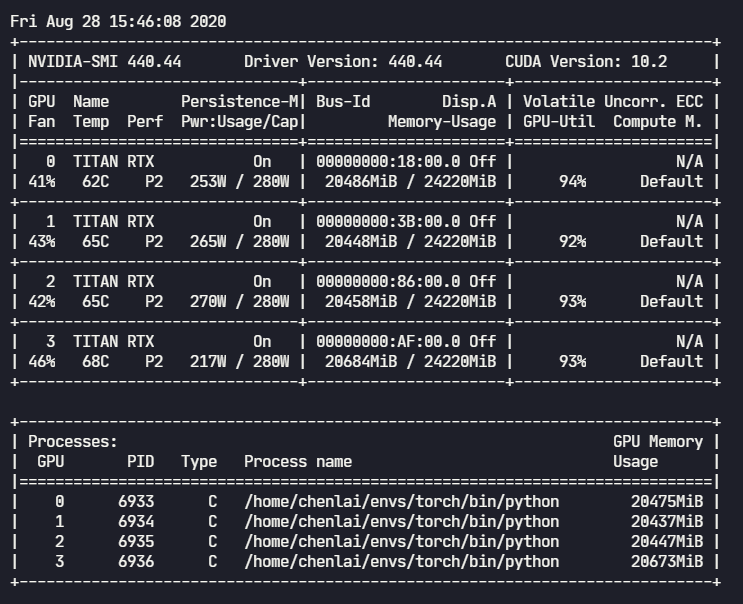
0. 引子 在训练轻量化模型时,经常发生的情况就是,明明 GPU 很闲,可速度就是上不去,用了多张卡并行也没有太大改善。 如果什么优化都不做,仅仅是使用nn.DataParallel这个模块,那么实测大概只能实现一点几倍的加速(按每秒处理的总图片数计算),不管用多少张卡。因为卡越多,数据传输的开销就越大,副作用就越大。 为了提高GPU服务器的资源利用率,尝试了一些加速的手段。 基于Pytorch1.6.0版本实现,官方支持amp功能,不再需要外部apex库; 此外比较重要的库是Dali。 参考代码 1. 训练速度的瓶颈及应对思路 这边主要说的是CV领域,但在其他领域,思路应该也是相通的。 模型训练过程中,影响整体速度的因素主要有以下几点: 将数据从磁盘读取到内存的效率; 对图片进行解码的效率; 对样本进行在线增强的效率; 网络前向/反向传播和Loss计算的效率; 针对这几个因素,分别采取如下几种应对思路: 加快数据读取可以有几种思路: 采取类似TF的tfrecord或者Caffe的lmdb格式,提前将数据打包,比反复加载海量的小文件要快很多,但pytorch没有通用的数据打包方式; 在初始化时,提前将所有数据加载到内存中(前提是数据集不能太大,内存能装得下); 将数据放在SSD而非HDD,可以大大提速(前提是你有足够大的SSD); 提升图片解码速度,可以考虑采用NVIDIA-DALI库,能够利用GPU来加速JPG格式的图片解码,针对其他格式的图片(如PNG),不能实现GPU加速,但也可以兼容; 提升样本在线增强的效率,同样可以通过NVIDIA-DALI库,实现GPU加速; 在网络结构确定的情况下,提速主要有两种方式,并且可以同时采用: 采用Data Parallel的多卡并行训练 采用amp自动混合精度训练 2. 实验配置 2.1 服务器 服务器为4卡TITAN RTX,进行实验时停止了其他高资源消耗的进程。 2.2 基本配置 Dataset:ImageNet Model:MobilenetV2 Augmentation:RandomCrop,RandomFlip,Resize,Normalization 每个进程的batch_size:256 每个进程的Dataloader的num_threads:8 3. 具体实现中的注意点 3.1 关于Dataloader 在使用DALI库构建Dataloader时,建议采用ops.ExternalSource的方式来加载数据,这样可以实现比较高的自由度。 示例代码中只实现了分类任务的dataloader,但按照这种方式构建,很容易实现其他如检测/分割任务的dataloader。 只要把数据来源按照迭代器来实现,就可以套用到ops.ExternalSource这一套框架下。 参见src/datasets/cls_dataset_dali.py中的ClsInputIterator。 3.2 关于Loss 在训练过程中,每个进程分别计算各自的loss,通过内部同步机制去同步loss信息。但是在训练中需要监控过程,此时需要计算所有loss的均值。 参见src/train/logger.py中关于reduce_tensor的计算方式。 3.3 关于多进程参数的选取 在训练过程中,实验用的服务器,CPU共32核心,4卡并行,因此每个进程的Dataloader,设定的num_threads为8,测试下来效率最高。 如果num_gpusnum_threads < CPU核心数,不能充分利用CPU资源; 如果num_gpusnum_threads > CPU核心数,速度反而也会有所下降。 4. 训练速度实测结果 4.1 未开启amp时的GPU占用 4.2 开启amp后的GPU占用 4.3 CPU占用情况 开启/关闭amp对于CPU的影响不大,基本看不出区别 4.4 综合训练速度 4卡并行,BS为256,训练集约120W图片。训练速度为: 未开启amp:约 2.4 iters/s(2458 帧/s),每个epoch训练时间不到 9 min; 开启amp:约 3.8 iters/s(3891 帧/s),每个epoch训练时间不到 6 min; 5. 一些总结 通过综合采用各种训练加速手段,基本可以做到充分利用多显卡服务器的GPU和CPU资源,不会造成硬件资源的浪费; 通过Nvidia-Dali模块的合理配置,可以显著提升数据加载和在线增强阶段的效率,特别是在训练一些轻量化模型时,往往瓶颈不在于GPU的计算速度,而在于CPU等其他部件的负载; 通过DistributedDataParallel模块的合理配置,可以实现多卡的负载均衡,不论是显存占用还是GPU利用率,都能够达到平衡,不会有其中1张卡变成效率瓶颈; 通过torch.cuda.amp模块的合理配置,可以进一步降低显存占用,从而可以设置更大的batch_size,提高模型收敛速度; torch.cuda.amp模块还可以显著降低网络前向推理时间,从而进一步提高训练效率。 综合应用如上所述的手段,基本上可以实现显卡数量和训练效率之间的线性增长关系。 不会发生卡多了,但是单卡的效率却大大下降的现象。 6. 一些意外 原以为本篇到此就该结束了,但又遇到了新的问题。 当训练执行一段时间后,由于整个系统长时间处于高负载的状态,显卡温度飙升,触发了显卡的保护机制,自动降频了,GPU利用率直接降到了原来的一半左右。 之前显卡运行效率低的时候,散热不良的问题还没有显露出来,一旦长时间高负荷运转,多卡密集排布和风冷散热的不足就暴露出来了。 下一步是要折腾水冷散热了么?

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册