首页 文章 精选 留言 我的

精选列表

搜索[实名实人认证解决方案],共10000篇文章
优秀的个人博客,低调大师

小白指南:Apache DolphinScheduler 补数据功能实操演示

最近使用 Apache DolphinScheduler 调度任务,不可避免地使用到【补数据】功能,经过不断尝试,终于成功运行了【补数据】功能,以此帖记录。 版本说明:3.1.9 补数据功能简介 "补数据" 在 Apache DolphinScheduler 中指的是 补数据(Complement Data) 功能,用于补充执行历史时间段内的工作流实例。 补数据功能概述 补数据是工作流执行的一种特殊模式,让用户可以为过去的时间段批量创建和执行工作流实例<cite />。这在以下场景中特别有用: 需要重新处理历史数据 系统故障后需要补充缺失的数据处理 新增数据处理逻辑后需要回填历史数据 定期批量数据处理 补数据配置参数 在工作流启动界面中,补数据功能包含以下配置选项: 是否是补数据 (whether_complement_data): 开关选项,启用补数据模式 调度日期 (schedule_date): 指定需要补数据的时间范围 : 支持日期选择和手动输入两种方式 格式为 yyyy-MM-dd HH:mm:ss,多个日期用逗号分隔 限制最多输入100条日期 执行方式 (mode_of_execution): 串行执行: 按顺序逐个执行补数据任务 并行执行: 同时执行多个补数据任务 并行度 (parallelism): 当选择并行执行时,可以设置自定义并行度来控制同时执行的任务数量 这有助于避免大量补数据任务对服务器造成过大影响 执行顺序 (order_of_execution) : 按日期升序执行: 从最早的日期开始执行 按日期降序执行: 从最近的日期开始执行 使用补数据功能操作步骤 首先是工作流的任务配置,见下图 接着,保存工作流,未设置全局变量。上线工作流。 最后,运行工作流,运行参数见下图 选择补数据的日期范围 【启动参数】为定义任务时设置的参数dt,value为空即可。 点击【确定】后自动运行 验证结果 点击【工作流实例】,查看运行结果。 点击第1个实例进入,查看日志 结果显示,SQL 运行结果为补数据选择的日期,补数据功能正常可用。 Notes 补数据功能是 Apache DolphinScheduler 工作流管理中的重要特性,通过灵活的配置选项(执行方式、并行度、执行顺序等)来满足不同的数据补充需求<cite />。在使用时需要注意合理设置并行度,避免对系统资源造成过大压力。

优秀的个人博客,低调大师

阿里通义开源实首个音频生成模型 ThinkSound

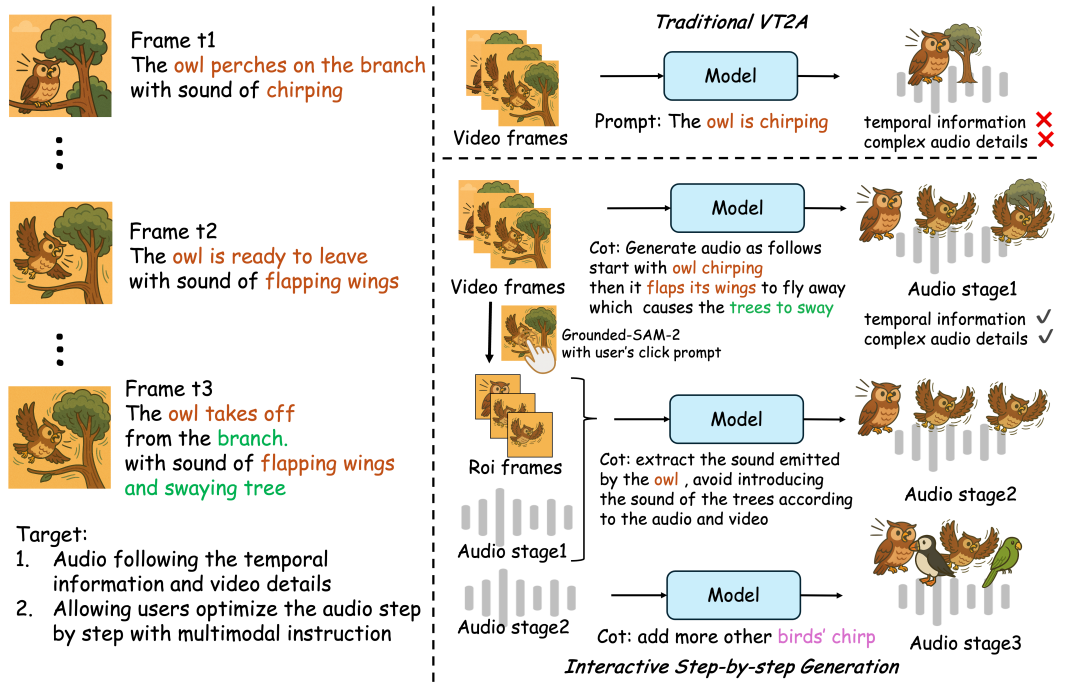
通义实验室首个音频生成模型 ThinkSound 现已正式开源,将打破“静音画面”的想象力局限。 该模型首次把多模态大模型的思维链推理引入音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,ThinkSound的代码和模型已在Github、HuggingFace、魔搭社区开源,开发者可免费下载和体验。 https://github.com/FunAudioLLM/ThinkSound https://huggingface.co/spaces/FunAudioLLM/ThinkSound https://www.modelscope.cn/studios/iic/ThinkSound 据介绍,ThinkSound 首次将 CoT(Chain-of-Thought,思维链)应用到音频生成领域,让 AI 学会一步步“想清楚”画面事件与声音之间的关系,从而实现高保真、强同步的空间音频生成 —— 不只是“看图配音”,而是真正“听懂画面”。 据悉,AudioCoT 融合了来自 VGGSound、AudioSet、AudioCaps、Freesound 等多个来源的 2531.8 小时高质量样本。这些数据覆盖了从动物鸣叫、机械运转到环境音效等多种真实场景,为模型提供了丰富而多样化的训练基础。为了确保每条数据都能真正支撑 AI 的结构化推理能力,研究团队设计了一套精细化的数据筛选流程,包括多阶段自动化质量过滤和不少于 5% 的人工抽样校验,层层把关以保障数据集的整体质量。

优秀的个人博客,低调大师

实操上手TinyEngine低代码引擎插件化开发

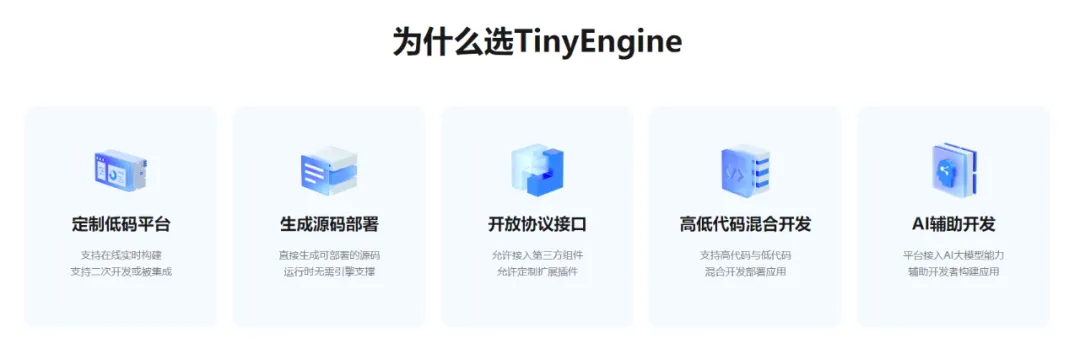
1.背景介绍 1.1 TinyEngine 低代码引擎简介 低代码开发是近些年非常热门的一种开发方式,用户可以通过可视化的方式,简单拖拽,不写代码或者编写少量代码,类似搭积木一样搭建业务应用。 TinyEngine是一个强大的低代码引擎,可以帮助开发者快速定制自己的低代码设计器或者低代码平台。 TinyEngine可以作为低代码平台的底座,提供可视化搭建页面等基础能力,既可以通过线上搭配组合使用,也可以通过cli创建个人工程进行二次开发,实时定制出自己的低代码平台。适用于多场景的低代码平台开发,如:资源编排、服务端渲染、模型驱动、移动端、大屏端、页面编排等。 TinyEngine 由OpenTiny 团队2023年开源,也欢迎大家点 Star 和 提Issue、PR 进行反馈。 TinyEngine 官网:https://opentiny.design/tiny-engine#/home TinyEngine 在线demo:https://opentiny.design/tiny-engine#/tiny-engine-editor TinyEngine 代码库:https://github.com/opentiny/tiny-engine 1.2 TinyEngine 插件化构建简介 TinyEngine引擎使用插件化架构,功能模块都由一个个插件构成,例如图片中页面上方的工具栏、左侧的插件栏、右侧的属性配置栏,以及中间的画布区域,都由一个个插件构成,通过插件化的架构,可以灵活配置、自由组装出个性化的设计器。 1.3 TinyEngine CLI简介 TinyEngine还提供了CLI工具方便用户二次开发,通过CLI,一行命令即可基于TinyEngine创建出全新的低代码项目、低代码插件项目,未来还会陆续增加创建设置器插件,创建新主题,新布局,新物料包等能力。 实验介绍 本实验主要通过体验使用TinyEngine几行命令快速创建一个用户专属低代码设计器,及通过开发一个新的侧边栏插件, 帮助开发者快速了解基于TinyEngine二次开发定制的能力。 2.1 实验目标 使用 TinyEngine CLI,通过一行命令创建全新低代码设计器,了解基于 TinyEngine 创建个性化低代码设计器/平台、二次开发的能力。 体验 TinyEngine 简单拖拽、配置 的开发形式帮助开发者快速了解低代码开发使用流程。 完成开发一个新的基础侧边栏插件,并集成到设计器中,了解基于 TinyEngine 扩展设计器功能的能力。 2.2 实验环境准备 在开始实验步骤之前,先确保我们的开发环境以及工具齐全: Node.js v18+版本、pnpm 包管理工具。 vscode 代码编辑器、git 代码版本管理工具。 chrome浏览器 110+ 版本。 必要的开发前端开发环境、工具等。 实践步骤 3.1 一行命令创建自己的专属低代码设计器 3.1.1 创建低代码设计器 执行engine-cli create,选择platform以创建一个新的设计器 npx @opentiny/tiny-engine-cli@alpha create 执行后首次会提示是否安装@opentiny/tiny-engine-cli,输入"Y"并回车 之后会提示选择要创建类型,选择platform之后,输入设计器名称,如:lowcode-designer,即可完成新设计器项目的创建。 查看当前文件目录,看发现已经创建出了 lowcode-designer 代码目录。 3.1.2 启动低代码设计器 执行下面命令安装依赖并启动项目: # 安装依赖 npm install # 启动项目 npm run dev 启动完项目之后,我们应该能看到浏览器打开的默认的低代码设计器: 3.1.3 体验低代码设计器 之后可以体验下低代码开发方式: 拖拽物料面板中组件到中间画布中 在右侧属性面板中修改属性值观察画布中的变化 在画布中拖拽组件调整组件的布局与位置 3.2 通过开发插件扩展设计器新功能 3.2.1 一行命令创建新插件 另起一个终端,输入下面命令,选择创建plugin类型,创建一个新的插件 npx @opentiny/tiny-engine-cli@alpha create 输入插件名称:demo-plugin 之后就可以在demo-plugin目录看到新创建的插件,进去该目录安装依赖: cd demo-plugin && npm install 3.2.2 将插件接入设计器 使用VS Code打开设计器项目,修改registry.js import { Breadcrumb, Fullscreen, /* ... */, GenerateCodeService } from '@opentiny/tiny-engine' import engineConfig from './engine.config' ++ import DemoPlugin from './demo-plugin' export default { // ... -- plugins: [Materials, Tree, Page, Block, Datasource, Bridge, I18n, Script, State, Schema, Help, Robot], ++ plugins: [DemoPlugin, Materials, Tree, Page, Block, Datasource, Bridge, I18n, Script, State, Schema, Help, Robot], dsls: [{ id: 'engine.dsls.dslvue' }], settings: [Props, Styles, Events], canvas: Canvas } 3.2.3 开发调试插件 重新打开项目页面,可以看到侧边栏多了一个新的插件: 修改插件代码,设计器界面也会实时刷新。 之后可以尝试完成以下功能: 为插件实现一个"添加按钮",点击按钮展开插件二级页面 在二级面板中添加一个输入框,并实现保存功能,点击保存按钮将输入框内容显示到一级面板中 如此即完成了一个简单的TinyEngine侧边栏插件开发全流程。 总结 本实践活动指导通过使用TinyEngine CLI创建一个全新设计器,上手体验低代码能力,并开发新的侧边栏插件扩展设计器能力,掌握基于TinyEngine定制设计器与插件的方式,了解TinyEngine的插件化架构与插件扩展能力。但实验中的部分只是TinyEngine扩展定制能力的一个缩影,TinyEngine提供了各种灵活的自定义能力,期待您的继续使用。 关于OpenTiny OpenTiny官网:https://opentiny.design TinyVue 源码:https://github.com/opentiny/tiny-vue(欢迎 Star ⭐) TinyEngine 源码:https://github.com/opentiny/tiny-engine(欢迎 Star ⭐) B站:https://space.bilibili.com/15284299 欢迎加入 OpenTiny 开源社区。添加微信小助手 opentiny-official 一起参与交流前端技术~

优秀的个人博客,低调大师

HBase实操:Spark-Read-HBase-Snapshot-Demo 分享

前言:之前给大家分享了Spark通过接口直接读取HBase的一个小demo:HBase-Spark-Read-Demo,但如果在数据量非常大的情况下,Spark直接扫描HBase表必然会对HBase集群造成不小的压力。基于此,今天再给大家分享一下Spark通过Snapshot直接读取HBase HFile文件的方式。 首先我们先创建一个HBase表:test,并插入几条数据,如下: hbase(main):003:0> scan 'test' ROW COLUMN+CELL r1 column=f:name, timestamp=1583318512414, value=zpb r2 column=f:name, timestamp=1583318517079, value=lisi r3 column=f:name, timestamp=1583318520839, value=wang 接着,我们创建该HBase表的快照,其在HDFS上路径如下: hbase(main):005:0> snapshot 'test', 'test-snapshot' 0 row(s) in 0.3690 seconds $ hdfs dfs -ls /apps/hbase/data/.hbase-snapshot Found 1 items drwxr-xr-x - hbase hdfs 0 2020-03-21 21:24 /apps/hbase/data/.hbase-snapshot/test-snapshot 代码如下: import org.apache.hadoop.fs.Path import org.apache.hadoop.conf.Configuration import org.apache.hadoop.hbase._ import org.apache.hadoop.mapreduce.Job import org.apache.hadoop.hbase.client.Scan import org.apache.hadoop.hbase.mapreduce.{TableInputFormat, TableSnapshotInputFormat} import org.apache.hadoop.hbase.protobuf.ProtobufUtil import org.apache.hadoop.hbase.util.{Base64, Bytes} import org.apache.spark.{SparkConf, SparkContext} object SparkReadHBaseSnapshotDemo { // 主函数 def main(args: Array[String]) { // 设置spark访问入口 val conf = new SparkConf().setAppName("SparkReadHBaseSnapshotDemo") .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer") .setMaster("local")//调试 val sc = new SparkContext(conf) // 获取HbaseRDD val job = Job.getInstance(getHbaseConf()) TableSnapshotInputFormat.setInput(job, "test-snapshot", new Path("/user/tmp")) val hbaseRDD = sc.newAPIHadoopRDD(job.getConfiguration, classOf[TableSnapshotInputFormat], classOf[org.apache.hadoop.hbase.io.ImmutableBytesWritable], classOf[org.apache.hadoop.hbase.client.Result]) hbaseRDD.map(_._2).map(getRes(_)).count() } def getRes(result: org.apache.hadoop.hbase.client.Result): String = { val rowkey = Bytes.toString(result.getRow()) val name = Bytes.toString(result.getValue("f".getBytes, "name".getBytes)) println(rowkey+"---"+name) name } // 构造 Hbase 配置信息 def getHbaseConf(): Configuration = { val conf: Configuration = HBaseConfiguration.create() conf.set(TableInputFormat.SCAN, getScanStr()) conf } // 获取扫描器 def getScanStr(): String = { val scan = new Scan() // scan.set.... 各种过滤 val proto = ProtobufUtil.toScan(scan) Base64.encodeBytes(proto.toByteArray()) } } 注:上述代码需将core-site.xml&hdfs-site.xml&hbase-site.xml文件放在资源目录resources下。否则,应在代码中进行配置,代码如下: package com.xcar.etl import org.apache.hadoop.fs.Path import org.apache.hadoop.conf.Configuration import org.apache.hadoop.hbase._ import org.apache.hadoop.mapreduce.Job import org.apache.hadoop.hbase.client.Scan import org.apache.hadoop.hbase.mapreduce.{TableInputFormat, TableSnapshotInputFormat} import org.apache.hadoop.hbase.protobuf.ProtobufUtil import org.apache.hadoop.hbase.util.{Base64, Bytes} import org.apache.spark.{SparkConf, SparkContext} object SparkReadHBaseSnapshotDemo2 { val HBASE_ZOOKEEPER_QUORUM = "xxxx.com.cn" // 主函数 def main(args: Array[String]) { // 设置spark访问入口 val conf = new SparkConf().setAppName("SparkReadHBaseSnapshotDemo2") .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer") .setMaster("local")//调试 val sc = new SparkContext(conf) // 获取HbaseRDD val job = Job.getInstance(getHbaseConf()) TableSnapshotInputFormat.setInput(job, "test-snapshot", new Path("/user/tmp")) val hbaseRDD = sc.newAPIHadoopRDD(job.getConfiguration, classOf[TableSnapshotInputFormat], classOf[org.apache.hadoop.hbase.io.ImmutableBytesWritable], classOf[org.apache.hadoop.hbase.client.Result]) hbaseRDD.map(_._2).map(getRes(_)).count() } def getRes(result: org.apache.hadoop.hbase.client.Result): String = { val rowkey = Bytes.toString(result.getRow()) val name = Bytes.toString(result.getValue("f".getBytes, "name".getBytes)) println(rowkey+"---"+name) name } // 构造 Hbase 配置信息 def getHbaseConf(): Configuration = { val conf: Configuration = HBaseConfiguration.create() conf.set("hbase.zookeeper.property.clientPort", "2181") conf.set("zookeeper.znode.parent", "/hbase") conf.set("hbase.zookeeper.quorum", HBASE_ZOOKEEPER_QUORUM) conf.set("hbase.rootdir", "/apps/hbase") // 设置查询的表名 conf.set(TableInputFormat.INPUT_TABLE, "test") conf.set("fs.defaultFS","hdfs://xxxxxx:8020") conf.set(TableInputFormat.SCAN, getScanStr()) conf } // 获取扫描器 def getScanStr(): String = { val scan = new Scan() // scan.set.... 各种过滤 val proto = ProtobufUtil.toScan(scan) Base64.encodeBytes(proto.toByteArray()) } } TableSnapshotInputFormat.setInput 方法参数解析: public static void setInput(org.apache.hadoop.mapreduce.Job job, String snapshotName, org.apache.hadoop.fs.Path restoreDir) throws IOException 参数解析: job - the job to configure snapshotName - the name of the snapshot to read from restoreDir - a temporary directory to restore the snapshot into. Current user should have write permissions to this directory, and this should not be a subdirectory of rootdir. After the job is finished, restoreDir can be deleted. 项目用到的 pom.xml 文件: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.zpb.test</groupId> <artifactId>spark-read-hbase-snapshot-demo</artifactId> <version>1.0-SNAPSHOT</version> <packaging>jar</packaging> <name>spark-read-hbase-snapshot-demo</name> <url>http://maven.apache.org</url> <repositories> <repository> <id>cloudera</id> <url>https://repository.cloudera.com/artifactory/cloudera-repos/</url> </repository> </repositories> <properties> <cdh.hbase.version>1.2.0-cdh5.7.0</cdh.hbase.version> <cdh.spark.version>1.6.0-cdh5.7.0</cdh.spark.version> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> </properties> <dependencies> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>3.8.1</version> <scope>test</scope> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson</artifactId> <version>1.2.62</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-core_2.10</artifactId> <version>${cdh.spark.version}</version> <!--<scope>provided</scope>--> </dependency> <dependency> <groupId>org.apache.hbase</groupId> <artifactId>hbase-server</artifactId> <version>${cdh.hbase.version}</version> </dependency> </dependencies> </project> 欢迎关注本人公众号【HBase工作笔记】,解锁更多姿势~

优秀的个人博客,低调大师

HBase实操 | 使用Java调用HBase的Endpoint Coprocessor

1.文档编写目的 HBase是一款基于Hadoop的Key-Value数据库,提供了对HDFS上数据的高效随机读写服务,填补了Hadoop MapReduce批处理的缺陷,但HBase作为列簇数据库无法轻易的建立“二级索引”、难以执行求和、计数、排序等操作。在HBase0.96版本后引入了协处理器(Coprocessor),用户可以编写运行在HBase Server端的代码。HBase支持两种类型的协处理器,Endpoint和Observer。 Endpoint协处理器类似传统数据库中的存储过程,客户端可以调用这些Endpoint协处理器执行一段Server端代码,并将Server端代码的结果返回给客户端处理。 Observer Coprocessor,这中协处理器类似于传统数据库中的触发器,当发生某些事件的时候,Observer协处理

优秀的个人博客,低调大师

Unity 裁员 265 人

Unity 在 2021 年以 16.25 亿美元收购了 Peter Jackson 联合创办的视觉特效公司 Weta Digital 的工程技术部门,与美术部门 Weta FX 达成服务协议。 根据路透社的报道,现在作为公司重组 (company reset) 的一部分它宣布终止服务协议裁掉相关的 265 名员工,约占员工总数的 3.8%。 Unity 是规模最大的游戏引擎开发商,目前还有 7000 名员工。它同时宣布将关闭部分办事处,缩小办公面积,不再强制要求员工每周前往办公室工作三天。 9 月份,Unity 宣布了新的收费规则,此举引起业内人士的强烈不满。之后 Unity 向公众和业内人士道歉,并调整了收费规则。 Unity 引擎明年起根据游戏安装量收费 (runtime fee) Unity 道歉:将修改 "runtime fee" 收费政策 走近 “收费门”:互相矛盾的服务条款导致 Unity 面临被起诉的风险 Unity CEO John Riccitiello 上个月因受争议的运行时费用而离职,前 IBM 总裁 Jim Whitehurst 担任临时 CEO,Whitehurst 表示为了重新专注于公司业务,更多的变化即将到来。虽然这对受影响的员工来说是一个挑战,但对于公司来说,这可能是一个重新调整和提高效率的机会。

优秀的个人博客,低调大师

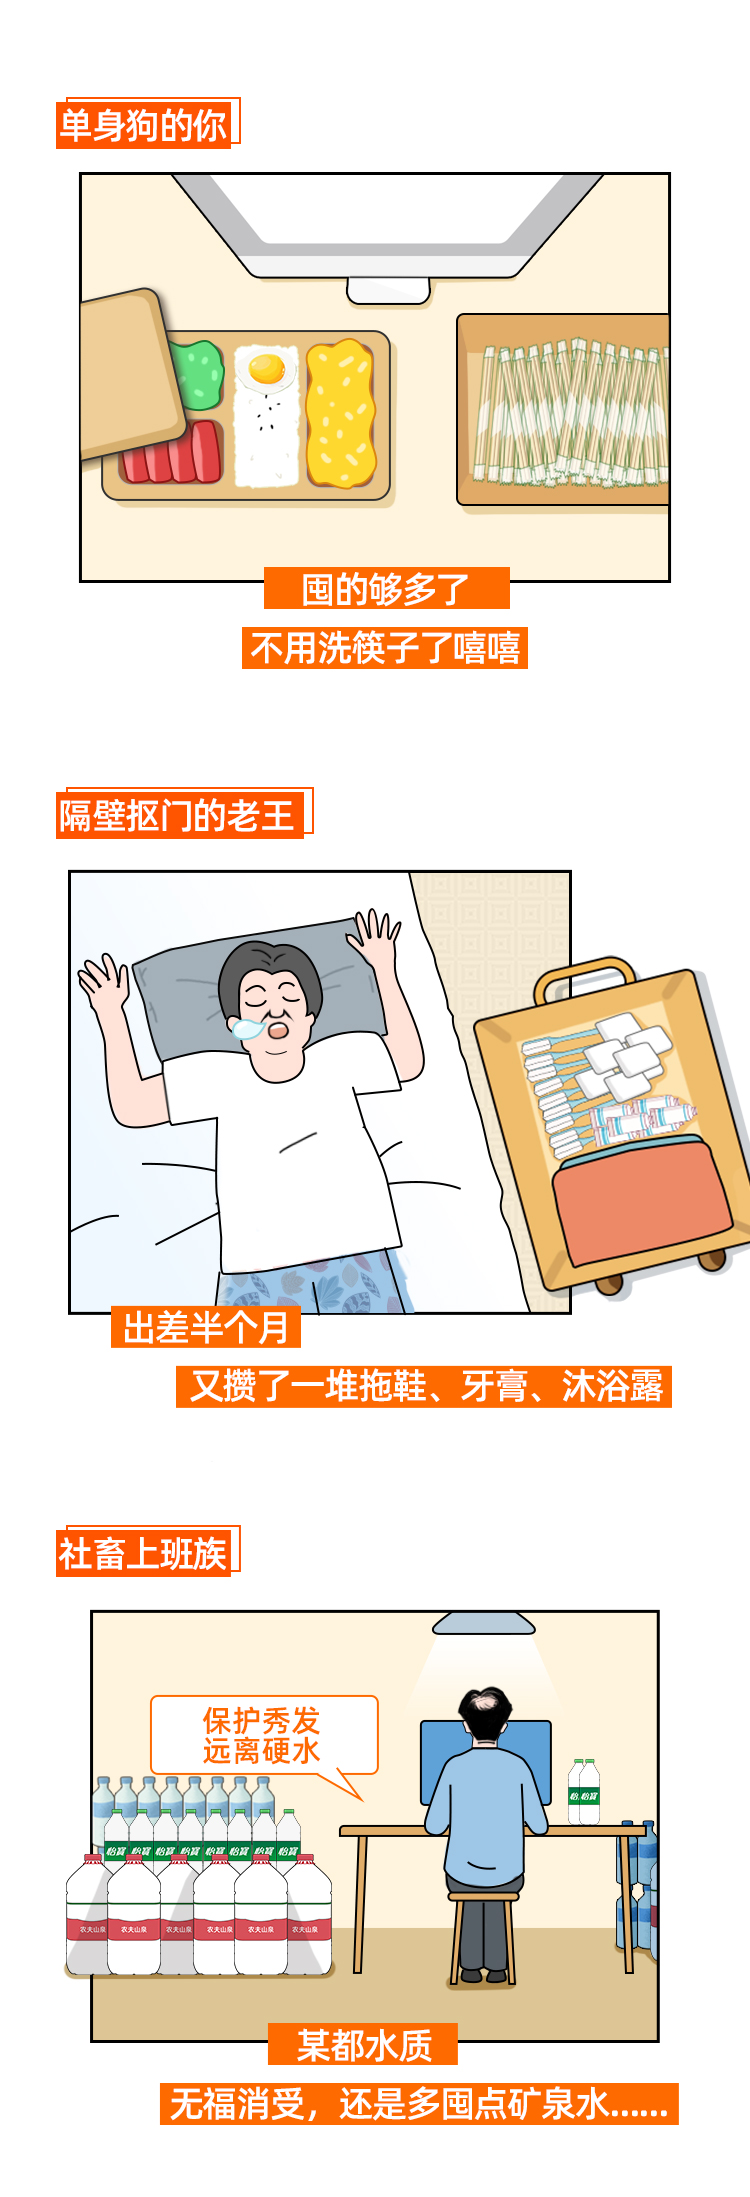
社会人囤货图鉴

囤货,总能给人一种唾手可得、毫不慌张的稳稳的幸福(错觉)。 好像有种“一囤在手,天下我有”的感觉。比如,囤了一堆从未打开的书,就觉得自己变得腹有诗书气自华;囤了一堆护肤品,就好像自己马上肤若凝脂美若天仙。​少年,你囤的不是货,囤的是向往。 一起来看看,咱们屯里的“海豚”(海量囤货)都在囤什么? 阿里云年中大促:新用户免费试用 12个月,最低 89.8 元可入手热销云服务器,购物车满减补贴,最多可减 12000 元! 阿里云最近还推出了:六代增强型云服务器 ECS,基于第六代的 CPU 和网络架构, 依托自研神龙架构获得第七代的 IO 能力, ESSD 使用门槛大幅下降 50%, 普惠百万客户! 某运维工程师特别提醒:我已经囤好了一年的量,屏幕前的运维小伙伴,不要错过哦! 一键直达阿里云服务器 ECS 大促专场,今年的服务器安排上!https

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册