首页 文章 精选 留言 我的

精选列表

搜索[全场景互联],共10008篇文章
优秀的个人博客,低调大师

互联网运维装腔指南

1、全球化的认证有助于提升逼格,什么OCM、CCIE、RHCA、CISSP等等能考都考,再不济,也要有一张系统架构设计师或者网络规划设计师的信产部认证。每过一个认证,逼格提升一档。如果再有能一个211工程的MSC,那就再好不过了。 2、TCP/IP协议、Linux内核深入研究、ORACLE大全等等之类的超过1千页大本头的书能有效提升B格,一定要放手边。不懂不要紧,别人能看见就行了。真有人跟你谈这些,也别担心装B失败,谈网络就从TCP的实现谈起,谈Linux就从内存的管理谈起,谈数据库就从各数据库SQL语句的源码实现谈起。如果有人跟你谈MS的东西也不要紧,就说自己之前有多年的微软的工作经历,外包的也算。反正也不会有查。有人非要跟你谈硬件,最次也要从CPU的指令集的实现谈起吧。 3、大众化的东西要少用。能用ATS,就别用squid;能用postgresql,就别用MySQL;坚信什么nginx、lighty这种webserver要比apache好一万倍,而且apache能实现的功能,这些都能实现,不行就自己写模块、写扩展。实在要用apache,也别用高版本,抱死1.3的系统。有人要是问起,就说这是基于1.3的版是自己深度二次开发版本。实在要找不到的话也不要紧,没事在sf、oschina上看看什么下载量少的项目,背背项目简介啥的。不得不说,这两个网站太贴心,分类都给你做好了。总之,小众的东西能很有效的提升iBer的战斗力。 4、写脚本的话,别用grep、sort 、uniq、管道这类命令。iBer会选择使用纯粹的awk、sed的实现,长度不要紧,阅读性、性能也不是问题。功能实现了,别人都还不懂这就是关键。如果真有人来请教,也要装出一副很简单的表情。切记不要摇头尾巴晃。就算是你是从《sed和awk》这种书上抄你自己也不一定能看懂的代码。 5、虽然会shell,但也要少用shell。初级iBer,系统管理会首选perl、python、php这类3p的工具,而且要对shell这种语言有一种不屑。把什么性能、移植性、面向对象要常挂嘴边。,如果再能写二行什么erlang、ruby、lua这类语言做系统管理,绝对是iBer的装B神器,也是中级iBer的标准。高级IBer会有Haskell这类函数式语言进行系统管理,这绝对是装B的B2轰炸机呀。当然,资深iBer会返璞归真,使用面向对象进行shell编程。对,你没看错,是使用OO进行shell编程。 6、iBer对谈到Redhat、ubuntu这类大众发行版本时,会回复一个字“切!”LFS、Gentoo这类系统绝对是iBer们首选。不为什么,就为在无穷尽的编译中找到属于iBer的快感。如果非装大众发行版,iBer也会从开机画面、登陆提示等等地方打自己上深刻的烙印。iBer的寂寞岂是一般人能懂的。 7、iBer对什么checkpoint,juniper等表示不屑。必须天天把iptabes的链和表都挂在嘴边,尤其是mangle表。原则上对商用产品的一律不屑一顾,什么f5,radware一律自己开发实现。至于意外的将自己关在外面的事情一定要严格遵守各自公司的保密协议。 8、iBer的操作终端呢,像SecureCRT、xshell这种绝对是不用的,一定要用最原始的,什么黑屏绿字只是初级iBer的水平,中高级iBer的都是Alpha半透明终端,桌面背景在设置个全球internet流量趋势图。让你根本就不知道他天天对着屏幕在敲什么东西。有事没事编译一些大型软件,看着翻滚的屏幕做思考状。 9、名片的title一定要是系统架构师,没有名片也不要紧,什么QQ签名、人人状态、微博简介上,有人看的地方一定要写上。这些都是提升B格的好地方。 10、初级iBer谈流量、PV、自动化;中级iBer谈流程、谈规范,什么ITIL、ITSM要常挂嘴边;高级iBer谈架构、谈模式;资深iBer谈合同、谈成本。 11、混圈子对iBer来非常有必要的。什么XX沙龙、XX架构师大会、XX优化大会之类必要是常客,露个B脸就行。基本原则就是跟搞系统谈网络,跟搞网络的谈数据库,跟搞数据库的谈安全……对方不懂什么就谈什么对就了 12、骨灰级iBer早就超出三界外,不在五行中,他们注定有着传奇的色彩。他们正忙于对iBer们进行职业发展规划。iBer助理、iBer、高级iBer、资深iBer、iBer总监直至CBO。如果发展了到了CBO,那么你一定是一位惊天地、泣鬼神的一代B神,一统江湖的教主,供万千iBer敬仰。darling,我很看好你哟! 作者:佚名 来源:51CTO

优秀的个人博客,低调大师

ELK之ES-Logstash-Kibana互联

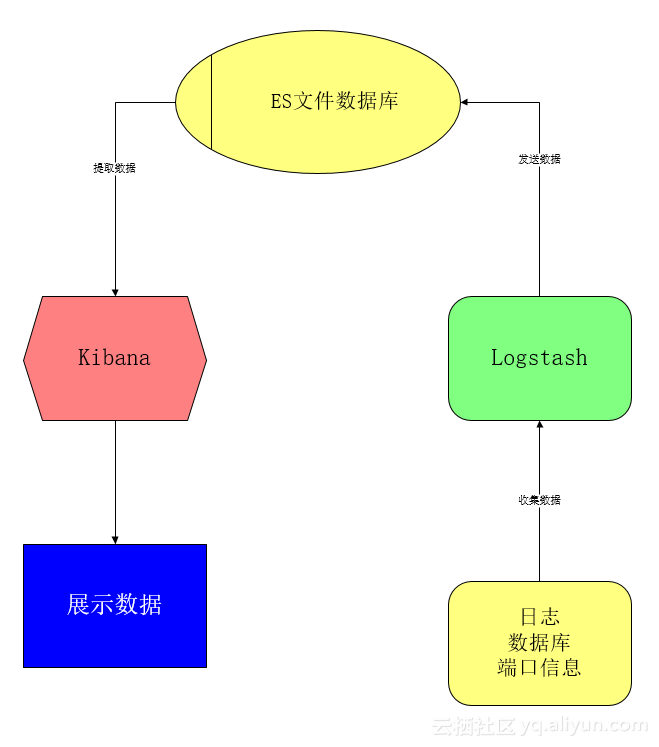
好久没有写,这久都是在做ELK的数据化模板,觉得还是有些东西需要写下来的,前面我已经写过了EKL的安装,今天就来说一下ELK三个软件之间的连接把。 # 关系介绍: ES是一个文档数据库,Logstash是一个数据收集工具,Kibana是一个数据处理工具,这么去理解这三个组件是无可厚非的。我们通过Logstash把数据收集起来,无论是通过读取日志,还是读取数据库,亦或是去监听某一个日志输出端口,总之Logstash就是一个数据收集工具,收集到数据之后再把数据发送给ES进行固化。好了,现在我们在ES中已经有了数据了,那么,通过什么来分析呢?没错,就是通过Kibana,它需要去ES数据库拿去数据,然后对数据进行分析。现在我们应该可以理ELK三个组件的逻辑关系了。现在把三者的关系理解清楚以后,就可以进行配置了。 # EKL相互配置 根据关系图我们可以知道,第一步需要做的是连接数据源和Logstash。第一步:连接数据源和Logstsh 假设我们使用时是日志文件数据源,我们就需要使用Logstash的file{}插件 事例代码如下: file{ path=>['/data/access.log'] type => "system" start_position => "beginning" sincedb_path => '/dev/null' } path属性是指定元数据位置type属性是指点该批元数据在ES中的类型start_position 属性表示从头开始读取数据sincedb_path 属性标识为/dev/null'时标识无论如何从头开始读取文件更多file插件的字段属性,可以参考ELK文档。 第二步:让Ligstash把数据发送给ES elasticsearch{ hosts => ["10.66.140.37:9200"] action=>"index" index => "%{[@metadata][beat]}-%{+YYYY.MM.dd}" manage_template => false idle_flush_time => 10 sniffing => true document_id=>"%{[DocID]}" } hosts属性是表示ES在哪index 属性表示事件要被写进的索引idle_flush_time 属性表示每10秒发送一次数据到ESactive属性表示ES要执行的动作 第三步:连接ES和Kibana 前面我们已经把需要的数据发送到ES进行了存储了,现在要做的就是通过Kibana来分析我们的数据。编辑Kibana的.ylm设置ES的地址。至此,ELK三大组件的连接已经完成。你可以开心的去编辑你的数据格式和图标了...

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册