首页 文章 精选 留言 我的

精选列表

搜索[summary],共2521篇文章
优秀的个人博客,低调大师

Python网络编程(weekly summary1)

网络的目的是什么? 用于信息传输、接受 能把各个点、面、体的信息链接到一起 实现资源的共享 OSI模型: 应用层:提供程序服务 表示层:数据加密、优化、压缩 会话层:建立链接、传输服务 传输层:提供数据传输服务 网络层:路由选择 网路互联 连表层:链接交换 物理层:硬件、接口、网卡规定等 特点: 将功能分开来达到高内聚低耦合 让开发更为清晰 什么是网络协议? 是为了完成计算机网络通讯而制定的规则、约定、标准 各模型使用的协议: 应用层:TFTP(文件传输)、HTTP(超文本传输协议)、DNS(域名解析)、SMTP(邮件传输) 传输层:TCP(面向有链接的可靠的传输服务)、UDP(面向无连接的不可的传输靠服务) 网络层:IP(IP地址)常用IPV4:点分十进制 取值0~256之间(32位) IPV6::128位 物理层:IEEE 特殊IP: 127.0.0.1 本机IP 0.0.0.0 自动使用本地可用网卡IP 192.168.1.0 代表网段 192.168.1.1 通常为网关地址 192.198.1.255 广播地址 端口: 取值范围1~65535之间 1~255 一些通用端口 256~1023 系统端口 1024~65535 自用端口 Linux命令: ifconfig 查看本机IP ping IP 查看延迟 ps -aux 查看系统进程信息 chmod 设置文件权限 nice -9 ./hello.py 以9的优先级运行 pstree 查看进程树 ps -ajx 查看父子进程ID Linux下文件类型: bcd -lsp b(快 设备文件) c(字符设备文件) d(目录) -(普通文件) l(链接文件) s(套接字文件) p(管道文件) ps -aux 查询结果的 STAT表示进程状态: D 等待态 阻塞 不可中断等待态 S 等待态 睡眠 可中断等待态 T 等待态 暂停 暂停执行 R 运行态(就绪态) Z 僵尸 + 前台进程(在终端运行) < 有较高优先级的进程 N 较低优先级的进程 s 回话组 l 有子进程链接 进程优先级: 取值范围:-20~19 -20最高 Python socket模块 socket.gethostname() 获取本机名 socket.gethostbyname("主机名") 利用主机名获取IP soccket.gethostbtname(“IP”) 获取本地IP IP的十六进制转换: socket.inet_aton(IP) 十进制转十六进制 socket.inet_atoa(十六进制) 十六进制转十进制 socket.gethostbyaddr('127.0.0.1') 返回值:元组(主机, 别名,ip地址) socket.getservbyname("程序名") 获取程序端口 套接字:是通过编程语言提供的套接字编程借口 传输层服务: tcp:(SOCK_STREAM) 面向有链接的可靠的传输服务 流式套接字 1.创建套接字: socket = socket.socket() 2.绑定地址: socket.bind 3.设置监听: socket.listen() 4.等待客户端链接: socket.accept() 5.消息收发: socket.recv(4096) socket.send(“”) 6.关闭套接字: socket.close() 客户端: 1.创建套接字 socket.socket.socket() 2.发起链接 socket.connect(地址) 3.消息收发 socket.recv(1024) 收消息 socket.send("") 发消息 socket.sendall(): 事物发消息 成功返回None 失败异常 4.关闭套接字 socket.close() recv特性: 建立链接的另一端被断开,会返回一个空字符串 从缓冲区取内容 send特性: 另一端不纯在产生一个pipe Broken 异常 向缓冲区写内容 缓冲区: 减少和和磁盘交互协调数据收发 提高效率 粘包: 由于tcp是数据流套接字的原因每次发送的数据间 没有边界一次取不完下次取数据时会形成粘包 udp:(SOCK_DGRAM) 面向无连接的不可靠的传输服务 数据报套接字 1.创建套接字: socket = socket.socket(AF_INET,SOCK_DGRAM) 2.绑定地址: socket.bind() 3.收发消息: socket.recvfrom() socket.sento() 4.关闭套接字: socket.close() 客户端: 1.创建套接字: socket = socket.socket() 2.收发消息; socket.recvform() socket.sendto(“”, 地址) 3.关闭套接字: socket.close() sys.argv() 命令行获取参数 返回值: 元组:sys.argv[0] 开始 空格隔开 引号隔开 套接字属性方法: 套接字的属性: socket.type 地址类型: socket.family 套接字IO描述符: socket.fileno() 系统IO描述符: sys.stdin = 0 sys.stdout = 1 sys.stderr = 2 获取套接字地址: socket.getsockname() 获取套接字客户端地址: socket.getpeername() 设置端口重用: socket.setsockopt(SOL_SOCKET, SO_REUSEADDR, 1) 获取套接字选项值: socket.getsockopt() 设置为非阻塞状态: socket.setblocking(False) 超时检测: socket.settimeout(sec) HTTP协议(超文本传输协议): 网站浏览器获取网页的一种协议 并且所有的www.文件都必须遵守这个标准 HTTP请求: 1.请求行: 说明具体的请求类别和内容 GET /index.html /HTTP/1.1 请求类别 请求内容 协议版本 请求类别: GET: 获取网络资源 POST: 提交一定的附加数据 HEAD: 获取响应头 PUT: 更新服务器资源 DELETE: 删除服务器资源 CONNECT: 未使用 TRACE: 用于测试 OPTIONS: 获取服务器性能信息 2.请求头: 对请求的具体描述 3.空行 4.请求体: 具体的参数或提交的内容 HTTP响应: 1.响应行:反馈具体的响应情况 HTTP/1.1 20 OK 版本协议 响应码 附加信息 响应吗: 1xx:提示信息,表示请求已经接收 2xx:响应成功 3xx:响应需要定向(重新记载链接第三方链接) 4xx:客户端错误 5xx:服务器端错误 2.响应头: 对响应内容的具体描述 3.空行 4.响应体: 将客户端请求内容进行返回 IO: 在内存中存在数据交换的操作可以认为是IO操作(输入输出) IO密集程序: 大量的IO操作,消耗CPU较少 CPU密集程序: 大量的内存CPU运算,IO相对较少 IO分类: 阻塞IO: 因为某些条件没有达成 导致程序堵塞 如:input函数 非阻塞IO: 改变阻塞函数的状态不让其阻塞 IO多路复用: 通过一个监测 监控多个IO事件的行为, 哪个IO事件准备就绪就执行哪个IO事件 IO准备就绪: IO事件即将发生时的临界状态 select模块 监控IO事件 rs, ws, xs = select(rlist, wlist, xlist[, timeout]) rlist: 等待处理的IO wlist: 主动处理的IO xlist: 出错希望去处理的IO 位运算: 按照二进制位进行位运算操作 & 按为与 | 按位或 ^ 按位异或 << 左异 >>右移 poll方法实现IO多路复用: 1.创建poll对象: p = select.poll 2.注册关注的IO: p.register(s, POLLIN | PLLERR) 不关注: p.unregister(s) 事件类别: POLLIN POLLOUT POLLERR POLLHUP POLLPRI rlist wlist xlist 断开 紧急处理 3.监控IO: events = p.poll() 功能:监控关注的IO事件 返回值: 返回发生IO事件 events是一个列表[(fileno, evnet), (), ()....] 每个就绪IO对应一个元组(描述符,就绪事件) IO地图:{s.fileno():s} 4.处理IO事件 本地套接字: 作用: 用于本地文件不同程序间进行数据传输 本地套接字传输流程: 1.创建本地套接字对象 sockfd = socket(AF_UNIX, SOCK_STREAM) 2.绑定套接字文件,如果文件不存在则自动创建 存在则报错 sockfd.bind(file) 3.监听 listen 4.消息收发 recv send 多任务编程: 通过程序利用计算机的多个核心达到同时执行多个任务的目的 因此达到提升程序运行效率的目的 并行: 多个计算机核心在同时处理多个任务, 这时多个任务之间是并行关系 并发: 同时运行多个任务,内核在多个任务之间的不断切换, 达到多个任务都会执行的处理效果 此时多个任务之间是并发关系 程序: 可执行文件,是静态的,只占有磁盘 进程: 是一个动态过程 程序的运行过程 CPU时间片: 如果有个进程占有CPU此时我们称为该进程占有CPU的时间片 多个进程任务或轮流占有CPU时间片并形成并发效果 进程特征: 进程是操作系统分配资源的最小单元 每个进程拥有自己独立的运行空间(4个G的虚拟内存空间) 进程之间相互独立各不影响 进程的状态: 三态: 就绪状态: 进程具备执行条件,等待系统分配处理器资源进入运行态 运行态: 进程占有CPU处于运行状态 等待态: 进程暂时不具备运行条件,需要阻塞等待 五态: 在三态的基础上增加新建和终止态 新建: 创建一个新的程序,获取系统资源的过程 终止: 进程执行结束,释放资源的过程 OS模块: 判断一个文件是否存在: os.path.exists(file) 删除文件: os.remove(file) os.unlink(file) 创建进程: os.fork() 获取进程id: os.getpid() 获取父进程id: os.getppid() 退出一个进程: os.exit() sys.exit(退出提示) sys.exit() 可以通过捕获 SystemExit异常退出 孤儿进程: 当父进程优先于子进程退出,此时子进程就会成为孤儿进程 孤儿进程会被系统指定进程收养 退出后会自动处理 僵尸进程: 当子进程优先于父进程退出,父进程没有处理子进程的退出状态 就会变成僵尸进程 僵尸进程会滞留PCB 消耗内存资源 如何避免僵尸进程的产生: 1.父进程先退出 2.父进程处理子进程状态 处理僵尸进程: PID,status = os.wait(): wait 在父进程中阻塞等待处理子进程的退出 返回退的子进程的怕pid和退出状态 pid,status = os.waitpid(pid,option): waitpid 在父进程阻塞等待处理子进程的退出 参数 : pid -1 表示等待任意子进程退出 >0 表示等待对应PID号的子进程退出 option 0 表示阻塞等待 WNOHANG 表示非阻塞 返回退的子进程的怕pid和退出状态 利用二级子进程: 父进程创建子进程等待进程退出 子进程创建下一个进程,然后立即退出 二级子进程成为孤儿进程 处理具体工作 multiprocessing模块 process() 功能: 创建进程对象 参数: target:函数对象 name 给进程新名称() args:元组 用来给target函数位置传参 kwargs:字典 用来给target函数键值传参 启动进程: p.start() 调用绑定函数有子进程运行 等待子进程退出: p.join([超时检测]) 不使用join回收可能后产生僵尸进程 使用multiprocessing创建进程子进程同样复制父进程的全部内存空间 之后有自己的独立空间 执行上互不干扰 子进程也有自己的PID特有资源等 使用multiprocessing创建子进程,一般父进程功能就是只用来创建子进程 回收子进程,返回事件交给子进程完成

优秀的个人博客,低调大师

访问Storm ui界面,出现Nimbus Summary或Supervisor Summary时有时无的问题解决(图文详解)

问题详情 问题分析 解决办法1 [hadoop@master storm]$ su root Password: [root@master storm]# ntpdate pool.ntp.org 21 May 19:57:55 ntpdate[10584]: step time server 173.255.246.13 offset 31.766614 sec [root@master storm]# [hadoop@slave1 storm]$ su root Password: [root@slave1 storm]# ntpdate pool.ntp.org 21 May 19:58:08 ntpdate[6337]: step time server 173.255.246.13 offset 338.531206 sec [root@slave1 storm]# [hadoop@slave2 storm]$ su root Password: [root@slave2 storm]# ntpdate pool.ntp.org 21 May 19:58:17 ntpdate[5787]: step time server 173.255.246.13 offset 49.728104 sec [root@slave2 storm]# 解决办法2 清除storm存储的目录,重新执行生成。 解决办法3 去查看日志。 http://master:9999/index.html 成功! 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6885771.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

台湾精准医疗计划:GWAS-summary statistics完全公开可下载

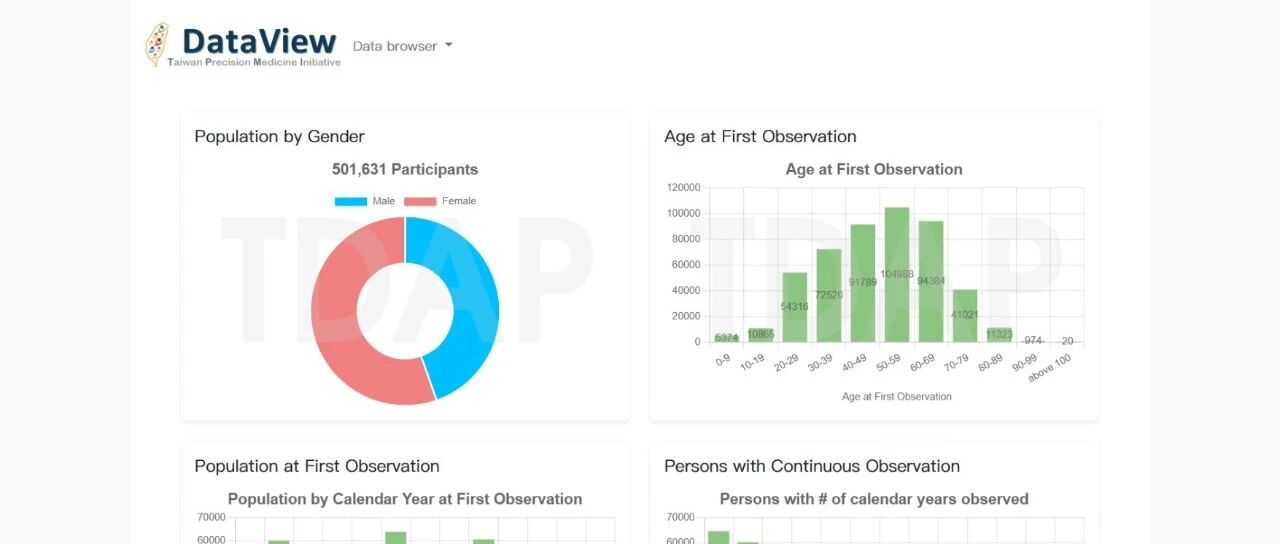
![](https://developer.qcloudimg.com/http-save/yehe-8140185/335be50c0bb7378007706b0bf29602d1.png) 小编发现台湾精准医疗计划(TPMI)的成果值得点赞,原因是他的开放性,当然大陆也有多个比这个项目队列多得多的项目,但是碍于各种利益,仅局限于小团体和小圈子,这很难实现数据资源的共享,也是巨大的浪费。期待国人的科研和数据资源也变得更加开放,特别是AI时代,只有开放合作才能实现成果。传统的小团体已经很难做出大成果。之前听说生物大模型方向的研究,都是上百人两周通力合作出一篇成果的,这种效率,真的是奇迹呀! # 719种表型与基因变异的关联分析结果 https://pheweb.ibms.sinica.edu.tw/phenotypes 平台提供广义表型和性状的全基因组关联研究(GWAS)摘要统计数据, 使研究人员能在用户友好的界面中探索719个表型之间的遗传关联。 ![](https://developer.qcloudimg.com/http-save/yehe-8140185/36901a2106c9a078f747cc78151eb8d0.png) # 计划简介 这个计划通过招募565,390名参与者,整合基因分型与纵向电子病历(EMR),建立了TPMI数据访问平台(TDAP),为验证疾病风险预测模型、开展健康管理临床试验及制定卫生政策提供了独特资源,有力推动了全球非欧裔人群的遗传学研究,已经有5篇论文发表。 ![](https://developer.qcloudimg.com/http-save/yehe-8140185/03266c8b7f3386c1562cf59a457c3f5a.png) 基因分型采用针对汉族人优化的单核苷酸多态性(SNP)芯片,该技术可用于全基因组关联分析(GWAS)、全表型组关联分析(PheWAS)5,6以及多基因风险评分(PRS)研究,以评估常见疾病风险和药物基因组学反应。 # 数据资源概览 ![](https://developer.qcloudimg.com/http-save/yehe-8140185/2bbd366db9d3ff9675eb9c378dfcace0.png) 除了前两个基因和表型数据的汇总资源是可以公开访问的,后面两个涉及临床等资料,做了限制,相对好理解的,国际合作最成功的UKB也是做了限制的。 ![](https://developer.qcloudimg.com/http-save/yehe-8140185/61fa1bbf2a25812e1280c7d796471dc2.png) TPMI Data View数据基于 501,631 名参与者的统计结果,反映了台湾地区慢性病和传染病对公共健康的主要影响。高血压、心脏病和糖尿病是最常见的死亡相关疾病,影响超过半数参与者。肺癌竟然排第三位,可能和空气质量好有相关性? ![](https://developer.qcloudimg.com/http-save/yehe-8140185/487c8ee5cef6ba714099ce1d86fe422e.png) ![](https://developer.qcloudimg.com/http-save/yehe-8140185/5f6acc9df6491e58d6f5a47ccfebd9f2.png) ![](https://developer.qcloudimg.com/http-save/yehe-8140185/f6173178eaec34468b17448c0950731d.png) ![](https://developer.qcloudimg.com/http-save/yehe-8140185/dfa594c191c9ff5330c58f24afbea17b.png) # 精准医疗的科普内容 网站还科普了下精准医疗的主要功能: - **期能提升用药安全**:药物治疗虽是控制疾病的常见方式,但由于个体体质与代谢能力不同,每个人对药物的反应可能差异甚大。 部分病患在用药过程中,可能因药品特性与个人差异,出现预料之外的副作用或疗效不佳的情形。 透过个性化用药,能帮助每个人用药更安全、更有效。 - **个性化医疗**:影响健康的因素包括环境因素、生活习惯与型态、是否暴露于有毒物质或致癌物等危险因子,以及每个人独有的基因组成; 而环境、生活型态及暴露于有毒物质或致癌因子与否均可能影响基因表现。透过精准医疗,可藉由基因信息及临床资料,选择最适合个人的治疗方法及用药建议,以期使疗效最大化并避免产生不良反应。 - **新型态健康管理**:随着人口老龄化,慢性病患者人数日益增加。 疾病治疗不仅提高了用药风险,治疗效果不佳也可能造成个人伤害,并加重社会医疗负担。精准医疗结合科技与大数据分析,不仅提升诊断与治疗的准确度,提高个人健康照护质量,也能从多方面降低成本,避免不必要的医疗浪费。 - **精准医疗未来应用**:计划的基因与健康数据分析,可更深入了解基因特性、健康风险与对药物的反应差异。当完善的精准医疗临床应用模型建立后,临床医师将能依据个人的基因特性,提供量身订做的用药建议与健康照护方案。 这不仅能提升治疗成效、减少副作用,也有助病患避开不必要的检查与医疗资源浪费。未来,精准医疗将成为日常医疗的重要一环,实现真正「因人而异」的个性化健康管理,让每个人都能获得最适合自己的治疗与照护。 # 参考资料 - https://tpmi.ibms.sinica.edu.tw/www/ - https://dataview.ibms.sinica.edu.tw/dataview/ - https://www.nature.com/articles/s41586-025-09680-x

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册