首页 文章 精选 留言 我的

精选列表

搜索[stack],共3377篇文章
优秀的个人博客,低调大师

elastic stack学习--logstash配置

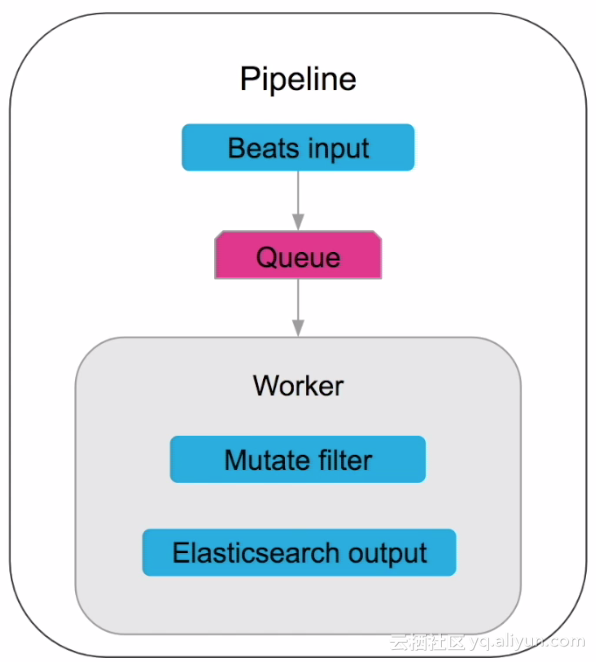
logstash组件 logstash中一条pipeline由输入、过滤、输出3个部分组成,数据经由inputs -> filters -> outputs进行流转,每个pipeline中可以包含一个或者多个inputs、filters、outputs,用户可根据需求在配置文件中定义。logstash对于3个部分提供了丰富的内置组件用于支撑数据的转换和处理。 inputs组件 input组件负责接收数据源的数据,生成event事件;一些常见的组件如下: stdin:读取操作系统标准输入流中的数据; file:读取文件系统的文件,类似于UNIX的命令tail -0F; syslog:监听操作系统514端口,接收系统日志,并根据RFC3164格式进行解析; redis:从redis中读取数据;redis经常用作logstash的消息队列,用于暂存event事件; beats:接收并处理Filebeat等beat组件发来的事件; 更多组件请参看官方文档Input Plugins filters组件 filter组件用于对流经管道的数据进行过滤、转换等操作,使得数据符合输出需求。常见组件如下: grok:用于解析和构建任意文本数据。grok是logstash用于解析非结构化日志数据的最好方式,包含120中pattern,能够满足大部分需求; mutate:执行event中通用的字段处理,包括:对字段的重命名、删除、替换、修改等操作; drop:删除event; clone:拷贝event,可以增减字段; geoip:根据event中的IP地址字段解析地理位置信息字段,添加到event中; 更多组件请参看官方文档Filter Plugins outputs组件 output组件用于将管道中的数据输出到下一环节;常见组件包括: stdout:操作系统标准输出流; elasticsearch:将所有event发送到elasticsearch; file:将event写入文件; graphite:发送event给graphite,graphite是一个开源的用于数据存储和绘图的组件; statsd:发送event给statsd; 更多组件请参看官方文档Output Plugins codecs组件 codecs组件主要用作inputs和outputs中数据的编解码使用,能够使数据的序列化操作对于数据传输透明,常见的组件包括: json:json格式编解码器; msgpack:msgpack格式编解码器; plain:文本格式编解码器; multiline:将多行文本event合并成一个event,比如将java中的异常跟踪日志合并成一条消息; 更多组件请参看官方文档Codec Plugins logstash执行模型 每个input组件都运行在其自己的线程中,将解析的event写入到一个中心队列中,队列的数据默认存放到内存中,也可以配置存放到硬盘中;一个pipeline包含多个工作线程,每个工作线程会从中心队列中获取一批event,按filter的配置顺序执行每个filter环节,然后再执行每个output。工作线程获取一批数据的数量以及工作线程数可配置。 logstash目录结构 home:logstash安装包解压后根目录; bin:二进制文件、脚本存放目录;默认:{extract.path}/bin config:配置文件目录,包括:logstash.yml、jvm.options文件;默认:{extract.path}/config,通过path.settings修改; logs:日志文件目录,默认:{extract.path}/logs,通过path.logs修改; plugins:存放插件,每个插件一个子目录;默认:{extract.path}/plugins,通过path.plugins修改; data:存放数据文件;默认:{extract.path}/data,通过path.data修改; logstash配置文件 logstash包含2种配置文件: 基本配置文件:用于配置logstash启动及运行参数;包括:logstash.yml、jvm.options、startup.options(linux使用)。 pipeline配置文件:用于配置pipeline数据处理流程; logstash.yml常用配置项 logstash.yml存放logstash的基本配置参数,包括数据文件路径、日志级别等。logstash.yml中的配置项也可以通过启动logstash时,通过指定命令行参数进行覆盖。 logstash.yml配置项支持环境变量作为参数值; node.name:用于标识一个logstash实例;默认:所在机器的hostname; path.data:存放logstash以及组件的持久化数据;默认:LOGSTASH_HOME/data; pipeline.id:pipeline的标识,类似于kafka中的topic,用于区分不同的pipeline;当多个logstash使用相同的pipeline.id时,相当于将数据汇总到同一个pipeline中,此时多个logstash可以视作一个通过pipeline.id关联的集群;默认:main; pipeline.workers:pipeline的工作线程数,用于执行filter和output阶段使用;默认:所在机器CPU核数; pipeline.batch.size:工作线程一次获取的event数量;设置较大的batchSize能够提升处理性能,但是可能消耗较大的内存;可以调整$LS_HEAP_SIZE环境变量来设置堆内存大小;默认:125; pipeline.batch.delay:;默认:50ms; pipeline.unsafe_shutdown:logstash在关闭时,默认会等到所有被处理的event都通过output输出后再执行关闭操作;如果设置为true,则允许强制关闭,而不必等待event处理完毕,此时可能会丢失数据;默认:false; path.config:logstash的main pipeline配置文件路径,如果指定通配符,则按照字母顺序读取配置文件; config.string:pipeline的配置字符串,语法同pipeline配置文件内容的语法;默认:不配置; config.test_and_exit:设置为true,则用来检测pipeline配置文件格式是否正确,检测完成后输出结果并退出;默认:false; config.reload.automatic:设置为true,则定期检测pipeline配置文件是否更新,如果有更新则触发SIGHUP信号,重新加载配置文件;默认:false; config.reload.interval:设置pipeline配置文件检测周期,配合config.reload.automatic使用,默认:3s; config.debug:设置为true,则将pipeline配置文件信息打印成debug日志,需同时保证log.level: debug才可生效;包括密码等信息均会被打印到日志中;默认:false; config.support_escapes:设置为true,将n等字符串转义成不可见字符;默认:false; modules:配置模块,格式类似如下,默认:未配置; modules: - name: MODULE_NAME1 var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY1: VALUE var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY2: VALUE var.PLUGIN_TYPE2.PLUGIN_NAME2.KEY1: VALUE var.PLUGIN_TYPE3.PLUGIN_NAME3.KEY1: VALUE - name: MODULE_NAME2 var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY1: VALUE var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY2: VALUE queue.type:缓存event的队列类型,如果设置为memory,则在内存中缓存event,如果设置为persisted,则在硬盘上缓存event;默认:memory; path.queue:当queue.type: persisted时,队列要存放的文件路径,默认:path.data/queue; queue.page_capacity:当queue.type: persisted时,每个文件存放的数据大小,文件中的数据只会追加,默认:64mb; queue.max_events:当queue.type: persisted时,queue中允许存放的最大未读取event数量;默认:0,即不限制; queue.max_bytes:当queue.type: persisted时,指定queue中存放数据的最大大小;默认:1024mb; queue.checkpoint.acks:当queue.type: persisted时,设置最大接收多少个应答event后更新检查点,如果设置为0,则表示不限制;默认:1024; queue.checkpoint.writes:当queue.type: persisted时,设置最大接收多少个写event后更新检查点,如果设置为0,则表示不限制;默认:1024; queue.drain:当queue.type: persisted时,设置为true,则执行关闭操作时,清空queue后再关闭;默认:false; dead_letter_queue.enable:设置是否使用dead_letter_queue;默认:false; dead_letter_queue.max_bytes:设置dead_letter_queue存放的最大数据量,超过数据量,则会删除队列中的节点;默认:1024mb; path.dead_letter_queue:设置dead_letter_queue数据文件存放路径,默认:path.data/dead_letter_queue; http.host:设置rest接口绑定ip地址,默认:"127.0.0.1"; http.port:设置rest接口绑定端口,默认:9600; log.level:设置日志级别,取值(fatal/error/warn/info/debug/trace),默认:info; log.format:设置日志格式,取值(json/plain),默认:plain; path.logs:设置日志文件存放目录,默认:LOGSTASH_HOME/logs; path.plugins:设置定制组件存放路径,组件存放的目录结构PATH/logstash/TYPE/NAME.rb,其中type取值(inputs/filters/outputs/codecs),默认:LOGSTASH_HOME/logs/plugins; 命令行运行logstash 运行logstash命令格式如下: bin/logstash [options] 通过-f选项可以指定pipeline配置文件; bin/logstash -f mypipeline.conf 通过命令行配置的参数将会覆盖logstash.yml中相应的参数; 常用命令行参数 --node.name NAME:同logstash.yml的node.name; -f, --path.config CONFIG_PATH:指定logstash的配置文件或者配置文件目录,如果配置为目录,则会按照字母排序,将多个配置文件合成一个;相同的配置项,取最新的配置项覆盖之前的同名配置项; -e, --config.string CONFIG_STRING:同config.string; --modules:指定module的名称,如果涉及多个module,则通过逗号分隔,或者配置多个--modules参数;使用--modules将会忽略logstash.yml中的modules配置; -M, --modules.variable:配合--modules,用于指定module中需要用到的变量,如果未指定,则使用默认值;如果未配置--modules,则忽略该参数; --pipeline.id ID:同logstash.yml的pipeline.id; -w, --pipeline.workers COUNT:同logstash.yml的pipeline.workers; -b, --pipeline.batch.size SIZE:同logstash.yml的pipeline.batch.size; -u, --pipeline.batch.delay DELAY_IN_MS:同logstash.yml的pipeline.batch.delay; --pipeline.unsafe_shutdown:同logstash.yml的pipeline.unsafe_shutdown; --path.data PATH:同logstash.yml的path.data; -p, --path.plugins PATH:同logstash.yml的path.plugins; -l, --path.logs PATH:同logstash.yml的path.logs; --log.level LEVEL:同logstash.yml的log.level; --config.debug:同logstash.yml的config.debug; -i, --interactive SHELL:使用指定shell替换当前shell;可选值:irb/pry; -t, --config.test_and_exit:同logstash.yml的config.test_and_exit; -r, --config.reload.automatic:同logstash.yml的config.reload.automatic; --config.reload.interval RELOAD_INTERVAL:同logstash.yml的config.reload.interval; --http.host HTTP_HOST:同logstash.yml的http.host; --http.port HTTP_PORT:同logstash.yml的http.port; --log.format FORMAT:同logstash.yml的log.format; --path.settings SETTINGS_DIR:指定包含logstash.yml和log4j配置文件的目录;也可以使用$LS_SETTINGS_DIR环境变量配置; -h, --help:打印帮助信息; -V, --version:查看当前logstash的版本; 常用环境变量 $LOGSTASH_HOME:logstash安装根目录; $LS_HEAP_SIZE:logstash堆内存大小设置; $LS_SETTINGS_DIR:指定logstash的logstash.yml和log4j配置文件目录; logstash安装x-pack logstash安装x-pack流程输入下: 1)下载x-pack安装包,如果部署elasticsearch时已经下载,则直接使用即可,下载地址: https://artifacts.elastic.co/downloads/packs/x-pack/x-pack-6.2.2.zip2)执行安装命令: bin/logstash-plugin install file:///path/to/file/x-pack-6.2.2.zip 注:此处的安装包路径一定是绝对路径,直接使用压缩包安装即可,无需解压;格式类似:file://路径 安装成功后,日志类似如下: Installing file: /home/work/x-pack-6.2.2.zip Install successful 3)设置logstash的监控的elasticsearch地址以及用户名和密码,使用内置用户logstash_system即可; xpack.monitoring.elasticsearch.url: "http://elasticsearch_ip:port" xpack.monitoring.elasticsearch.username: "logstash_system" xpack.monitoring.elasticsearch.password: "Huawei@1990" 4)启动logstash,查看kibana上已经出现了被监控的logstash实例; 问题 1)部署了多个logstash,在kibana上却只显示一个实例? 原因:logstash的唯一性标识是通过启动时候在${LOGSTASH_HOME}/data/uuid文件中创建的uuid来保证的。如果部署的时候使用相同的uuid,比如直接拷贝部署文件的情况,将导致kibana上只有一个实例的情况。解决办法:关闭logstash,删除${LOGSTASH_HOME}/data/uuid文件,重启logstash;参考:Kibana monitoring, logstash only one node 参考 官方文档:Settings File官方文档:Running Logstash from the Command Line官方文档:Setting Up X-Pack

优秀的个人博客,低调大师

Elastic Stack学习--logstash入门

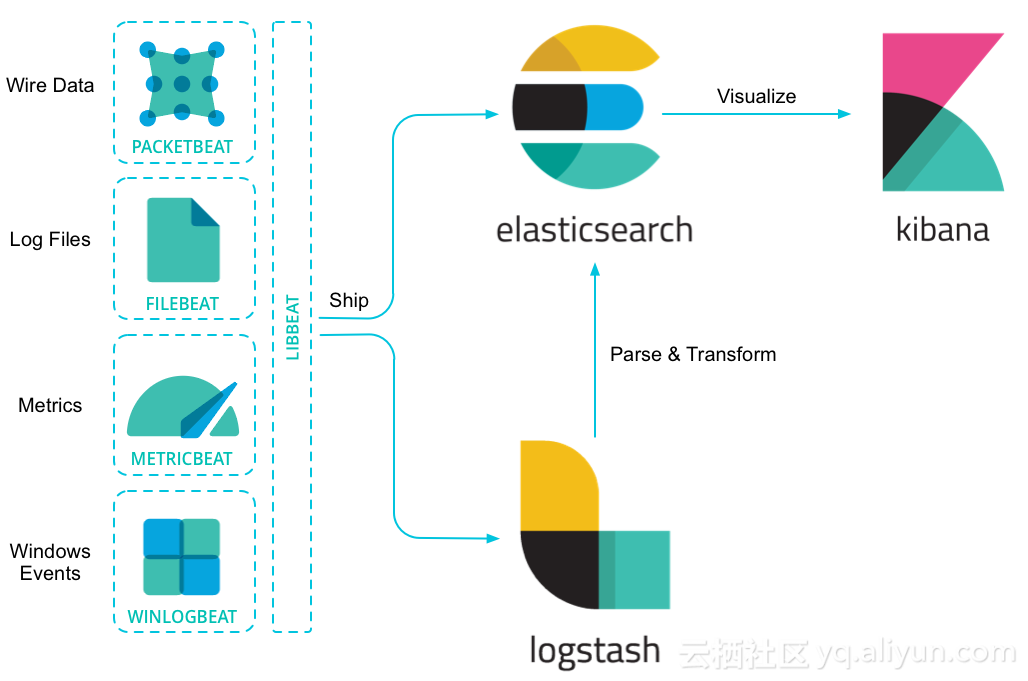
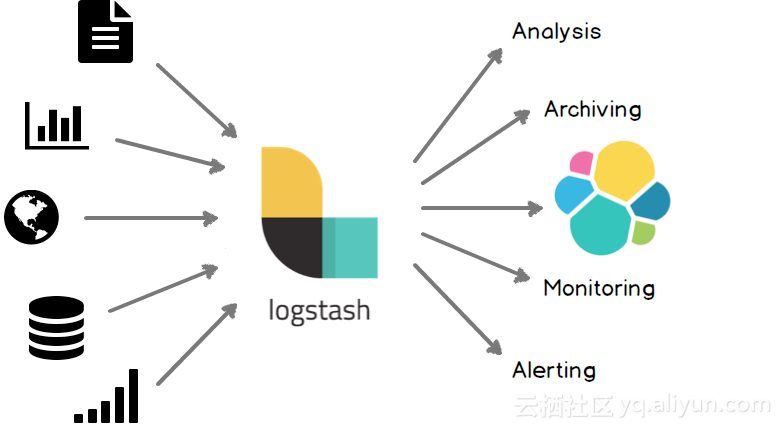
logstash是基于实时管道的数据收集引擎。它像一根处理数据的管道,收集分散的数据,进行汇总处理后输出给下游进行数据分析和展现。 logstash可以配合Beats组件或者其它第三方组件进行数据收集,数据经过处理后存放到elasticsearch中进行检索和分析。 除了对接beats以外,logstash有着丰富的组件,能够支持各种数据源接入。包括jdbc、kafka、http等。 logstash是基于pipeline方式进行数据处理的,pipeline可以理解为数据处理流程的抽象。在一条pipeline数据经过上游数据源汇总到消息队列中,然后由多个工作线程进行数据的转换处理,最后输出到下游组件。一个logstash中可以包含多个pipeline。 基本概念 pipeline:一条数据处理流程的逻辑抽象,类似于一条管道,数据从一端流入,经过处理后,从另一端流出;一个pipeline包括输入、过滤、输出3个部分,其中输入和输出部分是必选组件,过滤是可选组件; instance:一个logstash实例,可以包含多条数据处理流程,即多个pipeline; inputs:数据输入组件,用于对接各种数据源,接入数据,支持解码器,允许对数据进行编码解码操作;必选组件; filters:数据过滤组件,负责对输入数据进行加工处理;可选组件; outputs:数据输出组件,用于对接下游组件,发送处理后的数据,支持解码器,允许对数据进行编码解码操作;必选组件; event:pipeline中的数据都是基于事件的,一个event可以看作是数据流中的一条数据或者一条消息; 安装logstash 1)依赖java8,且不支持java9:检查java版本并配置JAVA_HOME环境变量。logstash基于jruby开发,logstash 6.x版本要求运行在java8环境,且目前不支持java9;2)下载并解压:下载logstash,解压文件;注意logstash所在路径中不可以包含冒号; tar -zxvf logstash-6.2.2.tar.gz cd logstash-6.2.2 3)启动logstash,发布第一个事件:通过-e指定一个pipeline的处理流程,指定从stdin中读取event,然后在stdout输出; bin/logstash -e 'input { stdin { } } output { stdout {} }' 可以看到类似如下日志: Sending Logstash's logs to /home/work/zion_package/elastic/logstash/logstash-6.2.2/logs which is now configured via log4j2.properties h[2018-03-14T14:48:00,053][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"fb_apache", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/fb_apache/configuration"} [2018-03-14T14:48:00,074][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"netflow", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/netflow/configuration"} [2018-03-14T14:48:00,172][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/queue"} [2018-03-14T14:48:00,178][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.dead_letter_queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/dead_letter_queue"} [2018-03-14T14:48:00,631][WARN ][logstash.config.source.multilocal] Ignoring the 'pipelines.yml' file because modules or command line options are specified [2018-03-14T14:48:00,672][INFO ][logstash.agent ] No persistent UUID file found. Generating new UUID {:uuid=>"5901ab9f-fdc9-43dc-a88d-c5c636cf8224", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/uuid"} [2018-03-14T14:48:01,337][INFO ][logstash.runner ] Starting Logstash {"logstash.version"=>"6.2.2"} [2018-03-14T14:48:01,733][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600} [2018-03-14T14:48:03,264][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T14:48:03,453][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x128244e5 run>"} The stdin plugin is now waiting for input: [2018-03-14T14:48:03,546][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 在控制台随便输入字符串按回车后,发现消息会立刻在控制台输出,此时pipeline的处理过程是从stdin接收我们的输入,然后再在stdout输出: Hello, this is my first event to logstash ! 2018-03-14T06:50:26.261Z yf-beidou-dmp00.yf01.baidu.com Hello, this is my first event to logstash ! logstash会给消息添加ip和时间戳,要退出logstash,输入ctrl+d; 通过Filebeat发送日志到logstash 配置Filebeat Filebeat用于追踪服务器上的文件数据,它的设计以可靠和低资源占用为初衷,和业务系统部署在一起时,能够避免因为资源消耗影响到业务系统的正常运行。logstash安装后默认包含Beats input组件,用于接收各种beat组件上报事件。Filebeat也可以直接上报事件给elasticsearch,而不用经过logstash。 1)下载文件样例logstash-tutorial.log.gz,上传至Filebeat将要部署的服务器并解压;该样例为官方文档提供的apache的web日志样例。2)下载Filebeat,上传服务器并解压;此处下载LINUX 64-BIT的安装包; tar -zxvf filebeat-6.2.2-linux-x86_64.tar.gz cd filebeat-6.2.2-linux-x86_64 3)配置Filebeat,修改filebeat.yml,设置监控日志文件路径和上报logstash地址; filebeat.prospectors: - type: log # 监控日志文件路径 paths: - /path/to/file/logstash-tutorial.log output.logstash: # 上报logstash地址 hosts: ["localhost:5044"] 注:设置监控日志文件的路径一定是绝对路径,支持通配符; 4)启动Filebeat;其中-e参数指定输出日志到stderr,而非输出到日志文件;-c参数指定配置文件路径;-d参数debug选择器; ./filebeat -e -c filebeat.yml -d "publish" 配置logstash 1)创建pipeline配置文件;pipeline配置格式如下: # The # character at the beginning of a line indicates a comment. Use # comments to describe your configuration. input { } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { } 创建一个名为first-pipeline.conf的文件,配置如下: input { beats { # 设置beats上报端口 port => "5044" } } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { # 输出到stdout,同时指定日志解码器为rubydebug stdout { codec => rubydebug } } 2)校验配置是否正确,命令如下。--config.test_and_exit选项会校验配置文件,并输出错误; bin/logstash -f first-pipeline.conf --config.test_and_exit 输出类似如下日志,说明配置文件格式校验通过: Configuration OK [2018-03-14T16:23:08,919][INFO ][logstash.runner ] Using config.test_and_exit mode. Config Validation Result: OK. Exiting Logstash 3)启动logstash,命令如下。--config.reload.automatic选项能够使得配置文件修改后被自动加载,从而避免重新启动logstash; bin/logstash -f first-pipeline.conf --config.reload.automatic 如果配置正确,可以看到logstash命令行有类似如下输出: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "offset" => 22310, "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "prospector" => { "type" => "log" }, "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "@timestamp" => 2018-03-14T08:43:52.564Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "@version" => "1" } 通过Grok过滤组件解析日志 通过上面的例子,我们可以将filebeat上报的日志经由logstash输出,接下来将添加filter组件,对日志进行处理。grok组件是logstash的filter组件之一,它可以将非结构化的数据按照一定规则整理成结构化数据,从而便于检索。这些规则需要根据日志格式事先设定好,因此需要了解采集日志的格式。因为我们的样例日志是apache的web日志,因而可以直接使用grok提供的%{COMBINEDAPACHELOG}格式进行日志的过滤,过滤后的日志格式如下: 修改first-pipeline.conf文件,增加filter,如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } } output { stdout { codec => rubydebug } } 因为启动logstash时添加了--config.reload.automatic选项,logstash能够自动加载修改后的配置文件,因而不需要重启;修改保存后可以看到重新加载配置,重启pipeline的日志: [2018-03-14T17:04:57,325][INFO ][logstash.pipelineaction.reload] Reloading pipeline {"pipeline.id"=>:main} [2018-03-14T17:05:01,758][INFO ][logstash.pipeline ] Pipeline has terminated {:pipeline_id=>"main", :thread=>"#<Thread:0x58f295b9 run>"} [2018-03-14T17:05:02,048][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T17:05:02,362][INFO ][logstash.inputs.beats ] Beats inputs: Starting input listener {:address=>"0.0.0.0:5044"} [2018-03-14T17:05:02,422][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x5506295b sleep>"} [2018-03-14T17:05:02,429][INFO ][org.logstash.beats.Server] Starting server on port: 5044 [2018-03-14T17:05:02,453][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 为了能够使filebeat重新读取文件,需要停止filebeat,删除读取文件的保存点记录,并重启filebeat: cd filebeat-6.2.2-linux-x86_64 rm data/registry 添加filter后,输出的日志格式如下,发现不仅输出了日志原文,同时对日志进行解析切割,存放到相应的字段中。 { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "121.107.188.202", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "121.107.188.202 - - [04/Jan/2015:05:27:57 +0000] \"GET /presentations/logstash-monitorama-2013/images/kibana-dashboard3.png HTTP/1.1\" 200 171717 \"-\" \"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "171717", "ident" => "-", "@version" => "1", "request" => "/presentations/logstash-monitorama-2013/images/kibana-dashboard3.png", "offset" => 21927, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:06:47.927Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:27:57 +0000", "agent" => "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "referrer" => "\"-\"" } 使用Geoip过滤器组件增强数据处理 geoip也是filter组件的一种,用于从ip地址中解析出位置信息,并添加到输出日志中;geoip需要配置需要指定存放ip地址的字段,在本例中,我们使用通过gork解析后clientip字段;因为过滤器是按顺序过滤,所以需要确保geoip的过滤器在之前配置的gork过滤器之后,配置文件如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { # 指定要进行ip解析的字段 source => "clientip" } } output { stdout { codec => rubydebug } } 停止filebeat,删除data/registry文件,重启filebeats后再次查看日志,发现新增了地理位置信息: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "218.30.103.62", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "10975", "ident" => "-", "@version" => "1", "request" => "/blog/geekery/xvfb-firefox.html", "geoip" => { "location" => { "lat" => 39.9289, "lon" => 116.3883 }, "latitude" => 39.9289, "continent_code" => "AS", "region_code" => "11", "country_code3" => "CN", "country_code2" => "CN", "longitude" => 116.3883, "city_name" => "Beijing", "country_name" => "China", "ip" => "218.30.103.62", "region_name" => "Beijing", "timezone" => "Asia/Shanghai" }, "offset" => 22310, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:22:31.299Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:28:43 +0000", "agent" => "\"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "referrer" => "\"-\"" } 将logstash数据输出到elasticsearch 1)修改output,写入数据到elasticsearch:修改first-pipeline.conf文件,配置elasticsearch访问地址; input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { source => "clientip" } } output { elasticsearch { # 指定elasticsearch地址,指定多个地址,logstash会自动负载均衡 hosts => [ "ip1:port1", "ip2,port2" ] # 如果设置用户名和密码,则需要指定如下两个字段; # 用户必须具有对index的CRUD权限; user => "username" password => "password" } } 2)重新发送消息:停止filebeat,删除data/registry文件,重启filebeats;3)检索日志:执行如下语句,查询是否有日志写入elasticsearch,ip和端口是elasticsearch实例的ip和端口;因为first-pipeline.conf中未指定创建index的名称格式,默认为:logstash-yyyy.MM.dd(日期部分需要替换);如果未指定用户名/密码,则不需要-u参数; curl -XGET 'ip:port/logstash-2018.03.14/_search?pretty&q=response=200' -u username:password 检索结果类似如下json串: { "took" : 20, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : 98, "max_score" : 2.3988724, "hits" : [ { "_index" : "logstash-2018.03.14", "_type" : "doc", "_id" : "t76VJGIBe9U4s2F_OL_W", "_score" : 2.3988724, "_source" : { "verb" : "GET", "@timestamp" : "2018-03-14T12:56:19.779Z", "response" : "200", "agent" : "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.77 Safari/537.36\"", "source" : "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "host" : "yf-beidou-dmp00.yf01.baidu.com", "auth" : "-", "clientip" : "83.149.9.216", "geoip" : { "country_code3" : "RU", "continent_code" : "EU", "ip" : "83.149.9.216", ... ... 4)在kibana上配置index-pattern,通过Discover检索日志:点击菜单:Management -> Index Pattern; 点击 Create Index Pattern,创建index pattern; 点击菜单:Discover,检索日志; 参考 官方视频:Getting Started with Logstash官方文档:Getting Started with Logstash

优秀的个人博客,低调大师

Elastic Stack学习--Kibana部署

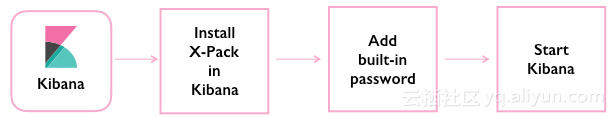
Kibana是一个开源的用于elasticsearch的数据分析可视化平台。Kibana以可视化界面的方式对elasticsearch的索引进行检索、查看、更新等,并提供丰富的图表展现。Kibana基于Node.js实现,因而需要有Node.js运行环境。Node.js环境依赖于glibc2.4以上版本,故如果操作系统版本过低,可能无法支持,安装时一定先更新操作系统或者glibc库。 Kibana部署 1)下载kibana安装包,我们在linux环境安装,下载tar包;2)上传tar包到服务器,解压并进入根目录; tar -xzf kibana-6.2.2-linux-x86_64.tar.gz cd kibana-6.2.2-linux-x86_64/ 3)执行如下命令,启动kibana: ./bin/kibana 默认情况下,以前台进程方式启动kibana,并输出日志到stdout;通过ctrl+c或者ctrl+z结束进程; Kibana目录结构 home:kibana的根目录,即$KIBANA_HOME变量指向的目录;默认为安装包解压后的路径; bin:kibana的二进制文件所在目录,比如:kibana用于启动进程,kibana-plugin用于安装插件;默认为:$KIBANA_HOMEbin config:kibana的配置文件目录,核心配置文件为kibana.yml,默认路径:$KIBANA_HOMEconfig; data:kibana及其插件数据文件存放目录,默认为:$KIBANA_HOMEdata; optimize:存放优化后源代码,默认$KIBANA_HOMEoptimize; plugins:插件安装目录,每个插件都对应一个子目录;默认$KIBANA_HOMEplugins; 配置kibana Kibana的配置基于kebana.yml文件,默认绑定localhost:5601启动。常用配置项如下: console.enabled(true) 是否允许控制台方式访问kibana; server.port(5601) 和 server.host(localhost) 配置服务器端口和地址;服务器地址默认为localhost,无法被外网访问; server.basePath("") kibana的访问地址根目录,类似于tomcat的rootPath; server.maxPayloadBytes(1048576) 请求允许的最大长度,默认为1M; server.name(hostname) kibana的名字,为展示使用,默认为所在物理机的hostname; elasticsearch.url(http://localhost:9200) kibana要访问elasticsearch的地址; kibana.index(.kibana) kibana会在elasticsearch上创建一个索引用于存放kibana保存的检索信息、创建的视图信息以及dashboard等信息;该配置指定存放的索引名称; pid.file(/var/run/kibana.pid) 指定kibana进程的pid文件路径; logging.dest(stdout) 指定kibana的日志输出路径; 输出日志级别设置 logging.silent(false),设置不输出任何日志; logging.quiet(false),设置只输出error日志; logging.verbose(false),设置输出详细日志,包括系统调用信息以及所有请求日志; Kibana安装X-Pack x-pack的安装顺序如下图: 1)下载x-pack安装包,如果部署elasticsearch时已经下载,则直接使用即可,下载地址: https://artifacts.elastic.co/downloads/packs/x-pack/x-pack-6.2.2.zip2)执行安装命令: bin/kibana-plugin install file:///path/to/file/x-pack-6.2.2.zip 注:此处的安装包路径一定是绝对路径,直接使用压缩包安装即可,无需解压;格式类似:file://路径 安装成功后,日志类似如下: urrent workdir: /home/work/fzx/kibana/kibana-6.2.2-linux-x86_64 Attempting to transfer from file:///home/work/fzx/kibana/x-pack-6.2.2.zip Transferring 314129017 bytes.................... Transfer complete Retrieving metadata from plugin archive Extracting plugin archive Extraction complete Optimizing and caching browser bundles... Plugin installation complete 3)设置elastic内置用户名和密码,一定要和elasticsearch的bin/x-pack/setup-passwords命令所设密码相同: elasticsearch.username: "elastic" elasticsearch.password: "elasticpassword" 注:一定要使用内置用户elastic的用户名和密码;否则会出现认证失败的情况,kibana、logstash_system用户所给权限不足,无法对索引进行CRUD操作; 4)重启kibana,通过浏览器访问kibana地址,使用内置用户elastic和密码登录; http://ip:port 登录后如下图: 坑 [security_exception] action [indices:admin/mappings/get] is unauthorized for user [kibana] 登录kibana后,报错如下图: 解决办法:配置kibana.yml中elasticsearch的用户名和密码错误,应该使用elastic用户而非kibana用户,kibana、logstash_system用户所给权限不足,无法对索引进行CRUD操作; kibana报503错误,elasticsearch日志报错:org.elasticsearch.indices.InvalidIndexTemplateException org.elasticsearch.indices.InvalidIndexTemplateException: index_template [kibana_index_template:.Elasticsearch-DEV-Kibana] invalid, cause [Validation Failed: 1: name must be lower cased;] at org.elasticsearch.cluster.metadata.MetaDataIndexTemplateService.validate(MetaDataIndexTemplateService.java:310) ~[elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.cluster.metadata.MetaDataIndexTemplateService.putTemplate(MetaDataIndexTemplateService.java:147) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.admin.indices.template.put.TransportPutIndexTemplateAction.masterOperation(TransportPutIndexTemplateAction.java:81) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.admin.indices.template.put.TransportPutIndexTemplateAction.masterOperation(TransportPutIndexTemplateAction.java:42) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.masterOperation(TransportMasterNodeAction.java:88) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction$2.doRun(TransportMasterNodeAction.java:167) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.common.util.concurrent.AbstractRunnable.run(AbstractRunnable.java:37) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.common.util.concurrent.EsExecutors$1.execute(EsExecutors.java:135) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction.doStart(TransportMasterNodeAction.java:164) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction.start(TransportMasterNodeAction.java:127) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.doExecute(TransportMasterNodeAction.java:105) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.doExecute(TransportMasterNodeAction.java:55) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.TransportAction$RequestFilterChain.proceed(TransportAction.java:167) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter.lambda$apply$0(SecurityActionFilter.java:103) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter $$ Lambda$2377/976841642.accept(Unknown Source) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.action.ActionListener$1.onResponse(ActionListener.java:60) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter.lambda$authorizeRequest$4(SecurityActionFilter.java:188) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter $$ Lambda$2387/1116948127.accept(Unknown Source) [x-pack-security-6.2.2.jar:6.2.2] 解决办法:kibana.yml中kibana.index指定的索引必须全部使用小写字母,否则报错; 参考 Configuring KibanaInstalling X-Pack in Kibana

优秀的个人博客,低调大师

《ELK Stack权威指南 》导读

目 录Contents 前 言 第一部分 Logstash 第1章 入门示例 1.1 下载安装 1.2 Hello World 1.3 配置语法 1.3.1 语法 1.3.2 命令行参数 1.3.3 设置文件示例 1.4 插件安装 1.5 长期运行方式 第2章 插件配置 2.1 输入插件 2.1.1 标准输入 2.1.2 文件输入 2.1.3 TCP输入 2.1.4 syslog输入 2.1.5 http_poller抓取 2.2 编解码配置 2.2.1 JSON编解码 2.2.2 多行事件编码 2.2.3 网络流编码 2.2.4 collectd输入 2.3 过滤器配置 2.3.1 date时间处理 2.3.2 grok正则捕获 2.3.3 dissect解析 2.3.4 GeoIP地址查询 2.3.5 JSON编解码 2.3.6 key-value切分 2.3.7 metrics数值统计 2.3.8 mutate数据修改 2.3.9 随心所欲的Ruby处理 2.3.10 split拆分事件 2.3.11 交叉日志合并 2.4 输出插件 2.4.1 输出到Elasticsearch 2.4.2 发送email 2.4.3 调用系统命令执行 2.4.4 保存成文件 2.4.5 报警发送到Nagios 2.4.6 statsd 2.4.7 标准输出stdout 2.4.8 TCP发送数据 2.4.9 输出到HDFS 第3章 场景示例 3.1 Nginx访问日志 3.1.1 grok处理方式 3.1.2 split处理方式 3.1.3 JSON格式 3.1.4 syslog方式发送 3.2 Nginx错误日志 3.3 Postfix日志 3.4 Ossec日志 3.4.1 配置所有Ossec agent采用syslog输出 3.4.2 配置Logstash 3.4.3 推荐Kibana仪表盘 3.5 Windows系统日志 3.5.1 采集端配置 3.5.2 接收解析端配置 3.6 Java日志 3.6.1 Log4J配置 3.6.2 Logstash配置 3.6.3 异常堆栈测试验证 3.6.4 JSON Event layout 3.7 MySQL慢查询日志 3.8 Docker日志 3.8.1 记录到主机磁盘 3.8.2 通过logspout收集

优秀的个人博客,低调大师

ELK Stack之Shield介绍

打开微信扫一扫,关注微信公众号【数据与算法联盟】 转载请注明出处: http://blog.csdn.net/gamer_gyt 博主微博: http://weibo.com/234654758 Github: https://github.com/thinkgamer 写在前边的话 elk是日志分析的利器,但是就elk本身而言室友一个弊端的那就是任何人都可以访问和操作,权限的管理方面似乎是一个空白,但是幸好elastic公司对其有辅助的产品Shield,Shield是一个收费的项目,但幸好有一个月的试用期,那么接下来我们就来玩玩这个shield Shield简介 Shield是Elastic公司官方发布的权限管理产品。其主要特性包括: 提供集群节点身份验证和集群数据访问身份验证 提供基于身份角色的细粒度资源和行为访问控制,细到索引级别的读写控制 提供节点间数据传输通道加密保护输出传输安全 提供审计功能 以插件的形式发布 基本部署 1:Elasticsearch安装shield 2.4.0插件,最基本的用户验证 先决条件: Java version >= java 7 Elasticsearch 2.4 Elasticsearch liscense 2.4.0 plugin 在线安装: 终端进入elasticsearch的根目录,此时要注意 以elasticsearch所属用户进行安装,同时注意elastic所属的用户组,若是属于root用户组,在安装时会报错提示没有权限 bin/plugin install license bin/plugin install shield 这里默认安装的是最新版本 离线安装: 下载需要的licese和shield包 https://download.elastic.co/elasticsearch/release/org/elasticsearch/plugin/license/2.4.0/license-2.4.0.zip(sha1) https://download.elastic.co/elasticsearch/release/org/elasticsearch/plugin/shield/2.4.0/shield-2.4.0.zip(sha1) 放在一个path下(eg:/opt/shield/),不要把zip包放在elasticsearch的plugins目录 然后执行安装命令(网友的说法是:这里的目录是绝对路径,不能写成相对路径): bin/plugin install /opt/shield/license-2.4.0.zip bin/plugin install /opt/shield/shield-2.4.0.zip 版本升级: 版本升级相对比较简单,只需要把原先的版本给remove掉,然后install就ok,因为卸载时shield会保留其配置 bin/plugin remove shield bin/plugin install shield 卸载: bin/plugin remove shield 之后重启elasticsearch即可 2:shield在elasticsearch上的验证 当安装完shield后,启动elasticsearch 执行 curl -X GET http://localhost:9200 会爆出以下error {"error":{"root_cause":[{"type":"security_exception","reason":"missing authentication token for REST request [/]","header":{"WWW-Authenticate":"Basic realm=\"shield\" charset=\"UTF-8\""}}],"type":"security_exception","reason":"missing authentication token for REST request [/]","header":{"WWW-Authenticate":"Basic realm=\"shie 因为shield已经起作用了,当然你也可以通过web访问http://localhost:920 我的是win10 的Edge跳出弹出框: 创建用户: 我们可以在shell终端中创建一个es_admin的用户(在es的根目录下执行) bin/shield/esusers useradd es_admin -r admin es_admin 为用户名,-r 表示指定的角色为admin PS:我们可以使用以下命令查看帮助 bin/shield/esusers -h 登录验证: 我们可以在web弹出的输入框输入账号和密码进行登录查看数据,也可以使用下面的这条命令进行验证 es_admin 是用户名,elasticsearch是我es_admin对应的密码 master@ubuntu:/opt/elk/elasticsearch-2.4.0$ curl -u es_admin:elasticsearch -X GET http://localhost:9200 { "name" : "Mauvais", "cluster_name" : "elasticsearch", "version" : { "number" : "2.4.0", "build_hash" : "ce9f0c7394dee074091dd1bc4e9469251181fc55", "build_timestamp" : "2016-08-29T09:14:17Z", "build_snapshot" : false, "lucene_version" : "5.5.2" }, "tagline" : "You Know, for Search" } 至此shield在elasticsearch上的简单部署已经完成 3:shield在Logstash中的应用 首先我们创建一个logstash用户,用于logstash访问elasticsearch 同样在elasticsearch的根目录下执行创建命令: master@ubuntu:/opt/elk/elasticsearch-2.4.0$ bin/shield/esusers useradd logstash -r logstash Enter new password: Retype new password: 然后当我们编写**.conf文件时,在output中加入 output{ ... elasticsearch{ .... user => "logstash" password => "logstash" } } 4:shield在kibana中的应用 kibana的配置相对比较麻烦,我会在下一篇博客中集合具体的实例讲解: http://blog.csdn.net/gamer_gyt/article/details/52896522 Shield的工作原理 Shield作为插件安装到elasticsearch中,一旦安装,插件会拦截入栈API调用,以强制执行身份验证和授权,插件还可以使用Secure Sockets Layer/Transport Layer Security (SSL/TLS)为来自网络和elasticsearch的网络流量提供加密,该插件还是用API拦截层,该层使身份验证和授权能够提供审计日志记录功能。 1:用户验证 Shield已经定义了一组用户,以便对发出请求的用户进行身份验证,这组用户集合通过一个称为realm来定义,realm是配置为使用shield插件的用户数据库,native, file, LDAP, Active Directory, PKI支持 realm 在native realm中,用户将与Elasticsearch集群一起存储和分发。对于native realm,管理员使用API​​管理用户进行用户管理,所有用户操作都发生在Elasticsearch集群中。用户使用用户名和密码对进行身份验证。 在 file realm中,用户保存与存储在Elasticsearch集群的每个节点上的文件中。使用file realm,管理员使用Elasticsearch提供的工具管理用户,所有用户操作都发生在Elasticsearch集群中。用户使用用户名和密码对进行身份验证。 在LDAP realm中,管理员使用LDAP供应商提供的工具管理用户。Elasticsearch通过访问配置的LDAP服务器来验证用户。用户使用用户名和密码对进行身份验证。Shield还支持将LDAP组映射到Shield中的角色。 在Active realm中,管理员在Active Directory中管理用户。Elasticsearch使用LDAP协议向Active Directory验证用户。用户使用用户名和密码对进行身份验证。Shield还支持将Active Directory安全组映射到Shield中的角色。 在PKI realm,管理员使用X.509证书管理工具管理用户。 Elasticsearch通过验证用户的X.509证书已由可信的授权方签名来验证用户。用户通过在TLS通信期间显示其PKI证书进行身份验证,Shield会将主题映射到适当的角色 您的应用程序可以是Shield领域中的用户。 Elasticsearch客户端通过为每个请求提供用户名和密码对(a.k.a身份验证令牌)来对集群进行身份验证。 shield定义的用户规则的路径为 ES_HOME/config/shield/roles.yml # All cluster rights # All operations on all indices admin: cluster: - all indices: - names: '*' privileges: - all # monitoring cluster privileges # All operations on all indices power_user: cluster: - monitor indices: - names: '*' privileges: - all # Read-only operations on indices user: indices: - names: '*' privileges: - read # Defines the required permissions for transport clients transport_client: cluster: - transport_client # The required permissions for the kibana 4 server kibana4_server: cluster: - monitor indices: - names: '.kibana*' privileges: - all - names: '.reporting-*' privileges: - all # The required role for logstash users logstash: cluster: - manage_index_templates indices: - names: 'logstash-*' privileges: - write - read - create_index # Marvel user role. Assign to marvel users. marvel_user: indices: - names: '.marvel-es-*' privileges: [ "read" ] - names: '.kibana' privileges: - view_index_metadata - read # Marvel remote agent role. Assign to the agent user on the remote marvel cluster # to which the marvel agent will export all its data remote_marvel_agent: cluster: [ "manage_index_templates" ] indices: - names: '.marvel-es-*' privileges: [ "all" ] 2:授权规则 Shield的行动授权数据包含以下元素: Secured Resource :定义资源的安全特权,包括集群索引/别名,或一组指标/集群中的别名 Privilege:用户可以针对安全资源执行的一个或多个动作。 这包括命名的动作组(例如读取)或设置特定动作(例如,索引:/ data / read / percolate) Permissions:针对安全资源的一个或者多个特权(eg:在索引“products”上的read) Role:命名的特权集 Users:可以分配零个或多个角色的实体,授权他们对其角色并集中描述的安全资源执行操作 安全的Elasticsearch集群通过角色管理用户的权限。 角色具有唯一的名称,并标识一组权限,这些权限转换为资源上的权限。 用户可以具有任意数量的角色。 有两种类型的权限:集群和索引。 用户具有的总权限集由所有角色中的权限的并集来定义。根据使用的领域,Shield提供了向用户分配角色的适当方法。 3:节点认证与信道加密

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册