首页 文章 精选 留言 我的

精选列表

搜索[science],共578篇文章
优秀的个人博客,低调大师

Data Science | Numpy基础(二)

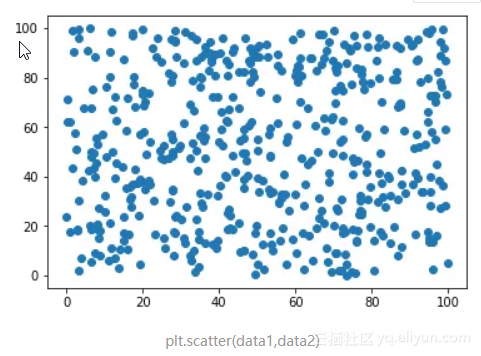
Anaconda的基本用法 按照上篇文章,相信大家都安装好了Anaconda,有朋友在留言区留言希望出一篇关于Anaconda的使用教程,其实Anaconda的基本使用非常简单,基本无需教程。 在windows下安装好Anaconda后,在所有程序中可以看到Anaconda下有以下几个组件: Anaconda Navigator:用于管理工具包和环境的图形界面。 Anaconda Prompt:用于管理包和环境的命令行界面。 Jupyter Notebook:基于Web的交互式计算环境,用于展示数据分析的过程,并且生成容易阅读的文档。 Spyder:Python集成开发环境,布局类似于Matlab。 我们学习主要使用的是第三个Jupyter Notebook。 这里简单普及一下常用的Anaconda命令(虽然我也不经常用)。 查看软件版本号 python--version#查看Python版本 conda--version#查看conda的版 添加镜像 condaconfig--addchannelshttps://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/ 更新conda condaupgrade--all 查看已经安装的packages condalist condainstall[packagename]#安装package,安装在默认的Python环境中 新手入门建议只安装Anaconda,可以省去很多不必要的麻烦,以上就是Anaconda的基本使用,欢迎大家在留言区补充。 Numpy索引及切片 纠正下上一篇的错误: #正确的导入方式importnumpyasnp numpy的索引方式和Python中的列表索引相似,这里主要介绍普通数组索引/切片和布尔型数组的索引/切片。 一维数组的索引/切片 一维数组的索引和切片和Python中的列表相同,索引都是从0开始,切片都是左闭右开。 importnumpyasnp ar=np.arange(20)#输出ar的第4个值 print(ar[3])#输出ar的前四个值 print(ar[:4]) >>>4 [0123] 多维数组的索引/切片 二维数组可以理解为两个一维数组横向堆叠在一起,所只要分别取对应索引即可。 importnumpyasnp ar=np.arange(16).reshape(4,4)#二维数组索引遵照先行后列(有以下两种写法)#选取第二行第二列的值 print(ar[2][2]) print(ar[2,2])#二维数组切片#取出前两行的值 print(ar[:2])#取出前两行后两列的值 print(ar[:2,2:]) >>> [[0123] [4567] [891011] [12131415]]1010 [[0123] [4567]] [[23] [67]] 三位数组的索引、切片的取值方式相当与二维数组的进化版。 importnumpyasnp ar=np.arange(12).reshape(3,2,2) print(ar)#三维数组索引遵照先维度后行再列 print(ar[2][0][1]) print(ar[2,0,1])#切片#获取第一个数组的第一行的第一列的数 print(ar[:1,:1,:1]) >>> [[[01] [23]] [[45] [67]] [[89] [1011]]] [[[0]]]99 布尔型的索引及切片 布尔型数组的使用是本片文章的重点。 #简单展示一下布尔型的一维数组长啥样 i=np.array([True,False,True]) j=np.array([True,True,False,False]) print(i) print(j) >>> [TrueFalseTrue] [TrueTrueFalseFalse] 而我们经常见到的是这样的: ar=np.arange(12).reshape(3,4) print(ar) print(ar>5) >>> [[0123] [4567] [891011]] [[FalseFalseFalseFalse] [FalseFalseTrueTrue] [TrueTrueTrueTrue]] 当我们需要筛选出ar中大于3的值,就可以使用布尔值进行筛选,如下: ar=np.arange(12).reshape(3,4) print(ar[ar>3]) >>> [4567891011] Numpy随机数 均匀分布和正态分布 以均匀分布和正态分布的方式生成随机数 #numpy.random.rand()生成一个0-1的随机浮点数或N维浮点数--均匀分布 a=np.random.rand() b=np.random.rand(4,4) print(a) print(b) >>>0.5544023939180306 [[0.463876480.973458760.120591750.7565951] [0.301929960.766332080.201077610.09315875] [0.793471180.267144040.086281580.72510313] [0.066060870.932600380.902682010.90941348]] 以正太分布的方式生成随机数 #numpy.random.randn()生成一个0-1的随机浮点数或N维浮点数--正态分布 a=np.random.randn() b=np.random.randn(4,4) print(a) print(b) >>> 0.26901442604096687 [[0.40261375-0.235411840.96607489-1.11253043] [-0.316707030.05841136-0.018625111.72597729] [0.170527991.03537825-0.943754171.32484928] [0.1327610.449505330.44131534-0.11319535]] 按照上面的写法相信大家对与.randn()和.rand()的认识还不够清晰,这里用可视化的方式展示一下: #平均分布#numpy.random.rand()生成一个0-1的随机浮点数或N维浮点数--均匀分布 data1=np.random.rand(500) data2=np.random.rand(500)#正态分布#numpy.random.randn()生成一个浮点数或N维浮点数--正态分布 data3=np.random.randn(500) data4=np.random.randn(500)importmatplotlib.pyplotasplt %matplotlibinline plt.scatter(data1,data2) plt.scatter(data3,data4) 这是随机分布的图样: 这是正态分布的图样: 可以看到正态分布和随机分布的成像还是有较大不同的,当然这里只是加深大家对.randn()和.rand()的认识,可视化在之后会进一步学习。 Numpy随机数的其他用法 #随机整数 print(np.random.randint(2))#在2-10之间生成随机整数 print((np.random.randint(2,10)))#在0-10之间生成10个整数 print((np.random.randint(10,size=10)))#在0-10之间生成包含10个元素的二维数组 print(np.random.randint(10,size=(2,5)))#在10-50之间生成包含10个元素的二维数组 print(np.random.randint(10,50,size=(2,5))) 原文发布时间为:2018-10-09 本文作者:煌金的咸鱼 本文来自云栖社区合作伙伴“咸鱼普拉思”,了解相关信息可以关注“咸鱼普拉思”。
优秀的个人博客,低调大师

Data Science | 时间序列的索引与切片

时间序列的索引与切片索引时间序列的索引方法同样是适用于Dataframe,而且在时间序列中由于按照时间先后排序,故不用考虑顺序问题。 基本位置索引,使用的方法和列表类似: from datetime import datetime rng = pd.date_range('2017/1','2017/3') ts = pd.Series(np.random.rand(len(rng)), index = rng) print(ts.head()) print(ts[0]) print(ts[:2]) >>> 2017-01-01 0.107736 2017-01-02 0.887981 2017-01-03 0.712862 2017-01-04 0.920021 2017-01-05 0.317863 Freq: D, dtype: float64 0.107735945027 2017-01-01 0.107736 2017-01-02 0.887981 Freq: D, dtype: float64 除了基本位置索引之外还有时间序列标签索引: from datetime import datetime rng = pd.date_range('2017/1','2017/3') ts = pd.Series(np.random.rand(len(rng)), index = rng) print(ts['2017/1/2']) print(ts['20170103']) print(ts['1/10/2017']) print(ts[datetime(2017,1,20)]) >>> 0.887980757812 0.712861778966 0.788336674948 0.93070380011 切片切片的使用操作在上面索引部分的基本位置索引中有提到和Series按照index索引原理一样,也是末端包含。 rng = pd.date_range('2017/1','2017/3',freq = '12H') ts = pd.Series(np.random.rand(len(rng)), index = rng) print(ts['2017/1/5':'2017/1/10']) >>> 2017-01-05 00:00:00 0.462085 2017-01-05 12:00:00 0.778637 2017-01-06 00:00:00 0.356306 2017-01-06 12:00:00 0.667964 2017-01-07 00:00:00 0.246857 2017-01-07 12:00:00 0.386956 2017-01-08 00:00:00 0.328203 2017-01-08 12:00:00 0.260853 2017-01-09 00:00:00 0.224920 2017-01-09 12:00:00 0.397457 2017-01-10 00:00:00 0.158729 2017-01-10 12:00:00 0.501266 Freq: 12H, dtype: float64 # 在这里我们可以传入月份可以直接获取整个月份的切片 print(ts['2017/2'].head()) >>> 2017-02-01 00:00:00 0.243932 2017-02-01 12:00:00 0.220830 2017-02-02 00:00:00 0.896107 2017-02-02 12:00:00 0.476584 2017-02-03 00:00:00 0.515817 Freq: 12H, dtype: float64 重复索引的时间序列 dates = pd.DatetimeIndex(['1/1/2015','1/2/2015','1/3/2015','1/4/2015','1/1/2015','1/2/2015']) ts = pd.Series(np.random.rand(6), index = dates) print(ts) # 我们可以通过is_unique检查值或index是否重复 print(ts.is_unique,ts.index.is_unique) >>> 2015-01-01 0.300286 2015-01-02 0.603865 2015-01-03 0.017949 2015-01-04 0.026621 2015-01-01 0.791441 2015-01-02 0.526622 dtype: float64 True False 按照上面的结果,可以看出在上面的时间序列中,出现了index(ts.index.is_unique)重复但值(ts.is_unique)不重复的情况。 我们可以通过时间序列把重复索引对应的值取平均值来解决索引重复的问题: print(ts.groupby(level = 0).mean()) # 通过groupby做分组,重复的值这里用平均值处理 >>> 2015-01-01 0.545863 2015-01-02 0.565244 2015-01-03 0.017949 2015-01-04 0.026621 dtype: float64 原文发布时间为:2018-12-17本文作者: 煌金的咸鱼本文来自云栖社区合作伙伴“ 咸鱼普拉思”,了解相关信息可以关注“xianyuplus1995”微信公众号

优秀的个人博客,低调大师

书籍python科学工程介绍 Python for Science and Engineering - 2019

简介 本指南提供了快速而精辟的Python编程介绍。 作者精心开发了一种在任何科学和工程学科中使用Python的简洁方法,包含大量示例,实用提示和内部提示。 读者将会看到为什么Python是如此广泛吸引人的程序,并学习语法,数据结构,输入和输出,绘图,条件和循环,用户定义函数,曲线拟合,数值例程,动画和可视化的基础知识。 作者通过示例进行教学,并假设读者没有编程背景。 David J. Pine是纽约大学的银教授兼物理学教授,纽约大学Tandon工程学院化学与生物分子工程系主任。 他是美国物理学会和美国科学促进会(AAAS)的当选研究员,并且是古根海姆研究员。 参考资料 下载:https://itbooks.pipipan.com/fs/18113597-339374445 首发地址 https://www.jianshu.com/p/4e4

优秀的个人博客,低调大师

【Science特稿】中国成数据沙特,美国至多领先半年

在北京北部高楼林立的海淀区,两个20多岁的硬件工程师正在测试新的计算机芯片,这些芯片有朝一日可能使智能手机、机器人和自动驾驶汽车真正拥有智能。旁边,站着一个穿着法兰绒格子衬衫、温和的年轻人。今年34岁的计算机科学家,同时也是寒武纪科技的创始技术顾问陈云霁解释说,传统处理器在最近的人工智能(AI)研究热潮兴起几十年前被设计出来,它们在处理AI所需的大量数据时,“速度和效率都很低”。陈云霁说:“即使你有一个非常好的算法或应用程序”,如果不能在你的手机、汽车或电子设备上运行,它在日常生活中的用处还是有限,“我们的目标是改变一切生活。” 2012年,Google Brain识别猫的开创性项目,用到了16,000个微处理器内核来运行相关的算法。这一壮举被誉为深度学习的突破:在没有人类程序员的指导下,从庞大的训练数据集中寻找模式。一年之后,陈云

优秀的个人博客,低调大师

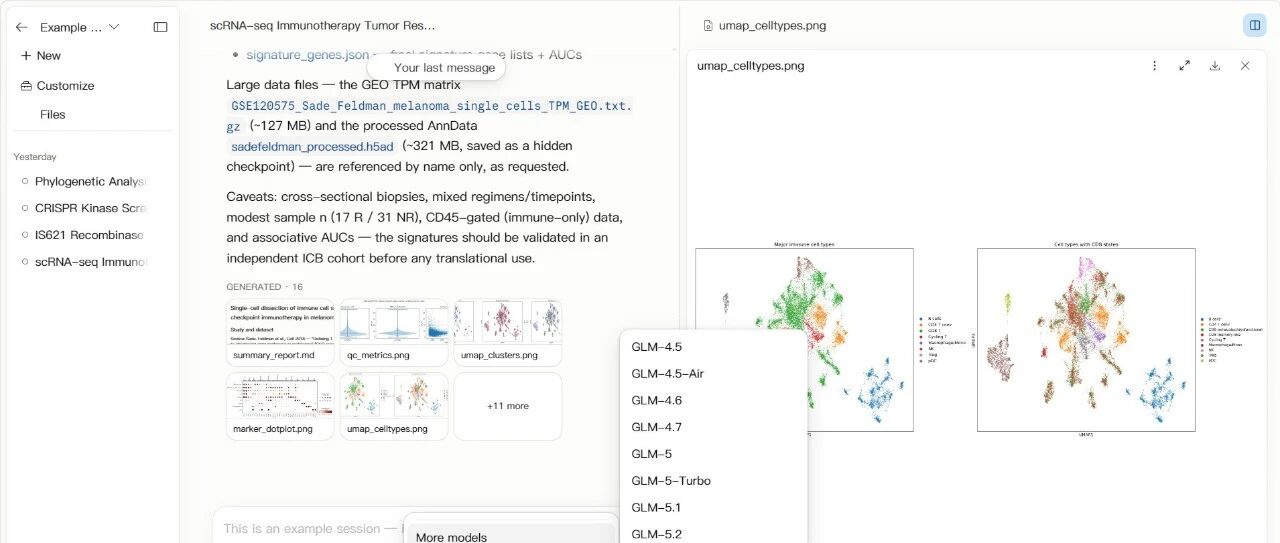
Open Science:把研究过程留在桌面,把证据留在结果身边

科研工作从来不只是提出一个问题,再等待一句答案。一个真正完整的研究过程,往往要在多个空间之间反复穿梭:聊天窗口里梳理思路,Notebook 中执行代码,本地脚本里处理数据,科学数据库中查找信息,文件浏览器里管理材料,报告工具中组织结果。每一次切换都可能带走一部分上下文,每一次复制粘贴都可能让过程变得难以回溯。

优秀的个人博客,低调大师

Science | 基于结构与进化信息设计最小化RNA引导核酸酶

RNA引导核酸酶是现代基因编辑技术的核心工具,其代表CRISPR-Cas系统已经彻底改变了生命科学研究。然而,目前几乎所有天然RNA引导核酸酶都受到长期生物进化的限制,在蛋白大小、结构组成以及催化性能方面存在天然边界。如何利用人工智能设计突破自然进化限制的新型RNA引导核酸酶,成为蛋白质设计领域的重要挑战。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册