阿里巴巴Java开发规约
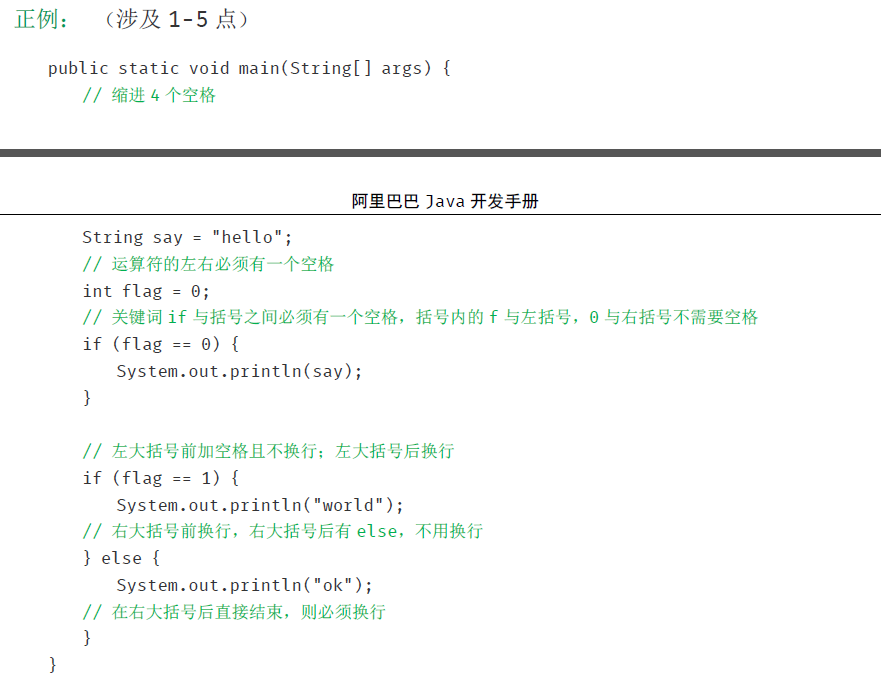
命名风格 【强制】代码中的命名均不能以下划线或美元符号开始,也不能以下划线或美元符号结束 【强制】代码中的命名严禁使用拼音与英文混合的方式,更不允许直接使用中文的方式。 说明:正确的英文拼写和语法可以让阅读者易于理解,避免歧义。注意,即使纯拼音命名方式也要避免采用。 【强制】类名使用UpperCamelCase风格,但以下情形例外:DO / BO / DTO / VO / AO / PO等。 正例:MarcoPolo / UserDO / XmlService / TcpUdpDeal / TaPromotion 反例:macroPolo / UserDo / XMLService / TCPUDPDeal / TAPromotion 分层领域模型规约: DO( Data Object):与数据库表结构一一对应,通过DAO层向上传输数据源对象。 DTO( Data Transfer Object):数据传输对象,Service或Manager向外传输的对象。 BO( Business Object):业务对象。 由Service层输出的封装业务逻辑的对象。 AO( Application Object):应用对象。 在Web层与Service层之间抽象的复用对象模型,极为贴近展示层,复用度不高。 VO( View Object):显示层对象,通常是Web向模板渲染引擎层传输的对象。 POJO( Plain Ordinary Java Object):在本手册中, POJO专指只有setter/getter/toString的简单类,包括DO/DTO/BO/VO等。 Query:数据查询对象,各层接收上层的查询请求。 注意超过2个参数的查询封装,禁止使用Map类来传输。 领域模型命名规约: 数据对象:xxxDO,xxx即为数据表名。 数据传输对象:xxxDTO,xxx为业务领域相关的名称。 展示对象:xxxVO,xxx一般为网页名称。 POJO是DO/DTO/BO/VO的统称,禁止命名成xxxPOJO。 【强制】方法名、参数名、成员变量、局部变量都统一使用lowerCamelCase风格,必须遵从驼峰形式。 正例: localValue / getHttpMessage() / inputUserId 【强制】常量命名全部大写,单词间用下划线隔开,力求语义表达完整清楚,不要嫌名字长。 正例:MAX_STOCK_COUNT 反例:MAX_COUNT 【强制】抽象类命名使用Abstract或Base开头;异常类命名使用Exception结尾;测试类命名以它要测试的类名开始,以Test结尾 【强制】类型与中括号紧挨相连来定义数组。 正例: 定义整形数组 int[] arrayDemo; int[] arrayDemo; 反例: 在 main 参数中,使用 String args[] 来定义 【强制】POJO(简单的Java对象,实际就是普通JavaBeans)类中布尔类型的变量,都不要加is前缀,否则部分框架解析会引起序列化错误。 反例:定义为基本数据类型Boolean isDeleted;的属性,它的方法也是isDeleted(),RPC 框架在反向解析的时候,“误以为”对应的属性名称是deleted,导致属性获取不到,进而抛出异常。 【强制】包名统一使用小写,点分隔符之间有且仅有一个自然语义的英语单词。包名统一使用单数形式,但是类名如果有复数含义,类名可以使用复数形式。 正例:应用工具类包名为com.alibaba.ai.util、类名为MessageUtils(此规则参考spring的框架结构) 【强制】杜绝完全不规范的缩写,避免望文不知义。 反例:AbstractClass“缩写”命名成AbsClass;condition“缩写”命名成 condi,此类随意缩写严重降低了代码的可阅读性。 【推荐】为了达到代码自解释的目标,任何定义编程元素在命名时使用尽量完整单词 组合来表达其意。 正例: 从远程 仓库 拉取代码的类 命名 为 PullCodeFromRemoteRepository 。 反例: 变量 int a; 的随意命名 方式。 【推荐】如果模块、接口、类、方法使用了设计模式,在命名时体现出具体模式,将设计模式体现在名字中,有利于阅读者快速理解架构设计理念 正例: public class OrderFactory; public class LoginProxy; public class ResourceObserver; 【推荐】接口类中的方法和属性不要加任何修饰符号(public 也不要加),保持代码的简洁性,并加上有效的Javadoc注释。尽量不要在接口里定义变量,如果一定要定义变量,肯定是与接口方法相关,并且是整个应用的基础常量。 正例:接口方法签名void f(); 接口基础常量String COMPANY = "alibaba"; 反例:接口方法定义public abstract void f(); 说明:JDK8中接口允许有默认实现,那么这个default方法,是对所有实现类都有价值的默认实现。 接口和实现类的命名有两套规则: 【强制】对于Service和DAO类,基于SOA的理念,暴露出来的服务一定是接口,内部的实现类用Impl的后缀与接口区别 正例:CacheServiceImpl实现CacheService接口。 【推荐】 如果是形容能力的接口名称,取对应的形容词为接口名(通常是–able的形式) 正例:AbstractTranslator实现 Translatable。 【参考】枚举类名建议带上Enum后缀,枚举成员名称需要全大写,单词间用下划线隔开。 说明:枚举其实就是特殊的常量类,且构造方法被默认强制是私有。 正例:枚举名字为ProcessStatusEnum的成员名称:SUCCESS / UNKNOWN_REASON。 【参考】各层命名规约: Service/DAO层方法命名规约 1) 获取单个对象的方法用get作前缀。 2) 获取多个对象的方法用list作前缀。 3) 获取统计值的方法用count作前缀。 4) 插入的方法用save/insert作前缀。 5) 删除的方法用remove/delete作前缀。 6) 修改的方法用update作前缀。 领域模型命名规约 1) 数据对象:xxxDO,xxx即为数据表名。 2) 数据传输对象:xxxDTO,xxx为业务领域相关的名称。 3) 展示对象:xxxVO,xxx一般为网页名称。 4) POJO是DO/DTO/BO/VO的统称,禁止命名成xxxPOJO。 常量定义 【强制】不允许任何魔法值(即未经预先定义的常量)直接出现在代码中。 反例:String key = "Id#taobao_" + tradeId; cache.put(key, value); 【强制】long或者Long初始赋值时,使用大写的L,不能是小写的l,小写容易跟数字1混淆,造成误解。 说明:Long a = 2l; 写的是数字的21,还是Long型的2? 【推荐】不要使用一个常量类维护所有常量,按常量功能进行归类,分开维护。 说明:大而全的常量类,非得使用查找功能才能定位到修改的常量,不利于理解和维护。 正例:缓存相关常量放在类CacheConsts下;系统配置相关常量放在类ConfigConsts下。 【推荐】如果变量值仅在一个固定范围内变化用enum类型来定义。 说明:如果存在名称之外的延伸属性使用enum类型,下面正例中的数字就是延伸信息,表示一年中的第几个季节。 正例: public enum SeasonEnum { SPRING(1), SUMMER(2), AUTUMN(3), WINTER(4); int seq; SeasonEnum(int seq){ this.seq = seq; } } 代码格式 【强制】大括号的使用约定。如果是大括号内为空,则简洁地写成{}即可,不需要换行;如果是非空代码块则: 左大括号前不换行。 左大括号后换行。 右大括号前换行。 右大括号后还有else等代码则不换行; 表示终止的右大括号后必须换行。 【强制】 左小括号和字符之间不出现空格;同样,右小括号和字符之间也不出现空格。详见第5条下方正例提示 【强制】if/for/while/switch/do等保留字与括号之间都必须加空格 【强制】任何二目、三目运算符的左右两边都需要加一个空格。 说明:运算符包括赋值运算符=、逻辑运算符&&、加减乘除符号等。 【强制】注释的双斜线与内容之间有且仅一个空格。 正例: // 这是示例注释,请注意在双斜线之后有一个空格 String ygb = new String(); 【强制】单行字符数限不超过 120 个,超出需要换行时 遵循如下原则: 第二行相对一缩进 4个空格,从第三行开始不再继续缩进参考示例。 运算符与下文一起换行。 方法调用的点符号与下文一起换行。 方法调用时,多个参数,需要换行时,在逗号后进行。 在括号前不要换行,见反例。 正例: StringBuffer sb = new StringBuffer(); // 超过120个字符的情况下,换行缩进4个空格,点号和方法名称一起换行 sb.append("zi").append("xin")... .append("huang")... .append("huang")... .append("huang"); 反例: StringBuffer sb = new StringBuffer(); // 超过120个字符的情况下,不要在括号前换行 sb.append("zi").append("xin")...append ("huang"); // 参数很多的方法调用可能超过120个字符,不要在逗号前换行 method(args1, args2, args3, ... , argsX); 【强制】方法参数在定义和传入时,多个参数逗号后边必须加空格。 正例:下例中实参的"a",后边必须要有一个空格。 method("a", "b", "c"); 【强制】IDE的text file encoding设置为UTF-8; IDE中文件的换行符使用Unix格式,不要使用Windows格式。 【推荐】没有必要增加若干空格来使某一行的字符与上一行对应位置的字符对齐。 正例: int a = 3; long b = 4L; float c = 5F; StringBuffer sb = new StringBuffer(); 说明:增加sb这个变量,如果需要对齐,则给a、b、c都要增加几个空格,在变量比较多的情况下,是非常累赘的事情。 【推荐】不同逻辑、不同语义、不同业务的代码之间插入一个空行分隔开来以提升可读性。 说明:没有必要插入多个空行进行隔开。 OOP规约 【强制】避免通过一个类的对象引用访问此类的静态变量或静态方法,无谓增加编译器解析成本,直接用类名来访问即可 【强制】所有的覆写方法,必须加@Override注解。 【强制】外部正在调用或者二方库依赖的接口,不允许修改方法签名,避免对接口调用方产生影响。接口过时必须加@Deprecated注解,并清晰地说明采用的新接口或者新服务是什么。 【强制】不能使用过时的类或方法。 【强制】Object的equals方法容易抛空指针异常,应使用常量或确定有值的对象来调用equals。 正例:"test".equals(object); 反例:object.equals("test"); 说明:推荐使用java.util.Objects#equals(JDK7引入的工具类) 【强制】所有的相同类型的包装类对象之间值的比较,全部使用equals方法比较。 说明: 对于Integer var = ? 在-128至127范围内的赋值,Integer对象是在IntegerCache.cache产生,会复用已有对象,这个区间内的Integer值可以直接使用==进行判断,但是这个区间之外的所有数据,都会在堆上产生,并不会复用已有对象,这是一个大坑,推荐使用equals方法进行判断。 【推荐】当一个类有多个构造方法,或者多个同名方法,这些方法应该按顺序放置在一起,便于阅读,此条规则优先于第15条规则。 【推荐】 类内方法定义的顺序依次是:公有方法或保护方法 > 私有方法 > getter/setter方法。 说明:公有方法是类的调用者和维护者最关心的方法,首屏展示最好;保护方法虽然只是子类关心,也可能是“模板设计模式”下的核心方法;而私有方法外部一般不需要特别关心,是一个黑盒实现;因为承载的信息价值较低,所有Service和DAO的getter/setter方法放在类体最后。 【推荐】setter方法中,参数名称与类成员变量名称一致,this.成员名 = 参数名。在getter/setter方法中,不要增加业务逻辑,增加排查问题的难度 【推荐】循环体内,字符串的连接方式,使用StringBuilder的append方法进行扩展。 说明:反编译出的字节码文件显示每次循环都会new出一个StringBuilder对象,然后进行append操作,最后通过toString方法返回String对象,造成内存资源浪费。 反例: String str = "start"; for (int i = 0; i < 100; i++) { str = str + "hello"; } 【推荐】类成员与方法访问控制从严: 控制语句 【强制】在一个switch块内,每个case要么通过break/return等来终止,要么注释说明程序将继续执行到哪一个case为止;在一个switch块内,都必须包含一个default语句并且放在最后,即使空代码。 【强制】在if/else/for/while/do语句中必须使用大括号。即使只有一行代码,避免采用 【强制】在高并发场景中,避免使用 ”等于 ”判断作为中或退出的条件。 判断作为中或退出的条件。 说明: 如果并发控制没有处理好,容易产生等值判断被 如果并发控制没有处理好,容易产生等值判断被 “击穿 ”的情况,使用大于或小区间 的情况,使用大于或小区间 的情况,使用大于或小区间 的情况,使用大于或小区间 判断条件来代替。 反例: 判断剩余奖品数量等于 0时,终止发放奖品但因为并处理错误导致数量瞬间变 时,终止发放奖品但因为并处理错误导致数量瞬间变 时,终止发放奖品但因为并处理错误导致数量瞬间变 成了负数, 这样的话,活动无法终止。 【推荐】表达异常的分支时,少用if-else方式,这种方式可以改写成 if (condition) { ... return obj; } // 接着写else的业务逻辑代码; 说明:如果非得使用if()...else if()...else...方式表达逻辑,【强制】避免后续代码维护困难,请勿超过3层。 【推荐】除常用方法(如getXxx/isXxx)等外,不要在条件判断中执行其它复杂的语句,将复杂逻辑判断的结果赋值给一个有意义的布尔变量名,以提高可读性。 说明:很多if语句内的逻辑相当复杂,阅读者需要分析条件表达式的最终结果,才能明确什么样的条件执行什么样的语句,那么,如果阅读者分析逻辑表达式错误呢? 正例: // 伪代码如下 final boolean existed = (file.open(fileName, "w") != null) && (...) || (...); if (existed) { ... } 反例: if ((file.open(fileName, "w") != null) && (...) || (...)) { ... } 【推荐】循环体中的语句要考量性能,以下操作尽量移至循环体外处理,如定义对象、变量、获取数据库连接,进行不必要的try-catch操作(这个try-catch是否可以移至循环体外)。 【推荐】避免采用取反逻辑运算符。 说明: 取反逻辑不利于快速理解,并且写法必然存在对应的正向。 正例: 使用 if (x < 628) if (x < 628) if (x < 628) 来表达 x 小于 628 。 反例: 使用 if (!(x >= 628)) if (!(x >= 628)) if (!(x >= 628)) 来表达 x 小于 628 。 【参考】下列情形,需要进行参数校验: 调用频次低的方法。 执行时间开销很大的方法。此情形中,参数校验时间几乎可以忽略不计,但如果因为参数错误导致中间执行回退,或者错误,那得不偿失。 需要极高稳定性和可用性的方法。 对外提供的开放接口,不管是RPC/API/HTTP接口。 敏感权限入口。 【参考】下列情形,不需要进行参数校验: 极有可能被循环调用的方法。但在方法说明里必须注明外部参数检查要求。 底层调用频度比较高的方法。毕竟是像纯净水过滤的最后一道,参数错误不太可能到底层才会暴露问题。一般DAO层与Service层都在同一个应用中,部署在同一台服务器中,所以DAO的参数校验,可以省略。 被声明成private只会被自己代码所调用的方法,如果能够确定调用方法的代码传入参数已经做过检查或者肯定不会有问题,此时可以不校验参数 注释规约 【强制】类、类属性、类方法的注释必须使用Javadoc规范,使用/*内容/格式,不得使用// xxx方式。 说明:在IDE编辑窗口中,Javadoc方式会提示相关注释,生成Javadoc可以正确输出相应注释;在IDE中,工程调用方法时,不进入方法即可悬浮提示方法、参数、返回值的意义,提高阅读效率。 【强制】所有的类都必须添加创建者和创建日期。 【强制】方法内部单行注释,在被注释语句上方另起一行,使用//注释。方法内部多行注释使用/ /注释,注意与代码对齐。 【强制】所有的枚举类型字段必须要有注释,说明每个数据项的用途。 【推荐】与其“半吊子”英文来注释,不如用中文注释把问题说清楚。专有名词与关键字保持英文原文即可。 反例:“TCP连接超时”解释成“传输控制协议连接超时”,理解反而费脑筋。 【推荐】代码修改的同时,注释也要进行相应的修改,尤其是参数、返回值、异常、核心逻辑等的修改。 说明:代码与注释更新不同步,就像路网与导航软件更新不同步一样,如果导航软件严重滞后,就失去了导航的意义。 【参考】谨慎注释掉代码。在上方详细说明,而不是简单地注释掉。如果无用,则删除。 说明:代码被注释掉有两种可能性: 1)后续会恢复此段代码逻辑。 2)永久不用。前者如果没有备注信息,难以知晓注释动机。后者建议直接删掉(代码仓库保存了历史代码)。 【参考】对于注释的要求: 第一、能够准确反应设计思想和代码逻辑; 第二、能够描述业务含义,使别的程序员能够迅速了解到代码背后的信息。完全没有注释的大段代码对于阅读者形同天书,注释是给自己看的,即使隔很长时间,也能清晰理解当时的思路;注释也是给继任者看的,使其能够快速接替自己的工作。 【参考】好的命名、代码结构是自解释的,注释力求精简准确、表达到位。避免出现注释的一个极端:过多过滥的注释,代码的逻辑一旦修改,修改注释是相当大的负担。 反例: // put elephant into fridge put(elephant, fridge); 方法名put,加上两个有意义的变量名elephant和fridge,已经说明了这是在干什么,语义清晰的代码不需要额外的注释。 【参考】特殊注释标记,请注明标记人与标记时间。注意及时处理这些标记,通过标记扫描,经常清理此类标记。线上故障有时候就是来源于这些标记处的代码。 待办事宜(TODO):( 标记人,标记时间,[预计处理时间]) 表示需要实现,但目前还未实现的功能。这实际上是一个Javadoc的标签,目前的Javadoc还没有实现,但已经被广泛使用。只能应用于类,接口和方法(因为它是一个Javadoc标签)。 错误,不能工作(FIXME):(标记人,标记时间,[预计处理时间]) 在注释中用FIXME标记某代码是错误的,而且不能工作,需要及时纠正的情况。 异常处理 【强制】Java 类库中定义的可以通过预检查方式规避的RuntimeException异常不应该通过catch 的方式来处理,比如:NullPointerException,IndexOutOfBoundsException等等。 说明:无法通过预检查的异常除外,比如,在解析字符串形式的数字时,不得不通过catch NumberFormatException来实现。 正例:if (obj != null) {...} 反例:try { obj.method() } catch (NullPointerException e) {…} 【强制】异常不要用来做流程控制,条件控制。 说明:异常设计的初衷是解决程序运行中的各种意外情况,且异常的处理效率比条件判断方式要低很多。 【强制】catch时请分清稳定代码和非稳定代码,稳定代码指的是无论如何不会出错的代码。对于非稳定代码的catch尽可能进行区分异常类型,再做对应的异常处理。 说明:对大段代码进行try-catch,使程序无法根据不同的异常做出正确的应激反应,也不利于定位问题,这是一种不负责任的表现。 【强制】捕获异常是为了处理它,不要捕获了却什么都不处理而抛弃之,如果不想处理它,请将该异常抛给它的调用者。最外层的业务使用者,必须处理异常,将其转化为用户可以理解的内容. 【强制】有try块放到了事务代码中,catch异常后,如果需要回滚事务,一定要注意手动回滚事务。 【强制】捕获异常与抛异常,必须是完全匹配,或者捕获异常是抛异常的父类 【推荐】方法的返回值可以为null,不强制返回空集合,或者空对象等,必须添加注释充分说明什么情况下会返回null值。 【推荐】防止NPE(编程语言中的空指针异常),是程序员的基本修养,注意NPE产生的场景: 返回类型为基本数据类型,return包装数据类型的对象时,自动拆箱有可能产生NPE。 反例:public int f() { return Integer对象}, 如果为null,自动解箱抛NPE。 数据库的查询结果可能为null。 集合里的元素即使isNotEmpty,取出的数据元素也可能为null。 远程调用返回对象时,一律要求进行空指针判断,防止NPE。 对于Session中获取的数据,建议NPE检查,避免空指针。 级联调用obj.getA().getB().getC();一连串调用,易产生NPE。 正例:使用JDK8的Optional类来防止NPE问题 【推荐】定义时区分unchecked / checked 异常,避免直接抛出new RuntimeException(),更不允许抛出Exception或者Throwable,应使用有业务含义的自定义异常。推荐业界已定义过的自定义异常,如:DAOException / ServiceException等。 【参考】对于公司外的http/api开放接口必须使用“错误码”;而应用内部推荐异常抛出;跨应用间RPC调用优先考虑使用Result方式,封装isSuccess()方法、“错误码”、“错误简短信息”。 【参考】避免出现重复的代码(Don’t Repeat Yourself),即DRY原则。 说明:随意复制和粘贴代码,必然会导致代码的重复,在以后需要修改时,需要修改所有的副本,容易遗漏。必要时抽取共性方法,或者抽象公共类,甚至是组件化。 正例:一个类中有多个public方法,都需要进行数行相同的参数校验操作,这个时候请抽取: private boolean checkParam(DTO dto) {...} 日志规约 【强制】应用中不可直接使用日志系统(Log4j、Logback)中的API,而应依赖使用日志框架SLF4J中的API,使用门面模式的日志框架,有利于维护和各个类的日志处理方式统一。 import org.slf4j.Logger; import org.slf4j.LoggerFactory; private static final Logger logger = LoggerFactory.getLogger(Abc.class); 【强制】日志文件推荐至少保存15天,因为有些异常具备以“周”为频次发生的特点。 【强制】应用中的扩展日志(如打点、临时监控、访问日志等)命名方式: appName_logType_logName.log。logType:日志类型,推荐分类有stats/monitor/visit等; logName:日志描述。这种命名的好处:通过文件名就可知道日志文件属于什么应用,什么类型,什么目的,也有利于归类查找。 正例:mppserver应用中单独监控时区转换异常, 如: mppserver_monitor_timeZoneConvert.log 说明:推荐对日志进行分类,如将错误日志和业务日志分开存放,便于开发人员查看,也便于通过日志对系统进行及时监控。 【强制】对trace/debug/info级别的日志输出,必须使用条件输出形式或者使用占位符的方式。 正例:(条件) if (logger.isDebugEnabled()) { logger.debug("Processing trade with id: " + id + " and symbol: " + symbol); } 正例:(占位符) logger.debug("Processing trade with id: {} and symbol : {} ", id, symbol); 【强制】避免重复打印日志,浪费磁盘空间,务必在log4j.xml中设置additivity=false。 正例:<logger name="com.taobao.dubbo.config" additivity="false"> 【强制】异常信息应该包括两类信息:案发现场信息和异常堆栈信息。如果不处理,那么通过关键字throws往上抛出。 正例:logger.error(各类参数或者对象toString + "_" + e.getMessage(), e); 【推荐】谨慎地记录日志。生产环境禁止输出debug日志;有选择地输出info日志;如果使用warn来记录刚上线时的业务行为信息,一定要注意日志输出量的问题,避免把服务器磁盘撑爆,并记得及时删除这些观察日志。 说明:大量地输出无效日志,不利于系统性能提升,也不利于快速定位错误点。记录日志时请思考:这些日志真的有人看吗?看到这条日志你能做什么?能不能给问题排查带来好处? 【推荐】可以使用 warnwarn warn日志级别来记录用户输入参数错误的情况,避免投诉时无所适 从。如非必要,请不在此场景打出 errorerror errorerror级别,避免频繁报警。 级 说明: 注意日志输出的级别, errorerror errorerror级别只记录系统逻辑出错、异常 级别只记录系统逻辑出错、异常 或者重要的错误信息。 其他 【强制】在使用正则表达式时,利用好其预编译功能,可以有效加快正则匹配速度。 【强制】velocity调用POJO类的属性时,建议直接使用属性名取值即可,模板引擎会自动按规范调用POJO的getXxx(),如果是boolean基本数据类型变量(boolean命名不需要加is前缀),会自动调用isXxx()方法。 说明:注意如果是Boolean包装类对象,优先调用getXxx()的方法。 【强制】注意 Math.random() 这个方法返回是double类型 注意取值的范围 0≤x<1(能够取到零值,注意除零异常),如果想获取整数类型的随机数,不要将x放大10的若干倍然后取整,直接使用Random对象的nextInt或者nextLong方法。 【强制】获取当前毫秒数System.currentTimeMillis(); 而不是new Date().getTime(); 说明:如果想获取更加精确的纳秒级时间值,使用System.nanoTime()的方式。在JDK8中,针对统计时间等场景,推荐使用Instant类。 【推荐】不要在视图模板中加入任何复杂的逻辑。 说明:根据MVC理论,视图的职责是展示,不要抢模型和控制器的活。 【推荐】任何数据结构的构造或初始化,都应指定大小,避免数据结构无限增长吃光内存。 【推荐】及时清理不再使用的代码段或配置信息。 说明:对于垃圾代码或过时配置,坚决清理干净,避免程序过度臃肿,代码冗余。 正例:对于暂时被注释掉,后续可能恢复使用的代码片断,在注释代码上方,统一规定使用三个斜杠(///)来说明注释掉代码的理由。 MySQL数据库 建表规约 【强制】表达是与否概念的字段,必须使用is_xxx的方式命名,数据类型是unsigned tinyint 正例: 表达逻辑删除的字段名 is_deleted,1表示删除, 0表示未删除。 【强制】表名、字段名必须使用小写字母或数字,禁止出现数字开头,禁止两个下划线中间只出现数字。数据库字段名的修改代价很大,因为无法进行预发布,所以字段名称需要慎重考虑。 说明: MySQLMySQLMySQLMySQL 在 WindowsWindows WindowsWindowsWindowsWindows下不区分大小写,但在 下不区分大小写,但在 LinuxLinux Linux下默认是区分大小写。因此,数据库 下默认是区分大小写。因此,数据库 下默认是区分大小写。因此,数据库 名、表字段,都不允许出现任何大写母避免节外生枝。 正例:aliyun_admin,rdc_config,level3_name 反例:AliyunAdmin,rdcConfig,level_3_name 【强制】表名不使用复数名词。 说明:表名应该仅仅表示表里面的实体内容,不应该表示实体数量,对应于DO类名也是单数形式,符合表达习惯。 【强制】禁用保留字,如desc、range、match、delayed等,请参考MySQL官方保留字。 【强制】主键索引名为pk_字段名;唯一索引名为uk_字段名;普通索引名则为idx_字段名。 说明:pk_ 即primary key;uk_ 即 unique key;idx_ 即index的简称 【强制】小数类型为decimal,禁止使用float和double。 说明:float和double在存储的时候,存在精度损失的问题,很可能在值的比较时,得到不正确的结果。如果存储的数据范围超过decimal的范围,建议将数据拆成整数和小数分开存储。 【强制】如果存储的字符串长度几乎相等,使用char定长字符串类型。 【强制】varchar是可变长字符串,不预先分配存储空间,长度不要超过5000,如果存储长度大于此值,定义字段类型为text,独立出来一张表,用主键来对应,避免影响其它字段索引效率。 【强制】表必备三字段:id, gmt_create, gmt_modified。 说明: 其中 id必为 主键,类型必为 主键,类型unsigned bigint、单表时自增步长为 、单表时自增步长为 1。gmt_create, gmt_modified的类型均为 的类型均为 datetime类型,前者现 类型,前者现 在时表示主动创建,后者过去分词被 动 【推荐】表的命名最好是加上“业务名称_表的作用”。 正例:alipay_task / force_project / trade_config 【推荐】库名与应用名称尽量一致。 【推荐】如果修改字段含义或对字段表示的状态追加时,需要及时更新字段注释。 【推荐】字段允许适当冗余,以提高查询性能,但必须考虑数据一致。冗余字段应遵循: 不是频繁修改的字段。 不是varchar超长字段,更不能是text字段。 【推荐】单表行数超过500万行或者单表容量超过2GB,才推荐进行分库分表。 说明:如果预计三年后的数据量根本达不到这个级别,请不要在创建表时就分库分表。 https://blog.csdn.net/xlgen157387/article/details/53976153 【参考】合适的字符存储长度,不但节约数据库表空间、节约索引存储,更重要的是提升检索速度。 索引规约 【强制】业务上具有唯一特性的字段,即使是多个字段的组合,也必须建成唯一索引。 说明:不要以为唯一索引影响了insert速度,这个速度损耗可以忽略,但提高查找速度是明显的;另外,即使在应用层做了非常完善的校验控制,只要没有唯一索引,根据墨菲定律,必然有脏数据产生。 【强制】超过三个表禁止join。需要join的字段,数据类型必须绝对一致;多表关联查询时,保证被关联的字段需要有索引。 【强制】在varchar字段上建立索引时,必须指定索引长度,没必要对全字段建立索引,根据实际文本区分度决定索引长度即可。 【强制】页面搜索严禁左模糊或者全模糊,如果需要请走搜索引擎来解决。 【推荐】如果有order by的场景,请注意利用索引的有序性。order by 最后的字段是组合索引的一部分,并且放在索引组合顺序的最后,避免出现file_sort的情况,影响查询性能. 【推荐】利用覆盖索引来进行查询操作,避免回表 说明:如果一本书需要知道第11章是什么标题,会翻开第11章对应的那一页吗?目录浏览一下就好,这个目录就是起到覆盖索引的作用。 正例:能够建立索引的种类分为主键索引、唯一索引、普通索引三种,而覆盖索引只是一种查询的一种效果,用explain的结果,extra列会出现:using index。 【推荐】利用延迟关联或者子查询优化超多分页场景。 说明:MySQL并不是跳过offset行,而是取offset+N行,然后返回放弃前offset行,返回N行,那当offset特别大的时候,效率就非常的低下,要么控制返回的总页数,要么对超过特定阈值的页数进行SQL改写。 正例:先快速定位需要获取的id段,然后再关联: SELECT a.* FROM 表1 a, (select id from 表1 where 条件 LIMIT 100000,20 ) b where a.id=b.id 【推荐】 SQL性能优化的目标:至少要达到 range 级别,要求是ref级别,如果可以是consts最好。 说明: 1)consts 单表中最多只有一个匹配行(主键或者唯一索引),在优化阶段即可读取到数据。 2)ref 指的是使用普通的索引(normal index)。 3)range 对索引进行范围检索。 反例:explain表的结果,type=index,索引物理文件全扫描,速度非常慢,这个index级别比较range还低,与全表扫描是小巫见大巫。 【推荐】建组合索引的时候,区分度最高的在最左边 正例:如果where a=? and b=? ,a列的几乎接近于唯一值,那么只需要单建idx_a索引即可。 说明:存在非等号和等号混合判断条件时,在建索引时,请把等号条件的列前置。如:where a>? and b=? 那么即使a的区分度更高,也必须把b放在索引的最前列。 【推荐】防止因字段类型不同造成的隐式转换,导致索引失效。 【参考】创建索引时避免有如下极端误解: 宁滥勿缺。认为一个查询就需要建一个索引。 宁缺勿滥。认为索引会消耗空间、严重拖慢更新和新增速度。 抵制惟一索引。认为业务的惟一性一律需要在应用层通过“先查后插”方式解决。 SQL语句 【强制】不要使用count(列名)或count(常量)来替代count(),count()是SQL92定义的标准统计行数的语法,跟数据库无关,跟NULL和非NULL无关。 说明:count(*)会统计值为NULL的行,而count(列名)不会统计此列为NULL值的行。 【强制】count(distinct col) 计算该列除NULL之外的不重复行数,注意 count(distinct col1, col2) 如果其中一列全为NULL,那么即使另一列有不同的值,也返回为0。 【强制】当某一列的值全是NULL时,count(col)的返回结果为0,但sum(col)的返回结果为NULL,因此使用sum()时需注意NPE问题。 正例:可以使用如下方式来避免sum的NPE问题:SELECT IF(ISNULL(SUM(g)),0,SUM(g)) FROM table; 【强制】使用ISNULL()来判断是否为NULL值。 说明:NULL与任何值的直接比较都为NULL。 NULL<>NULL的返回结果是NULL,而不是false。 NULL=NULL的返回结果是NULL,而不是true。 NULL<>1的返回结果是NULL,而不是true。 【强制】 在代码中写分页查询逻辑时,若count为0应直接返回,避免执行后面的分页语句。 【强制】不得使用外键与级联,一切外键概念必须在应用层解决。 说明:以学生和成绩的关系为例,学生表中的student_id是主键,那么成绩表中的student_id则为外键。如果更新学生表中的student_id,同时触发成绩表中的student_id更新,即为级联更新。外键与级联更新适用于单机低并发,不适合分布式、高并发集群;级联更新是强阻塞,存在数据库更新风暴的风险;外键影响数据库的插入速度。 【强制】禁止使用存储过程,存储过程难以调试和扩展,更没有移植性。 【强制】数据订正(特别是删除、修改记录操作)时,要先select,避免出现误删除,确认无误才能执行更新语句。 【推荐】in操作能避免则避免,若实在避免不了,需要仔细评估in后边的集合元素数量,控制在1000个之内。 【参考】如果有全球化需要,所有的字符存储与表示,均以utf-8编码,注意字符统计函数的区别。 【参考】 TRUNCATE TABLE 比 DELETE 速度快,且使用的系统和事务日志资源少,但TRUNCATE无事务且不触发trigger,有可能造成事故,故不建议在开发代码中使用此语句。 说明:TRUNCATE TABLE 在功能上与不带 WHERE 子句的 DELETE 语句相同。 ORM映射 【强制】在表查询中,一律不要使用 * 作为查询的字段列表,需要哪些字段必须明确写明。 说明:1)增加查询分析器解析成本。2)增减字段容易与resultMap配置不一致。 【强制】POJO类的布尔属性不能加is,而数据库字段必须加is_,要求在resultMap中进行字段与属性之间的映射。 【强制】不要用resultClass当返回参数,即使所有类属性名与数据库字段一一对应,也需要定义;反过来,每一个表也必然有一个与之对应。 说明:配置映射关系,使字段与DO类解耦,方便维护。 【强制】sql.xml配置参数使用:#{},#param# 不要使用${} 此种方式容易出现SQL注入。 【强制】iBATIS自带的queryForList(String statementName,int start,int size)不推荐使用。 【强制】不允许直接拿HashMap与Hashtable作为查询结果集的输出。 说明:resultClass=”Hashtable”,会置入字段名和属性值,但是值的类型不可控。 【强制】更新数据表记录时,必须同时更新记录对应的gmt_modified字段值为当前时间。 【推荐】不要写一个大而全的数据更新接口。传入为POJO类,不管是不是自己的目标更新字段,都进行update table set c1=value1,c2=value2,c3=value3; 这是不对的。执行SQL时,不要更新无改动的字段,一是易出错;二是效率低;三是增加binlog存储。 【参考】@Transactional事务不要滥用。事务会影响数据库的QPS,另外使用事务的地方需要考虑各方面的回滚方案,包括缓存回滚、搜索引擎回滚、消息补偿、统计修正等。 【参考】中的compareValue是与属性值对比的常量,一般是数字,表示相等时带上此条件;表示不为空且不为null时执行;表示不为null值时执行。