首页 文章 精选 留言 我的

精选列表

搜索[妙招生态],共10002篇文章
优秀的个人博客,低调大师

关于MySQL索引知识与小妙招 — 学到了!

一、索引基本知识 1.1 索引的优点 大大减少了服务器需要扫描的数据量,加快数据库的检索速度 帮助服务器避免排序和临时表 将随机io变成顺序io 1.2 索引的用处 速查找匹配WHERE子句的行 从consideration中消除行,如果可以在多个索引之间进行选择,mysql通常会使用找到最少行的索引 如果表具有多列索引,则优化器可以使用索引的任何最左前缀来查找行 当有表连接的时候,从其他表检索行数据 查找特定索引列的min或max值 如果排序或分组时在可用索引的最左前缀上完成的,则对表进行排序和分组 在某些情况下,可以优化查询以检索值而无需查询数据行 1.3 索引的分类 数据库会默认创建索引,但是并不是给主键建立索引,而是给唯一键建里索引的,因为主键的特性是唯一且非空 主键索引: 是一种特殊的唯一索引,不允许有空值。(主键约束,就是一个主键索引) 唯一索引: 索引列中的值必须是唯一的,但是允许为空值。 普通索引: MySQL中基本索引类型,没有什么限制,允许在定义索引的列中插入重复值和空值,纯粹为了查询数据更快一 点。 全文索引: 只有在MyISAM引擎上才能使用,只能在CHAR,VARCHAR,TEXT类型字段上使用全文索引 什么是全文索引,就是在一堆文字中,通过其中的某个关键字等,就能找到该字段所属的记录行,比如有"LOL LPL 牧小农" 通过牧小农,可能就可以找到该条记录。这里说的是可能,因为全文索引的使用涉及了很多细节,我们只需要知道这个大概意思。一般开发中,不贵用到全文索引,因为其占用很大的物理空间和降低了记录修改性,故较为少用。 组合索引: 在表中的多个字段组合上创建的索引,只有在查询条件中使用了这些字段的左边字段时,索引才会被使用,使用组合索引时遵循最左前缀集合。 例如这里由id、name和age3个字段构成的索引,索引行中就按id/name/age的顺序存放,索引可以索引下面字段组合(id,name,age)、(id,name)或者(id)。如果要查询的字段不构成索引最左面的前缀,那么就不会是用索引,比如,age或者(name,age)组合就不会使用索引查询。 1.4 面试技术名词 回表: 数据库根据索引(非主键)找到了指定的记录所在行后,还需要根据主键再次到数据块里获取数据,这种称之为回表 覆盖索引: 看我写的一篇文章:面试三轮我倒在了一道sql题上——sql性能优化 最左匹配: 指在联合索引中,如果你的 SQL 语句中用到了联合索引中的最左边的索引,那么这条 SQL 语句就可以利用这个联合索引去进行匹配,如果遇到范围查询(>、<、between、like)就会停止匹配。 select from t where a=1 and b=1 and c =1; #这样可以利用到定义的索引(a,b,c),用上a,b,cselect from t where a=1 and b=1; #这样可以利用到定义的索引(a,b,c),用上a,bselect from t where b=1 and a=1; #这样可以利用到定义的索引(a,b,c),用上a,c(mysql有查询优化器)select from t where a=1; #这样也可以利用到定义的索引(a,b,c),用上aselect from t where b=1 and c=1; #这样不可以利用到定义的索引(a,b,c)select from t where a=1 and c=1; #这样可以利用到定义的索引(a,b,c),但只用上a索引,b,c索引用不到 索引下推: 称为 Index Condition Pushdown (ICP),这是MySQL提供的用某一个索引对一个特定的表从表中获取元组”,注意我们这里特意强调了“一个”,这是因为这样的索引优化不是用于多表连接而是用于单表扫描,确切地说,是单表利用索引进行扫描以获取数据的一种方式。 1.5 索引采用的数据结构 1.5.1 哈希表缺点︰ 1、利用hash存储的话需要将所有的数据文件添加到内存,比较耗费内存空间2、如果所有的查询都是等值查询,那么hash确实很快,但是在企业或者实际工作环境中范围查找的数据更多,而不是等值查询,因此hash就不太适合了 1.5.2 二叉树缺点∶ 无论是二叉树还是红黑树,都会因为树的深度过深而造成io次数变多,影响数据读取的效率 1.5.3 B+树 B树特点:1、所有键值分布在整颗树中2、搜索有可能在非叶子结点结束,在关键字全集内做一次查找,性能逼近二分查找3、每个节点最多拥有m个子树4、根节点至少有2个子树5、分支节点至少拥有m/2颗子树(除根节点和叶子节点外都是分支节点)6、所有叶子节点都在同一层、每个节点最多可以有m-1个key,并且以升序排列 实例图说明∶每个节点占用一个磁盘块,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为16和34,P1指针指向的子树的数据范围为小于16,P2指针指向的子树的数据范围为16~34 ,P3指针指向的子树的数据范围为大于34。 查找关键字过程: 根据根节点找到磁盘块1,读入内存。【磁盘I/O操作第1次】 比较关键字28在区间(16,34 ),找到磁盘块1的指针P2。 根据P2指针找到磁盘块3,读入内存。【磁盘I/O操作第2次】 比较关健字28在区间(25,31 ),找到磁盘块3的指针P2。 根据P2指针找到磁盘块8,读入内存。【磁盘I/O 操作第3次】 在磁盘块8中的关健宁列表中找到关健字28。 缺点: 每个节点都有key,同时也包含data,而每个页存储空间是有限的,如果data比较大的话会导致每个节点存储的k ey数量变小 当存储的数据量很大的时候会导致深度较大,增大查询时磁盘io次数,进而影响查询性能 1.6 索引匹配方式 全值匹配: 全值匹配指的是和索引中的所有列进行匹配 explain select * from staffs where name = 'July' and age = '23' and pos = 'dev'; 匹配最左前缀: 只匹配前面的几列 explain select * from staffs where name = 'July' and age = '23'; explain select * from staffs where name = 'July'; 匹配列前缀: 可以匹配某一列的值的开头部分 explain select * from staffs where name like 'J%'; explain select * from staffs where name like '%y'; 匹配范围值: 可以查找某一个范围的数据 explain select * from staffs where name > 'Mary'; 精确匹配某一列并范围匹配另外一列:可以查询第一列的全部和第二列的部分 explain select * from staffs where name = 'July' and age > 25; 只访问索引的查询: 查询的时候只需要访问索引,不需要访问数据行,本质上就是覆盖索引 explain select name,age,pos from staffs where name = 'July' and age = 25 and pos = 'dev'; 二、哈希索引 基于哈希表的实现,只有精确匹配索引所有列的查询才有效 在mysql中,只有memory的存储引擎显式支持哈希索引 哈希索引自身只需存储对应的hash值,所以索引的结构十分紧凑,这让哈希索引查找的速度非常快 2.1 哈希索引的限制 哈希索引只包含哈希值和行指针,而不存储字段值,索引不能使用索引中的值来避免读取行 哈希索引数据并不是按照索引值顺序存储的,所以无法进行排序 哈希索引不支持部分列匹配查找,哈希索引是使用索引列的全部内容来计算哈希值 哈希索引支持等值比较查询,也不支持任何范围查询 访问哈希索引的数据非常快,除非有很多哈希冲突,当出现哈希冲突的时候,存储引擎必须遍历链表中的所有行指针,逐行进行比较,直到找到所有符合条件的行 哈希冲突比较多的话,维护的代价也会很高 2.2 案例 当需要存储大量的URL,并且根据URL进行搜索查找,如果使用B+树,存储的内容就会很大:select id from url where url="" 也可以利用将url使用CRC32做哈希,可以使用以下查询方式:select id fom url where url="" and url_crc=CRC32("") 此查询性能较高原因是使用体积很小的索引来完成查找 三、组合索引 当包含多个列作为索引,需要注意的是正确的顺序依赖于该索引的查询,同时需要考虑如何更好的满足排序和分组的需要 案例: 建立组合索引 a,b,c ,不同SQL语句使用索引情况 语句 索引是否发挥作用 where a=3 是,只使用了a where a=3 and b=5 是,使用了a,b where a =3 and b = 5 and c= 4 是,使用了a,b,c where a = 3 or c = 4 否 where a = 3 and c= 4 是,仅使用了a where a = 3 and b > 10 and c = 7 是,使用了a,b where a = 3 and b like '%mxn%' and c=7 使用了a 四、聚簇索引与非聚簇索引 4.1 聚簇索引 不是单独的索引类型,而是一种数据存储方式,指的是数据行跟相邻的键值紧凑的存储在一起,将数据存储与索引放到了一块,找到索引也就找到了数据 如果没有定义主键,InnoDB会选择一个唯一的非空索引代替。如果没有唯一索引,InnoDB会隐式定义一个主键来作为聚簇索引。InnoDB 只聚集在同一个页面中的记录。包含相邻健值的页面可能相距甚远。 4.2 非聚簇索引 数据文件跟索引文件分开存放,将数据存储于索引分开结构,索引结构的叶子节点指向了数据的对应行,myisam通过key_buffer把索引先缓存到内存中,当需要访问数据时(通过索引访问数据),在内存中直接搜索索引,然后通过索引找到磁盘相应数据,这也就是为什么索引不在key buffer命中时,速度慢的原因 通过叶子节点指针找到数据页中的数据,所以非聚簇索引是逻辑顺序 五、覆盖索引 5.1 基本介绍 如果一个索引包含所有需要查询的字段的值,我们称之为覆盖索引 不是所有类型的索引都可以称为覆盖索引,覆盖索引必须要存储索引列的值 不同的存储实现覆盖索引的方式不同,不是所有的引擎都支持覆盖索引,memory不支持覆盖索引 5.2 优势 1、索引条目通常远小于数据行大小,如果只需要读取索引,那么mysql就会极大的较少数据访问量2、因为索引是按照列值顺序存储的,所以对于IO密集型的范围查询会比随机从磁盘读取每一行数据的IO要少的多3、一些存储引擎如MYISAM在内存中只缓存索引,数据则依赖于操作系统来缓存,因此要访问数据需要一次系统调用,这可能会导致严重的性能问题4、由于INNODB的聚簇索引,覆盖索引对INNODB表特别有用 5.3 案例演示 1、当发起一个被索引覆盖的查询时,在explain的extra列可以看到using index的信息,此时就使用了覆盖索引2、在大多数存储引擎中,覆盖索引只能覆盖那些只访问索引中部分列的查询。不过,可以进一步的进行优化,可以使用innodb的二级索引来覆盖查询。 例如:actor使用innodb存储引擎,并在last_name字段又二级索引,虽然该索引的列不包括主键actor_id,但也能够用于对actor_id做覆盖查询 六、优化小细节 当使用索引列进行查询的时候尽量不要使用表达式,把计算放到业务层而不是数据库层 尽量使用主键查询,而不是其他索引,因为主键查询不会触发回表查询 使用前缀索引 有时候需要索引很长的字符串,这会让索引变的大且慢,通常情况下可以使用某个列开始的部分字符串,这样大大的节约索引空间,从而提高索引效率,但这会降低索引的选择性,索引的选择性是指不重复的索引值和数据表记录总数的比值,范围从1/#T到1之间。索引的选择性越高则查询效率越高,因为选择性更高的索引可以让mysql在查找的时候过滤掉更多的行。​ 一般情况下某个列前缀的选择性也是足够高的,足以满足查询的性能,但是对应BLOB,TEXT,VARCHAR类型的列,必须要使用前缀索引,因为mysql不允许索引这些列的完整长度,使用该方法的诀窍在于要选择足够长的前缀以保证较高的选择性,通过又不能太长。 --创建数据表 create table citydemo(city varchar(50) not null); insert into citydemo(city) select city from city; --重复执行5次下面的sql语句 insert into citydemo(city) select city from citydemo; --更新城市表的名称 update citydemo set city=(select city from city order by rand() limit 1); --查找最常见的城市列表,发现每个值都出现45-65次, select count(*) as cnt,city from citydemo group by city order by cnt desc limit 10; --查找最频繁出现的城市前缀,先从3个前缀字母开始,发现比原来出现的次数更多,可以分别截取多个字符查看城市出现的次数 select count(*) as cnt,left(city,3) as pref from citydemo group by pref order by cnt desc limit 10; select count(*) as cnt,left(city,7) as pref from citydemo group by pref order by cnt desc limit 10; --此时前缀的选择性接近于完整列的选择性 --还可以通过另外一种方式来计算完整列的选择性,可以看到当前缀长度到达7之后,再增加前缀长度,选择性提升的幅度已经很小了 select count(distinct left(city,3))/count(*) as sel3, count(distinct left(city,4))/count(*) as sel4, count(distinct left(city,5))/count(*) as sel5, count(distinct left(city,6))/count(*) as sel6, count(distinct left(city,7))/count(*) as sel7, count(distinct left(city,8))/count(*) as sel8 from citydemo; --计算完成之后可以创建前缀索引 alter table citydemo add key(city(7)); --注意:前缀索引是一种能使索引更小更快的有效方法,但是也包含缺点:mysql无法使用前缀索引做order by 和 group by。 使用索引扫描来排序 mysql有两种方式可以生成有序的结果:通过排序操作或者按索引顺序扫描,如果explain出来的type列的值为index,则说明mysql使用了索引扫描来做排序​ 扫描索引本身是很快的,因为只需要从一条索引记录移动到紧接着的下一条记录。但如果索引不能覆盖查询所需的全部列,那么就不得不每扫描一条索引记录就得回表查询一次对应的行,这基本都是随机IO,因此按索引顺序读取数据的速度通常要比顺序地全表扫描慢​ mysql可以使用同一个索引即满足排序,又用于查找行,如果可能的话,设计索引时应该尽可能地同时满足这两种任务。​ 只有当索引的列顺序和order by子句的顺序完全一致,并且所有列的排序方式都一样时,mysql才能够使用索引来对结果进行排序,如果查询需要关联多张表,则只有当orderby子句引用的字段全部为第一张表时,才能使用索引做排序。order by子句和查找型查询的限制是一样的,需要满足索引的最左前缀的要求,否则,mysql都需要执行顺序操作,而无法利用索引排序 union all,in,or都能够使用索引,但是推荐使用in 范围列可以用到索引,范围条件是:<、>,范围列可以用到索引,但是范围列后面的列无法用到索引,索引最多用于一个范围列 强制类型转换会全表扫描 create table user(id int,name varchar(10),phone varchar(11)); alter table user add index idx_1(phone); explain select * from user where phone=13800001234;(不会触发索引) explain select * from user where phone='13800001234';(触发索引) 更新十分频繁,数据区分度不高的字段上不宜建立索引 更新会变更B+树,更新频繁的字段建议索引会大大降低数据库性能.类似于性别这类区分不大的属性,建立索引是没有意义的,不能有效的过滤数据,一般区分度在80%以上的时候就可以建立索引,区分度可以使用 count(distinct(列名))/count(*) 来计算 创建索引的列,不允许为null,可能会得到不符合预期的结果 当需要进行表连接的时候,最好不要超过三张表,因为需要join的字段,数据类型必须一致 能使用limit的时候尽量使用limit 单表索引建议控制在5个以内 单索引字段数不允许超过5个(组合索引) 创建索引的时候应该避免以下错误概念 索引越多越好(错误)过早优化,在不了解系统的情况下进行优化(错误)

优秀的个人博客,低调大师

HDFS 细粒度锁优化,FusionInsight MRS有妙招

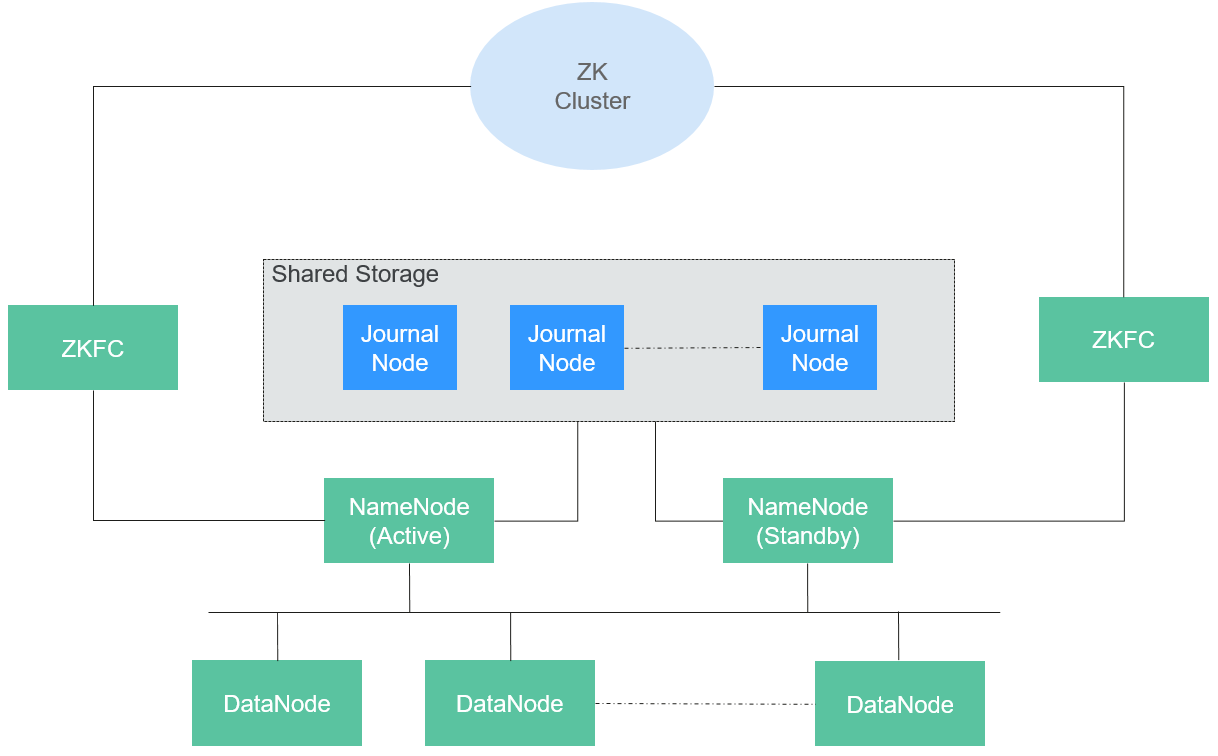
摘要:华为云FusionInsight MRS通过FGL对HDFS NameNode锁机制进行优化,有效提升了NameNode的读写吞吐量,从而能够支持更多数据,更多业务请求访问,从而更好的支撑政企客户高效用数,业务洞见更准,价值兑现更快。 本文分享自华为云社区《FusionInsight MRS HDFS 细粒度锁优化实践》,作者:pippo。 背景 HDFS依赖NameNode作为其元数据服务。NameNode将整个命名空间信息保存在内存中提供服务。读取请求(getBlockLocations、listStatus、getFileInfo)等从内存中获取信息。写请求(mkdir、create、addBlock)更新内存状态,并将日志事务写入到日志服务(QJM)。 HDFS NameNode的性能决定了整个Hadoop集群的可扩展性。命名空间性能的改进对于进一步扩展Hadoop集群至关重要。 Apache HDFS 整体架构如下: Apache HDFS 交互信息如下: 痛点 HDFS NameNode的写操作的性能受全局命名空间系统锁的限制。每个写操作都会获取锁并保留锁,直到该操作执行完成。这样可以防止写入操作的并发执行,即使它们是完全独立的,例如命名空间中的对象不相交部分。 什么是Fine Grained Locking(FGL) FGL【细粒度锁】的主要目的是通过在独立命名空间分区上用多个并发锁替换全局锁,允许写入操作的并发。 当前状态 HDFS设计思路为一次写,多次读。读操作使用共享锁,写操作使用独占锁。由于HDFS NameNode元数据被设计为单个内存空间中的命名空间树,因此树的任何级别的写操作都会阻塞其它写操作,直到当前写操作完成。虽然写是一次,但是当涉及大量并发读/写操作时,这就会影响整体性能。 在HDFS NameNode中,内存中的元数据有三种不同的数据结构: INodeMap: inodeid -> INode BlocksMap: blockid -> Blocks DataNodeMap: datanodeId -> DataNodeInfo INodeMap结构中包含inodeid到INode的映射,在整个Namespace目录树种存在两种不同类型的INode数据结构:INodeDirectory和INodeFile。其中INodeDirectory标识的是目录树中的目录,INodeFile标识的是目录树中的文件。 BlocksMap结构中包含blockid到BlockInfo的映射。每一个INodeFile都会包含数量不同的Block,具体数量由文件大小以及每个Block大小来决定,这些Block按照所在文件的先后顺序组成BlockInfo数组,BlockInfo维护的是Block的元数据;通过blockid可以快速定位Block。 DataNodeMap结果包含datanodeid到DataNodeInfo的映射。当集群启动过程中,通过机架感知逐步建立起整个集群的机架拓扑结构,一般在NameNode的生命周期内不会发生大变化。 通过INodeMap和BlocksMap共同标识存储在HDFS中的每个文件及其块的信息。随着文件数量的增加,此数据结构大小也会随之增加,并对单个全局锁的性能产生很大影响。下面我们采用简单的文件目录树结构来演示现有的单一全局锁在文件系统的缺点。 HDFS NameNode 内存目录树结构 如上图所示,/D11/D21/D31/F2 和 /D12/D24/D38/F16是不相交的文件,即有不同的父节点和祖父节点。可以看到F2和F16是两个独立的文件,对其中一个文件的任何操作都不应该影响另一个文件。 设计 如前所述,HDFS NameNode将文件信息和元数据结构在内存中保存为一个目录树结构。当修改任意两个独立的文件时,第二次操作需要等到第一次操作完成并释放锁。释放锁以后,只有第二个操作获取锁后才能继续修改文件系统。类似的,后续操作也会阻塞,直到第二次操作释放锁。 在下面的例子中,我们考虑2个文件并发写入(创建、删除、追加。。。)操作。F2和F16是文件系统下的2个独立文件(具有不同的父节点和祖父节点)。在将内容追加到F2时,F16也可以同时进行修改。但是由于整个目录树全局对象锁,对F16的操作必须等对F2的操作完成后才能执行。 代替全局锁,可以将锁分布在一组名为“分区”的文件中,每个分区都可以有自己的锁。现在F2属于分区-1,F16属于分区-2。F2文件操作可以通过获取分区-1的锁来进行修改,F16文件操作可以通过获取分区-2的锁来进行修改。 和以前一样,需要先获取全局锁,然后搜索每个文件属于哪个分区。找到分区后,获取分区锁并释放全局锁。因此全局锁并不会完全被删除。相反,通过减少全局锁时间跨度,一旦释放全局锁,则其它写操作可以获取全局锁并继续获取分区锁来进行文件操作。 分区的数量如何决定?如果有效的定义分区从而获得更高的吞吐量? 默认情况下,分区大小为65K,溢出系数为1.8。一旦分区达到溢出条件,将会创建新分区并加入到分区列表中。理想情况下,可以拥有等于NameNode可用CPU核数的分区数,过多的分区数量将会使得CPU过载,而过少的分区数量无法充分利用CPU。 实现 引入新的数据结构-PartitionedGSet,它保存命名空间创建的所有分区信息。PartitionEntry是一个分区的对象结构。LatchLock是新引入的锁,用于控制两级锁--顶层锁和子锁。 PartitionedGSet PartitionedGSet是一个两级层次结构。第一层RangeMap定义了INode的范围,并将它们映射到相应的分区中。分区构成了层次结构的第二级,每个分区存储属于指定范围的INode信息。为了根据键值查找INode,需要首先在RangeMap中找到对应键值的范围,然后在对应的RangeSet,使用哈希值获取到对应的INode。 HDFS NameNode 两级层次结构 RangeGSet的容量有一定的阈值。当达到阈值后,将创建新的RangeGSet。空的或者未充分利用的RangeGSet由后台RangeMonitor守护程序来进行垃圾回收。 HDFS NameNode启动时,根据镜像中的INode数量计算合理的初始分区数。同时还需要考虑CPU核数,因为将分区数量提高到远超CPU核数并不会增加系统的并行性。 动态分区:分区的大小有限,可以像平衡树一样可以进行分裂和合并。 单个分区:只有一个分区,且只有一个与之相对应的锁,并且应和全局锁类似。这适用于小型集群或写入负载比较轻的集群。 静态分区:有一个固定的RangeMap,不添加或者合并现有分区。这适用于分区均匀增长的文件系统。而且这将消除锁定RangeMap的要求,允许并行使用锁。 Latch Lock RangeMap与RangeGSet分别有单独的锁。Latch Lock是一种锁模式,其中首先获取RangeMap的锁,以查找与给定INode键对应的范围,然后获取与分区对应的RangeGSet的锁,同时释放RangeMap锁。这样针对任何其它范围的下一个操作都可以开始并发执行。 在RangeMap上持有锁类似于全局锁。目录删除、重命名、递归创建目录等几个操作可能需要锁定多个RangeGSet。这要确保当前HDFS语义所要求的操作的原子性。例如,如果重命名将文件从一个目录移动到另一个目录,则必须锁定包含文件、源和目标目录的RangeMap,以便使重命名成为原子。此锁定模式的一个理想优化是允许某些操作的Latch Lock与其他操作的全局锁结合使用。 INode Keys HDFS中的每个目录和文件都有一个唯一的INode,即使文件被重命名或者移动到其它位置,该INode会保持不变。INode键是以文件INode本身结尾,前面包含父INode的固定长度序列。 Key Definition:key(f) = <ppId, pId, selfId> selfId是文件的INodeId,pId是父目录的INodeId,ppId是父目录的父目录的INodeId。INode键的这种表达不仅保证了同级,同时也保证了表亲(相同祖父节点)在大多数情况下被分区到相同的范围中。这些键基于INodeId而非文件名,允许简单的文件和目录进行重命名,称为就地重命名,而无需重新进行分区。 效果 经过测试验证使用和不使用FGL功能性能,在主要写入操作情况下,吞吐量平均提高了25%左右。 详细性能对比 使用Hadoop NN Benchmarking工具(NNThroughputBenchmark)来验证NameNode的性能。每个写入API验证并观察到平均25%的性能提升。有很少一部分轻微或者没有提升的API,分析并发现这些API均是轻量级API,因此没有太大的提升。 NNThroughputBenchmark是用于NameNode性能基准测试工具。该工具提供了非常基本的API调用,比如创建文件,创建目录、删除。在这个基础上进行了增强,从而能够支持所有写入API,并能够捕获使用和不使用FGL的版本的性能数据。 用于测试的数据集:线程数 1000、文件数 1000000、每个目录文件数 40。 写入调用频率高的API 其它内部写API 常用读取API: 通过完整的FGL实现,读取API也有很好的性能提升。 运行基准测试工具的命令: ./hadoop org.apache.hadoop.hdfs.server.namenode.NNThroughputBenchmark -fs file:/// -op create -threads 200 -files 1000000 -filesPerDir 40 –close ./hadoop org.apache.hadoop.hdfs.server.namenode.NNThroughputBenchmark -fs hdfs:x.x.x.x:dddd/hacluster -op create -threads 200 -files 1000000 -filesPerDir 40 -close 参考 与FGL相关的社区讨论 Hadoop Meetup Jan 2019 — HDFS Scalability and Consistent Reads from Standby Node, which covers Three-Stage Scalability Plan. Slides 21–25 社区中跟踪与NameNode可扩展性相关的其它Jira HDFS-5453. Support fine grain locking in FSNamesystem HDFS-5477. Block manager as a service HDFS-8286. Scaling out the namespace using KV store HDFS-14703. Namenode Fine Grained Locking (design inspired us to implement it fully) 总结 华为云FusionInsight MRS云原生数据湖为政企客户提供湖仓一体、云原生的数据湖解决方案,构建一个架构可持续演进的离线、实时、逻辑三种数据湖,支撑政企客户全量数据的实时分析、离线分析、交互查询、实时检索、多模分析、数据仓库、数据接入和治理等大数据应用场景。 华为云FusionInsight MRS通过FGL对HDFS NameNode锁机制进行优化,有效提升了NameNode的读写吞吐量,从而能够支持更多数据,更多业务请求访问,从而更好的支撑政企客户高效用数,业务洞见更准,价值兑现更快。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

详解GaussDB(DWS)通信安全的小妙招:连接认证机制

本文分享自华为云社区《GaussDB(DWS)数据库安全系列之通信安全》,作者:yd_262982826。 1. 前言 适用版本:【8.1.3及以上】 网络是一个开放的环境,仅仅依靠用户名和密码难以应对复杂的网络环境,针对可能存在的身份伪造的欺骗行为,以及监听通信内容的窃听行为,为了确保通信双方身份的真实性和通信内容的私密性,防止非法用户对GaussDB(DWS)系统、其他用户造成不利影响,GaussDB(DWS)建立了一套完整而严密的防护机制——连接认证机制,可以有效防止非法用户入侵。 2. 证书校验&&秘钥协商 证书校验和秘钥协商在SSL的握手阶段实现,握手协议如下: 2.1 准备证书 在华为云CA认证中心申请到服务器、客户端的证书和密钥。(如:服务器的私钥为server.key,证书为server.crt,客户端的私钥为client.key,证书为client.crt,CA根证书名称为cacert.pem。) 为了安全性,私钥通常采用了密码保护,在此可以通过gs_guc encrypt工具生成私钥的两个密码保护文件(.key.rand、.key.cipher),命令如下: gs_guc encrypt [-M keymode] -K password -D DATADIR 说明: -M是加密类型,服务端选择server,客户端选择client。默认值为server。 -K是用户私钥的密码,密码需要满足要求:长度(8≤len≤16)、复杂度(需至少包含小写字母、大写字母、数字、特殊字符中的三种) -D生成的密码保护文件的存放地址 2.2 服务器参数配置 通过调用工具gs_guc实现服务器配置文件postgresql.conf有关参数设置,命令如下: gs_guc set -Z coordinator -D ${BIGDATA_DATA_HOME}/mppdb/data1/coordinator -c "ssl=on" 说明: -Z coordinator表示实例类型为coordinator; -D 数据目录 -c 指定设置postgresql.conf文件 服务器需设置SSL相关参数如下: 参数 描述 取值范围 ssl 表示是否启动SSL功能 on:开启SSL功能 off:关闭SSL功能默认值:on require_ssl 服务器是否强制要求SSL连接,只有当参数ssl为on时才有效 on:强制要求SSL连接 off:不强制要求SSL连接默认值:off ssl_cert_file 指定服务器证书文件 请以实际证书名为准。必须使用相对路径(相对于数据目录默认值:server.crt ssl_key_file 指定服务器私钥文件 请以实际的私钥名称为准。必须使用相对路径(相对于数据目录默认值:server.key ssl_ca_file 服务器侧CA根证书,需验证客户端证书合法性时才配置 请以实际CA根证书名称为准默认值:空,表示不对客户端的合法性进行校验 ssl_crl_file 证书吊销列表 请以实际证书吊销列表名称为准默认值:空,表示没有吊销列表 ssl_ciphers SSL通讯使用的加密算法,目前已升级至TLS1.3 TLS1_3_RFC_AES_128_GCM_SHA256 TLS1_3_RFC_AES_256_GCM_SHA384 TLS1_3_RFC_CHACHA20_POLY1305_SHA256 TLS1_3_RFC_AES_128_CCM_SHA256 TLS1_3_RFC_AES_128_CCM_8_SHA256默认值:ALL,表示允许对端使用以上所有加密算法,在满足条件的算法中按照安全强度最高的匹配 2.3 客户端参数配置 客户端设置SSL连接参数,按照模式分为:单向认证和双向认证。 单向认证,仅客户端验证服务器证书的合法性,设置参数:PGSSLMODE、PGSSLROOTCERT; 双向认证,客户端验证服务器证书的合法性,同时客户端向服务器发送证书,由服务器验证客户端证书的合法性,设置参数:PGSSLCERT、PGSSLKEY、PGSSLMODE、PGSSLROOTCERT; 客户端需设置SSL相关参数如下: 环境变量 描述 取值范围 PGSSLCERT 指定客户端证书文件 绝对路径,如: export PGSSLCERT=’/home/omm/client.crt’ PGSSLKEY 指定客户端私钥文件 必须包含文件的绝对路径,如: export PGSSLKEY=’/home/omm/client.key’ PGSSLMODE 设置是否和服务器进行SSL连接协商,以及指定SSL连接的优先级 取值及含义:disable:只尝试非SSL连接allow:首先尝试非SSL连接,如果连接失败,再尝试SSL连接prefer:首先尝试SSL连接,如果连接失败,将尝试非SSL连接require:只尝试SSL连接。如果存在CA文件,则按设置成verify-ca的方式验证verify-ca:只尝试SSL连接,并验证服务器是否具有由可信任证书机构签发的证书verify-full:只尝试SSL连接,并验证服务器是否具有由可信任的证书机构签发的证书,以及验证服务器主机名是否与证书中的一致默认值:prefer PGSSLROOTCERT 指定客户端侧根证书,验证服务器证书有效性 必须包含文件的绝对路径,如: export PGSSLROOTCERT=’/home/omm/certca.pem’ PGSSLCRL 指定证书吊销列表文件 必须包含文件的绝对路径,如: export PGSSLCRL=’/home/omm/sslcrl-file.crl’ 备注:假设证书,私钥和根证书都放在“/home/omm”目录。 3. 用户名和密码验证 用户名和密码的验证在服务器侧进行,其逻辑如下: 如果某主机需要远程连接到GaussDB(DWS),必须在GaussDB(DWS)系统的配置文件中增加此主机的信息,并且进行客户端接入认证。配置文件(pg_hba.conf)存放在数据目录里。hba(host-based authentication)表示是基于主机的认证。 通过调用工具gs_guc实现服务器配置文件pg_hba.conf有关参数设置,每次向配置文件中增加一条连接认证规则,命令如下: gs_guc set -Z coordinator -N all -I all -h "host all jack 10.10.0.30/32 sha256" 说明: -Z coordinator表示实例类型为coordinator; -N all 表示集群的所有主机 -I all表示主机的所有实例 -h 表示指定需要在“pg_hba.conf”增加的语句 all 表示允许客户端连接到任意的数据库 jack表示允许连接数据库的用户 10.10.0.30/32表示只允许IP地址为10.10.0.30的主机连接 sha256表示连接时jack用户的密码使用sha256算法加密 配置文件pg_hba.conf中的每条记录可以是以下四种格式之一: local DATABASE USER METHOD [OPTIONS] host DATABASE USER ADDRESS METHOD [OPTIONS] hostssl DATABASE USER ADDRESS METHOD [OPTIONS] hostnossl DATABASE USER ADDRESS METHOD [OPTIONS] 说明: local:只接受通过Unix域套接字进行的连接。 host:既接受一个普通的TCP/IP套接字连接,也接受一个SSL加密的TCP/IP套接字连接。 hostssl:只接受一个经过SSL加密的TCP/IP套接字连接。 hostnossl:只接受一个普通的TCP/IP套接字连接。 DATABASE:声明记录所匹配且允许访问的数据库:a) all:表示该记录匹配所有数据库;b) sameuser:表示如果请求访问的数据库和请求的用户同名,则匹配;c) samerole/ samegroup:表示请求的用户必须是与数据库同名角色中的成员;d) 一个包含数据库名的文件或者文件中的数据库列表:文件可以通过在文件名前面加前缀@来声明;e) 特定的数据库名称或者用逗号分隔的数据库列表; USER:声明记录所匹配且允许访问的数据库用户。a) all:表明该记录匹配所有用户;b) 用户角色:表示匹配任何直接或者间接属于这个角色的成员;c) 一个包含用户名的文件或者文件中的用户列表:文件可以通过在文件名前面加前缀@来声明;d) 特定的数据库用户名或者用逗号分隔的用户列表; ADDRESS:指定与记录匹配且允许访问的IP地址范围,支持IPv4和IPv6,可以使用如下两种形式来表示:a) IP地址/掩码长度。例如:10.10.0.0/24;b) IP地址子网掩码。例如:10.10.0.0 255.255.255.0 METHOD:声明连接时使用的认证方法。a) trust:只完全信任从服务器本机使用gsql且不指定-U参数的连接,此时不需要口令;b) reject:无条件地拒绝连接。常用于过滤某些主机;c) md5:要求客户端提供一个md5加密的口令进行认证(不推荐使用);d) sha256:要求客户端提供一个sha256算法加密的口令进行认证;e) cert:客户端证书认证模式,必须是SSL连接且客户端须提供有效的SSL证书,用户名必须与证书所有者同名;f) gss:使用基于gssapi的kerberos认证;g) ldap:ldap认证; 4. 异常处理 问题现象 解决方法 用户名或密码错误 FATAL: invalid username/password,login denied 说明用户名或者密码错误,请检查输入是否有误 连接的数据库不存在 FATAL: database “TESTDB” does not exist 说明尝试连接的数据库不存在,请检查连接的数据库名输入是否有误 未找到客户端匹配记录 FATAL: no pg_hba.conf entry for host “10.10.0.60”, user “ANDYM”, database “TESTDB” 说明已经连接了服务器,但服务器拒绝了连接请求,因为没有在pg_hba.conf配置文件里找到匹配的记录。请联系管理员在pg_hba.conf配置文件加入用户的信息 证书校验失败 SSL error: certificate verify failed 说明客户端CA校验服务器证书失败,请检查客户端CA证书配置是否有误 无效CA SSL error: tlsv1 alert unknown ca 说明客户端发送的证书,服务器侧CA校验失败,请检查客户端证书配置是否有误 服务器不支持SSL,但客户端要求SSL连接 server does not support SSL, but SSL was required 说明服务器关闭SSL建连,而客户端强制要求建连SSL连接,请联系管理员开启SSL连接(或客户端采用非SSL连接) 服务器强制要求SSL连接,客户端不支持 FATAL: SSL connection is required by the database system 说明客户端不支持SSL建连,请检查客户端SSL建连相关参数配置是否有误 服务端认证模式选择证书认证,校验失败 FATAL: certificate authentication failed for user “user01” 说明服务端认证模式选择证书认证,而客户端登录用户user01与证书不匹配,请检查客户端证书配置是否有误 校验服务端证书失败 server common name “server” does not match host name 说明客户端认证模式选择verify-full,而校验的服务器主机名与服务器证书中名称不一致,请检查“/etc/hosts”中配置的服务器主机名是否有误 错误的版本 SSL error: wrong version number 说明服务器无法读取到服务器证书,请联系管理员检查服务器证书配置是否有误 5. 总结 连接认证机制就是GaussDB(DWS)数据安全的一套有效防护机制,连接认证机制可以防止非法用户入侵GaussDB(DWS)系统内部。GaussDB(DWS)是基于客户端/服务器(C/S)架构的系统,通信过程是基于TPC/IP协议,为了确保用户访问的可信,建立了连接认证机制:通过安全套接字层(SSL)实现通信双方的证书校验和秘钥协商从而保护网络连接,通过服务端的认证模块确保用户名和密码合法。 关于SSL,SSL(及其继任者TLS)是在应用程序级实现的,位于应用层协议(HTTP、FTP)和传输层协议(TCP)之间。如果正确地配置了SSL,则第三方观察者最多只能获得连接参数、传输频率和大概数据量,但是无法读取或更改这些信息。基于SSL的证书校验可以确保通信双方(客户端和服务端)身份的真实性、秘钥协商可以确保数据的完整性和私密性。SSL/TLS在Internet协议栈中的位置如图所示: 关于认证模块,在建立的TCP/IP通道(SSL)的基础上,根据服务器配置文件pg_hba.conf中限定的合法用户名、数据库名、IP地址以及认证方式等信息,GaussDB(DWS)认证模块对用户名和密码进行校验,确保合法用户能正常连接到GaussDB(DWS)。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Libcomm通信库:GaussDB(DWS) 为解决建联过多的小妙招

本文分享自华为云社区《GaussDB(DWS) 集群通信系列三:Libcomm通信库》,作者: 半岛里有个小铁盒。 1.前言 适用版本:【8.1.0(及以上)】 在大规模集群、高并发业务下,如果有1000DN集群,每个stream线程需要建立1000个连接。如果1000 stream并发,DN总共需要建立100万个连接,会消耗大量的连接、内存、fd资源。为了解决这个问题,我们引入了Libcomm通信库,在一个物理长连接上模拟n个逻辑连接,使得所有并发的数据跑在一个物理连接上,极大的解决了物理连接数过多和建连耗时的问题。 2.基本原理 GaussDB(DWS)为解决建联过多的问题,实现了Libcomm通信库(即逻辑连接通信库),在一个物理长连接上模拟n个逻辑连接,使得所有并发的数据跑在一个物理连接上。比如DN1需要给DN2发送数据,并发数1000,在原有逻辑下,DN1需要建立与DN2连接的1000个线程与之进行交互,消耗了大量的连接、内存、fd资源,而改造Libcomm通信库之后,DN1与DN2仅需建立一个真正的物理连接,在这个物理连接上可以建立很多个逻辑链接,这样可以使得1000个并发就可以用同一个物理连接进行数据交互。 那么GaussDB(DWS)的逻辑连接是怎么实现的呢?首先我们从连接数据流入手,挖掘其实现逻辑。 物理连接支持TCP、RDMA等协议连接,以TCP为例,其物理连接数据流可以分为两部分,即数据包头+数据。数据包头为固定长度,其中包含逻辑连接号和数据块长度,用来区别逻辑连接,并接收每个连接各自对应的数据。 了解了物理连接发送的数据流,那具体的发送逻辑是什么样的呢?其具体的流程如下图所示: 上图中producer线程为发送线程,consumer线程为接收线程,发送端逻辑如下: send queue:producer发送线程将要发送的数据先push到一个无锁队列中,push完成之后,producer线程就可以继续做自己的事情了 send proxy thread:通信存在一个发送端代理线程,会统一将无锁队列中的数据,通过物理连接发送到对端 接收端逻辑如下: receive proxy thread:通信存在一个接收端代理线程,会统一将无锁队列中的数据,通过物理连接接收回来,解析数据包头之后,放到对应线程的buffer池中 buffer1:consumer接收线程会从自己对应的buffer池中取出数据,执行自己的数据加工逻辑。 上述这个方法可能会存在一些问题,并发比较高时producer线程会一直往队列里push,如果此时对端cunsumer1线程正在处理别的数据导致接收buffer1满了的话,producer2和producer3无法往网络上填充更多的数据,发送阶段就会阻塞,而此时可能consumer2和consumer3正在空闲状态,等待这个接收数据,但是因为发送端阻塞而接收不到,这种场景会严重影响性能。这个模型我们称之为push模型。因此我们需要通过另外一种流控机制来解决这个问题,我们称之为pull模型。 push模型:发送端不感知接收端状态。一直往无锁队列中push,直到push阻塞。 poll模型:发送端感知接收端状态。发送端一开始不会发送数据,当接收端里的buffer池内存满足一定条件时,通知对应的发送端,并告知可以接收的数据量,发送端可以按照对端可以接收的数据量进行发送。 通过poll模型的实现,在本线程阻塞的情况下,其他的线程不会阻塞,以确保物理连接中数据永远不会阻塞,保证连接的通畅性。 3.相关视图 3.1.pgxc_comm_delay 该视图展示所有DN的通信库时延状态。 该视图中的字段包括节点名称、连接对端节点的节点名称、连接对端IP的对端地址、当前物理连接使用的stream逻辑连接数量、当前物理连接一分钟内探测到的最小时延、当前物理连接一分钟内探测道德平均值和当前物理连接一分钟内探测到的最大时延。 3.2.pgxc_comm_recv_stream 该视图展示所有DN上的通信库接收流状态。其中字段包括节点名称、使用此通信流的线程ID、连接对端节点名称、连接对端节点ID、通信对端DN在本DN内的标识编号、通信流在物理连接中的标识编号、通信流所使用的tpc通信socket、通信流当前的状态、通信流对应的debug_query_id编号、通信流所执行查询的plan_node_id编号、通信流所执行查询send端的smpid编号、通信流所执行查询recv端的smpid编号、通信流接收的数据总量、通信流当前生命周期使用时长、通信流的平均接收速率、通信流当前的通信配额值、通信流当前缓存的数据大小。 3.3.pgxc_comm_send_stream 该视图展示所有DN上的通信库发送流状态。其中字段包括节点名称、使用此通信流的线程ID、连接对端节点名称、连接对端节点ID、通信对端DN在本DN内的标识编号、通信流在物理连接中的标识编号、通信流所使用的tpc通信socket、通信流当前的状态、通信流对应的debug_query_id编号、通信流所执行查询的plan_node_id编号、通信流所执行查询send端的smpid编号、通信流所执行查询recv端的smpid编号、通信流接收的数据总量、通信流当前生命周期使用时长、通信流的平均接收速率、通信流当前的通信配额值和通信流等待quota值产生的额外时间开销。 3.4.pgxc_comm_status 该视图展示所有DN的通信库状态。其中字段包括节点名称、节点通信库接收速率,单位为byte/s、节点通信库发送速率,单位为byte/s、节点通信库接收速率,单位为Kbyte/s、节点通信库发送速率,单位为Kbyte/s、cmailbox的buffer大小、libcomm进程通信内存的大小、libpq进程通信内存的大小、postmaster线程实时使用率、gs_sender_flow_controller线程实时使用率、gs_receiver_flow_controller线程实时使用率、多个gs_receivers_loop线程中最高的实时使用率、当前使用的逻辑连接总数。 4.相关GUC参数 4.1 comm_max_datanode 表示TCP代理通信库支持的最大DN数,最小值为1,最大值为8192。当DN数小于256时,默认值为256;否则,为大于等于DN数的2的N次方。在集群扩容、缩容场景下,要注意此参数的变更。 4.2 comm_max_stream 表示TCP代理通信库支持的最大并发stream数量,默认值为1024,最大为60000,此参数要保证大于并发数 每并发平均stream算子数 (smp的平方),否则会报错Cannot get stream index, maybe comm_max_stream is not enough。此外,在设置此参数时需要考虑占用内存问题,其大小为256byte * comm_max_stream * comm_max_datanode,可见在内存、comm_max_datanode和comm_max_stream三者之间需要一个动态的规划。 针对comm_max_stream不足问题,可以考虑三种解决方案: 新版本直接使用pgxc_comm_status视图查看DN的stream使用情况:select node_name, stream from pgxc_comm_status order by 2 desc; 在CN上查询当前任意两个DN之间的stream情况:select node_name, remote_name, count(*) as stream from pgxc_comm_send_stream group by 1, 2 order by 3 desc limit 30; 若当前业务恢复, 可使用脚本对stream进行监控; 然而,还有情况是个别的SQL语句严重消耗stream,此时可以使用实时topsql或历史topsql找到对应的语句,修改以解决问题。 4.3 comm_max_receiver 表示TCP代理通信库接收端接收线程的数量,最大值为50,默认值为4。在大集群、大并发场景下,适当的调大该参数有利于提升查询的性能;但如果通信层可用内存不足,线程间有竞争会对接收性能有负面影响。 注:SMP是指对称多处理技术,数据库领域的SMP并行技术一般指利用多线程技术实现查询的并行执行,以充分利用CPU资源,从而提升查询性能。SMP特性通过算子并行来提升性能,同时会占用更多的系统资源,在使用时,需要根据使用场景与限制进行合理的配置。在GaussDB中,SMP功能由query_dop参数决定,默认值为1。 4.4 comm_cn_dn_logic_conn 对于256节点的集群来说,并发场景导致CN和DN之间存在大量连接,每个连接占用一个端口,则CN的端口号很容易受限。为解决此问题,设计了CN多流,即CN与DN之间采用逻辑连接。comm_cn_dn_logic_conn参数默认值是off,在集群规模或并发达到一定程度时,需要将其开启为on,避免CN与DN之间由于端口号受限而无法建连。 4.5 comm_quota_size TCP代理通信库采用pull模式进行流量控制,避免消息堵塞。两个DN分别有一个buffer,当一条通道发送端数据量过大时,很容易造成buffer填满,阻塞了其他通道的发送。此时,对于每条通道设置一个quota,接收端根据buffer剩余空间的大小发送给发送端一个合理quota值,发送端根据quota大小发送数据。 comm_quota_size表示每个通道单次不间断发送数据量配额,默认值1MB。当通道发送数据量达到配额时,发送端等待接收端重新发送配额,进而继续发送数据,从而实现流控功能。其取值为0时,表示不使用quota,在一些大流量等场景中,查询之间可能会有影响。在1GE网卡环境中,受网卡能力限制,应该调小该参数,推荐20KB~40KB。如果环境内存充足,参数comm_usable_memory设置较大,可以适当调大,从而提升性能。 4.6 comm_usable_memory commusable_memory表示的是TCP代理通信库可使用的最大内存大小,默认值4000MB。此参数需要根据环境内存及部署方式具体配置,保证了系统不会因为通信层接收缓存造成进程内存膨胀。在单台机器上,通信占用内存最坏情况=部署节点个数* comm_usable_memory。考虑环境内存情况,此参数配置过小,会影响通信性能,过大则可能造成系统内存不足等问题。与comm_quota_size结合,进行合理的配置至关重要。 5.总结 本文详细介绍了Libcomm通信库及其原理,让我们更好的理解GaussDB(DWS)集群通信中的具体逻辑,对于GaussDB(DWS)通信运维也具备一定的参考意义。 6.参考连接 GaussDB重要通信参数汇总:https://bbs.huaweicloud.com/blogs/239863 【带你走进DWS大集群内幕】大集群通信:作业hang、残留问题定位:https://bbs.huaweicloud.com/blogs/407719 GaussDB(DWS) 集群通信系列三:集群通信常用视图:https://bbs.huaweicloud.com/blogs/209112 GaussDB(DWS)通信库libpq重构介绍(一):https://bbs.huaweicloud.com/blogs/289336 GaussDB(DWS)通信库libpq重构介绍(二):https://bbs.huaweicloud.com/blogs/297955 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Jacoco在K8S集群项目中部署小妙招

在项目交付过程中为了保证软件的质量,在交付之前通常会采用单元测试、接口测试、功能测试等手段对代码进行一次全方位的审查。怎样把case设计的全面、精简就成为了软件测试过程中最重要的命题,但在实际工作过程中,常常会遇到以下问题: 开发同学自测过程中,异常代码逻辑并未执行; 测试用例经过了反复的评审,但还是有部分异常情境未覆盖,漏测情况时有出现; 接口自动化测试case无法确定是否覆盖到了所有代码逻辑。 应对这种情况时,业界常常采用Jacoco来分析变更代码的覆盖率。 Jacoco简介 Jacoco是一个开源的代码覆盖率工具,支持JVM,很多第三方的工具提供对Jacoco的集成,如Jenkins、IDEA、Sonar。 关于Jacoco的注入原理和注入方式,在官方文档上已经写得非常详细了,大家可以去参考一下~ Jaoco在统计功能测试覆盖率时,通常使用on-the-fly模式,在启动被测应用服务时,添加jvm参数 -javaagent,指定jar文件启动代理程序,代理程序在通过 Class Loader 装载一个 class 前判断是否需要注入 class 文件,将统计代码插入 class ,测试覆盖率分析就可以在 JVM 执行测试的过程中完成。然后使用官方提供的cli包去连接代理获取exec文件,根据exec文件生成代码覆盖率报告。 在K8S集群项目中应用Jacoco 我们使用Jacoco的场景主要是用于统计功能测试的代码覆盖率,被测系统部署在K8s集群中使用传统的部署的方式会遇到下列问题: 1、 集群内被测服务以TCP server方式启动Jacoco代理后,需要去连接该代理,但集群外不能直接访问集群内的代理,需要在集群配置对外暴露的端口,不灵活; 2、service对外暴露的IP可能会变化,采用ingress,配置比较复杂; 3、存在多个副本时,不易获取每个副本的覆盖率文件。 一种解决方案是被测服务以file方式启动Jacoco代理,就不需要去连接该代理,停掉服务后,就会生成覆盖率文件。但是服务停掉后,POD也被销毁了,无法取到生成的覆盖率文件。 第二种解决方案是被测服务以client的方式启动Jacoco代理,自己写一个服务端程序,部署在集群外,让代理主动来连接服务端,这样就解决了集群内外的通信问题,该方式在被测服务运行前要先启动服务端程序,否则应用服务连接不到服务端,会启动失败。服务端定时获取并生成覆盖率文件,不能事件触发,使用不方便。多人使用时,可能会混淆覆盖率文件。 但是,既然在容器内能运行jar包,就可以把jacococli放在容器内运行,然后去连接以TCP server方式启动的jacoco代理,获取覆盖率文件后,拷贝到集群外的jenkins服务器,生成覆盖率报告。该方案解决了与集群内的jacoco代理通信的问题,配置简单,大部分操作可以直接在jenkins执行。 配置流程 具体的配置步骤如下: 1. 修改jenkins上被测服务CD任务下的镜像制作脚本,由server_build.sh 修改为server_build.sh_jacoco,将jacoco的Agent包打到镜像中,用于步骤2在jar文件启动代理程序。 2. 登录jenkins服务器,进入对应服务的CI工程目录,在target目录下找到对应的版本包,eg: /home/jenkins-new/jenkins_home/workspace/测试环境-k8s-后端-oneos-authentication-ci/target/ 将版本包下载到本地,解压后修改bin目录下的start.sh,增加jvm参数 - javaagent:/home/app/jacocoagent.jar=includes=**,output=tcpserver,port=11111,address=127.0.0.1*,append=true ,该参数用于启动jacoco代理。 注意:由于代码库中的start.sh未修改,每次执行CI操作后,需执行步骤2修改jvm启动参数 3. 在jenkin中新建任务,名称为”代码覆盖率-xxx“,在构建-执行shell中输入下列命令: 1)定义svc_name变量, 值为k8s中pod的名称前缀,如cms-portal-manager,可在portainer查看 svc_name="xxx" 2)在K8S集群的master节点执行copy_exec.sh。 ansible 10.11.12.13 -u app -b -m shell -a "bash /home/app/copy_exec.sh ${svc_name}" 该shell脚本主要是在每一个业务Pod内,使用jacoco.cli包去连接代理,获取覆盖率数据,生成exec文件,然后将文件从容器内拷贝出来。 3)将覆盖率数据文件从K8S主节点拷贝到Jenkins服务器中该任务对应的路径。 scp app@10.11.12.13:/tmp/${svc_name}/res-${svc_name}*.exec /var/jenkins_home/workspace/代码覆盖率-xxx/ 4)将被测服务编译的class文件拷贝到该任务的当前路径 cp -r /var/jenkins_home/workspace/测试环境-cms-portal-manager-ci/cms-portal-manager/target/ ./ 5)将被测服务的源码文件拷贝到该任务的当前路径 cp -r /var/jenkins_home/workspace/测试环境-cms-portal-manager-ci/cms-portal-manager/src/ ./ eg: 4. 在jenkins任务的invoke Ant,增加ant的配置,Properties中param1的值修改为当前任务名称,通过Ant,可以将多个exec文件合并。 5、在jenkins任务增加构建后操作,选择Record Jacoco coverage report,默认配置,保存退出。 6、对被测服务执行CD操作后,执行覆盖率任务,点击coverage report,查看覆盖率报告。 本文完~

优秀的个人博客,低调大师

踩准时钟节拍、玩转时间转换,鸿蒙轻内核时间管理有妙招

摘要:本文带领大家一起剖析了鸿蒙轻内核的时间管理模块的源代码。时间管理模块为任务调度提供必要的时钟节拍,会向应用程序提供所有和时间有关的服务,如时间转换、统计、延迟功能。 本文分享自华为云社区《鸿蒙轻内核M核源码分析系列六 时间管理》,原文作者:zhushy 。 本文会继续分析Tick和时间相关的源码,给读者介绍鸿蒙轻内核的时间管理模块。本文中所涉及的源码,以OpenHarmony LiteOS-M内核为例,均可以在开源站点https://gitee.com/openharmony/kernel_liteos_m获取。 时间管理模块以系统时钟为基础,可以分为2部分,一部分是SysTick中断,为任务调度提供必要的时钟节拍;另外一部分是,给应用程序提供所有和时间有关的服务,如时间转换、统计功能。 系统时钟是由定时器/计数器产生的输出脉冲触发中断产生的,一般定义为整数或长整数。输出脉冲的周期叫做一个“时钟滴答”,也称为时标或者Tick。Tick是操作系统的基本时间单位,由用户配置的每秒Tick数决定。如果用户配置每秒的Tick数目为1000,则1个Tick等于1ms的时长。另外一个计时单位是Cycle,这是系统最小的计时单位。Cycle的时长由系统主时钟频率决定,系统主时钟频率就是每秒钟的Cycle数,对于216MHz的CPU,1秒产生216000000个cycles。 用户以秒、毫秒为单位计时,而操作系统以Tick为单位计时,当用户需要对系统进行操作时,例如任务挂起、延时等,此时可以使用时间管理模块对Tick和秒/毫秒进行转换。 下面,我们剖析下时间管理模块的源代码,若涉及开发板部分,以开发板工程targets\cortex-m7_nucleo_f767zi_gcc\为例进行源码分析。 1、时间管理初始化和启动 我们先看下时间管理模块的相关配置,然后再剖析如何初始化,如何启动。 1.1 时间管理相关的配置 时间管理模块涉及3个配置项,系统时钟OS_SYS_CLOCK、每秒Tick数目LOSCFG_BASE_CORE_TICK_PER_SECOND两个配置选项,还有宏LOSCFG_BASE_CORE_TICK_HW_TIME。LOSCFG_BASE_CORE_TICK_HW_TIME默认关闭,开启时,需要提供定制函数VOID platform_tick_handler(VOID),在Tick中断处理函数中执行定制操作。这些配置项在模板开发板工程目录的文件target_config.h中定义,如文件targets\cortex-m7_nucleo_f767zi_gcc\target_config.h中定义如下: #define OS_SYS_CLOCK 96000000 #define LOSCFG_BASE_CORE_TICK_PER_SECOND (1000UL) #define LOSCFG_BASE_CORE_TICK_HW_TIME 0 1.2 时间管理初始化和启动 函数INT32 main(VOID)会调用kernel\src\los_init.c中的函数UINT32 LOS_Start(VOID)启动系统,该函数会调用启动调度函数UINT32 HalStartSchedule(OS_TICK_HANDLER handler)。源码如下: LITE_OS_SEC_TEXT_INIT UINT32 LOS_Start(VOID) { return HalStartSchedule(OsTickHandler); } 函数UINT32 HalTickStart(OS_TICK_HANDLER *handler)定义在kernel\arch\arm\cortex-m7\gcc\los_context.c,源码如下。其中函数参数为Tick中断处理函数OsTickHandler(),后文会分析该tick中断处理函数。⑴处代码继续调用函数进一步调用函数HalTickStart(handler)来设置Tick中断启动。⑵处会调用汇编函数HalStartToRun开始运行系统,后续任务调度系列再详细分析该汇编函数。 LITE_OS_SEC_TEXT_INIT UINT32 HalStartSchedule(OS_TICK_HANDLER handler) { UINT32 ret; ⑴ ret = HalTickStart(handler); if (ret != LOS_OK) { return ret; } ⑵ HalStartToRun(); return LOS_OK; /* never return */ } 函数HalTickStart(handler)定义在文件kernel\arch\arm\cortex-m7\gcc\los_timer.c,源码如下,我们分析下函数的代码实现。⑴处校验下时间管理模块的配置项的合法性。在开启宏LOSCFG_USE_SYSTEM_DEFINED_INTERRUPT时,会使用系统定义的中断。会执行⑵处的代码,调用定义在文件kernel\arch\arm\cortex-m7\gcc\los_interrupt.c中的函数OsSetVector()设置中断向量,该函数在中断系列会详细分析。⑶处设置全局变量g_sysClock为系统时钟,g_cyclesPerTick为每tick对应的cycle数目,g_ullTickCount初始化为0,表示系统tick中断发生次数。⑷处调用定义在targets\cortex-m7_nucleo_f767zi_gcc\Drivers\CMSIS\Include\core_cm7.h文件中的内联函数uint32_t SysTick_Config(uint32_t ticks),初始化、启动系统定时器Systick和中断。 WEAK UINT32 HalTickStart(OS_TICK_HANDLER *handler) { UINT32 ret; ⑴ if ((OS_SYS_CLOCK == 0) || (LOSCFG_BASE_CORE_TICK_PER_SECOND == 0) || (LOSCFG_BASE_CORE_TICK_PER_SECOND > OS_SYS_CLOCK)) { return LOS_ERRNO_TICK_CFG_INVALID; } #if (LOSCFG_USE_SYSTEM_DEFINED_INTERRUPT == 1) #if (OS_HWI_WITH_ARG == 1) OsSetVector(SysTick_IRQn, (HWI_PROC_FUNC)handler, NULL); #else ⑵ OsSetVector(SysTick_IRQn, (HWI_PROC_FUNC)handler); #endif #endif ⑶ g_sysClock = OS_SYS_CLOCK; g_cyclesPerTick = OS_SYS_CLOCK / LOSCFG_BASE_CORE_TICK_PER_SECOND; g_ullTickCount = 0; ⑷ ret = SysTick_Config(g_cyclesPerTick); if (ret == 1) { return LOS_ERRNO_TICK_PER_SEC_TOO_SMALL; } return LOS_OK; } 1.3 Tick中断处理函数OsTickHandler() 文件kernel\src\los_tick.c定义的函数VOID OsTickHandler(VOID),是时间管理模块中执行最频繁的函数,每当Tick中断发生时就会调用该函数。我们分析下该函数的源码,⑴处如果开启宏LOSCFG_BASE_CORE_TICK_HW_TIME,会调用定制的tick处理函数platform_tick_handler(),默认不开启。⑵处会更新全局变量g_ullTickCount,⑶处如果开启宏LOSCFG_BASE_CORE_TIMESLICE,会检查当前运行任务的时间片,在后续任务模块会详细分析下函数OsTimesliceCheck()。⑷处会遍历任务的排序链表,检查是否有超时的任务。⑸处如果支持定时器特性,会检查定时器是否超时。 源码如下: LITE_OS_SEC_TEXT VOID OsTickHandler(VOID) { #if (LOSCFG_BASE_CORE_TICK_HW_TIME == 1) ⑴ platform_tick_handler(); #endif ⑵ g_ullTickCount++; #if (LOSCFG_BASE_CORE_TIMESLICE == 1) ⑶ OsTimesliceCheck(); #endif ⑷ OsTaskScan(); // task timeout scan #if (LOSCFG_BASE_CORE_SWTMR == 1) ⑸ (VOID)OsSwtmrScan(); #endif } 2、LiteOS内核时间管理常用操作 时间管理提供下面几种功能,时间转换、时间统计等,这些函数定义在文件kernel\src\los_tick.c,我们剖析下这些操作的源代码实现。 2.1 时间转换操作 2.1.1 毫秒转换成Tick 函数UINT32 LOS_MS2Tick(UINT32 millisec)把输入参数毫秒数UINT32 millisec可以转化为Tick数目。代码中OS_SYS_MS_PER_SECOND,即1秒等于1000毫秒。时间转换也比较简单,知道一秒多少Tick,除以OS_SYS_MS_PER_SECOND,得出1毫秒多少Tick,然后乘以millisec,计算出Tick数目的结果值并返回。 LITE_OS_SEC_TEXT_MINOR UINT32 LOS_MS2Tick(UINT32 millisec) { if (millisec == OS_NULL_INT) { return OS_NULL_INT; } return ((UINT64)millisec * LOSCFG_BASE_CORE_TICK_PER_SECOND) / OS_SYS_MS_PER_SECOND; } 2.1.2 Tick转化为毫秒 函数UINT32 LOS_Tick2MS(UINT32 tick)把输入参数Tick数目转换为毫秒数。时间转换也比较简单,ticks数目除以每秒多少Tick数值LOSCFG_BASE_CORE_TICK_PER_SECOND,计算出多少秒,然后转换成毫秒,计算出结果值并返回。 LITE_OS_SEC_TEXT_MINOR UINT32 LOS_Tick2MS(UINT32 ticks) { return ((UINT64)ticks * OS_SYS_MS_PER_SECOND) / LOSCFG_BASE_CORE_TICK_PER_SECOND; } 2.1.3 Cycle数目转化为毫秒 介绍转换函数之前,先看下一个CpuTick结构体,结构体比较简单,就2个成员,分别表示一个UINT64类型数据的高、低32位数值。 typedef struct tagCpuTick { UINT32 cntHi; /* < 一个64位数值的高32位 */ UINT32 cntLo; /* < 一个64位数值的低32位 */ } CpuTick; 继续看转换函数OsCpuTick2MS(),它可以把CpuTick类型表示的cycle数目转换为对应的毫秒数,输出毫秒数据的高、低32位数值。看下具体的代码,⑴处校验参数是否为空指针,⑵处检查系统时钟是否配置。⑶处把CpuTick结构体表示的cycle数目转化为UINT64类型数据。⑷处进行数值计算,(DOUBLE)g_sysClock / OS_SYS_MS_PER_SECOND得到每毫秒多少个cycle数,然后和tmpCpuTick做除法运算,得到cycle数目对应的毫秒数目。⑸处把DOUBLE类型转换为UINT64类型,然后执行⑹,分别把结果数值的高、低64位赋值给*msLo、*msHi。 LITE_OS_SEC_TEXT_INIT UINT32 OsCpuTick2MS(CpuTick *cpuTick, UINT32 *msHi, UINT32 *msLo) { UINT64 tmpCpuTick; DOUBLE temp; ⑴ if ((cpuTick == NULL) || (msHi == NULL) || (msLo == NULL)) { return LOS_ERRNO_SYS_PTR_NULL; } ⑵ if (g_sysClock == 0) { return LOS_ERRNO_SYS_CLOCK_INVALID; } ⑶ tmpCpuTick = ((UINT64)cpuTick->cntHi << OS_SYS_MV_32_BIT) | cpuTick->cntLo; ⑷ temp = tmpCpuTick / ((DOUBLE)g_sysClock / OS_SYS_MS_PER_SECOND); tmpCpuTick = (UINT64)temp; *msLo = (UINT32)tmpCpuTick; *msHi = (UINT32)(tmpCpuTick >> OS_SYS_MV_32_BIT); return LOS_OK; } 2.1.4 Cycle数目转化为微秒 转换函数OsCpuTick2US(),它可以把CpuTick类型表示的cycle数目转换为对应的毫秒数,输出毫秒数据的高、低32位数值。该函数和OsCpuTick2MS()类似,自行阅读即可。 LITE_OS_SEC_TEXT_INIT UINT32 OsCpuTick2US(CpuTick *cpuTick, UINT32 *usHi, UINT32 *usLo) { UINT64 tmpCpuTick; DOUBLE temp; if ((cpuTick == NULL) || (usHi == NULL) || (usLo == NULL)) { return LOS_ERRNO_SYS_PTR_NULL; } if (g_sysClock == 0) { return LOS_ERRNO_SYS_CLOCK_INVALID; } tmpCpuTick = ((UINT64)cpuTick->cntHi << OS_SYS_MV_32_BIT) | cpuTick->cntLo; temp = tmpCpuTick / ((DOUBLE)g_sysClock / OS_SYS_US_PER_SECOND); tmpCpuTick = (UINT64)temp; *usLo = (UINT32)tmpCpuTick; *usHi = (UINT32)(tmpCpuTick >> OS_SYS_MV_32_BIT); return LOS_OK; } 2.2 时间统计操作 2.2.1 获取每个Tick等于多少Cycle数 函数UINT32 LOS_CyclePerTickGet(VOID)计算1个tick等于多少cycle。g_sysClock系统时钟表示1秒多少cycle,LOSCFG_BASE_CORE_TICK_PER_SECOND一秒多少tick,相除计算出1tick多少cycle数,即g_cyclesPerTick = g_sysClock / LOSCFG_BASE_CORE_TICK_PER_SECOND。 LITE_OS_SEC_TEXT_MINOR UINT32 LOS_CyclePerTickGet(VOID) { return g_cyclesPerTick; } 2.2.2 获取自系统启动以来的Tick数 UINT64 LOS_TickCountGet(VOID)函数计算自系统启动以来的Tick中断的次数。需要注意,在关中断的情况下不进行计数,不能作为准确时间使用。每次Tick中断发生时,在函数VOID OsTickHandler(VOID)中会更新g_ullTickCount数据。 LITE_OS_SEC_TEXT_MINOR UINT64 LOS_TickCountGet(VOID) { return g_ullTickCount; } 2.2.3 获取系统时钟 UINT32 LOS_SysClockGet(VOID)函数获取配置的系统时钟。 UINT32 LOS_SysClockGet(VOID) { return g_sysClock; } 2.2.4 获取系统启动以来的Cycle数 函数VOID HalGetCpuCycle(UINT32 *cntHi, UINT32 *cntLo)定义在文件kernel\arch\arm\cortex-m7\gcc\los_timer.c中,该函数获取系统启动以来的Cycle数。返回结果按高、低32位的无符号数值UINT32 *cntHi, UINT32 *cntLo分别返回。 我们看下该函数的源码。先关中断,然后⑴处获取启动启动以来的Tick数目。⑵处通过读取当前值寄存器SysTick Current Value Register,获取hwCycle。⑶处表示中断控制和状态寄存器Interrupt Control and State Register的第TICK_CHECK位为1时,表示挂起systick中断,tick没有计数,需要加1校准。⑷处根据swTick、g_cyclesPerTick和hwCycle计算出自系统启动以来的Cycle数。⑸处获取Cycle数的高、低32位的无符号数值,然后开中断、返回。 LITE_OS_SEC_TEXT_MINOR VOID HalGetCpuCycle(UINT32 *cntHi, UINT32 *cntLo) { UINT64 swTick; UINT64 cycle; UINT32 hwCycle; UINTPTR intSave; intSave = LOS_IntLock(); ⑴ swTick = g_ullTickCount; ⑵ hwCycle = SysTick->VAL; ⑶ if ((SCB->ICSR & TICK_CHECK) != 0) { hwCycle = SysTick->VAL; swTick++; } ⑷ cycle = (((swTick) * g_cyclesPerTick) + (g_cyclesPerTick - hwCycle)); ⑸ *cntHi = cycle >> SHIFT_32_BIT; *cntLo = cycle & CYCLE_CHECK; LOS_IntRestore(intSave); return; } 小结 本文带领大家一起剖析了鸿蒙轻内核的时间管理模块的源代码。时间管理模块为任务调度提供必要的时钟节拍,会向应用程序提供所有和时间有关的服务,如时间转换、统计、延迟功能。后续也会陆续推出更多的分享文章,敬请期待,也欢迎大家分享学习、使用鸿蒙轻内核的心得,有任何问题、建议,都可以留言给我们:https://gitee.com/openharmony/kernel_liteos_m/issues。为了更容易找到鸿蒙轻内核代码仓,建议访问https://gitee.com/openharmony/kernel_liteos_m,关注Watch、点赞Star、并Fork到自己账户下,谢谢。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

来看看飞桨开发者的妙招

【飞桨开发者说】韩爱庆 北京中医药大学管理学院 副教授 中药是中医临床治疗的主要载体、也是中医药文化最核心的载体,蕴含着大量的科技资源、文化资源、产业资源。据相关报道,我国是全球最大的中药材市场。数据显示,2019年预计我国中成药及饮片市场规模达到6800亿元,未来5年将达到2万亿元,可见中药材庞大的市场价值。由于中药材的真伪、优劣与临床用药的安全有效有直接关联,因此对中药材进行客观、科学的鉴定识别,有利于规范中药材市场,加强质量监控,促进中药材产业的发展。 很多学者对应用客观指标来进行中药材的鉴定识别进行了广泛的研究,相关研究所采用的方法包括近红外光谱、指纹图谱、电子鼻以及化学模式识别,或者采用多方法相结合来开展研究。这些方法的共同特征是需要基于专家经验或先验知识来人工设计或提取特征,前期的特征提取工作量特别大,得到的模型在训练集上准确率虽然高,但在测试集上普遍存在泛化能力差的情况;另外使用这些方法来进行中药识别需要专用设备,便利性较差,应用门槛高,不利于推广应用。因此,开发一款能够自动提取特征,并能够使用通用终端设备进行识别,准确率高,泛化性能好的中药识别系统是行业的迫切需求。 近年来,以深度学习为代表的人工智能技术飞速发展。与以往不同的是,这次人工智能不仅在学术界备受关注,在工业界也备受推崇。以“深度学习”为关键词搜索国家自然科学金委近年资助项目,发现基金委资助和立项的“深度学习”相关的课题数量呈逐年快速上升趋势,如下图所示。由于本轮人工智能可落地性非常强,可快速为行业应用赋能,所以在工业、商业、金融等各领域亦备受追捧,目前正快速应被推广应用到各个领域。 在此背景下,世界知名公司纷纷推出深度学习框架,在美国,Google推出TensorFlow,Facebook推出Pytorch,在国内,百度推出了飞桨。作为集深度学习核心框架、基础模型库、端到端开发套件、工具组件和服务平台于一体的开源深度学习平台。在深度学习框架上,我们选择了飞桨。基于飞桨模型,并借助百度AI Studio开发平台以及平台提供的Tesla V100 GPU算力,我们开发了基于深度学习的中药材识别模型,并完成了微信小程序开发和部署。在下文中,我们将为大家解析此过程。 方案解析 01数据采集与预处理 研究对象为炮制好的中药材,植物状态的药材不在考虑范围内。应用Python编写爬虫程序从百度图片批量爬取163种中药饮片图片,经过人工复检,删除重复图片、植物状态图片和中成药图片等异常图片,最后保留33834张,每种药材的图片数量约为200张。 应用留出法,将80%的样本设置为训练集,20%的样本设置为测试集。为了增加训练集的数据量,提高模型的泛化能力,对训练集进行数据增强处理,应用数据增强技术,对已有图片做缩放、随机旋转、随机裁剪、对比度调整、色调调整以及饱和度调整,使得总训练样本量达到213140张,数据增强后,大幅提升了训练样本数量。 02配置网络 配置网络包括三个部分:网络模型、损失函数及优化函数。 本研究采用的网络模型为ResNeXt50卷积神经网络。目前主流深度学习分类模型包括LeNet、AlexNet、VGG、GoogleNet、Inception、ResNet、ResNext等。其中,ResNet是2015年ILSVRC的冠军,而ResNeXt模型是ResNet模型的升级版,是2016年ILSVRC的亚军。ResNeXt同时采用 VGG 堆叠的思想和 Inception 的 split-transform-merge 思想,以一种简单可扩展的方式延续split-transform-merge策略,整个网络的buildingblock都是一样的,不用在每个stage里对每个buildingblock的超参数进行调整,只用一个结构相同的buildingblock,重复堆叠即可形成整个网络。模型的可扩展性比较强,可以认为是在增加准确率的同时基本不改变或降低模型的复杂度。以下为ResNet(左图)与ResNeXt(右图)基本block对比。 Left:ABlock of ResNet Right:Ablock of ResNeXt with cardinality=32,with roughly the same complexity 构成ResNeXt基本单元的Buildingblock代码如下: def bottleneck_block(self,input,num_filters,stride,cardinality,reduction_ratio,name=None): conv0 = self.conv_bn_layer( input=input, num_filters=num_filters, filter_size=1, act='relu', name='conv' + name + '_x1') conv1 = self.conv_bn_layer( input=conv0, num_filters=num_filters, filter_size=3, stride=stride, groups=cardinality, act='relu', name='conv' + name + '_x2') conv2 = self.conv_bn_layer( input=conv1, num_filters=num_filters * 2, filter_size=1, act=None, name='conv' + name + '_x3') scale = self.squeeze_excitation( input=conv2, num_channels=num_filters * 2, reduction_ratio=reduction_ratio, name='fc' + name) short = self.shortcut(input, num_filters * 2, stride, name=name)returnfluid.layers.elementwise_add(x=short,y=scale,act='relu') ResNeXt-50的整体网络结构如下,主要是将ResNet单元换成了ResNeXt单元。 Left:ResNet-50 Right:ResNeXt-50with a 32*4d template 在输出层,将softmax作为分类输出函数,损失函数使用交叉熵(cross_entropy)函数,采用在均方根传递算法(RMSprop)上改进的适合比较大规模的适合训练大数据集的阶梯阶梯型的学习率算法,通过反向传播来不断更新模型中的参数,从而使得损失函数逐渐减小来不断优化模型。 03训练网络 针对个人和机构AI研究者普遍缺乏算力的现状,AI Studio平台免费提供基础版(CPU:2 Cores RAM:8GB,Disk:100GB)和高级版(GPU:Tesla V100,Video Mem:16GB;CPU:8Cores,RAM:32GB, Disk:100GB)两种运行环境。由于本项目数据量较大,模型训练过程选用GPU高级版运行环境。 训练分为三步:第一步配置好GPU训练环境;第二步用训练集进行训练;第三步保存好训练的模型。 第一步,定义GPU计算场所,创建一个executor,对program进行参数初始化。 第二步,设置好训练的轮数,用训练集进行训练。遍历batch_reader迭代器,喂入一个批次的数据。为方便后续分析和过程可视化,为每个pass的每个批次数据加上索引step_id,每喂入500个batch,保存一次Pass_Num,trainbatch_Num,Train_loss,Train_acc1和time,并使用print语句输出训练的中间结果,随着训练的进行,损失率逐渐下降,准确率逐渐提高,模型逐渐优化。 第三步,模型保存。由于数据量较大,需要训练几十个小时。为防止训练过程意外中断,在训练过程中,每喂入500个批次的数据保存一次中间模型,一旦出现意外中断,下次训练直接导入中间模型继续训练,不需重新开始。最终训练完成时保存最终训练模型,为预测模型做准备。 04模型预测并设计微信小程序 预测程序为独立代码模块,可独立运行。预测主要分为四步: 第一步:配置预测环境; 第二步:预处理预测图片。将非RGB图片进行模式转换,转为RGB模式;对预测图片进行裁剪和缩放,调整大小为[3, 224, 224]; 第三步:加载预测模型并将预测图像放入模型进行预测; 第四步:输出预测结果,确定结果所属类别。本研究共预测图片6766张,预测准确率predict accuracy=94%,部分图片预测结果如下图所示。 为方便应用推广,我们还设计和开发了微信小程序。用户只需使用手机扫描真实的中药饮片,即可快速识别药材名称,小程序会在识别的同时推送该中药材的性味、归经和功能主治等信息,如下图(上)所示。目前小程序已收录了257味常见中药材的药性和作用,如下图(下)所示。 目前此款小程序还在内部测试中,上线时间待定。 05总结与展望 飞桨复现了经典和前沿深度学习算法,快速迭代更新,同步学术前沿,且提供高质量支持迁移学习的工业级预训练模型,利用飞桨进行中药材图片辨识取得较好的识别效果,基于微信小程序的应用也更便于人们使用,结合AI Studio平台的强大算力、丰富的数据、海量开源算法和优质共享项目,为AI技术学习者和行业应用者打开了一扇快速通往人工智能的大门。 从中药材识别,中药材真伪鉴定,到基于舌象、人脸特征、脉象的疾病诊断和中医体质识别等领域,都有待应用深度学习技术去深入探索。也希望未来飞桨能帮助越来越多的行业完成 AI 赋能,为中医药事业的发展注入新的活力。 想与更多的深度学习开发者交流,请加入飞桨官方QQ群:796771754。 如果您想详细了解更多飞桨PaddlePaddle的相关内容,请参阅以下文档。 官网地址: https://www.paddlepaddle.org.cn/ GitHub地址: https://github.com/paddlepaddle/paddle >> 访问 PaddlePaddle 官网,了解更多相关内容。

优秀的个人博客,低调大师

混乱的春运已至,人工智能在火车站有何妙招

在春运,利用人工智能提高各方面的效率才是重中之重。 此前,国家发改委、交通部等部门预测,2017年全国春运旅客发送量将达到29.78亿人次,比上年增长2.2%。其中,铁路发送旅客量将创历史新高,达到3.56亿人次,同比增长9.7%,较2002年激增近200%。此外,再加上春运提前、预售期缩短以及可能出现的拉尼娜天气等因素,也就不难怪今年是“史上最难抢票年”了。这一切都在提醒人们抢票要赶早,尤其是北上广等热门城市,往往开售还没一分钟,车票就已所剩不多了。 对此,为了改善春运压力,12306找上了阿里云,并免去了购票验证图的关卡,在措施施行后,12306的后台较之往年明显不卡了,只不过,“一票难求”的状况依旧存在。现如今,人工智能已经成了年度热词之一,在繁忙的铁路春运中,它又可发挥怎样的作用? 抢票难!车票需合理分配 虽说每年的春运现场就是一场大灾难,不过,跟抢票比起来,那还真不算什么,想想之前镁客君帮同学抢票,好不容易登上了12306,仅仅不到一分钟,满屏就找不到一丝绿色了,简直不忍回顾。 这年头,连网上买票都要“你争我抢”,更何况那些以老人和打工者为主的需要到售票点购票的人们,他们之中有些人只能守候在售票点等那几张退票。随着互联网普及范围的扩大,这种不平衡现象愈加严重。 面对此种情况,人工智能还是有着解决方案的。借助于对历年大数据的搜集和分析,人工智能系统可以对即将到来的春运作出预估。这可不只是简简单单的一个预估,在这份数据中,必须包括高峰时间段、各车型两种购票方式的比例、余票查询的高频时间等等。 基于高峰时间段的数据,铁路总局可以对之后的发车情况作出一个调整,看看是增加列次还是增加车厢较为合理,以此对车票的发售张数和班次进行调整。而根据各车型在两种购票方式的占比,12306可以对车票进行调节分配,如绿皮火车,一般情况下,其所乘人员的车票多是在售票点购买,网络购票的比例相对较少,此时,12306就可以将车票划分为两部分,以缓解人们一部分购票压力,当然,在临发车的前几天,所有余票都将两面开放。另外,依据人们查询余票的高频时间,12306可以适当对售票时间进行调整。以在售票点买票的人为例,到了售票点,他们往往第一句问的就是“**号从**到**的票开始卖了吗?”这时候,运气好的人能买到票,运气不好的人就得记住开售的时间下次再来。对事件进行灵活的变动之后,多数人就能顺利买到票,而不是一天天算着买票的日子,或是记错日子后苦苦的等退票。 安检堵!流程需简化 除开抢票,过安检也可谓是春运一大苦!早早的到了车站,穿越人流来到检票口,满眼望去,等待安检的队伍已经排到了楼梯口,自己只能跟在队伍后面龟速前进,看着时间流逝。 为了缓解安检处的人流堵塞情况,一部分火车站已经开通了“人脸识别”安检新形式。利用人脸识别技术,人们不必等待人工核对票务信息和身份,只需刷一下脸就可完成验证,据亲身体验过的人表示,信息核实的效率是大大提高了。 然而,除了信息核对那一块,最难啃的骨头就是行李安检的那一步了。走到机器前,人们需要先行卸下身上的大包小包,然后将它们一个一个的搬上传输带,过关之后,又得在出口那里将大包小包再次挂到身上,在这过程中,人们都是不堪其苦,行李出口堵塞的情况也是常有发生,尤其是客流量大的节假日期间,大大拉低了安检效率。 面对此情况,车站何不打造一条地面安检传输带?传输带两侧皆设有扶栏,扶栏中装载了一种堪称“透视眼”的视觉传感器,可以对行李和人本身直接进行安检。比如此前麻省理工学院研发的一种微波摄像机,其可以发射微波脉冲对物体进行识别追踪,并利用计算机成像技术生成3D透视图像。由此一来,人们只需正常带着行李走上传输带即可,不仅可以避免那微乎其微的辐射,也提高了安检的效率,让一切变得井然有序。 作为年度热门之一,人工智能已经渗透到了生活的多方多面,给人们的生活带来了极大的便利。而对于每年的春运,抢票和安检都是最艰难的部分,只要上了车,之后的流程就快的多了。不过,为了以防万一,铁道部门最好利用大数据对各车次的运行情况作出一个合理安排,避免火车晚点现象的出现,另外,或许也可以在出站处安装一个人脸识别系统,加快人员的流动。 原文发布时间: 2017-01-04 18:31 本文作者: 韩璐 本文来自云栖社区合作伙伴镁客网,了解相关信息可以关注镁客网。

优秀的个人博客,低调大师

这份数据安全自查checklist请拿好,帮你补齐安全短板的妙招全在里面!

企业数据安全自查Checklist! 快来对照表单,看看你的数据安全及格了吗? 一、京东云安全Checklist建议 京东云安全拥有业界领先的安全研究团队,经过多年实践与经验积累,京东云已面向不同业务场景制定了完善详细的安全配置Checklist。京东云安全Checklist可以根据用户的需求进行补充和调整,用户也可以基于该Checklist进行自定义。 1、网络设备安全Checklist 网络设备安全配置检查包含但不限于以下内容: OS安全 帐号和口令管理 认证和授权策略 网络与服务 访问控制策略 通讯协议、路由协议 日志审核策略 加密管理 设备其他安全配置 …… 2、主机操作系统Checklist 主机操作系统安全配置检查包含但不限于以下内容: 系统漏洞补丁管理 帐号和口令管理 认证、授权策略 网络与服务、进程和启动 文件系统权限 访问控制 通讯协议 日志审核功能 防DDoS攻击 剩余信息保护 其他安全配置 …… 3、数据库Checklist 数据库安全配置检查包含但不限于以下内容: 漏洞补丁管理 帐号和口令管理 认证、授权策略 访问控制 通讯协议 日志审核功能 其他安全配置 …… 4、中间件及网络服务Checklist 中间件及常见网络服务安全配置检查包含但不限于以下内容: 漏洞补丁管理 帐号和口令管理 认证、授权策略 通讯协议 日志审核功能 其他安全配置 …… “rm -rf /*” 在Unix/linux系统的服务器上,删库的代码虽然只有短短一行,但若使用不当,后果可是“瞬间毁灭”级别的存在。 二、数据安全威胁要素 在美国德克萨斯州大学的一份调查中显示:“只有6%的公司可以在数据丢失后生存下来,43%的公司会彻底关门,51%的公司会在两年之内消失。 1、数据安全问题 通常情况下,数据安全风险来自企业内网,是以非法占用网络资源、系统资源和数据资源为目的,利用云上业务系统或资产弱点进行恶意入侵和渗透,进而提升权限以非法获取数据资源,实施诸如数据窃取、数据篡改、数据下载、拖库和删除等行为。 常见的易导致数据安全风险的因素有: 2、运维安全问题 随着信息化的发展,企事业单位 IT 系统不断发展,网络规模迅速扩大、设备数量激增,建设重点逐步从网络平台建设,转向以深化应用、提升效益为特征的运行维护阶段, IT 系统运维与安全管理正逐渐走向融合。信息系统的安全运行直接关系企业效益,构建一个强健的 IT 运维安全管理体系对企业信息化的发展至关重要,对运维的安全性提出了更高要求。 三、数据安全管理实践 根据权威机构调查统计数据表示,57%的公司认为数据库是内部攻击最脆弱的资产。数据库的安全性是指保护数据库以防止不合法使用所造成的数据泄露、更改或损坏。安全保护措施是否有效是数据库系统的主要技术指标,我们可以将数据安全看做一个木桶,整个防护体系是否坚固其实取决于短板。 回顾近年来发生的多起重大安全事件,发现这类事件几乎都与数据安全有关——无论是数据泄露,还是对数据进行删除破坏的勒索病毒皆是如此,因此,企业需要在数据全生命周期不同阶段从多个方面进行监测、防御和治理,企业不仅需要针对来自外部的威胁给予管控,同时也应预防内部的恶意员工、恶意行为以及因为各类失误造成的数据损毁,并做到快速止损、追踪溯源和准确的调查取证。由于数字经济时代的全面来临,企业的业务也逐步由数据所驱动,因此对企业数据的安全保护将会成为企业赖以生存和发展的重要基石。 接下来将根据京东云在数据安全管理方面的经验总结出在数据生命周期不同阶段的数据安全管理实践方法: 1、建立数据全生命周期安全管理闭环 目前,互联网业务创新带来了新的风险,比如数据去隐私化处理以及数据上云后的主管权问题。因此,对于数据的保护不应该只是静态的保护,而要注重流动数据的保护。京东云根据自身多年时间经验提出了纵深防御策略。 初期安全洞察 对于事前的预警要做到威胁的发现以及对数据的梳理,从隐患来源以及数据库自身的弱点,先找到数据库的潜在攻击威胁。另外,需要对不同的数据有不同的分类,通过对不同的规范、大数据保护指南、对企业自身业务的敏感性和价值等角度,对数据进行不同的标签分类,从而对不同类型以及重要度的数据,进行不同的保护措施。通过这种方式,京东云可帮助用户更有效、更低成本地对数据进行事前的保护以及预警。 数据安全可防可控 对于外部攻击,云通过对SQL或者noSQL注入的特征,对相关的访问行为进行监测和保护,并采用虚拟补丁对整个数据库进行漏洞保护。同时,强调了来自内部的“攻击”。由于人是操作的最后执行者和系统的使用者,大量的问题都是出现在操作者端——无论是误操作还是有意的攻击。因此,京东云采用了数据库操作审计和权限审批的措施,做到内部的数据可控。 打造安全软胄甲 在运维管理场景中,京东云通过运维审计管理平台提供“从登陆到退出”的全程审计与管控措施,不但能够针对运维操作行为进行跟踪、审计、记录,还可针对恶意操作、误操作进行实时拦截,从根本上杜绝前述重大数据安全事故的发生。 因此,即使京东云的数据发生泄露,攻击者也无法获取真实信息,即做到看不懂、拿不走、用不了。由于企业对于数据很可能会进行分析,或者在开发、测试环境中进行利用,因此数据在第三方传输和使用中进行脱敏处理就成了必要工作。京东云对这些数据进行随机/部分替换以及掩码处理,确保数据在离开数据库进行其他处理时不会泄露,并针对在数据库中的数据进行国密算法的加密。 如果企业真的收到了安全攻击,那么在事件发生后,快速响应并且在事后进行分析追责是重中之重。京东云对整个数据库的运行提供审计、追溯以及分析的服务,能够确保在事后通过详细的数据库行为日志确定事件源头、识别定位风险、分析业务系统中的bug以及故障。 2、典型场景实践:如何构建数据库安全护城河 近年来,越来越多的企业摒弃了原先的自建数据库转而选择购买云数据库作为公司的数据存储工具。何为云数据库?云数据库是指被优化或部署到公有云端的全托管型数据库,可以实现按需付费、按需扩展、服务高可用性、数据高可靠等优势。而这些优势恰恰解决了传统自建数据库的痛点:资源利用率低,服务水平依赖专业DBA人员,运维成本高以及硬件采购等问题。 2020年的开年,几乎对全球所有行业都带来了不小的冲击。但有一个行业例外:受疫情影响,游戏等娱乐产品的流水反而屡创新高。大量的玩家涌入游戏会使服务器变得拥堵不堪,而依托云数据库MongoDB完善的备份机制和根据备份创建实例的能力,可快速实现游戏等分区类应用场景滚服和合服中对数据迁移的需求;针对传统数据库运维成本高的问题,京东云提供了LAMP网站所必须的云主机和MySQL云数据库产品,便于企业用户将网站部署在京东云上,同时,监控备份,安全防护等多项辅助运维能力和天生的主备高可用架构,使用户无需为云数据库运维工作伤神,专注于网站发展。 目前,京东云是市场上唯一一家免费向用户提跨地域备份同步功能的厂商,帮助客户搭建异地的数据库灾备中心。当某个地域的数据库因为自然灾害等不可抗因素无法提供服务时,跨地域同步备份服务可以快速在异地搭建新的云数据库服务,满足用户异地容灾的需求。此外,京东云平台的MFA(多因子认证)功能,可以在用户执行删除实例等重要操作前,以验证码的方式进行二次校验后,确认无误后方可操作;云数据库内置的操作审计功能可以对用户行为进行审计记录,帮助追溯安全事件,快速确认问题根源。 同时,京东云免费提供了DTS(Data Transformation Service)以快捷高效的帮助用户将数据迁移上云。目前已支持将用户的源数据库迁入京东云数据库RDS和MongoDB.同时在数据迁移过程中,源数据库可正常对外提供能服务,用户可以通过控制台随时查看数据迁移进度,并在完成迁移后进行数据校验进一步保证数据完整上云。 3、典型场景实践:运维安全审计管理与追溯 优秀的运维管理平台不仅应该及时捕捉危险的运维指令,还应该为使用者提供简单易用的管理方式,不但能够提升运维效率、还能降低因较大运维管理压力导致的误操作,使安全管理人员和运维人员的精力得到有效释放,进一步降低生产运营成本。 浏览器兼容 提供基于 B/S 架构的 Web 访问能力,只需要一个浏览器即可访问目标设备,支持目前主流的浏览器,包括:Chrome、FireFox、Edge、Safari、IE11。 客户端兼容 能够与第三方客户端工具无缝适配,包括:RDP、SSH、SFTP、HTTP/HTTPS等协议的客户端工具软件,如SecurCRT、putty、Xshell、Mstsc、Winscp、Xsftp等,不改变运维人员的操作习惯。 跨平台兼容 京东云-运维审计管理平台具有跨平台运维行为管控能力,可覆盖多种主流主机操作系统、网络设备和运维协议,包括不限于: 协议类型——SSH、RDP、SFTP、HTTP、HTTPS等; 操作系统类型——RedHat Linux、Windows等。

优秀的个人博客,低调大师

AutoMQ 生态集成 CubeFS

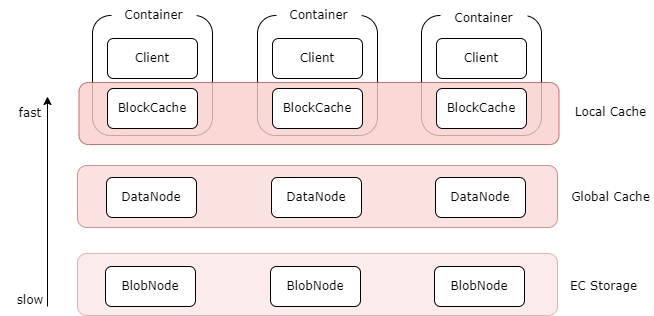
CubeFS [1] 是新一代云原生存储产品,目前是云原生计算基金会 CNCF托管的孵化阶段开源项目, 兼容 S3、POSIX、HDFS 等多种访问协议,支持多副本与纠删码两种存储引擎,为用户提供多租户、 多 AZ 部署以及跨区域复制等多种特性,广泛应用于大数据、AI、容器平台、数据库、中间件存算分离、数据共享以及数据保护等场景。 CubeFS的多级缓存[2] AutoMQ 创新的共享存储架构需要低成本的对象存储,而 CubeFS 支持 S3 兼容接口,其中 ObjectNode 提供兼容 S3 的对象存储接口来操作 CubeFS 中的文件,因此可以使用 S3Browser、S3Cmd 等开源工具或者原生的 Amazon S3 SDK 操作 CubeFS 中的文件。因此对于 AutoMQ 具有很好的适配性。因此你可以部署 AutoMQ 集群来获得一个与 Kafka 完全兼容,但是具备更好成本效益、极致弹性、个位数毫秒延迟的流系统。 本文将介绍如何将 AutoMQ 集群部署到您私有数据中心的 CubeFS 上。 01 前置条件 1.1 准备 CubeFS 集群 一个可用的 CubeFS 环境。如果您还没有 CubeFS 环境,可以参考官方文档进行依赖配置 [3] 以及搭建 CubeFS 基础集群 [4] 。 CubeFS 默认的安装包下的 build/bin 目录提供了一系列管理集群的命令行工具。本文中也将使用这些命令行工具做一些额外配置。通过 CubeFS 命令行工具查看集群状态,验证是否搭建成功: # 执行命令 ./build/bin/cfs-cli cluster info # 结果输出 [Cluster] Cluster name : cfs_dev Master leader : 172.16.1.101:17010 Master-1 : 172.16.1.101:17010 Master-2 : 172.16.1.102:17010 Master-3 : 172.16.1.103:17010 Auto allocate : Enabled MetaNode count (active/total) : 4/4 MetaNode used : 0 GB MetaNode available : 21 GB MetaNode total : 21 GB DataNode count (active/total) : 4/4 DataNode used : 44 GB DataNode available : 191 GB DataNode total : 235 GB Volume count : 2 ... 注意:这里的 CubeFS 集群的 master 节点的 ip 和端口将在接下来的对象网关配置中使用。 1.2 启用对象网关 为了让 CubeFS 支持对象存储协议,您需要开启对象网关 [5]。对象网关的作用在于,它提供了与 S3 兼容的对象存储接口,这使得 CubeFS 不仅能够支持传统的 POSIX 文件系统接口,还能够支持 S3 兼容的对象存储接口。通过这种方式,CubeFS 能够融合这两种通用类型接口的优势,进而为用户提供更为灵活的数据存储及访问方案。具体而言,开启对象网关后,用户便可以利用原生的 Amazon S3 SDK 来操作存储在 CubeFS 中的文件,从而享受到对象存储的便利性。 为了启动对象网关,首先需要在 CubeFS 根目录下创建 objectnode.json 配置文件,objectnode.json 配置文件示例内容如下: { "role": "objectnode", "listen": "17410", "domains": [ "object.cfs.local" ], "logDir": "/cfs/Logs/objectnode", "logLevel": "info", "masterAddr": [ "172.16.1.101:17010", "172.16.1.102:17010", "172.16.1.103:17010" ], "exporterPort": 9503, "prof": "7013" } 注意:此处的 masterAddr 的 ip 和端口信息可以从上一步的 CubeFS 集群信息中获取。 然后使用以下命令启动对象网关: nohup ./build/bin/cfs-server -c objectnode.json & 1.3 创建 CubeFS 用户 创建 CubeFS 用户,并查询得到 AccessKey 以及 Secret AccessKey 等信息。 可以参考用户管理文档 [6] 进行创建并查询对应用户的信息。 CubeFS 支持多种创建方式,比如可以通过 AWS SDK [7] 的方式进行创建或者 HTTP 请求的方式创建,这里我们将演示通过 HTTP 请求的方式进行创建: 指定用户id,密码以及 type,并请求创建接口: curl -H "Content-Type:application/json" -X POST --data '{"id":"automq","pwd":"12345","type":3}' "http://172.16.1.101:17010/user/create" 通过用户 ID 查询用户信息: curl -v "http://10.196.59.198:17010/user/info?user=automq" | python -m json.tool 响应示例 { "user_id": "automq", "access_key": "UZONf5FF6WKwFCj4", "secret_key": "TRZzfPitQkxOLXqPhKMBRrDYUyXXMpWG", "policy": { "own_vols": ["vol1"], "authorized_vols": { "ltptest": [ "perm:builtin:ReadOnly", "perm:custom:PutObjectAction" ] } }, "user_type": 3, "create_time": "2024-06-06 09:25:04" } 1.4 使用 S3 接口创建 Bucket 使用 aws cli 工具在 CubeFS 上创建需要的 bucket 以用于 AutoMQ 的集群部署。拿到用户的 key 等信息,通过 aws configure 进行配置,并使用 aws cli 工具进行 bucket 的创建。 aws s3api create-bucket --bucket automq-data --endpoint=http://127.16.1.101:17140 aws s3api create-bucket --bucket automq-ops --endpoint=http://127.16.1.101:17140 使用命令查看已经有的 bucket aws s3 ls --endpoint=http://172.16.1.101:17140 1.5 准备部署 AutoMQ 所需的机器 准备 5 台主机用于部署 AutoMQ 集群。建议选择 2 核 16GB 内存的 Linux amd64 主机,并准备两个虚拟存储卷。示例如下: Tips:请确保这些机器处于相同的网段,可以互相通信非生产环境也可以只部署 1 台 Controller,默认情况下该 Controller 也同时作为 Broker 角色 从 AutoMQ Github Releases 下载最新的正式二进制安装包,用于安装 AutoMQ。 02 安装并启动 AutoMQ 集群 配置S3 URL 第一步:生成 S3 URL AutoMQ 提供了 automq-kafka-admin.sh 工具,用于快速启动 AutoMQ。只需提供包含所需 S3 接入点和身份认证信息的 S3 URL,即可一键启动 AutoMQ,无需手动生成集群 ID 或进行存储格式化等操作。 ### 命令行使用示例 bin/automq-kafka-admin.sh generate-s3-url \ --s3-access-key=xxx \ --s3-secret-key=yyy \ --s3-region=cn-northwest-1 \ --s3-endpoint=s3.cn-northwest-1.amazonaws.com.cn \ --s3-data-bucket=automq-data \ --s3-ops-bucket=automq-ops 如果遇到报错,请注意验证参数正确性以及格式。 当使用 CubeFS 时,可以采用如下的配置来生成具体的 S3URL。 输出结果 执行该命令后,将自动按以下阶段进行: 根据提供的 accessKey 和 secret Key 对 S3 基本功能进行探测,以验证 AutoMQ 和 S3 的兼容性。 根据身份信息,接入点信息生成 s3url。 根据 s3url 获取启动 AutoMQ 的命令示例。在命令中,将 --controller-list 和 --broker-list 替换为实际需要部署的 CONTROLLER 和 BROKER。 执行结果示例如下: ############ Ping s3 ######################## [ OK ] Write s3 object [ OK ] Read s3 object [ OK ] Delete s3 object [ OK ] Write s3 object [ OK ] Upload s3 multipart object [ OK ] Read s3 multipart object [ OK ] Delete s3 object ############ String of s3url ################ Your s3url is: s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=xxx&s3-secret-key=yyy&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA ############ Usage of s3url ################ To start AutoMQ, generate the start commandline using s3url. bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" TIPS: Please replace the controller-list and broker-list with your actual IP addresses. 第 2 步:生成启动命令列表 将上一步生成的命令中的 --controller-list 和 --broker-list 替换为你的主机信息,具体来说,将它们替换为环境准备中提到的 3 台 CONTROLLER 和 2 台 BROKER 的 IP 地址,并且使用默认的 9092 和 9093 端口。 bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" 参数说明 输出结果 执行命令后,会生成用于启动 AutoMQ 的命令。 ############ Start Commandline ############## To start an AutoMQ Kafka server, please navigate to the directory where your AutoMQ tgz file is located and run the following command. Before running the command, make sure that Java 17 is installed on your host. You can verify the Java version by executing 'java -version'. bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=1 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.2:9092,CONTROLLER://192.168.0.2:9093 --override advertised.listeners=PLAINTEXT://192.168.0.2:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=2 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.3:9092,CONTROLLER://192.168.0.3:9093 --override advertised.listeners=PLAINTEXT://192.168.0.3:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=3 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.4:9092 --override advertised.listeners=PLAINTEXT://192.168.0.4:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=4 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.5:9092 --override advertised.listeners=PLAINTEXT://192.168.0.5:9092 TIPS: Start controllers first and then the brokers. 注意:node.id 默认从 0 开始自动生成。 第 3 步:启动 AutoMQ 要启动集群,请在预先指定的 CONTROLLER 或 BROKER 主机上依次执行上一步命令中的命令列表。例如,在 192.168.0.1 上启动第一个 CONTROLLER 进程,执行生成的启动命令列表中的第一条命令模板。 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 参数说明 使用启动命令时,未指定的参数将采用 Apache Kafka 的默认配置。对于 AutoMQ 新增的参数,将使用 AutoMQ 提供的默认值。要覆盖默认配置,可以在命令末尾添加额外的 --override key=value 参数来覆盖默认值。 Tips: 若需启用持续流量重平衡或运行 Example: Self-Balancing When Cluster Nodes Change,建议在启动时为 Controller 明确指定参数 --override autobalancer.controller.enable=true。 在私有数据中心部署 AutoMQ 用于生产环境,需确保本地 SSD 的可靠性。由于 CubeFS 不支持高可用的块设备协议,它无法直接管理磁盘的冗余或者备份。但是您可以通过 RAID [8] 方案进行解决。 后台运行如果需要以后台模式运行,请在命令末尾添加以下代码: command > /dev/null 2>&1 & 至此,你已经完成了基于 CubeFS 的 AutoMQ 集群部署,拥有了一个低成本、低延迟、秒级弹性的 Kafka 集群了。如果你需要进一步体验 AutoMQ 的秒级分区迁移、持续自平衡等特性,可以参考官方示例。 参考资料 [1] CubeFS: https://www.cubefs.io/zh/ [2] CubeFS 的多级缓存: https://www.cubefs.io/zh/docs/master/overview/introduction.html [3] 依赖配置: CubeFS | A Cloud Native Distributed Storage System [4] CubeFS 单机部署: www.cubefs.io [5] 对象网关: https://www.cubefs.io/zh/docs/master/design/objectnode.html [6] CubeFS 用户管理文档: CubeFS | A Cloud Native Distributed Storage System [7] CubeFS AWS SDK: https://www.cubefs.io/zh/docs/master/user-guide/objectnode.html#%E6%94%AF%E6%8C%81%E7%9A%84sdk [8] RAID: https://www.cnblogs.com/chuncn/p/6008173.html END 关于我们 我们是来自 Apache RocketMQ 和 Linux LVS 项目的核心团队,曾经见证并应对过消息队列基础设施在大型互联网公司和云计算公司的挑战。现在我们基于对象存储优先、存算分离、多云原生等技术理念,重新设计并实现了 Apache Kafka 和 Apache RocketMQ,带来高达 10 倍的成本优势和百倍的弹性效率提升。 🌟 GitHub 地址:https://github.com/AutoMQ/automq 💻 官网:https://www.automq.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册