首页 文章 精选 留言 我的

精选列表

搜索[创意玩法],共3191篇文章
优秀的个人博客,低调大师

我的个人创意本:用Workbuddy构建一个"创意孵化器"——用大模型把小创意养大、把相似创意整合放大,实现从想法到创意价值的全生命管理

做 AI 辅助开发,"让模型写代码"是最不值钱的环节。真正决定这个工具好不好用的,是三件事:把想法变成可匹配的设计语言、把 AI 生成的内容约束成真实可跑的界面、把离线包交付闭成"用户真能打开"的环。代码只是这三件事的副产品。

优秀的个人博客,低调大师

Pivotal大数据新玩法

目前大数据市场正处于快速成长阶段。根据IDC的预测,中国大数据技术与服务市场将会从2011年的7760万美元快速增长到2016年的6.16亿美元。尽管市场才起步,但市场竞争已经悄然展开,众多厂商推出了自己的大数据产品。 日前,Pivotal宣布推出了自己的大数据套件,该套件由Greenplum数据库、GemFire、 SQLFire、GemFire XD、HAWQ和HD共同组成。这是一个全面的数据管理解决方案,既包括面向传统结构化数据处理的数据仓库软件Greenplum,也包括面向实时数据处理领域的内存计算软件GemFire和SQLFire,还包括面向大数据的HD(Pivotal版本的Hadoop)。另外,还为混合数据类型的应用场景提供了一套连接和查询工具HAWQ。 应该说,这是Pivotal公司自去年4月成立以来的一个重要里程碑,不仅实现了将原来分别属于VMware和EMC两家公司产品的全面整合,还采用了创新的定价模式(订阅服务),其定价极富竞争力,订购价格以两年或三年为期限,视内核数量不同而不同。 “这几个产品组合在一起,满足了企业从MPP、Hadoop、NoSQL、内存计算等有关数据处理的全面需求。这几个产品是互相联通的,可以帮助客户构建一个统一的数据处理平台,全面满足企业的数据处理需求,而定价模式也非常新颖。”Pivotal大中华区总经理刘伟光表示。 Pivotal大中华区总经理刘伟光 据刘伟光介绍,相对市场上同类产品,Pivotal的大数据套件有自己独特的优势。首先是采用了统一的定价模型,按内核报价。刘伟光介绍说,目前数据库、数据仓库以及Hadoop等不同产品在不同公司报价方式是不一样的,有的按照CPU、有的按用户数、有的按容量,甚至对Pivotal而言,大数据套件中的不同产品报价方式也不同。现在统一按照内核来报价,在一定程度上简化了的用户选择。 第二个特点是其独特的许可证模型,可以保证投资和灵活部署,从容应对未知的需求。传统的软件套件许可是针对特定产品的,无论是按用户还是按CPU或者是按内核收费,都是如此,而在Pivotal的大数据套件中,不同产品之间的许可可以共享。比如,企业订阅了80个内核2年大数据套件的使用,它可以将80个内核的授权全部用于搭建基于Greenplum的数据仓库平台,同样也可以将这个80个内核的许可全部用于Gemfire来满足实时数据的处理需求,当然,用户也可以在各个产品中自由分配这80个内核的许可。而且,为了支持Hadoop的使用,Pivotal的Hadoop版本HD其使用不受许可的限制,也就是说只是订阅了大数据套件就可以无限制地使用Pivotal HD。 第三个特点是Pivotal大数据套件中各个产品的技术先进性和高度成熟度。比如,Greenplum在中国已经有非常庞大的用户基础,其用户遍布在电信、银行、零售、制造等多个领域。而Gemfire也成功地应用在12306网站,帮助12306的铁路购买系统应对全世界单点高并发量最高的春节期间购票点击。 “Pivotal的业务是专注于大数据和PaaS。其发展方向是建立一个在云平台上基于IaaS和PaaS的数据解决方案,来简化用户的应用程序管理、应用程序开发、维护的平台。这是未来Pivotal的使命。”刘伟光总结说。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

javascript史上最拽的玩法

摘要:在JavaScript世界中,有些操作会让你无法理解,但是却无比优雅,如果你真正了解这些,BAT公司任你选。(文章后面有惊喜) 一、5种方式实现值交换 1. var temp = a; a = b; b = temp; (传统,但需要借助临时变量)2. a ^= b; b ^= a; a ^= b; (需要两个整数)3. b = [a, a = b][0] (借助数组)4. [a, b] = [b, a]; (ES6,解构赋值)5. a = a + b; b = a - b; a = a - b; (小学奥赛题) 二、去掉小数部分 parseInt(num)~~numnum >> 0num | 0 三、判断 x 是否是整数 function isInt(x) { return (x ^ 0) === x}// return Math.round(x) === x// return (typeof x === 'number') && (x % 1 === 0)// ES6 -> Number.isInteger() 四、递归求阶乘 function factorial(n) { return (n > 1) ? n * f(n - 1) : n} 五、判断符号是否相同 function sameSign(a, b) { return (a ^ b) >= 0} 六、克隆数组 arr.slice(0) 七、数组去重 // ES6Array.from(new Set(arr))// ES5arr.filter(function(ele, index, array){ return index===array.indexOf(ele)}) 八、数组最大值 function maxArr(arr) { return Math.max.apply(null, arr)} 九、数组最小值 function minArr(arr) { return Math.min.apply(null, arr)} 十、随机获取数组的一个成员 function randomOne(arr) { return arr[Math.floor(Math.random() * arr.length)]} 十一、产生随机颜色 function getRandomColor() { return `#${Math.random().toString(16).substr(2, 6)}`} 十二、随机生成指定长度的字符串 function randomStr(n) { let standard = 'abcdefghijklmnopqrstuvwxyz9876543210' let len = standard.length let result = '' for (let i = 0; i < n; i++) { result += standard.charAt(Math.floor(Math.random() * len)) } return result} 十三、深拷贝 JSON.parse(JSON.stringify(obj)) 十四、打印出来看看 console.log(([][[]] + [])[+!![]] + ([] + {})[!+[] + !![]])console.log((!(~+[]) + {})[--[~+''][+[]] * [~+[]] + ~~!+[]] + ({} + [])[[~!+[]] * ~+[]]) 十五、美化console console.info("%c哈哈", "color: #3190e8; font-size: 30px; font-family: sans-serif"); 原文发布时间:2018年01月23日 作者:技术金三胖 本文来源:开源中国如需转载请联系原作者

优秀的个人博客,低调大师

Kubernetes 新玩法:在 yaml 中编程

引子 性能测试在日常的开发工作中是常规需求,用来摸底服务的性能。 那么如何做性能测试?要么是通过编码的方式完成,写一堆脚本,用完即弃;要么是基于平台,在平台定义的流程中进行。对于后者,通常由于目标场景的复杂性,如部署特定的 workload、观测特定的性能项、网络访问问题等,往往导致性能测试平台要以高成本才能满足不断变化的开发场景的需求。 在云原生的背景下,是否可以更好解决这种问题? 先看两个 yaml 文件: performance-test.yaml 描述了在 K8s 中的操作流程: 创建测试用的 Namespace 启动针对 Deployment 创建效率和创建成功率的监控 下述动作重复 N 次:① 使用 workload 模板创建 Deployment;② 等待 Deployment 变为 Ready 删除测试用的 Namespace basic-1-pod-deployment.yaml 描述使用的 workload 模板 performance-test.yaml : apiVersion: aliyun.com/v1alpha1 kind: Beidou metadata: name: performance namespace: beidou spec: steps: - name: "Create Namespace If Not Exits" operations: - name: "create namespace" type: Task op: CreateNamespace args: - name: NS value: beidou - name: "Monitor Deployment Creation Efficiency" operations: - name: "Begin To Monitor Deployment Creation Efficiency" type: Task op: DeploymentCreationEfficiency args: - name: NS value: beidou - name: "Repeat 1 Times" type: Task op: RepeatNTimes args: - name: TIMES value: "1" - name: ACTION reference: id: deployment-operation - name: "Delete namespace" operations: - name: "delete namespace" type: Task op: DeleteNamespace args: - name: NS value: beidou - name: FORCE value: "false" references: - id: deployment-operation steps: - name: "Prepare Deployment" operations: - name: "Prepare Deployment" type: Task op: PrepareBatchDeployments args: - name: NS value: beidou - name: NODE_TYPE value: ebm - name: BATCH_NUM value: "1" - name: TEMPLATE value: "./templates/basic-1-pod-deployment.yaml" - name: DEPLOYMENT_REPLICAS value: "1" - name: DEPLOYMENT_PREFIX value: "ebm" - name: "Wait For Deployments To Be Ready" type: Task op: WaitForBatchDeploymentsReady args: - name: NS value: beidou - name: TIMEOUT value: "3m" - name: CHECK_INTERVAL value: "2s" basic-1-pod-deployment.yaml: apiVersion: apps/v1 kind: Deployment metadata: labels: app: basic-1-pod spec: selector: matchLabels: app: basic-1-pod template: metadata: labels: app: basic-1-pod spec: containers: - name: nginx image: registry-vpc.cn-hangzhou.aliyuncs.com/xxx/nginx:1.17.9 imagePullPolicy: Always resources: limits: cpu: 2 memory: 4Gi 然后通过一个命令行工具执行 performance-test.yaml: $ beidou server -c ~/.kube/config services/performance-test.yaml 执行效果如下 (每个 Deployment 创建耗时,所有 Deployment 创建耗时的 TP95 值,每个 Deployment 是否创建成功): 这些 metrics 是按照 Prometheus 标准输出,可以被 Prometheus server 收集走,再结合 Grafana 可以可视化展示性能测试数据。 通过在 yaml 中表达想法,编排对 K8s 资源的操作、监控,再也不用为性能测试的实现头疼了 :D 为什么要在yaml 中编程? 性能测试、回归测试等对于服务质量保障有很大帮助,需要做,但常规的实现方法在初期需要投入较多的时间和精力,新增变更后维护成本比较高。 通常这个过程是以代码的方式实现原子操作,如创建 Deployment、检测 Pod 配置等,然后再组合原子操作来满足需求,如 创建 Deployment -> 等待 Deployment ready -> 检测 Pod 配置等。 有没有办法在实现的过程中既可以尽量低成本实现,又可以复用已有的经验? 可以将原子操作封装为原语,如 CreateDeployment、CheckPod,再通过 yaml 的结构表达流程,那么就可以通过 yaml 而非代码的方式描述想法,又可以复用他人已经写好的 yaml 文件来解决某类场景的需求。 即在 yaml 中编程,减少重复性代码工作,通过声明式的方式描述逻辑,并以 yaml 文件来满足场景级别的复用。 业界有很多种类型的声明式操作服务,如运维领域中的Ansible、SaltStack,Kubernetes 中的Argo Workflow、clusterloader2。它们的思想整体比较类似,将高频使用的操作封装为原语,使用者通过原语来表述操作逻辑。 通过声明式的方法,将面向 K8s 的操作抽象成 yaml 中的关键词,在 yaml 中提供串行、并行等控制逻辑,那么就可以通过 yaml 文件完整描述想要进行的工作。 这种思想和Argo Workflow比较像,但粒度比 Argo 更细,关注在操作函数上: 下面简单描述该服务的设计和实现。 设计和实现 1. 服务形态 使用者在 yaml 中,通过声明式的方式描述操作逻辑; 以 all-in-one 的二进制工具或 Operator 的方式交付; 服务内置常见原语的实现,以关键字的方式在 yaml 中提供; 支持配置原生 K8s 资源。 2. 设计 该方案的核心在于配置管理的设计,将操作流程配置化,自上而下有如下概念: Service:Modules 或 Tasks 的编排; Module:一种任务场景,是操作单元的集合(其中包含 templates/ 目录,表征模板文件的集合,可用来配置 K8s 原生资源); Task:操作单元,使用 plugin 及参数执行操作; Plugin:操作指令,类似开发语言中的函数。 抽象目标场景中的通用操作,这些通用操作即为可在 yaml 中使用的原语,对应上述 Plugin: K8s 相关 CreateNamespace DeleteNamespace PrepareSecret PrepareConfigMap PrepareBatchDeployments WaitForBatchDeploymentsReady etc. 观测性相关 DeploymentCreationEfficiency PodCreationEfficiency etc. 检测项相关 CheckPodAnnotations CheckPodObjectInfo CheckPodInnerStates etc. 控制语句相关 RepeatNTimes etc. 上述 4 个概念的关系如下: 示例可参见文章开头的 yaml 文件,对应形式二。 3. 核心实现 CRD 设计: package v1alpha1 import ( corev1 "k8s.io/api/core/v1" metav1 "k8s.io/apimachinery/pkg/apis/meta/v1" ) // BeidouType is the type related to Beidou execution. type BeidouType string const ( // BeidouTask represents the Task execution type. BeidouTask BeidouType = "Task" ) // +genclient // +k8s:deepcopy-gen:interfaces=k8s.io/apimachinery/pkg/runtime.Object // Beidou represents a crd used to describe serices. type Beidou struct { metav1.TypeMeta `json:",inline"` metav1.ObjectMeta `json:"metadata,omitempty" protobuf:"bytes,1,opt,name=metadata"` Spec BeidouSpec `json:"spec,omitempty" protobuf:"bytes,2,opt,name=spec"` Status BeidouStatus `json:"status,omitempty" protobuf:"bytes,3,opt,name=status"` } // BeidouSpec is the spec of a Beidou. type BeidouSpec struct { Steps []BeidouStep `json:"steps" protobuf:"bytes,1,opt,name=steps"` References []BeidouReference `json:"references" protobuf:"bytes,2,opt,name=references"` } // BeidouStep is the spec of step. type BeidouStep struct { Name string `json:"name" protobuf:"bytes,1,opt,name=name"` Operations []BeidouOperation `json:"operations" protobuf:"bytes,2,opt,name=operations"` } // BeidouOperation is the spec of operation. type BeidouOperation struct { Name string `json:"name" protobuf:"bytes,1,opt,name=name"` Type BeidouType `json:"type" protobuf:"bytes,2,opt,name=type"` Op string `json:"op" protobuf:"bytes,3,opt,name=op"` Args []BeidouArg `json:"args" protobuf:"bytes,4,opt,name=args"` } // BeidouArg is the spec of arg. type BeidouArg struct { Name string `json:"name" protobuf:"bytes,1,opt,name=name"` Value string `json:"value,omitempty" protobuf:"bytes,2,opt,name=value"` Reference BeidouOperationReference `json:"reference,omitempty" protobuf:"bytes,3,opt,name=reference"` Tolerations []corev1.Toleration `json:"tolerations,omitempty" protobuf:"bytes,4,opt,name=tolerations"` Checking []string `json:"checking,omitempty" protobuf:"bytes,5,opt,name=checking"` } // BeidouOperationReference is the spec of operation reference. type BeidouOperationReference struct { ID string `json:"id" protobuf:"bytes,1,opt,name=id"` } // BeidouReference is the spec of reference. type BeidouReference struct { ID string `json:"id" protobuf:"bytes,1,opt,name=id"` Steps []BeidouStep `json:"steps" protobuf:"bytes,2,opt,name=steps"` } // BeidouStatus represents the current state of a Beidou. type BeidouStatus struct { Message string `json:"message" protobuf:"bytes,1,opt,name=message"` } // +k8s:deepcopy-gen:interfaces=k8s.io/apimachinery/pkg/runtime.Object // BeidouList is a collection of Beidou. type BeidouList struct { metav1.TypeMeta `json:",inline"` metav1.ListMeta `json:"metadata" protobuf:"bytes,1,opt,name=metadata"` Items []Beidou `json:"items" protobuf:"bytes,2,opt,name=items"` } 核心流程: // ExecSteps executes steps. func ExecSteps(ctx context.Context, steps []v1alpha1.BeidouStep, references []v1alpha1.BeidouReference) error { logger, _ := ctx.Value(CtxLogger).(*log.Entry) var hasMonitored bool for i, step := range steps { for j, op := range step.Operations { switch op.Op { case "DeploymentCreationEfficiency": if !hasMonitored { defer func() { err := monitor.Output() if err != nil { logger.Errorf("Failed to output: %s", err) } }() } hasMonitored = true } err := ExecOperation(ctx, op, references) if err != nil { return fmt.Errorf("failed to run operation %s: %s", op.Name, err) } } } return nil } // ExecOperation executes operation. func ExecOperation(ctx context.Context, op v1alpha1.BeidouOperation, references []v1alpha1.BeidouReference) error { switch op.Type { case v1alpha1.BeidouTask: if !tasks.IsRegistered(op.Op) { return ErrNotRegistered } if !tasks.DoesSupportReference(op.Op) { return ExecTask(ctx, op.Op, op.Args) } return ExecTaskWithRefer(ctx, op.Op, op.Args, references) } return nil } // ExecTask executes a task. func ExecTask(ctx context.Context, opname string, args []v1alpha1.BeidouArg) error { switch opname { case tasks.CreateNamespace: var ns string for _, arg := range args { switch arg.Name { case "NS": ns = arg.Value } } return op.CreateNamespace(ctx, ns) // ... } // ... } // ExecTaskWithRefer executes a task with reference. func ExecTaskWithRefer(ctx context.Context, opname string, args []v1alpha1.BeidouArg, references []v1alpha1.BeidouReference) error { switch opname { case tasks.RepeatNTimes: var times int var steps []v1alpha1.BeidouStep var err error for _, arg := range args { switch arg.Name { case "TIMES": times, err = strconv.Atoi(arg.Value) if err != nil { return ErrParseArgs } case "ACTION": for _, refer := range references { if refer.ID == arg.Reference.ID { steps = refer.Steps break } } } } return RepeatNTimes(ctx, times, steps) } return ErrNotImplemented } 操作原语的实现示例: // PodAnnotations is an operation used to check whether annotations of Pod are expected. func PodAnnotations(ctx context.Context, data PodAnnotationsData) error { kclient, ok := ctx.Value(tasks.KubernetesClient).(kubernetes.Interface) if !ok { return tasks.ErrNoKubernetesClient } pods, err := kclient.CoreV1().Pods(data.Namespace).List(metav1.ListOptions{}) if err != nil { return fmt.Errorf("failed to list pods in ns %s: %s", data.Namespace, err) } for _, pod := range pods.Items { if pod.Annotations == nil { return fmt.Errorf("pod %s in ns %s has no annotations", pod.Name, data.Namespace) } for _, annotation := range data.Exists { if _, exists := pod.Annotations[annotation]; !exists { return fmt.Errorf("annotation %s does not exist in pod %s in ns %s", annotation, pod.Name, data.Namespace) } } for k, v := range data.Equal { if pod.Annotations[k] != v { return fmt.Errorf("value of annotation %s is not %s in pod %s in ns %s", k, v, pod.Name, data.Namespace) } } } return nil } 后续 目前阿里云容器服务团队内部已经实现了初版,已用于部分云产品的内部性能测试以及常规的回归测试,很大程度上提升了我们的工作效率。 在 yaml 中编程,是对云原生场景下声明式操作的体现,也是对声明式服务的一种实践。对于常规工作场景中重复编码或重复操作,可考虑类似的方式进行满足。 欢迎大家对这样的服务形态和项目进行讨论,探索这种模式的价值。 作者 |悟鹏 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

CVPR 2018 最具创意论文 TOP10

每年计算机视觉与模式识别会议 (CVPR) 都会带来杰出而有趣的研究,今年在美国盐湖城举办的CVPR 2018也不例外。CVPR 2018上许多论文提出了全新的深度神经网络在视觉上的应用,它们可能不是最根本的、具有突破性的工作,但它们非常有趣,从新的角度为人们提供了创造性和启发性的想法,而且有些想法很酷!下面是笔者认为的CVPR 2018中最酷的10篇论文,让我们来看看吧! Super SloMo:视频插值中多幅中间帧的高质量估计 论文地址: https://arxiv.org/abs/1712.00080 你有想过用超级慢动作拍摄一些超级酷的东西吗? 不妨看看英伟达(Nvdia)的 Super SloMo 吧!他们的卷积神经网络估计出视频中间帧,并且能够将标准的 30fps 的视频转换为看上去惊人的 240fps 下的慢动作!模型估计帧间光流,使用该模型还可以不影响画质地插入视频帧,从而慢镜头看上去也是清晰的。 WISPE:数码相机弱监督照片增强器 论文地址: http://www.vision.ee.ethz.ch/~ihnatova/wespe.html 真是机智啊!他们训练生成对抗网络 (GAN) 来自动美化照片。最酷的部分是它是弱监督的,你不需要输入-输出图像对!你训练的网络需要的是一组“好看”的图像(对于输出的标注图像)和一组你想要增强的“难看”的图像(对于输入图像)。然后,对 GAN 进行训练以产生输入图像的美化后的版本,通常极大地增强图像的颜色和对比度。 它是快速并且容易使用的,因为你不需要精确的图像对,最后你会得到一个“通用”的图像增强器。我也喜欢这种弱监督的方法。无监督的学习似乎相当遥远。但是对于计算机视觉中的许多子领域来说,弱监督似乎是一个有前途、有利可图的方向。 谁在控制狗? 根据视觉数据对狗的行为建模 论文地址: https://arxiv.org/abs/1803.10827 这可能是有史以来最酷的研究论文名字!它的思路是尝试并建模狗的所行所想。作者在狗的四肢安装了大量的传感器来收集它的运动数据,也在其头部安装照相机来获取狗看世界的第一视角。使用了一组卷积神经网络特征提取器来提取从视频帧中得到的图像中的特征,然后这些特征就和传感器数据一起传到一组长短期记忆网络,来学习和预测狗的行为。这是一个很新颖且具有创造力的应用。这个任务独特的框架和实现,都让这篇文章值得一读!希望这篇文章可以给未来的研究激发创造力,不管是对我们采集数据的方式还是深度学习技术的应用。 在笔记本上亲临球赛 论文地址: https://arxiv.org/abs/1806.00890 在世界杯进行之际,这篇论文的发布可以获得最佳时机奖了!这真的是 CVPR 计算机视觉里比较酷的应用之一。简单地说,给定一个足球比赛视频能够输出比赛的三维动态重建,从而训练模型。这就意味着你可以使用增强现实技术在任何地方观看这场比赛! 模型比较机智的地方在于不同类型信息的结合使用。使用视频比赛数据训练网络,根据这些数据可以非常轻易地提取三维网格。测试时,运动员的边界框、姿态和轨迹(在多帧之间)被提取来对其进行分割。 这些三维分割可以简单地投影到任意空间(这样你就可以任意制作虚拟球场)实现增强现实的足球比赛观看!在我看来,使用合成数据来训练时很聪明的做法,同样也是很有趣的应用! LayoutNet:从单幅彩色图像实现房间布局的三维建模 论文地址: https://arxiv.org/abs/1803.08999 我们中大多数有都有过这样的想法:给某个东西拍张照片,然后在数字三维对其进行重建 。这篇论文就是一个计算机视觉的应用,也正好是来实现这个想法的,尤其是对房间的三维重建。他们将全景图像作为输入来获得房间的整个视野,输出就是一个非常精确的三维重建的房间布局!这个模型有足够的能力来生成不同形状的房间,房间中可以包含许多不同的家居摆设。这个应用非常有趣,不用看大量计算机视觉研究员的工作,可以很好地阅读。 Polygon-RNN++ 分割数据集的高效交互标注 论文地址: https://arxiv.org/abs/1803.09693 深度网络工作得如此好的一个主要原因是有大量和完全注释的数据集可供使用。然而,对于许多计算机视觉任务来说,这样的数据既耗时又昂贵。特别是分割数据需要图像中的每个像素的类标记。正如你所想象的…对于大数据集来说,这个过程可能永远持续下去! Polygon-RNN++ 允许用户在图片中每个目标周围设置粗略的多边形,然后神经网络会自动生成分割标记。这篇论文很好地论述了这种方法,这种方法也可以在分割任务中创建快速、简单的标记。 在时尚大片中创造胶囊衣柜 论文地址: https://arxiv.org/abs/1712.02662 我今天应该穿什么呢? 如果每天早上都有人或东西来回答这个问题而不需要你去想,那该有多好啊。如果想拥有这样的东西,来认识一下胶囊衣柜 (Capsule Wardrobes) 吧。 这篇论文作者设计了一个模型,给定一个待选服装和饰品的清单,胶囊用最少的物品组成物品集,而这个集合可以提供最多的混搭配备。模型使用目标函数进行基本的训练,而目标函数的设计是用来获取视觉兼容性、多功能性和用户特定喜好的关键因素。使用胶囊衣柜,可以轻松地从你的衣橱里找到符合你品位的最佳搭配。 利用综合数据训练深度网络:通过域随机化来弥补现实差距 论文地址: https://arxiv.org/abs/1804.06516 这篇论文来自英伟达 ( NVIDIA )。它在使用合成数据来训练卷积神经网络 (CNNs) 上获得长足进步。它为 Unreal Engine 创建了一个插件,用于生成合成的训练数据。真正的关键是它们将训练数据的变量随机化,包括: 对象的数量和类型 干扰项的数量、类型、颜色和尺度 感兴趣物体的纹理和背景照片 虚拟摄影机相对于场景的位置 摄像机相对于场景的角度 点光源的数量和位置 他们展示了一些大有前途的结果,证明了用合成数据进行预训练的有效性。这个结果是以前没有达到。如果你缺少一些重要资源,它可能会对如何生成和使用合成数据有所帮助。 学习分割一切 论文地址: https://arxiv.org/abs/1711.10370 最近几年,何凯明团队(早先在微软亚洲研究院,现在在 Facebook 人工智能研究实验室)进行了大量的计算机视觉研究。他们文章的厉害之处就在于将创新性与简洁性有效结合。 ResNets 和 Mask R-CNN 都不是最疯狂、最复杂的研究思路。它们都非常简单、易于实现,在实践中也非常有效。这一篇也是一样。 学习分割一切是 Mask R-CNN 的扩展,使得神经网络在训练过程中不看见类也能进行分割! 这对快速、低成本获取数据集标记十分有效。它可以获得不可见目标类强大的基准库分割,这对在野外部署分割神经网络是十分重要的,因为在那样的环境中,存在着大量的不可见目标类。整体看来,这是我们朝着如何思考最大限度利用深度神经网络模型正确方向走了一步。 学习转换架构实现可扩展图像识别 论文地址: https://arxiv.org/abs/1707.07012 最后但也重要的就是关于深度学习的未来的思考:神经架构搜索 (NAS)。 NAS 背后的基本思想是取代手动设计网络架构,我们可以采用另外的神经网络来 “搜索”最好的模型结构。这个搜索基于回报函数,是很聪明的。回报函数对那些在验证数据集上表现良好的模型进行奖励。作者在文中展示了一个比手动设计更加精确的架构。这在未来是有很大发展空间的,尤其是特定应用的设计。因为我们只需要将全部精力放在设计好手动设计 NAS 算法,而不是为我们特定的应用设计特定的网络。一个良好设计大的 NAS 算法是足够灵活的,可以为任意特定任务找到好的网络。 原文发布时间为:2018-07-18本文来自云栖社区合作伙伴“计算机视觉life”,了解相关信息可以关注“计算机视觉life”

优秀的个人博客,低调大师

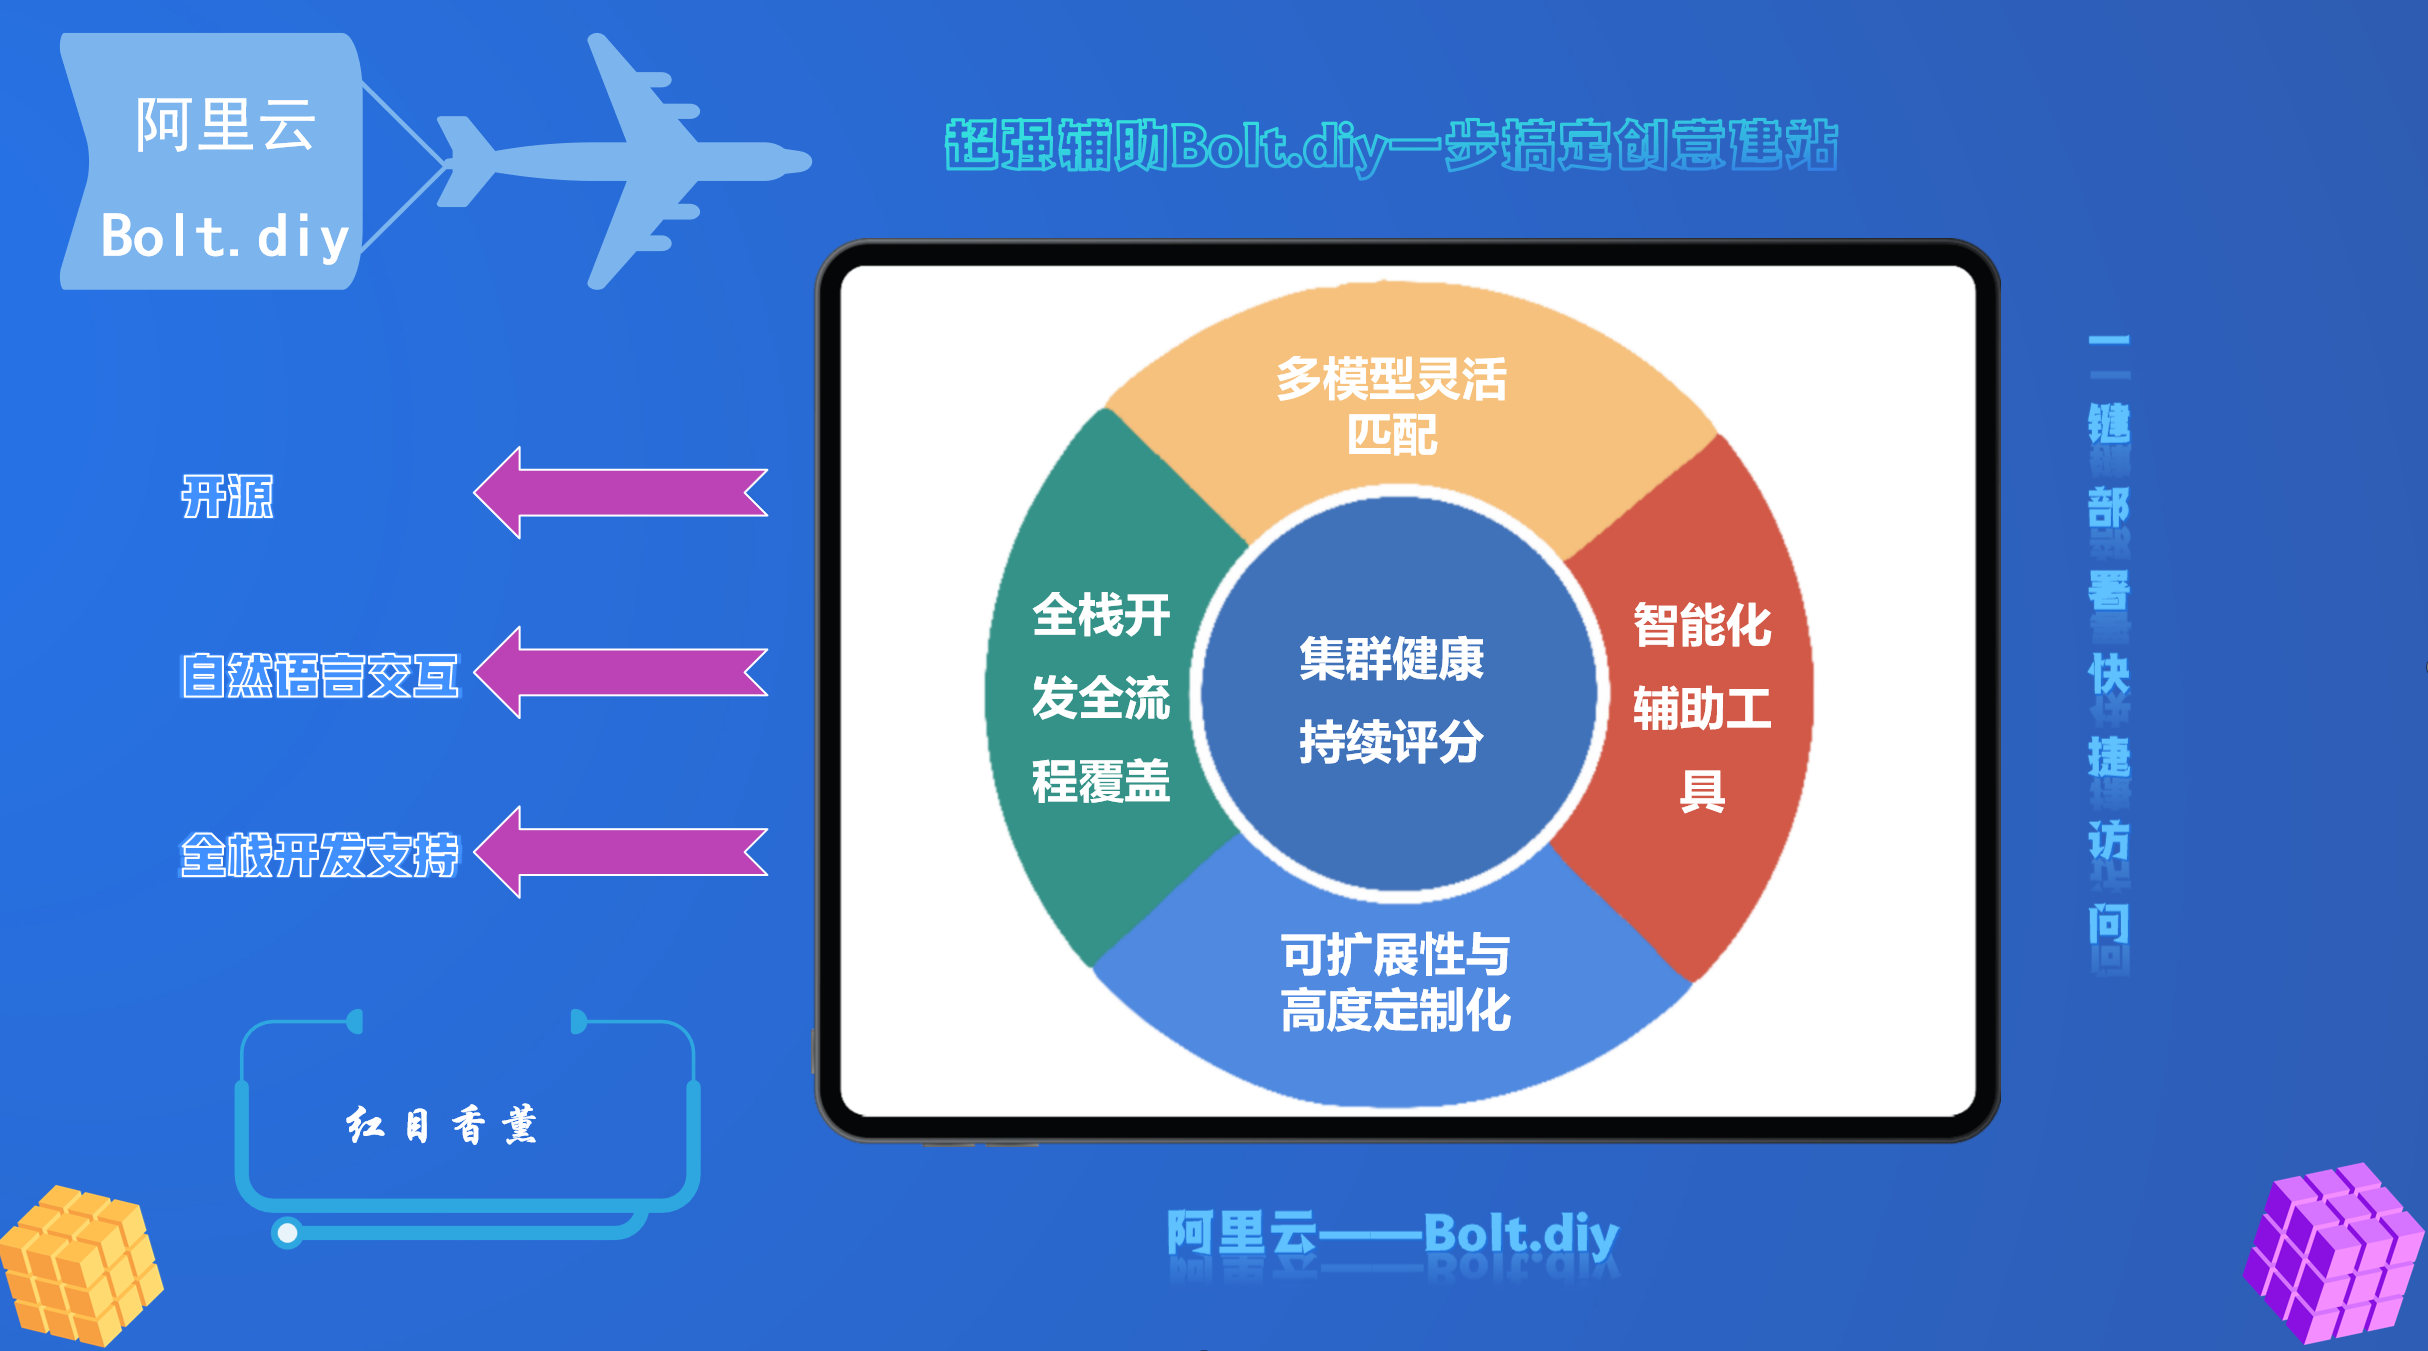
超强辅助 Bolt.diy ⼀步搞定创意建站

前⾔ 最近发现了⼀款可以部署在阿⾥云上的 AI 产品 ——Bolt.diy。它是⼀个非常好用的AI⼯具,通过提示词就可以帮助我们快速完成数据分析、网站搭建、原型设计等工作。 Bolt.diy是Bolt.new的⼀个开源版本,它提供了更⾼的灵活性和可定制性,通过⾃然语⾔交互简化开发流程,并提供全栈开发⽀持,同时允许⽤户⼆次开发。阿里云提供的方案是基于函数计算FC搭建,集成了阿⾥云百炼模型服务,新用户可以领取免费资源,搭上 AI 的快车道,资源指路:https://www.aliyun.com/solution/tech-solution/fc-bolt-diy?utm_content=g_1000403491 那么,接下来就和我一起看下 Bolt.diy 的表现吧。 价值体现 Bolt.diy的核⼼价值点从这⼏⽅⾯开始展开说⼀下。 多模型灵活匹配 多模型灵活适配这块,就是能⽀持好多种厉害的⼤语⾔模型,像国外的OpenAI,还有DeepSeek、Gemini,以及HuggingFace这些。咱⽤户呢,能根据不同的实际情况和需求,给不同的任务专⻔挑⼀个最合适的模型,这样任务完成起来就更顺⼿、更匹配了。 可扩展性与⾼度定制化 可扩展性与⾼度定制化也超棒。它⽤的是模块化的架构,咱不仅能⾃⼰定义Docker服务,还能把⼀些第三⽅的⼯具整合进来,⽤起来特别灵活。要是功能不够⽤,还能通过插件来扩展,甚⾄可以把⾃⼰本地私有的模型,⽐如⾃⼰训练出来的LLM模型也集成进去。 全栈开发全流程覆盖 全栈开发全流程覆盖这块,更⽜了。只要⽤⾃然语⾔和它交流,就能⽣成前端和后端的代码,像React前端代码、Node.js服务端代码这些都能⽣成。⽽且还⽀持实时调试,版本管理也⽅便,点⼀下就能部署。另外,⾥⾯还⾃带了可视化的⼯具,管理SQL或者NoSQL数据库都很轻松,数据模型和API接⼝都能⾃动⽣成。 智能化辅助⼯具 智能化辅助⼯具也很贴⼼。AI能实时检查代码,发现错误⻢上给出修复的建议,这样就不⽤花⽼多时间⼿动去调试代码了。⽽且它还能把代码的结构图谱和依赖关系⽤可视化的⽅式展示出来,碰到复杂的项⽬,⼀下⼦就能看明⽩是咋回事了。 ⾼效、⼴泛、专业这些形容词都是当之⽆愧,可以在后⾯的测试过程看到各类的效果,我们在使⽤过程中产⽣的各类原型图效果都是不错的,特别是五彩斑斓的⿊,给的是过渡效果,可以⾃⼰去做⼀个看看,我⽣成过⼏次,每次的效果都不同,都挺好的。 这是⼀个部署操作的⽤时,可以校验⼀下,整个部署时间仅仅使⽤了12秒,这才是⾼效的代表。 免费试用 阿⾥云给了3个⽉免费试⽤哦,我这⾥已经申请过了,还在观望的先过来看看,试⽤⼀下,有了具体的效果再去具体的评价还是对⼀个产品的真正认知。 技术⽅案的⼴泛应⽤场景 原型设计 模型语句 五彩斑斕的⿊ 提示词:⽣成⼀个中⽂的五彩斑斓的⿊为主体的颜⾊产品着陆⻚,除了五彩斑斓的⿊还要有⼀些⾮常⾼贵的颜⾊,例如:提夫尼蓝或太师⻘等颜⾊,给出颜⾊的⾊值以及对应的名称,如果是过渡渐变⾊,需要给出具体的过渡⽅式,⻛格要有现代科技感。 PC端和移动端的效果,都是直接就出来了,⾮常的效率呢,如果出现异常也是直接点击⼀下询问Bolt就⾏了。 ⽣肖产品 提示词:创建⼀个中⽂⽣肖产品的着陆⻚,包含所有星座介绍、星座运势,星座Emoji图案等,⻛格要⼩清新的感觉。 两个主题⻚的效果还都是不错的呢。 Bolt.diy⽀持操作 ⽀持图⽚原型上传,⽀持语⾳输⼊,可以下载代码结果, 可供选择的平台 可选的平台还是⾮常多的,默认的是openAILike,也就是百炼⼤模型的选项,还有很多国内外知名的平台,很全⾯,Deepseek的也是可以直接输⼊APIKey直接进⾏访问的。 可供选择的各类模型 OpenAILike也的将各类版本都上来了,从deepseek系列到qwen系列的各类模型都是可供选择的,从下拉条上就能看的出来他的模型量有多庞⼤。 我们看完他的强⼤,接下来我们来进⾏⼀下实操。 实战详情 阿里云提供了非常详细的实践手册,可以前往方案页面跟着一步一步进行操作:https://www.aliyun.com/solution/tech-solution/fc-bolt-diy?utm_content=g_1000403491 环境准备 这⾥环境主要是百炼⼤模型以及⽇志服务,但是⽇志服务会⾃动同步开通,那么剩下的就是需要独⽴的开通⼀下百炼⼤模型即可。 实验过程 我们需要先进⼊到实验中兵=并开启实操,这个实操没有具体的初始环境,所以是⽐较快的,我们直接按照左侧的操作⼿册来完成步骤内容即可。 ⽅案架构 这⾥⾯有个架构说明:按照本⽅案提供的配置完成部署后,会在阿⾥云上搭建⼀个如下图所示的运⾏环境。实际部署时,您可根据具体的资源规划调整部分配置,但最终的运⾏环境将与下图展示的架构相似。 也好理解,就是通过百炼模型服务提供的deepseek-v3的模型来返回对应的⽂本代码,通过云原⽣应⽤开发平台CAP进⾏解析,将对应⽂件的代码写⼊到对应⽂件中,最后使⽤npm进⾏启动并访问⻚⾯,流程还是很直接的。 开通百炼⼤模型 这⾥能直接跳转到百炼⼤模型,如果是第⼀次访问,那么右上⻆会有⼀个开通并领取百万Token的提示按钮,开通后就可以去创建我们需要的APIKey了。 获取APIKey操作 在下⽅能看到打开百炼⼤模型后的⻚⾯效果,我们这⾥直接点击应⽤,再点击左下⻆的APIKey即可。 进⼊到应⽤后左侧就能看到了,看好,是左下⻆。 有复制按钮,直接点击即可复制。 部署Bolt-diy 不是的时候由于只是⼀个服务,并没有对应的模型故⽽是很快的,我测试过⼗来次,基本时间范围是在12~22秒之间。 启动成功的效果,最后能看到completed就代表成功了呢,在右上⻆能看到有访问地址,直接点击即可访问。 访问后的效果,这⾥需要点击【忽略警告,继续访问】,但是要分浏览器,我这⾥的提示是360的浏览器,如果使⽤⾕歌等其它浏览器需要点击⼀下【⾼级->继续访问】才可以正常的访问,因为默认给的是https服务,⼤家都知道https是有验证的,咱们⾃⼰⼀般使⽤的是http访问这个验证就简单了,所以这⾥需要点击忽略。 成功进⼊Bolt-diy的⻚⾯。 配置API KEY 我们已经在上⾯的【获取APIKey】的操作时已经成功获取了APIKey,那么这时候就可以在OpenAILikeAPIKey中点击修改符号并输⼊获取的APIKey。 输⼊后点击勾选确认,效果图下图: 提示词与效果 提示词这个很有讲究,在上图中能看到给我了⼀个标准⾯板,这个要当做标准⾯板来看,并且例如【着陆⻚】这三个字就是最最最根本的⼀条重要提示词,没有加上这个词则会出现各类不符合的情况出现。 仿照写法: 创建⼀个⽔果产品的着陆⻚,包含各类的⽔果介绍,⽔果价格,⽔果营养,⽔果Emoji图案等,⻛格要⼩清新的。 ⽣成过程: 在完成编码后进⾏运⾏,但是运⾏的时候需要对环境进⾏初始化操作,补充⼀些环境内容,这⾥就可以看到,需要先进⾏vite安装操作。 npm install vite 安装过程需要稍等⼀会。 运⾏dev 页⾯效果 最后会⾃动打开Previrw⻚⾯来看看⻚⾯的效果,还是⾮常的不错的呢,不过我们的提示词中没有添加中⽂,故⽽体现的状态都是英⽂的,可以在提示词中加上⽣成中⽂的着陆⻚,这样产⽣的⻚⾯就是纯中⽂的了。 ⼆次提示词 改成中⽂的内容。 修改完成后会⾃动启动,效果还是很棒的,这⾥给开发的⼈员点个赞。 测试评价 整个操作过程快得很,快的话5分钟就能搞定,⽽且要是条件合适,甚⾄可以说⼀分钱不花就能⽤上DeepSeek-V3的模型,把它的强⼤功能为⼰所⽤,且快速⽣成的内容最起码⽤来交作业是没什么问题的,哈哈,这就很舒服了,对于⼤⼀⼤⼆的同学很有吸引⼒的。 整体操作过程 上下操作过程步骤很少,等待时间也不⻓,第⼀步骤等待时间也就10多秒,也就是在访问第⼀次的时候需要多等⼀会,点⼀下继续访问就好。 总结 整体测试下来,Bolt-diy⽆论是架设还是使⽤的整个使⽤过程中都可以说表现挺不错的,值得再次赞扬⼀下,如果能多给⼀些⽐较官⽅的提示词会更好,毕竟如果想针对提示词做⼀个全套的学习成本还是⾮常⾼的,希望这个建议能被官⽅看到并落实。 祝⼤家都能⽣成⾃⼰喜欢的⻚⾯。

优秀的个人博客,低调大师

MySQL 8.1 和 8.2 中 EXPLAIN 的新玩法

从 MySQL 8.1 开始 EXPLAIN 引入了 INTO 子句,它允许将 EXPLAIN 查询的输出存储在用户变量中,而不是将其返回给客户端。目前仅支持 JSON 格式,但这对于大多数用例来说应该足够了。 作者:Magnus Brevik 原文地址:https://dev.mysql.com/blog-archive/explain-into-and-explain-for-schema-in-mysql-81-and-82/ EXPLAIN INTO 从 MySQL 8.1 开始 EXPLAIN 引入了 INTO 子句,它允许将 EXPLAIN 查询的输出存储在用户变量中,而不是将其返回给客户端。目前仅支持 JSON 格式,但这对于大多数用例来说应该足够了。 EXPLAIN 的输出存储在用户变量之后,就可以将它当成 JSON 对象操作。这使您能够以编程方式直接从 EXPLAIN中提取、操作和存储数据到数据库中。 举个例子: mysql> SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id; +-------------+----------+ | name | quantity | +-------------+----------+ | Screwdriver | 23 | | Screwdriver | 1 | | Locket | 17 | | Armoire | 42 | | Armoire | 16 | +-------------+----------+ 如果只对此次查询的开销成本感兴趣,可以先将查询定义为为 @explain_output。 mysql> EXPLAIN FORMAT=JSON INTO @explain_output SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id; Query OK, 0 rows affected (0,00 sec) 现在,从这个 EXPLAIN 中得到的唯一输出是“Query OK”。如果我们想查看完整的 EXPLAIN 输出,我们可以选择 @explain_output,但是完整的 JSON 输出会占用很大的空间,而且我只对开销(cost )感兴趣。为了从 JSON 对象中提取,只需使用 MySQL 的 JSON 函数对指定的 JSON 对象处理即可。 mysql> SELECT JSON_EXTRACT(@explain_output, "$.query_block.cost_info.query_cost") AS query_cost; +------------+ | query_cost | +------------+ | "1.60" | +------------+ EXPLAIN SCHEMA 从 MySQL 8.2 开始 EXPLAIN 引入了 FOR SCHEMA 子句。它允许在当前 SCHEMA 之外的其他 SCHEMA 中执行 EXPLAIN 查询。这使得创建一个存储过程 PROCEDURE 来解释每个 SCHEMA 中最常运行的查询并收集有关它们的统计信息成为可能。 如果当前的 SCHEMA 与我们要查询的表所在的 SCHEMA 不同,我们可以 mysql> USE statistics; mysql> EXPLAIN FORMAT=TREE FOR SCHEMA customer1 SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id; -> Nested loop inner join (cost=2.3 rows=5) -> Table scan on items (cost=0.55 rows=3) -> Index lookup on orders using fk_item_id (item_id=items.id) (cost=0.472 rows=1.67) 这对于大多数 EXPLAIN 使用的情况可能不太有用,但是如果我们有多个具有相同表结构的 SCHEMA,并且想要一次性收集所有 SCHEMA 的统计信息,我们可以创建一个存储过程 PROCEDURE 来为我们做到这一点: DELIMITER | CREATE PROCEDURE explain_query_for_schema(IN schema_name VARCHAR(64), IN query VARCHAR(1000)) BEGIN SET @explain_stmt = CONCAT("EXPLAIN FORMAT=JSON INTO @explain_output FOR SCHEMA ", schema_name, " ", query); PREPARE stmt FROM @explain_stmt; EXECUTE stmt; INSERT INTO explain_outputs (schema_name, query, explain_output) VALUES (schema_name, query, @explain_output); END | CREATE PROCEDURE explain_query_for_all_schemas(IN query VARCHAR(1000)) BEGIN DECLARE done BOOLEAN DEFAULT FALSE; DECLARE schema_name VARCHAR(64); DECLARE cur_schema_names CURSOR FOR SELECT schema_name_table.schema_name FROM schema_name_table; DECLARE CONTINUE HANDLER FOR NOT FOUND SET done = TRUE; OPEN cur_schema_names; explain_loop: LOOP FETCH cur_schema_names INTO schema_name; IF done THEN LEAVE explain_loop; END IF; CALL explain_query_for_schema(schema_name, query); END LOOP; CLOSE cur_schema_names; END | DELIMITER ; SET @query = "SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id"; CALL explain_query_for_all_schemas(@query); SELECT schema_name, query, JSON_EXTRACT(explain_output, "$.query_block.cost_info.query_cost") AS query_cost, created_at FROM explain_outputs; +-------------+---------------------------------------------------------------------------+------------+---------------------+ | schema_name | query | query_cost | created_at | +-------------+---------------------------------------------------------------------------+------------+---------------------+ | customer1 | SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id | "2.30" | 2023-11-14 20:56:47 | | customer2 | SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id | "0.70" | 2023-11-14 20:56:47 | | customer3 | SELECT name, quantity FROM orders JOIN items ON orders.item_id = items.id | "9.10" | 2023-11-14 20:56:47 | +-------------+---------------------------------------------------------------------------+------------+---------------------+ 就是这样。EXPLAIN 的两个相对简单的扩展乍一看可能并不重要,但使存储过程能够以编程方式处理 EXPLAIN 输出。我们自己将其用于 《使用 MySQL Autopilot Indexing 删除索引猜测值》 这个案例中,其中 EXPLAIN INTO 和 EXPLAIN FOR SCHEMA 对于收集数据以建议更好的索引至关重要。我们希望它对您和我们一样有用。 如果您想了解更多信息,这些都记录在 MySQL EXPLAIN 文档 中。 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE SQLE 是一款全方位的 SQL 质量管理平台,覆盖开发至生产环境的 SQL 审核和管理。支持主流的开源、商业、国产数据库,为开发和运维提供流程自动化能力,提升上线效率,提高数据质量。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册