首页 文章 精选 留言 我的

精选列表

搜索[创意玩法],共4562篇文章
优秀的个人博客,低调大师

WEB安全新玩法 [2] 防范前端验证绕过

用户登录,几乎是所有 Web 应用所必须的环节。Web 应用通常会加入一些验证手段,以防止***者使用机器人自动登录,如要求用户输入图形验证码、拖动滑动条等。但是,如果验证的逻辑仅仅在前端执行,是很容易被***者绕过的。**iFlow 业务安全加固平台**可以为只使用前端验证的应用打上动态虚拟补丁,使之成为需要前后端配合执行的验证逻辑,大幅度提高***者的***难度。 ----- 以某个开源购物网站为例,其管理员后台登录只使用了前端验证。我们尝试一下,如何在不修改网站源代码的前提下,使用**iFlow**实现前后端配合身份验证。 # 一、前端验证的原始网站 原始网站设置了滑动条拖动验证,但仅使用了前端验证,极易被***者甚至一般用户绕过。 ## 1.1 正常用户访问 网站管理员在输入 **账号** 和 **口令** 后,必须拖动下方的 **滑动条** 到最右端,才能点击 **登录按钮** 发送登录信息。 ![图1](https://img-blog.csdnimg.cn/20200915170758580.png#pic_center) 反映在 HTTP 协议层面,是如下交互的: ```mermaid sequenceDiagram participant 正常用户 participant 浏览器 participant Web服务器 正常用户->>浏览器: 地址栏输入:/shopx/admin.php 浏览器->>Web服务器: 请求:/shopx/admin.php Web服务器->>浏览器: 返回:登录页面 浏览器->>Web服务器: 请求:/shopx/js/drag.js Web服务器->>浏览器: 返回:drag.js 浏览器->>正常用户: 显示:登录页面 正常用户->>浏览器: 填写账号口令 正常用户->>浏览器: 拖动滑动条 Note over 浏览器: 设置前端元素 正常用户->>浏览器: 点击登录按钮 Note over 浏览器: 前端元素验证通过 浏览器->>Web服务器: 发送:登录信息 Web服务器->>浏览器: 返回:登录结果页面 浏览器->>正常用户: 显示:登录结果页面 ``` 在实现上,当用户将滑动条拖到最右端时,前端代码将 DOM 中的一个数据元素 `validate-status` 的值设置为 `1`。 ## 1.2 ***者访问 使用浏览器自带的开发者工具 (F12) 或者使用浏览器自动化工具 (如 WebDriver),将数据元素 `validate-status` 的值直接设置为 `1`。 下图显示的是仅使用浏览器自带工具来修改元素: ![图2](https://img-blog.csdnimg.cn/20200915171115426.png#pic_center) 如此,***者无需实际拖动滑动条验证,同样能够发出登录信息。HTTP 协议层面交互如下: ```mermaid sequenceDiagram participant ***者 participant 浏览器 participant Web服务器 ***者->>浏览器: 地址栏输入:/shopx/admin.php 浏览器->>Web服务器: 请求:/shopx/admin.php Web服务器->>浏览器: 返回:登录页面 浏览器->>Web服务器: 请求:/shopx/js/drag.js Web服务器->>浏览器: 返回:drag.js 浏览器->>***者: 显示:登录页面 ***者->>浏览器: 填写账号口令 rect rgb(250, 128, 128) ***者->>浏览器: 【自行修改前端元素】 end ***者->>浏览器: 点击登录按钮 Note over 浏览器: 前端元素验证通过 浏览器->>Web服务器: 发送:登录信息 Web服务器->>浏览器: 返回:登录结果页面 浏览器->>***者: 显示:登录结果页面 ``` # 二、iFlow虚拟补丁后的网站 我们在 Web 服务器前部署 **iFlow 业务安全加固平台**,它有能力拦截、计算和修改双向 HTTP 报文并具备存储能力,成为 Web 应用的虚拟补丁。本例中,iFlow 通过在前端动态插入代码和在后端基于会话的状态保存,使得滑动条验证逻辑在前后端同时进行。 ## 2.1 正常用户访问 iFlow 在前端的拖动滑动条前端脚本中动态插入了一段代码,使得用户在完成拖动滑动条时,浏览器自动向 iFlow 发送一条信息并被 iFlow 保存为一个标记。用户在发送登录信息时,iFlow 检查该标记,对于一个正常用户,这个标记一定是存在的,于是登录过程正常继续。 正常用户的 HTTP 协议交互过程如下: ```mermaid sequenceDiagram participant 正常用户 participant 浏览器 participant iFlow participant Web服务器 正常用户->>浏览器: 地址栏输入:/shopx/admin.php 浏览器->>Web服务器: 请求:/shopx/admin.php Web服务器->>浏览器: 返回:登录页面 浏览器->>Web服务器: 请求:/shopx/js/drag.js Web服务器->>iFlow: 返回:drag.js rect rgb(160, 250, 160) iFlow->>浏览器: 修改:在drag.js插入代码 end 浏览器->>正常用户: 显示:登录页面 正常用户->>浏览器: 填写账号口令 正常用户->>浏览器: 拖动滑动条 Note over 浏览器: 设置前端元素 浏览器->>iFlow: 请求:/iflow/dragged.dummy rect rgb(160, 250, 160) Note over iFlow: 为会话设置drag_ok标志 end 正常用户->>浏览器: 点击登录按钮 Note over 浏览器: 前端元素验证通过 浏览器->>iFlow: 发送:登录信息 rect rgb(160, 250, 160) Note over iFlow: 会话中有drag_ok标志 end iFlow->>Web服务器: 发送:登录信息 Web服务器->>浏览器: 返回:登录结果页面 浏览器->>正常用户: 显示:登录结果页面 ``` ## 2.2 ***者访问 如前所示,***者强行修改前端元素,可以通过前端验证。但当发送登录信息而 iFlow 检查标记时,由于***者之前并未实际拖动滑动条发送标记请求,因此该标记并不存在。iFlow 可以据此判断这是一个恶意访问,于是终止登录过程。 ***者的 HTTP 协议交互过程如下: ```mermaid sequenceDiagram participant ***者 participant 浏览器 participant iFlow participant Web服务器 ***者->>浏览器: 地址栏输入:/shopx/admin.php 浏览器->>Web服务器: 请求:/shopx/admin.php Web服务器->>浏览器: 返回:登录页面 浏览器->>Web服务器: 请求:/shopx/js/drag.js Web服务器->>iFlow: 返回:drag.js rect rgb(160, 250, 160) iFlow->>浏览器: 修改:在drag.js中插入代码 end 浏览器->>***者: 显示:登录页面 ***者->>浏览器: 填写账号口令 rect rgb(250, 128, 128) ***者->>浏览器: 【自行修改前端元素】 end ***者->>浏览器: 点击登录按钮 Note over 浏览器: 前端元素验证通过 浏览器->>iFlow: 发送:登录信息 rect rgb(160, 250, 160) Note over iFlow: 会话中无drag_ok标志 end iFlow->>浏览器: 拒绝访问 rect rgb(250, 128, 128) 浏览器->>***者: 拒绝访问 end ``` ## 2.3 代码 **iFlow 内置的 W2 语言是一种专门用于实现 Web 应用安全加固的类编程语言**。它介于配置和通用语言之间,具备编程的基本要素和针对 HTTP 协议的特有扩展,能为业务系统编写涉及复杂判断和动态修改的逻辑。 考虑到安全产品的使用者通常为非程序员,他们习惯面对配置文件而非一段代码。因此,W2 语言虽包含语言要素,仍以规则文件方式呈现,并采用可以体现层次结构和方便词法校验的 JSON 格式。 用 W2 语言实现上述虚拟补丁的代码如下: ```json [ { "if": [ "REQUEST_FILENAME == '/shopx/js/drag.js'" ], "then": { "execution": { "directive": "alterResponseBody", "op": "string", "target": "function dragOk(){", "substitute": "function dragOk(){$.get('/iflow/dragged.dummy');" } } }, { "if": [ "REQUEST_FILENAME == '/iflow/dragged.dummy'" ], "then": { "execution": [ "SESSION.drag_ok@60 = true" ] } }, { "if": [ "REQUEST_FILENAME == '/shopx/admin.php'", "@ARGS.s == 'login'", "!SESSION.drag_ok" ], "then": { "verdict": { "action": "deny", "log": "Drag verifycode is not ok!" } } } ] ``` 示例代码中有三条规则,分别作用如下—— **第一条规则** 当浏览器请求 `drag.js` 时,iFlow 拦截响应报文,在 `dragOK()` 函数中插入一个代码片段,其作用是当用户拖拽验证框完成后向服务器发送一条验证请求,即下一条规则中的 `/iflow/dragged.dummy`; **第二条规则** 当浏览器请求 `/iflow/dragged.dummy` 时 (用户拖动完成后由 `dragOK()` 函数自动发出),iFlow 拦截此请求,将该会话 (SESSION) 存储中的 `drag_ok` 标志设置为 `true` ; **第三条规则** 当用户点击登录按钮时发出请求时,iFlow 拦截此请求,检查会话 (SESSION) 存储中的 `drag_ok` 标志是否为 `true` (正常用户操作在上一条规则中应该被设置),如果不为 `true` 则 iFlow 阻止该用户的继续操作。 > **注意**:上述会话中的 `drag_ok` 标志是保存在服务器端的 **iFlow** 存储中的,在浏览器端是看不到数据更无法进行修改的。 # 三、总结 iFlow 使用三条规则在不修改服务器端代码的前提下,透明地实现了在后端执行的拖动验证逻辑。 此外我们可以看到,iFlow 的规则是根据应用的实际情况和对安全功能的特定需求量身定制的,它不具备开箱即用的特点但却适合构造复杂的防护逻辑。 当然,这仅是一个入门的例子,主要是为了体现防御思路和 iFlow 的能力。聪明的读者一定会想到——***者可以针对这个防御手段采取对应的***方式 (如主动发出后端验证请求),而防御者也可以将防御手段制作得更高明一些 (如 js 混淆、检查滑动速度和时间等),这些我们在以后的例子中再慢慢展开。至少,比起原始的网站系统,现在***者没那么容易欺骗 Web 应用了。(张戈 | 天存信息)

优秀的个人博客,低调大师

云存储网关复制模式新玩法 - 部分复制

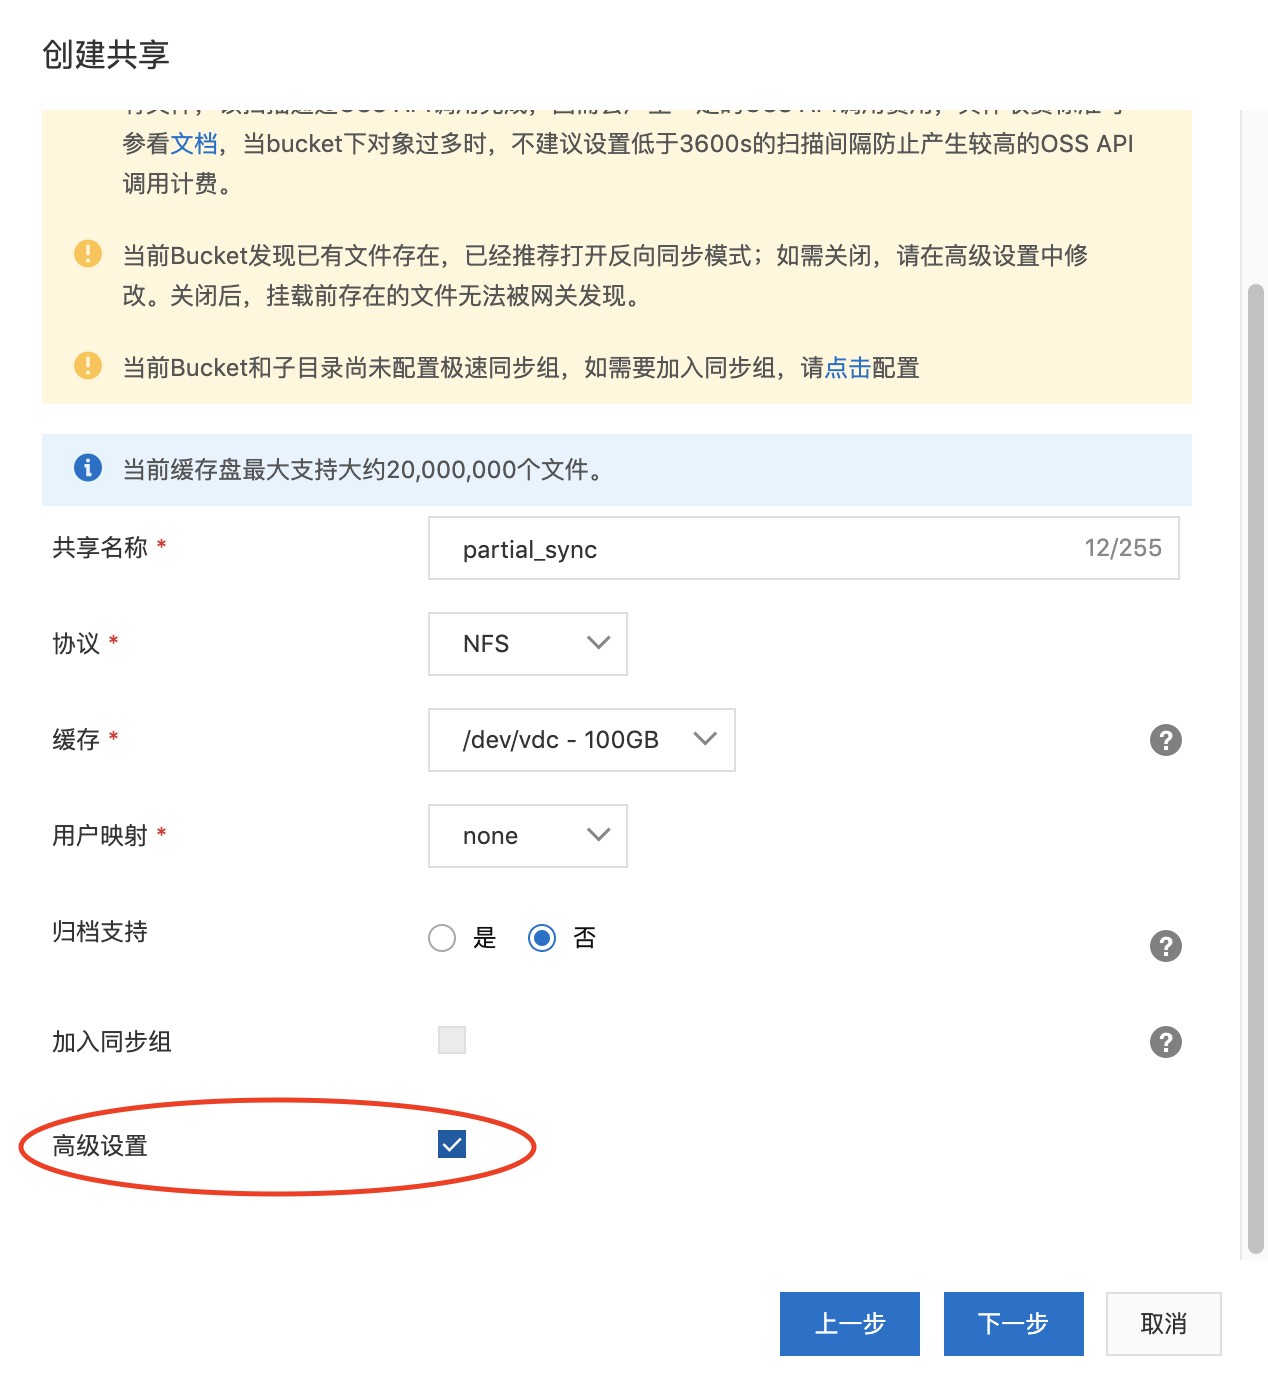
说到云存储网关的复制模式,相信不少人都有既爱又恨的感觉。复制模式确实是一个非常实用的功能,它将数据在云端和网关侧同时保留了两份,不但降低了数据丢失的风险,同时也极大地提高了从网关访问数据的性能。如果预算允许,我相信所有用户都会选择复制模式,这样所有的数据都会缓存在网关,使用起来性能绝对是杠杠的。问题就是,复制模式对缓存容量要求高,缓存盘贵啊。 想用户所想,急用户所急,云存储网关推出了新的复制模式功能 - 部分复制。不像之前只允许整个共享运行在复制模式,这次用户可以指定文件夹,只让这些被指定的文件夹运行在复制模式,其他未指定的,默认则会运行在缓存模式。这样,用户在预算有限的情况下,就可以选择那些重要的、经常需要访问的文件夹,只让它们运行在复制模式。​花很少的钱,享受更好的体验,不香吗? 下面我们就来看一下怎么使用部分复制的功能。 创建共享的时候,勾选高级设置,并选择开启复制模式,同时勾选复制模式高级​设置,进入下一步,勾选配置复制目录,并按提示填上需要运行在复制模式的目录,再完成共享的创建即可。如下截图所示: 这样创建出来的共享,所有在文件夹/important和/frequent_use中的文件,都会被永久​保留在网关的缓存盘中,而网关的缓存淘汰策略,只会作用于不属于这两个文件夹的其他文件。 性价比这么高的功能,赶紧去用起来吧!

优秀的个人博客,低调大师

【阿里云技术】PostgreSQL的20+种玩法

作者 德哥,周正中,阿里云高级技术专家,PostgreSQL 中国社区发起人之一,PostgreSQL 象牙塔发起人之一,DBA+社群联合发起人之一,10余项数据库相关专利,曾就职于斯凯网络,负责数据库部门。 背景 数据库对于一家企业来说,相比其他基础组件占据比较核心的位置。有很多企业由于最初数据库选型问题,导致一错再错,甚至还有为此付出沉痛代价的。数据库的选型一定要慎重,但是这么多数据库,该如何选择呢?我前段时间写过一篇关于数据库选型的文章,可以参考如下《数据库选型思考》另外,PostgreSQL这个数据库这些年的发展非常的迅猛,虽然国内还跟不上国外的节奏,但是相信国人逐渐会融合进去。 所以我专门针对PostgreSQL提炼了它的一些应用场景(普通的应用场景就不举例了),希望对你的选型可以起到一定的参考作用。 1 任意字段组合查询 - ERP、电商、网站、手机APP 等业务场景 在一些前端的人机交互页面中,经常会有很多选择框,让用户进行选择,这些选择框可能对应的是数据库表中的不同字段。这种画面经常出现在ERP,电商,网站,手机APP等场景中。对于开发人员来说是一件很头疼的事情,因为不知道该对哪些字段创建索引,或者干脆对所有字段都建立索引,给数据库带来较大的性能和维护的问题。PostgreSQL中有两个技术(gin, bloom索引),可以完美的解决这类业务场景的问题。 《宝剑赠英雄 - 任意组合字段等效查询, 探探PostgreSQL多列展开式B树》《PostgreSQL 9.6 黑科技 bloom 算法索引,一个索引支撑任意列组合查询》 2 高并发、高效率范围查询 - 金融、物联网、智能DNS 等业务场景 有些场景,经常要对值进行范围的比对。比如物联网,对传感器上传的值,进行范围比对。智能DNS,需要对来源IP进行判断,并找出其落在哪个IP地址段内。金融行业,经常要设置一些指标范围,时刻判断指数是否落在某个区间,当一些指数落在某个范围区间时,触发下一步的操作(比如买入或卖出)。传统的两个字段+复合B树的索引,效率低下,通常8核的机器只能达到3000多的QPS。PostgreSQL通过(range类型和gist,sp-gist索引),可以将效率提升20多备,8核的机器可以达到8万的QPS。 《聊聊between and的坑 和 神奇的解法》《PostgreSQL 黑科技 range 类型及 gist index 20x+ speedup than Mysql index combine query》《PostgreSQL 黑科技 range 类型及 gist index 助力物联网(IoT)》《从难缠的模糊查询聊开 - PostgreSQL独门绝招之一 GIN , GiST , SP-GiST , RUM 索引原理与技术背景》 3 网格化、矢量化地图 - 地理类应用、LBS社交、导航 等业务场景 人们为了更好的描述一个东西,有一种将大化小的思路,比如时钟被分为了12个区域,每个区域表示一个小时,然后每个小的区域又被划分为更小的区域表示分钟。 在GIS系统中,也有类似的思想,比如将地图划分成网格。通过编码来简化地理位置的判断(比如相交,包含,距离计算等),但是请注意使用网格带来的问题,比如精度的问题,网格的大小决定了精度,又比如相对坐标的问题,可能无法描述清楚边界的归属。PostgreSQL可以提供给你更好的选择,矢量化的运算。 在PostGIS中虽然也支持网格对象的描述方式,但是并不是使用这种方法来进行几何运算(比如相交,包含,距离计算等),所以不存在类似的精度问题,个人建议没有强需求的话,不必做这样的网格转换。 如果是多种精度地图的切换(比如多个图层,每个图层代表一种地图精度),建议使用辐射的方式逐渐展开更精细的图层,以点为中心,逐渐辐射。(很多专业的地图软件是这样做的) 《蜂巢的艺术与技术价值 - PostgreSQL PostGIS's hex-grid》《PostGIS 地理信息数据 多核并行处理》 4 异步消息 - 物联网、WEB、金融 等业务场景 《从电波表到数据库小程序之 - 数据库异步广播(notify/listen)》《从微信小程序 到 数据库"小程序" , 鬼知道我经历了什么》 一个例子这个例子使用PostgreSQL的异步消息通知机制(notify/listen),以及数据库的触发器,PostGIS地理库插件,结合nodejs, socket.io实现了一个实时的客户端GPS坐标更新的小业务。1.在数据库中新增GPS坐标,数据库端编写的"小程序"会自动发送异步消息给客户端,客户端马上就展示了当前新增的坐标 2.修改GPS坐标,数据库端编写的"小程序"会自动发送异步消息给客户端,客户端刷新了当前坐标 3.删除GPS坐标,数据库端编写的"小程序"会自动发送异步消息给客户端,客户端刷新了当前坐标 [《[转载] postgres + socket.io + nodejs 实时地图应用实践》](https://github.com/digoal/blog/blob/master/201701/20170113_02.md) 5 流式实时数据处理 - 物联网、金融 等业务场景 在物联网、金融行业中,有大量的数据产生,同时需要实时的对数据进行处理。pipelinedb是基于PostgreSQL的一个流式计算数据库,纯C代码,效率极高(32c机器,单机日处理流水达到了250.56亿条)。同时它具备了PostgreSQL强大的功能基础,正在掀起一场流计算数据库制霸的腥风血雨。在物联网(IoT)有非常广泛的应用场景,越来越多的用户开始从其他的流计算平台迁移到pipelineDB。pipelinedb的用法非常简单,首先定义stream(流),然后基于stream定义对应的transform(事件触发模块),以及Continuous Views(实时统计模块)数据往流里面插入,transform和Continuous Views就在后面实时的对流里的数据进行处理,对开发人员来说很友好,很高效。值得庆祝的还有,所有的接口都是SQL操作,非常的方便,大大降低了开发难度。《流计算风云再起 - PostgreSQL携PipelineDB力挺IoT》除此之外,PostgreSQL的undo table,batch调度, 异步消息结合,也能达到与pipeline一样的效果。 《PostgreSQL 流式数据处理(聚合、过滤、转换...)系列 - 9》 6 GIS、图像近似度运算 - 互联网、AR红包、虚拟现实与GIS结合、广告营销 等业务场景 《基于PostgreSQL的流式PipelineDB, 1000万/s实时统计不是梦》《"物联网"流式处理应用 - 用PostgreSQL实时处理(万亿每天)》 AR红包是GIS与图像、社交、广告等业务碰撞产生的一个全新业务场景。需要做广告投放的公司,可以对着广告牌,或者店铺中的某个商品拍照,然后藏AR红包。要找红包的人,需要找到这家店,并且也对准藏红包的物体拍摄,比较藏红包和找红包的两张图片,就可以实现抢红包的流程。可以想象的空间很多。使用的核心技术是GIS(地理位置)与图像近似度比较。PostgreSQL对于这两项技术都可以很好的支持。《(AR虚拟现实)红包 技术思考 - GIS与图像识别的完美结合》 7 相似内容搜索、去重 - 互联网、数据公司、搜索引擎 等业务场景 在搜索引擎、数据公司、互联网中都会有网络爬虫的产品,或者有人机交互的产品。有人的地方就有江湖,盗文、盗图的现象屡见不鲜,而更惨的是,盗图和盗文还会加一些水印。也就是说,你在判断盗图、盗文的时候,不能光看完全一致,可能要看的是相似度。这给内容去重带来了很大的麻烦,不过还好,PostgreSQL数据库整合了相似度去重的算法和索引接口,可以方便的处理相似数据。比如相似的数组、相似的文本、相似的分词、相似的图像的搜索和去重等等。又比如鉴黄。 《电商内容去重内容筛选应用(如何高效识别转载盗图侵权?) - 文本相似、图片集相似、数组相似的优化和索引技术》《PostgreSQL 在视频、图片去重,图像搜索业务中的应用》《从相似度算法谈起 - Effective similarity search in PostgreSQL》 8 任意字段模糊查询 - 互联网、前端页面、搜索引擎 等业务场景 在一些应用程序中,可能需要对表的所有字段进行检索,有些字段可能需要精准查询,有些字段可能需要模糊查询或全文检索。比如一些前端页面下拉框的勾选和选择。比如一些域名的模糊查询。这种需求对于应用开发人员来说,会很蛋疼,因为写SQL很麻烦,例子:之前写过一篇文章来解决这个问题《PostgreSQL 行级 全文检索》使用的是全文检索,而当用户的需求为模糊查询时? 如何来解决呢?PostgreSQL中可以很好的解决这个问题,适用于任意字符(包括英文、中文、等等)。《PostgreSQL 全表 全字段 模糊查询的毫秒级高效实现 - 搜索引擎颤抖了》《从难缠的模糊查询聊开 - PostgreSQL独门绝招之一 GIN , GiST , SP-GiST , RUM 索引原理与技术背景》 9 在线处理、离线分析、在线分析混合需求 - 互联网、传统企业、金融 等业务场景 随着IT行业在更多的传统行业渗透,我们正逐步的在进入DT时代,让数据发挥价值是企业的真正需求,否则就是一堆废的并且还持续消耗企业人力,财力的数据。传统企业可能并不像互联网企业一样,有大量的开发人员、有大量的技术储备,通常还是以购买IT软件,或者以外包的形式在存在。数据的核心 - 数据库,很多传统的行业还在使用传统的数据库。随着IT向更多行业的渗透,数据类型越来越丰富(诸如人像、X光片、声波、指纹、DNA、化学分子、图谱数据、GIS、三维、多维 等等。。。),数据越来越多,怎么处理好这些数据,怎么让数据发挥价值,已经变成了对IT行业,对数据库的挑战。对于互联网行业来说,可能对传统行业的业务并不熟悉,或者说互联网那一套技术虽然在互联网中能很好的运转,但是到了传统行业可不一定,比如说用于科研、军工的GIS,和互联网常见的需求就完全不一样。除了对数据库功能方面的挑战,还有一方面的挑战来自性能方面,随着数据的爆炸,分析型的需求越来越难以满足,主要体现在数据的处理速度方面,而常见的hadoop生态中的处理方式需要消耗大量的开发人员,同时并不能很好的支持品种繁多的数据类型,即使GIS可能也无法很好的支持,更别说诸如人像、X光片、声波、指纹、DNA、化学分子、图谱数据、GIS、三维、多维 等等。那么我们有什么好的方法来应对这些用户的痛处呢?且看ApsaraDB产品线的PostgreSQL与HybridDB如何来一招左右互搏,左手在线事务处理,右手数据分析挖掘,解决企业痛处。对传统企业来说,OLTP系统大多数使用的是Oracle等商业数据库,使用PostgreSQL可以与Oracle的功能、性能、SQL语法等做到高度兼容。而对于分析场景,使用MPP产品HybridDB(基于GPDB),则可以很好的解决PB级以上的AP需求。 《ApsaraDB的左右互搏术 - PostgreSQL+HybridDB解决企业痛处 TP+AP混合需求》对于中小型企业,数据量在10TB量级的,分析型的事务甚至也可以交给PostgreSQL来处理。因为它具备了多核并行处理的能力、列存储、JIT、算子复用、甚至向量化执行等技术,相比传统的数据库,在OLTP方面有10倍以上的性能提升。(同时还可以使用LLVM技术,GPU卡FPGA卡来 硬件加速分析) 《分析加速引擎黑科技 - LLVM、列存、多核并行、算子复用 大联姻 - 一起来开启PostgreSQL的百宝箱》《PostgreSQL 9.6 引领开源数据库攻克多核并行计算难题》《PostgreSQL 向量化执行插件(瓦片式实现) 10x提速OLAP》 10 用户群体搜索、根据标签圈人 - 电商、广告投放 等业务场景 电商推荐系统 部分需求介绍比如一家店铺,如何找到它的目标消费群体?要回答这个问题,首先我们需要收集一些数据,比如: 这家店铺以及其他的同类店铺的浏览、购买群体。我们在逛电商时,会产生一些行为的记录,比如在什么时间,逛了哪些店铺,看了哪些商品,最后在哪家店铺购买了什么商品。 然后,对于单个商店来说,有哪些用户逛过他们的商店,购买过哪些商品,可以抽取出一部分人群。 得到这些用户群体后,筛选出有同类消费欲望、或者具备相同属性的群体。对这部分人群的属性进行分析,可以获得一个更大范围的群体,从而可以对这部分群体进行营销。 以上是对电商推荐系统的两个简单的推理。PostgreSQL, HybridDB解决了推荐系统的三个核心问题精准,属于数据挖掘系统的事情,使用PostgreSQL, Greenplum 的 MADlib机器学习库可以实现。实时,实时的更新标签,在数据库中进行流式处理,相比外部流处理的方案,节约资源,减少开发成本,提高开发效率,提高时效性。高效,使用PostgreSQL以及数组的GIN索引功能,实现在万亿USER_TAGS的情况下的毫秒级别的圈人功能。 《恭迎万亿级营销(圈人)潇洒的迈入毫秒时代 - 万亿user_tags级实时推荐系统数据库设计》 11 位置信息处理、点面判断、按距离搜索、化学数据处理 - 危化品监管 等业务场景 危化品的种类繁多。包括如常见的易爆、易燃、放射、腐蚀、剧毒、等等。由于危化品的危害极大,所以监管显得尤为重要, 生产环节将各个原来人工监控的环节数字化,使用 传感器、流计算、规则(可以设置为动态的规则) 代替人的监管和经验。 销售环节利用社会关系分析,在销售环节挖掘不法分子,挖掘骗贷、骗保的虚假交易。利用地理位置跟踪,掌控整个交易的货物运输过程。 仓储环节仓储环节依旧使用传感器、流计算、应急机制对仓管的产品进行实时的监管,而对于危化品本身,我们已经不能使用普通的数据类型来存储,很幸运的是在PostgreSQL的生态圈中,有专门支持化学行业的RDKit支持,支持存储化合物类型,以及基于化合物类型的数据处理 (包括化学反应,分解等等)。 运输环节小结一下,在危化品的运输环节,使用传感器对货车、集装箱内的危化品的指标进行实时的监控,使用流式数据库pipelineDB流式的处理传感器实时上报的数据;使用PostgreSQL+PostGIS+pgrouting 对于货车的形式路径进行管理,绕开禁行路段、拥堵路段。 当出现事故时,使用PostgreSQL的GIS索引,快速的找出附近的应急救助资源(如交警、消防中队、医院、120)。同时对危化品的货物存储,使用化学物类型存储,可以对这些类型进行更多的约束和模拟的合成,例如可以发现化学反应,防止出现类似天津爆炸事件。 消耗环节增加剩余量的监控,在闭环中起到很好的作用,达到供需平衡,避免供不应求,或者供过于求的事情发生。 动态指挥中心在给生产、仓库、物流配送、消耗环节添加了终端、传感器后,就建立了一个全面的危化品监管数据平台。 构建实时的监管全图。 缉毒、发现不法分子等通过社会关系学分析,结合RDKit插件,在数据库中存储了人的信息,存储了人与化学物的关系(比如购买过),然后,根据社会关系学分析,将一堆的化合物(原材料)结合起来,看看会不会发生反应,生成毒品或危化品。从而发现不法分子。 《从天津滨海新区大爆炸、危化品监管聊聊 IT人背负的社会责任感》 12 图式数据搜索 - 金融风控、公安刑侦、社会关系、人脉分析 等业务场景 人类是群居动物,随着人口的增长,联络方式越来越无界化,人与人,人与事件,人与时间之间形成了一张巨大的关系网络。有许多场景就是基于这张巨大的关系网络的,比如。 猎头挖人作为IT人士或者猎头、HR,对Linkedin一定不陌生,领英网实际上就是一个维护人际关系的网站。 通过搜索你的一度人脉,可以找到与你直接相关的人,搜索2度人脉,可以搜索到与你间接相关的人。当然你还可以继续搜索N度人脉,不过那些和你可能就不那么相关了。如果你知道和美女范冰冰隔了几度人脉,是不是有点心动了呢?其实在古代,就有这种社会关系学,还有这种专门的职业,买官卖官什么的,其实都是人脉关系网。看过红楼梦的话,你会发现那家子人怎么那么多亲戚呢?2.公安破案公安刑侦学也是一类人脉相关的应用,只是现在的关系和行为越来越复杂,这种关系也越来越复杂,原来的人能接触的范围基本上就靠2条腿,顶多加匹马。现在,手机,电脑,ATM机,超时,摄像头,汽车等等,都通过公路网、互联网连接在一起。一个人的行为,产生的关系会更加的复杂,单靠人肉的关系分析,刑侦难度变得越来越复杂。3.金融风控比如银行在审核贷款资格时,通常需要审核申请人是否有偿还能力,是否有虚假消息,行为习惯,资产,朋友圈等等。 同样涉及到复杂的人物关系,人的行为关系分析等等。 此类围绕人为中心,事件为关系牵连的业务催生了图数据库的诞生。目前比较流行的图数据库比如neo4j,等。详见https://en.wikipedia.org/wiki/Graph_database PostgreSQL是一个功能全面的数据库,其中就有一些图数据库产品的后台是使用PostgreSQL的,例如OpenCog, Cayley等。除了这些图数据库产品,PostgreSQL本身在关系查询,关系管理方面也非常的成熟,十亿量级的关系网数据,3层关系运算仅需毫秒。还可以用于运算人与人之间的最短关系,穷举关系等。主要用到的技术plpgsql服务端编程、异步消息、数组、游标等。《金融风控、公安刑侦、社会关系、人脉分析等需求分析与数据库实现 - PostgreSQL图数据库场景应用》 13 大量数据的求差集、最新数据搜索, 最新日志数据与全量数据的差异比对, 递归收敛扫描 - 物联网、数据同步、数据清洗、数据合并 等业务场景 有一个这样的场景,一张小表A,里面存储了一些ID,大约几百个到万个。(比如说巡逻车辆ID,环卫车辆的ID,公交车,微公交的ID)。另外有一张日志表B,每条记录中的ID是来自前面那张小表的,但不是每个ID都出现在这张日志表中,比如说一天可能只有几十个ID会出现在这个日志表的当天的数据中。(比如车辆的行车轨迹数据,每秒上报轨迹,数据量就非常庞大,但是每天出勤的车辆有限)。那么我怎么快速的找出今天没有出现的ID呢。(哪些巡逻车辆没有出现在这个片区,是不是偷懒了?哪些环卫车辆没有出行,哪些公交或微公交没有出行)? select id from A where id not in (select id from B where time between ? and ?);select a.id from a left join b on (a.id=b.aid) where b.* is null; 这个QUERY会很慢,通常需要几百秒到几十秒,有什么优化方法呢。通过PostgreSQL的递归查询,可以高效的解决这个问题(在几亿记录中筛选出与几万记录的逻辑差集)。优化后只需要10毫秒左右。《用PostgreSQL找回618秒逝去的青春 - 递归收敛优化》同样的方法,还可以用于数据清洗与合并的场景,比如在物联网的环境中,每个传感器,每个小时会上报若干条数据(有新增的,有更新的,有删除的指标等),对于同一个KEY,后台的应用程序只关心最后一条记录。使用PostgreSQL的递归收敛,每秒可以清洗或合并千万量级的数据。除了物联网,同样适用于数据库之间的数据逻辑同步。《时序数据合并场景加速分析和实现 - 复合索引,窗口分组查询加速,变态递归加速》 14 数据一致性分享、数据泵 - 跨业务平台实时分享数据 等业务场景 在IoT的场景中,有流式分析的需求,也有存储历史数据的需求,同时还有数据挖掘的需求,搜索引擎可能也需要同一份数据,还有一些业务可能也要用到同一份数据。但是如果把数据统统放到一个地方,这么多的业务,它们有的要求实时处理,有的要求批量处理,有的可能需要实时的更新数据,有的可能要对大数据进行分析。显然一个产品可能无法满足这么多的需求。就好比数据库就分了关系数据库,NOSQL,OLTP场景,OLAP场景一样。 也是因为一个产品无法满足所有的业务需求。在企业中通常是借助数据冗余来解决各类场景的需求。那么如何才能够更好的分享数据,保证数据的一致性,提高分享的实时性呢?10万级别左右的机器,PostgreSQL 的数据吞吐量可以达到100万条/s以上,同时数据库本身具备了严格的可靠性和一致性保证。PostgreSQL为分享数据提供了插槽的概念,每个插槽对应一个目标端,支持断点续传,支持多个目标端。用于流式的分享数据是非常好的选择。 《实时数据交换平台 - BottledWater-pg with confluent》 15 分词搜索、模糊搜索、相似度搜索 - 电商、公安、传统企业 等业务场景 看刑侦剧经常有看到人物拼图,然后到图库搜索的,以前可能靠的是人肉,使用PG,可以靠数据库的图形近似度搜索功能。《弱水三千,只取一瓢,当图像搜索遇见PostgreSQL (Haar wavelet)》 而对于文本搜索,大家一定会想到分词,比如搜索引擎、淘宝的商品内容搜索、文章的关键字搜索等等。PostgreSQL内置了分词引擎,可以很好的满足这类搜索的需求。但是千万不要以为分词可以搞定一切需求,比如这样的需求就搞不定。hello world打成了hello word或者hello w0rld,你要让数据库匹配出来,怎么搞?又或者你的业务需要写正则进行匹配,怎么搞?比如一些域名的查询,www.firefoxcn.org 可能你只想输入其中的一个部分来搜索,如果firefox可以匹配。甚至更变态的 fi[a-z]{1}e.*?.?? ,这样的查询。数据量小,并发小时,这种查询是可以忍受全表扫描和CPU处理过滤的。但是想想一下,你是一个日请求过亿的业务,或者数据量亿级别的,全表扫描和CPU的开销会让你疯掉的。PostgreSQL完美的解决了这类变态的需求。 使用PostgreSQL regexp库,将正则转换为NFA样式(图形化词组)。 将NFA样式再进行转换,转换为扩展的图形样式(trigrams),包括拆分后的查询词组与NOT词组。 简化,过滤不必要的trigrams。 打包为TrgmPackedGraph结构,支持GIN,GIST索引的检索。 《聊一聊双十一背后的技术 - 毫秒分词算啥, 试试正则和相似度》《中文模糊查询性能优化 by PostgreSQL trgm》 《PostgreSQL 百亿数据 秒级响应 正则及模糊查询》[《PostgreSQL 1000亿数据量 正则匹配 速度与激情》](https://github.com/digoal/blog/blob/master/201603/20160307_01.md)还有一种场景,比如口音纠正、口音相似度搜索。 16 文本分析、人物画像 - 电商、公安、传统企业、广告商 等业务场景 在日常的生活中,我们可能会经常需要一些像相近、相仿、距离接近、性格接近等等类似这样的需求,对数据进行筛选。在PostgreSQL中,这些场景都支持索引排序和检索。 《聊一聊双十一背后的技术 - 分词和搜索》《PostgreSQL 全文检索加速 快到没有朋友 - RUM索引接口(潘多拉魔盒)》《PostgreSQL 如何高效解决 按任意字段分词检索的问题 - case 1》 比如收集了人群的各种喜好的数据,通过对关联数据的聚类分析,或者按喜好的重叠度进行排序,找出目标人群。这里就涉及到文本的近似度分析,PostgreSQL的文本分析功能可以很好的支持此类场景。 《PostgreSQL 文本数据分析实践之 - 相似度分析》 17 高并发更新少量记录 - 电商、票务系统 等业务场景 秒杀在商品交易中是一个永恒的话题,从双十一,到一票难求,比的仅仅是手快吗?其实对于交易平台来说,面对的不仅仅是人肉,还有很多脚本,外挂自动化的抢购系统,压力可想而知。秒杀的优化手段很多,就拿数据库来说,有用排队机制的,有用异步消息的,有用交易合并的。今天我要给大家介绍一种更极端的秒杀应对方法,裸秒。目前可能只有PostgreSQL可以做到裸秒,也即是说,来吧,一起上。PostgreSQL提供了一种ad lock,可以让用户尽情的释放激情,以一台32核64线程的机器为例,每秒可以获取、探测约130万次的ad lock。试想一下,对单条记录的秒杀操作,达到了单机100万/s的处理能力后,秒杀算什么?100台机器就能处理1亿/s的秒杀请求。 《聊一聊双十一背后的技术 - 不一样的秒杀技术, 裸秒》《PostgreSQL 使用advisory lock或skip locked消除行锁冲突, 提高几十倍并发更新效率》 18 实时用户画像 - 电商、实时广告、实时营销、金融 等业务场景 用户画像在市场营销的应用重建中非常常见,已经不是什么新鲜的东西,比较流行的解决方案是给用户贴标签,根据标签的组合,圈出需要的用户。通常画像系统会用到宽表,以及分布式的系统。宽表的作用是存储标签,例如每列代表一个标签,但是通常数据库到2000个列基本就是极限了,上万TAG的话,只能使用多表JOIN来实现,效率较差。另一方面,使用宽表(甚至列存储),标签的筛选性能也比较差(无法达到实时级别)。以PostgreSQL数据库为基础,给大家讲解一下更加另类的设计思路,以BIT来存储用户,每行一个TAG的方式。10万亿级TAG/users,毫秒级圈人。《基于 阿里云 RDS PostgreSQL 打造实时用户画像推荐系统》 19 动态规划 - 物流配送、打车软件、导航软件、出行软件、高速、高铁 等业务场景 每年双十一的交易额都创新高,今年也不例外,双十一几乎成了各种IT系统的大考,物流也不例外。每次双十一快递几乎都被爆仓,但是随着技术的发展,今年,听说双十一刚过,小伙伴们的包裹都快收到了。今天,来给大家分享一下物流与背后的数据库技术,当然我讲的还是PostgreSQL, Greenplum, PostGIS一类,大伙了解我的。物流行业是被电子商务催生的产业之一。快件的配送和揽件的调度算法是物流行业一个非常重要的课题,直接关系到配送或揽件的时效,以及物流公司的运作成本。好的算法,可以提高时效,降低成本,甚至可以更好的调动社会资源,就像滴滴打车一样,也许能全民参与哦。以后也许上班路途还能顺路提供快递服务呢。以物流行业为例,PostgreSQL与Greenplum为物流行业应用提供了包括机器学习、路径规划、地理位置信息存储和处理等基础服务。 《聊一聊双十一背后的技术 - 物流、动态路径规划》 20 流式同步多副本、极致数据可靠性 - 金融、传统企业、互联网 等业务场景 传统的金融行业高度依赖共享存储来解决数据库的高可用,数据0丢失以及异地容灾的场景。共享存储的解决方案价格昂贵,对厂商的依赖较大。PostgreSQL基于同步流复制的 任意副本 解决方案,在解决0丢失,高可用以及容灾的问题的同时,还可以提供只读的功能。相比传统的存储解决方案,优势更加明显。 《PostgreSQL 金融行业高可用和容灾解决方案》《PostgreSQL 9.6 同步多副本 与 remote_apply事务同步级别》《2017金秋将要发布的PostgreSQL 10.0已装备了哪些核武器?》 21 块级瘦索引 - 物联网、金融、日志、行为轨迹类数据 等业务场景 在物联网、金融、日志类型场景中,数据持续不断的产生,对于堆存储来说,有线性相关的特点。例如,时间字段往往和物理存储的顺序具有线性相关性。例如,有一些自增字段,也和堆存储的物理顺序线性相关。对与物理存储线性相关的字段(时间,自增字段),PostgreSQL提供了一种BRIN块级范围索引,索引中存储了对应数据块中的字段统计信息(例如最大值,最小值,平均值,记录数、SUM,空值个数等)这种索引很小,因为索引的粒度是连续的块,而不是每条记录。通常比BTREE索引小几百倍。如果字段的线性相关性很好,进行范围查询或者精确检索时,效率非常高。对于统计查询,也可以使用BRIN索引,提高分析统计的效率。[《PostgreSQL 物联网黑科技 - 瘦身几百倍的索引(BRIN index)》](https://github.com/digoal/blog/blob/master/201604/20160414_01.md)《PostgreSQL 9.5 new feature - BRIN (block range index) index》《PostgreSQL 聚集存储 与 BRIN索引 - 高并发行为、轨迹类大吞吐数据查询场景解说》 22 持续数据写入,高效、0丢失 - 运营商网关、物联网、IT系统FEED 等业务场景 在运营商网关、物联网的工业数据采集和处理,IT系统的FEED等业务场景中,数据产生的量非常庞大,这些数据要在保证可靠性的情况下,快速的入库。对于PostgreSQL来说,使用中端x86服务器(通常在10万以内,32核,SSD+SATA结合)上的数据插入速度(目标表包含一个brin索引),实际测试可以达到每天上百TB的写入。从而以较高的性价比,满足此类业务场景的需求。《PostgreSQL 如何潇洒的处理每天上百TB的数据增量》 23 时序数据有损压缩 - 时序、物联网、FEED数据、金融 等业务场景 在物联网、金融、FEED等场景中,往往有大批量的指标数据产生并进入数据库,通常包含 时间、值 两个字段。这些数据由于量非常庞大,而且就像音频一样,实际上是可以对其进行有损的压缩存储的。最为流行的是旋转门的压缩算法,在PostgreSQL中可以使用UDF,方便的实现这个功能。从而实现流式时序数据的有损压缩。 《旋转门数据压缩算法在PostgreSQL中的实现 - 流式压缩在物联网、监控、传感器等场景的应用》 24 会话级资源隔离 - 多租户、云、混合业务资源控制 等业务场景 在很多场景中,用户希望可以控制每个连接(会话)的资源使用情况,例如CPUIOPSMEMORY等。PostgreSQL是进程结构,可以通过cgroup很好的实现这个需求,不需要对数据库内核进行改造。另一方面,基于PostgreSQL的产品GPDB,则是在数据库的内核层面实施的控制。 《PostgreSQL 会话级资源隔离探索》 25 基因工程 - 生命科学、医疗 等业务场景 PostgreSQL凭借良好的扩展性,不仅仅是一个数据库,同时也是具备非常强大的数据处理能力的数据平台。很多垂直行业的用户拿它来做各种和业务贴合非常紧密的事情。例如PostgreSQL在生命科学领域的应用案例 - 基因工程。通常的思维可能是这样的,把数据存在数据库,需要运算的时候,再把数据取出进行运算(例如配对),需要花费非常多的网络传输时间。 PostgreSQL提供了基因工程相关的数据类型,操作类型,索引。满足基因工程业务的需求。用户可以直接在数据库中对基因数据进行处理。同时还可以利用MPP来解决更大数据量的问题(例如压缩后百TB级别)。 《为了部落 - 如何通过PostgreSQL基因配对,产生优良下一代》 26 数据预测、挖掘 - 金融数据分析、机器学习 等业务场景 PostgreSQL、以及HybridDB(基于GPDB),等PostgreSQL相关的数据库,都支持MADlib机器学习库,这个库支持机器学习领域常见的算法(例如聚类、线性回归、贝叶斯、文本处理等等)其中在数据领域用得较多的数据预测,可以使用MADLib的多元回归库,进行数据的预测。结合plR语言 或者R + pivotalR 、 python + pythonR插件,可以自动将Rpython语言的命令转换为MADlib库函数,对数据进行分析。非常适合使用R或者python对数据进行分析的数据科学家使用。其特点是高效(数据与运算一体,可以使用LLVM向量计算等技术优化,同时不需要传播数据,节约了传播的开销)、易用(支持常见的SQL、r, python等编程)。 《PostgreSQL 线性回归 - 股价预测 1》《在PostgreSQL中用线性回归分析linear regression做预测 - 例子2, 预测未来数日某股收盘价》 27 数据库端编程 - ERP、电商、传统企业、电商、运营商 等业务场景 在传统企业、电商、运营商等涉及用户交互、或者多个系统交互的业务场景中,通常一个事务涉及到很复杂的业务逻辑,需要保证数据的一致性,同时还需要与数据库多次交互。比如 银行开户 , 涉及的业务系统多,逻辑复杂。在传统企业中,通常使用商业数据库的过程函数,实现此类复杂的逻辑。PostgreSQL的数据库过程函数支持的语言非常丰富,比如plpgsql(可与Oracle pl/sql功能比肩),另外还支持语言的扩展,例如支持python,perl,java,c,r等等作为数据库的过程函数语言。对于开发人员来说,几乎可以在PostgreSQL数据库中处理任何业务逻辑。《论云数据库编程能力的重要性》 28 ECPG,C嵌入式开发 - 金融 等业务场景 在金融行业中,用得非常多的是嵌入式SQL开发,可能为了处理复杂的逻辑,同时还需要非常高的效率、以及方便的代码管理。所以此类场景就会用到嵌入式SQL开发,取代部分数据库过程语言的代码。PostgreSQL 的ECPG,与Oracle的Pro*C功能对齐,是个非常好的选择。 https://www.postgresql.org/docs/9.6/static/ecpg.html 29 数据库水平拆分、跨平台数据融合 - 金融、电商、互联网、物联网 等业务场景 PostgreSQL 从 2011年的9.1版本引入FDW开始,发展到现在已经支持几乎所有的外部数据源读写操作,例如mysql,oracle,pgsql,redis,mongo,hive,jdbc,odbc,file,sqlserver,es,S3,......。https://wiki.postgresql.org/wiki/Fdw开放的接口,允许用户自己添加外部数据源的支持。9.6针对postgres_fdw(即PostgreSQL外部数据源)再次增强,开始支持对sort, where, join的下推,支持remote cancel query, 用户使用FDW可以对应用透明的实现数据库的sharding,单元化需求。内核层支持sharding,这种分片技术相比中间件分片技术的好处: 支持跨库JOIN 支持绑定变量 支持master(coordinator)节点水平扩展 支持segment(datanode)节点水平扩展 支持函数和存储过程 支持sort, where, join的下推,支持remote cancel query,10.x支持聚合算子的下推。ps: 目前还不支持分布式事务(需要用户干预2PC) ,10.x的版本会增加内核层面的分布式事务控制。 《PostgreSQL 9.6 单元化,sharding (based on postgres_fdw) - 内核层支持前传》《PostgreSQL 9.6 sharding + 单元化 (based on postgres_fdw) 最佳实践 - 通用水平分库场景设计与实践》 除了postgres_fdw,PostgreSQL还有很多FDW,也就是说,你可以在PostgreSQL数据库中,访问几乎任何外部数据。就像访问本地的表效果一样。 30 地理位置信息查询 - LBS、社交、物流、出行、导航 等业务场景 在LBS、社交、物流、出行、导航等场景中,最为常见的一个需求是基于位置的搜索,比如搜索附近的人,并按距离由近到远排序。在PostgreSQL中,有专门的GiST, SP-GiST索引支持,可以做到非常高效的检索,100亿地理位置数据,查询某个点附近的点,普通硬件,单个数据库响应时间在1毫秒以内。PostgreSQL在位置信息近邻(KNN)查询方面的性能参考。 《PostgreSQL 百亿地理位置数据 近邻查询性能》 参考文献 《宝剑赠英雄 - 任意组合字段等效查询, 探探PostgreSQL多列展开式B树》 《PostgreSQL 9.6 黑科技 bloom 算法索引,一个索引支撑任意列组合查询》《聊聊between and的坑 和 神奇的解法》《PostgreSQL 黑科技 range 类型及 gist index 20x+ speedup than Mysql index combine query》《PostgreSQL 黑科技 range 类型及 gist index 助力物联网(IoT)》《从难缠的模糊查询聊开 - PostgreSQL独门绝招之一 GIN , GiST , SP-GiST , RUM 索引原理与技术背景》《蜂巢的艺术与技术价值 - PostgreSQL PostGIS's hex-grid》《PostGIS 地理信息数据 多核并行处理》《从电波表到数据库小程序之 - 数据库异步广播(notify/listen)》《从微信小程序 到 数据库"小程序" , 鬼知道我经历了什么》《[转载] postgres + socket.io + nodejs 实时地图应用实践》《流计算风云再起 - PostgreSQL携PipelineDB力挺IoT》《PostgreSQL 流式数据处理(聚合、过滤、转换...)系列 - 9》《基于PostgreSQL的流式PipelineDB, 1000万/s实时统计不是梦》《"物联网"流式处理应用 - 用PostgreSQL实时处理(万亿每天)》《(AR虚拟现实)红包 技术思考 - GIS与图像识别的完美结合》《电商内容去重内容筛选应用(如何高效识别转载盗图侵权?) - 文本相似、图片集相似、数组相似的优化和索引技术》《PostgreSQL 在视频、图片去重,图像搜索业务中的应用》《从相似度算法谈起 - Effective similarity search in PostgreSQL》《PostgreSQL 行级 全文检索》《PostgreSQL 全表 全字段 模糊查询的毫秒级高效实现 - 搜索引擎颤抖了》《从难缠的模糊查询聊开 - PostgreSQL独门绝招之一 GIN , GiST , SP-GiST , RUM 索引原理与技术背景》《ApsaraDB的左右互搏术 - PostgreSQL+HybridDB解决企业痛处 TP+AP混合需求》《分析加速引擎黑科技 - LLVM、列存、多核并行、算子复用 大联姻 - 一起来开启PostgreSQL的百宝箱》《PostgreSQL 9.6 引领开源数据库攻克多核并行计算难题》《PostgreSQL 向量化执行插件(瓦片式实现) 10x提速OLAP》《恭迎万亿级营销(圈人)潇洒的迈入毫秒时代 - 万亿user_tags级实时推荐系统数据库设计》《从天津滨海新区大爆炸、危化品监管聊聊 IT人背负的社会责任感》《金融风控、公安刑侦、社会关系、人脉分析等需求分析与数据库实现 - PostgreSQL图数据库场景应用》《用PostgreSQL找回618秒逝去的青春 - 递归收敛优化》《时序数据合并场景加速分析和实现 - 复合索引,窗口分组查询加速,变态递归加速》

优秀的个人博客,低调大师

Android wifi无线调试App新玩法ADB WIFI

Wifi 调试App已经不是什么新鲜的事情了,之前也看过不少,不是使用麻烦就是需要root权限,今个我给大家介绍一款好用的android studio 插件--ADB WIFI。 安装 settings->plugins->Browse repositories 搜索框输入ADB WIFI找到插件,安装,重启android Studio后可以看到 导航菜单下Tools->Android->ADB WIFI就算安装成功了。 使用 第一步:首先还是需要用数据线连接电脑,如下图: 第二步:找到ADB WIFI菜单,如下图: 第三步:运行ADB Restart(Ctrl+Alt+Shift+R)第四步:运行ADB USB to WIFI(Ctrl+Alt+Shift+W)第五步:最后拔掉数据线。 打开LogCat,看看有没有闪动的日志信息,如果有就是成功了。 另外Android WiFi ADB这个插件也很好用github地址AndroidWiFiADB 作者:dongjunkun 链接:http://www.jianshu.com/p/21d1b65d92a4 來源:简书 著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。

优秀的个人博客,低调大师

【云计算的1024种玩法】搭建个人博客

好吧,我承认您看了题目以后,可能就会很嫌弃的说,不就是一个博客吗,谁不会搞啊,某浪,某讯都有博客,注册一个博客谁还不会,用得着你教我嘛。您先静一静,喝口水压压惊,我们这里是帮您拥有一个属于您自己的不会冠以某浪某讯的title并且拥有更多freestyle的博客界面的博客,有点小心动的话,就去动手做一个吧。我和大家一起搭建博客平台,并发现一些小的技巧来丰富博客内容。 一、搭建一个博客平台1、 开通云服务器阿里巴巴财大气粗,对在校学生也是相当慷慨。阿里云账户完成实名认证和学生身份认证,购买云产品即可享受优惠,链接如下:https://promotion.aliyun.com/ntms/campus2017.html一定要保证已经实名认证和学生认证。 2、搭建镜像LAMP环境(Ubuntu16.04 Apache PHP7.1)第一种方法是在购买ECS是选择镜像: 第二种方法是更换镜像:强制停止服务器配置信息更换系统盘 第三种方法是直接购买:链接如下https://market.aliyun.com/products/53398003/cmjj016263.html 3、安装FileZiila和PuTTYFileZilla下载链接:https://filezilla-project.org/download.php?type=clientFileZilla从虚拟机上上传文件。 PuTTY下载地址:https://github.com/larryli/PuTTY/releases PuTTY 是自由的跨平台 Telnet/SSH 客户端,同时在 Win32 和 Unix 系统下模拟 xterm 终端。其主要作者是 Simon Tatham。4、下载WordPress并上传下载 WordPress地址:https://cn.wordpress.org/wordpress-4.8-zh_CN.zip并解压缩用FileZilla将WordPress上传至 /data/wwwroot/default/ 目录: 二、博客展示1、用阿里云服务器搭建个人博客的优势目前,除了用阿里云服务器搭建个人博客之外,常用的方法是使用hexo+githubpages搭建博客,该方法需要购买域名、安装hexo软件和配置各种参数等等;还有使用ubuntu14. 04+Nginx1.8+uWSGI来部署Django应用然后再购买域名,使用MySQL数据库,费时费力大概需要一个月左右的时间,可能还要备案一些东西,步骤繁琐,且安全性也得不到保证。阿里云以它超强的资源整合能力,以及完整的服务体系,搭建个人博客基于WordPress,从域名的申请到各种文件的配置再到最后写成第一篇博文,都有详细的解决方案,能够满足从零开始的使用者轻松快捷的使用,但是该方法提供的博文模式相对较少,后期还要开发人员多上线一些新的模板,满足不同需求的使用者。总体来说,使用阿里云搭建个人博客,简单易用,省时省力,只需要博主把精力放在博文的内容上,后台运行就交给阿里云,做一个“甩手掌柜”。2、亲身体验(1)在登录个人博客之后,点击左侧的文章---写文章,就可以开始写作了。在标题和正文的相应位置编写。 (2)内容编辑好之后,我们来预览一下,点击,预览更改,会出现预览失败的问题。这时可以点击左侧一栏中的设置----固定链接----保存更改,就解决预览失败的问题了。 (3)编写检查完成之后,点击,更新,就可以上传到主页上了 (4)登录http://外网IP,就可以看到更新的文章 (5)如果想再发文章,在首页上,点击,新建----文章,编辑完成以后,点击,发布,就完成了。 (6)还可以新建----媒体、页面和用户等等 ![_](https://yqfile.alicdn.com/ccaed6ef437fa8644eb9829b2d6c16c039be37f9.png) (7)个性化设置,下面我自己设置的,额,感觉不是很好看呀,快来发挥你的美学才华吧,把自己的博客装饰的更加多彩。 通过以上方法,可以搭建一个个人博客并且可以丰富页面内容,完善页面的功能,私人订制页面(个性化设置)等等,能够满足大部分功能需求。 更详细操作请见操作文档

优秀的个人博客,低调大师

美国智能家居产品又添新玩法

美国综合报道 最近,美国智能家居产品Nest增加了两个新的功能,一个是可以从手机上设置Nest,第二个可以在Nest增加一个账户。 不要小看这两个新的功能,这可以说是一次思维的转变。随着互联网时代的发展,人们越来越希望能够将一个设备与家庭进行有效连接,随着物联网的发展,设备制造商和运用商也不断在做出这种尝试,包括将设备与整个家庭的链接,和一个设备可以让不同人或者账号使用。 这两个功能只是一个开始。首先,设立一个家庭账户,Nest最多可以让10个人加入同一个账户,来控制家里的产品。在之前,如果你的家人,比如妻子想要控制恒温器、摄像头或者烟雾探测器,需要登录Nest的app,这样就必须要共享一个密码,让人觉得不是很方便。这个解决办法就是跟你一个电子邮件的账户,这样大家都可以都来使用这个账户了。 第二个特点就是解决了Nest可以在人离开房屋之后的工作模式。之前Nest的模式是当家里有人时,工作启动,进行温度的调节。如果将Nest装到比较偏僻的地方,无法感知人在房间时,就无法更好地工作。而这个功能添加以后,即便是人们离开了,它也能够进行判断,从而关闭加热系统。 之前有几家公司希望向Nest提供如何判断大家是否在家,以此来解决这个问题。Nest决定自己来解决,新增了一个手机地理定位的功能,如果定位在家里的话,就此可以判断在家里,如果不在家里的话,就会自动关闭加热系统。这样无论遥感器是否能够感应到你,都可以多一个判断你是否在家的工具。 Nest后期还想将这两个简单的功能进行扩展,通过家庭账户和地理定位的结合,将知道谁在家里,根据每个人的喜好,将温度调整到在家里那个人的喜好。换句话说,比如如果“我”在家的时候,Nest将根据“我”的喜好来调整温度,同时让整个照明系统也来适应“我”的需求,这将真正实现智能化。 本文转自d1net(转载)

优秀的个人博客,低调大师

极具个性创意机器人带你走入完美生活

随着节日的到来,各大厂商纷纷推出自己的新产品就不足为奇了,今天为大家带来的这个机器人叫Sakura,穿着粉色装扮的她,完全一副忧郁的表情,而且还踩着一个未来派的滑板。她可以发出一些好听的笑声,还可以播放五首不同的歌曲。除此之外,脚底的滑板可以由遥控器控制,当你们相处时间久了之后,获得了彼此之间的信任,你可以把你的小秘密告诉她哦,相信她是绝对不会泄密的。嗯,不过呢,这个漂亮的东东要花去你大约50英镑才可以买到哦。 在最近的一次发布会上,日立展出了这个叫做EMIEW 2的机器人。这个两轮的机器人可以在办公室里接受无线信号,并且可以没有任何障碍的执行命令。EMIEW 2身高31.5英尺,重29磅,当人们热情参观的时候,机器人突然变的像个木头一样静止不动了,设计者告诉观众机器人还在调试当中。然而,在通常情况下,EMIEW 2可以轻松的避开障碍物,并且可以理解和回应人类的语言,如果充一次点的话,至少可以不间断的工作一个小时。公司方面虽然还没有透露具体的价格和发布日期,但总是值得人们期待的。 这个身高1米的瓢虫机器人预计在2009年正式发行,她可以在你不在家的时候帮你清洗地板,打扫房间,在他的身上装有一个超级大的水箱,还有打扫卫生用的刷子。不仅如此,身上的障碍探测器可以避免在工作的时候碰到房间中的家具,甚至如果有人想要和他说话的话,他身上装的语音识别软件可以解决问题。不过官方没有给出机器人到底怎么打扫房屋的视频,但是如果一切顺利的话,这个小机器人将会卖到31,713美元。 原文出处:科技行者 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

VS Code Agents 新玩法:先闲聊,后绑定项目

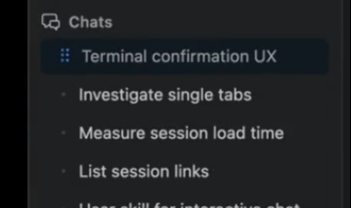
不知道大家平时用vscode Agents的时候有没有遇到这种尴尬。 想先跟AI唠唠思路,讨论下方案构思。可只要你想聊代码相关内容,就必须先打开对应的项目文件夹。 如果没加载工作区,Agent会话完全看不到本地代码;一旦切换工程,旧聊天直接作废,历史对话全部丢失,只能重新新建会话从头聊一遍,体验实在有点闹心。 有时候,再开发过程中,想临时问些通用的问题,但是不想污染目前的聊天内容,就类似于电影里面的一些旁白的作用。以前的vscode确实没有为这种需求做设计。 现在VS Code给Agents带来了一个很贴心的更新:**Quick chats快速会话,支持后期再绑定工作空间(workspace)**。 简单来说,你现在可以先开启一次无项目绑定的快速聊天。 一开始不用打开任何本地工程,直接就在Agents窗口跟AI自由沟通。可以聊聊技术选型、头脑风暴、梳理需求,纯粹讨论想法,不用跟本地文件夹挂钩。 可以使用快捷键 ctrl k ctrl n,连续按两组快捷键,快速打开quick chat,也可以点击Chats右上角的加号。 也可以使用命令面板,执行 `Chat: Open Agents Window` 来打开 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/49da8760ae35ed65e7b0c5dedc363a53.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/72e4ad49450ca6bb813274bc3c770817.png) 聊天记录可以再左边的Chats找到 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/7e6de4db6b7e6b48fbc2bbb066ff1c80.png) 这里顺便提一句,vscode之前也有一个叫quick chat的东西,是存在与编辑器窗口的,悬浮在编辑器顶部的临时轻量输入条。关掉之后聊天历史直接消失,不会保存会话记录。 这个quick chat经常用来临时问一个小问题、解释一段选中代码、快速生成一小段代码。 为了方便区分,可以把本文主题的chat quick叫做Agent window quick chat;另一个叫做editor window quick chat。 聊着聊着话题落到手上这个项目了,需要AI读取本地源码帮你改代码的时候,**不用关掉当前对话,也不用新开会话**。直接让Copilot Agent附加本地文件夹就可以继续往下聊。 当你想真正落地或者实现什么之后,这里会给出一个选择。你有3条路可选:直接使用当前文件夹,自定义一个目录,创建独立隔离的Git worktree。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/78b6aaf9507decfeb482115f27616487.png) 直接使用文件夹,Agent就直接读写你本机项目文件,改动实时生效。 而隔离worktree模式就有意思了,Agent的所有修改全部跑在一份独立的Git工作树上。你的原始源码不会被胡乱改动,相当于给AI开辟一块沙箱,先随便造,等你确认改动没问题之后,再合并回正式代码。这也是vscode最推荐的方式。 不过再使用这个方式之前,你至少有一个git仓库,并且提交了一次。 此时vscode就会再右边出现Changes的面板 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-11859176/b81136c8129ee6d454bf312ed83f52eb.png) 放在以前,头脑风暴和写代码只能割裂开来。先在外边想好了思路,复制粘贴提示词,新开会话再让AI改项目代码,中间很容易丢失一部分上下文。 现在的流程就顺滑很多:先闲聊头脑风暴定方案 → 原地挂载项目源码 →(可选开启隔离worktree沙箱)→ AI基于前面讨论的结果直接动手修改代码。 这个小更新看着不起眼,却实实在在改善了Agent的使用习惯。尤其是平时喜欢先跟AI一起梳理设计思路再动手写代码的小伙伴,可以好好体验一下这个新特性。

优秀的个人博客,低调大师

偷师 IDEA,Zed 也有这个 git 新玩法了!

## 在爱情中 我们无法真正选对某个人 ## 只是在我们有限的心智中 ## 足够好的选择了某个人 ## 引言 做团队协作开发、线上故障追查时,Git Blame几乎是每日必用工具流。 然而对于用过 IDEA 的我来说,我就有一个习惯:当看到一段不错的代码的时候,或者在找 bug 的时候,想看这段代码是谁写的或者这个 bug 是哪个妹子造的时候,就会习惯性的右击左侧行号栏。 而旧版Zed的Blame开关藏在编辑器右上角状态栏,每次追溯代码都要移动鼠标到窗口边角,频繁切换极其割裂工作流和厌烦心态。 zed这次更新就落地了这个全新交互特性,拯救了我的高频痛点:在行号侧边栏右键菜单内置Git Blame动态开关,交互逻辑完美复刻 IDEA,同时坚守Zed轻量化、低冗余的产品审美 ## 一、新特性核心能力拆解 该特性可能很多小伙伴不太了解,下面详细展开说说 git blame 的设计 1. **行号侧边栏原生右键切换功能** 右键任意代码行左侧gutter区域,菜单会根据当前状态动态切换文字:未开启注释时显示「打开Git Blame」,已开启则变为「关闭Git Blame」,单步完成开关操作,视线不用离开代码区域 1. **极简UI设计,原生清爽风格** 官方设计阶段直接否决丑陋的带勾选框的方案,仅保留单一动态菜单项,保证右键菜单干净整洁,符合Zed拒绝冗余视觉元素的设计准则。 ![](https://developer.qcloudimg.com/http-save/yehe-11859176/02ff7f7e04949984f3c011fd1465af73.png) 打开的效果基本上和idea比较类似 ![](https://developer.qcloudimg.com/http-save/yehe-11859176/885cf9e12d88329f9e3a4068531b0715.png) 使用链路极度贴合直觉:鼠标悬停行号、右键一键开启注释栏,查看完责任人随时可右键关闭,整套流程打下来流畅漂亮。将操作入口放在其渲染位置附近,有助于提升可发现性,看来这点已经在idea和zed达成了共识。 ## 二、Zed VS IDEA ### 1. 趋同:对齐行业主流高频交互逻辑 二者核心入口完全统一,均支持**行号侧边栏右键一键开关Blame**,解决了“展示区域和操作区域分离”的反人类设计。对于大量从IDEA迁移至Zed的Go、Rust开发者,这套操作零学习成本,不用重新记忆全新操作路径,大幅降低切换编辑器的适应门槛。 ![](https://developer.qcloudimg.com/http-save/yehe-11859176/99fb7826c83f1be5843fa36aa8c0ebae.png) ### 2. 分歧:极简轻量化 VS 大而全 IDEA作为全功能重型IDE,右键菜单承载完整版本追溯生态:开启注释后再次右键,可切换作者/哈希/日期展示样式、跳转提交详情、一键打开远程仓库Commit页面,复杂合并追溯的企业级场景。 反观Zed本次新增特性,只保留最核心的开关能力,官方思路十分清晰:90%日常开发仅需要快速查看代码责任人,低频高级功能不占用右键菜单空间,优先保证界面轻爽化。 vscode自身的git集成并没有整个能力,通常只有手敲命令,或者使用gitlens插件 查看行内blame ![image](https://developer.qcloudimg.com/http-save/yehe-11859176/6b261edac5473ef23ec49a5ac585be2f.png) 侧边栏blame ![image](https://developer.qcloudimg.com/http-save/yehe-11859176/338d0ebd09262835435acfc687477477.jpg) Zed始终坚持无冗余、低开销的设计路线,本次新特性没有照搬IDEA臃肿的多级菜单,仅补充基础开关,不增加编译体积。对于笔记本性能一般、追求长时间稳定编码的开发者,这套取舍远比堆砌功能更友好。 ## 结语 行号栏右键切换Git Blame看似微小UI更新,实则是Zed平衡「主流IDE交互习惯」与「自身轻量化高性能定位」的典型新特性。 这也给很多 IDEA 玩家转 zed 埋下了伏笔。 整体而言,这次 zed 的新特性又让我多爱它一点了,虽然 zed 对 git 的支持仍不尽如人意,但好在 zed 在 持续完善Git 功能,对键盘流、轻量化偏好开发者十分友好。

优秀的个人博客,低调大师

甘特图的这些新玩法,你都知道吗?

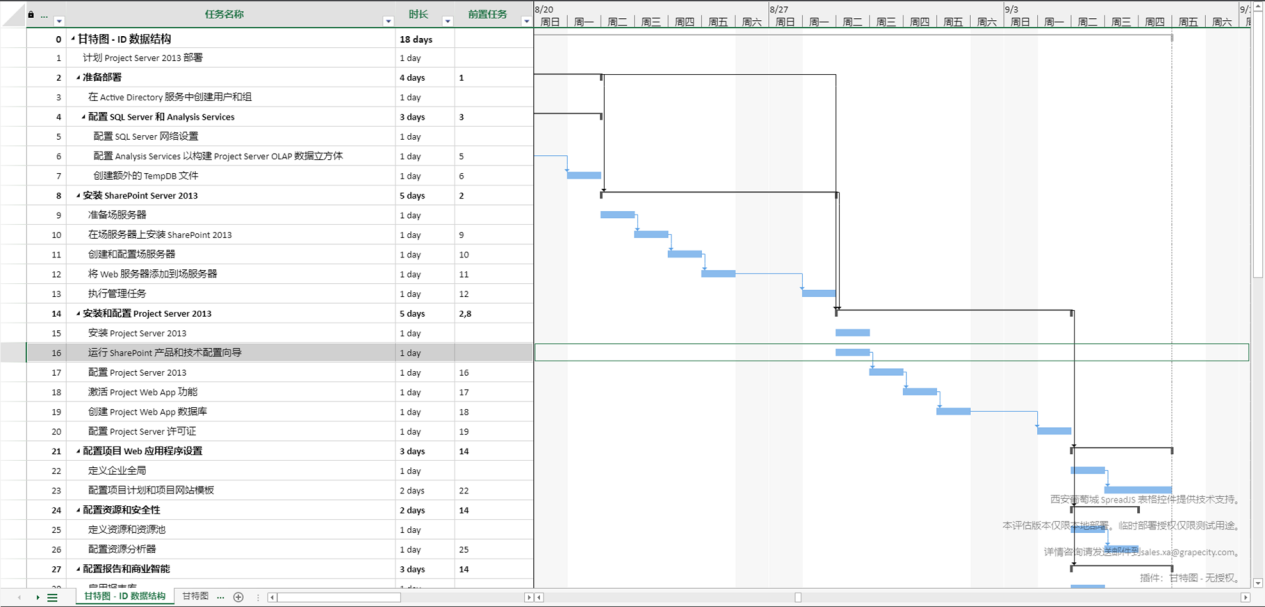
摘要:本文由葡萄城技术团队于OSCHINA发布。转载请注明出处:葡萄城官网,葡萄城为开发者提供专业的开发工具、解决方案和服务,赋能开发者。 前言 甘特图是项目管理、生产排程、节点管理中非常常见的一个功能。那么,有没有一种方法能够帮助将甘特图引入到系统中,让数据的进度、排程数据的展示更加直观,让管理更加高效。 本葡萄今天为大家带来一个新的插件——甘特图插件。该插件是结合 SpreadJS 本身强大电子表格能力提供的一种全新的可视化展示方案,能够有效地将生产计划、预算排期中的日程管理信息展示出来,显示关键路径上关键节点的进展或状态。其数据来自与集算表同源的数据管理器(DataManager),通过绑定 -> 视图的方式,将层级化的任务数据通过甘特图插件进行展示。 (通过甘特图插件展示层级化的数据) 1. 缩放和时间刻度滚动 (通过甘特图插件实现缩放及刻度滚动) JavaScript代码: var myTable; var ganttSheet; var adjustTierUnit = true; window.onload = function() { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initDataSource(spread) { var tableName = "Gantt_Id"; var baseApiUrl = getBaseApiUrl(); var apiUrl = baseApiUrl + "/" + tableName; var dataManager = spread.dataManager(); myTable = dataManager.addTable("myTable", { batch: true, remote: { read: { url: apiUrl } }, schema: { hierarchy: { type: "Parent", column: "parentId" }, columns: { id: { isPrimaryKey: true }, taskNumber: { dataType: "rowOrder" } } } }); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120 } ]); view.fetch().then(function() { ganttSheet.bindGanttView(view); }).then(function() { ganttSheet.project.timescale.zoomOut(); }); initSidePanel(ganttSheet); } 2.任务栏和网格线的样式调整 (通过甘特图插件实现的任务栏和网格线的样式) JavaScript代码: /*REPLACE_MARKER*/ /*DO NOT DELETE THESE COMMENTS*/ var myTable; var ganttSheet; window.onload = function() { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initDataSource(spread) { var tableName = "Gantt_Id"; var baseApiUrl = getBaseApiUrl(); var apiUrl = baseApiUrl + "/" + tableName; var dataManager = spread.dataManager(); myTable = dataManager.addTable("myTable", { batch: true, remote: { read: { url: apiUrl } }, schema: { hierarchy: { type: "Parent", column: "parentId" }, columns: { id: { isPrimaryKey: true }, taskNumber: { dataType: "rowOrder" } } } }); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120, visible: false } ]); view.fetch().then(function() { ganttSheet.bindGanttView(view); ganttSheet.project.timescale.tierMode = GC.Spread.Sheets.GanttSheet.TimescaleTierMode.topMiddleBottom; ganttSheet.project.timescale.topTier.unit = GC.Spread.Sheets.GanttSheet.TimescaleUnit.thirdsOfMonth; }).then(function() { ganttSheet.gridlines.bottomTierColumn = { lineType: GC.Spread.Sheets.GanttSheet.GanttGridlineType.dashed, lineColor: "#c85b11" }; ganttSheet.gridlines.ganttRows.lineType = GC.Spread.Sheets.GanttSheet.GanttGridlineType.thin; ganttSheet.gridlines.ganttRows.lineColor = "#abd08f"; ganttSheet.gridlines.ganttRows.interval = 2; ganttSheet.gridlines.ganttRows.intervalLineType = GC.Spread.Sheets.GanttSheet.GanttGridlineType.dashDot; ganttSheet.gridlines.ganttRows.intervalLineColor = "#9cc3e5"; }); initSidePanel(ganttSheet); } function initSidePanel(ganttSheet) { var setButton = document.getElementById("set-gridline"); var intervalPanel = document.getElementById("interval-panel"); var affectItemOption = document.getElementById("affectItem"); var lineTypeOption = document.getElementById("lineType"); var lineColorOption = document.getElementById("lineColor"); var intervalLineTypeOption = document.getElementById("intervalLineType"); var intervalLineColorOption = document.getElementById("intervalLineColor"); var intervalOption = document.getElementById("interval"); var option = convertToNormalOptions(ganttSheet, "ganttRows"); syncOptionToPanel(option); affectItemOption.addEventListener('change', function(e) { var target = affectItemOption.value; if (affectItemOption.value === "ganttRows") { intervalPanel.classList.remove("hide"); } else { intervalPanel.classList.add("hide"); } var option = convertToNormalOptions(ganttSheet, target); syncOptionToPanel(option); }); setButton.addEventListener('click', function() { var target = affectItemOption.value; var lineType = Number(lineTypeOption.value); var lineColor = lineColorOption.value; var intervalLineType = Number(intervalLineTypeOption.value); var intervalLineColor = intervalLineColorOption.value; var interval = Number(intervalOption.value); var option = convertToGanttGridlineOptions(lineType, lineColor, intervalLineType, intervalLineColor, interval); if (option) { ganttSheet.gridlines[target] = option; } }); 3.数据展示布局调整 (通过甘特图插件实现布局的调整) JavaScript代码: /*REPLACE_MARKER*/ /*DO NOT DELETE THESE COMMENTS*/ var myTable; var ganttSheet; var roundBarsToWholeDays = true; window.onload = function() { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initDataSource(spread) { var tableName = "Gantt_Id"; var baseApiUrl = getBaseApiUrl(); var apiUrl = baseApiUrl + "/" + tableName; var dataManager = spread.dataManager(); myTable = dataManager.addTable("myTable", { batch: true, remote: { read: { url: apiUrl } }, schema: { hierarchy: { type: "Parent", column: "parentId" }, columns: { id: { isPrimaryKey: true }, taskNumber: { dataType: "rowOrder" } } } }); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120, visible: false } ]); view.fetch().then(function() { ganttSheet.bindGanttView(view); ganttSheet.suspendPaint(); var summaryStyleRule = ganttSheet.project.taskStyleRules.getRule("summary"); var summaryStyle = summaryStyleRule.style.taskbarStyle; summaryStyle.leftText = "start"; summaryStyle.rightText = "finish"; summaryStyleRule.style.taskbarStyle = summaryStyle; var layout = ganttSheet.project.layout; layout.linkLineMode = "noLinks"; layout.barHeight = 18; ganttSheet.resumePaint(); }); initSidePanel(ganttSheet); } function initSidePanel(ganttSheet) { var roundBarItem = document.getElementById("round-bar"); var linkTypeItem = document.getElementById("link-type"); var barHeightItem = document.getElementById("bar-height"); var dateFormatItem = document.getElementById("date-format"); var setLayoutItem = document.getElementById("set-layout"); roundBarItem.addEventListener("click", function() { if (roundBarItem.classList.contains("active")) { roundBarItem.classList.remove("active"); roundBarsToWholeDays = false; } else { roundBarItem.classList.add("active"); roundBarsToWholeDays = true; } }); setLayoutItem.addEventListener("click", function() { var layout = ganttSheet.project.layout; ganttSheet.suspendPaint(); layout.linkLineMode = linkTypeItem.value; layout.barHeight = Number(barHeightItem.value); layout.barTextDateFormat = dateFormatItem.value; layout.roundBarsToWholeDays = roundBarsToWholeDays; ganttSheet.resumePaint(); }); } 4.任务操作 (可在甘特图插件实现任务操作) JavaScript代码: /*REPLACE_MARKER*/ /*DO NOT DELETE THESE COMMENTS*/ var myTable; var ganttSheet; var roundBarsToWholeDays = true; window.onload = function () { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initDataSource(spread) { var tableName = "Gantt_Id"; var baseApiUrl = getBaseApiUrl(); var apiUrl = baseApiUrl + "/" + tableName; var dataManager = spread.dataManager(); myTable = dataManager.addTable("myTable", { batch: true, remote: { read: { url: apiUrl }, batch: { url: apiUrl + "Collection" } }, schema: { hierarchy: { type: "Parent", column: "parentId" }, columns: { id: { isPrimaryKey: true }, taskNumber: { dataType: "rowOrder" } } } }); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "id", caption: "Id", width: 40 }, { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120 } ]); view.fetch().then(function () { ganttSheet.bindGanttView(view); }); initSidePanel(ganttSheet); } function initSidePanel(ganttSheet) { var addTaskItem = document.getElementById("add-task"); var addSummayItem = document.getElementById("add-summary"); var addMilestoneItem = document.getElementById("add-milestone"); var deleteItem = document.getElementById("delete-task"); var indentTaskItem = document.getElementById("indent-task"); var outdentTaskItem = document.getElementById("outdent-task"); var linkTaskItem = document.getElementById("link-task"); var unlinkTaskItem = document.getElementById("unlink-task"); var submitItem = document.getElementById("submit-changes"); var cancelItem = document.getElementById("cancel-changes"); addTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() addTask(); ganttSheet.resumePaint(); }); addSummayItem.addEventListener("click", function () { ganttSheet.suspendPaint() addSummary(); ganttSheet.resumePaint(); }); addMilestoneItem.addEventListener("click", function () { ganttSheet.suspendPaint() addMilestone(); ganttSheet.resumePaint(); }); deleteItem.addEventListener("click", function () { ganttSheet.suspendPaint() deleteTask(); ganttSheet.resumePaint(); }); indentTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() indentTask(); ganttSheet.resumePaint(); }); outdentTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() outdentTask(); ganttSheet.resumePaint(); }); linkTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() linkTask(); ganttSheet.resumePaint(); }); unlinkTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() unlinkTask(); ganttSheet.resumePaint(); }); submitItem.addEventListener("click", function () { ganttSheet.submitChanges(); }); cancelItem.addEventListener("click", function () { ganttSheet.cancelChanges(); }); function addTask() { var project = ganttSheet.project; var selections = ganttSheet.getSelections(); var insertedRow = Math.min(...selections.map(r => r.row), project.tasks.length) var rowCount = selections.map(r => r.rowCount).reduce((pre, current) => { return pre + current }); var taskData = createTaskDataList(rowCount, () => ({ name: "<新任务>" })); project.insertTasksByRow(insertedRow, taskData); } function addSummary() { var project = ganttSheet.project; var selectedRange = ganttSheet.getSelections()[0]; var insertedRow = selectedRange.row; var insertedTaskNumbers = ganttSheet.getTaskByRow(insertedRow).taskNumber || project.count; var selectedTasks = getSelectedRowIndexes().map((row) => ganttSheet.getTaskByRow(row)).filter((row) => !!row); if (selectedTasks.length == 0) { project.insertTasks(insertedTaskNumbers, [{ name: "<新摘要任务>" }, { name: "<新任务>" }]); project.indentTasks(insertedTaskNumbers + 1); } else { project.insertTasks(insertedTaskNumbers, { name: "<新摘要任务>" }, selectedTasks[0].level); project.indentTasks(selectedTasks.map((t) => t.taskNumber)); } ganttSheet.setSelection(insertedRow, -1, 1, -1); } function addMilestone() { var project = ganttSheet.project; var selections = ganttSheet.getSelections(); var rowCount = selections.map(r => r.rowCount).reduce((pre, current) => { return pre + current }); var insertedRow = Math.min(...selections.map(r => r.row), project.tasks.length); var taskData = createTaskDataList(rowCount, () => ({ name: "<新里程碑>", duration: 0 })); project.insertTasksByRow(insertedRow, taskData); ganttSheet.setSelection(insertedRow, -1, rowCount, -1); } function deleteTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.removeTasks(rowIds); } function indentTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.indentTasks(rowIds); } function outdentTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.outdentTasks(rowIds); } function linkTask() { var project = ganttSheet.project; var links = []; var selections = ganttSheet.getSelections(); var previous = -1; for (var range of selections) { if (previous != -1) { links.push([previous, range.row]); } for (var row = range.row + 1; row < range.row + range.rowCount; row++) { links.push([row - 1, row]); } previous = range.row + range.rowCount - 1; } if (links.length <= 0) { return; } project.suspendSchedule(); for (var link of links) { var [fromTaskNumber, toTaskNumber] = link; try { project.addDependency({ fromTaskNumber, toTaskNumber }); } catch { } } project.resumeSchedule(); } 5.日历 (可在甘特图插件内实现日历内容的调整) JavaScript代码: /*REPLACE_MARKER*/ /*DO NOT DELETE THESE COMMENTS*/ var myTable; var ganttSheet; var roundBarsToWholeDays = true; window.onload = function () { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "id", caption: "Id", width: 40 }, { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120 } ]); view.fetch().then(function () { ganttSheet.bindGanttView(view); }); initSidePanel(ganttSheet); } function initSidePanel(ganttSheet) { var addTaskItem = document.getElementById("add-task"); var addSummayItem = document.getElementById("add-summary"); var addMilestoneItem = document.getElementById("add-milestone"); var deleteItem = document.getElementById("delete-task"); var indentTaskItem = document.getElementById("indent-task"); var outdentTaskItem = document.getElementById("outdent-task"); var linkTaskItem = document.getElementById("link-task"); var unlinkTaskItem = document.getElementById("unlink-task"); var submitItem = document.getElementById("submit-changes"); var cancelItem = document.getElementById("cancel-changes"); addTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() addTask(); ganttSheet.resumePaint(); }); addSummayItem.addEventListener("click", function () { ganttSheet.suspendPaint() addSummary(); ganttSheet.resumePaint(); }); addMilestoneItem.addEventListener("click", function () { ganttSheet.suspendPaint() addMilestone(); ganttSheet.resumePaint(); }); deleteItem.addEventListener("click", function () { ganttSheet.suspendPaint() deleteTask(); ganttSheet.resumePaint(); }); indentTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() indentTask(); ganttSheet.resumePaint(); }); outdentTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() outdentTask(); ganttSheet.resumePaint(); }); linkTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() linkTask(); ganttSheet.resumePaint(); }); unlinkTaskItem.addEventListener("click", function () { ganttSheet.suspendPaint() unlinkTask(); ganttSheet.resumePaint(); }); submitItem.addEventListener("click", function () { ganttSheet.submitChanges(); }); cancelItem.addEventListener("click", function () { ganttSheet.cancelChanges(); }); function addTask() { var project = ganttSheet.project; var selections = ganttSheet.getSelections(); var insertedRow = Math.min(...selections.map(r => r.row), project.tasks.length) var rowCount = selections.map(r => r.rowCount).reduce((pre, current) => { return pre + current }); var taskData = createTaskDataList(rowCount, () => ({ name: "<新任务>" })); project.insertTasksByRow(insertedRow, taskData); } function addSummary() { var project = ganttSheet.project; var selectedRange = ganttSheet.getSelections()[0]; var insertedRow = selectedRange.row; var insertedTaskNumbers = ganttSheet.getTaskByRow(insertedRow).taskNumber || project.count; var selectedTasks = getSelectedRowIndexes().map((row) => ganttSheet.getTaskByRow(row)).filter((row) => !!row); if (selectedTasks.length == 0) { project.insertTasks(insertedTaskNumbers, [{ name: "<新摘要任务>" }, { name: "<新任务>" }]); project.indentTasks(insertedTaskNumbers + 1); } else { project.insertTasks(insertedTaskNumbers, { name: "<新摘要任务>" }, selectedTasks[0].level); project.indentTasks(selectedTasks.map((t) => t.taskNumber)); } ganttSheet.setSelection(insertedRow, -1, 1, -1); } function addMilestone() { var project = ganttSheet.project; var selections = ganttSheet.getSelections(); var rowCount = selections.map(r => r.rowCount).reduce((pre, current) => { return pre + current }); var insertedRow = Math.min(...selections.map(r => r.row), project.tasks.length); var taskData = createTaskDataList(rowCount, () => ({ name: "<新里程碑>", duration: 0 })); project.insertTasksByRow(insertedRow, taskData); ganttSheet.setSelection(insertedRow, -1, rowCount, -1); } function deleteTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.removeTasks(rowIds); } function indentTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.indentTasks(rowIds); } function outdentTask() { var project = ganttSheet.project; var rowIds = getSelectedTaskNumbers(); project.outdentTasks(rowIds); } function linkTask() { var project = ganttSheet.project; var links = []; var selections = ganttSheet.getSelections(); var previous = -1; for (var range of selections) { if (previous != -1) { links.push([previous, range.row]); } for (var row = range.row + 1; row < range.row + range.rowCount; row++) { links.push([row - 1, row]); } previous = range.row + range.rowCount - 1; } if (links.length <= 0) { return; } project.suspendSchedule(); for (var link of links) { var [fromTaskNumber, toTaskNumber] = link; try { project.addDependency({ fromTaskNumber, toTaskNumber }); } catch { } } project.resumeSchedule(); } function unlinkTask() { var project = ganttSheet.project; var taskNumbers = getSelectedTaskNumbers(); var dependencies = []; if (taskNumbers.length == 1) { var task = project.getTaskByRow(taskNumbers[0]); dependencies = [...task.predecessorDependencies, ...task.successorDependencies]; } else { var taskNumberSet = {}; for (var taskNumber of taskNumbers) { taskNumberSet[taskNumber] = true; } dependencies = project.dependencies.filter(dp => taskNumberSet[dp.from.taskNumber] && taskNumberSet[dp.to.taskNumber]); } if (dependencies.length >= 1) { project.removeDependency(dependencies); } } function getSelectedRowIndexes() { var rows = []; var selections = ganttSheet.getSelections(); for (var range of selections) { for (var row = range.row; row < range.row + range.rowCount; row++) { rows.push(row); } } return rows; } 6.导入和导出操作 甘特图插件中展示的内容导出至PDF及Excel的格式。 (支持导入导出能力) JavaScript代码: /*REPLACE_MARKER*/ /*DO NOT DELETE THESE COMMENTS*/ var myTable; var ganttSheet; var roundBarsToWholeDays = true; window.onload = function() { var spread = new GC.Spread.Sheets.Workbook(document.getElementById("ss"), { sheetCount: 0 }); initSpread(spread); initSplitView(spread); }; function initSpread(spread) { spread.suspendPaint(); initDataSource(spread); initGanttSheet(spread); spread.resumePaint(); } function initDataSource(spread) { var tableName = "Gantt_Id"; var baseApiUrl = getBaseApiUrl(); var apiUrl = baseApiUrl + "/" + tableName; var dataManager = spread.dataManager(); myTable = dataManager.addTable("myTable", { batch: true, remote: { read: { url: apiUrl } }, schema: { hierarchy: { type: "Parent", column: "parentId" }, columns: { id: { isPrimaryKey: true }, taskNumber: { dataType: "rowOrder" } } } }); } function initGanttSheet(spread) { ganttSheet = spread.addSheetTab(0, "GanttSheet", GC.Spread.Sheets.SheetType.ganttSheet); var view = myTable.addView("ganttView", [ { value: "taskNumber", caption: "NO.", width: 60 }, { value: "name", caption: "Task Name", width: 200 }, { value: "duration", caption: "Duration", width: 90 }, { value: "predecessors", caption: "Predecessors", width: 120, visible: false } ]); view.fetch().then(function() { ganttSheet.bindGanttView(view); }); initSidePanel(spread, ganttSheet); } function initSidePanel(spread, ganttSheet) { var excelIo = new GC.Spread.Excel.IO(); var fileInput = document.getElementById("file-input"); var openFileItem = document.getElementById("open-file"); var fileNameItem = document.getElementById("file-name"); var exportJSONItem = document.getElementById("export-to-json"); var exportSJSItem = document.getElementById("export-to-sjs"); var exportExcelItem = document.getElementById("export-to-excel"); var printItem = document.getElementById("print"); var pdfItem = document.getElementById("pdf"); var exportFileName = "export"; openFileItem.addEventListener('click', function() { fileInput.click(); }); fileInput.addEventListener('change', function(e) { fileNameItem.value = 'Loading file...'; var file = fileInput.files[0]; if (!file) { alert("Upload a file first."); return; } var fileName = file.name; var suffix = fileName.substr(fileName.lastIndexOf('.')); if (suffix === '.xlsx' || suffix === '.xlsm') { // here is excel IO API excelIo.open(file, function(json) { spread.fromJSON(json); fileNameItem.value = fileName; fileInput.value = ''; }, function(e) { // process error console.log(e); }); } else if (suffix === '.ssjson' || suffix === '.json') { var reader = new FileReader(); reader.onload = function() { var spreadJson = JSON.parse(this.result); spread.fromJSON(spreadJson); fileNameItem.value = fileName; fileInput.value = ''; }; reader.readAsText(file); } else if (suffix === '.sjs') { spread.open(file, () => { fileNameItem.value = fileName; fileInput.value = ''; }, (e) => { console.log(e); }, { openMode: GC.Spread.Sheets.OpenMode.normal, fullRecalc: true, }); } }); exportJSONItem.addEventListener('click', function () { var fileName = exportFileName + ".ssjson"; var json = spread.toJSON(); saveAs(new Blob([JSON.stringify(json)], { type: "text/plain;charset=utf-8" }), fileName); }); exportSJSItem.addEventListener('click', function () { var fileName = exportFileName + ".sjs"; spread.save(function (blob) { saveAs(blob, fileName); }, function (e) { // process error console.log(e); }, { fileType: GC.Spread.Sheets.FileType.ssjson, includeBindingSource: true, saveAsView: true }); }); exportExcelItem.addEventListener('click', function () { var fileName = exportFileName + ".xlsx"; var json = spread.toJSON({ includeBindingSource: true, saveAsView: true }); // here is excel IO API excelIo.save(json, function(blob) { saveAs(blob, fileName); }, function(e) { // process error console.log(e); }, { xlsxStrictMode: false }); }); printItem.addEventListener('click', function() { spread.print(); }); pdfItem.addEventListener('click', function() { spread.savePDF(function (blob) { var url = URL.createObjectURL(blob); pwin = window.open(url); }); }); } 总结 甘特图是一种强大的项目管理工具,通过直观的时间轴展示任务的安排和进度。它能帮助项目经理们创建详细的项目计划,有效跟踪进度,并合理分配资源。甘特图还可以管理任务间的依赖关系,及时调整时间表,并识别风险与关键路径。它在项目管理中扮演着重要的角色,提高了团队的协作效率和项目的成功率。通过使用甘特图,项目团队能够更好地掌握项目进展,作出决策,并确保项目按时交付。 如果您对该插件感兴趣,可以访问葡萄城官网下载SpreadJS产品。

优秀的个人博客,低调大师

WEB安全新玩法 [4] 防护邮箱密码重置漏洞

大部分具有账号系统的应用都会提供重置用户登录密码的功能,常见方式之一是:用户输入自己的邮箱地址或手机号,应用向这个邮箱或手机号发送验证码,用户将收到的验证码输入应用中即可完成密码重置。这一过程容易因设计不周全而被恶意利用。**iFlow 业务安全加固平台**可以为设计不当的应用打上动态虚拟补丁,使之防御可能的恶意利用。 ----- 以某网站为例,其邮箱密码重置功能就存在缺陷:获取验证码的邮箱和重置密码的邮箱可以不一致。恶意操作能够给任意邮箱所代表的用户设置新的登录密码,从而冒充受害者登录。当然,我们也会介绍如何在不修改网站源代码的前提下,使用 **iFlow** 实现业务逻辑缺陷的修补。 # 一、原始网站 ## 1.1 正常用户访问 在密码重置页面,正常用户「alice」在**手机/邮箱**中输入自己的邮箱地址,如 *alice@mail.com*,点击**获取验证码**按钮。 ![图1](https://img-blog.csdnimg.cn/2020091615281469.png#pic_center) 网站为避免邮件发送功能被滥用,弹出图形码进行验证。用户正确填写字符并**确认**后,网站系统后台发送邮件验证码到用户「alice」的邮件地址 *alice@mail.com* 中。 ![图2](https://img-blog.csdnimg.cn/20200916154337178.png#pic_center) 用户进入到邮件系统中收取寄给 *alice@mail.com* 的邮件,将邮件中的**验证码**和需要重置的**登录密码**填写到表单中并提交。 ![图3](https://img-blog.csdnimg.cn/20200916154554640.png#pic_center) 网站判断用户输入的邮箱验证码是正确的,就将 *alice@mail.com* 所代表的用户的登录密码设置为新的密码,操作成功。 各个实体的交互流程如下: ![chart1.png](https://s2.51cto.com/images/20210628/1624868875738925.png) ## 1.2 恶意访问 此处,网站在重置密码的业务处理上有个逻辑缺陷:并未确保发送邮箱验证码时的邮箱地址和设置新密码时的邮箱地址是一致的。 缺陷利用方法如下:在前面的步骤中,恶意访问者「mallory」使用自己的邮箱 *mallory@mail.com* 获取验证码。 ![图4](https://img-blog.csdnimg.cn/2020091615515810.png#pic_center) 在收到邮箱验证码并正确填写后,「mallory」将表单中的**手机/邮箱**内容改为 *alice@mail.com* (之前填的是 *mallory@mail.com* ),然后再填写新的登录密码并提交确认。 ![图5](https://img-blog.csdnimg.cn/20200916155238567.png#pic_center) 网站判断用户输入的邮箱验证码是正确的,就将 *alice@mail.com* 所代表的用户的登录密码设置为新的密码。如此一来,「mallory」成功重设了受害者「alice」的密码,并可以使用「alice」的身份登录网站。 各个实体的交互流程如下: ![chart2.png](https://s2.51cto.com/images/20210628/1624869324214753.png) # 二、iFlow虚拟补丁后的网站 我们在 Web 服务器前部署 **iFlow 业务安全加固平台**,它有能力拦截、计算和修改双向 HTTP 报文并具备存储能力,成为 Web 应用的虚拟补丁。在本例中,iFlow 可保存发送验证码时的邮箱地址,并在之后设置密码时将其与输入的邮箱地址作对比,发现并制止篡改行为。 ## 2.1 正常用户访问 iFlow 在图形验证码通过时,将请求中的邮箱地址保存在 IP 存储中,在设置新密码时进行以下检查: 1) 该 IP 进行过发送验证码的操作; 2) 该 IP 要设置密码的邮箱地址与发送验证码时的邮箱相同。 各个实体的交互流程如下: ![chart3.png](https://s2.51cto.com/images/20210628/1624869350745877.png) ## 2.2 恶意访问 如前所示,在收到邮箱验证码后,且未提交重设密码之前,「mallory」修改了邮箱地址。iFlow 会检查到这个变化,依此可判断这是一个恶意访问,于是终止此过程,不会让系统后端真正去修改受害者的登录密码。 恶意操作的 HTTP 协议交互过程如下: ![chart4.png](https://s2.51cto.com/images/20210628/1624869439964709.png) ## 2.3 代码 **iFlow 内置的 W2 语言是一种专门用于实现 Web 应用安全加固的类编程语言**。它介于配置和通用语言之间,具备编程的基本要素和针对 HTTP 协议的特有扩展,能为业务系统编写涉及复杂判断和动态修改的逻辑。 考虑到安全产品的使用者通常为非程序员,他们习惯面对配置文件而非一段代码。因此,W2 语言虽包含语言要素,仍以规则文件方式呈现,并采用可以体现层次结构和方便词法校验的 JSON 格式。 用 W2 语言实现上述虚拟补丁的代码如下: ```json [ { "if": [ "streq(REQUEST_FILENAME, '/shopx/index.php')", "streq(@ARGS.s, '/index/user/forgetpwdverifysend.html')" ], "then": { "if": "REAL_IP.the_mail", "then": { "verdict": { "action": "deny", "log": "There is a user having reset password." } }, "else": { "if": "contain(RESPONSE_BODY, '\"code\":0,')", "then": { "execution": "REAL_IP.the_mail@120=@ARGS.accounts" } } } }, { "if": [ "streq(REQUEST_FILENAME, '/shopx/index.php')", "streq(@ARGS.s, '/index/user/forgetpwd.html')" ], "then": { "if": { "or": [ "!REAL_IP.the_mail", "strne(@ARGS.accounts, REAL_IP.the_mail)" ] }, "then": { "verdict": { "action": "deny", "log": "Invalid ${@ARGS.accounts} access" } }, "else": { "execution": "REAL_IP.the_mail=null" } } } ] ``` 示例代码中有两条规则,分别作用如下: **第一条规则** 当服务器返回图形验证结果时,iFlow 拦截此响应。如果在同一个访问端 IP 上已经在进行重置密码操作,则终止这次操作 (避免重复及交叉操作);否则当验证结果为通过时,在访问者 IP (REAL_IP) 中创建存储变量 `the_mail` ,其值为用户输入邮箱地址。 **第二条规则** 当浏览器请求确认重置密码时,iFlow 拦截此请求。iFlow检查请求参数 `accounts` 与访问者 IP (REAL_IP) 中存储变量 `the_mail` 是否相等:如果相等则清除 `the_mail` ,以开放此访问者 IP 上的重置密码业务;如果不相等则阻止该用户的继续操作。 >**注意**:上述会话中的 `the_mail` 是保存在服务器端的 **iFlow** 存储中的,***者在浏览器端是看不到数据更无法进行修改的。 # 三、总结 iFlow 使用两条规则在不修改服务器端代码的前提下,透明地保证了重置密码时邮箱地址的一致性。从这个例子中我们可以看到,iFlow 适合构造前后报文相关联的复杂防护逻辑。(张戈 | 天存信息)

优秀的个人博客,低调大师

进阶玩法:针对ECS新购选型场景查询可用资源

接口名称(查询某一可用区的资源列表) DescribeAvailableResource 背景: 选购云服务ECS时,在指定条件下有哪些资源是可用的?如何更好的选择所需的资源?针对用户的ECS购买选型,介绍如何利用DescribeAvailableResource接口查询可用资源 针对选型场景做相应的查询 场景1. 用户在杭州地域下,包年包月(包含按周)ecs实例可以售卖实例规格列表场景2. 用户在杭州地域下,按量ecs实例可以售卖实例规格列表场景3. 用户在杭州地域下,Spot实例可以售卖实例规格列表场景4. 用户选购包年包月ecs.gn4.8xlarge规格的实例,在杭州地域下那个可用区可售卖场景5. 用户在杭州可用区E下,带vpc网络包年包月实例可以售卖实例规格列表 除了您现在看到的这文章,您还可以前往: DescribeAvailabl

优秀的个人博客,低调大师

让 Chrome 浏览器崩溃的新玩法来啦!

首先,你要有一部 Android 手机,其次你要安装一个Chrome。 接下来,你只要在 Chrome 地址栏输入“chrome://editbookmark”,就会发现调皮的Chrom已经自动罢工啦。 这个bug是由推特用户@oldfresher首先发现的。早在九月,雷锋网就报道了让Chrome浏览器崩溃的招数:胆小勿点!这16个字符可以导致Chrome崩溃。今天这个,可以算是玩坏Chrome的新方法。 不过,根据雷锋网(公众号:雷锋网)亲测,谷歌似乎已经火速修复了这个bug。但是无聊的小伙伴不要灰心,目前还可以通过作者提供的链接来间接触发崩溃动作,在谷歌注意到这个问题之前,还可以有时间调戏 Chrome 一下。时间有限,好奇的小伙伴快来试试吧~ 本文作者: 史中 本文转自雷锋网禁止二次转载, 原文链接

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册