首页 文章 精选 留言 我的

精选列表

搜索[分布式数据库],共1586篇文章
优秀的个人博客,低调大师

Databus 分布式数据库同步系统

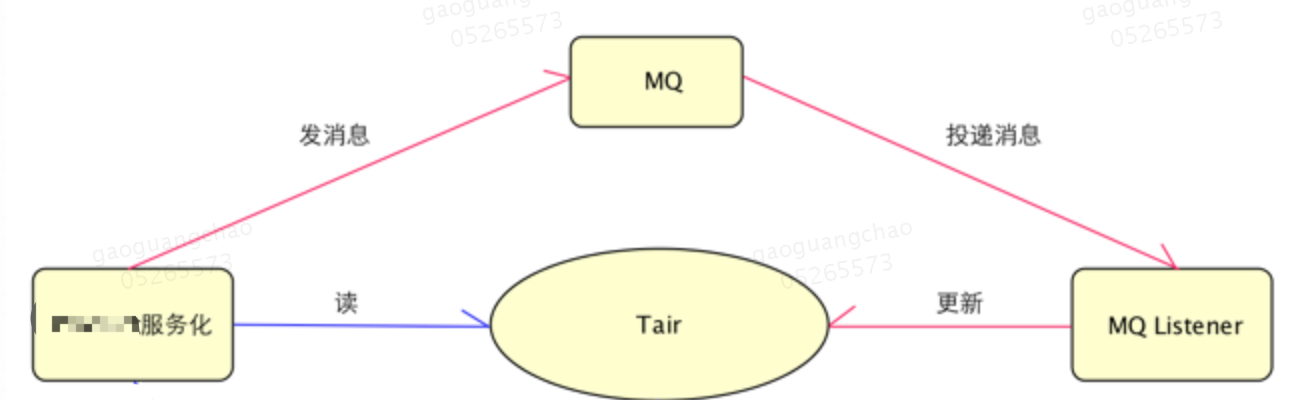
社区wiki主页:https://github.com/linkedin/Databus/wiki 背景 一个大型分布式系统往往存在多种的存储系统,mysql,tair,redis,memcache,hbase等等。一些重要的或者需要事务支持的数据操作,通常都会放到mysql处理。但是,为了满足高性能的访问需求或者做一些服务定制化的查询,业务上通常又会把mysql的数据再写到tair或者redis等外部存储中一份。 以业务将tair作为mysql的高速缓存为例,通常业务在代码中会有这么一段逻辑,读取tair,数据不存在,从mysql读取数据,然后写入tair。用户变更mysql,然后会同时刷新tair,或者将tair数据删除。为了降低客户端复杂度并且防止缓存穿透,常会引入MQ进行异步同步,如下图所示: image.png 但是无论客户端同步方式还是MQ方式,其实都会存在数据一致性问题,这些场景,如果没有一个强一致协议(比如两阶段提交,paxos等)是很难解决掉的。 现在,有了Databus,上面提到的这些一致性问题就都没有了,并且,那些冗长的双写逻辑也可以去掉了。 功能介绍 Databus是一个实时的、可靠的、支持事务的、保持一致性的数据变更抓取系统。 2011年在LinkedIn正式进入生产系统,2013年开源。 Databus通过挖掘数据库日志的方式,将数据库变更实时、可靠的从数据库拉取出来,业务可以通过定制化client实时获取变更。 Databus的传输层端到端延迟是微秒级的,每台服务器每秒可以处理数千次数据吞吐变更事件,同时还支持无限回溯能力和丰富的变更订阅功能。 功能&特性 来源独立:Databus支持多种数据来源的变更抓取,包括Oracle和MySQL。 可扩展、高度可用:Databus能扩展到支持数千消费者和事务数据来源,同时保持高度可用性。 事务按序提交:Databus能保持来源数据库中的事务完整性,并按照事务分组和来源的提交顺寻交付变更事件。 低延迟、支持多种订阅机制:数据源变更完成后,Databus能在微秒级内将事务提交给消费者。同时,消费者使用Databus中的服务器端过滤功能,可以只获取自己需要的特定数据。 无限回溯:这是Databus最具创新性的组件之一,对消费者支持无限回溯能力。当消费者需要产生数据的完整拷贝时(比如新的搜索索引),它不会对数据库产生任何额外负担,就可以达成目的。当消费者的数据大大落后于来源数据库时,也可以使用该功能。 设计 架构设计 Databus概要结构: image.png 图中显示:Search Index和Read Replicas等系统是Databus的消费者。当主数据库发生写操作时,连接其上的中继系统会将数据拉到中继中。签入在Search Index或是缓存中的Databus消费者客户端,就会从中继中拉出数据,并更新索引或缓存。 系统结构设计 image.png 上图中介绍了Databus系统的构成,包括中继Relay、bootstrap服务和客户端库。Bootstrap服务中包括Bootstrap Producer和Bootstrap Server。快速变化的消费者直接从Relay中取事件。如果一个消费者的数据更新大幅落后,它要的数据就不在Relay的日志中,而是在 Bootstrap Producer里面,提交给它的,将会是自消费者上次处理变更之后的所有数据变更快照。 Databus Relay中继的功能主要包括: 从Databus来源读取变更行,并在内存缓存内将其序列化为Databus变更事件 监听来自Databus客户端(包括Bootstrap Producer)的请求,并传输新的Databus数据变更事件 Databus客户端的功能主要包括: 检查Relay上新的数据变更事件,并执行特定业务逻辑的回调 如果落后Relay太多,向Bootstrap Server发起查询 新Databus客户端会向Bootstrap Server发起bootstrap启动查询,然后切换到向中继发起查询,以完成最新的数据变更事件 单一客户端可以处理整个Databus数据流,或者可以成为消费者集群的一部分,其中每个消费者只处理一部分流数据 Databus Bootstrap Producer的功能有: 检查中继上的新数据变更事件 将变更存储在MySQL数据库中 MySQL数据库供Bootstrap和客户端使用 Databus Bootstrap Server的主要功能,监听来自Databus客户端的请求,并返回长期回溯数据变更事件。 业务应用 Databus在linkedin 在LinkedIn,Databus支持的系统有: 社会化图谱索引(Social Graph Index),服务LinkedIn所有图谱查询 人员搜索索引(People Search Index),支持搜索所有LinkedIn用户 用户档案数据(Member Profile)多个冗余的读取查询 欢迎关注 高广超的简书博客 与 收藏文章 !欢迎关注 头条号:互联网技术栈 ! 个人介绍: 高广超:多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能、可扩展的互联网架构。 本文首发在 高广超的简书博客 转载请注明!

优秀的个人博客,低调大师

Hadoop组件--分布式数据库HBase

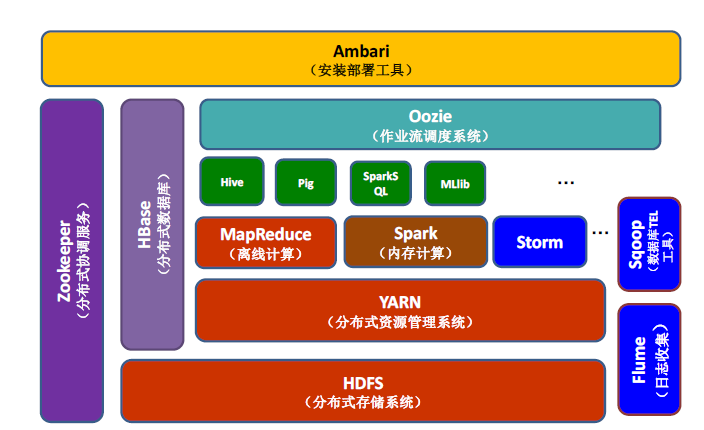
1. HBase概述 先来看下HBase在Hadoop生态中的位置 HBase是Apache Hadoop⽣态系统中的重要⼀员,主要⽤于海量结构化数据存储。 HBase是一个构建在HDFS上的分布式列存储系统(严格的来说应该是列族存储),数据保存在HDFS上。 HBase与MapReduce良好的集成,使用MapReduce来处理数据。 HBase利用Zookeeper做分布式协同。 从逻辑上讲,HBase将数据按照表、⾏和列进⾏存储,它是⼀个分布式的、稀疏的、持久化存储的多维度排序表。 相对于Hive来说,HBase适合实时数据访问,Hive则适合批处理数据分析。 HBase的应用场景很多,百度的页面库,淘宝的商品库,小米的云存储服务等。 2. HBase数据模型 (Table, RowKey, Family, Qualifier, TimeStamp) -->Value 在HBase中,一行数据由行健RowKey作为键,包含多个列族(Famliy),列族由可同时访问的多个列组成(Qualifier), 时间戳作为索引(TimeStamp)。 表 --可以是稀疏的,空值在HBase中不会被存储。 Row Key --行健,数据在表中的唯一标实 --所有的操作都是基于主键的。 --数据安照行健来排序。 特点 --大:⼀个表可以有数⼗亿⾏,上百万列 --⾯向列:⾯向列(族)的存储,列(族)独⽴检索 --稀疏:对于空(null)的列,并不占⽤存储空间,表可以设计的非常稀疏 --数据多版本:每个单元中的数据可以有多个版本(时间戳不同) --数据类型单⼀:HBase中的数据都是字节,没有类型 3. 物理模型 --以列族为单位存储 --每个cell中会存储以下信息 • Row key • Column family name • Column name • Timestamp • Value 数据表中所有行,安照Row Key字典序排列,Table在行的方向上分为多个region, Region按⼤⼩分割的,每个表开始只有⼀个Region,随着数据增多,Region不断增⼤,当增⼤到⼀个阀值的时候, Region就会等分会两新的Region,之后会有越来越多的Region。Region是HBase中分布式存储和负载均衡的最⼩单元, 不同Region分布到不同RegionServer上。 Region虽然是分布式存储的最⼩单元,但并不是存储的最⼩单元。 --Region由⼀个或者多个Store组成,每个Store保存⼀个columnsfamily --每个Strore又由⼀个MemStore和0至多个StoreFile组成 --MemStore存储在内存中,StoreFile存储在HDFS上 4. HBase架构 HRegion --HBase 会⾃动地将表划分为不同的区域 -- 每个区域包含所有⾏的⼀个⼦集 --对⽤户来说,每个表是⼀堆数据的集合,靠主键来区分 --从物理上来说,⼀张表被拆分成了多块,每⼀块是⼀个HRegion -- 我们⽤表名+ 开始和结束主键,来区分每⼀个HRegion -- ⼀个HRegion 会保存⼀个表⾥⾯某段连续的数据,从开始主键到结束主键 --⼀张完整的表格是保存在多个HRegion上⾯ HRegionServer --所有的数据库数据都保存在HDFS上⾯ -- ⽤户通过访问HRegionServer获取这些数据 --⼀台机器上⾯⼀般只运⾏⼀个HRegionServer -- ⼀个HRegionServer上⾯有多个HRegion,⼀个HRegion 也只会被⼀个HRegionServer维护 --HRegionServer主要负责响应⽤户I/O请求,从HDFS读写数据,是HBase中最核⼼的模块 -- HRegionServer内部管理了⼀系列HRegion对象 -- 每个HRegion对应了Table中的⼀个Region,HRegion中由多个HStore组成 -- 每个HStore 对应了Table中的⼀个Column Family的存储 -- 最好将具备共同IO特性的Column放在⼀个Column Family中 HMaster --每个HRegionServer都会与HMaster通信 -- HMaster的主要任务就是给HRegionServer分配HRegion -- HMaster指定HRegionServer 要维护哪些HRegion -- 当⼀台HRegionServer宕机时,HMaster会把它负责的HRegion标记为未分配,然后再把它们分配到其他HRegionServer 中 5. HBase Shell 启动HBase shell $./bin/hbase shell 建表:表名scores,有两个列族:‘grade’和‘course’ >create 'scores' ,'grade','course' 查看HBase中的表 >list 查看表结构 >describe 'scores' put: 写⼊数据,格式如下: >put 't1', 'r1', 'c1', 'value', ts1 t1指表名,r1指⾏键(key),c1指列名,value指值,ts1指数据戳, ⼀般都省略不设置。 向scores表中插⼊数据 > put 'scores', 'Tom', 'grade', 6 > put 'scores', 'Tom', 'course:math', 89 > put 'scores', 'Tom', 'course:art', 63 > put 'scores', 'Jim', 'grade', 7 > put 'scores', 'Jim', 'course:math', 75 > put 'scores', 'Jim', 'course:science', 48 get随机查找数据 格式 >get 't1', 'r1' >get 't1', 'r1', 'c1' >get 't1', 'r1', 'c1', 'c2' >get 't1', 'r1', {COLUMN => 'c1', TIMESTAMP => ts1} >get 't1', 'r1', {COLUMN => 'c1', TIMERANGE => [ts1, ts2], VERSIONS => 4} >get 'sources', 'Tom' >get 'sources', 'Tom', 'grade' >get 'sources', 'Tom', 'grede' , 'course' scan 范围查找数据,scan命令格式如下 >scan 't1' >scan 't1', {COLUMNS => 'c1:q1'} >scan 't1', {COLUMNS => ['c1', 'c2'], LIMIT => 10, STARTROW => 'xyz'} >scan 't1', {REVERSED => true} > scan 'scores' > scan 'scores',{COLUMNS =>'course:math'} > scan 'scores',{COLUMNS =>'course'} > scan 'scores',{COLUMNS =>'course', LIMIT => 1, STARTROW => 'Jim'} delete删除数据 delete命令格式如下 >delete 't1', 'r1', 'c1', ts1 > delete 'scores', 'Jim', 'course:math' Truncate删除全表数据 > truncate 'scores' alter修改表结构 为scores表增加⼀个family列族,名为profile > alter 'scores', NAME => 'profile' 删除profile列族 > alter 'scores', NAME => 'profile', METHOD => 'delete' 删除表 > drop 'scores' 上述所写如有不对之处,还请各位前辈指出赐教。--五维空间

优秀的个人博客,低调大师

分布式数据库HBase表设计

比较常用的数据库是关系型数据库,但很多场景下nosql数据库会更加擅长,从sql到nosql实施的第一步就是设计表结构,这是两种不同的思维方式,这里说下HBase表设计。 需求:需要一张stock表用于保存市场所有股票的分钟走向,即每个股票每分钟记录一次价格。 方案一:瘦表。 用stockId+datetime作为RowKey,这样方便通过stockId或datetime快速扫描获取到相关记录。 RowKey ColumnFamily “stock_cf” stockId+datetime stock_cf:price “00000120160615100000” 10.02 “00000120160615100001” 10.10 “00000120160615100002” 10.08 “00000220160615100000” 8.00 “00000220160615100001” 8.10 “00000220160615100002” 8.20 craete 'stock' , 'stock_cf' 优点:不受记录数限制,通过id查询时能很快跳过行,拥有很好的扩展性,高表也是推荐的用法。 缺点:不利于原子性,hbase只有行具备原子性。 方案二:宽表。 用stockId作为RowKey,datetime作为列,随着时间增长列会不断地增加,获取某个时间的记录将时间作为列。一个表的列族不要超过3个。 RowKey ColumnFamily “stock_cf” stockId “stock_cf:20160615100000” “stock_cf:20160615100001” “stock_cf:20160615100003” 000001 10.02 10.10 10.08 000002 8.00 8.10 8.20 craete 'stock' , 'stock_cf' 优点:更好的事务性。 缺点:宽表列数最多到百万级别,可扩展性较差。 后面有时间会写些hbase源码及其维护的相关的文章。 ========广告时间======== 鄙人的新书《Tomcat内核设计剖析》已经在京东销售了,有需要的朋友可以到 https://item.jd.com/12185360.html 进行预定。感谢各位朋友。 为什么写《Tomcat内核设计剖析》 ========================= 欢迎关注:

优秀的个人博客,低调大师

分布式数据库--ZMP数据迁移平台

在云计算、大数据和物联网时代,数字化转型悄然在各行各业中进行。然而数据作为最基础的要素,如何进行多源异构的海量数据交换?如何保证数据的时效性和准确性?如何让海量异构数据实现云上、云下的协同?是我们长此以往关注的焦点。而ZMP数据迁移平台正致力于云间数据交换场景,支持不同数据结构,可帮助政企客户快速搭建高性能、高安全、高可靠、高稳定的数据交换平台。 1.功能 ZMP数据迁移平台不仅有基础的系统、用户和主题管理,也有可视化运维的服务器管理及消息监控等,更主要的是集成了消息服务、数据转换同步等中间件,同时加入了迁移评估和应用的智能改造。 服务器管理:提供服务器、消息服务、同步组件的安装、启停、配置和监控等功能。 主题管理:提供消息服务主题的创建、删除、编辑和监控,在数据交换中,不需要用户创建和删除主题,由数据交换任务统一管理。 数据迁移评估:提供源库数据库(Oracle9i,Oracle11g,Oracle12c,SQLserver)的数据采集,画像及目的端数据库为云溪数据库或MySQL时的兼容性评估。 数据采集:针对多个Oracle版本和SQLServer,构建了数据采集工具。 源库画像:根据采集的数据,自动生成智能五边图(规模,会话,风险,负载,复杂度),数据库的概要信息与详细信息——包括数据库性能及运行时的性能,容量,Oracle特性,对象详情、全景搜索等。用户可以直观地把握以上信息,并在详情页查看具体的信息。同时,在不同对象的依赖关系里,还可以实现跳转,帮助理解数据库原有结构。 兼容评估:将源库所有对象与SQL语句进行解析,判断其与目标库(之间的兼容情况,并输出其统计结果。在评估详情中看到每一个对象的兼容情况及迁移风险等情况。 数据交换:提供作业、任务、数据源和同步表的创建、删除、编辑、监控和统计报表功能。 支持结构化数据交换:云溪数据库、Oracle、SQLserver、DB2、Sybase、MySQL、PostgreSQL、Greenplum、Redis、Cache、Kudu等。 支持非结构化数据交换:Linux/Windows文件、FTP、SFTP、OSS、HDFS各种样式,各种大小的数据交换。 支持半结构化数据交换:JSON、CSV等半结构化数据与数据库交换。 支持多协议数据采集:MQTT、COAP、MODBUS、XPH、DICOM、HTTP、RTSP、RTMP等。 智能改造:加载源代码(工程)文件夹,对其中文件进行嗅探,寻找其中的SQL语句,并进行统计、分析、改造,并对改造情况进行统计分析,并提供手动查看与改造等相关功能。 用户管理:提供用户的创建、删除、编辑、权限分配和审计等功能。 系统配置:提供控制台日志、系统告警等功能。 版本管理:提供同步组件安装包更新、同步组件升级等功能。 2. 优势 ZMP数据迁移平台在支持多种数据源的基础上,提供可视化拖拽方式进行流程编排。既大大降低了对源端的影响,又提高了同步效率。同时支持超大文件和各种网络数据传输。 同步效率高:每秒10万级记录以上同步量。 源端影响小:支持Oracle、SQLserver、MySQL、MariaBD和达梦日志增量同步,不需要依赖触发器、CDC、时间戳。 多字段时间戳:支持多时间戳、增量字段、支持时间戳及增量字段向前偏移。 DDL变更捕获:支持数据库级别和表字段级别 数据管理监控:采用可视化拖拽方式进行流程编排,可视化管理监控数据流向、数据统计、数据报表及相关警告。 支持结构化数据交换:云溪数据库、Oracle、SQLserver、DB2、Sybase、MySQL、PostgreSQL、Greenplum、Redis、Cache、Kudu等。 超大文件和网络数据传输:支持复杂环境下TB级别文件,支持中继路由、文件网闸、有限带宽等各种网络数据传输,支持断点续传。 国产化环境及中间件:支持mips、x86、arm等CPU架构和金蝶、中创等。 3. 架构 功能架构: 技术架构: 数据库交换架构: 文件交换架构: 4. 应用 各种类型数据、大数据平台和行业应用,通过ZMP数据迁移平台实现高效的数据交换。医疗通信等行业产生的结构化、非结构化、文件等数据,通过ZMP平台抽取、转换、加密传输和入库,最大化实现数据的价值。同时云上云下数据协同。 跨网络、跨防火墙、跨中继路由、跨网闸等方式部署平台可使用多种不同的应用场景。异构采集对数据源影响小,实现数据高效采集,可靠传输,支持海量消息存储;数据交换支持单节点每秒百万级消息处理,集群下支持每秒亿级消息吞吐量,消息容量可达PB级。

优秀的个人博客,低调大师

Apache HBase 2.3.0 发布,分布式数据库

Apache HBase 2.3.0 已发布,这是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用 HBase 技术可在廉价 PC Server 上搭建起大规模结构化存储集群。 HBase 2.3.0 是 HBase 2.x 系列中的第四个次要版本,旨在提升 HBase 的稳定性和可靠性。 值得关注的新功能包括: 对 JDK 11 的初步支持(要求 Hadoop 3.2.0+) Hadoop 版本增加到 2.10.0 和 3.1.2 ZooKeeper 版本增加到 3.5.7 围绕 HBCK2 的许多改进 HBase 客户端与 ZooKeeper 连接现在是可选的 基于 TinyLFU 的 BlockCache 持久性存储器上的 Bucket 缓存 改进 MTTR:将 WAL 拆分为 HFile 下载地址:https://hbase.apache.org/downloads.html 详情查看 发布公告。

优秀的个人博客,低调大师

Apache HBase 1.4.13 发布,分布式数据库

Apache HBase 1.4.13 发布了。HBase – Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用 HBase 技术可在廉价 PC Server 上搭建起大规模结构化存储集群。 这是一个维护版本,主要更新包括: Bug [HBASE-22096] -当 storeFile 是参考文件时,/storeFile.jsp 显示 CorruptHFileException [HBASE-22441] -cacheBlock 中的 BucketCache NullPointerException [HBASE-23205] -正确更新当前正在复制的 WAL 的位置 [HBASE-23337] -对于 Apache HBase 2.2.2,nexus 中缺少几个模块 [HBASE-23360] -[CLI] 修复了帮助命令 “set_quota”,以说明删除配额 [HBASE-23375] -将 HBASE-22441 移植到 branch-1 [HBASE-23585] -MetricsRegionServerWrapperImpl.getL1CacheHitCount 始终返回 200 [HBASE-23698] -将中央存储库切换到 Branch-1 上的 https [HBASE-23825] -增量原型转换失败 详情见更新说明: https://issues.apache.org/jira/secure/ReleaseNote.jspa?projectId=12310753&version=12346533

优秀的个人博客,低调大师

Apache HBase 1.4.12 发布,分布式数据库

Apache HBase 1.4.12发布了。HBase – Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用 HBase 技术可在廉价 PC Server 上搭建起大规模结构化存储集群。 这是一个维护版本,主要更新包括: HBASE-23227 - 将 jackson-databind 升级到 2.9.10.1 以避免最近的 CVE Bug [HBASE-18439] - o.a.h.h.chaos.actions.Action 的子类都使用相同的记录器 [HBASE-23149] - hbase shouldPerformMajorCompaction 逻辑不正确 [HBASE-23185] - cpu 使用率很高,因为 getTable()#put() 每次都会获取配置值 [HBASE-23261] - 分割时区域停留在过渡中 [HBASE-23273] - 表名称为 hbase:meta时,table.jsp 上的表头不正确 [HBASE-23287] - 由于 LogCleaner 未添加到 choreService 中,所以 WAL 尚未从 HDFS 中老化 改进 [HBASE-22701] - 更好地处理 DynamicClassLoader 的无效本地目录 [HBASE-23207] - 记录区域开放日志 [HBASE-23228] - 在预提交/每晚测试中允许 Branch-1 上的 jdk8 特定模块 [HBASE-23245] - 所有 MutableHistogram 实现都应删除 maxExpected 完整更新列表: https://s.apache.org/hbase-1.4.12-jira-release-notes

优秀的个人博客,低调大师

Apache HBase 1.4.11 发布,分布式数据库

Apache HBase 1.4.11 发布了。HBase – Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用 HBase 技术可在廉价 PC Server 上搭建起大规模结构化存储集群。 这是一个维护版本,主要更新包括: HBASE-22784 副本拓扑中的集群仅具有来自副本的传入写入从未清除 WAL。 HBASE-23101 批量加载文件的副本必须处理循环拓扑,包括对 Region 接口的二进制不兼容更改。 HBASE-23015 除非在 HBase REST 代理或 Apache Hadoop 需要时,否则停止在类路径中包含 Jackson 库。 HBASE-22728, HBASE-23174 更新 HBase REST 代理以使用 Jackson 2 进行序列化(CVE)。 HBASE-22627 运行不同的 WAL 和基本文件系统时,无法清理恢复的 WAL 目录。 HBASE-15666 用于测试客户端的新实用程序工件:hbase-shaded-testing-util。 HBASE-22874 为 Canary 定义一个公共接口并将现有实现移至 LimitedPrivate 详情查看: http://mail-archives.apache.org/mod_mbox/www-announce/201910.mbox/%3cCAN5cbe4ACYA0oaVCXG3VtT3HQm7oa_hesh+=Sk52+6LdAz2z5g@mail.gmail.com%3e https://s.apache.org/hbase-1.4.11-jira-release-notes

优秀的个人博客,低调大师

企业级分布式数据库 - GaussDB介绍

目录 什么是GaussDB 简介 应用场景 产品架构 产品优势 安全 责任共担 身份认证与访问控制 数据保护技术 审计与日志 监控安全风险 ​​​​​​​故障恢复 ​​​​​​​认证证书 GaussDB与其他服务的关系 约束与限制 计费模式 什么是GaussDB 简介 GaussDB是华为自主创新研发的分布式关系型数据库。该产品具备企业级复杂事务混合负载能力,同时支持分布式事务,同城跨AZ部署,数据0丢失,支持1000+的扩展能力,PB级海量存储。同时拥有云上高可用,高可靠,高安全,弹性伸缩,一键部署,快速备份恢复,监控告警等关键能力,能为企业提供功能全面,稳定可靠,扩展性强,性能优越的企业级数据库服务。 应用场景 交易型应用 大并发、大数据量、以联机事务处理为主的交易型应用,如政务、金融、电商、O2O、电信CRM/计费等,服务能力支持高扩展、弹性扩缩,应用可按需选择不同的部署规模。 详单查询 具备PB级数据负载能力,通过内存分析技术满足海量数据边入库边查询要求,适用于安全、电信、金融、物联网等行业的详单查询业务。 产品架构 GaussDB分布式形态整体架构如下: 产品优势 高安全 GaussDB拥有TOP级的商业数据库安全特性:数据动态脱敏,TDE透明加密,行级访问控制,密态计算。能够满足政企&金融级客户的核心安全诉求。 健全的工具与服务化能力 GaussDB已经拥有华为云,商用服务化部署能力,同时支持DAS、UGO、DRS等生态工具。有效保障用户开发、运维、优化、监控、迁移等日常工作需要。 全栈自研 GaussDB基于鲲鹏生态,是当前国内唯一能够做到全栈自主可控的国产品牌。同时GaussDB能够基于硬件优势在底层不断进行优化,提升产品综合性能。 开源生态 GaussDB已经支持开源社区,并提供主备版版本下载。 安全 ​​​​​​​责任共担 华为云安全责任共担模型 身份认证与访问控制 身份认证:用户访问云数据库 GaussDB时支持对数据库用户进行身份验证,包含密码验证和IAM验证两种方式。 密码验证:登录数据库时,需要对帐号密码进行验证,验证成功后方可进行操作。IAM验证:使用统一身份认证服务(Identity and Access Management, IAM)进行精细的权限管理。 访问控制: 权限控制:购买实例之后,您可以使用IAM为企业中的员工设置不同的访问权限,以达到不同员工之间的权限隔离,通过IAM进行精细的权限管理。 VPC和子网:虚拟私有云(Virtual Private Cloud, VPC)为云数据库构建隔离的、用户自主配置和管理的虚拟网络环境,提升用户云上资源的安全性,简化用户的网络部署。子网提供与其他网络隔离的、可以独享的网络资源,以提高网络安全性。 安全组:安全组是一个逻辑上的分组,为同一个虚拟私有云内具有相同安全保护需求并相互信任的弹性云服务器和GaussDB数据库实例提供访问策略。 数据保护技术 GaussDB通过多种数据保护手段和特性,保障存储在GaussDB中的数据安全可靠。 数据保护手段 简要说明 传输加密(HTTPS) 支持HTTP和HTTPS两种传输协议,为保证数据传输的安全性,推荐您使用更加安全的HTTPS协议。 数据备份 支持设置数据库的备份和恢复,来保障数据的可靠性。 敏感操作保护 控制台支持敏感操作保护,开启后执行删实例等敏感操作时,系统会进行身份验证,进一步保证GaussDB配置和数据的安全性。 SSL数据加密 可以使用SSL来加密数据库GaussDB和客户端的连接。SSL通过互相认证、使用数字签名确保完整性、使用加密确保私密性,以实现客户端和服务器之间的安全通讯。 审计与日志 云审计服务(Cloud Trace Service,CTS),是华为云安全解决方案中专业的日志审计服务,提供对各种云资源操作记录的收集、存储和查询功能,可用于支撑安全分析、合规审计、资源跟踪和问题定位等常见应用场景。 通过云审计服务,您可以记录与GaussDB实例相关的操作事件,便于日后的查询、审计和回溯。 ​​​​​​​监控安全风险 云监控服务为用户提供一个针对云数据库、云服务器等资源的立体化监控平台。使您全面了解云上的资源使用情况、业务的运行状况,并及时收到异常告警做出反应,保证业务顺畅运行。 ​​​​​​​故障恢复 GaussDB会在数据库实例的备份时段中创建数据库实例的自动备份,提供了多种方式恢复实例的数据,用以满足不同的使用场景,支持将实例的节点分别部署在多个可用区,以此来实现AZ级高可用。当主节点发生故障时,备节点会自动升级为主节点,保证实例的可用性。 ​​​​​​​认证证书 华为云服务及平台通过了多项国内外权威机构(ISO/SOC/PCI等)的安全合规认证,用户可自行申请下载合规资质证书。另外,华为云还提供了以下销售许可证及软件著作权证书,供用户下载和参考。 GaussDB与其他服务的关系 GaussDB与其他服务的关系如表1。 表1与其他服务的关系 相关服务 交互功能 弹性云服务器(ECS) GaussDB服务通过弹性云服务器(Elastic Cloud Server,简称ECS)远程连接GaussDB可以有效的降低应用响应时间、节省公网流量费用。 虚拟私有云(VPC) 对您的GaussDB实例进行网络隔离和访问控制。 对象存储服务(OBS) 存储GaussDB实例的自动和手动备份数据。 云监控服务(Cloud Eye) 云监控服务是一个开放性的监控平台,帮助用户实时监测GaussDB资源的动态。云监控服务提供多种告警方式以保证及时预警,为您的服务正常运行保驾护航。 云审计服务(CTS) 云审计服务(Cloud Trace Service,简称CTS),为用户提供云服务资源的操作记录,供您查询、审计和回溯使用。 数据管理服务(DAS) 使用数据管理服务(Data Admin Service,简称DAS),通过专业优质的可视化操作界面,提高数据管理工作的效率和安全。 约束与限制 云数据库GaussDB在使用上有一些固定限制,用来提高实例的稳定性和安全性,具体详见表1。 表1功能约束与限制 功能 使用限制 数据库访问 如果GaussDB实例未开通公网访问,则该实例必须与云主机弹性云服务器处在同一个虚拟私有云子网内才能相互访问。 弹性云服务器必须处于目标GaussDB实例所属安全组允许访问的范围内。 如果GaussDB实例与弹性云服务器处于不同的安全组,系统默认不能访问。需要在GaussDB的安全组添加一条“入”的访问规则。 GaussDB实例的默认端口为8000,只能在创建实例时修改。 部署 实例所部署的服务器,对用户都不可见,即只允许应用程序通过IP地址和端口访问数据库。 数据库的root权限 创建实例页面只提供管理员root用户权限。说明:在2022.08.30后,GaussDB为root用户开放了sysadmin权限。新创建实例的root用户都将拥有sysadmin权限,而存量实例执行版本升级后,root用户也将拥有sysadmin权限,如果需要进行版本升级,请联系客服处理。如果存量实例未进行版本升级,则管理员root用户权限为:createrole,createdb和monadmin。由于旧版本root权限低于完整的管理员用户权限, 部分SQL语法/函数执行时会报权限不足,例如:create tablespace 等 重启GaussDB实例 无法通过命令行重启,必须通过GaussDB的管理控制台操作重启实例。 GaussDB备份查看 GaussDB实例在对象存储服务上的备份文件,对用户不可见。 计费模式 提供按小时、按月、按年的计费方式供您灵活选择,使用越久越便宜。 预付费(包年包月):这种购买方式相对于按需付费提供更大的折扣,对于长期使用者,推荐该方式。 按需付费(小时):这种购买方式比较灵活,可以即开即停,按实际使用时长计费。以自然小时为单位整点计费,不足一小时按一小时计费。 支持区域: 华北-北京四华东-上海一华南-广州华南-广州-友好用户环境西南-贵阳一亚太-新加坡 更详细的信息可去官网​​​​​​​了解。

优秀的个人博客,低调大师

分布式数据库DDL的编译与执行

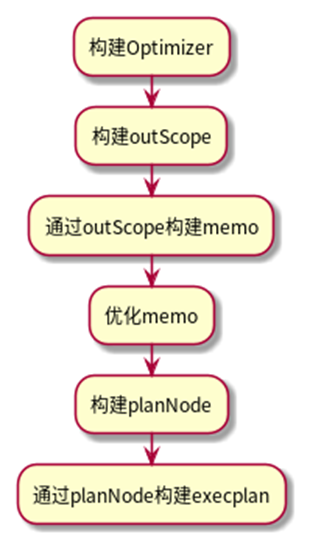
DDL是数据定义语言,用于定义和管理SQL 数据库中的所有对象的语言,常用的命令有:create,drop,alter等。通常来说,浪潮云溪数据库DDL语句的流程主要分为四个部分,分别是逻辑计划生成,物理计划生成,计划执行和schemachange。本文主要介绍逻辑计划生成,物理计划生成和计划执行。 - 逻辑计划生成 - 逻辑计划生成主要是生成一个planNode逻辑计划节点,每一条SQL都会有自己的planNode,以create table为例,该SQL生成的planNode中包含有CREATETABLE statement信息例如表名,有该表所属数据库的信息,还有该表的列的信息等。planNode生成后将其记录到planner的curplan(curplan有当前计划的属性,包含抽象语法树,planNode,子查询计划等)里,主要流程如下图所示。 以create table语句为例,构建逻辑计划主要是进行memo的构建以及RBO和CBO优化(memo是用来存储查询计划森林的一种数据结构)。首先会初始化一个优化计划的上下文optPlanningCtx,里面会初始化优化器并记录是否使用memo cache进行memo的缓存复用,而这也是DDL与DML语句之间的区别,DDL语句不会复用memo。 构建memo会调用builder的build()方法,对于不同的DDL语句,会调用不同的方法去构建逻辑计划。Create table语句会调用buildCreateTable,构建outScope,主要是生成语句的表达式expr记录在outScope里,最终记录到memo里面。而对于其他的DDL语句则会调用tryBuildOpaque,然后通过ConstructOpaqueDDL函数构建memo的expr。 Memo构建完以后就是进行优化,通过Optmize()函数进入进行RBO和CBO优化,而DDL语句不会进行优化,这也是与DML语句的区别,DML会将优化完的memo加入缓存。然后就是进行逻辑计划planNode的构建,DDL语句中,create语句会执行buildCreateTable进行ConstructCreateTable构建createTableNode,而drop和alter语句则会执行buildOpaque,通过ConstructOpaque返回所对应的planNode,最后将构建好的planNode封装到planTop里面,并且如果是DDL语句会在planTop的flags里面置planFlagIsDDL。 - 物理计划生成 - 逻辑计划生成后,就会根据逻辑计划生成物理计划,主要的流程如下图所示。 在生成物理计划之前会先判断语句是否需要分布式执行,DDL不会进行分布式执行,会生成一个本地的PlanningCtx(PlanningCtx 包含在单个查询的整个规划过程中使用和更新的数据)。如果SQL语句有子句的话,则会调用PlanAndRunSubqueries函数先执行子句。DDL语句会进入到wrapPlan进行物理计划的生成。在wrapPlan中会深度优先遍历planNode树,找到第一个支持DistSQL processor的planNode然后在该planNode上递归DistSQL优化,如果有等效的 DistSQL 处理器调用createPlanForNode生成物理计划。 函数首先判断当前planNode的类型,调用对应的函数为planNode创建物理计划(如indexJoinNode会调用createPlanForIndexJoin),DDL则会递归调用wrapPlan将planNode包起来继续处理(wrapPlan只包装节点本身而不包括孩子节点)。然后,调用shouldPlanTestMetadata函数判断是否需要进行元数据处理,如果需要则添加相关信息)。然后再进行创建planNodeToRowSource(该结构体),如果被包裹的planNode是flow中的第一个node,且语句类型是RowsAffected(返回受影响行的计数的语句)则可以使用fast path,planNode子树若支持DistSQL优化会在被优化后连接到wrapper。返回wrapper后,为物理计划添加LocalProcessor和LocalProcessorIndexes的元素,LocalProcessors数组包含了所有的planNodeToRowSource,即被包裹的planNode,记录物理计划的ResultTypes。 每当添加新的PhysicalPlan时,都需要覆写ResultRouters,我们将只需要一个result router,由于local processor不是分布式的,确保p.ResultRouters只有一个元素,最后填充计划的endpoints就进入执行流程。 - 执行 - 执行过程的主要流程如下图所示。 StartExec是具体执行planNode的方法,根据构建的物理计划对表描述符进行操作。StartExec会先对commend遍历(以alter table为例,commend是一个表修改操作的切片),在遍历中获取集群版本信息,检查在当前版本中是否支持添加列的类型,若支持则为true,反之报错;接着按照计划中的列定义信息生成列描述符,若添加的列是主键或含有唯一性约束,还会生成索引描述符,将这些描述符会包装成一个个mutation并添加到表描述符的Mutations字段里;然后根据表、mutation等信息创建一个job,job也是通过系统表system.jobs进行维护,这个job是用来触发及跟踪schema change执行,接着将含有mutations的表描述通过batch更新到系统表"descriptor"里。 执行流程中最主要的结构体就是batch,表描述符会存在batch里面,通过writeTableDescToBatch函数,在该函数里面,首先判断这个表如果不是一个新的表,需要将表的version+1,然后会验证表描述符格式是否良好,调用addUncommittedTable函数,这允许事务在绕过表租赁机制的情况下查看自己的修改,最后是将表描述符的KV写入到batch里面。batch构建完以后就执行batchRequest。 在执行流程结束后,如果需要数据回填的话,则进入到online schema change流程回填数据然后写入系统表完成执行流程,如果不需要的话,则在执行算子的时候就将数据写入到系统表中完成执行流程。

优秀的个人博客,低调大师

分布式数据库--SQL优化之Plan Hint

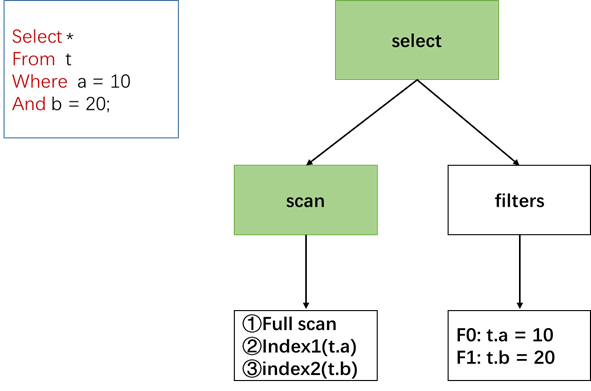
Part 1- 关于Hint Hint是嵌入SQL语句的对优化器进行提示的信息,是DBA进行SQL优化的常用手段。SQL语句经过优化器(规则优化(RBO)、代价优化(CBO)),通常会选择正确的查询路径,但是智者千虑,必有一失,有时优化器也会选择一个很差的计划,使得该条SQL查询变得很慢,此时需要DBA人为干预(通过给SQL语句增加一个注释),告诉优化器要选择指定的访问路径(full scan、index scan)或join 类型(merge、hash、lookup),使得该条SQL语句可以高效的运行。 Part 2 - Hint的使用 通过 /*+ ... */ 的注释形式放在 SELECT 关键字之后,多个 hint 之间用逗号隔开。 例如 select /*+use_index(t, index1)*/ * from t where a = 10 and b = 20; 如下图所示,经过RBO会得到如下normalized plan,而/*+ use_index(t, index1)*/ 将作用于scan选择的过程,这将告诉优化器在选择表t的访问路径(① ② ③)时,选择②索引index1。 Part 3 - Hint在云溪数据库中的 解析和应用流程 整体流程如下图3.1所示: 图3.1 hint 解析使用流程 第一步:输入带有hint SQL语句,如下所示 SELECT/*+ use_index(t1, idx1), merge_join(t1, t2) */ count(*) FROM t1, t2 WHERE t1.a = t2.b; 第二步:parser 编译解析; 第三步:将AST中的hint信息保存在HintSet中; 第四步:Builder从AST中获取hint信息,将对应hint解析到TableHint和IndexHint结构体中; 第五步:normalized plan阶段(RBO),通过调用buildScan为表构建ScanFlags,调用buildJoin为表构建JoinFlags; 第六步:在CBO阶段进行探索时,根据组成员的Flags信息,通过开销大小,来阻止某些等价表达式的生成,并生成hint需要的表达式,从而减小搜索空间; 第七步:生成hint作用之下的最优查询计划。 Part 4 - Hint 在云溪数据库中 不同阶段的表现形式 SQL语句中:显示指定要在表c上强制使用idx2,与c和o相关的join操作不允许使用NLJ算子; 经过parser后,hint信息保存在HintSet中; 在Builder中,hint信息以对象index和table为单位进行保存; 在规范化计划树和Memo结构体中,hint信息存在对应的Expr结构体中。 详细流程如下图4.1所示: 图4.1 hint在不同阶段的表现形式图 Part 5 - Hint对优化器的影响 图5.1结构解释: 图5.1 hint作用图 bestHT 存储着每个Group的代价最低的表达式。 exprHT 存储所有探索出来的表达式。 Group为逻辑等价的关系表达式的集合。 在云溪数据库中hint 影响计划的手段主要有两个,一个是探索阶段中,减少表达式的生成(例如指定megejoin,正常情况下会生成 merge、lookup、hash 三种连接类型,但是指定了mergejoin,就会直接不生成其他的的表达式),如下①;另一个是代价计算阶段中返回一个很大的代价hugeCost(例如针对t1,指定index1,然后对于其他的访问方法,则会直接返回很大的代价),如下③。 Hint对优化器的影响如下: ①排除了若干操作,减少了Memo结构体中表达式的个数,如下图X号所示; ②决定相关Group的最优计划选择, 如下图Group 1; ③ Group 1中,#1作为规范化表达式必然存在于组中,但是,它的代价被设置为hugeCost; ③由于使用ForceIndex,在探索阶段使用其它索引的表达式不会被优化器选择; ⑤ 最终影响最优计划树的选择。

优秀的个人博客,低调大师

分布式数据库--ZBConverter数据转换工具

- 基本介绍 - ZBConverter是一个可扩展、高性能的数据传输、模式转换和迁移验证的工具,支持云溪数据库、Oracle、MariaDB、MySQL、SQL Server、PostgreSQL、IBM DB2、Sybase、Informix、Teradata、Greenplum和Netezza之间数据库模式(DDL)、查询和DML语句、视图、存储过程、包、函数和触发器的转换。使用C/C++编写,使用本机低内存中批量加载器 API 来传输数据,适用于 Linux、Windows、64 位和 32 位平台。 命令行相关参数如下: - 逻辑架构 - 当单个SQL文件或者含有多个SQL文件的文件夹被-in参数所指定,就会经过ProcessFile处理文件。文件内容被ConvertSql预转换为数据流传入Convert,其中GetBomToken()函数将数据依照token语法树转换后传入Parse()函数。Parse()函数会根据映射进行批量处理直到token被处理完成,经过Post后由CreateOutputString处理为输出流,最后由Write写入文件或文件夹。在原有文件名的基础上默认加上_out,亦可自定义输出文件。 SQL文件处理逻辑 SQL语句处理逻辑 - 实际应用 - 例如MySQL->ZNBase(云溪数据库)效果如下:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册