首页 文章 精选 留言 我的

精选列表

搜索[分布式数据库],共1586篇文章
优秀的个人博客,低调大师

深入浅出RedisTimeSeries-分布式数据库

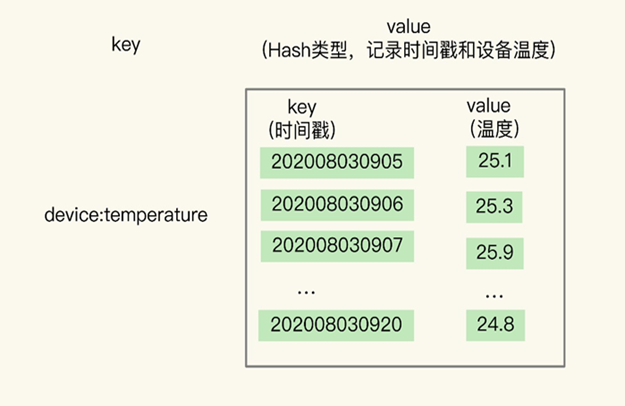
Part 1 - 背景 Redis作为一个灵活的高性能 key-value数据结构存储,可以用来作为数据库、缓存和消息队列。Redis 对比其他 key-value缓存产品有以下特点: Redis 支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载到内存使用。 Redis支持字符串(String)、哈希(Hash)、列表(list)、集合(sets)和有序集合(sorted sets)等数据结构的存储。 时序数据是指一串按照时间维度索引的数据,其特点是没有严格的关系模型,记录的信息可以表示成键和值的关系,因此并不需要关系型数据库进行保存。在实际应用中,时序数据通常是持续高并发写入的。针对时序数据的这一特性,Redis基于自身数据结构和扩展模块,提供了用于保存时间序列数据的两种方案: 1、基于Hash和Sorted Set数据保存时间序列数据; 2、基于RedisTimeSeries模块实现。 1.基于Hash保存时间序列数据 基于Hash保存时间序列数据的特点是可以实现对单键的快速查询,能够满足对时间序列数据的单键查询需求。Redis的Hash实现方式是将内部存储的value作为一个HashMap,并提供了用于直接存取Map成员的接口,将时间戳作为Hash集合的key,设备状态值作为Hash集合的value,因此对数据的修改和存取都可直接通过其内部Map的Key来实现操作对应属性数据,既不需要重复存储数据,也不会带来序列化和并发修改控制的问题。 但是,基于Hash保存时间序列数据的短板在于无法支持对数据的范围查询,虽然时间序列是按照时间顺序插入Hash集合的,但是Hash类型的底层结构是Hash表,并没有实现对数据的有序索引,因此要对Hash类型进行范围查询,则需要扫描Hash集合中的所有数据,再将这些数据取回客户端进行排序,之后才能在客户端得到查询范围内的数据,查询效率很低。 2、基于Sorted Set保存时间序列数据 基于Sorted Set保存时间序列数据的特点是能够同时支持按时间戳范围的查询,能够根据元素的权重值来排序,在时序数据的情况下,将时间戳作为Sorted Set集合的权重值,后跟时间点上记录的测量数据,例如:<时间戳>:<测量值>。RedisSorte Set的内部使用Hash Map和SkipList来保证数据的存储有序,使用SkipList的结构可以保证具有较高的查询效率,并且在实现上比较简单。 但是,基于Sorted Set保存时间序列数据策略的短板在于其仅仅能支持范围查询,无法直接完成对时序数据的聚合计算。因此,只能先把时间范围内的数据取回到客户端,然后在客户端自行完成聚合计算。这个方法虽然能完成聚合计算,但是会带来一定的潜在风险,也就是大量数据在Redis实例和客户端间频繁传输,这会和其他操作命令竞争网络资源,导致其他操作变慢。因此SortedSets 不是一种节约内存的数据结构,其插入的时间复杂度是 O(log(N)),因此集群越大,写入耗时越长。 综合来讲,基于Hash和SortedSet保存时间序列的策略短板主要包含两个方面:其一是当执行聚合计算时,需要把数据读取到客户端内再进行聚合,当存在大量数据需要聚合时,数据传输开销大;其二是当使用该策略时,所有的数据会在两个数据类型中各保存一份,内存开销大。 2、基于RedisTimeSeries保存时间序列数据 RedisTimeSeries作为Redis的一个扩展模块,它弥补了Redis基于Hash和Sorted Set保存时间序列数据内存和数据传输开销大的缺陷,它专门面向时间序列数据提供了数据类型和访问接口,并且支持在Redis端上直接对数据进行时间范围的聚合计算。它使用固定大小的内存块作为时间序列样本,采用与Redis Streams 相同的Radix Tree来实现索引。RedisTimeSeries 的底层数据结构使用了链表,范围查询的复杂度是 O(N) 级别。这种基于RedisTimeSeries保存时间序列数据的策略具有以下特点: 保证大容量插入,低延迟读取; 按开始时间和结束时间查询; 支持任何时间桶的聚合查询(min、max、avg、sum、range、count、first、last);支持配置保留时间; 下采样/压缩-自动更新的聚合时间序列; 二级索引-每个时间序列都有标签,允许按标签查询。 Part 2 - RedisTimeSeries存储结构 RedisTimeSeries将所有的时序数据存储在chunks中。每个chunks均由双向链表中的两个相关数组组成(一个用于时间戳,一个用于样本值)。每个chunks都有预定义的样本大小,当chunks填满的时候,其他数据将自动存储到下一个chunks。chunks size可以通过参数 CHUNK_SIZE进行设置。(CHUNK_SIZE的设置必须为8的倍数,默认值:4096) RedisTimeSeries的Key由metric指标和tags组成,其中每个Sample是时间和值的组合。标签是我们附加到数据点的键值元数据,允许我们进行分组和过滤。它们可以是字符串或数值,并在创建时添加到时间序列。 Part 3 -RedisTimeSeries的使用 当用于时间序列数据存取时,RedisTimeSeries的操作主要包含以下几个方面: 1、TS.CREATE命令 TS.CREATE命令用于创建时间序列数据集合,使用时需要设置时间序列数据集合的key和数据过期时间(以毫秒为单位)。还可以为数据集合设置标签,来表示数据集合的属性。说明: RETENTION:选填,数据保留时间,默认:0; ENCODING:选填,指定系列样本编码格式,分为COMPRESSED、UNCOMPRESSED两种格式; CHUNK_SIZE:选填,块的大小; DUPLICATE_POLICY:选填,配置对重复样本执行的操作,默认BLOCK堵塞状态。状态类型:(BLOCK,FIRST,LAST,MIN,MAX,SUM) LABELS:必填,数据标签。 实例1: 2、TS.ADD命令 TS.ADD命令用于向时间序列集合中插入数据,其中包括时间戳和具体的数值。若先前尚未使用TS.CREATE创建时间序列,将自动创建时序数据集合。 注意:不能向最后一次使用的时间戳之前添加数据。使用 TS.ADD 命令添加值的时间戳必须要大于最后一个值的时间戳。 实例2: 也可以使用 * 让Redis将自动生成时间戳。 实例3: TS.MADD命令用于向已存在的时间序列集合中插入新样本数据。 实例4: 3、TS.GET命令 TS.GET命令用于读取时间序列集合的最新数据。 实例5: TS.MGET命令用于按标签查询集合中的最新数据。在使用TS.CREATE创建数据集合时,可以给集合设置标签属性。当进行查询时,就可以在查询条件中根据集合标签属性对数据样本进行匹配,其查询结果只返回满足匹配集合的最新数据。 实例6: 下列TS.MGET命令,以及FILTER设置(这个配置项用来于设置集合标签的过滤条件),查询area_id等于32的所有数据集合,并返回各自集合中最新一条数据。 4、TS.RANGE/TS.RERANGE命令 TS.RANGE/RERANGE命令用于支持时间序列集合聚合计算的范围查询; 说明: [FROM_TIMESTAMP][TO_TIMESTAMP]:必填,起始时间戳; [FILTER_BY_TS]:选填,按照时间戳过滤样本数据; [FILTER_BY_VALUES]:选填,按照value值过滤样本数据; [COUNT]:选填,返回样本的最大数量。 [AGGREGATION]:选填,指定要执行的聚合计算类型,RedisTimeSeries支持的聚合计算类型很丰富,包括AVG、MAX、MIN、SUM、COUNT、LAST、FIRST。 实例7: TS.MRANGE命令通过FILTERS过滤查询跨多个时间序列的范围。 说明: [FROM_TIMESTAMP][TO_TIMESTAMP]:起始时间戳,也看用"- +"表示从开始到最新时间戳的所有内容; [FILTER_BY_TS]:按时间戳过滤时间序列集合; [FILTER_BY_VALUES]:按value值过滤时间序列集合; [WITHLABELS]:包含时间序列元数据标签的键值对。若[WITHLABELS]或[SELECTED_LABELS]未设置,默认情况下,标签数组位置会回复一个空数组; [GROUPBY]:汇总不同时间序列的结果,按提供的label名称分组; [REDUCE]:用于聚合具有相同标签值得系列的reducer类型。 实例: 5、RedisTimeSeries其他命令 TS.DEL KEY_NAME FROM_TIMESTAMP TO_TIMESTAMP:删除给定KEY_NAME的时间戳范围内的值; DEL KEY_NAME:删除已创建的KEY; TS.ALTER KEY_NAME [RETENTION] LABELS:更改已创建键的元数据,包括label和保留值; TS.INCREBY/TS.DECREBY:在最新数据上增加/减少某个值; TS.INFO:返回时间序列的信息和统计数据; KEYS *:获取所有KEY; EXISTS KEY_NAME:检查给定KEY是否存在,若存在返回1,否返回0。 Part 4 - 总结 RedisTimeSeries作为Redis的一种扩展模块,它的出现为时序数据的存取提供了一种新方法,具有高效的查询性能,并且在存取过程中仅需很小的开销,便能够实现时序数据实时分析的愿望。

优秀的个人博客,低调大师

云溪分布式数据库事务并发控制介绍

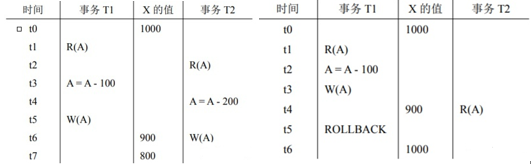
1.事务并发控制原理概述 1.1为什么要进行并发控制 数据库是共享资源,通常有许多个事务同时在运行。当多个事务并发地存取数据库时就会产生同时读取和/或修改同一数据的情况。若对并发操作不加控制就可能会存取和存储不正确的数据,破坏数据库的一致性。所以数据库管理系统必须提供并发控制机制。 下图左事务T2在t6时刻的写操作W(A)将事务T1在t5时刻的写操作覆盖了,造成事务T1的更新丢失;下图右事务T2读到了事务T1回滚了的写操作,该数据不合法,称为脏读。除此之外,由于事务的并发执行,还会产生不可重复读、幻读、读写偏序等问题,在此不一一介绍。 图1 左为更新丢失,右为脏读 数据库为了提高资源利用率和事务执行效率、降低响应时间,允许事务并发执行。但是多个事务同时操作同一对象,必然存在冲突,事务的中间状态可能暴露给其它事务,导致一些事务依据其它事务中间状态,把错误的值写到数据库里。需要提供一种机制,保证事务执行不受并发事务的影响,让用户感觉,当前仿佛只有自己发起的事务在执行,这就是隔离性。由于隔离性对事务的执行顺序要求较高,很多数据库提供了不同选项,用户可以牺牲一部分隔离性,提升系统性能。这些不同的选项就是事务隔离级别。事务的隔离级别一般划分为四个,由低到高分别为:读未提交、读已提交、可重复读、串行化。最终的目的是将并发执行的事务按照合理的顺序做到逻辑上的串行操作,避免按照时序执行破坏数据库的一致性。 图2 并发操作的串行执行顺序 1.2 常用的并发控制方方式 常用的并发控制有锁、时间戳、有效性检查、快照、多版本机制,在此我们介绍几个和云溪数据库相关的并发控制。 1.2.1 锁 为了最大化数据库事务的并发能力,数据库中的锁被设计为两种模式,分别是共享锁和互斥锁。当一个事务获得共享锁之后,它只可以进行读操作,所以共享锁也叫读锁;而当一个事务获得一行数据的互斥锁时,就可以对该行数据进行读和写操作,所以互斥锁也叫写锁。如果当前事务没有办法获取该行数据对应的锁时就会陷入等待的状态,直到其他事务将当前数据对应的锁释放才可以获得锁并执行相应的操作。 图3 互斥锁和共享锁的相容性 两阶段锁协议(2PL)是一种能够保证事务可串行化的协议,它将事务的获取锁和释放锁划分成了增长(Growing)和缩减(Shrinking)两个不同的阶段。在增长阶段,一个事务可以获得锁但是不能释放锁;而在缩减阶段事务只可以释放锁,并不能获得新的锁。 死锁在多线程编程中是经常遇到的事情,一旦涉及多个线程对资源进行争夺就需要考虑当前的几个线程或者事务是否会造成死锁.通过有向等待图是否产生环可以判断是否有死锁产生。如何从死锁中恢复其实非常简单,最常见的解决办法就是选择整个环中一个事务进行回滚,以打破整个等待图中的环。 图4 死锁的产生 1.2.2 时间戳 为每个事务分配timestamp,并以此决定事务执行顺序。当事务1的timestamp小于事务2时,数据库系统要保证事务1先于事务2执行基于T/O的并发控制,读写不需加锁, 每行记录都标记了最后修改和读取它的事务的timestamp。当事务的timestamp小于记录的timestamp时(不能读到”未来的”数据),需要abort后重新执行。假设记录X上标记了读写两个timestamp:WTS(X)和RTS(X),事务的timestamp为TTS,可见性判断如下: 读: TTS < WTS(X):该对象对该事务不可见,abort事务,取一个新timestamp重新开始。 TTS > WTS(X):该对象对事务可见,更新RTS(X) = max(TTS,RTS(X))。为了满足repeatable read,事务复制X的值。 写: TTS < WTS(X) || TTS < RTS(X):abort事务,重新开始。 TTS > WTS(X) && TTS > RTS(X): 事务更新X,WTS(X) = TTS。 它缺陷包括:长事务容易饿死,因为长事务的timestamp偏小,大概率会在执行一段时间后读到更新的数据,导致abort;读操作也会产生写(写RTS)。 1.2.3多版本并发控制 数据库维护了一条记录的多个物理版本。事务写入时,创建写入数据的新版本,读请求依据事务/语句开始时的快照信息,获取当时已经存在的最新版本数据。它带来的最直接的好处是:写不阻塞读,读也不阻塞写,读请求永远不会因此冲突失败(例如单版本T/O)或者等待(例如单版本2PL)。对数据库请求来说,读请求往往多于写请求。主流的数据库几乎都采用了这项优化技术。 图5 多版本并发读写操作 2. 云溪数据库并发控制机制 云溪数据库采用Percolator的并发控制模型,云溪数据库中的值不直接写入存储层; 相反,所有东西都是以临时状态写成的,称为“Write Intent”,并添加了一个附加值,用于标识值所属的事务记录(transaction record)。每当操作遇到Write Intent时,它会查找事务记录的状态以了解它应如何处理Write Intent值。 2.1事务记录 为了跟踪事务执行的状态,我们将一个事务记录的值写入KV存储,事务所有的write intents都指向该记录,该记录允许所有事务检查它们遇见的write intents。这个在分布式环境中对并发性支持很重要。事务记录表达了以下事务的状态之一: PENDING: 所有值的初始状态,表示Write Intent的事务仍在进行中。 COMMITTED: 事务完成后,此状态表示可以读取该值。 STAGING:用于启用并行提交功能。根据此记录引用的写入意图的状态,事务可能处于提交状态,也可能不处于提交状态。 ABORTED: 如果事务失败或被客户端中止,它将进入此状态。 Record does not exist:如果事务遇到不存在事务记录的写意图,它将使用写意图的时间戳来确定如何继续。如果写意图的时间戳在事务活跃度阈值内,则写意图的事务将被视为PENDING,否则将被视为事务ABORTED。 2.2 写意图 它们本质上是多版本的并发控制值(也称为MVCC,在存储层中有更深入的解释),并添加了一个附加值,用于标识值所属的事务记录。可以把它们视为复制锁和复制临时value的组合。 每当操作遇到Write Intent(而不是MVCC值)时,它会查找事务记录的状态以了解它应如何处理Write Intent值。如果事务记录丢失,操作将检查write intents的时间戳,并评估它是否过期。 每当操作遇到key的Write Intent时,它会尝试“解析”它,其结果取决于Write Intent的事务记录: COMMITTED: 该操作读取Write Intent并通过删除Write Intent指向事务记录的指针,来将其转换为MVCC值。 ABORTED: Write Intent被忽略并删除。 PENDING: 这表示存在事务冲突,必须解决。 STAGING:需要通过事务协调器去检查这个事务记录的心跳是否还在,如果存在则需要等待 2.3解决冲突 2.3.1写写冲突 1.如果事务具有明确的优先级设置,则比较优先级决定 push操作,优先级高的事务会将优先级低的事务回滚 2.如果没有优先级之分,时间戳大的事务会进入时间戳小的事务的队列中等待事务记录变为committed或者aborted 2.3.2写读冲突 1.如果事务具有明确的优先级设置,则比较优先级决定 push操作,优先级高的事务会将优先级低的事务的是时间戳推到高优先级事务之后 2.如果没有优先级之分,时间戳大的事务会进入时间戳小的事务的队列中等待事务记录变为committed或者aborted 2.3.3读后写 读操作读取值的时候都会把读时间戳存储到一个时间戳缓存,该缓存显示读取值的高水位线写操作发生时,对照这个时间戳缓存检查时间戳,如果写事务时间戳小于时间戳缓存最新值,那么就是发生了读后写。写事务时间戳会被后推,该操作可能影响事务发生重启(read refreshing) 3.云溪数据库并发控制器 3.1 为什么要做并发控制器 将请求同步处理和事务冲突处理集中在一个位置,允许单独记录、理解和测试主题。 简化了事务排队过程,降低了事务推送RPC的频率,并允许等待者在意图解析后立即继续。 创建一个锁的框架,可以做kv 级别 SELECT for update 和SELECT for share功能 。 当事务发生冲突时,围绕公平性提供更有力的保证,以减少竞争场景下的尾部延迟 3.2 并发控制器基本结构 并发管理器是一种结构,它对传入的请求进行排序,并在发出那些要执行冲突操作的请求的事务之间提供隔离。在排序过程中,通过被动排队和主动推送相结合的方式发现冲突并解决任何发现的冲突。一旦请求被排序,它就可以自由地进行evaluate,而不必担心与其他请求发生冲突。这种隔离在请求的生存期内得到保证,但在请求完成后终止。 事务中的每个请求都应该与其他请求隔离,无论是在请求的生存期内还是在请求完成后(假设它获得了锁),但请求都应该在事务的生存期内。 核心是两部分:latch manager和lock table。 lm是将request排序,保证他们的隔离性 lt给request提供锁和排序,它是一个在每个节点内存中的数据结构,保存获得锁的正在进行的事务集合。lock机制要和write intent兼容,所以当请求在evaluate过程中发现了外部锁,则会将这些信息引入。 3.3 并发控制器控制过程 从请求 SequenceReq 获取 Latch 保证没有 req 冲突并检查内存 locktable,如果有冲突则释放 latch 后等待对应锁 后开始正常执行请求,执行 apply 后会向 locktable 增加当前事务的锁信息 并在请求完成后 FinishReq 释放 Latch 继续其他请求 最后在事务提交或回滚后的 resolve intent 完成后释放 locktable 中事务占的锁,并唤醒其他等待事务的请求。 3.4 latch manager latch manager给传入请求进行排序,并在并发管理器的监督下提供这些请求之间的隔离。latch就像一个低级别的持续时间段的mutex 工作方式: 1.某个range的写请求会被这个range的LeaseHolder序列化,置于某种顺序中 2.为了强化这个序列化,LeaseHolder采用对这些写的值采用latch提供无竞争访问 3.其他请求进入LeaseHolder请求被latch锁的同一组key,必须先获取latch才能继续 4.读请求也能产生latch,并且多个读请求对于相同的key可以同时持有latch(相容),但 是读latch和写latch不能相容。 另一种看待latch的方式类似于互斥锁,它只在单个低级请求的持续时间内需要。为了协调运行时间更长、级别更高的请求(即客户端事务),我们使用持久的写意图系统。 3.5 lock table 它是一个在每个节点内存中的数据结构,保存获得锁的正在进行的事务集合。每个锁都有一个与之相关联的队列,等待该锁释放的事务都在里面排队。本地存储的lockWaitQueue中的项目会被RPC传播到现有的TxnWaitQueue上去,该TxnWaitQueue队列存储在事务记录所在的的Raft Group的leader节点上。 并非所有锁都直接存储在管理器的控制下,因此在排序过程中并非所有锁都可以发现。具体来说,write intents(复制的、排他的锁)内联存储在MVCC密钥空间中,因此直到请求evaluation时才可检测到它们。为了适应这种锁存储形式,管理器将有关外部锁的信息集成到并发管理器结构中。 锁的生命周期要大于锁持有者(事务)的生命周期,锁将特定的key上提供的隔离的持续时间延长到锁持有者事务本身的生命周期。它们(通常)仅在事务提交或中止时才被释放。 但是,并非所有锁都直接存储在管理器的控制下,因此在排序过程中并非所有锁都可以发现。具体来说,write intents(复制的、排他的锁)内联存储在MVCC中,因此直到请求evaluation时才可检测到它们。目前,并发管理器在非复制的锁表结构上运行 3.6 TxnWaitQueue TxnWaitQueue追踪所有他们遇到的无法推动(push)写事务的事务,并且必须等待阻塞事务完成才能继续。他是一个存储阻塞事务ID的数据结构 重点:这些活动发生在单个节点上,该节点是包含事务记录的range的Raft组的leader。 一旦事务确实解决了,一个信号被发送到TxnWaitQueue,它允许被该事务阻塞的所有事务开始执行。 被阻塞的事务会检查自己事务的状态,以确保它们仍处于活动状态。 如果被阻止的事务被中止,则只需将其删除。 如果事务之间存在死锁(即它们各自被彼此的Write Intents阻塞),则其中一个事务被随机中止。 3.7 lockTableWaiter lockTableWaiter负责lock wait queue中的持有锁的冲突事务,它保证在事务协调器出差或者死锁情况下,请求能够继续进行 waiter实现了请求等待冲突的锁在lock table里面释放的逻辑,类似的,他实现了调用者请求之前的等待冲突请求的逻辑,该锁等待队列是调用者的一部分 此等待状态响应锁表中的一组状态转换: 1.冲突的锁被释放 2.冲突的所被更新使其不再冲突 3.lock wait queue中冲突的请求获得锁 4.lock wait queue中冲突的请求退出lock wait queue 这些状态状态转换通常是反射性的,waiter可以等待锁释放或者被其他参与者退出。 LockManager支持对冲突锁的状态转换作出反应 RequestSequencer接口支持对冲突lock wait-queues的状态转换作出反应 但是,在事务协调器失败或事务死锁的情况下,如果没有waiter的干预,状态转换可能永远不会发生。为了确保向前推进,waiter可能需要主动推送冲突锁的持有者或冲突锁等待队列的头。该行为push需要一个RPC到冲突事务记录的leaseholder,通常会导致RPC在leaseholder的txnWaitQueue中排队。因为这样做的代价很高,所以推送不会立即执行,它只在延迟之后执行。

优秀的个人博客,低调大师

DistSQL 深度解析:打造动态化的分布式数据库

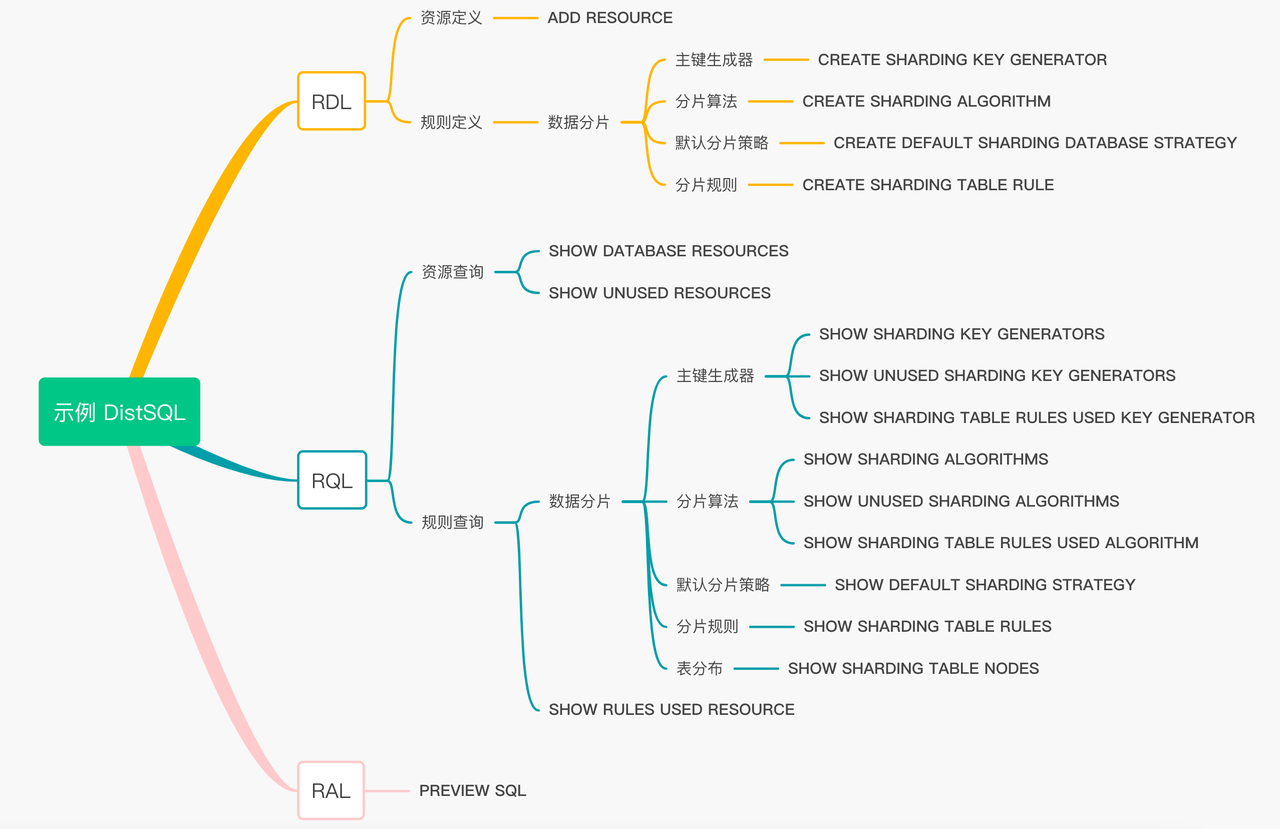
一、背景 自 ShardingSphere 5.0.0 版本发布以来,DistSQL 为 ShardingSphere 生态带来了强大的动态管理能力,通过 DistSQL,用户可以: 在线创建逻辑库; 动态配置规则(包括分片、数据加密、读写分离、数据库发现、影子库、全局规则等); 实时调整存储资源; 即时切换事务类型; 随时开关 SQL 日志; 预览 SQL 路由结果; ... 同时,随着使用场景的深入,越来越多的 DistSQL 特性被发掘出来,众多宝藏语法也受到了用户的喜爱。 二、内容提要 本文将以数据分片为例,深度解析 Sharding 相关 DistSQL 的应用场景和使用技巧。同时,通过实践案例将一系列 DistSQL 语句进行串联,为读者展现一套完整实用的 DistSQL 分片管理方案。 本文案例中将用到以下 DistSQL: 三、实战演练 3.1 场景需求 创建两张分片表t_order和 t_order_item; 两张表均以user_id字段分库,以order_id 字段分表; 分片数量为 2 库 x 3 表; 如图: 3.2 环境准备 准备可供访问的 MySQL 数据库实例,创建两个新库 demo_ds_0、demo_ds_1; 以 MySQL 为例,也可使用 PostgreSQL 或 openGauss 数据库。 2.部署 Apache ShardingSphere-Proxy 5.1.2 和 Apache ZooKeeper,其中 ZooKeeper 将作为治理中心,存储 ShardingSphere 元数据信息; 3.配置 Proxy conf 目录下的 server.yaml,内容如下; mode: type: Cluster repository: type: ZooKeeper props: namespace: governance_ds server-lists: localhost:2181 # ZooKeeper 地址 retryIntervalMilliseconds: 500 timeToLiveSeconds: 60 maxRetries: 3 operationTimeoutMilliseconds: 500 overwrite: false rules: - !AUTHORITY users: - root@%:root 启动 ShardingSphere-Proxy,并使用客户端连接到 Proxy,例如 mysql -h 127.0.0.1 -P 3307 -u root -p 3.3 添加存储资源 创建逻辑数据库 CREATE DATABASE sharding_db;USE sharding_db; 添加存储资源,对应之前准备的 MySQL 数据库 ADD RESOURCE ds_0 ( HOST=127.0.0.1, PORT=3306, DB=demo_ds_0, USER=root, PASSWORD=123456 ), ds_1( HOST=127.0.0.1, PORT=3306, DB=demo_ds_1, USER=root, PASSWORD=123456 ); 查看存储资源 mysql> SHOW DATABASE RESOURCES\\G; *************************** 1. row *************************** name: ds_1 type: MySQL host: 127.0.0.1 port: 3306 db: demo_ds_1 -- 省略部分属性 *************************** 2. row *************************** name: ds_0 type: MySQL host: 127.0.0.1 port: 3306 db: demo_ds_0 -- 省略部分属性 查询语句加了 \G 是为了让输出格式更易读,非必需。 3.4 创建分片规则 ShardingSphere 分片规则支持“常规分片”和“自动分片”两种配置方式,它们的分片效果是等价的,区别在于“自动分片”的配置定义更加简洁,而“常规分片”配置方式更加灵活自主。 还不了解“自动分片”的同学可以参考: 《DistSQL:像数据库一样使用 Apache ShardingSphere》 《分片利器 AutoTable:为用户带来「管家式」分片配置体验》 接下来,我们将采用“常规分片”的方式,使用 INLINE 表达式算法实现需求描述的分片场景。 3.4.1 主键生成器 创建主键生成器 CREATE SHARDING KEY GENERATOR snowflake\_key\_generator \( TYPE(NAME=SNOWFLAKE) ); 查询主键生成器 mysql> SHOW SHARDING KEY GENERATORS; +-------------------------+-----------+-------+ | name | type | props | +-------------------------+-----------+-------+ | snowflake_key_generator | snowflake | {} | +-------------------------+-----------+-------+ 1 row in set (0.01 sec) 3.4.2 分片算法 创建一个分库算法,由t_order和 t_order_item 共用 -- 分库时按 user_id 对 2 取模 CREATE SHARDING ALGORITHM database_inline ( TYPE(NAME=INLINE,PROPERTIES("algorithm-expression"="ds_${user_id % 2}")) ); 为t_order和t_order_item创建不同的分表算法 -- 分表时按 order_id 对 3 取模 CREATE SHARDING ALGORITHM t_order_inline ( TYPE(NAME=INLINE,PROPERTIES("algorithm-expression"="t_order_${order_id % 3}")) ); CREATE SHARDING ALGORITHM t_order_item_inline ( TYPE(NAME=INLINE,PROPERTIES("algorithm-expression"="t_order_item_${order_id % 3}")) ); 查询分片算法 mysql> SHOW SHARDING ALGORITHMS; +---------------------+--------+---------------------------------------------------+ | name | type | props | +---------------------+--------+---------------------------------------------------+ | database_inline | inline | algorithm-expression=ds_${user_id % 2} | | t_order_inline | inline | algorithm-expression=t_order_${order_id % 3} | | t_order_item_inline | inline | algorithm-expression=t_order_item_${order_id % 3} | +---------------------+--------+---------------------------------------------------+ 3 rows in set (0.00 sec) 3.4.3 默认分片策略 分片策略由分片键和分片算法组成,其概念可参考《分片策略》 分片策略包含分库策略(databaseStrategy)和分表策略(tableStrategy)。 由于t_order和t_order_item 的分库字段和分库算法相同,我们创建一个默认策略,未配置分库策略的分片表都使用它: 创建默认分库策略 CREATE DEFAULT SHARDING DATABASE STRATEGY ( TYPE=STANDARD,SHARDING_COLUMN=user_id,SHARDING_ALGORITHM=database_inline ); 查询默认策略 mysql> SHOW DEFAULT SHARDING STRATEGY\G; *************************** 1. row *************************** name: TABLE type: NONE sharding_column: sharding_algorithm_name: sharding_algorithm_type: sharding_algorithm_props: *************************** 2. row *************************** name: DATABASE type: STANDARD sharding_column: user_id sharding_algorithm_name: database_inline sharding_algorithm_type: inline sharding_algorithm_props: {algorithm-expression=ds_${user_id % 2}} 2 rows in set (0.00 sec) 未配置默认分表策略,因此 TABLE 类型的默认策略是 NONE。 3.4.4 分片规则 主键生成器和分片算法都已就绪,现在开始创建分片规则: t_order CREATE SHARDING TABLE RULE t_order ( DATANODES("ds_${0..1}.t_order_${0..2}"), TABLE_STRATEGY(TYPE=STANDARD,SHARDING_COLUMN=order_id,SHARDING_ALGORITHM=t_order_inline), KEY_GENERATE_STRATEGY(COLUMN=order_id,KEY_GENERATOR=snowflake_key_generator) ); DATANODES 指定了分片表的数据节点; TABLE_STRATEGY 指定了分表策略,其中 SHARDING_ALGORITHM 使用了已创建好的分片算法 t_order_inline; KEY_GENERATE_STRATEGY 指定该表的主键生成策略,若不需要主键生成,可省略该配置。 t_order_item CREATE SHARDING TABLE RULE t_order_item ( DATANODES("ds_${0..1}.t_order_item_${0..2}"), TABLE_STRATEGY(TYPE=STANDARD,SHARDING_COLUMN=order_id,SHARDING_ALGORITHM=t_order_item_inline), KEY_GENERATE_STRATEGY(COLUMN=order_item_id,KEY_GENERATOR=snowflake_key_generator) ); 查询分片规则 mysql> SHOW SHARDING TABLE RULES\G; *************************** 1. row *************************** table: t_order actual_data_nodes: ds_${0..1}.t_order_${0..2} actual_data_sources: database_strategy_type: STANDARD database_sharding_column: user_id database_sharding_algorithm_type: inline database_sharding_algorithm_props: algorithm-expression=ds_${user_id % 2} table_strategy_type: STANDARD table_sharding_column: order_id table_sharding_algorithm_type: inline table_sharding_algorithm_props: algorithm-expression=t_order_${order_id % 3} key_generate_column: order_id key_generator_type: snowflake key_generator_props: *************************** 2. row *************************** table: t_order_item actual_data_nodes: ds_${0..1}.t_order_item_${0..2} actual_data_sources: database_strategy_type: STANDARD database_sharding_column: user_id database_sharding_algorithm_type: inline database_sharding_algorithm_props: algorithm-expression=ds_${user_id % 2} table_strategy_type: STANDARD table_sharding_column: order_id table_sharding_algorithm_type: inline table_sharding_algorithm_props: algorithm-expression=t_order_item_${order_id % 3} key_generate_column: order_item_id key_generator_type: snowflake key_generator_props: 2 rows in set (0.00 sec) 💡至此,t_order 和t_order_item的分片规则已配置完成。什么?有点复杂? 好吧,其实也可以忽略单独创建主键生成器、分片算法、默认策略的步骤,一步完成分片规则,让我们来加点糖。 3.5 语法糖 现在,需求中要增加一张分片表t_order_detail,我们可以这样一步完成分片规则的创建: CREATE SHARDING TABLE RULE t_order_detail ( DATANODES("ds_${0..1}.t_order_detail_${0..1}"), DATABASE_STRATEGY(TYPE=STANDARD,SHARDING_COLUMN=user_id,SHARDING_ALGORITHM(TYPE(NAME=INLINE,PROPERTIES("algorithm-expression"="ds_${user_id % 2}")))), TABLE_STRATEGY(TYPE=STANDARD,SHARDING_COLUMN=order_id,SHARDING_ALGORITHM(TYPE(NAME=INLINE,PROPERTIES("algorithm-expression"="t_order_detail_${order_id % 3}")))), KEY_GENERATE_STRATEGY(COLUMN=detail_id,TYPE(NAME=snowflake)) ); 说明: 上述语句中指定了分库策略、分表策略、主键生成策略,但都没有引用已经存在的算法,因此 DistSQL 引擎会自动用输入的表达式创建相应的算法,供 t_order_detail分片规则使用。 此时我们再来查看主键生成器、分片算法和分片规则,结果如下: 主键生成器 mysql> SHOW SHARDING KEY GENERATORS; +--------------------------+-----------+-------+ | name | type | props | +--------------------------+-----------+-------+ | snowflake_key_generator | snowflake | {} | | t_order_detail_snowflake | snowflake | {} | +--------------------------+-----------+-------+ 2 rows in set (0.00 sec) 分片算法 mysql> SHOW SHARDING ALGORITHMS; +--------------------------------+--------+-----------------------------------------------------+ | name | type | props | +--------------------------------+--------+-----------------------------------------------------+ | database_inline | inline | algorithm-expression=ds_${user_id % 2} | | t_order_inline | inline | algorithm-expression=t_order_${order_id % 3} | | t_order_item_inline | inline | algorithm-expression=t_order_item_${order_id % 3} | | t_order_detail_database_inline | inline | algorithm-expression=ds_${user_id % 2} | | t_order_detail_table_inline | inline | algorithm-expression=t_order_detail_${order_id % 3} | +--------------------------------+--------+-----------------------------------------------------+ 5 rows in set (0.00 sec) 分片规则 mysql> SHOW SHARDING TABLE RULES\G; *************************** 1. row *************************** table: t_order actual_data_nodes: ds_${0..1}.t_order_${0..2} actual_data_sources: database_strategy_type: STANDARD database_sharding_column: user_id database_sharding_algorithm_type: inline database_sharding_algorithm_props: algorithm-expression=ds_${user_id % 2} table_strategy_type: STANDARD table_sharding_column: order_id table_sharding_algorithm_type: inline table_sharding_algorithm_props: algorithm-expression=t_order_${order_id % 3} key_generate_column: order_id key_generator_type: snowflake key_generator_props: *************************** 2. row *************************** table: t_order_item actual_data_nodes: ds_${0..1}.t_order_item_${0..2} actual_data_sources: database_strategy_type: STANDARD database_sharding_column: user_id database_sharding_algorithm_type: inline database_sharding_algorithm_props: algorithm-expression=ds_${user_id % 2} table_strategy_type: STANDARD table_sharding_column: order_id table_sharding_algorithm_type: inline table_sharding_algorithm_props: algorithm-expression=t_order_item_${order_id % 3} key_generate_column: order_item_id key_generator_type: snowflake key_generator_props: *************************** 3. row *************************** table: t_order_detail actual_data_nodes: ds_${0..1}.t_order_detail_${0..1} actual_data_sources: database_strategy_type: STANDARD database_sharding_column: user_id database_sharding_algorithm_type: inline database_sharding_algorithm_props: algorithm-expression=ds_${user_id % 2} table_strategy_type: STANDARD table_sharding_column: order_id table_sharding_algorithm_type: inline table_sharding_algorithm_props: algorithm-expression=t_order_detail_${order_id % 3} key_generate_column: detail_id key_generator_type: snowflake key_generator_props: 3 rows in set (0.01 sec) 说明: CREATE SHARDING TABLE RULE语句中,DATABASE_STRATEGY、TABLE_STRATEGY 和 KEY_GENERATE_STRATEGY 均可以引用已有算法,达到复用的目的,也可以通过语法糖快速定义,差异是会创建额外的算法对象。用户可根据场景灵活搭配使用。 3.6 配置验证 规则创建完毕后,我们可以通过如下方式进行验证: 3.6.1 检查节点分布 DistSQL 提供 SHOW SHARDING TABLE NODES的语法用于查看节点分布,帮助用户快速总览分片表的分布情况。使用方式如下: 从分片表的节点分布观察,与需求描述的分布一致。 3.6.2 SQL 预览 SQL 预览,也是验证配置的一种快捷的方式,语法是PREVIEW sql: 无分片键查询,全路由 2. 指定 user_id 查询,单库路由 3.指定 user_id 和 order_id,单表路由 单表路由扫描的分片表最少,效率最高。 3.7 辅助查询 DistSQL 在系统维护过程中,可能会出现不再使用的算法或存储资源需要释放,或是想要释放的资源被引用了无法删除,以下 DistSQL 可以为我们提供帮助: 3.7.1 查询未使用的资源 语法:SHOW UNUSED RESOURCES 示例: 3.7.2 查询未使用的主键生成器 语法:SHOW UNUSED SHARDING KEY GENERATORS 示例: 3.7.3 查询未使用的分片算法 1.语法:SHOW UNUSED SHARDING ALGORITHMS 2. 示例: 3.7.4 查询使用目标存储资源的规则 语法:SHOW RULES USED RESOURCE 示例: 使用了该资源的所有规则都会查询出来,不限于Sharding Rule。 3.7.5 查询使用目标主键生成器的分片规则 语法:SHOW SHARDING TABLE RULES USED KEY GENERATOR 示例: 3.7.6 查询使用目标算法的分片规则 语法:SHOW SHARDING TABLE RULES USED ALGORITHM 示例: ​​​​​​​ 4、结语 本篇以常用的数据分片场景为例,介绍了 DistSQL 的使用流程和应用技巧。同时,DistSQL 提供了灵活的语法糖以帮助减少操作步骤,用户可灵活选择使用。 在分片场景下,除了 INLINE 算法,DistSQL 也能完美支持其他的标准分片、复合分片、Hint 分片、自定义类分片算法,更多的应用案例将在后续的文章中为大家解读,敬请期待。 以上就是本次分享的全部内容,如果读者对 Apache ShardingSphere 有任何疑问或建议,欢迎在 GitHub issue 列表提出,或可前往中文社区交流讨论。 GitHub issue:https://github.com/apache/shardingsphere/issues 贡献指南:https://shardingsphere.apache.org/community/cn/contribute/ 中文社区:https://community.sphere-ex.com/ 5、参考文献 概念 DistSQL:https://shardingsphere.apache.org/document/current/cn/concepts/distsql/ 概念 分布式主键:https://shardingsphere.apache.org/document/current/cn/features/sharding/concept/key-generator/ 概念 分片策略:https://shardingsphere.apache.org/document/current/cn/features/sharding/concept/sharding/ 概念 行表达式:https://shardingsphere.apache.org/document/current/cn/features/sharding/concept/inline-expression/ 内置分片算法:https://shardingsphere.apache.org/document/current/cn/user-manual/shardingsphere-jdbc/builtin-algorithm/sharding/ 用户手册:DistSQLhttps://shardingsphere.apache.org/document/current/cn/user-manual/shardingsphere-proxy/distsql/syntax/ 作者 江龙滔,SphereEx 中间件研发工程师,Apache ShardingSphere Committer。 主要负责 DistSQL 及安全相关特性的创新与研发。 欢迎点击链接,了解更多内容: Apache ShardingSphere 官网:https://shardingsphere.apache.org/ Apache ShardingSphere GitHub 地址:https://github.com/apache/shardingsphere SphereEx 官网:https://www.sphere-ex.com 欢迎添加社区经理微信(ss_assistant_1)加入交流群,与众多 ShardingSphere 爱好者一同交流。

优秀的个人博客,低调大师

浪潮云溪分布式数据库 Tracing(二)—— 源码解析

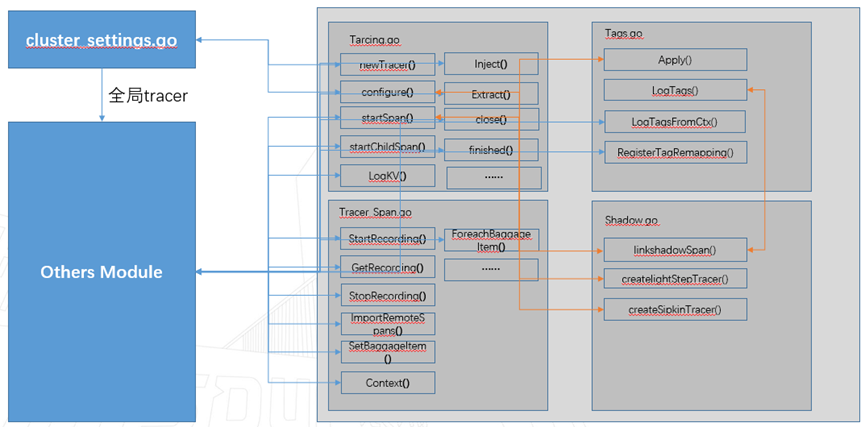
按照【云溪数据库Tracing(一)】介绍的使用opentracing要求,本文着重介绍云溪数据库Tracing模块中是如何实现Span,SpanContexts和Tracer的。 Part 1-Tracing 模块调用关系 1.1Traincg模块包含的文件列表 Tracer.go :定义了opentracing 中的trace相关接口的实现。 Tracer_span.go :定义了opentracing中的span 相关操作的实现。 Tags.go :定义了 opentracing中关于tags的相关接口。 Shadow.go :不是opentracing中的概念,这里主要实现与zipkin的通信,用于tracing 信息推送到外部的zipkin中。 1.2各个文件之间的调用关系 在cluster_settings.go中会创建tracer,供全局使用,其他模块中使用这个Tracer实现span的创建和其他操作,例如设定span名称、设定tag 、增加log等操作。 Part 2-Opentracing 在云溪数据库中的实现 以下是只是列出了部分接口实现,并非全部。 2.1Span 接口实现: GetContext实现:API用于获取Span中的SpanContext,主要功能是先创建一个map[string]string类型的baggageCopy,将span中的mu.Baggage读出写入baggageCopy,创建新的spanContext,并且返回。 func (s *span) Context() opentracing.SpanContext { s.mu.Lock() defer s.mu.Unlock() baggageCopy := make(map[string]string, len(s.mu.Baggage)) for k, v := range s.mu.Baggage { baggageCopy[k] = v } sc := &spanContext{ spanMeta: s.spanMeta, Baggage: baggageCopy, } if s.shadowTr != nil { sc.shadowTr = s.shadowTr sc.shadowCtx = s.shadowSpan.Context() } if s.isRecording() { sc.recordingGroup = s.mu.recordingGroup sc.recordingType = s.mu.recordingType } return sc} Finished实现:API用于结束一个Span的记录和追踪。​​​​​​ func (s *span) Finish() { s.FinishWithOptions(opentracing.FinishOptions{})} SetTag实现:用于向指定的Span添加Tag信息。 func(s*span)SetTag(keystring,valueinterface{})opentracing.Span{ return s.setTagInner(key, value, false /* locked */)} Log实现:用于向指定的Span添加Log信息。 func (s *span) LogKV(alternatingKeyValues ...interface{}) { fields, err := otlog.InterleavedKVToFields(alternatingKeyValues...) if err != nil { s.LogFields(otlog.Error(err), otlog.String("function", "LogKV")) return } s.LogFields(fields...)} SetBaggageItem实现:用于向指定的Span增加Baggage信息,主要是用于跨进程追踪使用。 func (s *span) SetBaggageItem(restrictedKey, value string) opentracing.Span { s.mu.Lock() defer s.mu.Unlock() return s.setBaggageItemLocked(restrictedKey, value)} BaggageItem实现:用于获取指定的Baggage信息。 func (s *span) BaggageItem(restrictedKey string) string { s.mu.Lock() defer s.mu.Unlock() return s.mu.Baggage[restrictedKey]} SetOperationName实现:用于设定Span 的名称。 func (s *span) SetOperationName(operationName string) opentracing.Span { if s.shadowTr != nil { s.shadowSpan.SetOperationName(operationName) } s.operation = operationName return s } Tracer实现:用于获取Span属于哪个Tracer。 // Tracer is part of the opentracing.Span interface.func (s *span) Tracer() opentracing.Tracer { return s.tracer } 2.2SpanContext 接口实现: ForeachBaggageItem实现:用于遍历spanContext中的baggage信息。 func (sc *spanContext) ForeachBaggageItem(handler func(k, v string) bool) { for k, v := range sc.Baggage { if !handler(k, v) { break } }} 2.3 Tracer接口实现: Inject实现:用于向carrier中注入SpanContext信息 // Inject is part of the opentracing.Tracer interface.func (t *Tracer) Inject( osc opentracing.SpanContext, format interface{}, carrier interface{},) error { …… // We onlysupport the HTTPHeaders/TextMap format. if format != opentracing.HTTPHeaders && format != opentracing.TextMap { return opentracing.ErrUnsupportedFormat } mapWriter, ok := carrier.(opentracing.TextMapWriter) if !ok { return opentracing.ErrInvalidCarrier } sc, ok := osc.(*spanContext) if !ok { return opentracing.ErrInvalidSpanContext } mapWriter.Set(fieldNameTraceID, strconv.FormatUint(sc.TraceID, 16)) mapWriter.Set(fieldNameSpanID, strconv.FormatUint(sc.SpanID, 16)) for k, v := range sc.Baggage { mapWriter.Set(prefixBaggage+k, v) } …… return nil} Extract实现:用于从carrier中抽取出SpanContext信息。 func (t *Tracer) Extract(format interface{}, carrier interface{}) (opentracing.SpanContext, error) { // We onlysupport the HTTPHeaders/TextMap format. if format != opentracing.HTTPHeaders && format != opentracing.TextMap { return noopSpanContext{}, opentracing.ErrUnsupportedFormat } mapReader, ok := carrier.(opentracing.TextMapReader) if !ok { return noopSpanContext{}, opentracing.ErrInvalidCarrier } var sc spanContext …… err :=mapReader.ForeachKey(func(k, v string) error { switch k = strings.ToLower(k); k { case fieldNameTraceID: var err error sc.TraceID, err = strconv.ParseUint(v, 16, 64) if err != nil { return opentracing.ErrSpanContextCorrupted } case fieldNameSpanID: var err error sc.SpanID, err = strconv.ParseUint(v, 16, 64) if err != nil { return opentracing.ErrSpanContextCorrupted } case fieldNameShadowType: shadowType = v default: if strings.HasPrefix(k, prefixBaggage) { if sc.Baggage == nil { sc.Baggage = make(map[string]string) } sc.Baggage[strings.TrimPrefix(k, prefixBaggage)] = v } else if strings.HasPrefix(k, prefixShadow) { if shadowCarrier == nil { shadowCarrier = make(opentracing.TextMapCarrier) } // We build ashadow textmap with the original shadow keys. shadowCarrier.Set(strings.TrimPrefix(k, prefixShadow), v) } } return nil }) if err != nil { return noopSpanContext{}, err } if sc.TraceID == 0 &&sc.SpanID == 0 { return noopSpanContext{}, nil } …… return &sc, nil} StartSpan接口实现:用于创建一个新的Span,可根据传入不同opts来实现不同Span的初始化。 func (t *Tracer) StartSpan( operationName string, opts ...opentracing.StartSpanOption,) opentracing.Span { // Fast paths toavoid the allocation of StartSpanOptions below when tracing // is disabled: if we have no optionsor a single SpanReference (the common // case) with a noop context, return anoop span now. if len(opts) == 1 { if o, ok := opts[0].(opentracing.SpanReference); ok { if IsNoopContext(o.ReferencedContext) { return &t.noopSpan } } } shadowTr := t.getShadowTracer() …… return s} 2.4 noop span 实现: noop span实现:使监控代码不依赖Tracer和Span的返回值,防止程序异常退出。 type noopSpan struct { tracer *Tracer} var _ opentracing.Span = &noopSpan{} func (n *noopSpan) Context() opentracing.SpanContext { return noopSpanContext{} }func (n *noopSpan) BaggageItem(key string) string { return "" }func (n *noopSpan) SetTag(key string, value interface{}) opentracing.Span { return n }func (n *noopSpan) Finish() {}func (n *noopSpan) FinishWithOptions(opts opentracing.FinishOptions) {}func (n *noopSpan) SetOperationName(operationName string) opentracing.Span { return n }func (n *noopSpan) Tracer() opentracing.Tracer { return n.tracer }func (n *noopSpan) LogFields(fields ...otlog.Field) {}func (n *noopSpan) LogKV(keyVals ...interface{}) {}func (n *noopSpan) LogEvent(event string) {}func (n *noopSpan) LogEventWithPayload(event string, payload interface{}) {}func (n *noopSpan) Log(data opentracing.LogData) {} func (n *noopSpan) SetBaggageItem(key, val string) opentracing.Span { if key == Snowball { panic("attempting to set Snowball on a noop span; use the Recordable optionto StartSpan") } return n} Part3-云溪数据库中 Opentracing 简单使用示例 3.1 开启Tracer Recording测试 云溪数据库中 开始创建的span均是no operator span,需要手动调用StartRecording,将span转换为可record状态,才能正常对span进行操作。 func TestTracerRecording(t *testing.T) { tr := NewTracer() noop1 := tr.StartSpan("noop") if _, noop := noop1.(*noopSpan); !noop { t.Error("expected noop span") } noop1.LogKV("hello", "void") noop2 := tr.StartSpan("noop2", opentracing.ChildOf(noop1.Context())) if _, noop := noop2.(*noopSpan); !noop { t.Error("expected noop child span") } noop2.Finish() noop1.Finish() s1 := tr.StartSpan("a", Recordable) if _, noop := s1.(*noopSpan); noop { t.Error("Recordable (but not recording) span should not be noop") } if !IsBlackHoleSpan(s1) { t.Error("Recordable span should be black hole") } // Unless recording is actually started, child spans are still noop. noop3 := tr.StartSpan("noop3", opentracing.ChildOf(s1.Context())) if _, noop := noop3.(*noopSpan); !noop { t.Error("expected noop child span") } noop3.Finish() s1.LogKV("x", 1) StartRecording(s1, SingleNodeRecording) s1.LogKV("x", 2) s2 := tr.StartSpan("b", opentracing.ChildOf(s1.Context())) if IsBlackHoleSpan(s2) { t.Error("recording span should not be black hole") } s2.LogKV("x", 3) if err := TestingCheckRecordedSpans(GetRecording(s1), ` span a: tags: unfinished= x: 2 span b: tags: unfinished= x: 3 `); err != nil { t.Fatal(err) } if err := TestingCheckRecordedSpans(GetRecording(s2), ` span b: tags: unfinished= x: 3 `); err != nil { t.Fatal(err) } s3 := tr.StartSpan("c", opentracing.FollowsFrom(s2.Context())) s3.LogKV("x", 4) s3.SetTag("tag", "val") s2.Finish() if err := TestingCheckRecordedSpans(GetRecording(s1), ` span a: tags: unfinished= x: 2 span b: x: 3 span c: tags: tag=val unfinished= x: 4 `); err != nil { t.Fatal(err) } s3.Finish() if err := TestingCheckRecordedSpans(GetRecording(s1), ` span a: tags: unfinished= x: 2 span b: x: 3 span c: tags: tag=val x: 4 `); err != nil { t.Fatal(err) } StopRecording(s1) s1.LogKV("x", 100) if err := TestingCheckRecordedSpans(GetRecording(s1), ``); err != nil { t.Fatal(err) } // The child span is still recording. s3.LogKV("x", 5) if err := TestingCheckRecordedSpans(GetRecording(s3), ` span c: tags: tag=val x: 4 x: 5 `); err != nil { t.Fatal(err) } s1.Finish()} 3.2 创建childSpan 测试 测试StartChildSpan,根据已有span创建出一个新的span,为已有span的子span。 func TestStartChildSpan(t *testing.T) { tr := NewTracer() sp1 := tr.StartSpan("parent", Recordable) StartRecording(sp1, SingleNodeRecording) sp2 := StartChildSpan("child", sp1, nil /* logTags */, false /*separateRecording*/) sp2.Finish() sp1.Finish() if err := TestingCheckRecordedSpans(GetRecording(sp1), ` span parent: span child: `); err != nil { t.Fatal(err) } sp1 = tr.StartSpan("parent", Recordable) StartRecording(sp1, SingleNodeRecording) sp2 = StartChildSpan("child", sp1, nil /* logTags */, true /*separateRecording*/) sp2.Finish() sp1.Finish() if err := TestingCheckRecordedSpans(GetRecording(sp1), ` span parent: `); err != nil { t.Fatal(err) } if err := TestingCheckRecordedSpans(GetRecording(sp2), ` span child: `); err != nil { t.Fatal(err) } sp1 = tr.StartSpan("parent", Recordable) StartRecording(sp1, SingleNodeRecording) sp2 = StartChildSpan( "child", sp1, logtags.SingleTagBuffer("key", "val"), false, /*separateRecording*/ ) sp2.Finish() sp1.Finish() if err := TestingCheckRecordedSpans(GetRecording(sp1), ` span parent: span child: tags: key=val `); err != nil { t.Fatal(err) }} 3.3 跨进程追踪测试 测试跨进程追踪功能,主要是测试inject接口和 extract 接口,Inject用于向carrier中注入SpanContext信息,Extract用于从carrier中抽取出SpanContext信息。 funcTestTracerInjectExtract(t*testing.T){ tr := NewTracer() tr2 := NewTracer() // Verify that noop spans become noop spans on the remote side. noop1 := tr.StartSpan("noop") if _, noop := noop1.(*noopSpan); !noop { t.Fatalf("expected noop span: %+v", noop1) } carrier := make(opentracing.HTTPHeadersCarrier) if err := tr.Inject(noop1.Context(), opentracing.HTTPHeaders, carrier); err != nil { t.Fatal(err) } if len(carrier) != 0 { t.Errorf("noop span has carrier: %+v", carrier) } wireContext, err := tr2.Extract(opentracing.HTTPHeaders, carrier) if err != nil { t.Fatal(err) } if _, noopCtx := wireContext.(noopSpanContext); !noopCtx { t.Errorf("expected noop context: %v", wireContext) } noop2 := tr2.StartSpan("remote op", opentracing.FollowsFrom(wireContext)) if _, noop := noop2.(*noopSpan); !noop { t.Fatalf("expected noop span: %+v", noop2) } noop1.Finish() noop2.Finish() // Verify that snowball tracing is propagated and triggers recording on the // remote side. s1 := tr.StartSpan("a", Recordable) StartRecording(s1, SnowballRecording) carrier = make(opentracing.HTTPHeadersCarrier) if err := tr.Inject(s1.Context(), opentracing.HTTPHeaders, carrier); err != nil { t.Fatal(err) } wireContext, err = tr2.Extract(opentracing.HTTPHeaders, carrier) if err != nil { t.Fatal(err) } s2 := tr2.StartSpan("remote op", opentracing.FollowsFrom(wireContext)) // Compare TraceIDs trace1 := s1.Context().(*spanContext).TraceID trace2 := s2.Context().(*spanContext).TraceID if trace1 != trace2 { t.Errorf("TraceID doesn't match: parent %d child %d", trace1, trace2) } s2.LogKV("x", 1) s2.Finish() // Verify that recording was started automatically. rec := GetRecording(s2) if err := TestingCheckRecordedSpans(rec, ` span remote op: tags: sb=1 x: 1 `); err != nil { t.Fatal(err) } if err := TestingCheckRecordedSpans(GetRecording(s1), ` span a: tags: sb=1 unfinished= `); err != nil { t.Fatal(err) } if err := ImportRemoteSpans(s1, rec); err != nil { t.Fatal(err) } s1.Finish() if err := TestingCheckRecordedSpans(GetRecording(s1), ` span a: tags: sb=1 span remote op: tags: sb=1 x: 1 `); err != nil { t.Fatal(err) }}

优秀的个人博客,低调大师

浪潮云溪分布式数据库协议代码解析(2)

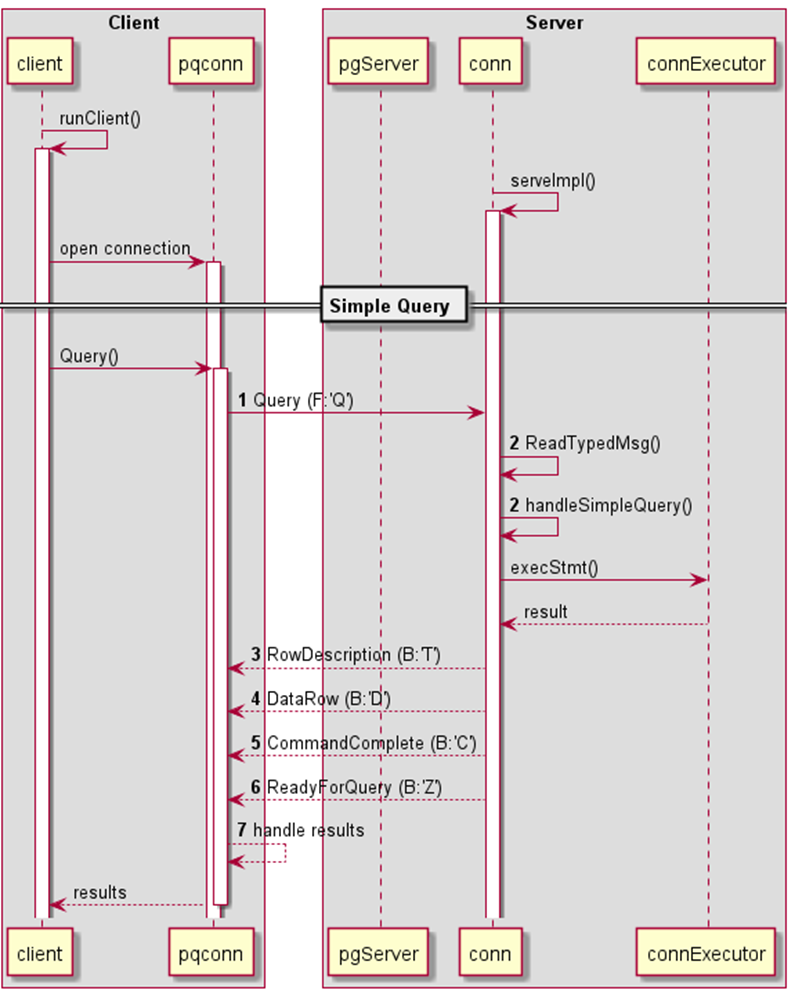
- 数据请求阶段 - Part 1 - 简单查询 1.客户端发送Query (‘Q’)消息给服务端,包含了一条字符串类型的SQL语句。 func(cn *conn) query(query string, args []driver.Value)(_ *rows, err error){ ... // Check to see if we can use the "simpleQuery"interface, which is // *much* faster than going through prepare/exec iflen(args)==0{ return cn.simpleQuery(query) } ...} 2.服务端收到Query消息,解析SQL语句,生成抽象语法树(AST),并传给执行器执行,获得结果。 func(c *conn) serveImpl( ctx context.Context, draining func()bool, sqlServer *sql.Server, reserved mon.BoundAccount, stopper *stop.Stopper,)error{ ...Loop: for{ typ, n, err = c.readBuf.ReadTypedMsg(&c.rd) if err !=nil{ break Loop } ... switch typ { case pgwirebase.ClientMsgSimpleQuery: ... case pgwirebase.ClientMsgExecute: ... case pgwirebase.ClientMsgParse: ... case pgwirebase.ClientMsgDescribe: ... case pgwirebase.ClientMsgBind: ... case pgwirebase.ClientMsgSync: ... } } ...} 3.服务端根据SQL结果,首先发送RowDescription(B:‘T’)消息,包含列的数量,列名,列的类型等参数。​​​​​​​ func(c *conn) writeRowDescription( ctx context.Context, columns []sqlbase.ResultColumn, formatCodes []pgwirebase.FormatCode, w io.Writer,)error{ c.msgBuilder.initMsg(pgwirebase.ServerMsgRowDescription) c.msgBuilder.putInt16(int16(len(columns))) for i, column :=range columns { ... c.msgBuilder.writeTerminatedString(column.Name) ... c.msgBuilder.putInt32(0)//Table OID (optional). c.msgBuilder.putInt16(0)//Column attribute ID (optional). c.msgBuilder.putInt32(int32(typ.oid)) c.msgBuilder.putInt16(int16(typ.size)) ... } ...} 4. RowDescription消息后面将跟着多个DataRow(B:‘D’)消息,每个DataRow消息包含一行的数据。 func(c *conn) bufferRow( ctx context.Context, row tree.Datums, formatCodes []pgwirebase.FormatCode, convsessiondata.DataConversionConfig, types []*types.T,){ c.msgBuilder.initMsg(pgwirebase.ServerMsgDataRow) c.msgBuilder.putInt16(int16(len(row))) for i, col :=range row { ... switch fmtCode { case pgwirebase.FormatText: c.msgBuilder.writeTextDatum(ctx, col, conv, types[i]) case pgwirebase.FormatBinary: c.msgBuilder.writeBinaryDatum(ctx, col, conv.Location, types[i]) ... } if err := c.msgBuilder.finishMsg(&c.writerState.buf); err !=nil{ panic(fmt.Sprintf("unexpected err from buffer: %s", err)) }} 5.发送CommandComplete(B:‘C’)消息表示这个SQL请求执行结束了。 6.服务端发送ReadyForQuery(‘Z’),通知客户端可以发送下一条SQL请求了。 func(r *commandResult) Close(ctx context.Context, t sql.TransactionStatusIndicator){ ... switch r.typ { case commandComplete: tag := cookTag( r.cmdCompleteTag, r.conn.writerState.tagBuf[:0], r.stmtType, r.rowsAffected, ) r.conn.bufferCommandComplete(tag) case parseComplete: r.conn.bufferParseComplete() case bindComplete: r.conn.bufferBindComplete() case closeComplete: r.conn.bufferCloseComplete() case readyForQuery: r.conn.bufferReadyForQuery(byte(t)) // The error is saved on conn.err. _ /* err */= r.conn.Flush(r.pos) ... } ...} 7.客户端根据接受SQL请求的结果。 func(cn *conn) simpleQuery(q string)(res *rows, err error){ b := cn.writeBuf('Q') b.string(q) cn.send(b) for{ t, r := cn.recv1() switch t { case'C','I': ... case'Z': ... case'E': ... case'D': ... case'T': ... } }} Part 2 - 扩展查询 1.客户端发送扩展查询请求,依次发送Parse (F:‘P’), Bind (F:‘B’), Describe (F:‘D’), Execute (F:‘E’), Sync(F:‘S’)消息。 func(cn *conn) query(query string, args []driver.Value)(_ *rows, err error){ ... if cn.binaryParameters { cn.sendBinaryModeQuery(query, args) cn.readParseResponse() cn.readBindResponse() rows :=&rows{cn: cn} rows.rowsHeader = cn.readPortalDescribeResponse() cn.postExecuteWorkaround() return rows,nil } ...} func(cn *conn) sendBinaryModeQuery(query string, args []driver.Value){ b := cn.writeBuf('P') b.byte(0)//unnamed statement b.string(query) b.int16(0) b.next('B') b.int16(0)//unnamed portal and statement cn.sendBinaryParameters(b, args) b.bytes(colFmtDataAllText) b.next('D') b.byte('P') b.byte(0)//unnamed portal b.next('E') b.byte(0) b.int32(0) b.next('S') cn.send(b)} 2.服务端处理扩展查询请求。 3.服务端发送回应消息,ParseComplete (B:‘1’), BindComplete (B:‘2’), ParameterDescription(B:‘t’), CommandComplete (B:‘C’), CloseComplete (B:‘3’), ReadyForQuery (B:‘Z’)。​​​​​​​ func(r *commandResult) Close(ctx context.Context, t sql.TransactionStatusIndicator){ ... switch r.typ { case commandComplete: tag := cookTag( r.cmdCompleteTag, r.conn.writerState.tagBuf[:0], r.stmtType, r.rowsAffected, ) r.conn.bufferCommandComplete(tag) case parseComplete: r.conn.bufferParseComplete() case bindComplete: r.conn.bufferBindComplete() case closeComplete: r.conn.bufferCloseComplete() case readyForQuery: r.conn.bufferReadyForQuery(byte(t)) // The error is saved on conn.err. _ /* err */= r.conn.Flush(r.pos) ... } ...}

优秀的个人博客,低调大师

浪潮云溪分布式数据库协议代码解析(1)

云溪数据库支持PostgreSQL protocol 3.0,用于客户端与服务端之间的信息通信,应用于连接认证及数据请求阶段。 PostgreSQL协议的消息通用格式如下图所示,包含1字节的消息类型,4字节的长度(不包括类型的长度),以及消息的内容。由于历史原因,startup消息不包含类型。 Part 1 -连接认证阶段 1.用户使用客户端,通过云溪数据库sql命令,尝试连接服务端时,客户端会获取连接命令的参数,生成URL,具体格式如下 postgres://<username>:<password>@<host>:<port>/<database>?<parameters> 其中,包含了当前用户的用户名和密码,节点的IP地址和端口,连接的数据库库名,以及额外的连接参数。 2.客户端会根据URL,建立与服务端之间的连接,发送一个startup消息。 func(c *Connector) open(ctx context.Context)(cn *conn, err error){ ... cn.startup(o) ...} 上述代码,将构建一个startup消息,该消息没有消息类型,包含了协议版本号,和连接参数等内容。 3.服务端接收解析startup消息,获得连接参数。 func(s *Server) ServeConn(ctx context.Context, conn net.Conn)error{ ... var buf pgwirebase.ReadBuffer n, err := buf.ReadUntypedMsg(conn) if err !=nil{ return err } version, err := buf.GetUint32() if err !=nil{ return err } ... // get connection parameters if sArgs, err = parseOptions(ctx, buf.Msg); err !=nil{ return sendErr(err) } ...} 4.服务端发送AuthenticationRequest消息,要求客户端进一步提供认证信息,以进行用户身份认证。​​​​​​​​​​​​​​​​​​​​​​​​​​​​ func authPassword( c AuthConn, tlsState tls.ConnectionState, insecure bool, hashedPassword []byte, validUntil *tree.DTimestamp, encryption string, execCfg *sql.ExecutorConfig, entry *hba.Entry,)(security.UserAuthHook,error){ if err := c.SendAuthRequest(authCleartextPassword,nil); err !=nil{ returnnil,err } // recevice password from client password, err := c.ReadPasswordString() ...} 认证请求消息中,除了消息类型’R’外,还包含认证方式,目前云溪数据库支持证书、口令和GSSAPI三种认证方式。证书认证不需要额外的认证信息,认证通过后直接发送AuthenticationOk消息,跳过5、6。 5.客户端收到AuthenticationRequest消息后,则会发送对应的认证信息,回应此消息,该回应的消息类型为’p’。​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​ func(cn *conn) startup(o values){ ... for{ // recevice responses after sending startup t, r := cn.recv() switch t { case'K': cn.processBackendKeyData(r) case'S': cn.processParameterStatus(r) case'R': cn.auth(r, o) case'Z': cn.processReadyForQuery(r) return default: errorf("unknown response forstartup: %q",t) } }} func(cn *conn) auth(r *readBuf, o values){ switch code := r.int32(); code { case0: // OK case3: w := cn.writeBuf('p') w.string(o["password"]) cn.send(w) ... case7:// GSSAPI, startup ... w := cn.writeBuf('p') w.bytes(token) cn.send(w) ... }} 6.服务端收到认证回应后,进行用户的身份认证。 7.服务端认证完成后,给客户端发送认证结果。成功,发送AuthenticationOk(‘R’),authType为0;失败,则发送ErrorResponse(‘E’),连接过程结束。​​​​​​​​​​​​​​ func(c *conn) handleAuthentication( ctx context.Context, insecure bool, ie *sql.InternalExecutor, auth *hba.Conf, execCfg *sql.ExecutorConfig,)(authErr error){ ... c.msgBuilder.initMsg(pgwirebase.ServerMsgAuth) c.msgBuilder.putInt32(authOK) return c.msgBuilder.finishMsg(c.conn)} 8.服务端认证完成后,将发送多条参数信息ParameterStatus(‘S’),包括server_version, client_encoding和DateStyle等参数。每个参数,都会发送一条ParameterStatus消息。​​​​​​​ func(c *conn) serveImpl( ctx context.Context, draining func()bool, sqlServer *sql.Server, reserved mon.BoundAccount, stopper *stop.Stopper,)error{ ... sendStatusParam:=func(param, value string)error{ c.msgBuilder.initMsg(pgwirebase.ServerMsgParameterStatus) c.msgBuilder.writeTerminatedString(param) c.msgBuilder.writeTerminatedString(value) return c.msgBuilder.finishMsg(c.conn) } ... for _, param :=range statusReportParams { value := connHandler.GetStatusParam(ctx, param) if err := sendStatusParam(param, value); err !=nil{ return err } } } ...} 9.服务端发送ReadyForQuery(‘Z’),表示一切准备就绪,通知客户端可以发送SQL请求了。​​​​​​​ func(c *conn) serveImpl( ctx context.Context, draining func()bool, sqlServer *sql.Server, reserved mon.BoundAccount, stopper *stop.Stopper,)error{ ... // An initial readyForQuery message is part of the handshake. c.msgBuilder.initMsg(pgwirebase.ServerMsgReady) c.msgBuilder.writeByte(byte(sql.IdleTxnBlock)) if err := c.msgBuilder.finishMsg(c.conn); err !=nil{ return err } ...}​​​​​​​ 至此,客户端与服务端之间,已经成功建立起连接,用户可以执行后续操作了。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册