首页 文章 精选 留言 我的

精选列表

搜索[内存黑科技],共10011篇文章
优秀的个人博客,低调大师

无痛减肥黑科技:拍照识热量

一直以来,横亘在减肥塑身的志士仁人面前的除了坚定的意志还有一道很难逾越的坎:每天的摄入热量怎么算? 对于统计每天步数和大致热量消耗的设备,我们有手环、watch、手机;但每天的热量摄入,怎么计算呢? 每次就餐带上纸、笔、记算器,不太现实。用热量计算app,需要手动输入每样食品吃了多少克,没有厨房称的帮助下,对大多数人来说,要感知50g和75g的区别比较困难。 当AI作为一个形容词,几乎可以应用在任何领域的时候,减肥这个领域,似乎还没有被充分开垦。 iDST数据实验室的算法同学,正致力于做一个小小的改变: 帮助用户,通过拍一张照片,识别照片里包含的食材和对应的营养成份;通过选择对应的份量,还可以算出大致热量。 到目前为止,已实现对大部分常见的食物:中餐各式菜肴、面点、水果、饮料的识别,覆盖了几千种南北食材。目前,该模型已经上线内测,我们也会努力尝试成为减肥界的一股清流。 ps,如果正在减肥的同学想抢先上手尝试,请直接拉到页面底部试用~ 让手机镜头,识别面前的每一种食物,输出它们的营养、热量和做法,我们是怎么做的? 一、数据收集和处理: 首先是大量的数据收集和知识库的建设。 我们通过各类网站:搜索引擎、点评和外卖、淘宝商品和用户评价、获取了几千万张食物相关的图片。 根据解析到的实体标签以及映射到后台的知识库,把所有的图片分成对应为后台食材的3000个左右的叶子类。从实拍集和训练效果的角度,保证每一个叶子类有至少2000张以上的训练数据。 二、训练框架和方法: 食材识别的难点在哪里? 与通常的图像分类算法相比,通过拍照识别食材并估算热量是一个异常艰巨的任务。因为烹调食品是一个复杂且漫长的过程,期间各种食材会经历多种物理和化学甚至生物变化。 例如,刀工会使得食材发生物理变化。即使是标准的刀工,也会将原先的食材加工为片、丁、丝、条、茸、段、麦穗型、梳子型、菊花形、米状、末等完全不同的形状。即便是同样的片状,还会细分为指甲片、柳叶片、月牙片、骨牌片、象眼片、马牙片、秋叶片等不同的模样。形状的多变无疑增加了识别的难度。 烹饪中的化学反应进一步增加了识别的难度。例如,随着烹饪过程中化学反应的发生,食材的颜色通常会发生变化,有些食材的颜色会与烹饪之前有很大的反差。 有些食材例如蛋白质会从液态变为固态,有些水溶性的食材会从固态变为液态。涉及到发酵等生物反应的烹饪过程时,食材会进一步变的面目全非。 在实际的识别过程中,有些食材只露出小小的一角,而有些菜,如水煮鱼,看到的是上面的鱼片,用户会希望模型还有对应的知识,即鱼片的下面,其实铺满了豆芽。 由此,食材的识别和通常的图片识别和分类算法相比,有更多的困难。 我们的方法 针对食材识别的问题,我们的方法是:使用深度学习的方法,将黑盒的神经网络与白盒的烹饪领域知识结合起来,同时确保训练数据的数量和质量。 我们综合评估了:GoogleNet, AlexNet, VGG, GoogleNet+BatchNorm 以及Caffe和TensorFlow,从Top5 ACC (输出的前5个结果的准确率)的角度,上述框架没有存在显著的差异性。目前我们采用的是Caffe以及GoogleNet 和 ImageNet,更多的是从工程的可伸缩性,支持并发部署的角度来考虑的。 三、挑战和业界评测: 在饮食领域的图像识别和分类上面,业内一直有关注和研究,比如下面的paper: Deep Learning Based Food RecognitionDeepFood: Deep Learning-based Food Image Recognition for Computer-aided Dietary AssessmentChineseFoodNet: A large-scale Image Dataset for Chinese Food RecognitionNutriNet: A Deep Learning Food and Drink Image Recognition System for Dietary AssessmentChinFood1000: A Large Benchmark Dataset for Chinese Food RecognitionLearning Cross-modal Embeddings for Cooking Recipes and Food Images 对上述paper中的方法进行比较,基本上是 基于AlexNet,Vgg,Gnet,ResNet,今年CVPR的DenseNet做修改,细节有差异。 从数据集和分类目标两个层面,在启动之初,我们就站在比目前业界更高的起点上。 上面是几个用于做公开测评的通用数据集的数据情况,我们可以看到上述通用测试集的分类较少,每一个分类的样本数量相对均匀。从千万级的数据规模和过千的分类数量上看, 我们的数据规模是比较庞大的。 从分类目标上,我们首先识别食材(而非菜名),进而解析出营养成分和热量,从场景上能够较完整地反映用户健康和饮食习惯。从食材的数量和烹饪方式上看,中餐的识别相较于西餐要困难,识别食材又比菜名更困难。 识别效果评测,目前业内的最好成绩是: 数据集名称 分类数量 数据集大小 准确率 备注 Food-101 101 101,000 88.28% 基于GoogleNet UEC FOOD 100 100 9,060 81.45% 日餐为主 UEC FOOD 256 256 31,397 76.17% 基于GoogleNet UNIMIB 2016 65 3616 86.39% 基于AlexNet Paper作者自有集 520 220,000 86.72% Paper作者实拍集 520 200 55% 从目前结果上看,我们的效果远远领先于MIT的CSAIL和业内在食物(中餐)上识别能力。 四、拍食物有什么用 对大家日常饮食有什么用? 当食物的营养和热量识别,简化成只需要轻点拍摄这一步之后,我们可以帮助用户记录日常的饮食摄入。 有了日常记录以后,可以从膳食结构角度,帮助用户分析摄入的营养和食材的均衡情况,基于中国居民膳食指南,同时参考美国、日本等居民膳食指南,给出饮食建议。这就是营养师口中的“营养干预”,帮助减肥、增脂、增肌都是这个范畴。 You are what you eat,人的健康除了先天、环境因素之外,最大的影响因子就是饮食习惯。 从模型训练和算法的角度,当学会识别食材以后,后续将学会识别菜谱名称,从而告诉你做法,以及,从千万个淘宝和天猫商品中,根据菜谱为你选出:主料、辅料、佐料。 从此以后,正确的美食打开方式应该是: 输入菜肴名称,看完菜谱做法以后,根据算法为你准备好的:主料、辅料、佐料,轻触点击,一键加入购物车。等着食材送上门以后一显身手吧。 切换成线下,到菜市场买菜也没问题,打开手机,拍一拍面前的生鲜食材,它叫什么,营养元素和热量,有哪些做法,可以搭配哪些食材一起烹饪,即时为你呈现。 作为iDST图像识别能力的输出,拍美食是“万物识别”项目的一部分,目标是致力于让AI使我们的生活越来越美好。如果希望体验上述技术,快捷传送门: 亲问app二维码

优秀的个人博客,低调大师

说说云盘背后的黑科技!

***当下,随着存储技术的飞速发展,各大公司都推出了云存储服务。但因为是免费面向大众的,无论微软的OneDrive还是百度的云网盘,好多人都难理解他们如何支撑起如此庞大的存储空间。就百度网盘而言 ,每个用户都可以免费得至少两个T的空间。其实百度并没有财力雄厚到为每个良好公民够买一个2T的硬盘,我们上传最多的无非是文本、图片、音频和视频,其中视频容量最最大,百度公司只要搞定“视频”这一关就足以撑起这一庞大的商业应用。据我自己总结,这背后主要有三点主要策略! 1.第一点,也是都能猜到的一点,大部分用户面对这2T的容量自然不会一下全部用完,据统计平均每个用户只上传了50~60M的文件,那么剩下的空间自然不会给你闲在那,百度也不傻,自然是存放其他人的上传文件。其实具体实施时,百度有一个存储器集群专门存放用户文件,我们每个人的空间都是一个虚拟(virtual)硬盘,而且它的大小是弹性的,按需分配,所有人的文件按上传时间顺序依次存放。而在终端用户上还显示的是连续的2T空间,这样宝贵的服务器硬盘空间不就节省出来了吗? 2.第二点,程序员发现,与邮箱不同,网盘里大家上传的内容有很多重复,尤其是电影电视剧,常常对于一个视频有上千次的重复上传。那么机会来了,显然只要对同一种文件存放一份,用户们共享它即可。但是计算机如何识别两个相同的文件呢?光比较文件名当然不行,这时厂商会利用哈希算法(Hash)算出每个文件的哈希值,哈希值相同则文件相同,要知道文件改变一个字符就会对哈希值产生天差地别的变化。然而如果每个文件上传时都计算的话,服务器的cpu很容易负荷超载,于是聪明的程序员想到一个办法,就是让客户机自己算,算完后再一起上传,这样算出之后若发现已经有重复就干脆不用上传了,直接在用户界面标记“秒传”。所以程序员写了个小软件或小插件,美其名曰“上传控件”,下载后会访问我们的cpu,成功圆事儿! 3.第三点,也是最强的一招,先要说到我们为什么要上传那些电影等视频了。比如好多人会把上传一些从优酷下载下来的视频和音乐,一个原因是看地方便,另一个原因是为了收藏老视频,防止哪天网上再也找不到了(或者要收费)。但百度知道这些视频网站的更新策略啊,百度资深的合作伙伴们会向百度提供视频的地址,并提供快速通道。这样一来借他人之手,百度网盘无需花费一个字节就可以实现各大网站视频的海量存储!! ——By Jim***

优秀的个人博客,低调大师

黑科技:利用机器发热盗取数据

互联网没有绝对的安全,除非你不上网。所以对保密要求高的场合,如军事系统、支付网络、工控系统等往往会采用所谓的气隙系统—即本身与互联网隔绝,而且也不与上网的其他计算机连接。要想攻破这样的系统通常需要能物理访问到机器,利用USB等可移动介质或者通过火线接口直接与另一台计算机连接才有机会。 但这样就安全了吗? 未必! 以色列本古里安(Ben Gurion)大学的研究人员发明了一种名为BitWhisper的新型攻击方式。攻击者可透过这种方式可以偷偷从气隙系统窃走密码或密钥,然后传输至附近的受攻击者控制的联网系统,同时还可以通过联网系统发送恶意指令给气隙系统,整个过程无需联网,只需要机器发热以及计算机内置的热传感器。 这种处于概念验证阶段的攻击手法要求两台机器都要预先植入恶意软件,目前其数据传输率尚低得可怜:1小时仅能传输8位数据,不过用来传送简单

优秀的个人博客,低调大师

Weex黑科技——提升用户体验实践

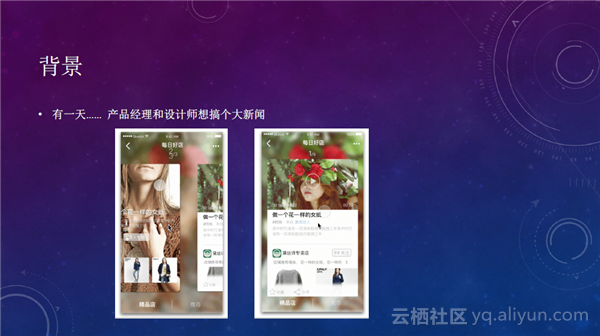
在2017年1月12日 Weex Conf 2017上,来自阿里的寒泉结合Weex的背景、动画和手势的技术分析,从Weex存在的实际问题入手,提出了新的构想和新方案expression binding。Weex总体来说性能较好,能够解决很多问题,具有协同多个业务在同一个大型APP上的能力,本文主要介绍怎么样通过Weex提升用户体验。 背景 基于某个业务,产品经理和设计师想实现一个页面,该页面是卡片型的List,既能像List一样水平方向滑动,又能在垂直方向获取类似详情页的功能,这种需求在web时代比较难实现。但是有了Weex之后,这个设计变得相对容易了。 技术分析 我们首先需要把效果拆成我们所能够认识的特性。实际上,效果是非常复杂的,是同时几个动画在一起变。我们可以看到,在横滑过程中,最显眼的是卡片的变化,卡片随着手指的拖动产生了大小的变

优秀的个人博客,低调大师

PostgreSQL 物联网黑科技 - 阅后即焚

在物联网应用场景中,有大量的传感器,会产生非常大量的消息以极高的并发进入数据库。 这些数据如果直接进入面向OLAP场景设计的数据仓库,数据实时入库会成为瓶颈,并且OLAP系统很难接受非常高并发的请求。 面对这样的应用场景,这些既要又要还要怎么满足呢? .1. 既要实时入库, .2. 又要实时分析, .3. 还要历史留档,应对随时变化的分析需求。 实时入库比较容易满足,我前些天写过一篇 "PostgreSQL 如何潇洒的处理每天上百TB的数据增量" https://yq.aliyun.com/articles/8528 实时分析也比较好满足,我前些天写过一篇 "PostgreSQL "物联网"应用 - 1 实时流式数据处理案例(万亿每天)" https://yq.aliyun.com/articles/

优秀的个人博客,低调大师

Solon v3.7 黑科技:消灭空指针异常!

生产环境的NullPointerException一直是困扰 Java 开发者的"幽灵"。每个人都遭遇过:这段代码在本地开发环境运行得好好的,但到了生产环境却莫名其妙地抛出 NPE 或触发其他边界异常。 问题的根源在于:Java 传统的类型检查无法在编译期区分可空与非空类型。 当你看到User findUser(String id)这样的方法签名时,返回值是否可能为 null?完全无从知晓。开发者只能依靠文档注释或运行时测试来发现,而边界条件往往在生产环境被触发时才暴露出来。 JSpecify:编译期进行非空检测 JSpecify 是一套现代化的 Java 空安全注解规范,旨在解决传统类型系统的盲区。它最核心的理念是:让类型系统携带空值信息,并在编译期进行验证。 Solon v3.7 正式采用 JSpecify 注解体系,这不仅仅是注解库的简单替换,而是将空安全检查从"运行时发现"提升到"编译期预防"的根本性变革。通过@NullMarked和@Nullable注解的组合,配合静态分析工具(如NullAway),开发者可以: 编译期捕获潜在的 NPE:不再等到运行时才发现空指针问题 显式化空值契约:方法签名明确告知调用者哪些值可能为 null 减少防御性代码:不再需要"以防万一"的过度空值检查 提升代码可维护性:团队成员无需深入实现就能理解 API 的空值语义 Solon v3.7 新特性 Solon v3.7 引入了一个简洁而强大的核心概念:默认非空(non-null by default)。与其假设所有对象都可能为空(并在代码中添加大量防御性空值检查),不如明确标注例外情况——那些真正可能为空的对象。 以下是实际应用对比: // Solon v3.7 之前 - 返回值是否可空?无从知晓! import org.noear.solon.annotation.Managed; @Managed public class PigUserService { public PigUser findUserByUsername(String username) { return pigUserRepository.findByUsername(username); // 可能返回 null } } // Solon v3.7 使用 JSpecify - 显式标注可空性 import org.jspecify.annotations.NullMarked; import org.jspecify.annotations.Nullable; import org.noear.solon.annotation.Managed; @Managed @NullMarked// 默认所有类型为非空 public class PigUserService { @Nullable public PigUser findUserByUsername(String username) { return pigUserRepository.findByUsername(username); // 明确表示可能返回 null } } 在包或类上使用@NullMarked注解设定了新的默认规则:除非用@Nullable明确标注,否则所有类型都是非空的。这与我们的编程思维模式一致——绝大多数对象本就不应该为空。 实战案例 让我们通过 Pig 商城应用的实际案例来深入理解。在处理客户订单时,某些字段是必需的(如用户名),而其他字段是可选的(如优惠券码)。 import org.jspecify.annotations.NullMarked; import org.noear.solon.annotation.Managed; @NullMarked package com.pig.mall.order; @Managed public class PigOrderService { public PigOrder createOrder(String username, @Nullable String couponCode) { // username 保证非空 - 无需检查! sendConfirmation(username); // couponCode 可能为空 - 必须进行检查 if (couponCode != null) { applyCoupon(couponCode); } returnnew PigOrder(username, couponCode); } } 注意方法签名如何精确传达预期行为。由于@NullMarked默认保证 username 参数非空,因此无需进行空值检查。而 couponCode 被显式标注为@Nullable,提示你必须处理空值情况。 集合类型的空安全处理 JSpecify 的一大优势是能够处理集合中的可空元素。考虑一个客户评价场景,其中某些评价项可能被留空: import org.jspecify.annotations.Nullable; import org.noear.solon.annotation.Managed; @Managed public class PigReviewService { // 列表本身非空,但可以包含空元素 public List<@Nullable String> getProductReviews() { List<@Nullable String> reviews = new ArrayList<>(); reviews.add("商品质量很好"); // 评价 1:已填写 reviews.add(null); // 评价 2:留空 reviews.add("lengleng 的服务态度非常棒"); // 评价 3:已填写 return reviews; } public int calculateReviewRate(List<@Nullable String> reviews) { long completed = reviews.stream() .filter(Objects::nonNull) .count(); return (int) ((completed * 100) / reviews.size()); } } 类型List<@Nullable String>清晰地表达了语义:列表本身不会为 null,但单个评价可能为空。 项目中配置空安全特性 步骤 1:设置包级默认规则 在你的包中创建 package-info.java 文件: import org.jspecify.annotations.NullMarked; @NullMarked package com.pig.admin.service; 重要提示:@NullMarked仅作用于声明它的特定包,不会级联到子包。你需要在每个需要非空默认规则的包中添加带有@NullMarked的package-info.java文件。 步骤 2:标注可空返回值 更新可能返回 null 的方法: import org.jspecify.annotations.NullMarked; import org.jspecify.annotations.Nullable; import org.noear.solon.annotation.Managed; @NullMarked @Managed public class PigGoodsService { @Nullable public PigGoods findById(Long id) { return goodsRepository.findById(id).orElse(null); } // 更佳实践:新 API 使用 Optional public Optional<PigGoods> findGoodsById(Long id) { return goodsRepository.findById(id); } } 步骤 3:处理可空参数 对于可选参数,显式标注: import org.jspecify.annotations.NullMarked; import org.jspecify.annotations.Nullable; import org.noear.solon.annotation.Controller; @Controller @NullMarked public class PigGoodsController { @Post @Mapping("/goods") public PigGoods createGoods( @Body PigGoods goods, @Header("X-User-Id") @Nullable String userId) { // goods 保证非空 validateGoods(goods); // userId 可能为空 if (userId != null) { auditLog(userId, "创建商品: " + goods.getName()); } return pigGoodsService.save(goods); } } 编译期安全检查:NullAway 集成 真正的威力体现在集成 NullAway 后,它能在编译期捕获空指针问题。虽然这一配置是可选的,但它能将潜在的运行时 NPE 转化为构建失败: <build> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <version>3.14.0</version> <configuration> <release>17</release> <encoding>UTF-8</encoding> <fork>true</fork> <compilerArgs> <arg>-XDcompilePolicy=simple</arg> <arg>--should-stop=ifError=FLOW</arg> <arg>-Xplugin:ErrorProne -Xep:NullAway:ERROR -XepOpt:NullAway:OnlyNullMarked</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.api=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.file=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.main=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.model=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.parser=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.processing=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.tree=ALL-UNNAMED</arg> <arg>-J--add-exports=jdk.compiler/com.sun.tools.javac.util=ALL-UNNAMED</arg> <arg>-J--add-opens=jdk.compiler/com.sun.tools.javac.code=ALL-UNNAMED</arg> <arg>-J--add-opens=jdk.compiler/com.sun.tools.javac.comp=ALL-UNNAMED</arg> </compilerArgs> <annotationProcessorPaths> <path> <groupId>com.google.errorprone</groupId> <artifactId>error_prone_core</artifactId> <version>2.38.0</version> </path> <path> <groupId>com.uber.nullaway</groupId> <artifactId>nullaway</artifactId> <version>0.12.7</version> </path> </annotationProcessorPaths> </configuration> </plugin> </plugins> </build> 配置 NullAway 后,以下代码将无法通过编译: import org.jspecify.annotations.NullMarked; import org.jspecify.annotations.Nullable; import org.noear.solon.annotation.Controller; @Controller @NullMarked public class PigOrderController { @Get @Mapping("/orders/{username}") public String getOrderStatus(@Path String username) { PigOrder order = pigOrderService.findByUsername(username); // 返回 @Nullable // 编译错误!"解引用表达式 order 为 @Nullable" return order.getStatus(); // 必须处理空值情况 return order != null ? order.getStatus() : "未找到订单"; } } 为什么选择 @Nullable 而不是 Optional? 你可能会问:"既然 Java 8 已经提供了Optional<T>,为什么还需要@Nullable注解?"这是个值得深入讨论的问题。 Optional 是 JDK 提供的一个容器类,用于包装可能不存在的值,它通过类型系统强制调用者处理"值不存在"的情况。乍看之下,Optional 似乎能完美解决空值问题,但在实际应用中,@Nullable 注解方式有其独特优势: API 兼容性 将现有方法改为返回Optional会破坏所有现有调用者。而为现有方法签名添加@Nullable不会破坏任何内容——它只是使现有行为显式化。 运行时开销 每个Optional都会产生额外的对象分配开销。在高性能代码路径中,这种开销会累积。而@Nullable没有任何运行时成本——它纯粹是编译期元数据。 使用场景受限 JDK 文档明确指出,Optional主要设计为返回类型使用。不鼓励在方法参数或字段中使用,否则会导致 API 设计别扭: // Optional 参数的别扭用法 public void processOrder(Optional<String> couponCode) { couponCode.ifPresent(code -> applyCoupon(code)); } // @Nullable 的简洁用法 public void processOrder(@Nullable String couponCode) { if (couponCode != null) { applyCoupon(couponCode); } } 调用地狱 Optional 增加了一层抽象。虽然其流式 API 在某些模式下很优雅,但对于简单的空值检查来说可能过于冗长: // 使用 Optional return pigUserService.findUser(id) .map(PigUser::getName) .orElse("未知用户"); // 使用 @Nullable PigUser user = pigUserService.findUser(id); return user != null ? user.getName() : "未知用户"; 总结 如果你在 Solon v3.7 的代码中看到@NullMarked和@Nullable这些"奇怪"的注解,不用感到困惑——这是 Solon 框架拥抱现代 Java 空安全实践的体现。 这些 JSpecify 注解的引入,本质上是将"哪些值可能为 null"这一隐藏信息,以类型系统的方式显式表达出来。配合 NullAway 等静态分析工具,能在编译期就发现潜在的空指针问题,而不是等到生产环境爆炸。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册