微软宣布推出新版本编程模型:MAI Code 2 和 Code 2 Flash。它给 MAI Code 2 定的核心卖点写在小标题里:「不到一半的价格,交付生产级质量」。
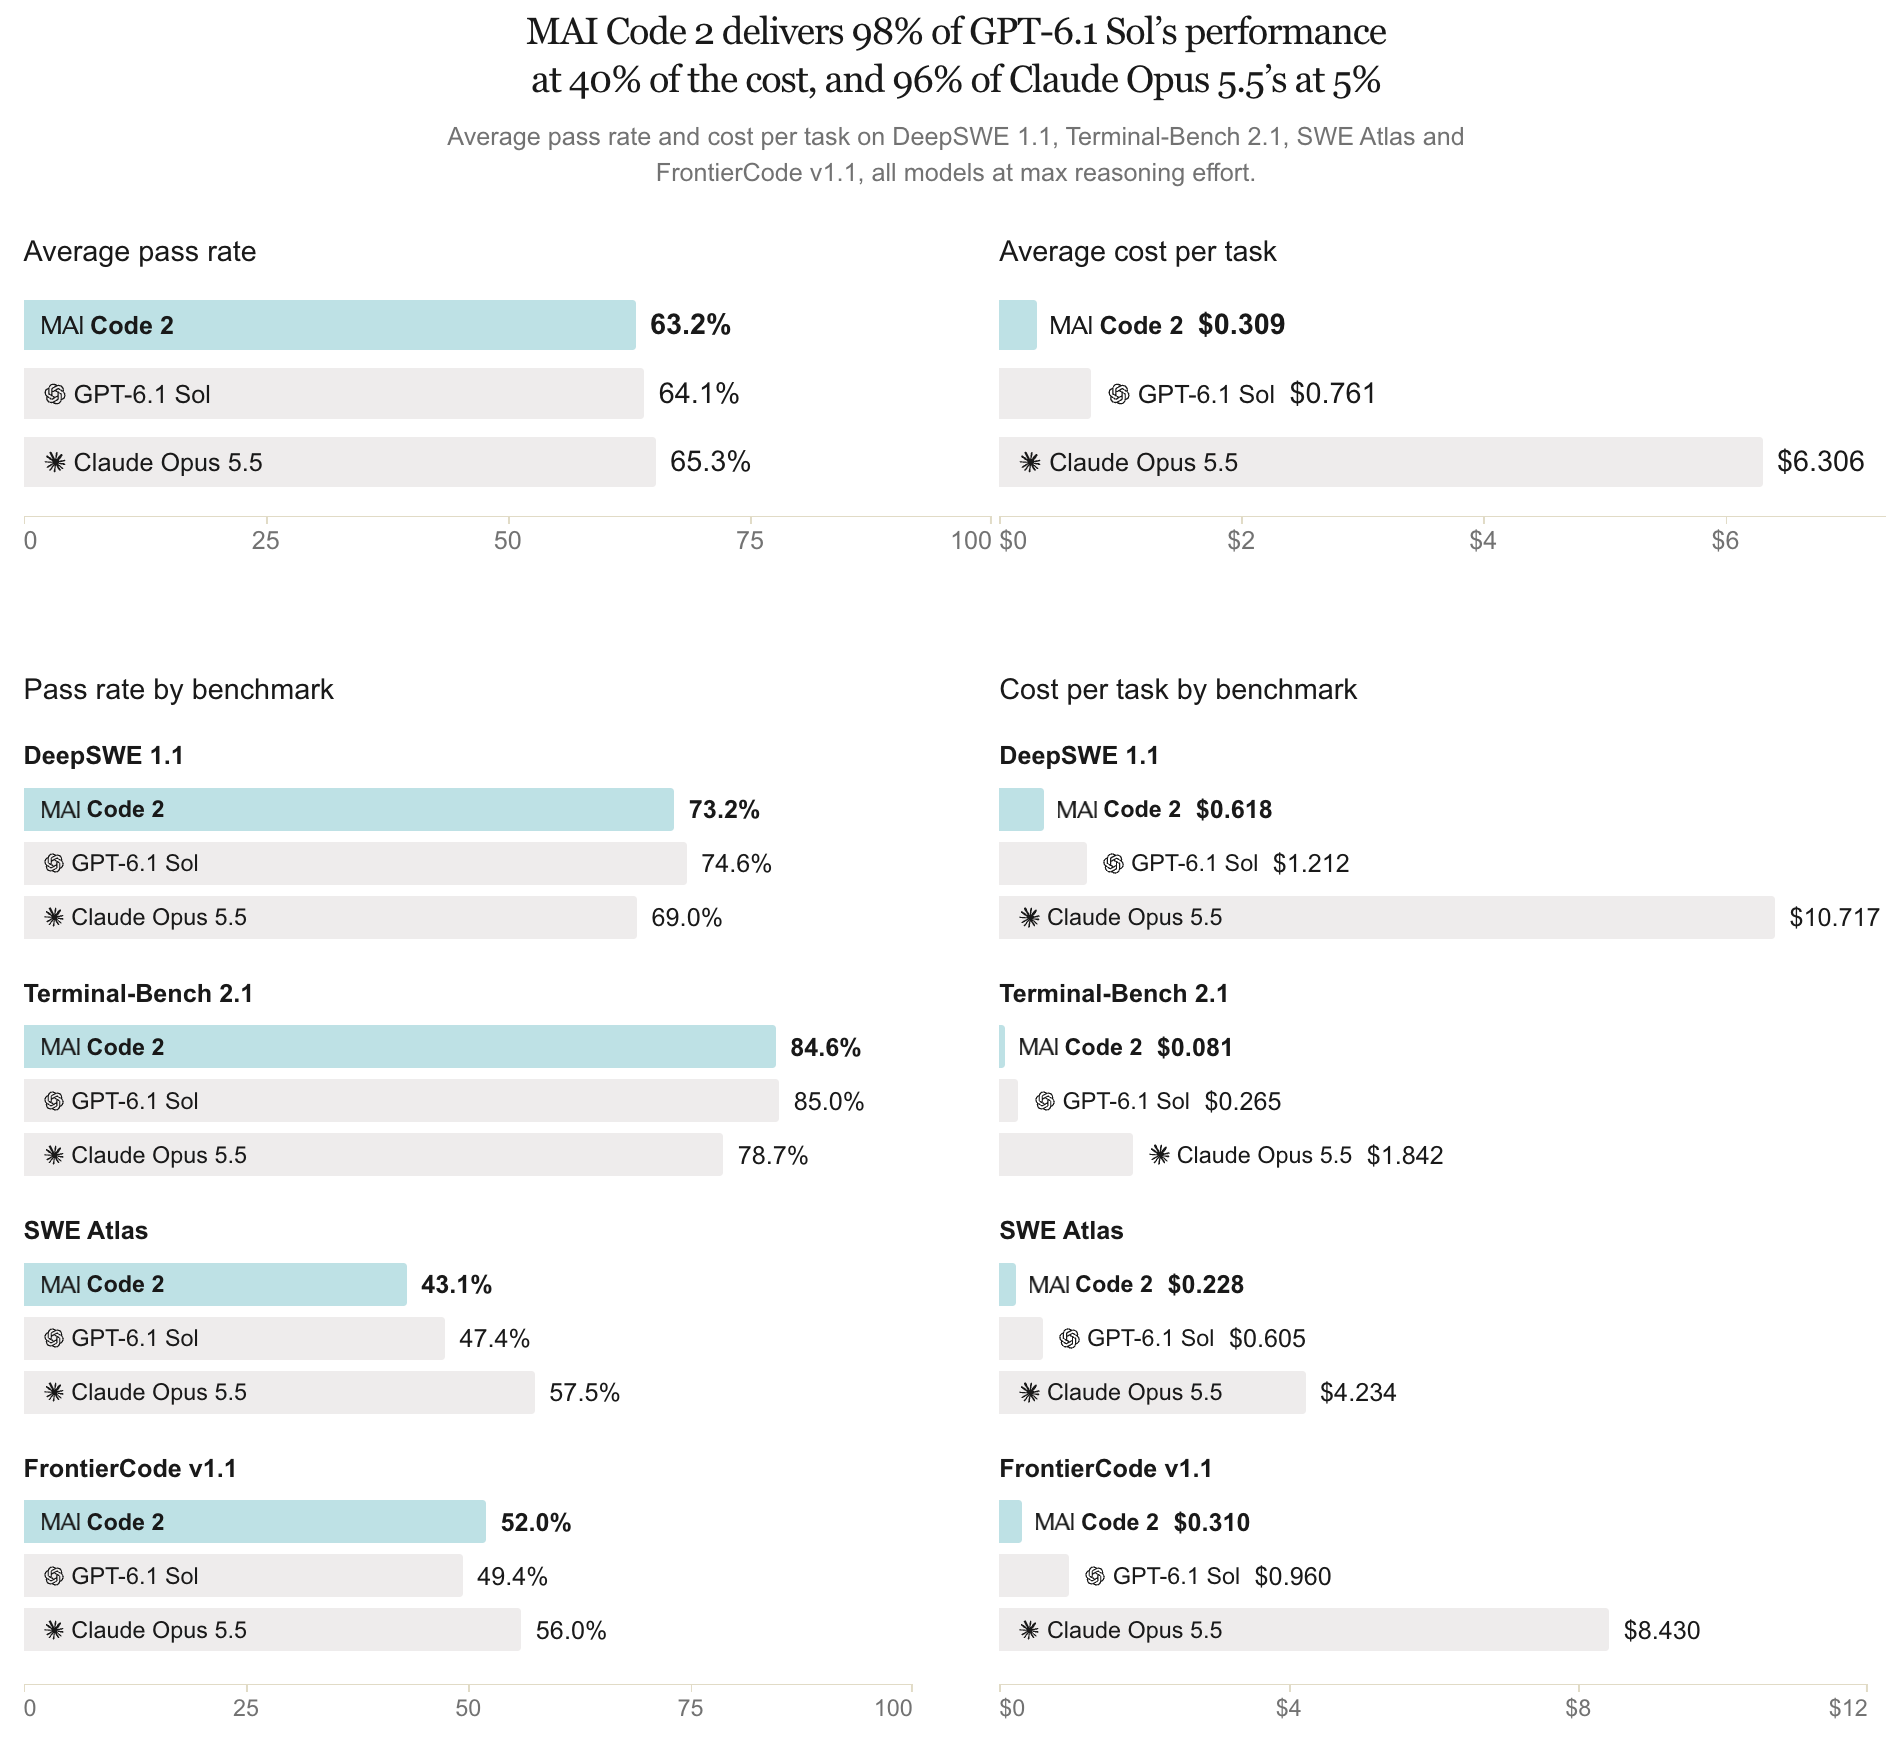
具体数字更有冲击力。在 DeepSWE 1.1、Terminal Bench 2.1、SWE-Atlas 和 FrontierCode v1.1 这四个针对企业日常编码任务的基准上取平均,MAI Code 2 拿到了 GPT 6.1 Sol 的 98% 性能,代价是 40% 的价格;拿到 Claude Opus 5.5 的 96% 性能,价格只要 5%。
两个模型的定位区分得很清楚
MAI Code 2 面向的是「把代码推进生产」这一类活:深度调试、跨文件实现、仓库级理解、UI 开发。微软的说法是它产出的改动「维护者愿意合并」。
MAI Code 2 Flash 走另一条路:代码解释、针对性修改、常规修复、快速迭代——高频、量大、单次要求不高的场景。它对比的是 GPT-6 Luna 和 Claude Haiku 5.5,性能相当,价格分别是 65% 和 20%。
这个分工思路和腾讯刚发的 Hy4 flash 很像,都是把「日常够用」和「难题攻坚」拆成两个模型,用前者吃量。
视觉编码是它想强调的差异点
微软专门写了一段说 MAI Code 2 在仪表盘和可视化上做了调优。盲测前端应用评估里,评审者在 64% 的情况下更偏好它的产出,对比对象是 GPT-6 Sol。
这个数字比价格对比更能说明微软的意图——它不满足于「便宜的替代品」,而是在特定场景上主张优势。
它已经在给微软自己的产品干活
这篇公告里有一块容易被忽略:MAI Code 2 正在成为微软内部产品的工作马。
从 Flash 版本进一步优化的一个单一模型,被用来服务 M365 和 Fabric IQ 的多个产品。在 Excel 的关键内部场景基准上,它的准确率和 token 效率与 GPT 6 Luna 持平;在 PowerPoint 的常见生产任务基准上同样持平。另有内部基准显示,它和 GPT 6.1 Sol 表现接近,但模型显著更小,生产环境每次调用少用约 42% 的输入 token。
指令遵循和工具调用上,微软说它「在跟踪决策、填补知识空白、适配自定义指令」方面超过 GPT 6 Luna,最多少用 28% 的 token。
这部分数据的分量在于:它不是第三方评测,而是微软自己产线上的实际压测。
官方自己划了能力边界
值得记一笔的是微软这句话——这些模型「明确还没有针对更难的问题调优,比如基础科学研究,以及非常长周期的 agent 工作」。
这是主动认下短板。配合「日常企业编码」这个定位,说明微软并不打算用它去打 Opus 5.5 的全场景能力,只想在 Copilot 每天真正在做的那些任务上抢性价比。
但社区实测没这么乐观
社区有人做了更细的对照,结论和官方叙事有出入。
这位用户的表格显示,MAI Code 2 在 Terminal-Bench 4.0 上只有 26.3 分,Flash 版本更低到 2.5 分;同期 Qwen4-Max 是 48.5,DeepSeek V4.1 Flash 是 42.3。他的判断是「这个模型可能蒸馏自 Qwen3-flash-next」。
不过要说明:这份对比他自己标注了「非受控比较」,部分分数带星号表示可能存在不同的 harness 和设置,而且参数量一栏用的是区间估计。它是个有参考价值的独立观察,不能当作定论。
另一类讨论集中在微软的评测方式上,有评论认为「他们用了旧版本的基准」。这条同样没有证据支撑。
现在哪里能用
MAI Code 2 和 Code 2 Flash 已进 GitHub Copilot。Code 2 Flash 在 Microsoft Foundry 里是限量访问预览。微软说接下来会陆续上 Open Router、Vercel、Hermes、Open Code 和 Kilo。
文末的免责声明也值得看一眼:所有模型都跑在最高推理强度下,性能与成本的对比会随工作负载、模型配置、推理强度和定价假设变化。这句话是标准免责,但结合社区实测来看,它不是客套。
参考来源: