首页 文章 精选 留言 我的

精选列表

搜索[next],共6058篇文章
优秀的个人博客,低调大师

The Next Generation of Apache Flink

摘要:本文整理自阿里云智能 Flink 分布式执行负责人、Apache Flink PMC 成员、Flink 2.0 Release Manager 宋辛童老师在 Flink Forward Asia 2023 主会场的分享。本次分享将介绍 Apache Flink 社区未来一年的主要技术方向及规划,以及 Flink 2.0 版本的筹备情况。 点击查看原文视频 Flink 社区目前正在大力投入且未来也会持续投入的工作主要集中在以下三个方向: 第一个方向,流处理上的极致优化与技术演进。Flink 是实时计算领域的事实标准,但这是一种横向的比较,如果纵向分析,即用 Flink 与自身作比较,在实时计算领域现有的技术是否已经足够成熟?是否足够解决用户在生产中遇到的各种各样的问题?从这个角度看,我们还有提高的空间。Flink 社区也会持续推动流处理技术的优化与演进,以保持项目在业界技术的领先性,同时也带动整个业界流处理技术向前发展。 第二个方向,流批一体架构的演进。从 Flink 社区自 2018、2019 年前后开始大力推广的基于 Flink 的流批一体架构,到现在提出的 Streaming Lakehouse 架构,流批一体已经成为 Flink 引擎非常重要的特色,同时也是越来越多的用户选择使用 Flink 的重要原因。Flink 社区也会持续在流批一体架构演进方面进行大力的投入。 第三个方向,用户体验的提升。我们都知道 Flink 项目起源于柏林工业大学的科研项目。在拥有先进的流处理技术架构的同时,由于流处理问题本身的复杂性,以及早期遗留的设计问题,Flink 在易用性上或多或少有一些不尽如人意的地方。Flink 社区充分意识到了一点,也在积极地寻求改进,将用户体验的提升提高到了整个项目未来发展的重要方向之一。 一、Streaming 这部分主要介绍在流计算领域,未来要做的工作。 1.1 存算分离状态管理 Flink 在流计算领域最重要的技术方向,当属状态管理机制的存算分离架构演进。Flink 提供的是一种有状态的流计算能力,状态管理是 Flink 非常核心的重要能力。云原生时代,大数据上云对 Flink 这样的有状态的计算引擎提出了新的挑战。例如,我们在云上通常会采用统一的资源池,做容器级的资源隔离,其中就包括磁盘空间资源的隔离。当 Flink 的状态存储在本地时,状态本身大小的不确定,会导致容器磁盘空间需求的不确定,进而导致我们难以做出高效的磁盘空间资源管理。此外,云主要的优势之一在于其资源的弹性能力,无论是 Flink 社区还是业界的一些厂商都纷纷推出了 AutoScale、AutoPilot 等能力,使 Flink 可以根据数据流量的实时变化进行动态弹性扩缩容。但在扩缩容过程中需要暂停作业再重启,如果 Flink 的状态存储在本地,在作业恢复时需要完整地将 state 文件拉取到本地,这会极大程度影响弹性扩缩容的作业中断时间。 基于以上因素,Flink 社区目前在大力投入下一代存算分离状态管理架构的设计和讨论。 1.2 持续完善算子语义和性能 除了状态管理之外,Flink 社区在流计算方面还在持续地优化和完善一些重要算子的语义和功能,相关内容相对灵散,这里主要列举 Window 和 Join 这两个比较重要的算子。 Window 是流计算中特有的概念,主要用于一些聚合操作。在 Flink SQL 中,我们推荐用户使用表值函数的方式来定义 Window。接下来,Flink 社区也会持续完善基于表值函数的窗口能力,包括支持更多的窗口类型、支持 Change Input 和 Window 的提早或延迟触发等。 另一个重要的算子是 Join 算子,它是数据分析中非常常用的一种算子操作,也往往非常容易成为大规模数据处理当中的计算瓶颈。Flink 社区目前也在探索多种用于 Join 的性能优化技术,包括 Mini-batch Join、Multi-way Join 等。 二、Batch-Streaming Unification 这部分主要介绍阿里云 Flink 社区未来在流批一体方面的工作。 2.1 流批一体 API 流批一体的优势在于采用统一的 API 进行流任务和批任务的开发,采用统一的引擎执行,依靠统一的算子实现天然地保证数据口径的一致。统一的 API 是整个流批一体的重要前提。目前 Flink 不论是 SQL 还是 DataStream 的 API 都可以使用同一套 API 进行流批两种不同任务的开发。但是我们发现在很多情况下,这样开发出来的流任务和批任务的代码并不相同,还没有真正做到一次开发,任意切换两种模式运行。 目前 Flink 社区在 SQL 领域正在探讨一种新的流批统一的语法语义,主要是基于物化视图的思想,让 Flink SQL 真正做到一次开发,流批两条链路都可以运行。在 DataStream 方面,由于 DataStream 是一种过程式的面向底层的 API,我们很难完全屏蔽掉流、批两种运行模式的差异。在这方面,社区优化的思路主要是希望明确区分哪些算子/能力具备流批一体的能力,而哪些算子/能力只能服务于特定的流或批的场景,以方便用户更好地开发属于自己的流批一体的业务逻辑。 2.2 批处理能力提升 有了统一的 API 远远不够,要想真正做到流批一体,还需要引擎同时具备优秀的流处理和批处理的能力、性能。Flink 在流处理能力上无疑是业界最好的,社区现在也在大力打造 Flink 的批处理能力,使其成为业界一流的水准。 关于批处理能力提升,这里主要列举了三项工作: 首先,在容错方面,Flink 目前已经可以做到单 task 级别的容错。但是一旦 JM 节点发生故障,仍旧需要重新运行整个作业,包括已经完成计算并且产出结果的任务,代价非常高。目前 Flink 社区已经在就 JM Failover 方案进行讨论,将在 JM 发生故障时恢复已经完成的任务的计算结果,从而大幅降低 JM Failover 的代价。 其次,动态执行优化(AQE)。Flink 社区目前已经能够做到的 AQE 的能力包括动态并发推断、动态分区剪裁等,后续我们也会持续在该方向发力,增加如动态负载均衡、动态拓扑生成、动态算子类型选择等能力。 此外,大规模批处理往往需要依赖存算分离的 Remote Shuffle Service,而 Apache Celeborn 是一个致力于提供通用的大数据 RSS 解决方案的开源项目。而 Flink 自身则在不久之前提出了全新的 Hybrid Shuffle 模式,能够结合流跟批两种不同 Shuffle 的优势,可以说是专门面向流批一体的 Shuffle 模式。Flink 社区目前正在和 Celeborn 社区合作,打造 Hybrid Shuffle 模式和 Apache Celeborn 的集成方案。 2.3 流批融合 有了优秀的流、批处理能力之后,Flink 社区还想进一步打破流、批两种模式之间的边界。 首先先思考为什么会有流和批两种不同的模式?我们观察到,用户在使用流和批模式时,他想要表达的数据处理的业务逻辑没有本质区别,其区别主要是在于对运行时不同性能指标的倾向性。 在流模式下,会更加倾向于低延迟的数据处理能力,我们希望数据处理具有更好的实时性,希望一条数据流过整个系统(从到达系统到产出结果)的时间最短。在追求低延时的过程中,难免会牺牲一部分资源的效率和计算的性能。 在批模式下,实时性要求较低,比起处理每条数据的延迟时间,往往更关注处理完整个数据集所需的时间及资源,也就是更倾向高吞吐性能。 在常见的数据处理场景中, 离线计算场景数据的新鲜度较低,往往更倾向高吞吐。 而在实时计算当中,大部分情况下我们会更倾向于低延迟,但也会存在一些更倾向于高吞吐的场景。如由于数据流量突然增大,处理性能不足,出现数据积压,导致延迟增大;或是在故障恢复需要追数据的情况。在这些情况下,增大的延迟时间已经不能够满足业务需求,比起具体延迟了多少时间,用户往往更关注用多长时间可以把延迟追回,即产生了高吞吐的需求。 此外,在全增量一体的场景下,如 CDC 数据同步,或利用数据回填做状态热启动等场景,我们在全量模式下通常更关注作业的高吞吐性能,而在增量场景下则更关注它的低延迟实时性。 就此,我们提出了流批融合的概念,希望引擎能够自动识别作业对于高吞吐或低延迟的需求倾向性,自动选择合适的流/批模式执行,并且当作业运行过程中状态和需求倾向性发生变化时能够自动进行动态切换。 2.4 Streaming Lakehouse Flink 社区也会持续完善 Streaming Lakehouse 的架构。图中所示的架构图是由 Flink 流批一体计算能力与 Paimon 流批一体的存储能力相结合,共同打造的一张 Streaming Lakehouse 架构图。 从 Flink 计算引擎的角度,除了前面提到的工作之外,主要还有两方面工作需要完成:一是在面向 OLAP 短查询的性能优化、SQL Gateway 功能完善等;另外,是面向湖存储场景,增强 Flink SQL 的数据管理以及元数据管理的能力。 三、Experience Improvements 这部分从用户体验方向出发,而用户体验部分往往落在一些细节上,这里列出了其中一部分比较有代表性的工作。 首先是 SQL 作业的升级,由于升级往往伴随着拓扑的变化,状态的兼容性是长期困扰用户的问题。目前 Flink 社区在这方面已经有了一版解决方案,还处在 MVP 阶段,后续也会持续完善和优化解决方案。 另外,在序列化方面,从功能角度而言,Flink 有非常强大的类型和序列化系统,支持多种序列化器;在易用性方面,目前的序列化机制还有待提高。比如要修改类型和序列化器之间的映射,或修改自动选择序列化器的规则时,往往还涉及到代码的修改。目前 Flink 社区正在进行完全基于配置文件的序列化管理方案的讨论。 关于配置系统,Flink 中有大量的配置项,但一部分的配置项也存在默认值不合理、语义和作用域不明确、暴露内部细节等问题。Flink 社区目前也在重新梳理其配置机制,包括对所有现存的配置项进行重新的评估。 最后,在 API 的演进方面,我们将会淘汰一部分比较陈旧的 API,包括 DataSet API、Scala API,还有 Legacy Table Source/Sink 等。同时对于现有的主要 API,像 DataStream API、REST API、Metrics 等的不足之处进行持续的完善。 可以发现刚才提到的优化很多与 public interface 的修改有关,这会影响到整个项目的向后兼容性,也就引出了我们接下来的话题——Flink 2.0版本。 四、Flink 2.0 Flink 在 2016 年推出了 1.0 版本,在 2023 年 10 月推出 Flink 1.18 版本。在七年半的时间中,共发布了 19 个小版本。此次开始筹备新的大版本,最主要的原因是为了引入 API 的非兼容性改动。 Flink 社区对于 API 的兼容性进行了相应的规定。我们有三个不同的 API 级别,分别是@Public、@PublicEvolving 和@Experimental。 在兼容性保证方面,@Public API 保证同一大版本内(即一位版本号相同)兼容,@PublicEvolving API 保证小版本内(即二位版本号相同)兼容,而@Experimental 没有这方面的保证。除了兼容性保证之外,Flink 社区近期还新提出了对 API 迁移周期的要求,即 API 从标记为@Deprecated 到可以删除的最小时间周期。该时间周期对于@Public API 是两个版本,对于@PublicEvolving API 是一个版本。只有同时满足兼容性保证和最小迁移周期的要求,才能够对 API 进行修改。换言之,要修改最新的 1.18 版本当中的@Public API,则至少要在 1.19 版本对其进行 Deprecation,经过 1.19 和 1.20 两个版本迁移周期,才可以在 2.0 版本中进行删除。 基于上述的 API 兼容性的规定,可以得出整个 Flink 2.0 的时间规划大致如下: Flink 社区已经在 2023 年 10 月推出 1.18 版本;在 2024 年 2 月和 6 月,将分别推出 1.19 和 1.20 版本,以满足 API 迁移周期的需求。同时,我们预计 1.20 版本有可能是 Flink 1.x 系列中的最后版本。考虑到大版本升级的复杂性和工作量,我们计划将 1.20 版本作为长期支持的 LTS 版本,持续为其提供漏洞的修复。我们预计在 2024 年 10 月推出全新的 Flink 2.0 版本。前面提到的未来工作规划中,所有影响兼容性的 API 改动,我们需要严格遵守这一版本规划,而对于一些不涉及到 API 改动的优化和工作,则没有严格的版本对应的要求。 点击查看原文视频 Flink Forward Asia 2023 本届 Flink Forward Asia 更多精彩内容,可微信扫描图片二维码观看全部议题的视频回放及 FFA 2023 峰会资料! 更多内容 活动推荐 阿里云基于 Apache Flink 构建的企业级产品-实时计算 Flink 版现开启活动: 0 元试用实时计算 Flink 版(5000CU*小时,3 个月内) 了解活动详情:https://free.aliyun.com/?pipCode=sc

优秀的个人博客,低调大师

【HarmonyOS NEXT】地图使用详解(二)

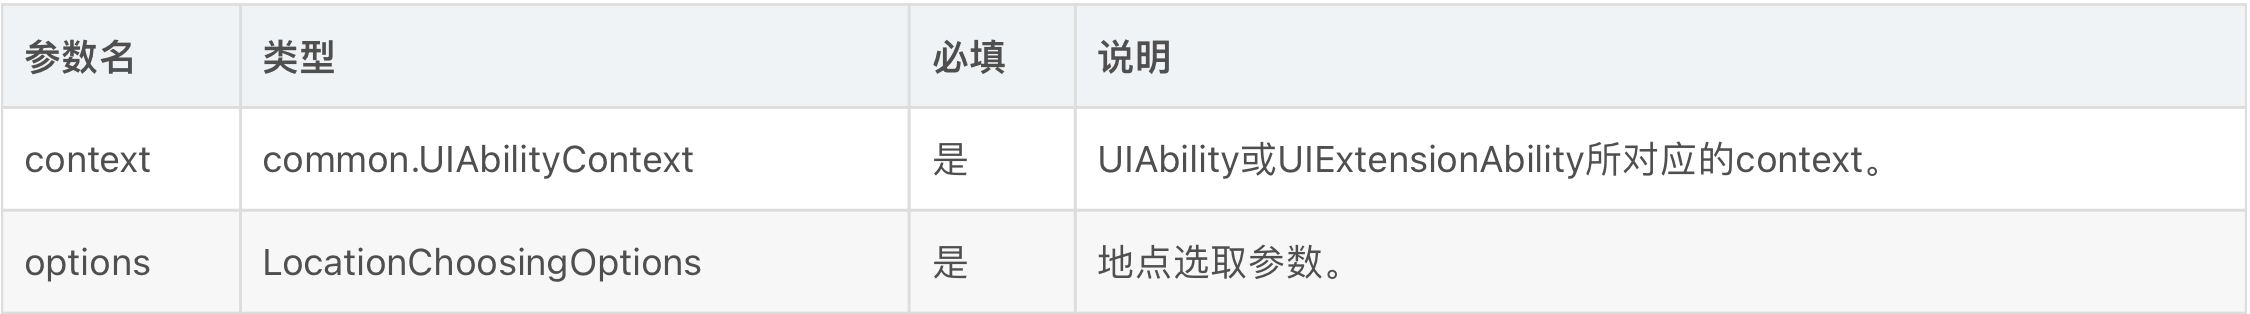
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398 背景 上篇文章对开发环境初始化进行了讲解,这篇文章是对地图Picker系列组件的讲解。包括地点选取模块和地点详情展示模块。 地点选取模块(sceneMap.chooseLocation) · 参数 · 返回值 Promise 地点选取初始化参数(LocationChoosingOptions) location · 地图中心点坐标。如果参数未传,使用设备当前位置作为中心点;如果未获取到设备当前位置,默认以故宫博物院为中心点。 language · 地图组件显示的语言。仅支持中文和英文,zh_CN和en poiTypes · 指定需要展示的poi类别。取值范围需要查看HwLocationType searchEnabled · 是否展示搜索控件,默认值为false。true:展示;false:不展示 showNearbyPoi · 是否展示附近poi,默认值为false。true:展示;false:不展示 snapshotEnabled · 是否返回映射快照,默认值为false。true:返回;false:不返回 地点选择返回值(LocationChoosingResult) siteId · 选择的地点ID,如果选测试非Poi(即手动滑动到随便某个位置),则不返回 location · 选点的坐标点。返回mapCommon.Latlng值 name · 选点的Poi名称。非Poi时,返回name值为标记点 address · 选点的地址信息 addressComponent · 选点地址的详细信息。返回site.AddressComponent值,包括国家名字,行政区,地区等信息。 zoom · 选点地址的缩放层级。 snapshot · 地图快照。返回图片类型 代码 实现效果 地点详情展示模块(sceneMap.queryLocation) 由官方提供的地点详情展示模块,可以实现快速调用页面,查看地点详情。 · 参数 LocationQueryOptions(查询地点详情设置参数) 需要注意点,如果没有填写siteid参数时,需要同时填写location和name才能实现页面的定位 siteId · 地点详情页的地点ID。 language · 语言。当前仅支持中文和英文,取值:zh_CN、en。 location · 地图中心点坐标。如果没有siteId,使用location查询地点详情。 name · 地点的名称。如果没有siteId,使用name作为location的名称标注。 address · 地点的地址。如果没有siteId,使用address作为location的地址标注。 showBusiness · 是否显示商业信息(如打车),默认值为true。 代码 实现效果 · 当选择的地址是Poi时,ID和Name都可以正常显示 · 当选择地址不是Poi时,ID是为undefined的,Name可以正常显示 总结 这里展示了官方提供的两种地图组件的使用方式,希望可以让你对这两个组件的使用有更深的理解(转载自CSDN,作者:baobao熊)

优秀的个人博客,低调大师

【HarmonyOS NEXT】地图使用详解(一)

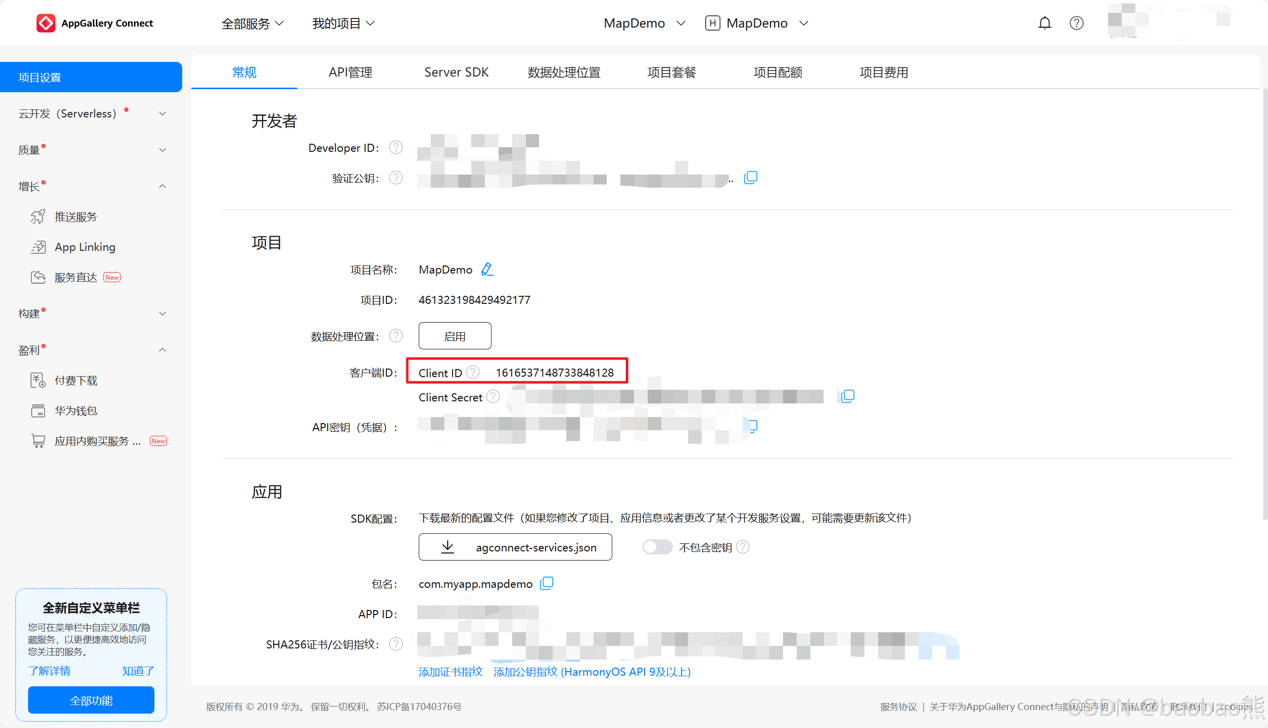
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398 背景 这系列文章主要讲解鸿蒙地图的使用,当前可以免费使用,并提供了丰富的SDK给开发者去自定义控件开发。目前可以实现个性化显示地图、位置搜索和路径规划等功能,轻松完成地图构建工作。需要注意的是,现在测试只能使用实体手机去做调试,模拟器和预览器是没有办法做测试和使用的。 地图开发环境搭建 1.AGC中创建项目 在AGC中新建项目,并复制AGC项目中的Client ID 填写到工程中的entry模块的module.json5文件中,新增metadata,配置name为client_id,value为AGC项目中的Client ID。 2.AGC中开通地图服务 在API管理界面,打开地图服务 3.AGC中创建APP 在证书、APP ID和Profile中,APP ID中创建之前项目中的App 4.在项目文件中生成密钥请求文件 这个密钥文件比较重要,务必妥善保存。 这里的Alias需要记住,后面需要用到 保存csr文件 查看生成的csr文件 5.AGC项目中创建证书和设备 新建调试证书,并把证书下载到本地。 6.AGC项目中创建Profile 选择对应的调试证书,完成Profile的创建 7.把生成的证书和调试文件添加到项目结构中 8.确保当前IDE已经登陆了你的华为账号 地图组件(MapComponent) · 示例代码使用MVVM架构来配置 1、MapComponent组件初始化 · 提供了两个必填参数,mapOptions和mapCallback · 项目初始化框架 · VM中的MapOption赋值 · VM中的MapCallBack赋值 · 权限申请(在VM中封装申请) 权限方法封装 · 项目加载时,先进行VM的初始化 · 界面初始化展示 2、地图初始化类(MapOptions) 属于mapCommon类 · 常用属性 · 在VM类中,需要在类初始化的时候把MapOption初始化。 3、获取手机用户当前位置 通过geoLocationManager的getCurrentLocation方法,获取用户的坐标经纬度,然后封装成更新用户定位的方法,在初始化的时候调用,就可以实现手机打开后会直接更新到用户的位置 完整代码 · Page · ViewModel · PermissionUtils 总结 上面的流程是地图组件的初始化的个人理解流程,看完这篇希望可以在地图开发上给你提供帮助。(转载自CSDN,作者:baobao熊)

优秀的个人博客,低调大师

【HarmonyOS NEXT】Calendar Kit日历管理

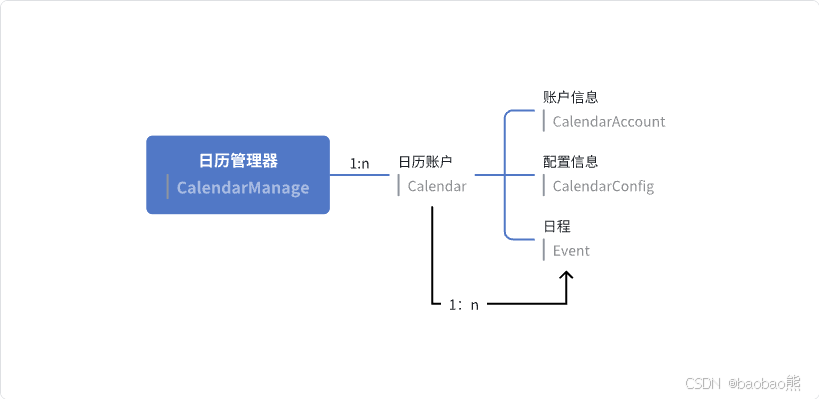
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-csdn&ha_sourceId=89000445 简介 Calendar Kit提供日历与日程管理能力,包括日历的获取和日程的创建能力。 Calendar Kit为用户提供了一系列接口来获取日历账户,并使用特定的接口向日历账户中写入日程。 如果写入的日程带有提醒时间则系统会在时间到达时向用户发送提醒。 约束点 ·需要用户手动授权获取读取、写入日历日程的权限。 ·仅支持stage模型。 ·从api11开始支持 相关知识 配置需要的权限 在module.json5中配置所需申请的权限 在EntryAbility中配置权限和日历管理器 EntryAbility中检查用户是否确认权限: 日历管理器(CalendarManager) 提供了添加、删除、获取日历账户的相关方法。如果不需要关注日程(Event)的账户(Calendar)归属时,可以直接使用getCalendar方法直接获取。 相关方法如下: 日历账户(Calendar) 可以对账户中的日程进行创建、删除、修改、查询等操作,还有日历配置信息、日历账户信息等方法 日程(Event) (转载自51CTO,作者:奥尼5354)

优秀的个人博客,低调大师

Next.js 使用全系列手册

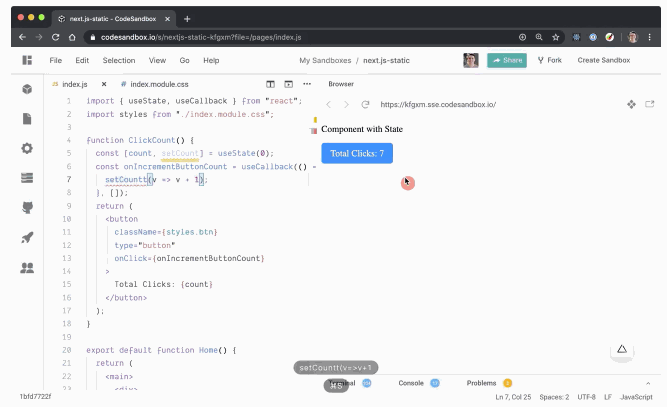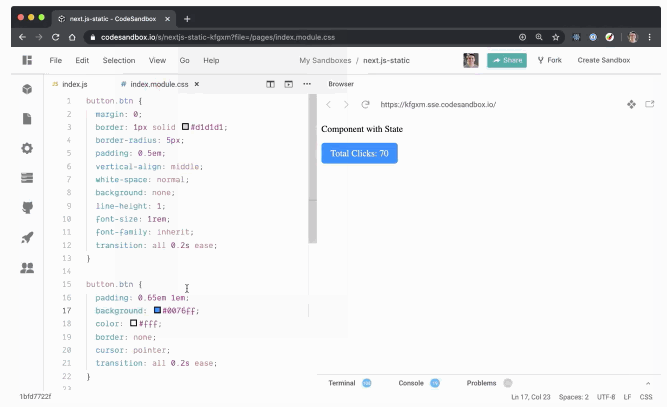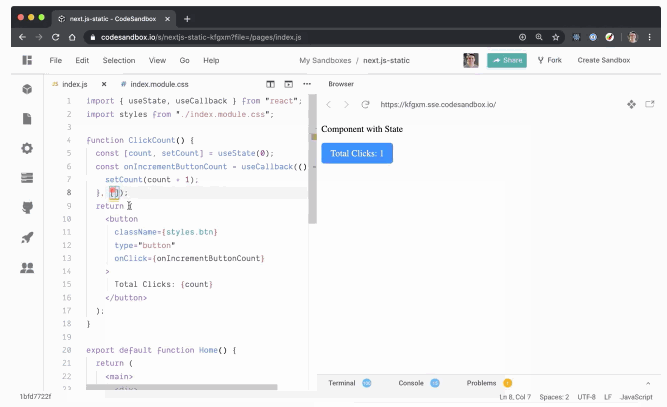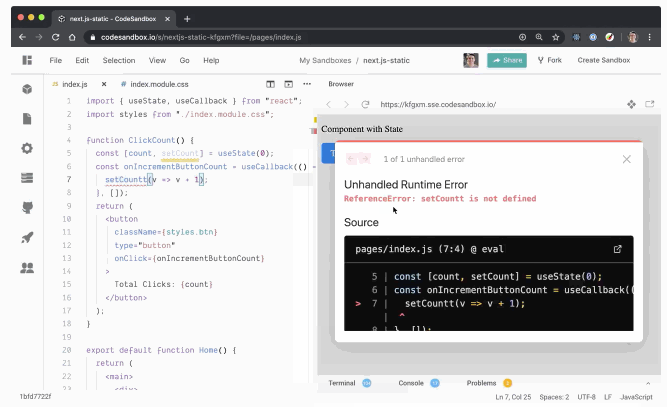
刚开始接触现代前端框架时,最让人头疼的往往不是复杂的逻辑实现,而是如何快速搭建一个稳定、规范且易于扩展的开发环境。很多开发者在起步阶段花费了大量时间配置工具链,结果项目还没开始写业务代码,精力就已经消耗了一半。特别是在需要兼顾服务端渲染(SSR)和静态生成的场景下,选择一个合适的框架并正确初始化项目,直接决定了后续开发的效率和最终产品的性能表现。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册