首页 文章 精选 留言 我的

精选列表

搜索[Skill资产共创],共8455篇文章
优秀的个人博客,低调大师

[python skill]Python 中 NaN 和 None 的详细比较

原文出自:http://junjiecai.github.io/posts/2016/Oct/20/null_value_comparison/ 感谢~ python原生的None和pandas, numpy中的numpy.NaN尽管在功能上都是用来标示空缺数据。但它们的行为在很多场景下确有一些相当大的差异。由于不熟悉这些差异,曾经给我的工作带来过不少麻烦。 特此整理了一份详细的实验,比较None和NaN在不同场景下的差异。 实验的结果有些在意料之内,有些则让我大跌眼镜。希望读者看过此文后会None和NaN这对“小妖精”有更深的理解。 为了理解本文的内容,希望本文的读者需要对pandas的Series使用有一定的经验。 首先,导入所需的库 In[2]: Python 1 2 3 from numpy import NaN from pandas import Series, DataFrame import numpy as np 数据类型? None是一个python特殊的数据类型, 但是NaN却是用一个特殊的float In[3]: Python 1 type(None) Out[3]: Python 1 NoneType In[4]: Python 1 type(NaN) Out[4]: Python 1 float 能作为dict的key? In[5]: Python 1 {None:1} Out[5]: Python 1 {None: 1} In[6]: Python 1 {NaN:1} Out[6]: Python 1 {nan: 1} In[7]: Python 1 {None:1, NaN:2} Out[7]: Python 1 {nan: 2, None: 1} 都可以,而且会被认为是不同的key Series函数中的表现 Series.map In[8]: Python 1 2 s = Series([None, NaN, 'a']) s Out[8]: Python 1 2 3 4 0None 1 NaN 2 a dtype: object In[9]: Python 1 s.map({None:1,'a':'a'}) Out[9]: Python 1 2 3 4 01 11 2a dtype: object 可以看到None和NaN都会替换成了1 In[10]: Python 1 s.map({NaN:1,'a':'a'}) Out[10]: Python 1 2 3 4 01 11 2a dtype: object 同样None和NaN都会替换成了1 In[11]: Python 1 s.map({NaN:2,'None':1,'a':'a'}) Out[11]: Python 1 2 3 4 02 12 2a dtype: object 将None替换成1的要求被忽略了 In[12]: Python 1 s.map({'None':1,NaN:2,'a':'a'}) Out[12]: Python 1 2 3 4 02 12 2a dtype: object 将NaN替换成1的要求被忽略了 总结:用Series.map对None进行替换时,会“顺便”把NaN也一起替换掉;NaN也会顺便把None替换掉。 如果None和NaN分别定义了不同的映射数值,那么只有一个会生效。 Series.replace中的表现 In[13]: Python 1 2 s = Series([None, NaN, 'a']) s Out[13]: Python 1 2 3 4 0None 1 NaN 2 a dtype: object In[14]: Python 1 s.replace([NaN],9) Out[14]: Python 1 2 3 4 09 19 2a dtype: object In[15]: Python 1 s.replace([None],9) Out[15]: Python 1 2 3 4 09 19 2a dtype: object 和Series.map的情况类似,指定了None的替换值后,NaN会被替换掉;反之亦然。 对函数的支持 numpy有不少函数可以自动处理NaN。 In[16]: Python 1 np.nansum([1,2,NaN]) Out[16]: Python 1 3.0 但是None不能享受这些函数的便利,如果数据包含的None的话会报错 In[17]: Python 1 2 3 4 try: np.nansum([1,2,None]) except Exception as e: print(type(e),e) unsupported operand type(s) for +: ‘int’ and ‘NoneType’ pandas中也有不少函数支持NaN却不支持None。(毕竟pandas的底层是numpy) In[18]: Python 1 2 import pandas as pd pd.cut(Series([NaN]),[1,2]) Out[18]: Python 1 2 3 0NaN dtype: category Categories (1, object): [(1, 2]] In[19]: Python 1 2 3 4 5 import pandas as pd try: pd.cut(Series([None]),[1,2]) except Exception as e: print(type(e),e) unorderable types: int() > NoneType() 对容器数据类型的影响 混入numpy.array的影响 如果数据中含有None,会导致整个array的类型变成object。 In[20]: Python 1 np.array([1, None]).dtype Out[20]: Python 1 dtype('O') 而np.NaN尽管会将原本用int类型就能保存的数据转型成float,但不会带来上面这个问题。 In[21]: Python 1 np.array([1, NaN]).dtype Out[21]: Python 1 dtype('float64') 混入Series的影响 下面的结果估计大家能猜到 In[22]: Python 1 Series([1, NaN]) Out[22]: Python 1 2 3 01.0 1NaN dtype: float64 下面的这个就很意外的吧 In[23]: Python 1 Series([1, None]) Out[23]: Python 1 2 3 01.0 1NaN dtype: float64 pandas将None自动替换成了NaN! In[24]: Python 1 Series([1.0, None]) Out[24]: Python 1 2 3 01.0 1NaN dtype: float64 却是Object类型的None被替换成了float类型的NaN。 这么设计可能是因为None无法参与numpy的大多数计算, 而pandas的底层又依赖于numpy,因此做了这样的自动转化。 不过如果本来Series就只能用object类型容纳的话, Series不会做这样的转化工作。 In[25]: Python 1 Series(['a', None]) Out[25]: Python 1 2 3 0 a 1None dtype: object 如果Series里面都是None的话也不会做这样的转化 In[26]: Python 1 Series([None,None]) Out[26]: Python 1 2 3 0None 1None dtype: object 其它的数据类型是bool时,也不会做这样的转化。 In[27]: Python 1 Series([True, False, None]) Out[27]: Python 1 2 3 4 0 True 1False 2 None dtype: object 等值性判断 单值的等值性比较 下面的实验中None和NaN的表现会作为后面的等值性判断的基准(后文称为基准) In[28]: Python 1 None == None Out[28]: Python 1 True In[29]: Python 1 NaN == NaN Out[29]: Python 1 False In[30]: Python 1 None == NaN Out[30]: Python 1 False 在tuple中的情况 这个不奇怪 In[31]: Python 1 (1, None) == (1, None) Out[31]: Python 1 True 这个也不意外 In[32]: Python 1 (1, None) == (1, NaN) Out[32]: Python 1 False 但是下面这个实验NaN的表现和基准不一致 In[33]: Python 1 (1, NaN) == (1, NaN) Out[33]: Python 1 True 在numpy.array中的情况 In[34]: Python 1 np.array([1,None]) == np.array([1,None]) Out[34]: Python 1 array([ True,True], dtype=bool) In[35]: Python 1 np.array([1,NaN]) == np.array([1,NaN]) Out[35]: Python 1 array([ True, False], dtype=bool) In[36]: Python 1 np.array([1,NaN]) == np.array([1,None]) Out[36]: Python 1 array([ True, False], dtype=bool) 和基准的表现一致。 但是大部分情况我们希望上面例子中, 我们希望左右两边的array被判定成一致。这时可以用numpy.testing.assert_equal函数来处理。 注意这个函数的表现同assert, 不会返回True, False, 而是无反应或者raise Exception In[37]: Python 1 np.testing.assert_equal(np.array([1,NaN]), np.array([1,NaN])) 它也可以处理两边都是None的情况 In[38]: Python 1 np.testing.assert_equal(np.array([1,None]), np.array([1,None])) 但是一边是None,一边是NaN时会被认为两边不一致, 导致AssertionError In[39]: Python 1 2 3 4 try: np.testing.assert_equal(np.array([1,NaN]), np.array([1,None])) except Exception as e: print(type(e),e) Python 1 2 3 4 5 6 <class 'assertionerror'=""> Arrays are not equal (mismatch 50.0%) x: array([1.,nan]) y: array([1, None], dtype=object) 在Series中的情况 下面两个实验中的表现和基准一致 In[40]: Python 1 Series([NaN,'a']) == Series([NaN,'a']) Out[40]: Python 1 2 3 0False 1 True dtype: bool In[41]: Python 1 Series([None,'a']) == Series([NaN,'a']) Out[41]: Python 1 2 3 0False 1 True dtype: bool 但是None和基准的表现不一致。 In[42]: Python 1 Series([None,'a']) == Series([None,'a']) Out[42]: Python 1 2 3 0False 1 True dtype: bool 和array类似,Series也有专门的函数equals用于判断两边的Series是否整体看相等 In[43]: Python 1 Series([None,'a']).equals(Series([NaN,'a'])) Out[43]: Python 1 True In[44]: Python 1 Series([None,'a']).equals(Series([None,'a'])) Out[44]: Python 1 True In[45]: Python 1 Series([NaN,'a']).equals(Series([NaN,'a'])) Out[45]: Python 1 True 比numpy.testing.assert_equals更智能些, 三种情况下都能恰当的处理 在DataFrame merge中的表现 两边的None会被判为相同 In[46]: Python 1 2 3 a = DataFrame({'A':[None,'a']}) b = DataFrame({'A':[None,'a']}) a.merge(b,on='A', how = 'outer') Out[46]: A 0 None 1 a 两边的NaN会被判为相同 In[47]: Python 1 2 3 a = DataFrame({'A':[NaN,'a']}) b = DataFrame({'A':[NaN,'a']}) a.merge(b,on='A', how = 'outer') Out[47]: A 0 NaN 1 a 无论两边都是None,都是NaN,还是都有,相关的列都会被正确的匹配。 注意一边是None,一边是NaN的时候。会以左侧的结果为准。 In[48]: Python 1 2 3 a = DataFrame({'A':[None,'a']}) b = DataFrame({'A':[NaN,'a']}) a.merge(b,on='A', how = 'outer') Out[48]: A 0 None 1 a In[49]: Python 1 2 3 a = DataFrame({'A':[NaN,'a']}) b = DataFrame({'A':[None,'a']}) a.merge(b,on='A', how = 'outer') Out[49]: A 0 NaN 1 a 注意 这和空值在postgresql等sql数据库中的表现不一样, 在数据库中, join时两边的空值会被判定为不同的数值 在groupby中的表现 In[50]: Python 1 2 d = DataFrame({'A':[1,1,1,1,2],'B':[None,None,'a','a','b']}) d.groupby(['A','B']).apply(len) Out[50]: Python 1 2 3 4 AB 1a2 2b1 dtype: int64 可以看到(1, NaN)对应的组直接被忽略了 In[51]: Python 1 2 d = DataFrame({'A':[1,1,1,1,2],'B':[None,None,'a','a','b']}) d.groupby(['A','B']).apply(len) Out[51]: Python 1 2 3 4 AB 1a2 2b1 dtype: int64 (1,None)的组也被直接忽略了 In[52]: Python 1 2 d = DataFrame({'A':[1,1,1,1,2],'B':[None,NaN,'a','a','b']}) d.groupby(['A','B']).apply(len) Out[52]: Python 1 2 3 4 AB 1a2 2b1 dtype: int64 那么上面这个结果应该没啥意外的 总结 DataFrame.groupby会忽略分组列中含有None或者NaN的记录 支持写入数据库? 往数据库中写入时NaN不可处理,需转换成None,否则会报错。这个这里就不演示了。 相信作为pandas老司机, 至少能想出两种替换方法。 In[53]: Python 1 2 s = Series([None,NaN,'a']) s Out[53]: Python 1 2 3 4 0None 1 NaN 2 a dtype: object 方案1 In[54]: Python 1 s.replace([NaN],None) Out[54]: Python 1 2 3 4 0None 1None 2 a dtype: object 方案2 In[55]: Python 1 2 s[s.isnull()]=None s Out[55]: Python 1 2 3 4 0None 1None 2 a dtype: object 然而这么就觉得完事大吉的话就图样图森破了, 看下面的例子 In[56]: Python 1 2 s = Series([NaN,1]) s Out[56]: Python 1 2 3 0NaN 11.0 dtype: float64 In[57]: Python 1 s.replace([NaN], None) Out[57]: Python 1 2 3 0NaN 11.0 dtype: float64 In[58]: Python 1 2 s[s.isnull()] = None s Out[58]: Python 1 2 3 0NaN 11.0 dtype: float64 当其他数据是int或float时,Series又一声不吭的自动把None替换成了NaN。 这时候可以使用第三种方法处理 In[59]: Python 1 s.where(s.notnull(), None) Out[59]: Python 1 2 3 0None 1 1 dtype: object where语句会遍历s中所有的元素,逐一检查条件表达式, 如果成立, 从原来的s取元素; 否则用None填充。 这回没有自动替换成NaN None vs NaN要点总结 在pandas中, 如果其他的数据都是数值类型, pandas会把None自动替换成NaN, 甚至能将s[s.isnull()]= None,和s.replace(NaN, None)操作的效果无效化。 这时需要用where函数才能进行替换。 None能够直接被导入数据库作为空值处理, 包含NaN的数据导入时会报错。 numpy和pandas的很多函数能处理NaN,但是如果遇到None就会报错。 None和NaN都不能被pandas的groupby函数处理,包含None或者NaN的组都会被忽略。 等值性比较的总结:(True表示被判定为相等) None对None NaN对NaN None对NaN 单值 True False False tuple(整体) True True False np.array(逐个) True False False Series(逐个) False False False assert_equals True True False Series.equals True True True merge True True True 由于等值性比较方面,None和NaN在各场景下表现不太一致,相对来说None表现的更稳定。 为了不给自己惹不必要的麻烦和额外的记忆负担。 实践中,建议遵循以下三个原则即可 在用pandas和numpy处理数据阶段将None,NaN统一处理成NaN,以便支持更多的函数。 如果要判断Series,numpy.array整体的等值性,用专门的Series.equals,numpy.array函数去处理,不要自己用==判断 * 如果要将数据导入数据库,将NaN替换成None


优秀的个人博客,低调大师

[python skill]利用python实现假设性检验方法

hello,大噶好,最近新学习了利用python实现假设性检验的一些方法,下面结合方法的数学原理做简单的总结~ 假设检验是推论统计中用于检验统计假设的一种方法。而“统计假设”是可通过观察一组随机变量的模型进行检验的科学假说。[1]一旦能估计未知参数,就会希望根据结果对未知的真正参数值做出适当的推论。 统计上对参数的假设,就是对一个或多个参数的论述。而其中欲检验其正确性的为零假设(null hypothesis),零假设通常由研究者决定,反应研究者对未知参数的看法。相对于零假设的其他有关参数之论述是备择假设(alternative hypothesis),它通常反应了执行检定的研究者对参数可能数值的另一种(对立的)看法(换句话说,备择假设通常才是研究者最想知道的)。 假设检验的种类包括:t检验,Z检验,卡方检验,F检验等等。 参考:https://zh.wikipedia.org/wiki/%E5%81%87%E8%A8%AD%E6%AA%A2%E5%AE%9A 应该说假设性检验是一种处理数据的思路,依据不同的实验数据和目的可以使用不同的处理方法。如T检验,Z检验,卡方检验,F检验等等~~ -------------------------------------------------------------------------------------------------------------------- Permutation test on frog data 学习假设性检验之前大家不妨先复习一下之前转载的一篇关于置换检验 permutation test的一篇博文,它是假设性检验的一种方法,比较简单基础,所以先从这种方法说起。 置换检验适用于两组完整的实验数据(n1,n2)之间的分析比较: 主要流程是: 1、合并n1,n2,无放回地抽取生成与原数据长度相等的两组数据(n1`,n2`) def permutation_sample(data1, data2): """Generate a permutation sample from two data sets.""" # Concatenate the data sets: data data = np.concatenate((data1, data2)) # Permute the concatenated array: permuted_data permuted_data = np.random.permutation(data) # Split the permuted array into two: perm_sample_1, perm_sample_2 perm_sample_1 = permuted_data[:len(data1)] perm_sample_2 = permuted_data[len(data1):] return perm_sample_1, perm_sample_2 2、重复1过程,进行多次实验(如10000次),将每次实验得出数据(n1`,n2`)求平均,再将平均值做差: def draw_perm_reps(data_1, data_2, func, size=1): """Generate multiple permutation replicates.""" # Initialize array of replicates: perm_replicates perm_replicates = np.empty(size) for i in range(size): # Generate permutation sample perm_sample_1, perm_sample_2 = permutation_sample(data_1,data_2) # Compute the test statistic perm_replicates[i] = func(perm_sample_1,perm_sample_2) return perm_replicates def diff_of_means(data_1, data_2): """Difference in means of two arrays.""" # The difference of means of data_1, data_2: diff diff = np.mean(data_1)-np.mean(data_2) return diff 3、这样我们得到多个(10000)置换排列求得的结果,这些结果能代表模拟抽样总体情况。 举个栗子: Kleinteich and Gorb (Sci. Rep.,4, 5225, 2014) performed an interesting experiment with South American horned frogs. They held a plate connected to a force transducer, along with a bait fly, in front of them. They then measured the impact force and adhesive force of the frog's tongue when it struck the target. K和G博士以前做过一系列实验,研究青蛙舌头的黏力与哪些因素有关。 他们经过测试发现:FROG_A(老青蛙)的平均黏力0.71 Newtons (N)和FROG_B(小青蛙)的0.42 Newtons (N)。这0.29牛顿的差距仅仅因为测试样本过少而偶然发生的吗?还是由于年龄的差距确实影响了青蛙的舌头黏力呢? 于是,两位科学家使用置换检验的方法对数据进行了分析: # Compute difference of mean impact force from experiment: empirical_diff_means empirical_diff_means = diff_of_means(force_a,force_b)#求得原始数据的平均值的差值 # Draw 10,000 permutation replicates: perm_replicates perm_replicates = draw_perm_reps(force_a, force_b, diff_of_means, size=10000)#重复一万次实验之后统计差值分布情况 # Compute p-value: p p = np.sum(perm_replicates >= empirical_diff_means) / len(perm_replicates)#计算统计差值中比原始数据差值还大的可能 # Print the result print('p-value =', p) output: p-value = 0.0063 可以看到,在这个假设中,我们认为:FROG_A和FROG_B的分布是相同的(年龄并不影响舌头的黏力)(You will compute the probability of getting at least a 0.29 N difference in mean strike force under the hypothesis that the distributions of strike forces for the two frogs are identical. )。经过反复实验之后,我们得到依据原始数据得出的(估计的,可能的)客观世界均值的差值的分布情况,并求出了原始数据以及比原始数据更大(更加离谱的差值)的概率,他是0.6%,说明出现这种比原始数据还离谱的差值概率是很小的。所以我们只能否定原来的假设,认为年龄是影响舌头黏力的因素。 这就是简单置换检验。 ----------------------------------------------------------------------------------------------------------------------------------- Bootstrap hypothesis tests ----------------------------------------------------------------------------------------------------------------------------------- A one-sample bootstrap hypothesis test 下面科学家继续对青蛙们进行研究: 在后面的研究中,科学家们发现了另一组青年青蛙FROG_C(FROG_B也是年轻青蛙哦),但不幸的是,FROG_C原始数据由于某些原因遗失,只记得它们的黏力均值为0.55N,而FROG_B的黏力均值是0.4191。因为没有FROG_C原始数据,所以我们无法进行置换检验,无法确定FROG_B和FROG_C是否服从同一种分布(是否是同一种青蛙)。它们是同一种青蛙吗?为了进行分析,两个科学家绞尽脑汁,提出了一个大胆的想法: 既然不能确定分布情况,那我们假设FROG_B和FROG_C的黏力均值是一样的好了(The mean strike force of Frog B is equal to that of Frog C.): Another juvenile frog was studied, Frog C, and you want to see if Frog B and Frog C have similar impact forces. Unfortunately, you do not have Frog C's impact forces available, but you know they have a mean of 0.55 N. Because you don't have the original data, you cannot do a permutation test, and you cannot assess the hypothesis that the forces from Frog B and Frog C come from the same distribution. You will therefore test another, less restrictive hypothesis: The mean strike force of Frog B is equal to that of Frog C. To set up the bootstrap hypothesis test, you will take the mean as our test statistic.Remember, your goal is to calculate the probability of getting a mean impact force less than or equal to what was observed for Frog Bif the hypothesis that the true mean of Frog B's impact forces is equal to that of Frog C is true. You first translate all of the data of Frog B such that the mean is 0.55 N. This involves adding the mean force of Frog C and subtracting the mean force of Frog B from each measurement of Frog B. This leaves other properties of Frog B's distribution, such as the variance, unchanged. # Make an array of translated impact forces: translated_force_b translated_force_b = force_b-np.mean(force_b)+0.55#改变FROG_B的黏力(为什么要改FROG_B的数据呢???认为FROG_B的原始数据采集错误吗?) # Take bootstrap replicates of Frog B's translated impact forces: bs_replicates bs_replicates = draw_bs_reps(translated_force_b, np.mean, 10000)#bootstrap reps # Compute fraction of replicates that are less than the observed Frog B force: p p = np.sum(bs_replicates <= np.mean(force_b)) / 10000#求p # Print the p-value print('p = ', p) output: p = 0.0046 用人类普通话重复一下代码语言就是:在我们做出的假设的前提下,修改了一组FROG_B的数据(因为我们没有均值为0.55N的实验数据,所以我们杜撰了这个???我不确定这里我的理解是否正确),使之均值为0.55,记录于translated_force_b中,我们经过10000次bootstrap replicate实验,我们得出了满足假设条件的客观世界的均值分布,最后求出比真实FORG_B数据更加极端的所有情况的概率是0.46%,可能性很小,所以否定了原来的假设,即FROG_B的黏力均值几乎不可能和FROG_C相等。 可以看到这个实验是针对一组有数据的样本,和一组没有数据的样本(只是知道其中的某个统计量),以这个没有样本的某个统计量为研究目的进行的分析。 ----------------------------------------------------------------------------------------------------------------------------------- A bootstrap test for identical distributions 这个实验是基于两种样本完整的数据,检测他们是否具有相同的分布情况(Frog A and Frog B have identical distributions of impact forces ): # Compute difference of mean impact force from experiment: empirical_diff_means empirical_diff_means = diff_of_means(force_a,force_b) # Concatenate forces: forces_concat forces_concat = np.concatenate((force_a,force_b)) # Initialize bootstrap replicates: bs_replicates bs_replicates = np.empty(10000) for i in range(10000): # Generate bootstrap sample bs_sample = np.random.choice(forces_concat, size=len(forces_concat)) # Compute replicate bs_replicates[i] = diff_of_means(bs_sample[:len(force_a)], bs_sample[len(force_a):]) # Compute and print p-value: p p = np.sum(bs_replicates>=empirical_diff_means) / len(bs_replicates) print('p-value =', p) output: p-value = 0.0055 代码过程解析: 1、首先我们认为FROG_A和FROG_B的分布是相同的,那么我们就可以将其合并(forces_concat = np.concatenate((force_a,force_b))); 2、利用bootstrap replicate,我们可以有放回地抽取force_a,force_b长度的两组数据,求平均值(得到一种可能的客观世界均值),并对平均值做差。 3、重复2步骤10000次,我们就得到了可能的客观世界中两个里在假设情况下均值之差的分布情况。 4、检验比原始数据(empirical_diff_means = diff_of_means(force_a,force_b))更极端的情况发生的概率是多少,求出p值。 得到了概率为0.55%,很小,所以我们否定了原来的假设,即:FROG_A和FROG_B不应该有相同的分布情况。 可以看到,与重置检验的方法类似,两个检验方法的出发点都是:在两个给出的样本中,如果假设他们的分布相同,那么均值之差为0.29的情况下在是否是一个大概率事件。但两种方法孰优孰劣呢?datacamp中老师们给出的答案是: Testing the hypothesis that two samples have the same distribution may be done with a bootstrap test, but a permutation test is preferred because it is more accurate (exact, in fact). 可见,重置检验的方法是更加值得信任的。 但重置检验方法也有它的局限性: But therein lies the limit of a permutation test; it is not very versatile. We now want to test the hypothesis that Frog A and Frog B have the same mean impact force, but not necessarily the same distribution. This, too, is impossible with a permutation test. 当我们只想比较FROG_A和FROG_B是否具有相同的均值,而不必知道他们是否有相同的分布时,重置检验就没有办法了。 ----------------------------------------------------------------------------------------------------------------------------------- A two-sample bootstrap hypothesis test for difference of means. # Compute mean of all forces: mean_force mean_force = np.mean(forces_concat) # Generate shifted arrays force_a_shifted = force_a - np.mean(force_a) + mean_force force_b_shifted = force_b - np.mean(force_b) + mean_force # Compute 10,000 bootstrap replicates from shifted arrays bs_replicates_a = draw_bs_reps(force_a_shifted, np.mean, 10000) bs_replicates_b = draw_bs_reps(force_b_shifted, np.mean, 10000) # Get replicates of difference of means: bs_replicates bs_replicates = bs_replicates_a - bs_replicates_b # Compute and print p-value: p p = np.sum(bs_replicates>=empirical_diff_means) / len(bs_replicates) print('p-value =', p) output: p-value = 0.0043 可以看到,bootstrap analysis确实具有更加灵活多样的检验能力,不仅可以检验两组数据是否具有相同的分布,而且可以检验数据是否具有相同的均值。 that's all thank you~

优秀的个人博客,低调大师

模力方舟百模破浪 —— 北京经开区推进 AI 开源开放生态共创

4月27日下午,在北京人工智能产业生态创新发布会上,开源人工智能社区“模力方舟”正式发布,“开源人工智能应用创新大赛”也同步启动,经开区将围绕建设全域人工智能之城,助力共建国内AI开源开放生态。 模力方舟依托开源中国17年生态构建,积累超1800万开发者、2000余所高校、36万家企业,以绝对中立平台面向开发者提供从开源模型、训练数据集、国产算力底座到模型在线微调测试的全流程支持,降低大模型开发门槛,提高开发效率,以深厚的开源和开发者服务底蕴,致力于成为AI时代的重要创新引擎与生态共建平台。 https://ai.gitee.com “模力方舟”旨在对标国外开源社区Hugging Face,于2024年1月上线,算力供给方面与沐曦MetaX、华为昇腾、天数智芯、摩尔线程等国产GPU企业合作,目前已积累约16000个开源模型及约10000个高质量数据集,覆盖自然语言处理、计算机视觉等主流AI领域,注册用户数超100万。 建设“模力方舟”有哪些资源基础?未来又将如何推进?北京经开区有关负责人介绍:“此前,经开区与北京市联动投资牵引国内头部开源社区企业——开源中国总部落地经开区。基于开源中国在传统开源领域的生态积累,围绕人工智能开源大模型和国产算力底座软硬一体化适配,我们启动了人工智能开源社区‘模力方舟’建设工作。” 为助力“模力方舟”建设成为具有国际影响力的开源人工智能社区,经开区将支持开源中国从夯实平台能力、引导资源汇聚、打造国际品牌、政策保驾护航四个方面展开工作。具体来说,充分依托公有云的弹性拓展特性与私有云的安全可控优势,精心构建起具备高并发处理能力、能够实现低延时响应的算力基础设施体系;整合自然语言处理、计算机视觉、语音识别等多个AI核心领域的国内外前沿模型,以及图像数据集、文字数据集、各类先进算法;围绕“一赛一会”这一核心策略持续扩大影响力,举办开源人工智能大赛及开源峰会等品牌活动,推动具有高成长性的开源AI创业项目在开源社区形成落地集聚;对优质开源项目、优秀商业化应用、开源生态活动给予一定资金支持等。 值得一提的是,在本次发布会上,“一赛一会”核心策略中的“开源人工智能应用创新大赛”正式启动。由开源中国联合战略合作伙伴,华为昇腾、商汤科技、智谱(Z.ai)、沐曦MetaX、天数智芯、睿思芯科、希姆计算等国内领先人工智能企业共同发起。他们将为赛事提供核心算力支持、先进AI模型、优质数据资源以及行业生态联动支持。这是一场全国性的人工智能赛事,定位国家级影响力赛会,通过竞赛展示开源与人工智能前沿技术创新和商业化应用,推动产业化落地,为项目实践应用提供发展平台。大赛设专业组和青少年组两个组别:专业组赛道涵盖AI医疗、AI金融、AI智能制造、视觉呈现与感知、具身智能与机器人、AI教育与智能教学解决方案等七大方向,青少年组赛道包括创新场景实践应用、AI算法设计与优化等四大方向。 此外,入选团队将在半决赛中与2025 GOTC全球开源技术峰会深度联动,为参赛团队打造国际化的展示舞台。优秀项目可在峰会分论坛演讲,演示对抗和大咖点评,全程媒体直播,让创新成果获得最大曝光。 与此同时,为更好地促进参赛团队创新成果落地,大赛主办方与经开区政府积极联动,将设立一、二、三等奖及多项单项奖项,为获奖团队提供奖金和配套政策支持,同时协调优质办公空间及算力资源的方式支持优秀项目孵化落地。 本次大赛旨在打造一项全国性、具有国家级影响力的人工智能赛事,目标是通过赛事展示技术创新与商业化应用,推动产业落地,聚焦人工智能的前沿技术,同时也为项目的实际应用提供发展平台。 目前,大赛已面向全国范围的参赛者开放报名,参赛团队可通过报名通道提供成熟的技术方案、商业化路径与应用场景等作品。

优秀的个人博客,低调大师

「中国开源原生商业社区」将在 GOTC 2021 启动,共创中国开源原生商业生态圈

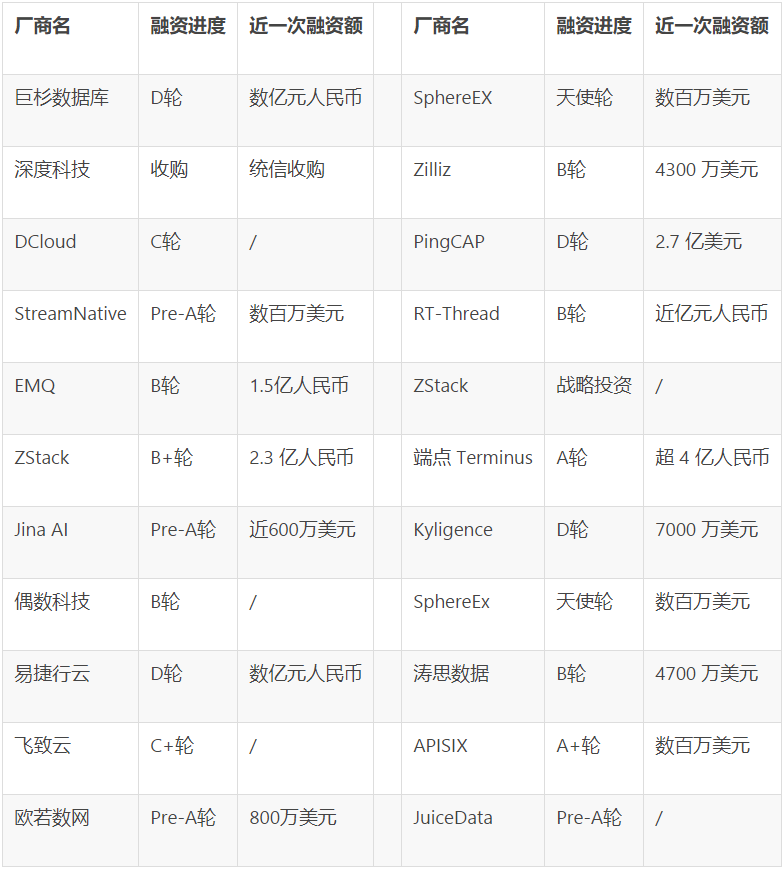
7 月 31 日至 8 月 1 日,GOTC 全球开源技术峰会深圳站会在深圳会展中心与大家见面,继续开源之旅。同时,GOTC 2021 深圳站特设「开源原生商业」专题论坛,正式启动中国开源原生商业社区。 2021 年可以称得上是开源商业化爆发的一年,根据 OSS Capital 的统计,国际上截至 2021 年上半年,仅仅 6 个月的时间里风投公司对开源商业公司的投资额已经超过了 50 亿美元,全年产品融资额已经达到甚至超越此前 20 年的总和,开源上市公司市值突破 5000 亿美元。 中国领域内的开源虽然起步较晚,但是当前也显示出了片片生机。自 2019 年起,我国逐渐孕育出首个国际通用的开源许可证 Mulan PSL2,组建了立足本土的开放原子开源基金会,与此同时,大型开源项目在茁壮成长,开源原生商业公司接连获得市场的青睐。中国目前已有多家商业公司通过核心开源项目打造自己的商业闭环,构筑了开源软件生态链并取得了令人振奋的资本助推。 以下是本土开源原生商业公司最新融资概况: 为进一步支持中国开源事业的发展,7 月 31 日下午,GOTC 全球开源技术峰会将邀请众多开源原生商业公司代表齐聚「开源原生商业」专题论坛,为现场观众呈现一幅中国开源原生商业公司版图。届时,由国家工业信息安全发展研究中心(工业和信息化部电子第一研究所)与开源中国牵头,并联合二十余家公司发起的「中国开源原生商业社区」将正式启动,共同组建一个互惠互利,携手共进的开源社区。 中国开源原生商业社区旨在凝聚开源生态的产业界力量,整合优质资源,促进相关主体之间的深度交流和合作,形成优势互补,面向商业成功,构建合作共赢的开源原生生态圈,有效推进开源软件的产业发展。 中国开源原生商业社区以“体现商业核心利益”为共性,设秘书处与执行单位,遵循零门槛准入准出原则,高度自治。社区主要由各领域单位构成,除工信部一所外,还有各个开源原生商业公司、投资机构如天际资本、创投媒体如 36Kr、以及助力开源的社区如开源中国。 「开源原生商业」专题论坛议程如下: GOTC,the Global Opensource Technology Conference,即全球开源技术峰会。该会议由开放原子开源基金会与 Linux 基金会亚太区联合开源中国社区共同发起,邀请 10+ 重量级开源基金会与开源社区深度参与,覆盖 100+ 公司的相关开源经验,涉及优秀开源项目 300+。峰会将携头部开源公司和顶级开源项目一起亮相,覆盖云原生、人工智能、物联网、区块链、大前端、音视频、安全、操作系统、数据库、开源治理等多个技术领域,为开发者带来全球最新、最纯粹的开源技术,同时传播开源文化和理念,推动开源生态的发展和建设。 大会详情请查看:https://gotc.oschina.net/

优秀的个人博客,低调大师

致敬过去,迎接未来:DataCap 感恩有您的 2023,翘首期盼 2024 的精进与共创

亲爱的 DataCap 软件用户,开发者: 时光荏苒,2023 年即将成为过去,我们深感荣幸与感慨地站在这个时刻,对您们表达我们最深切的感谢。在过去的一年中,我们一直感受到了您们对我们软件的不离不弃和坚定支持,这是我们最宝贵的动力。 2023 年是我们 DataCap 软件发展的关键一年。我们荣幸地宣布,预定支持的大部分功能在这一年里得以实现。然而,我们也要坦诚地承认,虽然这些功能在某些方面还存在不足和改进的空间,但正是在这个过程中,您们对我们软件的宽容与理解成为我们前行路上最强大的支持。无论是在社交媒体上的反馈,还是通过邮件和客服的沟通以及 GitHub 和 Gitee 反馈,您们的每一次建议和反馈都是我们前进的明灯,是我们改进的方向。 在这个感恩的季节,我们要向每一位 DataCap 用户致以最衷心的感谢。是你们的热情使用和持续支持,让我们能够不断发展、完善软件。每一个新的用户,每一个老用户,都是我们成长历程中不可或缺的一部分。感谢您们的信任,让我们得以在软件开发的道路上越走越远。 随着 2023 年即将谢幕,我们更加兴奋地展望着 2024 年。我们承诺,为了回馈您们的信任,我们将不遗余力地投入到软件的不断完善中。我们将不懈努力,以确保软件在稳定性、安全性和用户友好性方面取得更大的进步。我们也将持续关注用户反馈,不断优化用户体验,确保软件在您们手中能够发挥最大的价值。同时也希望您在使用软件中遇到的任何问题以及技术与我们沟通,我们将会以最大能力去解决并修复它。 在此,我们要特别感谢那些默默为软件发展贡献的开发者们 (排名不分先后,开发者的列表为 github 中的 id,如果您有兴趣可以关注他(她)们)。mlboy、why198852、javalover123、pan3793、GtoCm、Smilewh888、chenwenming-zj、Stacey1018、hometownglory、shuangzishuai 等等,感谢你们的辛勤付出和无私奉献。正是有了你们的技术支持,软件才能不断创新、不断进步。 感谢 GitHub,Gitee 对软件的托管和支持,在此向他们所有的工作人员致敬。 感谢 OpenTiny 对我们的支持。 最后,让我们向新老用户们表达最真挚的感激之情。是你们的陪伴,让我们在软件的道路上走得更加坚定。在新的一年里,我们期许能够为您们带来更多的惊喜和便捷。无论您是一位新用户,还是一位老用户,都请相信,您的支持是我们前行的最大动力。 2024 年,愿我们继续携手,共同创造更加美好、更加智能的未来。 再次感谢您们的支持! DataCap 软件团队 (Devlive 开源组织)

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册