首页 文章 精选 留言 我的

精选列表

搜索[CodeBuddy开发者分享季],共10002篇文章
优秀的个人博客,低调大师

#WorkBuddy#/经验分享

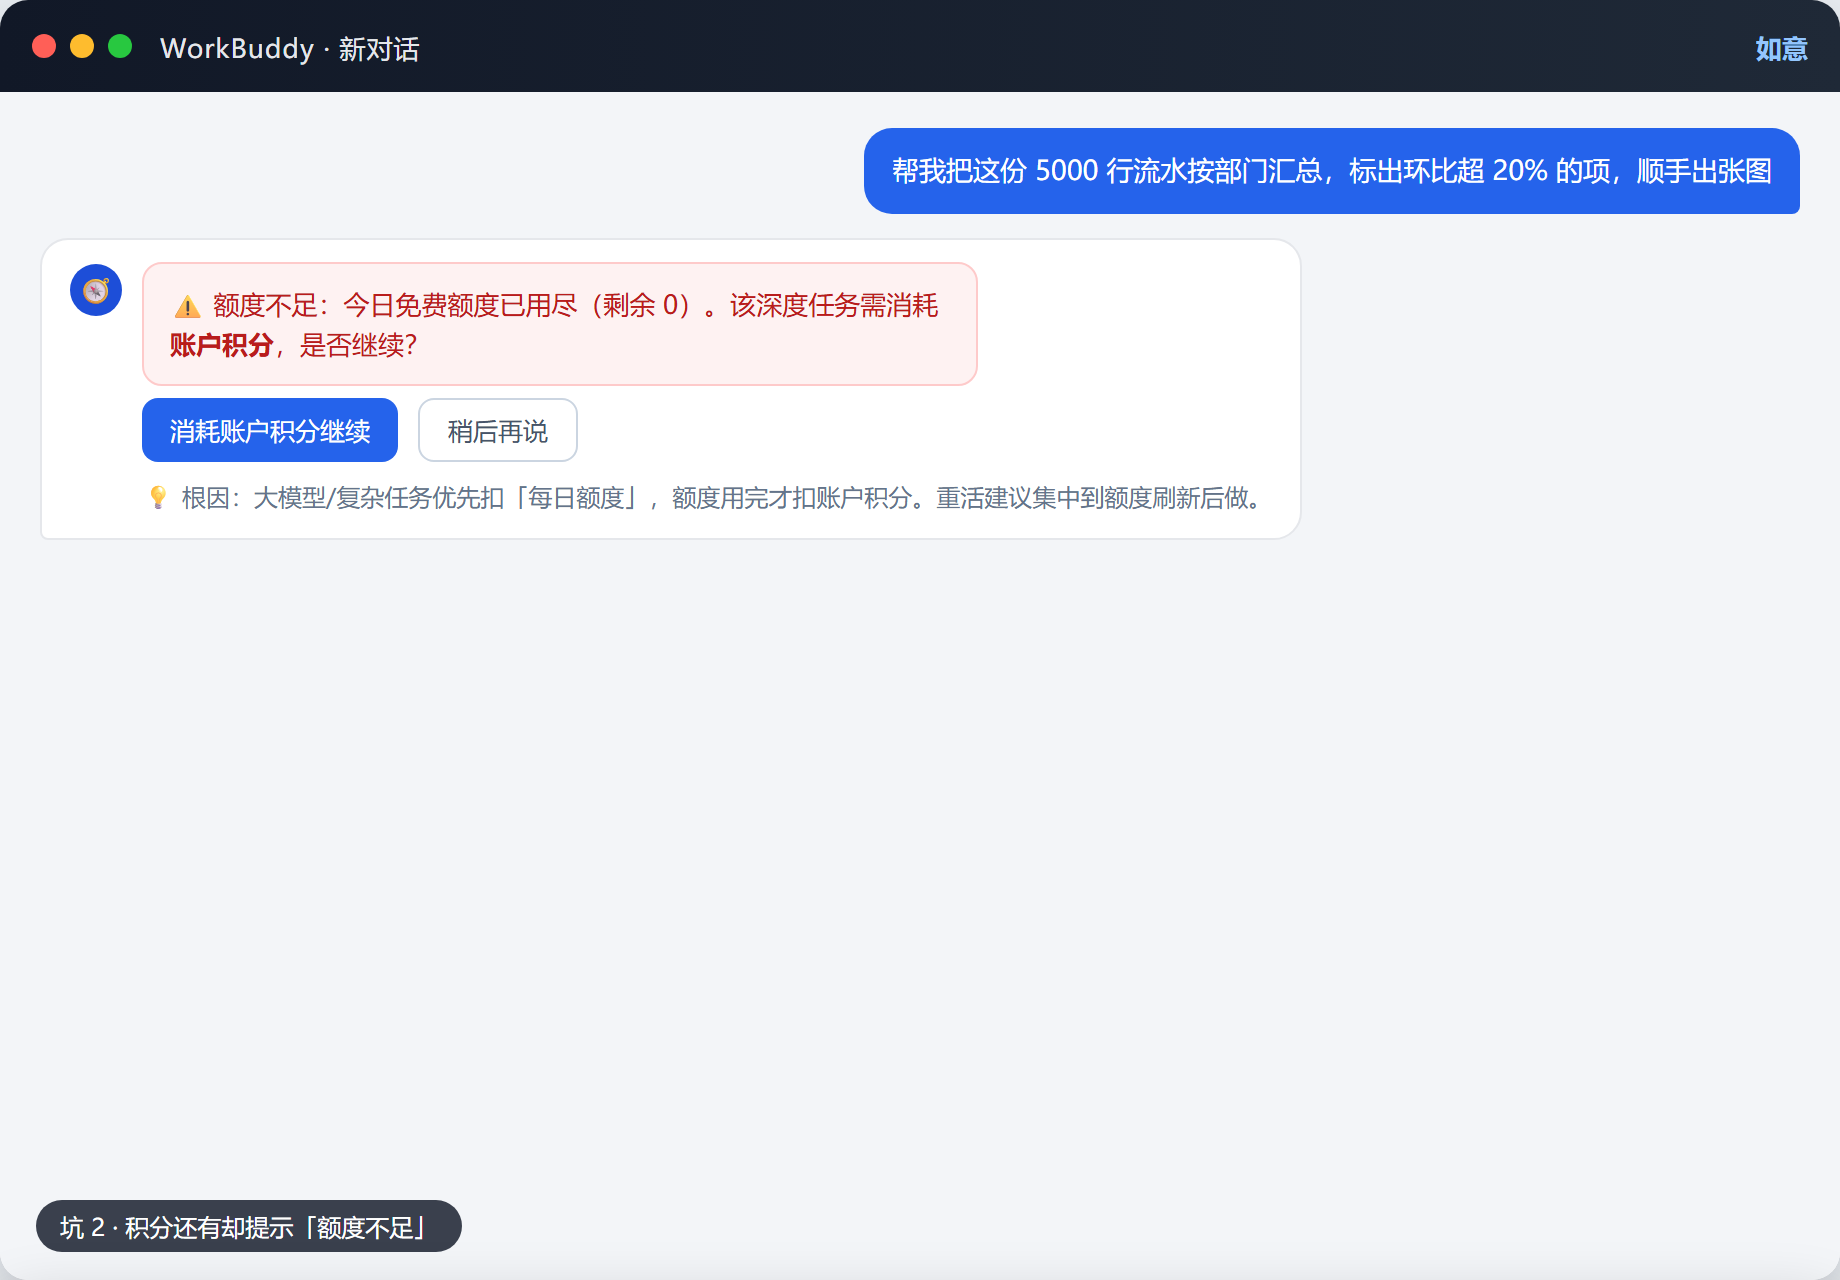
# WorkBuddy 新手最常踩的 10 个坑与避坑指南 # 适用对象:刚接触 WorkBuddy 或用了不到一个月、总觉得"哪里不对"的用户。 核心结论:90% 的"不好用"不是工具不行,是用法没对上。本文汇总社区里被问最多的 10 个问题,每个都给出复现步骤、根因分析和解决方案——看完能少走至少一周弯路。配图说明:文中 5 张客户端截图均为按真实场景还原的模拟界面,文案与报错均来自实际使用反馈,可直接用于社区发布。 ## 目录 # 坑 1:AI 生成的表格/文档格式错乱坑 2:积分明明还有,突然提示"额度不足"坑 3:让 AI 读本地文件,结果它"看不见"坑 4:长任务执行到一半断了,白忙活坑 5:生成 PPT 后内容对不上需求坑 6:代码运行报错,AI 给的方案不生效坑 7:多轮对话后 AI"失忆",前面说的不算了坑 8:Connector 连不上,提示授权失败坑 9:输出内容太长被截断坑 10:同样的 Prompt,每次结果不一样一句话总结:避坑 checklist ## 坑 1:AI 生成的表格/文档格式错乱 # **症状**:让 AI 生成一个带格式的表格,复制到 Excel 或 Word 里列对不齐、中文乱码、字体全变。**根因**:Markdown 表格和标准办公软件的数据格式不是一回事。直接复制粘贴会丢失制表符、合并单元格等结构信息。**解决方案**:场景正确做法要进 Excel让 AI 输出 CSV 格式,或保存为 .xlsx 文件再下载要进 Word让 AI 直接生成 .docx 文件,不要复制 Markdown只是临时看用 WorkBuddy 自带的预览功能,不要导出**Prompt 模板**:"请将结果保存为 Excel 文件(.xlsx),列名用中文,日期格式统一为 yyyy-mm-dd,金额保留两位小数。" ## 坑 2:积分明明还有,突然提示"额度不足" ![](https://developer.qcloudimg.com/http-save/audit-12835205/068b68e5b26d2eb8ae1048dd4245bc07.png) # **症状**:账户显示剩余积分 3000+,执行一个中等任务却弹出"额度不足"。**根因**:WorkBuddy 的积分体系分"每日额度"和"账户积分"两档。每日额度是每天重置的免费调用上限;账户积分是额外攒的。大模型调用、复杂任务会优先扣每日额度,额度用完才扣账户积分。如果当日额度已耗尽,即使账户积分充足,部分任务也会被拦截。下图为该坑在 WorkBuddy 客户端中的真实表现(模拟截图,文案与报错均按真实场景还原):**解决方案**:先看清楚提示是"日额度"还是"账户积分"不足;日额度用完时,可手动切换消耗账户积分(部分场景支持);重度用户建议把高消耗任务集中到每日额度刷新后执行(通常凌晨重置)。 ## 坑 3:让 AI 读本地文件,结果它"看不见" ![](https://developer.qcloudimg.com/http-save/audit-12835205/d52719a3a517600e237cba29d854d48b.png) # **症状**:上传了一个 .xlsx 或 .pdf,AI 回复"未检测到文件"或分析的内容和文件对不上。**根因**:文件还在上传中,AI 已经开始处理;文件格式被系统识别为"不可读"(如加密 PDF、扫描版图片 PDF);文件太大,触发了大小限制。下图为该坑在 WorkBuddy 客户端中的真实表现(模拟截图,文案与报错均按真实场景还原):**解决方案**:情况处理方法上传没完成等文件显示"已上传"再发指令,不要急着回车加密/扫描 PDF先用 OCR 工具转成可编辑文本,再上传文件过大拆分成多个小文件,或只上传关键 Sheet/页格式不确定优先传 .xlsx、.csv、.txt,兼容性最好 ## 坑 4:长任务执行到一半断了,白忙活 # **症状**:让 AI 处理一个 5000 行的表格或写一份长报告,执行几分钟后报错中断,前面的结果也没保存。**根因**:单次对话有 Token/时间上限,超长任务容易触发截断;部分复杂操作(如多表合并、大量数据清洗)超出单次处理能力。**解决方案**:**分而治之**:把大任务拆成 3-5 个小步骤,逐步推进;**先采样后全量**:先让 AI 处理前 50 行验证逻辑,确认无误后再执行全量;**关键节点保存**:每完成一个子任务,让 AI 输出中间结果并保存为文件,不要全部堆在一轮对话里。**Prompt 模板**:"请先只处理前 50 行数据,展示处理逻辑和中间结果。我确认无误后,再执行全量处理。" ## 坑 5:生成 PPT 后内容对不上需求 # **症状**:让 AI 做一份 PPT,出来的框架很空、内容泛泛、数据全是占位符。**根因**:Prompt 里只说了"帮我做一份销售汇报 PPT",没有给素材、没有定结构、没有标重点。AI 没有读心术,信息越少,填空越多。下图为该坑在 WorkBuddy 客户端中的真实表现(模拟截图,文案与报错均按真实场景还原):**解决方案**:要素写法示例主题"Q3 销售复盘"页数"15 页左右"结构"封面→目标回顾→数据亮点→问题分析→下季度计划"数据源"数据见附件 Excel,重点看 Sheet2"风格"商务简洁,蓝白配色,每页不超过 6 行字"**Prompt 模板**:"基于附件 Q3 销售数据,生成一份 15 页的汇报 PPT。结构:封面→目标回顾→区域业绩对比(用柱状图)→Top3 成功经验→3 个主要问题→下季度重点计划。风格商务简洁,每页核心结论放在标题。" ![](https://developer.qcloudimg.com/http-save/audit-12835205/b298687e4d1d9708e71cf4a9620d1ce5.png) ## 坑 6:代码运行报错,AI 给的方案不生效 # **症状**:AI 写了一段 Python/Shell 代码,复制到本地运行报错;或者 AI 说"执行成功",但结果不对。**根因**:AI 不知道你的本地环境(Python 版本、包依赖、操作系统);路径、权限、编码等本地差异导致代码无法直接复用;AI 有时会"编造"不存在的 API 或参数。**解决方案**:**先给环境信息**:在 Prompt 里说明操作系统、Python/Node 版本;**小步验证**:让 AI 先写最小可运行片段,确认能跑通再扩展;**报错回传**:把完整的报错信息贴回对话,AI 修正准确率会大幅提升;**不要盲信**:涉及删除、修改系统文件的命令,先在沙箱或备份环境测试。 ## 坑 7:多轮对话后 AI"失忆",前面说的不算了 # **症状**:聊了 20 轮之后,AI 忘记了最初的任务目标,开始重复提问或偏离主题。**根因**:对话上下文有长度限制,超过一定轮数或 Token 数后,最早的内容会被"遗忘"。这是大模型架构的固有限制,不是 Bug。下图为该坑在 WorkBuddy 客户端中的真实表现(模拟截图,文案与报错均按真实场景还原):**解决方案**:策略做法定期小结每 5-8 轮让 AI 总结当前共识,作为后续对话的起点关键信息前置每轮对话把核心约束重复一遍(可以用引用格式)新开会话任务阶段切换时(如从"分析"到"输出"),果断新开一个对话,把前文摘要贴进去用文件传递把已确认的中间结果保存为文件,下一轮直接上传 ![](https://developer.qcloudimg.com/http-save/audit-12835205/9ebd175c87a5e3f1e16a764c811ba800.png) ## 坑 8:Connector 连不上,提示授权失败 # **症状**:点击某个 Connector(如腾讯文档、飞书、GitHub),弹出授权页面但授权后仍显示"未连接"。**根因**:授权窗口被浏览器拦截;授权 Token 过期或权限范围不足;企业版账号和个人版账号混用导致权限不匹配。**解决方案**:授权时确保浏览器弹窗未被拦截,允许打开新窗口;授权后返回 WorkBuddy 界面,手动刷新 Connector 列表;检查授权时选择的账号是否与 WorkBuddy 登录账号一致;企业版服务(如腾讯文档企业版)需管理员开通 API 权限,个人授权无效。 ## 坑 9:输出内容太长被截断 # **症状**:让 AI 输出一份完整报告,结果到一半突然结束,后面没了。**根因**:单次输出有 Token 上限,长内容会被截断。部分场景下 AI 也会"偷懒",用省略号代替详细展开。下图为该坑在 WorkBuddy 客户端中的真实表现(模拟截图,文案与报错均按真实场景还原):**解决方案**:**分段索取**:"先写第一部分:背景分析。写完后我提示你再写第二部分。"**扩写指令**:被截断后回复"继续"或"从上一段接着写",通常可以续上;**控制密度**:要求"只写要点,不要展开",减少单次输出量;**文件输出**:长内容让 AI 保存为文件下载,绕过聊天窗口的长度限制。 ## 坑 10:同样的 Prompt,每次结果不一样 # **症状**:同一个问题问两遍,答案不一样;甚至同一次复制粘贴,结果也有差异。**根因**:大模型本质上是概率生成,Temperature(随机性)不为 0 时,每次采样结果都会不同。这是设计特性,不是故障。**解决方案**:场景对策需要稳定结果在 Prompt 里加约束:"请严格按以下步骤执行,不要省略"需要可复现把确认好的结果保存为模板/文件,不要依赖重新生成结果差异大检查是否切换了模型版本(不同模型输出风格不同)追求一致性用"Step 1/2/3"结构化 Prompt,减少模型自由发挥空间 ## 一句话总结:避坑 checklist # 坑一句话解法格式错乱要文件直接生成文件,不要复制 Markdown额度不足分清"日额度"和"账户积分",大任务挑时段文件读不到等上传完成再指令,优先传 xlsx/csv长任务中断拆成小步,先采样验证PPT 太水给结构、给数据、给页数、给风格代码报错先报环境信息,小步验证,报错回传AI 失忆定期小结,关键信息前置,阶段切换开新会话Connector 失败查弹窗拦截、查账号一致、企业版需管理员开权限输出截断分段索取,长内容输出为文件结果不稳定结构化 Prompt,好结果及时固化 ---

优秀的个人博客,低调大师

使用WorkBuddy感受分享

先说最直观的感受:信息找人,不用人找信息。 以前做项目,最头疼的就是“找东西”。合同在哪?上次的审批流程走到哪了?这个客户之前是谁跟进的?翻聊天记录、翻邮件、翻文件夹,有时候光找这些就花掉半天时间。现在WorkBuddy把所有信息都串起来了,我只要在搜索框里敲几个关键词,相关项目、客户、单据、审批记录,清清楚楚列出来。更爽的是,它还会主动提醒我——该续签合同了、该催款了、某项任务快到期了,我一个做项目的人,再也不用靠脑子记这些琐碎的deadline,省心太多了。 协作效率的提升,是很明显的。 我们团队经常要跨部门沟通,以前发个需求,在微信群里@人,对方可能隔半天才回,或者干脆忘了。现在直接在WorkBuddy上建任务,指派责任人,设置截止时间,系统自动跟踪进度。谁完成了、谁超时了,一目了然,根本不用我去催。而且所有沟通记录都在任务下面,不会像微信那样被新消息刷走,翻历史记录特别方便。上周我们一个紧急项目,销售、技术、采购三个部门同时在线协作,以前至少要开两三次会才能对齐的事,这次在系统里一天就捋清楚了,大家都不用来回跑,效率直接翻倍。 管理层看数据,比以前靠谱多了。 以前老板问项目进度,我得先问各个负责人,再手动汇总,数据还经常对不上,有时候给老板的报表和实际差一大截,特别尴尬。现在WorkBuddy自动生成报表,所有数据都是实时更新的,从合同签约到回款周期,从项目进度到人员工效,一眼就能看明白。上个月我们复盘项目,发现某环节总是超时,系统自动分析出了瓶颈点,我们针对性地优化了流程,这个月的交付效率明显提高了。 几个小细节,挺打动我的。 一是手机端做得不错,出差在路上,用手机就能审批、看任务、回复消息,不用非得开电脑。二是系统很灵活,我们公司有些业务比较特殊,之前担心新系统不好用,结果跟实施顾问沟通后,很快就配置上了个性化模块,没有想象中那么僵化。 当然,也不是没有槽点。刚上线那两周,大家都不太习惯,老员工对操作流程不熟悉,内部培训花了不少时间。而且有些功能确实偏复杂,对于习惯简单操作的人来说,学习成本有点高。但熬过适应期之后,发现其实都是熟能生巧的事。 总的来说,用WorkBuddy最大的感受就是:省心、省力、省时间。 以前做项目,人围着流程转,天天追着人问进度;现在流程围着人转,系统帮我把杂事打理好,我只需要专注做好业务本身。如果你也在为公司管理混乱、效率低下发愁,真心建议试试这个工具,它可能不会让你立刻变强,但一定会让你少走很多弯路。 ![](https://developer.qcloudimg.com/http-save/audit-12668258/42da8d1e69263f924b195c8b4b831029.png) ![](https://developer.qcloudimg.com/http-save/audit-12668258/d329debf5c083b8280b006dcb848a8dd.png) ![](https://developer.qcloudimg.com/http-save/audit-12668258/e49e655de694d0bafe6d23e03d52f9a5.png) 「WorkBuddy」「AI办公」

优秀的个人博客,低调大师

技术分享连载(十三)

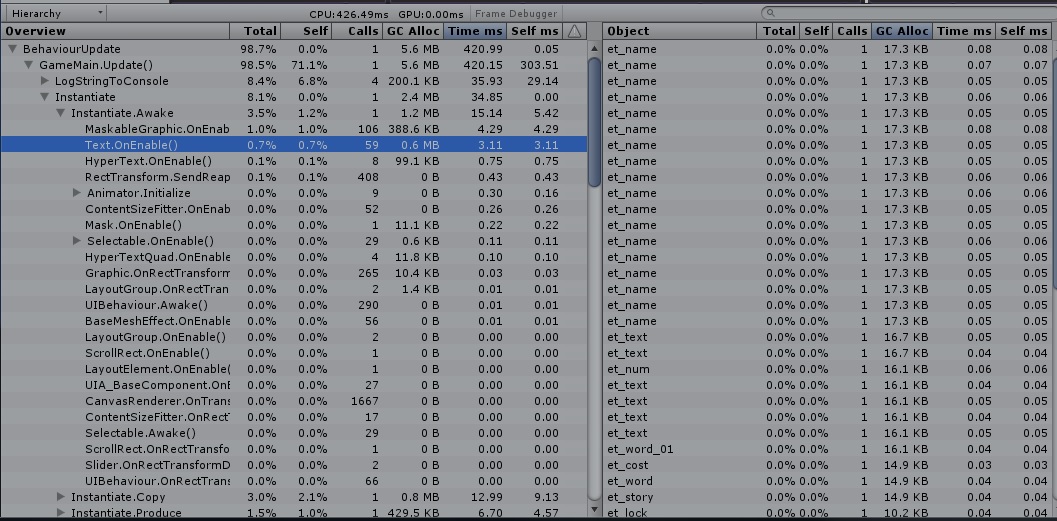
资源管理 Q1: 请问粒子特效的Shader是否不能使用依赖打包? 我们对Shader的模型和特效使用了依赖打包,运行的时候发现模型显示是正常的,但是粒子特效使用的Shader就不能正常运行,特效显示不正常。而在编辑器中,我们看到Material中的Shader是存在的。这时候如果重新手动给这个Material指定同样的Shader,这个粒子特效就能正常显示,请问这是什么原因引起的? 部分 Shader 在打包到 Android 版本的 Assetbundle 之后,会因为平台不兼容而无法正确显示,这是因为打包后的 Shader 代码只保留了目标平台的预编译代码,不一定能够在 Editor 下运行,所以这是正常现象。 但这并不会影响依赖打包,因为在真机上并不会出现类似的问题。 性能优化 Q2:如图,我们在UI打开或者移动到某处的时候经常会观测到CPU上的冲激,经过进一步观察发现是因为Instantiate产生了大量的GC。想请问下Instantiate是否应该产生GC呢?我们能否通过资源制作上的调整来避免这样的GC呢?如下图,因为一次性产生若干MB的GC在直观感受上还是很可观的。 准确的说这些 GC Alloc 并不是由Instantiate 直接引起的,而是因为被实例化出来的组件会进行 OnEnable 操作,而在 OnEnable 操作中产生了 GC,比如以上图中的函数为例: 上图中的 Text.OnEnable 是在实例化一个 UI 界面时,UI 中的文本(即 Text 组件)进行了 OnEnable 操作,其中主要是初始化文本网格的信息(每个文字所在的网格顶点,UV,顶点色等等属性),而这些信息都是储存在数组中(即堆内存中),所以文本越多,堆内存开销越大。但这是不可避免的,只能尽量减少出现次数。 因此,我们不建议通过 Instantiate/Destroy 来处理切换频繁的 UI 界面,而是通过 SetActive(true/false),甚至是直接移动 UI 的方式,以避免反复地造成堆内存开销。 资源管理 Q3: iOS平台需要对图集做RGB和Alpha通道的分离吗?我发现在同样大小的图片(正方形),RGB Compressed PVRTC 4bits和RGBA Compressed PVRTC 4bits两种格式,占用内存是一样的,如果把一张图片分成两张,那么在iOS平台是不是占用内存多一倍?有透明通道的,对于它的图集怎么处理会更好一点? 通常iOS下是不需要做通道分离的,因为 iOS 通用的 PVRTC 格式支持 Alpha 通道。但目前也有团队反馈,在 iOS 上进行通道分离有助于减少失真,可以在一定程度上提高视觉效果,因此也可以尝试做一个对比。 如果发现占用内存是一样的,那么原始图片是RGB的。如果iOS上做通道分离,内存确实会增加一倍。UI的纹理在iOS下可以直接选择默认的 Compress,在打Atlas时会自动处理成 PVRTC,开发团队可以从Sprite packer窗口来看Atlas的压缩格式做个确认。 性能优化 Q4: 关于场景中玩家和NPC名字的DrawCall的问题。我们项目中是使用TextMesh挂到场景单位上,但是这样每个名字就占了一个DrawCall,请问有没有好的办法优化呢? 游戏中的HUD的做法一般有两种,一种是如上的做法,另一种则是通过NGUI/UGUI来制作HUD。第二种的实现方法大致如下: (1)计算屏幕中角色在屏幕中的位置; (2)根据屏幕中的位置来计算各自HUD的位置,并根据HUD的数量分别放置在一个或几个Panel/Canvas下。 第二种方法的优势是尽可能用少的Draw Call数来渲染角色的HUD。开发团队可以就该方法来进行尝试。 性能优化 Q5: 我们能通过Batching来进行效能方面的优化吗?透过粒子发射出来的半透明模型片是无法Saved by Batching ,如果粒子可以使用Dynamic Batching的话,想请教具体的使用规则与方法。 根据Unity 官方的信息,目前粒子系统已经不再进行 Draw Call 的拼合,因为在新版本5.3 中已通过多线程进行更新,暂时无法支持拼合,但性能已经得到提升。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(十五)

图形渲染 Q1:以前端游时代,材质根据Pass不同、光照环境不同可以离线预编译成ShaderCache,运行时并不需要拼材质再实时编译,只要加载二进制代码就好了。那Unity有没有做这件事呢?我们是根据平台和环境预编译的Shader。 对于支持 Binary Shader 加载的设备,在首次编译某个 Shader 的时候是会生成其对应的 Binary Shader Cache ,生成的 Binary 文件位于和 Application.persistantPath 并列的Cache 目录下。 图形渲染 Q2:相同效果前提下,就性能而言,Shader 是用 V&F 还是Surface好? Surface生成的V&F比较庞杂,分支较多,如果不注意 #pragma surface 参数的选择,容易出现不必要的开销。举例来说,如果直接用 Unity 5.x 中默认创建的 Surface Shader (默认参数为 #pragma surface surf Standard fullforwardshadows),那么 Shader 是会做 Physically based Standard Lighting 的,而这在移动端开销非常大,且并非必要。 图形渲染 Q3:Lightmap在Baked GI的等待时间比较长(Realtime GI已关闭),想请教有没有什么建议的参数或是方式,可以缩短等待的时间? 目前就我们的了解,在Unity 5.x比较影响烘焙时间的主要是大面积的面片导致Light Transport 过程过久(Enlighten 的机制所限)。可以尝试拆分面积较大的面片,来提高烘焙的速度(通常,拆分大面积的面片对渲染性能也会有所提升)。 主要原因可参考如下的帖子: http://forum.unity3d.com/threads/light-transport-problem-with-large-objects.310405 资源管理 Q4:Prefab中的GameObject的tag设置为EditorOnly仍然会被打进Resoures包吗?有其它EditorOnly方案吗? EditorOnly理论上只对场景中的 GameObject起效。因此 Project 目录中的 Prefab 打上 EditorOnly 后,放在 Resources 目录下依然会被打进游戏包中。但只要将其放在 Resources 目录以外,则其就会因为没有场景中的物件引用而被排除在外。 内存管理 Q5:对于Handheld.PlayFullScreenMovie 这个Unity播放开场动画的API,会有内存问题吗?比如我的mp4动画有20MB,那么这个动画会撑高mono堆内存吗? Android上PlayFullScreenMovie 的实现实际上是通过Android原生的接口直接播放的,播放过程中Unity也是停止更新的,因此这部分的内存理论上并不会记录在 Unity 中,同样也不影响mono。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册