首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

【最佳实践】Solr集群数据迁移至Elasticsearch

Elasticsearch是一款非常强大的搜索引擎,可以让你在海量的数据中快速找到想要的内容。例如,代码搜索:可以帮助您找到相应的代码仓库,还可以实现代码级的搜索及高亮显示;网上shopping:可以帮助您推荐商品。 除了大数据搜索,Elasticsearch结合Logstash和Beats,还被广泛应用在大数据实时分析领域,例如日志分析、指标监控、信息安全等。帮助您探索海量的结构化和非结构化的数据,按需创建可视化报表、对监控数据设置报警阈值,甚至使用机器学习技术,自动识别异常状况、及时发出警报。 在DBRanking 2019年5月的数据库评测中,Elasticsearch在搜索引擎中排名第一,国内也有大量的公司在使用Elasticsearch。并且Elasticsearch在全球的下载量已经超过了3.5亿次。如果您需要将Solr集群中的数据迁移至Elasticsearch,请跟着本文一步步来操作吧。 本文以阿里云Elasticsearch为例,为您演示通过第三方社区提供的solr-to-es工具,将Solr节点中的文档迁移到阿里云Elasticsearch(简称ES)中的方法。 阿里云Elasticsearch兼容开源Elasticsearch的功能,以及Security、Machine Learning、Graph、APM等商业功能,致力于数据分析、数据搜索等场景服务。支持5.5.3、6.3.2、6.7.0、6.8.0和7.4.0等版本,并提供了商业插件X-Pack服务。在开源Elasticsearch的基础上提供企业级权限管控、安全监控告警、自动报表生成等功能。阿里云Elasticsearch为您提供1个月的免费试用活动,单击此处即可免费试用。 环境准备 创建阿里云ES实例,要求版本为6.x,本文使用6.3.2 版本,详情请参见创建阿里云Elasticsearch实例。 **说明:** 本文使用的solr-to-es迁移工具仅支持阿里云ES 6.x版本,其他版本需自行测试。 开启目标阿里云ES的自动创建索引功能,详情请参见开启自动创建索引。 创建阿里云ECS实例,本文使用CentOS 7.3版本,详情请参见步骤一:创建ECS实例。 **说明:** ECS实例需要与阿里云ES实例在同一区域和可用区,以及同一专有网络VPC(Virtual Private Cloud)下。 在ECS上安装Solr,本文使用5.0.0版本的Solr,详情请参见Solr官方文档。 在ECS上安装Python,要求3.0及以上版本,本文使用Python 3.6.2。 在ECS上安装PySolr,要求3.3.3及以上,4.0以下版本。 安装solr-to-es工具 连接ECS服务器,下载solr-to-es工具。 进入setup.py所在的目录,运行python setup.py install命令,安装solr-to-es工具。 安装成功后,参考以下命令进行文档迁移。 python __main__.py <solr_url>:8983/solr/<my_core>/select http://<username>:<password>@<elasticsearch_url>:9200 <elasticsearch_index> <doc_type> |参数|说明| |--|--| |`<solr_url>`|Solr集群的完整访问地址。例如,http://116.62.\*\*.\*\*。| |`<my_core>`|迁移文档对应的SolrCore的名称。| |`<username>`|阿里云ES的访问用户名,默认为elastic。| |`<password>`|阿里云ES的访问密码,在创建实例时设定。| |`<elasticsearch_url>`|阿里云ES实例的内网或外网访问地址。可在实例的基本信息页面获取,详情请参见[查看实例的基本信息](https://help.aliyun.com/document_detail/67804.html?spm=a2c4g.11186623.2.19.18a87461Jp4xKZ#task-2449896)。| |`<elasticsearch_index>`|待写入的Solr文档对应的索引名称。| |`<doc_type>`|对应索引的类型名称。| **说明:** 如果您使用的是其他版本的solr-to-es工具,也可以尝试使用如下命令进行文档迁移,参数详情请参见[solr-to-es](https://github.com/o19s/solr-to-es)。 solr-to-es [-h] [--solr-query SOLR_QUERY] [--solr-fields COMMA_SEP_FIELDS] [--rows-per-page ROWS_PER_PAGE] [--es-timeout ES_TIMEOUT] solr_url elasticsearch_url elasticsearch_index doc_type 本案例使用以上命令会输出`-bash: solr-to-es.py: command not found`的错误。 操作示例 通过以下命令,查询名称为my_core的SolrCore的所有文档,写入到阿里云ES实例中。对应的索引为elasticsearch_index,索引类型为doc_type。 在Solr环境中,进入solr-to-es-master/solr_to_es文件夹下。 执行以下命令。 python __main__.py 'http://116.62.**.**:8983/solr/my_core/select?q=*%3A*&wt=json&indent=true' 'http://elastic:替换密码@es-cn-so4lwf40ubsrf****.public.elasticsearch.aliyuncs.com:9200' elasticsearch_index doc_type |参数|说明| |--|--| |`q`|Solr的查询语法,必选,可以使用运算符。`*%3A*`表示查询所有文档。| |`wt`|返回的数据类型,支持JSON、XML、Python、Ruby、CSV等格式。| |`indent`|返回结果是否需要格式化展示,默认为`false`。| 其他参数说明请参见[表 1](https://help.aliyun.com/document_detail/143003.html?spm=a2c4g.11174283.6.832.4d097958P4tOeH#table-lnc-t0w-8ud)。 登录目标阿里云ES实例的Kibana控制台。 登录控制台的具体操作步骤请参见[登录Kibana控制台](https://help.aliyun.com/document_detail/122668.html?spm=a2c4g.11186623.2.22.18a87461Jp4xKZ#task-761873)。 单击左侧导航栏的Dev Tools(开发工具),在Console中执行以下命令,查看阿里云ES集群服务中是否已成功创建elasticsearch_index索引。 GET _cat/indices?v 执行以下命令,查看迁移成功的文档详情。 GET /elasticsearch_index/doc_type/_search 查询成功后,返回如下结果。 { "took" : 12, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : 2, "max_score" : 1.0, "hits" : [ { "_index" : "elasticsearch_index", "_type" : "doc_type", "_id" : "Tz8WNW4BwRjcQciJ****", "_score" : 1.0, "_source" : { "id" : "2", "title" : [ "test" ], "_version_" : 1648195017403006976 } }, { "_index" : "elasticsearch_index", "_type" : "doc_type", "_id" : "Tj8WNW4BwRjcQciJ****", "_score" : 1.0, "_source" : { "id" : "1", "title" : [ "change.me" ], "_version_" : 1648195007391203328 } } ] } } 相关活动 更多折扣活动,请访问阿里云 Elasticsearch 官网。 阿里云 Elasticsearch 商业通用版,1核2G ,SSD 20G首月免费阿里云 Logstash 2核4G首月免费

优秀的个人博客,低调大师

Java 日志框架解析:汇总及最佳实践

基本介绍 在java的世界里有许多实现日志功能的工具,最早得到广泛使用的是 log4j,现在比较流行的是slf4j+logback。作为开发人员,我们有时候需要封装一些组件(二方包)提供给其他人员使用,但是那么多的日志工具,根本没法保证每个组件里都能使用约定好的日志工具,况且还有很多第三方的包,鬼知道他会用什么日志工具。假如一个应用程序用到了两个组件,恰好两个组件使用不同的日志工具,那么应用程序就会有两份日志输出了,蛋疼吧。。下面简单介绍下常见的日志工具: ▐ JUL JUL 全称 java.util.logging.Logger,JDK 自带的日志系统,从 JDK1.4 就有了。因为 log4j 的存在,这个 logger 一直沉默着,其实在一些测试性的代码中,jdk自带的 logger 比 log4j 更方便。JUL是自带具体实现的,与 log4j、logback 等类似,而不是像 JCL、slf4j 那样的日志接口封装。 import java.util.logging.Level; import java.util.logging.Logger; private static final Logger LOGGER = Logger.getLogger(MyClass.class.getName()); 相同名字的Logger对象全局只有一个; 一般使用圆点分隔的层次命名空间来命名 Logger;Logger 名称可以是任意的字符串,但是它们一般应该基于被记录组件的包名或类名,如 java.net 或 javax.swing; 配置文件默认使用jre/lib/logging.properties,日志级别默认为INFO;可以通过系统属性java.util.logging.config.file指定路径覆盖系统默认文件; 日志级别由高到低依次为:SEVERE(严重)、WARNING(警告)、INFO(信息)、CONFIG(配置)、FINE(详细)、FINER(较详细)、FINEST(非常详细)。另外还有两个全局开关:OFF「关闭日志记录」和ALL「启用所有消息日志记录」。 《logging.properties》文件中,默认日志级别可以通过.level= ALL来控制,也可以基于层次命名空间来控制,按照Logger名字进行前缀匹配,匹配度最高的优先采用;日志级别只认大写; JUL通过handler来完成实际的日志输出,可以通过配置文件指定一个或者多个hanlder,多个handler之间使用逗号分隔;handler上也有一个日志级别,作为该handler可以接收的日志最低级别,低于该级别的日志,将不进行实际的输出;handler上可以绑定日志格式化器,比如java.util.logging.ConsoleHandler就是使用的String.format来支持的; 配置文件示例: handlers= java.util.logging.ConsoleHandler .level= ALL com.suian.logger.jul.xxx.level = CONFIG com.suian.logger.jul.xxx.demo2.level = FINE com.suian.logger.jul.xxx.demo3.level = FINER java.util.logging.ConsoleHandler.level = ALL java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter java.util.logging.SimpleFormatter.format=%1$tF %1$tT [%4$s] %3$s - %5$s %n ▐ Apache Commons Logging 之前叫Jakarta Commons Logging,简称JCL,是Apache提供的一个通用日志API,可以让应用程序不再依赖于具体的日志实现工具。 commons-logging包中对其它一些日志工具,包括Log4J、Avalon LogKit、JUL等,进行了简单的包装,可以让应用程序在运行时,直接将JCL API打点的日志适配到对应的日志实现工具中。 common-logging通过动态查找的机制,在程序运行时自动找出真正使用的日志库。这一点与slf4j不同,slf4j是在编译时静态绑定真正的Log实现库。 commons-logging包里的包装类和简单实现列举如下: org.apache.commons.logging.impl.Jdk14Logger,适配JDK1.4里的JUL; org.apache.commons.logging.impl.Log4JLogger,适配Log4J; org.apache.commons.logging.impl.LogKitLogger,适配avalon-Logkit; org.apache.commons.logging.impl.SimpleLog,common-logging自带日志实现类,它实现了Log接口,把日志消息都输出到系统错误流System.err中; org.apache.commons.logging.impl.NoOpLog,common-logging自带日志实现类,它实现了Log接口,其输出日志的方法中不进行任何操作; 如果只引入Apache Commons Logging,也没有通过配置文件《commons-logging.properties》进行适配器绑定,也没有通过系统属性或者SPI重新定义LogFactory实现,默认使用的就是jdk自带的java.util.logging.Logger来进行日志输出。 JCL使用配置文件commons-logging.properties,可以在该文件中指定具体使用哪个日志工具。不配置的话,默认会使用JUL来输出日志。配置示例: ▐ Avalon LogKit Avalon LogKit是一个高速日志记录工具集,Avalon里的各个组件Framework、Excalibur、Cornerstone和Phoenix都用到它。它的模型与JDK 1.4 Logging package采用相同的原理,但与JDK 1.2+兼容。使用LogKit的原因是:Context和LogTargets。 使用Log4j的时候,日志的内容只能是一句话,而使用LogKit,你可以记录很多项内容,甚至可以各项内容记录到对应的数据库字段中。如果使用Log4j存储日志到不同的存储介质,如数据库,需要使用Appender,而LogKit已经可以支持多种存储目标。 ▐ log4j Log4j是Apache的一个开放源代码项目,通过使用Log4j,我们可以控制日志信息输送的目的地是控制台、文件、数据库等;我们也可以控制每一条日志的输出格式;通过定义每一条日志信息的级别,我们能够更加细致地控制日志的生成过程。 Log4j有7种不同的log级别,按照等级从低到高依次为:TRACE、DEBUG、INFO、WARN、ERROR、FATAL、OFF。如果配置为OFF级别,表示关闭log。Log4j支持两种格式的配置文件:properties和xml。包含三个主要的组件:Logger、appender、Layout。 ▐ SLF4J SLF4J全称The Simple Logging Facade for Java,简单日志门面,这个不是具体的日志解决方案,而是通过门面模式提供一些Java Logging API,类似于JCL。题外话,作者当时创建SLF4J的目的就是为了替代Jakarta Commons Logging(JCL)。 SLF4J提供的核心API是一些接口以及一个LoggerFactory的工厂类。在使用SLF4J的时候,不需要在代码中或配置文件中指定你打算使用哪个具体的日志系统,可以在部署的时候不修改任何配置即可接入一种日志实现方案,在编译时静态绑定真正的Log库。 使用SLF4J时,如果你需要使用某一种日志实现,那么你必须选择正确的SLF4J的jar包的集合(各种桥接包)。SLF4J提供了统一的记录日志的接口,只要按照其提供的方法记录即可,最终日志的格式、记录级别、输出方式等通过具体日志系统的配置来实现,因此可以在应用中灵活切换日志系统。 logback是slf4j-api的天然实现,不需要桥接包就可以使用。另外slf4j还封装了很多其他的桥接包,可以使用到其他的日志实现中,比如slf4j-log4j12,就可以使用log4j进行底层日志输出,再比如slf4j-jdk14,可以使用JUL进行日志输出。 ▐ Logback Logback,一个“可靠、通用、快速而又灵活的Java日志框架”。Logback当前分成三个模块:logback-core,logback- classic和logback-access。logback-core是其它两个模块的基础模块。logback-classic是log4j的一个改良版本,完整实现了SLF4J API。 logback-access模块与Servlet容器集成提供通过Http来访问日志的功能。Logback依赖配置文件logback.xml,当然也支持groovy方式。Logback相比log4j,有很多很多的优点,网上一搜一大片,此处就不再赘述了。 ▐ Log4j2 Log4j 2是log4j 1.x和logback的改进版,据说采用了一些新技术(无锁异步等等),使得日志的吞吐量、性能比log4j 1.x提高10倍,并解决了一些死锁的bug,而且配置更加简单灵活。 Log4j2支持插件式结构,可以根据需要自行扩展Log4j2,实现自己的appender、logger、filter等。在配置文件中可以引用属性,还可以直接替代或传递到组件,而且支持json格式的配置文件。不像其他的日志框架,它在重新配置的时候不会丢失之前的日志文件。 Log4j2利用Java5中的并发特性支持,尽可能地执行最低层次的加锁。解决了在log4j 1.x中存留的死锁的问题。Log4j 2是基于LMAX Disruptor库的。在多线程的场景下,和已有的日志框架相比,异步logger拥有10倍左右的效率提升。 Log4j2体系结构: 使用场景 ▐ 只使用java.util.logging.Logger 最简单的场景,正式系统一般不会这么用,自己写点小demo、测试用例啥的是可以这么用。不要任何第三方依赖,jdk原生支持。 ▐ 只使用Apache Commons Logging 需要引入commons-logging包,示例如下: <dependency> <groupId>commons-logging</groupId> <artifactId>commons-logging</artifactId> <version>1.2</version> </dependency> ▐ Apache Commons Logging和log4j结合使用 需要引入commons-logging包和log4j包,示例如下: <dependency> <groupId>commons-logging</groupId> <artifactId>commons-logging</artifactId> <version>1.2</version> </dependency> <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> <version>1.2.17</version> </dependency> 该模式下可以使用的打点api: org.apache.commons.logging.Log,commons-logging里的api; org.apache.log4j.Logger,log4j里的api; 无论使用哪种api打点,最终日志都会通过log4j进行实际的日志记录。推荐用commons-logging里的api,如果直接用log4j里的api,就跟单用log4j没区别,就没有再引入commons-logging包的必要了。 既然最终是通过log4j实现日志记录,那么日志输出的level、target等也就是通过log4j的配置文件进行控制了。下面是一个log4j配置文件《log4j.properties》的简单示例: #log4j.rootLogger = error,console log4j.logger.com.suian.logtest = trace,console #输出源console输出到控制台 log4j.appender.console = org.apache.log4j.ConsoleAppender log4j.appender.console.Target = System.out log4j.appender.console.layout = org.apache.log4j.PatternLayout log4j.appender.console.layout.ConversionPattern = %d{yyyy-MM-dd HH:mm:ss,SSS} [%t] %-5p %c - [log4j]%m%n 既然是推荐使用commons-logging里的api打点,为了能找到log4j的日志实现,必须通过《commons-logging.properties》配置文件显式的确定关联,示例如下: org.apache.commons.logging.Log=org.apache.commons.logging.impl.Log4JLogger 代码中使用JCL api进行日志打点,底层使用log4j进行日志输出。日志输出控制依托于log4j的配置文件,另外需要在commons-logging.properties配置文件中显式指定与log4j的绑定关系。 ▐ 单独使用log4j 这个是早几年最最流行的用法了,现在因为log4j本身的问题以及新的日志框架的涌现,已经逐步退出历史舞台了。具体怎么用自己去百度吧。 ▐ SLF4J结合Logback 当下最流行的用法,SLF4J为使用场景最广泛的日志门面,加上Logback的天然实现,简单、统一、快速。 需要引入第三方依赖: <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-api</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-core</artifactId> <version>${logback.version}</version> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-classic</artifactId> <version>${logback.version}</version> </dependency> ▐ 单独使用Log4j2 Log4j2感觉就是SLF4J+Logback。log4j-api等价于SLF4J,log4j-core等价于Logback。 需要引入第三方依赖: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-api</artifactId> <version>2.6.2</version> </dependency> <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-core</artifactId> <version>2.6.2</version> </dependency> 冲突处理 理论上各种日志输出方式是可以共存的,比如log4j和log4j2以及logback等,但是麻烦的是我们得维护多个配置文件,必须充分了解每个组件使用的是那种日志组件,然后进行对应的配置文件配置。 如何解决呢?每一个想做通用日志解决方案的,都对兼容性问题进行了特殊处理。目前只有slf4j和log4j2提供了这样的整合机制,其他的基本都很弱。代码中可能使用的日志打点Api列举: java.util.logging.Logger,jdk自带的; org.apache.commons.logging.Log,commons-logging包里的api; org.apache.log4j.Logger,log4j包里的api; org.apache.logging.log4j.Logger,log4j2提供的api,在log4j-api包里; org.slf4j.Logger,slf4j提供的api,在slf4j-api包里; 上述打点方式,在一个应用中是有可能共存的,即使自己写的代码可以确保都使用同一类api,但是引入的第三方依赖里就可能各式各样了。该怎么处理呢? 前面已经提过了,现在能够对各类冲突支持比较到位的就是slf4j和log4j2,他们都提供了很多的绑定器和桥接器。 所谓的绑定器,也可以称之为适配器或者包装类,就是将特定api打点的日志绑定到具体日志实现组件来输出。比如JCL可以绑定到log4j输出,也可以绑定到JUL输出;再比如slf4j,可以通过logback输出,也可以绑定到log4j、log4j2、JUL等; 所谓的桥接器就是一个假的日志实现工具,比如当你把 jcl-over-slf4j.jar 放到 CLASS_PATH 时,即使某个组件原本是通过 JCL 输出日志的,现在却会被 jcl-over-slf4j “骗到”SLF4J 里,然后 SLF4J 又会根据绑定器把日志交给具体的日志实现工具。 slf4j整合日志输出 ▐ java.util.logging.Logger 将JUL日志整合到slf4j统一输出,需要引入slf4j提供的依赖包: <dependency> <groupId>org.slf4j</groupId> <artifactId>jul-to-slf4j</artifactId> <version>1.7.22</version> </dependency> 只引入依赖并不能整合JUL日志,该包里只是提供了一个JUL的handler,仍旧需要通过JUL的配置文件进行配置,slf4j绑定器(如logback)上设置的日志级别等价于JUL handler上的日志级别,因此控制JUL的日志输出,日志级别仍旧分两个地方控制:JUL配置文件《logging.properties》和slf4j绑定器的配置文件,比如《logback.xml》、《log4j2.xml》等。 建立jdk14-logger的配置文件《logger.properties》,加入handler配置以及日志级别配置; handlers= org.slf4j.bridge.SLF4JBridgeHandler .level= ALL 在启动程序或容器的时候加入JVM参数配置-Djava.util.logging.config.file = /path/logger.properties;当然也可以使用编程方式进行处理,可以在main方法或者扩展容器的listener来作为系统初始化完成;此种方式有些场景下不如配置JVM参数来的彻底,比如想代理tomcat的系统输出日志,编程方式就搞不定了。 ▐ org.apache.commons.logging.Log 将JCL日志整合到slf4j统一输出,需要引入slf4j提供的依赖包: <dependency> <groupId>org.slf4j</groupId> <artifactId>jcl-over-slf4j</artifactId> <version>1.7.22</version> </dependency> jcl-over-slf4j包里所有类的根路径为org.apache.commons.logging,也有Log和LogFactory类,相当于以重写commons-logging包的代价来实现对JCL的桥接。Log与commons-logging包里的一模一样,LogFactory的实现,代码写死使用的是org.apache.commons.logging.impl.SLF4JLogFactory。 commons-logging包里默认使用的是org.apache.commons.logging.impl.LogFactoryImpl。以这样的代价来实现桥接,可以实现无缝对接,不像JUL那样还得添加额外配置,但是有一个坏处就是需要处理类库冲突了。commons-logging包和jcl-over-slf4j包肯定是不能共存的,需要将commons-logging包在classpath里排掉。 题外话,因为JCL本身就支持通过配置文件《commons-logging.properties》绑定适配器,所以个人感觉更倾向于封装一个适配器的方式来支持,就像commons-logging包里的org.apache.commons.logging.impl.Log4JLogger,这样更符合程序员的思维,明明白白。 桥接包的命名也是很讲究的,覆写的这种,命名为xxx-over-slf4j,如本例的jcl-over-slf4j;纯桥接的,命名为xxx-to-slf4j,如文章前面提到的jul-to-slf4j。 ▐ org.apache.log4j.Logger 将log4j日志整合到slf4j统一输出,需要引入slf4j提供的依赖包: <dependency> <groupId>org.slf4j</groupId> <artifactId>log4j-over-slf4j</artifactId> <version>1.7.22</version> </dependency> 看桥接包的名字就知道了,log4j-over-slf4j肯定是覆写了log4j:log4j包,因此使用起来只需要引入依赖即可,不需要其他额外的配置。但是仍旧是要处理冲突的,log4j包和log4j-over-slf4j是不能共存的哦。 ▐ org.apache.logging.log4j.Logger 将log4j2日志整合到slf4j统一输出,slf4j没有提供桥接包,但是log4j2提供了,原理是一样的,首先引入log4j2的桥接包: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-to-slf4j</artifactId> <version>2.6.2</version> </dependency> log4j2提供的依赖包有org.apache.logging.log4j:log4j-api和org.apache.logging.log4j:log4j-core,其作用看包名就清楚了。log4j-core是log4j-api的标准实现,同样log4j-to-slf4j也是log4j-api的一个实现。 log4j-to-slf4j用于将log4j2输出的日志桥接到slf4j进行实际的输出,作用上来讲,log4j-core和log4j-to-slf4j是不能共存的,因为会存在两个log4j2的实现。 经测试,就测试结果分析,共存也是木有问题的,何解?log4j2加载provider的时候采用了优先级策略,即使找到多个也能决策出一个可用的provider来。在所有提供log4j2实现的依赖包中,都有一个META-INF/log4j-provider.properties配置文件,里面的FactoryPriority属性就是用来配置provider优先级的,幸运的是log4j-to-slf4j(15)的优先级是高于log4j-core(10)的,因此测试结果符合预期,log4j2的日志桥接到了slf4j中进行输出。 同样,为确保系统的确定性,不会因为log4j2的provider决策策略变更导致问题,建议还是要在classpath里排掉log4j-core,log4j2也是推荐这么做的。 log4j2整合日志输出 ▐ java.util.logging.Logger 将JUL日志整合到log4j2统一输出,需要引入log4j2提供的依赖包: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-jul</artifactId> <version>2.6.2</version> </dependency> log4j2整合JUL日志的方式与slf4j不同,slf4j只是定义了一个handler,仍旧依赖JUL的配置文件;log4j2则直接继承重写了java.util.logging.LogManager。 使用时,只需要通过系统属性java.util.logging.manager绑定重写后的LogManager(org.apache.logging.log4j.jul.LogManager)即可,感觉比slf4j的方式要简单不少。 ▐ org.apache.commons.logging.Log 将JCL日志整合到log4j2统一输出,需要引入log4j2提供的依赖包: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-jcl</artifactId> <version>2.6.2</version> </dependency> 基于log4j-jcl包整合JCL比较简单,只要把log4j-jcl包扔到classpath就可以了。看起来slf4j的整合方式优雅多了,底层原理是这样的:JCL的LogFactory在初始化的时候,查找LogFactory的具体实现,是分了几种场景的,简单描述如下: 首先根据系统属性org.apache.commons.logging.LogFactory查找LogFactory实现类; 如果找不到,则以SPI方式查找实现类,META-INF/services/org.apache.commons.logging.LogFactory;log4j-jcl就是以这种方式支撑的;此种方式必须确保整个应用中,包括应用依赖的第三方jar包中,org.apache.commons.logging.LogFactory文件只有一个,如果存在多个的话,哪个先被加载则以哪个为准。万一存在冲突的话,排查起来也挺麻烦的。 还找不到,则读取《commons-logging.properties》配置文件,使用org.apache.commons.logging.LogFactory属性指定的LogFactory实现类; 最后再找不到,就使用默认的实现org.apache.commons.logging.impl.LogFactoryImpl。 ▐ org.apache.log4j.Logger 将log4j 1.x日志整合到log4j2统一输出,需要引入log4j2提供的依赖包: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-1.2-api</artifactId> <version>2.6.2</version> </dependency> log4j2里整合log4j 1.x日志,也是通过覆写log4j 1.x api的方式来实现的,跟slf4j的实现原理一致。因此也就存在类库冲突的问题,使用log4j-1.2-api的话,必须把classpath下所有log4j 1.x的包清理掉。 ▐ org.slf4j.Logger 将slf4j日志整合到log4j2统一输出,需要引入log4j2提供的依赖包: <dependency> <groupId>org.apache.logging.log4j</groupId> <artifactId>log4j-slf4j-impl</artifactId> <version>2.6.2</version> </dependency> log4j-slf4j-impl基于log4j2实现了slf4j的接口,其就是slf4j-api和log4j2-core之间的一个桥梁。这里有个问题需要注意下,务必确保classpath下log4j-slf4j-impl和log4j-to-slf4j不要共存,否则会导致事件无止尽地在SLF4J和Log4j2之间路由。 日志打点API绑定实现 slf4j-api和log4j-api都是接口,不提供具体实现,理论上基于这两种api输出的日志可以绑定到很多的日志实现上。slf4j和log4j2也确实提供了很多的绑定器。简单列举几种可能的绑定链: slf4j → logback slf4j → slf4j-log4j12 → log4j slf4j → log4j-slf4j-impl → log4j2 slf4j → slf4j-jdk14 → jul slf4j → slf4j-jcl → jcl jcl → jul jcl → log4j log4j2-api → log4j2-cor log4j2-api → log4j-to-slf4j → slf4j 来个环图: 手淘行业与智能运营团队 在阿里,如果不经历电商,那么你可能就失去了一半的工作乐趣;做电商,如果不搞商业智能,那么你可能就失去了链接人、货、场、商,给几亿用户创造更美好生活的机会!但是现在,一个充满乐趣和机会的岗位就摆在你的面前 —— 它就是,行业与智能运营团队,电商中最智能的技术团队!大家走过路过,不要错过!我们要从上到下打造一支幸福感极强的团队 —— 如果你在追求幸福感,找我们,没毛病!未来已来,淘系技术部行业与智能运营团队,这支即将成为阿里最具幸福感的技术团队,期待具有好奇心和思考力的你的加入! 就是现在,阿里巴巴淘系技术部行业与智能运营团队,Java工程师、技术专家、架构师面向社会+校园招聘,base杭州阿里巴巴西溪园区! 投喂简历给我们:mingkai.wmk@alibaba-inc.com 关注「淘系技术」微信公众号,一个有温度有内容的技术社区~

优秀的个人博客,低调大师

HBR云上统一备份最佳实践

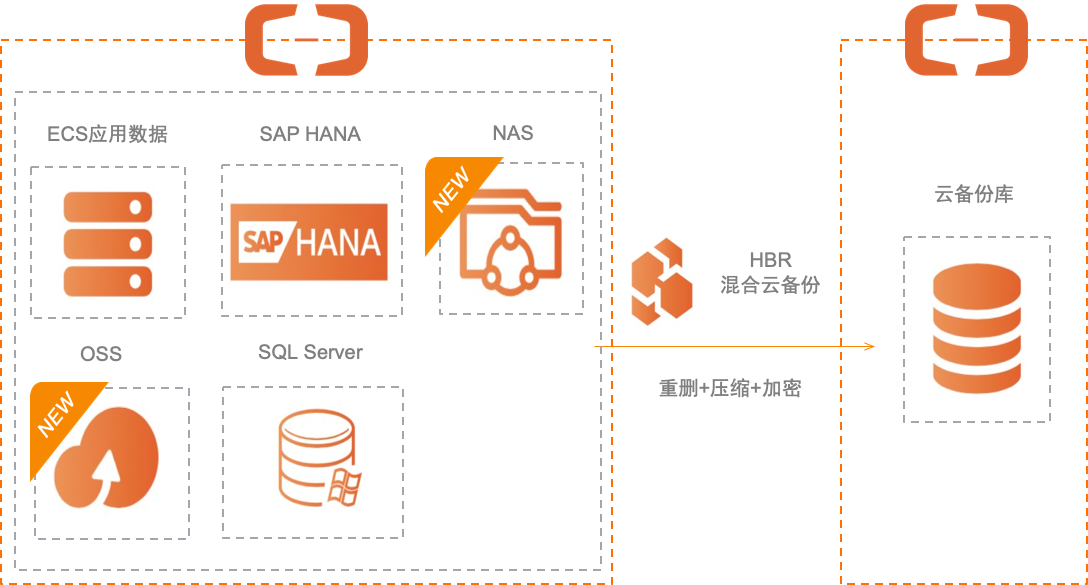
场景描述 本文介绍如何在云上对文件系统进行备份,通过阿里云HBR可以对 ECS文件系统、NAS文件、OSS对象存储文件,以及ECS上自建的SQL Server、SAP HANA数据库进行统一备份、管理和恢复。 解决问题 阿里云上ECS的文件系统备份。 阿里云NAS、OSS备份。 阿里云上使用ECS自建的SQL Server、SAP HANA备份。 产品列表 备份服务HBR 云服务器ECS 文件存储NAS 对象存储OSS

优秀的个人博客,低调大师

Flink最佳实践(一)流式计算系统概述

前言 传统的批处理拥有巨大 吞吐量 的优势,但是随之而来的是极其 高延迟 的缺陷。 随着大数据系统的不断发展,传统的批处理已然无法全部满足对 时效性 要求愈加严苛的业务需求。 为了适应逐渐变得 「实时」 的年代,大数据系统架构也由简单的批处理转向批流混合的Lambda架构,最后可能会逐渐演变成只有流计算的 高精准高时效 的Kappa架构。 无论是看起来像是过渡期产物的批流混合,还是感觉像是 「终结者」 的纯流式计算,都离不开最核心的计算组件:流式计算系统。 做为当今最火热的流式计算引擎,Flink以其卓越的性能、高度可信的正确性等种种特性收获了大量粉丝。 本文作为学习Flink的前置知识,将从 时域、窗口、时间推理工具、强正确性方案 等方面讨论流式计算系统的核心概念,为初学者揭开其神秘面纱。 从本文中你将了解到: 流式计算系统是如何做到批处理的 准确性,从而达到可以和批处理平起平坐、互相代替的地步。 流式计算系统是如何做到游刃有余地 处理现实世界中杂乱的事件流,做到批处理无法完成的事情,从而实现对批处理的反超。 值得注意的是,本文并不涉及任何具体的流式计算引擎,这意味着本文中的所有概念在几乎所有流式计算系统中都是通用的(Flink、SparkStreaming、StructuredStreaming等),因为大部分流式计算系统的抽象模型大体一致。 一、术语与解释 在进行正文描述之前,我们先规定流式计算系统中的基本术语,正文内容将会基于这些术语进行讨论。 1.1 无限数据 无限数据是一种不断增长的,本质上 无限的数据集。 也常被称为 流数据,但是我们这里只用 无限数据 这个概念来描述它。 因为流数据语义上 与流式计算强制绑定,但是实际上无限数据也经常使用批处理工具来计算,比如在一个源源不断增长的数据集上进行 T+1天 的计算。 数据是一个无限增长的数据集,但是处理工具是批处理,每次只处理前一天的数据。 如果这里用流数据来描述可能经常会让人误以为其是一个流式计算系统处理的数据集。 1.2 数据乱序 数据乱序是指 服务端接收的数据顺序并不是客户端数据产生的顺序 的现象。 互联网中的数据流并 不会按照人们事先预想的顺序进行传输,这是现实生活中的真实体现。 不同的客户端按顺序发出的数据包可能因为各种原因的影响,服务端接受到的时候有极大的可能顺序是和客户端发送顺序不一致的,这就是数据的乱序。 1.3 无限数据处理 批处理 批处理是一种通过将无限数据 划分成最终一致的有限批次数据 的处理方式。 如前文描述,T+1的批处理将一个无限数据集按天划分成一批批的数据集,每个批次中的数据都是 不可变的、有限的。 现实中有很多用批处理系统来处理无限数据的场景,对于乱序的数据,批处理通过 拉长时间窗口 的做法来保持 结果的正确性。 比如T+1每天一个时间窗口,那么除非数据延迟超过一天,否则人们认为这个批次处理的结果是正确的、没有遗漏的: 一天之内的所有数据只会被处理一次,结果准确。 一天之内的所有一起被处理,不存在数据乱序问题。 当然这种做法也并不是百分百正确,在划分时间界限的附近仍然可能存在乱序的数据,时间窗口越长正确性越高。 流处理 流处理是一种 持续的数据处理模式、设计用于无限数据处理的执行引擎。 传统的流处理器经常存在系统不可靠、数据易丢失、结果不准确等缺陷,导致了曾经的一段时间内,流就代表了 「约等于」 的处理结果。 但是随着流处理器的不断发展,现代化的流处理器依托 State、Checkpoint、WAL 等机制支持 准确一次,基本都具备了与批处理平起平坐 正确性: 一些先进的流处理器还会提供让系统可以游刃有余地 应对真实世界中错乱数据 的工具,这就是 超越批处理的时间推理能力: 能够处理乱序数据流,超越批处理的能力 使得流计算可以获得比批处理事实 更准确的结果 1.4 准确一次 准确一次 是事件在流处理器中 只被准确地处理一次 的描述。 本文中的 准确一次 ,与经常被提及的 精准一次、Exactly Once 等概念描述上有点区别,精准一次表示事件在流处理器中 只被精确地处理了一次,不多不少正好一次。 但是现实生活中,能够真正做到精准一次的效果是非常难的。 即使数据源、计算引擎、存储系统都能够支持精准一次的语义,但是在某些复合指标的计算过程中(如5分钟内的PV),计算系统进行到一半因为特殊原因奔溃后重启,虽然其将自动将上次计算过程产生的副作用消除,并从数据源重新拉取数据进行计算并输出,看起来就像什么问题都没发生过一样。 但是对于上次到本次计算过程中的某些数据来说,它们确确实实 被计算了两次,只是第一次计算作废且始终保证最终结果是正确的,看起来就像只被处理了一次一样。 所以本文中用 准确一次 的概念来描述这个语义,对于数据结果来说,事件在流处理器中 只被准确的处理了一次。 二、时域 时域是学习流处理系统的第一门课,大多数从事批处理系统相关工作的同学在第一次接触流处理系统时经常会有疑惑或者概念混淆,其原因大部分是因为没有 时域 的概念。 在批处理系统中,时域可能就只是一个划分处理数据集的工具,并没有其他特殊之处。 但是在流处理系统中,时域是一个最基本的概念,流处理系统的所有计算过程都将围绕着时域来构建。 2.1 时间类别 流处理与批处理最大的不同在于流处理中对时间类别划分比批处理更丰富,且用不同时间类别计算出的数据,结果与意义可能全然不同。 事件时间 事件时间是 事件真实发生的时间。 由于数据乱序的原因,服务端收到数据时的时间和事件本身的时间可能是相差极大的。 正是因为这种差异,服务端做基于事件时间的计算是 最复杂的,需要对乱序的数据流做处理以 「还原」 真实世界的情况,需要依赖一定的数据缓存。 达到时间 达到时间是 系统接收到事件的时间,即服务端接收到事件的时间。 达到时间比较少被使用。 处理时间 处理时间是 系统开始处理到达事件的时间。 在某些场景下,处理时间等于达到时间。 因为处理时间 没有乱序 的问题,所以服务端做基于处理时间的计算是比较简单的,无迟到与乱序数据。 2.2 造成时间乱序的因素 从时间类别的划分上来看,只有事件时间会有乱序的困扰。 在最理想的状态下,事件时间=达到时间=处理时间,在批处理系统中的简单粗暴默认三者相等,所以批处理没有乱序的烦恼。 但是在流处理系统中,要达到这种理想状态 几乎是不可能的,事件时间与处理时间总是会有误差,如下图所示。 现实生活中造成时间乱序的原因有很多,基本都是不可避免的,比如以下几种因素: 共享资源限制,如网络拥塞,网络分区或在非专用环境中共享CPU 软件因素,如分布式系统的复杂逻辑、资源竞争等 数据本身的特性,包括 key 的分布、吞吐的差异、乱序 软件使用时的场景限制 等等。 举一个简单的场景,在联网的游戏程序中,游戏结束时会将本地的数据上传到服务器进行排名、得分等结果统计。 某个比较倒霉的哥们,可能在地铁或者隧道等信号不好的场所中,数据发送的过程可能因为外部环境因素而发生意外情况(信号不好、甚至无信号)导致延迟发送甚至无法发送。 在这种情况下,可能原本应该于9点发送的数据包,服务端到10点多才收到,甚至永远收不到。 那么服务端在基于事件时间统计9-10点时间段内游戏的排行时,因为该用户数据迟迟未到,马上计算的话结果将是不正确的(因为少了一个用户的数据),而选择等待的话没人知道该用户的数据何时到来。 这就是基于事件时间计算时,时间乱序带来的困扰。 而如果基于处理时间计算,那么事情将变得十分简单,只需要处理9-10点范围内服务端收到的所有数据即可,但是输出的结果并不是真正正确的结果。 2.3 基于时域的操作 流处理器定义完时域之后,接着需要定义在时域之上的操作,所有流处理器的操作都可以分为两种类型:与时间无关的和与时间有关的。 与时间无关的操作 这种类型的操作往往是最简单的,因为不管是什么类别的时间,都对这类操作 没有任何影响。 比如 过滤、转换 等简单映射,来一条就可以处理一条,处理完一条就可以直接输出,和时间没有任何关系。 与时间有关的操作 基于各类时间的窗口处理 是流处理器中主要的与时间有关的操作。 三、窗口 3.1 窗口的本质 对拥有时域概念的数据流做操作,就必定会用到窗口这个工具,它的本质就是将无限数据集 沿着时间的边界切分成有限数据集。 在批处理中,窗口就是定义的多久处理一次,每次处理的数据就是根据这个窗口时间(一般都是处理时间)划分出来的有限数据集。 在流处理中,根据不同的时间类别,划分出来的窗口性质也不同: 基于处理时间划分 优点 简单,不需要根据时间 shuffle 数据,每个时间窗口内的数据都是 完整的 容易判断完整性,不需要处理迟到的数据 缺点 数据不准确,无法反映真实世界的数据情况 基于事件时间划分 优点 能够反映出真实世界 最准确的数据 缺点 需要 还原并处理迟到的数据 迟到的数据到来前 需要缓存更多数据 需要根据不同的时间窗口 shuffle 数据 延迟更高 系统的完整性问题无法保证 3.2 窗口的类别 不论是基于事件时间的窗口还是基于处理时间的窗口,都会有不同的窗口类型可以使用,常见的如:固定窗口、滑动窗口、会话窗口 等。 固定窗口 按照固定的时间片划分数据流,将数据流 分割成具有固定大小的片段。 如图所示: 假设 window-size=1那么window1、window2、window3等各个窗口的大小永远固定是1,且 各个窗口不会重叠也不会有间隙。 固定窗口是最简单也是最常见的窗口类型。 滑动窗口 在固定窗口的基础上,滑动窗口增加了 滑动步长 的定义。 滑动窗口由 固定窗口长度、窗口滑动步长 确定,如下图所示: 假设 window-size=1 & window-slide=0.5那么表示 窗口长度为1单位且每0.5个单位就向前滑动一个新窗口。 滑动窗口经常被用来统计诸如 每5分钟统计过去10分钟的访问量 的需求,窗口长度为10分钟,滑动步长为5分钟。 滑动窗口的窗口长度和滑动步长的关系如下: 窗口长度>滑动步长,则窗口重叠 窗口长度=滑动步长,则等同于固定窗口,没有窗口重叠 窗口长度<滑动步长,有一些数据就无法分配到窗口中,窗口之间将出现空隙 会话窗口 和固定窗口、滑动窗口不一样,会话窗口没有固定的窗口大小定义。 会话窗口的大小由 用户活动事件频率 决定,长度不能被事先定义而取决于实际数据。 比如Web服务器中Session的概念,用户在一定时间内没有后续活动的话Session将会过期,如果用户一直保持活跃的操作,那么Session将一直保留。 会话窗口的划分也类似Session的定义,如下图所示: 每个用户都可能产生多个会话窗口,每个会话窗口的大小取决于该用户是否持续产生活动事件。 会话窗口是批处理引擎不擅长处理的类型,通常用于 分析一段时间内的用户行为。 四、时间推理工具 有了时域和窗口的概念后,基本上我们就拥有了上手流处理程序开发的条件了。 但是此时我们仍然无法了解到,先进的流处理器核心思想到底先进在哪里?它是如何做到和批处理器一样的正确性甚至拥有超越批处理的能力? 本节先从 时间推理工具 的角度来讨论流处理器拥有的 能够正确处理乱序数据的超能力,使其成为超越批处理的事实标准。 在本节中,我们会尝试在这三个问题的回答上更好的理解流处理器的时间推理工具: 流处理器的计算结果是什么? 流处理器会在事件时间的哪个位置计算? 流处理器会在处理时间的什么时候触发? 4.1 计算结果是什么? 这个问题也是经典批处理需要回答的问题,即想得到什么样的数据运算结果,将会被定义在程序代码中。 比如简单的转换操作、复杂的窗口操作,以及是否做聚合、join等,比较具有代表性的计算结果有 计算总和、构建直方图、训练模型 等。 比较简单的问题,可以理解为用户的业务需求。 4.2 在事件时间的哪个位置计算? 从事件时间的维度上看,流处理器执行代码获取计算结果时,必定需要 取某个事件时间范围内的数据进行计算。 假设用一坐标轴表示无限数据,坐标轴上 以事件时间为x轴、以处理时间为y轴 画图,我们可以得到: 以x轴上的事件时间点做切分,将会把坐标图(无限数据) 划分成一片片有界限的数据集。 是不是很眼熟?这就是窗口的作用,将无限数据集 沿着时间的边界切分成有限数据集。 我们在事件时间的维度上定义窗口,就是定义了各个数据片的 数据区域与位置,流数据将会 按照自身携带的事件时间被划分到指定的时间窗口中,流处理器将会取其中某个位置的数据进行计算。 如果是与时间无关的操作则在事件时间的任意位置都能计算。 在事件时间的哪个位置计算 由窗口决定,窗口定义了事件时间的计算位置(区域)。 用窗口在事件时间的维度上定义好计算位置后,流处理器还需要在处理时间的维度上知道,什么时候触发计算。 4.3 在处理时间的什么时候触发? 有些同学到这里会出现一些概念上的混淆,我们不是已经定义过事件时间了吗,为什么还要定义处理时间? 事件时间和处理时间两个管的维度不一样,事件时间是定义 切分数据集的时间边界,而 程序真正要触发计算 需要在处理时间上定义。 可以理解为 到达某个处理时间后,程序取指定事件时间范围内的数据进行计算。 在事件时间的维度上定义了一个个的数据窗口,流数据将会按照自身携带的事件时间被划分到指定的时间窗口中。 我们还需要定义在处理时间的什么时候触发计算,也就是说,什么时候我们才能说某个窗口的数据已经都到了,是个完整的数据集,可以进行计算了。 只有事件时间的流处理中 缺乏对窗口数据完整性的判断。 所以在处理时间的维度上,流处理器需要额外借助一些工具辅助程序 判断某个事件时间窗口是否已经完整,以及是否触发计算。 4.3.1 Watermark Watermark 是描述 「事件时间」的输入完整性 的概念,是系统根据当前处理数据的 「事件时间」 判断 「处理进度和完整性」 的工具。 在事件时间维度上划分的各个窗口原本都是 未封闭的,表示 数据还没全部达到。 Watermark 的作用就是给各个窗口 「盖上盖子」,使其成为一个封闭的窗口,表示数据已经全部达到。 如下图所示: 在图中,Watermark 出现表示当前事件时间窗口已完整。 那么用户如何去定义 Watermark ,程序又是怎么判断 Watermark 到了需要关闭窗口进行计算呢? 我们通过一个例子来说明 Watermark 的作用。 设事件时间窗口大小 size=5s,在事件时间的维度上可以划分以下窗口: 窗口序号 事件时间范围 0-5 20:10:00 - 20:10:05 6-10 20:10:06 - 20:10:10 定义数据携带的Watermark为 当前事件时间-2s,(Flink中通过SourceFunction的emitWatermark设置,每条数据都会携带一个Watermark)。 数据接收情况如下: 数据序号 事件时间 所属的窗口 携带的Watermark 当前的Watermark 备注 第1条 20:10:00 0-5 20:09:58 20:09:58 第一条直接取携带的WK为系统的WK 第2条 20:10:01 0-5 20:09:59 20:09:59 携带的WK比当前WK大,取携带的WK为当前的WK 第3条 20:10:02 0-5 20:10:00 20:10:00 同上 第4条 20:10:00 0-5 20:09:58 20:10:00 携带的WK比当前WK小,故继续使用当前WK 第5条 20:10:05 0-5 20:10:03 20:10:03 同第3条 第6条 20:10:06 6-10 20:10:04 20:10:04 同上 第7条 20:10:08 6-10 20:10:06 20:10:06 此时 WK已经>=事件时间窗口(0-5),表示第1个窗口已经完整,WK为20:10:06,在当前处理时间维度上「画上」水位线,表示在这之前的数据已经都达到了,可以触发计算 第8条 20:10:03 0-5 20:10:01 20:10:06 这是一条延迟「很久」的数据,0-5的窗口已经关闭 可以看到,每条数据过来,都会更新程序中最新的 Watermark。 在第7条数据到达时,其携带的 Watermark 已经 超过了 0-5 这个窗口的边界,那么此时我们可以认为 0-5 这个窗口的所有数据已经达到,可以进行计算。 用户可以根据业务与数据情况自定义每条数据应该携带怎样的 Watermark,而系统接收到数据时,根据当前 Watermark 是否超出某事件时间的窗口边界来判断该事件时间窗口是否完整。 那么用户该 如何定义具体的 Watermark 的值 呢。 下面我们来介绍两种定义 Watermark 的方式,来帮助用户设置 Watermark 的值。 完美式 完美式的 Watermark 是在用户 完全了解输入数据的前提下,构建出完美的水位线,不会有数据超过水位线。 也就是说,在完美式的 Watermark 中,不会有任何数据被遗漏,所有数据在完美式的 Watermark 下都能够准时达到。 这是最完美的一种情况,但是真实业务场景中使用完美式的 Watermark 往往要付出比较大的代价。 因为其要兼顾所有数据,注定了 Watermark 会在比较晚的时间后才能到来。 比如 当前事件时间-10m,在窗口大小为10s的程序中,这意味着第一个窗口要 等到10分钟之后的数据出现 才可能会被关闭。 但是正因为较大的 Watermark 值,只要某窗口中迟到的数据在其窗口边界10m之内达到,都是不会被遗漏的。 缺点:延迟太高、需要缓存的数据量太大。 优点:数据完整性高。 启发式 在实际应用中,完全了解输入数据是不切实际的,且数据的乱序延迟现象总比用户想象的要糟糕。 因而,完美式的 Watermark 往往是一个比较大的值,但在某些高时效性要求的系统中,完美式的 Watermark 带来的高延迟往往是不能被接受的。 所以我们需要另外一种启发式的 Watermark,其 能够在保持低延迟的同时,最大可能的保持窗口的完整性。 启发式的 Watermark 一般都是用户根据数据情况,比如 分区、分区内排序、文件增长率等 提供尽可能准确的进度估计,设置一个较为理想的值。 缺点:会存在小部分数据是延迟到达的,会损失部分数据。 优点:低延迟。 4.3.2 Trigger 有了 Watermark 之后,虽然用户可以以此来判定 窗口是否完整,但窗口完整并不意味着要触发计算,只能说满足了触发计算的条件。 真正决定在处理时间的什么时候触发计算的是 Trigger,其是描述 何时「计算窗口」的机制 。 Trigger 的触发计算信号可以从以下几个维度来定义: 事件时间维度:按照事件时间窗口完整触发计算,即 Watermark 出现。 处理时间维度:按照固定的处理时间触发计算,是固定的、不延迟的,定期输出结果。 元素计数维度:窗口累计固定数量后触发计算 带标记信号或其他依赖其他触发器:接受到EOF等事件时触发计算 触发器可以是简单的触发器,即以上任意一种,也可是是复合的触发器,即以上 多种触发条件的组合。 重复触发器:适用于处理时间以提供固定更新。 AND触发器:多触发器「与」组合。 OR触发器:多触发器「或」组合。 序列触发器:自触发器按照预定义的顺序依次触发。 有了 Trigger 的定义之后,我们再来看看 完美式Watermark 和 启发式Watermark 中的缺点如何通过 Trigger 的组合来避免。 对于完美式的Watermark,可以通过 窗口+固定处理时间 多重触发器组合的方式,在 Watermark 到来之前,提前或周期触发计算并输出,达到低延迟的效果,Watermark 到来后也会触发一次计算。 对于启发式的Watermark,通过 窗口+LastestDelay 多重触发器组合的方式,定义 LastestDelay 的大小,可以延迟计算处理迟到数据。LastestDelay 为最大允许的延迟时间,可以在窗口关闭之后将迟到的数据划入特定空间中等待补充计算。但是 LastestDelay 本身也有大小限制,仍然可能遗漏极端延迟的数据。 由于 Watermark 本身存在严重的缺陷,数据完整性与低延迟不可兼得,且在极端情况下仍然 不可保证所有数据都被处理到。所以,只根据 Watermark 来决定是否开始处理数据是比较不精准的。 通过 Trigger 的定义可以做到让事件时间窗口尽可能的完整,且延迟尽可能的低。 现在,我们来总结一下关于流处理器的时间推理工具的三个问题: 流处理器的计算结果是什么? 由业务逻辑决定 流处理器会在事件时间的哪个位置计算? 由窗口来划分时间边界与定义数据位置 流处理器会在处理时间的什么时候触发? 由 Watermark 定义事件时间窗口的完整性 由 Trigger 决定处理时间上触发的条件 现在,你知道流处理器的时间推理工具是什么了吗? 五、保持强正确性的工具 时间推理工具让流处理器站在了批处理器的之上,使其能够真正地处理现实世界中的乱序问题。 但是流处理器中还有一个问题未解决,那就是 正确性如何保证? 在批处理器中,同一批数据、同一个程序重复计算的结果应该是 始终一致 的,这样一来即使批处理器执行过程中挂了,用户也可以通过一些补数的手段重跑,以 保证最后结果的正确性。 那么对于流处理器来说,流处理器执行过程中宕机重启之后 是否能够保持结果数据的正确性与一致性 是现代流处理器的基本素质。 抛开时间推理工具不说,能够保持强正确性的流处理器可以直接取代系统中的批处理器,而不会出现结果不一致的情况。 下面我们来讨论现代流处理器中,常见的保持强正确性的工具。 5.1 State State 即为状态,流处理器中常用来缓存窗口数据、程序运行时状态、数据源偏移量等信息。 可以简单理解为流处理器中的一块内存区域(或者使用了外部数据库来存储)。 为什么流处理器需要 State? 计算需求 流处理器要求数据实时产出,不延迟 需要使用状态缓存窗口数据 准确一次语义需求 流处理器要求数据不丢失不重复,准确一次 需要使用状态记录数据源、计算程序、输出端等链路信息,可以及时恢复 容错需求 流处理器要求7 * 24小时运行,高可靠 需要状态来提供故障恢复与容灾的数据支持 横向扩容时根据状态中的数据进行分配管理 用户的计算需求中经常使用到状态的场景: 访问量统计 去重 窗口计算 访问历史数据 机器学习与深度学习 状态的存储实现一般有以下几种: 基于内存 基于嵌入式数据库 基于外部共享文件系统 State不仅给用户提供了高性能实现计算需求的方案,也是流处理器保持强正确性的工具之一。 5.2 Checkpoint 除了 State 之外,流处理器还需要一种 可以将 State 中的数据进行备份与恢复的机制 才能保证 任何时刻流处理器的宕机重启都不会影响最后的正确结果。 这种机制就是 Checkpoint(分布式全域一致快照),其包含流处理器全链路中的信息: Source的offset信息 各个节点上的State信息 Sink的事务信息 通过 Checkpoint,流处理器可以定时的备份系统中的状态与数据,并在必要时刻提供帮助。 以 Flink 中 Checkpoint 为例,其一个生成周期如下: 在数据源设置一系列的checkpoint barrier ck barrier n 与 ck barrier n-1 之间的数据都属于当前的checkpoint ck barrier n经过第一个op时向ck后端 保存source offset 经过后续每个op时 ck barrier n到达之前,会用input buffer缓存之前的数据集 ck barrier n到达表示当前所属的所有数据已经处理完成并更新状态 将当前op的状态保存至ck后端 ck barrier n经过sink op时向ck后端确认ck完整性 Checkpoint 生成之后,如果需要状态恢复与故障容错,则所有节点从hdfs中读取 「上次的数据位置」 来重置消息队列,并从 「上次的状态」 开始重新计算。 Checkpoint 机制对数据源有一定要求,即数据源的必要条件为 支持重放。 通过 State 与 Checkpoint 的结合使用,流处理器可以保持结果数据的强一致性。 定时制作分布式快照,对程序状态进行备份 发生故障时将程序恢复到最近一次成功的checkpoint,从那个点开始处理 问题:如何保证端到端的准确一次? 从以上我们讨论 State、Checkpoint 等机制来看,它们只能保证在 流处理器内部的准确一次。 Sink在使用了外部存储的情况下,在本次 Checkpoint 和上次 Checkpoint 之间源源不断写数据到外部存储中。 即使流处理器宕机从恢复点重启了,那么 之前处理的数据实际上已经写到了外部存储中,这种情况下就不能称之为端到端的准确一次了。 借助可重放的数据源、State/Checkpoint的流处理器,我们可以保证数据源到计算引擎的准确一次,那么使用外部存储的情况下如何保证端到端的准确一次?

优秀的个人博客,低调大师

基于阿里云的企业安全最佳实践

账户安全管理1、为云账户和高风险权限RAM用户启用多因素认证(MFA)。2、授权予高风险特权操作时,使用带IP和MFA限制条件的授权策略进行授权。3、分离用户管理、权限管理与资源管理的RAM用户,分权制衡。4、使用群组给RAM用户分配权限。5、善用STS安全令牌服务,为临时用户提供短期访问资源的权限凭证。6、为云账户和RAM登录用户配置强密码策略。7、不要为云账户(主账号)创建Access Key,避免AK泄漏的巨大风险。8、定期轮转用户登录密码和Access Key。9、将控制台用户与API用户分离。10、使用策略限制条件来增强安全性,比如访问源IP,时间等。比如,授权用户Alice可以关停ECS实例,限制条件是Alice必须在指定时间、并且用户公司网络中执行该操作。11、及时调整和撤销RAM用户不再需要的权限。12、遵循最小授

优秀的个人博客,低调大师

日志服务数据加工最佳实践: 函数调用

编写数据加工规则过程中,需根据场景选择不同的函数。LOG DSL函数的具体用法可参考数据加工语法参考。 场景1: 理解e_keep/KEEP的应用场景 默认规则中, 不做处理的事件都是保留. 所以KEEP通常只用于特定场景. 如果需要丢弃日志, 可以使用e_drop/e_drop传入条件或者使用e_if/e_if_else与DROP搭配使用: 如下比较区别: e_keep(e_search(...) ) # 满足保留, 不满足丢弃 e_drop(e_search(...) ) # 满足丢弃, 不满足保留 e_if(e_search("..."), KEEP) # 没有意义的代码, 满足后KEEP e_if_else(e_search("..."), KEEP, DROP) # 有意义 e_if(e_search("

优秀的个人博客,低调大师

日志服务数据加工最佳实践: 事件判断

场景1:判断字段是否存在 原始日志 a: a_vlue b: // 空串 LOG DSL编排 方案一:使用e_has, e_not_has e_if(e_has("a"), e_set("has_a", true)) e_if(e_has("b"), e_set("has_b", true)) e_if(e_has("c"), e_set("has_c", true)) e_if(e_not_has("a"), e_set("not_has_a", true)) e_if(e_not_has("b"), e_set("not_has_b", true)) e_if(e_not_has("c"), e_set("not_has_c", true)) 方案二:使用e_search e_if(e_search("a: *"), e_set("h

优秀的个人博客,低调大师

OSS数据处理最佳实践--文档预览

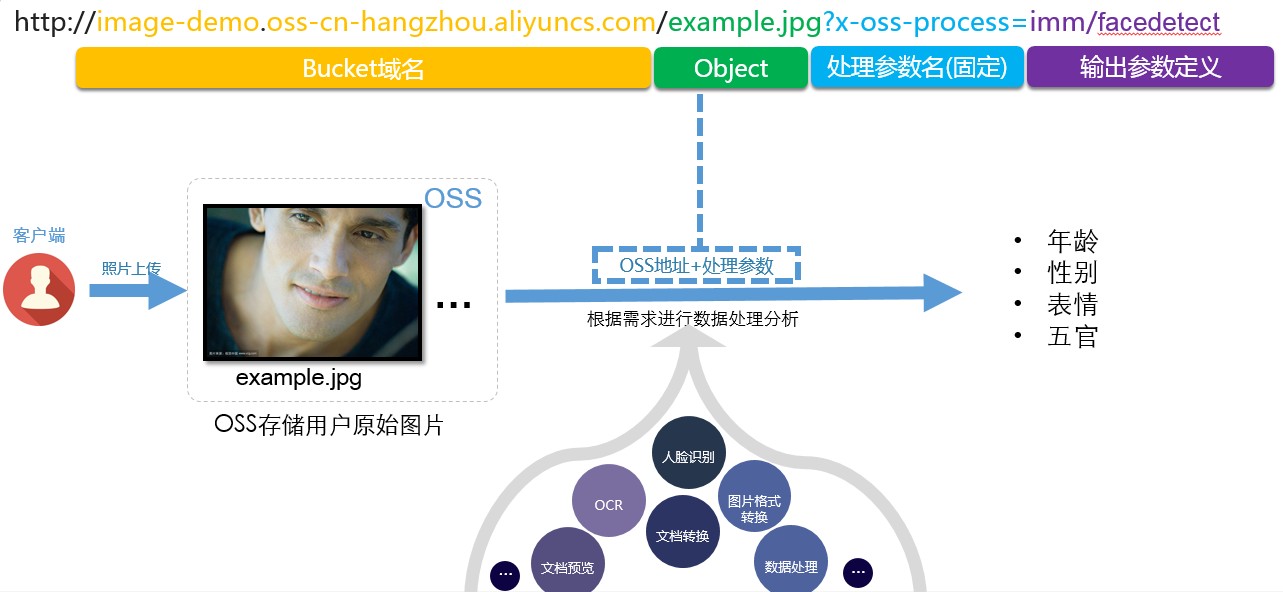
前言 当前整个企业级数据管理市场面临着数字化转型,如何更好的管理数据、挖掘非结构化数据(专业文档、视频、图像等)的价值是当前企业需要解决的问题。 阿里云存储开放的数据湖体系引入众多计算引擎。通过阿里云智能媒体管理产品,对象存储OSS面向视频处理应用,图像处理应用,文档处理应用开放了接入能力。目前通过智能媒体管理支持图像识别、人脸检测、视频截帧、图片处理、文档预览、文本检索等多项数据处理能力,为上层应用提供强有力的支持。 框架介绍 阿里云OSS为在云上的数据打通了一个处理与使用的快速通道。通过简单的 RESTful 接口,可以在任何时间、任何地点、任何互联网设备上对存储在OSS中的数据进行分析处理。 数据处理包含以下两种: 阿里云OSS原生处理服务阿里云OSS原生处理服务包括图片处理和视频截帧,其中图片处理包括图片的缩略、剪裁、参数调节等, O

优秀的个人博客,低调大师

【最佳实践】用户Bucket如何防御DDOS攻击?

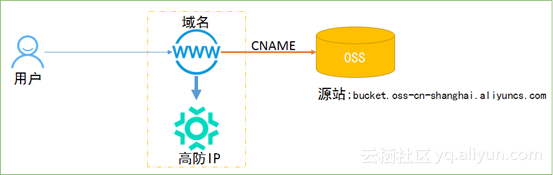
第一章:OSS沙箱说明 阿里云OSS不承担网络攻击的防护义务。用户账号下的Bucket遭受攻击后,OSS会自动将用户的Bucket切入到沙箱。沙箱中的Bucket仍然可以正常响应请求,但是用户有可能明显感受到该Bucket服务质量的下降。 注:沙箱介绍:沙箱介绍 第二章:借助于高防IP,OSS抵御DDOS攻击 2.1 方案1:绑定域名+高防IP方式防御DDOS攻击 如果您的业务有可能遭受DDOS攻击,可以按照如下方式进行配置。 绑定OSS自定义域名: 配置参考:[绑定自定义域名]; 购买高防IP,并将高防IP绑定到第一步设置的自定义域名。配置参考:[设置高防IP];注意:请根据业务实际情况,购买对应的弹性防护带宽; - “防护网站”:填写用户自定义的域名; - “协议类型”:根据实际访问请求方式,合理配置; - “源站IP

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册