首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10008篇文章
优秀的个人博客,低调大师

Istio on ACK集成生态(2): 扩展AlertManager集成钉钉助力可观测性监控能力

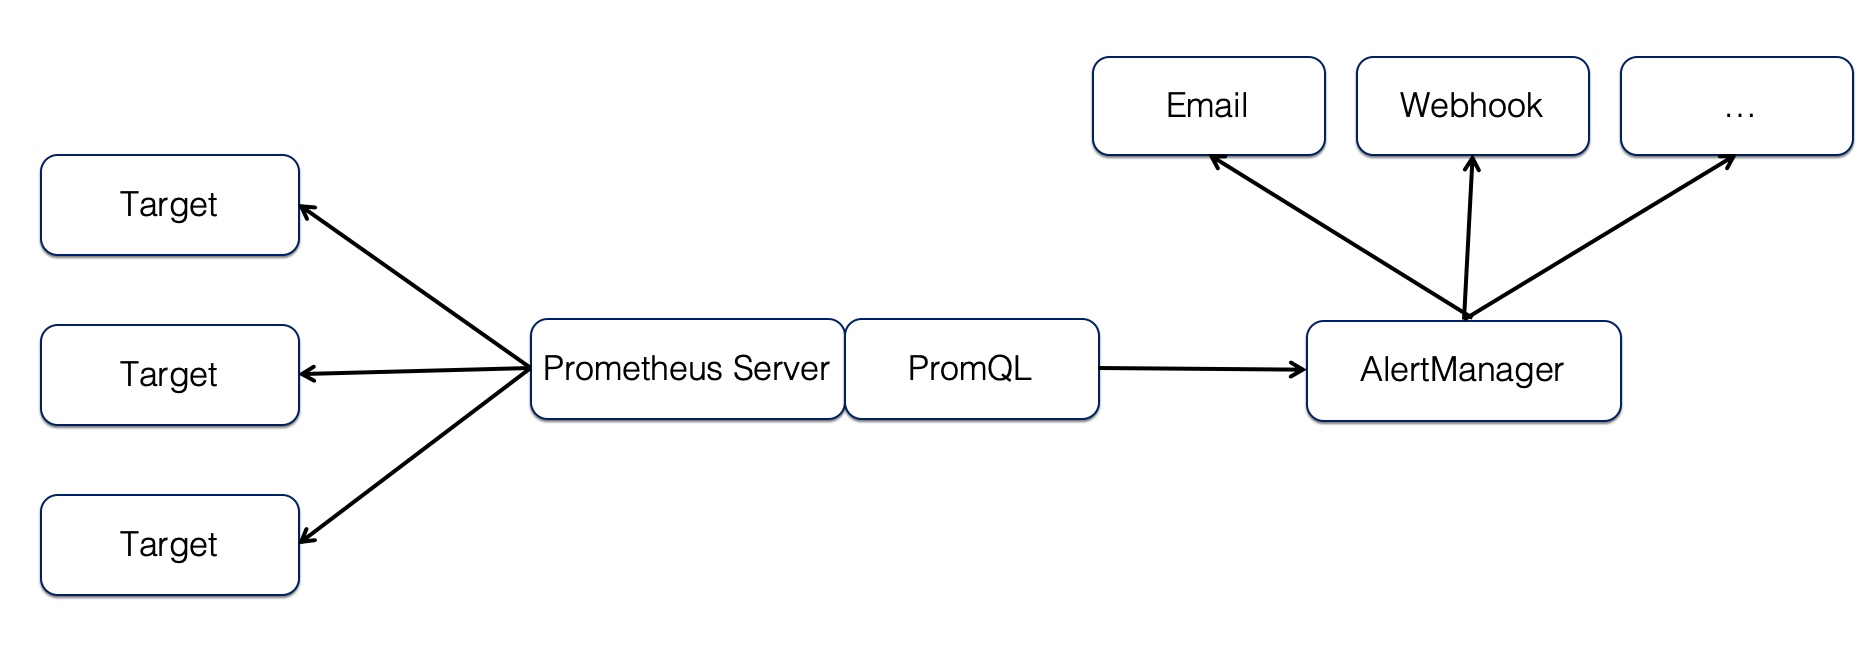
阿里云容器服务Kubernetes(简称ACK)支持一键部署Istio,可以参考文档在ACK上部署使用Isito。Istio on ACK提供了丰富的监控能力,为网格中的服务收集遥测数据,其中Mixer是负责提供策略控制和遥测收集的Istio组件。使用Prometheus进行监控是Istio提供的监控能力之一。 告警能力在Prometheus的架构中被划分成两个独立的部分:Prometheus负责产生告警,而Alertmanager负责告警产生后的后续处理。如下所示,通过在Prometheus中定义告警规则,Prometheus会周期性的对告警规则进行计算,如果满足告警触发条件就会向Alertmanager发送告警信息。 Alertmanager作为一个独立的组件,负责接收并处理来自Prometheus Server(也可以是其它的客

优秀的个人博客,低调大师

React Hooks源码深度解析

作者:京东零售 郑炳懿 前言 React Hooks是React16.8 引入的一个新特性,它允许函数组件中使用state和其他 React 特性,而不必使用类组件。Hooks是一个非常重要的概念,因为它们提供了更简单、更易于理解的React开发体验。 React Hooks的核心源码主要包括两个部分:React内部的Hook管理器和一系列预置的Hook函数。 首先,让我们看一下React内部的Hook管理器。这个管理器是React内部的一个重要机制,它负责管理组件中的所有Hook,并确保它们在组件渲染期间以正确的顺序调用。 内部Hook管理器 示例: const Hook = { queue: [], current: null, }; function useState(initialState) { const state = Hook.current[Hook.queue.length]; if (!state) { Hook.queue.push({ state: typeof initialState === 'function' ? initialState() : initialState, setState(value) { this.state = value; render(); }, }); } return [state.state, state.setState.bind(state)]; } function useHook(callback) { Hook.current = { __proto__: Hook.current, }; try { callback(); } finally { Hook.current = Hook.current.__proto__; } } function render() { useHook(() => { const [count, setCount] = useState(0); console.log('count:', count); setTimeout(() => { setCount(count + 1); }, 1000); }); } render(); 在这个示例中,Hook对象有两个重要属性:queue和current。queue存储组件中所有Hook的状态和更新函数,current存储当前正在渲染的组件的Hook链表。useState和useHook函数则分别负责创建新的Hook状态和在组件中使用Hook。 预置 Hook 函数 useState Hook 以下是useState Hook的实现示例: function useState(initialState) { const hook = updateWorkInProgressHook(); if (!hook.memoizedState) { hook.memoizedState = [ typeof initialState === 'function' ? initialState() : initialState, action => { hook.queue.pending = true; hook.queue.dispatch = action; scheduleWork(); }, ]; } return hook.memoizedState; } 上述代码实现了useState Hook,其主要作用是返回一个state和更新函数的数组,state 初始值为initialState。 在这个实现中,updateWorkInProgressHook()函数用来获取当前正在执行的函数组件的 fiber 对象并判断是否存在对应的hook。它的实现如下: function updateWorkInProgressHook() { const fiber = getWorkInProgressFiber(); let hook = fiber.memoizedState; if (hook) { fiber.memoizedState = hook.next; hook.next = null; } else { hook = { memoizedState: null, queue: { pending: null, dispatch: null, last: null, }, next: null, }; } workInProgressHook = hook; return hook; } getWorkInProgressFiber()函数用来获取当前正在执行的函数组件的fiber对象,workInProgressHook则用来存储当前正在执行的hook对象。在函数组件中,每一个useState调用都会创建一个新的 hook 对象,并将其添加到fiber对象的hooks链表中。这个hooks链表是通过fiber对象的memoizedState属性来维护的。 我们还需要注意到在useState Hook的实现中,每一个hook对象都包含了一个queue对象,用来存储待更新的状态以及更新函数。scheduleWork()函数则用来通知React调度器有任务需要执行。 在React的源码中,useState函数实际上是一个叫做useStateImpl的内部函数。 下面是useStateImpl的源码: function useStateImpl<S>(initialState: (() => S) | S): [S, Dispatch<SetStateAction<S>>] { const dispatcher = resolveDispatcher(); return dispatcher.useState(initialState); } 可以看到,useStateImpl函数的作用就是获取当前的dispatcher并调用它的useState方法,返回一个数组,第一个元素是状态的值,第二个元素是一个dispatch函数,用来更新状态。这里的resolveDispatcher函数用来获取当前的dispatcher,其实现如下: function resolveDispatcher(): Dispatcher { const dispatcher = currentlyRenderingFiber?.dispatcher; if (dispatcher === undefined) { throw new Error('Hooks can only be called inside the body of a function component. (https://fb.me/react-invalid-hook-call)'); } return dispatcher; } resolveDispatcher函数首先尝试获取当前正在渲染的fiber对象的dispatcher属性,如果获取不到则说 明当前不在组件的渲染过程中,就会抛出一个错误。 最后,我们来看一下useState方法在具体的dispatcher实现中是如何实现的。我们以useReducer的 dispatcher为例,它的实现如下: export function useReducer<S, A>( reducer: (prevState: S, action: A) => S, initialState: S, initialAction?: A, ): [S, Dispatch<A>] { const [dispatch, currentState] = updateReducer<S, A>( reducer, // $FlowFixMe: Flow doesn't like mixed types [initialState, initialAction], // $FlowFixMe: Flow doesn't like mixed types reducer === basicStateReducer ? basicStateReducer : updateStateReducer, ); return [currentState, dispatch]; } 可以看到,useReducer方法实际上是调用了一个叫做updateReducer的函数,返回了一个包含当前状态和dispatch函数的数组。updateReducer的实现比较复杂,涉及到了很多细节,这里不再展开介绍。 useEffect Hook useEffect是React中常用的一个Hook函数,用于在组件中执行副作用操作,例如访问远程数据、添加/移除事件监听器、手动操作DOM等等。useEffect的核心功能是在组件的渲染过程结束之后异步执行回调函数,它的实现方式涉及到 React 中的异步渲染机制。 以下是useEffect Hook的实现示例: function useEffect(callback, dependencies) { // 通过调用 useLayoutEffect 或者 useEffect 方法来获取当前的渲染批次 const batch = useContext(BatchContext); // 根据当前的渲染批次判断是否需要执行回调函数 if (shouldFireEffect(batch, dependencies)) { callback(); } // 在组件被卸载时清除当前 effect 的状态信息 return () => clearEffect(batch); } 在这个示例中,useEffect接收两个参数:回调函数和依赖项数组。当依赖项数组中的任何一个值发生变化时, React会在下一次渲染时重新执行useEffect中传入的回调函数。 useEffect函数的实现方式主要依赖于React中的异步渲染机制。当一个组件需要重新渲染时,React会将所有的state更新操作加入到一个队列中,在当前渲染批次结束之后再异步执行这些更新操作,从而避免在同一个渲染批次中连续执行多次更新操作。 在useEffect函数中,我们通过调用useContext(BatchContext)方法来获取当前的渲染批次,并根据shouldFireEffect方法判断是否需要执行回调函数。在回调函数执行完毕后,我们需要通过clearEffect方法来清除当前effect的状态信息,避免对后续的渲染批次产生影响。 总结 总的来说,React Hooks的实现原理并不复杂,它主要依赖于React内部的fiber数据结构和调度系统,通过这些机制来实现对组件状态的管理和更新。Hooks能够让我们在函数组件中使用状态和其他React特性,使得函数组件的功能可以和类组件媲美。 除了useState、useEffect等hook,React还有useContext等常用的Hook。它们的实现原理也基本相似,都是利用fiber架构来实现状态管理和生命周期钩子等功能。 以上是hook简单实现示例,它们并不是React中实际使用的代码,但是可以帮助我们更好地理解hook的核心实现方式。

优秀的个人博客,低调大师

深度解析 Jetpack Compose 布局

Jetpack Compose 是用于构建原生 Android 界面的新工具包。它可简化并加快 Android 上的界面开发,使用更少的代码、强大的工具和直观的 Kotlin API,快速让应用生动而精彩。Compose 使用全新的组件——可组合项 (Composable) 来布局界面,使用 修饰符 (Modifier) 来配置可组合项。 本文会为您讲解由可组合项和修饰符提供支持的组合布局模型,并深入探究其背后的工作原理以及它们的功能,让您更好地了解所用布局和修饰符的工作方式,和应如何以及在何时构建自定义布局,从而实现满足确切应用需求的设计。 如果您更喜欢通过视频了解本文内容,请 点击这里 观看。 布局模型 Compose 布局系统的目标是提供易于创建的布局,尤其是 自定义布局。这要求布局系统具备强大的功能,使开发者能创建应用所需的任何布局,并且让布局具备优异的性能。接下来,我们来看看 Compose 的布局模型 是如何实现这些目标的。 Jetpack Compose 可将状态转换为界面,这个过程分为三步: 组合、布局、绘制。组合阶段执行 可组合函数,这些函数可以生成界面,从而创建界面树。例如,下图中的 SearchResult 函数会生成对应的界面树: △ 可组合函数生成对应的界面树 可组合项中可以包含逻辑和控制流,因此可以根据不同的状态生成不同的界面树。在布局阶段,Compose 会遍历界面树,测量界面的各个部分,并将每个部分放置在屏幕 2D 空间中。也就是说,每个节点决定了其各自的宽度、高度以及 x 和 y 坐标。在绘制阶段,Compose 将再次遍历这棵界面树,并渲染所有元素。 本文将深入探讨布局阶段。布局阶段又细分为两个阶段: 测量和放置。这相当于 View 系统中的 onMeasure 和 onLayout。但在 Compose 中,这两个阶段会交叉进行,因此我们把它看成一个布局阶段。将界面树中每个节点布局的过程分为三步: 每个节点必须测量自身的所有子节点,再决定自身的尺寸,然后放置其子节点。如下例,单遍即可对整个界面树完成布局。 △ 布局过程 其过程简述如下: 测量根布局 Row; Row 测量它的第一个子节点 Image; 由于 Image 是一个不含子节点的叶子节点,它会测量自身尺寸并加以报告,还会返回有关如何放置其子节点的指令。Image 的叶子节点通常是空节点,但所有布局都会在设置其尺寸的同时返回这些放置指令; Row 测量它的第二个子节点 Column; Column 测量其子节点,首先测量第一个子节点 Text; Text 测量并报告其尺寸以及放置指令; Column 测量第二个子节点 Text; Text 测量并报告其尺寸以及放置指令; Column 测量完其子节点,可以决定其自身的尺寸和放置逻辑; Row 根据其所有子节点的测量结果决定其自身尺寸和放置指令。 测量完所有元素的尺寸后,将再次遍历界面树,并且会在放置阶段执行所有放置指令。 Layout 可组合项 我们已经了解这个过程涉及的步骤,接下来看一下它的实现方式。先看看组合阶段,我们采用 Row、Column、Text 等更高级别的可组合项来表示界面树,每个高级别的可组合项实际上都是由低级别的可组合项构建而成。以 Text 为例,可以发现它由若干更低级别的基础构建块组成,而这些可组合项都会包含一个或多个 Layout 可组合项。 △ 每个可组合项都包含一个或多个 Layout Layout 可组合项是 Compose 界面的基础构建块,它会生成 LayoutNode。在 Compose 中,界面树,或者说组合 (composition) 是一棵 LayoutNode 树。以下是 Layout 可组合项的函数签名: @Composable fun Layout( content: @Composable () -> Unit, modifier: Modifier = Modifier, measurePolicy: MeasurePolicy ) { … } △ Layout 可组合项的函数签名 其中,content 是可以容纳任何子可组合项的槽位,出于布局需要,content 中也会包含子 Layout。modifier 参数所指定的修饰符将应用于该布局,这在下文中会详细介绍。measurePolicy 参数是 MeasurePolicy 类型,它是一个函数式接口,指定了布局测量和放置项目的方式。一般情况下,如需实现自定义布局的行为,您要在代码中实现该函数式接口: @Composable fun MyCustomLayout( modifier: Modifier = Modifier, content: @Composable () -> Unit ) { Layout( modifier = modifier, content = content ) { measurables: List<Measurable>, constraints: Constraints -> // TODO 测量和放置项目 } } △ 实现 MeasurePolicy 函数式接口 在 MyCustomLayout 可组合项中,我们调用 Layout 函数并以 Trailing Lambda 的形式提供 MeasurePolicy 作为参数,从而实现所需的 measure 函数。该函数接受一个 Constraints 对象来告知 Layout 它的尺寸限制。Constraints 是一个简单类,用于限制 Layout 的最大和最小宽度与高度: class Constraints { val minWidth: Int val maxWidth: Int val minHeight: Int val maxHeight: Int } △ Constraints measure 函数还会接受 List<Measurable> 作为参数,这表示的是传入的子元素。Measurable 类型会公开用于测量项目的函数。如前所述,布局每个元素需要三步: 每个元素必须测量其所有子元素,并以此判断自身尺寸,再放置其子元素。其代码实现如下: @Composable fun MyCustomLayout( content: @Composable () -> Unit, modifier: Modifier = Modifier ) { Layout( modifier = modifier, content = content ) { measurables: List<Measurable>, constraints: Constraints -> // placeables 是经过测量的子元素,它拥有自身的尺寸值 val placeables = measurables.map { measurable -> // 测量所有子元素,这里不编写任何自定义测量逻辑,只是简单地 // 调用 Measurable 的 measure 函数并传入 constraints measurable.measure(constraints) } val width = // 根据 placeables 计算得出 val height = // 根据 placeables 计算得出 // 报告所需的尺寸 layout (width, height) { placeables.foreach { placeable -> // 通过遍历将每个项目放置到最终的预期位置 placeable.place( x = … y = … ) } } } } △ 布局每个元素的代码示例 上述代码中使用了 Placeable 的 place 函数,它还有一个 placeRelative 函数可用于从右到左的语言设置中,当使用该函数时,它会自动对坐标进行水平镜像。 请注意,API 在设计上可阻止您尝试放置未经测量的元素,place 函数只适用于 Placeable,也就是 measure 函数的返回值。在 View 系统中,调用 onMeasure 以及 onLayout 的时机由您决定,而且调用顺序没有强制要求,但这会产生一些微妙的 bug 以及行为上的差异。 自定义布局示例 MyColumn 示例 △ Column Compose 提供一个 Column 组件用于纵向排布元素。为了理解这个组件背后的工作方式及其使用 Layout 可组合项的方式,我们来实现自己的一个 Column。暂且将其命名为 MyColumn,其实现代码如下: @Composable fun MyColumn( modifier: Modifier = Modifier, content: @Composable () -> Unit ) { Layout( modifier = modifier, content = content ) { measurables, constraints -> // 测量每个项目并将其转换为 Placeable val placeables = measurables.map { measurable -> measurable.measure(constraints) } // Column 的高度是所有项目所测得高度之和 val height = placeables.sumOf { it.height } // Column 的宽度则为内部所含最宽项目的宽度 val width = placeables.maxOf { it.width } // 报告所需的尺寸 layout (width, height) { // 通过跟踪 y 坐标放置每个项目 var y = 0 placeables.forEach { placeable -> placeable.placeRelative(x = 0, y = y) // 按照所放置项目的高度增加 y 坐标值 y += placeable.height } } } } △ 自定义 Column VerticalGrid 示例 △ VerticalGrid 我们再来看另一个示例: 构建常规网格。其部分代码实现如下: @Composable fun VerticalGrid( modifier: Modifier = Modifier, columns: Int = 2, content: @Composable () -> Unit ) { Layout( content = content, modifier = modifier ) { measurables, constraints -> val itemWidth = constraints.maxWidth / columns // 通过 copy 函数保留传递下来的高度约束,但设置确定的宽度约束 val itemConstraints = constraints.copy ( minWidth = itemWidth, maxWidth = itemWidth, ) // 使用这些约束测量每个项目并将其转换为 Placeable val placeables = measurables.map { it.measure(itemConstraints) } … } } △ 自定义 VerticalGrid 在该示例中,我们通过 copy 函数创建了新的约束。这种为子节点创建新约束的概念就是实现自定义测量逻辑的方式。创建不同约束来测量子节点的能力是此模型的关键,父节点与子节点之间并没有协商机制,父节点会以 Constraints 的形式传递其允许子节点的尺寸范围,只要子节点从该范围中选择了其尺寸,父节点必须接受并处理子节点。 这种设计的优点在于我们可以单遍测量整棵界面树,并且禁止执行多个测量循环。这是 View 系统中存在的问题,嵌套结构执行多遍测量过程可能会让叶子视图上的测量次数翻倍,Compose 的设计能够防止发生这种情况。实际上,如果您对某个项目进行两次测量,Compose 会抛出异常: △ 重复测量某个项目时 Compose 会抛出异常 布局动画示例 由于具备更强的性能保证,Compose 提供了新的可能性,例如为布局添加动画。Layout composable 不仅可以创建通用布局,还能创建出符合应用设计需求的专用布局。以 Jetsnack 应用中的自定义底部导航为例,在该设计中,如果某项目被选中,则显示标签;如果未被选中,则只显示图标。而且,设计还需要让项目的尺寸和位置根据当前选择状态执行动画。 △ Jetsnack 应用中的自定义底部导航 我们可以使用自定义布局来实现该设计,从而对布局变化的动画处理进行精确控制: @Composable fun BottomNavItem( icon: @Composable BoxScope.() -> Unit, text: @Composable BoxScope.() -> Unit, @FloatRange(from = 0.0, to = 1.0) animationProgress: Float ) { Layout( content = { // 将 icon 和 text 包裹在 Box 中 // 这种做法能让我们为每个项目设置 layoutId Box( modifier = Modifier.layoutId(“icon”) content = icon ) Box( modifier = Modifier.layoutId(“text”) content = text ) } ) { measurables, constraints -> // 通过 layoutId 识别对应的 Measurable,比依赖项目的顺序更可靠 val iconPlaceable = measurables.first {it.layoutId == “icon” }.measure(constraints) val textPlaceable = measurables.first {it.layoutId == “text” }.measure(constraints) // 将放置逻辑提取到另一个函数中以提高代码可读性 placeTextAndIcon( textPlaceable, iconPlaceable, constraints.maxWidth, constraints.maxHeight, animationProgress ) } } fun MeasureScope.placeTextAndIcon( textPlaceable: Placeable, iconPlaceable: Placeable, width: Int, height: Int, @FloatRange(from = 0.0, to = 1.0) animationProgress: Float ): MeasureResult { // 根据动画进度值放置文本和图标 val iconY = (height - iconPlaceable.height) / 2 val textY = (height - textPlaceable.height) / 2 val textWidth = textPlaceable.width * animationProgress val iconX = (width - textWidth - iconPlaceable.width) / 2 val textX = iconX + iconPlaceable.width return layout(width, height) { iconPlaceable.placeRelative(iconX.toInt(), iconY) if (animationProgress != 0f) { textPlaceable.placeRelative(textX.toInt(), textY) } } } △ 自定义底部导航 使用自定义布局的时机 希望以上示例能帮助您了解自定义布局的工作方式以及这些布局的应用理念。标准布局强大而灵活,但它们也需要适应很多用例。有时,若您知道具体的实现需求,使用自定义布局可能更加合适。 当您遇到以下场景时,我们推荐使用自定义布局: 难以通过标准布局实现的设计。虽然可以使用足够多的 Row 和 Column 构建大部分界面,但这种实现方式有时难以维护和升级; 需要非常精确地控制测量和放置逻辑; 需要实现布局动画。我们正在开发可对放置进行动画处理的新 API,未来可能不必自行编写布局就能实现; 需要完全控制性能。下文会详细介绍这一点。 修饰符 至此,我们了解了 Layout 可组合项以及构建自定义布局的方式。如果您使用 Compose 构建过界面,就会知道 修饰符 在布局、配置尺寸和位置方面发挥着重要作用。通过前文的示例可以看到,Layout 可组合项接受修饰符链作为参数。修饰符会装饰它们所附加的元素,可以在布局自身的测量和放置操作之前参与测量和放置。接下来我们来看看它的工作原理。 修饰符分很多不同的类型,可以影响不同的行为,例如绘制修饰符 (DrawModifier)、指针输入修饰符 (PointerInputModifier) 以及焦点修饰符 (FocusModifier)。本文我们将重点介绍布局修饰符 (LayoutModifier),该修饰符提供了一个 measure 方法,该方法的作用与 Layout 可组合项基本相同,不同之处在于,它只作用于单个 Measurable 而不是 List<Measurable>,这是因为修饰符的应用对象是单个项目。在 measure 方法中,修饰符可以修改约束或者实现自定义放置逻辑,就像布局一样。这表示您并不总是需要编写自定义布局,如果只想对单个项目执行操作,则可以改用修饰符。 以 padding 修饰符为例,该工厂函数以修饰符链为基础,创建能够捕获所需 padding 值的 PaddingModifier 对象。 fun Modifier.padding(all: Dp) = this.then(PaddingModifier( start = all, top = all, end = all, bottom = all ) ) private class PaddingModifier( val start: Dp = 0.dp, val top: Dp = 0.dp, val end: Dp = 0.dp, val bottom: Dp = 0.dp ) : LayoutModifier { override fun MeasureScope.measure( measurable: Measurable, constraints: Constraints ): MeasureResult { val horizontal = start.roundToPx() + end.roundToPx() val vertical = top.roundToPx() + bottom.roundToPx() // 按 padding 尺寸收缩外部约束来修改测量 val placeable = measurable.measure(constraints.offset(-horizontal, -vertical)) val width = constraints.constrainWidth(placeable.width + horizontal) val height = constraints.constrainHeight(placeable.height + vertical) return layout(width, height) { // 按所需的 padding 执行偏移以放置内容 placeable.placeRelative(start.roundToPx(), top.roundToPx()) } } } △ padding 修饰符的实现 除了通过上例中的方式覆写 measure 方法实现测量,您也可以使用 Modifier.layout,在无需创建自定义布局的情况下直接通过修饰符链向任意可组合项添加自定义测量和放置逻辑,如下所示: Box(Modifier .background(Color.Gray) .layout { measurable, constraints -> // 通过修饰符在竖直方向添加 50 像素 padding 的示例 val padding = 50 val placeable = measurable.measure(constraints.offset(vertical = -padding)) layout(placeable.width, placeable.height + padding) { placeable.placeRelative(0, padding) } } ) { Box(Modifier.fillMaxSize().background(Color.DarkGray)) } △ 使用 Modifier.layout 实现布局 虽然 Layout 接受单个 Modifier 参数,该参数会建立一个按顺序应用的修饰符链。我们通过示例来了解它与布局模型的交互方式。我们将分析下图修饰符的效果及其工作原理: △ 修饰符链的效果示例 首先,我们为 Box 设置尺寸并将其绘制出来,但这个 Box 放置在了父布局的左上角,我们可以使用 wrapContentSize 修饰符将 Box 居中放置。wrapContentSize 允许内容测量其所需尺寸,然后使用 align 参数放置内容,align 参数的默认值为 Center,因此可以省略这个参数。但我们发现,Box 还是在左上角。这是因为大多数布局都会根据其内容自适应调整尺寸,我们需要让测量尺寸占据整个空间,以便让 Box 在空间内居中。因此,我们在 wrapContentSize 前面添加 fillMaxSize 布局修饰符来实现这个效果。 △ 修饰符链的应用过程 我们来看一下这些修饰符是如何实现此效果的。您可以借助下图动画来辅助理解该过程: △ 修饰符链的工作原理 假设这个 Box 要放入最大尺寸为 200*300 像素的容器内,容器会将相应的约束传入修饰符链的第一个修饰符中。fillMaxSize 实际上会创建一组新约束,并设置最大和最小宽度与高度,使之等于传入的最大宽度与高度以便填充到最大值,在本例中是 200*300 像素。这些约束沿着修饰符链传递以测量下一个元素,wrapContentSize 修饰符会接受这些参数,它会创建新的约束来放宽对传入约束的限制,从而让内容测量其所需尺寸,也就是宽 0-200,高 0-300。这看起来只像是对 fillMax 步骤的反操作,但请注意,我们是使用这个修饰符实现项目居中的效果,而不是重设项目的尺寸。这些约束沿着修饰符链传递到 size 修饰符,该修饰符创建具体尺寸的约束来测量项目,指定尺寸应该正好是 50*50。最后,这些约束传递到 Box 的布局,它执行测量并将解析得到的尺寸 (50*50) 返回到修饰符链,size 修饰符因此也将其尺寸解析为 50*50,并据此创建放置指令。然后 wrapContent 解析其大小并创建放置指令以居中放置内容。因为 wrapContent 修饰符知道其尺寸为 200*300,而下一个元素的尺寸为 50*50,所以使用居中对齐创建放置指令,以便将内容居中放置。最后,fillMaxSize 解析其尺寸并执行放置操作。 修饰符链的执行方式与布局树的工作方式非常相像,差异在于每个修饰符只有一个子节点,也就是链中的下一个元素。约束会向下传递,以便后续元素用其测量自身尺寸,然后返回解析得到的尺寸,并创建放置指令。该示例也说明了 修饰符顺序的重要性。通过使用修饰符对功能进行组合,您可以很轻松地将不同的测量和布局策略组合在一起。 高级功能 接下来将介绍布局模型的一些高级功能,虽然您不一定总是需要这些功能,但它们能够帮助您构建更高级的功能。 固有特性测量 (Intrinsic Measurement) 前文提到过,Compose 使用单遍布局系统。这个说法并不完全正确,布局并不总是能通过单遍操作就得以完成,有时我们也需要了解有关子节点尺寸的信息才能最终确定约束。 以弹出式菜单为例。假设有一个包含五个菜单项的 Column,如下图所示,它的显示基本上是正常的,但是可以看到,每个菜单项的尺寸却不相同。 △ 菜单项的尺寸不相同 我们很容易想到,让每个菜单项都占用允许的最大尺寸即可: △ 每个菜单项都占有允许的最大尺寸 但这么做也没能完全解决问题,因为菜单窗口会扩大到其最大尺寸。有效的解决方法是使用最大固有宽度来确定尺寸: △ 使用最大固有宽度来确定尺寸 这里确定了 Column 会尽力为每个子节点提供所需的空间,对 Text 而言,其宽度是单行渲染全部文本所需的宽度。在确定固有尺寸后,将使用这些值设置 Column 的尺寸,然后,子节点就可以填充 Column 的宽度了。 如果使用最小值而非最大值,又会发生什么呢? △ 使用最小固有宽度来确定尺寸 它将确定 Column 会使用子节点的最小尺寸,而 Text 的最小固有宽度是每行一个词时的宽度。因此,我们最后得到一个按词换行的菜单。 如需详细了解固有特性测量,请参阅 Jetpack Compose 中的布局 Codelab 中的 "固有特性" 部分。 ParentData 到目前为止,我们看到的修饰符都是通用修饰符,也就是说,它们可以应用于任何可组合项。有时,您的布局提供的一些行为可能需要从子节点获得一些信息,这便要用到 ParentDataModifier。 我们回到前面那个在父节点中居中放置蓝色 Box 的示例。这一次,我们将这个 Box 放在另一个 Box 中。Box 中的内容在一个称为 BoxScope 的接收器作用域内排布。BoxScope 定义了只在 Box 内可用的修饰符,它提供了一个名为 Align 的修饰符。这个修饰符刚好能够提供我们要应用到蓝色 Box 的功能。因此,如果我们知道蓝色 Box 位于另一个 Box 内,就可以改用 Align 修饰符来定位它。 △ 在 BoxScope 中可以改用 Align 修饰符来定位内容 Align 是一个 ParentDataModifier 而不是我们之前看到的那种布局修饰符,因为它只是向其父节点传递一些信息,所以如果不在 Box 中,该修饰符便不可用。它包含的信息将提供给父 Box,以供其设置子布局。 您也可以为自己的自定义布局编写 ParentDataModifier,从而允许子节点向父节点告知一些信息,以供父节点在布局时使用。 对齐线 (Alignment Lines) 我们可以使用对齐线根据布局顶部、底部或中心以外的标准来设置对齐。最常用的 对齐线 是文本基线。假设需要实现这样一个设计: △ 需要实现设计图中的图标和文本对齐 我们很自然就能想到这样来实现它: Row { Icon(modifier = Modifier .size(10. dp) .align(Alignment.CenterVertically) ) Text(modifier = Modifier .padding(start = 8.dp) .align(Alignment.CenterVertically) ) } △ 有问题的对齐实现 仔细观察,会发现图标并没有像设计稿那样对齐在文本的基线上。 △ 图标和文本居中对齐,图标底部没有落在文本基线上 我们可以通过以下代码进行修复: Row { Icon(modifier = Modifier .size(10. dp) .alignBy { it.measuredHeight } ) Text(modifier = Modifier .padding(start = 8.dp) .alignByBaseline() ) } △ 正确的对齐实现 首先,对 Text 使用 alignByBaseline 修饰符。而图标既没有基线,也没有其他对齐线,我们可以使用 alignBy 修饰符让图标对齐到我们需要的任何位置。在本例中,我们知道图标的底部是对齐的目标位置,因此将图标的底部进行对齐。最终便实现了期望的效果: △ 图标底部与文本基线完美对齐 由于对齐功能会穿过父节点,因此,处理嵌套对齐时,只需设置父节点的对齐线,它会从子节点获取相应的值。如下例所示: △ 未设置对齐的嵌套布局 △ 通过父节点设置对齐线 您甚至可以在自定义布局中创建自己的自定义对齐,从而允许其他可组合项对齐到它。 BoxWithConstraints BoxWithConstraints 是一个功能强大且很实用的布局。在组合中,我们可以根据条件使用逻辑和控制流来选择要显示的内容,但是,有时候可能希望根据可用空间的大小来决定布局内容。 从前文中我们知道,尺寸信息直到布局阶段才可用,也就是说,这些信息一般无法在组合阶段用来决定要显示的内容。此时 BoxWithConstraints 便派上用场了,它与 Box 类似,但它将内容的组合推迟到布局阶段,此时布局信息已经可用了。BoxWithConstraints 中的内容在接收器作用域内排布,布局阶段确定的约束将通过该作用域公开为像素值或 DP 值。 @Composable fun BoxWithConstraints( ... content: @Composable BoxWithConstraintsScope.() -> Unit ) // BoxWithConstraintsScope 公开布局阶段确定的约束 interface BoxWithConstraintsScope : BoxScope { val constraints: Constraints val minWidth: Dp val maxWidth: Dp val minHeight: Dp val maxHeight: Dp } △ BoxWithConstraints 和 BoxWithConstraintsScope 它内部的内容可以使用这些约束来选择要组合的内容。例如,根据最大宽度选择不同的呈现方式: @Composable fun MyApp(...) { BoxWithConstraints() { // this: BoxWithConstraintsScope when { maxWidth < 400.dp -> CompactLayout() maxWidth < 800.dp -> MediumLayout() else -> LargeLayout() } } } △ 在 BoxWithConstraintsScope 中根据最大宽度选择不同的布局 性能 我们介绍了单遍布局模型如何防止在测量或放置方面花费过多时间,也演示了布局阶段两个不同的子阶段: 测量和放置。现在,我们将介绍性能相关的内容。 尽量避免重组 单遍布局模型的设计效果是,任何只影响项目的放置而不影响测量的修改都可以单独执行。以 Jetsnack 为例: △ Jetsnack 应用中产品详情页的协调滚动效果 这个产品详情页包含协调滚动效果,页面上的一些元素根据滚动操作进行移动或缩放。请注意标题区域,这个区域会随着页面内容而滚动,最后固定在屏幕的顶部。 @Composable fun SnackDetail(...) { Box { val scroll = rememberScrollState(0) Body(scroll) Title(scroll = scroll.value) ... } } @Composable fun Body(scroll: ScrollState) { Column(modifier = Modifier.verticalScroll(scroll)) { … } } △ 详情页的大致实现 为了实现此效果,我们将不同元素作为独立的可组合项叠放在一个 Box 中,提取滚动状态并将其传入 Body 组件。Body 会使用滚动状态进行设置以使内容能够垂直滚动。在 Title 等其他组件中可以观察滚动位置,而我们的观察方式会对性能产生影响。例如,使用最直接的实现,简单地使用滚动值对内容进行偏移: @Composable fun Title(scroll: Int) { Column( modifier = Modifier.offset(scroll) ) { … } } △ 简单地使用滚动值偏移 Title 的内容 这种方法的问题是,滚动是一个可观察的状态值,读取该值所处的作用域规定了状态发生变化时 Compose 需要重新执行的操作。在此示例中,我们要读取组合中的滚动偏移值,然后使用它来创建偏移修饰符。只要滚动偏移值发生变化,Title 组件都需要重新组合,也就需要创建并执行新的偏移修饰符。由于滚动状态是从组合中读取的,任何更改都会导致重组,在重组时,还需要进行布局和绘制这两个后续阶段。 不过,我们不是要更改显示的内容,而是更改内容的位置。我们还可以进一步提高效率,通过修改一下实现,不再接受原始滚动位置,而是传递一个可以提供滚动位置的函数: @Composable fun Title(scrollProvider: () -> Int) { Column( modifier = Modifier.offset { val scroll = scrollProvider() val offset = (maxOffset - scroll).coerceAtLeast(minOffset) IntOffset(x = 0, y = offset) } ) { … } } △ 使用提供滚动位置的函数代替原始滚动位置 这时,我们可以在不同的时间只调用此 Lambda 函数并读取滚动状态。这里使用了 offset 修饰符,它接受能提供偏移值的 Lambda 函数作为参数。这意味着在滚动发生变化时,不需要重新创建修饰符,只在放置阶段才会读取滚动状态的值。所以,当滚动状态变化时我们只需要执行放置和绘制操作,不需要重组或测量,因此能够提高性能。 再回到底部导航的示例,它存在同样的问题,我们可以用相同方法加以修正: @Composable fun BottomNavItem( icon: @Composable BoxScope.() -> Unit, text: @Composable BoxScope.() -> Unit, animationProgress: () -> Float ) { … val progress = animationProgress() val textWidth = textPlaceable.width * progress val iconX = (width - textWidth - iconPlaceable.width) / 2 val textX = iconX + iconPlaceable.width return layout(width, height) { iconPlaceable.placeRelative(iconX.toInt(), iconY) if (animationProgress != 0f) { textPlaceable.placeRelative(textX.toInt(), textY) } } } △ 修正后的底部导航 我们使用了能提供当前动画进度的函数作为参数,因此不需要重组,只执行布局即可。 您需要掌握一个原则: 只要可组合项或修饰符的参数可能频繁发生更改,都应当保持谨慎,因为这种情况可能导致过度组合。只有在更改显示内容时,才需要重组,更改显示位置或显示方式则不需要这么做。 BoxWithConstraints 可以根据布局执行组合,是因为它会在布局阶段启动子组合。出于性能考虑,我们希望尽量避免在布局期间执行组合。因此,相较于 BoxWithConstraints,我们倾向于使用会根据尺寸更改的布局。当信息类型随尺寸更改时才使用 BoxWithConstraints。 提高布局性能 有时候,布局不需要测量其所有子节点便可获知自身大小。举个例子,有如下构成的卡片: △ 布局卡片示例 图标和标题构成标题栏,剩下的是正文。已知图标大小为固定值,标题高度与图标高度相同。测量卡片时,就只需要测量正文,它的约束就是布局高度减去 48 DP,卡片的高度则为正文的高度加上 48 DP。 △ 测量过程只测量正文尺寸 系统识别出只测量了正文,因此它是决定布局尺寸的唯一重要子节点,图标和文本仍然需要测量,但可以在放置过程中执行。 △ 放置过程测量图标和文本 假设标题是 "Layout",当标题发生变化时,系统不必重新执行布局的测量操作,因此不会重新测量正文,从而省去不必要的工作。 △ 标题发生变化时不必重新测量 总结 在本文中,我们介绍了自定义布局的实现过程,还使用修饰符构建和合并布局行为,进一步降低了满足确切功能需求的难度。此外,还介绍了布局系统的一些高级功能,例如跨嵌套层次结构的自定义对齐,为自有布局创建自定义 ParentDataModifier,支持自动从右向左设置,以及将组合操作推迟到布局信息已知时,等等。我们还了解如何执行单遍布局模型,如何跳过重新测量以使其只执行重新放置操作的方法,熟练使用这些方法,您将能编写出通过手势进行动画处理的高性能布局逻辑。 对布局系统的理解能够帮助您构建满足确切设计需求的布局,从而创建用户喜爱的优秀应用。如需了解更多,请查阅以下列出的资源: Jetpack Compose 使用入门文档 Jetpack Compose 学习路线图 Jetpack Compose 相关示例 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!
优秀的个人博客,低调大师

Group By 深度优化,真是绝了!

作者:谦虚的小K<br> 来源:www.juejin.cn/post/6957696820621344775 导读 当我们交友平台在线上运行一段时间后,为了给平台用户在搜索好友时,在搜索结果中推荐并置顶他感兴趣的好友,这时候,我们会对用户的行为做数据分析,根据分析结果给他推荐其感兴趣的好友。 这里,我采用最简单的SQL分析法:对用户过去查看好友的性别和年龄进行统计,按照年龄进行分组得到统计结果。依据该结果,给用户推荐计数最高的某个性别及年龄的好友。 那么,假设我们现在有一张用户浏览好友记录的明细表t_user_view,该表的表结构如下: CREATE TABLE `t_user_view` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增id', `user_id` bigint(20) DEFAULT NULL COMMENT '用户id', `viewed_user_id` bigint(20) DEFAULT NULL COMMENT '被查看用户id', `viewed_user_sex` tinyint(1) DEFAULT NULL COMMENT '被查看用户性别', `viewed_user_age` int(5) DEFAULT NULL COMMENT '被查看用户年龄', `create_time` datetime(3) DEFAULT CURRENT_TIMESTAMP(3), `update_time` datetime(3) DEFAULT CURRENT_TIMESTAMP(3) ON UPDATE CURRENT_TIMESTAMP(3), PRIMARY KEY (`id`), UNIQUE KEY `idx_user_viewed_user` (`user_id`,`viewed_user_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; 为了方便使用SQL统计,见上面的表结构,我冗余了被查看用户的性别和年龄字段。 我们再来看看这张表里的记录: 现在结合上面的表结构和表记录,我以user_id=1的用户为例,分组统计该用户查看的年龄在18 ~ 22之间的女性用户的数量: SELECT viewed_user_age as age, count(*) as num FROM t_user_view WHERE user_id = 1 AND viewed_user_age BETWEEN 18 AND 22 AND viewed_user_sex = 1 GROUP BY viewed_user_age 得到统计结果如下: 可见: 该用户查看年龄为18的女性用户数为2 该用户查看年龄为19的女性用户数为1 该用户查看年龄为20的女性用户数为3 所以,user_id=1的用户对年龄为20的女性用户更感兴趣,可以更多推荐20岁的女性用户给他。 如果此时,t_user_view这张表的记录数达到千万规模,想必这条SQL的查询效率会直线下降,为什么呢?有什么办法优化呢? 想要知道原因,不得不先看一下这条SQL执行的过程是怎样的? Explain 我们先用explain看一下这条SQL: EXPLAIN SELECT viewed_user_age as age, count(*) as num FROM t_user_view WHERE user_id = 1 AND viewed_user_age BETWEEN 18 AND 22 AND viewed_user_sex = 1 GROUP BY viewed_user_age 执行完上面的explain语句,我们得到如下结果: 在Extra这一列中出现了三个Using,这3个Using代表了《导读》中的groupBy语句分别经历了3个执行阶段: Using where:通过搜索可能的idx_user_viewed_user索引树定位到满足部分条件的viewed_user_id,然后,回表继续查找满足其他条件的记录 Using temporary:使用临时表暂存待groupBy分组及统计字段信息 Using filesort:使用sort_buffer对分组字段进行排序 这3个阶段中出现了一个名词:临时表。这个名词我在《MySQL分表时机:100w?300w?500w?都对也都不对!》一文中有讲到,这是MySQL连接线程可以独立访问和处理的内存区域,那么,这个临时表长什么样呢? 下面我就先讲讲这张MySQL的临时表,然后,结合上面提到的3个阶段,详细讲解《导读》中SQL的执行过程。 临时表 我们还是先看看《导读》中的这条包含groupBy语句的SQL,其中包含一个分组字段viewed_user_age和一个统计字段count(*),这两个字段是这条SQL中统计所需的部分,如果我们要做这样一个统计和分组,并把结果固化下来,肯定是需要一个内存或磁盘区域落下第一次统计的结果,然后,以这个结果做下一次的统计,因此,像这种存储中间结果,并以此结果做进一步处理的区域,MySQL叫它临时表。 刚刚提到既可以将中间结果落在内存,也可以将这个结果落在磁盘,因此,在MySQL中就出现了两种临时表:内存临时表和磁盘临时表。 内存临时表 什么是内存临时表?在早期数据量不是很大的时候,以存储分组及统计字段为例,那么,基本上内存就可以完全存放下分组及统计字段对应的所有值,这个存放大小由tmp_table_size参数决定。这时候,这个存放值的内存区域,MySQL就叫它内存临时表。 此时,或许你已经觉得MySQL将中间结果存放在内存临时表,性能已经有了保障,但是,在《MySQL分表时机:100w?300w?500w?都对也都不对!》中,我提到过内存频繁的存取会产生碎片,为此,MySQL设计了一套新的内存分配和释放机制,可以减少甚至避免临时表内存碎片,提升内存临时表的利用率。 此时,你可能会想,在《为什么我调大了sort_buffer_size,并发量一大,查询排序慢成狗?》一文中,我讲了用户态的内存分配器:ptmalloc和tcmalloc,无论是哪个分配器,它的作用就是避免用户进程频繁向Linux内核申请内存空间,造成CPU在用户态和内核态之间频繁切换,从而影响内存存取的效率。用它们就可以解决内存利用率的问题,为什么MySQL还要自己搞一套? 或许MySQL的作者觉得无论哪个内存分配器,它的实现都过于复杂,这些复杂性会影响MySQL对于内存处理的性能,因此,MySQL自身又实现了一套内存分配机制:MEM_ROOT。它的内存处理机制相对比较简单,内存临时表的分配就是采用这样一种方式。 下面,我就以《导读》中的SQL为例,详细讲解一下分组统计是如何使用MEM_ROOT内存分配和释放机制的? MEM_ROOT 我们先看看MEM_ROOT的结构,MEM_ROOT设计比较简单,主要包含这几部分,如下图: free:一个单向链表,链表中每一个单元叫block,block中存放的是空闲的内存区,每个block包含3个元素: left:block中剩余的内存大小 size:block对应内存的大小 next:指向下一个block的指针 如上图,free所在的行就是一个free链表,链表中每个箭头相连的部分就是block,block中有left和 size,每个block之间的箭头就是next指针 used:一个单向链表,链表中每一个单元叫block,block中存放已使用的内存区,同样,每个block包含上面3 个元素 min_malloc:控制一个 block 剩余空间还有多少的时候从free链表移除,加入到used链表中 block_size:block对应内存的大小 block_num:MEM_ROOT 管理的block数量 first_block_usage:free链表中第一个block不满足申请空间大小的次数 pre_alloc:当释放整个MEM_ROOT的时候可以通过参数控制,选择保留pre_alloc指向的block 下面我就以《导读》中的分组统计SQL为例,看一下MEM_ROOT是如何分配内存的? 分配 初始化MEM_ROOT,见上图: min_malloc = 32 block_num = 4 first_block_usage = 0 pre_alloc = 0 block_size = 1000 err_handler = 0 free = 0 used = 0 申请内存,见上图: 由于初始化MEM_ROOT时,free = 0,说明free链表不存在,故向Linux内核申请4个大小为1000/4=250的block,构造一个free链表,如上图,链表中包含4个block ,结合前面free链表结构的说明,每个block中size为250,left也为250 分配内存,见上图: (1) 遍历free链表,从free链表头部取出第一个block,如上图向下的箭头 (2) 从取出的block中划分220大小的内存区,如上图向右的箭头上面-220,block中的left从250变成30 (3) 将划分的220大小的内存区分配给SQL中的groupby字段viewed_user_age和统计字段count(*),用于后面的统计分组数据收集到该内存区 (4) 由于第(2)步中,分配后的block中的left变成30,30 < 32,即小于第(1)步中初始化的min_malloc,所以,结合上面min_malloc的含义的讲解,该block将插入used链表尾部,如上图底部,由于used链表在第(1)步初始化时为0,所以,该block插入used链表的尾部,即插入头部 释放 下面还是以《导读》中的分组统计为例,我们再来看一下MEM_ROOT是如何释放内存的? image-20210323233158459.png 如上图,MEM_ROOT释放内存的过程如下: 遍历used链表中,找到需要释放的block,如上图,block(30,250)为之前已分配给分组统计用的block 将block(30,250)中的left + 220,即30 + 220 = 250,释放该block已使用的220大小的内存区,得到释放后的block(250,250) 将block(250,250)插入free链表尾部,如上图曲线箭头部分 通过MEM_ROOT内存分配和释放的讲解,我们发现MEM_ROOT的内存管理方式是在每个Block上连续分配,内部碎片基本在每个Block的尾部,由min_malloc成员变量控制,但是min_malloc的值是在代码中写死的,有点不够灵活。所以,对一个block来说,当left小于min_malloc,从其申请的内存越大,那么block中的left值越小,那么,该block的内存利用率越高,碎片越少,反之,碎片越多。这个写死是MySQL的内存分配的一个缺陷。 磁盘临时表 当分组及统计字段对应的所有值大小超过tmp_table_size决定的值,那么,MySQL将使用磁盘来存储这些值。这个存放值的磁盘区域,MySQL叫它磁盘临时表。 我们都知道磁盘存取的性能一定比内存存取的性能差很多,因为会产生磁盘IO,所以,一旦分组及统计字段不得不写入磁盘,那性能相对是很差的,所以,我们尽量调大参数tmp_table_size,使得组及统计字段可以在内存临时表中处理。 执行过程 无论是使用内存临时表,还是磁盘临时表,临时表对组及统计字段的处理的方式都是一样的。《导读》中我提到想要优化《导读》中的那条SQL,就需要知道SQL执行的原理,所以,下面我就结合上面讲解的临时表的概念,详细讲讲这条SQL的执行过程,见下图: 创建临时表temporary,表里有两个字段viewed_user_age和count(*),主键是viewed_user_age,如上图,倒数第二个框temporary表示临时表,框中包含两个字段viewed_user_age和count(*),框内就是这两个字段对应的值,其中viewed_user_age就是这张临时表的主键 扫描表辅助索引树idx_user_viewed_user,依次取出叶子节点上的id值,即从索引树叶子节点中取到表的主键id。如上图中的idx_user_viewed_user框就是索引树,框右侧的箭头表示取到表的主键id 根据主键id到聚簇索引cluster_index的叶子节点中查找记录,即扫描cluster_index叶子节点: (1) 得到一条记录,然后取到记录中的viewed_user_age字段值。如上图,cluster_index框,框中最右边的一列就是viewed_user_age字段的值 (2) 如果临时表中没有主键为viewed_user_age的行,就插入一条记录 (viewed_user_age, 1)。如上图的temporary框,其左侧箭头表示将cluster_index框中的viewed_user_age字段值写入temporary临时表 (3) 如果临时表中有主键为viewed_user_age的行,就将viewed_user_age这一行的count(*)值加 1。如上图的temporary框 遍历完成后,再根据字段viewed_user_age在sort_buffer中做排序,得到结果集返回给客户端。如上图中的最右边的箭头,表示将temporary框中的viewed_user_age和count(*)的值写入sort_buffer,然后,在sort_buffer中按viewed_user_age字段进行排序 通过《导读》中的SQL的执行过程的讲解,我们发现该过程经历了4个部分:idx_user_viewed_user、cluster_index、temporary和sort_buffer,对比上面explain的结果,其中前2个就对应结果中的Using where,temporary对应的是Using temporary,sort_buffer对应的是Using filesort。 优化方案 此时,我们有什么办法优化这条SQL呢? 既然这条SQL执行需要经历4个部分,那么,我们可不可以去掉最后两部分呢,即去掉temporary和sort_buffer? 答案是可以的,我们只要给SQL中的表t_user_view添加如下索引: ALTER TABLE `t_user_view` ADD INDEX `idx_user_age_sex` (`user_id`, `viewed_user_age`, `viewed_user_sex`); 你可以自己尝试一下哦!用explain康康有什么改变! 小结 本章围绕《导读》中的分组统计SQL,通过explain分析SQL的执行阶段,结合临时表的结构,进一步剖析了SQL的详细执行过程,最后,引出优化方案:新增索引,避免临时表对分组字段的统计,及sort_buffer对分组和统计字段排序。 当然,如果实在无法避免使用临时表,那么,尽量调大tmp_table_size,避免使用磁盘临时表统计分组字段。 思考题 为什么新增了索引idx_user_age_sex可以避免临时表对分组字段的统计,及sort_buffer对分组和统计字段排序? 提示:结合索引查找的原理。 近期热文推荐: 1.1,000+ 道 Java面试题及答案整理(2021最新版) 2.别在再满屏的 if/ else 了,试试策略模式,真香!! 3.卧槽!Java 中的 xx ≠ null 是什么新语法? 4.Spring Boot 2.5 重磅发布,黑暗模式太炸了! 5.《Java开发手册(嵩山版)》最新发布,速速下载! 觉得不错,别忘了随手点赞+转发哦!

优秀的个人博客,低调大师

深度分析Dridex银行木马

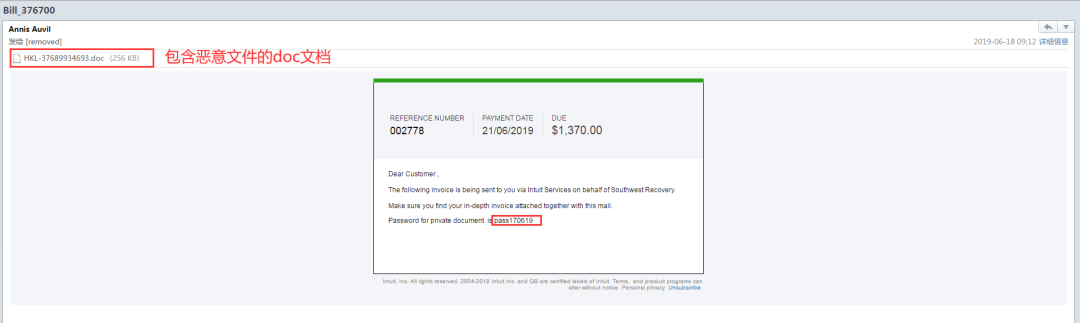
安全分析与研究 专注于全球恶意软件的分析与研究 样本简介 Dridex是目前全球活跃的技术最先进的银行木马之一。该恶意软件的主要目标是从受害者身上窃取银行凭证。Dridex自2014年以来一直存在,并且一直在更新,这些更新帮助恶意软件不断发展并变得越来越强大。 由于黑客组不断的技术改进发展,Dridex当前支持非常先进的功能,例如Atom Bombing注入技术,将Web注入Chrome和Microsoft Word的0day漏洞,这帮助Dridex恶意软件感染了无数机器。 Dridex被归类为GameOver ZeuS的演变,它借鉴了该病毒的C&C架构并对其进行了进一步改进,从而使控制服务器很难确定。Dridex银行木马还具有与其他恶意软件CRIDEX和Bugat相似的特征。尽管最新消息Dridex主要依赖漏洞作为攻击媒介,但Dridex还使用垃圾邮件感染受害者的计算机。 行为分析 传播途径 样本的传播是通过钓鱼邮件发送恶意doc文件,邮件内容如下。 附件的恶意doc文件是被加密的,密码为pass170619 输入密码打开之后提示我们要启用宏 开启宏之后的内容 恶意word行为 对doc文件进行分析发现文件包含自启动和一些可疑的行为以及包含的URL下载链接。 恶意宏代码 包含的恶意宏代码。 从宏代码中可以看到在C:\Windows\Temp释放了一个aXwZvnt48.xsl文件。并调用VMIC.exe执行释放的xsl文件。 XSL文件 XSL文件内容如下,从tor2net.com下载恶意文件servicewn.exe。 从服务器下载dridex木马并保存在temp目录,运行完之后删除自身xsl文件。 变种分析 XSL文件 上面这个样本的服务器已经不能通信了,该病毒的最新变种前面的步骤和上面的都差不多,到这一步的xsl文件内容不同,最新的变种的xsl文件从服务器下载的是个dll文件。保存在C:/Windows/Temp文件下,名称是随机命名的。 第一段shellcode 拷贝数据 将加密的数据复制到指定的地址。 解密数据 对加密的shellcode进行解密。 修改内存页属性 修改shellcode所在地址内存执行权限为可读可写可执行。 执行shellcode 跳转到shellcode执行。 自解密 解密自身中加密的代码 解密shellcode中的代码。 获取指定函数地址 获取函数地址kernel32.dll中指定函数的地址。这里shellcode当中使用的循环,每次都对kernel32.dll的导出表进行遍历,找到需要的函数名之后在从头开始遍历 获取加载基址 通过pe头标志和对地址每次减0x1000来获取加载基址。 申请新的空间 申请内存空间 第二段shellcode 拷贝数据 将shellcode拷贝到刚申请的内存空间当中。 执行并拷贝第三段shellcode 上面拷贝完第二段shellcode之后,接着执行第二段shellcode中的内容,然后拷贝第三段shellcode的内容到内存中。 位置变换 将从dll里面拷贝的数据以特殊的方式进行调整位置。末尾是2FB的函数就是调整位置的函数。 解密shellcode算法 调整完位置之后在对数据进行解密。解密方式用的xor DL,DL中的内容根据循环次数和3做AND操作,为0就变换一次DL中的内容。DL中内容的变换规律是DL和DL相加,结果乘以3然后在右移5位,得到一个新的DL。 末尾是2CE的函数是解密函数。 第四段shellcode 接着申请空间,然后拷贝第四段shellcode的数据到新申请的空间。 拷贝依据 判断是否接着拷贝数据是根据之前第三段shellcode最终解密出来的数据。当值不为0的时候就继续执行拷贝。 最后一次拷贝 最后一次拷贝。 释放空间 释放第三段shellcode申请的空间。 位置变换 对刚才拷贝的数据以特殊的方式进行调整。 解密shellcode 和上面解密第三段shellcode使用的算法相同。 特殊处理 解密之后对数据进行了特殊的处理,处理之后变成了pe文件。 释放FLS 释放FLS索引。 dll替换 修改内存页属性 更改1220000地址的内存页属性为可读可写,这个地址就是dll加载的地址。 清除原来数据 清除加载的dll的内容。 替换dll内容 将上面处理的pe文件拷贝到刚才清空的空间当中。 按照pe信息中的节依次拷贝过去。 修改内存页属性 把上面修改的内存页属性在改回来。 修改对应段的内存页属性 代码段所在内存页修改为可读可执行。 资源数据段内存页修改为可读 数据段内存页修改为可读可写 重定位段内存页修改为可读 释放资源 释放原始数据的空间。 清除当前执行的shellcode。 执行替换之后的dll 之后retn返回到最初加载的dll文件里面,但是这个内存空间里面的数据都是被替换的新的数据,retn到的是新的dll文件的OEP。 替换之后的dll 自己实现的获取字符串的长度。 hash加密 末尾为0510的函数的功能为对指定的字符串进行加密。 在0510函数内部调用的是13C0这个函数,函数内部通过移位异或等方式处理过后在循环0x100次之后加密完成。 加密之后的字符串和0x6AECC489异或之后如果为0xADC2B18也就是ntdll.dll就通过自己实现的GetProcAddress函数获取指定函数的地址。 末尾为4200的函数功能是根据传递的dll的地址和函数名加密后的hash获取函数的地址。这里为获取0xD047C681的地址,也就是RtlAddVectoredExceptionHandler函数。 遍历dll的导出表,然后对函数名进行加密,之后比对加密过后的值是不是自己需要的函数。 注册VEH异常 获取到需要的函数之后,3790函数作用为执行获取到的函数。这里执行RtlAddVectoredExceptionHandler为注册VEH异常,其中6A686CB0为异常处理函数。 上面这些就是0F60函数的功能。 GetProcAddress函数 注册完VEH异常之后获取kernel32.dll中的函数。 在3BB0函数里面判断字符串是不是kernel32.dll B140函数的主要功能。 函数44C0为GetProcAddress,传递进去的两个参数一个是dll的加载基址,另一个是函数名。这里0xADC2B18是ntdll,0x92E0E512是RtlCreateHeap函数,0xD084EC36是RtlDestroyHeap函数。 执行RtlCreateHeap 异常处理函数 之后获取0xCB389DFD RtlAllocateHeap函数的地址,获取之后判断是否获取成功,之后触发INT3 异常。 跳转到VEH异常处理函数里面。 对异常进行处理,分析发现是直接修改线程上下文,跳过了INT3异常。 跳过异常之后通过retn执行RtlAllocateHeap函数。 通过异常retn执行RtlAllocateHeap循环申请内存空间 获取RtlComputeCrc32函数地址 最终这里获取到ExitProcess函数的地址,然后退出了程序。不知道有什么地方的判断条件不满足,所以程序没有执行下去。 木马特征 1.通过office宏从服务器下载恶意文件。 2.恶意文件被加密做过免杀处理。 3.执行全部过程采用无文件加载,所有的内容都在内存中。 4.关键函数被hash加密处理过。 5.导出表,导入表等信息被加密。 6.自己重写GetProcAddress函数。 7.注册VEH异常,调用异常处理函数执行异常,增加调试难度。 恶意软件研究需要大量的专业知识储备,而且需要掌握很多不同的专业技能,同时需要研究人员持之以恒的研究态度,是一项非常具有挑战性的安全研究工作,需要付出很多的时间和精力,银行类木马又是一种非常复杂的恶意软件家族,这篇文章进行了深入的分析与研究。 威胁情报收集 常常有读者朋友通过微信或其他方式给我发送一些新的恶意软件或遇到的一些网络攻击案例,非常感谢这些朋友或公众号读者给我提供这些最新的攻击样本和威胁情报,同时也欢迎各位读者朋友,不管是你的企业,还是你个人遇到了一些网络安全攻击事件,都可以通过微信或邮件给我提供各种相关的威胁情报,这些威胁情报包含: 样本 域名 IP地址 钓鱼邮件 钓鱼网站 以及其它一些相关的安全威胁情报信息,同时笔者为了让更多从事这方面的专业人员可以一起交流学习,相互讨论,共同进步,也为了培养更多这方面的专业人才,成立了一个"虚拟的"MR安全团队,有一个MR安全团队微信群,群里的成员可以随时交流讨论各种关于恶意软件的相关话题,专注于全球恶意软件家族的分析与研究,跟踪分析全球黑客组织攻击活动 MR安全团队的成员需要分享自己业余时间的一些安全技术分析报告或相关研究文章等,这样可以帮助更多想从事这个方向的新人,有兴趣的可以找我私聊,加入MR安全团队微信群,一起学习,共同进步,同时MR安全团队的成员,可以免费加入笔者的知识星球和专业群,与更多安全行业各个不同方向的朋友进行交流,学习! 目前针对我国的黑客攻击行为越来越多,各种远控木马、窃密后门、勒索病毒、APT攻击行动已经层出不穷,未来有组织有目的的攻击行为会越来越多,全球网络安全战已经开始,各个黑客组织都在不断的研发自己的新的恶意软件以及各种攻击武器,预计到2021年全球的恶意软件成本会高达6万亿美元 可以说恶意软件已经无处不在,企业数据安全受到了严重的威胁,各种窃密木马以及远控软件横行,地下黑客组织的各种网络犯罪活动未来也会越来越多,不管是政府部门,还是各大中小型企业都是黑客攻击的目的,黑客组织无时无刻不在寻找着新的攻击目标 随着未来各种平台的不断增多,各种新型的恶意软件将会无处不在,黑客组织也在不断开发研究新型的恶意软件做为网络攻击武器,未来会需要更多专业的恶意软件研究人员,安全的路很长,坚持,坚持,再坚持! 本文分享自微信公众号 - 安全分析与研究(MalwareAnalysis)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

OSS 直播功能深度分享

场景描述 目前有很多直播爱好者使用的是 OSS + RTMP 做的推流直播,其中不乏一些企业级别应用,由于 OSS 作为推流的接收略微有一些复杂,故单独开篇讲一下。其实不建议使用 OSS+RTMP 做直播推流,因为功能性相比专业的阿里云直播产品来说,OSS 的推流适合监管备份等特定场景 ,客户端对直播推流的延迟要求不是很敏感。如果对直播的拉流推流延迟有高敏感的场景,建议大家使用阿里云视频直播服务,可以做到上下行链路加速,且支持多样化的直播功能适配; 使用基础 简单的直播知识 您需要了解甚至掌握简单的直播知识技巧才能熟练的使用 OSS 直播,不仅是针对 OSS 还涉及到客户端的推流等相关问题,所以需要明白直播的相关基础 【音视频头介绍】 OSS 的直播功能是建立在 RTMP 直播传输协议的基础上,所以需要指导一些基础的 RMTP 知识:RTMP 的音视频流的封装形式和 FLV 格式相似, 流媒体服务器向客户端发送包含 H264 和 AAC 的 RTMP 直播流,需要首先发送这两个 header,没有这些信息播放端是无法解码音视频流的,其中音频 tag 格式如下 1)AVC sequence header2)AAC sequence header 从上面推论出 AAC sequence header 内容的前 2 个字节是 0xAF 0x00,我们来看一个示例: 3)ADIF:Audio Data Interchange Format 音频数据交换格式。这种格式的特征是可以确定的找到这个音频数据的开始,不需进行在音频数据流中间开始的解码,即它的解码必须在明确定义的开始处进行。故这种格式常用在磁盘文件中。 4)ADTS:Audio Data Transport Stream 音频数据传输流。这种格式的特征是它是一个有同步字的比特流,解码可以在这个流中任何位置开始。它的特征类似于 mp3 数据流格式。 【RTMP 内容介绍】 以下是我对 RTMP 总结的一张完整描述图 对象存储推流架构 看下官网对于 OSS 推流的过程定义: 1)只能使用RTMP推流的方式,不支持拉流。2)必须包含视频流,且视频流格式为H264。3)音频流是可选的,并且只支持AAC格式,其他格式的音频流会被丢弃。4)转储只支持HLS协议。5)一个LiveChannel同时只能有一个客户端向其推流。 RTMP 的推流格式: demo :rtmp://your-bucket.oss-cn-hangzhou.aliyuncs.com/live/test-channel live 等同于 RTMP 的 APP 挂载点 test-channel 等同于 RTMP 的 stream name RTMP URL 推流签名: demo:rtmp://${bucket}.${host}/live/${channel}?OSSAccessKeyId=xxx&Expires=yyy&Signature=zzz&${params} 推流前 LiveChannel有两种Status:enabled和disabled,用户可以使用本接口在两种Status之间进行切换。处于disabled状态时,OSS会禁止用户向该LiveChannel进行推流操作;如果有用户正在向该LiveChannel推流,那么推流的客户端会被强制断开(可能会有10s左右的延迟) 对象存储推流的流程汇总图如下 生成推流 URL API设置推流状态API 使用 JAVA SDK 生成推流地址 我们现在用 java 的 SDK 演示一下如上的推理过程,在跑 SDK 之前,需要先搭建好一套本地的 eclipse 环境,如下是我用的 eclipse,如果有没搭建请网上搜索一下 eclipse 的搭建方式(之前需要安装 JDK 且配置环境变量) 环境要求 Eclipse 版本:Version: Neon.3 Release (4.6.3) JDK 版本:jdk1.8.0_144 OSS:公开读(为了验证推流功能是否正常,我们用公开读的方式快速测试) 我们采用主函数入口的方式,实例化其他类进行调用,这样方便类的拆分,不用都集合在主函数中。 主函数 domain,实例化 OSSClient 对象传入到 RtmpTest 类中测试。 所有的 jar 都会通过官方的 maven 解决的依赖关系,https://help.aliyun.com/document_detail/32009.html package javasdk; import java.io.FileNotFoundException; import java.text.ParseException; import java.util.HashMap; import java.util.Map; import com.aliyun.oss.OSSClient; public class domain { public static void main( String[] args ) throws ParseException, FileNotFoundException { System.out.println( "Hello World!" ); String accessid = "AK"; String secretkey = "SK"; String objectpath = "C://Users//hanli.zyb//Desktop//running.png"; String bucket = "bucket"; String object = "running"; String endpoint = "http://oss-cn-hangzhou.aliyuncs.com"; // OSS + rtmp 推流 String bucketName = "ali-hangzhou"; RtmpTest pushoss = new RtmpTest(); OSSClient ossClient = new OSSClient(endpoint, AK, SK); pushoss.testCreateLiveChannel(bucketName,ossClient); } } ​``` /* Licensed to the Apache Software Foundation (ASF) under one or more contributor license agreements. See the NOTICE file distributed with this work for additional information regarding copyright ownership. The ASF licenses this file to you under the Apache License, Version 2.0 (the "License"); you may not use this file except in compliance with the License. You may obtain a copy of the License at* http://www.apache.org/licenses/LICENSE-2.0* Unless required by applicable law or agreed to in writing, software distributed under the License is distributed on an "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied. See the License for the specific language governing permissions and limitations under the License.*/ package javasdk; import java.text.ParseException;import java.util.Date;import java.util.List;import junit.framework.Assert; import org.junit.Ignore;import org.junit.Test; import com.aliyun.oss.OSSClient;import com.aliyun.oss.OSSErrorCode;import com.aliyun.oss.OSSException;import com.aliyun.oss.common.utils.DateUtil;import com.aliyun.oss.model.CannedAccessControlList;import com.aliyun.oss.model.CreateLiveChannelRequest;import com.aliyun.oss.model.CreateLiveChannelResult;import com.aliyun.oss.model.ListLiveChannelsRequest;import com.aliyun.oss.model.LiveChannel;import com.aliyun.oss.model.LiveChannelInfo;import com.aliyun.oss.model.LiveChannelListing;import com.aliyun.oss.model.LiveChannelStat;import com.aliyun.oss.model.LiveChannelStatus;import com.aliyun.oss.model.LiveChannelTarget;import com.aliyun.oss.model.LiveRecord;import com.aliyun.oss.model.PushflowStatus;import com.aliyuncs.DefaultAcsClient;import com.aliyuncs.profile.DefaultProfile;import com.aliyuncs.profile.IClientProfile; /** Test rtmp*/ public class RtmpTest { String bucketName = "bucket"; final String liveChannel = "stream name"; @Test public void testCreateLiveChannelDefault(String bucketname,OSSClient ossClient) { try { CreateLiveChannelRequest createLiveChannelRequest = new CreateLiveChannelRequest( bucketName, liveChannel); CreateLiveChannelResult createLiveChannelResult = ossClient.createLiveChannel(createLiveChannelRequest); LiveChannelInfo liveChannelInfo = ossClient.getLiveChannelInfo(bucketName, liveChannel); ossClient.deleteLiveChannel(bucketName, liveChannel); } catch (Exception e) { Assert.fail(e.getMessage()); } } @Test public void testCreateLiveChannel(String bucketname,OSSClient ossClient) { final String liveChannel = "normal-create-live-channel"; final String liveChannelDesc = "my test live channel"; try { LiveChannelTarget target = new LiveChannelTarget("HLS", 100, 99, "myplaylist.m3u8"); CreateLiveChannelRequest createLiveChannelRequest = new CreateLiveChannelRequest( bucketName, liveChannel, liveChannelDesc, LiveChannelStatus.Enabled, target); CreateLiveChannelResult createLiveChannelResult = ossClient.createLiveChannel(createLiveChannelRequest); System.out.println(createLiveChannelResult.getPublishUrls()); /*Assert.assertEquals(createLiveChannelResult.getPublishUrls().size(), 1); Assert.assertTrue(createLiveChannelResult.getPublishUrls().get(0).startsWith("rtmp://")); Assert.assertTrue(createLiveChannelResult.getPublishUrls().get(0).endsWith("live/" + liveChannel)); Assert.assertEquals(createLiveChannelResult.getPlayUrls().size(), 1); Assert.assertTrue(createLiveChannelResult.getPlayUrls().get(0).startsWith("http://")); Assert.assertTrue(createLiveChannelResult.getPlayUrls().get(0).endsWith(liveChannel + "/myplaylist.m3u8"));*/ /* LiveChannelInfo liveChannelInfo = ossClient.getLiveChannelInfo(bucketName, liveChannel); Assert.assertEquals(liveChannelInfo.getDescription(), liveChannelDesc); Assert.assertEquals(liveChannelInfo.getStatus(), LiveChannelStatus.Disabled); Assert.assertEquals(liveChannelInfo.getTarget().getType(), "HLS"); Assert.assertEquals(liveChannelInfo.getTarget().getFragDuration(), 100); Assert.assertEquals(liveChannelInfo.getTarget().getFragCount(), 99); Assert.assertEquals(liveChannelInfo.getTarget().getPlaylistName(), "myplaylist.m3u8");*/ // ossClient.deleteLiveChannel(bucketName, liveChannel); } catch (Exception e) { Assert.fail(e.getMessage()); } } } 其中我们最关注的是 testCreateLiveChannel 类,创建了推流地址,其中参数 LiveChannelStatus.enable 是要让推流变为可用状态。 running 主函数,打印出推流地址。 rtmp://hangzhou.oss-cn-hangzhou.aliyuncs.com/live/normal-create-live-channel public void testCreateLiveChannel(String bucketname,OSSClient ossClient) { final String liveChannel = "normal-create-live-channel"; final String liveChannelDesc = "my test live channel"; try { LiveChannelTarget target = new LiveChannelTarget("HLS", 100, 99, "myplaylist.m3u8"); CreateLiveChannelRequest createLiveChannelRequest = new CreateLiveChannelRequest( bucketName, liveChannel, liveChannelDesc, LiveChannelStatus.Enabled, target); CreateLiveChannelResult createLiveChannelResult = ossClient.createLiveChannel(createLiveChannelRequest); System.out.println(createLiveChannelResult.getPublishUrls()); /*Assert.assertEquals(createLiveChannelResult.getPublishUrls().size(), 1); Assert.assertTrue(createLiveChannelResult.getPublishUrls().get(0).startsWith("rtmp://")); Assert.assertTrue(createLiveChannelResult.getPublishUrls().get(0).endsWith("live/" + liveChannel)); Assert.assertEquals(createLiveChannelResult.getPlayUrls().size(), 1); Assert.assertTrue(createLiveChannelResult.getPlayUrls().get(0).startsWith("http://")); Assert.assertTrue(createLiveChannelResult.getPlayUrls().get(0).endsWith(liveChannel + "/myplaylist.m3u8"));*/ // ossClient.deleteLiveChannel(bucketName, liveChannel); } catch (Exception e) { Assert.fail(e.getMessage()); } }​

优秀的个人博客,低调大师

深度解读何为智慧校园

随着互联网技术和信息技术的高速发展,各行各业信息化建设如火如荼,教育信息化发展也日新月异。早在2010年信息化“十二五”规划率先明确提出“智慧校园”概念,2012年《教育信息化十年发展规划(2011-2020年)》中再次明确要求各学校加快教育信息化建设,全力推动智慧型校园建设。智慧校园的建设已经成为教育信息化的重要组成部分,是衡量教育现代化程度的重要标志,有力的主导了当前中小学校教育信息化建设与发展的方向,当前各地中小学校正在从传统数字化校园建设向智慧化校园建设迈进。 智慧校园 1、智慧校园的概念 智慧校园一般是指通过应用互联网、物联网、云计算、大数据等新技术,将学校教学、科研、管理等事务以及各类校园资源和应用系统高效整合,从而实现智慧化管理和服务的新型信息化校园建设模式,以促进信息技术与教育教学融合、提高教与学的效果为目的,并能对教育教学、教育管理进行洞察和预测的智慧学习环境。 智慧校园建设的核心内容是支持管理服务体系技术系统、学校教育教学模式和相应的组织体系,为教师、学生、管理人员和校外人员等提供了智慧化的教学、科研、管理、公共服务、文化生活、社会服务和决策支持服务,促进教师和学生信息化素养的全面发展。 2、智慧校园与数字校园的区别 我国自实施教育信息化以来,已发展经历基础的校园网建设、数字校园,到目前智慧校园建设等几个阶段。智慧校园与数字校园是密不可分的,数字校园是互联网时代的产物,互联网是物联网的基础,物联网是互联网的延伸,没有互联网的基础,物联网无从产生,因此智慧校园是建立在数字校园基础上的,两者都是致力于解决校园信息化问题的。 传统数字校园是建立在互联网基础上的校园网,它以数字化信息和互联网络为基础,在计算机和网络技术上建立起来的对教学、科研、管理、技术服务、生活服务等校园信息的收集、处理、整合、存储、传输和应用。智慧校园则是以物联网、云技术、大数据等新技术为核心技术,它是建立在物联网基础之上的校园网。数字校园强调统一的信息编码及通过单点登录提供系统授权后的服务,而智慧校园是在数字校园基础之上将服务延伸及扩展到物,提供人与物、物与物信息互通互联的智能化服务。可以说智慧校园是数字校园发展到一定阶段的产物,是数字校园发展的一个新阶段。智慧校园与数字校园相比,在环境、管理、技术、服务提供、教学、科研等方面也存在较大的区别,见表1。 当前中小学智慧校园建设现状 目前各地很多中小学校在传统数字化校园建设基础上,已经陆续开展智慧化校园的研究和建设。很多地方教育主管部门非常重视智慧校园的建设,有些地区将智慧校园建设与当地智慧城市建设相结合,并采用分层创建形式加以推动,很多中小学校已经开始建设基于智慧校园的信息基础环境。不少学校将智慧校园的建设纳入学校“十三五”规划之中,并作为学校教育信息化的重点工程,不少学校也成立了智慧校园建设工作领导小组,初步规划了建设内容和方向,也建成了部分信息化应用系统平台,比如校园网站、微信公众号、教学资源库、网络教学平台、校园一卡通等系统平台。有部分中小学校已初步建成符合当地标准的县级或市级智慧校园,但大部分建设处于启动或初级阶段,距离真正意义上智慧校园还有很大的距离。 智慧校园建设存在问题 但是由于对智慧校园尚没有统一的认识,很多中小学在智慧校园建设过程中普遍存在认识不到位、缺乏整体系统规划、没有统一的标准、建设内容庞杂、参与部门分工不清,规划建设周期长、缺乏统一信息编码标准以及信息化保障机制不够健全等问题,严重制约了智慧化校园的建设进程。 1、智慧校园建设认识不足 智慧校园的建设涉及人力因素、环境配备、设备资源以及社会多方面因素,它需要顶层设计,更需要结合各学校实际进行因地制宜。从目前总体看,我国各中小学智慧校园建设的观念还十分滞后。首先,中小学智慧校园建设的理念较为落后。同时,仍有不少学校管理者对智慧校园建设的重要性认识不足,还简单的认为智慧校园不过是以往数字化校园换个高大上的名字,错误地认为智慧校园的建设就是将学校网络建好,买几台电脑、各班级装上多媒体;其次,一些中小学教师或其他教辅人员对智慧校园认识非常不到位,缺乏现代教育技术的先进教学理念,信息化的教学应用水平较低,甚至还认为智慧校园建设加重教师的工作量。 2、智慧校园建设缺乏系统规划 智慧校园建设的的主要是为了更好的方便广大教育管理者、教师和学生学习、工作、生活。然而当前不少学校在开展智慧校园建设时,急功近利,很多时候就是为了达到创建的目的,没有真正领会智慧校园建设的内涵,只满足与解决当前的一些局部的需求,没有进行系统的、长远的规划和设计,参与部门有时候都是各自为政,从而导致很多公共教育资源没有实现实质性共享,在物联网、大数据等应用方面是空白,违背了智慧校园建设的初衷。很多学校虽然建有学校网站、教师博客、人事管理、学生评价分析、校本资源库等系统,但是这些系统都相互独立,各系统数据账号等信息不通,演变成新的信息资源孤岛,这样由于缺乏统一的规划设计,导致广大教师对智慧校园的建设认识出现误判,大家投身智慧校园建设的积极性下降,也造成许多投入和教育资源的浪费。 3、智慧校园建设重硬轻软 同数字化校园建设一样,智慧校园的建设应该在硬件和软件方面形成合力,才能凸显物联网、云计算、大数据等新技术在智慧校园建设应用中作用。在各地中小学创建智慧校园或在智慧校园建设过程中,目前普遍存在“重硬件,轻软件;重建设,轻应用”的现象,在学校硬件环境基础实施建设方便都是不惜重金投入,在硬件设备配置上也是高标准,有些设备的技术性能参数远远高于实际的需求。而最为重要的软件系统方面投入甚少,智慧化的应用平台也是停滞不前,与传统数字化校园相比没有太大的变化,严重忽视了软件平台系统在智慧校园建设中的重要性。有些地区部分学校因为创建智慧校园在某些方面实现了信息技术自动化管理,但也都是分散不成体系的。智慧校园的核心建设应该体现以应用为本,从学校教学、教研、管理和后勤服务等实际需要出发,合理设计,开发适应智慧化校园的各种信息化系统平台,才能充分体现数字化、智慧化校园的先进性。 推进智慧校园建设的对策 1、提高认识,充分体会智慧校园建设的重要性 各地教育主管部门要加强智慧校园内涵的通识和理论培训,首先要让各中小学校的领导充分认识到建设智慧校园的重要性,要让大家切身感受到智慧校园是未来智慧教育发展的必然趋势。各学校要定期组织不同范围层次的人员进行培训宣传,或者组织部分技术骨干教师外出参观学习,让大家耳濡目染,身临其境去感受智慧型校园的魅力,让他们在认识上再提高,可以通过系列活动,要让大家形成共识:智慧校园的建设最终是实现教学、教研、师生学习、管理以及校园生活等各项工作实现数字化、自动化和智能化,全面提高学校教学管理水平,为广大教师学生提供一站式服务的管理目标。 2、科学规划,分布建设智慧校园各阶段目标 很多中小学在智慧校园建设过程中出现的一些问题都是因为前期缺乏系统的发展规划。一个经过科学系统论证的发展规划,它在理念上、技术上以及应用上能保持一定的先进性,可以将学校有限的人力、物力和资金投入到最需要的地方。智慧校园的建设发展规划要从学校全局和实际校情出发,一般包含以下五个方面:现状分析、指导思想或工作方针、发展目标、重点任务或重大工程、保证措施等,如图1所示。 智慧校园在科学的发展规划指导下,要充分调动校内外各种力量,强化各部门的协调与合作,要组建强有力的实施团队。按照组织机构划分,智慧校园建设至少包括上级教育主管部门、学校、智慧校园研发企业、应用产品供应商等。按照团队人员构成划分,智慧校园的建设包括学校领导、实施智慧校园建设项目主管和具体协调人员、学生、教师、后勤服务人员、智慧校园建设专家、基础实施部署安装人员、项目监理人员、智慧校园的管理与维护人员等。 第一,成立智慧校园建设领导班子,筛选骨干组成建设团队; 第二,组织建设团队到一些智慧校园建设水平高的一些中小学进行实地调研学习,到承担过智慧校园建设项目的成熟公司进行考察,充分听取他们成功经验; 第三,建设团队需要有较高的信息素养,了解物联网、云计算、大数据、人工智能等新技术的发展,能够充分理解智慧校园科学发展规划的内涵并有能力组织实施。 3、软硬并举,加快软件应用平台的建设 智慧校园建设在必要的网络环境、硬件装备投入的基础上,要广泛根据实际需要建设各种软件应用平台,要让物联网、云计算、大数据等核心技术在硬件基础上得以应用。软件系统平台建设要采用成熟可靠的技术,可选用模块化、开放式架构,这样才能保证今后软件平台系统的可持续升级扩容。软件应用系统是为教育教学服务,实现教学资源分享,为学习者创设学习情景,提供学习服务,为教师提供方便的教学环境和引导环境,为学生提供优质的学习空间,为管理者提供高效的管理环境。在软件应用平台中,尤以智慧化教学系统的建设更为重要,根据智慧教育的总体思路,软件平台可包含管理信息平台、教务管理、办公自动化系统、网上教学教研等系统。 结束语 智慧校园建设是顺应信息技术的发展趋势,是扩大优质教育教学资源,优化教育教学环境、深化教育改革的重要途径。智慧校园的建设是系统工程,绝不会一蹴而就,根据校情,科学谋划,统筹安排,在加强学校基础信息环境和软件应用建设的同时,提高广大教职工信息化水平,在实践中不断反思总结,最终建成适合自身发展需要的智慧校园。 本文内容来源:《电脑与信息技术》 编辑:飞进科技 super丹

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册