首页 文章 精选 留言 我的

精选列表

搜索[动态节点],共10008篇文章
优秀的个人博客,低调大师

配置单节点伪分布式Hadoop

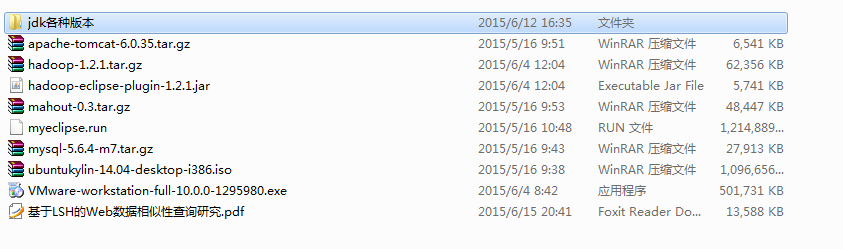
先写的这一篇,很多东西没再重复写。 一.所需软件 jdk和ubuntu都是32位的。 二.安装JDK 1.建jdk文件夹 cd usr sudo mkdir javajdk 2.移动mv或者复制cp安装包 //进入桌面 cd home/hxsyl/DeskTop sudo mv /usr/javajdk 3.安装 //切换到root下 //如果忘记密码,先 sudo passwd //直接会让你输入新密码,不需要输入原来的密码 //到jdk目录下 ./jdk-6u30-linux-i586.bin //如果提示权限不足,先 chmod 777 jdk-6u30-linux-i586.bin 3.配置环境变量 sudo gedit /etc/profile 加入如下内容 # /etc/profile: system-wide .profile file for the Bourne shell (sh(1)) # and Bourne compatible shells (bash(1), ksh(1), ash(1), ...). #set java environment export JAVA_HOME=/usr/javajdk/jdk1.6.0_45 export JRE_HOME=/usr/local/java/jdk1.6.0_45/jre export CLASSPATH=.:$JAVA_HOME/lib:$JRE_HOME/lib:$CLASSPATH export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$JAVA_HOME:$PATH 注意:为了以后集群工作的方便,这里建议每台机器的java环境最好一致。一般更改/etc/profile文件后,需要重启机器才能生效。这里介绍一种不用重启使其生效的方法。 source /etc/profile 这个我没试过,我记得win下配置jdk的环境变量,不需要重启吧.......通过 //根目录下(已经知道在哪了),可以查看是否配置成功 java -version 注:java -version时出错: The program 'java' can be found in the following packages:* default-jre* gcj-4.8-jre-headless* openjdk-7-jre-headless* gcj-4.6-jre-headless* openjdk-6-jre-headlessTry: apt-get install <selected package> 意思是,系统可能自带有java,且现在还是使用默认自带的,未使用自行安装的jdk,所以需要更改默认的jdk才OK! sudo update-alternatives --install /usr/bin/java java /usr/javajdk/jdk1.6.0_30/bin/java 300 sudo update-alternatives --install /usr/bin/javac javac /usr/javajdk/jdk1.6.0_30/bin/javac 300 sudo update-alternatives --config java 三.安装Hadoop 1.先把Hadoop文件搞到usr/hadoop1.2.1file下,然后进入该文件并解压。 sudo tar -zxvf hadoop-1.2.1.tar.gz //hxsyl是此时登陆的用户 sudo chown -hR hxsyl /usr/hadoop1.2.1file 2.配置环境变量 直接洁的别人图,可以复制jdk的环境变量,然后结合这个图,修改配置下就ok。 3.设置安全外壳协议 推荐安装OpenSSH,Hadoop需要通过SSH来启动Slave列表中各台主机的守护进程,因此SSH是必需安装的。虽然我们现在搭建的是一个伪分布式的平台,但是Hadoop没有区分开集群式和伪分布式,对于伪分布式,Hadoop会采用与集群相同的处理方式,即按次序启动文件conf/slaves中记载的主机进程,只不过在伪分布式中Salve为localhost而已,所以对于伪分布式,SSH是必须的。 //配置过程(首先确保连接上网络): //安装SSH,在命令行输入如下 sudo apt-get install openssh-server //配置可以免密码登陆本机 //在命令行输入(注意其中的ssh前面还有一个“.”不要遗漏) ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa (解释一下上面这条命令,ssh-keygen 代表生成密钥;-t 表示指定生成的密钥类型;dsa 是dsa密钥认证的意思;-P 用于提供密语(接着后面是两个单引号,不要打错);-f 表示指定生成密钥文件) 这条命令完成后,会在当前文件夹下面的.ssh文件夹下创建id_dsa和id_dsa.pub两个文件,这是SSH的一对私钥和公钥,把id_dsa.pub(公钥)追加到授权的key中去,输入如下命令: cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 说明:一般来说,安装SSH时会自动在当前用户下创建.ssh这个隐藏文件夹,一般不会直接看到,除非安装好了以后,在命令行使用命令ls才会看到。 输入ssh localhost,显示登陆成功信息。 四.配置hadoop伪分布式 1.现在进入到安装Hadoop的文件夹,找到里面的conf文件夹,点击进去;配置hadoop环境文件hadoop-env.sh;打开文件,找到某行有”# export JAVA_HOME = ...” 字样的地方,去掉“#”,然后在等号后面填写你自己的JDK路径。 2.配置Hadoop的核心文件core-site.xml,打开文件,会发现标签<configuration></configuration>中是空的,在空的地方添加如下配置 <property> <name>fs.default.name</name> <value>hdfs://localhost:9000</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/hxsyl/tmp</value> </property> 注意:在最后一个value值中,上面是hxsyl,是因为那是我的用户名,所以你需要将那个修改为你自己的用户名。 3.配置Hadoop中MapReduce的配置文件mapred-site.xml,打开文件,会发现标签<configuration></configuration>中是空的,在空的地方添加如下配置 <property> <name>mapred.job.tracker</name> <value>localhost:9001</value> </property> 4.配置Hadoop中hdfs-site.xml的配置文件,同样的在标签<configuration></configuration>中加入一下代码 <property> <name>dfs.name.dir</name> <value>/usr/hadoop1.2.1file/hadoop-1.2.1/datalog1,/usr/local/hadoop/hadoop-1.2.1/datalog2</value> </property> <property> <name>dfs.data.dir</name> <value>/usr/hadoop1.2.1file/hadoop-1.2.1/data1,/usr/local/hadoop/hadoop-1.2.1/data2</value> </property> <property> <name>dfs.replication</name> <value>2</value> </property> 注意:若是直接打开修改后无法保存,那么就 sudo gedit ................... 五.格式化HDFS并启动Hadoop 1.首次运行hadoop必须进行格式化Hadoop文件系统,以后运行即可跳过。打开命令行,进入安装了Hadoop的文件路径下,然后在命令行输入 bin/hadoop namenode -format //格式化文件系统,然后启动Hadoop,在命令行里面输入 bin/start-all.sh 2.验证是否正常启动,在命令行里面输入jps,然后回车。 jps(Java Virtual Machine Process Status Tool)是JDK 1.5提供的一个显示当前所有java进程pid的命令,简单实用,非常适合在linux/unix平台上简单察看当前java进程的一些简单情况。 关闭hadoop bin/stop-all.sh 3.运行自带WordCount在上一篇博文中有详细说明。 参考文献:http://www.cnblogs.com/yangxiao99/p/4574889.html

优秀的个人博客,低调大师

python 动态迁移solr数据

上项目的时候,遇见一次需求,需要把在线的 其中一个 collection 里面的数据迁移到另外一个collection下,于是就百度了看到好多文章,其中大部分都是使用导入的方法,没有找到在线数据的迁移方法。于是写了python脚本,分享出来。 思路: collection数据量比较大,所以一次性操作所有数据太大,于是分段执行操作。 先分段 按1000条数据量进行查询,处理成json数据 把处理后的json数据 发送到目的collection上即可 实现:一、使用http的接口先进行查询 使用如下格式查询:其中:collection_name 是你查询的collection的名称rows 是需要查询多少行,这里设置为1000start 从多少行开始进行查询,待会儿脚本里面就是控制这个参数进行循环查询http://host:port/solr/collection_name/select?q=*:*&rows=1000&start=0 查询处理后会得到如下图片里面的数据格式,其中在response里面,有两个键值数据是我们需要的,一个是numFound(总的数据条数),docs(所有json数据都在这里面) 在docs里面,每条数据都带有version 键值,这个需要给去掉 二、使用http的接口提交数据wt:使用json格式提交http://host:port/solr/collection_name/update?wt=json header 需设置为 {"Content-Type": "application/json"} 提交参数:solr在做索引的时候,如果文档已经存在,就替换。(这里的参数也可以直接加到url里面){"overwrite":"true","commit":"true"} data_dict 就是我们处理后的 docs数据提交数据:data={"add":{ "doc":data_dict}} 三、实现的脚本如下: #coding=utf-8 import requests as r import json import threading import time #发送数据到目的url des_url,data_dict 参数为去掉version键值后的一条字典数据 def send_data(des_url,data_dict): data={"add":{ "doc":data_dict}} headers = {"Content-Type": "application/json"} params = {"boost":1.0,"overwrite":"true","&commitWithin":1000,"commit":"true"} url = "%s/update?wt=json"%(des_url) re = r.post(url,json = data,params=params,headers=headers) if re.status_code != 200: print("导入出错",data) #获取数据,调用send_data 发送数据到目的url def get_data(des_url,src_url): #定义起始行 start = 0 #先获取到总的数据条数 se_data=r.get("%s/select?q=*:*&rows=0&start=%s"%(src_url,start)).text se_dict = json.loads(se_data) numFound = int(se_dict["response"]["numFound"]) #while循环,1000条数据为一个循环 while start < numFound: #定义存放多线程的列表 th_li = [] #获取1000条数据 se_data=r.get("%s/select?q=*:*&rows=1000&start=%s"%(src_url,start)).text #把获取的数据转换成字典 se_dict = json.loads(se_data) #获取数据里的docs数据 s_data = (se_dict["response"]["docs"]) #循环得到的数据,删除 version键值,并使用多线程调用send_data 方法发送数据 for i in s_data: del i["_version_"] th = threading.Thread(target=send_data,args=(des_url,i)) th_li.append(th) for t in th_li: t.start() t.join() start += 1000 print(start) if __name__ == "__main__": #源数据,查询数据的collection地址 src_url = "http://ip:port/solr/src_connection" #导入数据导目的collection 的地址 des_url = "http://ip:port/solr/des_connection" start_time = time.time() get_data(des_url,src_url) end_time = time.time() print("耗时:",end_time-start_time,"秒") 备注:一、如果你的collection 不在同一个网络,不能实现在线传输,可以先把for循环 删除了version键值的数据,写入一个文件中,然后copy到目的网络的服务器上,循环读取文件进行上传,如下写入文件(这个就根据各位大佬的喜好来写了),但读取后,需要把每一条数据都转换成字典进行上传:file = open("solr.json","a+")for i in s_data:del i["version"]file.write(str(i)+"\n")file.close() 二、清除数据可使用一下方法,自测比较方便的一种在你要清除collection里面 选择 documents document type 选择xml 将一下内容复制到如图位置,最后点击submit document 按钮即可#控制web界面删除数据<delete><query>:</query></delete><commit/>
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册