首页 文章 精选 留言 我的

精选列表

搜索[python],共10000篇文章
优秀的个人博客,低调大师

更好的编写Python代码的方式

检查Tuple里的每个元素 假设有一个Tuple,里面包含了几个元素: p = (170, 0.1, 0.6) if p[1] >= 0.5: print u'好深的' if p[2] >= 0.5: print u'好亮啊' 这段代码本身没有任何问题,但是写的时候需要记住Tuple里每个元素都是什么,才能打印出对的描述。为了让代码更容易看懂: from collections import namedtuple Color = namedtuple('Color', ['hue', 'saturation', 'luminosity']) p = Color(170, 0.1, 0.6) if p['saturation'] >= 0.5: print u'好深的' if p['luminosity'] >= 0.5: print u'好亮啊' 计算列表里的重复元素 假设有一个叫做颜色的列表, 需要计算出这个列表里每个颜色的名字被重复了几次 colors = ['red', 'green', 'red', 'blue', 'green', 'red'] d = {} 一般书写方式: for color in colors: if color not in d: d[color] = 0 d[color] += 1 稍好一点的写法: for color in colors: d[color] = d.get(color, 0) + 1 最好的写法: from collections import defaultdict d = defaultdict(int) for color in colors: d[color] += 1 将一个字典里的内容归类 有一个列表,需要将列表中的内容根据长度归类 names = ['raymond', 'rachel', 'matthew', 'roger', 'bettry', 'melissa', 'judith', 'charlie'] 一般写法: d = {} for name in names: key = len(name) if key not in d: d[key] = [] d[key].append(name) 稍好一点的写法: for name in names: key = len(name) d.setdefault(key, []).append(name) 最好的写法: d = defaultdict(list) for name in names: key = len(name) d[key].append(name) 使用Keyword Argument tw('@obama', False, 20, True) 如果不看ts函数的内容的话,是无法理解这个函数是干什么用的,如果改写成这样呢: twitter_search('@obama', retweets=False, numtweets=20, popular=True) 同时更新多个变量 编程的时候经常会碰到这种情况,需要用一个临时的变量来存住一个数值,然后过一会再把这个数值取出来 t = y y = x + y x = t 最好的写法: x, y = y, x+y 所有等号右侧的数值都是旧的数值。这个写法的好处是不需要像原来那样担心每一行顺序的问题。 对序列起始位置做改动 当改动序列第一位的元素时,经常会引起程序速度变慢 names = ['raymond', 'rachel', 'matthew', 'roger', 'bettry', 'melissa', 'judith', 'charlie'] #以下任意操作都会很慢 del names[0] names.pop(0) names.insert(0, 'mark') 最好的方式: from collections import deque #将names变为可以在左右两端添加或删减的数据类型 names = deque(['raymond', 'rachel', 'matthew', 'roger', 'bettry', 'melissa', 'judith', 'charlie']) 引自:https://www.youtube.com/watch?v=OSGv2VnC0gohttps://www.youtube.com/watch?v=wf-BqAjZb8M

优秀的个人博客,低调大师

蛇皮的Python面试题目

1.小易有一些彩色的砖块。每种颜色由一个大写字母表示。各个颜色砖块看起来都完全一样。现在有一个给定的字符串s,s中每个字符代表小易的某个砖块的颜色。小易想把他所有的砖块排成一行。如果最多存在一对不同颜色的相邻砖块,那么这行砖块就很漂亮的。请你帮助小易计算有多少种方式将他所有砖块排成漂亮的一行。(如果两种方式所对应的砖块颜色序列是相同的,那么认为这两种方式是一样的。) 例如: s = “ABAB”,那么小易有六种排列的结果: “AABB”,”ABAB”,”ABBA”,”BAAB”,”BABA”,”BBAA” 其中只有”AABB”和”BBAA”满足最多只有一对不同颜色的相邻砖块。 . 输入描述: 1.输入包括一个字符串s,字符串s的长度length(1 ≤ length ≤ 50),s中的每一个字符都为一个大写字母(A到Z)。 输出描述: 2.输出一个整数,表示小易可以有多少种方式。 输入例子:ABAB 输出例子:2 代码: a = raw_input("") new = [] for i in range(len(a)): new.append(a[i]) f len(set(new)) == 2: #set(new) 返回有序不重复 eg:输入ABAB 那么set(new) = ['A','B'] print 2 elif len(set(new)) == 1:#当输入的字符串是 一个 字符时 那么就只有一种方法了 print 1 else: print 0 #当有ABC三种颜色的地板时 那么 无论如何都超过 相邻的不同颜色对数 超过 1 因此排序方式为0 print '这怎一个狗字了的,蛇皮,皮这一下网易你就很快乐吗?'

优秀的个人博客,低调大师

初学Python——字符串相关操作

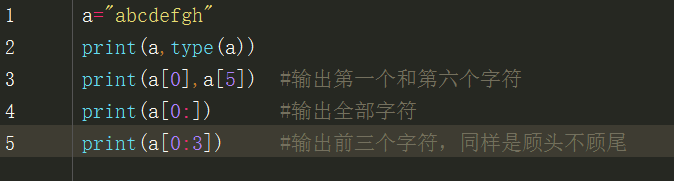
Pyhton中字符串的格式化输出在前面已经总结了,接下来介绍一些常用的字符串操作 先定义一个字符变量,以下的操作都以此为例: name=" my name is china " #(首尾有空格) 1.首字母大写(整个字符串的首字母) print(name.capitalize()) 运行结果:my name is china并没有变化!是因为第一个字符是空格!如果把第一个空格去掉,结果为:My name is china 2.将所有字母变大写或变小写 print(name.lower()) #把所有字母变成小写 print(name.upper()) #把所有字母变成大写 输出结果分别为: my name is chinaMY NAME IS CHINA 3.首字母大写(每个单词) print(name.title()) 输出结果为:My Name Is China 4.大小写互换 print(name.swapcase()) 输出结果为:MY NAME IS CHINA此方法是:大写变小写,小写变大写 5.统计相同字符的数目 print(name.count("i")) #统计字符串中字符i的个数 6.Center()方法 print(name.center(50,"-")) 运行结果: ---------------- my name is china ---------------- 一共50个字符,字符串以外用指定的“-”来填充,并将字符串变量内容居中 7.判断字符串是否以这个字符结尾 print(name.endswith("ng")) #判断字符串是否以“ng”结尾 运行结果为:False 8.在字符串中寻找某个子字符串的位置 例如:寻找字符串中“name”的位置 print(name.find("name")) 输出结果为4,即“name”首字母的地址“n”的地址 9.去掉字符串两端的空格 有时候为了避免不必要的麻烦,会将用户输入的字符串去掉两端的空格 print(name.strip()) 10.去掉字符串左边或右边的空格 print(name.lstrip()) #去掉左边的空格 print(name.rstrip()) #去掉右边的空格 11.字符串的加密 p=str.maketrans("abcedfghij","9876543210") #编写密码规则 print(name.translate(p)) #按照上述密码转换规则将明文翻译成密文 先上运行结果: my n9m6 1s 721n9 看懂了吗?就是用“9”来替代“a”,“8”来替代“b”,“7”来替代“c”,……,依次类推 12.将字符串中特定字符替换 将字符串中某些旧字符替换成新字符,并返回新的字符串 print(name.replace("m","M",2)) 将字符串中前2个“m”替换成“M” 结果为:My naMe is china 第一个值是被替换字符,第二个值是替换字符,第三个值是被替换的个数(可以省略) 13.字符串切片(截取) 不光列表,字符串也可以切片,而且和列表的操作一样 新定义一个字符串 运行结果: 14.获取字符串的长度 len(a) 获取的是字符串的长度(字符数、字节数)。此方法不是字符串的专属,列表、字典等其他数据类型都可以用。列表获取的是元素的个数,字典获取的是key的数量。 15.split()分割函数 split()通过指定分隔符对字符串进行分割,并返回分割后的字符串列表。如果参数 num 有指定值,则仅分隔 num 个子字符串 split(str,num) 参数: str:分隔符,默认为所有的空字符,包括空格、换行(\n)、制表符(\t)等。 num:分割次数(可以省略) str = "Line1-abcdef \nLine2-abc \nLine4-abcd" print str.split( ) print str.split(' ', 1 ) #运行结果: ['Line1-abcdef', 'Line2-abc', 'Line4-abcd'] ['Line1-abcdef', '\nLine2-abc \nLine4-abcd'] 16.index() print(str.index("L")),输出第一个L的下标

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册