首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

初学Python——字符串相关操作

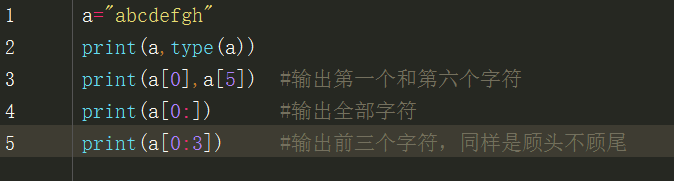
Pyhton中字符串的格式化输出在前面已经总结了,接下来介绍一些常用的字符串操作 先定义一个字符变量,以下的操作都以此为例: name=" my name is china " #(首尾有空格) 1.首字母大写(整个字符串的首字母) print(name.capitalize()) 运行结果:my name is china并没有变化!是因为第一个字符是空格!如果把第一个空格去掉,结果为:My name is china 2.将所有字母变大写或变小写 print(name.lower()) #把所有字母变成小写 print(name.upper()) #把所有字母变成大写 输出结果分别为: my name is chinaMY NAME IS CHINA 3.首字母大写(每个单词) print(name.title()) 输出结果为:My Name Is China 4.大小写互换 print(name.swapcase()) 输出结果为:MY NAME IS CHINA此方法是:大写变小写,小写变大写 5.统计相同字符的数目 print(name.count("i")) #统计字符串中字符i的个数 6.Center()方法 print(name.center(50,"-")) 运行结果: ---------------- my name is china ---------------- 一共50个字符,字符串以外用指定的“-”来填充,并将字符串变量内容居中 7.判断字符串是否以这个字符结尾 print(name.endswith("ng")) #判断字符串是否以“ng”结尾 运行结果为:False 8.在字符串中寻找某个子字符串的位置 例如:寻找字符串中“name”的位置 print(name.find("name")) 输出结果为4,即“name”首字母的地址“n”的地址 9.去掉字符串两端的空格 有时候为了避免不必要的麻烦,会将用户输入的字符串去掉两端的空格 print(name.strip()) 10.去掉字符串左边或右边的空格 print(name.lstrip()) #去掉左边的空格 print(name.rstrip()) #去掉右边的空格 11.字符串的加密 p=str.maketrans("abcedfghij","9876543210") #编写密码规则 print(name.translate(p)) #按照上述密码转换规则将明文翻译成密文 先上运行结果: my n9m6 1s 721n9 看懂了吗?就是用“9”来替代“a”,“8”来替代“b”,“7”来替代“c”,……,依次类推 12.将字符串中特定字符替换 将字符串中某些旧字符替换成新字符,并返回新的字符串 print(name.replace("m","M",2)) 将字符串中前2个“m”替换成“M” 结果为:My naMe is china 第一个值是被替换字符,第二个值是替换字符,第三个值是被替换的个数(可以省略) 13.字符串切片(截取) 不光列表,字符串也可以切片,而且和列表的操作一样 新定义一个字符串 运行结果: 14.获取字符串的长度 len(a) 获取的是字符串的长度(字符数、字节数)。此方法不是字符串的专属,列表、字典等其他数据类型都可以用。列表获取的是元素的个数,字典获取的是key的数量。 15.split()分割函数 split()通过指定分隔符对字符串进行分割,并返回分割后的字符串列表。如果参数 num 有指定值,则仅分隔 num 个子字符串 split(str,num) 参数: str:分隔符,默认为所有的空字符,包括空格、换行(\n)、制表符(\t)等。 num:分割次数(可以省略) str = "Line1-abcdef \nLine2-abc \nLine4-abcd" print str.split( ) print str.split(' ', 1 ) #运行结果: ['Line1-abcdef', 'Line2-abc', 'Line4-abcd'] ['Line1-abcdef', '\nLine2-abc \nLine4-abcd'] 16.index() print(str.index("L")),输出第一个L的下标


优秀的个人博客,低调大师

优雅的在终端中编写Python

前言 最早我也只是在服务器上编辑文件的时候用用vim来改改程序,并没有把vim当做自己的主力编辑器。但是偶然的一次机会需要改一个奇葩的输入文件的格式,用了下Vim的宏录制,尝到了甜头,于是后面就开始用Vim来写程序了,虽然使用初期有些阻力,但时间久了就会发现,双手再也不用离开键盘,即使使用sublime这样的编辑器我也要改成使用Vim模式,Vim真的能让自己一思维的速度编辑文本(对我来说就是写程序了)。 正好最近换了新的电脑,需要在新电脑上配置一下,就干脆把一些配置相关的东东记录下来吧,相关的配置文件我都放在了github(PytLab/dotfiles) 上并写了相应的安装和卸载脚本,给有需要的同学做个参考吧。 本文是有关配置的文章,并不对Vim的核心技巧进行说明,有需要的童鞋可以参考文档和相关书籍。这里主要配合tmux和vim可以更

优秀的个人博客,低调大师

用 Python 分析《红楼梦》(1)

1 前言 两个月以来,我通过互联网自学了一些文本处理的知识,用自然语言处理和机器学习算法对《红楼梦》进行了一些分析。这个过程中我找到了一些有趣的发现,所以我想写一篇文章,既㲌与大家分享和讨论实验结果,也顺便做一个整理和总结。(其实虽说是两个月,但是中间停顿了一段时间,真正在做的时间大概是两周左右) 我开始做这件事情是因为之前看到了一篇挺好玩的文章,大概内容是,作者用“结巴分词”这个开源软件统计了红楼梦中各词汇的出现次数(也就是词频),然后用词频作为每个章回的特征,最终用“主成份分析”算法把每个章回映射到三维空间中,从而比较各个章回的用词有多么相似。(文章:用机器学习判定红楼梦后40回是否曹雪芹所写)作者的结论是后四十回的用词和前八十回有明显的差距。 看完文章之后,我觉得有两个小问题:首先,作者用的结巴分词里的词典是根据现代文的语料获得的

优秀的个人博客,低调大师

用 Python 分析《红楼梦》(2)

6 词频统计 完成分词以后,词频统计就非常简单了。我们只需要根据分词结果把片段切分开,去掉长度为一的片段(也就是单字),然后数一下每一种片段的个数就可以了。 这是出现次数排名前 20 的单词: (括号内为频数) 可以跟之前只统计出现次数,不考虑切分问题的排名做个对比: (括号内为频数) 通过分词后的词频,我们发现《红楼梦》中的人物戏份由多到少依次是宝玉、凤姐、贾母、袭人、黛玉、王夫人和宝钗。然而,这个排名是有问题的,因为”林黛玉”这个词的出现次数还有 267 次,需要加到黛玉的戏份里,所以其实黛玉的戏份比袭人多。同理,“老太太”一般是指贾母,所以贾母的戏份加起来应该比凤姐多。正确的排名应该是宝玉、贾母、凤姐、黛玉、袭人、王夫人和宝钗。 此外,我们还发现《红楼梦》中的人物很爱笑,因为除了人名以外出现次数最多的单词就是“笑道” : ) 我把完整的词频

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册