首页 文章 精选 留言 我的

精选列表

搜索[玩转 Agent Bucket],共10001篇文章
优秀的个人博客,低调大师

每日一博 | 玩转 Go 链路追踪

前言 链路追踪是每个微服务架构下必备的利器,go-zero 当然早已经为我们考虑好了,只需要在配置中添加配置即可使用。 关于 go-zero 如何追踪的原理追溯,之前已经有同学分享,这里我就不再多说,如果有想了解的同学去 https://mp.weixin.qq.com/s/hJEWcWc3PnGfWfbPCHfM9g 这个链接看就好了。默认会在 api 的中间件与 rpc 的 interceptor 添加追踪,如果有不了解 go-zero 默认如何使用默认的链路追踪的,请移步我的开源项目 go-zero-looklook 文档 https://github.com/Mikaelemmmm/go-zero-looklook/blob/main/doc/chinese/12-%E9%93%BE%E8%B7%AF%E8%BF%BD%E8%B8%AA.md。 今天我想讲的是,除了 go-zero 默认在 api 的 middleware 与 rpc 的 interceptor 中帮我们集成好的链路追踪,我们想自己在某些本地方法添加链路追踪代码或者我们想在 api 发送一个消息给 mq 服务时候想把整个链路包含 mq 的 producer、consumer 穿起来,在 go-zero 中该如何做。 场景 我们先简单讲一下我们的小 demo 的场景,一个请求进来调用 api 的 Login 方法,在 Login 方法中先调用 rpc 的 GetUserByMobile 方法,之后在调用 api 本地的 local 方法,紧接着调用 rabbitmq 传递消息到 mq 服务。 go-zero 默认集成了 jaeger、zinpink,这里我们就以 jaeger 为例 我们希望看到的链路是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 也就是 api 衍生出来三条子链路,api.producerMq 有一条调用 mq.Consumer 的子链路。 我们想要将一个方法添加到链路中需要两个因素,一个 traceId,一个span,当我们在同一个 traceId 下开启 span 把相关的 span 都串联起来,如果想形成父子关系,就要把 span 之间相互串联起来,因为「微服务实践」公众号中讲解原理太多,我这里就简单提一下不涉及过多,如果不是特别熟悉原理可以看文章开头推荐的文章,这里我们只需要知道 traceId 与 spanId 关系就好。 核心业务代码 1、首先 API 中 LoginLogic 代码 type LoginLogic struct { logx.Logger ctx context.Context svcCtx *svc.ServiceContext } func NewLoginLogic(ctx context.Context, svcCtx *svc.ServiceContext) *LoginLogic { return &LoginLogic{ Logger: logx.WithContext(ctx), ctx: ctx, svcCtx: svcCtx, } } type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (l *LoginLogic) Login(req *types.RegisterReq) (*types.AccessTokenResp, error) { resp, err := l.svcCtx.UserRpc.GetUserByMobile(l.ctx, &usercenter.GetUserByMobileReq{ Mobile: req.Mobile, }) if err != nil { return &types.AccessTokenResp{}, nil } l.local() tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx, span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx, carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &MsgBody{ Carrier: carrier, Msg: req.Mobile, } b, err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail , msg :%s , err:%v", msg, err) } span.End() return &types.AccessTokenResp{ AccessExpire: resp.User.Id, }, err } func (l *LoginLogic) local() { tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... } 2、rpc 中 GetUserByMobile 的代码 func (s *Logic) GetUserByMobile(context.Context, *usercenterPb.GetUserByMobileReq) (*usercenterPb.GetUserByMobileResp, error) { vo := &usercenterPb.UserVo{ Id: 1, } return &usercenterPb.GetUserByMobileResp{ User: vo, }, nil } 3、mq 中 Consumer 的代码 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } 代码详解 1、go-zero 默认集成 当一个请求进入 api 后,我们可以在 go-zero 源码中查看到 https://github.com/zeromicro/go-zero/blob/master/rest/engine.go#L92。go-zero 已经在 api 的 middleware 中帮我们添加了第一层 trace,当进入 Login 方法内,我们调用了 rpc 的 GetUserByMobile 方法,通过 go-zero 的源码 https://github.com/zeromicro/go-zero/blob/master/zrpc/internal/rpcserver.go#L55 可以看到在 rpc 的 interceptor 也默认帮我们添加好了,这两层都是 go-zero 默认帮我们做好的。 2、本地方法 当调用完 rpc 的 GetUserByMobile 之后,api 调用了本地的 local,如果我们想在整个链路上体现出来调用了本地 local 方法,那默认的 go-zero 是没有帮我们做的,需要我们手动来添加。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... 我们通过上面代码拿到 tracer,ctx 之后开启一个 local 的 span,因为 start 时候会从 ctx 获取父 span 所以会将 local 方法与 Login 串联起父子调用关系,这样就将本次操作加入了这个链路 3、mq 的 producer 到 mq 的 consumer 我们在mq传递中如何串联起来这个链路呢?也就是形成 api.Login->api.producer->mq.Consumer。 想一下原理,虽然跨越了网络,api 可以通过 header 传递,rpc 可以通过 metadata 传递,那么 mq 是不是也可以通过 header、body 传递就可以了,按照这个想法来看下我门的代码。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx , span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx,carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &MsgBody{ Carrier: carrier, Msg: req.Mobile, } b , err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail, msg :%s, err:%v", msg, err) } span.End() 首先获取到了这个全局的 tracer,然后开启一个 producer 的 span,跟 local 方法一样,我们开启 producer 的 span 时候也是通过 ctx 获取到上一级父级 span,这样就可以将 producer 的 span 与 Login 形成父子 span 调用关系,那我们想将 producer 的 span 与 mq 的 consumer 中的 span 形成调用父子关系怎么做?我们将 api.producer 的 spanCtx 注入到 carrier 中,这里我们通过 mq 的 body 将 carrier 发送给 consumer,发送完成我们 stop 我们的 producer,那么 producer 的这层链路完成了。 随后我们来看 mq-consumer 在接收到 body 消息之后怎么做的。 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } consumer 接收到消息后反序列化出来 Carrier *propagation.HeaderCarrier,然后通过 otel.GetTextMapPropagator().Extract 取出来 api.producer 注入的 wireContext,在通过 tracer.Start、wireContext 创建 consumer 的 span,这样 consumer 就是 api.producer 的子 span,就形成了调用链路关系,最终我们得到的关系就是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 让我们来调用一下 Logic 方法,看下 jaeger 中的链路如果与我们预想的链路一致,so happy~ 项目地址 go-zero 微服务框架:https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero go-zero 微服务最佳实践项目:https://github.com/Mikaelemmmm/go-zero-looklook 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

手把手带你玩转 openEuler | 初识 openEuler

为了让更多人更深入认识 openEuler 并积极参与进来,社区将出一些列课程和大家近距离接触,邀请 openEuler 开源的重要参与者、SIG 组 maintainer 等资深专家来进行持续分享。本课程分为三部分,主要是让大家了解 openEuler 是什么、怎么玩、如何参与。 第 1 部分:认识 openEuler。了解 openEuler 是一个怎样的平台,包含哪些内容。 第 2 部分:openEuler 社区运作。通过本讲您可以了解到 openEuler 社区的治理及运作方式。 第 3 部分:openEuler 版本介绍。通过该部分您可以了解到 openEuler 的软件构建和未来的一些规划。 1. 认识 openEuler 1.1 社区网站:openEuler.org[1] 通过社区网站大家可以了解到更多关于 openEuler 的相关内容,并通过文档查看 openEuler 的使用方法。 openEuler 是一个开源、免费的 Linux 发行版平台,通过开放的社区形式与全球的开发者共同构建一个开放、多元和架构包容的软件生态体系。同时,openEuler 也是一个创新的平台,鼓励任何人在该平台上提出新想法、开拓新思路、实践新方案。 1.2 下载体验 openEuler 上面了解了 openEuler 是一个开源免费的平台,对于工程师来说,下载使用才是第一步,那么我们怎么去下载 openEuler 呢? openEuler 社区提供了openEuler 下载地址[2]。 可以通过 openEuler 社区导航上的【下载】按钮,下载openEuler 20.03 LTS的 ISO 安装包。openEuler 20.03 LTS 版本是面向开放场景的标准发行版,生命周期四年。 在 openEuler 使用过程中遇到问题或想提出意见,在社区导航下的【下载】里和文档里可以提出意见反馈,供相关技术人员及时解决问题。 1.3 参与 openEuler 社区 可以通过 openEuler 导航下的【社区】来参与 openEuler 社区,里面有很多社区相关的子菜单大家可以在官方社区里进行深入的了解。【社区】里的【贡献攻略】可以指导开发者一步一步参于 openEuler 社区、【SIG(项目组)】可以找到自己感兴趣的项目组、【邮件列表】可以收听参与相关的一些讨论。 开发者:参与社区贡献需要签署”贡献者许可协议(CLA)“,要了解社区行为守则。 SIG(项目组):SIGs 是社区根据领域划分的各个领域的兴趣小组,每一个小组会根据情况维护社区一个或者多个项目。访问此处[3]了解如何申请一个新 SIG。 邮件列表:邮件列表是社区交流的很重要的一种方式。 你可以订阅邮件列表:建议您在订阅前把邮箱的‘答复邮件上的邮件头使用英语’的相关设置打开:1)打开邮箱的选项界面。2)点击【高级】——并找到【国际选项】——勾选‘答复或转发邮件上的邮件头和转发通知使用英语’。 发送邮件到邮件列表:要将邮件发送到指定的邮件列表,请向上表中列出的邮件地址发送您的电子邮件。这样所有在这个邮件列表中的社区成员都能收到您的电子邮件。 查看以前的邮件列表:要查看邮件列表中以前发布的电子邮件,请访问以下存档地址(Community[4]、Dev[5]、Announce[6]、Council[7]、Infra[8]、Marketing[9]、User-committee[10]、Build-team[11]、TC[12]、Kernel[13]、A-Tune[14]、iSulad[15]、QA[16]、Sig-ai-bigdata[17]、Crystal-ci[18]、Virt[19]) 通过社区我们可以做些什么: 在我们要做一些事情之前,先说一下 openEuler 本身是在什么地方的?openEuler 本身是放在 gitee.com 上的,并且是开源的,如果大家想要加入使用 openEuler 需要有一个 gitee 账号。 下面就是我们要在社区里做些事情了。 1)提需求/bug:在使用/开发过程中遇到的一些问题,发现哪些地方使用不方便,大家都可以可以通过 issue 或者邮件列别提出问题。 最简单基本的参与社区的方式:当然是先点一点社区里的内容了,看看有哪些需要优化改进的地方,提出一些有价值有意义的建议。这也是最简单的方式了。 在社区中提交问题都是通过 issue 机制来进行的,在提交问题的过程中需要提交人指定提交的对象是谁,也就是你要提交问题给谁。 让我们看下 issue 的界面长什么样子? 举个栗子:如果你想提交一个社区治理的一个问题,那么你可以在 Community 代码仓库的 issue 中提交问题 方框里的 issue 就是我们用来提交 bug/问题的入口,进入到 issue 里我们可以点击【新建 Issue】,进去之后就可以提交 issue 了。 当然你可以设置提交的 issue 是什么级别的。 我们在提交问题时怎么来接行 issue 的划分呢? 总的来说分为以下几类: 在社区中使用基础设施的过程中,感觉不爽,比如页面布局不够霸气,文字太小等等,可以提交问题到https://gitee.com/openeuler/infrastructure[20] 如果遇到社区治理方面的问题,比如委员选举机制等问题可以提交到https://gitee.com/openeuler/community[21] 具体的软件问题,提交到https://gitee.com/openeuler/kernel[22] 其他问题,也就是你知道该提交什么地方的问题,可以提交到https://gitee.com/openeuler/community-issue[23] 如果你想要更详细的了解 issue 提交的流程,下面的链接可以帮助到你:https://gitee.com/openeuler/community/blob/master/zh/contributors/issue-submit.md[24] 2)修 bug 解决问题:这个就需要高层次的社区人员,以一个开发者的身份参与到社区中,在社区里可以自己主动认定一些 bug,来解决相关的问题。 在社区里,通常我们希望提出问题并同时解决问题,如果有一个问题,当然最好的情况是同时提供问题解决的 patch 补丁。我们以社区的轻量化容器引擎 iSulad 为例,https://gitee.com/openeuler/iSulad[25],假定我们需要为 iSulad 提交一个 patch 补丁,基本流程如下: 第一步:首先要先建立一个自己的分支 分支是通过 Fork 创建的,如果大家不了解 Fork,还是先去学习以下 git 吧,对于开发者来说,git 的开发模式是最常用的,也是最基本的,使用 git 是必须的。 第二步:修改代码并生成 Pull Request 点击 fork 完毕后,目录已经从 openEuler 切换成了自己的账户了,你自己的分支就创建好了。接下来就可以在自己的分支上进行代码的修改了。 修改完代码后,点击 Pull Request,就会生成一个 patch 提交代码到原始社区里了,到这里就完成了 patch 的提交了,接下来的时间就是等待 maintainer 审核你的代码了。 3)贡献软件包:可以在 openEuler 代码仓库中的 openeuler 或者 src-openeuler 贡献自己的软件包,当然里面有很多软件包供开发者使用。这样日积月累,openEuler 就能够提供更多更丰富的软件包功能,越多人参与进来,openEuler 就能够成为万能的软件生态系统。 4)开发新软件:大家根据自己爱好和想法,可以开发一些新的软件,贡献到 openeler 下面,经过一定时间的孵化可以进驻到 src-openeuler 里,供大家使用。 有两种方式可以将自己的作品发布到 openEuler 社区: 在其他社区开发,集成到 openEuler 中:假如我们常使用的 github、gitlab、gitee,在上面有一些我们的项目,我们可以通过将软件放到 src-openEuler 的 repo 仓就可以了。这样就可以把我们在其他管理平台里的软件集成到 openEuler 里。 在 openEuler 社区中开发,在 openEuler 中集成:我们可以直接在 openEuler 的代码仓库https://gitee.com/openeuler中创建项目,相当于将代码托管到openEuler社区。就像社区里的iSula和A-Tune就是这样的模式。 1.4 《社区参与之旅》 如果大家想更加详细的了解社区,可以通过两篇比较好的博客去进一步了解。可以介绍如何参与社区的博客地址如下:我的社区参与之旅[26]openEuler 社区参与之旅[27] 1.5 openEuler 代码仓库 openEuler 的愿景是:通过社区合作,打造创新平台,构建支持多处理器架构、统一和开放的操作系统 openEuler,推动软硬件生态繁荣发展。 openEuler 代码是放在 gitee 上的,大家可以尽情的去下载使用。 openEuler 主要包括两个代码仓库: src-openEuler 软件包仓库地址:https://gitee.com/src-openeuler[28] src-openEuler 主要用于存放制作发布件所需的软件包。为 openEuler 的 release 发行版提供生成 rpm 包等构建信息等的地方。 openEuler 代码仓库地址:https://gitee.com/openeuler[29] openEuler 主要用于存放源码类项目。openeuler 这个仓是存储所有“原生态”的软件,也就是为原创性的软件提供一个展示的舞台,或者是一个孵化器平台。 2. openEuler 社区运作 2.1 社区治理:开放、透明 openEuler 社区码云地址:https://gitee.com/openeuler/community[30] 代码仓 Community 保存了关于 openEuler 社区的所有信息,包括社区治理、社区活动、开发者贡献指南、沟通交流指南等内容。这里包括:openEuler 社区介绍、社区治理组织架构、社区活动、开发者贡献指南。 社区治理组织结构 我们主要介绍 秘书处、安全委员会、技术委员会、SIG。通过对各自的介绍,大家很明白的知道这些架构组织的作用了。 秘书处:负责社区的筹备、运营规划等支撑社区规范化运作成熟。 现阶段,openEuler 社区秘书处的主要职责如下: 制定社区运营规划 制定费用预算,请获得社区创始人批准 执行社区创始人筹备社区的工作 openEuler 社区其他未明确分配到责任人的工作 安全委员会:负责接收和响应 openEuler 安全问题报告、提供社区安全指导。 现阶段,openEuler 社区安全委员会的工作职责如下: 协助漏洞修复:确保及时修复已知漏洞。通过为软件包 Maintainer 们提供补丁帮助,帮助用户系统在成为攻击受害者之前进行漏洞修复,包括提供相关漏洞检测和修复工具。 响应安全问题:响应上报的安全问题,跟踪安全问题的处理进展,并遵循安全问题披露策略对安全问题在社区内进行披露和公告。 安全编码规则:普及安全编码知识是安全团队的目标。安全团队会努力创建文档或开发工具来帮助开发团队避免软件开发过程中的常见陷阱。安全团队还会尝试回答在开发和使用过程中遇到的任何问题。 参与代码审核:安全团队希望能够通过代码审核帮助团队提前发现代码中的漏洞。 技术委员会:负责社区技术决策和技术资源的协调。 技术委员会的主要职责如下: 负责回答理事会提出的技术问题,支撑理事会对战略蓝图的技术发展方向做出判断; 以远程协作的方式运行,每半年召开一次面对面沟通的正式会议,正式会议间定期召开例行线上公开会议; 对社区技术路线、接口定义、架构设计、构建发布等进行指导,并逐步构建社区规则; 协调跨项目合作,对社区跨项目技术问题进行指导,并逐步构建社区规则; 制定、指导项目孵化、开发、退出流程,支撑社区技术生态健康发展; 制定、指导软件包接纳、退出 openEuler 的流程,支撑 openEuler 开源版本的可信和可靠; 接受用户委员会的反馈(需求和问题),牵引社区资源将其落地至项目; 建立社区认证标准和平台,为社区认证(OS 商业发行版认证、硬件兼容性认证等)提供技术支撑; SIG:社区兴趣小组,每个小组维护一个或多个项目(对应多个 gitee 仓) 2.2 参与社区治理和运作 在您遇到任何问题、想参与各委员会/各 SIG 的运作、找到感兴趣的 SIG 都可以通过一下方式进行了解和提问。 如果您对社区治理有任何问题或建议,可以发邮件到 maillist:community@openeuler.org 提 issue:https://gitee.com/openeuler/community 如果您想参与各委员会、各 SIG 的运作,可以通过邮件列表交流及获取信息邮件列表:https://openeuler.org/zh/community/mails.html SIGs:https://openeuler.org/zh/sig.html 如果您没找到感兴趣或者合适的 SIG,可以申请创建 1 个新 SIGhttps://gitee.com/openeuler/community/tree/master/zh/technical-committee/governance 如果您对社区版本发布有任何建议或者需求、想法,可以发邮件到 maillist:dev@openeuler.org 标题行首带上[release management] 提 issue:https://gitee.com/openeuler/release-management 3. openEuler 版本介绍 3.1 Linux Kernel 等上游社区 openEuler 跟其他大家比较熟悉的操作系统是一样的,主要是从上游社区来取相关的软件进行一些增强开发、集成和质量保障,然后构建出来的一个社区免费版本。基于上游社区开源软件构建的免费、开源的 Linux 社区发行版,与国内主流 OS 厂商共建共享,形成合力繁荣国内 Linux 操作系统生态 下图是 openEuler 与 Linux 发行版的对比,大家可以了解一下。 openEuler 与 SUSE、Debian、 RedHat 一样基于上游社区开源软件 构建 openEuler 社区发行 LTS 免费版本, 使能 OSV 发展商业发行版,如麒麟软件、普华、中科软、万里开源等 openEuler 当前基于内核 4.19 版本 3.2 openEuler 基于上游开源软件构建,回馈上游开源社区 openEuler 大部分软件来自于上游开源社区,基于上游开源社区我们也做了大量的贡献来回馈上游开源社区。(比如:在 Linux Kernel 社区里,华为的贡献排到了 Top5;在 GCC 社区里华为有 Maintainer 在社区里进行贡献,等等。)推送到上游社区比较困难的代码,经过 openEuler maintainer 的评审,如果确实有价值,也可以将代码先合入到openEuler社区里。但还是鼓励尽可能推送到上游社区,坚持upstream first的原则。 3.3 openEuler 版本路标规划 openEuler 社区版本命名,发布时间与生命周期管理[31] LTS 版本:2 年发布 1 个,维护 4 年,OSV 厂商可以基于 LTS 版本构建商用发行版;下一个 LTS 版本 22.03 创新版本:6 个月发布 1 个,维护 6 个月 社区版本按按照交付年份和月份进行版本号命名。例如,openEuler 20.09 于 2020 年 09 月发布 社区版本分为长期支持版本和创新版本。 长期支持版本:发布间隔周期定为 2 年,提供 4 年社区支持。社区首个 LTS 版本 openEuler 20.03 已于 20 年 3 月正式发布。 社区创新版本:LTS 版本之间每隔 6 个月 openEuler 会发布一个社区创新版本,提供 6 个月社区支持。 欢迎社区开发者和用户提出宝贵建议,以上规则将根据反馈意见以及社区实施情况不断完善。 3.4 openEuler 20.03LTS 版本基本信息 20.03LTS 版本基本信息表[32] LTS 版本架构环境支持 ARM 和 X86 版本。如果对 ARM 感兴趣的人员可以通过 openEuler 的【首页】—【鹏城实验室】可以去申请 ARM 的虚拟机资源进行体验。详细的版本信息可查看下表。 3.5 openEuler 软件全堆栈的技术优化,充分释放多样化计算平台算力 openEuler 关键特性文档说明[33] 多核调度技术:关键路径 Fs pagecache 免锁重构,极致发挥算力,Nginx HTTP 性能提升 15% 集成 KAE 插件:软硬协同,助力鲲鹏加速库实现 10%-100%性能提升 iSula 轻量级容器:具备轻、快、易、灵特点启动时间缩短 35%,内存资源消耗降低 68%,通过 Smart-loading 智能镜像下载技术,显著提升镜像下载速度 openEuler Community build of OpenJDK:通过 GC 优化,冗余 DMB 指令消除等技术提升性能 20% A-Tune 场景自优化:典型场景智能自优化,推理出业务特征,配置最佳的系统参数合,使业务处于最优运行状态,提升系统调优效率 30% 4. To Do More 通过社区合作,打造创新平台,构建支持多处理器架构、统一和开放的操作系统 openEuler,推动软硬件生态繁荣发展。后面会有更多有意义有挑战性的一些特性在后续的开发维护中会陆陆续续的发布出来,大家尽请关注。 社区地址:https://gitee.com/openeuler[34] 参考资料 [1]openEuler.org:https://openeuler.org/ [2]https://openeuler.org/zh/download.html:https://openeuler.org/zh/download.html [3]https://gitee.com/openeuler/community/blob/master/zh/technical-committee/governance/README.md [4]Community:https://mailweb.openeuler.org/hyperkitty/list/community@openeuler.org [5]Dev:https://mailweb.openeuler.org/hyperkitty/list/dev@openeuler.org [6]Announce:https://mailweb.openeuler.org/hyperkitty/list/announce@openeuler.org [7]Council:https://mailweb.openeuler.org/hyperkitty/list/council@openeuler.org [8]Infra:https://mailweb.openeuler.org/hyperkitty/list/infra@openeuler.org [9]Marketing:https://mailweb.openeuler.org/hyperkitty/list/marketing@openeuler.org [10]User-committee:https://mailweb.openeuler.org/hyperkitty/list/user-committee@openeuler.org [11]Build-team:https://mailweb.openeuler.org/hyperkitty/list/buildteam@openeuler.org [12]TC:https://mailweb.openeuler.org/hyperkitty/list/tc@openeuler.org [13]Kernel:https://mailweb.openeuler.org/hyperkitty/list/kernel@openeuler.org [14]A-Tune:https://mailweb.openeuler.org/hyperkitty/list/a-tune@openeuler.org [15]iSulad:https://mailweb.openeuler.org/hyperkitty/list/isulad@openeuler.org [16]QA:https://mailweb.openeuler.org/hyperkitty/list/qa@openeuler.org [17]Sig-ai-bigdata:https://mailweb.openeuler.org/hyperkitty/list/sig-ai-bigdata@openeuler.org [18]Crystal-ci:https://mailweb.openeuler.org/hyperkitty/list/crystal-ci@openeuler.org [19]Virt:https://mailweb.openeuler.org/hyperkitty/list/virt@openeuler.org [20]https://gitee.com/openeuler/infrastructure [21]https://gitee.com/openeuler/community [22]https://gitee.com/openeuler/kernel [23]https://gitee.com/openeuler/community-issue [24]https://gitee.com/openeuler/community/blob/master/zh/contributors/issue-submit.md [25]https://gitee.com/openeuler/iSulad [26]我的社区参与之旅:https://openeuler.org/zh/blog/2020/06/10/2020-06-10-my-traval-of-openeuler.html [27]openEuler 社区参与之旅:https://openeuler.org/zh/blog/2020/05/13/2020-5-13-openEuler-Travel.html [28]https://gitee.com/src-openeuler [29]https://gitee.com/openeuler [30]https://gitee.com/openeuler/community [31]openEuler 社区版本命名,发布时间与生命周期管理:https://gitee.com/openeuler/release-management/blob/master/lifecycle.md [32]20.03LTS 版本基本信息表:https://openeuler.org/zh/docs/20.03_LTS/docs/Releasenotes/release_notes.html [33]openEuler 关键特性文档说明:https://openeuler.org/zh/docs/20.03_LTS/docs/Releasenotes/%E5%85%B3%E9%94%AE%E7%89%B9%E6%80%A7.html [34]https://gitee.com/openeuler

优秀的个人博客,低调大师

手把手教你玩转openEuler开源社区

引言 openEuler社区已经建立起来了,也有不少合作伙伴, OSV, ISV等参与进来。整个社区的治理结构也初步建立了起来。但毕竟是一个年轻的社区,因此有一些流程方面还有待优化,很多文档还有待于完善。 鉴于有很多希望参与到社区里的工程师对整个社区的运作流程,开发流程还比较陌生,我总结了一个文档来帮助一个工程师更容易的参与到社区中。 openEuler社区概要 openEuler的主站点是https://openeuler.org/ 主站点主要是提供一些入口,对于工程师来说,最重要的应该是下载链接: https://openeuler.org/zh/releases.html 除了下载以外,对工程师来说,真正的社区开始之旅的起点: https://openeuler.org/zh/developer.html 这个链接给大家做了一个简要的引导,但是不幸的是,对于一个新人来说,信息量依然非常大,可能有些摸不到头脑。下面,就让我带着大家一步步的化繁为简的做一次openEuler参与之旅吧。 法律合规是第一步,也是最重要的一步 “开源”这两个字眼虽然在很大程度上代表了自由,奔放,随心所欲,符合码农天生追求“自由飞翔”的特质。但是开源并不是法外之地,因此法律合规是一个社区健康发展最重要的前提,没有之一。因此,任何一个人,如果想要参与到openEuler项目中,第一步就是要签署CLA协议。协议的签署网址是: https://openeuler.org/en/cla.html 虽然协议并不复杂,但是作为一个码农,通常我都对这类法律文书都是免疫的,我们连需要给自己赔钱的保险合同都不会多花上一分钟时间看上一眼,对于这种需要自己奉献的条款又怎会关注呢?还有更关键的是,如果码农看懂了法律文书,那还是码农么? 虽然这很大程度是我们码农的现状,但是我还是建议大家认真阅读一下协议,了解一下权益范围并没有坏处。 我们是开源的 openEuler社区原则上只接受开源协议的软件,哪些开源协议是社区认可的开源协议呢?大家可以参考下面的网址。这个网站上所列举的开源协议都是openEuler社区所能接纳的协议。 https://opensource.org/licenses/alphabetical 对于社区本身,我们默认使用mulan V2协议,https://opensource.org/licenses/MulanPSL-2.0,这是一个非常友好的开源协议,也欢迎大家更多的使用这个协议来开发开源软件。 我能做点什么 在签署完CLA协议,了解我们所认可的开源协议范围以后,需要完成社区的注册。 由于openEuler本身是开放到gitee.com上,因此需要大家在gitee上拥有账号。我们也衷心希望gitee能成长为世界级的代码托管平台。 当大家完成了这些过程以后,就需要考虑在社区里具体能做点什么了。参与社区有很多种方法和形式,如果总结起来,大体有下面的四类: 提交一些需求,或者bug,简单来说就是发觉哪里用的不爽,直接提要求。 或者在用openEuler的过程中发现了一些问题,然后需要在社区把这个问题提出来。 为社区修正bug,这是更高一个层面的参与社区了,在这个层面,参与者实质上是以一个开发者的姿态进入到了社区中。一般我们都提倡,除了提出问题,更期待大家能解决问题。 贡献软件包,发现openEuler缺失了一个软件包,帮openEuler把这个软件包补上。实际上贡献软件包的过程就是帮助openEuler提供更丰富功能的过程。希望随着大家的参与,openEuler能够成为一个“无所不有”的软件生态系统。 开发新软件,有自己的一些想法,独立开发一个全新的软件,并将这个软件贡献到openEuler社区,成为openEuler发行版本中的一份子。 我们就一个个来看看这4种参与方式如何进行把。 网站和社区 在具体讨论这四类参与方法之前,我先给出三个网址链接。 https://openeuler.org/ https://gitee.com/openeuler/ https://gitee.com/src-openeuler 第一个网址是openEuler的门户网站,是供大家获取一些通用信息的地方,前面已经提到过了。而真正我们所谓的“社区”则是体现在2,3这两个网址上。 这两个网址互相有链接,它们分别长这个样子: 长得这么像,为什么要分两个网址呢? 两者有什么分工呢?我们在后续讲解中会慢慢的给大家说清楚。 不论怎么样,这两个网址,以及里面的内容将会是社区工作的主要场所。虽然人机界面并不友好,但我相信对于码农来说这不是一个大问题,因为码农们的世界从来都不曾经友好过。 参与方式一:提交需求&bug 最基本参与社区的方式当然是要先用一用社区的物件,看看还有哪些需要改进的地方。提出一些有价值的建议和意见了。这几乎是最简单参与社区的方式了。 在社区中,我们提交问题都是通过“issue”机制来进行。但是在提交之前,提交人得先明确这个issue要提交给谁。在社区里,我们是一个个“repo”来对功能进行分组的。比如我们著名的Linux操作系统的“内核”(kernel)就有一个独立的“repo”(通常我们称之为“仓”)。 如果你发现了一个内核的问题,或者需求,那么就需要找到内核相关的repo地址:https://gitee.com/openeuler/kernel 它的界面这个样子。 其中红圈里大家可以看到Issues这个字样,这就是我们所有问题&bug&需求的入口了。点进去以后可以看到: 红圈位置的按钮就是我们建立一个新的Issue的入口。 进入以后,就可以提交issue了,有分类栏来说明这个issue属于什么类别。 在这里,可能会有一些同学们会问:为什么没有一个bugzilla?这是一个拷问灵魂的问题,是呀,为啥没有建立一个工程师们更为熟悉的bugzilla呢?我没有办法给出一个合理的解释,不过目前看越来越多的项目都逐步通过issue,PR等机制来管理项目,如果再独立构建一个bugzilla系统,那么和PR,Merge合入等的工作就需要进行交联,复杂度会增加,因此目前我们还是选择通过issue来管理bug和需求。 这里有一个小问题,我的问题需要提交到哪里去呢? Issue的归宿 总体来说,提交issue分如下几类: 具体软件的问题直接提交到相关的软件repo中,比如上面所提到的kernel的repo中。 社区中的一些基础设施用的不爽,比如网页看起来不顺眼等,提交到https://gitee.com/openeuler/infrastructure,基础设施组。 如果是一些社区治理方面问题,例如技术选型,软件的增加,删除,gnome和KDE哪个更图形界面原教旨主义一些等问题可以提到https://gitee.com/openeuler/community里。 如果你实在不知道该提到什么地方,就统统提交到https://gitee.com/openeuler/community-issue,这里会为你排忧解难。 更为详细的issue提交流程可以参见如下的专业讲解。 https://gitee.com/openeuler/community/blob/master/zh/contributors/issue-submit.md 参与方式二:修复bug 在社区里,通常我们希望提出问题并同时解决问题,如果有一个问题,当然最好的情况是同时提供问题解决的patch补丁。我们以社区的轻量化容器引擎iSulad为例,https://gitee.com/openeuler/iSulad,假定我们需要为iSulad提交一个patch补丁,基本流程如下: 第一步:建立自己的分支 在红圈处先要Fork一个“分支”到自己的账号下。如果大家不清楚fork的含义,建议学习一下git的使用方法。在这里要提一句,无论如何,现代工程师要理解git的开发模式,不了解git在当代几乎会寸步难行。 第二步,修改代码并生成Pull Request(简称PR) 当fork完毕以后,大家可以在下图的红圈1中发现,目录已经从openEuler切换成了自己的账户。 接下来,就可以在自己的“分支”上进行代码的修改了。 修改完以后,点击红圈2中的+Pull Request,这可能是提交代码中最关键的一个步骤,这里会正式生成一个patch并送到https://gitee.com/openeuler/iSulad这个原始社区。 比如我修改了一个函数,增加了一行printf(“hello, world”)这行代码。那么PR看起来就是这样的: 你需要为这个PR起一个名字,同时填写一个说明。分别是红圈1和2,最后确定patch没有问题以后,点击红圈3中的“创建”按钮提交。 你会在openEuler/iSulad上看到你所提交的PR,红圈一表明你提交的PR已经进入了iSulad的社区,红圈2中的数字228是这个PR的编号。同时这个PR的URL是:https://gitee.com/openeuler/iSulad/pulls/228 至此,作为一个patch提交者的工作就做完了,你剩下所要做的事情就是耐心的等待iSulad开发组的maintainer来审核你的patch,比如我相信今天晚上他会非常诧异,谁提交了这么一个stupid的patch,而且公然用useless demo这样的PR题目来挑战他脆弱而敏感的maintainer神经。 因此,你的PR可能有三种命运: 被iSulad社区接受。 被iSulad社区残忍的拒绝。 提出修改意见,修改后再提交PR。goto 1 不仅仅是可以提交代码的PR,任何修改,甚至是为readme修正了一个拼写错误,所遵循的流程都一摸一样。 更细致,更专业的介绍请参考: https://gitee.com/openeuler/community/blob/master/zh/contributors/Gitee-workflow.md 这里有一步步的教程引导大家来提交。 另外,PR的提交也在很大程度上体现了提交者的专业能力和亲和力。Be nice很重要,下面的链接可以帮助大家理解如何更优雅的提交一个PR。 https://gitee.com/openeuler/community/blob/master/zh/contributors/pull-request.md 好了,恭喜您,至此,您的第一次真正意义上的社区开发之旅就画上了一个完美的句号。 让我们进入下一个挑战环节,为openEuler增加一个新的软件包。 参与方式三:贡献软件包 在能够为openEuler贡献一个软件包之前,需要我们的开发者理解两个基本的概念: 什么是Linux的软件包。或者说Linux操作系统是怎么组织的。 如何制作一个软件包。 OS是怎么组织的 显然这是一个非常巨大的话题,可能需要写一本书来讲OS是怎么组织,怎么构建出来的。在这里我只能简要的给大家介绍一下。 实际上,一个OS系统的组成既复杂,也简单。 何所谓简单呢,其实OS本质上就是一堆安装包的大杂烩,就类似我们不论使用Windows也好,使用Android也罢,或者使用Linux,我们都经历过“安装”这个概念,就是从网上,或者是从“仓库”中下载一个安装包,然后安装到系统上,所以大家可以看到安装的“进度条”。实际上,一个OS的安装过程和在andorid上安装微信的道理一摸一样。只不过所谓的安装OS是需要一次性的要把几千个软件包按照一定的顺序安装到机器中。 那么OS所谓的组织很复杂呢,大家可以想象以下,几千个软件,他们之间会有很多的交联关系,通常我们叫做“依赖关系”,就好比,如果你想用微信小程序,那么前提是必须先得有微信,那么安装微信小程序的前提就是必须要先安装微信。因此,即使我们考虑一个OS的安装过程,其实也是非常复杂的,必须要精确的计算哪些软件需要先安装,哪些需要后安装。随着系统的膨胀,那么这些软件包之间就形成了复杂的网状关系。即使我们这些行业内的人都为此头痛不已。 讲了这么多,和我们的openEuler社区开发有啥关系呢?其实,上面的讲解是要让大家理解,任何OS的基本零件就是软件包,就类似组成人体的基本零件是细胞一样。这一个个软件包就是构成OS的一个个基本零件。 在Linux的世界,有两种基本的安装包格式: RPM 这个格式是redhat, suse, WindRiver, openEuler等所选用,目前在企业市场,基本是以这些厂家为主,因此rpm格式在商用企业市场用的比较多。 Deb 这个格式是debian, Ubuntu, android使用的,目前在desktop,终端侧用的比较广泛。 这两种格式本身没有什么优劣之分,只是不用厂商的选择而已。当然,对于客户,开发者来说,世界被割裂成为两个互不兼容的部分总归是一种不必要的残忍。对于这个问题社区也有不同的尝试,但目前为止还没有出现某个大一统的软件包格式能够终结这个分裂的世界。 不过幸好我们有容器,很大程度上,容器的出现缓解了这个问题。那未来能不能找到一条优雅的技术道路将这些不兼容,将这些复杂的软件包的依赖带来的诸多痛苦一并解决掉呢?我把这个问题留给本文的爱好者吧,也许在你们中间就会出现这样的“历史终结者”。 所以,一个软件从源代码到能进入到我们的OS安装光盘中,要经历三个步骤。 第一步: 源代码开发阶段,也就是写程序的阶段。这个阶段可以在任何地方,可以在github,gitlab, gitee等代码托管平台上,也可以是自己的笔记本电脑上。 第二步: 将代码编译,生成二进制可执行程序。并且制作RPM软件包,其中“制作RPM”的过程实际上也是一种“编程”,只不过使用的是一种定义好的脚本语言,“程序”是一种叫做spec的文件。讲真,spec的编写是非常不符合老派程序员思维的,那种分段式的,跳跃式的,宏式的写法绝对挑战老派程序员的神经。所以,我们有很多很好的程序员,但是却很少有程序员能将一个程序真正制作成一个rpm包(或者deb包)。希望大家能挑战一下自己,成为一个RPMer。真的,不难,但是够你手忙脚乱一阵的。 我们有一个rpm的编写规范,可以供大家参考。 https://gitee.com/openeuler/community/blob/master/zh/contributors/packaging.md 第三步 将这些rpm包放在iso中,做成安装光盘。这一步一般的工程师不用感知,后台有自动化的系统来完整整个工作,而且相关的工具我们也会开源到openEuler中。也就是说,后续任何人都可以简单的为自己构建一个My Linux。 那就让我们看看如果你有一个项目在github上,我们如何将它最终转变成为安装光盘上的一个软件包吧。 首先,你得有一个组织 人生活在社会中,无时无刻不属于某个组织,并受到一些人的领导,比如白天,你需要属于某一个公司组织,晚上,你需要属于一个家庭组织。 社区也一样,在你想要把一个软件做成软件包放到openEuler系统中之前,你需要明确两件事情: 你自己属于哪个组织? 你要加入的这个软件包属于哪个组织? 在openEuler社区中,它的基本“组织”单元是SIG组,也就是special interest group,我至今没有弄明白为什么“兴趣”要加上“特殊”这个极易产生歧义和联想的前缀。不过anyway,如果你想有归属感,你有两种选择: 寻找到和你具有同样“特殊爱好”的小组,然后申请加入。 你的爱好太“特殊”以至于目前还没有志同道合的人,自己申请建一个。 openEuler所有的SIG组都在https://gitee.com/openeuler/community/tree/master/sig列出来,大家可以参考。 如果你有意愿,同时也展示了对某些“特殊爱好”有着深厚的积累或者惊人的天赋,那么欢迎你参照https://gitee.com/openeuler/community/blob/master/zh/technical-committee/governance/README.md完成一个新的SIG组的申请。我不得不说,这个流程不光看起来有一些复杂,也不友好,实际操作起来也是这样的。但我相信这难不倒码农,我们不就是为了制造这些复杂和不友好而生的吗! 最后一步,当创建完SIG的PR申请以后,需要到技术委员会(TC)的例行会议上进行评审,在https://gitee.com/openeuler/community/tree/master/zh/technical-committee可以找到TC委员会的基本信息,还有联系方式,大家可以订阅TC的邮件列表来获取一些动态,特别是例会的信息。 既然说到了TC(技术委员会),我们就简要讲一下openEuler的组织结构吧。 组织结构 openEuler是一个完全开放的组织架构,而且非常简单,https://gitee.com/openeuler/community这里可以看到基本的情况。 我想这副图已经说的很清楚了。 开始干活,先要弄明白干什么 当然,即使你完全不属于任何一个SIG组,理论上也能提交一个软件包到openEuler中,只是被接受的概率相对较低而已。其主要原因是很难来评估相关提交的质量,SIG组很大的意义就在于一些专业方面的人能够为每次提交做出质量的保证。 软件包本身必须是要属于某一个SIG的。以我自己常用的一个软件包为例,我每次写完程序以后,都总会执行一下cloc这个命令,看一下今天又新增了多少行代码,以期获得一下码农与生俱来的成就感,并中和一下写PPT带来的空虚和乏力感。 显然cloc是一个开发类的工具,帮助码农统计代码行,幸运的是,拥有同样“特殊爱好”的人并不在少数,他们建立了一个dev-utils的SIG组,https://gitee.com/openeuler/community/tree/master/sig/dev-utils,我们可以将cloc这个软件归属于这个SIG组。 如何把大象放到冰箱里 一般来说,增加一个软件包到openEuler中,需要如下的几个大步骤 让系统为你的cloc软件包建立一个“仓”,也就是git仓。 上传制作cloc软件包所需要的“零件” 将这个软件系统加入到openEuler的自动化编译系统中,由系统自动化构建出软件。 建仓 建仓其实就是提交一个PR,一般来说需要修改三个文件。 https://gitee.com/openeuler/community/blob/master/sig/dev-utils/README.md https://gitee.com/openeuler/community/blob/master/sig/sigs.yaml https://gitee.com/openeuler/community/blob/master/repository/src-openeuler.yaml 修改第一个文件README.md将你要加入的cloc软件的名字和地址放上去。 修改sigs.yaml文件,将cloc软件增加到dev-utils这个SIG分组下面。 修改src-openeuler.yaml将cloc增加到src-openeuler里。 你要做的就是照猫画虎的把这三个文件修改了,然后提交PR就可以了。剩下的就是等待“命运的裁决”。 当申请的结果被批准以后,你所需要的“仓”就会被系统自动建立起来,对于cloc来说,它的代码仓的位置在https://gitee.com/src-openeuler/cloc,这是PR被批准以后由系统自动为我建立的。 剩下的时间,你就可以开始真正上传制作cloc软件的原材料了。 上传软件包 一般来说,一个软件只需要上传两个“原材料”就足够制作一个软件包了。如下图所示: 第一个材料:首先要上传这个软件包的spec文件,也就是告诉构建系统如何编译,制作cloc这个软件包。 第二个材料:cloc的源代码压缩包。 其它零件:如果spec中需要有patch,那么也需要把相关的patch文件上传到仓中。 上传完毕一个软件包所需要的原材料,下一步就是要把这些原材料加入到构建系统中,使之能够被真正编译,生成一个实际的软件包。 加入构建系统 openEuler现在使用obs作为构建工具系统,大家可以参考下面的这个链接把自己的软件加入到obs中 https://gitee.com/openeuler/community/blob/master/zh/contributors/create-obs-package.md 加入到构建系统中,就意味着你的软件可以被系统自动编译,自动生成rpm包,继而在后续的openEuler发行版本中出现。 TIPS 在整个过程中有几点需要开发者要注意: 能够本地构建:提交的软件包首先要在自己的笔记本,或者服务器上能够编译通过。也就是如果你的软件包在本地无法构建成功,那么上传到openEuler社区也不会构建成功。因此。我们建议最好能下载最新的openEuler版本,安装以后通过rpmbuild等命令来进行构建验证。 保证软件包可用:软件除了能够被编译和生成软件包,还要能正确运行,因此,在本地环境要保证制作出来的软件包能够: 正确的安装 正确的卸载 正确的升级 软件的功能是正常的。 保证多体系架构支持:openEuler目前支持x86_64和ARM64两种指令集,因此在构建过程中需要能够保证软件包在这两种环境下都能被正确编译和运行。虽然ARM64环境可能并不那么容易获取,但幸运的是,一般性软件在这两个系统上没有那么大的差异。 保证正确的依赖关系:一个软件通常都需要依赖其它的一些软件才能运行,比如所有软件都需要依赖glibc这个库来执行,一些复杂的软件可能会依赖很多软件包来提供功能。这些软件包可能已经在openEuler社区中有了,也可能没有。如果没有,那么就需要同时在openEuler社区中将这这些软件包补齐才行。比如cloc这样一个小软件,缺需要依赖如下的几个perl的软件包: 也就是说在提交cloc软件包的同时,也需要同时提交这几个软件包,这样才能保证cloc能够被系统正确的编译和构建出来。 保证spec文件的规范性:要保证spec文件是“规范”的,避免将外部的spec直接引入到openEuler中,因为如前所述,因为选择包的范围,依赖关系,版本等都不相同,同时保证所有软件包spec是一致的,请依照前面的rpm制作规范中的内容来书写spec文件。 因此,制作一个软件包,有的时候远比想象中的要复杂一些。但好在这并不是一个难度很大的事情,只需要提交一个软件包,走一遍流程,后续就会轻车熟路了。 参与方式四:开发新软件 上面讲的过程都是怎么给“别人”的软件提意见,怎么把“别人”做的软件添加到openEuler社区。但是每一个真正做软件的人内心都希望能拥有属于自己的作品,那么如何建立自己的作品,如何将自己的作品融入到openEuler社区呢? 将自己的作品融入到openEuler社区有如下两种方法: 方法一:在其它社区开发,集成到openEuler中 假定你已经在github,gitlab或者gitee上拥有了自己的项目,那么只需要按照参与方式三那样,将软件加入到src-openeuler这个repo仓就可以了。 方法二:在openEuler社区中开发,在openEuler中集成 另外一种方法是,直接在https://gitee.com/openeuler中建立项目,类似将项目“托管”到openEuler社区。比如现在社区中的iSula和A-Tune这样的项目就是这样的模式。 至此,我相信所有人都能明白了为什么openEuler会建立两个仓: https://gitee.com/openeuler https://gitee.com/src-openeuler openeuler这个仓是存储所有“原生态”的软件,也就是为原创性的软件提供一个展示的舞台,或者是一个孵化器平台。 而src-openeuler则是为openEuler的release发行版提供生成rpm包等构建信息等的地方。 因此,当一个很有梦想,很有情怀的工程师突然有一天有了一个很棒的idea,那么他可以依照下面的过程来深度参与到openEuler中。 在TC委员会的例会meeting中申请一个开源项目,比如项目名称叫做“broken_dream”。 如果TC委员会认为这是一个很好的idea,并且认为值得为破碎的梦想提供一个机会,那么我们会在https://gitee.com/openeuler中建立一个repo,网址就是https://gitee.com/openeuler/broken_dream 这个项目在openeuler中持续开发和孵化,直到有一天,大家认为broken_dream已经足以成熟到为所有人提供破碎的梦想服务了,那么就可以在src-openeuler中建立一个仓,为broken_dream提供相关的spec文件,制作成为一个rpm。 最终broken_dream.rpm会随着openEuler的发布版本走遍全世界,为世界人民提供broken_dream功能。 我始终认为,一个工程师,在他的职业生涯中,至少要有一个,哪怕只有一个项目和他自己的名字是息息相关的。只有这样,才能在孙子,孙女骑在我们背上,问我们这辈子做的最棒的事情是什么的时候,我们可以让他们爬下来,然后直起身,看着他们天真无邪,对未来充满憧憬的大眼睛,认真的问他们:你知道broken_dream的作者是谁吗? 最后,我要感谢openEuler社区中每一个贡献者,特别是文档的撰写者们,文档对于码农们来说永远是痛苦的源泉,但正是各位文档的撰写者的辛勤工作,才使得本文能够有一个机会为大家呈现一个完整的openEuler参与之旅。 作者:openEuler技术委员会委员 熊伟 ------------------------------------------------------------------------ 添加小助手 openEuler,加入openEuler交流群 更多内容,敬请关注openEuler公众号

优秀的个人博客,低调大师

新零售:带你玩转全域营销

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 今日下午15点整,三位大咖与您一起探讨全域数据中台如何助力飞鹤成为最懂中国爸妈的品牌。 全域数据中台助力品牌成长专场,阿里云架构师、产品专家联合飞鹤一起带你解读全域营销,数据中台在企业全链路数智化转型中的价值定位,实现方法,组织保障,运营策略以及技术路线的全面分享,全域数据中台的产品介绍、常见场景及案例、依赖阿里生态的多样化玩法,飞鹤如何通过全域数据中台获取更多的用户及粉丝?又是如何提高用户的购买转化率?"。 点击观看 本次讲师: 吴雪军 阿里云新零售高级解决方案架构师 专注服饰,快消,百货,超市等零售行业20年,牵动全域数据中台解决方案全面落地30多家客户,用数据为客户创造价值,推动新零售玩儿法在数据驱动下提升客户运营效率,从需求走向供给形成产业化生态升级。 杨波 阿里云新零售业务运营专家 负责全域数据中台产品运营,帮助服饰、家清、美家、消费电子、乳业、食品等行业数字化转型。曾就职于百度、阿里妈妈,从事营销IT咨询、整合营销和全域营销领域工作十二年。 张睿 飞鹤乳业数据中台项目总监 飞鹤乳业数据中台项目总负责人,作为飞鹤乳业IT与智慧营销业务架构师,规划并落地数据中台、消费者运营、门店终端、分销等多个营销业务平台、C2M战略体系等多个战略项目。 观看地址:https://yq.aliyun.com/live/2790 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK

优秀的个人博客,低调大师

在 Flutter 中玩转 Objective-C Block

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! dart_native 作为一条比 Channel 性能更高开发成本更低的超级通道,通过 C++ 调用 Native 的 API,深入底层且考虑全面。很多 Objective-C 接口的参数和返回值是 Block,所以这就需要支持用 Dart 语言创建和调用 Objective-C Block。 Dart 调用 Objective-C 带 Block 的 API Dart 语言支持协程,这样就无需传递闭包来作为异步调用的回调。而 Objective-C 大量 API 都使用 Block 作为回调,当 Dart 调用这类异步 API 的时候,就需要 Dart 侧创建 Block 并传递给 Objective-C。 Dart 语言中的 Function 可以当做闭包,可以实现下面这样的效果: 而对应的 Objective-C 接口如下: 下面就讲下 dart_native 是如何做到把 Dart Function 当做 Block 传给 Objective-C 的。 函数签名 首先要确保的是 Dart Function 的签名跟 Objective-C Block 是一致的,这样二者才能转换。在 Dart 里一切皆为对象,Function 也不例外。那么拿到 Function 的 runtimeType 即可,然后解析其内容。不过 runtimeType 的内容都是 Dart 类名,如何能与 Objective-C 类型对应上呢?dart_native 的策略是提供与 Native 同名的类,这样使用这些同名类定义 Dart Function,就可以把函数签名映射到 Native 上了。 列举一些 Dart 声明的基础类型: 动态创建 Block 有了函数签名,如何构造对应的 Block 对象呢?首先要知道 Block 是什么,而这是就又个老生常谈的话题了。我十分建议你先了解下 BlockHook 及其相关文章,这样会对理解这部分内容有很大帮助。 废话不多说,上硬核: 简单来说,动态创建 Block 的流程封装在了一个 Wrapper 类中,步骤如下: • 用 libffi 动态创建相同签名的函数, • 准备好创建 Block 需要的 flag、description、signature 和 wrapper 对象等 • 根据 Block 的内存模型创建对应的结构体(栈上) • 把 Block 对象 copy 到堆上,并发送 autorelease 消息 这上面每一步其实都不简单,单独拆出来都能写一段。但因为 bang 大佬已经写过文章介绍过了,我这里就不再赘述了。我只是站在巨人的肩膀上,增加了一些改进和对 Dart 的适配(如支持结构体、x86 兼容等)。很惭愧,就做了一点微小的工作。 映射 Block 和 Dart Function Block 对象创建好了,需要跟 Dart Function 映射起来,然后当 Block 被执行的时候才会调用到对应的 Dart 逻辑。 关于回调这块,我在 Dart 侧维护一个 Map 来管理 Native 到 Dart 的回调映射。基本思路是,Key 为 Native 对象的地址,Value 为 Dart 侧的 Block 类。 Dart 版的 Block 类构造方法里会将映射建立起来: 在 Block 类的 dealloc 方法里会移除映射,防止造成 Dart 版的『野指针』。 Dart 调用 Objective-C 返回的 Block 结合对 Block 的理解以及实践过 Dart 调用 OC 方法的经验,很容易在 Dart 版的 Block 中实现个 invoke 方法: 简单来说上面的实现做了如下几步: • 获取 Block 的函数签名 • 校验 Dart 测传入的参数列表是否符合函数签名 • 将 Dart 参数转为 Native 对应的类型,写入堆中 • 调用 C 函数 blockInvoke,将 Block 指针和参数列表二级指针传过去 • 释放二级指针(其指向的对象类型和堆上的结构体会自动释放) • 将 blockInvoke 返回的指针内容转为 Dart 对象 后续 关于 Block 这块其实还有很多技术细节没有叙述完整,包括 copy 方法的实现,回调映射的细节,类型自动转换的细节等。因为篇幅原因,感兴趣的可以直接看源码:https://github.com/dart-native/dart_native 其实我期望的是使用 Dart 的协程来完成处理异步回调,这样更现代更优雅。日后会基于此方案再次封装上层接口,支持协程。 dart_native 作为一条深入底层且考虑全面的 Dart 到 Native 超级通道,未来还要做的事情还有很多。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-15本文作者:杨萧玉本文来自:“玉令天下的博客”,了解相关信息可以关注“玉令天下的博客”

优秀的个人博客,低调大师

MaxCompute管家详解--管家助力,轻松玩转MaxCompute

精彩视频回顾请点击:MaxCompute管家详解以下是直播内容精华整理,主要包括以下四个方面:1.背景速览;2.功能介绍;3.案例讲解;4.新功能预告。 一、背景速览 MaxCompute(原ODPS)是一项大数据计算服务,它能提供快速、完全托管的PB级数据仓库解决方案,使用户可以经济并高效的分析处理海量数据。在购买了MaxCompute之后会有相当多而繁琐的管理和维护工作,比如如何对项目进行更精细化的管理、如何将项目与配额进行关联等等,而MaxCompute管家可以帮助用户更好地完成这些工作,它是一个为用户提供作业信息查看、资源消耗查看(涵盖CU资源和存储资源)、项目查看及调整、配额组增删改查等涉及日常MaxCompute运维能力的管理平台。目前,全球包括美国、英国、德国、印度、日本、新加坡在内的18个国家或地区(详情见官网)购买了数加并购买MaxCompute”包年包月“的用户(后期也会支持购买MaxCompute“按量付费“的用户)可以使用MaxCompute管家功能,且已经支持英文界面。MaxCompute管家的入口有两个:(1)管理控制台(图1)和(2)数加控制台(图2)。需要注意的是从管理控制台和数加控制台进入MaxCompute管家页面时候需要先选择正确的MaxCompute对应区域。 图 1 MaxCompute管家入口1:管理控制台 图 2 MaxCompute管家入口1:管理控制台 二、功能介绍 当前,管家主要针对MaxCompute中项目、配额以及作业三个核心模块来提供相应的支持。(一)项目在项目列表页面可查看当前用户具备的预付费project的所有相关信息,包括项目名称、所属dataworks工作空间、账号、配额组、已用存储、project默认预付费quota组调整,如图3所示。这里需要注意项目名称和所属dataworks工作空间是两个概念,不要混淆了。在项目列表页面点击项目名称会跳转到存储使用趋势的页面来查看项目存储使用的相关情况,并且支持按时段搜索,在存储水位曲线中还可以查看具体到某一个时段的详情(最近1小时、最近6小时、最近12小时、最近1天、最近1周,存储量每1个小时采集一次);账号是指项目所属的一个访问身份;点击配额组可以查看相应的配额使用情况,在后面会重点进行介绍。除了以上操作之外,管家还提供了一个对项目配额组进行修改的操作,用户可以对项目所属的配额组进行修改,更加方便管理。在将项目迁移到新的配额组之后,如果原来的配额组没有被删除,那么项目会沿用原来的配额组进行作业,如果已经被删除,就会使用新的配额组进行作业,以此来达到资源的最大化利用。 图 3 项目列表页面 (二)配额配额管理是MaxCompute的资源管理中的重点也是难点,面对不同的业务需求,用户也有不同的配额管理方式。配额组有4个比较重要的配置参数,具体如下:(1)预留CU最小配额:单个quota组分配资源的下限。(2)预留CU最大配额:单个quota组分配资源的上限。(3)非预留CU最大配额:单个quota组可使用弹性资源的上限。(4)配额组标签:标签主要是用于指定作业的配额组,如果您的包年包月资源组设置多个二级Quota组,可以在提交作业的时候,指定作业运行的Quota组,可以与project所属Quota组不同。这样设置,能够更加灵活的设置和使用您的计算资源。大家也可以根据具体情况灵活设置标签。在配额列表页面,可查看当前用户具备的预付费project的相关信息,包括配额组、CU最小配额、CU最大配额、弹性CU最大配额、配额组标签、涵盖项目个数、最近一次配额组操作状态等,如图4所示。 图 4 配额列表页面 点击配额组中的某一配额组名称,会跳转到相应的页面,里面可以查看对应的资源使用情况,比如预留CU资源使用趋势和非预留CU资源使用趋势,如图5所示,我们也可以查看不同时段的资源使用情况。除此之外,还可以查看该配额组所包含的项目列表,该处项目列表的详情如上文中图3所示的一样,也可以进行相应的操作。 图 5 配额组详情 对配额组的操作主要有新建配额组、修改配额组和删除配额组。(1)新建配额组在新建配额组的是时候修改预留CU最小配额、预留CU最大配额、非预留CU最大配额以及标签,单击执行,完成修改即可。这里我们可以根据自己业务的需求来给配额组设置相应的名称。(2)修改配额组修改配额组的时候可以修改预留CU最小配额、预留CU最大配额、非预留CU最大配额以及标签,然后单击执行,即可完成修改。需要注意的是非预留CU最大配额即为包年包月里的非预留计算资源,此功能仅中国站用户可以使用。另外,这里需要需要注意的时候,配额组的名称一旦建立就不能修改。(3)删除配额组删除功能相对比较简单,就是在配额组不需要的时候删除相应的配额组即可。但是需要注意,处于安全考虑,没有涵盖项目的配额组可删除,删除后的配额会归还至默认配额组,而如果配额组的涵盖项目数不为0,那么是无法删除的。(三)作业在作业模块中,我们支持当前的作业快照,因此在默认状态下,进入作业快照列表的时候,展示的是当前的状态。在作业列表页面,可以查看当前用户指定配额组下所有作业情况,包括InstanceID、账号、项目名称、cpu使用占比(%)、内存使用占比(%)、提交时间、等待时长、运行时长、运行状态,作业快照每2分钟采集1次。如果需要了解更多的关于作业的运行情况,可以点击InstanceID查看对应的LogView,它与作业是一对一的关系,具体的可以查看官网关于LogView的说明。一般在需要对资源使用进行详细了解以优化资源配置的时候,我们可以查看某一个作业的资源使用情况,做到心中有数,也方便对资源配置进行优化。 图 6 作业列表页面 三、案例讲解 在上文的基础上,下面通过案例来进行具体分析如何更好的使用现有的功能来分配和管理资源,让资源得到更有效的利用。首先,我们需要了解几个关于配额的规则:(1)预留CU最大配额配置规则:单个子组的最大CU要小于等于默认资源组的最大CU;(2)预留CU最小配额配置规则:所有子组的最小CU之和要小于等于默认资源组的最小CU;(3)非预留CU最大配额配置规则:所有子组的弹性最大CU之和要小于等于默认资源组的弹性最大CU;(4)配额组标签命名规则:配额组标签只允许使用字母、数字、下划线,不同配额组对应标签不要重名,否则作业指定此重名标签,将会随机调度到其中一个配额组;配额组标签调度规则:如果提交作业时设置的Quota Tag和某个配额组属性中的标签相等,这个作业就会被优先调度到这个配额组中,否则会被调度到所属Project指定的配额组中,详细信息请参见官网Quota Tag描述。在了解清楚了以上几个规则以后,如果进行资源的分配呢?我们以两个具体的问题来了解一下。(一)拿到资源如何配置?首先我们要明白,配置策略跟业务是密不可分的,脱离了业务谈配置是不切实际的。一般来说,在实际配置中我们有资源独享和资源共享两种资源配置策略。资源独享更偏向于重点确保的业务,就是说那些一定要完成的和一定要保障到的业务,而资源共享就没有那么苛刻的要求了,大部分情况下我们都可以采用资源共享的形式来进行配置,这样子就可以避免前置资源的浪费。假设我们共有预留计算资源60CU,非预留计算资源30CU,由两个部门使用,可以按照如下方式分配:(1)资源独享方式 这么划分意味着当A组哪怕没有资源使用时,B组资源最多也只能用到20(由最大CU限制)+10(由弹性最大CU限制)的资源;反之亦然,当B组没有资源使用的时候,A组最多也只能使用30+10CU的资源。这里需要注意,默认的预付费Quota组预留最小CU和非预留最大CU最少也需要有1CU,也就是说默认的预付费Quota组是一个天然的共享型的资源池。所以在业务上只需要资源独享配额时候,就不要把项目迁移到默认的预付费Quota组,而要去做自定义的资源独享组。(2)资源共享方式 这么划分意味着当A组和B组资源均紧张时,A组可以用到20+10的资源,B组可以用到30+10的资源。当A组没有作业时,B组最多可以用到60+10的资源;反之当B组没有资源时,A组可以用到60+10的资源。我们需要注意的是,当采用资源共享方式,如果B组没有作业,A组分配了60(预留最大CU)+10(非预留最大CU)的资源时,之后B组突然有大量作业需要申请资源,这时候需要调度器通知A组释放相应资源之后B组才能开始分配资源进行作业。(二)作业慢或者资源不足怎么办?在实际业务中,可能随着业务量的增加、作业的复杂度增大,我们可能会遇到作业慢或者资源不足的情况。这里我们给出了三个解决方案:(1)优化作业代码我们可通过快照作业的资源使用情况得到top消耗的作业,并尝试进行优化,可参考官网最佳实践来做相应调整。(2)更换调度策略若单个配额组资源不足,但其他配额组有足够空闲资源时,建议使用quota tag,可调度到闲置配额组内进行资源周转,或者调整内部配额组之间的资源上下限,增加资源使用的灵活性,或者通过切换project对应的quota组的方式进行重组式管理,前提是取决于业务情况。(3)扩容若整体资源不足,且其他待跑任务无重保诉求,建议走非预留扩容;若整体资源不足,且有重保任务持续新增时,建议走预留型扩容并已独享型模式配置或后付费采买。 四、新功能预告 本文所提到的功能只是MaxCompute管家所提供的功能中的一部分,主要是面向初级用户,后续将会有更多的功能对外开放,也会分享更多的进阶版、高级版的功能,来解决大家工作中的痛点。未来一段时间,MaxCompute管家会有一些新功能与大家见面,比如以下:(1)资源概览页 资源概览页用来展示用户对应的”包年包月“付费模式下的整体CU使用量、CU资源使用趋势、存储资源使用趋势,方便用户更快速、更便捷的了解当前的资源使用情况。(2)历史作业快照历史作业快照支持按时间搜索历史作业快照,便于用户对历史作业的资源使用情况的追述。(3)终止作业支持作业owner小批量终止作业,同时支持终止作业历史追述。(4)分时配额针对于部分用户作业有时段性的要求,增加了分时配额,支持用户对不同配额组进行分时段的动态配额调整,便于用户对周期性任务调度的有效管理。 如果大家需要了解更多的关于MaxCompute管家的细节,可以通过官网 -> 大数据计算服务 · MaxCompute -> 文档&SDK -> MaxCompute管家来查看相应的说明文档,官方也会持续的进行迭代更新。

优秀的个人博客,低调大师

[玩转MySQL之一]MySQL体系架构简介

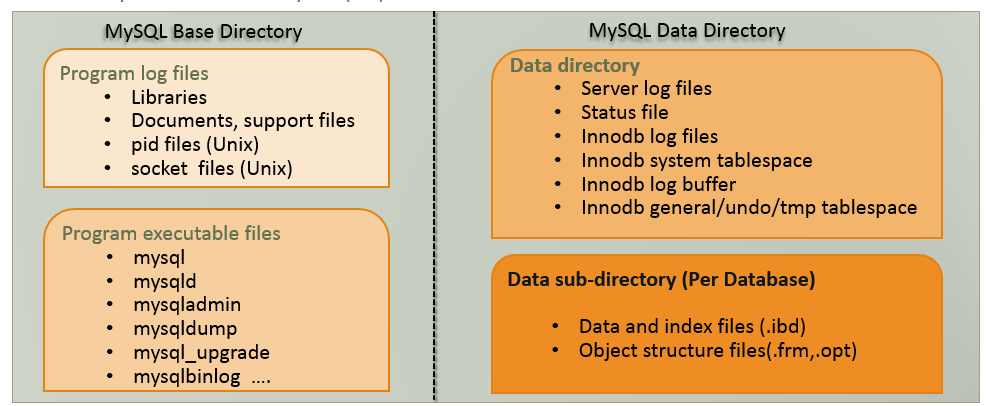
引言 MySQL是一个典型的C/S架构程序,MySQL Server提供数据库服务,完成客户端的请求和操作,Client负责连接到Server。MySQL和其他关系型数据库不一样的地方在于它的弹性以及可以通过插件形式提供不同种类的存储引擎,MySQL请求处理过程会根据不同的存储引擎发生变化,比如事务性的InnoDB和非事务性的MyISAM,数据的存储和SQL的执行会产生很大的差异。本文以MySQL5.7为例,简单介绍MySQL的物理和逻辑架构。 1. MySQL物理结构 1.1 配置文件 auto.cnf: 配置了MySQL Server的UUID my.cnf: MySQL的配置文件 1.2 其他重要文件 -basedir=dir_name: MySQL安装的二进制文件目录 -datadir=dir_name: MySQL的数据目录和 -pid-file=file_name: 保存MySQL进程ID文件 -log-error=file_name: MySQL错误日志文件 2. MySQL逻辑体系架构 MySQL逻辑系统架构分为3层: 应用层 MySQL服务层 存储引擎层 2.1 应用层 应用层是MySQL体系架构的最上层,它可其他client-server架构一样,主要包含如下内容: 连接处理 用户鉴权 安全管理 1. 连接处理当一个客户端向服务端发送连接请求后,MySQL server会从线程池中分配一个线程来和客户端进行连接,以后该客户端的请求都会被分配到该线程上。MySQL Server为了提高性能,提供了线程池,减少了创建线程和释放线程所花费的时间。 2. 用户鉴权当客户端向MySQL服务端发起连接请求后,MySQL server会对发起连接的用户进行鉴权处理,MySQL鉴权依据是: 用户名,客户端主机地址和用户密码 3. 安全管理当客户连接到MySQL server后,MySQL server会根据用户的权限来判断用户具体可执行哪些操作。MySQL 提供的部分权限的如下: mysql> show privileges \G; *************************** 1. row *************************** Privilege: Alter Context: Tables Comment: To alter the table *************************** 2. row *************************** Privilege: Alter routine Context: Functions,Procedures Comment: To alter or drop stored functions/procedures *************************** 3. row *************************** Privilege: Create Context: Databases,Tables,Indexes Comment: To create new databases and tables 2.2 MySQL 服务层 该层是MySQL Server的核心层,提供了MySQL Server数据库系统的所有逻辑功能,该层可以分为如下不同的组件: MySQL Management Server & utilities(系统管理) SQL Interface(SQL 接口) SQL Parser(SQL 解析器) Optimizer (查询优化器) Caches & buffers(缓存) 1. MySQL Management Server & utilities(系统管理)提供了丰富的数据库管理功能,具体如下: 数据库备份和恢复 数据库安全管理,如用户及权限管理 数据库复制管理 数据库集群管理 数据库分区,分库,分表管理 数据库元数据管理 2. SQL Interface(SQL 接口)SQL接口,接收用户的SQL命令并进行处理,得到用户所需要的结果,具体处理功能如下: Data Manipulation Language (DML). Data Definition Language (DDL). 存储过程 视图 触发器 3. SQL Parser(SQL 解析器)解析器的作用主要是解析查询语句,最终生成语法树。首先解析器会对查询语句进行语法分析,如果语句语法有错误,则返回相应的错误信息。语法检查通过后,解析器会查询缓存,如果缓存中有对应的语句,就直接返回结果不进行接下来的优化执行操作。 注:读者会疑问,从缓存中查出来的数据会不会被修改,与真实的数据不一致,这里读者大可放心,因为缓存中数据被修改,会被清出缓存。 4. Optimizer(查询优化器)优化器的作用主要是对查询语句进行优化,包括选择合适的索引,数据的读取方式。 5. Caches & buffers(缓存)包括全局和引擎特定的缓存,提高查询的效率。如果查询缓存中有命中的查询结果,则查询语句就可以从缓存中取数据,无须再通过解析和执行。这个缓存机制是由一系列小缓存组成,如表缓存、记录缓存、key缓存、权限缓存等。 2.3 存储引擎层 1. 存储引擎存储引擎是MySQL中具体与文件打交道的子系统,也是MySQL最有特色的地方。MySQL区别于其他数据库的最重要特点是其插件式的表存储引擎。他根据MySQL AB公司提供的文件访问层抽象接口来定制一种文件访问的机制(该机制叫存储引擎)。 2. 物理文件物理文件包括:redolog、undolog、binlog、errorlog、querylog、slowlog、data、index等 3. 参考文献 MySQL Architecture and ComponentsUnderstanding MySQL Architecture带你认识 MySQL 之 MySQL 体系结构 更多内容请关注公众号

优秀的个人博客,低调大师

伸手党福利-从零开始玩转图库

名词解释 vetex:节点 edge:边 graph:图 tinkerpop tinkerpop是一个图库标准,一个框架,学习图库,先从这个项目入手比较合适, neo4j, janusGraph只是它两个组件(图storage-engine)的vendor而已。图库是节点&边的集合,边描述了节点间的关联关系。 tourist 打开gremlin-console,我们可以通过groovy语言对图进行curd操作,也可以使用gremlin语法进行遍历 $ bin/gremlin.sh \,,,/ (o o) -----oOOo-(3)-oOOo----- plugin activated: tinkerpop.server plugin activated: tinkerpop.utilities plu

优秀的个人博客,低调大师

教程:用强化学习玩转恐龙跳跳

DeepMind在2013年发表了一篇题为《用深度强化学习玩Atari》的文章,介绍了一种新的用于强化学习的深度学习模型,并展示了它仅使用原始像素作为输入来掌握Atari 2600计算机游戏难度控制策略的能力。在本教程中,我将使用Keras实现本文。我们将从增强学习的基础开始,然后深入代码中进行实践性的理解。 AI玩游戏 我在2018年3月初开始了这个项目,并取得了一些不错的成果。但是,只有CPU的系统是学习更多功能的瓶颈。强大的GPU极大地提升了性能。 在我们运行模型之前,我们需要了解许多步骤和概念。 步骤: 在浏览器(JavaScript)和模型(Python)之间构建双向接口 捕获和预处理图像 训练模型 评估 源代码:https://github.com/Paperspace/DinoRunTutorial.git 入门 要按照原样训练和玩游戏,

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册