首页 文章 精选 留言 我的

精选列表

搜索[创业扶持],共6103篇文章
优秀的个人博客,低调大师

创业公司做数据分析(三)用户行为数据采集系统

作为系列文章的第三篇,本文将重点探讨数据采集层中的用户行为数据采集系统。这里的用户行为,指的是用户与产品UI的交互行为,主要表现在Android App、iOS App与Web页面上。这些交互行为,有的会与后端服务通信,有的仅仅引起前端UI的变化,但是不管是哪种行为,其背后总是伴随着一组属性数据。对于与后端发生交互的行为,我们可以从后端服务日志、业务数据库中拿到相关数据;而对于那些仅仅发生在前端的行为,则需要依靠前端主动上报给后端才能知晓。用户行为数据采集系统,便是负责从前端采集所需的完整的用户行为信息,用于数据分析和其他业务。 举个例子,下图所示是一次营销活动(简化版)的注册流程。如果仅仅依靠后端业务数据库,我们只能知道活动带来了多少新注册用户。而通过采集用户在前端的操作行为,则可以分析出整个活动的转化情况:海报页面浏览量—>>点击”立即注册”跳转注册页面量—>>点击“获取验证码”数量—>>提交注册信息数量—>>真实注册用户量。而前端用户行为数据的价值不仅限于这样的转化率分析,还可以挖掘出更多的有用信息,甚至可以与产品业务结合,比如笔者最近在做的用户评分系统,便会从用户行为中抽取一部分数据作为评分依据。 在早期的产品开发中,后端研发人员每人负责一个摊子,虽然也会做些数据采集的事情,但是基本上只针对自己的功能,各做各的。通常做法是,根据产品经理提出的数据需求,设计一个结构化的数据表来存储数据,然后开个REST API给前端,用来上报数据;前端负责在相应的位置埋点,按照协商好的数据格式上报给后端。随着业务的发展,这样的做法暴露了很多问题,给前后端都带来了混乱,主要表现在:前端四处埋点,上报时调用的API不统一,上报的数据格式不统一;后端数据分散在多个数据表中,与业务逻辑耦合严重。 于是,我们考虑做一个统一的用户行为数据采集系统,基本的原则是:统一上报方式、统一数据格式、数据集中存储、尽可能全量采集。具体到实现上,归纳起来主要要解决三个问题: 采什么。搞清楚需要什么数据,抽象出一个统一的数据格式。 前端怎么采。解决前端如何有效埋点、全量采集的问题。 后端怎么存。解决数据集中存储、易于分析的问题。 采什么 用户在前端UI上的操作,大多数表现为两类:第一类,打开某个页面,浏览其中的信息,然后点击感兴趣的内容进一步浏览;第二类,打开某个页面,根据UI的提示输入相关信息,然后点击提交。其行为可以归纳为三种:浏览、输入和点击(在移动端,有时也表现为滑动)。其中,浏览和点击是引起页面变化和逻辑处理的重要事件,输入总是与点击事件关联在一起。 因此,浏览和点击便是我们要采集的对象。对于浏览,我们关注的是浏览了哪个页面,以及与之相关的元数据;对于点击,我们关注的是点击了哪个页面的哪个元素,与该元素相关联的其他元素的信息,以及相关的元数据。页面,在Android与IOS上使用View名称来表示,在Web页面上使用URL(hostname+pathname)来表示。 元素,使用前端开发中的UI元素id来表示。与元素相关联的其他元素信息,指的是与“点击”相关联的输入/选择信息,比如在上面的注册页面中,与“提交”按钮相关联的信息有手机号、验证码、姓名。元数据,是指页面能提供的其他有用信息,比如URL中的参数、App中跳转页面时传递的参数等等,这些数据往往都是很重要的维度信息。 除了这些页面中的数据信息,还有两个重要的维度信息:用户和时间。用户维度,用来关联同一用户在某个客户端上的行为,采用的方案是由后端生成一个随机的UUID,前端拿到后自己缓存,如果是登录用户,可以通过元数据中的用户id来关联;时间维度,主要用于数据统计,考虑到前端可能延迟上报,前端上报时会加上事件的发生时间(目前大多数正常使用的移动端,时间信息应该是自动同步的)。 综合起来,将前端上报的数据格式定义如下。uuid、event_time、page是必填字段,element是点击事件的必填字段,attrs包含了上述的元数据、与元素相关联的其他元素的信息,是动态变化的。 而针对不同客户端的不同事件,通过不同的REST API来上报,每个客户端只需调用与自己相关的两个API即可。 前端怎么采 整理好数据格式和上报方式后,前端的重点工作便是如何埋点。传统的埋点方式,就是在需要上报的位置组织数据、调用API,将数据传给后端,比如百度统计、google analysis都是这样做的。这是最常用的方式,缺点是需要在代码里嵌入调用,与业务逻辑耦合在一起。近几年,一些新的数据公司提出了“无埋点”的概念,通过在底层hook所有的点击事件,将用户的操作尽量多的采集下来,因此也可以称为“全埋点”。这种方式无需嵌入调用,代码耦合性弱,但是会采集较多的无用数据,可控性差。经过一番调研,结合我们自己的业务,形成了这样几点设计思路: hook底层的点击事件来做数据上报,在上报的地方统一做数据整理工作。 通过UI元素的属性值来设置是否对该元素的点击事件上报。 通过UI元素的属性值来设置元素的关联关系,用于获取上述的“与元素相关联的其他元素的信息”。 我们首先在Web的H5页面中做了实践,核心的代码很简单。第一,在页面加载时绑定所有的click事件,上报页面浏览事件数据。第二,通过user_action_id属性来表示一个元素是否需要上报点击事件,通过user_action_relation属性来声明当前元素被关联到哪个元素上面,具体代码实现不解释,很简单。 上述代码可以嵌入到任何HTML页面,然后只要在对应的元素中进行申明就好了。举个例子, 后端怎么存 数据进入后台后,首先接入Kafka队列中,采用生产消费者模式来处理。这样做的好处有:第一,功能分离,上报的API接口不关心数据处理功能,只负责接入数据;第二,数据缓冲,数据上报的速率是不可控的,取决于用户使用频率,采用该模式可以一定程度地缓冲数据;第三,易于扩展,在数据量大时,通过增加数据处理Worker来扩展,提高处理速率。 除了前端上报的数据内容外,我们还需要在后端加入一些其他的必要信息。在数据接入Kafka队列之前,需要加入五个维度信息:客户端类型(Web/Android/IOS)、事件类型(浏览/点击)、时间、客户端IP和User Agent。在消费者Worker从Kafka取出数据后,需要加入一个名为event_id的字段数据,具体含义等下解释。因此,最后存入的数据格式便如下所示: 再来看event_id的含义。前端传过来的一组组数据中,通过page和element可以区分出究竟是发生了什么事件,但是这些都是前端UI的名称,大部分是开发者才能看懂的语言,因此我们需要为感兴趣的事件添加一个通俗易懂的名称,比如上面的数据对应的事件名称为“在海报页面中注册”。将page+element、事件名称进行关联映射,然后将相应的数据记录id作为event id添加到上述的数据中,方便后期做数据分析时根据跟event id来做事件聚合。做这件事有两种方式:一种是允许相关人员通过页面进行配置,手动关联;一种是前端上报时带上事件名称,目前这两种方式我们都在使用。 最后,来看看数据存储的问题。传统的关系型数据库在存储数据时,采用的是行列二维结构来表示数据,每一行数据都具有相同的列字段,而这样的存储方式显示不适合上面的数据格式,因为我们无法预知attrs中有哪些字段数据。象用户行为数据、日志数据都属于半结构化数据,所谓半结构化数据,就是结构变化的结构化数据(WIKI中的定义),适合使用NoSQL来做数据存储。我们选用的是ElasticSearch来做数据存储,主要基于这么两点考虑: Elasticsearch是一个实时的分布式搜索引擎和分析引擎,具有很强的数据搜索和聚合分析能力。 在这之前我们已经搭建了一个ELK日志系统,可以复用Elasticsearch集群做存储,也可以复用Kibana来做一些基础的数据分析可视化。 Elasticsearch的使用方法可以参考Elasticsearch使用总结一文,这里不做过多讲解。使用Elasticsearch来做数据存储,最重要的是两件事:建立Elasticsearch的映射模板、批量插入。Elasticsearch会根据插入的数据自动建立缺失的index和doc type,并对字段建立mapping,而我们要做的创建一个dynamic template,告诉Elasticsearch如何自动建立,参考如下。批量插入,可以通过Elasticsearch的bulk API轻松解决。 本文作者:Mr-Bruce 来源:51CTO

优秀的个人博客,低调大师

创业公司如何做数据分析(四)ELK日志系统

作为系列文章的第四篇,本文将重点探讨数据采集层中的ELK日志系统。日志,指的是后台服务中产生的log信息,通常会输入到不同的文件中,比如Django服务下,一般会有nginx日志和uWSGI日志。这些日志分散地存储在不同的机器上,取决于服务的部署情况了。如果我们依次登录每台机器去查阅日志,显然非常繁琐,效率也很低,而且也没法进行统计和检索。因此,我们需要对日志进行集中化管理,将所有机器上的日志信息收集、汇总到一起。完整的日志数据具有非常重要的作用: 信息查找。通过检索日志信息,定位相应的bug,找出解决方案。 服务诊断。通过对日志信息进行统计、分析,了解服务器的负荷和服务运行状态,找出耗时请求进行优化等等。 数据分析。如果是格式化的log,可以做进一步的数据分析,统计、聚合出有意义的信息,比如根据请求中的商品id,找出TOP10用户感兴

优秀的个人博客,低调大师

创业企业如何选择To B产品——法大大电子合同云平台

本文转载自拓扑社。 档案主角:法大大 店铺地址:https://market.aliyun.com/store/1769028.html 简介:“法大大”是国内领先的第三方电子合同平台,目前主要为金融、保险、第三方支付、旅游、房地产、物流、B2B、B2C、HR等企业及个人用户提供电子合同、电子文件签署及存证服务,同时整合提供司法鉴定、网络仲裁和律师服务。法大大目前已通过ISO27001安全认证并获得众安保险承保,用户量超过1000万(截止2017年2月)。因其便捷、安全、合规的特性,目前法大大的产品和服务已被阿里巴巴、微软(中国)、携程、同程旅游、众安保险、美团网、51社保、金蝶云之家、积木盒子、投哪网、房多多等众多知名平台所采用。 融资轮次:B轮 采访对象:副总裁 林希婧 团队使用的toB领域产品 云服务:使用 阿里云。阿里云的安全机制与数

优秀的个人博客,低调大师

贝佐斯重返 CEO 角色,启动新 AI 创业项目 “Prometheus”

《纽约时报》报道称,亚马逊创始人杰夫・贝索斯在辞去亚马逊 CEO 职位四年后,决定重返 CEO 岗位,担任一家新成立的人工智能初创企业 ——“Project Prometheus” 的联席首席执行官。该项目的另一位创始人和联席 CEO 是知名科技高管维克・巴贾杰,他曾在谷歌的 “月球 shot 工厂” 任职,并创立了健康科技公司 Verily。 “Project Prometheus” 专注于为各个领域的工程和制造业开发人工智能技术。据了解,这家初创公司已经获得了高达 62 亿美元的融资,这一金额超过了许多企业在其一生中能够筹集到的资金。尽管尚不清楚这家公司成立的具体时间,但目前已招募了约 100 名员工,其中不少来自 OpenAI、DeepMind 和 Meta 等知名公司。 关于 “Project Prometheus” 的详细信息仍然有限,贝索斯也未透露公司的具体所在地以及其技术的运作方式。尽管贝索斯多年来一直积极参与其航天公司蓝色起源的运营,但这次他重返 CEO 角色标志着他自离开亚马逊以来首次担任正式职务。 如今,贝索斯和巴贾杰将加入竞争激烈的人工智能市场,随着巨额资金源源不断地流入 OpenAI 等竞争对手,业界对人工智能行业的财务可持续性也开始产生疑虑。知名投资者迈克尔・伯里最近在预测到 2008 年住房危机后,选择以 10 亿美元的资金押注 Palantir 和 Nvidia 股票下跌,并指责一些大型科技公司利用会计技巧 “人为地提高收益”。

优秀的个人博客,低调大师

尤雨溪创业公司 VoidZero 完成 1250 万美元 A 轮融资 ​​​​

知名开源前端框架 Vue 作者尤雨溪创办的 VoidZero 公司宣布完成1250 万美元 A 轮融资。 本轮由 Accel 领投,参与方还有 Peak XV Partners、 Sunflower Capital、Koen Bok(Framer)以及 Eric Simons(StackBlitz)等。 VoidZero 去年已完成种子轮融资,用于验证能否构建一个“更快、更易用、开发者体验(DX)更好”的 JavaScript 工具链。在种子阶段验证成功后,本轮融资主要用于 “加速”发展:团队扩张、开发周期加快、提升研发效率。 尤雨溪介绍称,借助团队努力,VoidZero 在其开源项目上取得了如下成绩: Vite 的每周下载量已超过 Webpack Vitest 的 Browser 模式(Browser Mode)已稳定 Rolldown 每周下载量达到 100 万次 Oxlint 增加了类型感知(type-aware)linting 和自定义 JavaScript 插件 此外,他们提到最近推出了 Vite+ —— 一个统一的 JavaScript 工具链,目前处于私测阶段(private beta)。融资将使得 Vite+ 的稳定版本发布时间提早。

优秀的个人博客,低调大师

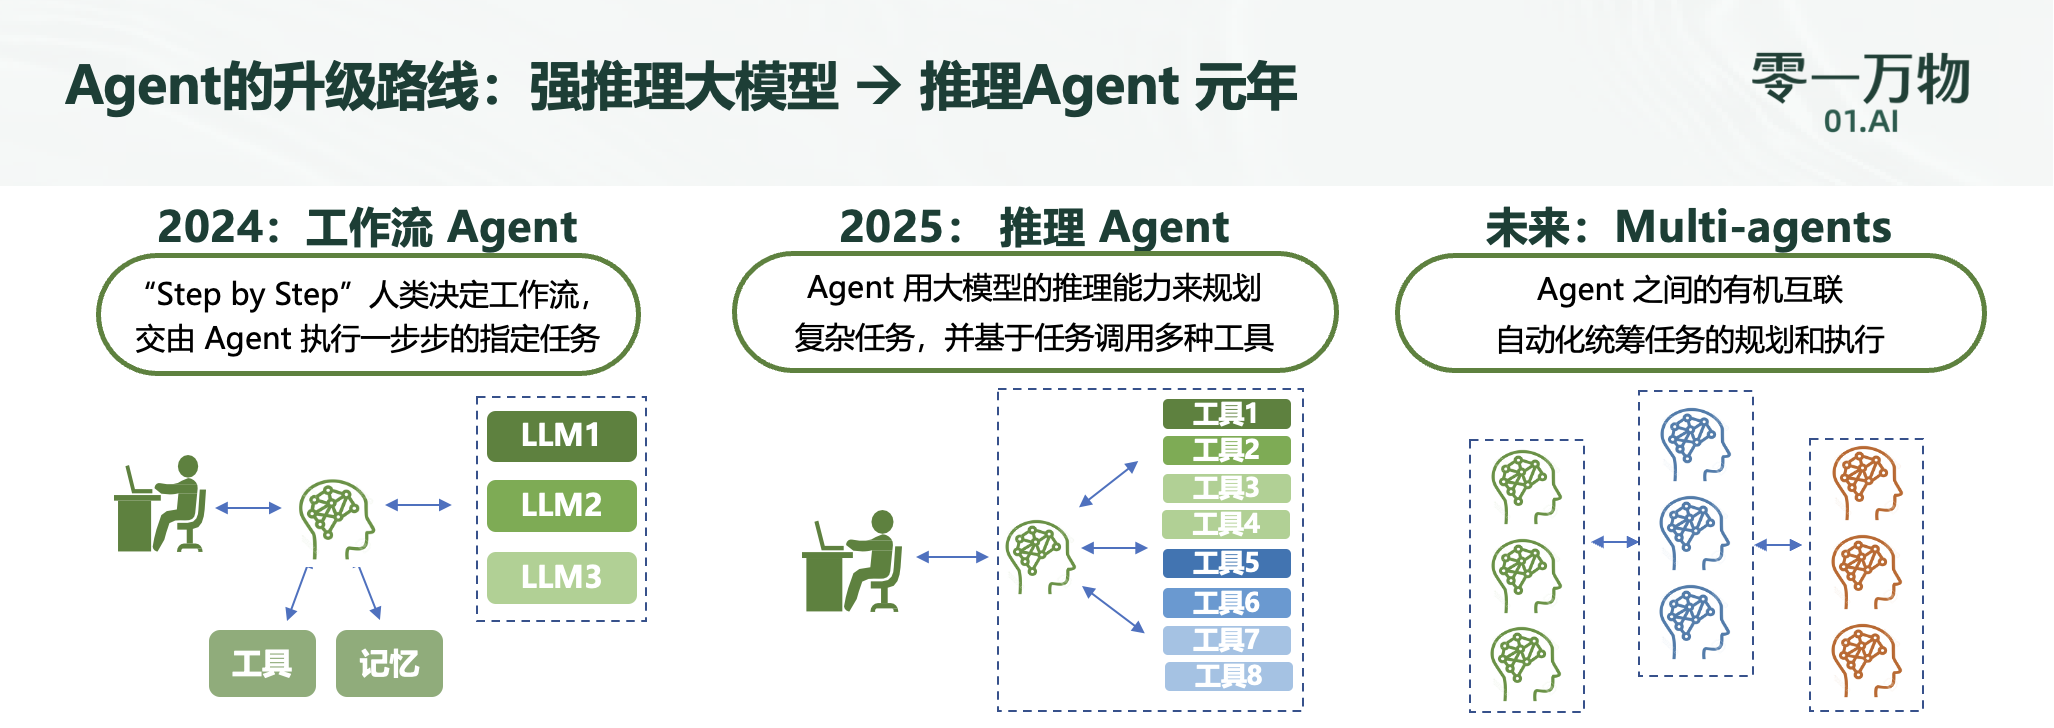
李开复 AI 创业公司发布下首个智能体(AI Agent)产品

7月22日,零一万物在北京举办产品发布会,正式发布万智企业大模型一站式平台(万智平台)2.0版本,并推出企业级Agent智能体(代号“万仔”),以“超级员工”为核心定位,具备深度思考和任务规划能力,可访问手机和Web端,连接各类企业服务,帮助企业基于自身业务场景定制专属Agent,解决真实问题。 万智企业级Agent通过自研强化学习和全栈研发工程技术栈,提升任务规划能力,结合企业知识库和生产任务,以交付结果为目标动态生成执行计划,实现“从工具流执行者”向“人机共同决策者”的跃迁,并支持私有化部署和结果校验,确保业务数据与安全无忧。 零一万物CEO李开复表示,企业级Agent已步入推理Agent阶段,与OpenAI最新发布的ChatGPT Agent处于同一技术水位,推动中国大模型产业从“交付服务”迈向“交付结果”的产业AI时代。 对于目前AI Agent的发展路径,李开复预计会经历三个演进层级: L1:工作流Agent:这一阶段由人类主导任务的规划与决策流程,Agent仅按指令一步步执行指定动作。虽然实现了任务自动化的初步落地,但其智能化程度有限,本质仍为强化版的“RPA(机器人流程自动化)”或“Co-pilot”,难以应对企业中复杂多变、跨环节的任务。 L2:推理Agent:Agent具备基于大模型的任务规划能力,能通过推理机制自主判断任务步骤,调度多种工具完成复杂目标。此阶段的Agent不再依赖人类指定的流程,而是能“想清楚再做”,具备真正的任务闭环执行能力。 L3:多智能体 Multi-Agents:多个AI Agent之间实现有机协作,自主进行任务分配、资源调度与协同优化。这一阶段将彻底重构企业运作范式,形成真正的去中心化智能协作网络,是Agent发展的进阶形态与行业变革的关键临界点。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册