首页 文章 精选 留言 我的

精选列表

搜索[Python环境],共10000篇文章
优秀的个人博客,低调大师

微服务网关Zuul在EDAS环境的实践

问题起因 最近参与的一个项目,客户基于EDAS开发的微服务应用,应用间提供的都是Restful接口。 总所周知,EDAS是基于内部HSF接口的分布式服务框架,HSF的特点是服务调用者和服务提供者直接连接,不经过网关层转发,HSF接口无需引入网关层,EDAS会承担服务注册与服务发现功能,服务调用时由HSF-Client根据从configserver推送过来的服务提供方ip,直接发起调用。 但是后端的微服务应用提供Restful接口的话,不可能把每一个微服务所提供的Restful接口都直接暴露给前端应用,这样的话,前端应用需要知道每个微服务的vip、端口、请求path,这么做并不友好。这里需要引入一个网关层,前端应用发起请求到网关,由网关根据请求url智能转发到后端不同的微服务应用处理。 调研过程 调研了相关的产品,有几个备选方案:1)Ngin

优秀的个人博客,低调大师

Intellij idea配置Spark开发环境,统计哈姆雷特词频(2)

idea 新建maven 项目 输入maven坐标 maven 坐标 编辑maven文件 Spark 体系 中间层Spark,即核心模块Spark Core,必须在maven中引用。 编译Spark还要声明java8编译工具。 <properties> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-core_2.11</artifactId> <version>2.1.0</version> </dependency> </dependencies> <build> <plugins> <plugin> <artifactId>maven-compiler-plugin</artifactId> <configuration> <source>${java.version}</source> <target>${java.version}</target> </configuration> </plugin> </plugins> </build> idea自动加载引用,在窗口左侧Project导航栏-->External Libraries中看到引用org.apache.spark中spark-core_2.11-2.1.0.jar文件。 idea Externel Libraries 注:Spark Streaming是流式计算框架、SparkSQL数据库工具、Mlib机器学习框架、GraphX图计算工具。 Java 8 lambda函数风格的wordCount //定义单词总数累加器、和停用词累加器 Accumulator countTotal = jsc.accumulator(0); Accumulator stopTotal = jsc.accumulator(0); // 文件初始化RDD JavaRDD<String> stopword = jsc.textFile("data/text/stopword.txt"); JavaRDD<String> rdd = jsc.textFile("data/text/Hamlet.txt"); // RDD 转换为List List<String> stopWordList = stopword.collect(); // Broadcast 广播变量,task共享executor的变量 Broadcast<List<String>> broadcastedStopWordSet = jsc.broadcast(stopWordList); rdd.filter(l->l.length()>0) .flatMap(l-> Arrays.asList(l.trim().split(" ")).iterator()) // 将line分割展成词向量,词向量在连接,返回Rdd<String> .map(v->v.replaceAll("['.,:;?!-]", "").toLowerCase()) // 特殊字符处理, Rdd<String> .filter(v->{ boolean isStop = false; countTotal.add(1); if(broadcastedStopWordSet.value().contains(v)){ stopTotal.add(1); isStop = true; } return !isStop; }) //遍历总数计数、停用词计数,过滤停止词, Rdd<String> .mapToPair(v-> new Tuple2<>(v,1)) .reduceByKey((v1,v2)->v1+v2) //统计个数 .mapToPair(p-> new Tuple2<>(p._2,p._1)) .sortByKey(false) //排序 .take(10).forEach(e->{ System.out.println(e._2+":"+e._1); }); 将line分割展成词向量,词向量连接,flatmap返回Rdd<String> 特殊字符处理,返回 Rdd<String> 遍历总数计数、停用词计数,过滤停止词, 返回Rdd<String> Reduce Rdd<String,1>,返回Rdd<String,total> 排序 SortByKey,返回 Rdd<String,total> 后期有更多案例介绍Java 8 lambda风格的RDD开发


优秀的个人博客,低调大师

检查多云数据管理环境中的所有因素

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 随着人们创建和存储数字对象的能力的增强,这些数据的可用性却随着时间的推移而下降。人们希望通过长期数字保存(LTDP)来保持持久价值的数字信息的可访问和可用性,以应对过时的软件和硬件,以及精确呈现内容的这些挑战。 此外,世界各国政府强制实施“云计算优先”政策,以及各行业厂商和用户从云计算解决方案中获得的收益,使得云计算中的长期数字保存(LTDP)技术成为数字图书馆和档案馆可行的考虑因素和具有吸引力的替代选择。通过利用云计算的可扩展性、冗余性、成本效益,以及对数字保存不断变化的需求的适应性,长期数字保存(LTDP)可以从云计算技术中大大受益。 在过去几年中,多种云计算产品的使用已经从“影子IT”实践中有机地发展而来,客户发现他们需要解决其已有问题的解决方案。在这个关键时刻,越来越多的客户对云计算服务的使用有着更好的体验和理解,促使他们探索和实施多云策略。也就是说,重要的是他们需要寻找值得信赖的技术合作伙伴以及专业知识、技术诀窍和解决方案,以确保上述原则得到解决。 多云是超越混合云的云计算IT架构的又一次飞跃。它指的是同时使用多个公共云提供商的公共云和本地私有云的资源,以实现某些业务目标和指标的IT设计,这些目标和指标很难通过企业的内部部署和/或混合云设计实现。这些优势包括:自由选择跨公共云提供商挑选***云服务,数据移动性无需担心供应商锁定,通过跨多个云架构分布的数据集增强数据可用性和持久性,并能够针对不同供应商的每个应用程序使用最合适的云定价方案,从而优化成本。简而言之,这些因素让云计算客户掌握了充分的杠杆作用和控制力,助长了多云增长的势头。 尽管当今企业的大多数数据仍然来自并存储在本地存储解决方案中,但许多行业都出现了用于多云数据管理的用例。例如,在媒体和娱乐公司中,利用对象存储在内部部署私有云中创建内容非常普遍,但是用于内容分发(CDN)的公共云服务或计算代码转换的使用正在增长。在金融服务行业中,对内部存储的需求仍然提供***的安全性、控制和性能,但公共云为场外合规性和长期存档目的(如AWS Glacier和Microsoft的Azure Blob存储归档层)提供了引人注目的解决方案。此外,用于分析的云计算服务(如Amazon QuickSight或Azure机器学习)还提供了其他用于公共云的增值服务。 上面概述的多云优势取决于企业必须遵守的原则。以下是一个简便的清单,可以用于确定企业的云存储选择对于支持其长期数字保存策略的适用程度: 通过标准化的对象和文件界面对所有云平台中的数据访问、控制和安全进行规范化处理,事实上的对象选择是Amazon S3 API,文件选择是NFS和SMB。 确保数据始终保持其开放的云原生格式,并且在任何地方都不具有透明度,因此可以在任何地方访问,并可根据需要自由移动。 透明的数据代理能力,允许数据根据预定义的业务策略自动放置和移动。 跨云体系结构的动态索引和搜索功能,以便可以在任何给定时间发现并采取行动的数据。 最重要的是,遵循管理组织内许多云平台的***实践。 如果组织缺乏成熟性、纪律性或遵守上述原则的能力,那么采用多云将毫无益处。而一旦被锁定到任何供应商或技术中,就很难改变。 如果没有正确实施或没有合理的保障措施,采用多云可能会加剧云客户面临的问题和挑战,如增加数据管理的复杂性和开销,降低数据访问和使用方式的灵活性、控制和跟踪数据放置的位置,以及在多个云上存放不必要的副本而增加成本。 企业在部署多云存储时需要注意一些挑战。由于跨公共云和网关产品的专有存储格式的锁定,真正的混合云存储尚未通过当今的网关和云备份解决方案实现。尽管当前的解决方案可以实现从内部部署到云端的数据移动和分层,但是他们并没有通过允许云服务访问存储在其中的数据来真正利用云计算的力量。相反,这些产品是“单向”的解决方案,迫使应用程序使用网关访问数据,而无论其是在本地部署数据中心还是在云端。由于无法在此数据上使用本地云服务,因此这会损失公共云的关键价值。因此,业界需要一个能从根本上改变混合云存储和数据管理的解决方案,为客户提供本地存储和公共云的全部功能和灵活性。 多云正在成为云计算应用的常态,将成为市场主流。展望未来,企业将需要一种从根本上改变云存储和数据管理的解决方案,为客户提供内部存储和公共云的全部功能和灵活性,以便他们不仅可以从数据中获得***的价值,也获得***的***体验。这种新型多云数据控制器解决方案的兴起将为跨不同云平台的代理和管理信息提供帮助。

优秀的个人博客,低调大师

自己动手搭建一个简易的SpringBoot环境

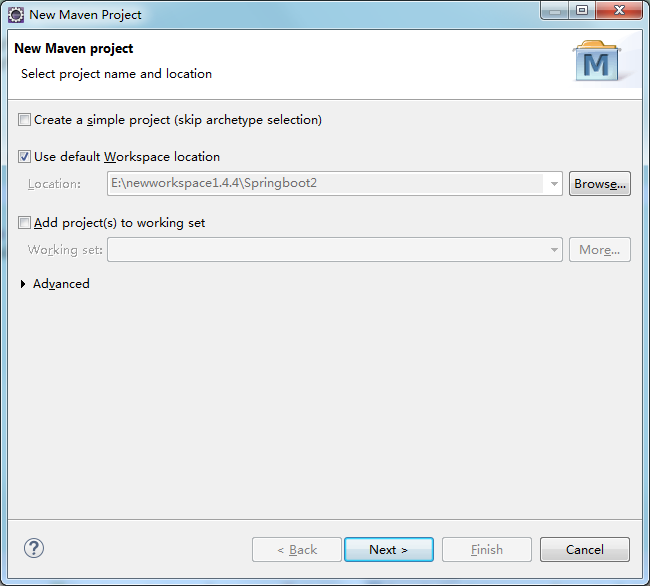
什么是springboot? Spring Boot俗称微服务。Spring Boot是由Pivotal团队提供的全新框架,其设计目的是用来简化新Spring应用的初始搭建以及开发过程。该框架使用了特定的方式来进行配置,从而使开发人员不再需要定义样板化的配置。通过这种方式,Spring Boot致力于在蓬勃发展的快速应用开发领域(rapid application development)成为领导者。 1, 新建一个maven工程 先选择workspace 点击【next】 直接默认,再点击【next】 填写groupid等~然后【finish】,到这里整个新建工程结束。 2,引入相关的jar包 1 <parent> 2 <groupId>org.springframework.boot</groupId> 3 <artifactId>spring-boot-starter-parent</artifactId> 4 <version>1.5.8.RELEASE</version> 5 </parent> 6 <dependencies> 7 <dependency> 8 <groupId>org.springframework.boot</groupId> 9 <artifactId>spring-boot-starter-web</artifactId> 10 </dependency> 11 </dependencies> 这里说明下看似我们只引用了2个jar包其实里面包含了很多东西,像spring-boot-starter-web 我们通过压缩包打开后 查看里面的pom文件可以看到如下所示的内容,它引用了很多jar像spring的web,还有json的jar包都包含在内了 1 <dependencies> 2 <dependency> 3 <groupId>org.springframework.boot</groupId> 4 <artifactId>spring-boot-starter</artifactId> 5 </dependency> 6 <dependency> 7 <groupId>org.springframework.boot</groupId> 8 <artifactId>spring-boot-starter-tomcat</artifactId> 9 </dependency> 10 <dependency> 11 <groupId>org.hibernate</groupId> 12 <artifactId>hibernate-validator</artifactId> 13 </dependency> 14 <dependency> 15 <groupId>com.fasterxml.jackson.core</groupId> 16 <artifactId>jackson-databind</artifactId> 17 </dependency> 18 <dependency> 19 <groupId>org.springframework</groupId> 20 <artifactId>spring-web</artifactId> 21 </dependency> 22 <dependency> 23 <groupId>org.springframework</groupId> 24 <artifactId>spring-webmvc</artifactId> 25 </dependency> 26 </dependencies> 3,编写程序入口类 1 package com.springbooot2; 2 3 import org.springframework.boot.SpringApplication; 4 import org.springframework.boot.autoconfigure.SpringBootApplication; 5 6 /** 7 * Hello world! 8 * 9 */ 10 @SpringBootApplication 11 public class App 12 { 13 14 public static void main(String[] args) throws Exception { 15 SpringApplication.run(App.class, args); 16 } 17 } 这里说明下,@SpringBootApplication 就是为了让spring扫描识别,告诉他我是一个程序入口类。 4,编写请求响应类 1 package com.springbooot2; 2 3 4 import org.springframework.stereotype.Controller; 5 import org.springframework.web.bind.annotation.RequestMapping; 6 import org.springframework.web.bind.annotation.ResponseBody; 7 8 @Controller 9 public class FristBlood { 10 @RequestMapping("/FristBlood") 11 @ResponseBody 12 public String hello() { 13 return "dont worry,be happy!<br/><br/> <input type=\"submit\" value=\"ok\" />"; 14 } 15 } 这里说明下 @Controller 请求处理控制器类。 @RequestMapping 熟悉spring的都应该不陌生,这是spring的东西,url映射。 @ResponseBody 响应方法,我们的响应信息都会被自动转化为json信息返回给前台页面 到这里整个代码就撸完了,比起我们之前搭建一个ssh或者ssm之类的框架简单了不少,如果我们有那种只需要发送一个邮件啊。或者简单的服务,用springboot可以说很方便了。 5,测试代码 启动程序,打开浏览器,输入:http://localhost:8080/FristBlood 请求页面响应结果如下图 give me the ball!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册