首页 文章 精选 留言 我的

精选列表

搜索[python],共10000篇文章
优秀的个人博客,低调大师

Python高级知识点学习(九)

并发、并行,同步、异步,阻塞、非阻塞 并发、并行 并发是在一个时间段内,有几个程序在同一个cpu上运行,但是任意时刻只有一个程序在cpu上运行。 并行是任意时刻点上,有多个程序同时运行在多个cpu上。 同步、异步 同步是指代码调用IO操作时,必须等待IO操作完成才返回的调用方式。 异步是指代码调用IO操作时,不必等待IO操作完成就返回的调用方式。 阻塞、非阻塞 阻塞是指调用函数时候当前线程被挂起。 非阻塞是指调用函数时候当前线程不会被挂起,而是立即返回。 阻塞和非阻塞的概念和同步异步感觉很像,但是其实它们之间是有区别的。 区别: 同步和异步实际上是消息通信的一种机制,可以把IO操作看做一个消息,调用IO操作时,相当于发一个消息给另外一个线程(或者说另外一个协程),让它去执行某些操作,在提交数据之后立刻得到future,后边就可以通过future拿到结果,实际上是消息之间的通信机制。 阻塞和非阻塞是不同于同步异步的,它是函数调的一种机制。 IO 多路复用 (select、poll 和 epoll) unix中五种I/O模型 阻塞式I/O 非阻塞式I/O I/O复用 信号驱动式I/O (用的比较少) 异步I/O (POSIX的aio_系列函数) 以上五种是递进式的发展。 I/O多路复用: select方法也是阻塞的方法,select本身是阻塞式的,select可以监听多个文件句柄和socket,select在某一个文件句柄或者socket准备好的话就会返回,这时候立刻可以做业务逻辑处理。 I/O多路复用带来的好处是: 比如现在同时发起了100个非阻塞式的请求,这时候直接使用select去监听这100个socket,这样的话一旦有一个发生状态变化,我们就可以立马处理它。 I/O多路复用中,将数据从内核复制到用户空间这段时间消耗还是省不了。 异步IO: 这里的异步IO是真正意义上的异步IO(aio),我们现在接触到很多高并发框架实际上都没有使用异步IO,实际上在很大程度上使用的都是io多路复用技术,IO多路复用很成熟很稳定,异步IO对于IO多路复用性能提升并没有达到很明显的程度,但是编码难度有很大提升,所以当前情况下IO多路复用用的比较多。 异步IO节省掉了数据从内核拷贝到用户空间这一步骤。 select、poll、epoll: select、poll、epoll都是I/O多路复用的机制。 I/O多路复用就是通过一种机制,一个进程可以监视多个描述符,一旦某个描述符就绪(一般就是读就绪或写就绪),能够通知程序进行相应的读写操作。 但select、poll、epoll本质上都是同步I/O,因为它们都需要在读写事件就绪后自己负责进行读写(数据从内核拷贝到用户区),也就是说这个读写过程是阻塞的,而异步I/O则无需自己负责进行读写,异步I/O的实现会负责把数据从内核拷贝到用户空间。 select是什么? select 函数监视的文件描述符分三类,分别是writefds、readfds、exceptfds。调用select后会阻塞,直到有描述符就绪(有数据可读、可写、或者有except),或者超时(timeout指定等待时间,如果立即返回设为null即可),函数返回。当select函数返回后,可以通过遍历fdset来找到就绪的描述符。 select目前几乎在所有的平台上支持,其良好的跨平台也是它的一个优点。select的一个缺点在于单个进程监视的文件描述符的数量有最大限制,在linux上一般为1024,可以通过修改宏定义甚至重新编译内核的方式提升这一性质,但是这样也会造成效率的降低。 poll是什么? 不同于select使用三个位图来表示三个fdset的方式,poll使用一个pollfd的指针实现。pollfd结构包含了要监视的event和发生的event,不再使用select "参数-值" 传递的方式。同时,pollfd并没有最大数量限制(但是数量过大性能也会下降)。和select函数一样,poll返回后,需要轮询pollfd来获取就绪的描述符。 从上面看,select和poll都需要在返回后,通过遍历文件描述符来获取已经就绪的socket。事实上,同时连接的大量客户端在一时刻可能只有很少的处于就绪的状态,因此随着监视的描述符数量的增长,其效率也会线性下降。 epoll是什么? epoll是在2.6内核中提出的,epoll是之前的select和poll的增强版本。相对于select和poll来讲,epoll更加灵活,没有描述符限制。epoll使用一个文件描述符管理多个描述符,将用户关系的文件描述符的事件存放到内核的一个事件表中,这样在用户空间和内核空间的copy只需要一次。 epoll它的查询使用了数据结构中性能很高的一个:红黑树。 nginx就是使用了epoll。 epoll并不代表一定比select好: 在并发高的情况下,连接活跃度不是很高, epoll比select。 并发性不高,同时连接很活跃, select比epoll好。 非阻塞I/O实现http请求 上示例代码: import socket from urllib.parse import urlparse def get_url(url): # 通过socket请求html url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 这里会导致后边抛异常,但是连接请求已经发出去了 client.setblocking(False) # 捕获异常 try: client.connect((host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass # 不停的询问连接是否建立好, 需要while循环不停的去检查状态 # 做计算任务或者再次发起其他的连接请求 while True: try: client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) break except OSError as e: pass data = b"" while True: # 这里还会抛异常,读不到就继续读 try: d = client.recv(1024) except BlockingIOError as e: continue if d: data += d else: break data = data.decode("utf8") html_data = data.split("\r\n\r\n")[1] #打印返回的数据 print(html_data) client.close() if __name__ == "__main__": get_url("http://www.baidu.com") 非阻塞I/O整个过程依赖前后的监测,整个过程不停的做while循环检测状态,但是返回时间没有变,所以并没有提高并发。 select+回调+事件循环实现http请求 目前开源的高性能框架,一般都是使用这种方式实现并发。 使用select + 回调 + 事件循环实现下载网页,并发性高且是单线程。 select方法本尊是在import select这个包里边,但是有另外一个包把select基础上进行了封装,用起来更简单:from selectors import DefaultSelector,DefaultSelector一般使用DefaultSelector这个比较多。 看代码示例: import socket import time from urllib.parse import urlparse from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE selector = DefaultSelector() urls = [] stop = False class Fetcher: def connected(self, key): selector.unregister(key.fd) self.client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(self.path, self.host).encode("utf8") selector.register(self.client.fileno(), EVENT_READ, self.readable) # 当socket可读时,读数据,全部都是cpu操作 def readable(self, key): d = self.client.recv(1024) if d: self.data += d else: # 数据读完为空 selector.unregister(key.fd) data = self.data.decode("utf8") html_data = data.split("\r\n\r\n")[1] print(html_data[:30]) self.client.close() urls.remove(self.spider_url) if not urls: global stop stop = True def get_url(self, url): self.spider_url = url url = urlparse(url) self.host = url.netloc self.path = url.path self.data = b"" if self.path == "": self.path = "/" # 建立 socket 连接 self.client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) self.client.setblocking(False) try: self.client.connect((self.host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass selector.register(self.client.fileno(), EVENT_WRITE, self.connected) # 驱动整个事件循环 def loop(): while not stop: ready = selector.select() for key, mask in ready: call_back = key.data call_back(key) if __name__ == "__main__": # 计时开始 start_time = time.time() for url in range(60): url = "http://www.baidu.com" urls.append(url) fetcher = Fetcher() fetcher.get_url(url) loop() print(time.time()-start_time) 上边代码中,Fetcher类包含三个方法,get_url简历socket连接,connected和readable是两个回调函数。 loop函数负责驱动整个事件循环。 回调的缺点 可读性差 共享状态异常处理 异常处理困难

优秀的个人博客,低调大师

Python高级知识点学习(七)

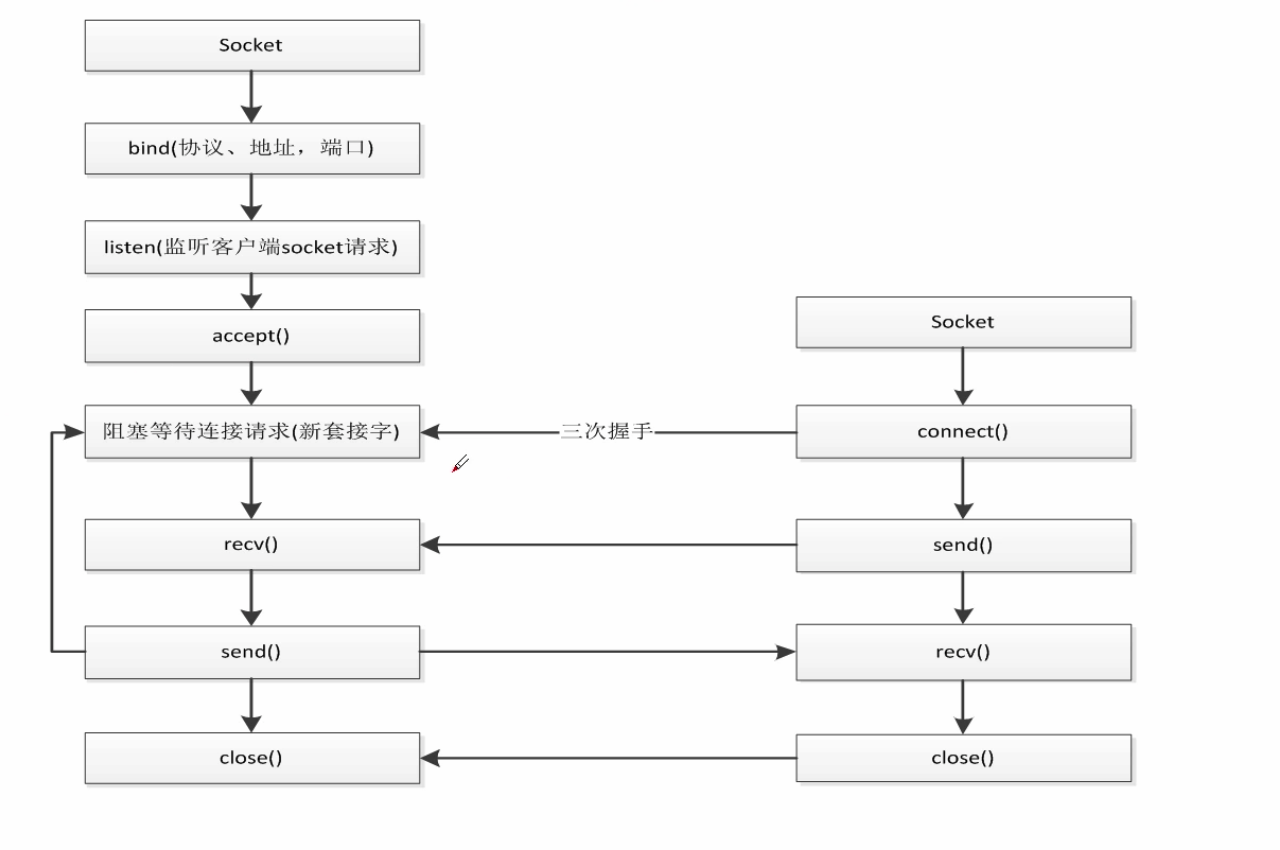
HTTP、Socket、TCP概念 socket属于常用的http协议之下的让我们可以使用tcp/ip协议的一个接口。 socket编程 image.png socket编程的模式其实是非常固定的。 上图: 左侧server端 右侧client端 server必须是随时处于一个监听的状态和服务的状态,因为不知道客户端什么时候会发送来请求。 绑定协议、地址、端口。 每一个应用程序只能占用一个端口,服务器a到服务器b发数据时,数据是不知道是由哪个应用程序接受的,这时候就需要端口机制,每一个应用程序提供一个端口。 socket连接后,只要不关闭连接,服务端可以一直给客户端发送请求,但是在http中,只完成一次发送数据就停止了。 编写测试代码: 新建文件sever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 绑定ip 端口 server.bind(('0.0.0.0', 8000)) # 监听 server.listen() sock, addr = server.accept() # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) # 给client发数据 sock.send("hello".encode("utf8")) # 关闭 server.close() sock.close() 新建文件client.py import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) # 给server端发数据 client.send("allen".encode("utf-8")) # 接受server端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) # 关闭 client.close() 首先运行server.py,再运行client.py,观察打印结果,可以看到,数据发送接收已经是实现。 socket实现简单聊天 要实现双向交流,肯定不能做close操作,改为一直while循环, 代码: 修改srever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(("0.0.0.0", 8000)) server.listen() sock, addr = server.accept() while True: # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) re_data = input() # 给client发数据 sock.send(re_data.encode("utf8")) 修改client.py: import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) while True: # 输入消息 re_data = input() client.send(re_data.encode("utf8")) # 接受client端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) 运行server.py ,再运行client.py,在client.py中输入要发送的文字,在server.py中观察接收到的文字,再在server.py中发送文字,在client.py中查看。 以上就是实现了最初级的基本聊天过程。 如果要在网页上做一个聊天模块,一般都是需要用web socket来实现。 socket多用户聊天 所谓多用户聊天,其实平时我们也经常遇到。 假如你是一位线上客服人员,你需要接待的人员可能同时有多位,当你和A用户聊天时,并不妨碍和B用户C用户给你发消息,而你回消息,回给A用户的消息只有A用户可以看到,B用户是看不到的,接着看如何实现这种功能。 首先client.py的代码不用改动,只需修改server.py: import socket import threading server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(('0.0.0.0', 8000)) server.listen() def handle_sock(sock, addr): while True: data = sock.recv(1024) print(data.decode("utf8")) re_data = input() sock.send(re_data.encode("utf8")) while True: sock, addr = server.accept() #用线程去处理新接收的连接(用户) client_thread = threading.Thread(target=handle_sock, args=(sock, addr)) client_thread.start() 上边代码把接受处理逻辑放到了线程中,每一个线程存放一个不同的socket,主线程来查看有哪些线程进入。 运行server.py,再运行多个client.py,client.py给server发消息,测试可发现可实现上边的客服功能。 注:真正客服系统要比这个复杂得多,以上代码仅供测试。 socket模拟http请求 我们平常所用到的requests包,是基于 urllib,urllib实际上是基于socket上来完成的。 requests - urlib - socket 如何通过socket去完成类似urllib中http请求呢? http请求无非就是在tcp协议之上加了一些协议,只要按照这个协议发,就会返回数据。 看代码: import socket from urllib.parse import urlparse def request_demo(url): # url拆分 url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect((host, 80)) client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) data = b"" # 每次读取1024大小,循环知道读取完毕 while True: d = client.recv(1024) if d: data += d else: break data = data.decode("utf8") print(data) client.close() if __name__ == "__main__": url = 'http://www.baidu.com' request_demo(url) 运行结果包含两部分: 第一部分request header 第二部分html源码 建立连接的过程是比较费时的,一般在使用socket编程都是为了解决长连接的问题,而不是说每发送一个请求数据返回就把它关掉。 很多时候我们需要一个交互的过程,这时候socket就派上用场了,有了socket后我们的代码灵活性高,它完全可以让我们将整个过程变得可以操控。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册