首页 文章 精选 留言 我的

精选列表

搜索[mapreduce],共3590篇文章
优秀的个人博客,低调大师

hadoop 原生MapReduce 实现数据连接

其实很简单,输入两个文件,一个作为基础数据(学生信息文件),一个是分数信息文件。 学生信息文件:存放学生数据:包括学号,学生名称 分数信息数据:存放学生的分数信息:包括学号,学科,分数。 我们将通过M/R实现根据学号,进行数据关联,最终结果为:学生名称,学科,分数。 模拟数据 学生数据 [hadoop@hadoop11 student_data]$ cat students.txt 1 Randy 2 Tom 3 kitty 4 Lucy 5 Lily 6 Bruce 7 King 8 Jay 9 Melody 10 Kimy ///////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////// 分数数据 [hadoop@hadoop11 student_data]$ cat scores.txt 1 English 89 2 English 77 3 English 54 4 English 98 5 English 83 6 English 99 7 English 30 8 English 76 9 English 56 10 English 88 1 Math 79 2 Math 37 3 Math 65 4 Math 88 5 Math 89 6 Math 59 7 Math 60 8 Math 86 9 Math 56 10 Math 68 1 China 89 2 China 67 3 China 84 4 China 68 5 China 43 6 China 89 7 China 70 8 China 96 9 China 56 10 China 78 /////////////////////////////////////////////////////////////////////////////////////////////////////// 实现 1)两个文本解析器,分别解析两个文本文件。 本文转自 randy_shandong 51CTO博客,原文链接:http://blog.51cto.com/dba10g/1565697,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop体系结构之 Mapreduce

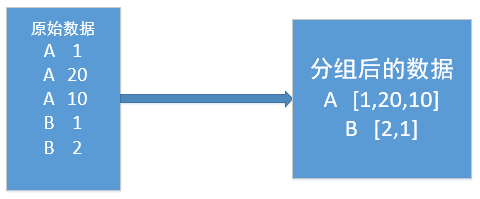
MR框架是由一个单独运行在主节点上的JobTracker和运行在每个集群从节点上的TaskTracker共同组成。主节点负责调度构成一个作业的所有任务,这些任务分布在不同的不同的从节点上。主节点监视它们的执行情况,并重新执行之前失败的任务。从节点仅负责由主节点指派的任务。当一个Job被提交时,JobTracker接受到提交作业和配置信息之后,就会将配置信息等分发给从节点,同时调度任务并监控TaskTracker的执行。JobTracker可以运行于集群中的任意一台计算机上。TaskTracker负责执行任务,它必须运行在DataNode上,DataNode既是数据存储节点,也是计算节点。JobTracker将map任务和reduce任务分发给空闲的TaskTracker,这些任务并行运行,并监控任务运行的情况。如果JobTracker出了故障,JobTracker会把任务转交给另一个空闲的TaskTracker重新运行。 Hadoop上的并行应用程序开发是基于MR编程框架。MR编程模型原理:利用一个输入的key-value对集合来产生一个输出的key-value对集合。MR库通过Map和Reduce两个函数来实现这个框架。用户自定义的map函数接受一个输入的key-value对,然后产生一个中间的key-value对的集合。MR把所有具有相同的key值的value结合在一起,然后传递个reduce函数。Reduce函数接受key和相关的value结合,reduce函数合并这些value值,形成一个较小的value集合。通常我们通过一个迭代器把中间的value值提供给reduce函数(迭代器的作用就是收集这些value值),这样就可以处理无法全部放在内存中的大量的value值集合了。 流程简而言之,大数据集被分成众多小的数据集块,若干个数据集被分在集群中的一个节点进行处理并产生中间结果。单节点上的任务,map函数一行行读取数据获得数据的(k1,v1),数据进入缓存,通过map函数执行map(基于key-value)排序(框架会对map的输出进行排序)执行后输入(k2,v2)。每一台机器都执行同样的操作。不同机器上的(k2,v2)通过merge排序的过程(shuffle的过程可以理解成reduce前的一个过程),最后reduce合并得到,(k3,v3),输出到HDFS文件中。 谈到reduce,在reduce之前,可以先对中间数据进行数据合并(Combine),即将中间有相同的key的<key,value>对合并。Combine的过程与reduce的过程类似,但Combine是作为map任务的一部分,在执行完map函数后仅接着执行。Combine能减少中间结果key-value对的数目,从而降低网络流量。 Map任务的中间结果在做完Combine和Partition后,以文件的形式存于本地磁盘上。中间结果文件的位置会通知主控JobTracker,JobTracker再通知reduce任务到哪一个DataNode上去取中间结果。所有的map任务产生的中间结果均按其key值按hash函数划分成R份,R个reduce任务各自负责一段key区间。每个reduce需要向许多个map任务节点取的落在其负责的key区间内的中间结果,然后执行reduce函数,最后形成一个最终结果。有R个reduce任务,就会有R个最终结果,很多情况下这R个最终结果并不需要合并成一个最终结果,因为这R个最终结果可以作为另一个计算任务的输入,开始另一个并行计算任务。这就形成了上面图中多个输出数据片段(HDFS副本)。 source: 总结于网络。 本文转自 张冲andy 博客园博客,原文链接:http://www.cnblogs.com/andy6/p/7351156.html ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册