首页 文章 精选 留言 我的

精选列表

搜索[CodeBuddy开发者分享季],共10002篇文章
优秀的个人博客,低调大师

Android GIS开发系列-- 入门季(6)GraphicsLayer添加文字与图片标签

一、GraphicsLayer添加图片 GraphicLayer添加图片Graphic,要用到PictureMarkerSymbol,也是样式的一种。添加代码如下: Drawable drawable = getResources().getDrawable(R.mipmap.ic_launcher); PictureMarkerSymbol pictureMarkerSymbol = new PictureMarkerSymbol(this, drawable); Graphic graphic = new Graphic(new Point(113,22), pictureMarkerSymbol); graphicsLayer.addGraphic(graphic); 添加图片效果如下: 二、GraphicsLayer添加文字 GraphicLayer添加文字,要利用TextSymbol。代码如下 TextSymbol textSymbol = new TextSymbol(20,"我是文字" , Color.RED); Graphic graphic = new Graphic(new Point(113,22), textSymbol ); graphicsLayer.addGraphic(graphic); 上面的代码没有设置使用哪种字体,Arcgis会默认的字体。如果 我们想添加中文,要设置textSymbol.setFontFamily("DroidSansFallback.ttf");, 为textSymbol设置字体,arcgis会到system\fonts下找到此字体。但有时我们设置此代码时中文并没有出现,可能会有乱码等,是因为系统的fon ts下面并没有此字体,解决的办法有,将手机root,将DroidSansFallback.ttf字体添加到system\fonts下。华为的手机是有此字体的,而三星5.0以 上则没有此字体,在华为手机上还有一款中文DroidSansChinese.ttf字体arcgis也是支持的。而三星5.0以上的中文字体好像不是ttf字体,而是otf字体 ,Arcgis好像不支持,本人也没有找到好的解决办法。 没有整理与归纳的知识,一文不值!高度概括与梳理的知识,才是自己真正的知识与技能。 永远不要让自己的自由、好奇、充满创造力的想法被现实的框架所束缚,让创造力自由成长吧! 多花时间,关心他(她)人,正如别人所关心你的。理想的腾飞与实现,没有别人的支持与帮助,是万万不能的。 本文转自wenglabs博客园博客,原文链接:http://www.cnblogs.com/arxive/p/7751888.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

SparkContext的初始化(季篇)——测量系统、ContextCleaner等组件介绍

《深入理解Spark:核心思想与源码分析》一书前言的内容请看链接《深入理解SPARK:核心思想与源码分析》一书正式出版上市 《深入理解Spark:核心思想与源码分析》一书第一章的内容请看链接《第1章 环境准备》 《深入理解Spark:核心思想与源码分析》一书第二章的内容请看链接《第2章 SPARK设计理念与基本架构》 由于本书的第3章内容较多,所以打算分别开辟四篇随笔分别展现。 《深入理解Spark:核心思想与源码分析》一书第三章第一部分的内容请看链接《深入理解Spark:核心思想与源码分析》——SparkContext的初始化(伯篇)》《深入理解Spark:核心思想与源码分析》一书第三章第一部分的内容请看链接《深入理解Spark:核心思想与源码分析》——SparkContext的初始化(仲篇)》《深入理解Spark:核心思想与源码分析》一书第三章第三部分的内容请看链接《深入理解Spark:核心思想与源码分析》——SparkContext的初始化(叔篇)》 本文展现第3章第四部分的内容: 3.9 启动测量系统MetricsSystem MetricsSystem使用codahale提供的第三方测量仓库Metrics,有关Metrics的具体信息可以参考附录D。MetricsSystem中有三个概念: Instance:指定了谁在使用测量系统; Source:指定了从哪里收集测量数据; Sink:指定了往哪里输出测量数据。Spark按照Instance的不同,区分为Master、Worker、Application、Driver和Executor。Spark目前提供的Sink有ConsoleSink、CsvSink、JmxSink、MetricsServlet、GraphiteSink等。Spark中使用MetricsServlet作为默认的Sink。MetricsSystem的启动代码如下。 val metricsSystem = env.metricsSystem metricsSystem.start() MetricsSystem的启动过程包括以下步骤:1) 注册Sources;2) 注册Sinks;3) 给Sinks增加Jetty的ServletContextHandler。MetricsSystem启动完毕后,会遍历与Sinks有关的ServletContextHandler,并调用attachHandler将它们绑定到SparkUI上。 metricsSystem.getServletHandlers.foreach(handler=> ui.foreach(_.attachHandler(handler))) 3.9.1 注册Sources registerSources方法用于注册Sources,它的实现见代码清单3-44。注册Sources的过程分为以下步骤:1) 从metricsConfig获取Driver的Properties,默认为创建MetricsSystem的过程中解析的{sink.servlet.class=org.apache.spark.metrics.sink.MetricsServlet,sink.servlet.path=/metrics/json}。2) 从Driver的Properties中用正则匹配以source.开头的属性。然后将属性中的Source反射得到的实例,加入ArrayBuffer[Source]。3) 将每个Source的metricRegistry(也是MetricSet的子类型)注册到ConcurrentMap metrics。这里的registerSource方法已在3.8.2节讲解过。代码清单3-44 MetricsSystem private def registerSources() { val instConfig =metricsConfig.getInstance(instance) val sourceConfigs =metricsConfig.subProperties(instConfig, MetricsSystem.SOURCE_REGEX) //Register all the sources related to instance sourceConfigs.foreach{ kv => val classPath = kv._2.getProperty("class") try { val source =Class.forName(classPath).newInstance() registerSource(source.asInstanceOf[Source]) } catch { case e: Exception =>logError("Source class" + classPath + " cannot beinstantiated", e) } } } 3.9.2 注册Sinks registerSinks方法用于注册Sinks,它的实现见代码清单3-45。注册Sinks的步骤如下:1) 从Driver的Properties中用正则匹配以sink.开头的属性,如:{sink.servlet.class=org.apache.spark.metrics.sink.MetricsServlet,sink.servlet.path=/metrics/json}。将其转换为Map(servlet-> {class=org.apache.spark.metrics.sink.MetricsServlet, path=/metrics/json})。2) 将子属性class对应的类metricsServlet反射得到MetricsServlet实例。如果属性的key是servlet,将其设置为metricsServlet;如果是Sink,则加入到ArrayBuffer[Sink]中。代码清单3-45 MetricsSystem注册Sinks的实现 private def registerSinks() { val instConfig = metricsConfig.getInstance(instance) val sinkConfigs = metricsConfig.subProperties(instConfig, MetricsSystem.SINK_REGEX) sinkConfigs.foreach { kv => val classPath = kv._2.getProperty("class") if (null != classPath) { try { val sink = Class.forName(classPath) .getConstructor(classOf[Properties], classOf[MetricRegistry], classOf[SecurityManager]) .newInstance(kv._2, registry, securityMgr) if (kv._1 == "servlet") { metricsServlet = Some(sink.asInstanceOf[MetricsServlet]) } else { sinks += sink.asInstanceOf[Sink] } } catch { case e: Exception => logError("Sink class "+ classPath + " cannot be instantialized",e) } } } } 3.9.3 给Sinks增加Jetty的ServletContextHandler MetricsSystem的getServletHandlers方法,实现如下。 def getServletHandlers = { require(running, "Canonly call getServletHandlers on a running MetricsSystem") metricsServlet.map(_.getHandlers).getOrElse(Array()) } 可以看到调用了metricsServlet的getHandlers,其实现如下。 def getHandlers = Array[ServletContextHandler]( createServletHandler(servletPath, newServletParams(request => getMetricsSnapshot(request), "text/json"), securityMgr) ) 最终生成处理/metrics/json请求的ServletContextHandler,而请求的真正处理由getMetricsSnapshot方法,利用fastjson解析。生成的ServletContextHandler通过SparkUI的attachHandler方法,也被绑定到SparkUI。createServletHandler与attachHandler方法都已经在3.4.4节详细阐述。最终我们可以使用以下这些地址来访问测量数据。http://localhost:4040/metrics/applications/jsonhttp://localhost:4040/metrics/jsonhttp://localhost:4040/metrics/master/json 3.10 创建和启动ExecutorAllocationManager ExecutorAllocationManager用于动态分配executor,创建和启动ExecutorAllocationManager的代码如下。 private[spark] val executorAllocationManager: Option[ExecutorAllocationManager] = if (conf.getBoolean("spark.dynamicAllocation.enabled",false)) { Some(newExecutorAllocationManager(this, listenerBus, conf)) } else { None } executorAllocationManager.foreach(_.start()) 默认情况下不会创建ExecutorAllocationManager,可以修改属性spark.dynamicAllocation.enabled为true来创建。ExecutorAllocationManager可以设置动态分配最小Executor数量、动态分配最大Executor数量、每个Executor可以运行的Task数量等配置信息,并对配置信息进行校验。start方法将ExecutorAllocationListener加入到listenerBus中,ExecutorAllocationListener通过监听listenerBus里的事件,动态添加删除executor。并且通过Thread不断的添加executor,并且遍历executor,将超时的executor杀掉并且移除。ExecutorAllocationListener的实现与其他SparkListener类似,不再赘述。ExecutorAllocationManager的关键代码见代码清单3-46。代码清单3-46 ExecutorAllocationManagerr的关键代码 private valintervalMillis: Long = 100 private var clock: Clock = new RealClock private val listener = newExecutorAllocationListener def start():Unit = { listenerBus.addListener(listener) startPolling() } private defstartPolling(): Unit = { val t = new Thread { override def run(): Unit= { while (true) { try { schedule() } catch { case e: Exception =>logError("Exception in dynamic executor allocation thread!", e) } Thread.sleep(intervalMillis) } } } t.setName("spark-dynamic-executor-allocation") t.setDaemon(true) t.start() } 根据3.4.1节的内容,我们知道listenerBus内置了线程listenerThread,此线程不断从eventQueue中拉出事件对象,调用监听器的监听方法。要启动此线程,需要调用listenerBus的start方法,代码如下。 listenerBus.start() 3.11 ContextCleaner的创建与启动 由于配置属性spark.cleaner.referenceTracking默认是true,所以会构造并启动ContextCleaner,代码如下。 private[spark] val cleaner:Option[ContextCleaner] = { if (conf.getBoolean("spark.cleaner.referenceTracking",true)) { Some(newContextCleaner(this)) } else { None } } cleaner.foreach(_.start()) ContextCleaner用于清理那些超出应用范围的RDD、ShuffleDependency和Broadcast对象。ContextCleaner的组成如下: referenceQueue:缓存顶级的AnyRef引用; referenceBuffer:缓存AnyRef的虚引用; listeners:缓存清理工作的监听器数组; cleaningThread:用于具体清理工作的线程。ContextCleaner的工作原理和listenerBus一样,也采用监听器模式,由线程来处理,此线程实际只是调用keepCleaning方法。keepCleaning的实现见代码清单3-47。 代码清单3-47 ContextCleaner的实现 private defkeepCleaning(): Unit = Utils.logUncaughtExceptions { while (!stopped) { try { val reference = Option(referenceQueue.remove(ContextCleaner.REF_QUEUE_POLL_TIMEOUT)) .map(_.asInstanceOf[CleanupTaskWeakReference]) //Synchronize here to avoid being interrupted on stop() synchronized { reference.map(_.task).foreach { task=> logDebug("Gotcleaning task " + task) referenceBuffer -= reference.get task match { case CleanRDD(rddId) => doCleanupRDD(rddId, blocking = blockOnCleanupTasks) case CleanShuffle(shuffleId) => doCleanupShuffle(shuffleId, blocking = blockOnShuffleCleanupTasks) case CleanBroadcast(broadcastId) => doCleanupBroadcast(broadcastId, blocking = blockOnCleanupTasks) } } } } catch { case ie:InterruptedException if stopped => // ignore case e: Exception =>logError("Error in cleaningthread", e) } } } 3.12 Spark环境更新 在SparkContext的初始化过程中,可能对其环境造成影响,所以需要更新环境,代码如下。 postEnvironmentUpdate() postApplicationStart() SparkContext初始化过程中,如果设置了spark.jars属性, spark.jars指定的jar包将由addJar方法加入到httpFileServer的jarDir变量指定的路径下。spark.files指定的文件将由addFile方法加入到httpFileServer的fileDir变量指定的路径下。见代码清单3-48。代码清单3-48 依赖文件处理 val jars: Seq[String] = conf.getOption("spark.jars").map(_.split(",")).map(_.filter(_.size!= 0)).toSeq.flatten val files: Seq[String] = conf.getOption("spark.files").map(_.split(",")).map(_.filter(_.size!= 0)).toSeq.flatten // Addeach JAR given through the constructor if (jars != null) { jars.foreach(addJar) } if (files != null) { files.foreach(addFile) } httpFileServer的addFile和addJar方法,见代码清单3-49。 代码清单3-49 HttpFileServer提供对依赖文件的访问 def addFile(file: File) : String = { addFileToDir(file, fileDir) serverUri + "/files/"+ file.getName } def addJar(file:File) : String = { addFileToDir(file, jarDir) serverUri + "/jars/" +file.getName } def addFileToDir(file: File, dir: File) : String = { if (file.isDirectory) { throw newIllegalArgumentException(s"$filecannot be a directory.") } Files.copy(file, new File(dir, file.getName)) dir + "/" + file.getName } postEnvironmentUpdate的实现见代码清单3-50,其处理步骤如下:1) 通过调用SparkEnv的方法environmentDetails最终影响环境的JVM参数、Spark 属性、系统属性、classPath等,参见代码清单3-51。2) 生成事件SparkListenerEnvironmentUpdate,并post到listenerBus,此事件被EnvironmentListener监听,最终影响EnvironmentPage页面中的输出内容。代码清单3-50 SparkContext环境更新 private def postEnvironmentUpdate() { if (taskScheduler != null) { val schedulingMode =getSchedulingMode.toString val addedJarPaths = addedJars.keys.toSeq val addedFilePaths = addedFiles.keys.toSeq val environmentDetails = SparkEnv.environmentDetails(conf, schedulingMode, addedJarPaths, addedFilePaths) val environmentUpdate =SparkListenerEnvironmentUpdate(environmentDetails) listenerBus.post(environmentUpdate) } } 代码清单3-51 environmentDetails的实现 val jvmInformation = Seq( ("JavaVersion", s"$javaVersion ($javaVendor)"), ("Java Home", javaHome), ("Scala Version", versionString) ).sorted val schedulerMode = if (!conf.contains("spark.scheduler.mode")) { Seq(("spark.scheduler.mode", schedulingMode)) } else { Seq[(String, String)]() } val sparkProperties = (conf.getAll ++ schedulerMode).sorted // System properties that are not java classpaths val systemProperties = Utils.getSystemProperties.toSeq val otherProperties = systemProperties.filter { case (k, _) => k != "java.class.path" && !k.startsWith("spark.") }.sorted // Class paths including all added jars andfiles val classPathEntries = javaClassPath .split(File.pathSeparator) .filterNot(_.isEmpty) .map((_, "System Classpath")) val addedJarsAndFiles = (addedJars ++ addedFiles).map((_, "AddedBy User")) val classPaths = (addedJarsAndFiles ++ classPathEntries).sorted Map[String, Seq[(String, String)]]( "JVMInformation" -> jvmInformation, "Spark Properties" ->sparkProperties, "System Properties"-> otherProperties, "Classpath Entries"-> classPaths) postApplicationStart方法很简单,只是向listenerBus发送了SparkListenerApplicationStart事件,代码如下。 listenerBus.post(SparkListenerApplicationStart(appName, Some(applicationId), startTime, sparkUser)) 3.13 创建DAGSchedulerSource和BlockManagerSource 在创建DAGSchedulerSource、BlockManagerSource之前首先调用taskScheduler的postStartHook方法,其目的是为了等待backend就绪,见代码清单3-52。postStartHook的实现见代码清单3-53。创建DAGSchedulerSource和BlockManagerSource的过程类似于ExecutorSource,只不过DAGSchedulerSource测量的信息是stage. failedStages、stage.runningStages、stage. waitingStages、stage. allJobs、stage.activeJobs,BlockManagerSource测量的信息是memory. maxMem_MB、memory.remainingMem_MB、memory. memUsed_MB、memory. diskSpaceUsed_MB。代码清单3-52 创建DAGSchedulerSource和BlockManagerSource taskScheduler.postStartHook() private val dagSchedulerSource =new DAGSchedulerSource(this.dagScheduler) private val blockManagerSource =new BlockManagerSource(SparkEnv.get.blockManager) ivate def initDriverMetrics() { SparkEnv.get.metricsSystem.registerSource(dagSchedulerSource) SparkEnv.get.metricsSystem.registerSource(blockManagerSource) } initDriverMetrics() 代码清单3-53 等待backend就绪的实现 override def postStartHook() { waitBackendReady() } private def waitBackendReady(): Unit = { if (backend.isReady) { return } while (!backend.isReady) { synchronized { this.wait(100) } } } 3.14 将SparkContext标记为激活 SparkContext初始化的最后将当前SparkContext的状态从contextBeingConstructed(正在构建中)改为activeContext(已激活),代码如下。[java] view plain copy 在CODE上查看代码片派生到我的代码片SparkContext.setActiveContext(this, allowMultipleContexts) setActiveContext方法的实现如下。 private[spark] defsetActiveContext( sc:SparkContext, allowMultipleContexts: Boolean): Unit = { SPARK_CONTEXT_CONSTRUCTOR_LOCK.synchronized { assertNoOtherContextIsRunning(sc, allowMultipleContexts) contextBeingConstructed = None activeContext =Some(sc) } } 3.15 小结 回顾本章, Scala与Akka基于Actor的并发编程模型给人带来深刻的印象,改变了我本人每当需要提升性能时就想到使用多线程的传统观念,Actor与事件模型有类似之处,通过异步处理,减少线程切换开销,值得开发人员借鉴。listenerBus对于监听器模式的经典应用将处理转化为事件并交给统一的线程处理,减少了线程阻塞与切换,提升了性能,希望读者朋友能应用到自己的产品开发中去。此外,使用Netty所提供的异步网络框架构建的Block传输服务,基于Jetty构建的内嵌web服务、HTTP文件服务器和SparkUI,基于codahale提供的第三方测量仓库创建的测量系统,Executor中的心跳实现等内容,都值得借鉴。

优秀的个人博客,低调大师

开发规范分享

最近要准备新同事的开发规范培训,所以大概理了理开发过程中总结的一些注意点和规范,有git管理、代码编写和API设计原则这3个方面 # git分支开发管理 ## Git三大特色之Branch(分支) ``` 主分支: master: origin/master 分支上的最新代码永远是版本发布状态(这个分支只能从其他分支合并,不能在这个分支直接修改)。 develop:origin/develop 分支则是最新的开发进度(这个主要合并与其他分支,比如Feature分支) 协助分支: feature:Feature 分支用来做分模块功能开发,一旦开发完成,可以合并到develop 分支,提交时对应的负责人可以code review release:分支用来做版本发布的预发布分支 建议命名为 release/xxx 如:release/1.0.0 hotfix: 分支是用来做线上的紧急 bug 修复的分支,建议命名为 hotfix/xxx ``` ### 原则: ``` 1、分支不混用,一个分支就开发一个功能,开发完成合并就删除 2、分支名称简明,看到名字能知道这个分支要开发/修复的功能,分支名字长没关系只要能说明要做的事情就可以 3、commit一定要跟commit对应修改的代码对应的上,commit要能说明修改的内容,不要fix,fix这种,或者n个commit一模一样 ``` ### 注意点: ``` 1、提merge request时,如果有冲突请把develop分支合并到本地解决完冲突后重新提交 2、打tag时一定要修改对应的version文件,确保version文件和实际的tag对应的上 2、打tag的时候需要全局替换@CommandLine.Command(version = "4.2.0")中的数字为对应的版本号,和version.ini中的信息对应上 ``` ![image.png](https://s2.51cto.com/images/20210609/1623244379735624.png?x-oss-process=image/watermark,size_14,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_20,type_ZmFuZ3poZW5naGVpdGk=) # 设计原则 ``` 1.清晰(是什么,做了什么,一眼看得出来) 2.简单(职责少,代码少,逻辑少) 3.干净(没有多余的逻辑) 4.好拓展(依赖的比较少,修改不会影响很多) ``` # 命名原则 ``` 1.名副其实 阅读名称就知道它为什么存在、做什么事、应该怎么用,如果需要通过注释来回答,那就不算名副其实 2.不容易混淆 避免使用非常相似的名称,尤其是类型还相同,比如小写 l 和1、o 和 0、专有名词 3.读的出来 不要因为害怕名称过长而使用缩写,那样不便于和别人讨论 4.方便搜索 名称长度和其作用范围成正比,作用范围比较大的,长名称也可以,只要能表达清楚 ``` # 方法设计原则 ``` 1.函数的第一要则:短小 (多短才算可以?不超过 40 行,缩进层级不该大于两层,尽量不出现2层for) 2. **只做一件事** 要判断函数是否做了不止一件事,就看它里面的代码,是否能再拆出一个函数 函数变大的头号凶手:switch 语句 switch 语句天生要做多件事,我们能做的,就是减少 switch 语句的次数,把它埋藏在较低的抽象层级,同时不重复使用 switch 如果有类似的 switch 出现多次,就要考虑使用多态来减少 switch 语句出现的次数 3.参数尽量少 定义的函数的参数越多,你耗费函数使用者的青春就越多,使用者需要花时间搞清楚每个参数的具体含义和顺序 最理想的参数数量是 1~2 从测试的角度看,参数越多,可能出现的用例就越多,就越容易出错 保持参数列表短小的方法: 参数升为全局变量、多个参数封装成一个类 ``` # 注释 #### 原则是尽量不写注释,除非一些特别的业务逻辑,代码看起来很奇怪但业务是这样子的 ``` 1.弥补代码表达意图的失败 代码本身无法说明意图,这时使用注释,说明这段代码需要被修改 2.提供信息 提供代码以外的信息,比如产品相关信息 3.复杂实现的简要概括 让阅读者快速了解某个复杂的系统 4.警示、提醒 比如某个不起眼的代码是为了解决某个 bug,防止别人误删 ``` # 异常处理 ``` 1、尽量不使用异常捕获 原则是程序中尽量不使用try,代码层面可预期的全部使用代码层面处理掉,除非一些外部依赖,如连mysql失败,操作文件本身会报exception等 2、抽离错误处理 如果错误处理很重要的话,可以考虑把错误处理单独放到一个方法里。 3.不要返回 null 返回空对象好于返回 null,尽可能的避免空指针的出现。 ``` # 整体开发注意事项可以参考阿里巴巴的java开发手册 https://github.com/alibaba/p3c/blob/master/Java%E5%BC%80%E5%8F%91%E6%89%8B%E5%86%8C%EF%BC%88%E5%B5%A9%E5%B1%B1%E7%89%88%EF%BC%89.pdf # API设计规范 ## 路径(Endpoint) ``` 路径又称"终点"(endpoint),表示API的具体网址。 在RESTful架构中,每个网址代表一种资源(resource),所以网址中不能有动词,只能有名词,而且所用的名词往往与数据库的表格名对应。 一般来说,数据库中的表都是同种记录的"集合"(collection),所以API中的名词也应该使用复数。 举例来说,有一个API提供动物园(zoo)的信息,还包括各种动物和雇员的信息,则它的路径应该设计成下面这样。 https://api.example.com/zoos https://api.example.com/animals https://api.example.com/employees ``` ## HTTP动词 对于资源的具体操作类型,由HTTP动词表示。 常用的HTTP动词有下面五个(括号里是对应的SQL命令)。 ``` GET(SELECT):从服务器取出资源(一项或多项)。 POST(CREATE):在服务器新建一个资源。 PUT(UPDATE):在服务器更新资源(客户端提供改变后的完整资源)。 PATCH(UPDATE):在服务器更新资源(客户端提供改变的属性)。 DELETE(DELETE):从服务器删除资源。 ``` 下面是一些例子。 ``` GET /zoos:列出所有动物园 POST /zoos:新建一个动物园 GET /zoos/ID:获取某个指定动物园的信息 PUT /zoos/ID:更新某个指定动物园的信息(提供该动物园的全部信息) PATCH /zoos/ID:更新某个指定动物园的信息(提供该动物园的部分信息) DELETE /zoos/ID:删除某个动物园 GET /zoos/ID/animals:列出某个指定动物园的所有动物 DELETE /zoos/ID/animals/ID:删除某个指定动物园的指定动物 (也可以把数据放到body里面) ``` ## 过滤信息(Filtering) 如果记录数量很多,服务器不可能都将它们返回给用户。API应该提供参数,过滤返回结果。 下面是一些常见的参数。 ``` ?limit=10:指定返回记录的数量 ?offset=10:指定返回记录的开始位置。 ?page=2&per_page=100:指定第几页,以及每页的记录数。 ?sortby=name&order=asc:指定返回结果按照哪个属性排序,以及排序顺序。 ?animal_type_id=1:指定筛选条件 ``` 参数的设计允许存在冗余,即允许API路径和URL参数偶尔有重复。比如,GET /zoo/ID/animals 与 GET /animals?zoo_id=ID 的含义是相同的。 ## 接口返回定义 ``` 数据标准返回code,data,message这3个字段,如果有额外的字段可以自行添加, 如es_search_ts代表es查询耗费时间,对排错有帮助 code: 接口响应状态码 data: 接口返回数据 message: 返回给用户的提示 { code: 20000 data: {} message: "操作成功" } ``` ## 接口返回原则 ### 返回message 1、不能出现页面一堆报错飘红的情况(即使某个组件出错,也需要catch住,但是需要能报出来,比如通过debug或者返回中增加额外错误信息展示字段) 2、报错类型尽量详细,每种返回简明致意,不要返回看到了也不知道什么原因的信息 3、有调试机制,开启后可以在返回中增加一个字段显示代码track信息 ### 返回状态码 | status | 含义 | | ------- | ------- | | 200 | 成功的状态,成功又分两种code:20000表示后端校验通过,返回正确的数据; 40000表示后端验证不通过,把错误信息返回给前端展示 | | 500 | 服务端异常,错误信息不展示| | 401 | 未登陆状态,给提示,用户点击确定按钮,跳转登陆页面| |403 | 权限问题,api没有权限,重定向到登陆页面| |404 | 路由没有权限或不存在,跳转默认的首页| ### 返回翻页信息 ``` { "totalDoc":0, # 文档总数 "items": [] # 具体的数据信息 } ```

优秀的个人博客,低调大师

Android -- 经验分享

目录 代码中安装apk 判断某个apk是否已经安装 取得屏幕大小 获得 LayoutInflater 实例的三种方式 ContentResolver.query(),以及 Activity.managedQuery异同 解锁功能 点亮屏幕 activity全屏显示 屏常亮代码 SQL中 inner join、 left join 、right join、 outer join之间的区别 包含button的item也能弹出菜单,回调click以及long click的监听器 背光亮度 /sys/class/leds/lcd-backlight/brightness 判断是否在锁屏界面的函数 OnTouchListener实现双击事件 回到待机界面 定时器相关 sd卡和sim卡状态判断 开机启动,检查sim卡是否发生变更 代码中安装apk Runtime.getRuntime().exec("pm install xxx.apk"); 需要在manifest.xml文件中,加上INSTALL_PACKAGES的权限,可以用 Package install的receiver来处理安装成功后的操作 或者: /** * 安装apk * @param url */ private void installApk(String saveFileName){ File apkfile = new File(saveFileName); if (!apkfile.exists()) { return; } Intent i = new Intent(Intent.ACTION_VIEW); i.setDataAndType(Uri.parse("file://" + apkfile.toString()), "application/vnd.android.package-archive"); mContext.startActivity(i); } 判断某个APK是否已经安装 private boolean isAppInstalled(String uri){ PackageManager pm = getPackageManager(); boolean installed =false; try{ pm.getPackageInfo(uri,PackageManager.GET_ACTIVITIES); installed =true; }catch(PackageManager.NameNotFoundException e){ installed =false; } return installed; } //Just call the method by passing the package name of the application you need to check. if(isAppInstalled("com.yourpackage.package")){ //app installed }else{ //app not installed } 取得屏幕大小 1、在非activity类中 WindowManager windowManager = (WindowManager)(mContext.getSystemService(Context.WINDOW_SERVICE)); int screenWidth = windowManager.getDefaultDisplay().getWidth(); int screenHeight = windowManager.getDefaultDisplay().getHeight(); 2、在activity类中 int screenWidth = getWindowManager().getDefaultDisplay().getWidth(); // 屏幕宽(像素,如:480px) int screenHeight = getWindowManager().getDefaultDisplay().getHeight(); // 屏幕高(像素,如:800px) 获得 LayoutInflater 实例的三种方式 LayoutInflater inflater = getLayoutInflater(); //调用Activity的getLayoutInflater() LayoutInflater localinflater =(LayoutInflater)context.getSystemService(Context.LAYOUT_INFLATER_SERVICE); LayoutInflater inflater = LayoutInflater.from(context); 示意代码: LayoutInflater inflater = (LayoutInflater)getSystemService(Context.LAYOUT_INFLATER_SERVICE); View view = inflater.inflate(R.layout.custom, (ViewGroup)findViewById(R.id.test)); 对于上面代码,指定了第二个参数 ViewGroup root,当然你也可以设置为 null 值。 ContentResolver.query(),以及 Activity.managedQuery异同 参数、返回值相同:都返回 Cursor 对象 参数: URI: Content Provider 需要返回的资源索引 Projection: 用于标识有哪些columns需要包含在返回数据中。 Selection: 作为查询符合条件的过滤参数,类似于SQL语句中Where之后的条件判断。 SelectionArgs: 同上。 SortOrder: 用于对返回信息进行排序。 不同: mContext.getContentResolver().query ContentResolver.query(),以及 Activity.managedQuery()所以,我们看到一个是ContentResolver提供的查询方法,位于android.content.ContextWrapper.getContentResolver(),另一个则为Activity。 Activity.managedQuery() 方法导致活动管理 Cursor 的生命周期 解锁功能 KeyguardManager keyguardManager = (KeyguardManager)getSystemService(KEYGUARD_SERVICE); KeyguardLock keyguardLock = keyguardManager.newKeyguardLock(""); keyguardLock.disableKeyguard(); PowerManager pm = (PowerManager)getSystemService(POWER_SERVICE); 点亮屏幕 PowerManager pm = (PowerManager)getSystemService(POWER_SERVICE); WakeLock mWakelock = pm.newWakeLock(PowerManager.ACQUIRE_CAUSES_WAKEUP|PowerManager.SCREEN_DIM_WAKE_LOCK,"SimpleTimer"); mWakeLock.acquire();//点亮 mWakeLock.release();//关闭 activity全屏显示 getWindow().setFlags(WindowManager.LayoutParams.FLAG_FULLSCREEN, WindowManager.LayoutParams.FLAG_FULLSCREEN); requestWindowFeature(Window.FEATURE_NO_TITLE); 注意;要在setContentView(R.layout.layout)语句之前调用才行。 屏常亮代码 getWindow().addFlags(WindowManager.LayoutParams.FLAG_KEEP_SCREEN_ON);//屏常亮 SQL中 inner join、 left join 、right join、 outer join之间的区别 举例说明 A表(a1,b1,c1) B表(a2,b2) a1 b1 c1 a2 b2 01 数学 95 01 张三 02 语文 90 02 李四 03 英语 80 04 王五 select A.*,B.* from A inner join B on(A.a1=B.a2) 结果是: a1 b1 c1 a2 b2 01 数学 95 01 张三 02 语文 90 02 李四 select A.*,B.* from A left outer join B on(A.a1=B.a2) 结果是: a1 b1 c1 a2 b2 01 数学 95 01 张三 02 语文 90 02 李四 03 英语 80 NULL NULL select A.*,B.* from A right outer join B on(A.a1=B.a2) 结果是: a1 b1 c1 a2 b2 01 数学 95 01 张三 02 语文 90 02 李四 NULL NULL NULL 04 王五 select A.*,B.* from A full outer join B on(A.a1=B.a2) 结果是: a1 b1 c1 a2 b2 01 数学 95 01 张三 02 语文 90 02 李四 03 英语 80 NULL NULL NULL NULL NULL 04 王五 包含button的item也能弹出菜单,回调click以及long click的监听器 设置button属性: android:focusable="false" 外还要设置 listview属性: android:longClickable="true" PS: 如果包含的Button是ImageButton,那么在xml中设置了android:focusable="false"属性在当前版本是无效的,必须在代码中,再次呼叫函数ImageButton.setFocusable(false)设置一次。 或者在父Item里面加上 android:descendantFocusability="blocksDescendants" 背光亮度 /sys/class/leds/lcd-backlight/brightness 例如 echo 255 > /sys/class/leds/lcd-backlight/brightness 代码修改亮度: Settings.System.putInt(getContentResolver(), SCREEN_BRIGHTNESS, brightness); //brightness 背光亮度 0~255 Settings.System.putInt(getContentResolver(),SCREEN_OFF_TIMEOUT, timeoutValues);//timeoutValues 灭屏时间 ms 判断是否在锁屏界面的函数 KeyguardManager: inKeyguardRestrictedInputMode(); 例: KeyguardManager km = (KeyguardManager)getSystemService(Context.KEYGUARD_SERVICE); boolean keyguardexist = km.inKeyguardRestrictedInputMode(); OnTouchListener实现双击事件 class MyOnTouchListener implements View.OnTouchListener{ private long mLastTime = 0; private long mCurTime = 0; @Override public boolean onTouch(View v, MotionEvent event) { if(MotionEvent.ACTION_DOWN == event.getAction()){ mLastTime = mCurTime; mCurTime = System.currentTimeMillis(); if (mCurTime - mLastTime < 1000) { // 双击事件 关闭activity FullBlackActivity.this.finish(); return true; } } return false; } } 回到待机界面 Intent home = new Intent(Intent.ACTION_MAIN); home.addCategory(Intent.CATEGORY_HOME); this.startActivity(home); 定时器相关 采用Handler与线程的sleep(long)方法 Handler主要用来处理接受到的消息。 1. 定义一个Handler类,用于处理接受到的Message。 Handler handler = new Handler() { public void handleMessage(Message msg) { // 要做的事情 super.handleMessage(msg); } }; 新建一个实现Runnable接口的线程类,如下: public class MyThread implements Runnable { @Override public void run() { // TODO Auto-generated method stub while (true) { try { Thread.sleep(10000);// 线程暂停10秒,单位毫秒 Message message = new Message(); message.what = 1; handler.sendMessage(message);// 发送消息 } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } } 3. 在需要启动线程的地方加入下面语句: new Thread(new MyThread()).start(); 4. 启动线程后,线程每10s发送一次消息。 采用Handler的postDelayed(Runnable, long)方法 1. 定义一个Handler类 Handler handler=new Handler(); Runnable runnable=new Runnable() { @Override public void run() { // TODO Auto-generated method stub //要做的事情 handler.postDelayed(this, 2000); } }; 2. 启动计时器 handler.postDelayed(runnable, 2000);//每两秒执行一次runnable. 3. 停止计时器 handler.removeCallbacks(runnable); 采用Handler与timer及TimerTask结合的方法 1. 定义定时器、定时器任务及Handler句柄 private final Timer timer = new Timer(); private TimerTask task; Handler handler = new Handler() { @Override public void handleMessage(Message msg) { // TODO Auto-generated method stub // 要做的事情 super.handleMessage(msg); } }; 2. 初始化计时器任务 task = new TimerTask() { @Override public void run() { // TODO Auto-generated method stub Message message = new Message(); message.what = 1; handler.sendMessage(message); } }; 3. 启动定时器 timer.schedule(task, 2000, 2000); 简要说一下上面三步提到的一些内容: 1. 定时器任务(TimerTask)顾名思义,就是说当定时器到达指定的时间时要做的工作,这里是想Handler发送一个消息,由Handler类进行处理。 2. java.util.Timer.schedule(TimerTask task, long delay, long period):这个方法是说,delay/1000秒后执行task,然后进过period/1000秒再次执行task,这个用于循环任务,执行无数次,当然,你可以用timer.cancel();取消计时器的执行。 闹钟定时 AlarmManager am = (AlarmManager) mContext.getSystemService(Context.ALARM_SERVICE); PendingIntent pendingIntent = PendingIntent.getBroadcast(mContext, 0, new Intent(SEND_SMS_BEGIN), 0); am.set(AlarmManager.RTC_WAKEUP, 60*1000, pendingIntent); 耳机状态 private static final String HEADSET_STATE_PATH = "/sys/class/switch/h2w/state"; //保存状态文件位置 private boolean isHeadsetExists(){ //判断耳机是否插入的函数 FM源码 FMplayService.java char[] buffer = new char[1024]; int newState = 0; try { FileReader file = new FileReader(HEADSET_STATE_PATH); int len = file.read(buffer, 0, 1024); newState = Integer.valueOf((new String(buffer, 0, len)).trim()); } catch (FileNotFoundException e) { Log.e(LOGTAG, "This kernel does not have wired headset support"); } catch (Exception e) { Log.e(LOGTAG, "" , e); } return newState != 0; } 未插入耳机: # cat /sys/class/switch/h2w/state cat /sys/class/switch/h2w/state 0 插入耳机: # cat /sys/class/switch/h2w/state cat /sys/class/switch/h2w/state 1 sd卡和sim卡状态判断 //sdcard是否可读写 public boolean IsCanUseSdCard() { try { return Environment.getExternalStorageState().equals( Environment.MEDIA_MOUNTED); } catch (Exception e) { e.printStackTrace(); } return false; } //sim卡是否可读 public boolean isCanUseSim() { try { TelephonyManager mgr = (TelephonyManager) getSystemService(Context.TELEPHONY_SERVICE); return TelephonyManager.SIM_STATE_READY == mgr.getSimState(); } catch (Exception e) { e.printStackTrace(); } return false; } 开机启动,检查sim卡是否发生变更 (1)注册receiver,设置意图过滤器 <receiver android:name=".receiver.BootCompleteReceiver" > <intent-filter android:priority="1000" > <action android:name="android.intent.action.BOOT_COMPLETED" /> </intent-filter> </receiver> (2)接受开机广播,并判断sim卡时候发生更改 public class BootCompleteReceiver extends BroadcastReceiver { private static final String TAG = "BootCompleteReceiver"; private SharedPreferences sp; private TelephonyManager tm; @Override public void onReceive(Context context, Intent intent) { Log.i(TAG,"手机重启了"); sp = context.getSharedPreferences("config", Context.MODE_PRIVATE); boolean protecting = sp.getBoolean("protecting", false); //如果防盗保护开启 if(protecting){ //判断sim卡是否发生了变化 tm = (TelephonyManager) context.getSystemService(Context.TELEPHONY_SERVICE); String currentSim = tm.getSimSerialNumber(); String savedSim= sp.getString("sim", ""); if(savedSim.equals(currentSim)){ // sim卡为发生变化, do nothint }else{ //sim卡发生了变化 //发送报警短信 给安全号码 SmsManager smsManager = SmsManager.getDefault(); String destinationAddretss = sp.getString("safenumber", ""); smsManager.sendTextMessage(destinationAddretss, null, "sim change !!!", null, null); } } } } 我是天王盖地虎的分割线 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3886021.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

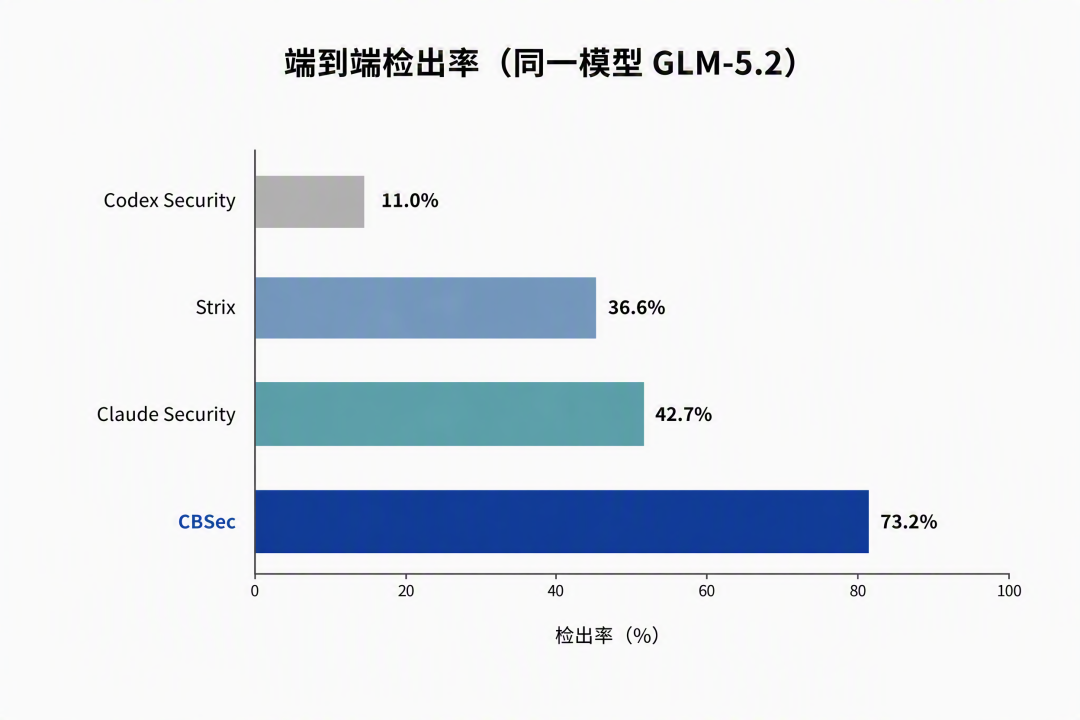
以无厚入有间:CodeBuddy Security的漏洞发现思路与实践

AI 找漏洞,像庖丁解牛:刀刃再好,也要顺着骨节的缝隙下刀。“以无厚入有间”,说的不是蛮力,而是先看清结构。对漏洞发现也是如此:线索可以来自代码结构,也可以来自历史修复和外部知识;它们共同做一件事——不断约束"这套代码可能在哪里、以什么方式出错"。搜索范围收得越窄,AI 这把刀越容易落到真正的缝隙里。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册