首页 文章 精选 留言 我的

精选列表

搜索[首次盈利],共10002篇文章
优秀的个人博客,低调大师

Unity 桌面 6 年来首次重大更新,7.6 版本正式发布

Unity 7.6 将是 6 年来 Unity 的第一个重要版本(上一个版本还是在 2016 年 5 月)。官方已经重新启动了 Unity7 的积极开发,并将定期发布具有更多功能的新版本。 现在已经为 Ubuntu Unity 22.04 用户发布了一个更新,所以可以运行 sudo apt update && sudo apt upgrade 来升级到 Unity 7.6。 下面是 Unity 7.6 中的一些变化: 仪表盘(应用启动器)和 HUD 已经被重新设计,使其看起来更现代 为 Unity 和 unity-control-center 增加了对重点颜色的支持,并更新了 unity-control-center 的主题列表 修复了仪表盘预览中损坏的应用信息和评级。 在 unity-control-center 中更新了信息面板 改进了仪表盘的圆角 修复了 Dock 中的 "清空垃圾桶" 按钮 将完整的 Unity7 shell 源代码迁移到 GitLab,并使其在 22.04 上进行了编译。 设计更加扁平化,但保留了全系统范围的模糊效果。 dock 的菜单和工具提示被赋予了一个更现代的外观。 低图形模式现在工作得更好,仪表盘速度也比以前快。 现在 Unity7 的内存占用率略低,而 Ubuntu Unity 22.04 的内存占用率已大幅降低至约 700-800 MB。 修复了独立测试的 Unity7 启动器 有问题的测试已经被禁用,构建时间大大缩短 以下是 Unity 7.6 的一些屏幕截图: 更多详情可查看:https://unity.ubuntuunity.org/blog/unity-7.6/

优秀的个人博客,低调大师

Unity 7.6 测试版发布,6 年来首次重大更新

Unity 7.6 将是 6 年来 Unity 的第一个重要版本(上一个版本还是在 2016 年 5 月)。官方已经重新启动了 Unity7 的积极开发,并将定期发布具有更多功能的新版本。你可以在 Ubuntu Unity 22.04 上运行以下命令来测试它: sudo wget https://repo.unityx.org/unityx.key sudo apt-key add unityx.key echo 'deb https://repo.unityx.org/main testing main' | sudo tee /etc/apt/sources.list.d/unity-x.list sudo apt-get update && sudo apt-get install -y unity 下面是 Unity 7.6 中的一些变化: 仪表盘(应用启动器)和 HUD 已经被重新设计,使其看起来更现代 修复了仪表盘预览中损坏的应用信息和评级。 修复了 Dock 中的 "清空垃圾桶" 按钮 将完整的 Unity7 shell 源代码迁移到 GitLab,并使其在 22.04 上进行了编译。 设计更加扁平化,但保留了全系统范围的模糊效果。 dock 的菜单和工具提示被赋予了一个更现代的外观。 低图形模式现在工作得更好,仪表盘速度也比以前快。 现在 Unity7 的内存占用率略低,而 Ubuntu Unity 22.04 的内存占用率已大幅降低至约 700-800 MB。 修复了独立测试的 Unity7 启动器 有问题的测试已经被禁用,构建时间大大缩短 如果您想在 Ubuntu Unity 22.04 上编译 Unity7 并生成 DEB 文件,则需要运行以下命令: sudo apt-get install -y build-essential git cmake git clone https://gitlab.com/ubuntu-unity/unity/unity cd unity && sudo apt build-dep . debuild -b --no-sign nemo .. & disown 以下是 Unity 7.6 的一些屏幕截图:

优秀的个人博客,低调大师

Google 资助 Linux 项目,Linux 内核将首次出现 Rust 代码

这家搜索引擎巨头正努力尝试在 Linux 内核中使用 Rust 代码,这是在几十年来只使用 C 语言后的一次重大技术转变。 Google 在周四表示,他们正在资助一个项目,通过用 Rust 编程语言编写操作系统的内核部分来提高 Linux 的安全性。如果该项目成功,这种变化将标志着一个开源软件项目的重大技术转变,这一举措可以加强互联网和智能设备的安全性,毕竟 Linux 是 Android、Chrome OS 以及互联网中众多基础设施的基础。 Miguel Ojeda 曾编写过大型强子对撞机粒子加速器所使用的软件,并从事过编程语言安全方面的工作。因此 Google 与 Miguel 签订了合约,希望能够利用他在 Rust for Linux 的工作和相关的安全领域的背景来提高 Linux 内核的内存安全,这份合同至少要持续到明年。 Google 的目标并不是要用 Rust 取代 Linux 操作系统中所有的 C 代码,而是用 Rust 有选择性地改进现有部分以及未来会新增加的部分。 Linux 操作系统自 1991 年推出以来,一直在使用强大但又有点“古老”的 C 编程语言编写。C 语言早在 1972 年就已推出,比当代的编程语言更容易受到黑客的攻击。 反观 Rust,Rust 是由 Firefox 浏览器开发商 Mozilla 所开发的,现在由独立的 Rust 基金会管理,通过该编程语言使软件向内存写入时更加安全。而且,在 Stack Overflow 的年度开发者调查中,Rust 已经连续五年蝉联最受喜爱的编程语言。

优秀的个人博客,低调大师

俄媒:美首次承认对俄网络机构进行攻击

据多家俄罗斯媒体报道,近日,美国总统特朗普在接受媒体采访时证实,他于2018年批准了对俄罗斯互联网研究所的网络攻击。 报道称,特朗普指责他的前任奥巴马“很早就了解这家俄罗斯网络机构”,但“为了协助希拉里竞选总统而保持了沉默”。 特朗普称,他在获悉“俄罗斯干预美国选举的情报”后下令对这家互联网研究机构进行了网络攻击——他承认,网络攻击是在美俄两国政治对抗日益激烈的背景下进行的。 特朗普在接受采访时还强调,他对俄罗斯政策“更为强硬”,包括在“北溪-2”天然气管道项目问题上通过对德国施加压力来遏制俄罗斯。 遭受美国网络攻击的俄罗斯互联网研究所位于圣彼得堡,被外界称为俄罗斯的“巨魔工厂”。部分美国政客宣称,正是这个机构成为俄罗斯干预2016年美国总统大选以及2018年美国中期选举的主要力量,但俄罗斯始终坚决否认这些指控。本月10日,俄罗斯总统新闻秘书佩斯科夫就指出,美国官方参与了对俄罗斯的网络攻击,这一点确信无疑,而俄罗斯从来没有、也不会与任何网络犯罪有关系。去年10月,俄罗斯联邦安全会议秘书帕特鲁舍夫曾表示,外国情报机构积极寻找俄罗斯网络部门的漏洞,以进行大规模的网络攻击。

优秀的个人博客,低调大师

首次使用 linux 阿里云服务器【入门及使用】

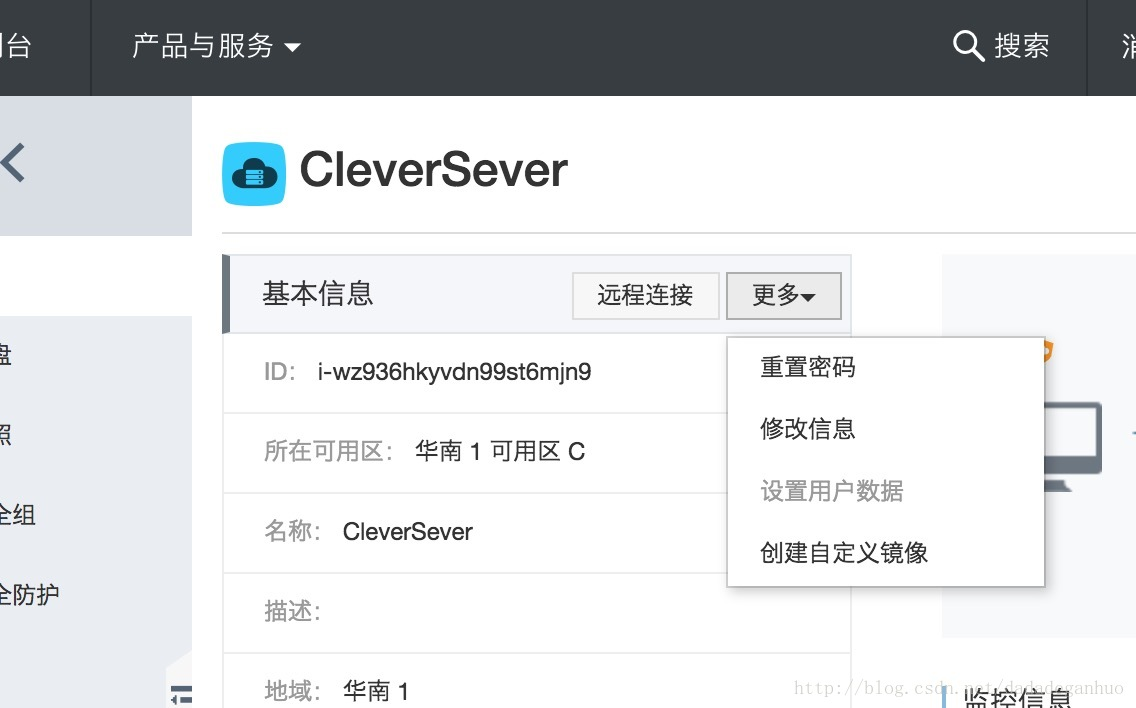
上午编辑的文章 下午更新下 安装环境 因为服务器默认 linux 系统,所以这里讲怎么配置 linux 云服务环境。我第一次使用的时候,还以为是要去安装一个界面化桌面,以便我这个命令小白可以操作。但是,对于只有2G 的内存来说安装了之后将会很卡很卡。后来我问学长,他说不要安装界面化,使用命令就好了。 首先关于远程服务器的登录入口, 默认系统的用户名是 root, 然后登录密码可以在控制台进行修改。如下图点击重置密码。 重置之后,然后点击远程连接,就可以连接登录到你的服务器上了。这里要将一点,如果你是 mac 电脑的话,可以在你的电脑上通过 ssh 登录到你的服务器。 命令如下:ssh root@你的公网IP,比如 ssh root@120.78.32.12然后输入密码即可连接成功。 接下来在终端中输入命令。配置环境。如果你是配置 java 环境,那么可以去谷歌一下如何在 linux 中配置 java 环境,这里我是配置的 node 环境,就讲一下如何配置 node 环境以及 npm。 这里我用的是源码安装。首先安装 node 编译依赖的第三方模块yum -y install gcc make gcc-c++ openssl-devel 然后下载 node 的源码包 node 官网的源码 包。wgethttps://nodejs.org/dist/v8.9.4/node-v8.9.4.tar.gz 你下载的时候可以手动改成当前最新版本。下载后,进行解压 tar -zxvf node-v8.9.4.tar.gz, 然后进入解压后的文件夹 cd node-v8.9.4, 依次./configuremakesudo make install这里编译时间会有点久,请耐心等待- -查看安装成功安装 npm同样下载 npm 包wgethttp://nodejs.org/dist/npm/npm-1.4.9.zip解压 tar -zxvf npm-1.4.9.tgz查看是否安装成功 npm -v 这就是 node 环境配置了, 然后就是 mysql 数据库。http://blog.csdn.net/win7system/article/details/53579500 关于项目的上传,如果你本地编写了代码,想上传至服务器,第一个方式,可以是使用 ftp 上传文件。 第二个方式,就是在你的服务器上搭建一个 git 服务器,通过从服务器推送和克隆项目来获取文件。这里我使用的是第二种方法,参见教程: >https://www.liaoxuefeng.com/wiki/0013739516305929606dd18361248578c67b8067c8c017b000/00137583770360579bc4b458f044ce7afed3df579123eca000 这里注意一下, 关于 设置 ssh 登录,一定要把创建的 .ssh 文件放到你创建的用户下,如我这里是 git 用户,路径就是放置在正确位置之后,还要注意项目的归属者也要是 git 用户,这样才会在 git 用户里匹配到对应的 ssh key。也就是下面这一个步骤还有一点要注意的就是,你再本地推送了代码上 git 服务器之后,想要在云服务器上获取到代码, 需要在服务器上再次克隆 git clone git@server:/srv/sample.git 项目,git pull 获取到代码。 这里也可以通过自己配置 git 服务器的钩子函数,使其自动更新代码,我还没配置,就先不说了 - -。 好了,现在现在基本环境配置好了就可以开始开发你的项目啦。 另外附:项目在服务器上启动了,发现在本地电脑无法通过 ip 访问,那么可能是你的端口号没有开放,需要去服务器上设置安全组。具体添加方法,以及其他一些关于服务器的配置,都可以随时点击右侧的 点我提问,像云博士提问。 = =入口 博客到这里就结束啦,希望可以帮到大家,最后还要跟大家说的一件事就是在使用阿里云服务器时,出现任何问题都可以在控制台提交工单,让阿里的程序员们来帮你解决问题,但是工单的回复速度可能会比较慢 如果在阿里云官方买产品包括:云服务器,云数据库等, 参考下面这些建站干货:阿里云产品2000元代金券领取地址:阿里云云小站阿里云官方最新活动公布地址:阿里云官方最新活动 (实时更新)阿里云服务器实例规格组地址:官方云服务器实例阿里云学习路径地址:阿里云学习路径

优秀的个人博客,低调大师

2020 年恶意软件状况报告:Mac 威胁首次超 Windows

Malwarebytes Labs 发布了 2020 年恶意软件状况报告,该报告提供了从产品遥测、honey pots、intelligence,以及 Malwarebytes 威胁分析师和记者进行的其他研究中收集的数据集,以调查网络犯罪分子在 2019 年对消费者和企业造成的主要威胁。 Malwarebytes Labs 方面表示,其提供的分析内容包括了对 Mac 和 Windows PC,Android 和 iOS 的威胁,以及一些基于浏览器的攻击。此外,该团队还检查了消费者和企业对全球特定区域和行业所面临威胁的检测。并研究了 2019 年的数据隐私状况,包括州和联邦立法,以及一些大型科技公司的隐私失败与其他前瞻性政策并列。 该报告发现的一些威胁内容如下: 与针对 Windows PC 的威胁相比,Mac 威胁呈指数增长。 2019 年每个 Mac 端点平均 11 个威胁,几乎是 Windows 上每个端点 5.8 个威胁的平均值的两倍。总体而言,Mac 威胁同比增长了 400% 以上。 攻击性广告软件,特洛伊木马和 HackTools 主导了针对业务端点的全球威胁,比去年同期增长了 13%。 由特洛伊木马转为僵尸网络的 Emotet 和 TrickBot 在 2019 年回归,且威胁性名列前茅。特别是 TrickBot 的检测量比前一年增加了 50% 以上。 攻击企业的净新勒索软件活动达到历史最高水平,Ryuk 和 Sodinokibi 等勒索软件家族分别增长了 543% 和 820%。 要了解有关 Mac,Windows,Android 和 Web 一年中最大的威胁以及商业和法规中数据隐私状况的信息,可在此处查看完整的 2020 年恶意软件状况报告 。

优秀的个人博客,低调大师

首次曝光 | 阿里AI芯片含光800硬核编程模型

阿里妹导读:今年,平头哥发布全球最强AI推理芯片含光800。在杭州城市大脑的业务测试中,1颗含光800的算力相当于10颗GPU。在业界标准的ResNet-50测试中,含光800推理性能达到78563IPS,比目前业界最好的AI芯片性能高4倍。究竟是什么模型打造出如此性能,今天,我们请来阿里高级技术专家一皓来聊聊它的编程模型。 前言 当我们手拿含光这把神兵利器的时候,首先要了解这把剑的精华。比如杨过用的玄铁重剑,其剑法要诀是“重剑无锋,大巧不工”,其中境界,远胜世上诸般最巧妙的剑招,越是平平无奇的招数,对方越难抗御,如挺剑直刺,劲力强猛,轻重刚柔随心所欲,刚劲柔劲混而为一,威力远比变幻奇妙的剑招更大。又如金蛇剑,形状奇特,却因此比之寻常长剑增添了不少用法,配合“金蛇秘笈”,颇多招式看来绝无用处或者甚不可解的,尽成厉害招术。虽然这是武侠小说中的创意,但金大侠确是有深意:剑不同而诀不同,需为剑量身打造剑法心诀,才能发挥剑的威力。 如果由我来理解,含光的精髓在于“利”,如一把削铁如泥的宝剑!使用如此锋利的宝剑,其剑道需要由繁化简,由简而快,达到返璞归真。在芯片领域,特定领域架构(Domain-Specific Architecture, DSA)正是一种由繁化简的思路。虽然怎么去做到真正的由繁化简其实很难! 编程模型(Programming Model),就是从开发者和用户的角度出发,基于NPU的硬件系统,软件系统的架构和特性,提炼出怎么理解和使用NPU的要诀,主要包括: 硬件模型:设备和核心的抽象及相互关系 存储模型:即存储的分级,各级主要特性和相互的关系 深度神经网络在含光NPU系统上的结构模式 深度神经网络在含光NPU系统上的布局模式 执行网络的异构和并行模式 通过对这些的了解,我们大致能在顶层抽象上,对含光800NPU建立一个整体的模型,理解编程使用含光NPU的基本要点,为后面具体使用打下坚实的基础。 深度神经网络推理计算模型 在开始介绍含光800NPU的编程模型之前,有必要看看深度神经网路推理的计算模型。分析一下CPU,GPU,以及其他AI芯片的计算模型。通过这个对比,应该可以帮助大家理解含光的特点和编程模型。 推理计算特性 首先借用网络上的训练和推理介绍图来看看推理计算的最简单的计算模型是什么。虽然这是一个非常非常基本的知识点,还是请允许我再强调一遍。 如果只关注计算部分,我们可以这么简单地理解: 训练是双向计算,先将输入和网络模型参数做前向计算得到结果,然后根据标签,做逆向的计算,修改网络模型参数。 推理的计算是单向的,网络模型参数是训练之后固定下来不会再改变的,可以认为是一个常数,输入和模型参数计算之后直接就得到推理的结果了。可是在当前几乎所有芯片的实际计算模型中,并没有特别的体现这一个特性。 其他芯片计算模型 深度神经网络确实是名副其实的比较有“深度”!这就导致了当前主流的网络模型参数量都很大。即使有很多轻型模型的网络模型设计,加上量化,剪枝等技术配合,大部分网络模型还是远远大于当前芯片的Level1缓存的大小,何况缓存还需要存放输入,输出,和中间临时计算结果。 看看来自于网络的两张对比图,分别是CPU,GPU,TPU在存储子系统架构和计算单位两个方面的对比。 AI推理计算时,大多数的芯片系统中,虽然计算的单元有区别,比如CPU以scalar为主, GPU Tensor Core 以vector为主,华为DaVinci AI Cube Core以Tensor为单位,但输入输出(即激活/activation)和模型参数(即权重/weight)是无差别对待的,把他们都看作是计算中的等价的操作数。从存储系统以及计算上都没有体现出任何区别。因此在编程开发中,用户不需要特别地关注模型参数的管理。 在TPU的架构中,激活Activation和权重Weight有了区分。特别的,TPU可以显式地管理权重,使用独立的权重FIFO来调度。由于权重的简单和特殊性,这种方式能简化调度,提高FIFO利用率,保证更高的吞吐量。 含光800硬件模型 含光的设计中,最重要的一点,就是利用相对比较大的一级存储,将网络模型的权重布局和分配好,保证权重一次上传之后,就能一直保存在本地存储中,避免了这部分数据的频繁地上传。这样既降低了对带宽的需求,也让整个计算流水线的设计变得相对简单了。 下图是含光800NPU的一个核心的示意图,详细芯片的架构图可见上一篇介绍。交代一些此处的用词: 设备(Device):此处指的是含光800NPU(Neural-network Processing Unit),一个设备就是一块NPU卡。 核心(Core):一个完整的计算核心,可独立调度运行的最小单位,组成如下图: 本地存储(Local Memory):核内存储,核间连接。含光800 NPU核心简图 每个含光800 NPU核包含4个Tensor Array和对应的本地存储(LM);LM里存放权重,激活(输入,输出,临时),等各种计算所需数据。权重是一次性装载后常驻LM,其他数据是每个批次(batch)流水处理的。 含光800编程模型 存储 从系统的角度来看,存储系统可以分为4种不同级别: L0 Cache/Buffer 特殊用途的cache/buffer,比如给累积缓存(Accumulation buffer)等。由于这部分属于硬件控制,从编程的角度来说完全不可见。编程模型通常不需要考虑这一级别的存储。 Local Memory 片上核内存储,HanGuangAI软件栈分配控制。HanGuangAI应用层不能直接访问和控制核内存储,没有相关操作的任何API,但可以通过核心分配来间接地影响使用情况。 Host Memory 映射到设备地址空间的主机内存(PageLocked Host Memory),NPU可以DMA访问。软件栈负责分配和使用这部分存储。应用层也可以通过HanGuangAI的API直接分配和使用。 System Memory CPU访问的主机内存,NPU不能直接访问。 后面两种存储是应用层可访问的。特别的,应用层可以通过HanGuangRT API创建相关的张量,并读写数据。在上传和下载过程中,如果按照NPU的规则直接把数据放到Host Memory,相比放到System Memory,可以少一次拷贝,对整体性能功耗是有好处的。当然由于这部分(Host Memory)大小比较有限,所以需要快速周转,提高存储的利用率。 深度网络模型 深度神经网络是以图的方式表达,以算子(Operator)做为节点。从一个训练好的网络模型到含光NPU上的可执行指令。网络模型需要量化和编译两个步骤: 1)量化 含光800 NPU主要算子是8-bit和/或16-bit整形和运算。需要使用量化操作将32-bit浮点精度的网路模型转化成对应的整形运算。为了让量化更能充分利用含光NPU的设计,HanGuangAI整合了量化的功能,使用了一些特有的量化技巧来达到更好的效果和效率。 HanGuangAI软件栈提供python的量化接口。量化分为两个步骤:校准和量化。两个步骤分别在原来的模型中插入了适当的校准和量化算子,这些算子有HanGuangAI提供,做为原始框架的自定义算子。请参考HanGuangAI相关文档了解校准和量化的细节。 上图是量化产生的网路图的部分节点示范图 2)编译 高效的推理运行模式,是将整个网络做提前编译(AOT),生成优化的后端代码。运行时把整个网络看作一个整体执行运算。我们把这个可执行的整体叫做一个运行引擎(Engine)。 如果所有算子都能在含光NPU上执行的话,这个网路就变是一个单独的引擎。实际在一些网络中,像TensorRT一样,有些算子现在的含光NPU软件或者硬件不支持。这时候,我们需要对整个网络做合适地分割,分成一段一段能支持的子网络,然后再对每一段子网络进行编译,这个过程是由HanGuangAI软件栈来完成。 编译后的图结构是一个经过算子融合简化的图结构。包含一个或多个NPU引擎算子(AliNPUEngineOp)和0到多个原来的算子。如图: 另外,编译后的网络模型的格式和输入一样,比如原来是Tenorflow的pb格式,编译后输出还是pb文件格式。这样在插入我们的自定义算子之后,可以保证网络模型能在原来的框架中运行。 3)网络的结构模式 综上所述,从网络结构和算子属性的角度来说,用于推理的模型有以下4种模式: 原始模型(Original Float Model) 校准模型(Calibration Model) 量化模型(Quantized Model) 编译模型(Compiled Model) 另外,通常来说,剪枝压缩不会改变网络结构,这里没有特别的讨论相关影响。 异构执行 编译网络模型在NPU上的计算执行,是以一个NPU引擎算子为运行单位的。NPU引擎算子将通过HanGuangAI的软件栈,执行在含光NPU上。 如果一个网络模型的所有算子都被编译在一个引擎算子里,推理的计算运行就比较简单了。但如果网络模型包含其他算子,或者被分割成了多个引擎算子,这时候,其他的算子需要在其他的设备上运行,比如CPU,GPU。 比如上图的编译模型,AliNPUEngineOp是有NPU执行的,而NonNPUOp(SparseToDense)可以在CPU上执行。 这种异构计算可以由几种工作模式: 基于框架,这是一种简单的方式,利用框架的多设备异构执行的支持。因为编译后的模型文件格式一样的,所以如果原来有框架可以执行,可利用框架来执行。框架可以根据设置将其他的算子转到对应的设备上执行。 实际应用中,很多用户有自己的推理引擎,以前是直接使用比如TensorRT在GPU上做推理,TensorRT不支持的算子,会有CUDA或者其他库在GPU上执行,或者使用CPU库在CPU上执行。现在使用含光NPU,只需要使用HanGuangRT,将NPU引擎算子的支持加到这个推理引擎中,然后把其他NPU不支持在其他设备上实现。 后续,我们会提供更多的方式友好地支持异构执行,保证执行的方便和流畅。 权重装载 如前所述,含光NPU的高效工作模式,是需要将权重数据等全部事先分配好空间,这样就避免运行过程中重复地从Host上传权重数据到LM。由于我们有很多不同的业务情况,有些模型很小,只需要少数的几兆空间,有的模型很大,有的模型被分割成多个引擎,还有很多业务需要几个到十来个模型一起协同工作。因此我们需要提供灵活多变的装载模式。 我们在编译的时候,根据引擎需要的存储大小和可以使用的核心数等信息,我们提供一些不同的解决方案: 单核单引擎 模型比较小,编译成一个引擎,比如ResNet50,一个核心能够容纳下,编译出的引擎以单核心为最小运行单位。在Runtime运行时: 既可以每个核心装载一个不同的模型,可以独立地运行 也可以将这个模型同时装载在多个核心,多个核心并行工作,提高吞吐 单核多引擎 引擎比较小,而且不需要并行时,可以将多个引擎放在同一个核心上,这时候根据是否共享输入/输出/临时空间,又可以分为两种: 共享输入/输出/临时空间,输入/输出/临时都是按照最大的来分配,这样可以放更多的引擎 不共享,完全独立分配空间,逻辑简单,但需要更多空间 多核单引擎 这是一种特殊的工作模式,由于单个引擎的大小超过了一个核心的存储大小,可以将单个引擎分布在多个核上,主要是将权重分割,多个核心协同工作。 多核多引擎 复杂的应用场景了,有时候一个应用流程里,需要几个步骤,几个或者十来个不同的模型,为了保证这些模型能流线性的高速地执行,我们需要将多个引擎分配在多个核心上。当然这些分配是有HanGuang编译来分析和适配的。结果会返回给用户做评估。 跨设备多引擎 这是更充分地一种扩展方式,保证更复杂场景的应用。多个设备一起合作,完成一个复杂的应用场景,保证足够好的性能和吞吐。以下例图,整个业务由engine0和engine1提取特征分割,engine2/4做一类特征提取和识别,engine3/5做另一类的特征提取和识别。其中engine0特别大,需要4核协同处理。 以上各种解决方案,我们现在主要是由用户指定网络模型和可用资源(设备和核心),软件栈编译器做相关具体的优化配置,并在在编译后的结果中提供一个执行方案,然后推理运行时根据执行方案和实际的设备/核心情况做动态的运行分配。整个过程基本是不需要用户做太多的干预,即能达到比较好的效果。当然理解这些工作模式可以帮助用户做更深层次的控制和优化。 并行执行 深度神经网络计算在并行上要求很高,不同的芯片通过不同的方法,在不同的维度上去实现并行执行。在之前的一片文章里提到过一些对比。 含光NPU的并行模式和权重装载的方式相关,权重装载是基础,为特定的并行方式提高数据支持。而并行执行更多的是从数据流动的角度来看。可以从三个层次来看待并行执行的模式:DMA/compute引擎,核心之间,核心内部各管道(pipe)。 1)核心并行 这个层次的并行,是NPU核心在一个输入批次(batch)级别的并行。具体地说,如何把多个输入分布在多个核心上,让所有的核心都能运行起来,提高利用率。下面几种模式: 核心并行模式 每个核心执行一个batch,N个核心共同工作完成N batches。这是简单高效的方式,适合网络能够运行在一个独立核心上,而执行批量比较大的情况。由于每个核心执行的计算是一样的,所需要cycle数相同,因此核心利用率很高。 核心协同并行模式 也是每个核心执行一个batch,也就是统一时间,N个核心共同工作完成N batches,但与上面不同的是需要核心之间协同。这种对应上面的“多核单引擎“装载模式。由于权重是分配到多个核心上的,因此需要核心之间的相互合作和核间数据传输。 核心流水线模式 多核心合作完成一个batch,所以输入的batch是一个一个进入到NPU的。比如,第一个核心先完成整个业务的一部分,完成之后传到后面的核心,然后第一个核心接着做下一个batch。因此,同一时刻,多个核心可以都在并行计算,但计算的不是同一个部分,而是已流水线的方式传递。 混合模式 复杂业务情况下,上面多种并行方式的组合。一些核心之间,或者一个时段是核心协同并行,而另外一些核心或者其他时段是直接的核心并行。 核心的并行,像上面权重装载一样,大部分是软件栈来配置和实现的。但也通过软件接口提供配置方式让用户可以做一些调整和选择。 2)计算和数据传输并行 需要软件保证整个数据流的通畅: 上传数据:System Memory-->Host Meomry-->Local Memory 计算:compute 下传数据:Local Memory-->Host Momory-->System Memory 3)核内计算并行 核内有多个硬件引擎,如果没有数据依赖,引擎之间也是可以并行的。基本上可以认为模型/算法开发者不需要考虑这方面的并行,编译器会根据图和数据依赖来做相关的优化,所以不在这里做详细介绍。 答疑 上面从NPU架构,存储系统,网络模型,装载和执行几个方面建立了整个系统的编程模型。读者对整个编程模型了解之后,可能会产生一些问题。在回答一些问题之前,我先强调一个重点:含光800NPU是为数据中心和大型端上设计的。这两个场景的特点是: 数据中心上会有数量众多的NPU可以做分配和调度 大型端上,业务场景固定,推理的算法一旦确定实施,网络模型也就固定下来了,不需要动态的调整模型, 这两个场景的特点是硬件设计和编程模型设计的重要根据。因为这意味着我们要不可以动态地申请额外的核心,要不可以提前保证有足够的核心。 下面我根据自己的判断回答一些可能的疑惑: Q:一个含光800NPU能放下所有模型吗? 首先,一般的大网络模型,通过多核单引擎的模式,基本都能在单张卡上运行。另外含光800NPU也支持压缩的网络模型,有些网络模型可以做到在有限的精度损失的情况下,获得很高的压缩比。 其次,碰到特别大的模型,一张卡放不下的时候,可以使用分割然后在两张卡上运行。所以通常我们不建议破坏权重常驻本地存储的模式,因为这样会影响性能。 如果说极端情况,就是只有一张卡,就是要跑超大网络网络,一个方法是分段大批量执行,把中间结果暂存。我想即使使用如此大的模型,应该是不会考虑单批量(即一个batch)的延迟了。 Q:看起来多模型装载很复杂,用户能掌握吗? 在上面文章中提到,绝大部分的模型装载逻辑由编译器来处理。用户只需要指定那些模型要一起编译,以及设备和核心的资源情况。编译器内会根据相关信息建立成本模型(Cost Model),选择一个相对最优的分配生成一个执行方案供用户使用。这个执行方案由HanGuangRT读取并根据实际的物理资源分配,所以通常不需要用户介入。当然用户也可以读取查看。 所以总的来说,开发用户不需要掌握太多细节就可以很方便地使用多模型装载模式了。后面在API介绍中会具体地讲解相关的使用。 Q:算子支持情况怎么样?异构执行设备间切换太频繁会不会导致性能下降太多? 如果一个网络模型被分割成很多的子网络,这种情况确实会严重影响推理的系统性能的。所以我们正在努力地完善软件栈,支持更多的算子和网络模型。 现在阶段图像,视频,搜索,推荐等应用的主要模型都没太大的问题。我们正在向集团内各业务方收集更多的算法模型,进一步完善。 另外软件栈也在做异构执行的优化,包括一些算子的CPU优化,以及减少异构切换的性能损失等。后续会发布更多的模型的性能数据。 后记 作者在写这篇文章的时候,英特尔首席架构师Raja Koduri正好在上海,在接受新闻媒体采访的时候,他强调了Intel最近提出的“软硬结合,软件为先”的策略。提到了一些观点: 软硬结合,可使摩尔定律的提升幅度变成10倍级别,因为软件可以将越来越多的晶体管性能潜力释放出来。 软件的重要性,是其他领域的10倍,没有软件的支持,无法实现计算性能的指数级的增长。 Intel现在推崇SVMS异构:标量(Scalar),矢量(Vector),矩阵(Matrix),空间(Spatial)四种架构,通过多种多样的组合方式异构。 对比Raja的这些观点和含光软硬结合的DSA芯片架构,有不少的相似之处! 不过,我们可以看到,不论是软硬结合,特定领域架构,还是多维异构,都对软件有更高的要求,远远超过去十几二十年的软件变迁。这些影响是多方面的: 编程语言(接口):如何用统一的编程语言来对异构架构,各种DSA硬件架构编程。(Intel 在设计oneAPI) 编译器:多种DSL(Domain Specific Language),对接各种硬件架构,对新的编译器技术的渴求 异构与并行:不同级别的异构,包括: 片上不同类型的核间 同一系统的不同架构芯片 互联的不同系统 总的说来,软件栈变得复杂了很多,需要软件架构的进化!后续我们也可以在软件栈架构方面做更多的探讨。 回到含光800NPU的开发和编程,乍一看,有些思路和在CPU或者GPU上编程很不一样。但是在经过软件栈对硬件特性的提炼和包装之后,实际使用起来是很方便的。开发者能通过主流的深度学习框架无缝使用含光NPU,也能比较方便地使用HanGuangAI开发部署推理引擎,充分发挥含光NPU的性能。 正所谓利剑在手,剑道心诀已熟记在心,只等开始学习剑法了! 原文发布时间:2019-12-19作者:一皓本文来自阿里云合作伙伴“阿里技术”,了解相关信息可以关注“阿里技术”。

优秀的个人博客,低调大师

首次 OpenChain 中国活动,从 Patrick 代行 GPL 执法案讲起

9 月 25 日,第一次OpenChainChinaWorkshop 在深圳举行。 OpenChain 是 Linux 基金会下的一个项目,它制定了一系列标准规范,这些规范和条例包含一系列管理流程,用来帮助各种规模的组织更高效地解决他们的开源许可证一致性问题。通过统一的 OpenChain 规范,开源许可证的一致性将变得更加可预测和易于理解,参与者可以更有效地参与到软件供应链中。 OpenChain 项目目前已有多位白金会员,包括 Adobe、ARM、谷歌、Cisco、微软与 GitHub 等。 通俗地来说,OpenChain 项目可以理解为,它统一了一套在整个开源软件供应链上的认证标准,加入的供应商及其项目都需要经过合规认定,之后大家在 OpenChain 这么一个统一的框架下,就不需要再担心开源供应链上关于开源许可的相关问题。而这也就是为什么当天参加会议的大多是各个公司的法务与知识产权相关的代表。此外,OpenChain 还通过一套程序将这个认证过程简化了。 开源软件合规无法由一个人单独完成 其实不仅是国内,目前整个开源界对于这个问题的探讨都处在早期阶段,这其实涉及到开源软件专利问题,这里也不得不提一下相关项目 OIN(Open Invention Network)。 OIN 是一个共享的防御性专利池,旨在保护 Linux 及其相关的开源项目。OIN 已经拥有多个行业领导者支持,包括谷歌、IBM、NEC、飞利浦、红帽、索尼、SUSE 和丰田等。任何从事 Linux、GNU、Android 或其它Linux 相关的软件开发的公司、项目或开发者都可以加入 OIN,通过交叉许可而免费获得数千项专利或版权。 可以简单理解为 OIN 项目主要针对开源软件(并以 Linux 为基础),比如它定义了一个集成了各种软件专利认证的 Linux 操作系统是怎么样的,这可以结合微软之前开放 exFAT到 Linux 内核时所做的承诺来理解:微软同时也宣布支持在未来OIN 的 Linux 系统定义版本中最终包含具有 exFAT 支持的 Linux 内核;而 OpenChain 项目主要面向的是公司层面。 为什么 OpenChain 与 OIN 都关注到开源软件专利相关的问题呢,从会上多次被提到的Patrick McHardy 案例可以大概看得出来。 Patrick McHardy 是 Netfilter 核心开发团队的前负责人,Netfilter 是Linux 内核的一个实用网络工具,在 Linux 内核中占有比较重要的地位。来自 Linux 基金会的 OpenChain 项目总经理ShaneCoughlan 介绍,Patrick 通过给全球各个国家(包括中国)使用到 Linux(也就是使用到了Netfilter)的公司发送邮件,以他们项目没有遵守 GPL(Linux 内核采用的开源许可协议)为由索要小额金钱,但这并不是 Linux 的主张,据介绍,Patrick 此前已经通过这种方式获得了数百万欧元。Patrick 被称为“自行担负起GPL 执法的角色”与“开源专利流氓”,同时他的索要方式也在不断演化。 虽然开源社区对如何以最好的方式来推动公司遵守 GPL 条款也有许多苦恼(公司没有正确采用 GPL 协议本身就是不对的),但是像 Linux 大多数人认为这种维权应该是非正式的,也就是不应该通过诉讼,并且主要的目的也应该是告知合规,而不是为了惩罚企业。Patrick 的方式之所以能够奏效,主要也是因为这种机制里边存在着过多的“道德因素”,没有强制效力;并且由于像 Linux 内核这样的大型项目,它的所有权通常是分散在不同开发者手里,那么这些个体所有者就可以采取不符合社区整体目标的维权行动,Patrick 就是以一人的想法代替了整个 Linux 内核在进行所谓的维权(当然了,Linux 社区唾弃他)。 所以我们可以看到开源软件会在运作中产生这样那样的专利许可等问题,并且对于整个软件供应链会造成严重的破坏,OpenChain 与 OIN 可能就是行之有效的解决方案。 回到此次 OpenChain 会议上,会上大家还讨论了当前中国公司在开源方面面临的一些问题与挑战,特别是关乎到整个开源软件供应链上的问题,诸如目前没有便捷的机制去把控公司使用到的开源项目的合规性,比如从 npm 或者 Maven 等软件平台上下载一个项目,这些项目虽然声明了采用某某开源协议,但是当你只想要快速、简单地使用它提供的二进制包时,那这种时候,怎么去确认它的协议合规性呢?同时项目下又可能会依赖许多其它的项目,这又使同一个问题更加复杂;又比如有人提出源代码继承问题,比如开源贡献者死亡,那么他所写的代码的继承如何处理? 目前 OpenChain 相关活动已经在日本与韩国等地展开,中国这还是第一场线下活动。开源软件供应链上的相关问题虽然棘手,但是现场Shane 与 OIN 首席执行官 KeithBergelt 都认为接下来的 5 年内,中国在这一方面的建设将会跑在世界前列。 关于 OpenChain 的更多信息查看官网: https://www.openchainproject.org

优秀的个人博客,低调大师

首次发现在例程中使用日语命名的编程书籍

初めてのJavaScript 第3版 -- ES2015以降の最新ウェブ開発. 示例代码: class Person { constructor(name) { this.name = name; this.id = Person.nextId++; } } Person.nextId = 0; const 一郎 = new Person("一郎"), /* id 0 */ 次郎 = new Person("次郎"), /* id 1 */ 三郎 = new Person("三郎"), /* id 2 */ 四郎 = new Person("四郎"); /* id 3 */ const arr = [一郎, 次郎, 三郎, 四郎]; /* 1. IDを使って直接比較 */ console.log(arr.find(p => p.id === 三郎.id)); // Person { name: '三郎', id: 2 } /* 2. thisを利用。thisを定数「三郎」に指定 */ console.log(arr.find(function(p) {return p.id === this.id}, 三郎)); // Person { name: '三郎', id: 2 } /* アロー関数ではthisは「語彙的に(lexically)」に束縛される(6章参照) */ console.log(arr.find(p => p.id === this.id, 三郎)); // undefined 译者对采用日语命名的缘由在此阐述初めてのJavaScript 第3版 -- ES2015以降の最新ウェブ開発(2016年12月): 翻訳の過程で、一部の例を日本語の識別子(変数名や関数名など)を使って書いてみましたが、「日本語で関数名や変数名を考えるのはとても楽だなあ」と感じました。英語を仕事で毎日使っている私でもそうなのですから、普通の方ならなおさらでしょう。コメントと識別子の区別がつきにくいなど、慣れないと少し読みにくい印象はありますが、特に書く際の負担はだいぶ減るように感じます。また、たとえば単数形のbookで、値をひとつ記憶する変数、複数形のbooksで配列を表すといった手法が日本語では使えないなど、日本語独特の工夫が必要になる場面があるかもしれません(一部の例では「本」と「本_配列」のようにしてみましたが)。これからは、日本国内をターゲットにした開発では徐々に日本語識別子が使われることになるのでしょう。英語の本を読むよりも、日本語にていねいに翻訳された本を読むほうが理解がずっと早いのと同じです。 倚靠在线翻译, 大致意思如下, 如有出入请指教: 日语命名函数/变量对常人更易理解, 即使译者在日常工作中使用英语仍是如此 虽然使用日语命名导致注释和实际代码行有些难以区分(日文注释+英文代码会比较显眼), 但译者编写时更容易 <--这里不大确定含义 有时单复数难以在日语中表达, 此时还是沿用英文命名 -- 中文命名也有类似情况, 之前的探讨: 中文命名的特定问题, 相关风格及规范 · Issue #45 · program-in-chinese/overview, 在代码中进行中文命名(类/变量/方法等)的优势 最后提到(粗体部分): 对面向日本国内的软件开发, 将会逐渐普及使用日语命名. 阅读使用日语命名的编程书籍会比英文原版更容易理解. -- 听起来似乎是有某些日本的业内推动力量, 值得深入发掘一下. 补译者 武舎 広幸 Hiroyuki Takeba 简历(机翻): 出生于长野县上田市。他在东京工业大学,科学技术研究生院,国际基督教大学,山梨大学研究生院,俄亥俄州立大学研究生院,卡内基梅隆大学机器翻译中心等完成博士课程。作为Merlin Arms Co.,Ltd。(http://www.marlin-arms.co.jp)的代表董事,他从事与计算机和自然科学,软件开发(翻译软件等),软件项目管理,在线翻译课程(http://www.dhc-online.com)相关的翻译和写作。和字典网站(http://www.dictjuggler.net) 另外, 看来日语命名在日本开发者中也是有阻力的, 日本語識別子(変数名や関数名)を好まれない方がいらっしゃるようですので - "似乎有些人不喜欢日语标识符(变量名和函数名)"(在初めてのJavaScript 第3版 -- ES2015以降の最新ウェブ開発). 确实在Amazon上有一星抱怨日语命名的, 但感觉并没什么说服力. 无论如何, 日本编程书籍出版商在推广母语命名上先行一步了. 期待中文示例代码的编程书籍早日面世. 源讨论帖在: 索引: 用中文代码作示例的编程教程 · Issue #5 · program-in-chinese/overview 2018-11补: 译者发消息, 重印(第四次印刷)已经确定. 另外, 经告知之前有一本"我的第一本编程书"日文编程书的中译本中使用了中文命名的示例代码, 但因为偏算法, 个人感觉母语命名的优势不是特别明显. 2019-2-16补: 发现2003年的日文论坛提到, 2003年出版的"MYSQL徹底活用(翔泳社-初版)"一书中(貌似MySQL徹底活用―SQL言語+サーバアプリケーション+管理者編 データベースの本), 使用了日文命名的示例代码: CREATE TABLE 社員 ( 社員番号 INT NOT NULL, 氏名 CHAR(20) NOT NULL, 性別 ENUM(`男`,`女`) NOT NULL, 部署コード INT NOT NULL, 入社年度 year NOT NULL, MAIL CHAR(40) NOT NULL, INDEX (社員番号), INDEX (氏名) ); 2018-10-18

优秀的个人博客,低调大师

首次使用 linux 阿里云服务器,入门及使用

上午编辑的文章 下午更新下 安装环境 因为服务器默认 linux 系统,所以这里讲怎么配置 linux 云服务环境。 我第一次使用的时候,还以为是要去安装一个界面化桌面,以便我这个命令小白可以操作。但是,对于只有2G 的内存来说安装了之后将会很卡很卡。后来我问学长,他说不要安装界面化,使用命令就好了。 首先关于远程服务器的登录入口, 默认系统的用户名是 root, 然后登录密码可以在控制台进行修改。如下图点击重置密码。 重置之后,然后点击远程连接,就可以连接登录到你的服务器上了。这里要将一点,如果你是 mac 电脑的话,可以在你的电脑上通过 ssh 登录到你的服务器。 命令如下: ssh root@你的公网IP,比如 ssh root@120.78.32.12 然后输入密码即可连接成功。 接下来在终端中输入命令。配置环境。如果你是配置 j

优秀的个人博客,低调大师

TIOBE 6 月编程语言榜:TypeScript 首次跻身前100

TIOBE 公布了 6 月编程语言指数排名榜,此次榜单的焦点在于 TypeScript 成功跻身前100名,以及 C 语言指数再度暴涨。 TypeScript 语言已经被 TIOBE 追踪了好几年,作为微软推出的 JavaScript 增加版,尽管它在业界的知名度很高,但是从未进入前100名。本月 TypeScript 终于进入了 TIOBE 指数排名前100,居第93位,相反,JavaScript 下降了一位,排到第8。TypeScript 是 JavaScript 的一个严格超集,它为 JavaScript 增加了很多额外的类型安全,前景是被看好的。 C 语言的指数还是一路上涨,继上个月上涨7个百分点后,本月涨幅更是达到了8.09%,在整个榜单中格外显眼。目前 TIOBE 榜单中排名第一的依旧是Java,但是领榜15.368%的指数与第2名C 的14.936%相差已经不多了,如果 C 再按照这样疯狂的增长速度向上,那下个月的头把交椅可能就让C 拿了。 而上个月强势杀入前20名的 Scala 在6月份又下降了3位,退出20名行列,排到23。 6月榜单前20名语言如下: 需要注意的是,SQL自 2018 年 2 月起被重新添加到了 TIOBE 排行榜中,由于没有以往的数据可以对比,所以会给人 SQL 语言指数突然暴涨的错觉。 Top 10编程语言TIOBE指数走势(2002-2018) 可以看到 C 语言的黑线在一路上扬,差不多与 Java 相交了。 其他编程语言排名 第 21-50 名如下: 第 51-100 名如下,由于它们之间的数值差异较小,仅以文本形式列出(按字母排序): (Visual) FoxPro, 4th Dimension/4D, APL, AutoLISP, Bourne shell, C shell, CFML, CL (OS/400), Clipper, Common Lisp, Crystal, Elixir, Elm, Euphoria, F#, Forth, Groovy, Hack, Haskell, Icon, Inform, Io, J, Korn shell, ML, Monkey, MQL4, NATURAL, NXT-G, OCaml, OpenEdge ABL, Oz, PL/I, PostScript, PowerShell, Q, RPG, S-PLUS, Scheme, Simulink, Smalltalk, Solidity, SPARK, SPSS, Standard ML, Stata, Tcl, TypeScript, Verilog, VHDL 历史排名(1988-2018/每5年) 以下排名位次取决于 12 个月的平均值: 编程语言名人堂 历届“年度编程语言”获奖名单如下图所示,该奖项授予一年中评分最高的编程语言: 详细榜单信息可以查看 TIOBE 官网。 你用什么编程语言?

优秀的个人博客,低调大师

快递老大顺丰,首次披露自己的技术“护城河”

划重点: 顺丰上半年营收321.61亿,雷锋网对比发现比申通、韵达、中通、圆通四家上半年累计总营收多85亿,顺丰交出了一份漂亮的成绩单。 2017年上半年顺丰净利润为18.84亿元,同比增长7.31%,与此同时,2017年上半年圆通同比增速为6.29%,中通同比增速为59.48%,韵达同比增速为41.13%,申通同比增长7.31%。 顺丰的营收一路高歌,始终稳居快递行业的龙头老大,但是其净利润增长却落后于圆通、中通、韵达,与申通持平。此外,雷锋网(公众号:雷锋网)整理2016年三通一达和顺丰最新18个月的数据,其中顺丰的净利润增幅变化幅度是最大的。方方面面的考虑之下,加码科技似乎不二的选择,事实上顺丰亦大手笔地进行技术技术力量的投入。 顺丰也在上半年中,前所未有地披露自己在科技力量上投入,雷锋网进行了综合的筛选、删减、梳理出顺丰在技术上的

优秀的个人博客,低调大师

iOS: 首次使用App时,显示半透明新手指引

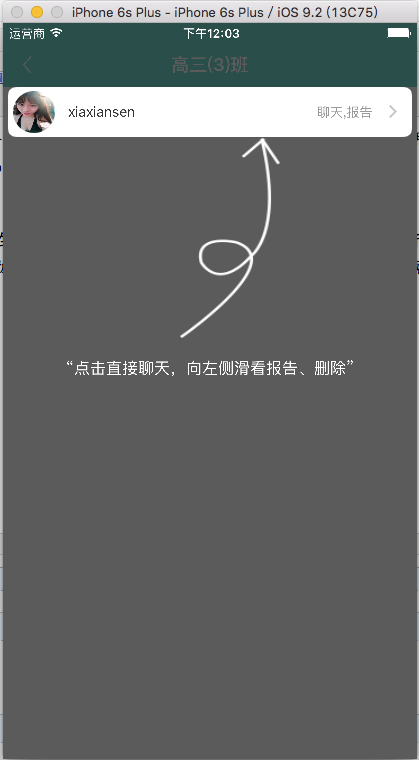
在很多的app,我们都会发现这样一个功能:就是app启动后进入主界面时,会有一个半透明的指引图,它会提示用户如何一步步进行操作,快速的熟悉app的使用规则,极大地方便了用户的使用,也加快了app的推广,优点不言而喻。 我主要介绍一下思路: 首先创建一个半透明的蒙版覆盖在当前整个屏幕上,然后用贝塞尔曲线绘制白色的提示框(矩形或者圆形),接着给出带箭头图标的文字提示,也即在蒙版上添加自定义的子视图控件。当然,最后给整个蒙版添加一个触摸手势,只要轻轻点击就移除蒙版、子视图、手势,恢复正常界面。 注意:新手引导只需要出现一次就够了,可以通过偏好设置来控制器只出现一次。 演示截图如下: 出现指引 点击指引消失,按照提示操作 代码如下: 颜色宏定义 // 颜色RGB #define XYQColorRGB(r, g, b) [UIColor colorWithRed:(r)/255.0 green:(g)/255.0 blue:(b)/255.0 alpha:1.0] #define XYQColorRGBA(r, g, b, a) [UIColor colorWithRed:(r)/255.0 green:(g)/255.0 blue:(b)/255.0 alpha:a] 新手指引 #pragma mark - 新手引导 - (void)newUserGuide { // 这里创建指引在这个视图在window上(蒙版、手势) CGRect frame = [UIScreen mainScreen].bounds; UIView * bgView = [[UIView alloc]initWithFrame:frame]; bgView.backgroundColor = XYQColorRGBA(50, 50, 50, 0.8); UITapGestureRecognizer * tap = [[UITapGestureRecognizer alloc]initWithTarget:self action:@selector(sureTapClick:)]; [bgView addGestureRecognizer:tap]; //添加子视图控件 UILabel *textLabel = [[UILabel alloc]initWithFrame:CGRectMake(5, 320, frame.size.width-10, 50)]; textLabel.backgroundColor = [UIColor clearColor]; textLabel.text = @"“点击直接聊天,向左侧滑看报告、删除”"; textLabel.textColor = [UIColor whiteColor]; textLabel.textAlignment = NSTextAlignmentCenter; textLabel.font = fontSize_16; [bgView addSubview:textLabel]; UIImageView * imageView = [[UIImageView alloc]initWithFrame:CGRectMake(frame.size.width/2-30,115,100, 200)];; imageView.image = [UIImage imageNamed:@"CouponBoard_guid"]; [bgView addSubview:imageView]; [[UIApplication sharedApplication].keyWindow addSubview:bgView]; //create path 重点来了(这里需要添加第一个路径) UIBezierPath *path = [UIBezierPath bezierPathWithRect:frame]; // 这里添加第二个路径 (这个是矩形) [path appendPath:[[UIBezierPath bezierPathWithRoundedRect:CGRectMake(5, 64, frame.size.width-10, 50) cornerRadius:8] bezierPathByReversingPath]]; //渲染 CAShapeLayer *shapeLayer = [CAShapeLayer layer]; shapeLayer.path = path.CGPath; [bgView.layer setMask:shapeLayer]; } /** * 新手指引确定 */ - (void)sureTapClick:(UITapGestureRecognizer *)tap { UIView *guidevView = tap.view; [guidevView removeFromSuperview]; //移除蒙版 [guidevView.subviews makeObjectsPerformSelector:@selector(removeFromSuperview)];//移除所有子视图 [guidevView removeGestureRecognizer:tap]; //移除手势 } 参考资料: http://www.jianshu.com/p/00d4fe5a3c1a http://www.jianshu.com/p/b83aefdc9519 欢迎关注我的github:https://github.com/xiayuanquan 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 本文转自当天真遇到现实博客园博客,原文链接:http://www.cnblogs.com/XYQ-208910/p/5714352.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Oracle 原版经典ppt首次公开,免费下载:Oracle RAC Internals

一、Cluster Domain 在12.2中,OracleRAC有很多重要的改进。而Cluster Domain堪称最醒目的变化。 Oracle Cluster Domain为集群架构提供了新的部署选项。为私有数据库云下RAC的部署提供了标准化、集中式的部署,并能够对RAC进行优化。 多个集群配置分组在Oracle Cluster Domain下进行管理,并利用该Oracle Cluster Domain中可用的共享服务。Oracle Domain Services Cluster为在同一个Domain内的其他集群提供了集中的服务,这些服务包括:集中的网格基础架构管理存储库;TFA服务;合并Oracle ASM服务;RHP服务等。 参考阅读:YH4 Oracle Flex Clusters 二、ASM存储 12.2中,通过flex ASM能够对ASM磁盘中的文件进行分组管理,这样每个组就可以存放一个库的文件或者一个PDB的文件。 同时,在一个磁盘组中,可以支持再次分组,以文件组为单位,分成quota组。 好处是可以对文件组再次实现分组管理,如果以复制的方式生成quota group,那么可以改变文件组界别的冗余度。通过Shadow copies 的方式复制PDB的文件组,可以直接生成克隆的PDB。 三、Oracle自主健康检查 在12.2中,Oracle提供了完善的自主健康检查机制,包含集群可用性检查、ORA错误检查、集群健康状态检查、Trace文件分析、内存检查等各个方面。能够对Oracle数据库进行全面细致的健康诊断和把关。 四、内存融合改进 在内存融合的基础上,通过DRM,将资源的主节点动态调整,降低节点之间的数据交互。 数据在节点之间地方交互基本上是LMS进程来完成的。LMS负责访问资源主节点获取资源使用信息,并访问资源持有节点申请资源数据,最后把数据返回给申请节点。 数据在节点间的交互有两种情况,一种是当前块的交互,另一种是一致性块的交互。在一致性块的交互过程中,需要在资源的持有节点进行事务回滚,创建一致性块。这时候,回滚的工作也是由LMS进程来完成。 考虑以下情况:如果资源持有节点事务很大,创建一致性块需要回滚很多步骤,系统将长时间处于等待状态;如果undo表空间不足,回滚出错,未能正常创建一致性块,则数据访问请求会报错,甚至可能引发LMS进程奔溃。 因此,在Oracle 12.2 中,为LMS进程增加了两类slave进程,一类是RMVn进程,负责处理LMS的常规事务,另一类是CRn进程,负责协助LMS在申请一致性块的时候的事务。 五、内存基于PDB的域划分 在多租户环境中,以前内存空间是所有PDB共享的,一个pdb的事务需要做内存寻址的话,需要扫描全局的空间,很不方便。在12.2中,内存空间能够基于PDB做划分。 参考阅读:YH9:Oracle Multitenant 知识库 六、集群重新配置优化 在RAC环境的重新配置中,以前配置过程需要五个步骤完成:Detect(检测到异常)->(Evict)节点驱逐->Elect Recovery Master(选取恢复主节点)->read redo(读取日志并获得相应的锁)->实例恢复。 在12.2中,通过recovery buddy,能够很大程度上减少集群节点的重新配置时间。只需要将出现异常的节点驱逐出去,然后做资源的重新配置就好。 如上图,实现机制就是集群中的每一个节点互为recovery buddy,在共享池里,分配一部分空间存放彼此的内存资源信息。这样,当一个节点出现问题,其他节点可以直接进行资源的重新配置过程,无需访问故障节点。 七、Flex Cluster解决方案 在集群的架构上,12.2提出了Flex Cluster方案,每个集群有两类节点,一类是hub 节点,一类是leaf 节点,前者可以直接访问共享存储,后者不能。leaf 节点可以做成只读节点,reader node,实现业务上读写分离。 leaf node与hub node之间松耦合的方式连接,如果hub node出现问题,与它相连的leaf node可以连接到其他的hub node,避免对业务的影响,实现高可用。 八、GI升级过程详解 最后,作者还分享了如何进行GI从12.1到12.2的升级。 本文出自数据和云公众号,原文链接

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册