首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 初窥鸿蒙

一、什么是鸿蒙 鸿蒙即 HarmonyOS ,是华为公司推出的支持手机、平板、智能穿戴、智慧屏、车机等多种终端设备的分布式操作系统,并且它提供了多语言开发的 API,支持 Java、XML、C/C++、JS、CSS、HML(类 html 的鸿蒙自己的标记语言)等开发语言,而且它提供多种响应式布局方案,支持栅格化布局,可以使用同一套代码部署在手机手表平板等多种不同尺寸屏幕的设备上。 二、开发准备 2.1 环境安装 开发鸿蒙软件需要用到 HUAWEI DevEco Studio,它提供了模板创建、开发、编译、调试、发布等服务。 1、登录 HarmonysOS 应用开发门户,点击右上角注册按钮,注册开发者帐号。 2、进入 HUAWEI DevEco Studio 产品页,登录华为开发者账号后下载 DevEco Studio 安装包并进行安装。 3、启动 DevEco Studio,根据工具引导下载 HarmonyOS SDK。 4、下载 HarmonyOS SDK 成功后会进入欢迎页,点击欢迎页中的 Configure > Settings 打开设置窗口,点击 Apparance&behavior > System settings > HarmonyOS SDK,选中 JS SDK 进行下载。 至此开发环境安装完成。 2.2 新建项目 点击菜单栏中的 File > New > New Project 选择需要开发的项目设备,然后选择 Empty Featrue Ability(JS) 后,点击 Next,此时会出现项目的信息配置 点击 Finish,一个新的项目就被创建出来了。 2.3 项目目录 使用 JS SDK 进行开发的话,需要关注的是 entry > src > main > js 文件夹,其中: i18n 目录下存放的是多语言的 json 文件 en-US.json 为英文模式展示的内容 zh-CN.json 为中文模式展示的内容 pages 下存放的是项目的多个页面,每个页面都由 hml、js 和 css 组成 hml 文件定义了页面的布局、页面中用到的组件,以及这些组件的层级关系 js 文件定义了页面的业务逻辑,比如数据绑定、事件处理等 css 文件定义了 index 页面的样式 app.js 中存放的是全局的 js 逻辑和 app 的生命周期管理 除此之外,还可以自己创建 common 目录用于存放公共资源文件,比如:公共样式和公用方法。 2.4 生命周期 生命周期分为应用的生命周期以及页面的生命周期 其中,应用的生命周期主要分为应用创建时调用的 onCreate,以及应用销毁时触发的 onDestroy。 而页面的生命周期分为: onInit:页面数据准备完成时触发; onReady:页面编译完成时触发; onShow:页面展示时触发; onHide:页面被隐藏时触发; onDestroy:页面被销毁时触发; 由于JS UI只支持应用同时运行并展示一个页面,因此当应用从页面 A 跳转到页面 B 时,首先触发页面 A 的 onHide、onDestroy 函数,然后依次调用页面 B 的 onInit、onReady、onShow 函数来初始化和显示页面 B。 三、组件 在 hml 文件中,组件分为容器组件、基础组件、媒体组件、画布组件、栅格组件,由于篇幅有限,这里只列举一下组件名称和对应的描述,感兴趣的同学可以点击 组件文档 进行查阅。 3.1 容器组件 组件名 描述 div 基础容器 list 列表容器 list-item list 的子组件,用来展示列表具体 item list-item-group list 的子组件,用来展示分组,宽度默认充满 list 组件 badge 新事件标记容器 dialog 自定义弹窗容器 panel 弹出式可滑动面板容器 popup 气泡提示容器 refresh 下拉刷新容器 stack 堆叠容器,子组件按照顺序依次入栈,后一个子组件覆盖前一个子组件 stepper 步骤导航器。当完成一个任务需要多个步骤时,可以使用步骤导航器展示当前进展 stepper-item 步骤导航器子组件,作为步骤导航器某一个步骤的内容展示组件 swiper 滑动切换容器 tabs tab 页标签切换容器 tab-bar tabs 的子组件,用来展示 tab 的标签区 tab-content tabs 的子组件,用来展示 tab 的内容区 3.2 基础组件 组件名 描述 image 图片组件,用来渲染展示图片 image-animator 图片帧动画播放器 text 文本组件,用于展示文本信息 span text 的子组件,提供文本修饰能力 textarea 多行文本输入框 input 交互式组件,包括单选框,多选框,按钮和单行文本输入框 button 按钮组件,包括胶囊按钮、圆形按钮、文本按钮、弧形按钮、下载按钮 chart 图表组件,用于呈现线形图、柱状图、量规图界面 divider 提供分隔器组件,分隔不同内容块/内容元素。可用于列表或界面布局 label 为 input、button、textarea 组件定义相应的标注,点击该标注时会触发绑定组件的点击效果 marquee 跑马灯组件,用于展示一段单行滚动的文字 menu 菜单组件,作为临时性弹出窗口,用于展示用户可执行的操作 select 下拉选择组件,可让用户在多个选项之间选择 option 可作为 menu 或 select 组件的子组件,用来展示具体项目 picker 滑动选择器组件,类型支持普通选择器,日期选择器,时间选择器,时间日期选择器,多列文本选择器 picker-view 嵌入页面的滑动选择器 piece 一种块状的入口组件,可包含图片和文本,常用于展示收件人 progress 进度条组件,用于显示内容加载或操作处理进度 qrcode 二维码组件,用于生成并显示二维码 rating 评分条组件 search 搜索框组件,用于提供用户搜索内容的输入区域 slider 滑动条组件,用来快速调节设置值,如音量、亮度等 switch 开关组件,用于开启或关闭某个功能 toolbar 工具栏组件,放在界面底部,用于展示针对当前界面的操作选项 toolbar-item toolbar 子组件,用于展示工具栏上的一个操作选项 toggle 状态按钮组件,用于从一组选项中进行选择 3.3 媒体组件 媒体组件暂时只有 video 组件一个,除了智能穿戴设备不支持外,手机、平板、智慧屏设备均支持该组件,它为设备提供了视频播放功能。 3.4 画布组件 画布组件展示只有 canvas 组件一个,手机、平板、智慧屏、智能穿戴设备均支持该组件,它为设备提供了自定义绘制图形的能力。 3.5 栅格组件 组件名 描述 grid-container 栅格布局容器根节点 grid-row grid-row 是栅格布局容器 grid-container 的子容器组件,使用 flex 横向布局,排列每个 grid-col 容器,justify-content 与 align-items 默认为 flex-start,支持折行显示 grid-col grid-row 的子容器组件 栅格系统有 Margins, Gutters, Columns 三个属性: Margins:用于控制元素距离屏幕最边缘的距离 Gutters:用来控制元素和元素之间的距离关系 Columns:用来辅助布局的主要定位工具,不同的屏幕尺寸匹配不同的 Columns 数量来辅助布局定位,它会根据实际设备的宽度和 Columns 数量自动计算每一个 Columns 的宽度 不同的设备根据水平宽度 px,显示不同数量的栅格数: xs : 0px < 水平分辨率 < 320px:2 Columns 栅格; sm : 320px <= 水平分辨率 < 600px:4 Columns 栅格; md : 600px <= 水平分辨率 < 840px:8 Columns 栅格; lg : 840px <= 水平分辨率:12 Columns 栅格。 四、HML语法 HML(HarmonyOS Markup Language)是一套类 HTML 的标记语言,通过组件,事件构建出页面的内容。页面具备事件绑定、数据绑定、列表渲染、条件渲染和逻辑控制等能力。 4.1 事件绑定 hml 中事件绑定默认返回一个事件对象参数,可以通过该参数获取事件信息,同时也可以传递额外参数。 <!-- xxx.hml --> <div> <!-- 正常格式 --> <div onclick="clickfunc"></div> <!-- 缩写 --> <div @click="clickfunc('hello')"></div> <!-- 使用事件冒泡模式绑定事件回调函数 --> <div on:touchstart.bubble="touchstartfunc"></div> <!-- 使用事件捕获模式绑定事件回调函数 --> <div on:touchstart.capture="touchstartfunc"></div> <!-- on:{event}等价于on:{event}.bubble --> <div on:touchstart="touchstartfunc"></div> <!-- 绑定事件回调函数,但阻止事件向上传递 --> <div grab:touchstart.bubble="touchstartfunc"></div> <!-- 绑定事件回调函数,但阻止事件向下传递 --> <div grab:touchstart.capture="touchstartfunc"></div> <!-- grab:{event}等价于grab:{event}.bubble --> <div grab:touchstart="touchstartfunc"></div> </div> // xxx.js export default { data: { text: '', }, clickfunc: function(str, e) { console.log(e); this.text = str; }, touchstartfunc: function(e) { console.log(e); } } 4.2 数据绑定 数据绑定的形式分两种:数据初始化,数据更新 hml 只支持数据层到视图层的单向数据绑定。 视图层想改变数据层,只能通过绑定事件的方式实现。 4.2.1 数据初始化 hml 中的数据都来自于对应 js 中的 data 对象,因此在初始化页面时,在 data 对象中写入数据,hml 中就可以通过 {{}} 的形式绑定数据。 // xxx.js export default { data: { text: 'HELLO WORLD' } } <!-- xxx.hml --> <div>{{text}}</div> 4.2.2 数据更新 通过为页面元素绑定事件,可以调用方法更新数据,从而触发视图更新数据 // xxx.js export default { data: { text: 'HELLO WORLD' }, changeText: function() { this.$set('text', '你好,世界'); } } <!-- xxx.hml --> <div @click='changeText'>{{text}}</div> 4.3 列表渲染 hml 中需要进行列表渲染的话只需在组件上添加 for 属性并绑定需要渲染的数据,同时可自定义变量和索引的名称: // xxx.js export default { data: { array: [ {id: 1, name: '老周', age: 28}, {id: 2, name: '老李', age: 29}, ], }, changeText: function(val, index) { if (val === "老李"){ this.array.splice(index, 1, {id:2, name: '老王', age: 30}); } else { this.array.splice(index, 1, {id:3, name: '老郑', age: 31}); } }, } <!-- xxx.hml --> <div class="array-container"> <!-- div列表渲染 --> <!-- 默认$item代表数组中的元素, $idx代表数组中的元素索引 --> <div for="{{array}}" tid="id" onclick="changeText($item.name, $idx)"> <text>{{$idx}}.{{$item.name}}</text> </div> <!-- 自定义元素变量名称 --> <div for="{{value in array}}" tid="id" onclick="changeText(value.name, $idx)"> <text>{{$idx}}.{{value.name}}</text> </div> <!-- 自定义元素变量、索引名称 --> <div for="{{(index, value) in array}}" tid="id" onclick="changeText(value.name, index)"> <text>{{index}}.{{value.name}}</text> </div> </div> 数组中的每个元素必须存在 tid 指定的数据属性,且必须具有唯一性。 针对数组内的数据修改,请使用 splice 方法生效数据绑定变更 4.4 条件渲染 hml 中实现条件渲染有两种方式,分别是为组件添加 if/elif/else 或 show 属性,它们的区别在于 if/elif/else 属性不符合条件判断则不会在 vdom 中构建,而 show 属性为 false 时虽然不会渲染,但是会在 vdom 中构建,只是设置了 display 样式为 none。 因此出于性能因素考虑,显示隐藏状态需要频繁切换推荐使用 show,显示状态改变次数较少则使用 if/elif/else。 // xxx.js export default { data: { show: false, display: true, visible: false }, toggle: function() { this.visible = !this.visible; } } <!-- xxx.hml --> <div class="container"> <text if="{{show}}"> 你好,世界 </text> <text elif="{{display}}"> hi </text> <text else> Hello World </text> <button class="btn" type="capsule" value="toggle" onclick="toggle"></button> <text show="{{visible}}" > Hello World! </text> </div> 当使用 if/elif/else 写法时,节点必须是兄弟节点,否则编译无法通过 禁止在同一个元素上同时设置 for 和 if 属性 4.5 逻辑控制块 hml 中提供了 <block> 控制块,它不会被当作真实的节点编译,但是只支持 for 和 if 属性。 4.6 自定义组件 HML 可以通过 element 标签引用模板文件,通过它可以实现自定义组件。 <!-- template.hml --> <div class="item"> <text>Name: {{name}}</text> <text>Age: {{age}}</text> </div> <!-- index.hml --> <element name='man' src='../../common/template.hml'></element> <div> <man name="老朱" age="28"></man> </div> 其中 element 标签的 name 属性则为自定义组件的名称,src 属性为自定义组件相对该文件的路径,可以为自定义组件标签添加属性向其传递数据,自定义组件内也可使用 $emit 方法向父组件传递参数。 五、JS语法 鸿蒙中的 js 文件支持 ES6 语法。 5.1 引用 鸿蒙中可以使用 import 方法引入功能模块或 js 代码: import router from '@system.router' import utils from '../../common/utils.js' 5.2 获取app对象 在页面中可以使用 this.$app.$def 获取在 app.js 中暴露的对象。 // app.js export default { onCreate() { console.info('App onCreate'); }, onDestroy() { console.info('App onDestroy'); }, globalData: { appData: 'appData', appVersion: '2.0', }, changeAppVer () { this.globalData.appVersion = '3.0'; } }; // index.js export default { data: { appData: 'localData', appVersion:'1.0', }, onInit() { this.appData = this.$app.$def.globalData.appData; this.appVersion = this.$app.$def.globalData.appVersion; }, pageMethod() { this.$app.$def.changeAppVer(); } } 5.3 页面对象 属性 类型 描述 data Object/Function 页面的数据模型 $refs Object 持有注册过 ref 属性的 DOM 元素或子组件实例的对象 props Array/Object props 用于接收父组件传递过来的参数 computed Object 计算属性,用于在读取或设置进行预先处理,计算属性的结果会被缓存 private Object 页面的数据模型,private 下的数据属性只能由当前页面修改 public Object 页面的数据模型,public 下的数据属性的行为与 data 保持一致 5.4 方法 5.4.1 数据方法 属性 类型 参数 描述 $set Function key: string, value: any 添加新的数据属性或者修改已有数据属性。用法:this.$set('key',value)。 $delete Function key: string 删除数据属性。用法:this.$delete('key')。 export default { data: { appInfo: { OS: 'HarmonyOS', Version: '2.0', }, }, changeAppInfo() { this.$set('appInfo.Version', '3.0'); console.log(this.appInfo); this.$delete('appInfo'); console.log(this.appInfo); } } 5.4.2 事件方法 鸿蒙中可以使用 $watch 方法观察 data 中的属性变化,如果属性值改变,则会触发绑定的事件。 export default { props: ['title'], onInit() { this.$watch('title', 'onPropChange'); }, onPropChange(newV, oldV) { console.info('title属性由'+ oldV +'变化为' + newV); }, } 5.5 路由 { "pages": [ "pages/index/index", "pages/detail/index" ] } 鸿蒙 app 中页面的路由信息保存在 src > main > config.json 文件中的 pages 内,引入 @system.router 后,调用其 push 方法传入需要跳转页面的 uri,即可完成跳转,也可使用其 back 方法回到首页。 import router from '@system.router'; export default { launch() { router.push ({ uri: 'pages/detail/index', }); }, goBack() { router.back(); } } 六、CSS语法 CSS 是描述 HML 页面结构的样式语言,所有组件均存在系统默认样式,也可在页面 CSS 样式文件中对组件、页面自定义不同的样式。 6.1 尺寸单位 鸿蒙中尺寸单位有两种,px(逻辑像素) 以及百分比。 { "window": { "designWidth": 720, "autoDesignWidth": false } } 逻辑像素的配置在 src > main > config.json 文件中的 window 内,designWidth 为屏幕的逻辑宽度,默认为720px,实际显示时会将页面布局缩放至屏幕实际宽度,如100px在实际宽度为1440物理像素的屏幕上,实际渲染为200物理像素。 当 autoDesignWidth 设置为 true 时,逻辑像素 px 将按照屏幕密度进行缩放,如 100px 在屏幕密度为3的设备上,实际渲染为300物理像素。 而百分比单位表示该组件占父组件尺寸的百分比,如组件的 width 设置为50%,代表其宽度为父组件的50%。 6.2 样式导入 CSS 样式文件支持 @import 语句,导入 CSS 文件。 @import '../../common/style.css'; 七、总结 使用鸿蒙的 JS SDK 开发 App,整体的项目结构、生命周期以及开发流程很像微信的小程序,而 hml 和 JS 的语法又很像 Vue,整个流程走下来,感觉对 web 开发者而言还是很友好的,相信有 Web 前端开发基础的小伙伴们都可以快速的上手。 由于篇幅有限,文中还有很多没有提到的鸿蒙赋予开发者的硬件调用能力,希望鸿蒙可以越做越好,让越来越多的开发者和用户加入到鸿蒙的大生态中来。 八、参考 HarmonyOS Developer 欢迎关注凹凸实验室博客:aotu.io 或者关注凹凸实验室公众号(AOTULabs),不定时推送文章。

优秀的个人博客,低调大师

每日一博 | 详解微前端

好的前端开发很难。扩展前端开发,使许多团队可以同时处理大型复杂产品,这变得更加困难。在本文中,我们将描述将前端整体拆分成许多更小,更易管理的片段的最新趋势,以及该体系结构如何提高处理前端代码的团队的效率和效率。在讨论各种收益和成本的同时,我们还将介绍一些可用的实现选项,并且将深入研究一个演示该技术的完整示例应用程序。 近年来,微服务已迅速普及,许多组织都使用这种架构风格来避免大型,整体后端的局限性。尽管有关构建服务器端软件这种风格的文章已很多,但许多公司仍在与整体式前端代码库作斗争。 也许您想构建一个渐进式或响应式Web应用程序,但是找不到一个轻松的地方来开始将这些功能集成到现有代码中。也许您想开始使用新的JavaScript语言功能(或可以编译为JavaScript的多种语言之一),但是您无法在现有的构建过程中使用必要的构建工具。或者,也许您只是想扩展您的开发,以便多个团队可以同时处理一个产品,但是现有整体中的耦合和复杂性意味着每个人都在互相踩脚。这些都是真正的问题,都会对您有效地向客户提供高质量体验的能力产生负面影响。 最近,我们看到越来越多的注意力集中在复杂的现代Web开发所必需的总体体系结构和组织结构上。特别是,我们看到了将前端整体分解为更小,更简单的块的模式,这些块可以独立开发,测试和部署,同时仍然对客户而言是一个具有凝聚力的产品。我们称这种技术为微前端,我们将其定义为: “一种架构风格,可独立交付的前端应用程序组成了一个更大的整体” 在ThoughtWorks技术雷达的2016年11月号中,我们列出了微前端作为组织应评估的一种技术。后来我们将其推广到试用版,最后推广到采用,这意味着我们认为它是一种行之有效的方法,应在合理的情况下使用。 图1:微前端已经多次出现在技术雷达上。 我们从微前端看到的一些主要好处是: 较小,更紧密和可维护的代码库 解耦的自主团队可扩展性更高的组织 能够以比以前更多的增量方式升级,更新甚至重写前端的功能 这些头条新闻优势与微服务可以提供的某些优势并非偶然。 当然,涉及软件体系结构时不会有免费的午餐-一切都是有代价的。一些微前端实现可能导致依赖关系重复,从而增加了用户必须下载的字节数。此外,团队自主权的急剧增加可能会导致团队工作方式分散。尽管如此,我们认为可以控制这些风险,而且微前端的收益往往超过成本。 好处 我们没有按照特定的技术方法或实施细节来定义微观前端,而是将重点放在了出现的属性和它们带来的好处上。 增量升级 对于许多组织而言,这是其微前端之旅的开始。过去的技术堆栈或在交付压力下编写的代码阻碍了旧的,大型的前端组件的发展,目前正进行着完全重写的尝试。为了避免完全重写的危险,我们更希望逐个扼杀旧的应用程序,与此同时,继续为我们的客户提供新功能,而不会受到整体功能的影响。 这通常会导致建立微前端架构。一旦一个团队经历了将功能一直投入生产且几乎不对旧世界进行任何修改的经验,其他团队也将希望加入新世界。仍然需要维护现有代码,在某些情况下,继续为其添加新功能可能是有意义的,但是现在可以选择了。 最终的结果是,我们有更大的自由可以对产品的各个部分进行逐案决策,并对我们的体系结构,依赖关系和用户体验进行增量升级。如果我们的主框架发生了重大的重大变化,那么每个微前端都可以在有意义的时候进行升级,而不必被迫停止世界并立即升级所有内容。如果我们想尝试新技术或新的交互方式,则可以比以前更孤立的方式进行。 简单,解耦的代码库 根据定义,每个单独的微前端的源代码都将比单个整体前端的源代码小得多。这些较小的代码库对于开发人员而言更趋于简单和容易。尤其是,我们避免了彼此不了解的组件之间无意和不适当的耦合所引起的复杂性。通过在应用程序的有界上下文周围绘制粗线,我们使这种偶然的耦合变得更加困难。 当然,一个单一的高层体系结构决策(即“让我们去做微前端”)不能替代老式的干净代码。我们并非试图免除自己对代码的思考,并努力提高其质量。相反,我们试图通过艰难地做出错误的决定,而容易做出好的决定来使自己陷入成功的陷阱。例如,跨有限上下文共享域模型变得更加困难,因此开发人员这样做的可能性较小。同样,微前端可以使您明确和审慎地了解数据和事件在应用程序不同部分之间的流动方式,无论如何,这是我们应该做的事情! 独立部署 就像微服务一样,微前端的独立部署能力是关键。这减小了任何给定部署的范围,进而降低了相关的风险。无论前端代码的托管方式或托管位置如何,每个微前端都应具有自己的连续交付管道,该管道将在整个生产过程中对其进行构建,测试和部署。我们应该能够在不考虑其他代码库或管道的当前状态的情况下部署每个微前端。不管旧的整体式设备是否处于固定的,手动的,每季度发布的周期,或者隔壁的团队是否已将半完成或损坏的功能推送到其主分支中,都没有关系。如果给定的微前端准备好投入生产,那么它应该能够进行生产,并且该决定应由构建和维护它的团队来决定。 图2:每个微前端都独立部署到生产中 自治团队 作为将我们的代码库和发布周期解耦的更高阶优势,我们对于拥有完全独立的团队还有很长的路要走,他们可以拥有从构思到生产再到整个产品的一部分。团队可以完全拥有为客户创造价值所需的一切,从而使他们能够快速有效地行动。为此,我们的团队需要围绕业务功能的垂直部分而不是技术能力组成。一种简单的方法是根据最终用户将看到的产品来精简产品,因此每个微前端都封装了应用程序的单个页面,并由一个团队端到端拥有。这比团队围绕技术或“水平”问题(如样式,形式或验证)组成团队时,具有更高的团队凝聚力。 图3:每个应用程序应由一个团队拥有 简而言之 简而言之,微前端就是将大而恐怖的东西切成更小,更易于管理的部分,然后明确地说明它们之间的依赖关系。我们的技术选择,我们的代码库,我们的团队以及我们的发布流程都应该能够彼此独立地运行和发展,而无需过多的协调。 这个例子 想象一下一个网站,客户可以在该网站上订购要交付的食物。从表面上看,这是一个非常简单的概念,但是如果您想做得好,会有很多令人惊讶的细节: 应该有一个登陆页面,客户可以在其中浏览和搜索餐馆。这些餐厅应该可以通过任何数量的属性进行搜索和过滤,包括价格,美食或客户先前订购的内容 每个餐厅都需要有自己的页面,显示其菜单项,并允许客户选择自己想吃的东西,折扣,餐饮优惠和特殊要求 客户应该有一个个人资料页面,他们可以在其中查看其订单历史记录,跟踪交货以及自定义其付款方式 图4:一个食品配送网站可能会有几个相当复杂的页面 每个页面都有足够的复杂性,因此我们可以轻松地为每个页面辩护一个专门的团队,并且每个团队都应该能够独立于所有其他团队而在其页面上工作。他们应该能够开发,测试,部署和维护其代码,而不必担心与其他团队的冲突或协调。但是,我们的客户仍然应该看到一个无缝的网站。 在本文的其余部分中,我们将在需要示例代码或场景的任何地方使用该示例应用程序。 整合方法 鉴于上面的定义相当宽松,可以合理地将许多方法称为微前端。在本节中,我们将显示一些示例并讨论它们的取舍。所有方法都有一个相当自然的架构-通常,应用程序中的每个页面都有一个微前端,并且有一个容器应用程序,该容器可以: 呈现常见的页面元素,例如页眉和页脚 解决认证和导航等跨领域问题 将各种微前端集中到页面上,并告诉每个微前端何时以及在何处进行渲染 图5:您通常可以从页面的视觉结构中得出您的架构 服务器端模板组成 我们从绝对新颖的前端开发方法开始-从多个模板或片段中渲染服务器上的HTML。我们有一个index.html,其中包含所有常见的页面元素,然后使用服务器端包含从片段HTML文件插入特定于页面的内容: <html lang="en" dir="ltr"> <head> <meta charset="utf-8"> <title>Feed me</title> </head> <body> <h1> Feed me</h1> <!--# include file="$PAGE.html" --> </body> </html> 我们使用Nginx来提供此文件,并$PAGE通过与所请求的URL进行匹配来配置变量: server { listen 8080; server_name localhost; root /usr/share/nginx/html; index index.html; ssi on; # Redirect / to /browse rewrite ^/$ http://localhost:8080/browse redirect; # Decide which HTML fragment to insert based on the URL location /browse { set $PAGE 'browse'; } location /order { set $PAGE 'order'; } location /profile { set $PAGE 'profile' } # All locations should render through index.html error_page 404 /index.html; } 这是相当标准的服务器端组成。我们之所以可以称其为微前端,是因为我们以这样的方式拆分了我们的代码,使得每个代码代表一个独立的领域概念,可以由一个独立的团队交付。此处未显示的是这些HTML文件如何最终存储在Web服务器上,但是假设它们各自具有自己的部署管道,这使我们可以将更改部署到一个页面上而不会影响或考虑其他页面。 为了获得更大的独立性,可以有一个单独的服务器负责渲染和服务每个微前端,其中一个服务器位于前端,向其他服务器发出请求。通过仔细地缓存响应,可以在不影响延迟的情况下完成此操作。 图6:这些服务器中的每一个都可以独立构建和部署 这个例子说明了微前端不是必须是一种新技术,也不必太复杂。只要我们对设计决策如何影响代码库和团队的自治性保持谨慎,无论我们采用何种技术堆栈,我们都可以实现许多相同的收益。 构建时整合 我们有时看到的一种方法是将每个微前端发布为一个包,并让容器应用程序将它们全部作为库依赖项包含在内。这是package.json示例应用程序的容器外观: { "name": "@feed-me/container", "version": "1.0.0", "description": "A food delivery web app", "dependencies": { "@feed-me/browse-restaurants": "^1.2.3", "@feed-me/order-food": "^4.5.6", "@feed-me/user-profile": "^7.8.9" } } 起初,这似乎是有道理的。像往常一样,它会产生一个可部署的Javascript捆绑包,从而使我们能够从各种应用程序中删除常见的依赖项。但是,这种方法意味着我们必须重新编译并发布每个微前端,才能发布对产品任何单个部分的更改。就像微服务一样,我们已经看到了如此棘手的发布过程所引起的痛苦,因此我们强烈建议不要使用这种微前端方法。 解决了将我们的应用程序划分为可以独立开发和测试的离散代码库的所有麻烦,让我们不要在发布阶段重新引入所有这些耦合。我们应该找到一种在运行时而不是构建时集成微前端的方法。 通过iframe进行运行时集成 不起眼的iframe是在浏览器中将应用程序组合在一起的最简单方法之一。从本质上讲,iframe可以轻松地从独立的子页面中构建页面。在样式和全局变量互不干扰方面,它们还提供了很好的隔离度。 <html> <head> <title>Feed me!</title> </head> <body> <h1>Welcome to Feed me!</h1> <iframe id="micro-frontend-container"></iframe> <script type="text/javascript"> const microFrontendsByRoute = { '/': 'https://browse.example.com/index.html', '/order-food': 'https://order.example.com/index.html', '/user-profile': 'https://profile.example.com/index.html', }; const iframe = document.getElementById('micro-frontend-container'); iframe.src = microFrontendsByRoute[window.location.pathname]; </script> </body> </html> 就像使用服务器端include选项一样,从iframe中构建页面并不是一项新技术,也许似乎并不那么令人兴奋。但是,如果我们重新审视前面列出的微前端的主要优势,则只要我们谨慎地划分应用程序和组建团队的方式,iframe便很适合。 我们经常看到很多人不愿意选择iframe。尽管某些不情愿似乎是由直觉造成的,即iframe有点“讨厌”,但人们还是有一些很好的理由让人们避免使用它们。上面提到的容易隔离确实会使它们不如其他选项灵活。在应用程序的不同部分之间建立集成可能很困难,因此它们会使路由,历史记录和深层链接变得更加复杂,并且给使页面完全响应带来了一些额外的挑战。 通过JavaScript运行时集成 我们将描述的下一种方法可能是最灵活的一种,也是我们看到的团队采用频率最高的一种方法。每个微前端都使用<script>标签包含在页面上,并在加载时公开全局函数作为其入口点。然后,容器应用程序确定应安装哪个微前端,并调用相关函数以告知微前端何时以及在何处进行渲染。 <html> <head> <title>Feed me!</title> </head> <body> <h1>Welcome to Feed me!</h1> <!-- These scripts don't render anything immediately --> <!-- Instead they attach entry-point functions to `window` --> <script src="https://browse.example.com/bundle.js"></script> <script src="https://order.example.com/bundle.js"></script> <script src="https://profile.example.com/bundle.js"></script> <div id="micro-frontend-root"></div> <script type="text/javascript"> // These global functions are attached to window by the above scripts const microFrontendsByRoute = { '/': window.renderBrowseRestaurants, '/order-food': window.renderOrderFood, '/user-profile': window.renderUserProfile, }; const renderFunction = microFrontendsByRoute[window.location.pathname]; // Having determined the entry-point function, we now call it, // giving it the ID of the element where it should render itself renderFunction('micro-frontend-root'); </script> </body> </html> 以上显然是一个原始示例,但它演示了基本技术。与构建时集成不同,我们可以bundle.js独立部署每个文件。而且,与iframe不同的是,我们具有完全的灵活性,可以随意构建微前端之间的集成。我们可以通过多种方式扩展上述代码,例如仅根据需要下载每个JavaScript捆绑包,或在呈现微前端时传入和传出数据。 这种方法的灵活性以及独立的可部署性使其成为我们的默认选择,也是我们最常在野外看到的一种选择。当我们进入完整的示例时,我们将对其进行更详细的探讨。 通过Web组件进行运行时集成 对前一种方法的一种变体是为每个微前端定义一个HTML自定义元素供容器实例化,而不是为容器调用定义全局函数。 <html> <head> <title>Feed me!</title> </head> <body> <h1>Welcome to Feed me!</h1> <!-- These scripts don't render anything immediately --> <!-- Instead they each define a custom element type --> <script src="https://browse.example.com/bundle.js"></script> <script src="https://order.example.com/bundle.js"></script> <script src="https://profile.example.com/bundle.js"></script> <div id="micro-frontend-root"></div> <script type="text/javascript"> // These element types are defined by the above scripts const webComponentsByRoute = { '/': 'micro-frontend-browse-restaurants', '/order-food': 'micro-frontend-order-food', '/user-profile': 'micro-frontend-user-profile', }; const webComponentType = webComponentsByRoute[window.location.pathname]; // Having determined the right web component custom element type, // we now create an instance of it and attach it to the document const root = document.getElementById('micro-frontend-root'); const webComponent = document.createElement(webComponentType); root.appendChild(webComponent); </script> </body> </html> 最终结果与前面的示例非常相似,主要区别在于您选择以“ Web组件方式”进行操作。如果您喜欢Web组件规范,并且喜欢使用浏览器提供的功能的想法,那么这是一个不错的选择。如果您希望在容器应用程序和微前端之间定义自己的接口,那么您可能更喜欢前面的示例。 Styling CSS作为一种语言固有地是全局的,继承的和级联的,传统上没有模块系统,命名空间或封装。这些功能中的某些功能现在确实存在,但通常缺乏浏览器支持。在微前端环境中,许多问题都变得更加严重。例如,如果一个团队的微前端的样式表为h2 { color: black; },而另一个团队的则为h2 { color: blue; },而这两个选择器都附加在同一页面上,那么某个人会很失望的!这不是一个新问题,但是由于这些选择器是由不同的团队在不同的时间编写的,并且使代码可能分散在不同的存储库中,因此使发现变得更加困难,这使情况变得更糟。 多年来,已经发明了许多方法来使CSS更易于管理。有些选择使用严格的命名约定,例如BEM,以确保选择器仅在需要的地方应用。其他一些人则不想单独依赖开发人员纪律,而是使用预处理器,例如SASS,其选择器嵌套可以用作命名空间的一种形式。一种较新的方法是通过CSS模块或各种CSS-in-JS库之一以编程方式应用所有样式,以确保仅将样式直接应用于开发人员想要的位置。或者,对于更基于平台的方法,shadow DOM还提供了样式隔离。 只要您找到一种方法来确保开发人员可以彼此独立地编写样式,并确信将其代码组合到一个应用程序中便可以预测其行为,那么您选择的方法就没什么大不了的。 共享组件库 上面我们提到,跨微前端的视觉一致性很重要,一种解决方法是开发一个共享的,可重复使用的UI组件库。总的来说,我们认为这是一个好主意,尽管很难做到。创建这样一个库的主要好处是通过重复使用代码减少了工作量,并实现了视觉一致性。此外,您的组件库可以充当生活风格指南,并且可以是开发人员和设计师之间进行协作的重要方面。 最容易出错的事情之一就是太早地创建了太多这些组件。试图创建一个Foundation Framework,并具有所有应用程序所需的所有常见视觉效果。但是,经验告诉我们,在现实世界中使用组件之前,很难(即使不是不可能)猜测组件的API应该是什么,这会导致组件的早期使用大量混乱。因此,我们希望让团队根据需要在代码库中创建自己的组件,即使这最初会导致某些重复。允许模式自然出现,并且一旦组件的API变得很明显,您就可以将重复的代码收集到共享库中,并确信您已经证明了这一点。 共享最明显的候选对象是“哑”的视觉原语,例如图标,标签和按钮。我们还可以共享更复杂的组件,这些组件可能包含大量的UI逻辑,例如自动完成的下拉搜索字段。或可排序,可过滤的分页表格。但是,请注意确保共享的组件仅包含UI逻辑,而不包含业务或域逻辑。将域逻辑放入共享库后,它将在应用程序之间建立高度的耦合,并增加了更改的难度。因此,例如,您通常不应该尝试共享一个ProductTable,其中包含有关“产品”的确切含义和行为方式的各种假设。这样的域建模和业务逻辑属于微前端的应用程序代码,而不是共享库中。 与任何共享内部库一样,围绕其所有权和治理也存在一些棘手的问题。一种模式是说,“所有人”都拥有它作为共享资产,尽管实际上这通常意味着没有人拥有它。如果没有明确的约定或技术远见,它很快就会成为不一致代码的大杂烩。在另一个极端,如果完全集中共享库的开发,则在创建组件的人员和使用这些组件的人员之间将存在很大的脱节。我们看到的最好的模型是任何人都可以为图书馆做出贡献的模型,但是有一个托管人(一个人或一个团队)负责确保这些贡献的质量,一致性和有效性。维护共享库的工作需要强大的技术技能,但也需要培养许多团队之间的协作所必需的人员技能。 跨应用程序通信 关于微前端的最常见问题之一是如何让它们彼此交谈。通常,我们建议让他们尽可能少地进行交流,因为这通常会重新引入我们一开始要避免的那种不适当的耦合。 也就是说,经常需要某种程度的跨应用程序通信。定制事件允许微前端进行间接通信,这是使直接耦合最小化的一种好方法,尽管这样做确实使确定和执行微前端之间存在的合同变得更加困难。另外,向下传递回调和数据(在这种情况下,从容器应用程序向下传递到微前端)的React模型也是使合同更加明确的一种很好的解决方案。第三种选择是使用地址栏作为一种通信机制,我们将在后面详细探讨。 如果您使用的是redux,则通常的方法是为整个应用程序使用单个全局共享存储。但是,如果每个微前端都应该是自己的独立应用程序,那么每个微前端都有自己的redux存储是有意义的。Redux文档甚至提到“将Redux应用程序隔离为更大的应用程序中的组件”是拥有多个商店的有效理由。 无论我们选择哪种方法,我们都希望我们的微前端通过彼此发送消息或事件进行通信,并避免具有任何共享状态。就像跨微服务共享数据库一样,一旦我们共享数据结构和域模型,我们就会创建大量的耦合,并且进行更改变得极为困难。 与样式一样,这里有几种不同的方法可以很好地起作用。最重要的是,要认真思考正在引入的耦合类型,以及随着时间的推移如何维护该合同。就像微服务之间的集成一样,如果没有跨不同应用程序和团队的协调升级过程,您将无法对集成进行重大更改。 您还应该考虑如何自动验证集成没有中断。功能测试是一种方法,但是由于实现和维护它们的成本,我们更倾向于限制编写的功能测试的数量。或者,您可以实施某种形式的消费者驱动的合同,以便每个微前端可以指定它对其他微前端的要求,而无需实际将它们全部集成在一起并在浏览器中运行。 后端通讯 如果我们有独立的团队在前端应用程序上独立工作,那么后端开发又如何呢?我们坚信全栈团队的价值,他们拥有从可视代码一直到API开发以及数据库和基础结构代码的所有应用程序开发。一种在这里有用的模式是BFF模式,其中每个前端应用程序都有一个相应的后端,其目的仅仅是为了满足该前端的需求。虽然BFF模式最初可能意味着每个前端通道(Web,移动等)的专用后端,但可以轻松扩展为每个微前端的后端。 这里有很多变量要说明。 BFF可能是独立包含其自己的业务逻辑和数据库的,也可能只是下游服务的聚合器。如果有下游服务,则拥有微前端及其BFF的团队也拥有其中一些服务可能没有意义。如果微前端只有一个与之通信的API,并且该API相当稳定,那么构建BFF可能根本没有太大价值。这里的指导原则是,构建特定的微前端的团队不必等待其他团队为他们构建事物。因此,如果添加到微前端的每个新功能也需要后端更改,那么对于由同一团队拥有的BFF来说,这就是一个很好的例子。 图7:有很多不同的方式来构建前端/后端关系 另一个常见的问题是,微前端应用程序的用户应如何通过服务器进行身份验证和授权?显然,我们的客户只需要对自己进行一次身份验证,因此授权通常完全属于应该由容器应用程序拥有的横切关注点类别。容器可能具有某种登录形式,我们可以通过该登录形式获得某种令牌。该令牌将归容器所有,并可以在初始化时注入到每个微前端中。最后,微前端可以将令牌及其发出的任何请求发送到服务器,服务器可以执行所需的任何验证。 测试 在测试方面,我们看不到单片前端和微前端之间的太大区别。通常,用于测试单片前端的任何策略都可以在每个单独的微前端上重现。也就是说,每个微前端都应具有自己的全面的自动化测试套件,以确保代码的质量和正确性。 显而易见的差距是容器应用程序对各种微前端的集成测试。可以使用您首选的功能/端到端测试工具(例如Selenium或Cypress)来完成此操作,但是不要太过分。功能测试应该只涵盖无法在较低的测试金字塔水平上进行测试的方面。意思是说,使用单元测试来覆盖您的低级业务逻辑和呈现逻辑,然后使用功能测试来验证页面是否正确组装。例如,您可以在特定的URL上加载完全集成的应用程序,并断言页面上存在相关的微前端的硬编码标题。 如果存在跨越微前端的用户旅程,那么您可以使用功能测试来涵盖这些旅程,但是将功能测试的重点放在验证前端的集成上,而不是在每个微前端的内部业务逻辑上进行验证被单元测试所覆盖。如上所述,消费者驱动的合同可以帮助直接指定微前端之间发生的交互,而不会造成集成环境和功能测试的脆弱性。 详细的例子 本文的其余大部分内容将仅对示例应用程序的一种实现方式进行详细说明。我们将主要关注容器应用程序和微前端如何使用JavaScript集成在一起,因为这可能是最有趣和最复杂的部分。您可以在 https://demo.microfrontends.com上实时查看最终部署的结果,完整的源代码可以在Github上看到。 图8:完整的微前端演示应用程序的“浏览”登录页面 该演示都是使用React.js构建的,因此值得一提的是React在该架构上没有垄断地位。微前端可以使用许多不同的工具或框架来实现。我们之所以选择React,是因为它很受欢迎,也因为我们对它很熟悉。 容器 我们将从容器开始,因为它是我们客户的切入点。让我们看看我们可以从中了解到什么package.json: { "name": "@micro-frontends-demo/container", "description": "Entry point and container for a micro frontends demo", "scripts": { "start": "PORT=3000 react-app-rewired start", "build": "react-app-rewired build", "test": "react-app-rewired test" }, "dependencies": { "react": "^16.4.0", "react-dom": "^16.4.0", "react-router-dom": "^4.2.2", "react-scripts": "^2.1.8" }, "devDependencies": { "enzyme": "^3.3.0", "enzyme-adapter-react-16": "^1.1.1", "jest-enzyme": "^6.0.2", "react-app-rewire-micro-frontends": "^0.0.1", "react-app-rewired": "^2.1.1" }, "config-overrides-path": "node_modules/react-app-rewire-micro-frontends" } 在版本1中react-scripts,可能有多个应用程序共存于一个页面上而没有冲突,但是版本2使用了一些webpack功能,当两个或多个应用程序试图在一个页面上呈现自己时,这些功能会导致错误。因此,我们使用react-app-rewired覆盖的一些内部webpack配置react-scripts。这样可以解决这些错误,并让我们继续依靠它react-scripts来管理构建工具。 从依赖关系react和react-scripts,我们可以得出结论,这是与创建React.js应用create-react-app。更有趣的是没有什么:我们将一起组成最终应用程序的任何微前端的提及。如果我们在这里将它们指定为库依赖项,那么我们将走在构建时集成的道路上,如前所述,构建时集成往往会在我们的发布周期中引起问题耦合。 要查看如何选择和显示微前端,让我们看一下App.js。我们使用React Router将当前URL与预定义的路由列表进行匹配,并渲染相应的组件: <Switch> <Route exact path="/" component={Browse} /> <Route exact path="/restaurant/:id" component={Restaurant} /> <Route exact path="/random" render={Random} /> </Switch> 该Random组件并不是那么有趣-它只是将页面重定向到随机选择的餐厅URL。在Browse和Restaurant组件是这样的: const Browse = ({ history }) => ( <MicroFrontend history={history} name="Browse" host={browseHost} /> ); const Restaurant = ({ history }) => ( <MicroFrontend history={history} name="Restaurant" host={restaurantHost} /> ); 在这两种情况下,我们都渲染一个MicroFrontend组件。除了历史记录对象(稍后将变得很重要)之外,我们还指定应用程序的唯一名称,以及可以从中下载其捆绑软件的主机。此配置驱动的URL类似于http://localhost:3001本地运行或 https://browse.demo.microfrontends.com在生产中运行。 在中选择了一个微前端App.js,现在我们将在中渲染它MicroFrontend.js,这只是另一个React组件: class MicroFrontend extends React.Component { render() { return <main id={`${this.props.name}-container`} />; } } 这不是整个类,我们将很快看到更多的方法。 渲染时,我们要做的只是在页面上放置一个容器元素,其ID对于微前端是唯一的。这是我们告诉微前端进行渲染的地方。我们使用ReactcomponentDidMount作为下载和安装微前端的触发器: componentDidMount 是React组件的生命周期方法,在第一次将组件实例“安装”到DOM后,框架便会调用该方法。 类 MicroFrontend… componentDidMount() { const { name, host } = this.props; const scriptId = `micro-frontend-script-${name}`; if (document.getElementById(scriptId)) { this.renderMicroFrontend(); return; } fetch(`${host}/asset-manifest.json`) .then(res => res.json()) .then(manifest => { const script = document.createElement('script'); script.id = scriptId; script.src = `${host}${manifest['main.js']}`; script.onload = this.renderMicroFrontend; document.head.appendChild(script); }); } componentDidMount 是React组件的生命周期方法,在第一次将组件实例“安装”到DOM后,框架便会调用该方法。 首先,我们检查是否已经下载了具有唯一ID的相关脚本,在这种情况下,我们可以立即对其进行渲染。如果不是,我们asset-manifest.json从适当的主机获取文件,以查找主脚本资产的完整URL。设置脚本的URL后,剩下的就是将其附加到文档,并带有一个onload呈现微前端的处理程序: 我们必须从资产清单文件中获取脚本的URL,因为react-scripts输出的编译JavaScript文件的文件名中带有哈希值以方便缓存。 类 MicroFrontend… renderMicroFrontend = () => { const { name, history } = this.props; window[`render${name}`](`${name}-container`, history); // E.g.: window.renderBrowse('browse-container', history); }; 在上面的代码中,我们调用了一个类似的全局函数window.renderBrowse,该函数由我们刚刚下载的脚本放置在该函数中。我们向它传递<main>微前端应在其中呈现自身的元素的ID和一个history对象,我们将在稍后对此进行说明。全局功能的签名是容器应用程序与微前端之间的关键契约。这是应该进行任何通信或集成的地方,因此使其保持相当轻巧的状态使其易于维护,并在将来添加新的微前端。每当我们想做一些需要更改此代码的事情时,就应该认真思考这对我们的代码库的耦合以及合同的维护意味着什么。 最后一件是清理工作。当我们MicroFrontend卸载组件(从DOM中删除)时,我们也想卸载相关的微前端。每个微前端为此定义了一个相应的全局函数,我们从适当的React生命周期方法中调用该函数: 类 MicroFrontend… componentWillUnmount() { const { name } = this.props; window[`unmount${name}`](`${name}-container`); } 就其自身的内容而言,容器直接呈现的所有内容都是网站的顶级标题和导航栏,因为它们在所有页面中都是不变的。这些元素的CSS已经精心编写,以确保仅对标头中的元素进行样式设置,因此它不应与微前端中的任何样式代码冲突。 到此,容器应用程序结束了!这是非常基本的,但这为我们提供了一个外壳程序,可以在运行时动态下载我们的微前端,并将它们粘合在一起,形成单个页面上的凝聚力。这些微前端可以在生产过程中一直独立部署,而无需更改任何其他微前端或容器本身。 微前端 继续讲这个故事的合乎逻辑的地方是我们不断引用的全局渲染功能。我们应用程序的主页是餐厅的可过滤列表,其入口点如下所示: import React from 'react'; import ReactDOM from 'react-dom'; import App from './App'; import registerServiceWorker from './registerServiceWorker'; window.renderBrowse = (containerId, history) => { ReactDOM.render(<App history={history} />, document.getElementById(containerId)); registerServiceWorker(); }; window.unmountBrowse = containerId => { ReactDOM.unmountComponentAtNode(document.getElementById(containerId)); }; 通常在React.js应用程序中,对的调用ReactDOM.render将在顶级范围内进行,这意味着,一旦加载了此脚本文件,它将立即开始渲染为硬编码的DOM元素。对于此应用程序,我们需要能够控制何时何地进行渲染,因此我们将其包装在一个函数中,该函数接收DOM元素的ID作为参数,并将该函数附加到全局window对象。我们还可以看到用于清理的相应卸载功能。 虽然我们已经看到了将微前端集成到整个容器应用程序中时如何调用此函数,但成功的最大标准之一是我们可以独立开发和运行微前端。因此,每个微前端还具有自己index.html的内联脚本,以在容器外部以“独立”模式呈现应用程序: <html lang="en"> <head> <title>Restaurant order</title> </head> <body> <main id="container"></main> <script type="text/javascript"> window.onload = () => { window.renderRestaurant('container'); }; </script> </body> </html> 图9:每个微前端都可以在容器外部作为独立的应用程序运行。 从现在开始,微前端大多只是普通的旧React应用程序。在“浏览”应用程序读取的从后端的餐馆列表,提供<input>搜索和过滤餐厅元素,并呈现阵营路由器<Link>元素,导航到特定餐厅。到那时,我们将切换到第二个“订单”微前端,该前端将显示一个带有菜单的餐厅。 图10:这些微前端仅通过路由更改进行交互,而不是直接进行交互 关于我们的微前端,最后值得一提的是它们都styled-components用于所有样式。通过CSS-in-JS库,可以轻松地将样式与特定组件相关联,因此我们保证微前端的样式不会泄漏并影响容器或其他微前端。 通过路由进行跨应用程序通信 前面我们提到过,应将跨应用程序通信保持在最低限度。在此示例中,我们唯一的要求是浏览页面需要告诉餐厅页面要加载哪个餐厅。在这里,我们将看到如何使用客户端路由来解决此问题。 这里涉及的所有三个React应用程序都使用React Router进行声明式路由,但是以两种略有不同的方式进行初始化。对于容器应用程序,我们创建一个<BrowserRouter>,它会在内部实例化一个history对象。这是history我们之前讨论过的相同对象。我们使用该对象来处理客户端历史记录,也可以使用它来将多个React Router链接在一起。在我们的微前端中,我们按以下方式初始化路由器: <Router history={this.props.history}> 在这种情况下,我们没有为React Router实例化另一个历史对象,而是为它提供了容器应用程序传入的实例。<Router>现在所有实例都已连接,因此任何实例中触发的路由更改都将反映在所有实例中。这为我们提供了一种通过URL将“参数”从一个微前端传递到另一个微前端的简便方法。例如,在浏览微前端中,我们有一个像这样的链接: <Link to={`/restaurant/${restaurant.id}`}> 单击此链接后,该路径将在容器中更新,该容器将看到新的URL并确定应该安装和呈现餐厅微前端。然后,该微前端自己的路由逻辑将从URL中提取餐厅ID,并提供正确的信息。 希望此示例流程能够显示谦虚URL的灵活性和强大功能。除了对共享和添加书签有用之外,在这种特定的体系结构中,它还可以是在微前端之间交流意图的有用方法。为此使用页面URL会打勾许多框: 其结构是定义明确的开放标准 该页面上的任何代码均可全局访问 其有限的大小鼓励仅发送少量数据 它是面向用户的,这鼓励了一种忠实的建模域的结构 它是声明性的,而不是命令性的。即“这就是我们的位置”,而不是“请执行此操作” 它迫使微前端进行间接通信,而不直接了解彼此或相互依赖 当使用路由作为微前端之间的通信方式时,我们选择的路由即构成合同。在这种情况下,我们已经确立了可以在看到餐厅的想法/restaurant/:restaurantId,并且在不更新所有引用该餐厅的应用程序的情况下就无法更改该路线。鉴于此合同的重要性,我们应该进行自动化测试,以检查合同是否得到遵守。 共同内容 尽管我们希望我们的团队和微观前端尽可能地独立,但是有些事情应该是共同的。我们之前曾写过关于共享组件库如何帮助微前端实现一致性的文章,但是对于这个小型演示而言,组件库会显得过分杀伤力。因此,我们有一个小的公共内容存储库,其中包括图像,JSON数据和CSS,它们通过网络提供给所有微前端。 我们可以选择在微前端之间共享的另一件事:库依赖项。正如我们将简短描述的那样,依赖项的重复是微前端的一个常见缺点。即使在应用程序之间共享这些依赖关系也有其自身的困难,但是对于此演示应用程序,值得讨论如何完成。 第一步是选择要共享的依赖项。对我们编译后的代码进行的快速分析表明,大约50%的捆绑包是由react和贡献的react-dom。除了它们的大小之外,这两个库是我们最“核心”的依赖项,因此我们知道所有微前端都可以从提取它们中受益。最后,它们是稳定,成熟的库,通常会在两个主要版本中引入重大更改,因此跨应用程序升级的工作应该不会太困难。 至于实际的提取,我们需要做的就是在我们的webpack配置中将库标记为外部库,我们可以通过与前面所述类似的重新布线来完成。 module.exports = (config, env) => { config.externals = { react: 'React', 'react-dom': 'ReactDOM' } return config; }; 然后,我们script向每个index.html文件添加几个标签,以从共享内容服务器中获取两个库。 <body> <noscript> You need to enable JavaScript to run this app. </noscript> <div id="root"></div> <script src="%REACT_APP_CONTENT_HOST%/react.prod-16.8.6.min.js"></script> <script src="%REACT_APP_CONTENT_HOST%/react-dom.prod-16.8.6.min.js"></script> </body> 在团队之间共享代码始终是一件棘手的事情。我们需要确保我们只共享我们真正希望成为共同的东西,并且希望一次在多个地方进行更改。但是,如果我们对共享的内容和不共享的内容保持谨慎,则将获得真正的好处。 基础设施 该应用程序托管在具有核心基础架构(S3存储桶,CloudFront发行版等)的AWS上,并使用Terraform代码的集中式存储库一次进行配置。然后,每个微前端都有自己的源存储库,并在Travis CI上具有自己的连续部署管道,该管道将静态资产构建,测试并部署到这些S3存储桶中。这在集中式基础架构管理的便利性与独立部署性的灵活性之间取得了平衡。 请注意,每个微前端(和容器)都有自己的存储桶。这意味着它可以自由支配其中的内容,而我们不必担心来自另一个团队或应用程序的对象名称冲突或访问管理规则冲突。 缺点 在本文的开头,我们提到了与任何前端一样的微前端折衷。我们提到的好处确实伴随着成本,我们将在这里介绍。 有效负载大小 独立构建的JavaScript捆绑包可能导致重复的公共依赖关系,从而增加了我们必须通过网络发送给最终用户的字节数。例如,如果每个微前端都包含自己的React副本,那么我们将迫使客户下载n次React 。页面性能和用户参与/转换之间存在直接关系,世界上许多地方的互联网基础设施运行速度远比高度发达城市的互联网基础设施慢,因此我们有很多理由在乎下载大小。 这个问题不容易解决。在我们希望团队独立地编译应用程序以使其能够自主工作的渴望与我们在构建我们的应用程序以共享共同依赖关系的愿望之间存在着内在的张力。一种方法是从我们的编译包中外部化常见的依赖关系,如我们所述用于演示应用程序。但是,一旦走上这条路,我们就重新引入了一些构建时耦合到我们的微前端的方法。现在,它们之间存在一个隐式契约,其中规定:“我们所有人都必须使用这些依赖项的这些确切版本”。如果依赖项发生重大变化,我们可能最终需要进行大量的协调升级工作并一次性完成锁步释放事件。这就是我们最初尝试使用微前端时要避免的一切! 这种内在的紧张是一个困难的局面,但这并不是所有的坏消息。首先,即使我们选择不对重复的依赖项做任何事情,也有可能每个单独页面的加载速度都比构建单个整体式前端要快。原因是通过独立地编译每个页面,我们有效地实现了我们自己的代码分割形式。在经典的Monolith中,当加载应用程序中的任何页面时,我们通常一次下载所有页面的源代码和依赖项。通过独立构建,任何单个页面加载都只会下载该页面的源和依赖项。这可能会导致初始页面加载速度更快,但随后的导航速度会变慢,因为用户被迫在每个页面上重新下载相同的依赖项。如果我们的纪律是不要在不必要的依赖项上膨胀我们的微前端,或者如果我们知道用户通常只停留在应用程序中的一两个页面,那么我们很可能会实现净收入。即使有重复的依赖关系,也可以提高性能。 上一段中有很多“可能的”和“可能的”,这凸显了一个事实,即每个应用程序将始终具有自己独特的性能特征。如果您想确定特定更改对性能的影响,那么最好在生产中进行实际测量是无可替代的。我们已经看到团队苦苦挣扎了超过数千KB的JavaScript,只是去下载许多MB的高分辨率图像,或者对一个非常慢的数据库运行昂贵的查询。因此,尽管考虑每个架构决策对性能的影响很重要,但请确保您知道真正的瓶颈在哪里。 环境差异 我们应该能够开发单个微前端,而无需考虑其他团队正在开发的所有其他微前端。我们甚至可以在空白页上以“独立”模式运行微前端,而不是在将其存储在生产环境中的容器应用程序内部运行。这可以使开发更加简单,尤其是当实际容器是复杂的旧代码库时,当我们使用微前端进行从旧世界到新世界的逐步迁移时,通常就是这种情况。但是,在与生产环境完全不同的环境中进行开发存在风险。如果我们在开发时的容器的行为与生产时的容器不同,那么我们可能会发现我们的微前端已损坏,或者在部署到生产中时的行为有所不同。特别令人关注的是容器或其他微前端可能带来的全局样式。 这里的解决方案与我们不得不担心环境差异的任何其他情况没有什么不同。如果我们在这不是一个环境中本地发展生产样,我们需要确保我们经常集成和我们的微前端部署到环境是在这些环境中,如生产,我们应该做的测试(手动和自动),以尽早发现集成问题。这不能完全解决问题,但是最终这是我们必须权衡的另一个权衡:简化开发环境的生产率提高是否值得承担集成问题的风险?答案将取决于项目! 运营和治理复杂性 最后的缺点是与微服务直接相似的缺点。作为一个分布更广泛的体系结构,微前端将不可避免地导致要管理更多的东西-更多的存储库,更多的工具,更多的构建/部署管道,更多的服务器,更多的域等。因此在采用这种体系结构之前,您需要提出一些问题应该考虑: 您是否有足够的自动化措施来可行地配置和管理所需的其他基础架构? 您的前端开发,测试和发布过程是否可以扩展到许多应用程序? 您是否对围绕工具和开发实践的决策变得更加分散和难以控制感到满意? 您将如何确保跨多个独立的前端代码库的最低质量,一致性或治理水平? 我们可能还会再写整篇讨论这些主题的文章。我们要提出的主要观点是,当您选择微前端时,根据定义,您选择创建的是许多小东西,而不是一个大东西。您应该考虑是否具备在不造成混乱的情况下采用这种方法所需的技术和组织成熟度。 结论 多年来,随着前端代码库的不断复杂化,我们看到了对更具可扩展性的体系结构的日益增长的需求。我们需要能够划清界限,以建立技术实体和领域实体之间正确的耦合和凝聚力级别。我们应该能够在独立的自治团队之间扩展软件交付。 尽管远非唯一的方法,但我们已经看到了许多微前端提供这些好处的实际案例,并且随着时间的推移,我们已经能够逐渐将这种技术应用于旧代码库和新代码库。无论微前端对您和您的组织是否是正确的方法,我们只能希望这将成为持续趋势的一部分,在这种趋势下,前端工程和体系结构将得到我们应有的重视。 致谢 非常感谢Charles Korn,Andy Marks和Willem Van Ketwich的详尽评论和详细反馈。 也要感谢Bill Codding,Michael Strasser和Shirish Padalkar在ThoughtWorks内部邮件列表中提供的意见。 还要感谢Martin Fowler的反馈,并在他的网站上为本文提供了家。 最后,感谢Evan Bottcher和Liauw Fendy的鼓励和支持。 (本文翻译自Cam Jackson的文章《Micro Frontends》,转载请注明出处,原文链接:https://martinfowler.com/articles/micro-frontends.html)

优秀的个人博客,低调大师

每日一博 | Nacos 快速上手

Nacos 快速上手 简介 准备工作 部署 Spring Boot 集成 配置说明 Spring Cloud + Nacos Dubbo + Nacos 问题及解决方式 微服务现在越来火,有基于 Spring Cloud Netflix 体系的,也有基于 Spring Cloud Alibaba 为体系的。从以前的 Eureka 注册中心、Spring Cloud Config 配置中心、Spring Cloud Bus消息总线 到完全可以替代他们的 Nacos 出现,微服务技术体系的未来发展方向愈加清晰。所以,学会并了解如何使用 Nacos 是十分重要的。Nacos 不仅仅可以作为配置中心使用,还可以作为注册中心使用,其有很多十分优秀的特性,部署起来也十分方便。 主要目的: 熟练使用 Nacos; 基于 Spring Cloud Alibaba 体系进行项目基础 Demo 搭建,便于后续源码分析; 整合 Dubbo,便于后续源码分析; 手机用户请横屏获取最佳阅读体验,REFERENCES中是本文参考的链接,如需要链接和更多资源,可以加入『知识星球』获取长期知识分享服务。 简介 动态配置服务 动态配置服务让您能够以中心化、外部化和动态化的方式管理所有环境的配置。动态配置消除了配置变更时重新部署应用和服务的需要。配置中心化管理让实现无状态服务更简单,也让按需弹性扩展服务更容易。 服务发现及管理 动态服务发现对以服务为中心的(例如微服务和云原生)应用架构方式非常关键。Nacos支持DNS-Based和RPC-Based(Dubbo、gRPC)模式的服务发现。Nacos也提供实时健康检查,以防止将请求发往不健康的主机或服务实例。借助Nacos,您可以更容易地为您的服务实现断路器。 动态DNS服务 通过支持权重路由,动态DNS服务能让您轻松实现中间层负载均衡、更灵活的路由策略、流量控制以及简单数据中心内网的简单DNS解析服务。动态DNS服务还能让您更容易地实现以DNS协议为基础的服务发现,以消除耦合到厂商私有服务发现API上的风险。 准备工作 Docker 运行环境 Mysql 或 Mysql 的容器 部署 单机版本 #拉取镜像dockerpullnacos/nacos-server#运行dockerrun--envMODE=standalone--namenacos-d-p8848:8848nacos/nacos-server 访问 http://127.0.0.1:8848/nacos/#/login . 密码和账号默认都是 nacos . Spring Boot 集成 配置说明 配置命名空间 . Spring Cloud + Nacos 依赖配置 compilelibs["spring-cloud-starter-alibaba-nacos-config"]compilelibs["spring-cloud-starter-alibaba-nacos-discovery"] resources 下新建文件 bootstrap.yaml #nacos配置(nacosconfig必须配置在bootstrap)spring:cloud:nacos:discovery:server-addr:${NACOS_SERVER_ADDR:127.0.0.1:8848}namespace:${NACOS_NAMESPACE:dsb-cloud}metadata:{"checkSum":"${random.value}-${random.uuid}"}config:server-addr:${NACOS_SERVER_ADDR:127.0.0.1:8848}namespace:${NACOS_NAMESPACE:dsb-cloud}file-extension:yaml 服务注册中心 //启动类开启注解@EnableDiscoveryClient 作为 Spring Boot 项目启动后,可以看到成功注册到 Nacos 上了。 . 点击详情后可以看到对应的服务信息 . Dubbo + Nacos 公共 API 包 . 服务提供者 pom dependencies{compilelibs["spring-boot-starter-actuator"]//nacoscompile(libs["nacos-discovery-spring-boot-starter"]){excludegroup:'com.alibaba.spring',module:'spring-context-support'}compile'com.alibaba.spring:spring-context-support:1.0.3'compileproject(':spring-cloud-examples:dubbo-examples:spring-cloud-dubbo-api')compilelibs['dubbo-spring-boot-starter']testCompile"org.springframework.boot:spring-boot-starter-test"} application.yaml spring:application:name:spring-boot-dubbo-providerdubbo:application:name:spring-boot-dubbo-providerregistry:nacos://127.0.0.1:8848protocol:name:dubboport:20880 bootstrap.yaml #nacos配置(nacosconfig必须配置在bootstrap)spring:cloud:nacos:discovery:server-addr:${NACOS_SERVER_ADDR:127.0.0.1:8848}namespace:${NACOS_NAMESPACE:dsb-cloud}metadata:{"checkSum":"${random.value}-${random.uuid}"}config:server-addr:${NACOS_SERVER_ADDR:127.0.0.1:8848}namespace:${NACOS_NAMESPACE:dsb-cloud}file-extension:yaml 核心类 //启动类@SpringBootApplication@DubboComponentScanpublicclassSpringBootDubboProviderApplication{publicstaticvoidmain(String[]args){SpringApplication.run(SpringBootDubboProviderApplication.class,args);}}//服务实现类packagepub.dsb.api.service.impl;importorg.apache.dubbo.config.annotation.Service;importpub.dsb.api.service.IHelloService;@ServicepublicclassHelloServiceImplimplementsIHelloService{@OverridepublicStringhi(Stringname){return"spring-cloud-dubbo-example:"+name;}} 启动服务提供者 . 服务消费者 pom (和服务提供者一样) dependencies{compilelibs["spring-boot-starter-web"]compilelibs["spring-boot-starter-actuator"]//nacoscompile(libs["nacos-discovery-spring-boot-starter"]){excludegroup:'com.alibaba.spring',module:'spring-context-support'}compile'com.alibaba.spring:spring-context-support:1.0.3'compileproject(':spring-cloud-examples:dubbo-examples:spring-dubbo-api')compilelibs['dubbo-spring-boot-starter']testCompile"org.springframework.boot:spring-boot-starter-test"} yaml spring:application:name:spring-boot-dubbo-consumerdubbo:registry:address:nacos://127.0.0.1:8848 核心类 @RestControllerpublicclassDubboRefController{@Reference(check=false)privateIHelloServicehelloService;@GetMapping("/hi")publicStringhi(){returnhelloService.hi(System.currentTimeMillis()+"");}}//启动类@SpringBootApplicationpublicclassSpringBootDubboConsumerApplication{publicstaticvoidmain(String[]args){SpringApplication.run(SpringBootDubboConsumerApplication.class,args);}} 接口测试 服务提供者 8080, 服务消费者 8081 GET http://127.0.0.1:8081/hiHTTP/1.1 200Content-Type: text/plain;charset=UTF-8Content-Length: 40Date: Tue, 01 Sep 2020 16:55:53 GMTspring-cloud-dubbo-example:1598979353325 注册信息 . 问题及解决方式 ClassNotFoundException: com.alibaba.spring.util.BeanRegistrar 引用新包,剔除有问题的包 spring-context-support。 No provider available for the service @Reference(check = false) 本文分享自微信公众号 - 架构探险之道(zacsnz1314)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | WidgetKit 入门指北

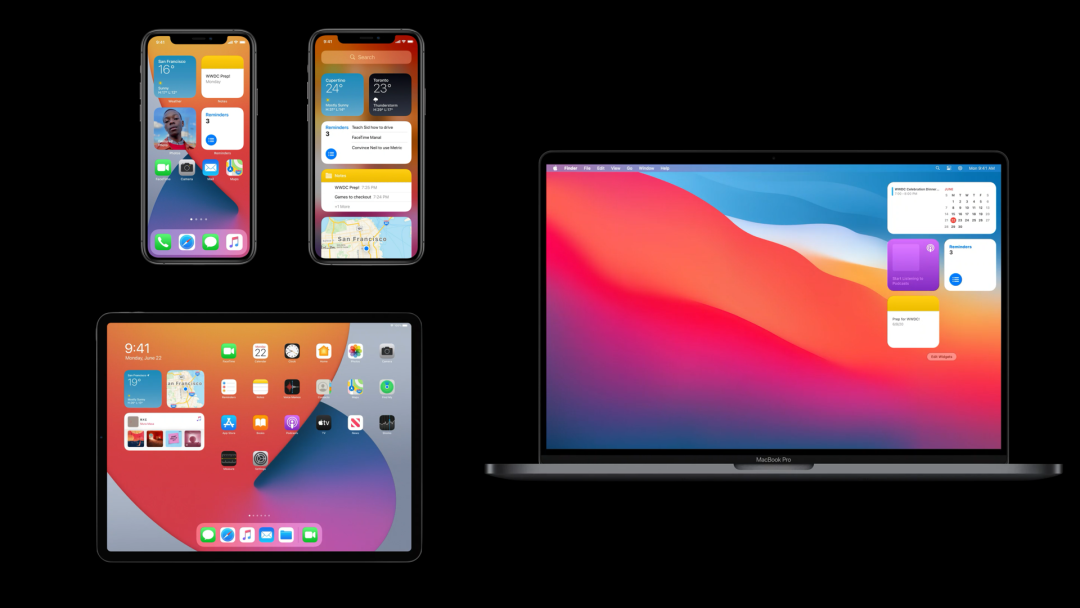
作者:zvving,iOS 开发者,现就职于字节跳动音乐团队 本主题基于 https://developer.apple.com/videos/play/wwdc2020/10028/ 梳理 概述 WidgetKit 是 WWDC20 备受关注的新特性,支持在 iOS、iPadOS 主屏幕,今日视图以及 macOS 通知栏展示动态信息和个性化内容。 众所周知,Apple 对 iOS 主屏幕的改进一直保持克制,这次引入 Widget 是一次巨大的改动。Widget 如何提供一致的跨平台体验?如何提供实时的个性化内容?如何引入 Widget 同时最大可能减少主屏幕的性能、电量开销?本文作为 WidgetKit 速览,带你快速了解这些内容。 优秀 Widget 的三要素 设计优秀的 Widget,包含如下三个要素 Glanceable 一目了然 Relevant 高相关性 Personalized 个性化 Glanceable 一目了然 Widgets are not mini-apps Widget 并不是(常驻桌面的)微型应用程序,这句话被反复提起。在一闪而过的快速切换应用的主屏幕里,设计交互复杂的应用界面并不能切合用户的需要。一目了然的内容才是用户关心的唯一要素 通过强大的 SwiftUI,你可以快速实现跨平台体验一致的 Widget,同时非常方便的支持 Dynamic Type、DarkMode 等系统特性,提供一目了然、快速响应的桌面体验。 Relevant 高相关性 一般用户每天进入主屏幕的次数超过 90 次,但停留的总时长不过几分钟。用户可不想在主屏幕见到枯燥的加载界面 WidgetKit 会在正确的时机显示即时的内容,避免每个 Widget 启动、加载、渲染的漫长过程。为了达成这一目标,WidgetKit 统一管理所有 Widget,支持预渲染、复用,并提供合适的更新策略,灵活可控的更新时机。 智能叠放 智能叠放是 Widget 与用户高相关性的又一体现。它是支持多个 Widget 叠放的智能组件。用户可以上下滑动手动切换,更巧妙的是:基于用户的使用场景以及开发者的配置,系统也会智能地为用户展示最需要的 Widget。 Personalized 个性化 在天气 widget 中,基于不同地理位置,语言、摄氏度单位,提供个性化的使用体验。同时支持三种尺寸,更小的尺寸展示核心内容,更大的尺寸则展示更多的相关信息,满足不同用户的需要。 快速开发一个 Widget 配置信息 Configuration Static configuration :静态配置,无用户配置项 Intent configuration :支持用户配置及用户意图推测功能(Intents Extension) SupportedFamilies Widget 支持 small、medium、large三种尺寸 ,建议开发者同时提供三种尺寸。 Placeholder UI Placeholder UI 是 Widget 加载中所显示的占位信息,它应该清晰的表达 Widget 所属类型。绝大多数场景下,用户不会看到 Placeholder UI ,只有在修改设备环境配置等个别场景下会碰到。 Widget 交互 Widgets are not mini-apps Widget UI 是无状态的,不支持滚动,不能展示视频和动态图像。 Widget 为用户提供一目了然的内容展示,在用户需要进一步查看或编辑的时候,通过轻点启动 app 完成顺畅的体验。 用户点击 Widget 中的特定专辑后,通过 Deep links,App 启动后快速展示对应专辑,方便用户的进一步操作。 注意:systemSmall 只支持一个 link ,systemMedium,systemLarge 支持多个 WidgetKit 执行原理 开发者通过 SwiftUI 构建 Views,定义 Timelines 为 Views 提供对应时间所需数据。数据变化时,通过 reload 更新数据。 WidgetKit 统一管理多个 Widgets:序列化 Widget Views 和 Timelines 数据,处理预渲染和复用,响应并处理 System reloads、App-driven reloads,为桌面、Widget Gallery 预览等场景提供高效、即时的 widget 体验。 值得一提的是:WidgetKit 会把 Timelines 所定义的 Entries 对应的 Views 结构信息缓存到磁盘,仅在需要的时候实时渲染特定的 View。这使得系统可以在极低电量开销下为众多 Widgets 处理 Timelines 信息。 Views Placeholder UI:(上文已经介绍)Widget 占位 UI Snapshot 以最快速度返回的视图。并非截图,而是真实体验。 大多数I情况下,timeline 第一条数据可以与 snapshot 相同,这样用户在 Widget Gallery 中看到内容和添加到设备时得到的东西相同。 Timelines Timeline 是一系列驱动 Views 的数据集合,WidgetKit 随着时间流逝加载对应的 Widget 数据,配合 Reload 策略灵活支持复杂业务场景的变化。 Reloads Reloads 分两类:System reloads,App-driven reloads。系统会综合判断,确定重新加载 widget 的最佳时间。 System reloads ReloadPolicy:配置 timeline 时定制 reload 策略 atEnd after(date: Date) never Widget 被查看越多,将更多的被 reload 设备环境变化也会触发 reload App-driven reloads 当应用在后台时,后台推送可以触发 reload;当应用在前台时,应用可以主动触发 reload。进而通过 reload 变更全部或特定 timeline entry。 请谨慎的对待 widget reload,仅当相关数据变化需要反映在 widget 中时才触发 relaod,避免无谓的重新加载。 对于后台加载需要网络数据可以通过 Background sessions 完成,相关的系统资源占用将计入 widget 开销,由 WidgetKit 管理对应 background reload 预算。 个性化并理解用户意图 Intents framework Intents framework 一直被应用在 SiriKit 和 Shortcuts,从现在开始 WidgetKit 也将借助 Intents framework 更好的理解用户意图。 驱动理解用户意图的智能堆栈 在智能堆栈小组件中,开发者通过每一个 TimelineEntryRelevance 可以告知 WidgetKit 用户在特定场景下相关性评分和持续时间。WidgetKit 综合评估不同 Widget 评分,分析用户意图,旋转堆栈到用户关心的 widget。 注意:widget 提供的所有 TimelineEntryRelevance 都会作为理解用户意图相关性的参考 Demo 配置 Widget 是很容易的,如下 SampleWidget 代码已经包含大部分 widget 初始配置: 静态 WidgetConfiguration 需要提供 Provider(),PlaceholderView(),entry -> SampleWidgetEntryView 闭包 Provider 中定义 snapshot,构建包含 Entry 集合的 Timeline 最后使用 SwiftUI 实现 PlaceholderView 和 SampleWidgetEntryView 即可 @mainpublicstructSampleWidget:Widget{privateletkind:String="SampleWidget"publicvarbody:someWidgetConfiguration{StaticConfiguration(kind:kind,provider:Provider(),placeholder:PlaceholderView()){entryinSampleWidgetEntryView(entry:entry)}.configurationDisplayName("MyWidget").description("Thisisanexamplewidget.")}}publicstructProvider:TimelineProvider{publicfuncsnapshot(withcontext:Context,completion:@escaping(SimpleEntry)->()){letentry=SimpleEntry(date:Date())completion(entry)}publicfunctimeline(withcontext:Context,completion:@escaping(Timeline<Entry>)->()){letentry=SimpleEntry(date:Date())lettimeline=Timeline(entries:[entry,entry],policy:.atEnd)completion(timeline)}} 总结 终于讲完了,为了理解上的完整性,本文做了很多扩展性的说明,感谢各位读者的耐心阅读;这是 Widget 系列的最后一篇,WidgetKit 的概念很棒,也非常好用!希望大家能真正读懂原理,创造更多优秀的 Widget! 推荐阅读 ✨ Apple Widget:下一个顶级流量入口? ✨ 为 Widgets 构建 SwiftUI 视图 《Widgets 边看边写》第一部分:冒险开始了 《Widgets 边看边写》第二部分:Timelines 的基本使用 《Widgets 边看边写》第三部分:Timelines的进阶使用 关注我们 我们是「老司机技术周报」,每周会发布一份关于 iOS 的周报,也会定期分享一些和 iOS 相关的技术。欢迎关注。 支持作者 这篇文章的内容来自于 《WWDC20 内参》。在这里给大家推荐一下这个专栏,专栏目前已经创作了 101 篇文章,只需要 29.9 元。点击【阅读原文】,就可以购买继续阅读 ~ WWDC 内参 系列是由老司机周报、知识小集合以及 SwiftGG 几个技术组织发起的。已经做了几年了,口碑一直不错。 主要是针对每年的 WWDC 的内容,做一次精选,并号召一群一线互联网的 iOS 开发者,结合自己的实际开发经验、苹果文档和视频内容做二次创作。 本文分享自微信公众号 - 老司机技术周报(LSJCoding)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | SwiftUI 编程指南

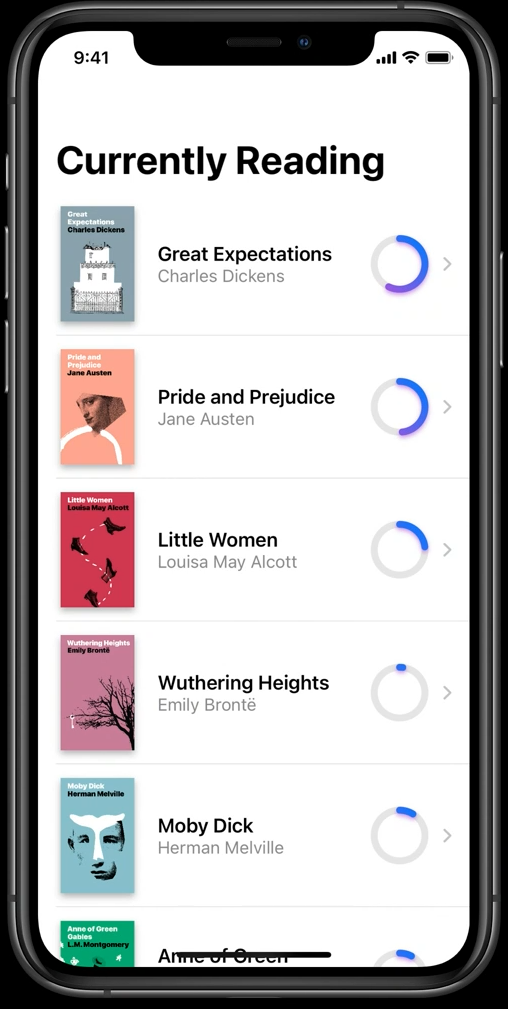
作者:CoderAFI, iOS 开发者 Session: https://developer.apple.com/videos/play/wwdc2020/10040/ 前言 时光荏苒,SwiftUI 技术已经推出一年,从 WWDC 2020 来看,SwiftUI 团队付出了空前的努力,使得 SwiftUI 无论是在开发体验,还是性能上都得到了很大的提升。如果说 SwiftUI 是去年苹果在开发技术转型上的小试牛刀,那么今年的 SwiftUI 基本已经成为了未来 5-10 年苹果生态开发技术的主流方式。 众所周知, SwiftUI 是一种数据驱动型的 DSL。也就是说,所有的界面显示效果,必须去改变数据然后通过绑定才能体现到相应的视图上。那么接下来,设计和组织好这些数据结构,才能让 SwiftUI 发挥出它的特性和优势。 回顾 WWDC 2019 Data Flow Through SwiftUI[1] 对应的文章 SwiftUI 数据流[2] 有幸也是笔者操刀撰写,文章内介绍了SwiftUI 数据流的基本原理、绘制流程以及发展趋势,并且对比了各种不同的编程范式,感兴趣的读者可以回顾阅读。 大纲 去年 SwiftUI 给出了 @State, @ObservedObject,@EnvironmentObject[3] 三个 PropertyWrapper 来处理视图和数据之间的绑定依赖关系,但并没有详细的讲解这几个 PropertyWrapper 的使用场景以及区别,后续大家都是根据自己的编码和调试经验得出一些使用上的技巧,今年苹果直接拿出一个 Book Club App[4] 做为案例,全方位的给你讲解如何使用它们,并给出一些参考规范,真香!本 Session 是由 Curt Clifton[5] 、Luca[6]、Raj Ramamurthy 三位大神为我们讲解,议题主要围绕以下三个方面: 视图和数据的生命周期 @StateObject 和一些新特性 值类型和引用类型数据在 SwiftUI 中的处理 三步走编写 SwiftUI 从本质上讲,编写 SwiftUI 应用程序还是属于前端技术的范畴,所以写界面是每位开发者都应该掌握的技能,那么当大家拿到设计稿开始编码的时候,首先要思考以下三个问题: 如何建立视图元素与数据的对应关系 视图和数据之间的操作逻辑有哪些 数据由谁持有 Property(属性绑定) 那么现在我们用上面这个设计图来回答以上三个问题: 这个界面是个读书的列表,每条书籍信息里有书籍的封面、数据的名称作者以及读书的进度 这个列表只是用来展示书籍列表,没有对数据的更改操作 这个图书数据是由每个 BookCard 持有,实例化的时候从父视图传递进来 通过回答上面问题,很容易就可以编写上述代码,可以看出 BookCard 视图的数据是由 Book 这个结构体提供的,Book 数据结构中包含了书籍的封面、标题、作者等信息,Progress 用来标记读书的进度;这个书籍列表视图只是用来展示数据,所以 book 和 progress 都用 let 声明为常量。那这些数据从哪来?他们可以通过在实例化 BookCard 的时候,通过构造函数从父视图传进来,每次渲染调用 body 计算属性获取绘制信息时,BookCard 都会实例一次。这个新实例化的 BookCard 生命周期只局限于本次渲染,如果下次渲染流程里它不再需要展示,那么它就被销毁了。它的可视化视图层级以及对应的数据关系图,如下: 接下来我们进入书籍详情页面,设计图如下,当点击 Update Progress 按钮的时候,需要弹出一个弹层,来记录读书进度。 根据信息展示的对应关系,我们需要一个 Boolean 变量 isEditorPresented 来控制弹层的显示与否,需要一个 String 类型的 note 来记录备注信息,需要一个 Double 类型的 progress 来记录读书进度,代码如下: 通常情况下可以把这些数据组装到一个 EditorConfig 的结构体中,如下图: 这样组装成 EditorConfig 后,BookCard 代码一下就清晰了,也非常方便进行独立测试。由于 EditorConfig 是一个值类型,改变它的内部属性它本身也会发生改变。 @State(状态绑定) 以上我们处理完弹层视图与数据之间的信息展示对应关系,那么接下来处理第二个问题 - “视图和数据之间的操作逻辑有哪些“,当我们要展示弹层的时候,我们需要将 isEditorPresented 属性设置为 true,那么就需要给 EditorConfig 添加一个 mutating 方法来进行更改并且初始化一些其他信息,如下图: 最后来处理第三个问题 - ”数据由谁持有“,从代码看 EditorConfig 上的数据都是 BookView 视图本地持有,没有从父视图传递进来,再结合上面数据需要被更改的情况,这时候需要创建一个单一数据源以维持数据与视图之间的同步。在 SwiftUI 中创建单一数据源最简单的方法就是 @State Property Wrapper,用 @State 来修饰属性后,SwiftUI 便接管了被修饰属性的存储 (简单理解就是 Get, Set 方法)。那么 SwiftUI 为什么要这么处理呢?因为如果是一个单纯的结构体,每次调用 body 进行重绘的时候,都是实例化一个全新 EditorConfig 结构体,对于只是展示数据的视图是没问题的,但是如果视图中有修改数据的行为,那么被修改的数据在结构体被销毁的时候也丢失了,而 SwIftUI 通过 @State PropertyWrapper,帮我们缓存住 EditorConfig,每次绘制的时候从内存缓存的数据中进行恢复。 @Binding(共享绑定) 那接下来让我们再用三步走法则,思考下 ProgressEditor (弹层视图) 该怎么实现,在这里值得注意的是弹层的数据从哪来的,由谁持有?如果我们先假设 ProgressEditor (弹层视图) 自己持有 EditorConfig,直接在它内部声明为一个属性,然后在实例化的时候从 BookView 传递进来,这样做只是传递了一份数据拷贝,当 ProgressEditor (弹层视图) 要修改 EditorConfig 的值时,也只是对自己内部的拷贝进行更改,不会影响到 BookView 中的 EditorConfig 实例,所以两边的数据是不同步的。那么我们给 ProgressEditor (弹层视图) 的 EditorConfig 也添加上一个 @State PropertyWrapper 可以吗?答案是否定的,这样做相当于在 BookView 和 ProgressEditor (弹层视图) 里创建了两个数据源,但是我们需要一个数据源来保持两个视图的数据同步,在 SwiftUI 中这种共享数据源的方式可以用 @Binding PropertyWrapper 来实现。使用 @Binding 后,现在 SwiftUI 帮你接管 EditorConfig 而且 BookView 和 ProgressEditor 都依赖于这个共享数据源。所以当数据发生变化时,SwiftUI 会对两个视图进行重绘。 接下来 ProgressEditor 还需要把修改好的数据传递给 BookView 进行展示,SwiftUI 采用了 PropertyWrapper 的 Projection 特性来实现了双向数据绑定,所以只需要在参数前面加一个 $ 符号即可。最终相当于 ProgressEditor (弹层视图) 直接跟 BookView 里的 EditorConfig 数据建立依赖关系。很多 SwiftUI 默认控件也采用的了这种绑定声明机制。 三步走法则 如何建立视图元素与数据的对应关系 视图和数据之间的操作逻辑有哪些 数据由谁持有 小技巧 当视图上只是对数据的展示时,用 Property (一般属性) 当视图要修改数据,而且只是在当前视图中短暂用到时,用 @State (状态绑定) 当 @State 或者 @Published 修饰的数据要被传递到其他视图访问修改时,用 @Binding(共享绑定) 设计好数据中间层 使用 ObservableObject @State 主要是针对视图内短暂的状态处理,但是通常情况下,UI 代码和业务逻辑代码是分开的。这个时候想要把业务逻辑代码绑定到 SwiftUI 视图中,就需要用到 ObservableObject。首先我们来看下ObservableObject 协议是如何定义的: 它遵循 AnyObject 协议,所以只能是引用类型遵循来实现它 需要实现 objectWillChange 属性,这个属性是个 Publisher,当数据发生变化时要通过它来告诉 SwiftUI,然后触发重绘 提供了默认的 Publisher 来处理 @Publisher 修饰的属性,当然也可以通过自定义 Publisher 来处理数据变化 ObservableObject 中间层 我们可以把 ObservableObject 理解为视图和数据建立依赖关系的中间层(类似 ViewModel),ObservableObject 内部不仅仅包含要展示到视图上的数据,也可以处理业务逻辑,数据缓存,网络请求等操作。当然你可以根据自己的业务逻辑来定义 ObservableObject 的生命周期。比如可以将所有的数据都包含在一个 ObservableObject 中,所有的视图都通过这个 ObservableObject 与相对应的数据建立依赖关系,如下图: 当你的数据结构非常复杂的时候,也可以拆分多个 ObservableObject 分别管理对应的视图数据,处理起来非常灵活性,如下图: @Published 属性修饰器 接下来,我们结合 Book App,看下代码是如何编写的: 我们这里定义了一个 CurrentlyReading 类来处理当前阅读书籍的业务逻辑,它内部的 Book 数据是不变的,可以用 let 声明,当我们要更新阅读进度时,我们直接对 @Published 修饰的属性进行更改,SwiftUI 通过之前对该属性的监听,就能感知到数据变化,触发 SwiftUI 重绘,然后在各 View 节点获取到定义的视图结构信息,组装成渲染树,最终将数据的变化呈现到新渲染的视图上,所以 @Published 就是 SwiftUI 感知 ObservableObject 数据变化的标记,它有以下特性: ObservableObject 默认集成 在 willSet 的时候触发数据变化通知 内部是通过一个 Publisher 来实现的,所以可以与任何响应式框架相结合 ObservableObject 绑定到视图 上面讲解了 ObservableObject 中间层如何定义,那么如何绑定到视图呢?SwiftUI 提供了三个 PropertyWrapper (属性修饰器): @ObservedObject - 最灵活的绑定方式,生命周期需要自己手动管理,使用不恰当会造成卡顿,建议是在一个顶级 View 中使用,传递给子视图共享数据源 @StateObject - WWDC20 新增的绑定方式,修饰的属性由 SwiftUI 控制创建与销毁,保持与 View 的生命周期一致,相当于 @State 和 @ObservedObject 的结合体 . [7] @EnvironmentObject - 全局绑定方式,在最顶级视图设置后,不需要参数传递,直接在子视图就可以使用 下面给出一些案例代码的使用场景: 性能优化与新特性 上面我们已经了解到如何为 SwiftUI 定义好数据中间层,接下来讨论下如何让 SwiftUI App 有更好的性能。首先我们深入思考下 View 到底是什么? View 生命周期 View 其实就是一部分 UI 属性信息的定义,SwiftUI 根据这些定义好的属性信息来进行渲染绘制,同时帮你标记好不同的 View 以管理他们的生命周期。由于 View 只是一些基本视图信息的定义,所以它非常轻量而且廉价。在 SwiftUI App 中所有界面上展示的视图都是一个 View。这里要注意的是 View 的生命周期和定义它的结构体的生命周期是不一样的,遵循了 View 协议的结构体,生命周期非常短,用完即销毁。也就是意味着 SwiftUI 只通过每个结构体的 body 属性来获取绘制信息,然后在内部对这些信息做一次拷贝,这时遵循 View 协议的结构体已经没用了,就会被销毁掉。SwiftUI 内部根据拷贝过来的信息进行绘制处理,当然通过信息计算后,如果有些 View 不需要显示,也会被被销毁掉。 SwiftUI 渲染流程 我们可以通过下图,了解到基本的渲染流程,当视图上有事件触发后,会对本地的数据进行更改,这个数据更改会影响到数据源的更改,当数据源发生了变化,SwiftUI 会触发重绘,重新获取新的视图定义结构,然后内部渲染成新的 UI 视图呈现给用户。 为了更好的理解,我们可以把上面的渲染流程简化成一个简单的圆环,如下图: 每次渲染的过程这个圆环就会重复执行相关操作。所以如何维持这个圆环执行流畅是保证 SwiftUI App性能的关键。如果圆环流程卡住了,SwiftUI 通常称这种现象为 Slow Update(慢更新),出现这种情况就说明你的 App 有丢帧的情况 。 那么如何避免上述情况呢?下面给出三点注意: 尽量保持 View 内绑定的数据信息轻量 body 计算属性只包含视图信息定义,不处理其他业务逻辑 避免错误的猜测 SwiftUI 渲染流程 接下来,我们通过下面 Book Club App 中的代码来看一个 SlowUpdate 的示例: 这里注意在 ReadingList 中定义的 ObservedObject 数据,看起来定义挺合理的,其实是有个 Bug 的,每当 ReadingListViewer 被创建的时候,ReadingListStore 都会再被实例化一次,因为每次 SwiftUI 都会把 ReadingList 实例化一次,进行拷贝。这样就导致了 SlowUpdate 的出现,同时也会导致数据的丢失。那么怎么解决呢?按照去年的实现标准,需要把 store 放到父视图中定义,然后用参数把它传递进来。但能不能能保持这种内部的编写方式呢?这样做更容易分割组件。今年新推出的 @StateObject PropertyWrapper[8] 就可以解决这个问题。就像上面提到的,StateObject PropertyWrapper 告诉 SwiftUI 在合适的时机再去实例化 ObservableObject,相当于在内部做了缓存机制,这样数据不会丢失,同时也避免了不必要的实例化。 在这里要注意的是,SwiftUI 不仅要响应界面操作事件,还要处理很多其他的外部通知事件,所以今年提供了一些新事件处理的 Modifier,如下图,这些 Modifier 可能会用一个 closure 回调来处理操作,但回调函数是在 UI 线程上执行的,如果要做逻辑复杂的处理,建议单独在后台线程执行。 全局数据源 我们再回到三步走法则,仔细想想数据由谁持这个问题,其实这个问题是最难回答的,因为它没有一个标准答案。在这里只能给出一些参考场景: 有可能是子视图与父视图共享数据源,共同持有 有可能是 View 自己持有的 ObservableObject,可以用 @StateObject 修饰的数据源 也可以定义一些全局数据源,所有视图共同持有 由于今年 SwiftUI 不仅只有 View 这一种视图,还增加了 Scene 和 App,所以数据的生命周期,也可以根据这些不同的视图定义发生变化,在 Scene 中你可以为每个 Window 定义一个全局的数据源,这样不同 Window 之间的数据操作就会相互隔离,如下图: 当然你可以用用 @StateObject 为 App 定义一个 App 级别的全局数据源,如下图: 缓存数据源 到目前为止,虽然我们可以处理各种数据与视图之间的依赖关系,但是每当 App 重新后,内存数据也就不存在了,这种情况通常我们要自己处理缓存逻辑,今年 SwiftUI 新增了本地缓存机制的 PropertyWrapper。它们拓展了数据的生命周期,而且可以自动从本地缓存中恢复过来: SceneStorage - 可以用来缓存一些自定义视图中的简单数据,在 App 重启后,会在这个视图中重新加载这些缓存数据并做为数据源 AppStroage - App 级别全局的数据缓存,相当于对 UserDefault 的封装,任何子视图都可以访问这部分缓存 属性修饰器对比 上述文章中介绍了基本上所有 SwiftUI PropertyWrapper[9],笔者总体汇总下各自的使用场景,方便大家记忆和区分: Property - 一般数据展示,不需要同步数据修改操作 @State - 数据修改需要同步 UI, 生命周期只局限于当前 View,一般修饰数据为结构体或枚举 @ObservedObject - 修饰数据为引用类型,数据的生命周期可以根据情况灵活控制,通常情况下一个顶级视图对应一个 ObservedObject @StateObject - 修饰数据为引用类型,生命周期跟 View 保持一致,可看做 @State 和 @ObservedObject 的结合体 @EnvironmentObject - 全局的数据绑定机制,生命周期与绑定到视图的生命周期一致 @SceneStorage - View 级别的数据缓存,注意只需要针对需要缓存的数据进行缓存 @AppStorage - App 级别的数据缓存,所有子视图都可以访问 @Binding - 父子视图之间进行数据源共享,双向绑定,一般只接受处理值类型 通过上述对比,推荐下我的编码流程,通常情况下,我先不会管这些属性修饰器,上来我会先定义视图对应的数据结构,直接在 SwiftUI 里面用上,等处理到相关 View 和数据绑定的时候,再回过头来加这些属性修饰器,或者更改一些数据结构的定义方式,相反如果一上来就考虑这些属性修饰器该怎么用,个人感觉很容易就陷入无限的思考,导致自己无法下手写代码,大家可以做为参考。 推荐阅读 ✨ 详解 WWDC 20 SwiftUI 的重大改变及核心优势 WWDC20 10041 - What's new in SwiftUI WWDC20 10048 - 在 SwiftUI 中创建复杂功能 WWDC20 10039 - 如何用 SwiftUI 写一个独立的 App? WWDC20 10033 - 为小组件构建 SwiftUI 视图 WWDC20 10037 - SwiftUI 中的 App 要领 WWDC20 10149 - 打造更容易 Preview 的 SwiftUI 应用 WWDC20 10649 - 为 Xcode Library 添加自定义 views 和 modifiers 关注我们 我们是「老司机技术周报」,每周会发布一份关于 iOS 的周报,也会定期分享一些和 iOS 相关的技术。欢迎关注。 支持作者 这篇文章的内容来自于《WWDC20 内参》。在这里给大家推荐一下这个专栏,专栏目前已经创作了 97 篇文章,只需要 29.9 元,一杯咖啡的价格,点击【阅读原文】,就可以畅读所有文章了~ WWDC 内参系列是由老司机周报、知识小集合以及 SwiftGG 几个技术组织发起的。已经做了几年了,口碑一直不错。主要是针对每年的 WWDC 的内容,做一次精选,并号召一群一线互联网的 iOS 开发者,结合自己的实际开发经验、苹果文档和视频内容做二次创作。 参考资料 [1]WWDC 2019 Data Flow Through SwiftUI: https://developer.apple.com/videos/play/wwdc2019/226/ [2]SwiftUI 数据流: https://xiaozhuanlan.com/topic/0528764139 [3]What's the difference between @ObservedObject, @State, and @EnvironmentObject?: https://www.hackingwithswift.com/quick-start/swiftui/whats-the-difference-between-observedobject-state-and-environmentobject [4]Building a Feature-Rich App with SwiftUI: https://developer.apple.com/documentation/swiftui/fruta_building_a_feature-rich_app_with_swiftui [5]Curt Clifton: https://github.com/curtclifton [6]Luca: https://github.com/lukabernardi [7]What's the difference between @StateObject and @ObservedObject? - Donny Wals: https://www.donnywals.com/whats-the-difference-between-stateobject-and-observedobject/ [8]What is the @StateObject property wrapper?: https://www.hackingwithswift.com/quick-start/swiftui/what-is-the-stateobject-property-wrapper [9]Swift UI Property Wrappers: https://swiftuipropertywrappers.com/ 本文分享自微信公众号 - 老司机技术周报(LSJCoding)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 线程隔离浅析

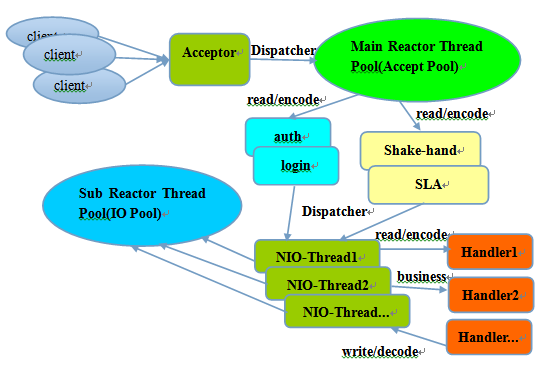
前言 随着微服务的流行,单体应用被拆分成一个个独立的微进程,可能一个简单的请求,需要多个微服务共同处理,这样其实是增加了出错的概率,所以如何保证在单个微服务出现问题的时候,对整个系统的负面影响降到最低,这就需要用到我们今天要介绍的线程隔离。 线程模型 在介绍线程隔离之前,我们先了解一下主流容器,框架的线程模型,因为微服务是一个个独立的进程,之间的调用其实就是走网络io,网络io的处理容器如tomcat,通信框架如netty,微服务框架如dubbo,都很好的帮我们处理了底层的网络io流,让我们可以更加的关注于业务处理; Netty Netty是基于java nio的高性能通信框架,使用了主从多线程模型,借鉴Netty系列之 Netty线程模型的一张图片如下所示: 主线程负责认证,连接,成功之后交由从线程负责连接的读写操作,大致如下代码: EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(); ServerBootstrap b = new ServerBootstrap(); b.group(bossGroup, workerGroup); 主线程是一个单线程,从线程是一个默认为cpu*2个数的线程池,可以在我们的业务handler中做一个简单测试: public void channelRead(ChannelHandlerContext ctx, Object msg) { System.out.println("thread name=" + Thread.currentThread().getName() + " server receive msg=" + msg); } 服务端在读取数据的时候打印一下当前的线程: threadname=nioEventLoopGroup-3-1server receive msg="..." 可以发现这里使用的线程其实和处理io线程是同一个; Dubbo Dubbo的底层通信框架其实使用的就是Netty,但是Dubbo并没有直接使用Netty的io线程来处理业务,可以简单在生产者端输出当前线程名称: threadname=DubboServerHandler-192.168.1.115:20880-thread-2,... 可以发现业务逻辑使用并不是nioEventLoopGroup线程,这是因为Dubbo有自己的线程模型,可以看看官网提供的模型图: 其中的Dispatcher调度器可以配置消息的处理线程: all所有消息都派发到线程池,包括请求,响应,连接事件,断开事件,心跳等。 direct所有消息都不派发到线程池,全部在 IO 线程上直接执行。 message只有请求响应消息派发到线程池,其它连接断开事件,心跳等消息,直接在 IO 线程上执行。 execution只有请求消息派发到线程池,不含响应,响应和其它连接断开事件,心跳等消息,直接在 IO 线程上执行。 connection在 IO 线程上,将连接断开事件放入队列,有序逐个执行,其它消息派发到线程池。 Dubbo默认使用FixedThreadPool,线程数默认为200; Tomcat Tomcat可以配置四种线程模型:BIO,NIO,APR,AIO;Tomcat8开始默认配置NIO,此模型和Netty的线程模型很像,可以理解为都是Reactor模式,在此不过多介绍;其中maxThreads参数配置专门处理IO的Worker数,默认是200;可以在业务Controller中输出当前线程名称: ThreadName=http-nio-8888-exec-1... 可以发现处理业务的线程就是Tomcat的io线程; 为什么要线程隔离 从上面的介绍的线程模型可以知道,处理业务的时候还是使用的io线程比如Tomcat和netty,这样会有什么问题那,比如当前服务进程需要同步调用另外三个微服务,但是由于某个服务出现问题,导致线程阻塞,然后阻塞越积越多,占满所有的io线程,最终当前服务无法接受数据,直至奔溃; Dubbo本身做了IO线程和业务线程的隔离,出现问题不至于影响IO线程,但是如果同样有以上的问题,业务线程也会被占满; 做线程隔离的目的就是如果某个服务出现问题可以把它控制在一个小的范围,不至于影响到全局; 如何做线程隔离 做线程隔离原理也很简单,给每个请求分配单独的线程池,每个请求做到互不影响,当然也可以使用一些成熟的框架比如Hystrix(已经不更新了),Sentinel等; 线程池隔离 SpringBoot+Tomcat做一个简单的隔离测试,为了方便模拟配置MaxThreads=5,提供隔离Controller,大致如下所示: @RequestMapping("/h1") String home() throws Exception { System.out.println("h1-->ThreadName=" + Thread.currentThread().getName()); Thread.sleep(200000); return "h1"; } @RequestMapping("/h3") String home3() { System.out.println("h3-->ThreadName=" + Thread.currentThread().getName()); return "h3"; } 请求5次/h1请求,再次请求/h3,观察日志: h1-->ThreadName=http-nio-8888-exec-1 h1-->ThreadName=http-nio-8888-exec-2 h1-->ThreadName=http-nio-8888-exec-3 h1-->ThreadName=http-nio-8888-exec-4 h1-->ThreadName=http-nio-8888-exec-5 可以发现h1请求占满了5条线程,请求h3的时候Tomcat无法接受请求;改造一下h1请求使用使用线程池来处理: ExecutorService executorService = Executors.newFixedThreadPool(2); List<Future<String>> list = new CopyOnWriteArrayList<Future<String>>(); @RequestMapping("/h2") String home2() throws Exception { Future<String> result = executorService.submit(new Callable<String>() { @Override public String call() throws Exception { System.out.println("h2-->ThreadName=" + Thread.currentThread().getName()); Thread.sleep(200000); return "h2"; } }); list.add(result); //降级处理 if (list.size() >= 3) { return "h2-fallback"; } String resultStr = result.get(); list.remove(result); return resultStr; } 如上部分伪代码,使用线程池异步执行,并且超出限制范围做降级处理,这样再次请求h3的时候,就不受影响了;当然上面代码比较简陋,我们可以使用成熟的隔离框架; Hystrix Hystrix 提供两种隔离策略:线程池隔离(Bulkhead Pattern)和信号量隔离,其中最推荐也是最常用的是线程池隔离。Hystrix的线程池隔离针对不同的资源分别创建不同的线程池,不同服务调用都发生在不同的线程池中,在线程池排队、超时等阻塞情况时可以快速失败,并可以提供fallback机制;可以看一个简单的实例: public class HelloCommand extends HystrixCommand<String> { public HelloCommand(String name) { super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("ThreadPoolTestGroup")) .andCommandKey(HystrixCommandKey.Factory.asKey("testCommandKey")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey(name)) .andCommandPropertiesDefaults( HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(20000)) .andThreadPoolPropertiesDefaults(HystrixThreadPoolProperties.Setter().withMaxQueueSize(5) // 配置队列大小 .withCoreSize(2) // 配置线程池里的线程数 )); } @Override protected String run() throws InterruptedException { StringBuffer sb = new StringBuffer("Thread name=" + Thread.currentThread().getName() + ","); Thread.sleep(2000); return sb.append(System.currentTimeMillis()).toString(); } @Override protected String getFallback() { return "Thread name=" + Thread.currentThread().getName() + ",fallback order"; } public static void main(String[] args) throws InterruptedException, ExecutionException { List<Future<String>> list = new ArrayList<>(); System.out.println("Thread name=" + Thread.currentThread().getName()); for (int i = 0; i < 8; i++) { Future<String> future = new HelloCommand("hystrix-order").queue(); list.add(future); } for (Future<String> future : list) { System.out.println(future.get()); } Thread.sleep(1000000); } } 如上配置了处理此业务的线程数为2,并且指定当线程满了之后可以放入队列的最大数量,运行此程序结果如下: Thread name=main Thread name=hystrix-hystrix-order-1,1589776137342 Thread name=hystrix-hystrix-order-2,1589776137342 Thread name=hystrix-hystrix-order-1,1589776139343 Thread name=hystrix-hystrix-order-2,1589776139343 Thread name=hystrix-hystrix-order-1,1589776141343 Thread name=hystrix-hystrix-order-2,1589776141343 Thread name=hystrix-hystrix-order-2,1589776143343 Thread name=main,fallback order 主线程执行可以理解为就是io线程,业务执行使用的是hystrix线程,线程数2+队列5可以同时处理7条并发请求,超过的部分直接fallback; 信号量隔离 线程池隔离的好处是隔离度比较高,可以针对某个资源的线程池去进行处理而不影响其它资源,但是代价就是线程上下文切换的开销比较大,特别是对低延时的调用有比较大的影响; 上面对线程模型的介绍,我们发现Tomcat默认提供了200个io线程,Dubbo默认提供了200个业务线程,线程数已经很多了,如果每个命令在使用一个线程池,线程数会非常多,对系统的影响其实也很大;有一种更轻量的隔离方式就是信号量隔离,仅限制对某个资源调用的并发数,而不是显式地去创建线程池,所以开销比较小;Hystrix和Sentinel都提供了信号量隔离方式,Hystrix已经停止更新,而Sentinel干脆就没有提供线程隔离,或者说线程隔离是没有必要的,完全可以用更轻量的信号量隔离代替; 总结 本文从线程模型开始,讲到了IO线程,以及为什么要分开IO线程和业务线程,具体如何去实现,最后简单介绍了一下更加轻量的信号量隔离,为什么说更加轻量哪,其实业务还是在IO线程处理,只不过会限制某个资源的并发数,没有多余的线程产生;当然也不是说线程隔离就没有价值了,其实还是要根据实际情况来定,根据你使用的容器,框架本身的线程模型来决定

优秀的个人博客,低调大师

Spark编程模型(博主推荐)

一、Spark编程模型(上) 从Hadoop MR到Spark 回顾hadoop—mapreduce计算过程 MRVS Spark Spark编程模型 核心概念 注意:对比mr里的概念来学习。 这些概念,大家一定要好好理解!!! Spark Application的组成 其中,Driver Program是运行main函数并且新建SparkContext的程序 Cluster Manager是在集群上获取资源的外部服务(例如: standalonde、Mesos、Yarn) Worker Node是集群中任何运行应用代码的节点 Executor是在一个worker node上为某应用启动的一个进程,该进程负责运行任务,并且负责将数据存在内存或磁盘上。每个应用都有各自独立的executors。 Task是被送到某个executor上的工作单元 Spark应用程序的组成 (1)Driver (2)Executor 注意:对照helloworld来思考 Spark Application基本概念 Spark Application编程模型 Spark 应用程序编程模型 – Driver Program ( SparkContext ) – Executor ( RDD 操作) (1)输入Base-> RDD (2)Transformation RDD->RDD (3)Action RDD->driver or Base (4)缓存 Persist or cache() – 共享变量 (1)broadcast variables(广播变量) (2)accumulators(累加器) 回顾Spark Hello World 初识RDD 什么是RDD 定义:Resilient distributed datasets (RDD), an efficient, general-purpose and fault-tolerant abstraction for sharing data in cluster applications. RDD 是只读的。 RDD 是分区记录的集合。 RDD 是容错的。--- lineage RDD 是高效的。 RDD 不需要物化。---物化:进行实际的变换并最终写入稳定的存储器上 RDD 可以缓存的。---课指定缓存级别 RDD是spark的核心,也是整个spark的架构基础,RDD是弹性分布式集合(Resilient Distributed Datasets)的简称,是分布式只读且已分区集合对象。这些集合是弹性的,如果数据集一部分丢失,则可以对它们进行重建。 RDD接口 RDD的本质特征 RDD--partitions Spark中将1~100的数组转换为rdd 通过第15行的size获得rdd的partition的个数,此处创建rdd显式指定定分区个数2,默认数值是这个程序所分配到的资源的cpu核的个数 RDD-preferredLocations 返回此RDD的一个partition的数据块信息,如果一个数据块(block)有多个备份在返回所有备份的location地址信息 主机ip或域名 作用:spark在进行任务调度室尽可能根据block的地址做到本地计算 RDD-dependencies RDD之间的依赖关系分为两类: (1)窄依赖 每个父RDD的分区都至多被一个子RDD的分区使用,即为OneToOneDependecies; (2)宽依赖 多个子RDD的分区依赖一个父RDD的分区,即为ShuffleDependency 。例如,map操作是一种窄依赖,而join操作是一种宽依赖(除非父RDD已经基于Hash策略被划分过了,co-partitioned) (1)窄依赖相比宽依赖更高效资源消耗更少 (2)允许在单个集群节点上流水线式执行,这个节点可以计算所有父级分区。例如,可以逐个元素地依次执行filter操作和map操作。 (3)相反,宽依赖需要所有的父RDD数据可用并且数据已经通过类MapReduce的操作shuffle完成。 (4)在窄依赖中,节点失败后的恢复更加高效。因为只有丢失的父级分区需要重新计算,并且这些丢失的父级分区可以并行地在不同节点上重新计算。 (5)与此相反,在宽依赖的继承关系中,单个失败的节点可能导致一个RDD的所有先祖RDD中的一些分区丢失,导致计算的重新执行。 RDD-compute 分区计算 Spark对RDD的计算是以partition为最小单位的,并且都是对迭代器进行复合,不需要保存每次的计算结果 RDD- partitioner 分区函数:目前spark中提供两种分区函数: (1)HashPatitioner(哈希分区) (2)RangePatitioner(区域分区) 且partitioner只存在于(K,V)类型的RDD中,rdd本身决定了分区的数量。 RDD- lineage val lines = sc.textFile("hdfs://...") // transformed RDDs val errors = lines.filter(_.startsWith("ERROR")) val messages = errors.map(_.split("\t")).map(r => r(1)) messages.cache() // action 1 messages.filter(_.contains("mysql")).count() // action 2 messages.filter(_.contains("php")).count() RDD经过trans或action后产生一个新的RDD,RDD之间的通过lineage来表达依赖关系,lineage是rdd容错的重要机制,rdd转换后的分区可能在转换前分区的节点内存中 典型RDD的特征 不同角度看RDD Scheduler Optimizations Spark编程模型(中) 创建RDD 方式一:从集合创建RDD (1)makeRDD (2)Parallelize 注意:makeRDD可以指定每个分区perferredLocations参数,而parallelize则没有。 方式二:读取外部存储创建RDD Spark与Hadoop完全兼容,所以对Hadoop所支持的文件类型或者数据库类型,Spark同样支持。 (1)多文件格式支持: (2)多文件系统支持: 1)本地文件系统 2)S3 3)HDFS (3)数据库 1)JdbcRDD 2)spark-cassandra-connector(datastax/spark-cassandra-connector) 3)org.apache.hadoop.hbase.mapreduce.TableInputFormat(SparkContext.newAPIHadoopRDD) 4)Elasticsearch-Hadoop transformation操作 惰性求值 (1)RDD 的转化操作都是惰性求值的。这意味着在被调用行动操作之前Spark 不会开始计算 (2)读取数据到RDD的操作也是惰性的 (3)惰性求值的好处: a.Spark 使用惰性求值可以把一些操作合并到一起来减少计算数据的步骤。在类似 Hadoop MapReduce 的系统中,开发者常常花费大量时间考虑如何把操作组合到一起,以减少MapReduce 的周期数。 b.而在Spark 中,写出一个非常复杂的映射并不见得能比使用很多简单的连续操作获得好很多的性能。因此,用户可以用更小的操作来组织他们的程序,这样也使这些操作更容易管理。 转换操作 RDD 的转化操作是返回新RDD 的操作 我们不应该把RDD 看作存放着特定数据的数据集,而最好把每个RDD 当作我们通过转化操作构建出来的、记录如何计算数据的指令列表。 基本转换操作1 基本转换操作2 控制操作 (1)persist操作,可以将RDD持久化到不同层次的存储介质,以便后续操作重复使用。 1)cache:RDD[T] 2)persist:RDD[T] 3)Persist(level:StorageLevel):RDD[T] (2)checkpoint 将RDD持久化到HDFS中,与persist操作不同的是checkpoint会切断此RDD之前的依赖关系,而persist依然保留RDD的依赖关系。 注意:控制操作的细节会在后续博客专门讲解 action操作 Spark编程模型(下) 什么是Pair RDD (1)包含键值对类型的RDD被称作Pair RDD (2)Pair RDD通常用来进行聚合计算 (3)Pair RDD通常由普通RDD做ETL转换而来 创建Pair RDD Python语言 pairs = lines.map(lambda x: (x.split(" ")[0], x)) scala语言 val pairs = lines.map(x => (x.split(" ")(0), x)) Java语言 PairFunction keyData = new PairFunction() { public Tuple2 call(String x) { return new Tuple2(x.split(" ")[0], x); } }; JavaPairRDD pairs = lines.mapToPair(keyData); Pair RDD的transformation操作 Pair RDD转换操作1 Pair RDD 可以使用所有标准RDD 上转化操作,还提供了特有的转换操作。 Pair RDD转换操作2 Pair RDD的action操作 Pair RDD转换操作1 所有基础RDD 支持的行动操作也都在pair RDD 上可用 Pair RDD的分区控制 Pair RDD的分区控制 (1) Spark 中所有的键值对RDD 都可以进行分区控制---自定义分区 (2)自定义分区的好处: 1)避免数据倾斜 2)控制task并行度 自定义分区方式 class DomainNamePartitioner(numParts: Int) extends Partitioner { override def numPartitions: Int = numParts override def getPartition(key: Any): Int = { val domain = new Java.net.URL(key.toString).getHost() val code = (domain.hashCode % numPartitions) if(code < 0) { code + numPartitions // 使其非负 }else{ code } } // 用来让Spark区分分区函数对象的Java equals方法 override def equals(other: Any): Boolean = other match { case dnp: DomainNamePartitioner => dnp.numPartitions == numPartitions case _ => false }

优秀的个人博客,低调大师

资源编排(ROS)博文索引

资源编排ROS 是一种简单易用的云计算资源管理和自动化运维服务。用户通过模板描述多个云计算资源的依赖关系、配置等,并自动完成所有资源的创建和配置,以达到自动化部署、运维等目的。 了解更多 资源编排(ROS)之入门篇 Hello, 资源编排 不写代码也可以驾驭阿里云OpenAPI 基于阿里云构建自己的弹性应用 资源编排模板详解 通过资源编排创建一个ECS实例 资源编排最佳实践之入门篇:云服务器如何从1到N? 简单高效的云服务器单元化扩容方案 资源编排(ROS)之ECS篇 端到端构建VPC网络,安全组和ECS资源 利用资源编排创建100台ECS实例并指定自动释放时间 利用资源编排服务,创建安全组(SecurityGroup)访问规则 一键创建包年包月ECS实例 资源编排Instance Clone 实现详解 使用ROS一键创建,分区,格式化和挂载数据盘 为ROS创建的资

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册