首页 文章 精选 留言 我的

精选列表

搜索[架构师],共6916篇文章
优秀的个人博客,低调大师

人人都是架构师-清晰架构 | 京东物流技术团队

前言 了解清晰架构之前需要大家先熟悉以下常见架构方案: EBI架构(Entity-Boundary-Interactor Architecture) 领域驱动设计(Domain-Driven Design) 端口与适配器架构(Ports & Adapters Architecture,又称为六边形架构) 洋葱架构(Onion Architecture) 整洁架构(Clean Architecture) 事件驱动架构(Event-Driven Architecture) 命令查询职责分离模式(CQRS,即Command Query Responsibility Segregation) 面向服务的架构(Service Oriented Architecture) 清晰架构(Explicit Architecture,直译为显式架构)是将上述架构的部分优势整合之后产生的另一种架构,因其2017年已经出现,已经不算是一种新的架构,实际应用的项目尚且较少。以下主要介绍架构的形成及各步骤的意义。 1 架构演化过程 1.1 系统的基本构建块 端口和适配器架构明确地识别出了一个系统中的三个基本代码构建块: 运行用户界面所需的构建块; 系统的业务逻辑,或者应用核心; 基础设施代码。 1.2 工具 在远离【应用核心】的地方,有一些应用会用到的工具,例如数据库引擎、搜索引擎、Web 服务器或者命令行控制台(虽然最后两种工具也是传达机制)。 把命令行控制台和数据库引擎都是应用使用的工具,关键的区别在于,命令行控制台和 Web 服务器告诉我们的应用它要做什么,而数据库引擎是由我们的应用来告诉它做什么。 1.3 将传达机制和工具连接到应用核心 连接工具和应用核心的代码单元被称为适配器(源自端口和适配器架构)。适配器有效地实现了让业务逻辑和特定工具之间可以相互通信的代码。 “告知我们的应用应该做什么”的适配器被称为主适配器或主动适配器,而那些“由我们的应用告知它该做什么”的适配器被称为从适配器或者被动适配器。 1.3.1 端口 适配器需要按照应用核心某个特定的入口的要求来创建,即端口。在大多数语言里最简单的形式就是接口,但实际上也可能由多个接口和 DTO 组成。 端口(接口)位于业务逻辑内部,而适配器位于其外部,这一点要特别注意。要让这种模式按照设想发挥作用,端口按照应用核心的需要来设计而不是简单地套用工具的 API。 1.3.2 主适配器或主动适配器 主适配器或主动适配器包装端口并通过它告知应用核心应该做什么。它们将来自传达机制的信息转换成对应用核心的方法调用。 换句话说,我们的主动适配器就是 Controller 或者控制台命令,它们需要的接口(端口)由其他类实现,这些类的对象通过构造方法注入到 Controller 或者控制台命令。 再举一个更具体的例子,端口就是 Controller 需要的 Service 接口或者 Repository 接口。Service、Repository 或 Query 的具体实现被注入到 Controller 供 Controller 使用。 此外,端口还可以是命令总线接口或者查询总线接口。这种情况下,命令总线或者查询总线的具体实现将被注入到 Controller 中, Controller 将创建命令或查询并传递给相应的总线。 1.3.3 从适配器或被动适配器 和主动适配器包装端口不同,被动适配器实现一个端口(接口)并被注入到需要这个端口的应用核心里。 举个例子,假设有一个需要存储数据的简单应用。我们创建了一个符合应用要求的持久化接口,这个接口有一个保存数据数组的方法和一个根据 ID 从表中删除一行的方法。接口创建好之后,无论何时应用需要保存或删除数据,都应该使用实现了这个持久化接口的对象,而这个对象是通过构造方法注入的。 现在我们创建了一个专门针对 MySQL 实现了该接口的适配器。它拥有保存数组和删除表中一行数据的方法,然后在需要使用持久化接口的地方注入它。 如果未来我们决定更换数据库供应商,比如换成 PostgreSQL 或者 MongoDB,我们只用创建一个专门针对 PostgreSQL 实现了该接口的适配器,在注入时用新适配器代替旧适配器。 1.3.4 控制反转 这种模式有一个特征,适配器依赖特定的工具和特定的端口(它需要提供接口的特定实现)。但业务逻辑只依赖按照它的需求设计的端口(接口),它并不依赖特定的适配器或工具。 换句话说,适配器根据使用的工具不同可以灵活变更,但是业务逻辑产生的接口基本不会变化。 这意味着依赖的方向是由外向内的,这就是架构层面的控制反转原则。 再一次强调,端口按照应用核心的需要来设计而不是简单地套用工具的 API。 1.4 应用核心的结构 洋葱架构采用了 DDD 的分层,将这些分层融合进了端口和适配器架构。这种分层为位于端口和适配器架构“六边形”内的业务逻辑带来一种结构组织,和端口与适配器架构一样,依赖的方向也是由外向内。 1.4.1 应用层 在应用中,由一个或多个用户界面触发的应用核心中的过程就是用例。例如,在一个 CMS 系统中,我们可以提供普通用户使用的应用 UI、CMS 管理员使用的独立的 UI、命令行 UI 以及 Web API。这些 UI(应用)可以触发的用例可能是专门为它设计的,也可以是多个 UI 复用的。 用例定义在应用层中,这是 DDD 提供的第一个被洋葱架构使用的层。 这个层包括了应用服务(以及它们的接口),也包括了端口与适配器架构中的接口,例如 ORM 接口、搜索引擎接口、消息接口等等。如果我们使用了命令总线和查询总线,命令和查询分别对应的处理程序也属于这一层。 1.4.2 领域层 继续向内一层就是领域层。这一层中的对象包含了数据和操作数据的逻辑,它们只和领域本身有关,独立于调用这些逻辑的业务过程。它们完全独立,对应用层完全无感知。 1.领域服务 我们偶尔会碰到某种涉及不同实体的领域逻辑,当然,无论实体是否相同,直觉告诉我们这种领域逻辑并不属于这些实体,这种逻辑不是这些实体的直接责任。 所以,我们的第一反应也许是把这些逻辑放到实体外的应用服务中,这意味着这些领域逻辑就不能被其它的用例复用:领域逻辑应该远离应用层。 解决方法是创建领域服务,它的作用是接收一组实体并对它们执行某种业务逻辑。领域服务属于领域层,因此它并不了解应用层中的类,比如应用服务或者 Repository。另一方面,它可以使用其他领域服务,当然还可以使用领域模型对象。 2.领域模型 在架构的正中心,是完全不依赖外部任何层次的领域模型。它包含了那些表示领域中某个概念的业务对象。这些对象的例子首先就是实体,还有值对象、枚举以及其它领域模型中用到的任何对象。 领域事件也“活在”领域模型中。当一组特定的数据发生变化时就会触发这些事件,而这些事件会携带这些变化的信息。换句话说,当实体变化时,就会触发一个领域事件,它携带着发生变化的属性的新值。这些事件可以完美地应用于事件溯源。 1.5 组件 目前为止,我们都是使用层次来划分代码,但这是细粒度的代码隔离。根据 Robert C. Martin 在尖叫架构中表达的观点,按照子域和限界上下文对代码进行划分这种粗粒度的代码隔离同样重要。这通常被叫做“按特性分包”或者“按组件分包”,和“按层次分包”相呼应。 我是“按组件分包”方式的坚定拥护者,在此我厚着脸皮将 Simon Brown 按组件分包的示意图做了如下修改: 这些代码块在前面描述的分层基础上再进行了“横切”,它们是应用的组件(译)。 组件的例子包括认证、授权、账单、用户、评论或帐号,而它们总是都和领域相关。像认证和授权这样的限界上下文应该被看作外部工具,我们应该为它们创建适配器,把它们隐藏在某个端口之后。 1.5.1 组件解耦 与细粒度的代码单元(类、接口、特质、混合等等)一样,粗粒度的代码单元(组件)也会从高内聚低耦合中受益。 我们使用依赖注入(通过将依赖注入类而不是在类内部初始化依赖)以及依赖倒置(让类依赖抽象,即接口和抽象类,而不是具体类)来解耦类。这意味着类不用知道它要使用的具体类的任何信息,不用引用所依赖的类的完全限定类名。 以同样的方式完全解耦组件意味着组件不会直接了解其它任何组件的信息。换句话说,它不会引用任何来自其它组件的细粒度的代码单元,甚至都不会引用接口!这意味着依赖注入和依赖倒置对组件解耦是不够用的,我们还需要一些架构层级的结构。我们需要事件、共享内核、最终一致性甚至发现服务! 1.触发其它组件的逻辑 当一个组件(组件 A)中有事情发生需要另一个组件(组件B)做些什么时,我们不能简单地从组件 A 直接调用组件 B 中的类/方法,因为这样 A 就和 B 耦合在一起了。 但是我们可以让 A 使用事件派发器,派发一个领域事件,这个事件将会投递给任何监听它的组件,例如 B,然后 B 的事件监听器会触发期望的操作。这意味着组件 A 将依赖事件派发器,但和 B 解耦了。 然而,如果事件本身“活在” A 中,这将意味着 B 知道了 A 的存在,就和 A 存在耦合。要去掉这个依赖,我们可以创建一个包含应用核心功能的库,由所有组件共享,这就是共享内核。这意味着两个组件都依赖共享内核,而它们之间却没有耦合。共享内核包含了应用事件和领域事件这样的功能,而且还包含规格对象,以及其它任何有理由共享的东西。记住共享内核的范围应该尽可能的小,因为它的任何变化都会影响所有应用组件。 而且,如果我们的系统是语言异构的,比如使用不同语言编写的微服务生态,共享内核需要做到与语言无关的,这样它才能被所有组件理解,无论它们是用哪种语言编写的。例如,共享内核应该包含像 JSON 这样无关语言的事件描述(例如,名称、属性,也许还有方法,尽管它们对规格对象来说更有意义)而不是事件类,这样所有组件或者微服务都可以解析它,还可以自动生成各自的具体实现。 这种方法既适用于单体应用,也适用于像微服务生态系统这样的分布式应用。然而,这种方法只适用于事件异步投递的情况,在需要即时完成触发其它组件逻辑的上下文中并不适用!组件 A 将需要向组件 B 发起直接的调用,例如HTTP。这种情况下,要解耦组件,我们需要一个发现服务,A 可以询问它得知请求应该发送到哪里才能触发期望的操作,又或是向发现服务发起请求并由发现服务将请求代理给相关服务并最终返回响应给请求方。这种方法会把组件和发现服务耦合在一起,但会让组件之间解耦。例如jsf。 2.从其它组件获得数据 原则上,组件不允许修改不“属于”它的数据,但可以查询和使用任何数据。 1)组件之间共享数据存储 当一个组件需要使用属于其它组件的数据时,比如说账单组件需要使用属于账户组件的客户名字,账单组件会包含一个查询对象,可以在数据存储中查询该数据。简单的说就是账单组件知道任何数据集,但它只能通过查询只读地使用不“属于”它的数据。 2)按组件隔离的数据存储 这种情况下,这种模式同样有效,但数据存储层面的复杂度更高。 组件拥有各自的数据存储意味着每个数据存储都包含: 一组属于它的数据,并且只允许它自己修改这些数据,让它成为单一事实来源; 一组其它组件数据的副本,它自己不能修改这些数据,但组件的功能需要这些数据,而且一旦数据在其所属的组件中发生了变化,这些副本需要更新。 每个组件都会创建其所需的其它组件数据的本地副本,在必要时使用。当数据在其所属的组件中发生了变化,该组件将触发一个携带数据变更的领域事件。拥有这些数据副本的组件将监听这个领域事件并相应地更新它们的本地副本。 1.6 控制流 如前所述,控制流显然从用户出发,进入应用核心,抵达基础设施工具,再返回应用核心并最终返回给用户。但这些类到底是是如何配合的?哪些类依赖哪些类?我们怎样把它们组合在一起? 1.6.1 没有命令/查询总线 如果没有命令总线,控制器要么依赖应用服务,要么依赖查询对象。 上图中我们使用了应用服务接口,尽管我们会质疑这并没有必要。因为应用服务是我们应用代码的一部分,而且我们不会想用另外一种实现来替换它,尽管我们可能会彻底地重构它。 1.6.2 有命令/查询总线 如果我们的应用使用了命令/查询总线,UML 图基本没有变化,唯一的区别是控制器现在会依赖总线、命令或查询。它将实例化命令或查询,将它们传递给总线。总线会找到合适的处理程序接收并处理命令。 在下图中,命令处理程序接下来将使用应用服务。然而,这不总是必须的,实际上大多数情况下,处理程序将包含用例的所有逻辑。只有在其它处理程序需要重用同样的逻辑时,我们才需要把处理程序中的逻辑提取出来放到单独的应用服务中。 总线和命令查询,以及处理程序之间没有依赖。这是因为实际上它们之间应该互相无感知,才能提供足够的解耦。只有通过配置才能设置总线可以发现哪些命令,或者查询应该由哪个处理程序处理。 如你所见,两种情况下,所有跨越应用核心边界的箭头——依赖——都指向内部。如前所述,这是端口和适配器架构、洋葱架构以及整洁架构的基本规则。 1.7 共享内核 共享内核由 DDD 之父 Eric Evans 定义,它是多个限界上下文之间共享的代码,由开发团队决定: […] 两个团队同意共享的领域模型的子集。当然,和模型子集一起共享还包括代码的子集,还有和这部分模型有关的数据库设计。这部分明确要共享的内容有着特殊的状态,而且在没有和其他团队达成一致的情况下不应该修改。 Shared Kernel(http://ddd.fed.wiki.org/view/shared-kernel), Ward Cunningham 的 DDD wiki 所以基本上,它可能是任何类型的代码:领域层代码、应用层代码、库,随便什么代码。 然而,在这份心智地图里,我们将它当做一些特定类型的代码的子集。共享内核包含的是领域层和应用层的代码,这些代码会在限界上下文之间共享,让这些上下文可以互相通信。 这意味着,例如,一个或多个限界上下文触发的事件可以在其它的限界上下文里被监听到。需要和这些事件一起共享的还有它们用到的所有数据类型,例如:实体 ID、值对象、枚举,等等。事件不应该直接使用像实体这样的复杂对象,因为将它们序列化到队列中或是从队列中反序列化时都会遇到一些问题,所以共享的代码不应该太宽泛。 当然,如果我们手中的是一个由不同语言开发的微服务组成的多语言系统,共享内核必须是描述性的语言,格式是 json、xml、yaml 或者其它,这样所有的微服务都能理解。 因此,共享内核就完全和其余的代码以及组件完全解耦了。这样很好,因为这意味着尽管组件耦合了共享内核,但组件之间不再耦合。共享代码可以被清晰地识别出来,并轻松地提取到一个独立的库中。 如果我们决定将一个限界上下文从单体中分离出来并提取成一个微服务,这也会很方便。我对共享代码了然于心,可以轻松地将共享内核提取到一个库中。而这个库即可以安装到单体中,也可以安装到微服务中。 2 用代码体现架构 2.1 两张脑图 第一张脑图由一系列同心圆层级组成,它们最终按照业务维度的应用模块切分,形成组件。在这张图里,依赖的方向由外向内,意味着内层对外层可见,而外层对内层不可见。 第二张则是一组平面的层级,其中最上面的一层就是前面这张同心圆,下一层是组件之间共享的代码(共享内核),再下一层使是我们自己对编程语言的扩展,最下面一层则是实际使用的编程语言。这里的依赖方向是自上而下的。 2.2 体现架构的代码风格 使用体现架构的代码风格,意味着代码风格(编码规范、类/方法/变量命名约定、代码结构…)某种程度上可以和阅读代码的人交流领域和架构的设计意图。要实现体现架构的代码风格,主要有两种思路。 “[…] 体现架构的代码风格能让你给代码的阅读者留下提示,帮助他们正确地推断出设计意图。” —George Fairbanks(https://links.jianshu.com/go?to=https%3A%2F%2Fresources.sei.cmu.edu%2Fasset_files%2FPresentation%2F2013_017_001_48651.pdf) 第一种思路是通过代码制品的名字(类、变量、模块…)来传达领域和架构的含义。因此,如果一个类是处理收据(Invoice)实体的仓库(Repository),我们就应该将它命名成InvoiceRepository,从这个名字我们就可以看出,它处理的是收据领域的概念,而它在架构中被当做一个仓库。这可以帮助我们理解它应该放在哪个地方,何时使用它以及如何使用它。但是,我认为代码仓库中并不是每个代码制品都需要这样做,例如,我觉得不必为每个实体(Entity)都加上后缀Entity,这样做就有些画蛇添足,徒增噪音。 “[…] 代码应该体现架构。换句话说,我一看到代码,就应该能够清晰地区分出各种组件[…]” —Simon Brown(https://links.jianshu.com/go?to=http%3A%2F%2Fwww.codingthearchitecture.com%2F2014%2F06%2F01%2Fan_architecturally_evident_coding_style.html) 第二种思路是让代码仓库中的顶级制品明确地区分出各个子域,即领域维度的模块,也就是组件。 第一种思路应该很清楚,无需赘述。但第二种思路有点儿微妙,我们得深入探讨一下。 2.3 让架构清晰的展现出来 在我的第一张图里,我们已经看到,在最粗粒度的层级上,我们只有三种不同用途的代码: 用户界面,这里的代码就是为了适配某个用例的传达机制; 应用核心,这里的代码就是用例和领域逻辑; 基础设施,这里的代码就是为了适配应用核心所需的工具/库。 因此,在源代码的根目录下我们可以创建三个文件夹来体现这三类代码,一个文件夹对应一个类别的代码。这三个文件夹表示三个命名空间,稍后我们甚至可以创建测试来断言核心对用户界面和基础设施可见,反过来却不可见,也就是说,我们可以测试由外向内的依赖方向。 2.3.1 用户界面 一个 Web 企业应用通常拥有多套 API,例如,一套给客户端使用的 REST API,还有一套给第三方应用使用的 web-hook, 业务还有一套需要维护的遗留 SOAP API,或者还有一套给全新移动应用使用的 GraphQL API… 这样的应该通常还有一些 CLI 命令,用于定时作业(Cron Job)或按需的维护操作。 当然,还有普通用户可以使用的网站本身,但也许还有另一个供应用管理员使用的网站。 这些全都是同一个应用的不同视图,全都是同一个应用的不同用户界面。 实际上我们的应用可能拥有多个用户界面,其中有些还是供非人类用户(第三方应用)使用的。我们通过文件/命名空间来区分并隔离这些用户界面,来展现出这一点。 用户界面主要有三类:API、CLI 和网站。所以我们在UserInterface根命名空间里为每个类别创建一个文件夹,将不同界面的类型清晰地区分开来。 下一步,如果有必要的话,我们还可以继续深入每种类型的命名空间,再创建更细分类的用户界面的命名空间(CLI 可能不需要再细分了)。 2.3.2 基础设施 和用户界面一样,我们的应用使用了多种工具(库和第三方应用),例如 ORM、消息队列、SMS 提供商。 此外,上述每一种工具都可以有不同的实现。例如,考虑一家公司业务扩张到另一个国家的情况,由于价格的因素,不同的国家最好采用不同的 SMS 提供商:我们需要端口相同的适配器的不同实现,这样使用时可以互相替换。另一个例子是对数据库 Schema 进行重构或者切换数据库引擎,需要(或决定要)切换 ORM 时:我们会在应用中注入两种 ORM 适配器。 因此,在Infrastructure命名空间来说,我们先给每一种工具类型创建一个命名空间(ORM、MessageQueue、SmsClient),然后再每一种工具类型内部为每一种用到的供应商(Doctrine、Propel、MessageBird、Twilio…)的适配器在创建一个命名空间。 2.3.3 核心 在Core命名空间下,可以按照最粗粒度的层级划分出三类代码: 组件(Component)、共享内核(Shared Kernel) 和 端口(Port)。为这三个类别创建文件夹/命名空间。 1.组件 在 Component 命名空间下,我们为每个组件创一个命名空间,然后在每个组件命名空间下,我们再分别为应用(Application)层和领域(Domain)层分别创建一个命名空间。 在 Application 和 Domain 命名空间下,我们先将全部类放在一起,随着类的数量不断增加,再来考虑必要的分组(我觉得一个文件夹下就放一个类有些矫枉过正,所以我宁愿在必要时再进行分组)。 这是我们就要考虑是按照业务主题(收据、交易…)分组还是按照技术作用(仓库、服务、值对象…)分组,但我觉得无论怎样分组影响都不大,因为这已经是整个代码组织树的叶子节点了,如果需要,在整个组织结构的最底端进行调整也很简单,不会影响代码仓库的其它部分。 2.端口 和 Infrastructure 命名空间一样,Port 命名空间里核心使用的每一种工具都有一个命名空间,核心通过这些代码才能使用底层的这些工具。 这些代码还会被适配器使用,它们的作用就是端口和真正工具之间的转换。这种形式简单得不能再简单了,端口就是一个接口,但很多时候它还需要值对象、DTO、服务、构建起、查询对象甚至是仓库。 3.共享内核 我们把在组件之间共享的代码放到 Shared Kernel 命名空间下。尝试了几种不同的共享内核内部结构之后,我无法找到一种适用于所有情况的结构。有些代码和Core\Component一样按组件划分很合理(例如 Entity ID 显然属于一个组件),有些代码这样划分却不合适(例如,事件可能被多个组件触发或监听)。也许要结合使用两种划分的思路。 2.3.4 用户区里的编程语言扩展 最后,我们还有一些自己对编程语言的扩展。这个系列中前面一篇文章已经讨论过,这些代码本可以放在编程语言中,却因为某些原因没有。比如,在 PHP 中我们可以想到的是 DateTime 类,它基于 PHP 提供的类扩展,提供了一些额外的方法。另一个例子是 UUID 类,尽管 PHP 没有提供,但是这个类天然就是纯粹的、对领域无感,因此可以在任意项目中使用,并且不依赖任何领域。 这些代码用起来和编程语言自己的提供的功能没啥区别,因此我们要完全掌控这些代码。然而,这并不是意味着我们不能使用第三方库。我们能用而且应该用,只要合理,但是这些库应该用我们自己的实现包装起来(这样的话我们可以方便的切换背后的第三方库),而应用代码应该直接使用这些包装代码。最终,这些代码可以自成项目,使用自己的 CVS 仓库,被多个项目使用。 3 通过文档描述架构 我们有哪些可供选择的文档工具来表达整个应用的构建块以及应用如何工作?! UML 4+1 架构视图模型 架构决策记录 C4 模型 依赖图 应用地图 3.1 C4 模型 C4 模型是 Simon Brown 发明的,是我目前看到的关于软件架构文档的最好思路。我会快速地用自己的语言来阐述主要的思路,但使用的还是他的图例。 其思路是用四种不同粒度(或者“缩放”)层级来记录软件的架构: 第一级:系统上下文图 第二级:容器图 第三级:组件图 第四级:代码图 3.1.1 第一级:系统上下文图 这是最粗粒度的图。它的细节很少但其主要目标是描述应用所处的上下文。因此,这幅图中只有一个方块代表整个应用,其它围绕着应用的方块代表了应用要进行交付的外部系统和用户。 3.1.2 第二级:容器图 现在,我们将应用放大,也就是上一级图中的蓝色方块,在这一级它对应的是下图中的虚线框。 在这个粒度级别,我们将看到应用得容器,一个容器就是一个应用中技术上独立的一小部分,例如一个移动 App,一个 API 或者一个数据库。它还描述了应用使用的主要技术和容器之间的通信方式。 3.1.3 第三级:组件图 组件图展示的是一个容器内的组件。在 C4 模型上下文里,每个组件就是应用的一个模块,不光是领域维度的模块(如账单、用户…)还包括纯粹的功能模块(如 email、sms…)。因此这个层级的图向我们展示了一个容器的主要齿轮和齿轮之间的啮合关系。 3.1.4 第四级:代码图 这是最细粒度的图,目的是描述一个组件内部的代码结构。在这个层级,我们使用的是表示类级别制品的 UML 图。 4 总结 清晰架构集百家之长,天然有很多优势: 从外向内,越向内越偏核心原则,核心原则相对稳定。核心原则就是常规的领域层,提供核心能力 外层基于核心原则适配不同的业务场景,组装内层的能力。这里的外层就是常规的接口层到应用层,主要使用主动适配器模式,重点关注 BFF(BackendsForFrontends) 及对内层能力的聚合 内层不依赖外层,不受业务变化而变化。关注能力的扩展,完成核心策略实现 边界明显,尤其是领域层与应用层之间 CQRS 机制,耦合度低,通过外层组装内层能力动态适配业务变化,扩展性高 这只是一份指南!应用才是你的疆域,现实情况和具体用例才是运用这些知识的地方,它们才能勾勒出实际架构的轮廓! 我们需要理解所有这些模式,但我们还时常需要思考和理解我们的应用需要什么,我们应该在追求解耦和内聚的道路上走多远。这个决定可能受到许多因素的影响,包括项目的功能需求,也包括构建应用的时间期限,应用寿命,开发团队的体验等等因素。 应用遵循某种领域结构组成,也遵循某种技术结构(即架构)组成。这两种结构才是一个应用的与众不同之处,而不是它使用的工具、库或者传达机制。如果我们想让一个应用可以长时间的维护,这两种结构都要清晰的体现在代码仓库中,这样开发者才能知道、理解、遵循,并在需要时改进。 这种清晰度让我们可以在编码的同时理解边界,这能反过来帮助我们保持应用的模块化设计,做到高内聚低耦合。 附录: 软件架构编年史(译):https://www.jianshu.com/p/b477b2cc6cfa The Software Architecture Chronicles:https://herbertograca.com/2017/07/03/the-software-architecture-chronicles/ 技术案例—基于 DDD 思想的技术架构战略调整:https://www.6aiq.com/article/1648170246451 中文图 作者:京东物流 李国梁 来源:京东云开发者社区自猿其说Tech

优秀的个人博客,低调大师

程序员的进阶课-架构师之路 - 数组

从这一节开始,我们就要正式进去数据结构的世界了,那么第一个是什么呢,就是我们的数组。在我想写数组的时候,我的第一印象是去看它的源码,很可惜,数组的实现太特殊了,找了很久,我没有找到它的源码,带着这样的思考,我就开始了Java中数组的挖掘。Wow,真香!一、Java中数组的介绍 数组是一种最简单的复合数据类型,它是有序数据的集合,数组中的每个元素具有相同的数据类型,可以用一个统一的数组名和不同的下标来唯一确定数组中的元素。根据数组的维度,可以将其分为一维数组、二维数组和多维数组等。一定要注意,数组只能存放同一种数据类型(Object类型数组除外)。二、数组是一个引用类型吗? 先给答案,是的,没有任何疑问。注意,数组也是一种数据类型,它本身是一种引用类型。数组是一种大小固定的数据结构,对线性表的所有操作都可以通过数组来实现。虽然数组一旦创建之后,它的大小就无法改变了,但是当数组不能再存储线性表中的新元素时,我们可以创建一个新的大的数组来替换当前数组。这样就可以使用数组实现动态的数据结构。如何验证? 定义一个数组,发现它拥有Object类的所有方法。 根据这个例子,其实大家已经看出来了,数组拥有超类Object的所有方法,说明他也是一个类。并且他拥有自己的clone()方法和length属性。三、如何了解数组的底层实现 既然数组拥有Object的所有方法,那我们是否能查看一下数组的源码,来了解一下数组的实现呢?可惜,数组太特殊了,他的实现是虚拟机编译的时候动态生成的,所以我们无法直接查看源码,只能通过查看编译后的class的字节码一探究竟。JVM 中数组对象是一种特殊的对象,虚拟机从数组的元数据中无法确认数组的大小,它的Object Header 比普通对象多了一个word 来存储数组的长度,length 会编译成对应的字节码读取这个field 就可以了。我分别定义基本数据类型和引用类型来查看一下最终生成的字节码有何区别。 public void test08(){ Object[] o = new String[11]; o[0]="1aaa"; int i=o.length; Integer[] a=new Integer[11]; a[0]=100; int j=a.length; int[] b=new int[11]; b[0]=100; int k=b.length; } 对应的字节码为: 0 bipush 11 2 anewarray #12 <java/lang/String> //anewarray代表对象数组 5 astore_1 6 aload_1 7 iconst_0 8 ldc #25 <1aaa>10 aastore11 aload_112 arraylength //arraylength代表长度13 istore_214 bipush 1116 anewarray #26 <java/lang/Integer> //anewarray代表包装类数组19 astore_320 aload_321 iconst_022 bipush 10024 invokestatic #27 <java/lang/Integer.valueOf>27 aastore28 aload_329 arraylength30 istore 432 bipush 1134 newarray 10 (int) //newarray代表基本数组类型数组36 astore 538 aload 540 iconst_041 bipush 10043 iastore44 aload 546 arraylength47 istore 649 return 注意:定义并初始化一个数组后,在内存中分配了两个空间,一个用于存放数组的引用变量,另一个用于存放数组本身。 进行程序开发时,要深入底层的运行机制。看待一个数组时,一定要把数组看成两个部分:一部分是数组引用,也就是在代码中定义的数组引用变量;还有一部分是实际的数组对象,这部分是在对内存里运行的,通常无法直接访问它,只能通过数组引用变量来访问。 四、Array 的 length 域相关 在很多的资料中都写了,Array中有类似public final int length的成员变量。但是在《Java Language Specifications》10.1. Array Types中明确写了,length不是类型的一部分;An array's length is not part of its type. private static void test06() { String[] s = new String[2]; System.out.println(s.length); System.out.println(s.getClass().getDeclaredFields().length); try { System.out.println(s.getClass().getDeclaredField("length")); } catch (NoSuchFieldException e) { System.out.println(e.toString()); } } 打印:20java.lang.NoSuchFieldException: length 可以看到length并不是Array的成员变量。五、Java语言规范关于Array的定义 数组在Java里是一种特殊类型,有别于普通的“类的实例”的对象。10.1. Array Types10.8. Class Objects for ArraysEvery array has an associated Class object, shared with all other arrays with the same component type.Although an array type is not a class, the Class object of every array acts as if:1、The direct superclass of every array type is Object.2、Every array type implements the interfaces Cloneable and java.io.Serializable. 数组类型是由JVM从元素类型合成出来的。10.7. Array MembersThe members of an array type are all of the following:1、The public final field length, which contains the number of components of the array. length may be positive or zero. 从Java语言到Class文件,Java源码编译器会识别出对数组类型的length字段的访问,并生成对应的字节码。以OpenJDK8的javac为例:jdk8u/jdk8u/langtools: 84eb51777733 src/share/classes/com/sun/tools/javac/jvm/Gen.java base.load();if (sym == syms.lengthVar) { code.emitop0(arraylength); result = items.makeStackItem(syms.intType);} 六、数据应用场景 这种数据结构使用一段连续的空间来存贮元素,所以可以直接通过索引来获取到某个元素,而且可以通过对元素的内容进行排序,然后使用二分法查找,从而提供查找效率。其适合的场合主要是:1、不会频繁增删元素的场合,因为增删元素都牵涉到元素空间的重新分配,频繁的内存分配操作会大幅降低操作效率。但添加操作时,可以通过预分配足够的空间来优化添加时的效率。 2、属于随机迭代器,可以随机访问任意元素。对于已排序的元素查找起来效率较高。 七、数组总结 在看数组的时候,因为class是动态创建的,所以看了很久,但是根据数组的特性,基本可以认为数组的域和方法,类似于: class A<T> implements Cloneable, java.io.Serializable { public final int length = X; public T[] clone() { try { return (T[]) super.clone(); } catch (CloneNotSupportedException e) { throw new InternalError(e.getMessage()); } }} 数组可以是一维数组、二维数组或多维数组。 数值数组元素的默认值为 0,而引用元素的默认值为 null。 交错数组是数组的数组,因此,它的元素是引用类型,初始化为 null。交错数组元素的维度和大小可以不同。 数组的索引从 0 开始,如果数组有 n 个元素,那么数组的索引是从 0 到(n-1)。 数组元素可以是任何类型,包括数组类型。 数组类型是从抽象基类 Array 派生的引用类型。 课程扩展阅读:https://www.roncoo.com/view/1160515822987776001

优秀的个人博客,低调大师

支付宝架构师眼中的高并发架构

​阅读本文大概需要 11.4 分钟。 来源:my.oschina.net/u/3772106/blog/1793561 前言 高并发经常会发生在有大活跃用户量,用户高聚集的业务场景中,如:秒杀活动,定时领取红包等。 为了让业务可以流畅的运行并且给用户一个好的交互体验,我们需要根据业务场景预估达到的并发量等因素,来设计适合自己业务场景的高并发处理方案。 在电商相关产品开发的这些年,我有幸的遇到了并发下的各种坑,这一路摸爬滚打过来有着不少的血泪史,这里进行的总结,作为自己的归档记录,同时分享给大家。 服务器架构 业务从发展的初期到逐渐成熟,服务器架构也是从相对单一到集群,再到分布式服务。 一个可以支持高并发的服务少不了好的服务器架构,需要有均衡负载,数据库需要主从集群,nosql缓存需要主从集群,静态文件需要上传cdn,这些都是能让业务程序流畅运行的强大后盾。 服务器这块多是需要运维人员来配合搭建,具体我就不多说了,点到为止。 大致需要用到的服务器架构如下: 服务器 均衡负载(如:nginx,阿里云SLB) 资源监控 分布式 数据库 主从分离,集群 DBA 表优化,索引优化,等 分布式 nosql 主从分离,集群 主从分离,集群 主从分离,集群 redis mongodb memcache cdn html css js image 并发测试 高并发相关的业务,需要进行并发的测试,通过大量的数据分析评估出整个架构可以支撑的并发量。 测试高并发可以使用第三方服务器或者自己测试服务器,利用测试工具进行并发请求测试,分析测试数据得到可以支撑并发数量的评估,这个可以作为一个预警参考,俗话说知己自彼百战不殆。 第三方服务: 阿里云性能测试 并发测试工具: Apache JMeter Visual Studio性能负载测试 Microsoft Web Application Stress Tool 实战方案 通用方案 日用户流量大,但是比较分散,偶尔会有用户高聚的情况; 场景: 用户签到,用户中心,用户订单,等 服务器架构图: 说明: 场景中的这些业务基本是用户进入APP后会操作到的,除了活动日(618,双11,等),这些业务的用户量都不会高聚集,同时这些业务相关的表都是大数据表,业务多是查询操作,所以我们需要减少用户直接命中DB的查询;优先查询缓存,如果缓存不存在,再进行DB查询,将查询结果缓存起来。 更新用户相关缓存需要分布式存储,比如使用用户ID进行hash分组,把用户分布到不同的缓存中,这样一个缓存集合的总量不会很大,不会影响查询效率。 方案如: 用户签到获取积分 计算出用户分布的key,redis hash中查找用户今日签到信息 如果查询到签到信息,返回签到信息 如果没有查询到,DB查询今日是否签到过,如果有签到过,就把签到信息同步redis缓存。 如果DB中也没有查询到今日的签到记录,就进行签到逻辑,操作DB添加今日签到记录,添加签到积分(这整个DB操作是一个事务) 缓存签到信息到redis,返回签到信息 注意这里会有并发情况下的逻辑问题,如:一天签到多次,发放多次积分给用户。 我的博文《大话程序猿眼里的高并发》(http://blog.thankbabe.com/2016/04/01/high-concurrency/)有相关的处理方案。 用户订单 这里我们只缓存用户第一页的订单信息,一页40条数据,用户一般也只会看第一页的订单数据 用户访问订单列表,如果是第一页读缓存,如果不是读DB 计算出用户分布的key,redis hash中查找用户订单信息 如果查询到用户订单信息,返回订单信息 如果不存在就进行DB查询第一页的订单数据,然后缓存redis,返回订单信息 用户中心 计算出用户分布的key,redis hash中查找用户订单信息 如果查询到用户信息,返回用户信息 如果不存在进行用户DB查询,然后缓存redis,返回用户信息 其他业务 上面例子多是针对用户存储缓存,如果是公用的缓存数据需要注意一些问题,如下 注意公用的缓存数据需要考虑并发下的可能会导致大量命中DB查询,可以使用管理后台更新缓存,或者DB查询的锁住操作。 我的博文《大话Redis进阶》(http://blog.thankbabe.com/2016/08/05/redis-up/)对更新缓存问题和推荐方案的分享。 以上例子是一个相对简单的高并发架构,并发量不是很高的情况可以很好的支撑,但是随着业务的壮大,用户并发量增加,我们的架构也会进行不断的优化和演变,比如对业务进行服务化,每个服务有自己的并发架构,自己的均衡服务器,分布式数据库,nosql主从集群,如:用户服务、订单服务; 消息队列 秒杀、秒抢等活动业务,用户在瞬间涌入产生高并发请求 场景:定时领取红包,等 服务器架构图: 说明: 场景中的定时领取是一个高并发的业务,像秒杀活动用户会在到点的时间涌入,DB瞬间就接受到一记暴击,hold不住就会宕机,然后影响整个业务; 像这种不是只有查询的操作并且会有高并发的插入或者更新数据的业务,前面提到的通用方案就无法支撑,并发的时候都是直接命中DB; 设计这块业务的时候就会使用消息队列的,可以将参与用户的信息添加到消息队列中,然后再写个多线程程序去消耗队列,给队列中的用户发放红包; 方案如: 定时领取红包 一般习惯使用 redis的 list 当用户参与活动,将用户参与信息push到队列中 然后写个多线程程序去pop数据,进行发放红包的业务 这样可以支持高并发下的用户可以正常的参与活动,并且避免数据库服务器宕机的危险 附加: 通过消息队列可以做很多的服务。 如:定时短信发送服务,使用sset(sorted set),发送时间戳作为排序依据,短信数据队列根据时间升序,然后写个程序定时循环去读取sset队列中的第一条,当前时间是否超过发送时间,如果超过就进行短信发送。 一级缓存 高并发请求连接缓存服务器超出服务器能够接收的请求连接量,部分用户出现建立连接超时无法读取到数据的问题; 因此需要有个方案当高并发时候时候可以减少命中缓存服务器; 这时候就出现了一级缓存的方案,一级缓存就是使用站点服务器缓存去存储数据,注意只存储部分请求量大的数据,并且缓存的数据量要控制,不能过分的使用站点服务器的内存而影响了站点应用程序的正常运行,一级缓存需要设置秒单位的过期时间,具体时间根据业务场景设定,目的是当有高并发请求的时候可以让数据的获取命中到一级缓存,而不用连接缓存nosql数据服务器,减少nosql数据服务器的压力 比如APP首屏商品数据接口,这些数据是公共的不会针对用户自定义,而且这些数据不会频繁的更新,像这种接口的请求量比较大就可以加入一级缓存; 服务器架构图: 合理的规范和使用nosql缓存数据库,根据业务拆分缓存数据库的集群,这样基本可以很好支持业务,一级缓存毕竟是使用站点服务器缓存所以还是要善用。 静态化数据 高并发请求数据不变化的情况下如果可以不请求自己的服务器获取数据那就可以减少服务器的资源压力。 对于更新频繁度不高,并且数据允许短时间内的延迟,可以通过数据静态化成JSON,XML,HTML等数据文件上传CDN,在拉取数据的时候优先到CDN拉取,如果没有获取到数据再从缓存,数据库中获取,当管理人员操作后台编辑数据再重新生成静态文件上传同步到CDN,这样在高并发的时候可以使数据的获取命中在CDN服务器上。 CDN节点同步有一定的延迟性,所以找一个靠谱的CDN服务器商也很重要 其他方案 对于更新频繁度不高的数据,APP,PC浏览器,可以缓存数据到本地,然后每次请求接口的时候上传当前缓存数据的版本号,服务端接收到版本号判断版本号与最新数据版本号是否一致,如果不一样就进行最新数据的查询并返回最新数据和最新版本号,如果一样就返回状态码告知数据已经是最新。减少服务器压力:资源、带宽等. 分层,分割,分布式 大型网站要很好支撑高并发,这是需要长期的规划设计 在初期就需要把系统进行分层,在发展过程中把核心业务进行拆分成模块单元,根据需求进行分布式部署,可以进行独立团队维护开发。 分层 将系统在横向维度上切分成几个部分,每个部门负责一部分相对简单并比较单一的职责,然后通过上层对下层的依赖和调度组成一个完整的系统 比如把电商系统分成:应用层,服务层,数据层。(具体分多少个层次根据自己的业务场景) 应用层:网站首页,用户中心,商品中心,购物车,红包业务,活动中心等,负责具体业务和视图展示 服务层:订单服务,用户管理服务,红包服务,商品服务等,为应用层提供服务支持 数据层:关系数据库,nosql数据库 等,提供数据存储查询服务 分层架构是逻辑上的,在物理部署上可以部署在同一台物理机器上,但是随着网站业务的发展,必然需要对已经分层的模块分离部署,分别部署在不同的服务器上,使网站可以支撑更多用户访问 分割 在纵向方面对业务进行切分,将一块相对复杂的业务分割成不同的模块单元 包装成高内聚低耦合的模块不仅有助于软件的开发维护,也便于不同模块的分布式部署,提高网站的并发处理能力和功能扩展 比如用户中心可以分割成:账户信息模块,订单模块,充值模块,提现模块,优惠券模块等 分布式 分布式应用和服务,将分层或者分割后的业务分布式部署,独立的应用服务器,数据库,缓存服务器 当业务达到一定用户量的时候,再进行服务器均衡负载,数据库,缓存主从集群 分布式静态资源,比如:静态资源上传cdn 分布式计算,比如:使用hadoop进行大数据的分布式计算 分布式数据和存储,比如:各分布节点根据哈希算法或其他算法分散存储数据 网站分层-图1来自网络 集群 对于用户访问集中的业务独立部署服务器,应用服务器,数据库,nosql数据库。 核心业务基本上需要搭建集群,即多台服务器部署相同的应用构成一个集群,通过负载均衡设备共同对外提供服务, 服务器集群能够为相同的服务提供更多的并发支持,因此当有更多的用户访问时,只需要向集群中加入新的机器即可, 另外可以实现当其中的某台服务器发生故障时,可以通过负载均衡的失效转移机制将请求转移至集群中其他的服务器上,因此可以提高系统的可用性 应用服务器集群 nginx 反向代理 slb … … (关系/nosql)数据库集群 主从分离,从库集群 通过反向代理均衡负载-图2来自网络 异步 在高并发业务中如果涉及到数据库操作,主要压力都是在数据库服务器上面,虽然使用主从分离,但是数据库操作都是在主库上操作,单台数据库服务器连接池允许的最大连接数量是有限的 当连接数量达到最大值的时候,其他需要连接数据操作的请求就需要等待有空闲的连接,这样高并发的时候很多请求就会出现connection time out 的情况 那么像这种高并发业务我们要如何设计开发方案可以降低数据库服务器的压力呢? 如: 自动弹窗签到,双11跨0点的时候并发请求签到接口 双11抢红包活动 双11订单入库 等 设计考虑: 逆向思维,压力在数据库,那业务接口就不进行数据库操作不就没压力了 数据持久化是否允许延迟? 如何让业务接口不直接操作DB,又可以让数据持久化? 方案设计: 像这种涉及数据库操作的高并发的业务,就要考虑使用异步了 客户端发起接口请求,服务端快速响应,客户端展示结果给用户,数据库操作通过异步同步 如何实现异步同步? 使用消息队列,将入库的内容enqueue到消息队列中,业务接口快速响应给用户结果(可以温馨提示高峰期延迟到账) 然后再写个独立程序从消息队列dequeue数据出来进行入库操作,入库成功后刷新用户相关缓存,如果入库失败记录日志,方便反馈查询和重新持久化 这样一来数据库操作就只有一个程序(多线程)来完成,不会给数据带来压力 补充: 消息队列除了可以用在高并发业务,其他只要有相同需求的业务也是可以使用,如:短信发送中间件等 高并发下异步持久化数据可能会影响用户的体验,可以通过可配置的方式,或者自动化监控资源消耗来切换时时或者使用异步,这样在正常流量的情况下可以使用时时操作数据库来提高用户体验 异步同时也可以指编程上的异步函数,异步线程,在有的时候可以使用异步操作,把不需要等待结果的操作放到异步中,然后继续后面的操作,节省了等待的这部分操作的时间 缓存 高并发业务接口多数都是进行业务数据的查询,如:商品列表,商品信息,用户信息,红包信息等,这些数据都是不会经常变化,并且持久化在数据库中 高并发的情况下直接连接从库做查询操作,多台从库服务器也抗不住这么大量的连接请求数(前面说过,单台数据库服务器允许的最大连接数量是有限的) 那么我们在这种高并发的业务接口要如何设计呢? 设计考虑: 还是逆向思维,压力在数据库,那么我们就不进行数据库查询 数据不经常变化,我们为啥要一直查询DB? 数据不变化客户端为啥要向服务器请求返回一样的数据? 方案设计: 数据不经常变化,我们可以把数据进行缓存,缓存的方式有很多种,一般的:应用服务器直接Cache内存,主流的:存储在memcache、redis内存数据库 Cache是直接存储在应用服务器中,读取速度快,内存数据库服务器允许连接数可以支撑到很大,而且数据存储在内存,读取速度快,再加上主从集群,可以支撑很大的并发查询 根据业务情景,使用配合客户端本地存,如果我们数据内容不经常变化,为啥要一直请求服务器获取相同数据,可以通过匹配数据版本号,如果版本号不一样接口重新查询缓存返回数据和版本号,如果一样则不查询数据直接响应 这样不仅可以提高接口响应速度,也可以节约服务器带宽,虽然有些服务器带宽是按流量计费,但是也不是绝对无限的,在高并发的时候服务器带宽也可能导致请求响应慢的问题 补充: 缓存同时也指静态资源客户端缓存 cdn缓存,静态资源通过上传cdn,cdn节点缓存我们的静态资源,减少服务器压力 面向服务 SOA面向服务架构设计 微服务更细粒度服务化,一系列的独立的服务共同组成系统 使用服务化思维,将核心业务或者通用的业务功能抽离成服务独立部署,对外提供接口的方式提供功能。 最理想化的设计是可以把一个复杂的系统抽离成多个服务,共同组成系统的业务,优点:松耦合,高可用性,高伸缩性,易维护。 通过面向服务化设计,独立服务器部署,均衡负载,数据库集群,可以让服务支撑更高的并发 服务例子: 用户行为跟踪记录统计 说明: 通过上报应用模块,操作事件,事件对象,等数据,记录用户的操作行为 比如:记录用户在某个商品模块,点击了某一件商品,或者浏览了某一件商品 背景: 由于服务需要记录用户的各种操作行为,并且可以重复上报,准备接入服务的业务又是核心业务的用户行为跟踪,所以请求量很大,高峰期会产生大量并发请求。 架构: nodejs WEB应用服务器均衡负载 redis主从集群 mysql主 nodejs+express+ejs+redis+mysql 服务端采用nodejs,nodejs是单进程(PM2根据cpu核数开启多个工作进程),采用事件驱动机制,适合I/O密集型业务,处理高并发能力强 业务设计: 并发量大,所以不能直接入库,采用:异步同步数据,消息队列 请求接口上报数据,接口将上报数据push到redis的list队列中 nodejs写入库脚本,循环pop redis list数据,将数据存储入库,并进行相关统计Update,无数据时sleep几秒 因为数据量会比较大,上报的数据表按天命名存储 接口: 上报数据接口 统计查询接口 上线跟进: 服务业务基本正常 每天的上报表有上千万的数据 冗余,自动化 当高并发业务所在的服务器出现宕机的时候,需要有备用服务器进行快速的替代,在应用服务器压力大的时候可以快速添加机器到集群中,所以我们就需要有备用机器可以随时待命。 最理想的方式是可以通过自动化监控服务器资源消耗来进行报警,自动切换降级方案,自动的进行服务器替换和添加操作等,通过自动化可以减少人工的操作的成本,而且可以快速操作,避免人为操作上面的失误。 冗余 数据库备份 备用服务器 自动化 自动化监控 自动化报警 自动化降级 通过GitLab事件,我们应该反思,做了备份数据并不代表就万无一失了,我们需要保证高可用性,首先备份是否正常进行,备份数据是否可用,需要我们进行定期的检查,或者自动化监控, 还有包括如何避免人为上的操作失误问题。(不过事件中gitlab的开放性姿态,积极的处理方式还是值得学习的) 总结 高并发架构是一个不断衍变的过程,冰洞三尺非一日之寒,长城筑成非一日之功 。 打好基础架构方便以后的拓展,这点很重要。 ·END· 程序员的成长之路 路虽远,行则必至

优秀的个人博客,低调大师

Java架构师必会的技能(你都会了吗?)

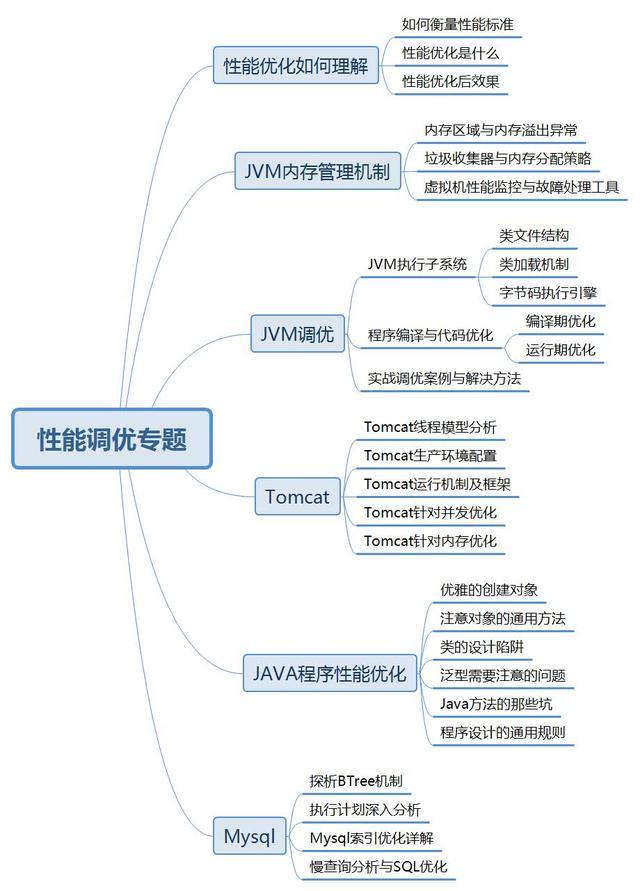
我把它分为了五大专题 工程化专题 工程化专题 git git安装使用 git日常使用:fetch/pull/push/revert/rebase git分支管理git flow Jenkins多套环境(test/pre/production)系统自动化发布 Jenkins自动发布到远程主机 MavenMaven私服搭建setting.xml文件剖析pom.xml详解Maven实用插件教学(静态代码检查、生成可执行jar包)profile使用 源码分析 源码分析 Spring源码分析 Spring IOC的实现原理Spring BeanFactory源码分析Spring AOP的实现原理及配置文件详解Spring AOP的各种应用场景分析Spring MVC与Struts对比Spring HandlerMapping详解手写实现SpringMVC框架Spring与各种框架集成原理Spring JDBC操作原理基于Spring JDBC手写ORM框架 MyBatis源码分析 MyBatis3简介MyBatis3 SqlMap那些事儿数据库连接池到底是什么MyBatis3 SessionFactory实现原理MyBatis3 配置文件详解MyBatis3 事务管理与集成浅谈HibernateMyBatis3与Hibernate框架对比Netty源码分析 NIO通信原理剖析深入了解NIO缓冲区Buffer NIO Selector原理AIO编程Netty产生的背景以及基础入门 Netty高性能之道Netty的HTTP与Socket通信原理利用Netty搭建高性能的 WebSocket聊天室 Netty聊天室客户端架构实现Netty的编码解码 Netty的拆包粘包操作MsgPack原理讲解及各种序列化框架对比MsgPack与Netty整合 Netty HTTP通信与Spring整合Netty RPC架构Netty与各种架构整合以及Netty源码分析 性能调优 性能调优 JVMJVM内存模型JVM运行时数据区垃圾回收机制GC日志详解 根据GC日志调优系统,调优不靠碰运气!Mysql数据库优化 数据库底层数据结构索引数据存储结构 innodb详解SQL调优及原理分库、分表实现Nginx调优动静资源分离 nginx参数详解nginx + lua使用应用:ip过滤,扛DDOSTomcat调优 Tomcat源码、架构分析Tomcat具体调优参数设置Tomcat压力基准测试Tomcat NIO配置 双十一技术架构专题-九阳真经 九阳真经技术专题 秒杀系统实战 从0到1构建秒杀系统从all-in-one到分布式从1到100的优化重构分布式压测系统 最简单的单机压测压测应该关注的点如何做分布式压测分布式跟踪系统 如何梳理链路依赖如何做到优雅降级分布式配置系统 灵活配置热发布一切都是为了自动化分布式消息系统 异步化&系统隔离应对瞬时大流量分布式缓存体系 五级缓存体系热点数据处理 高性能及分布式专题 分布式专题分布式缓存技术 RedisRedis简介及安装Redis基础知识、数据类型、Keys的操作命令Redis对不同数据类型的操作命令使用Redis核心配置分析Redis持久化概述,RDB原理、AOP原理分析Redis事务操作分析以及发布订阅模式的操作使用Redis集群搭建,一步步教你如何搭建Redis集群Redis主从复制原理分析Redis的优化建议、最佳实践Redis的JAVA客户端使用Redis集成Spring的使用MemcachedMemcached的介绍和安装、基本配置、常用运维命令 Memcached的工作原理Memcached的常用操作命令使用分析理解Memcached的数据存储方式,理解Slab Allocator、新建Item分配内存的过程Memcached数据存储方式的缺点;分析Memcached的数据过期方式Memcached内存调优建议、常见问题的解决方案Memcached的典型应用场景、不适用的场景Memcached基于Java客户端的使用分布式接口技术 DubboDubbo的发展过程及基本原理Dubbo控制台及监控平台的搭建使用快速搭建Dubbo服务框架Dubbo常用配置的使用及分析Dubbo注册中心原理、整合Zookeeper实现服务动态发现Dubbo多注册中心、多协议支持Dubbo服务分组、服务版本号控制Dubbo并发控制、连接控制Dubbo负载均衡、集群容错使用和分析Dubbo配置文件优先级别Dubbo和DubboX的比较以及DubboX的使用介绍ThriftThrift基本介绍、 如何安装配置ThriftThrift的数据类型、基本类型、结构体类型、容器类型介绍通过Thrift搭建服务端客户端通信Thrift数据传输协议分析 Restful什么是RestfulRestful的起源如何实现一个满足Restful架构的设计Restful实战 分布式服务协调 技术 Zookeeper 什么是Zookeeper、Zookeeper的安装配置、常用命令使用Zookeeper节点特性以及节点属性分析如何搭建zookeeper的集群环境Zookeeper客户端的使用:zkclient/curatorZookeeper的实现原理分析Zookeeper实战,共享锁、 master选举Consoul Eureka 微服务架构Spring BootSpring Boot概述、如何快速搭建一个Spring Boot的项目Spring 常用注解回顾Spring Boot核心配置文件分析Spring Boot四大神器使用剖析自定义Starter、自定义ActuatorSpring Boot 实现原理分析Spring Boot 数据存储配置、缓存配置、日志框架配置 DockerDocker原理分析入门介绍及安装配置网络模型常用命令讲解自己构建Docker镜像仓库管理实际案例使用搭建微服务架构Docker集群及编排工具分布式消息技术 ActiveMQActiveMQ功能简介、安装配置使用通过ActiveMQ实现简单的消息收发测试JMS的基本概念、PTP、Pub/Sub域分析JMS消息结构分析、理解JMS可靠性机制演示Topic持久化接收与非持久化接收理解Broker,Java内嵌Broker启动ActiveMQ结合Spring的使用理解ActiveMQ的传输协议ActiveMQ消息持久化方式(jdbc/KahaDB/Memory)及特点ActiveMQ集群(静态网络连接、动态网络连接)ActiveMQ的高级特性分析 KafkaKafka的基本介绍、安装配置使用Kafka的设计原理分析利用Kafka快速搭建一个消息发送接收程序Kafka数据传输的事务特点Kafka消息存储格式Kafka的集群部署配置Kafka消息分组、消息消费原理 分布式事务 分布式事务的基本介绍常用的分布式技术说明理解2PC和3PC协议分布式事务实践演练分布式环境session共享 什么时候需要用到Session共享Session共享的常用解决方案 高性能专题高性能web容器nginx Nginx简介、安装和基本配置Nginx的进程模型分析深入理解Nginx核心配置文件Nginx http模块功能配置及使用Nginx location定位功能的优先级Nginx 反向代理、负载均衡的配置Nginx 如何实现动静分离Nginx rewrite模块的使用Nginx 的使用建议Keepalived+nginx实现nginx高可用数据库性能 分库分表的基本概念mysql的主从配置分库分表的基本规则Mycat的安装使用Mycat配置深入分析及实践Mycat结合Mysql实现读写分离 MongoDBMongoDB是什么?MongoDB安装配置、及常用命令MongoDB增删改查的基本操作MongoDB查询操作命令使用深入理解MongoDB文档存储机制MongoDB索引使用分析MongoDB副本集配置及基本原理分析MongoDB分片功能介绍、分片和复制、片键的选择MongoDB数据备份、数据恢复MongoDB于spring集成使用 工作一到五年的程序员朋友面对目前的技术无从下手,感到很迷茫可以加群744677563,里面有阿里Java高级大牛直播讲解知识点,分享知识,课程内容都是各位老师多年工作经验的梳理和总结,带着大家全面、科学地建立自己的技术体系和技术认知! 我把它分为了五大专题 工程化专题 工程化专题 git git安装使用 git日常使用:fetch/pull/push/revert/rebase git分支管理git flow Jenkins多套环境(test/pre/production)系统自动化发布 Jenkins自动发布到远程主机 MavenMaven私服搭建setting.xml文件剖析pom.xml详解Maven实用插件教学(静态代码检查、生成可执行jar包)profile使用 源码分析 源码分析 Spring源码分析 Spring IOC的实现原理Spring BeanFactory源码分析Spring AOP的实现原理及配置文件详解Spring AOP的各种应用场景分析Spring MVC与Struts对比Spring HandlerMapping详解手写实现SpringMVC框架Spring与各种框架集成原理Spring JDBC操作原理基于Spring JDBC手写ORM框架 MyBatis源码分析 MyBatis3简介MyBatis3 SqlMap那些事儿数据库连接池到底是什么MyBatis3 SessionFactory实现原理MyBatis3 配置文件详解MyBatis3 事务管理与集成浅谈HibernateMyBatis3与Hibernate框架对比Netty源码分析 NIO通信原理剖析深入了解NIO缓冲区Buffer NIO Selector原理AIO编程Netty产生的背景以及基础入门 Netty高性能之道Netty的HTTP与Socket通信原理利用Netty搭建高性能的 WebSocket聊天室 Netty聊天室客户端架构实现Netty的编码解码 Netty的拆包粘包操作MsgPack原理讲解及各种序列化框架对比MsgPack与Netty整合 Netty HTTP通信与Spring整合Netty RPC架构Netty与各种架构整合以及Netty源码分析 性能调优 性能调优 JVMJVM内存模型JVM运行时数据区垃圾回收机制GC日志详解 根据GC日志调优系统,调优不靠碰运气!Mysql数据库优化 数据库底层数据结构索引数据存储结构 innodb详解SQL调优及原理分库、分表实现Nginx调优动静资源分离 nginx参数详解nginx + lua使用应用:ip过滤,扛DDOSTomcat调优 Tomcat源码、架构分析Tomcat具体调优参数设置Tomcat压力基准测试Tomcat NIO配置 双十一技术架构专题-九阳真经 九阳真经技术专题 秒杀系统实战 从0到1构建秒杀系统从all-in-one到分布式从1到100的优化重构分布式压测系统 最简单的单机压测压测应该关注的点如何做分布式压测分布式跟踪系统 如何梳理链路依赖如何做到优雅降级分布式配置系统 灵活配置热发布一切都是为了自动化分布式消息系统 异步化&系统隔离应对瞬时大流量分布式缓存体系 五级缓存体系热点数据处理 高性能及分布式专题 分布式专题分布式缓存技术 RedisRedis简介及安装Redis基础知识、数据类型、Keys的操作命令Redis对不同数据类型的操作命令使用Redis核心配置分析Redis持久化概述,RDB原理、AOP原理分析Redis事务操作分析以及发布订阅模式的操作使用Redis集群搭建,一步步教你如何搭建Redis集群Redis主从复制原理分析Redis的优化建议、最佳实践Redis的JAVA客户端使用Redis集成Spring的使用MemcachedMemcached的介绍和安装、基本配置、常用运维命令 Memcached的工作原理Memcached的常用操作命令使用分析理解Memcached的数据存储方式,理解Slab Allocator、新建Item分配内存的过程Memcached数据存储方式的缺点;分析Memcached的数据过期方式Memcached内存调优建议、常见问题的解决方案Memcached的典型应用场景、不适用的场景Memcached基于Java客户端的使用分布式接口技术 DubboDubbo的发展过程及基本原理Dubbo控制台及监控平台的搭建使用快速搭建Dubbo服务框架Dubbo常用配置的使用及分析Dubbo注册中心原理、整合Zookeeper实现服务动态发现Dubbo多注册中心、多协议支持Dubbo服务分组、服务版本号控制Dubbo并发控制、连接控制Dubbo负载均衡、集群容错使用和分析Dubbo配置文件优先级别Dubbo和DubboX的比较以及DubboX的使用介绍ThriftThrift基本介绍、 如何安装配置ThriftThrift的数据类型、基本类型、结构体类型、容器类型介绍通过Thrift搭建服务端客户端通信Thrift数据传输协议分析 Restful什么是RestfulRestful的起源如何实现一个满足Restful架构的设计Restful实战 分布式服务协调 技术 Zookeeper 什么是Zookeeper、Zookeeper的安装配置、常用命令使用Zookeeper节点特性以及节点属性分析如何搭建zookeeper的集群环境Zookeeper客户端的使用:zkclient/curatorZookeeper的实现原理分析Zookeeper实战,共享锁、 master选举Consoul Eureka 微服务架构Spring BootSpring Boot概述、如何快速搭建一个Spring Boot的项目Spring 常用注解回顾Spring Boot核心配置文件分析Spring Boot四大神器使用剖析自定义Starter、自定义ActuatorSpring Boot 实现原理分析Spring Boot 数据存储配置、缓存配置、日志框架配置 DockerDocker原理分析入门介绍及安装配置网络模型常用命令讲解自己构建Docker镜像仓库管理实际案例使用搭建微服务架构Docker集群及编排工具分布式消息技术 ActiveMQActiveMQ功能简介、安装配置使用通过ActiveMQ实现简单的消息收发测试JMS的基本概念、PTP、Pub/Sub域分析JMS消息结构分析、理解JMS可靠性机制演示Topic持久化接收与非持久化接收理解Broker,Java内嵌Broker启动ActiveMQ结合Spring的使用理解ActiveMQ的传输协议ActiveMQ消息持久化方式(jdbc/KahaDB/Memory)及特点ActiveMQ集群(静态网络连接、动态网络连接)ActiveMQ的高级特性分析 KafkaKafka的基本介绍、安装配置使用Kafka的设计原理分析利用Kafka快速搭建一个消息发送接收程序Kafka数据传输的事务特点Kafka消息存储格式Kafka的集群部署配置Kafka消息分组、消息消费原理 分布式事务 分布式事务的基本介绍常用的分布式技术说明理解2PC和3PC协议分布式事务实践演练分布式环境session共享 什么时候需要用到Session共享Session共享的常用解决方案 高性能专题高性能web容器nginx Nginx简介、安装和基本配置Nginx的进程模型分析深入理解Nginx核心配置文件Nginx http模块功能配置及使用Nginx location定位功能的优先级Nginx 反向代理、负载均衡的配置Nginx 如何实现动静分离Nginx rewrite模块的使用Nginx 的使用建议Keepalived+nginx实现nginx高可用数据库性能 分库分表的基本概念mysql的主从配置分库分表的基本规则Mycat的安装使用Mycat配置深入分析及实践Mycat结合Mysql实现读写分离 MongoDBMongoDB是什么?MongoDB安装配置、及常用命令MongoDB增删改查的基本操作MongoDB查询操作命令使用深入理解MongoDB文档存储机制MongoDB索引使用分析MongoDB副本集配置及基本原理分析MongoDB分片功能介绍、分片和复制、片键的选择MongoDB数据备份、数据恢复MongoDB于spring集成使用 工作一到五年的程序员朋友面对目前的技术无从下手,感到很迷茫可以加群744677563,里面有阿里Java高级大牛直播讲解知识点,分享知识,课程内容都是各位老师多年工作经验的梳理和总结,带着大家全面、科学地建立自己的技术体系和技术认知!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册