首页 文章 精选 留言 我的

精选列表

搜索[开源贡献],共10011篇文章
优秀的个人博客,低调大师

CPI指数反弹有望 物联网行业将为市场带来贡献

日前发布的消费者物价指数,显示通胀预期有所缓解,消费的活跃,让市场情绪也趋于乐观。但是按照预计,5月份CPI大概会反弹到1.6%,较4月份的1.2%仍有较大提升空间。显然,需要投资者与消费者的积极参与,才能让宏观经济欣欣向荣。 为了盘活消费,市场上的玩家也是拼了。制造领域有智能制造,为消费者个性化定制各类产品,激发其购买需求。家电厂商推出了智能、互联的智能家居解决方案,交通部门为了缓解交通拥堵,也纷纷引入智能调度系统。智能设备玩家也纷纷推出各类可穿戴设备,就连汽车制造商也将会推出了智能互联的汽车。 所有的企业,都在想方设法激发市场的消费潜力。想要实现这一目标,就要提高产品与服务的吸引力,眼下物联网就是能够帮助制造业厂商提高产品吸引力的手段,而物联网的存在,更是有望为制造业、服务业企业带来新的玩法,帮助他们更好地开拓消费市场。 物联网是新兴市场,更是提高市场消费水平的一大助力。而眼下物联网企业过多地关注于2B领域,例如环保企业的数据采集、交通部门的车流量监管、汽车厂商的联网汽车、其他制造业的物联网工厂,也正是这一载体,让物联网市场规模保持了较高的增长速度。但是未来,随着物联网技术逐渐成熟、成本逐渐降低,就会像当初的智能手机一样普及,届时,物联网在大众消费领域将会席卷全球,物联网市场将会出现各种各样的需求,这将会为物联网玩家们带来广阔的发展空间。 例如,眼下面向消费者的物联网应用有智能家居与可穿戴设备,这一领域的创新以及技术迭代也更加迅速,毕竟开发者不需要与企业客户合作,相对而言进入市场的门槛也较低。在“消费者化”这一潮流下,联网汽车算是最具代表性的。 不过从目前物联网行业的发展现状来看,业内还缺乏大型的企业。而眼下物联网技术储备已经大幅度提升,越来越多的设备都可以实现互联,但是市场上缺少那些平台式的应用,与这些物联设备形成生态闭环。 以智慧医疗为例,各种智能医疗设备只有接入智慧医疗平台,才能打造完整的产品与服务体系。另外,在细分垂直领域加以应用,也是发挥物联网效用的关键。 据前瞻产业研究院的分析,当下全球物联网行业的市场规模已经达到700亿美元。 图表:全球物联网市场规模及增速(亿美元) 资料来源:前瞻产业研究院整理 本文相关报告 REPORTS2017-2022年中国物联网行业应用领域市场需求与投资预测分析报告 在一个供大于求的需求经济时代,企业成功的关键就在于,是否能够在需求尚未形成之时就牢牢的锁定并捕捉到它。那些成功的公司往往都会倾尽毕生的精力及资源搜寻产业的当前... 本文转自d1net(转载)

优秀的个人博客,低调大师

NeurIPS 2025 最佳论文奖公布,中国研究者贡献突出

人工智能领域顶级会议NeurIPS 2025最佳论文奖近日公布,共四篇论文获奖,其中多篇由华人学者主导。获奖工作涵盖语言模型多样性、大模型注意力机制、深度强化学习及扩散模型理论。 其中包括 Liwei Jiang 等提出的《Artificial Hivemind》,揭示大模型生成中的“人工蜂群效应”;Zihan Qiu 等来自阿里巴巴Qwen团队的《Gated Attention for Large Language Models》,提出有效缓解“注意力沉降”问题的新机制;Princeton University 的 Kevin Wang 等通过千层网络实现自监督强化学习突破;以及 PSL University 的 Tony Bonnaire 等对扩散模型泛化机理的理论分析。 此外,He Kaiming、Sun Jian 等的《Faster R-CNN》荣获“时间检验奖”。 以下是获奖论文的简要介绍: 最佳论文 Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond) 作者:Liwei Jiang, Yuanjun Chai等 机构:艾伦人工智能研究所、斯坦福大学 内容:提出大规模数据集Infinity-Chat,揭示大语言模型在开放式生成中存在“人工蜂群思维”效应,即模型内重复和模型间同质化问题,为评估模型多样性提供了新基准。 链接:https://openreview.net/pdf?id=saDOrrnNTz Gated Attention for Large Language Models: Non-Linearity, Sparsity, and Attention-Sink-Free 作者:Zihan Qiu, Zekun Wang等 机构:阿里通义千问团队、爱丁堡大学等 内容:系统分析注意力门控机制对大语言模型的影响,发现其能提升模型性能、训练稳定性及长上下文泛化能力,相关成果已应用于Qwen3-Next模型。 链接:https://openreview.net/pdf?id=1b7whO4SfY 1000 Layer Networks for Self-Supervised RL: Scaling Depth Can Enable New Goal-Reaching Capabilities 作者:Kevin Wang, Ishaan Javali等 机构:普林斯顿大学、华沙理工大学 内容:证明将网络深度扩展至1024层可显著提升自监督强化学习性能,突破传统浅层网络限制,为构建更强大的AI系统开辟新途径。 链接:https://openreview.net/pdf?id=s0JVsx3bx1 Why Diffusion Models Don’t Memorize: The Role of Implicit Dynamical Regularization in Training 作者:Tony Bonnaire, Raphaël Urfink等 机构:巴黎文理研究大学、博科尼大学 内容:揭示扩散模型训练中的隐式动态正则化机制,解释其为何能在高度过参数化下避免记忆化,为理解生成式AI的泛化能力提供理论基础。 链接:https://openreview.net/pdf?id=BSZqpqgqM0 最佳论文亚军 Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? 作者:Yang Yue, Zhiqi Chen等 机构:清华大学、上海交通大学 内容:挑战强化学习激发大语言模型推理能力的假设,指出带可验证奖励的强化学习(RLVR)未必能提升模型推理能力,为新型强化学习范式的研究提供方向。 链接:https://openreview.net/pdf?id=4OsgYD7em5 Optimal Mistake Bounds for Transductive Online Learning 作者:Zachary Chase, Steve Hanneke等 机构:肯特州立大学、普渡大学等 内容:解决学习理论领域长达30年的公开难题,精确刻画传导式在线学习的最优错误上界,确立其与标准在线学习的二次量级差距。 链接:https://openreview.net/pdf?id=EoebmBe9fG Superposition Yields Robust Neural Scaling 作者:Yizhou Liu, Ziming Liu等 机构:麻省理工学院 内容:论证表征叠加是神经网络缩放定律的主要机制,为理解模型规模与性能的关系提供新视角。 链接:https://openreview.net/pdf?id=knPz7gtjPW 此外,任少卿、何恺明等2015年合著的《Faster R-CNN》获得时间检验奖,该论文奠定了现代目标检测框架的核心范式。

优秀的个人博客,低调大师

社区新贡献:X2SeaTunnel 助你无缝迁移到 SeaTunnel!

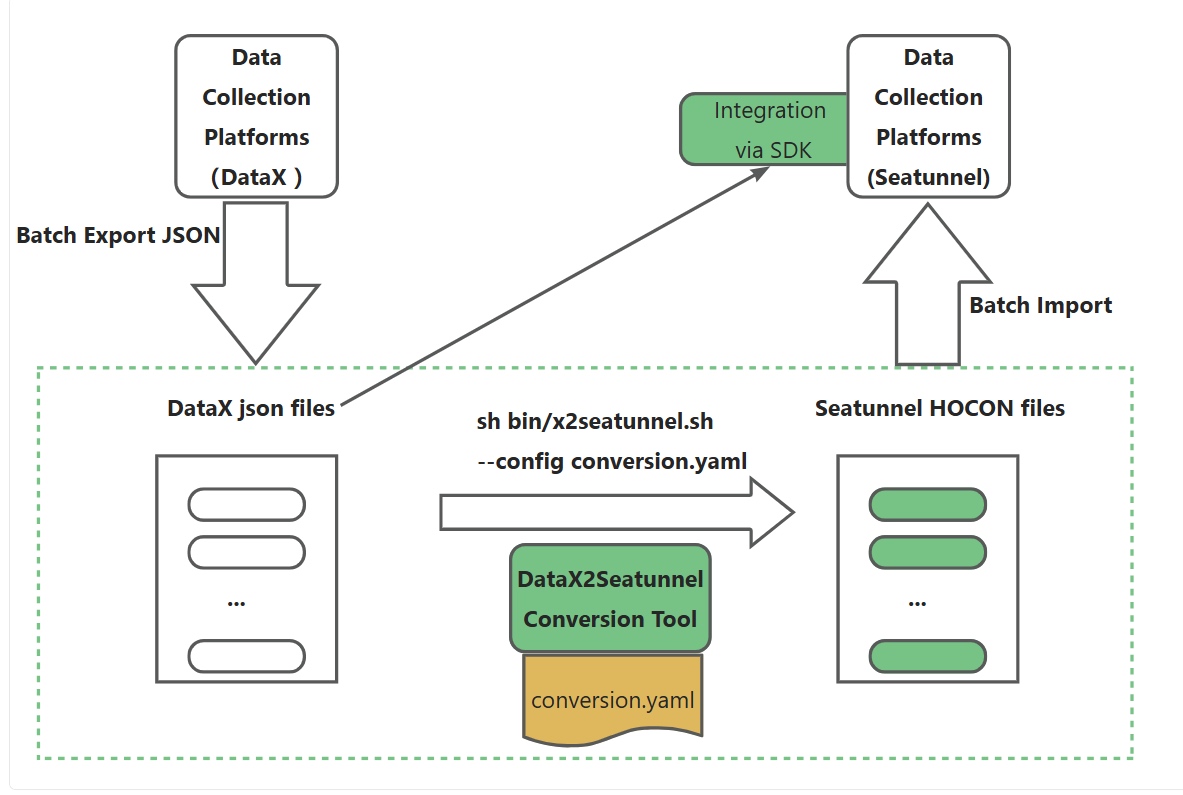
为了帮助用户更顺利地迁移到 Apache SeaTunnel 平台,社区成员提出了一个实用建议:开发一个通用的配置转换工具,支持将多种数据集成工具的配置文件转换为 SeaTunnel 支持的 HOCON 或 JSON 格式。这样,用户在迁移过程中将更加省心高效。 目前,该工具的设计方案已在 GitHub 上发布,并正式进入 SeaTunnel Roadmap。开发工作也已启动。 这个想法是否正好戳中你的需求?如果你也感兴趣,欢迎加入共建,一起打磨这个实用功能! GitHub 链接:https://github.com/apache/seatunnel/issues/9507 背景概述 X2SeaTunnel 是一个通用配置转换工具,用于将多种数据集成工具(如 DataX、Sqoop 等)的配置文件转换为 SeaTunnel 的 HOCON 或 JSON 配置文件,帮助用户平滑迁移到 SeaTunnel 平台。 设计思路 核心理念 简单轻量:保持工具轻量高效,专注于配置文件格式转换 统一框架:构建一个通用框架,支持多种数据集成工具的配置转换 可扩展性:采用插件式设计,便于后续扩展支持更多工具 易用性:提供多种使用方式,提供SDK,提供命令行方式,支持单脚本和批量,满足不同场景需求 转换流程 源工具配置(DataX json) → 解析 → 统一模型 → 映射转换 → 生成 SeaTunnel 配置 使用方式 简单命令行方式 # 基本用法 sh bin/x2seatunnel.sh -t datax -i /path/to/config.json -o /path/to/output.conf # 指定工具类型、输入输出和格式 sh bin/x2seatunnel.sh -t datax -i input.json -o output.conf -f hocon # 批量转换 sh bin/x2seatunnel.sh -t datax -d /input/dir/ -o /output/dir/ Yaml命令行方式 # 使用YAML配置文件 sh bin/x2seatunnel.sh --config conversion.yaml YAML配置文件示例 # X2SeaTunnel配置文件 metadata: # 配置文件格式版本 configVersion: "1.0" # 描述(可选) description: "DataX到SeaTunnel转换配置" # 工具配置 tool: # 源工具类型:datax, sqoop等 sourceType: "datax" sourceVersion: "2.1.2" # 目标SeaTunnel版本 targetVersion: "2.3.11" # 输入配置 input: # 源配置路径(文件或目录) path: "/path/to/configs" # 是否递归处理子目录 recursive: true # 文件匹配模式 pattern: "*.json" # 输出配置 output: # 输出路径 path: "/path/to/output" # 输出格式:hocon或json format: "hocon" # 文件名转换规则 namePattern: "${filename}_seatunnel.conf" # 映射配置 mapping: # 自定义映射规则路径(可选) rulesPath: "/path/to/custom/rules.json" # 验证配置 validation: # 是否启用验证 enabled: true # 验证失败行为:warn, error, ignore # 日志配置 logging: # 日志级别:debug, info, warn, error level: "info" # 日志输出路径 path: "./logs" # 日志文件名模式 filePattern: "x2seatunnel-%d{yyyy-MM-dd}.log" # 是否同时输出到控制台 console: true SDK方式集成 // 创建特定工具转换器 X2SeaTunnelConverter converter = X2SeaTunnelFactory.createConverter("datax"); // 配置转换选项 ConversionOptions options = new ConversionOptions.Builder() .outputFormat("hocon") .targetVersion("2.3.11") .build(); // 执行转换 String seatunnelConfig = converter.convert(sourceConfigContent, options); 实施路线图 第一阶段:基础框架及DataX支持,Mysql数据源可使用 核心接口设计 DataX常用连接器支持(MySQL, Hive) 基本命令行工具 批量处理功能 实现单元测试与e2e测试 总结基于AI实现不同连接器的prompt。 第二阶段:完善DataX更多数据源支持 扩展DataX连接器支持(PostgreSQL,ES, Kafka等) 版本适配功能 第三阶段:扩展其他工具支持与持续优化 Sqoop支持实现 更多高级功能 实现思路 采用“配置驱动、取用逻辑的设计”,可以减少代码量,降低扩展难度,适合迁移转换场景。因为: 目标系统Seatunnel的配置规范是确定的 需要确保迁移后配置的完整性和正确性 需要识别哪些原有配置无法迁移,不追求完美,需要人工处理 具体选型依据见后文。 如上图,整体逻辑包含如下几步: 脚本调用与工具触发 执行 sh bin/x2seatunnel.sh --config conversion.yaml ,调用 X2Seatunnel jar包工具,依托 conversion.yaml 配置(可选)或命令行参数,启动数据转换工具流程 。 Jar 包核心初始化 Jar 包运行时,根据 DataX(或sqoop等)的配置文件,以及相关参数,推断待转换的 SeaTunnel Connector 类型,明确转换适配的组件方向,为后续字段匹配、文件转换奠定基础。 规则匹配与字段填充阶段 遍历 Connector,借助映射规则库,从 DataX 的 json 文件中提取并填充对应字段值,同时输出字段、Connector 的匹配情况,明确转换过程中各元素的适配状态。 转换输出阶段 4.1 配置文件转换 将 Connector 对象转化为 SeaTunnel 适用的 HOCON/JSON 文件,输出到指定目录; 4.2 输出转换报告 生成转换报告(convert report),记录转换详情与匹配结果;供人工检查和确认,保障转换质量。 规则迭代阶段 基于实际转换场景,可持续完善映射规则库,覆盖更多数据转换需求,优化 X2Seatunnel 工具的适配能力,让流程在多样场景下更精准、高效。 待规则引擎逐步迭代稳定后,后续新增转换规则,只需要修改映射规则库,即可快速添加新类型数据源的转换。 通过总结的prompt,可以利用AI大模型,快速生成映射规则。 整个流程通过规则驱动、人工校验,助力数据同步任务向 SeaTunnel 迁移,支撑工具功能落地与迭代 。 三种实现思路探讨 X2Seatunnel的实现方式有很多种,主要有以下三种实现方式: 对象映射路线:强类型,通过对象模型转换,编码为主 声明映射逻辑(推送式):遍历源配置,映射到目标,配置为主 取用逻辑(拉取式):遍历目标需求,从源获取,模板为主 下面用一个表格来说明不同实现思路的特点: 各实现思路本质区别 对象映射路线:强类型,通过对象模型转换,编码为主 DataXConfig dataX = JsonUtils.parse(jsonStr, DataXConfig.class); SeaTunnelConfig st = converter.convert(dataX); String stJson = JsonUtils.toString(st); 声明映射逻辑(推送式):遍历源配置,映射到目标,配置为主 // 遍历源配置中的每个字段 for (String srcPath : mappingRules.keySet()) { String targetPath = mappingRules.get(srcPath); Object value = JsonPath.read(sourceJson, srcPath); JsonPath.set(targetJson, targetPath, value); } 取用逻辑(拉取式):遍历目标需求,从源获取,模板为主 // 遍历目标模板中需要的每个字段 for (TemplateField field : targetTemplate.getFields()) { String sourcePath = field.getSourcePath(); Object value = sourcePath != null ? JsonPath.read(sourceJson, sourcePath) : field.getDefault(); targetJson.put(field.getName(), value); } 推送式与拉取式的本质区别 这两种方式看似相似(都用映射引擎),但方向完全相反: 推送式:从源出发,"我有什么给你什么",可能遗漏目标字段 拉取式:从目标出发,"我需要什么从你那拿什么",确保目标完整 最佳实践建议 根据分析,混合方案最为合适,结合三种思路的优点: 以拉取式映射为核心:确保目标配置的完整性 # 模板驱动的映射配置 seatunnel_mysql_source: required_fields: url: source_path: "job.content[0].reader.parameter.connection[0].jdbcUrl[0]" 复杂转换用对象处理:处理需要编程逻辑的转换 这个到时候具体看,我觉得基于简单的字符串拼接规则应该就ok了。 配置驱动扩展:新增工具支持主要通过配置文件 实现思路结论 推荐采用以 "拉取式映射"为核心,辅以少量对象映射处理复杂逻辑的混合方案。这种方式既确保了目标配置的完整性,又保持了良好的扩展性和维护性,同时能够应对复杂的转换场景。 总结 X2SeaTunnel工具采用统一框架设计,支持多种数据集成工具配置向SeaTunnel的转换。通过插件式架构,既保证了工具的轻量高效,又提供了良好的扩展性。该工具通过降低迁移成本,帮助用户平滑迁移到SeaTunnel平台,提高数据集成效率。 工具同时提供命令行和SDK两种使用方式,满足不同场景需求。核心设计着重于配置映射的准确性和通用性,确保生成的SeaTunnel配置可直接使用。整体架构支持未来扩展更多数据集成工具的转换能力。

优秀的个人博客,低调大师

AWK 加入 Unicode 支持,由 80 岁的原作者贡献

AWK 是用于处理文本的编程语言工具,也是 UNIX 操作系统的核心组件之一,任何 POSIX 兼容操作系统被认为都应该包含 AWK。其名字来自于三名原作者 Alfred Aho、Peter Weinberger 和 Brian Kernighan 姓的首字母缩写。 AWK 提供了极其强大的功能:可以进行正则表达式的匹配、样式装入、流控制、数学运算符、进程控制语句,甚至于内置的变量和函数。它具备了一个完整的语言所应具有的几乎所有精美特性。实际上 AWK 的确拥有自己的语言:AWK 程序设计语言,三位创建者已将它正式定义为“样式扫描和处理语言”。它允许创建简短的程序,这些程序读取输入文件、为数据排序、处理数据、对输入执行计算以及生成报表,还有无数其他的功能。gawk 是 AWK 的 GNU 版本。 Brian Kernighan 最近在接受采访时透露,他在几个月前为 AWK 添加了对 Unicode 的支持。不过由于他对 Git 不熟悉,所以尚未向 AWK 的代码仓库提交 commit。Brian Kernighan 在邮件中表示,几个月前,他在学习使用 Git,尝试通过提交 PR 来更好地理解 Git。在弄清楚这些之后,他正式提交 PR 为 AWK 添加对 Unicode 的支持。 除了 AWK,相信 Kernighan 教授命名的「Unix」和发明的 "Hello, world" 语言演示更广为人知。

优秀的个人博客,低调大师

Ceph v17.2.0 Quincy 发布,中国开发者贡献凸显

Ceph v17.2.0 Quincy 现已发布。Quincy是 Ceph 的第 17 个稳定版本,它以海绵宝宝的章鱼Quincy触手命名,这是 Ceph Quincy 的第一个稳定版本。 相比于 Pacific 版本的大变化有: FileStore在 Quincy 中已被弃用。BlueStore 成为 Ceph 的默认存储引擎。 ceph-mgr-modules-coredebian 软件包不再ceph-mgr-rook推荐.ceph-mgr-rook依赖于,当版本早于 1.19python3-numpy时,不能在不同的 Python 子解释器中多次导入。python3-numpy因为默认apt-get安装软件包,所以总是与debian 软件包一起作为间接依赖安装。如果您的工作流程取决于此行为,您可能需要单独安装。Recommendsceph-mgr-rookceph-mgrceph-mgr-rook device_health_metrics池已重命名.mgr。它现在用作所有ceph-mgr模块的公共存储。升级到 Quincy 后,该device_health_metrics池将.mgr在现有集群上重命名。 该ceph pg dump命令现在打印三个附加列:LAST_SCRUB_DURATION显示最后完成的擦洗的持续时间(以秒为单位);SCRUB_SCHEDULING传达一个 PG 是否被安排在指定时间被擦洗,它是否排队等待擦洗,或者它是否正在被擦洗;OBJECTS_SCRUBBED显示擦洗开始后在 PG 中擦洗的对象数量。 require-osd-release如果在集群升级后未将标志设置为适当的版本,现在会报告运行状况警告。 LevelDB 支持已被删除。WITH_LEVELDB不再是受支持的构建选项。用户 - 应该 - 在升级到 Quincy 之前将他们的监视器和 OSD 迁移到 RocksDB。 Cephadm:osd_memory_target_autotune默认启用,设置mgr/cephadm/autotune_memory_target_ratio为0.7总 RAM。这不适合超融合基础架构。对于超融合 Ceph,请参考文档或设置mgr/cephadm/autotune_memory_target_ratio为0.2. 遥测:改进了选择加入流程,以便用户可以继续共享相同的数据,即使有新的数据收集可用。现在可以选择使用一个新的“性能”频道来收集各种性能指标:ceph telemetry onceph telemetry enable channel perf查看带有 的示例报告ceph telemetry preview。请注意,在大型集群中使用“perf”通道数据生成遥测报告可能需要一些时间。有关更多详细信息,请参阅:https ://docs.ceph.com/en/quincy/mgr/telemetry/ MGR:progress 模块默认禁用 pg 恢复事件,因为该事件代价高昂,并且当有 OSD 被标记为从集群中进入/退出时会中断其他服务。但是,用户仍然可以随时启用此事件。有关更多详细信息,请参阅https://docs.ceph.com/en/quincy/mgr/progress/ https://tracker.ceph.com/issues/55383是一个已知问题。mon_cluster_log_to_journald当设置为 true 时需要设置为 falsemon_cluster_log_to_file以在日志轮换后继续将集群日志消息记录到文件中。 Cephadm SNMP 支持 守护进程托管 (mgr, mds, rgw) osd内存自动调整 与新的 NFS 管理模块集成 能够在 osd 被删除时对其进行删除 用于提高性能/可扩展性的 cephadm 代理 Dashboard 第 1 天:新的“集群扩展向导”将引导用户完成安装后的步骤:添加新主机、存储设备或服务。 NFS:仪表板现在允许用户从一个地方完全管理所有 NFS 导出。 新的 mgr 模块(反馈):用户可以直接从 Dashboard 或 CLI 快速报告 Ceph 跟踪器问题或建议。 新的“每日消息”:集群管理员可以在横幅中发布自定义消息。 Cephadm 集成改进: ​​​​​​​主机管理:维护、规格和标签, 服务管理:编辑和显示日志, 守护进程管理(启动、停止、重启、重新加载), 支持的新服务:入口(HAProxy)和 SNMP 网关。 监控和警报: ​​​​​​​添加了 43 个新警报(总共 68 个),提高了对影响以下事件的可观察性:集群运行状况、监视器、存储设备、PG 和 CephFS。 现在可以通过新的 SNMP 网关服务(提供 MIB)将警报作为 SNMP 陷阱发送到外部。 改进的集成完整/接近完整事件通知。 Grafana 仪表板现在使用 grafonnet 格式(尽管它们仍以 JSON 格式提供)。 堆栈更新:用于监控容器的图像已更新。Grafana 8.3.5、Prometheus 2.33.4、Alertmanager 0.23.0 和 Node Exporter 1.3.1。这减少了对多个 Grafana 漏洞(CVE-2021-43798、CVE-2021-39226、CVE-2021-43798、CVE-2020-29510、CVE-2020-29511)的暴露。 RADOS OSD:Ceph 现在mclock_scheduler默认使用 BlueStore OSDosd_op_queue来提供 QoS。Filestore OSD 不支持“mclock_scheduler”。因此,默认的 'osd_op_queue' 设置为wpq用于 Filestore OSD,即使用户尝试更改它也会强制执行。有关配置 mclock 的更多详细信息,请参阅, https://docs.ceph.com/en/quincy/rados/configuration/mclock-config-ref/ 运行时存在一个突出问题,在使用命令切换到custommclock 配置文件后,无法修改与预留、重量和限制相关的 mclock 配置选项。ceph config set ...这由https://tracker.ceph.com/issues/55153跟踪。在问题得到解决之前,建议用户避免使用“自定义”配置文件或使用跟踪器中提到的解决方法。 MGR:pg_autoscaler 现在可以使用标志在全局范围内on转动。默认情况下,它设置为,但此标志可以派上用场,以防止在集群升级和维护期间由自动缩放触发重新平衡。现在可以使用该标志创建池,这允许自动缩放器将更多 PG 分配给此类池。这对于为数据密集型池获得更好的开箱即用性能很有用。offnoautoscaleon--bulk 有关自动缩放的更多详细信息,请参阅:https ://docs.ceph.com/en/quincy/rados/operations/placement-groups/ offOSD:默认支持 osd-osd 通信的在线压缩。 有关压缩模式的更多详细信息,请参阅:https ://docs.ceph.com/en/quincy/rados/configuration/msgr2/#compression-modes OSD:集群日志中慢速操作的简明报告。可以通过设置osd_aggregated_slow_ops_logging为 false 来恢复旧的和更详细的日志记录行为。 “kvs” Ceph 对象类不再打包。“kvs” Ceph 对象类提供了在 librados 对象 omap 之上实现的分布式平面 b 树键值存储。由于该对象类没有现有的内部用户,因此不再对其进行打包。 RBD block storage rbd-nbd:rbd device attach和rbd device detach添加的命令,这些允许在rbd-nbd守护进程自 Linux 内核 5.14 以来重新启动后安全重新连接。 rbd-nbd:notrim添加了映射选项以支持厚配置映像,类似于 krbd。 SSD 设备上客户端持久缓存的大量稳定工作,也可在 16.2.8 中使用。有关使用的详细信息,请参阅https://docs.ceph.com/en/quincy/rbd/rbd-persistent-write-log-cache/ 使用快速差异图像特征 + 整个对象(不精确)模式时,差异计算中的几个错误修复。在极少数情况下,这些长期存在的问题可能会导致不正确的rbd export. 也在 15.2.16 和 16.2.8 中修复。 修复了在 krbd 上运行 Windows VM 时潜在的性能下降问题。详情见rxbounce地图选项说明:https ://docs.ceph.com/en/quincy/man/8/rbd/#kernel-rbd-krbd-options RGW object storage RGW 现在支持按用户和/或按桶进行速率限制。使用此功能,可以限制用户和/或存储桶,可以交付总操作数和/或每分钟字节数。此功能允许管理员仅限制 READ 操作和/或 WRITE 操作。通过使用全局配置,可以将限速配置应用于所有用户和所有存储桶。 radosgw-admin realm delete已重命名为radosgw-admin realm rm. 这与帮助信息一致。 S3 存储桶通知事件现在包含一个eTag键而不是etag,并且 eventName 值不再带有s3:前缀,从而修复了与在 AWS 上观察到的消息格式的偏差。 现在可以为野兽前端指定 ssl 选项和密码。默认 ssl 选项设置为“no_sslv2:no_sslv3:no_tlsv1:no_tlsv1_1”。如果要返回旧行为,请将 'ssl_options='(空)添加到rgw frontends配置中。 分段上传的行为已修改,以便在分段上传结束时仅发送 CompleteMultipartUpload 通知。上传开始时的 POST 通知和每个部分上发送的 PUT 通知不再发送。 CephFS distributed file system fs:可以使用特定 ID(“fscid”)创建文件系统。这在某些恢复方案中很有用(例如,当监视器数据库丢失并重新构建时,并且恢复的文件系统预计具有与以前相同的 ID)。 fs:可以使用该fs rename命令重命名文件系统。任何为旧文件系统名称授权的 cephx 凭据都需要重新授权为新文件系统名称。由于使用这些重新授权的 ID 的客户端的操作可能会中断,因此该命令需要“--yes-i-really-mean-it”标志。此外,预计将在文件系统上禁用镜像。 MDS 升级不再需要在升级文件系统的唯一活动 MDS 之前停止所有备用 MDS 守护程序。 CephFS:如果备用重放守护进程重放日志失败,现在会导致等级被标记为“损坏”。 详情可查看官方公告。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册