首页 文章 精选 留言 我的

精选列表

搜索[库存盘点],共7325篇文章
优秀的个人博客,低调大师

Xiuno BBS 审计之问题05:数据库存在宽字节注入与转义绕过

# 问题:DB 抽象层使用 addslashes 转义而非 PDO 预处理,存在宽字节注入与转义绕过 此文章为XIUNOX版本重构审计时发现问题,分享出来方便后续想基于xiuno bbs4.0.4版本制作维护版本或插件模板等需求的开发者和站长参考。 ## 现象 Xiuno BBS 4.0.4 的数据库抽象层在拼接 SQL 时统一使用 PHP 内置 `addslashes()` 对字符串值进行转义,并未使用 PDO 预编译语句(prepare + bind)。该转义方式存在以下风险: 1. 当 MySQL 连接字符集为 GBK/GB2312/BIG5 等多字节字符集时,攻击者可构造 `%bf%27` 形式的宽字节序列,使 `addslashes` 添加的反斜杠被前一个字节“吞掉”,从而绕过转义形成 SQL 注入。 1. `addslashes` 与 `mysql_real_escape_string` 行为不一致,对部分特殊字符(如 `\x00`、`\n`、`\r`、`\x1a`)处理不当,存在边缘绕过场景。 1. `db_mysql.class.php` 使用 PHP 7.0 已移除的 `mysql_*` 扩展,无法设置连接字符集到 `mysql_set_charset`,只能用 `SET NAMES`,导致 addslashes 与 server 端字符集认知不一致,是宽字节注入的典型温床。 ## 源码证据 文件:`xiunobbs_4.0.4/xiunophp/db.func.php` 行 242-279(db_cond_to_sqladd 使用 addslashes) ``` function db_cond_to_sqladd($cond) { $s = ''; if(!empty($cond)) { $s = ' WHERE '; foreach($cond as $k=>$v) { if(!is_array($v)) { $v = (is_int($v) || is_float($v)) ? $v : "'".addslashes($v)."'"; $s .= "`$k`=$v AND "; } elseif(isset($v[0])) { // OR 效率比 IN 高 $s .= '('; foreach ($v as $v1) { $v1 = (is_int($v1) || is_float($v1)) ? $v1 : "'".addslashes($v1)."'"; $s .= "`$k`=$v1 OR "; } // ... } else { foreach($v as $k1=>$v1) { if($k1 == 'LIKE') { $k1 = ' LIKE '; $v1="%$v1%"; } $v1 = (is_int($v1) || is_float($v1)) ? $v1 : "'".addslashes($v1)."'"; $s .= "`$k`$k1$v1 AND "; } } } } return $s; } ``` 文件:`xiunobbs_4.0.4/xiunophp/db.func.php` 行 303-342(insert/update 拼 SQL 也用 addslashes) ``` function db_array_to_update_sqladd($arr) { $s = ''; foreach($arr as $k=>$v) { $v = addslashes($v); // ... $v = (is_int($v) || is_float($v)) ? $v : "'$v'"; $s .= "`$k`=$v,"; } return substr($s, 0, -1); } function db_array_to_insert_sqladd($arr) { // ... foreach($arr as $k=>$v) { $k = addslashes($k); $v = addslashes($v); $keys[] = '`'.$k.'`'; $v = (is_int($v) || is_float($v)) ? $v : "'$v'"; $values[] = $v; } // ... } ``` 文件:`xiunobbs_4.0.4/xiunophp/db_mysql.class.php` 行 52-58(使用废弃 mysql_* 扩展,且 SET NAMES 设置字符集) ``` public function real_connect($host, $user, $password, $name, $charset = '', $engine = '') { $link = @mysql_connect($host, $user, $password); if(!$link) { $this->error(mysql_errno(), '连接数据库服务器失败:'.mysql_error()); return FALSE; } if(!mysql_select_db($name, $link)) { $this->error(mysql_errno(), '选择数据库失败:'.mysql_error()); return FALSE; } $charset AND $this->query("SET names $charset, sql_mode=''", $link); return $link; } ``` 文件:`xiunobbs_4.0.4/xiunophp/db_pdo_mysql.class.php` 行 114-128(虽然使用 PDO,但 query/exec 均直接拼接 SQL 字符串,未使用 prepare/execute) ``` public function query($sql) { if(!$this->rlink && !$this->connect_slave()) return FALSE; $link = $this->link = $this->rlink; try { $t1 = microtime(1); $query = $link->query($sql); // 直接 query,未 prepare $t2 = microtime(1); } catch (Exception $e) { $this->error($e->getCode(), $e->getMessage()); return FALSE; } // ... } public function exec($sql) { // ... $n = $link->exec($sql); // 直接 exec,未 prepare // ... } ``` ## 风险等级与结论 **高危** 危害后果: - 在 GBK/GB2312 等多字节字符集环境下,攻击者可通过宽字节注入绕过转义,对任意 SQL 语句进行注入,导致拖库、写马、提权、绕过登录。 - `addslashes` 转义不如 `mysql_real_escape_string` 严谨,对部分字符处理存在差异,存在边缘绕过风险。 - `db_mysql.class.php` 依赖 PHP 5.x 的 `mysql_*` 扩展,在 PHP 7+ 环境下直接不可用,且无法使用 `mysql_set_charset` 同步字符集认知,进一步放大宽字节注入风险。 - 即使使用 PDO 驱动,也并未启用预处理,无法享受 PDO 参数绑定的安全优势。 修复建议: 1. 全面切换到 PDO 预编译语句 `prepare()` + `bindParam()`/`bindValue()`,禁止再使用字符串拼接 + `addslashes`。 1. 在连接时通过 `PDO::ATTR_EMULATE_PREPARES => false` 关闭模拟预处理,确保语句真正由 server 端编译。 1. 强制使用 `utf8` 或 `utf8mb4` 字符集,并通过 `mysql_set_charset`/`PDO::query("SET NAMES utf8mb4")` 显式同步 client/server 字符集认知。 1. 移除 `db_mysql.class.php` 中 `mysql_*` 扩展支持,统一使用 `db_pdo_mysql.class.php`。 1. 对所有进入 SQL 的字段做白名单校验(如表名、列名),数值做 intval 强转。

优秀的个人博客,低调大师

蚂蚁金服生产级 Raft 算法库存储模块剖析 | SOFAJRaft 实现原理

摘要:本文为《剖析 | SOFAJRaft 实现原理》第一篇。本文从 Log 日志存储 LogStorage、Meta 元信息存储 RaftMetaStorage 以及 Snapshot 快照存储 SnapshotStorage 三个方面详述 SOFAJRaft 存储模块实现细节,直观刻画 SOFAJRaft Server 节点 Node 之间存储日志、Raft 配置和镜像流程。 SOFAStack ScalableOpenFinancialArchitecture Stack 是蚂蚁金服自主研发的金融级分布式架构,包含了构建金融级云原生架构所需的各个组件,是在金融场景里锤炼出来的最佳实践。 SOFAJRaft是一个基于Raft一致性算法的生产级高性能Java实现,支持MULTI-RAFT-GROUP,适用于高负载低延迟的场景。 本文为《剖析 | SOFAJRaft 实现原理》第一篇,本篇作者米麒麟,来自陆金所。《剖析 | SOFAJRaft 实现原理》系列由 SOFA 团队和源码爱好者们出品,项目代号:,文章尾部有参与方式,欢迎同样对源码热情的你加入。 SOFAJRaft:https://github.com/alipay/sofa-jraft 前言 SOFAJRaft是一个基于Raft一致性算法的生产级高性能Java实现,支持MULTI-RAFT-GROUP,适用于高负载低延迟的场景。 SOFAJRaft存储模块分为: Log存储记录Raft配置变更和用户提交任务日志; Meta存储即元信息存储记录Raft实现的内部状态; Snapshot存储用于存放用户的状态机Snapshot及元信息。 本文将围绕日志存储,元信息存储以及快照存储等方面剖析SOFAJRaft存储模块原理,阐述如何解决Raft协议存储问题以及存储模块实现: Raft配置变更和用户提交任务日志如何存储?如何调用管理日志存储? SOFAJRaft Server节点Node是如何存储Raft内部配置? Raft状态机快照Snapshot机制如何实现?如何存储安装镜像? 日志存储 Log存储,记录Raft配置变更和用户提交任务的日志,把日志从Leader复制到其他节点上面。 LogStorage是日志存储实现,默认实现基于RocksDB存储,通过LogStorage接口扩展自定义日志存储实现; LogManager负责调用底层日志存储LogStorage,针对日志存储调用进行缓存、批量提交、必要的检查和优化。 LogStorage存储实现 LogStorage日志存储实现,定义Raft分组节点Node的Log存储模块核心API接口包括: 返回日志里的首/末个日志索引; 按照日志索引获取Log Entry及其任期; 把单个/批量Log Entry添加到日志存储; 从Log存储头部/末尾删除日志; 删除所有现有日志,重置下任日志索引。 Log Index提交到Raft Group中的任务序列化为日志存储,每条日志一个编号,在整个Raft Group内单调递增并复制到每个Raft节点。LogStorage日志存储实现接口定义入口: com.alipay.sofa.jraft.storage.LogStorage RocksDBLogStorage基于RocksDB实现 Log Structured Merge Tree简称LSM ,把一颗大树拆分成N棵小树,数据首先写入内存,内存里构建一颗有序小树,随着小树越来越大,内存的小树Flush到磁盘,磁盘中的树定期做合并操作合并成一棵大树以优化读性能,通过把磁盘的随机写转化为顺序写提高写性能,RocksDB就是基于LSM-Tree数据结构使用C++ 编写的嵌入式KV存储引擎,其键值均允许使用二进制流。RocksDB按顺序组织所有数据,通用操作包括get(key),put(key),delete(Key)以及newIterator()。RocksDB有三种基本的数据结构:memtable,sstfile以及logfile。memtable是一种内存数据结构--所有写入请求都会进入memtable,然后选择性进入logfile。logfile是一种有序写存储结构,当memtable被填满的时候被刷到sstfile文件并存储起来,然后相关的logfile在之后被安全地删除。sstfile内的数据都是排序好的,以便于根据key快速搜索。 LogStorage默认实现RocksDBLogStorage是基于RocksDB存储日志,初始化日志存储StorageFactory根据Raft节点日志存储路径和Raft内部实现是否调用fsync配置默认创建RocksDBLogStorage日志存储。基于RocksDB存储实现RocksDBLogStorage核心操作包括: init():创建RocksDB配置选项调用RocksDB#open()方法构建RocksDB实例,添加default默认列族及其配置选项获取列族处理器,通过newIterator()生成RocksDB迭代器遍历KeyValue数据检查Value类型加载Raft配置变更到配置管理器ConfigurationManager。RocksDB引入列族 ColumnFamily 概念,所谓列族是指一系列 KeyValue 组成的数据集,RocksDB读写操作需要指定列族,创建RocksDB默认构建命名为default的列族。 shutdown():首先关闭列族处理器以及RocksDB实例,其次遍历列族配置选项执行关闭操作,接着关闭RocksDB配置选项,最后清除强引用以达到Help GC垃圾回收RocksDB实例及其配置选项对象。 getFirstLogIndex():基于处理器defaultHandle和读选项totalOrderReadOptions方法构建 RocksDB迭代器RocksIterator,检查是否加载过日志里第一个日志索引,未加载需调用seekToFirst()方法获取缓存 RocksDB 存储日志数据的第一个日志索引。 getLastLogIndex():基于处理器defaultHandle和读选项totalOrderReadOptions构建RocksDB迭代器RocksIterator,调用seekToLast()方法返回RocksDB存储日志记录的最后一个日志索引。 getEntry(index):基于处理器defaultHandle和指定日志索引调用RocksDB#get()操作返回RocksDB索引位置日志LogEntry。 getTerm(index):基于处理器defaultHandle和指定日志索引调用RocksDB#get()操作获取RocksDB索引位置日志并且返回其LogEntry的任期。 appendEntry(entry):检查日志LogEntry类型是否为配置变更,配置变更类型调用RocksDB#write()方法执行批量写入,用户提交任务的日志基于处理器defaultHandle和LogEntry对象调用RocksDB#put()方法存储。 appendEntries(entries):调用RocksDB#write()方法把Raft配置变更或者用户提交任务的日志同步刷盘批量写入RocksDB存储,通过Batch Write手段合并IO写入请求减少方法调用和上下文切换。 truncatePrefix(firstIndexKept):获取第一个日志索引,后台启动一个线程基于默认处理器defaultHandle和配置处理器confHandle执行RocksDB#deleteRange()操作删除从Log头部以第一个日志索引到指定索引位置范围的RocksDB日志数据。 truncateSuffix(lastIndexKept):获取最后一个日志索引,基于默认处理器defaultHandle和配置处理器confHandle执行RocksDB#deleteRange()操作清理从Log末尾以指定索引位置到最后一个索引范畴的RocksDB未提交日志。 reset(nextLogIndex):获取nextLogIndex索引对应的LogEntry,执行RocksDB#close()方法关闭RocksDB实例,调用RocksDB#destroyDB()操作销毁RocksDB实例清理RocksDB所有数据,重新初始化加载RocksDB实例并且重置下一个日志索引位置。 RocksDBLogStorage基于RocksDB存储日志实现核心入口: com.alipay.sofa.jraft.storage.RocksDBLogStorage LogManager存储调用 日志管理器LogManager负责调用Log日志存储LogStorage,对LogStorage调用进行缓存管理、批量提交、检查优化。Raft分组节点Node初始化/启动时初始化日志存储StorageFactory构建日志管理器LogManager,基于日志存储LogStorage、配置管理器ConfigurationManager、有限状态机调用者FSMCaller、节点性能监控NodeMetrics等LogManagerOptions配置选项实例化LogManager。根据Raft节点Disruptor Buffer大小配置生成稳定状态回调StableClosure事件Disruptor队列,设置稳定状态回调StableClosure事件处理器StableClosureEventHandler处理队列事件,其中StableClosureEventHandler处理器事件触发的时候判断任务回调StableClosure的Log Entries是否为空,如果任务回调的Log Entries为非空需积攒日志条目批量Flush,空则检查StableClosureEvent事件类型并且调用底层存储LogStorage#appendEntries(entries)批量提交日志写入RocksDB,当事件类型为SHUTDOWN、RESET、TRUNCATE_PREFIX、TRUNCATE_SUFFIX、LAST_LOG_ID时调用底层日志存储LogStorage进行指定事件回调ResetClosure、TruncatePrefixClosure、TruncateSuffixClosure、LastLogIdClosure处理。 当Client向SOFAJRaft发送命令之后,Raft分组节点Node的日志管理器LogManager首先将命令以 Log 的形式存储到本地,调用appendEntries(entries,done)方法检查Node节点当前为Leader并且Entries来源于用户未知分配到的正确日志索引时需要分配索引给添加的日志Entries,而当前为Follower时并且Entries来源于Leader必须检查以及解决本地日志和Entries之间的冲突。接着遍历日志条目Log Entries检查类型是否为配置变更,配置管理器ConfigurationManager缓存配置变更Entry,将现有日志条目Entries添加到logsInMemory进行缓存,稳定状态回调StableClosure设置需要存储的日志,发布OTHER类型事件到稳定状态回调StableClosure事件队列,触发稳定状态回调StableClosure事件处理器StableClosureEventHandler处理该事件,处理器获取任务回调的Log Entries把日志条目积累到内存中以便后续统一批量Flush,通过appendToStorage(toAppend)操作调用底层LogStorage存储日志Entries。同时Replicator把此条Log复制给其他的Node实现并发的日志复制,当Node接收集群中半数以上的Node返回的“复制成功”的响应将这条Log以及之前的Log有序的发送至状态机里面执行。 LogManager调用日志存储LogStorage实现逻辑: 元信息存储 Metadata存储即元信息存储,用来存储记录Raft实现的内部状态,譬如当前任期Term、投票给哪个PeerId节点等信息。 RaftMetaStorage存储实现 RaftMetaStorage元信息存储实现,定义Raft元数据的Metadata存储模块核心API接口包括: 设置/获取Raft元数据的当前任期Term; 分配/查询Raft元信息的PeerId节点投票。 Raft内部状态任期Term是在整个Raft Group里单调递增的long数字,用来表示一轮投票的编号,其中成功选举出来的Leader对应的Term称为Leader Term,Leader没有发生变更期间提交的日志都有相同的Term编号。PeerId表示Raft协议的参与者(Leader/Follower/Candidateetc.), 由三元素组成:ip:port:index,其中ip是节点的IP,port是端口,index表示同一个端口的序列号。RaftMetaStorage元信息存储实现接口定义入口: com.alipay.sofa.jraft.storage.RaftMetaStorage LocalRaftMetaStorage基于ProtoBuf实现 Protocol Buffers是一种轻便高效的结构化数据存储格式,用于结构化数据串行化或者说序列化,适合做数据存储或RPC数据交换格式,用于通讯协议、数据存储等领域的语言无关、平台无关、可扩展的序列化结构数据格式。用户在.proto文件定义Protocol Buffer的Message类型指定需要序列化的数据结构,每一个Message都是一个小的信息逻辑单元包含一系列的键值对,每种类型的Message涵盖一个或者多个唯一编码字段,每个字段由名称和值类型组成,允许Message定义可选字段Optional Fields、必须字段Required Fields、可重复字段Repeated Fields。 RaftMetaStorage默认实现LocalRaftMetaStorage是基于ProtoBufMessage本地存储Raft元数据,初始化元信息存储StorageFactory根据Raft元信息存储路径、Raft内部配置以及Node节点监控默认创建LocalRaftMetaStorage元信息存储。基于ProtoBuf存储实现LocalRaftMetaStorage主要操作包括: init():获取Raft元信息存储配置RaftMetaStorageOptions节点Node,读取命名为raft_meta的ProtoBufFile文件加载StablePBMeta消息,根据StablePBMetaProtoBuf元数据缓存Raft当前任期Term和PeerId节点投票信息。 shutdown():获取内存里Raft当前任期Term和PeerId节点投票构建StablePBMeta消息,按照Raft内部是否同步元数据配置写入ProtoBufFile文件。 setTerm(term):检查LocalRaftMetaStorage初始化状态,缓存设置的当前任期Term,按照Raft是否同步元数据配置把当前任期Term作为ProtoBuf消息保存到ProtoBufFile文件。 getTerm():检查LocalRaftMetaStorage初始化状态,返回缓存的当前任期Term。 setVotedFor(peerId):检查LocalRaftMetaStorage初始化状态,缓存投票的PeerId节点,按照Raft是否同步元数据配置把投票PeerId节点作为ProtoBuf消息保存到ProtoBufFile文件。 getVotedFor():检查LocalRaftMetaStorage初始化状态,返回缓存的投票PeerId节点。 LocalRaftMetaStorage基于ProtoBuf本地存储Raft元信息实现入口: com.alipay.sofa.jraft.storage.impl.LocalRaftMetaStorage 快照存储 当Raft节点Node重启时,内存中状态机的状态数据丢失,触发启动过程重新存放日志存储LogStorage的所有日志重建整个状态机实例,此种场景会导致两个问题: 如果任务提交比较频繁,例如消息中间件场景导致整个重建过程很长启动缓慢; 如果日志非常多并且节点需要存储所有的日志,对存储来说是资源占用不可持续; 如果增加Node节点,新节点需要从Leader获取所有的日志重新存放至状态机,对于Leader和网络带宽都是不小的负担。 因此通过引入Snapshot机制来解决此三个问题,所谓快照Snapshot即对数据当前值的记录,是为当前状态机的最新状态构建"镜像"单独保存,保存成功删除此时刻之前的日志减少日志存储占用;启动的时候直接加载最新的Snapshot镜像,然后重放在此之后的日志即可,如果Snapshot间隔合理,整个重放到状态机过程较快,加速启动过程。最后新节点的加入先从Leader拷贝最新的Snapshot安装到本地状态机,然后只要拷贝后续的日志即可,能够快速跟上整个Raft Group的进度。Leader生成快照有几个作用: 当有新的节点Node加入集群不用只靠日志复制、回放机制和Leader保持数据一致,通过安装Leader的快照方式跳过早期大量日志的回放; Leader用快照替代Log复制减少网络端的数据量; 用快照替代早期的Log节省存储占用空间。 Snapshot存储,用于存储用户的状态机Snapshot及元信息: SnapshotStorage用于Snapshot存储实现; SnapshotExecutor用于管理Snapshot存储、远程安装、复制。 SnapshotStorage存储实现 SnapshotStorage快照存储实现,定义Raft状态机的Snapshot存储模块核心API接口包括: 设置filterBeforeCopyRemote设置为true复制到远程之前过滤数据; 创建快照编写器; 打开快照阅读器; 从远程Uri复制数据; 启动从远程Uri复制数据的复制任务; 配置SnapshotThrottle,SnapshotThrottle用于重盘读/写场景限流的,比如磁盘读写、网络带宽。 LocalSnapshotStorage基于本地文件实现 SnapshotStorage默认实现LocalSnapshotStorage是基于本地文件存储Raft状态机镜像,初始化元快照存储StorageFactory根据Raft镜像快照存储路径和Raft配置信息默认创建LocalSnapshotStorage快照存储。基于本地文件存储实现LocalSnapshotStorage主要方法包括: init():删除文件命名为temp的临时镜像Snapshot,销毁文件前缀为snapshot_ 的旧快照Snapshot,获取快照最后一个索引lastSnapshotIndex。 close():按照快照最后一个索引lastSnapshotIndex和镜像编写器LocalSnapshotWriter快照索引重命名临时镜像Snapshot文件,销毁编写器LocalSnapshotWriter存储路径快照。 create():销毁文件命名为temp的临时快照Snapshot,基于临时镜像存储路径创建初始化快照编写器LocalSnapshotWriter,加载文件命名为__raft_snapshot_meta的Raft快照元数据至内存。 open():根据快照最后一个索引lastSnapshotIndex获取文件前缀为snapshot_ 快照存储路径,基于快照存储路径创建初始化快照阅读器LocalSnapshotReader,加载文件命名为__raft_snapshot_meta的Raft镜像元数据至内存。 startToCopyFrom(uri,opts):创建初始化状态机快照复制器LocalSnapshotCopier,生成远程文件复制器RemoteFileCopier,基于远程服务地址Endpoint获取Raft客户端RPC服务连接指定Uri,启动后台线程复制Snapshot镜像数据,加载Raft快照元数据获取远程快照Snapshot镜像文件,读取远程指定快照存储路径数据拷贝到BoltSession,快照复制器LocalSnapshotCopier同步Raft快照元数据。 SnapshotExecutor存储管理 快照执行器SnapshotExecutor负责Raft状态机Snapshot存储、Leader远程安装快照、复制镜像Snapshot文件,包括两大核心操作:状态机快照doSnapshot(done) 和安装快照installSnapshot(request, response, done)。StateMachine快照doSnapshot(done)获取基于临时镜像temp文件路径的Snapshot存储快照编写器LocalSnapshotWriter,加载__raft_snapshot_meta快照元数据文件初始化编写器;构建保存镜像回调SaveSnapshotDone提供FSMCaller调用StateMachine的状态转换发布SNAPSHOT_SAVE类型任务事件到Disruptor队列,通过Ring Buffer方式触发申请任务处理器ApplyTaskHandler运行快照保存任务,调用onSnapshotSave()方法存储各种类型状态机快照。远程安装快照installSnapshot(request, response, done)按照安装镜像请求响应以及快照原信息创建并且注册快照下载作业DownloadingSnapshot,加载快照下载DownloadingSnapshot获取当前快照拷贝器的阅读器SnapshotReader,构建安装镜像回调InstallSnapshotDone 分配FSMCaller调用StateMachine的状态转换发布SNAPSHOT_LOAD类型任务事件到Disruptor队列,也是通过Ring Buffer触发申请任务处理器ApplyTaskHandler执行快照安装任务,调用onSnapshotLoad()操作加载各种类型状态机快照。 SnapshotExecutor状态机快照和远程安装镜像实现逻辑: 总结 本文从Log日志存储LogStorage、Meta元信息存储RaftMetaStorage以及Snapshot快照存储SnapshotStorage三个方面详述SOFAJRaft存储模块实现细节,直观刻画SOFAJRaft Server节点Node之间存储日志、Raft配置和镜像流程。 欢迎加入,参与 SOFAJRaft 源码解析 本文为《剖析 | SOFAJRaft 实现原理》系列的第一篇, SOFAJRaft存储模块的介绍,本系列也会逐步详细介绍各个部分的代码设计和实现,预计按照如下的目录进行: SOFAJRaft 选举实现剖析 SOFAJRaft 存储模块剖析 SOFAJRaft replication-pipeline 实现剖析 SOFAJRaft batch 优化剖析 SOFAJRaft 线性一致读实现剖析 SOFAJRaft snapshot 实现剖析 SOFAJRaft-RheaKV 是如何使用 Raft 的 SOFAJRaft-RheaKV 分布式锁实现剖析 SOFAJRaft-RheaKV multi-raft-group 实现分析 原文链接​ 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

盘点 2023 十大宕机事故“冥场面”

名场面?冥场面! 速来围观 2023 十大宕机事故“冥场面”—— 哔哩哔哩(B 站)崩了两次 2023 年 3 月 5 日晚 20:20 左右,许多网友表示在使用 B 站时,手机和电脑端都无法访问视频详情页,且手机端无法查看收藏夹与历史记录。还有网友表示,首页能够正常加载,但全部是繁体字。 8 月 4 日晚间,距离上次事故 5 个月后,又有许多网友反馈 B 站图片(视频封面)无法加载、视频无法打开、视频一直在缓冲。 腾讯“3.29”一级事故 2023 年 3 月 29 日凌晨,腾讯旗下的微信和 QQ 等业务曾出现崩溃状况,包括微信语音对话、朋友圈、微信支付,以及 QQ 文件传输、QQ 空间和 QQ 邮箱在内的多个功能无法使用。 直到 29 日早间,腾讯微信团队才回应表示,经工程师抢修,系统正在逐步恢复。 本次事故由广州电信机房冷却系统故障导致,腾讯将它定义为公司一级事故,并对大量相关领导做出了处罚。 4 月 12 日,工业和信息化部信息通信管理局听取腾讯公司关于 “3・29” 微信业务异常情况汇报,要求腾讯公司进一步健全安全生产管理制度、落实网络运行保障措施,坚决避免发生重大安全生产事故,切实提升公众业务安全稳定运行水平。 唯品会 329 事故处罚结果:基础平台部负责人被免职 今年 3 月 29 日,“唯品会崩了” 登上热搜,由于崩溃时间太长,影响了很多消费者无法正常下单。唯品会官方对此回应称,因系统短时故障,主站 “加购” 等功能或出现异常。 6 月 5 日,唯品会发布 “关于 329 机房宕机故障处理的公告”。公告称,3 月 29 日(00:14-12:01)南沙 IDC 冷冻系统故障,导致机房设备温度快速升高宕机,造成线上商城停止服务。此次事故影响时间持续 12 个小时,导致唯品会业绩损失超亿元,影响客户达 800 万,唯品会将此次故障判定为 P0 级故障。据了解,P0 属于最高级别事故,比如崩溃、页面无法访问、主流程不通、主功能未实现,或在影响面上影响很大(即使 Bug 本身不严重)。 公告指出,唯品会决定对此次事件严肃处理,对应部门的直接管理者承担此次事故责任,基础平台部负责人予以免职作相应处理。 微软 Azure 故障,17 个生产级数据库被删 5 月 24 日,微软 Azure DevOps 在巴西南部地区的一处 scale-unit 发生故障,导致宕机约 10.5 个小时。后续微软首席软件工程经理 Eric Mattingly 出面针对此次故障事件道歉,并透露了导致中断的原因:即,一个简单的拼写错误致使 17 个生产级数据库被删除。 中国电信出现大规模无服务问题 2023 年 6 月 8 日下午,中国电信的网络和通信服务出现无信号等失灵现象,绝大部分反馈的用户都在广东区域,疑似广东省内故障。 此后中国电信客服回应表示,电信基站全省(广东电信)故障,暂时不能拨打电话,请耐心等待,现在紧急加急处理中,不便之处,敬请谅解。 历时 4 个小时左右,广东省内电信网络全面恢复。 语雀 10.23 重大服务故障,持续 7 小时 2023 年 10 月 23 日语雀出现重大服务故障,且持续 7 个多小时才完全恢复。语雀团队后续公布了故障原因及处理过程: 10 月 23 日下午,服务语雀的数据存储运维团队在进行升级操作时,由于新的运维升级工具 bug,导致华东地区生产环境存储服务器被误下线。受其影响,语雀数据服务发生严重故障,造成大面积的服务中断。 阿里云 11.12 重大服务故障,全线产品受影响 2023 年 11 月 12 日下午,阿里云出现严重故障,全线产品受影响。 后续官方确认故障原因与某个底层服务组件有关。在历时约 5 个小时后,阿里云宣布受影响云产品均已恢复,因故障影响部分云产品的数据(如监控、账单等)可能存在延迟推送情况,不影响业务运行。 滴滴 11.27 系统服务故障,技术团队连夜修复 2023 年 11 月 27 日晚间,滴滴因系统故障导致 App 服务异常,不显示定位且无法打车。11 月 27 日晚,滴滴出行进行了回复:非常抱歉,由于系统故障,今天晚间滴滴 App 服务出现异常,经技术同学紧急修复,目前正陆续恢复中。 2023 年 11 月 28 日早间,滴滴出行消息称,网约车等服务已恢复,骑车等在陆续修复中。11 月 28 日,在滴滴发出公告的同时,记者在上海、深圳等地使用滴滴呼叫网约车,发现网约车功能并未恢复使用,网络加载异常,仍无法打车。11 月 28 日,滴滴向记者回应称,网约车服务已恢复,司机乘客权益陆续恢复补发。 11 月 29 日,滴滴再次发文致歉,称初步确定事故起因是底层系统软件发生故障。 推特严重宕机,马斯克暴怒 2023 年 2 月,马斯克因其关于超级碗的推文曝光度不如美国总统拜登,而深夜紧急召集约 80 人解决算法问题。 3 月份,因一名工程师修改配置导致推特出现严重的宕机故障,马斯克扬言要将代码全部进行重构。 7 月份,用户反馈平台再次出现问题,无法发布新推文,收到 “超出限制” 的错误提示。马斯克则回应称,Twitter 正在努力应对 “极端程度的数据抓取” 和 “系统操纵”,这些新的限制是遏制这些紧迫问题的重要措施。 ChatGPT 服务中断近 2 小时,CEO 奥特曼道歉:流量远超预期 北京时间 11 月 8 日晚 22 点左右,OpenAI 旗下 ChatGPT 以及相关 API 出现中断故障,导致面向用户和开发者的服务近 2 小时无法正常使用。 随后 OpenAl 更新事故报告称,已确定了一个导致 API 和 ChatGPT 错误率高的问题,正在努力修复。 与此同时,OpenAI CEO 山姆・奥特曼公开致歉称,本周发布的新功能遇到远超预期的使用量。公司原计划在周一为所有订阅者启用 GPTs 服务,但目前还无法实现。由于负载的原因,短期内可能会出现服务不稳定的情况,对此情况向用户道歉。 延伸阅读:网信办发布《网络安全事件报告管理办法(征求意见稿)》 更多年度重磅事件回顾,查看《2023 中国开源开发者报告》。

优秀的个人博客,低调大师

盘点 MySQL 创建内部临时表的所有场景

作者总结了 MySQL 中所有触发使用内部临时表的场景。 作者:刘嘉浩,爱可生团队 DBA 成员,重度竞技游戏爱好者。 爱可生开源社区出品,原创内容未经授权不得随意使用,转载请联系小编并注明来源。 本文约 2000 字,预计阅读需要 5 分钟。 临时表属于是一种临时存放数据的表,这类表在会话结束时会被自动清理掉,但在 MySQL 中存在两种临时表,一种是外部临时表,另外一种是内部临时表。 外部临时表指的是用户使用 CREATE TEMPORARY TABLE 手动创建的临时表。而内部临时表用户是无法控制的,并不能像外部临时表一样使用 CREATE 语句创建,MySQL 的优化器会自动选择是否使用内部临时表。 那么由此引发一个问题,MySQL 到底在什么时候会使用内部临时表呢? 我们将针对 UNION、GROUP BY 等场景进行分析。 UNION 场景 首先准备一个测试表。 CREATETABLE`employees` ( `id`intNOTNULLAUTO_INCREMENT, `first_name`varchar(100)COLLATEutf8mb4_binDEFAULTNULL, `last_name`varchar(100)COLLATEutf8mb4_binDEFAULTNULL, `sex` enum('M','F')COLLATEutf8mb4_binDEFAULTNULL, `age`intDEFAULTNULL, `birth_date`dateDEFAULTNULL, `hire_date`dateDEFAULTNULL, PRIMARYKEY(`id`), KEY`last_name` (`last_name`), KEY`hire_date` (`hire_date`) ) ENGINE=InnoDB AUTO_INCREMENT=500002DEFAULTCHARSET=utf8mb4COLLATE=utf8mb4_bin; 准备插入数据的脚本。 #! /usr/bin/python #! coding=utf-8 importrandom importpymysql fromfakerimportFaker fromdatetimeimportdatetime, timedelta # 创建Faker实例 fake=Faker() # MySQL连接参数 db_params={ 'host':'localhost', 'user':'root', 'password':'root', 'db':'db1', 'port':3311 } # 连接数据库 connection=pymysql.connect(**db_params) # 创建一个新的Cursor实例 cursor=connection.cursor() # 生成并插入数据 foriinrange(5000): id=(i+1) first_name=fake.first_name() last_name=fake.last_name() sex=random.choice(['M','F']) age=random.randint(20,60) birth_date=fake.date_between(start_date='-60y', end_date='-20y') hire_date=fake.date_between(start_date='-30y', end_date='today') query=f"""INSERT INTO employees (id, first_name, last_name, sex, age, birth_date, hire_date) VALUES ('{id}', '{first_name}', '{last_name}', '{sex}', {age}, '{birth_date}', '{hire_date}');""" cursor.execute(query) # 每1000提交一次事务 if(i+1)%1000==0: connection.commit() # 最后提交事务 connection.commit() # 关闭连接 cursor.close() connection.close() 在创建好测试数据后,执行一个带有 UNION 的语句。 root@localhost:mysqld.sock[db1]> explain (select 5000 as res from dual) union (select id from employees order by id desc limit 2); +----+--------------+------------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------+------------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ | 1 | PRIMARY | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | No tables used | | 2 | UNION | employees | NULL | index | NULL | PRIMARY | 4 | NULL | 2 | 100.00 | Backward index scan; Using index | | NULL | UNION RESULT | <union1,2> | NULL | ALL | NULL | NULL | NULL | NULL | NULL | NULL | Using temporary | +----+--------------+------------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ 3 rows in set, 1 warning (0.00 sec) 可见第二行中 key 值是 PRIMARY,即第二个查询使用了主键 ID。第三行 extra 值是 Using temporary,表明在对上面两个查询的结果集做 UNION 的时候,使用了临时表。 UNION 操作是将两个结果集取并集,不包含重复项。要做到这一点,只需要先创建一个只有主键的内存内部临时表,并将第一个子查询的值插入进这个表中,这样就可以避免了重复的问题。因为值 5000 早已存在临时表中,而第二个子查询的值 5000 就会因为冲突无法插入,只能插入下一个值 4999。 UNION ALL 与 UNION 不同,并不会使用内存临时表,下列例子是使用 UNION ALL 的执行计划。 root@localhost:mysqld.sock[db1]> explain (select 5000 as res from dual) union all (select id from employees order by id desc limit 2); +----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ | 1 | PRIMARY | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | No tables used | | 2 | UNION | employees | NULL | index | NULL | PRIMARY | 4 | NULL | 2 | 100.00 | Backward index scan; Using index | +----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+----------------------------------+ 2 rows in set, 1 warning (0.01 sec) 因为 UNION ALL 并不需要去重,所以优化器不需要新建一个临时表做去重的动作,执行的时候只需要按顺序执行两个子查询并将子查询放在一个结果集里就好了。 可以看到,在实现 UNION 的语义上,临时表起到的是一个暂时存储数据并做去重的动作的这么一种作用的存在。 GROUP BY 除了 UNION 之外,还有一个比较常用的子句 GROUP BY 也会使用到内部临时表。下列例子展示了一个使用 ID 列求余并进行分组统计,且按照余数大小排列。 root@localhost:mysqld.sock[db1]> explain select id%5 as complementation,count(*) from employees group by complementation order by 1; +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+----------------------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+----------------------------------------------+ | 1 | SIMPLE | employees | NULL | index | PRIMARY,last_name,hire_date | hire_date | 4 | NULL | 5000 | 100.00 | Using index; Using temporary; Using filesort | +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+----------------------------------------------+ 1 row in set, 1 warning (0.00 sec) 可以看到 extra 的值是 using index、using temporary、using filesort; 这三个值分别是:使用索引、使用临时表、使用了排序。 注意:在 MySQL 5.7 版本中 GROUP BY 会默认按照分组字段进行排序,在 MySQL 8.0 版本中取消了默认排序功能,所以此处使用了 ORDER BY 进行复现。 对于 GROUP BY 来说,上述的语句执行后,会先创建一个内存内部临时表,存储 complementation 与 count(*) 的值,主键为 complementation。然后按照索引 hire_date 对应的 ID 值依次计算 id%5 的值记为 x,如果临时表中没有主键为 x 的值,那么将会在临时表中插入记录;如果存在则累加这一行的计数 count(*)。在遍历完成上述的操作后,再按照 ORDER BY 的规则对 complementation 进行排序。 在使用 GROUP BY 进行分组或使用 DISTINCT 进行去重时,MySQL 都给我们提供了使用 hint 去避免使用内存内部临时表的方法。 hint 解释 SQL_BIG_RESULT 显式指定该 SQL 语句使用磁盘内部临时表,适合大数据量的操作;适用于 InnoDB 引擎与 Memory 引擎。 SQL_SMALL_RESULT 显式指定该 SQL 语句使用内存内部临时表,速度更快,适合小数据量的操作;适用于 Memory 引擎。 下列是一个使用了 SQL_BIG_RESULT 的例子。 root@localhost:mysqld.sock[db1]> explain select SQL_BIG_RESULT id%5 as complementation,count(*) from employees group by complementation order by 1; +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+-----------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+-----------------------------+ | 1 | SIMPLE | employees | NULL | index | PRIMARY,last_name,hire_date | hire_date | 4 | NULL | 5000 | 100.00 | Using index; Using filesort | +----+-------------+-----------+------------+-------+-----------------------------+-----------+---------+------+------+----------+-----------------------------+ 1 row in set, 1 warning (0.00 sec) 从执行计划中我们可以看出,使用了 SQL_BIG_RESULT 这个 hint 进行查询后,在 extra 列中 Using Temporary 字样已经不见了,即避免了使用内存内部临时表。 其他场景 当然,除了上述两个例子外,MySQL 还会在下列情况下创建内部临时表: 对于UNION语句的评估,但有一些后续描述中的例外情况。 对于某些视图的评估,例如使用 TEMPTABLE 算法、UNION 或聚合的视图。 对派生表的评估。 对公共表达式的评估。 用于子查询或半连接材料化的表。 对包含 ORDER BY 子句和不同 GROUP BY 子句的语句的评估,或者对于其中 ORDER BY 或 GROUP BY 子句包含来自连接队列中第一个表以外的表的列的语句。 对于 DISTINCT 与 ORDER BY 的组合,可能需要一个临时表。 对于使用 SQL_SMALL_RESULT 修饰符的查询,MySQL 使用内存中的临时表,除非查询还包含需要在磁盘上存储的元素。 为了评估从同一表中选取并插入的 INSERT … SELECT 语句,MySQL 创建一个内部临时表来保存 SELECT 的行,然后将这些行插入目标表中。 对于多表 UPDATE 语句的评估。 对于 GROUP_CONCAT() 或 COUNT(DISTINCT) 表达式的评估。 窗口函数的评估,根据需要使用临时表。 值得注意的是,某些查询条件 MySQL 不允许使用内存内部临时表,在这种情况下,服务器会使用磁盘内部临时表。 表中存在 BLOB 或 TEXT 列。MySQL 8.0 中用于内存内部临时表的默认存储引擎 TempTable 从 8.0.13 开始支持二进制大对象类型。 如果使用了 UNION 或 UNION ALL,SELECT 的列表中存在任何最大长度超过 512 的字符串列(对于二进制字符串为字节,对于非二进制字符串为字符)。 SHOW COLUMNS 和 DESCRIBE 语句使用 BLOB 作为某些列的类型,因此用于此结果的临时表是将会是磁盘内部临时表。 参考资料 [1]: 丁奇 《MySQL45讲》 37.什么时候会使用内部临时表? [2]: 8.4.4 Internal Temporary Table Use in MySQL URL:https://dev.mysql.com/doc/refman/8.0/en/internal-temporary-tables.html 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE SQLE 是一款全方位的 SQL 质量管理平台,覆盖开发至生产环境的 SQL 审核和管理。支持主流的开源、商业、国产数据库,为开发和运维提供流程自动化能力,提升上线效率,提高数据质量。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

优秀的个人博客,低调大师

大盘点:11家国外SASE供应商

SASE(Secure Access Service Edge)是一种将广域网功能与SWG、CASB、FWaaS和ZTNA等网络安全功能结合起来的组网技术,可以帮助IT团队优化访问性能、降低操作复杂性,并能在全球范围内增强安全态势。 安全服务访问边缘(SASE) SASE云架构会提供一个单一的网络连接并保护所有的企业资源,包括物理资源、云资源和移动资源。一个理想的SASE解决方案应具有身份驱动、云原生、支持所有边缘和全局分布等功能。 Netskope的研究表明,到2024年,预计至少40%的企业将拥有使用SASE的明确战略。SASE解决方案将帮助从小型到大型的企业应对网络、账户异常、恶意软件、系统异常、政策违反、社交工程等安全事件,如下图所示。据MarketWatch报告,到2026年,全球SASE市场预计将达到3.964亿美元。 为了利用SASE平台,需要具备云原生和基于云的架构。此架构应支持所有边缘,并在全球范围内分布有PoP点。具有关键地理覆盖范围的SASE平台可以使用户在竞争中取得高效率,并满足低延迟的需求。具有基于代理功能的平台可以促进基于策略的访问,一些预置的功能可以提供QoS等网络功能。 在选择SASE供应商时需要考虑的几点: 1)SASE供应商提供的解决方案应是将网络和安全融合在一起的服务。解决方案应是一个具有企业级网络功能(如SD-WAN和WAN加速)和安全服务(如FWaaS、IPS、SWG等)的云本地平台。 2)为了最大化平台优势,该平台应该是云原生的。 3)一个理想的SASE解决方案应具有全局SLA支持的私有主干网络。 4)ZTNA是SASE的另一个基本要求,也是一个必须具备的功能。它可以帮助企业根据云和移动用户、本地用户和资源配置面向应用程序的访问通道。 5)一个简单、直观、稳固的管理平台将降低使用复杂度。 为什么SASE平台需要云原生架构 SASE平台将网络和安全功能与适当的软件体系结构融合在一起,而不应只是通过集成工具将网络和安全特性组合起来。具有云原生架构的SASE供应商将提供最大的灵活性、最低的延迟并满足资源需求。 下图显示了SASE平台的组成部分: 最佳SASE公司比较: 让我们回顾一下下面列出的所有SASE供应商。 1. Cato SASE Cato SASE云是一种全球融合的云原生服务。它可以连接所有分支、云、人员和数据中心。它支持逐步部署,以替换或扩展先前网络服务和安全点解决方案。它能够为WAN和云流量提供端到端路由优化。 功能: Cato SASE云拥有自我修复架构。 提供NG防火墙、安全web网关、高级威胁防护、云和移动安全等特性。 包含云优化、广域网优化和全局路由优化功能。 远程访问(SDP / ZTNA)。 Cato管理应用程序具有控制整个服务的功能。该工具能帮助完成完整的网络和安全策略配置,并提供关于安全事件和网络流量的详细分析。 总结: Cato SASE具有自修复架构,因此可以提供最长的服务正常运行时间。它拥有超过65个PoP点的全球私有主干网络,通过多个SLA支持的网络提供商连接。 网站: https://www.catonetworks.com/sase/?utm_source=software_testing&utm_medium=banner&utm_campaign=top_sase_vendors 2. Twingate 最适合于配置和管理企业范围的访问控制。 Twingate是分布式工作人员的安全远程访问平台。传统的、以网络为中心的虚拟专用网方法陈旧且难以维护,这为安全漏洞留下了隐患。虚拟专用网解决方案存在公共网关暴露、横向攻击漏洞、维护困难等问题。 Twingate提供的解决方案可以使网络对Internet不可见,从而减少了对攻击的暴露。这个平台具有管理可用性、客户端可用性、无公共网关、支持所有应用程序、快速且易于部署等特性。 功能: Twingate是一种基于云的服务,提供了现代零信任网络的快速实现。 IT团队将能够轻松地配置软件定义的边界,而不需要更改基础设施。 允许团队集中管理用户对各种内部应用程序的访问,包括本地应用程序和云应用程序。 总结: Twingate是一种可以替代企业虚拟专用网的安全、高效、零信任平台。它比任何虚拟专用网都更安全且可维护,是一个具有最小维护需求的可扩展平台。 网站: https://www.twingate.com/ 3. Netskope 最适合于提供以数据为中心、云智能和快速的安全平台。 Netskope SASE是网络和安全业务的统一解决方案。它遵循以数据为中心的方法,因此数据和用户在任何地方都能得到保护。 Netskope为安全使用云和网络提供了有效的安全控制。它可以提供高级分析、私有访问、NextGen SWG、CASB和公有云安全。 功能: Netskope的实时和云原生安全特性为企业始终提供安全保障。 其下一代SWG是全面的网络安全解决方案,具有先进的数据和威胁保护和内容过滤功能。 CASB是一个高级的数据和威胁保护管理云应用程序,如Office 365。 它为AWS、谷歌云平台和Microsoft Azure中的关键工作负载以及敏感数据提供可见性、遵从性和威胁保护。 总结: Netskope有云原生ZTNA、高级分析、下一代SWG、CASB和公有云安全的解决方案。 网站: https://www.netskope.com/what-is-sase 4. Zscaler 提供最好的安全服务。 Zscaler为云和移动端提供了SASE平台。Zscaler Internet Access可以使用户免受威胁和数据泄漏危害。Zscaler Private Access允许授权访问应用程序和数据来进行保护。 Zscaler business-to-business有保护访问B2B应用程序的功能。 为了提供最优带宽和低延迟,Zscaler从一百五十多个地点提供安全和策略解决方案。 功能: Zscaler具有基于代理的架构,方便其对加密流量的全面检查。 ZTNA通过限制访问来提供本机应用程序细分。 通过零攻击面来阻止目标攻击。零攻击面可以防止源网络和身份暴露在互联网上。 具有本地的、多租户的云架构,可以根据需要提供动态扩展。 总结: Zscaler这种自动化的云交付服务易于部署和管理,且是一个可扩展平台。 网站: https://www.zscaler.com/products/secure-access-service-edge 5. Barracuda Networks 最适合于安全性、应用程序交付和数据保护的解决方案。 Barracuda CloudGen Access是一个为企业提供对SaaS应用程序、内部应用程序和设备上安全的访问的云原生平台。它是一个设备无关的解决方案。它通过代理提供设备安全性,而无需访问设备。大部分的计算、逻辑和保护都是在设备上执行的。 功能: Barracuda CloudGen Access具有通过安全网关来防止网络钓鱼和其他恶意软件域的功能。这个安全网关是驻留在设备上的。 与身份集成的访问代理提供对内部应用程序的安全访问。这些代理由零信任策略提供支持。 为了加强策略,它执行用户身份和设备的持续验证,同时也持续验证应用程序。 结论: Barracuda SASE解决方案将提供无缝、一致、安全的网络接入,易于部署和管理,具有保护关键数据和应用程序的能力。 网站: https://www.barracuda.com/ 6. VMware 最适合为移动客户端提供可靠的应用程序交付。 VMware提供了一个云原生SASE架构。它结合并通过PoP点提供了SD-WAN网关,VMware安全访问,ZTNA解决方案,SWG, CASB,和VMware NSX防火墙等多种解决方案。 功能: VMware具有启用企业范围云策略、扩展新的操作模型、将工作负载迁移到云等特性,可以帮助处理与云资源相关的各种用例。 具有保护分布式用户和应用程序免受来自网络、数据、应用程序和用户等所有级别的内部和外部威胁的功能。 使用户即使在网络条件不佳的情况下,也能向移动客户端、校园等提供放心可靠的应用交付。 总结: VMware为分支机构边缘、物联网设备、园区和移动用户提供网络和安全服务。使用此解决方案将获得构建和扩展新的全球WAN的敏捷性和操作简单性。 网站: https://www.vmware.com/content/microsites/sase/home.html 7. Perimeter 81 最适合于简单过渡到云环境和全面可视化。 Perimeter 81 SASE平台是一个集网络和安全功能于一体的统一网络安全服务解决方案。它为零信任的应用程序访问、零信任的网络访问、软件定义的边界和业务虚拟专用网解决方案提供解决方案。大中小企业都适合使用。 它可以用于统一云管理、零信任NaaS、防火墙即服务、云沙箱、DNS安全、SaaS安全、端点安全、端点合规等多种场景。 功能: 零信任应用程序访问提供了完全审计访问、高级威胁保护、检查记录所有流量、高性能设计、全面的API集成和最低权限访问控制等特性。 其零信任网络解决方案提供了多区域部署、精确分割隧道、点对点互连、基于策略的细分、内置的双因素验证、网络审计和监控等功能。 为了保护网络和关键资产免受外部威胁,Perimeter 81提供了SDP (Software Defined Perimeter,软件定义边界)解决方案,具有自适应、全局访问、精确分割和安全加密等特点。 它同时为企业提供了下一代安全虚拟专用网解决方案。 总结: Perimeter 81具有用于安全和管理网络的基本功能,适用于所有企业的高级功能,以及适用于企业的安全功能。该云管理平台具有专用的全球网关、快速便捷的网络部署、基于策略的细分等特点。 网站: https://www.perimeter81.com/ 8. Fortinet 最适用于动态和分布式网络的一致性保护。 Fortinet SASE解决方案为分布式网络提供云交付的安全性。它结合了ZTNA, SWG,云交付的NGFW等多种功能。它将在所有网络边缘提供一致的保护。具有企业级安全特性。 FortiSASE包含各种工具和功能,如DLP, SWG, ZTNA, 虚拟专用网,Sandboxing,IPS, DNS等。 功能: FortiSASE具有自动预防恶意域的能力。它能实时识别这些域,保护核心网络。 其入侵防御系统会始终对网络进行监控,查找恶意活动。 为了保护Web访问免受内部和外部风险的影响,它具有SWG(Secure Web Gateway, 安全网关)的功能。 它具有将零信任网络访问扩展到远程用户的功能。 总结: Fortinet提供一套完全集成的SASE解决方案,具有广泛的安全驱动的网络功能、直观的部署和管理。 网站: https://www.fortinet.com/products/sase 9. PaloAlto Network 具备全面、一流的安全性。 PaloAlto Prisma Access具有完全的云交付安全性。它提供了一流的安全特性来保护所有应用程序。它包含FWaaS、SWG、ADEM、ZTNA、CASB和IoT解决方案。 功能: FWaaS提供了包括威胁保护、URL过滤等的一整套安全功能,用于防止远程地址受到威胁。 SWG功能利用静态分析和机器学习来避免来自网络的威胁。 在自主数字体验管理(Autonomous Digital Experience Management ,ADEM)的帮助下可以获得全程可视性。 总结: Plato Alto Prisma Access是一个单一的云交付平台。它可以保护访所有应用程序的访问、抵御所有的威胁。 网站: https://www.paloaltonetworks.com/resources/sase 10. Akamai Enterprise Application Access 最适合于提供对应用程序的安全远程访问。 Akamai Enterprise Application Access是一种云架构,它具有关闭入站防火墙端口的功能,并能确保只有经过授权的用户和设备才能访问内部应用程序。它使这些应用程序能够在互联网和公共网络上隐藏起来。 它适用于各种应用场景,如安全访问云应用程序、远程和第三方应用程序,加速兼并和收购、取代传统虚拟专用网等。 功能: 无论业务关键型应用程序的位置和应用程序类型如何,您都能够获得对其的安全访问。它消除了提供全面网络访问的需要。 来自第三方应用程序、设备和用户的多种威胁信号都有助于强化访问决策。 具有IdP、MFA、SSO、端到端加密、负载均衡等功能。 总结: Akamai提供了一个以用户或应用程序为中心的模型,由此提供了安全访问功能。它建立在Akamai智能边缘平台上,因此可以提供极高的可扩展性。同时Akamai也降低了技术复杂性。 网站: https://www.akamai.com/us/en/products/security/enterprise-application-access.jsp 11. Cisco 适用于任何地址的安全访问。 Cisco提供云原生SASE解决方案,在单一平台上具有领先的网络和安全功能。它可以使用现有设备基础并简化转变过程,是一个简单而灵活的解决方案。 功能: Cisco SASE具有简化策略创建和管理的功能。 它可以保护任何地址的所有用户和设备。 Cisco SASE平台提供云规模架构、简化云内安全、零信任访问和简易性等功能。 提供灵活和优化的SD-WAN网络性能。 具备安全网关、云接入安全代理、防火墙、ZTNA等安全功能。 总结: Cisco 的SASE结合了SD-WAN和虚拟专用网功能以及安全网关和防火墙等安全特性。 网站: https://www.cisco.com/c/en/us/products/security/sase.html 结 论 市场上大多数可用的网络和安全解决方案并不适合于以云为中心、以移动为优先的数字企业。SASE供应商将网络和安全功能融合到一个云原生解决方案中。这降低了成本,提高了简易性和灵活性。 SASE解决方案可以帮助企业快速开发和交付新产品,缩短对需求变化作出反应所需的时间。 希望这篇详细的SASE供应商回顾、比较和总结文章可以让大家对市场有初步的了解。 鸿蒙官方战略合作共建――HarmonyOS技术社区 【责任编辑:赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

盘点 12 个 GitHub 上的高仿项目

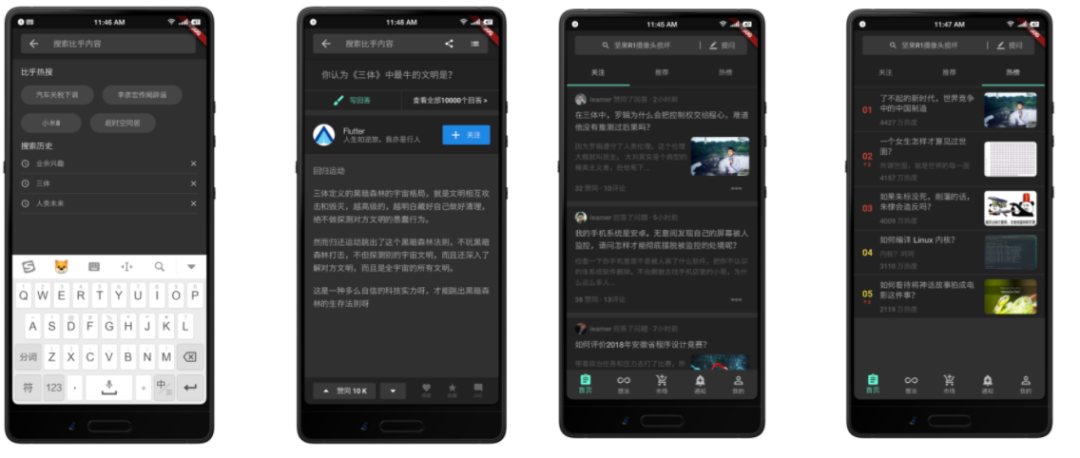
老逛整理了现在比较热门 App 的高仿项目,这些项目都是有「recently updated」,而不是年代久远不再维护的项目。包括高仿微信、微博、B站、斗鱼、抖音、美团、头条、掘金等等。 这些项目涉及的技术栈有 Vue、Flutter 等等,看这些高仿项目的源码有什么用呢?比如下面这个高仿知乎,采用 Flutter 技术栈,把代码 Download 下来,看着代码做一遍基本可以入门 Flutter,学会 APP 布局。 高仿知乎 使用 Flutter 模仿的知乎黑色主题的 UI, 在 我的页中可以修改日间和夜间模式。 GitHub地址:https://github.com/xujiyou/zhihu-flutter 高仿微信 已实现的功能包括:消息界面、发现界面、好友搜索、聊天界面等。微信中常用功能都支持,比如: 好友列表、好友搜索、好友资料、资料设置、新的朋友、群聊、标签、好友圈、扫一扫、摇一摇、漂流瓶、购物、游戏等等。 至于聊天功能,可以调节字体大小、更改聊天背景、我的表情、清空聊天记录。智慧城表情键盘(动态增删表情包)、文字消息、图片消息、表情消息、语音消息、聊天输入框、消息展示视图、聊天键盘、聊天记录存储等。 GitHub地址:https://github.com/tbl00c/TLChat 高仿炸弹特效 微信 8.0 来临,新版本微信中最吸引眼球的莫过于「表情特效」,尤其是超级震撼的「炸弹」更是把微信群炸上了天。 版本刚刚发布不就,就有前端大佬复现了「炸弹」特效,大佬折腾了许久,做出来的效果如下。不到 300 行代码,并且已经开源,教程和代码可以关注微信公众号「逛逛GitHub」回复「炸弹」获取代码。 仿美团外卖点餐 前端用 vue+vuex+vue-router+axios,后端基于nodej.s的框架,数据库采用mongodb。功能涉及登录,定位,浏览商品,加购物车,下订单,支付(微信、支付宝扫码支付),评价,个人信息更改。 https://github.com/zwStar/vue-meituan 精仿今日头条 数据是抓取今日头条 App 的数据。使用 RxJava + Retrofit + MVP 开发的开源项目。 https://github.com/chaychan/TouTiao 高仿掘金 仿照掘金客户端使用 Vue 开发的 WebApp。里面所有的API均来自官方Android。页面基本上和掘金App差不多,不过由于里面的一些图片本菜使用的是阿里的iconfont,因此会和掘金App上面的图片有点不一样,但是整体的功能和掘金App还是差不多的。 地址:https://github.com/sanfengliao/vue-juejin 高仿微博 iOS 版: Github 地址:https://github.com/sam408130/DSLolita Android: Github 地址:https://github.com/wenmingvs/WeiBo iOS 仿抖音 这个抖音 Demo 适配 iPhone、iPad,同时兼容 iOS 8.0 - iOS 12.0系统。采用 Object-C 语言编写。标星 1.5K Star,项目地址: https://github.com/sshiqiao/douyin-ios-objectc 本项目共分为三个部分:抖音个人主页实现、网络视频相关功能实现、WebSocket 实现 IM 即时聊天功能。 Android 仿抖音 这个 Demo 涉及的技术要点如下: Recycler +PagerSnapHelper 实现全屏切换播放效果, 使用 Lottie 库加载 Json 动画 BottomSheetDialogFragment 实现分享评论弹框功能 CoordinatorLayout + AppBarLayout 实现折叠布局。 该项目标星 1K Star,项目地址: http s://github. com/ 18380438200/Tiktok 高仿 YouTube iOS版本, Github 地址: https://github.com/aslanyanhaik/youtube-iOS 安卓版本, Github 地址: https://github.com/TeamNewPipe/NewPi 仿斗鱼直播 APP flutter 重构的斗鱼直播 APP,首页、娱乐为Material组件;直播间、鱼吧为纯自定义编写。GitHub 地址: https://github.com/yukilzw/dy_flutter 仿网易云音乐 基于 flutter 的仿网易云音乐软件,支持 iOS 和 Android。GitHub 地址: https://github.com/boyan01/flutter-netease-music 高仿 B站 基于 react 和 express 开发的,高仿B站 Web 移动端,GitHub 项目: https://github.com/code-mcx/react-bilibili 高仿Bilibili, iOS 版 Github 地址: https://github.com/MichaelHuyp/Bilibili_Wuxianda Android 版本 Github 地址: https://github.com/HotBitmapGG/bilibili-android-client 界面截图: 最后,防止找不到本篇文章,可以收藏点赞,方便翻阅查找。本文首 发至公众号 逛逛GitHub(ggGithub),转载请注明出处。 推荐阅读 1.推荐几个好玩项目 2.推荐几个有用项目 3. 推荐几个有用工具 每天推荐一个有趣、好玩且可能你会用到的 GitHub 项目。 本文分享自微信公众号 - 逛逛GitHub(ggGithub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

年终盘点 | 2020云巨头们的宕机事件

本文转载自微信公众号「SDNLAB」。转载本文请联系SDNLAB公众号。 今年,疫情的爆发给云计算带来了一次非凡的考验——云计算不仅要提供正常运营业务的能力,还需要具有在负载激增的情况下保持可用性的能力。目前,云计算已被很多企业采用,但是,在此过程中也出现了许多问题。 以下是今年规模巨大的十大宕机事件,随着这些问题的出现和解决,云计算技术正面临着新的挑战和机遇。 1.3月份,Microsoft Azure 3月,微软发生两次大规模宕机事件。 3月3日,微软位于美国东部的数据中心发生了服务中断,持续六小时,导致美国北部的客户无法使用Azure云服务。 微软称,这次故障应归咎于冷却系统故障。发生故障的楼宇自动化控制导致气流减少,随后整个数据中心的温度达到峰值,影响了网络设备的性能,使得计算和存储都无法继续使用。 3月24日-26日,Azure Pipelines发生故障,这是DevOps团队使用的持续交付服务,接下来的几天,软件开发管道遇到了严重的延迟,开发人员受到的影响特别大。 微软证实,由于全球疫情爆发,需求激增,虚拟机容量受限使得设备重新映像的时间增加,导致可用代理的等待时间也随之增加。 2.3月26日,Google Cloud Platform 3月26日,Google多个云服务出现无法访问的问题。Google用户发Twitter称,他们遇到了Google 500和502错误代码——500代码代表因内部错误导致请求失败;502代码则代表网关出现故障。 Google最终将这次故障归咎于“基础设施组件”问题。据Downdetector称,美国东部沿海地区的Google客户受到的影响最大。 3.4月10日,华为云 4 月 10 日,华为云出现大面积宕机,华为云登录、管理后台无法访问,部分公司业务无法正常维持。本次宕机持续约三小时。 不少网友在微博反映,华为云登录、管理后台便开始无法访问,并出现了“服务器暂时过载或处于维护中,请稍后重试。”、“建立数据库连接时出错”等提示。华为云官方微博随后发布公告回应称:“检测到部分主机异常,目前故障基本修复,部分客户的业务正在配合恢复中。” 对此,有消息称这次宕机主要是由于北京的机房出现故障导致的,广州和上海的用户表示能够正常使用。 4.4月21日,GitHub 微软旗下的源代码存储库GitHub在4月底发生了多次宕机。 4月21日,多个GitHub服务出现访问异常,持续了一个半小时。4月22日,服务再次出现中断,持续时间至少两小时。4月23日,多个GitHub服务也遇到了各种问题的影响,持续了近三小时。软件工程师经常使用的API请求、Webhooks等服务被标注为 "已降级"。 官方没有提供任何原因,也没有公布恢复过程的信息。虽然GitHub网站上更新了微软试图修复各种故障的情况,但并没有提供任何关于问题的细节,开发者们在Twitter上抨击微软缺乏透明度。 (5) 6月9日,IBM Cloud 6月9日,IBM Cloud 遭遇了重大宕机故障,平台上托管的多项服务也因此中断,其中就包括知名科技新闻聚合网站 Techmeme。本次宕机事件从下午2点30分左右开始,并快速蔓延至全球。 IBM Cloud页面也在故障发生期间短暂关闭,然后在下午6:30之后报告称一系列问题已经得以解决。 IBM网站解释到,INM网络运营团队调整了路由策略,处理了第三方提供商引入的问题,这次故障也得以解决。 (6)8月24日,Zoom 8月24日,Zoom发生了部分中断,导致用户无法访问其离线会议和在线视频会议,本次中断持续了3小时。Zoom并未解释造成中断的原因,他只是在状态页面上说找到并解决了问题。 Zoom现在每天约有1.15亿活跃用户,该公司的服务可能已成为2020年在家工作的关键词。 (7)9月28日,Microsoft 365和Azure 9月29日,Microsoft Office 365办公软件和Azure云产品出现故障,导致部分用户服务中断数小时。 微软表示,故障涉及Outlook电邮服务和Teams办公协作工具的部分用户,其中Teams具备聊天和视频会议功能,在新冠疫情期间其用户增长迅速。微软表示,一些用户无法登录这些服务,但已经登录上去的不受影响。 当天,Azure云计算用户也遭遇了与Office365套件类似的问题。Azure是微软的大规模云计算系统,许多企业都依靠其存储和分析数据。 (8)10月7日,Microsoft Office 365 10月7日,Microsoft更新了其网络基础结构,随后,Microsoft Teams,Outlook,SharePoint Online,OneDrive for Business和Outlook.com的功能均下降。 当天下午2:48,Twitter上的Microsoft 365官方号确认中断。微软随后表示,网络基础结构的最新更新对Microsoft 365服务产生了影响,目前环境正在恢复更新。 (9)11月25日,AWS 11月25日,亚马逊云服务出现中断,大量网站和服务受到影响。本次宕机持续约5小时。 AWS发布通知称,处理流媒体数据的Kinesis服务出现问题,大量网站受到影响,错误率上升。并且,宕机还影响了它向状态页发布更新的能力。 据了解,此次宕机导致亚马逊智能安全子公司Ring、Roku、软件开发商Autodesk纽约大都会运输署的地铁网站,论坛出版集团旗下的《芝加哥论坛报》和《巴尔的摩太阳报》等一些公司或机构的服务受到了影响,网站频频出现错误。 值得注意的是,AWS 的大客户苹果、Slack、Netflix 并没有受到宕机的影响,仍然运行正常。 (10)12月14日,Google Cloud 12月14日晚间,Google服务器又一次全球宕机。这是近5个月来第3次全球宕机。 Google旗下的YouTube、Gmail、Google Drive、Google Search等服务出现死机,用户无法正常使用,全球多个国家及地区用户均受到影响。 Google随后发推文确认,由于内部存储配额问题,Google身份验证系统中断。宕机45分后问题得以解决,现在所有服务都已恢复。 互联网时代对系统的可靠性提出了更高的要求。关键系统往往要求每年的不可用时间不能超过53分钟,而以上事故很多都远远超过了故障预算。 未来,系统架构会越来越复杂,整体的数据和流量也会越来越大,有专家表示,快速响应和控制影响半径,是当前的互联网需要重视起来的两个实践方向。 【责任编辑: 赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

年中盘点:2020年10大云故障

仅仅几个月前,新冠病毒就以人们无法预测的方式对云提供商进行了一轮测试。大多数情况下,云计算产业已经能够在全球突然开始极大地依赖云服务以继续工作、学习和娱乐的时候、保持云服务的可用性和稳定性。 在面对前所未有的压力测试时,公有云已经被证明具有极强的弹性,但今年上半年也还是有一些例外。虽然今年到目前为止,只有少数几起中断故障是由于新冠病毒让云服务使用激增所导致的,但还有一些是由于某些常见的故障引发的,即使是在特殊时期,这些故障在某些程度上也是不可避免的。 下面就让我们来看看今年到目前为止给用户带来影响的10大云故障。 1. Twitter,2月7日 今年2月Twitter发生部分服务中断,导致一些用户无法发送推文。 “推文无法发送,我们正在努力修复,”社交媒体巨头Twitter的产品经理Patrick Traughber发推文表示。 根据Downdetector.com的报道,美国东部时间下午5点之前,有关服务中断的投诉激增至12000起,主要发生在美国和欧洲。 Twitter支持团队在推文中说:“我们对这次服务中断感到抱歉,我们会在恢复正常之后通知您。” Twitter很快发现,这次服务中断的罪魁祸首,是最近的一次更新中包含的错误代码,随后取消了这次更新。美国东部时间下午5:07之前,Twitter支持团队向用户发送通知称:“您可以继续使用Twitter了,问题已经得到解决!感谢您继续使用。” 2. 微软Azure,3月3日 从美国东部时间上午9:30开始,微软位于美国东部数据中心发生了6个小时的服务中断,从而导致美国北部的一些客户无法使用Azure云服务。 几天后,微软称这次故障应归咎于冷却系统故障。微软解释说,楼宇自动化控制功能故障导致气流减少,随后整个数据中心达到峰值,从而影响了网络设备的性能,使计算和存储实例无法使用。 微软最终重置了冷却系统控制器,一旦温度降下来,工程师就可以关闭电源,重启硬件,恢复服务。 3. 微软Teams,3月16日 在新冠病毒大爆发之际,微软Teams平台涌入了大量新用户,导致该服务在欧洲地区出现了持续2个小时的宕机,此次事件也突显了Teams服务的支持能力问题。 微软在推特上称,截至美国东部时间上午4:50,“微软一直在调查Teams中与通信相关的功能问题”。有报道称,对欧洲用户来说,Teams应用程序套件已经完全无法使用。 微软在一份声明中表示:“我们已经采取措施解决部分客户可能遇到的问题,工程团队将继续积极监控性能和使用情况。” 而就在两周前,微软刚刚承诺向目前尚无Teams许可的企业和教育机构免费提供6个月的Office 365 E1订阅服务。 4. 微软Azure,3月24日至26日 今年3月微软证实,新冠病毒大爆发给微软多项云服务带来极大的压力,这导致了欧洲地区发生一系列宕机。 这次故障给开发者带来的影响特别大,因为3月24日首先“阵亡”的是Azure Pipelines,DevOps团队使用的持续交付服务。接下来的几天里,微软的软件开发管道发生严重的延迟。 微软后来解释说:“此次事件是由全球新冠病毒大爆发引起虚拟机容量受限所导致的,使得设备重新映像的时间增加,可用代理的等待时间也随之增加。” 当周晚些时候,微软接受了关于没能及时解决故障的指责。 微软工程总监Chad Kimes说:“第一天影响最严重的时候,我们有大约5个小时都没有意识到故障的发生,这比我们设定的10分钟要糟糕得多。” 5. Google Cloud Platform,3月26日 谷歌用户从3月26日上午11点开始报告有多项云服务无法访问的问题。 用户发推特称,他们遇到了Google 500和502错误代码——500代码代表因内部错误导致请求失败;502代码则代表网关出现故障。 Google最终将这次故障归咎于“基础设施组件”问题。 据Downdetector称,美国东部沿海地区的谷歌客户受到影响似乎最大。 6. Zoom,4月3日 新冠病毒大流行迫使全球开始转向远程办公和远程学习模式,Zoom作为全球最重要的视频服务提供商之一,遭遇了平台需求的激增。 这种压力似乎导致了4月3日的服务中断,使得美国东海岸和部分欧洲地区的Zoom用户对于无法使用Zoom服务感到震惊。根据DownDetector.com的报道,美国加利福尼亚州、佛罗里达州、中西部和马来西亚的部分地区都出现了的宕机。 登录尝试时报告的错误消息表明Zoom Web客户端出现了问题,Zoom的状态页面称正在维护中。 Zoom在自己的开发者论坛页面上表示:“在这个艰难的时期,我们看到人们对Zoom服务的需求出现激增。为了继续为客户和开发者提供卓越的服务,我们可能会迅速实施一些变更措施。” 此前Zoom一直在为教育机构免费提供视频服务,为企业和消费者提供40分钟的免费视频会议,这导致3月日活用户数量同比增长了151%。 7. Google Cloud Platform,4月8日 这次涉及Google Cloud身份和访问管理(IAM)API的故障,导致用户被锁定在Google Gmail帐户之外,并影响了其他基于Google Cloud的主流服务。 这次故障从美国东部时间上午10:35开始,持续了不到90分钟,导致多个Google服务中断,包括App Engine、Cloud Functions、BigQuery及其核心Compute Engine IaaS。 Google的姊妹公司Nest不得不向客户解释为什么他们的安全摄像机暂时无法使用。而作为Google Cloud的重要客户,Snapchat完全瘫痪了一个多小时。 8. GitHub,4月21日 微软旗下的源代码存储库GitHub在4月底发生了多次宕机。 首先是在4月21日,GitHub苦苦挣扎了一个多小时;第二天,GitHub又发生了两次背靠背的宕机,再次让依赖GitHub平台的开发者工作停滞,然后又一次影响了多个GitHub服务一个多小时;第二天又是如此。 软件工程师在日常工作中所依赖的Git Operations、API请求、拉取请求等功能都出现了级。随着整周持续不断的宕机,开发者们开始在Twitter抨击微软缺乏透明度。 9. Adobe Creative Cloud,5月28日 今年5月,Adobe云平台(包括Photoshop、InDesign和Premier Pro等备受欢迎的产品)发生宕机一整天的时间,让创意专业人士的工作完全停滞。 Adobe Creative Cloud的故障在数字设计社区引发了有关云服务缺点的讨论,很多人在Twitter上开始思考,他们是否应该倾向于这些产品的本地化版本。 从美国东部时间上午9点开始,Adobe客户报告称他们无法登录Adobe Creative Cloud平台并使用相关服务,有客户称,他们因为无法登陆帐户而无法联系到支持人员。 问题曝光的7个多小时之后,Adobe在推特上发布了该问题的解决方法,但未详细说明根本原因。 10. IBM Cloud,6月9日 IBM将这次导致很多客户(包括一些备受欢迎的网站)宕机的云故障归咎于第三方网络故障。IBM的一家商业合作伙伴公司首席执行官称,客户无法访问IBM的环境、状态屏幕和控制台,“根本不知道发生了什么”。 他说:“这带来了广泛的影响,整个环境都停滞了。” IBM Cloud状态页面也在故障发生期间短暂关闭,然后在下午6:30之后报告称一系列问题已经得以解决。 IBM状态页面解释说:“网络运营团队调整了路由策略,解决了第三方提供商引入的问题,从而解决了这次故障。” 【责任编辑: 赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

年度大盘点:机器学习开源项目及框架

我们先来看看Mybridge AI 中排名靠前的顶级开源项目,再聊聊机器学习今年都有哪些发展,最后探寻下新的一年中会有哪些有值得我们期待的事情。 顶级的开源项目 BERT BERT,全称为Bidirectional Encoder Representations from Transformers,是一种基于TensorFlow解决自然语言处理的新方法,且性能更好。我们可以使用BERT中的预训练模型解决问题,该模型在性能上具有很大优势,比如可以识别句子中的上下文。在Github中非常受欢迎,有8848个星,完整学术论文请访问这里。 DeepCreamPy DeepCreamPy是一个深度学习工具,可以像Photoshop一样重建图像中被删除的区域。我们使用图像编辑工具(比如PS)将删减的区域填充为绿色,神经网络可以对其进行复

优秀的个人博客,低调大师

盘点物联网发展五大痛点

Gartner 预测 2017 年环球连接设备将达到 84 亿台,其中包括消费性产品,如智能电视、车载娱乐系统,能够预测工厂维修需求或估算发电厂最有效配电方式的工业应用程序。这些应用程序能够在同一平台上连接及互动,为企业带来创造额外收入的机会。物联网带来的增长将对不同国家的各个行业产生影响。物联网方案物联网在长期发展演进过程中,遇到了以下5个行业痛点:设备安全、个人隐私、架构僵化、通信兼容和多主体协同5大痛点。设备安全:我们都对10大物联网恶意软件(Mirai、BrickerBot、Persirai、Hajime、http81、Stantinko、WireX、Rowdy、Linux.ProxyM、IOTroop)的攻击事件记忆犹新。随着物联网在制造业、交通、能源、电力、家居、医疗等领域的普及,不同类型的设备和数据数量都在快速增长,因此物联网面临的安全挑战日趋严峻。个人隐私:2017年底的“水滴直播”事件,让物联网从业者重新思考数据的归属问题、数据变现的边界以及智能安防产品的良性生长模式问题。在B2C应用中,从数据变现角度来看,数据由消费者产生,价值分流向物联网产业各层,数据归属权的斗争将越来越激烈。近期,号称史上最严的数据监管条例GDPR(通用数据保护条例)正式生效,意味着隐私权作为基本人权愈发受到关注和保护。架构僵化:部分物联网方案的架构采用中心化的服务器模式,随着设备量的几何级数增长,达到了前所未有的水平,成本与规模的矛盾逐渐凸显,中心化的服务成本难以负担。同时,对于采集到的数据,往往缺乏深入分析与决策提炼的步骤,很难与实际价值挂钩。多主体协同:越来越多的物联网应用场景,需要跳出单一公司或组织内部,涉及到跨主体、多个对等实体之间的协作,有可能包含供应商、制造商、经销商、平台方、服务商、最终用户、金融保险机构等众多角色,这时建立信任的时间成本与沟通成本高昂。通信兼容:物联网设备往往兼容多种通信协议,即要涵盖Zigbee、Wi-Fi、蓝牙等近距离通信,又要兼顾NB-IoT、LoRa等远距离传输,针对不同的应用场景,数据模型、接口规范、网络协议等各类标准众多,造成互联互通较为困难,难免形成信息孤岛,降低了通信效率。科技的发展会催生新的产品,而这些产品也会使得我们的生活更加轻松,也更加舒适。但是我们也要警惕这些产品所面临的安全风险。近年来在中国制造2025、互联网+双创等带动下,中国物联网产业发展取得长足进步。物联网技术是融合的技术,随着物联网连接设备的增加,创造的价值会越来越大!

优秀的个人博客,低调大师

确保物联网安全的关键技术盘点

最近几年,许多广为人知的网络攻击已经表明了缺乏物联网安全所能导致的威胁,其中最著名的攻击可能是 “Stuxnet 蠕虫病毒” 攻击。即使你实施了一定的IoT安全措施,你所连接的小工具也可能成为犯罪分子攻击的媒介。物联网安全去年秋天,互联网DNS供应商Dyn遭受到一次网络攻击,这次攻击打乱了人们对公共网站的访问。攻击者能够利用的联网设备非常之多,甚至包括 DVR、相机等。由于物联网安全的挑战不断加大,因此需要技术和生产同时来解决这些问题。 网络安全:IoT网络现在以无线网络为主。在2015年,无线网络的流量已经超过了全球有线网络的流量。由于新生的RF和无线通信协议和标准的出现,这使得IoT设备面临着比传统有限网络更具挑战性的安全问题。 身份授权:IoT 设备必须由所有合法用户进行身份验证。实现这种认证的方法包括静态口令、双因素身份认证、生物认证和数字证书。物联网的独特之处在于设备(例如嵌入式传感器)需要验证其他设备。 加密:加密主要用于防止对数据和设备的未经授权访问。这一点估计有点困难,因为 IoT 设备以及硬件配置是各种各样的。一个完整的安全管理过程必须包括加密。 安全侧信道攻击:即使有足够的加密和认证,IoT 设备也还可能面临另一个威胁,即侧信道攻击。这种攻击的重点不在于信息的传输工程,而在于信息的呈现方式。侧信道攻击(SCA)会搜集设备的一些可操作性特性,例如执行时间、电源消耗、恢复密钥时的电磁辐射等,以进一步获取其它的价值(图 2)。 安全分析和威胁预测:除了监视和控制与安全有关的数据,还必须预测未来的威胁。必须对传统的方法进行改进,寻找在既定策略之外的其它方案。预测需要新的算法和人工智能的应用来访问非传统攻击策略。 接口保护:大多数硬件和软件设计人员通过应用程序编程接口(API)来访问设备,这些接口需要对需要交换数据(希望加密)的设备进行验证和授权的能力。只有经过授权,开发者和应用程序才能在这些设备之间进行通信。 交付机制:需要对设备持续得更新、打补丁,以应对不断变化的网络攻击。这涉及一些修复漏洞的专业知识,尤其是修复关键软件漏洞的知识。 系统开发:IoT 安全需要在网络设计中采用端到端的方法。此外,安全应该至始至终贯穿在整个产品的开发生命周期中,但是如果产品只是传感器,这就会变得略微困难。对于大多数设计者而言,安全只是一个事后的想法,是在产品实现(而不是设计)完成后的一个想法。事实上,硬件和软件设计都需要将安全考虑在整个系统当中。

优秀的个人博客,低调大师

百度旗下手机应用大盘点

9 月2号百度大会上,百度正式推出了其手机操作系统——“百度·易”。该系统的推出,意味着百度深度布局移动互联网。虽说百度现在依然是超越腾讯成为中国市 值最高的互联网企业,但是其盈利大部分依然是依靠广告,上个月CCTV还针对其广告推荐系统提供虚假网站致使消费者权益受损连续炮轰四天造成其市值损失超 70亿美元。如今百度开始不断寻找更多的健康盈利模式。“百度·易”系统的推出,不难推测未来的某个时间百度会推出自有品牌手机——“百度手机”。今天小 编就给大家先总结下百度旗下的手机应用。 掌上百度 支持平台:Android、iOS、Symbian等 价格:免费 杀手指数: 8/10 山寨指数:6/10 下载地址:http://shouji.baidu.com/zhangbai/download.html?from=757b 简评:掌上百度是百度公司专门为手机用户打造的一款客户端软件。除了强大的无线搜索功能外,还整合了百度贴吧、知道这两个最大的社区平台;为用户提 供便捷、快速的网页搜索、语音搜索,知识搜索(百度知道)、以百度贴吧为核心的社区服务、以百度新闻为核心的资讯服务,目前支持国内主流手机操作系统。跟 UCWEB(UC浏览器)一样省流量。 百度手机输入法 支持平台:Android、iOS(需越狱)、Symbian 价格:免费 杀手指数: 5/10 山寨指数:6/10 下载地址:http://ishouji.baidu.com/input/download.html 简评:百度手机输入法是百度公司推出的一款智能手机平台下的输入法产品。具有功能全面、词库精准、操作简便、界面美观、输入流畅等特点。其将支持全 拼、简拼、笔划、双拼、模糊音等多种输入方式,并且还采用了“点划结合”专利技术;精准、全面、持续优化,并提供多重词库优化和个性适配功能;精心设计, 切换方便,简单可依赖,还有独创的点划专利技术;个性化主题,丰富的皮肤定制功能;高性能的手机输入法内核,保证输入流畅快捷。有相关人士称:“这绝对是 目前手机平台最强大的输入法” 百度手机地图 支持平台:Android、iOS、Symbian 价格:免费 杀手指数: 7/10 山寨指数:6/10 下载地址:http://shouji.baidu.com/map/download.html?from=1052 简评:支持全国2800多个县市地图浏览,快速定位、搜索地点、公交、驾车和步行路线,支持离线地图下载;另存地图:保留当前屏幕截屏到手机,贴心 省流量,不用联网,也可随时查看预先查好的地点和线路;晃一晃就能定位。Android版本新增超酷语音搜索功能,进入搜索界面,点击语音搜索按钮即可体 验语音搜索功能。 百度快搜 支持平台:Android、Symbian 价格:免费 杀手指数: 8/10 山寨指数:7/10 下载地址:http://shouji.baidu.com/search/download.html 简评:是百度推出的一款让用户随时随地的享受百度搜索的应用。通过桌面启动等方式,大大减少了使用百度服务的操作步骤。提供热门关键词的推送服务, 掌握最新的网络热点;在量身定做的推荐信息中,优质的网络资源一键直达。百度快搜保持了百度一贯简洁、清晰,使用方便的产品特点。更值得一提的是程序体积 小,为您节省了下载流量和使用空间。 百度手机浏览器 平台:Android、WP7 价格:免费 杀手指数: 6/10 山寨指数:6/10 下载地址:http://mb.baidu.com/ 简评:采用太空小熊形象,很是卡哇伊。基于webkit浏览器开发,在浏览速度、网站兼容性、稳定性上均有明显提升。能自动寻找网页中的主体内容, 提供人性化的排版方式;首创底部无极滑动缩放,体验指尖在触摸屏上的酷炫操作效果,轻轻松松实现手机访问PC网页的畅游体验;轻点图标即可访问常用网站, 不断更新的插件库更能提供最贴心的服务;页面右下角小气泡中能收藏常用操作,让一切变得更加简单。放大镜功能可帮助随时随地对文字进行即时放大、复制、发 送和搜索。地址栏与搜索框合二为一,智能识别网址和关键词搜索,无须分辨地址栏和搜索框,所有信息一键到达。后台多页面加载可以一边发微博一边逛论坛,快 捷书签更能迅速访问新页面,全面提升浏览效率。 百度身边 支持平台:Android、iOS、Symbian 价格:免费 杀手指数: 7/10 山寨指数:7/10 下载地址:http://s.baidu.com/event/iphone 简评:全方位的本地生活信息综合服务平台,网罗最丰盛的吃喝玩乐信息。美食拍客社区:全城吃货的聚集地;轻松一按,自动定位,搜索你身边的各式店 铺、缤纷美味。支持GPS、基站、Wifi多种定位方式;覆盖全国326个城市,美食、购物、休闲娱乐、丽人等8大类,信息包括电话、地址、营业时间、推 荐商品、特色服务、用户点评等;覆盖北京、上海、广州、深圳、重庆5个城市,提供免费试吃、商场打折、独家优惠券等。 百度视频 支持平台:Android、iOS(即将上线) 价格:免费 杀手指数: 7/10 山寨指数:5/10 下载地址:http://list.video.baidu.com/iph_promote.html 简评:百度视频是百度公司推出的一款为Android用户精心优化的免费视频应用,集视频搜索、视频推荐、离线观看、剧集提醒等等众多创新优秀功能 于一身。视频全、搜索王、省流量、提醒强、体验佳、速度快,针对不同的网络环境,提供了流畅版与清晰版两种结果,可把观看时卡顿的烦恼抛到脑后。视频内容 检索网站:奇艺、56、激动、酷6、优酷、土豆、搜狐、凤凰、乐视、新浪、腾讯等 百度文库 支持平台:iOS、Android 价格:免费 杀手指数: 8/10 山寨指数:8/10 下载地址:http://www.baidu.com/search/wenku/kehuduanfabu/Index.html 简评:百度文库是供网友在线分享文档的开放平台。2000万份海量文档轻松阅览;绝佳的阅读体验,支持字号调节、亮度调节、进度调节、目录、书签、 屏幕亮度锁、屏幕方向锁等;操作简单,节省流量,实现本地书籍完善管理;超炫的3D仿真翻书效果,翻页灵敏,阅读舒适,带您体验真实阅读;支持本地SD存 储卡内书籍阅读,支持umd, txt, epub, html;新增双书架、3D旋转书架,自动区分在线阅读与本地阅读。百度文库的手机版支持iPhone和Android手机,不过看上去百度文库的 Android版本比iPhone版本功能多,Android版支持本地SD存储卡内书籍阅读,以及手势3D翻书效果,iPhone版的百度文库界面效果 稍逊。 【本文首发于:百度互联网技术官方博客】 【 关注百度技术沙龙】 本文转自百度技术51CTO博客,原文链接:http://blog.51cto.com/baidutech/744311,如需转载请自行联系原作者

优秀的个人博客,低调大师

【盘点】2017杭州云栖大会迁云实战Workshop

10月14日云栖大会上,阿里云针对“迁云上云”这一热门领域开设了一个专场Workshop——迁云实战面对面。Workshop围绕企业应用、传统企业迁云等经典场景,阿里云迁云专家文强现场讲解<企业应用迁云实战>,睿得分享<经典网络迁移VPC>的内容,让技术人员快速提升对应场景下的迁云效率,更加务实地在云上解决他们自身所属行业的应用性问题。 文强对当下较受关注的应用迁云整体流程做了详细讲解,从调研评估的方案内容,到云上架构优化和实施的步骤,最后到系统切割上线。最后一步步带着参与者进行了Web站点迁移的实操。 VPC(Virtual Private Cloud)作为一种更加安全,更加灵活的网络类型,获得越来越多客户的青睐。那么原有经典网络类型下的业务系统,如何平稳的迁移到VPC环境中?阿里云迁云专家睿得做了深入的阐述

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册