首页 文章 精选 留言 我的

精选列表

搜索[官方产品],共10012篇文章
优秀的个人博客,低调大师

HarmonyOS官方模板学习 之 Grid Ability(Java)

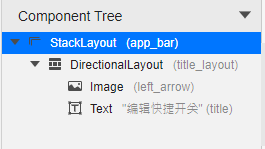
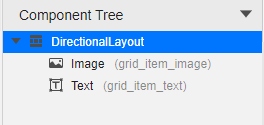
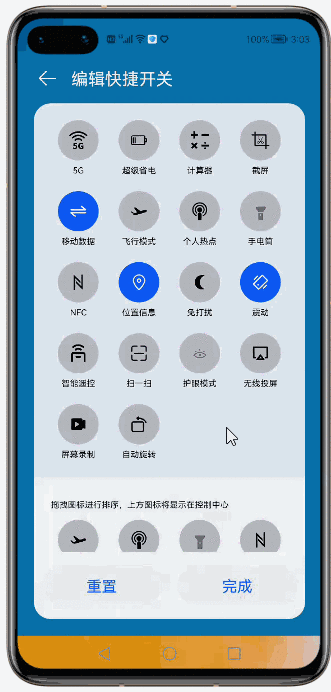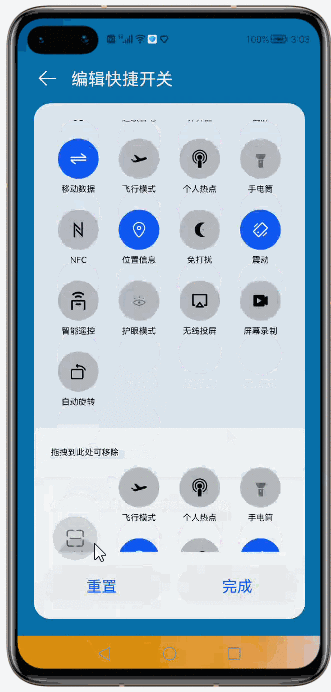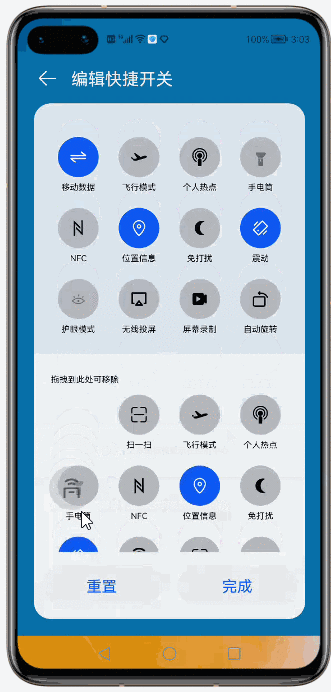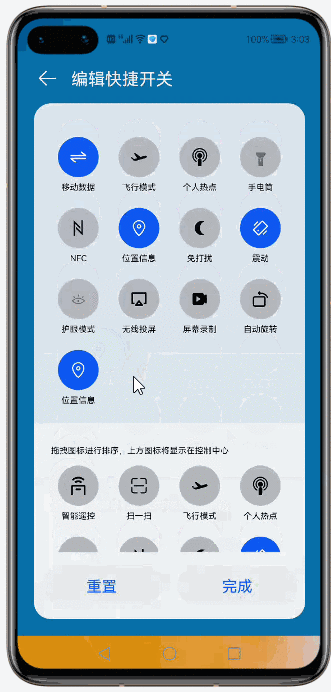
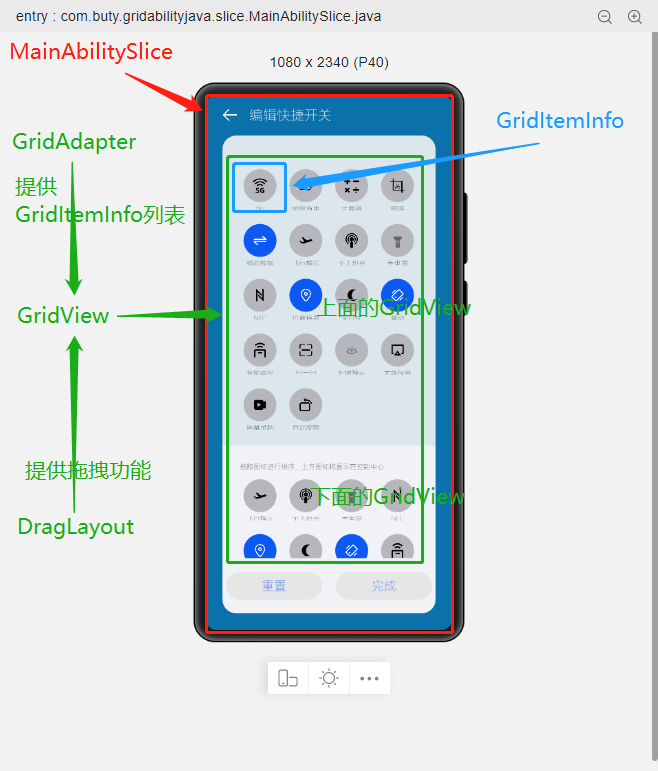
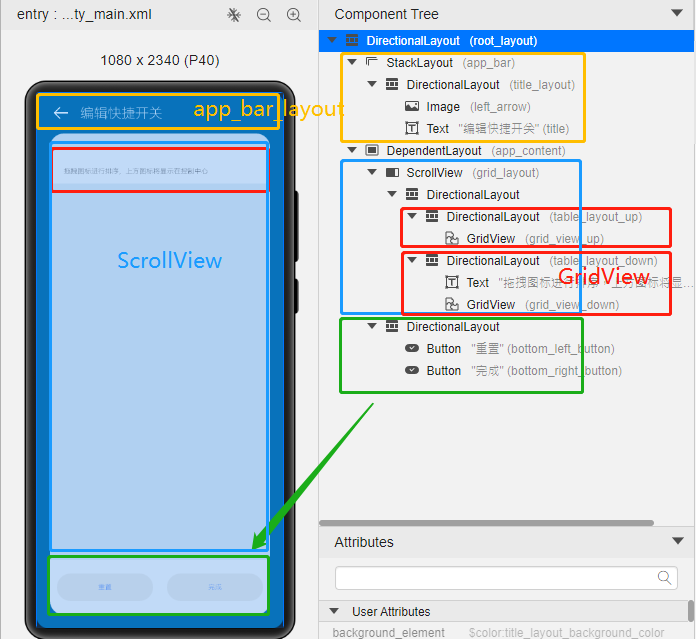
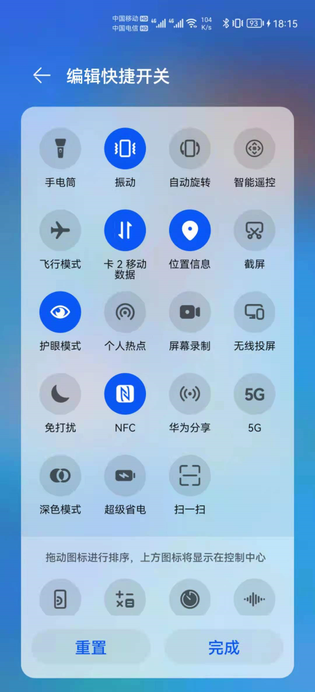
@[toc](目录) # Grid Ability(Java) ## 介绍 使用Java语言开发,用于Phone设备的Feature Ability模板,使用XML布局,显示内容为两部分网格表,网格每行显示4个项目,网格内元素可进行拖拽排序。 ## 搭建环境 安装DevEco Studio,详情请参考[DevEco Studio下载](https://developer.harmonyos.com/cn/develop/deveco-studio)。 设置DevEco Studio开发环境,DevEco Studio开发环境需要依赖于网络环境,需要连接上网络才能确保工具的正常使用,可以根据如下两种情况来配置开发环境: 如果可以直接访问Internet,只需进行[下载HarmonyOS SDK](https://developer.harmonyos.com/cn/docs/documentation/doc-guides/environment_config-0000001052902427)操作。 如果网络不能直接访问Internet,需要通过代理服务器才可以访问,请参考[配置开发环境](https://developer.harmonyos.com/cn/docs/documentation/doc-guides/environment_config-0000001052902427)。 ## 代码结构解读 注意:'#'代表注释 后台功能 ```json gridabilityjava │ MainAbility.java │ MyApplication.java │ ├─component │ DragLayout.java #自定义的拖拽功能组件 │ GridView.java #自定义的Grid视图组件,extends TableLayout │ ├─model │ GridItemInfo.java #Grid item 模型 │ ├─provider │ GridAdapter.java #给Grid提供实例化好的item 组件列表;提供了计算单个item的宽度的方法 │ ├─slice │ MainAbilitySlice.java #主能力页,负责实例化自定义的DragLayout拖拽组件 │ └─utils AppUtils.java #工具类,提供了从element资源中中获取value;获取屏幕的坐标的方法 ``` 这是几个java类之间的关系 ![image.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/580eaf59927ec18dd90122d1ceee31f6a4f3ff.png?x-oss-process=image/resize,w_658,h_771) 页面资源 ```json resources ├─base │ ├─element │ │ color.json │ │ float.json │ │ integer.json │ │ string.json │ │ │ ├─graphic │ │ background_bottom_button.xml #页面底部按钮形状 │ │ background_bottom_layout.xml #页面底部布局形状 │ │ background_item_active_button.xml #grid item 激活形状 │ │ background_item_button.xml #grid item 默认形状 │ │ background_table_layout_down.xml #下面的 grid 形状 │ │ background_table_layout_up.xml #上面的 grid 形状 │ │ │ ├─layout │ │ ability_main.xml #主显示页面 │ │ app_bar_layout.xml #app工具栏布局页面 │ │ grid_item.xml #单个grid item布局页面 │ │ │ ├─media │ │ 5G.png │ │ back.png │ │ back_white.png ``` ## 页面布局 ### ability_main.xml #主显示页 此页面由DirectionalLayout、StackLayout、DependentLayout 布局构成,整体布局是上下布局。 上面时app工具栏,使用了StackLayout布局,通过includ标签引入到主页面。 下面是支持拖拽的GridView,由DependentLayout 和DirectionalLayout布局组成,使用的组件有ScrollView、GridView、Text、Button、Image。 ![image.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/995bf5c59199f2ed3d79375f5593bd8e67a9a8.png?x-oss-process=image/resize,w_696,h_639) ### app_bar_layout.xml #app工具栏布局页面 ![image.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/03992ad991e2af350920520652a8c66bc1cdc5.png?x-oss-process=image/resize,w_265,h_149) ### grid_item.xml #单个grid item布局页面 ![image.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/2800b6b146e1585dde0483cfac61a140a44c94.png?x-oss-process=image/resize,w_264,h_125) ## 后台逻辑 ### 1.初始化上面的GridView 先构建item模拟数据列表,将构建好的数据传递给GridAdapter 初始化item组件列表,通过GridView.setAdapter方法给每个item组件绑定长按事件,并设置GridView的TAG属性(TAG就是指上面的GridView还是下面的GridView)。 ```java /** * 初始化上面的Grid item */ private void initUpListItem() { //构建item模拟数据列表 List upperItemList = new ArrayList<>(); for (int i = 0; i < UP_ITEM_COUNT; i++) { int iconId = icons[i]; String text = texts[i]; upperItemList.add(new GridItemInfo(text, iconId, UP_GRID_TAG)); } GridView gridView = (GridView) slice.findComponentById(ResourceTable.Id_grid_view_up); //将构建好的数据传递给GridAdapter 初始化item组件列表 GridAdapter adapter = new GridAdapter(slice.getContext(), upperItemList); //通过GridView.setAdapter方法给每个item组件绑定长按事件 gridView.setAdapter(adapter, longClickListener); //设置GridView的TAG属性 gridView.setTag(UP_GRID_TAG); } ``` ### 2.初始化下面的GridView 逻辑同上 ```java /** * 初始化下面的Grid item */ private void initDownListItem() { String itemText = AppUtils.getStringResource(slice.getContext(), ResourceTable.String_grid_item_text); List lowerItemList = new ArrayList<>(); for (int i = 0; i < DOWN_ITEM_COUNT; i++) { //随意取的图标 int iconId = icons[i + 5]; String text = texts[i + 5]; lowerItemList.add(new GridItemInfo(text, iconId, DOWN_GRID_TAG)); } if (slice.findComponentById(ResourceTable.Id_grid_view_down) instanceof GridView) { GridView gridView = (GridView) slice.findComponentById(ResourceTable.Id_grid_view_down); GridAdapter adapter = new GridAdapter(slice.getContext(), lowerItemList); gridView.setAdapter(adapter, longClickListener); gridView.setTag(DOWN_GRID_TAG); } } ``` ### 3.初始化底部的按钮 这个地方做了一个屏幕适配,就是根据屏幕的宽度、边距来设置按钮的宽度, 同时添加了按钮的监听事件,点击按钮 关闭当前Ability。 ```java /** * Calculating button width based on screen width. * The actual width is the screen width minus the margin of the buttons. * 设置底部 2个按钮的宽度 */ private void initBottomItem() { int screenWidth = AppUtils.getScreenInfo(slice.getContext()).getPointXToInt(); //计算按钮宽度 int buttonWidth = (screenWidth - AttrHelper.vp2px(80, slice.getContext())) / 2; Component leftButton = slice.findComponentById(ResourceTable.Id_bottom_left_button); leftButton.setWidth(buttonWidth); //关闭Ability leftButton.setClickedListener(component -> slice.terminateAbility()); Component rightButton = slice.findComponentById(ResourceTable.Id_bottom_right_button); rightButton.setWidth(buttonWidth); //关闭Ability rightButton.setClickedListener(component -> slice.terminateAbility()); } ``` ### 4.初始化app工具栏 这个没做什么,似乎是想根据本地化信息,设置返回箭头的方向,因为有的语言是从右往左看的。 ```java /** * 检查指定 Locale 的文本布局是否从右到左。 * 设置返回箭头的方向 */ private void initAppBar() { if (TextTool.isLayoutRightToLeft(Locale.getDefault())) { Image appBackImg = (Image) slice.findComponentById(ResourceTable.Id_left_arrow); appBackImg.setRotation(180); } } ``` ### 5.初始化监听事件 包括返回按钮的返回事件、ScrollView的touch事件。 touch事件包含大量的细节操作,如拖拽时有一个阴影效果,滚动条的处理,拖拽交换结束的处理,过渡效果,上下grid 有效区域的计算,拖拽完成将拖拽的组件添加到对应grid的操作等,参照着拿来用吧。 ```java /** * 初始化监听事件,包括返回按钮返回事件、ScrollView的touch事件 */ private void initEventListener() { //‘返回按钮’的监听事件 if (slice.findComponentById(ResourceTable.Id_left_arrow) instanceof Image) { Image backIcon = (Image) slice.findComponentById(ResourceTable.Id_left_arrow); // backIcon.setClickedListener(component -> slice.terminateAbility()); } //ScrollView的 Touch事件监听,拿来用就可以了 scrollView.setTouchEventListener( (component, touchEvent) -> { //按下屏幕的位置 MmiPoint downScreenPoint = touchEvent.getPointerScreenPosition(touchEvent.getIndex()); switch (touchEvent.getAction()) { //表示第一根手指触摸屏幕。这表示交互的开始 case TouchEvent.PRIMARY_POINT_DOWN: currentDragX = (int) downScreenPoint.getX(); currentDragY = (int) downScreenPoint.getY(); //获取指针索引相对于偏移位置的 x 和 y 坐标。 MmiPoint downPoint = touchEvent.getPointerPosition(touchEvent.getIndex()); scrollViewTop = (int) downScreenPoint.getY() - (int) downPoint.getY(); scrollViewLeft = (int) downScreenPoint.getX() - (int) downPoint.getX(); return true; //表示最后一个手指从屏幕上抬起。这表示交互结束 case TouchEvent.PRIMARY_POINT_UP: //恢复下面grid的描述 changeTableLayoutDownDesc(ResourceTable.String_down_grid_layout_desc_text); case TouchEvent.CANCEL: if (isViewOnDrag) { selectedView.setScale(1.0f, 1.0f); selectedView.setAlpha(1.0f); selectedView.setVisibility(Component.VISIBLE); isViewOnDrag = false; isScroll = false; return true; } break; //表示手指在屏幕上移动 case TouchEvent.POINT_MOVE: if (!isViewOnDrag) { break; } int pointX = (int) downScreenPoint.getX(); int pointY = (int) downScreenPoint.getY(); this.exchangeItem(pointX, pointY); if (UP_GRID_TAG.equals(selectedView.getTag())) { this.swapItems(pointX, pointY); } this.handleScroll(pointY); return true; } return false; } ); } ``` ## 归纳总结 ### 1.自定义组件在构造函数中传递slice 这样的目的是便于获取页面的其它组件。 ```java Component itemLayout=LayoutScatter.getInstance(slice.getContext()) .parse(ResourceTable.Layout_grid_item, null, false); ``` 需要注意的是slice指代的是页面,但是自定义组件往往是有自己的布局文件的,一般不在slice中,所以不要通过slice获取自定义组件的子组件,获取不到,不过可以通过LayoutScatter获取 ```java //错误的方式 Component gridItem= slice.findComponentById(ResourceTable.Layout_grid_item); //正确的方式 Component gridItem = LayoutScatter.getInstance(context).parse(ResourceTable.Layout_grid_item, null, false); ``` ### 2.单位转换vp2px java组件对象宽高、边距的单位默认时px, 从element中获取的值需要进行单位转换,可以使用AttrHelper.vp2px 将vp转换为px。 ```java if (gridItem.findComponentById(ResourceTable.Id_grid_item_text) instanceof Text) { Text textItem = (Text) gridItem.findComponentById(ResourceTable.Id_grid_item_text); textItem.setText(item.getItemText()); textItem.setTextSize(AttrHelper.fp2px(10, context)); } ``` ### 3.子组件的获取 获取一个组件对象后,可以使用该组件对象的findComponentById方法继续获取内部的子组件 ```java Component gridItem = LayoutScatter.getInstance(context).parse(ResourceTable.Layout_grid_item, null, false); Image imageItem = (Image) gridItem.findComponentById(ResourceTable.Id_grid_item_image); ``` ### 4.TableLayout的使用 TableLayout继承自ComponentContainer,提供用于在带有表格的组件中排列组件的布局。 TableLayout 提供了用于对齐和排列组件的接口,以在带有表格的组件中显示组件。 排列方式、行列数、元件位置均可配置。 例如 removeAllComponents();可以用来清除 ComponentContainer 管理的所有组件,addComponent 用来将组件添加到ComponentContainer 容器中。示例中GridView就是继承自TableLayout。 ```java /** * The setAdapter * * @param adapter adapter * @param longClickedListener longClickedListener */ void setAdapter(GridAdapter adapter, LongClickedListener longClickedListener) { //清除 ComponentContainer 管理的所有组件 removeAllComponents(); //遍历item组件列表 for (int i = 0; i < adapter.getComponentList().size(); i++) { //为组件中的长按事件注册一个监听器(组件被点击并按住) adapter.getComponentList().get(i).setLongClickedListener(longClickedListener); //将组件添加到容器中 addComponent(adapter.getComponentList().get(i)); } } ``` ## 效果展示 示例代码模拟了一下手机控制中心,编辑快捷开关的效果 |原效果|模拟效果| |-|-| |![image.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/c362eba72a004a3896d752987de60df614e988.png?x-oss-process=image/resize,w_331,h_692)|![动画2.gif](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/18c5aea55f50cb0521b243a0278f415bffe0c2.gif?x-oss-process=image/resize,w_331,h_692)| ## 完整代码 文章相关附件可以点击下面的原文链接前往下载 原文链接:https://harmonyos.51cto.com/posts/6257#bkwz
优秀的个人博客,低调大师

scrapy官方文档提供的常见使用问题

Scrapy与BeautifulSoup或lxml相比如何? BeautifulSoup和lxml是用于解析HTML和XML的库。Scrapy是一个用于编写Web爬虫的应用程序框架,可以抓取网站并从中提取数据。 Scrapy提供了一种用于提取数据的内置机制(称为选择器),但如果您觉得使用它们感觉更舒服,则可以轻松使用BeautifulSoup(或lxml)。毕竟,他们只是解析可以从任何Python代码导入和使用的库。 换句话说,将BeautifulSoup(或lxml)与Scrapy进行比较就像将jinja2与Django进行比较一样。 我可以和BeautifulSoup一起使用Scrapy吗? 是的你可以。如所提到的上面,BeautifulSoup可用于在Scrapy回调解析HTML响应。您只需将响应的主体提供给BeautifulSo

优秀的个人博客,低调大师

组复制官方翻译二、Group Replication Background

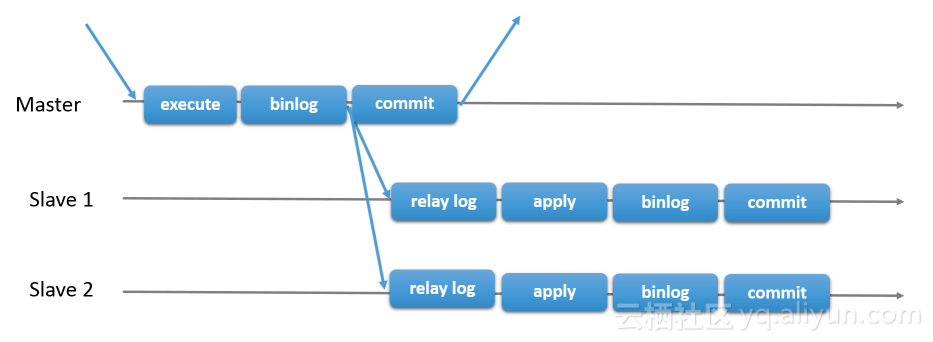
https://dev.mysql.com/doc/refman/8.0/en/group-replication-background.html 这一章主要描述一些组复制的背景 构建一个容错系统最常用的方法就是让组件冗余,换句话说就是组件即便被移除掉,整个系统还是能够正常对外提供服务这无疑在不同层面上提出了更多的挑战需要注意的是,复制结构的数据库系统必须思考的一个事实就是:他们需要维护和管理一堆不同的sever此外,他们还必须解决分布式系统所面临的问题:比如 脑裂、网络分区等等 因此,最大的挑战就是去融合这种逻辑数据库,保证数据复制的一致性换句话说,为了让不同server都同意这个系统的状态,他们每一台server的数据修改都必须验证一致这就意味着他们需要运作的想一个状态机一样(分布式) MySQL Group Replication提供了一套分布式状态机制复制管理方法 对于要提交的事务,这个group采取大部分原则来投票,让事务全局有序决定commit还是拒绝这个事务都是由server自行判断,但是所有servers都会做出一样的决定如果网络产生了分区,脑裂产生导致成员之间无法达成一致投票决定,那么这个系统会停止运行直到这个问题被解决所以,他有一个内置、自动的脑裂包含机制在运行 以上所有的功能都是由Group Communication System (GCS) 协议来保证它有错误检测机制、组成员通信服务、安全可靠的顺序一致消息分发所有这些特性是搭建一个 数据完全一致性的系统 的关键要素在一些非常核心重要的技术点上 罗列了Paxos 算法的实现,它扮演着组复制通信引擎的角色,至关重要 18.1.1 Replication Technologies 在了解MGR内幕之前,这里先主要介绍下相关的背景概念、以及概述这章主要告诉我们,MGR需要什么,以及传统的异步复制和MGR直接的一些区别 18.1.1.1 Primary-Secondary Replication 传统的复制提供了一个简单的主从复制架构(Primary-Secondary)primary就是master,secondary就是slaves,可以有多个slavesmaster执行事务、commit事务,然后异步的将这些事务发送到slaves,让他们re-executed一遍(statement模式)或者 重新applied (ROW模式)它是share-nothing架构,即所有server都有一份完整的数据copy 还有一种传统复制叫:半同步复制它意味着:在commit的之前,master等待,直到slaves给master一个确认接收到事务的ack,master才恢复commit的操作 在上面的两幅图中,你能看到异步传统复制协议的基本架构,箭头代表client消息的流动和转变 18.1.1.2 Group Replication 组复制是一个实现了容错系统的技术组复制集群就是一堆机器,他们之间通过消息进行沟通communication 层:提供了一系列的保障机制,atomic message(原子广播) , total order message delivery(全局序列消息分发机制) MGR在此基础上构建并实现了一个multi-master的复制协议,它可以在任何server上写数据集群的本质就是多server,每个server可以独立的处理事务但是所有的读写(RW)事务都必须经过集群的审核所有的只读(RO)事务不受任何影响换句话说,对于RW事务,group只需要决定它应该commit还是拒绝commit,因此事务操作并不是单方面(origi server)的决定确切的说,当origin server准备进行事务commit的时候,这个server会自动广播这个写集然后,一个全局排序的事务产生了这意味着,所有的server都接收同样顺序的事务集由于是有序的,所有server应用相同顺序,相同数据的写集,因此他们的数据也是一致的 然而,如果是并发写在不同server的场景会遇到冲突因此,对应这种情况需要进行冲突检测,这个过程叫做认证 certification如果两个并发事务在不同server同时执行,并且更新了相同的row,那么他们就是冲突的那么它的解决方案就是,排在前面的事务会被标记commit,排在后面的会被拒绝(这个事务在origin server会回滚,其他server会被丢弃) 最后,MGR也是一种share-nothing架构,每个server都有一份完整的数据copy 18.1.2 Group Replication Use Cases 组复制提供了一个高容错性的系统,即使一些机器宕机,只要不是所有或者大多数机器不可用,那么整个系统还是可用状态总结下来,MGR保证数据库持续可用 18.1.2.1 Examples of Use Case Scenarios 以下就是典型的MGR使用案例 Elastic Replication 可伸缩的复制 Highly Available Shards 高可用的分片 Alternative to Master-Slave replication 可选择master-slave架构 Autonomic Systems 完全自动化的系统 18.1.3 Group Replication Details 18.1.3.1 Failure Detection 它提供一个错误检测机制,可以找到或报告出哪些servers没有回应,哪些server挂了在高一层次来将,错误检测机制就是一个分布式服务,用于提供哪些server挂掉或可能挂掉的情报信息之后,如果组成员通过某种协议认证了这个嫌疑犯(可能挂掉的家伙)已经真的挂了,那么集群就会决定这个嫌疑犯真的的确挂了这意味着,组的其他成员一致决定将这个嫌疑犯踢出集群 当Server A 在指定time-out时间内没有收到来自server B的回应,那么B就会被提升为嫌疑犯如果一个Server被其他group成员隔离,那么它就会怀疑所有其他的成员都挂了由于它不能达成投票的一致性认可(没有达到法定人数的确认),所以它认为的嫌疑犯就不能被确认为failed如果一个Server在这种情况下被隔离,那么他是不能执行local事务的 18.1.3.2 Group Membership MGR依赖组会员服务(Group Membership Service,简称GMS),它是内置的它定义了哪些servers是online并加入了这个group,这些online servers经常被称为view因此,这个组里面的任一online成员都有一个一致的view 如果servers同意让一个新server加入到这个group中来,那么这个group就好重新自动将其配置上,且重新触发形成一个新的view如果一个server非自愿的离开了group,那么错误检测机制就开始识别,也会重新配置上一个新的view上面提到的这些都需要一个协议,并且需要大多数人参与并认可的协议如果这个group没有满足达到这个协议认可的要求,那么自动配置将不会起作用,并且该系统会被阻塞来防止脑裂的产生最后,这意味着管理员需要手动介入来解决这个问题 18.1.3.3 Fault-tolerance MGR 是在Paxos分布式算法构建实现的,以此它需要满足大多数活跃成员进行投票选举的策略。有一个公式:n = 2 x f + 1 , n代表group的成员数,f代表允许挂掉的成员数 ,在这个公式下,整个集群是安全的 如果n=3,那么允许挂掉的server是1,也能满足要求,但是如果再挂一个呢, 其实就问题非常大了 集群成员数量n majority 可允许挂掉的server数量 1 1 0 2 2 0 3 2 1 4 3 1 5 3 2 6 4 2 7 4 3

优秀的个人博客,低调大师

Redisson官方文档 - 10. 额外功能

10.1. 对Redis节点的操作 Redisson的NodesGroup对象提供了许些对Redis节点的操作。 NodesGroup nodesGroup = redisson.getNodesGroup(); nodesGroup.addConnectionListener(new ConnectionListener() { public void onConnect(InetSocketAddress addr) { // Redis节点连接成功 } public void onDisconnect(InetSocketAddress addr) { // Redis节点连接断开 } }); 也可以用来PING单个Redis节点或全部节点。 NodesGroup nodesGroup = redisson.getNodesGroup(); Collection<Node> allNodes = nodesGroup.getNodes(); for (Node n : allNodes) { n.ping(); } // 或者 nodesGroup.pingAll(); 10.2. 复杂多维对象结构和对象引用的支持 Redisson突破了Redis数据结构维度的限制,通过一个特殊引用对象的帮助,Redisson允许以任意的组合方式构建多维度的复杂对象结构,实现了对象之间的类似传统数据库里的关联关系。使用范例如下: RMap<RSet<RList>, RList<RMap>> map = redisson.getMap("myMap"); RSet<RList> set = redisson.getSet("mySet"); RList<RMap> list = redisson.getList("myList"); map.put(set, list); // 在特殊引用对象的帮助下,我们甚至可以构建一个循环引用,这是通过普通序列化方式实现不了的。 set.add(list); list.add(map); 可能您已经注意到了,在map包含的元素发生改变以后,我们无需再次“保存/持久”这些对象。因为map对象所记录的并不是序列化以后的值,而是元素对象的引用。这让Redisson提供的对象在使用方法上,与普通Java对象的使用方法一致。从而让Redis成为内存的一部分,而不仅仅是一个储存空间。 以上范例中,一共创建了三个Redis数据结构:一个Redis HASH,一个Redis SET和一个Redis LIST。 10.3. 命令的批量执行 多个连续命令可以通过RBatch对象在一次网络会话请求里合并发送,这样省去了产生多个请求消耗的时间和资源。这在Redis中叫做管道。 RBatch batch = redisson.createBatch(); batch.getMap("test").fastPutAsync("1", "2"); batch.getMap("test").fastPutAsync("2", "3"); batch.getMap("test").putAsync("2", "5"); batch.getAtomicLongAsync("counter").incrementAndGetAsync(); batch.getAtomicLongAsync("counter").incrementAndGetAsync(); // 原子化(事务)批量执行所有的命令 batch.atomic(); // 告知Redis不用返回结果(可以减少网络用量) batch.skipResult(); // 将写入操作同步到从节点 // 同步到2个从节点,等待时间为1秒钟 batch.syncSlaves(2, 1, TimeUnit.SECONDS) // 处理结果超时为2秒钟 batch.timeout(2, TimeUnit.SECONDS); // 命令重试等待间隔时间为2秒钟 batch.retryInterval(2, TimeUnit.SECONDS); // 命令重试次数,仅适用于未发送成功的命令 batch.retryAttempts(4); BatchResult res = batch.execute(); // 或者 Future<BatchResult> asyncRes = batch.executeAsync(); 在集群模式下,所有的命令会按各个槽所在的节点,筛选分配到各个节点并同时发送。每个节点返回的结果将会汇总到最终的结果列表里。 10.4. 脚本执行 redisson.getBucket("foo").set("bar"); String r = redisson.getScript().eval(Mode.READ_ONLY, "return redis.call('get', 'foo')", RScript.ReturnType.VALUE); // 通过预存的脚本进行同样的操作 RScript s = redisson.getScript(); // 首先将脚本保存到所有的Redis主节点 String res = s.scriptLoad("return redis.call('get', 'foo')"); // 返回值 res == 282297a0228f48cd3fc6a55de6316f31422f5d17 // 再通过SHA值调用脚本 Future<Object> r1 = redisson.getScript().evalShaAsync(Mode.READ_ONLY, "282297a0228f48cd3fc6a55de6316f31422f5d17", RScript.ReturnType.VALUE, Collections.emptyList()); 10.5. 底层Redis客户端 Redisson在底层采用了高性能异步非阻塞式Java客户端,它同时支持异步和同步两种通信模式。如果有哪些命令Redisson还没提供支持,也可以直接通过调用底层Redis客户端来实现。Redisson支持的命令在Redis命令和Redisson对象匹配列表里做了详细对比参照。 // 在使用多个客户端的情况下可以共享同一个EventLoopGroup EventLoopGroup group = new NioEventLoopGroup(); RedisClientConfig config = new RedisClientConfig(); config.setAddress("redis://localhost:6379") // 或者用rediss://使用加密连接 .setPassword("myPassword") .setDatabase(0) .setClientName("myClient") .setGroup(group); RedisClient client = RedisClient.create(config); RedisConnection conn = client.connect(); // 或 RFuture<RedisConnection> connFuture = client.connectAsync(); conn.sync(StringCodec.INSTANCE, RedisCommands.SET, "test", 0); // 或 conn.async(StringCodec.INSTANCE, RedisCommands.GET, "test"); conn.close() // 或 conn.closeAsync() client.shutdown(); // 或 client.shutdownAsync();

优秀的个人博客,低调大师

App开发架构指南(谷歌官方文档译文)

这篇文章面向的是已经掌握app开发基本知识,想知道如何开发健壮app的读者。 注:本指南假设读者对 Android Framework 已经很熟悉。如果你还是app开发的新手,请查看 Getting Started 系列教程,该教程涵盖了本指南的预备知识。 app开发者面临的常见问题 跟传统的桌面应用开发不同,Android app的架构要复杂得多。一个典型的Android app是由多个app组件构成的,包括activity,Fragment,service,content provider以及broadcast receiver。而传统的桌面应用往往在一个庞大的单一的进程中就完成了。 大多数的app组件都声明在app manifest中,Android OS用它来决定如何将你的app与设备整合形成统一的用户体验。虽然就如刚说的,桌面app只运行一个进程,但是一个优秀的Android app却需要更加灵活,因为用户操作在不同app之间,不断的切换流程和任务。 比如,当你要在自己最喜欢的社交网络app中分享一张照片的时候,你可以想象一下会发生什么。app触发一个camera intent,然后Android OS启动一个camera app来处理这一动作。此时用户已经离开了社交网络的app,但是用户的操作体验却是无缝对接的。而 camera app反过来也可能触发另一个intent,比如启动一个文件选择器,这可能会再次打开另一个app。最后用户回到社交网络app并分享照片。在这期间的任意时刻用户都可被电话打断,打完电话之后继续回来分享照片。 在Android中,这种app并行操作的行为是很常见的,因此你的app必须正确处理这些流程。还要记住移动设备的资源是有限的,因此任何时候操作系统都有可能杀死某些app,为新运行的app腾出空间。 总的来说就是,你的app组件可能是单独启动并且是无序的,而且在任何时候都有可能被系统或者用户销毁。因为app组件生命的短暂性以及生命周期的不可控制性,任何数据都不应该把存放在app组件中,同时app组件之间也不应该相互依赖。 通用的架构准则 如果app组件不能存放数据和状态,那么app还是可架构的吗? 最重要的一个原则就是尽量在app中做到separation of concerns(关注点分离)。常见的错误就是把所有代码都写在Activity或者Fragment中。任何跟UI和系统交互无关的事情都不应该放在这些类当中。尽可能让它们保持简单轻量可以避免很多生命周期方面的问题。别忘了能并不拥有这些类,它们只是连接app和操作系统的桥梁。根据用户的操作和其它因素,比如低内存,Android OS可能在任何时候销毁它们。为了提供可靠的用户体验,最好把对它们的依赖最小化。 第二个很重要的准则是用。之所以要持久化是基于两个原因:如果OS销毁app释放资源,用户数据不会丢失;当网络很差或者断网的时候app可以继续工作。Model是负责app数据处理的组件。它们不依赖于View或者app 组件(Activity,Fragment等),因此它们不会受那些组件的生命周期的影响。保持UI代码的简单,于业务逻辑分离可以让它更易管理。 app架构推荐 在这一小节中,我们将通过一个用例演示如何使用Architecture Component构建一个app。 注:没有一种适合所有场景的app编写方式。也就是说,这里推荐的架构适合作为大多数用户案例的开端。但是如果你已经有了一种好的架构,没有必要再去修改。 假设我们在创建一个显示用户简介的UI。用户信息取自我们自己的私有的后端REST API。 创建用户界面 UI由UserProfileFragment.java以及相应的布局文件user_profile_layout.xml组成。 要驱动UI,我们的data model需要持有两个数据元素。 User ID: 用户的身份识别。最好使用fragment argument来传递这个数据。如果OS杀死了你的进程,这个数据可以被保存下来,所以app再次启动的时候id仍是可用的。 User object: 一个持有用户信息数据的POJO对象。 我们将创建一个继承ViewModel类的UserProfileViewModel来保存这一信息。 一个ViewModel为特定的UI组件提供数据,比如fragment 或者 activity,并负责和数据处理的业务逻辑部分通信,比如调用其它组件加载数据或者转发用户的修改。ViewModel并不知道View的存在,也不会被configuration change影响。 现在我们有了三个文件。 user_profile.xml: 定义页面的UI UserProfileViewModel.java: 为UI准备数据的类 UserProfileFragment.java: 显示ViewModel中的数据与响应用户交互的控制器 下面我们开始实现(为简单起见,省略了布局文件): publicclassUserProfileViewModelextendsViewModel{ privateStringuserId; privateUseruser; publicvoidinit(StringuserId){ this.userId=userId; } publicUsergetUser(){ returnuser; } } publicclassUserProfileFragmentextendsLifecycleFragment{ privatestaticfinalStringUID_KEY="uid"; privateUserProfileViewModelviewModel; @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); StringuserId=getArguments().getString(UID_KEY); viewModel=ViewModelProviders.of(this).get(UserProfileViewModel.class); viewModel.init(userId); } @Override publicViewonCreateView(LayoutInflaterinflater, @NullableViewGroupcontainer,@NullableBundlesavedInstanceState){ returninflater.inflate(R.layout.user_profile,container,false); } } 注:上面的例子中继承的是LifecycleFragment而不是Fragment类。等Architecture Component中的lifecycles API稳定之后,Android Support Library中的Fragment类也将实现LifecycleOwner。 现在我们有了这些代码模块,如何连接它们呢?毕竟当ViewModel的user成员设置之后,我们还需要把它显示到界面上。这就要用到LiveData了。 LiveData是一个可观察的数据持有者。 无需明确在它与app组件之间创建依赖就可以观察LiveData对象的变化。LiveData还考虑了app组件(activities, fragments, services)的生命周期状态,做了防止对象泄漏的事情。 注:如果你已经在使用RxJava或者Agera这样的库,你可以继续使用它们,而不使用LiveData。但是使用它们的时候要确保正确的处理生命周期的问题,与之相关的LifecycleOwner stopped的时候数据流要停止,LifecycleOwner destroyed的时候数据流也要销毁。你也可以使用android.arch.lifecycle:reactivestreams让LiveData和其它的响应式数据流库一起使用(比如, RxJava2)。 现在我们把UserProfileViewModel中的User成员替换成LiveData,这样当数据发生变化的时候fragment就会接到通知。LiveData的妙处在于它是有生命周期意识的,当它不再被需要的时候会自动清理引用。 publicclassUserProfileViewModelextendsViewModel{ ... privateUseruser; privateLiveData<User>user; publicLiveData<User>getUser(){ returnuser; } } 现在我们修改UserProfileFragment,让它观察数据并更新UI。 @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); viewModel.getUser().observe(this,user->{ //updateUI }); } 每当User数据更新的时候 onChanged 回调将被触发,然后刷新UI。 如果你熟悉其它library的observable callback的用法,你会意识到我们不需要重写fragment的onStop()方法停止对数据的观察。因为LiveData是有生命周期意识的,也就是说除非fragment处于活动状态,否则callback不会触发。LiveData还可以在fragmentonDestroy()的时候自动移除observer。 对我们也没有做任何特殊的操作来处理 configuration changes(比如旋转屏幕)。ViewModel可以在configuration change的时候自动保存下来,一旦新的fragment进入生命周期,它将收到相同的ViewModel实例,并且携带当前数据的callback将立即被调用。这就是为什么ViewModel不应该直接引用任何View,它们游离在View的生命周期之外。参见ViewModel的生命周期。 获取数据 现在我们把ViewModel和fragment联系了起来,但是ViewModel该如何获取数据呢?在我们的例子中,假设后端提供一个REST API,我们使用Retrofit从后端提取数据。你也可以使用任何其它的library来达到相同的目的。 下面是和后端交互的retrofit Webservice: publicinterfaceWebservice{ /** *@GETdeclaresanHTTPGETrequest *@Path("user")annotationontheuserIdparametermarksitasa *replacementforthe{user}placeholderinthe@GETpath */ @GET("/users/{user}") Call<User>getUser(@Path("user")StringuserId); } ViewModel的一个简单的实现方式是直接调用Webservice获取数据,然后把它赋值给User对象。虽然这样可行,但是随着app的增大会变得难以维护。ViewModel的职责过多也违背了前面提到的关注点分离(separation of concerns)原则。另外,ViewModel的有效时间是和Activity和Fragment的生命周期绑定的,因此当它的生命周期结束便丢失所有数据是一种不好的用户体验。相反,我们的ViewModel将把这个工作代理给Repository模块。 Repository模块负责处理数据方面的操作。它们为app提供一个简洁的API。它们知道从哪里得到数据以及数据更新的时候调用什么API。你可以把它们看成是不同数据源(persistent model, web service, cache, 等等)之间的媒介。 下面的UserRepository类使用了WebService来获取用户数据。 publicclassUserRepository{ privateWebservicewebservice; //... publicLiveData<User>getUser(intuserId){ //Thisisnotanoptimalimplementation,we'llfixitbelow finalMutableLiveData<User>data=newMutableLiveData<>(); webservice.getUser(userId).enqueue(newCallback<User>(){ @Override publicvoidonResponse(Call<User>call,Response<User>response){ //errorcaseisleftoutforbrevity data.setValue(response.body()); } }); returndata; } } 虽然repository模块看起来没什么必要,但它其实演扮演着重要的角色;它把数据源从app中抽象出来。现在我们的ViewModel并不知道数据是由Webservice提供的,意味着有必要的话可以替换成其它的实现方式。 注:为简单起见我们省略了网络错误出现的情况。实现了暴露网络错误和加载状态的版本见下面的Addendum: exposing network status。 管理不同组件间的依赖: 前面的UserRepository类需要Webservice的实例才能完成它的工作。可以直接创建它就是了,但是为此我们还需要知道Webservice所依赖的东西才能构建它。这显著的增减了代码的复杂度和偶合度(比如,每个需要Webservice实例的类都需要知道如何用它的依赖去构建它)。另外,UserRepository很可能不是唯一需要Webservice的类。如果每个类都创建一个新的WebService,就变得很重了。 有两种模式可以解决这个问题: 依赖注入: 依赖注入允许类在无需构造依赖的情况下定义自己的依赖对象。在运行时由另一个类来负责提供这些依赖。在Android app中我们推荐使用谷歌的Dagger 2来实现依赖注入。Dagger 2 通过遍历依赖树自动构建对象,并提供编译时的依赖。 Service Locator:Service Locator 提供一个registry,类可以从这里得到它们的依赖而不是构建它们。相对依赖注入来说要简单些,所以如果你对依赖注入不熟悉,可以使用 Service Locator 。 这些模式允许你扩展自己的代码,因为它们提供了清晰的模式来管理依赖,而不是不断的重复代码。两者均支持替换成mock依赖来测试,这也是使用它们主要优势之一。 在这个例子中,我们将使用 Dagger 2 来管理依赖。 连接ViewModel和repository 现在我们修改UserProfileViewModel以使用repository。 publicclassUserProfileViewModelextendsViewModel{ privateLiveData<User>user; privateUserRepositoryuserRepo; @Inject//UserRepositoryparameterisprovidedbyDagger2 publicUserProfileViewModel(UserRepositoryuserRepo){ this.userRepo=userRepo; } publicvoidinit(StringuserId){ if(this.user!=null){ //ViewModeliscreatedperFragmentso //weknowtheuserIdwon'tchange return; } user=userRepo.getUser(userId); } publicLiveData<User>getUser(){ returnthis.user; } } 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Ack 框架的实现

Storm 的acker使用哈希校验和来跟踪每个 tuple 树的完成情况:每个 tuple 在被发送出的时候,它的值会与校验和进行异或运算,然后在 tuple 被 ack 的时候这个值又会再次与校验和进行异或运算。这样,一旦所有的 tuple 都被成功 ack,校验和就会变为 0(随机生成的校验和为 0 的概率极小,可以忽略不计)。 你可以在wiki中了解更多关于可靠性机制的信息。 ackerexecute() Acker 实际上也是一个 bolt,它的execute 方法是定义在mk-acker-bolt中的。在一个新的 tuple 树生成的时候,spout 为每个 tuple 发送一个用于异或的固有 id,acker 会将这些 id 记录在它的挂起队列中。每次 executor ack 一个 tuple 的时候,acker 会接收到一个部分校验和,这个校验和是 tuple 自身的 id(将其从挂起队列中清除)和 executor 发送的每个下游 tuple 的 id(放入挂起队列中)的异或值。 这个过程是这样的: 在接收到 tick tuple 信号的时候,将 tuple 树的校验值向超时方向移动并且返回。同时,在 tuple 树中更新或者创建一个记录。 初始化阶段:使用指定的校验和值进行初始化,并且记录 spout 的 id; ack 阶段:将部分校验和与当前的校验和进行异或运算; fail 阶段:仅仅将 tuple 标记为 failed 状态。 接下来,将记录存入RotatingMap(重新设置超时计数值)并且继续以下过程: 如果总校验和为 0, 表明 tuple 树已经完成:将记录从挂起队列中移除,并通知 spout 处理成功; 如果 tuple 树失败了,也会有一种完成状态:将记录从挂起队列中移除,并通知 spout 处理失败。 最后,发送一个我们自己的 ack 信号。 挂起 tuples 与RotatingMap Acker 将挂起树存放在一个RotatingMap中。RotatingMap是一个在 Storm 中多处使用的简单工具,它主要用于高效地处理过程的超时。 RotatingMap 与 HashMap 类似,支持 O(1) 时间的 get 操作。 在 RotatingMap 内部有多个 HashMap(称为槽,buckets),每个 HashMap 都保存有一群会在同一时间超时的记录。我们称存在时间最长的 bucket 为死亡牢房(death row),而访问最多的 bucket 称为苗圃(nursery)。一个新的值在被.put()到 RotatingMap 中,它都会被重定位到 nursery 中,并且从其他的它之前可能在的 bucket 中移除(这是一种高效的重新设置延时时间的方法)。 在 RotatingMap 的所有者调用.rotate()方法的时候,RotatingMap 会将每个 bucket 向着超时的方向移动一步(一般 Storm 对象会在收到一个系统 tick 流 tuple 的时候调用 rotate 方法)。如果此时在前面所说的 death row bucket 中有 key-value 键值对,RotatingMap 会为每个 key-value 键值对触发一个回调函数(在构造器中定义的),让他们的所有者选择一个合适的操作(例如,将 tuple 标记为处理 转载自并发编程网 - ifeve.com 失败)。

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 分布式 RPC

分布式 RPC(DRPC)的设计目标是充分利用 Storm 的计算能力实现高密度的并行实时计算。Storm 接收若干个函数参数作为输入流,然后通过 DRPC 输出这些函数调用的结果。严格来说,DRPC 并不能算作是 Storm 的一个特性,因为它只是一种基于 Storm 原语 (Stream、Spout、Bolt、Topology) 实现的计算模式。虽然可以将 DRPC 从 Storm 中打包出来作为一个独立的库,但是与 Storm 集成在一起显然更有用。 概述 DRPC 是通过一个 DRPC 服务端(DRPC server)来实现分布式 RPC 功能的。DRPC server 负责接收 RPC 请求,并将该请求发送到 Storm 中运行的 Topology,等待接收 Topology 发送的处理结果,并将该结果返回给发送请求的客户端。因此,从客户端的角度来说,DPRC 与普通的 RPC 调用并没有什么区别。例如,以下是一个使用参数 “http://twitter.com”调用 “reach” 函数计算结果的例子: DRPCClient client = new DRPCClient("drpc-host", 3772); String result = client.execute("reach", "http://twitter.com"); 下图是 DRPC 的原理示意图。 客户端通过向 DRPC 服务器发送待执行函数的名称以及该函数的参数来获取处理结果。实现该函数的拓扑使用一个DRPCSpout从 DRPC 服务器中接收一个函数调用流。DRPC 服务器会为每个函数调用都标记了一个唯一的 id。随后拓扑会执行函数来计算结果,并在拓扑的最后使用一个名为ReturnResults的 bolt 连接到 DRPC 服务器,根据函数调用的 id 来将函数调用的结果返回。 定义 DRPC 拓扑 可以直接使用普通的拓扑构造方法来构造 DRPC 拓扑,如下所示: public static class ExclaimBolt extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String input = tuple.getString(1); collector.emit(new Values(tuple.getValue(0), input + "!")); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("id", "result")); } } public static void main(String[] args) throws Exception { TopologyBuilder builder = new TopologyBuilder(); // builder.setSpout(drpcSpout); // builder.setBolt(new ExclaimBolt(), 3); // submit(builder.createTopology()); } 本地模式 DRPC DRPC 可以在本地模式下运行。以下是使用本地模式构造拓扑的例子: LocalDRPC drpc = new LocalDRPC(); DRPCSpout spout = new DRPCSpout("exclamation", drpc); builder.setSpout("drpc", spout); builder.setBolt("exclaim", new ExclaimBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 3) .shuffleGrouping("exclaim"); LocalCluster cluster = new LocalCluster(); Config conf = new Config(); cluster.submitTopology("drpc-demo", conf, builder.createTopology()); // local mode 测试代码 System.out.println(drpc.execute("exclamation", "hello")); cluster.shutdown(); drpc.shutdown(); 在这种模式下,首先你会创建一个LocalDPRC对象,该对象会在进程中模拟一个 DRPC 服务器,其作用类似于LocalCluster在进程中模拟 Storm 集群的功能。在定义好拓扑的各个组件之后,就可以使用LocalCluster来提交拓扑。在本地模式下LocalDPRC对象不会绑定到任何一个实际的端口,所以需要通过向DRPCSpout传入参数的方式来关联到拓扑中。 在启动拓扑后,你可以使用execute方法来完成 DRPC 调用。 远程模式 DRPC 在一个实际的集群中使用 DRPC 有以下三个步骤: 配置并启动 DRPC 服务器; 在集群的各个服务器上配置 DRPC 服务器的地址; 将 DRPC 拓扑提交到集群运行。 可以像 Nimbus、Supervisor 那样使用storm命令来启动 DRPC 服务器(注意,此 server 的基本配置,如 nimbus,ZooKeeper 等参数应该与 Storm 集群其他机器相同): bin/storm drpc 接下来,你需要在集群的各个服务器上配置 DRPC 服务器的地址。这是为了让DRPCSpout了解从哪里获取函数调用的方法。可以通过编辑storm.yaml或者添加拓扑配置的方式实现配置。配置storm.yaml的方式类似于下面这样: drpc.servers: - "drpc1.foo.com" - "drpc2.foo.com" 最后,你可以像其他拓扑一样使用StormSubmitter来启动拓扑。 以下是使用远程模式构造拓扑的一个例子: TopologyBuilder builder = new TopologyBuilder(); DRPCSpout spout = new DRPCSpout("exclamation"); builder.setSpout("drpc", spout, 3); builder.setBolt("exclaim", new ExclamationBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 7) .shuffleGrouping("exclaim"); Config conf = new Config(); conf.setNumWorkers(2); StormSubmitter.submitTopology("drpc-demo", conf, builder.createTopology()); 更复杂的例子 请参考Trident 教程一文中计算指定 URL 的 Reach 数的例子。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 命令行操作

本文介绍了 Storm 命令行客户端中的所有命令操作。如果想要了解怎样设置你的 Strom 客户端和远程集群的交互,请按照配置开发环境一文中的步骤操作。 Storm 中支持的命令包括: jar kill activate deactivate rebalance repl classpath localconfvalue remoteconfvalue nimbus supervisor ui drpc jar 语法:storm jar topology-jar-path class ... 使用指定的参数运行 main 方法(也就是打包好的拓扑 jar 包中的 main 方法)。Storm 所需要的 jar 包和配置信息都在类路径(classpath)中。这个运行过程已经配置好了,这样StormSubmitter就可以在提交拓扑的时候将topology-jar-path中的 jar 包上传到集群中。 kill 语法:storm kill topology-name [-w wait-time-secs] 杀死集群中正在运行的名为topology-name的拓扑。执行该操作后,Storm 首先会注销拓扑中的 spout,使得拓扑中的消息超时,这样当前的所有消息就会结束执行。随后,Storm 会将所有的 worker 关闭,并清除他们的状态。你可以使用-w参数来调整 Storm 在注销与关闭拓扑之间的间隔时间。 activate 语法:storm activate topology-name 激活运行指定拓扑的所有 spout。 deactivate 语法:storm deactivate topology-name 停止指定拓扑的所有 spout 的运行。 rebalance 语法:storm rebalance topology-name [-w wait-time-secs] 有些场景下需要对正在运行的拓扑的工作进程(worker)进行弹性扩展。例如,加入你有 10 个节点,每个节点上运行有 4 个 worker,现在由于各种原因你需要为集群添加 10 个新节点。这时你就会希望通过扩展正在运行的拓扑的 worker 来使得每个节点只运行两个 worker,降低集群的负载。实现这个目的的一种直接的办法是 kill 掉正在运行的拓扑,然后重新向集群提交。不过 Storm 提供了再平衡命令可以以一种更简单的方法实现目的。 再平衡首先会在一个超时时间内(这个时间是可以通过-w参数配置的)注销掉拓扑,然后在整个集群中重新分配 worker。接着拓扑就会自动回到之前的状态(也就是说之前处于注销状态的拓扑仍然会保持注销状态,而处于激活状态的拓扑则会返回激活状态)。 repl 语法:storm repl 打开一个带有类路径上的 jar 包和配置信息的 Clojure 的交互式解释器(REPL)。该命令主要用于调试。 classpath 语法:storm classpath 打印客户端执行命令时使用的类路径环境变量。 localconfvalue 语法:storm localconfvalue conf-name 打印出本地 Storm 配置中conf-name属性的值。这里的本地配置指的是~/.storm/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。 remoteconfvalue 语法:storm remoteconfvalue conf-name 打印出集群配置中conf-name属性的值。这里的集群配置指的是$STORM-PATH/conf/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。该命令必须在一个集群机器上执行。 nimbus 语法:storm nimbus 启动 nimbus 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 supervisor 语法:storm supervisor 启动 supervisor 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 ui 语法:storm ui 启动 UI 后台进程。UI 提供了一个访问 Storm 集群的 Web 接口,其中包含有运行中的拓扑的详细信息。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 drpc 语法:storm drpc 启动 DRPC 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考分布式 RPC一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Adopt Open JDK官方文档(五) Docker镜像

5.1 复制镜像 镜像可以从别的设备复制并导入本地的Docker仓库。 保存镜像的命令为: docker save -o <save image to path> <image name> 或者 docker save <image name> > <save image to path> 保存镜像示例 docker save -o base-image-openjdk9.tar neomatrix369/openjdk9-base-image:latest 或者 docker save neomatrix369/openjdk9-base-image:latest > openjdk9-base-image.tar 或者 docker save neomatrix369/openjdk9-base-image:latest | gzip > openjdk9-base-image.tar.gz openjdk9-base-image.tar 和 openjdk9-base-image.tar.gz 的镜像已默认保存至Docker仓库。 加载镜像的命令为 docker load -i <path to image tar file> 或者 docker load < <path to image tar file> 加载镜像示例 docker load -i openjdk9-base-image.tar 或者 docker load < openjdk9-base-image.tar 或者 docker load < gzip < openjdk9-base-image.tar.gz 5.2 创建镜像 提示:在之前的介绍章节中,已经给出了Docker在相关平台使用的介绍。 在Linux,MacOS,Windows平台创建OpenJDK9 docker镜像的详细步骤如下: Why not build #OpenJDK 9 using #Docker ? – Part 1 of 2 Why not build #OpenJDK 9 using #Docker ? – Part 2 of 2 5.3 检查镜像 提示:这一步针对的OpenJDK镜像,是已经创建好的或者从别处导入至本地的Docker仓库的。 不同的操作系统启动docker的方法也不相同,在Mac和Windows平台,通常通过命令boot2docker启动docker,Linux系统在启动时会自动加载。 在docker启动之后运行命令: $ docker images 会得到如下输出: REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE neomatrix369/openjdk9 latest 5877e8efd939 4 days ago 5.82 GB neomatrix369/full-image-openjdk9 latest 32b0a686e93b 4 days ago 5.82 GB neomatrix369/base-image-openjdk9 latest ce63b2673e6a 4 days ago 781.7 MB phusion/baseimage latest 5a14c1498ff4 4 months ago 279.7 MB 继续执行如下命令: $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 /bin/bash 这一步是跳转到docker容器中执行bash shell命令 $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 java -version 这一步会运行java命令(需要事先配置好java环境变量,通过PATH或者JAVA_HOME可以找到java命令)获取如下信息: openjdk version "1.9.0-internal" OpenJDK Runtime Environment (build 1.9.0-internal-_2015_06_04_06_46-b00) OpenJDK 64-Bit Server VM (build 1.9.0-internal-_2015_06_04_06_46-b00, mixed mode) 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》机器学习库(MLlib)指南

机器学习库(MLlib)指南 MLlib是Spark的机器学习(ML)库。旨在简化机器学习的工程实践工作,并方便扩展到更大规模。MLlib由一些通用的学习算法和工具组成,包括分类、回归、聚类、协同过滤、降维等,同时还包括底层的优化原语和高层的管道API。 MLllib目前分为两个代码包: spark.mllib包含基于RDD的原始算法API。 spark.ml则提供了基于DataFrames高层次的API,可以用来构建机器学习管道。 我们推荐您使用spark.ml,因为基于DataFrames的API更加的通用而且灵活。不过我们也会继续支持spark.mllib包。用户可以放心使用,spark.mllib还会持续地增加新的功能。不过开发者需要注意,如果新的算法能够适用于机器学习管道的概念,就应该将其放到spark.ml包中,如:特征提取器和转换器。 下面的列表列出了两个包的主要功能。 spark.mllib: 数据类型,算法以及工具 Data types(数据类型) Basic statistics(基础统计) summary statistics(摘要统计) correlations(相关性) stratified sampling(分层抽样) hypothesis testing(假设检验) streaming significance testing random data generation(随机数据生成) Classification and regression(分类和回归) linear models (SVMs, logistic regression, linear regression)(线性模型(SVM,逻辑回归,线性回归)) naive Bayes(朴素贝叶斯) decision trees(决策树) ensembles of trees (Random Forests and Gradient-Boosted Trees)(树套装(随机森林和梯度提升决策树)) isotonic regression(保序回归) Collaborative filtering(协同过滤) alternating least squares (ALS)(交替最小二乘(ALS)) Clustering(聚类) k-means(K-均值) Gaussian mixture(高斯混合) power iteration clustering (PIC)(幂迭代聚类(PIC)) latent Dirichlet allocation (LDA)(隐含狄利克雷分配) bisecting k-means(平分K-均值) streaming k-means(流式K-均值) Dimensionality reduction(降维) singular value decomposition (SVD)(奇异值分解(SVD)) principal component analysis (PCA)(主成分分析(PCA)) Feature extraction and transformation(特征抽取和转换) Frequent pattern mining(频繁模式挖掘) FP-growth(FP-增长) association rules(关联规则) PrefixSpan(PrefixSpan) Evaluation metrics(评价指标) PMML model export(PMML模型导出) Optimization (developer)(优化(开发者)) stochastic gradient descent(随机梯度下降) limited-memory BFGS (L-BFGS)(有限的记忆BFGS(L-BFGS)) spark.ml: 机器学习管道高级API Overview: estimators, transformers and pipelines(概览:评估器,转换器和管道) Extracting, transforming and selecting features(抽取,转换和选取特征) Classification and regression(分类和回归) Clustering(聚类) Advanced topics(高级主题) 虽然还有些降维技术在spark.ml中尚不可用,不过用户可以将spark.mllib中的的相关实现和spark.ml中的算法无缝地结合起来。 依赖项 MLlib使用的线性代数代码包是Breeze,而Breeze又依赖于netlib-java优化的数值处理。如果在运行时环境中这些原生库不可用,你将会收到一条警告,而后spark会使用纯JVM实现来替代之。 由于许可限制的原因,spark在默认情况下不会包含netlib-java的原生代理库。如果需要配置netlib-java/Breeze使用其系统优化库,你需要添加依赖项:com.github.fommil.netlib:all:1.1.2(或者在编译时加上参数:-Pnetlib-lgpl),然后再看一看netlib-java相应的安装文档。 要使用MLlib的Python接口,你需要安装NumPy1.4以上的版本。 迁移指南 MLlib目前还在积极的开发当中。所以标记为 Experimental / DeveloperApi 的接口可能在未来发生变化,下面的迁移指南说明了版本升级后的变化。 从1.5升级到1.6 从1.5到1.6,spark.mllib 和 spark.ml 包中并没有重大的API变化,不过有一些行为不再支持或者发生变化。 已经废弃: SPARK-11358: spark.mllib.clustering.KMeans 的runs参数已经废弃 SPARK-10592: spark.ml.classification.LogisticRegressionModel和spark.ml.regresion.LinearRegressionModel 中,weights字段改名为coefficients。这一变动有助于消除歧义,可以和输入给算法的实例(行)权重(weights)区分开来。 行为有变: SPARK-7770:spark.mllib.tree.GradientBoostedTrees:validationTol的语义在1.6中有变。原先其代表误差变化绝对值的一个阈值,而现在它类似于GradientDescent中的convergenceTol:对于较大的误差,使用相对误差(相对于上一次);而对于较小的误差(<0.01),使用绝对误差。 SPARK-11069:spark.ml.feature.RegexTokenizer:以前,在分词之前不会讲字符串转小写。现在的实现是,默认会将字符串转小写,不过有选项可以设为不转。这中实现和Tokenizertransformer的行为相匹配。 Spark老版本 以前版本的迁移指南归档在这里:on this page 要了解更多有关系统优化的好处和背景资料,可以看看Sam Halliday关于ScalaX的演讲:High Performance Linear Algebra in Scala 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》Spark Streaming编程指南(二)

累加器和广播变量 首先需要注意的是,累加器(Accumulators)和广播变量(Broadcast variables)是无法从Spark Streaming的检查点中恢复回来的。所以如果你开启了检查点功能,并同时在使用累加器和广播变量,那么你最好是使用懒惰实例化的单例模式,因为这样累加器和广播变量才能在驱动器(driver)故障恢复后重新实例化。代码示例如下: Scala Java Python object WordBlacklist { @volatile private var instance: Broadcast[Seq[String]] = null def getInstance(sc: SparkContext): Broadcast[Seq[String]] = { if (instance == null) { synchronized { if (instance == null) { val wordBlacklist = Seq("a", "b", "c") instance = sc.broadcast(wordBlacklist) } } } instance } } object DroppedWordsCounter { @volatile private var instance: Accumulator[Long] = null def getInstance(sc: SparkContext): Accumulator[Long] = { if (instance == null) { synchronized { if (instance == null) { instance = sc.accumulator(0L, "WordsInBlacklistCounter") } } } instance } } wordCounts.foreachRDD((rdd: RDD[(String, Int)], time: Time) => { // 获取现有或注册新的blacklist广播变量 val blacklist = WordBlacklist.getInstance(rdd.sparkContext) // 获取现有或注册新的 droppedWordsCounter 累加器 val droppedWordsCounter = DroppedWordsCounter.getInstance(rdd.sparkContext) // 基于blacklist来过滤词,并将过滤掉的词的个数累加到 droppedWordsCounter 中 val counts = rdd.filter { case (word, count) => if (blacklist.value.contains(word)) { droppedWordsCounter += count false } else { true } }.collect() val output = "Counts at time " + time + " " + counts }) 这里有完整代码:source code。 DataFrame和SQL相关算子 在Streaming应用中可以调用DataFrames and SQL来处理流式数据。开发者可以用通过StreamingContext中的SparkContext对象来创建一个SQLContext,并且,开发者需要确保一旦驱动器(driver)故障恢复后,该SQLContext对象能重新创建出来。同样,你还是可以使用懒惰创建的单例模式来实例化SQLContext,如下面的代码所示,这里我们将最开始的那个小栗子做了一些修改,使用DataFrame和SQL来统计单词计数。其实就是,将每个RDD都转化成一个DataFrame,然后注册成临时表,再用SQL查询这些临时表。 Scala Java Python /** streaming应用中调用DataFrame算子 */ val words: DStream[String] = ... words.foreachRDD { rdd => // 获得SQLContext单例 val sqlContext = SQLContext.getOrCreate(rdd.sparkContext) import sqlContext.implicits._ // 将RDD[String] 转为 DataFrame val wordsDataFrame = rdd.toDF("word") // DataFrame注册为临时表 wordsDataFrame.registerTempTable("words") // 再用SQL语句查询,并打印出来 val wordCountsDataFrame = sqlContext.sql("select word, count(*) as total from words group by word") wordCountsDataFrame.show() } See the fullsource code. 这里有完整代码:source code。 你也可以在其他线程里执行SQL查询(异步查询,即:执行SQL查询的线程和运行StreamingContext的线程不同)。不过这种情况下,你需要确保查询的时候 StreamingContext 没有把所需的数据丢弃掉,否则StreamingContext有可能已将老的RDD数据丢弃掉了,那么异步查询的SQL语句也可能无法得到查询结果。举个栗子,如果你需要查询上一个批次的数据,但是你的SQL查询可能要执行5分钟,那么你就需要StreamingContext至少保留最近5分钟的数据:streamingContext.remember(Minutes(5)) (这是Scala为例,其他语言差不多) 更多DataFrame和SQL的文档见这里:DataFrames and SQL MLlib算子 MLlib提供了很多机器学习算法。首先,你需要关注的是流式计算相关的机器学习算法(如:Streaming Linear Regression,Streaming KMeans),这些流式算法可以在流式数据上一边学习训练模型,一边用最新的模型处理数据。除此以外,对更多的机器学习算法而言,你需要离线训练这些模型,然后将训练好的模型用于在线的流式数据。详见MLlib。 缓存/持久化 和RDD类似,DStream也支持将数据持久化到内存中。只需要调用 DStream的persist() 方法,该方法内部会自动调用DStream中每个RDD的persist方法进而将数据持久化到内存中。这对于可能需要计算很多次的DStream非常有用(例如:对于同一个批数据调用多个算子)。对于基于滑动窗口的算子,如:reduceByWindow和reduceByKeyAndWindow,或者有状态的算子,如:updateStateByKey,数据持久化就更重要了。因此,滑动窗口算子产生的DStream对象默认会自动持久化到内存中(不需要开发者调用persist)。 对于从网络接收数据的输入数据流(如:Kafka、Flume、socket等),默认的持久化级别会将数据持久化到两个不同的节点上互为备份副本,以便支持容错。 注意,与RDD不同的是,DStream的默认持久化级别是将数据序列化到内存中。进一步的讨论见性能调优这一小节。关于持久化级别(或者存储级别)的更详细说明见Spark编程指南(Spark Programming Guide)。 检查点 一般来说Streaming 应用都需要7*24小时长期运行,所以必须对一些与业务逻辑无关的故障有很好的容错(如:系统故障、JVM崩溃等)。对于这些可能性,Spark Streaming 必须在检查点保存足够的信息到一些可容错的外部存储系统中,以便能够随时从故障中恢复回来。所以,检查点需要保存以下两种数据: 元数据检查点(Metadata checkpointing)– 保存流式计算逻辑的定义信息到外部可容错存储系统(如:HDFS)。主要用途是用于在故障后回复应用程序本身(后续详谈)。元数包括: Configuration– 创建Streaming应用程序的配置信息。 DStream operations– 定义流式处理逻辑的DStream操作信息。 Incomplete batches– 已经排队但未处理完的批次信息。 数据检查点(Data checkpointing)– 将生成的RDD保存到可靠的存储中。这对一些需要跨批次组合数据或者有状态的算子来说很有必要。在这种转换算子中,往往新生成的RDD是依赖于前几个批次的RDD,因此随着时间的推移,有可能产生很长的依赖链条。为了避免在恢复数据的时候需要恢复整个依赖链条上所有的数据,检查点需要周期性地保存一些中间RDD状态信息,以斩断无限制增长的依赖链条和恢复时间。 总之,元数据检查点主要是为了恢复驱动器节点上的故障,而数据或RDD检查点是为了支持对有状态转换操作的恢复。 何时启用检查点 如果有以下情况出现,你就必须启用检查点了: 使用了有状态的转换算子(Usage of stateful transformations)– 不管是用了 updateStateByKey 还是用了 reduceByKeyAndWindow(有”反归约”函数的那个版本),你都必须配置检查点目录来周期性地保存RDD检查点。 支持驱动器故障中恢复(Recovering from failures of the driver running the application)– 这时候需要元数据检查点以便恢复流式处理的进度信息。 注意,一些简单的流式应用,如果没有用到前面所说的有状态转换算子,则完全可以不开启检查点。不过这样的话,驱动器(driver)故障恢复后,有可能会丢失部分数据(有些已经接收但还未处理的数据可能会丢失)。不过通常这点丢失时可接受的,很多Spark Streaming应用也是这样运行的。对非Hadoop环境的支持未来还会继续改进。 如何配置检查点 检查点的启用,只需要设置好保存检查点信息的检查点目录即可,一般会会将这个目录设为一些可容错的、可靠性较高的文件系统(如:HDFS、S3等)。开发者只需要调用 streamingContext.checkpoint(checkpointDirectory)。设置好检查点,你就可以使用前面提到的有状态转换算子了。另外,如果你需要你的应用能够支持从驱动器故障中恢复,你可能需要重写部分代码,实现以下行为: 如果程序是首次启动,就需要new一个新的StreamingContext,并定义好所有的数据流处理,然后调用StreamingContext.start()。 如果程序是故障后重启,就需要从检查点目录中的数据中重新构建StreamingContext对象。 Scala Java Python 不过这个行为可以用StreamingContext.getOrCreate来实现,示例如下: // 首次创建StreamingContext并定义好数据流处理逻辑 def functionToCreateContext(): StreamingContext = { val ssc = new StreamingContext(...) // 新建一个StreamingContext对象 val lines = ssc.socketTextStream(...) // 创建DStreams ... ssc.checkpoint(checkpointDirectory) // 设置好检查点目录 ssc } // 创建新的StreamingContext对象,或者从检查点构造一个 val context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext _) // 无论是否是首次启动都需要设置的工作在这里 context. ... // 启动StreamingContext对象 context.start() context.awaitTermination() 如果 checkpointDirectory 目录存在,则context对象会从检查点数据重新构建出来。如果该目录不存在(如:首次运行),则 functionToCreateContext 函数会被调用,创建一个新的StreamingContext对象并定义好DStream数据流。完整的示例请参见RecoverableNetworkWordCount,这个例子会将网络数据中的单词计数统计结果添加到一个文件中。 除了使用getOrCreate之外,开发者还需要确保驱动器进程能在故障后重启。这一点只能由应用的部署环境基础设施来保证。进一步的讨论见部署(Deployment)这一节。 另外需要注意的是,RDD检查点会增加额外的保存数据的开销。这可能会导致数据流的处理时间变长。因此,你必须仔细的调整检查点间隔时间。如果批次间隔太小(比如:1秒),那么对每个批次保存检查点数据将大大减小吞吐量。另一方面,检查点保存过于频繁又会导致血统信息和任务个数的增加,这同样会影响系统性能。对于需要RDD检查点的有状态转换算子,默认的间隔是批次间隔的整数倍,且最小10秒。开发人员可以这样来自定义这个间隔:dstream.checkpoint(checkpointInterval)。一般推荐设为批次间隔时间的5~10倍。 部署应用 本节中将主要讨论一下如何部署Spark Streaming应用。 前提条件 要运行一个Spark Streaming 应用,你首先需要具备以下条件: 集群以及集群管理器 – 这是一般Spark应用的基本要求,详见deployment guide。 给Spark应用打个JAR包 – 你需要将你的应用打成一个JAR包。如果使用spark-submit提交应用,那么你不需要提供Spark和Spark Streaming的相关JAR包。但是,如果你使用了高级数据源(advanced sources– 如:Kafka、Flume、Twitter等),那么你需要将这些高级数据源相关的JAR包及其依赖一起打包并部署。例如,如果你使用了TwitterUtils,那么就必须将spark-streaming-twitter_2.10及其相关依赖都打到应用的JAR包中。 为执行器(executor)预留足够的内存 – 执行器必须配置预留好足够的内存,因为接受到的数据都得存在内存里。注意,如果某些窗口长度达到10分钟,那也就是说你的系统必须知道保留10分钟的数据在内存里。可见,到底预留多少内存是取决于你的应用处理逻辑的。 配置检查点 – 如果你的流式应用需要检查点,那么你需要配置一个Hadoop API兼容的可容错存储目录作为检查点目录,流式应用的信息会写入这个目录,故障恢复时会用到这个目录下的数据。详见前面的检查点小节。 配置驱动程序自动重启 – 流式应用自动恢复的前提就是,部署基础设施能够监控驱动器进程,并且能够在其故障时,自动重启之。不同的集群管理器有不同的工具来实现这一功能: Spark独立部署 – Spark独立部署集群可以支持将Spark应用的驱动器提交到集群的某个worker节点上运行。同时,Spark的集群管理器可以对该驱动器进程进行监控,一旦驱动器退出且返回非0值,或者因worker节点原始失败,Spark集群管理器将自动重启这个驱动器。详见Spark独立部署指南(Spark Standalone guide)。 YARN – YARN支持和独立部署类似的重启机制。详细请参考YARN的文档。 Mesos – Mesos上需要用Marathon来实现这一功能。 配置WAL(write ahead log)- 从Spark 1.2起,我们引入了write ahead log来提高容错性。如果启用这个功能,则所有接收到的数据都会以write ahead log形式写入配置好的检查点目录中。这样就能确保数据零丢失(容错语义有详细的讨论)。用户只需将 spark.streaming.receiver.writeAheadLog 设为true。不过,这同样可能会导致接收器的吞吐量下降。不过你可以启动多个接收器并行接收数据,从而提升整体的吞吐量(more receivers in parallel)。另外,建议在启用WAL后禁用掉接收数据多副本功能,因为WAL其实已经是存储在一个多副本存储系统中了。你只需要把存储级别设为 StorageLevel.MEMORY_AND_DISK_SER。如果是使用S3(或者其他不支持flushing的文件系统)存储WAL,一定要记得启用这两个标识:spark.streaming.driver.writeAheadLog.closeFileAfterWrite 和 spark.streaming.receiver.writeAheadLog.closeFileAfterWrite。更详细请参考:Spark Streaming Configuration。 设置好最大接收速率 – 如果集群可用资源不足以跟上接收数据的速度,那么可以在接收器设置一下最大接收速率,即:每秒接收记录的条数。相关的主要配置有:spark.streaming.receiver.maxRate,如果使用Kafka Direct API 还需要设置 spark.streaming.kafka.maxRatePerPartition。从Spark 1.5起,我们引入了backpressure的概念来动态地根据集群处理速度,评估并调整该接收速率。用户只需将 spark.streaming.backpressure.enabled设为true即可启用该功能。 升级应用代码 升级Spark Streaming应用程序代码,可以使用以下两种方式: 新的Streaming程序和老的并行跑一段时间,新程序完成初始化以后,再关闭老的。注意,这种方式适用于能同时发送数据到多个目标的数据源(即:数据源同时将数据发给新老两个Streaming应用程序)。 老程序能够优雅地退出(参考StreamingContext.stop(...)orJavaStreamingContext.stop(...)),即:确保所收到的数据都已经处理完毕后再退出。然后再启动新的Streaming程序,而新程序将接着在老程序退出点上继续拉取数据。注意,这种方式需要数据源支持数据缓存(或者叫数据堆积,如:Kafka、Flume),因为在新旧程序交接的这个空档时间,数据需要在数据源处缓存。目前还不能支持从检查点重启,因为检查点存储的信息包含老程序中的序列化对象信息,在新程序中将其反序列化可能会出错。这种情况下,只能要么指定一个新的检查点目录,要么删除老的检查点目录。 应用监控 除了Spark自身的监控能力(monitoring capabilities)之外,对Spark Streaming还有一些额外的监控功能可用。如果实例化了StreamingContext,那么你可以在Spark web UI上看到多出了一个Streaming tab页,上面显示了正在运行的接收器(是否活跃,接收记录的条数,失败信息等)和处理完的批次信息(批次处理时间,查询延时等)。这些信息都可以用来监控streaming应用。 web UI上有两个度量特别重要: 批次处理耗时(Processing Time)– 处理单个批次耗时 批次调度延时(Scheduling Delay)-各批次在队列中等待时间(等待上一个批次处理完) 如果批次处理耗时一直比批次间隔时间大,或者批次调度延时持续上升,就意味着系统处理速度跟不上数据接收速度。这时候你就得考虑一下怎么把批次处理时间降下来(reducing)。 Spark Streaming程序的处理进度可以用StreamingListener接口来监听,这个接口可以监听到接收器的状态和处理时间。不过需要注意的是,这是一个developer API接口,换句话说这个接口未来很可能会变动(可能会增加更多度量信息)。 性能调优 要获得Spark Streaming应用的最佳性能需要一点点调优工作。本节将深入解释一些能够改进Streaming应用性能的配置和参数。总体上来说,你需要考虑这两方面的事情: 提高集群资源利用率,减少单批次处理耗时。 设置合适的批次大小,以便使数据处理速度能跟上数据接收速度。 减少批次处理时间 有不少优化手段都可以减少Spark对每个批次的处理时间。细节将在优化指南(Tuning Guide)中详谈。这里仅列举一些最重要的。 数据接收并发度 跨网络接收数据(如:从Kafka、Flume、socket等接收数据)需要在Spark中序列化并存储数据。 如果接收数据的过程是系统瓶颈,那么可以考虑增加数据接收的并行度。注意,每个输入DStream只包含一个单独的接收器(receiver,运行约worker节点),每个接收器单独接收一路数据流。所以,配置多个输入DStream就能从数据源的不同分区分别接收多个数据流。例如,可以将从Kafka拉取两个topic的数据流分成两个Kafka输入数据流,每个数据流拉取其中一个topic的数据,这样一来会同时有两个接收器并行地接收数据,因而增加了总体的吞吐量。同时,另一方面我们又可以把这些DStream数据流合并成一个,然后可以在合并后的DStream上使用任何可用的transformation算子。示例代码如下: Scala Java Python val numStreams = 5 val kafkaStreams = (1 to numStreams).map { i => KafkaUtils.createStream(...) } val unifiedStream = streamingContext.union(kafkaStreams) unifiedStream.print() 另一个可以考虑优化的参数就是接收器的阻塞间隔,该参数由配置参数(configuration parameter)spark.streaming.blockInterval决定。大多数接收器都会将数据合并成一个个数据块,然后再保存到spark内存中。对于map类算子来说,每个批次中数据块的个数将会决定处理这批数据并行任务的个数,每个接收器每批次数据处理任务数约等于 (批次间隔 / 数据块间隔)。例如,对于2秒的批次间隔,如果数据块间隔为200ms,则创建的并发任务数为10。如果任务数太少(少于单机cpu core个数),则资源利用不够充分。如需增加这个任务数,对于给定的批次间隔来说,只需要减少数据块间隔即可。不过,我们还是建议数据块间隔至少要50ms,否则任务的启动开销占比就太高了。 另一个切分接收数据流的方法是,显示地将输入数据流划分为多个分区(使用 inputStream.repartition(<number of partitions>))。该操作会在处理前,将数据散开重新分发到集群中多个节点上。 数据处理并发度 在计算各个阶段(stage)中,任何一个阶段的并发任务数不足都有可能造成集群资源利用率低。例如,对于reduce类的算子,如:reduceByKey 和 reduceByKeyAndWindow,其默认的并发任务数是由 spark.default.parallelism 决定的。你既可以修改这个默认值(spark.default.parallelism),也可以通过参数指定这个并发数量(见PairDStreamFunctions)。 数据序列化 调整数据的序列化格式可以大大减少数据序列化的开销。在spark Streaming中主要有两种类型的数据需要序列化: 输入数据: 默认地,接收器收到的数据是以StorageLevel.MEMORY_AND_DISK_SER_2的存储级别存储到执行器(executor)内存中的。也就是说,收到的数据会被序列化以减少GC开销,同时保存两个副本以容错。同时,数据会优先保存在内存里,当内存不足时才吐出到磁盘上。很明显,这个过程中会有数据序列化的开销 – 接收器首先将收到的数据反序列化,然后再以spark所配置指定的格式来序列化数据。 Streaming算子所生产的持久化的RDDs: Streaming计算所生成的RDD可能会持久化到内存中。例如,基于窗口的算子会将数据持久化到内存,因为窗口数据可能会多次处理。所不同的是,spark core默认用StorageLevel.MEMORY_ONLY级别持久化RDD数据,而spark streaming默认使用StorageLevel.MEMORY_ONLY_SER级别持久化接收到的数据,以便尽量减少GC开销。 不管是上面哪一种数据,都可以使用Kryo序列化来减少CPU和内存开销,详见Spark Tuning Guide。另,对于Kryo,你可以考虑这些优化:注册自定义类型,禁用对象引用跟踪(详见Configuration Guide)。 在一些特定的场景下,如果数据量不是很大,那么你可以考虑不用序列化格式,不过你需要注意的是取消序列化是否会导致大量的GC开销。例如,如果你的批次间隔比较短(几秒)并且没有使用基于窗口的算子,这种情况下你可以考虑禁用序列化格式。这样可以减少序列化的CPU开销以优化性能,同时GC的增长也不多。 任务启动开销 如果每秒启动的任务数过多(比如每秒50个以上),那么将任务发送给slave节点的开销会明显增加,那么你也就很难达到亚秒级(sub-second)的延迟。不过以下两个方法可以减少任务的启动开销: 任务序列化(Task Serialization): 使用Kryo来序列化任务,以减少任务本身的大小,从而提高发送任务的速度。任务的序列化格式是由 spark.closure.serializer 属性决定的。不过,目前还不支持闭包序列化,未来的版本可能会增加对此的支持。 执行模式(Execution mode): Spark独立部署或者Mesos粗粒度模式下任务的启动时间比Mesos细粒度模式下的任务启动时间要短。详见Running on Mesos guide。 这些调整有可能能够减少100ms的批次处理时间,这也使得亚秒级的批次间隔成为可能。 设置合适的批次间隔 要想streaming应用在集群上稳定运行,那么系统处理数据的速度必须能跟上其接收数据的速度。换句话说,批次数据的处理速度应该和其生成速度一样快。对于特定的应用来说,可以从其对应的监控(monitoring)页面上观察验证,页面上显示的处理耗时应该要小于批次间隔时间。 根据spark streaming计算的性质,在一定的集群资源限制下,批次间隔的值会极大地影响系统的数据处理能力。例如,在WordCountNetwork示例中,对于特定的数据速率,一个系统可能能够在批次间隔为2秒时跟上数据接收速度,但如果把批次间隔改为500毫秒系统可能就处理不过来了。所以,批次间隔需要谨慎设置,以确保生产系统能够处理得过来。 要找出适合的批次间隔,你可以从一个比较保守的批次间隔值(如5~10秒)开始测试。要验证系统是否能跟上当前的数据接收速率,你可能需要检查一下端到端的批次处理延迟(可以看看Spark驱动器log4j日志中的Total delay,也可以用StreamingListener接口来检测)。如果这个延迟能保持和批次间隔差不多,那么系统基本就是稳定的。否则,如果这个延迟持久在增长,也就是说系统跟不上数据接收速度,那也就意味着系统不稳定。一旦系统文档下来后,你就可以尝试提高数据接收速度,或者减少批次间隔值。不过需要注意,瞬间的延迟增长可以只是暂时的,只要这个延迟后续会自动降下来就没有问题(如:降到小于批次间隔值) 内存调优 Spark应用内存占用和GC调优已经在调优指南(Tuning Guide)中有详细的讨论。墙裂建议你读一读那篇文档。本节中,我们只是讨论一下几个专门用于Spark Streaming的调优参数。 Spark Streaming应用在集群中占用的内存量严重依赖于具体所使用的tranformation算子。例如,如果想要用一个窗口算子操纵最近10分钟的数据,那么你的集群至少需要在内存里保留10分钟的数据;另一个例子是updateStateByKey,如果key很多的话,相对应的保存的key的state也会很多,而这些都需要占用内存。而如果你的应用只是做一个简单的 “映射-过滤-存储”(map-filter-store)操作的话,那需要的内存就很少了。 一般情况下,streaming接收器接收到的数据会以StorageLevel.MEMORY_AND_DISK_SER_2 这个存储级别存到spark中,也就是说,如果内存装不下,数据将被吐到磁盘上。数据吐到磁盘上会大大降低streaming应用的性能,因此还是建议根据你的应用处理的数据量,提供充足的内存。最好就是,一边小规模地放大内存,再观察评估,然后再放大,再评估。 另一个内存调优的方向就是垃圾回收。因为streaming应用往往都需要低延迟,所以肯定不希望出现大量的或耗时较长的JVM垃圾回收暂停。 以下是一些能够帮助你减少内存占用和GC开销的参数或手段: DStream持久化级别(Persistence Level of DStreams): 前面数据序列化(Data Serialization)这小节已经提到过,默认streaming的输入RDD会被持久化成序列化的字节流。相对于非序列化数据,这样可以减少内存占用和GC开销。如果启用Kryo序列化,还能进一步减少序列化数据大小和内存占用量。如果你还需要进一步减少内存占用的话,可以开启数据压缩(通过spark.rdd.compress这个配置设定),只不过数据压缩会增加CPU消耗。 清除老数据(Clearing old data): 默认情况下,所有的输入数据以及DStream的transformation算子产生的持久化RDD都是自动清理的。Spark Streaming会根据所使用的transformation算子来清理老数据。例如,你用了一个窗口操作处理最近10分钟的数据,那么Spark Streaming会保留至少10分钟的数据,并且会主动把更早的数据都删掉。当然,你可以设置 streamingContext.remember 以保留更长时间段的数据(比如:你可能会需要交互式地查询更老的数据)。 CMS垃圾回收器(CMS Garbage Collector): 为了尽量减少GC暂停的时间,我们墙裂建议使用CMS垃圾回收器(concurrent mark-and-sweep GC)。虽然CMS GC会稍微降低系统的总体吞吐量,但我们仍建议使用它,因为CMS GC能使批次处理的时间保持在一个比较恒定的水平上。最后,你需要确保在驱动器(通过spark-submit中的–driver-java-options设置)和执行器(使用spark.executor.extraJavaOptions配置参数)上都设置了CMS GC。 其他提示: 如果还想进一步减少GC开销,以下是更进一步的可以尝试的手段: 配合Tachyon使用堆外内存来持久化RDD。详见Spark编程指南(Spark Programming Guide) 使用更多但是更小的执行器进程。这样GC压力就会分散到更多的JVM堆中。 容错语义 本节中,我们将讨论Spark Streaming应用在出现失败时的具体行为。 背景 要理解Spark Streaming所提供的容错语义,我们首先需要回忆一下Spark RDD所提供的基本容错语义。 RDD是不可变的,可重算的,分布式数据集。每个RDD都记录了其创建算子的血统信息,其中每个算子都以可容错的数据集作为输入数据。 如果RDD的某个分区因为节点失效而丢失,则该分区可以根据RDD的血统信息以及相应的原始输入数据集重新计算出来。 假定所有RDD transformation算子计算过程都是确定性的,那么通过这些算子得到的最终RDD总是包含相同的数据,而与Spark集群的是否故障无关。 Spark主要操作一些可容错文件系统的数据,如:HDFS或S3。因此,所有从这些可容错数据源产生的RDD也是可容错的。然而,对于Spark Streaming并非如此,因为多数情况下Streaming需要从网络远端接收数据,这回导致Streaming的数据源并不可靠(尤其是对于使用了fileStream的应用)。要实现RDD相同的容错属性,数据接收就必须用多个不同worker节点上的Spark执行器来实现(默认副本因子是2)。因此一旦出现故障,系统需要恢复两种数据: 接收并保存了副本的数据– 数据不会因为单个worker节点故障而丢失,因为有副本! 接收但尚未保存副本数据– 因为数据并没有副本,所以一旦故障,只能从数据源重新获取。 此外,还有两种可能的故障类型需要考虑: Worker节点故障– 任何运行执行器的worker节点一旦故障,节点上内存中的数据都会丢失。如果这些节点上有接收器在运行,那么其包含的缓存数据也会丢失。 Driver节点故障– 如果Spark Streaming的驱动节点故障,那么很显然SparkContext对象就没了,所有执行器及其内存数据也会丢失。 有了以上这些基本知识,下面我们就进一步了解一下Spark Streaming的容错语义。 定义 流式系统的可靠度语义可以据此来分类:单条记录在系统中被处理的次数保证。一个流式系统可能提供保证必定是以下三种之一(不管系统是否出现故障): 至多一次(At most once): 每条记录要么被处理一次,要么就没有处理。 至少一次(At least once): 每条记录至少被处理过一次(一次或多次)。这种保证能确保没有数据丢失,比“至多一次”要强。但有可能出现数据重复。 精确一次(Exactly once): 每条记录都精确地只被处理一次 – 也就是说,既没有数据丢失,也不会出现数据重复。这是三种保证中最强的一种。 基础语义 任何流式处理系统一般都会包含以下三个数据处理步骤: 数据接收(Receiving the data): 从数据源拉取数据。 数据转换(Transforming the data): 将接收到的数据进行转换(使用DStream和RDD transformation算子)。 数据推送(Pushing out the data): 将转换后最终数据推送到外部文件系统,数据库或其他展示系统。 如果Streaming应用需要做到端到端的“精确一次”的保证,那么就必须在以上三个步骤中各自都保证精确一次:即,每条记录必须,只接收一次、处理一次、推送一次。下面让我们在Spark Streaming的上下文环境中来理解一下这三个步骤的语义: 数据接收: 不同数据源提供的保证不同,下一节再详细讨论。 数据转换: 所有的数据都会被“精确一次”处理,这要归功于RDD提供的保障。即使出现故障,只要数据源还能访问,最终所转换得到的RDD总是包含相同的内容。 数据推送: 输出操作默认保证“至少一次”的语义,是否能“精确一次”还要看所使用的输出算子(是否幂等)以及下游系统(是否支持事务)。不过用户也可以开发自己的事务机制来实现“精确一次”语义。这个后续会有详细讨论。 接收数据语义 不同的输入源提供不同的数据可靠性级别,从“至少一次”到“精确一次”。 从文件接收数据 如果所有的输入数据都来源于可容错的文件系统,如HDFS,那么Spark Streaming就能在任何故障中恢复并处理所有的数据。这种情况下就能保证精确一次语义,也就是说不管出现什么故障,所有的数据总是精确地只处理一次,不多也不少。 基于接收器接收数据 对于基于接收器的输入源,容错语义将同时依赖于故障场景和接收器类型。前面也已经提到过,spark Streaming主要有两种类型的接收器: 可靠接收器– 这类接收器会在数据接收并保存好副本后,向可靠数据源发送确认信息。这类接收器故障时,是不会给缓存的(已接收但尚未保存副本)数据发送确认信息。因此,一旦接收器重启,没有收到确认的数据,会重新从数据源再获取一遍,所以即使有故障也不会丢数据。 不可靠接收器– 这类接收器不会发送确认信息,因此一旦worker和driver出现故障,就有可能会丢失数据。 对于不同的接收器,我们可以获得如下不同的语义。如果一个worker节点故障了,对于可靠接收器来书,不会有数据丢失。而对于不可靠接收器,缓存的(接收但尚未保存副本)数据可能会丢失。如果driver节点故障了,除了接收到的数据之外,其他的已经接收且已经保存了内存副本的数据都会丢失,这将会影响有状态算子的计算结果。 为了避免丢失已经收到且保存副本的数,从 spark 1.2 开始引入了WAL(write ahead logs),以便将这些数据写入到可容错的存储中。只要你使用可靠接收器,同时启用WAL(write ahead logs enabled),那么久再也不用为数据丢失而担心了。并且这时候,还能提供“至少一次”的语义保证。 下表总结了故障情况下的各种语义: 部署场景 Worker 故障 Driver 故障 Spark 1.1及以前版本 或者 Spark 1.2及以后版本,且未开启WAL 若使用不可靠接收器,则可能丢失缓存(已接收但尚未保存副本)数据; 若使用可靠接收器,则没有数据丢失,且提供至少一次处理语义 若使用不可靠接收器,则缓存数据和已保存数据都可能丢失; 若使用可靠接收器,则没有缓存数据丢失,但已保存数据可能丢失,且不提供语义保证 Spark 1.2及以后版本,并启用WAL 若使用可靠接收器,则没有数据丢失,且提供至少一次语义保证 若使用可靠接收器和文件,则无数据丢失,且提供至少一次语义保证 从Kafka Direct API接收数据 从Spark 1.3开始,我们引入Kafka Direct API,该API能为Kafka数据源提供“精确一次”语义保证。有了这个输入API,再加上输出算子的“精确一次”保证,你就能真正实现端到端的“精确一次”语义保证。(改功能截止Spark 1.6.1还是实验性的)更详细的说明见:Kafka Integration Guide。 输出算子的语义 输出算子(如 foreachRDD)提供“至少一次”语义保证,也就是说,如果worker故障,单条输出数据可能会被多次写入外部实体中。不过这对于文件系统来说是可以接受的(使用saveAs***Files 多次保存文件会覆盖之前的),所以我们需要一些额外的工作来实现“精确一次”语义。主要有两种实现方式: 幂等更新(Idempotent updates): 就是说多次操作,产生的结果相同。例如,多次调用saveAs***Files保存的文件总是包含相同的数据。 事务更新(Transactional updates): 所有的更新都是事务性的,这样一来就能保证更新的原子性。以下是一种实现方式: 用批次时间(在foreachRDD中可用)和分区索引创建一个唯一标识,该标识代表流式应用中唯一的一个数据块。 基于这个标识建立更新事务,并使用数据块数据更新外部系统。也就是说,如果该标识未被提交,则原子地将标识代表的数据更新到外部系统。否则,就认为该标识已经被提交,直接忽略之。dstream.foreachRDD { (rdd, time) => rdd.foreachPartition { partitionIterator => val partitionId = TaskContext.get.partitionId() val uniqueId = generateUniqueId(time.milliseconds, partitionId) // 使用uniqueId作为事务的唯一标识,基于uniqueId实现partitionIterator所指向数据的原子事务提交 } } 迁移指南 – 从0.9.1及以下升级到1.x 在Spark 0.9.1和Spark 1.0之间,有一些API接口变更,变更目的是为了保障未来版本API的稳定。本节将详细说明一下从已有版本迁移升级到1.0所需的工作。 输入DStream(Input DStreams): 所有创建输入流的算子(如:StreamingContext.socketStream, FlumeUtils.createStream 等)的返回值不再是DStream(对Java来说是JavaDStream),而是InputDStream/ReceiverInputDStream(对Java来说是JavaInputDStream/JavaPairInputDStream/JavaReceiverInputDStream/JavaPairReceiverInputDStream)。这样才能确保特定输入流的功能能够在未来持续增加到这些class中,而不会打破二进制兼容性。注意,已有的Spark Streaming应用应该不需要任何代码修改(新的返回类型都是DStream的子类),只不过需要基于Spark 1.0重新编译一把。 定制网络接收器(Custom Network Receivers): 自从Spark Streaming发布以来,Scala就能基于NetworkReceiver来定制网络接收器。但由于错误处理和汇报API方便的限制,该类型不能在Java中使用。所以Spark 1.0开始,用Receiver来替换掉这个NetworkReceiver,主要的好处如下: 该类型新增了stop和restart方法,便于控制接收器的生命周期。详见custom receiver guide。 定制接收器用Scala和Java都能实现。 为了将已有的基于NetworkReceiver的自定义接收器迁移到Receiver上来,你需要如下工作: 首先你的自定义接收器类型需要从org.apache.spark.streaming.receiver.Receiver继承,而不再是org.apache.spark.streaming.dstream.NetworkReceiver。 原先,我们需要在自定义接收器中创建一个BlockGenerator来保存接收到的数据。你必须显示的实现onStart() 和 onStop() 方法。而在新的Receiver class中,这些都不需要了,你只需要调用它的store系列的方法就能将数据保存到Spark中。所以你接下来需要做的迁移工作就是,删除BlockGenerator对象(这个类型在Spark 1.0之后也没有了~),然后用store(…)方法来保存接收到的数据。 基于Actor的接收器(Actor-based Receivers): 从actor class继承后,并实org.apache.spark.streaming.receiver.Receiver后,即可从Akka Actors中获取数据。获取数据的类被重命名为org.apache.spark.streaming.receiver.ActorHelper,而保存数据的pushBlocks(…)方法也被重命名为 store(…)。其他org.apache.spark.streaming.receivers包中的工具类也被移到org.apache.spark.streaming.receiver包下并重命名,新的类名应该比之前更加清晰。 下一步 其他相关参考文档 Kafka Integration Guide Flume Integration Guide Kinesis Integration Guide Custom Receiver Guide API文档 Scala 文档 StreamingContext和DStream KafkaUtils,FlumeUtils,KinesisUtils,TwitterUtils,ZeroMQUtils, 以及MQTTUtils Java 文档 JavaStreamingContext,JavaDStream以及JavaPairDStream KafkaUtils,FlumeUtils,KinesisUtilsTwitterUtils,ZeroMQUtils, 以及MQTTUtils Python 文档 StreamingContext和DStream KafkaUtils 其他示例:Scala,Java以及Python Spark Streaming相关的Paper和video。 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》Spark Streaming编程指南(一)

Spark Streaming编程指南 概览 Spark Streaming是对核心Spark API的一个扩展,它能够实现对实时数据流的流式处理,并具有很好的可扩展性、高吞吐量和容错性。Spark Streaming支持从多种数据源提取数据,如:Kafka、Flume、Twitter、ZeroMQ、Kinesis以及TCP套接字,并且可以提供一些高级API来表达复杂的处理算法,如:map、reduce、join和window等。最后,Spark Streaming支持将处理完的数据推送到文件系统、数据库或者实时仪表盘中展示。实际上,你完全可以将Spark的机器学习(machine learning)和 图计算(graph processing)的算法应用于Spark Streaming的数据流当中。 下图展示了Spark Streaming的内部工作原理。Spark Streaming从实时数据流接入数据,再将其划分为一个个小批量供后续Spark engine处理,所以实际上,Spark Streaming是按一个个小批量来处理数据流的。 Spark Streaming为这种持续的数据流提供了的一个高级抽象,即:discretized stream(离散数据流)或者叫DStream。DStream既可以从输入数据源创建得来,如:Kafka、Flume或者Kinesis,也可以从其他DStream经一些算子操作得到。其实在内部,一个DStream就是包含了一系列RDDs。 本文档将向你展示如何用DStream进行Spark Streaming编程。Spark Streaming支持Scala、Java和Python(始于Spark 1.2),本文档的示例包括这三种语言。 注意:对Python来说,有一部分API尚不支持,或者是和Scala、Java不同。本文档中会用高亮形式来注明这部分Python API。 一个小栗子 在深入Spark Streaming编程细节之前,我们先来看看一个简单的小栗子以便有个感性认识。假设我们在一个TCP端口上监听一个数据服务器的数据,并对收到的文本数据中的单词计数。以下你所需的全部工作: Scala Java Python 首先,我们需要导入Spark Streaming的相关class的一些包,以及一些支持StreamingContext隐式转换的包(这些隐式转换能给DStream之类的class增加一些有用的方法)。StreamingContext是Spark Streaming的入口。我们将会创建一个本地 StreamingContext对象,包含两个执行线程,并将批次间隔设为1秒。 import org.apache.spark._ import org.apache.spark.streaming._ import org.apache.spark.streaming.StreamingContext._ // 从Spark 1.3之后这行就可以不需要了 // 创建一个local StreamingContext,包含2个工作线程,并将批次间隔设为1秒 // master至少需要2个CPU核,以避免出现任务饿死的情况 val conf = new SparkConf().setMaster("local[2]").setAppName("NetworkWordCount") val ssc = new StreamingContext(conf, Seconds(1)) 利用这个上下文对象(StreamingContext),我们可以创建一个DStream,该DStream代表从前面的TCP数据源流入的数据流,同时TCP数据源是由主机名(如:hostnam)和端口(如:9999)来描述的。 // 创建一个连接到hostname:port的DStream,如:localhost:9999 val lines = ssc.socketTextStream("localhost", 9999) 这里的 lines 就是从数据server接收到的数据流。其中每一条记录都是一行文本。接下来,我们就需要把这些文本行按空格分割成单词。 // 将每一行分割成多个单词 val words = lines.flatMap(_.split(" ")) flatMap 是一种 “一到多”(one-to-many)的映射算子,它可以将源DStream中每一条记录映射成多条记录,从而产生一个新的DStream对象。在本例中,lines中的每一行都会被flatMap映射为多个单词,从而生成新的words DStream对象。然后,我们就能对这些单词进行计数了。 import org.apache.spark.streaming.StreamingContext._ // Spark 1.3之后不再需要这行 // 对每一批次中的单词进行计数 val pairs = words.map(word => (word, 1)) val wordCounts = pairs.reduceByKey(_ + _) // 将该DStream产生的RDD的头十个元素打印到控制台上 wordCounts.print() words这个DStream对象经过map算子(一到一的映射)转换为一个包含(word, 1)键值对的DStream对象pairs,再对pairs使用reduce算子,得到每个批次中各个单词的出现频率。最后,wordCounts.print() 将会每秒(前面设定的批次间隔)打印一些单词计数到控制台上。 注意,执行以上代码后,Spark Streaming只是将计算逻辑设置好,此时并未真正的开始处理数据。要启动之前的处理逻辑,我们还需要如下调用: ssc.start() // 启动流式计算 ssc.awaitTermination() // 等待直到计算终止 完整的代码可以在Spark Streaming的例子NetworkWordCount中找到。 如果你已经有一个Spark包(下载在这里downloaded,自定义构建在这里built),就可以执行按如下步骤运行这个例子。 首先,你需要运行netcat(Unix-like系统都会有这个小工具),将其作为data server $ nc -lk 9999 然后,在另一个终端,按如下指令执行这个例子 Scala Java Python $ ./bin/run-example streaming.NetworkWordCount localhost 9999 好了,现在你尝试可以在运行netcat的终端里敲几个单词,你会发现这些单词以及相应的计数会出现在启动Spark Streaming例子的终端屏幕上。看上去应该和下面这个示意图类似: # TERMINAL 1: # Running Netcat $ nc -lk 9999 hello world ... # TERMINAL 2: RUNNING NetworkWordCount $ ./bin/run-example streaming.NetworkWordCount localhost 9999 ... ------------------------------------------- Time: 1357008430000 ms ------------------------------------------- (hello,1) (world,1) ... 基本概念 下面,我们在之前的小栗子基础上,继续深入了解一下Spark Streaming的一些基本概念。 链接依赖项 和Spark类似,Spark Streaming也能在Maven库中找到。如果你需要编写Spark Streaming程序,你就需要将以下依赖加入到你的SBT或Maven工程依赖中。 Maven SBT <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-streaming_2.10</artifactId> <version>1.6.1</version> </dependency> 还有,对于从Kafka、Flume以及Kinesis这类数据源提取数据的流式应用来说,还需要额外增加相应的依赖项,下表列出了各种数据源对应的额外依赖项: 数据源 Maven工件 Kafka spark-streaming-kafka_2.10 Flume spark-streaming-flume_2.10 Kinesis spark-streaming-kinesis-asl_2.10 [Amazon Software License] Twitter spark-streaming-twitter_2.10 ZeroMQ spark-streaming-zeromq_2.10 MQTT spark-streaming-mqtt_2.10 最新的依赖项信息(包括源代码和Maven工件)请参考Maven repository。 初始化StreamingContext 要初始化任何一个Spark Streaming程序,都需要在入口代码中创建一个StreamingContext对象。 Scala Java Python AStreamingContextobject can be created from aSparkConfobject. 而StreamingContext对象需要一个SparkConf对象作为其构造参数。 import org.apache.spark._ import org.apache.spark.streaming._ val conf = new SparkConf().setAppName(appName).setMaster(master) val ssc = new StreamingContext(conf, Seconds(1)) 上面代码中的 appName 是你给该应用起的名字,这个名字会展示在Spark集群的web UI上。而 master 是Spark, Mesos or YARN cluster URL,如果支持本地测试,你也可以用”local[*]”为其赋值。通常在实际工作中,你不应该将master参数硬编码到代码里,而是应用通过spark-submit的参数来传递master的值(launch the application withspark-submit)。不过对本地测试来说,”local[*]”足够了(该值传给master后,Spark Streaming将在本地进程中,启动n个线程运行,n与本地系统CPU core数相同)。注意,StreamingContext在内部会创建一个SparkContext对象(SparkContext是所有Spark应用的入口,在StreamingContext对象中可以这样访问:ssc.sparkContext)。 StreamingContext还有另一个构造参数,即:批次间隔,这个值的大小需要根据应用的具体需求和可用的集群资源来确定。详见Spark性能调优(Performance Tuning)。 StreamingContext对象也可以通过已有的SparkContext对象来创建,示例如下: import org.apache.spark.streaming._ val sc = ... // 已有的SparkContext val ssc = new StreamingContext(sc, Seconds(1)) context对象创建后,你还需要如下步骤: 创建DStream对象,并定义好输入数据源。 基于数据源DStream定义好计算逻辑和输出。 调用streamingContext.start() 启动接收并处理数据。 调用streamingContext.awaitTermination() 等待流式处理结束(不管是手动结束,还是发生异常错误) 你可以主动调用 streamingContext.stop() 来手动停止处理流程。 需要关注的重点: 一旦streamingContext启动,就不能再对其计算逻辑进行添加或修改。 一旦streamingContext被stop掉,就不能restart。 单个JVM虚机同一时间只能包含一个active的StreamingContext。 StreamingContext.stop() 也会把关联的SparkContext对象stop掉,如果不想把SparkContext对象也stop掉,可以将StreamingContext.stop的可选参数 stopSparkContext 设为false。 一个SparkContext对象可以和多个StreamingContext对象关联,只要先对前一个StreamingContext.stop(sparkContext=false),然后再创建新的StreamingContext对象即可。 离散数据流 (DStreams) 离散数据流(DStream)是Spark Streaming最基本的抽象。它代表了一种连续的数据流,要么从某种数据源提取数据,要么从其他数据流映射转换而来。DStream内部是由一系列连续的RDD组成的,每个RDD都是不可变、分布式的数据集(详见Spark编程指南 –Spark Programming Guide)。每个RDD都包含了特定时间间隔内的一批数据,如下图所示: 任何作用于DStream的算子,其实都会被转化为对其内部RDD的操作。例如,在前面的例子中,我们将 lines 这个DStream转成words DStream对象,其实作用于lines上的flatMap算子,会施加于lines中的每个RDD上,并生成新的对应的RDD,而这些新生成的RDD对象就组成了words这个DStream对象。其过程如下图所示: 底层的RDD转换仍然是由Spark引擎来计算。DStream的算子将这些细节隐藏了起来,并为开发者提供了更为方便的高级API。后续会详细讨论这些高级算子。 输入DStream和接收器 输入DStream代表从某种流式数据源流入的数据流。在之前的例子里,lines 对象就是输入DStream,它代表从netcat server收到的数据流。每个输入DStream(除文件数据流外)都和一个接收器(Receiver –Scala doc,Java doc)相关联,而接收器则是专门从数据源拉取数据到内存中的对象。 Spark Streaming主要提供两种内建的流式数据源: 基础数据源(Basic sources): 在StreamingContext API 中可直接使用的源,如:文件系统,套接字连接或者Akka actor。 高级数据源(Advanced sources): 需要依赖额外工具类的源,如:Kafka、Flume、Kinesis、Twitter等数据源。这些数据源都需要增加额外的依赖,详见依赖链接(linking)这一节。 本节中,我们将会从每种数据源中挑几个继续深入讨论。 注意,如果你需要同时从多个数据源拉取数据,那么你就需要创建多个DStream对象(详见后续的性能调优这一小节)。多个DStream对象其实也就同时创建了多个数据流接收器。但是请注意,Spark的worker/executor 都是长期运行的,因此它们都会各自占用一个分配给Spark Streaming应用的CPU。所以,在运行Spark Streaming应用的时候,需要注意分配足够的CPU core(本地运行时,需要足够的线程)来处理接收到的数据,同时还要足够的CPU core来运行这些接收器。 要点 如果本地运行Spark Streaming应用,记得不能将master设为”local” 或 “local[1]”。这两个值都只会在本地启动一个线程。而如果此时你使用一个包含接收器(如:套接字、Kafka、Flume等)的输入DStream,那么这一个线程只能用于运行这个接收器,而处理数据的逻辑就没有线程来执行了。因此,本地运行时,一定要将master设为”local[n]”,其中 n > 接收器的个数(有关master的详情请参考Spark Properties)。 将Spark Streaming应用置于集群中运行时,同样,分配给该应用的CPU core数必须大于接收器的总数。否则,该应用就只会接收数据,而不会处理数据。 基础数据源 前面的小栗子中,我们已经看到,使用ssc.socketTextStream(…) 可以从一个TCP连接中接收文本数据。而除了TCP套接字外,StreamingContext API 还支持从文件或者Akka actor中拉取数据。 文件数据流(File Streams):可以从任何兼容HDFS API(包括:HDFS、S3、NFS等)的文件系统,创建方式如下: Scala Java Python streamingContext.fileStream[KeyClass, ValueClass, InputFormatClass](dataDirectory) Spark Streaming将监视该dataDirectory目录,并处理该目录下任何新建的文件(目前还不支持嵌套目录)。注意: 各个文件数据格式必须一致。 dataDirectory中的文件必须通过moving或者renaming来创建。 一旦文件move进dataDirectory之后,就不能再改动。所以如果这个文件后续还有写入,这些新写入的数据不会被读取。 对于简单的文本文件,更简单的方式是调用 streamingContext.textFileStream(dataDirectory)。 另外,文件数据流不是基于接收器的,所以不需要为其单独分配一个CPU core。 Python APIfileStream目前暂时不可用,Python目前只支持textFileStream。 基于自定义Actor的数据流(Streams based on Custom Actors):DStream可以由Akka actor创建得到,只需调用 streamingContext.actorStream(actorProps, actor-name)。详见自定义接收器(Custom Receiver Guide)。actorStream暂时不支持Python API。 RDD队列数据流(Queue of RDDs as a Stream):如果需要测试Spark Streaming应用,你可以创建一个基于一批RDD的DStream对象,只需调用 streamingContext.queueStream(queueOfRDDs)。RDD会被一个个依次推入队列,而DStream则会依次以数据流形式处理这些RDD的数据。 关于套接字、文件以及Akka actor数据流更详细信息,请参考相关文档:StreamingContextfor Scala,JavaStreamingContextfor Java, andStreamingContextfor Python。 高级数据源 Python API自 Spark 1.6.1 起,Kafka、Kinesis、Flume和MQTT这些数据源将支持Python。 使用这类数据源需要依赖一些额外的代码库,有些依赖还挺复杂的(如:Kafka、Flume)。因此为了减少依赖项版本冲突问题,各个数据源DStream的相关功能被分割到不同的代码包中,只有用到的时候才需要链接打包进来。例如,如果你需要使用Twitter的tweets作为数据源,你需要以下步骤: Linking: 将spark-streaming-twitter_2.10工件加入到SBT/Maven项目依赖中。 Programming: 导入TwitterUtils class,然后调用 TwitterUtils.createStream 创建一个DStream,具体代码见下放。 Deploying: 生成一个uber Jar包,并包含其所有依赖项(包括 spark-streaming-twitter_2.10及其自身的依赖树),再部署这个Jar包。部署详情请参考部署这一节(Deploying section)。 Scala Java import org.apache.spark.streaming.twitter._ TwitterUtils.createStream(ssc, None) 注意,高级数据源在spark-shell中不可用,因此不能用spark-shell来测试基于高级数据源的应用。如果真有需要的话,你需要自行下载相应数据源的Maven工件及其依赖项,并将这些Jar包部署到spark-shell的classpath中。 下面列举了一些高级数据源: Kafka:Spark Streaming 1.6.1 可兼容 Kafka 0.8.2.1。详见Kafka Integration Guide。 Flume:Spark Streaming 1.6.1 可兼容 Flume 1.6.0 。详见Flume Integration Guide。 Kinesis:Spark Streaming 1.6.1 可兼容 Kinesis Client Library 1.2.1。详见Kinesis Integration Guide。 Twitter:Spark Streaming TwitterUtils 使用Twitter4j 通过Twitter’s Streaming API拉取公开tweets数据流。认证信息可以用任何Twitter4j所支持的方法(methods)。你可以获取所有的公开数据流,当然也可以基于某些关键词进行过滤。示例可以参考TwitterPopularTags和TwitterAlgebirdCMS。 自定义数据源 Python API自定义数据源目前还不支持Python。 输入DStream也可以用自定义的方式创建。你需要做的只是实现一个自定义的接收器(receiver),以便从自定义的数据源接收数据,然后将数据推入Spark中。详情请参考自定义接收器指南(Custom Receiver Guide)。 接收器可靠性 从可靠性角度来划分,大致有两种数据源。其中,像Kafka、Flume这样的数据源,它们支持对所传输的数据进行确认。系统收到这类可靠数据源过来的数据,然后发出确认信息,这样就能够确保任何失败情况下,都不会丢数据。因此我们可以将接收器也相应地分为两类: 可靠接收器(Reliable Receiver)– 可靠接收器会在成功接收并保存好Spark数据副本后,向可靠数据源发送确认信息。 不可靠接收器(Unreliable Receiver)– 不可靠接收器不会发送任何确认信息。不过这种接收器常用语于不支持确认的数据源,或者不想引入数据确认的复杂性的数据源。 自定义接收器指南(Custom Receiver Guide)中详细讨论了如何写一个可靠接收器。 DStream支持的transformation算子 和RDD类似,DStream也支持从输入DStream经过各种transformation算子映射成新的DStream。DStream支持很多RDD上常见的transformation算子,一些常用的见下表: Transformation算子 用途 map(func) 返回会一个新的DStream,并将源DStream中每个元素通过func映射为新的元素 flatMap(func) 和map类似,不过每个输入元素不再是映射为一个输出,而是映射为0到多个输出 filter(func) 返回一个新的DStream,并包含源DStream中被func选中(func返回true)的元素 repartition(numPartitions) 更改DStream的并行度(增加或减少分区数) union(otherStream) 返回新的DStream,包含源DStream和otherDStream元素的并集 count() 返回一个包含单元素RDDs的DStream,其中每个元素是源DStream中各个RDD中的元素个数 reduce(func) 返回一个包含单元素RDDs的DStream,其中每个元素是通过源RDD中各个RDD的元素经func(func输入两个参数并返回一个同类型结果数据)聚合得到的结果。func必须满足结合律,以便支持并行计算。 countByValue() 如果源DStream包含的元素类型为K,那么该算子返回新的DStream包含元素为(K, Long)键值对,其中K为源DStream各个元素,而Long为该元素出现的次数。 reduceByKey(func, [numTasks]) 如果源DStream 包含的元素为 (K, V) 键值对,则该算子返回一个新的也包含(K, V)键值对的DStream,其中V是由func聚合得到的。注意:默认情况下,该算子使用Spark的默认并发任务数(本地模式为2,集群模式下由spark.default.parallelism 决定)。你可以通过可选参数numTasks来指定并发任务个数。 join(otherStream, [numTasks]) 如果源DStream包含元素为(K, V),同时otherDStream包含元素为(K, W)键值对,则该算子返回一个新的DStream,其中源DStream和otherDStream中每个K都对应一个 (K, (V, W))键值对元素。 cogroup(otherStream, [numTasks]) 如果源DStream包含元素为(K, V),同时otherDStream包含元素为(K, W)键值对,则该算子返回一个新的DStream,其中每个元素类型为包含(K, Seq[V], Seq[W])的tuple。 transform(func) 返回一个新的DStream,其包含的RDD为源RDD经过func操作后得到的结果。利用该算子可以对DStream施加任意的操作。 updateStateByKey(func) 返回一个包含新”状态”的DStream。源DStream中每个key及其对应的values会作为func的输入,而func可以用于对每个key的“状态”数据作任意的更新操作。 下面我们会挑几个transformation算子深入讨论一下。 updateStateByKey算子 updateStateByKey 算子支持维护一个任意的状态。要实现这一点,只需要两步: 定义状态 – 状态数据可以是任意类型。 定义状态更新函数 – 定义好一个函数,其输入为数据流之前的状态和新的数据流数据,且可其更新步骤1中定义的输入数据流的状态。 在每一个批次数据到达后,Spark都会调用状态更新函数,来更新所有已有key(不管key是否存在于本批次中)的状态。如果状态更新函数返回None,则对应的键值对会被删除。 举例如下。假设你需要维护一个流式应用,统计数据流中每个单词的出现次数。这里将各个单词的出现次数这个整型数定义为状态。我们接下来定义状态更新函数如下: Scala Java Python def updateFunction(newValues: Seq[Int], runningCount: Option[Int]): Option[Int] = { val newCount = ... // 将新的计数值和之前的状态值相加,得到新的计数值 Some(newCount) } 该状态更新函数可以作用于一个包括(word, 1) 键值对的DStream上(见本文开头的小栗子)。 val runningCounts = pairs.updateStateByKey[Int](updateFunction _) 该状态更新函数会为每个单词调用一次,且相应的newValues是一个包含很多个”1″的数组(这些1来自于(word,1)键值对),而runningCount包含之前该单词的计数。本例的完整代码请参考StatefulNetworkWordCount.scala。 注意,调用updateStateByKey前需要配置检查点目录,后续对此有详细的讨论,见检查点(checkpointing)这节。 transform算子 transform算子(及其变体transformWith)可以支持任意的RDD到RDD的映射操作。也就是说,你可以用tranform算子来包装任何DStream API所不支持的RDD算子。例如,将DStream每个批次中的RDD和另一个Dataset进行关联(join)操作,这个功能DStream API并没有直接支持。不过你可以用transform来实现这个功能,可见transform其实为DStream提供了非常强大的功能支持。比如说,你可以用事先算好的垃圾信息,对DStream进行实时过滤。 Scala Java Python val spamInfoRDD = ssc.sparkContext.newAPIHadoopRDD(...) // 包含垃圾信息的RDD val cleanedDStream = wordCounts.transform(rdd => { rdd.join(spamInfoRDD).filter(...) // 将DStream中的RDD和spamInfoRDD关联,并实时过滤垃圾数据 ... }) 注意,这里transform包含的算子,其调用时间间隔和批次间隔是相同的。所以你可以基于时间改变对RDD的操作,如:在不同批次,调用不同的RDD算子,设置不同的RDD分区或者广播变量等。 基于窗口(window)的算子 Spark Streaming同样也提供基于时间窗口的计算,也就是说,你可以对某一个滑动时间窗内的数据施加特定tranformation算子。如下图所示: 如上图所示,每次窗口滑动时,源DStream中落入窗口的RDDs就会被合并成新的windowed DStream。在上图的例子中,这个操作会施加于3个RDD单元,而滑动距离是2个RDD单元。由此可以得出任何窗口相关操作都需要指定一下两个参数: (窗口长度)window length– 窗口覆盖的时间长度(上图中为3) (滑动距离)sliding interval– 窗口启动的时间间隔(上图中为2) 注意,这两个参数都必须是DStream批次间隔(上图中为1)的整数倍. 下面咱们举个栗子。假设,你需要扩展前面的那个小栗子,你需要每隔10秒统计一下前30秒内的单词计数。为此,我们需要在包含(word, 1)键值对的DStream上,对最近30秒的数据调用reduceByKey算子。不过这些都可以简单地用一个 reduceByKeyAndWindow搞定。 Scala Java Python // 每隔10秒归约一次最近30秒的数据 val windowedWordCounts = pairs.reduceByKeyAndWindow((a:Int,b:Int) => (a + b), Seconds(30), Seconds(10)) 以下列出了常用的窗口算子。所有这些算子都有前面提到的那两个参数 – 窗口长度 和 滑动距离。 Transformation窗口算子 用途 window(windowLength,slideInterval) 将源DStream窗口化,并返回转化后的DStream countByWindow(windowLength,slideInterval) 返回数据流在一个滑动窗口内的元素个数 reduceByWindow(func,windowLength,slideInterval) 基于数据流在一个滑动窗口内的元素,用func做聚合,返回一个单元素数据流。func必须满足结合律,以便支持并行计算。 reduceByKeyAndWindow(func,windowLength,slideInterval, [numTasks]) 基于(K, V)键值对DStream,将一个滑动窗口内的数据进行聚合,返回一个新的包含(K,V)键值对的DStream,其中每个value都是各个key经过func聚合后的结果。 注意:如果不指定numTasks,其值将使用Spark的默认并行任务数(本地模式下为2,集群模式下由 spark.default.parallelism决定)。当然,你也可以通过numTasks来指定任务个数。 reduceByKeyAndWindow(func,invFunc,windowLength,slideInterval, [numTasks]) 和前面的reduceByKeyAndWindow() 类似,只是这个版本会用之前滑动窗口计算结果,递增地计算每个窗口的归约结果。当新的数据进入窗口时,这些values会被输入func做归约计算,而这些数据离开窗口时,对应的这些values又会被输入 invFunc 做”反归约”计算。举个简单的例子,就是把新进入窗口数据中各个单词个数“增加”到各个单词统计结果上,同时把离开窗口数据中各个单词的统计个数从相应的统计结果中“减掉”。不过,你的自己定义好”反归约”函数,即:该算子不仅有归约函数(见参数func),还得有一个对应的”反归约”函数(见参数中的 invFunc)。和前面的reduceByKeyAndWindow() 类似,该算子也有一个可选参数numTasks来指定并行任务数。注意,这个算子需要配置好检查点(checkpointing)才能用。 countByValueAndWindow(windowLength,slideInterval, [numTasks]) 基于包含(K, V)键值对的DStream,返回新的包含(K, Long)键值对的DStream。其中的Long value都是滑动窗口内key出现次数的计数。 和前面的reduceByKeyAndWindow() 类似,该算子也有一个可选参数numTasks来指定并行任务数。 Join相关算子 最后,值得一提的是,你在Spark Streaming中做各种关联(join)操作非常简单。 流-流(Stream-stream)关联 一个数据流可以和另一个数据流直接关联。 Scala Java Python val stream1: DStream[String, String] = ... val stream2: DStream[String, String] = ... val joinedStream = stream1.join(stream2) 上面代码中,stream1的每个批次中的RDD会和stream2相应批次中的RDD进行join。同样,你可以类似地使用 leftOuterJoin, rightOuterJoin, fullOuterJoin 等。此外,你还可以基于窗口来join不同的数据流,其实现也很简单,如下;) Scala Java Python val windowedStream1 = stream1.window(Seconds(20)) val windowedStream2 = stream2.window(Minutes(1)) val joinedStream = windowedStream1.join(windowedStream2) 流-数据集(stream-dataset)关联 其实这种情况已经在前面的DStream.transform算子中介绍过了,这里再举个基于滑动窗口的例子。 Scala Java Python val dataset: RDD[String, String] = ... val windowedStream = stream.window(Seconds(20))... val joinedStream = windowedStream.transform { rdd => rdd.join(dataset) } 实际上,在上面代码里,你可以动态地该表join的数据集(dataset)。传给tranform算子的操作函数会在每个批次重新求值,所以每次该函数都会用最新的dataset值,所以不同批次间你可以改变dataset的值。 完整的DStream transformation算子列表见API文档。Scala请参考DStream和PairDStreamFunctions. Java请参考JavaDStream和JavaPairDStream. Python见DStream。 DStream输出算子 输出算子可以将DStream的数据推送到外部系统,如:数据库或者文件系统。因为输出算子会将最终完成转换的数据输出到外部系统,因此只有输出算子调用时,才会真正触发DStream transformation算子的真正执行(这一点类似于RDD 的action算子)。目前所支持的输出算子如下表: 输出算子 用途 print() 在驱动器(driver)节点上打印DStream每个批次中的头十个元素。 Python API对应的Python API为pprint() saveAsTextFiles(prefix, [suffix]) 将DStream的内容保存到文本文件。 每个批次一个文件,各文件命名规则为 “prefix-TIME_IN_MS[.suffix]” saveAsObjectFiles(prefix, [suffix]) 将DStream内容以序列化Java对象的形式保存到顺序文件中。 每个批次一个文件,各文件命名规则为 “prefix-TIME_IN_MS[.suffix]”Python API暂不支持Python saveAsHadoopFiles(prefix, [suffix]) 将DStream内容保存到Hadoop文件中。 每个批次一个文件,各文件命名规则为 “prefix-TIME_IN_MS[.suffix]”Python API暂不支持Python foreachRDD(func) 这是最通用的输出算子了,该算子接收一个函数func,func将作用于DStream的每个RDD上。 func应该实现将每个RDD的数据推到外部系统中,比如:保存到文件或者写到数据库中。 注意,func函数是在streaming应用的驱动器进程中执行的,所以如果其中包含RDD的action算子,就会触发对DStream中RDDs的实际计算过程。 使用foreachRDD的设计模式 DStream.foreachRDD是一个非常强大的原生工具函数,用户可以基于此算子将DStream数据推送到外部系统中。不过用户需要了解如何正确而高效地使用这个工具。以下列举了一些常见的错误。 通常,对外部系统写入数据需要一些连接对象(如:远程server的TCP连接),以便发送数据给远程系统。因此,开发人员可能会不经意地在Spark驱动器(driver)进程中创建一个连接对象,然后又试图在Spark worker节点上使用这个连接。如下例所示: Scala Python dstream.foreachRDD { rdd => val connection = createNewConnection() // 这行在驱动器(driver)进程执行 rdd.foreach { record => connection.send(record) // 而这行将在worker节点上执行 } } 这段代码是错误的,因为它需要把连接对象序列化,再从驱动器节点发送到worker节点。而这些连接对象通常都是不能跨节点(机器)传递的。比如,连接对象通常都不能序列化,或者在另一个进程中反序列化后再次初始化(连接对象通常都需要初始化,因此从驱动节点发到worker节点后可能需要重新初始化)等。解决此类错误的办法就是在worker节点上创建连接对象。 然而,有些开发人员可能会走到另一个极端 – 为每条记录都创建一个连接对象,例如: Scala Python dstream.foreachRDD { rdd => rdd.foreach { record => val connection = createNewConnection() connection.send(record) connection.close() } } 一般来说,连接对象是有时间和资源开销限制的。因此,对每条记录都进行一次连接对象的创建和销毁会增加很多不必要的开销,同时也大大减小了系统的吞吐量。一个比较好的解决方案是使用 rdd.foreachPartition – 为RDD的每个分区创建一个单独的连接对象,示例如下: Scala Python dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => val connection = createNewConnection() partitionOfRecords.foreach(record => connection.send(record)) connection.close() } } 这样一来,连接对象的创建开销就摊到很多条记录上了。 最后,还有一个更优化的办法,就是在多个RDD批次之间复用连接对象。开发者可以维护一个静态连接池来保存连接对象,以便在不同批次的多个RDD之间共享同一组连接对象,示例如下: Scala Python dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => // ConnectionPool 是一个静态的、懒惰初始化的连接池 val connection = ConnectionPool.getConnection() partitionOfRecords.foreach(record => connection.send(record)) ConnectionPool.returnConnection(connection) // 将连接返还给连接池,以便后续复用之 } } 注意,连接池中的连接应该是懒惰创建的,并且有确定的超时时间,超时后自动销毁。这个实现应该是目前发送数据最高效的实现方式。 其他要点: DStream的转化执行也是懒惰的,需要输出算子来触发,这一点和RDD的懒惰执行由action算子触发很类似。特别地,DStream输出算子中包含的RDD action算子会强制触发对所接收数据的处理。因此,如果你的Streaming应用中没有输出算子,或者你用了dstream.foreachRDD(func)却没有在func中调用RDD action算子,那么这个应用只会接收数据,而不会处理数据,接收到的数据最后只是被简单地丢弃掉了。 默认地,输出算子只能一次执行一个,且按照它们在应用程序代码中定义的顺序执行。 转载自 并发编程网 - ifeve.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册