首页 文章 精选 留言 我的

精选列表

搜索[基础模型],共10008篇文章
优秀的个人博客,低调大师

Java基础1.1

虚拟机:vm,java虚拟机jvm。 C语言:写源码;用文本文件写的(写出来就是一个文本文件)。 源码————编译————可执行程序。 运行平台(系统+硬件)。 C;优点:与系统接触近,可以操作系统和系统API 缺点:程序不可跨平台,内存管理十分的麻烦。 内存(运行内存)又称闪存 ———速度十分的快——(一旦掉电数据全部消失)服务器(数据服务中心)服务器运行时间很长。内存运行完要回收 Java优化:如何跨平台(在所有操作系统上运行),如何管理内存(让所有的程序员不在头疼如何管理内存) 怎样跨平台; 三大系统的内核不一样:如何让程序可以跨平台运行那【源码】————【字节码】—————【翻译官】(虚拟机),字节码交给翻译官 怎样优化内存:C语言————编译——-exe————运行 虚拟机就像一个鱼缸: 你要操作内存的话交个容器,虚拟机就像是一个管家;你不用管内存,交给管家就行了,你想要内存问这个管家要就行了。 为什么要形成字节码: 把源码转换为字节码,能让虚拟机很快的认识,运行速度就快。(加快运行速度在运行的时候不用再次解析代码了)优化速度。

优秀的个人博客,低调大师

Java基础1.2

java 编译环节 源码 public .... /// 代码 文件名字后缀用java 全小写 文件1字母大写 (可以用中文命名)比较麻烦 网页下载的只是将虚拟机文件解压出去,不是java环境安装 Java编译环节虚拟机中找到一个程序。叫(javac.exe)程序形成字节码 生成一个字节码文件 如何搭建Java开发环境 :j a v a开发运行流程 java编译环境;写入代码 1名字 文件名字后缀用j a v a 全小写(规定)文件 1字母大写(可以用中文)不太好弄。 运行(java exe)程序并传递你写的文件的源码路径路径,告诉源码路径(打开cmd)磁盘管理系统 编译时时要敲空格 空格表示参数的分割 不空的话表示参数和路径是1(起).的。(不然就会报错)前面是要运行的程序 给程序传递的数据(告诉java路径要他进行编译) 如何让J a v a虚拟机运行我们的字节码 文件名,字节码文件要存在。

优秀的个人博客,低调大师

Java基础1.3

什么是批处理:批处理就是多个dos命令组成的,双击可执行里面的命令。(微软系统) 批处理:桌面文件以双击就能打开,而java一双击是打不开的因为java是一个class文件他需要虚拟机得运行才能打开。 Java不擅长做桌面程序你要是非要做你就得写一个简单的批处理操作。 run.bat:在批处理文件中运行你要运行的文件(java,javaw)加文件名。 bat(批处理的后缀)批处理就是dos的命令。javaw窗口文件运行,使用java不能关闭dos的窗口就是关闭程序的运行,这里是指窗口件。start(开启命令)犹如在dos中运行程序, 要想将你写的程序传播出去,就需要将源码(文件名.java)字节码(文件名.class)批处理(文件名.bat) 还要带上jdk 并且在批处理 bat文件中配置临时环境变量 , JAVA_HOME配置的是子目录前的路径 在配置path的时候不要在配置目录了只需要引入JAVA_HOME即可 set path=./jdk-10.0.2./bin()当前目录显得bin目录 .(代表当前目录下执行) set JAVA_HOME =./jdk-10.0.2(当前路径下的jdk) .(代表当前目录先执行) set CLASSPATH= . ;(当前目录) 这里有语法规定当前目录是(.;) 批处理就是字一个记事本中写执行代码让系统顺着去执行。 Java程序永远离不开jdk 就算你生成了exe也需要jdk才能运行。 如果想直接运行也可以就需要通过一个工具(exej4)这个工具可以直接将java打包成exe可执行程序。(这个你看到的只是假象 他只是做了一个批处理) 所以还不如我们自己写一个批处理

优秀的个人博客,低调大师

Java 基础语法

基本语法 2.1关键字 关键字是电脑语言里事先定义的,有特别意义的标识符,有时又叫保留字,还有特别意义的变量。Java的关键字对Java的编译器有特殊的意义,他们用来表示一种数据类型,或者表示程序的结构等,关键字不能用作变量名、方法名、类名、包名和参数。 Java语言规定关键字不能作为标识符。目前共有50个Java关键字,其中,"const"和"goto"这两个关键字在Java语言中并没有具体含义。Java语言把它们列为关键字,只是因为"const"和"goto"是其他某些计算机语言的关键字。2.2 标识符2.2.1 含义Java语言中,对于变量,常量,函数,语句块也有名字,我们统统称之为Java标识符.标识符是用来给类、对象、方法、变量、接口和自定义数据类型命名的。2.2.2 组成Java标识符由数字,字母和下划线(_),美元符号($)或人民币符号(¥)组成。在Java中是区分大小写的,而且还要求首位不能是数字。最重要的是,Java关键字不能当作Java标识符。2.2.3 命名规则1.类和接口名。每个字的首字母大写,含有大小写。例如MyClass,HelloWorld等。2.方法名。首字符小写,其余的首字母大写,含大小写。尽量少用下划线。例如,myName等。这种命名方法叫做驼峰式命名。3.常量名。基本数据类型的常量名使用全部大写字母,字与字之间用下划线分隔。对象常量可大小混写。例如,SIZE_NAME。 4.变量名。可大小写混写,首字符小写,字间分隔符用字的首字母大写。不用下划线,少用美元符号。给变量命名是尽量做到见名知义。 2.3 运算符2.3.1分类1.算数运算符(1)单目:+(取正)-(取负) ++(自增1) - -(自减1)(◆注:++和—既可以是前置运算符,也可以是后置运算符。前置时,变量的值先增1或先减1,然后用变量参加表达式的计算;后置时,变量的值先参加表达式的计算,然后变量再增1或减1。)(2)双目:+(加) -(减) *(乘) /(除) %(取余)2.赋值运算符(一)简单赋值运算符“=”用来将一个数据赋给一个变量(二)复合赋值运算符(1)= (2) += (3) -= (4) *= (5) /= (6) %= (7) &= (8) ^= (9)|= (10) <<= (11) >>=3.关系运算符等于符号==,不等于符号!= ,大于符号 >, 小于符号<,大于等于符号: >= ,小于等于符号: <= 。4.短路运算符短路运算符就是我们常用的“&&”、“||”,一般称为“条件操作”。5.条件运算符三目:a>b?true:false 说明:当a大于b的时候,为true(也就是冒号之前的值),否则为false;这整个运算符包括一个关系运算符(可以是“>”"<""!="等等),一个“?”,一个“:”,冒号前后需要有两个表达式或者是值或者是对象。6.位运算符(1)逻辑运算符常见的共有4种逻辑位运算符:(~)按位取反(&)按位与(|)按位或(^)按位异或(2)移位运算符(a)左移动运算符:会将操作的数向左边移动,移动的位的个数由指定,左移(b)右移动运算符:反过来,把操作数向右移动,移动的位个数同样由右操作数指定。(c)无正负号的右移运算符(>>>):7.布尔运算符布尔运算符布尔(boolean)变量或表达式的组合运算可以产生新的boolean值,fales和true(记得是小写)。单目运算符“!”是布尔非。双目运算符&,|和^是逻辑AND,OR和XOR运算符,它们强制两个操作数求布尔值。为避免右侧操作数冗余求值,用户可以使用短路求值运算符&&和||。8.其他运算符(1)instanceof(运行时的类型识别)(2). 点运算符,用来访问对象实例和访问类的成员方法和成员方法。(3)() “()”运算符,当声明或调用一个方法时,可以在()之间列出方法的参数,也可以利用“()”来指定一个空的参数。(4)new运算符 可以使用new运算符来出创建一个新对象或者一个新的数组(5)[]运算符 可以使用方括号来声明数组、创建数组以及访问数组中的元素。2.3.2 优先级按优先级从高到低排列如下:[ ] ( ) ++ -- ! ~ instanceof * / % + - << >> >>> <> < = > \ == != &^& & || ? := op= 。

优秀的个人博客,低调大师

python基础3

1.函数基本语法及特性 函数是什么? 函数一词来源于数学,但编程中的「函数」概念,与数学中的函数是有很大不同的,具体区别,我们后面会讲,编程中的函数在英文中也有很多不同的叫法。在BASIC中叫做subroutine(子过程或子程序),在Pascal中叫做procedure(过程)和function,在C中只有function,在Java里面叫做method。 定义: 函数是指将一组语句的集合通过一个名字(函数名)封装起来,要想执行这个函数,只需调用其函数名即可 特性: 减少重复代码 使程序变的可扩展 使程序变得易维护 定义: 1 def Hello():#函数名 2 print('Hello World!') 3 Hello()#调用函数 可以带参数: 1 def calc(x,y): 2 z = x*y 3 return z 4 c = calc(3,4) 5 print(c)#结果12 2.函数参数与局部变量 形参变量只有在被调用时才分配内存单元,在调用结束时,即刻释放所分配的内存单元。因此,形参只在函数内部有效。函数调用结束返回主调用函数后则不能再使用该形参变量 实参可以是常量、变量、表达式、函数等,无论实参是何种类型的量,在进行函数调用时,它们都必须有确定的值,以便把这些值传送给形参。因此应预先用赋值,输入等办法使参数获得确定值 还是上面的代码: 1 def calc(x,y): #(x,y)为形参 2 z = x*y 3 return z 4 c = calc(a,b) #(a.b)为实参 5 print(c) 默认参数 1 def stu_register(name, age, country, course): 2 print("----注册学生信息------") 3 print("姓名:", name) 4 print("age:", age) 5 print("国籍:", country) 6 print("课程:", course) 7 8 9 stu_register("小丽", 22, "CN", "python_devops") 10 stu_register("小明", 21, "CN", "linux") 11 stu_register("小王", 25, "CN", "linux") 发现 country 这个参数 基本都 是"CN", 就像我们在网站上注册用户,像国籍这种信息,你不填写,默认就会是 中国, 这就是通过默认参数实现的,把country变成默认参数非常简单 所以,我们可以通过下面代码简化代码: def stu_register(name, age, course,country="CN"): 这样,这个参数在调用时不指定,那默认就是CN,默认你选的值,默认参数! 注意:跟上一段代码比较,为什么默认参数放到后面呢? 简单来讲就是会产生歧义。 不妨想一想,如果确实如你所说,有默认值的参数位于无默认值之前,则调用函数时就必须使用key=Value的形式,而不能使用直接送入Value的形式了。为了调用函数时可以更便捷地使用后者,而同时又不产生歧义,在定义函数时,无默认值参数就必须位于前面了。考虑到定义函数只要一次,调用函数可能是很多地方、很多人使用,定义函数时稍微注意点是可以理解的了。 关键参数 正常情况下,给函数传参数要按顺序,不想按顺序就可以用关键参数,只需指定参数名即可,但记住一个要求就是,关键参数必须放在位置参数之后。 关键字参数: 1 def tes(x=1,y=2): 2 print(x) 3 print(y) 4 tes() 位置参数: 1 def tet1(x,y): 2 print(x) 3 print(y) 4 tet1(1,2) 非固定参数: 若你的函数在定义时不确定用户想传入多少个参数,就可以使用非固定参数 #*args参数组,将位置参数(一一对应的位置)放到元组 def tes(*args): print(args) tes(1,2,34,5,6) #结果:(1, 2, 34, 5, 6) 还可以有一个**kwargs 1 def tes(**kwargs): 2 print(kwargs) 3 tes(name='young',age='23',sex='1') 将上述几个参数组合: 1 def tes(name,age=23,*args,**kwargs): 2 print(name) 3 print(age) 4 print(args) 5 print(kwargs) 6 tes('young',3,5,6,sex='man',job='IT') 7 ''' 8 结果: 9 young 10 3 11 (5, 6) 12 {'sex': 'man', 'job': 'IT'} 13 ''' 局部变量: 1 name = "哈哈" 2 3 def change_name(name): 4 print("before:", name) 5 name = "Young" 6 print("after", name) 7 8 change_name(name) 9 print("真的改了吗?", name) 输出: before: 哈哈 after Young 真的改了吗? 哈哈 可以通过global来实现 1 name = "哈哈" 2 3 def change_name(obj): 4 global name 5 print("before:", name) 6 name = "Young" 7 print("after", name) 8 9 change_name(name) 10 print("确实改了!", name) 输出: before: 哈哈 after Young 确实改了! Young 全局与局部变量 在子程序中定义的变量称为局部变量,在程序的一开始定义的变量称为全局变量。 全局变量作用域是整个程序,局部变量作用域是定义该变量的子程序。 当全局变量与局部变量同名时: 在定义局部变量的子程序内,局部变量起作用;在其它地方全局变量起作用 3.返回值 要想获取函数的执行结果,就可以用return语句把结果返回 注意: 函数在执行过程中只要遇到return语句,就会停止执行并返回结果,so 也可以理解为 return 语句代表着函数的结束 如果未在函数中指定return,那这个函数的返回值为None 嵌套函数: python允许在定义函数的时候,其函数体内又包含另外一个函数的完整定义,这就是我们通常所说的嵌套定义。为什么?因为函数是用def语句定义的,凡是其他语句可以出现的地方,def语句同样可以出现。像这样定义在其他函数内的函数叫做内部函数,内部函数所在的函数叫做外部函数。当然,我们可以多层嵌套,这样的话,除了最外层和最内层的函数之外,其它函数既是外部函数又是内部函数。 1 spam = 99 2 def tester(): 3 def nested(): 4 global spam 5 print('current=',spam) 6 spam += 1 7 return nested 8 #注意:打印 print 那行的代码调用是tester()() 9 #而不是tester().nested() 4.递归 在函数内部,可以调用其他函数。如果一个函数在内部调用自身本身,这个函数就是递归函数。 1 def calc(n): 2 print(n) 3 if int(n/2)>0: 4 return calc(int(n/2)) 5 print("->",n) 6 calc(10) 输出: 1 10 2 5 3 2 4 1 5 -> 1 递归特性: 1. 必须有一个明确的结束条件 2. 每次进入更深一层递归时,问题规模相比上次递归都应有所减少 3. 递归效率不高,递归层次过多会导致栈溢出(在计算机中,函数调用是通过栈(stack)这种数据结构实现的,每当进入一个函数调用,栈就会加一层栈帧,每当函数返回,栈就会减一层栈帧。由于栈的大小不是无限的,所以,递归调用的次数过多,会导致栈溢出) 堆栈相关知识:http://www.cnblogs.com/lln7777/archive/2012/03/14/2396164.html 递归实例, 二分查找: 1 data = [1, 3, 6, 7, 9, 12, 14, 16, 17, 18, 20, 21, 22, 23, 30, 32, 33, 35] 2 3 4 def binary_search(dataset,find_num): 5 print(dataset) 6 7 if len(dataset) >1: 8 mid = int(len(dataset)/2) 9 if dataset[mid] == find_num: #find it 10 print("找到数字",dataset[mid]) 11 elif dataset[mid] > find_num :# 找的数在mid左面 12 print("\033[31;1m找的数在mid[%s]左面\033[0m" % dataset[mid]) 13 return binary_search(dataset[0:mid], find_num) 14 else:# 找的数在mid右面 15 print("\033[32;1m找的数在mid[%s]右面\033[0m" % dataset[mid]) 16 return binary_search(dataset[mid+1:],find_num) 17 else: 18 if dataset[0] == find_num: #find it 19 print("找到数字啦",dataset[0]) 20 else: 21 print("没的分了,要找的数字[%s]不在列表里" % find_num) 22 23 24 binary_search(data,66) View Code 5.匿名函数 匿名函数就是不需要显式的指定函数 1 def calc(n): 2 return n ** n 3 print(calc(3)) 4 # 换成匿名函数 5 calc = lambda n: n ** n 6 print(calc(3)) 匿名函数主要是和其它函数搭配使用的: res = map(lambda x:x**2,[1,2,3,4,5]) for i in res: print(i) 输出: 1 4 9 16 25 6.函数式编程介绍 函数是Python内建支持的一种封装,我们通过把大段代码拆成函数,通过一层一层的函数调用,就可以把复杂任务分解成简单的任务,这种分解可以称之为面向过程的程序设计。函数就是面向过程的程序设计的基本单元。 函数式编程中的函数这个术语不是指计算机中的函数(实际上是Subroutine),而是指数学中的函数,即自变量的映射。也就是说一个函数的值仅决定于函数参数的值,不依赖其他状态。比如sqrt(x)函数计算x的平方根,只要x不变,不论什么时候调用,调用几次,值都是不变的。 Python对函数式编程提供部分支持。由于Python允许使用变量,因此,Python不是纯函数式编程语言。 一、定义 简单说,"函数式编程"是一种"编程范式"(programming paradigm),也就是如何编写程序的方法论。 主要思想是把运算过程尽量写成一系列嵌套的函数调用。举例来说,现在有这样一个数学表达式: (1 + 2) * 3 - 4 传统的过程式编程,可能这样写: var a = 1 + 2; var b = a * 3; var c = b - 4; 函数式编程要求使用函数,我们可以把运算过程定义为不同的函数,然后写成下面这样: var result = subtract(multiply(add(1,2), 3), 4); 这段代码再演进以下,可以变成这样 add(1,2).multiply(3).subtract(4) 这基本就是自然语言的表达了。再看下面的代码,大家应该一眼就能明白它的意思吧: merge([1,2],[3,4]).sort().search("2") 因此,函数式编程的代码更容易理解。 7.高阶函数 变量可以指向函数,函数的参数能接收变量,那么一个函数就可以接收另一个函数作为参数,这种函数就称之为高阶函数。 def add(a,b,f): return f(a)+f(b) res = add(2,-3,abs) print(res) 8.内置参数 内置参数详解 https://docs.python.org/3/library/functions.html?highlight=built#ascii 几个内置方法用法提醒: #compile f = open("函数递归.py") data =compile(f.read(),'','exec') exec(data) #print msg = "又回到最初的起点" f = open("tofile","w") print(msg,"记忆中你青涩的脸",sep="|",end="",file=f) # #slice # a = range(20) # pattern = slice(3,8,2) # for i in a[pattern]: #等于a[3:8:2] # print(i) # # #memoryview #usage: #>>> memoryview(b'abcd') #<memory at 0x104069648> #在进行切片并赋值数据时,不需要重新copy原列表数据,可以直接映射原数据内存, import time for n in (100000, 200000, 300000, 400000): data = b'x'*n start = time.time() b = data while b: b = b[1:] print('bytes', n, time.time()-start) for n in (100000, 200000, 300000, 400000): data = b'x'*n start = time.time() b = memoryview(data) while b: b = b[1:] print('memoryview', n, time.time()-start) View Code

优秀的个人博客,低调大师

python基础2

1.列表元组 列表是我们最以后最常用的数据类型之一,通过列表可以对数据实现最方便的存储、修改等操作. 定义列表: 1 # yu 2 3 names=["啦啦","嘿嘿",'鱼鱼'] 我们通过列表下标进行数据的提取: 1 # yu 2 names=["啦啦","嘿嘿",'鱼鱼'] 3 print(names) 4 print(names[0])#第一个数据从0开始 5 print(names[-1])#倒过来取值 切片: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha'] 3 print(names[1:3])#取下标1 ,不包含下标3 ['heihei', 'yuyu'] 4 print(names[1:-1])#取下标1至-1的值,不包括-1 5 print(names[:3])#如果是从头开始取,0可以忽略 6 print(names[3:])#取到最后一个值 7 print(names[3:-1])#取不到最后一个值 8 print(names[0::2])#后面的2是代表,每隔一个元素,就取一个 View Code 追加: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha'] 3 names.append("嘻嘻") 4 print(names) 5 #结果['lala', 'heihei', 'yuyu', 'hehe', 'haha', '嘻嘻'] View Code 插入: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha'] 3 names.insert(2,'从2插入') 4 print(names) 5 #结果['lala', 'heihei', '从2插入', 'yuyu', 'hehe', 'haha'] View Code 修改: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha'] 3 names[1]='修改下标为1' 4 print(names) 5 #结果['lala', '修改下标为1', '从2插入', 'yuyu', 'hehe', 'haha'] View Code 删除: 1 names=["lala","heihei",'yuyu','hehe','haha'] 2 #names.clear()#清空列表 3 print(names)#返回[] 4 #del names[1]#删除指定下标的值 5 print(names)#['lala', 'yuyu', 'hehe', 'haha' 6 #names.remove("yuyu")#删除指定的值 7 print(names) 8 names.pop()#默认删最后一个,也可以加入你祥删除的下标 9 print(names) View Code 扩展: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha'] 3 b=[1,2,3] 4 names.extend(b) 5 print(names)#['lala', 'heihei', 'yuyu', 'hehe', 'haha', 1, 2, 3] View Code 拷贝(浅拷贝与深拷贝的区别): 1 names=["Young","Jon",["Tom","Jerry"],'Jems','Sunny'] 2 names2 = names.copy() 3 names[1]="浅copy" 4 names[2][0]="深copy" 5 print('name1:',names) 6 print('name2:',names2) 7 #结果 8 #name1: ['Young', '浅copy', ['深copy', 'Jerry'], 'Jems', 'Sunny'] 9 #name2: ['Young', 'Jon', ['深copy', 'Jerry'], 'Jems', 'Sunny'] View Code 统计: 1 # yu 2 names=["lala","heihei",'yuyu','hehe','haha','haha'] 3 print(names.count('haha'))#结果2 View Code 排序: 1 # yu 2 names=["1lala","3heihei",'5yuyu','4hehe','2haha','1haha'] 3 names.sort() 4 print(names) View Code 反转: 1 names=["1lala","2heihei",'3yuyu','4hehe','5haha','6haha'] 2 names.reverse() 3 print(names) 4 #结果['6haha', '5haha', '4hehe', '3yuyu', '2heihei', '1lala'] View Code 获取下标: 1 # yu 2 names=["0lala","1heihei",'2yuyu','3hehe','4haha','5haha'] 3 print(names.index("2yuyu"))#2 View Code 元组 元组其实跟列表差不多,也是存一组数,只不是它一旦创建,便不能再修改,所以又叫只读列表 定义: names=("lala","heihei",'yuyu','hehe','haha','haha') 它只有2个方法,一个是count,一个是index. 2.字符串操作 特性;不可修改. # yu name='young' #首字母大写 print(name.capitalize() ) # name.casefold() 大写全部变小写 print(name.center(50,"-") ) #输出----------------------young----------------------- # name.count('lex') 统计 lex出现次数 # name.encode() 将字符串编码成bytes格式 # name.endswith("g") 判断字符串是否以g结尾 # "Young\tY".expandtabs(10) 输出'Young Y', 将\t转换成多长的空格 print(name.find('o')) #查找A,找到返回其索引, 找不到返回-1 1 #format 2 cata = "my name is {}, and age is {}" 3 print(cata.format("young",23))#结果my name is young, and age is 23 4 cata = "my name is {}, and age is {}" 5 print(cata.format("23",'young'))#my name is 23, and age is young 6 cata = "my name is {name}, and age is {age}" 7 print(cata.format(age=23,name='young')) 8 9 #format_map 10 cata = "my name is {name}, and age is {age}" 11 print(cata.format_map({'name':'young','age':23})) View Code cata = "my name is {name}, and age is {age}" print(cata.index('a')) print('9aA'.isalnum() ) print('9'.isdigit() )#是否整数) name='Hello' print(name.isnumeric ) # name.isprintable # name.isspace # name.istitle # name.isupper print("|".join(['lala','hihi','wow'])) View Code #maketrans intab = "aeiou" #This is the string having actual characters. outtab = "12345" #This is the string having corresponding mapping character trantab = str.maketrans(intab, outtab) print(trantab) str = "this is string example....wow!!!" print(str.translate(trantab)) # 'th3s 3s str3ng 2x1mpl2....w4w!!!' View Code 1 print(cata.partition('is'))#('my name ', 'is', ' {name}, and age is {age}') 2 print(cata.swapcase())#大小写互换 3 print(cata.zfill(40)) 4 n='hello world' 5 print(n.ljust(40, "-")) 6 print(n.rjust(40, "-")) 7 b="ddefdsdff_哈哈" 8 b.isidentifier() #检测一段字符串可否被当作标志符,即是否符合变量命名规则 View Code 3.字典操作 字典一种key - value 的数据类型. 定义: info = { "1":"嘻嘻", "2":"哈哈", "3":"呵呵", "4":"嘿嘿" } 字典的特性: dict是无序的 key必须是唯一的 增删改查: #增 info["5"]="哇哇" #改 info["1"]="么么" print(info) #删 info.pop("1") #del info["1"] #info.popitem()#随机删除 #查 print("3" in info) print(info["3"]) print(info.get("2")) print(info) View Code 其他方法: print(info.keys()) print(info.values()) info2 = { "5":'啦啦', '6':'哼哼' } info.update(info2) print(info) print(info.setdefault("1","大少")) print(info.items()) View Code 循环dict: #两种方法: for key in info: print(key,info[key]) for k,v in info.items(): print(k,v) View Code 三级菜单: 打印省、市、县三级菜单 可返回上一级 可随时退出程序 data = { '黑龙江':{ "哈尔滨":{ "南岗":["凯德","许乐会所"], "松北":["君慕稀","大保健"] }, "牡丹江":{ "镜泊湖":["大山","河流"], "好地方":{"优美","地灵"}, "小城":{"故事","美好"}, }, "海淀":{}, }, '山东':{ "德州":{}, "青岛":{}, "济南":{} }, '广东':{ "东莞":{}, "常熟":{}, "佛山":{}, }, } exit_flag = False while not exit_flag: for i in data: print(i) choice = input(">>选择进入1") if choice in data: while not exit_flag: for i2 in data[choice]: print("\t",i2); choice2 = input(">>选择进入2") if choice2 in data[choice]: while not exit_flag: for i3 in data[choice][choice2]: print("\t\t", i3); choice3 = input(">>选择进入3") if choice3 in data[choice][choice2]: for i4 in data[choice][choice2][choice3]: print("\t\t", i4); choice4 =input("最后一次,按b返回") if choice4 =="b": pass elif choice4 =="q": exit_flag=True; if choice3 == "b": break elif choice3 == "q": exit_flag = True; if choice2 == "b": break elif choice2 == "q": exit_flag = True; View Code 4.集合操作 集合是一个无序的,不重复的数据组合,它的主要作用如下: 去重,把一个列表变成集合,就自动去重了 关系测试,测试两组数据之前的交集、差集、并集等关系 常用操作: #定义一个集合 list1=[1,23,4,5,6,0] list1 =set(list1) list2=set([1,2,7,8,9,0]) ''' print (list1) print(list2) #交集 print(list1.intersection(list2)) print(list1 & list2) #并集 print(list1.union(list2)) print(list1 | list2) #差集 print(list1.difference(list2)) print(list1 - list2) #子集 list3 = set([1,2,3,4]) list4 = set([1,2]) list5 = set([0,9]) print(list4.issubset(list3)) print(list3.issuperset(list4)) #对称差集 print(list1.symmetric_difference(list2)) print("-----------------------") print(list3.isdisjoint(list5))#看有没有交集,并返回true or false; ''' #添加,没有插入 list1.add(12) print(list1) #删 print(list1.pop()) print(list1.pop()) print(list1) list1.discard(23) print(list1) View Code 5.文件操作 对文件操作流程 打开文件,得到文件句柄并赋值给一个变量 通过句柄对文件进行操作 关闭文件 文件text: 晚风轻拂着澎湖湾 白浪逐沙滩 没有椰林醉斜阳 只是一片海蓝蓝 坐在门前的矮墙上一遍遍幻想 也是黄昏的沙滩上有着脚印两对半 那是外婆拄着杖将我手轻轻挽 踩着薄暮走向余晖暖暖的澎湖湾 一个脚印是笑语一串消磨许多时光 直到夜色吞没我俩在回家的路上 澎湖湾澎湖湾外婆的澎湖湾 有我许多的童年幻想 阳光沙滩海浪仙人掌 还有一位老船长 View Code 基本操作: 1 f = open("外婆的澎湖湾",encoding='utf-8')#文件句柄, 2 # f.write("hello world\n".encode()) 3 f1 = f.readline() 4 print('first line:',f1) 5 print('我是分隔线'.center(50,'-')) 6 data = f.read()# 读取剩下的所有内容,文件大时不要用 7 print(data) #打印文件 8 f.close() View Code 打开文件的模式有: r,只读模式(默认)。 w,只写模式。【不可读;不存在则创建;存在则删除内容;】 a,追加模式。【可读; 不存在则创建;存在则只追加内容;】 "+" 表示可以同时读写某个文件 r+,可读写文件。【可读;可写;可追加】 w+,写读 a+,同a "U"表示在读取时,可以将 \r \n \r\n自动转换成 \n (与 r 或 r+ 模式同使用) rU r+U "b"表示处理二进制文件(如:FTP发送上传ISO镜像文件,linux可忽略,windows处理二进制文件时需标注) rb wb ab with语句 为了避免打开文件后忘记关闭,可以通过管理上下文,即: 1 with open('外婆的澎湖湾','r') as f: 2 3 ... 如此方式,当with代码块执行完毕时,内部会自动关闭并释放文件资源。 在Python 2.7 后,with又支持同时对多个文件的上下文进行管理,即: 1 with open('log1') as obj1, open('log2') as obj2: 2 pass 6.字符的编码与转码 参考文章: http://www.cnblogs.com/yuanchenqi/articles/5956943.html 需知: 1.在python2默认编码是ASCII, python3里默认是unicode 2.unicode 分为 utf-32(占4个字节),utf-16(占两个字节),utf-8(占1-4个字节), so utf-16就是现在最常用的unicode版本, 不过在文件里存的还是utf-8,因为utf8省空间 3.在py3中encode,在转码的同时还会把string 变成bytes类型,decode在解码的同时还会把bytes变回string python3中: 1 import sys 2 print(sys.getdefaultencoding()) 3 s = "你好" 4 5 s_gbk = s.encode("gbk") 6 7 print(s_gbk)#gbk 8 9 print(s.encode())#utf8 10 11 gbk_to_utf8 = s_gbk.decode("gbk").encode("utf-8") 12 print(gbk_to_utf8) View Code
优秀的个人博客,低调大师

Java基础题

List和Set比较,各自的子类比较 对比一:Arraylist与LinkedList的比较 1、ArrayList是实现了基于动态数组的数据结构,因为地址连续,一旦数据存储好了,查询操作效率会比较高(在内存里是连着放的)。 2、因为地址连续, ArrayList要移动数据,所以插入和删除操作效率比较低。 3、LinkedList基于链表的数据结构,地址是任意的,所以在开辟内存空间的时候不需要等一个连续的地址,对于新增和删除操作add和remove,LinedList比较占优势。 4、因为LinkedList要移动指针,所以查询操作性能比较低。 适用场景分析: 当需要对数据进行对此访问的情况下选用ArrayList,当需要对数据进行多次增加删除修改时采用LinkedList。 对比二:ArrayList与Vector的比较 1、Vector的方法都是同步的,是线程安全的,而ArrayList的方法不是,由于线程的同步必然要影响性能。因此,ArrayList的性能比Vector好。 2、当Vector或ArrayList中的元素超过它的初始大小时,Vector会将它的容量翻倍,而ArrayList只增加50%的大小,这样。ArrayList就有利于节约内存空间。 3、大多数情况不使用Vector,因为性能不好,但是它支持线程的同步,即某一时刻只有一个线程能够写Vector,避免多线程同时写而引起的不一致性。 4、Vector可以设置增长因子,而ArrayList不可以。 适用场景分析: 1、Vector是线程同步的,所以它也是线程安全的,而ArrayList是线程异步的,是不安全的。如果不考虑到线程的安全因素,一般用ArrayList效率比较高。 2、如果集合中的元素的数目大于目前集合数组的长度时,在集合中使用数据量比较大的数据,用Vector有一定的优势。 对比三:HashSet与TreeSet的比较 1.TreeSet 是二叉树实现的,Treeset中的数据是自动排好序的,不允许放入null值 。 2.HashSet 是哈希表实现的,HashSet中的数据是无序的,可以放入null,但只能放入一个null,两者中的值都不能重复,就如数据库中唯一约束 。 3.HashSet要求放入的对象必须实现HashCode()方法,放入的对象,是以hashcode码作为标识的,而具有相同内容的String对象,hashcode是一样,所以放入的内容不能重复。但是同一个类的对象可以放入不同的实例。 适用场景分析: HashSet是基于Hash算法实现的,其性能通常都优于TreeSet。我们通常都应该使用HashSet,在我们需要排序的功能时,我们才使用TreeSet。 大体回答如上,类似文章请移驾: List,Set和Map详解及其区别和他们分别适用的场景 HashMap和ConcurrentHashMap的区别 1、HashMap不是线程安全的,而ConcurrentHashMap是线程安全的。 2、ConcurrentHashMap采用锁分段技术,将整个Hash桶进行了分段segment,也就是将这个大的数组分成了几个小的片段segment,而且每个小的片段segment上面都有锁存在,那么在插入元素的时候就需要先找到应该插入到哪一个片段segment,然后再在这个片段上面进行插入,而且这里还需要获取segment锁。 3、ConcurrentHashMap让锁的粒度更精细一些,并发性能更好。 大体回答如上,类似文章请移驾: HashMap详解 至于两者的底层实现,你如果想通过一篇文章就理解了,那就too young了,好好找些博文+看源码去吧。 HashTable和ConcurrentHashMap的区别 它们都可以用于多线程的环境,但是当Hashtable的大小增加到一定的时候,性能会急剧下降,因为迭代时需要被锁定很长的时间。因为ConcurrentHashMap引入了分割(segmentation),不论它变得多么大,仅仅需要锁定map的某个部分,而其它的线程不需要等到迭代完成才能访问map。简而言之,在迭代的过程中,ConcurrentHashMap仅仅锁定map的某个部分,而Hashtable则会锁定整个map。 大体回答如上,类似文章请移驾: HashMap和HashTable到底哪不同? String,StringBuffer和StringBuilder的区别 1、运行速度,或者说是执行速度,在这方面运行速度快慢为:StringBuilder > StringBuffer > String。 2、线程安全上,StringBuilder是线程不安全的,而StringBuffer是线程安全的。 适用场景分析: String:适用于少量的字符串操作的情况 StringBuilder:适用于单线程下在字符缓冲区进行大量操作的情况 StringBuffer:适用多线程下在字符缓冲区进行大量操作的情况 大体回答如上,类似文章请移驾: String、StringBuffer与StringBuilder介绍 wait和sleep的区别 1、sleep()方法是属于Thread类中的,而wait()方法,则是属于Object类中的。 2、sleep()方法导致了程序暂停执行指定的时间,让出cpu给其他线程,但是他的监控状态依然保持着,当指定的时间到了又会自动恢复运行状态。所以在调用sleep()方法的过程中,线程不会释放对象锁。 3、调用wait()方法的时候,线程会放弃对象锁,进入等待此对象的等待锁定池,只有针对此对象调用notify()方法后本线程才进入对象锁定池准备获取对象锁进入运行状态。 转载:阿木侠芋道源码 https://mp.weixin.qq.com/s?__biz=MzUzMTA2NTU2Ng==&mid=2247484399&idx=1&sn=498a9f0151541d7c3bad2ebccb9aaa2f&chksm=fa497c5ecd3ef5488e6c4cddb24df96725b6147b99bbd485aa1f2c0ddb5d5604ef30026fad0d&key=de1ccb5f17d36506c921d919664438825a1235a753e24a11b1ce3a031c7b378e28090b3fdcffd4b73edbaaeb6562b6f280d4bc67a57e6cb626ac516e2eb54ccf7e5aef241c5043778c8fc78b26d0d479&ascene=0&uin=MTE1MDEyOTYwMA%3D%3D&devicetype=iMac+MacBookPro13%2C1+OSX+OSX+10.12.4+build(16E195)&version=12020810&nettype=WIFI&lang=zh_CN&fontScale=100&pass_ticket=8hfanWIrVdtZ6JsIT2zjCOessVLBtelL6wU308J%2FGjCOe3Il9eKp%2BWWn70JiqUCX

优秀的个人博客,低调大师

python 基础语法

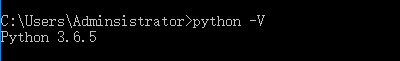
1.查看python版本 python -V 以上命令执行结果如下: 2.标识符 第一个字符必须是字母表中字母或下划线_。 标识符的其他的部分由字母、数字和下划线组成。 标识符对大小写敏感。 3.python保留字 保留字即关键字,我们不能把它们用作任何标识符名称。Python 的标准库提供了一个 keyword 模块,可以输出当前版本的所有关键字: >>> import keyword >>> keyword.kwlist['False', 'None', 'True', 'and', 'as', 'assert', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try', 'while', 'with', 'yield'] 4.注释 Python中单行注释以#开头,实例如下: # 第一个注释 print ("Hello, Python!") 多行注释可以用多个#号,还有'''和""": # 第一个注释 # 第二个注释 ''' 第三注释 第四注释 ''' """ 第五注释 第六注释 """ print ("Hello, Python!") 5.行与缩进 python最具特色的就是使用缩进来表示代码块,不需要使用大括号{}。 缩进的空格数是可变的,但是同一个代码块的语句必须包含相同的缩进空格数。 if True: print('True') else: print('False') 以下代码最后一行语句缩进数的空格数不一致,会导致运行错误: if True: print('C') print('C#') else: print('python') print('java') # 缩进不一致,会导致运行错误错误:IndentationError: unindent does not match any outer indentation level 补充:if else 后的参数可不写"()",单必须写":" 6.多行语句 Python 通常是一行写完一条语句,但如果语句很长,我们可以使用反斜杠(\)来实现多行语句 total = "item_one \ item_two \ item_three" 在 [], {}, 或 () 中的多行语句,不需要使用反斜杠(\) total = ['one', 'two', 'three'] 7.等待用户输入 temp = input('\n请输入内容:') print(temp) \n在结果输出前会输出个新的空行 8.同一行显示多条语句 Python可以在同一行中使用多条语句,语句之间使用分号(;)分割 import sys; x = 'runoob'; sys.stdout.write(x + '\n') # 输出结果:runoob 9.Print 输出 print 默认输出是换行的,如果要实现不换行需要在变量末尾加上end="": string1 = "one" string2 = "two" # 换行输出 print(string1) print(string2) # 不换行输出 print(string1,end=" ") print(string2) 10.import 与 from...import 在 python 用import或者from...import来导入相应的模块。 将整个模块(turtle)导入,格式为:importturtle 从某个模块中导入某个函数,格式为:from turtle import done 从某个模块中导入多个函数,格式为:from turtle import done,deepcopy 将某个模块中的全部函数导入,格式为:from turtle import * import turtle from turtle import done from turtle import done,deepcopy from turtle import * 11.命令行参数 很多程序可以执行一些操作来查看一些基本信息,Python可以使用-h参数查看各参数帮助信息

优秀的个人博客,低调大师

JDBC---基础

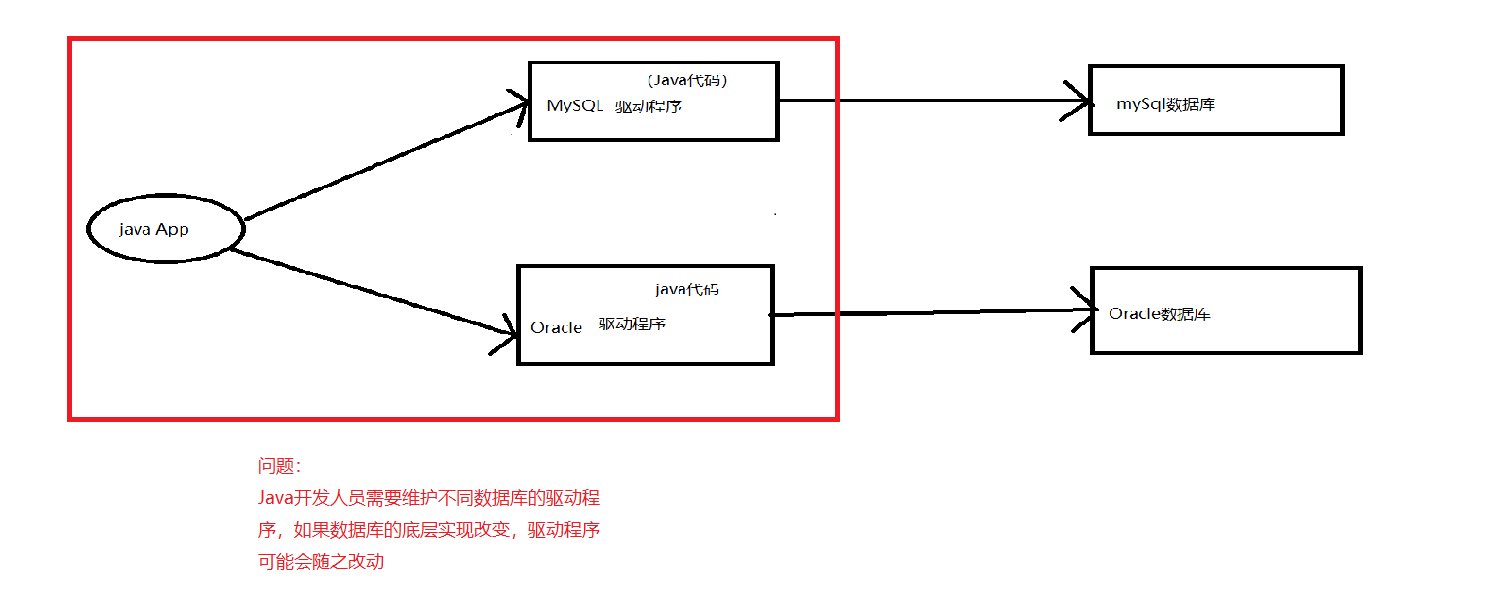
概念 之前操作数据(客户端工具) 登录到服务器(mysql -u root -p root) 编写sql的语句 发送sql语句到数据库服务器执行 jdbc 使用java代码(程序)操作数据库(发送sql语句),的技术就是jdbc技术 使用jdbc执行sql的前提 登录数据库的服务器(连接数据库服务器) 1.数据库的IP地址 2.端口 3.数据库的用户名/密码 image.png image.png jdbc的接口在哪里: java.sql.* javax.sql.* 代码详情 package cn.persistXl.jdbc; import org.junit.jupiter.api.Test; import java.sql.Connection; import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.util.Properties; /** * jdbc链接数据库 * @author persistXL * @data 2018/4/29 14:51 */ public class TestJdbc { //链接数据库的url private String url = "jdbc:mysql://localhost:3306"; private String user = "root"; private String password = "root"; /** * 包括两部分 jdbc协议:数据库子协议:主机:端口/需要链接的数据库 */ /** * * 第一种相连接数据库的方法 * @throws Exception */ @Test public void test() throws Exception { //创建驱动程序类对象 Driver driver = new com.mysql.jdbc.Driver(); //设置一个Properties Properties properties = new Properties(); properties.setProperty("user", user); properties.setProperty("password", password); //链接数据库,返回链接对象 Connection conn = driver.connect(url,properties); System.out.println(conn); } /** * 使用驱动管理器类链接数据库 * 第二种链接数据库的方法 */ @Test public void test1() throws SQLException { //注册驱动程序(可注册多个驱东程序) Driver driver = new com.mysql.jdbc.Driver(); DriverManager.registerDriver(driver); //链接到具体的数据库 Connection conn = DriverManager.getConnection(url, user, password); System.out.println(conn); } /** *最终的简洁版本 */ @Test public void test2() throws SQLException { /* Driver driver = new com.mysql.jdbc.Driver(); //注册驱动程序(可注册多个驱东程序) DriverManager.registerDriver(driver);*/ //通过字节码对象的方式加载静态代码块,从而注册驱动程序 try { Class.forName("com.mysql.jdbc.Driver"); } catch (ClassNotFoundException e) { e.printStackTrace(); } //链接到具体的数据库 Connection conn = DriverManager.getConnection(url, user, password); System.out.println(conn); } } 常用的方式 public class TestJdbc { //链接数据库的url private String url = "jdbc:mysql://localhost:3306"; private String user = "root"; private String password = "root"; /** * 包括两部分 jdbc协议:数据库子协议:主机:端口/需要链接的数据库 */ @Test public void test2() throws SQLException { /* Driver driver = new com.mysql.jdbc.Driver(); //注册驱动程序(可注册多个驱动程序) DriverManager.registerDriver(driver);*/ //通过字节码对象的方式加载静态代码块,从而注册驱动程序 try { Class.forName("com.mysql.jdbc.Driver"); } catch (ClassNotFoundException e) { e.printStackTrace(); } //链接到具体的数据库 Connection conn = DriverManager.getConnection(url, user, password); System.out.println(conn); } } JDBC接口的核心的API java.sql.* 和 javax.sql.* |---Driver 接口:表示java驱动程序接口,所有的具体的数据库厂商要来实现此接口 |-- connect(url,properties):连接数据库的方法 url : 连接数据库的URL URL语法:jsbc协议:数据库子协议://主机:端口/数据库 user:数据库的用户名 password:数据库用户密码 |--DriverManager 类:驱动管理器,用于管理所有的注册的驱动程序 |--registerDriver(driver):注册驱动类对象 |--Connection getConnection(url,user,password); 获取连接对象 |-- Connection接口:表示Java程序和数据库的连接对象 |--Statement createStatement();创建一个Statement对象 |--PreparedStatement preparedStatement(String sql);创建PreparedStatement对象 |- CallableStatement prepareCall(String sql) 创建CallableStatement对象 |- Statement接口: 用于执行静态的sql语句 |- int executeUpdate(String sql) : 执行静态的更新sql语句(DDL,DML) |- ResultSet executeQuery(String sql) :执行的静态的查询sql语句(DQL) |-PreparedStatement接口:用于执行预编译sql语句 |- int executeUpdate() : 执行预编译的更新sql语句(DDL,DML) |-ResultSet executeQuery() : 执行预编译的查询sql语句(DQL) |-CallableStatement接口:用于执行存储过程的sql语句(call xxx) |-ResultSet executeQuery() : 调用存储过程的方法 |- ResultSet接口:用于封装查询出来的数据 |- boolean next() : 将光标移动到下一行 |-getXX() : 获取列的值 使用Statement执行sql语句 执行DDL语句(创建表) package cn.persistXl.statement; import org.junit.Test; import java.sql.Connection; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Statement; /** * @author persistXL * @data 2018/4/29 16:57 */ public class StatementTest { private String url = "jdbc:mysql://localhost:3306/jdbc"; private String user = "root"; private String password = "root"; /** * * 执行DDL语句 */ @Test public void test(){ int count = 0; Connection conn = null; Statement stmt = null; try { //连接数据库,注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接对象 conn = DriverManager.getConnection(url, user, password); //创建statement对象 stmt = conn.createStatement(); //准备sql String sql = "CREATE TABLE student(id INT PRIMARY KEY AUTO_INCREMENT,name VARCHAR(20),gender VARCHAR(4))"; //发送sql语句并执行,得到返回的结果 count = stmt.executeUpdate(sql); //输出 System.out.println(count); } catch (Exception e) { e.printStackTrace(); } finally { //关闭连接(顺序:先打开都关闭) if (stmt != null) { try { stmt.close(); } catch (SQLException e) { e.printStackTrace(); } } if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } } } } 执行DML语句(操作表内容) package cn.persistXl.statement; import org.junit.Test; import java.sql.Connection; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Statement; /** * @author persistXL * @data 2018/4/29 18:06 */ /** * 使用statement执行DML语句 */ public class DmlTest { /** * 增加 */ private String url = "jdbc:mysql://localhost:3306/jdbc"; private String name = "root"; private String password = "root"; @Test public void testInsert() throws SQLException{ Connection conn = null; Statement stmt = null; try { //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接对象 conn = DriverManager.getConnection(url, name, password); //创建Statement对象 stmt = conn.createStatement(); //准备sql语句 String sql = "insert into student(name,gender) VALUES ('zhangsan','nan')"; //执行sql int count = stmt.executeUpdate(sql); System.out.println(count); } catch (Exception e) { e.printStackTrace(); }finally { if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } if (stmt != null) { try { stmt.close(); } catch (SQLException e) { e.printStackTrace(); } } } } @Test public void testUpdate() throws SQLException{ Connection conn = null; Statement stmt = null; try { //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接对象 conn = DriverManager.getConnection(url, name, password); //创建Statement对象 stmt = conn.createStatement(); //准备sql语句 String sql = "UPDATE student SET gender='nv' WHERE id='1'"; //执行sql int count = stmt.executeUpdate(sql); System.out.println(count); } catch (Exception e) { e.printStackTrace(); }finally { if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } if (stmt != null) { try { stmt.close(); } catch (SQLException e) { e.printStackTrace(); } } } } } 创建公共的 db.properties 作用:当连接的数据库不是MySQL时在这里修改,当访问的数据库需要改变时在这里修改 url=jdbc:mysql://localhost:3306/day17 user=root password=root driverClass=com.mysql.jdbc.Driver 抽取公共类(JdbcUtil) package cn.persistXl.util; /** * @author persistXL * @data 2018/4/29 18:27 */ import java.io.FileInputStream; import java.io.InputStream; import java.sql.*; import java.util.Properties; /** * jdbc 的工具类 */ public class JdbcUtil { private static String url = null; private static String name = null; private static String password = null; private static String driverClass = null; /** * 静态代码块(只加载一次) */ static { try { //读取db.properties文件 Properties props = new Properties(); /** * . 代表java命令运行的目录 * 在java项目下,. java命令的运行目录从项目的根目录开始 * 在web项目下, . java命令的而运行目录从tomcat/bin目录开始 * 所以不能使用点. */ //FileInputStream in = new FileInputStream("./src/db.properties"); //若使用java项目时没有问题,若使用web项目时文件的路径就有问题 /** * 使用类路径的读取方式 * / : 斜杠表示classpath的根目录 * 在java项目下,classpath的根目录从bin目录开始 * 在web项目下,classpath的根目录从WEB-INF/classes目录开始 */ InputStream in = JdbcUtil.class.getResourceAsStream("/db.properties"); //加载文件 props.load(in); //读取信息 url = props.getProperty("url"); name = props.getProperty("user"); password = props.getProperty("password"); driverClass = props.getProperty("driverClass"); //注册驱动程序 Class.forName(driverClass); } catch (Exception e) { e.printStackTrace(); System.out.println("驱动程序注册失败"); } } /** * 抽取获取连接对象的方法 */ public static Connection getConnection() { try { Connection conn = DriverManager.getConnection(url, name, password); return conn; } catch (SQLException e) { e.printStackTrace(); throw new RuntimeException(e); } } /** * 释放资源的方法 */ public static void close(Connection conn, Statement stmt, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (SQLException e) { e.printStackTrace(); } } if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } if (stmt != null) { try { stmt.close(); } catch (SQLException e) { e.printStackTrace(); } } } public static void close(Connection conn, Statement stmt) { if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } if (stmt != null) { try { stmt.close(); } catch (SQLException e) { e.printStackTrace(); } } } } 执行DQL语句(查询) package cn.persistXl.statement; /** * @author persistXL * @data 2018/4/29 19:50 */ import cn.persistXl.util.JdbcUtil; import org.junit.Test; import java.sql.Connection; import java.sql.ResultSet; import java.sql.Statement; /** * 使用statement执行DQL语句(查询语句) */ public class InsertTest { @Test public void inseret(){ Connection conn = null; Statement stmt = null; try { //获取连接 conn = JdbcUtil.getConnection(); //创建statement stmt = conn.createStatement(); //准备sql String sql = "SELECT * FROM student"; //执行sql ResultSet rs = stmt.executeQuery(sql); //移动光标 boolean flag = rs.next(); if (flag) { //取出列的值(根据索引值) /* int id = rs.getInt(1); String name = rs.getString(2); String gender = rs.getString(3); System.out.println(id+name+gender); */ //根据列的名称 /* int id = rs.getInt("id"); String name = rs.getString("gender"); String gender = rs.getString("name"); System.out.println(id+name+gender); */ //遍历结果 while (rs.next()) { int id = rs.getInt("id"); String name = rs.getString("gender"); String gender = rs.getString("name"); System.out.println(id+name+gender); } } } catch (Exception e) { e.printStackTrace(); } } } 使用PreparedStatement执行sql package cn.persistXl.PreparedStatement; import cn.persistXl.util.JdbcUtil; import org.junit.Test; import java.sql.*; /** * @author persistXL * @data 2018/4/29 20:26 */ /** * 使用PreparedStatement执行sql语句 */ public class PreparedStatementTest { /** * 增加 */ @Test public void InsertTest(){ Connection conn = null; PreparedStatement stmt = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "insert into student (name,gender) values (?,?)"; //?表示一个参数占位符 //执行预编译sql语句(检查语法) stmt = conn.prepareStatement(sql); //设置参数值 stmt.setString(1,"李四"); stmt.setString(2,"男"); //发送参数,执行sql stmt.executeUpdate(); System.out.println(stmt); } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt); } } /** * 修改 */ @Test public void UpdateTest(){ Connection conn = null; PreparedStatement stmt = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "UPDATE student SET name=? WHERE id=?"; //?表示一个参数占位符 //执行预编译sql语句(检查语法) stmt = conn.prepareStatement(sql); //设置参数值 stmt.setString(1,"王五"); stmt.setInt(2,2); //发送参数,执行sql stmt.executeUpdate(); System.out.println(stmt); } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt); } } /** * 删除 */ @Test public void DeleteTest(){ Connection conn = null; PreparedStatement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "DELETE FROM student WHERE id=?"; //?表示一个参数占位符 } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt, rs); } } /** * 查询 */ @Test public void SelectTest(){ Connection conn = null; PreparedStatement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备预编译sql String sql = "select * from student"; //预编译 stmt = conn.prepareStatement(sql); //执行sql rs = stmt.executeQuery(); boolean flag = rs.next(); System.out.println(flag); if (flag) { //便利rs while (rs.next()) { int id = rs.getInt("id"); String name = rs.getString("name"); String gender = rs.getString("gender"); System.out.println(id + "," + name + "," + gender); } } } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt, rs); } } } 两种方式的登录的比较 package cn.persistXl.PreparedStatement; /** * @author persistXL * @data 2018/4/29 21:38 */ import cn.persistXl.util.JdbcUtil; import org.junit.Test; import java.sql.Connection; import java.sql.PreparedStatement; import java.sql.Statement; import java.sql.ResultSet; /** * 模拟用户登录 */ public class Index { //模拟用户输入 private String name = "admin"; private String password = "admin"; /** * statement存在sql注入风险 */ /* @Test public void idnex(){ Connection conn = null; Statement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //创建statement stmt = conn.createStatement(); //准备sql String sql = "select * from user where name = '"+name+"' and password = '"+password+"'"; //执行sql rs = stmt.executeQuery(sql); if (rs.next()) { //登录成功 System.out.println("登录成功"); } else { //登录失败 System.out.println("登录失败"); } } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt, rs); } }*/ @Test public void idnex(){ /** * PreparedStatement有效预防sql注入 * */ Connection conn = null; PreparedStatement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "select * from user where name =? and password = ?"; //创建sql预编译 stmt = conn.prepareStatement(sql); //设置参数 stmt.setString(1, name); stmt.setString(2, password); //执行sql rs = stmt.executeQuery(); if (rs.next()) { //登录成功 System.out.println("登录成功"); } else { //登录失败 System.out.println("登录失败"); } } catch (Exception e) { e.printStackTrace(); }finally { JdbcUtil.close(conn, stmt, rs); } } } //statement登录时存在sql被注入的风险,PrepareStatement则不存在 PreparedStatement vs Statment 1)语法不同:PreparedStatement可以使用预编译的sql,而Statment只能使用静态的sql 2)效率不同: PreparedStatement可以使用sql缓存区,效率比Statment高 3)安全性不同: PreparedStatement可以有效防止sql注入,而Statment不能防止sql注入。 推荐使用PreparedStatement CallableStatement执行存储过程 /** * 使用CablleStatement调用存储过程 * @author APPle * */ public class Demo1 { /** * 调用带有输入参数的存储过程 * CALL pro_findById(4); */ @Test public void test1(){ Connection conn = null; CallableStatement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "CALL pro_findById(?)"; //可以执行预编译的sql //预编译 stmt = conn.prepareCall(sql); //设置输入参数 stmt.setInt(1, 6); //发送参数 rs = stmt.executeQuery(); //注意: 所有调用存储过程的sql语句都是使用executeQuery方法执行!!! //遍历结果 while(rs.next()){ int id = rs.getInt("id"); String name = rs.getString("name"); String gender = rs.getString("gender"); System.out.println(id+","+name+","+gender); } } catch (Exception e) { e.printStackTrace(); throw new RuntimeException(e); } finally { JdbcUtil.close(conn, stmt ,rs); } } /** * 执行带有输出参数的存储过程 * CALL pro_findById2(5,@NAME); */ @Test public void test2(){ Connection conn = null; CallableStatement stmt = null; ResultSet rs = null; try { //获取连接 conn = JdbcUtil.getConnection(); //准备sql String sql = "CALL pro_findById2(?,?)"; //第一个?是输入参数,第二个?是输出参数 //预编译 stmt = conn.prepareCall(sql); //设置输入参数 stmt.setInt(1, 6); //设置输出参数(注册输出参数) /** * 参数一: 参数位置 * 参数二: 存储过程中的输出参数的jdbc类型 VARCHAR(20) */ stmt.registerOutParameter(2, java.sql.Types.VARCHAR); //发送参数,执行 stmt.executeQuery(); //结果不是返回到结果集中,而是返回到输出参数中 //得到输出参数的值 /** * 索引值: 预编译sql中的输出参数的位置 */ String result = stmt.getString(2); //getXX方法专门用于获取存储过程中的输出参数 System.out.println(result); } catch (Exception e) { e.printStackTrace(); throw new RuntimeException(e); } finally { JdbcUtil.close(conn, stmt ,rs); } } } 总结 JDBC的五部曲 //获取连接 Connection conn = JdbcUtil.getConnection(); //准备sql String sql = ""; //创建PreparedStatement PreparedStatement pstmt = conn.prepareStatement(sql); //设置参数值 stmt.setString(1,""); //发送参数,执行sql stmt.executeUpdate(); //关闭连接(finally内关闭) JdbcUtil.close(conn, stmt); || JdbcUtil.close(conn, stmt, rs);

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册