首页 文章 精选 留言 我的

精选列表

搜索[创意玩法],共4562篇文章
优秀的个人博客,低调大师

带你玩转 Vite + Vue3 高低版本常用玩法 | 京东云技术团队

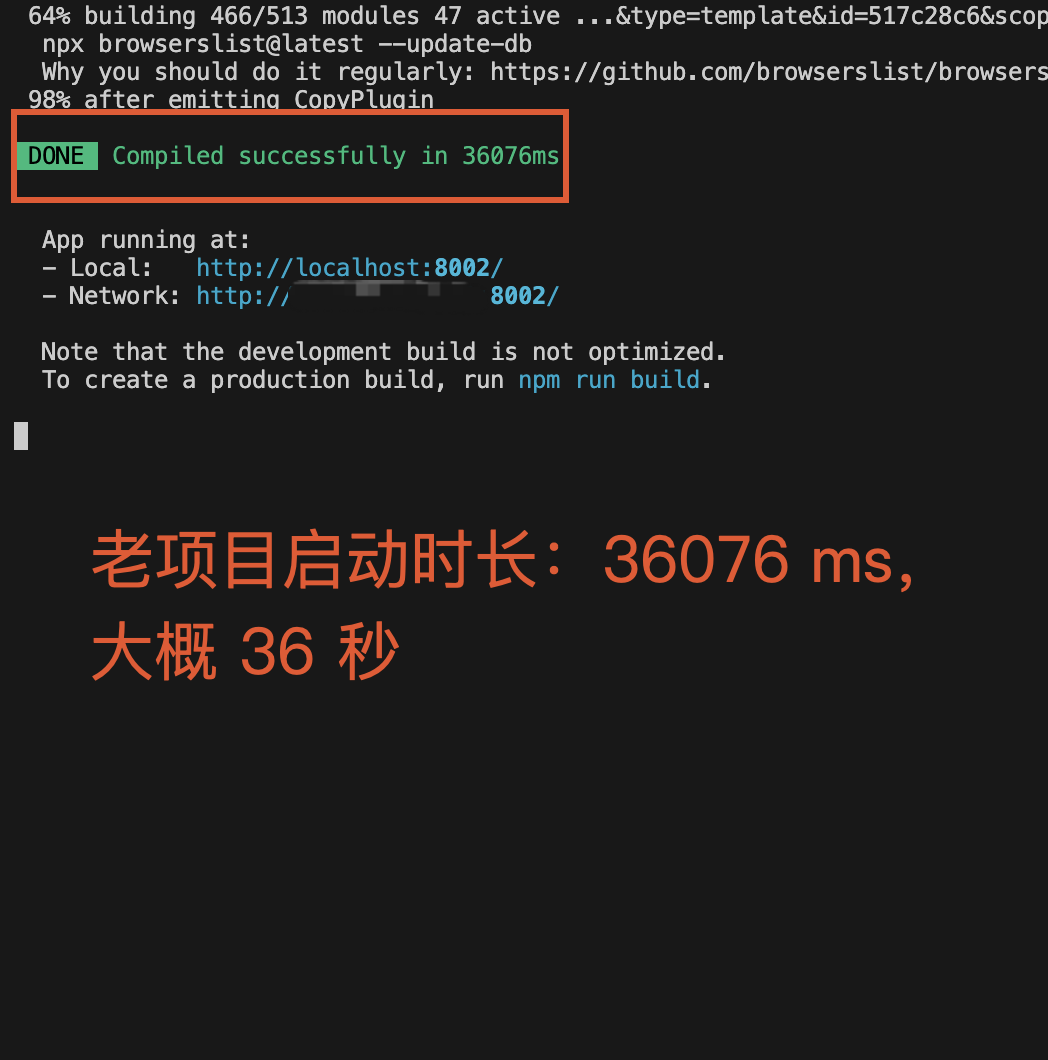
一、首先来个 Vite 的通用简介 Vite 是一种新型前端构建工具,在我们保险前端项目中已经推动并应用很久了,Vite 能够显著降低构建时间,提升前端开发效率。 它主要由两部分组成: 一个开发服务器,它基于 原生 ES 模块 提供了 丰富的内建功能,如速度快到惊人的 模块热更新(HMR) 一套构建指令,它使用 Rollup 打包你的代码,并且它是预配置的,可输出用于生产环境的高度优化过的静态资源 Vite 还提供了强大的扩展性,可通过其 插件 API 和 JavaScript API 进行扩展,并提供完整的类型支持。 二、Vite 的优势,为什么使用 Vite ? 当我们开始构建越来越大型的应用时,需要处理的 JavaScript 代码量也呈指数级增长。包含数千个模块的大型项目相当普遍。基于 JavaScript 开发的工具就会开始遇到性能瓶颈:通常需要很长时间(甚至是几分钟!)才能启动开发服务器,即使使用模块热替换(HMR),文件修改后的效果也需要几秒钟才能在浏览器中反映出来。如此循环往复,严重影响开发人员的效率。 当冷启动开发服务器时,基于打包器的方式启动必须优先抓取并构建你的整个应用,然后才能提供服务,如果项目很大,导致的一个必然结果就是,服务启动很慢,热更新很慢,效率降低。Vite 只需要在浏览器请求源码时进行转换并按需提供源码。根据情景动态导入代码,即只在当前屏幕上实际使用时才会被处理,节省启动及更新时间。 如下图是新旧项目启动时长对比,Vite 启动速度,快了 30 多倍;   常规的通过 webpack 启动的服务,基于打包器启动,整个重新构建,即使将构建内容放到缓存中,更新速度也会随着应用体积增长而直线下降: Vite 在原生 ESM 基础上执行 HMR,Vite 只需要精确地使已编辑的模块与其最近的 HMR 边界之间的链失活(大多数时候只是模块本身),使得无论应用大小如何,HMR 始终能保持快速更新: 三、Vite 为我们开发提升了很大的效率,但是也会有一些小问题 1、使用 Vite + Vue3 +Element-plus 或者其他 UI 库,按需加载使用时,多人开发,每人页面重新 reload 了吗🤓? 2、低版本 Vite(2.9以下)配置 Preview 的 proxy 时,是不是不生效🤓? 3、低版本 Vite 配合 unocss 设置样式后,是不是热更新不生效🤓? 4、部分依赖包,使用京东镜像,是不是无法下载🤓?  如果你遇到了以上问题,那这边文章可以帮助你解决困惑! 四、解决页面 reload 问题:高低版本 Vite 解决方法不同 原因:UI 库配置按需加载,点击跳转新页面,导致重新 reload 页面 情况:高低版本 Vite 解决页面 reload 方法不同 问题现象如下,上方图片页面会 reload,会有一段时间白屏,下方图片中文件 preload:   1、Vite 低版本(v2.9以下)页面 reload 解决方法; 解决方法:提前进行依赖包的预加载,可通过如下两种方法配置,推荐方法b(因为低版本有现成插件); 通过这些配置,就能够使页面 reload 在多人开发时只进行一次。 注意事项(低版本 Vite 的 bug,高版本已经修复): 使用 unocss 时,热更新会失效,需要手动刷新页面,如果不使用 unocss 影响不大 方法a、通过手动配置 vite.config.ts 文件的 optimizeDeps 选项; // vite.config.js { ... optimizeDeps: { include: [ 'vue', 'vue-router', 'pinia', '@element-plus/icons-vue', 'driver.js', 'element-plus', 'element-plus/es', 'element-plus/es/components/alert/style/index', 'element-plus/es/components/badge/style/index', 'element-plus/es/components/breadcrumb-item/style/index', 'element-plus/es/components/breadcrumb/style/index', 'element-plus/es/components/button/style/index', 'element-plus/es/components/card/style/index' ... ] } } 方法b、使用现成的插件 vite-plugin-optimize-persist、vite-plugin-package-config (推荐原因: 自动会生成预加载配置文件 optimizeDeps),通用配置如下: 😂遗憾的是高版本(v2.9及以上失效)配置无效,有兴趣的话,可以试着修改下源码。 // vite.config.ts // 两个插件组合使用,会自动生成 optimizeDeps 配置,默认生成到 package.json 文件中,可通过 PkgConfig() 修改生成目录 import OptimizationPersist from 'vite-plugin-optimize-persist' import PkgConfig from 'vite-plugin-package-config' export default { ... plugins: [ ... PkgConfig(), OptimizationPersist() ] } 2、Vite 高版本(v4+)页面 reload 解决方法: 解决方法:上述两个插件已被弃用,只能自己配置 optimizeDeps 选项,提前进行依赖包的预加载; 全量配置案例如下,备注:如果项目中使用,根据项目需要进行相应依赖包的配置,否则会出现首屏加载过慢的问题,类似我们常规使用的 webpack 一样; // vite.config.js { ... optimizeDeps:{ include: [ '@element-plus/icons-vue', '@tinymce/tinymce-vue', '@vueuse/core', '@vueuse/shared', 'axios', 'clipboard', 'codemirror', 'codemirror/addon/lint/json-lint', 'codemirror/addon/lint/lint', 'codemirror/mode/css/css', 'codemirror/mode/htmlmixed/htmlmixed', 'codemirror/mode/javascript/javascript', 'driver.js', 'element-plus', 'element-plus/es', 'element-plus/es/components/alert/style/index', 'element-plus/es/components/badge/style/index', 'element-plus/es/components/breadcrumb-item/style/index', 'element-plus/es/components/breadcrumb/style/index', 'element-plus/es/components/button/style/index', 'element-plus/es/components/card/style/index', 'element-plus/es/components/cascader/style/index', 'element-plus/es/components/check-tag/style/index', 'element-plus/es/components/checkbox-group/style/index', 'element-plus/es/components/checkbox/style/index', 'element-plus/es/components/col/style/index', 'element-plus/es/components/color-picker/style/index', 'element-plus/es/components/config-provider/style/index', 'element-plus/es/components/date-picker/style/index', 'element-plus/es/components/dialog/style/index', 'element-plus/es/components/divider/style/index', 'element-plus/es/components/drawer/style/index', 'element-plus/es/components/dropdown-item/style/index', 'element-plus/es/components/dropdown-menu/style/index', 'element-plus/es/components/dropdown/style/index', 'element-plus/es/components/empty/style/index', 'element-plus/es/components/form-item/style/index', 'element-plus/es/components/form/style/index', 'element-plus/es/components/icon/style/index', 'element-plus/es/components/input-number/style/index', 'element-plus/es/components/input/style/index', 'element-plus/es/components/link/style/index', 'element-plus/es/components/loading/style/index', 'element-plus/es/components/menu-item/style/index', 'element-plus/es/components/menu/style/index', 'element-plus/es/components/message-box/style/index', 'element-plus/es/components/message/style/index', 'element-plus/es/components/notification/style/index', 'element-plus/es/components/option/style/index', 'element-plus/es/components/pagination/style/index', 'element-plus/es/components/popover/style/index', 'element-plus/es/components/progress/style/index', 'element-plus/es/components/radio-group/style/index', 'element-plus/es/components/radio/style/index', 'element-plus/es/components/row/style/index', 'element-plus/es/components/scrollbar/style/index', 'element-plus/es/components/select/style/index', 'element-plus/es/components/space/style/index', 'element-plus/es/components/step/style/index', 'element-plus/es/components/steps/style/index', 'element-plus/es/components/sub-menu/style/index', 'element-plus/es/components/switch/style/index', 'element-plus/es/components/tab-pane/style/index', 'element-plus/es/components/table-column/style/index', 'element-plus/es/components/table/style/index', 'element-plus/es/components/tabs/style/index', 'element-plus/es/components/tag/style/index', 'element-plus/es/components/timeline-item/style/index', 'element-plus/es/components/timeline/style/index', 'element-plus/es/components/tooltip/style/index', 'element-plus/es/components/transfer/style/index', 'element-plus/es/components/upload/style/index', 'element-plus/es/components/popconfirm/style/index', 'element-plus/es/components/backtop/style/index', 'element-plus/es/components/affix/style/index', 'element-plus/es/components/statistic/style/index', 'element-plus/es/components/tree/style/index', 'element-plus/es/components/tree-v2/style/index', 'element-plus/es/components/tree-select/style/index', 'element-plus/es/components/table-v2/style/index', 'element-plus/es/components/skeleton/style/index', 'element-plus/es/components/skeleton-item/style/index', 'element-plus/es/components/collapse/style/index', 'element-plus/es/components/collapse-item/style/index', 'element-plus/es/components/collapse-transition/style/index', 'element-plus/es/components/carousel/style/index', 'element-plus/es/components/carousel-item/style/index', 'element-plus/es/components/calendar/style/index', 'element-plus/es/components/badge/style/index', 'element-plus/es/components/avatar/style/index', 'element-plus/es/components/aside/style/index', 'element-plus/es/locale/lang/zh-cn', 'fuse.js', 'js-base64', 'js-cookie', 'js-file-download', 'nprogress', 'pako', 'path-browserify', 'path-to-regexp', 'pinia', 'prismjs', 'qs', 'screenfull', 'sortablejs', 'vue', 'vue-json-pretty', 'vue-router', 'vuedraggable' ] } } 五、解决 Vite 低版本(v2.9以下),preview 配置 proxy 不生效: 问题原因:低版本 Vite 的执行 preview 预览时,使用的 proxy 是 server 中的 proxy 配置,官方文档中提供的 preview 的 proxy 无效,这是低版本 Vite 的一个 bug,高版本已经修复,github 上有相关的 issue,也可以通过源码查看。 解决办法: 1. 在 vite.config.js 使用 server 中的 proxy 代替 2. 使用 switchhost 进行代理配置 六、解决 Vite 低版本(v2.9以下),unocss 热更新失效: 1. 解决方法a:升级 Vite,从根本解决问题,以后项目升级比较方便,各种小问题容易规避,推荐升级 2. 解决方法b:降低 unocss 的版本,可能会出现各种其他问题,不建议 针对这个问题,作者没有降低 unocss 的版本,直接进行 Vite 升级,如果使用 unocss 强烈建议进行 Vite 升级; 不升级后期如果使用其他的依赖包,可能也会有各种其他问题出现 七、解决升级 Vite 项目后,部分依赖包,使用京东镜像无法下载: 产生原因:各种依赖包之间互相依赖,京东镜像的 npm 包可能有问题; 解决方法:非京东私有依赖包,使用 npm 官方镜像下载,京东私有镜像使用京东镜像,初始化项目,生成 package-lock.json 文件,多人合作时,以 package-lock.json 文件为主。 总结:Vite 帮助我们提升开发效率,但是区分 Vite 是否需要使用最新版本,还是需要作为考虑依据: 如果你的项目不使用 unocss,同时对于 preview 下的 proxy 没有特殊要求,那么 Vite2.8.6 + Vue3 + elementPlus 可自动生成预加载文件,省时省力,开发体验好,强烈推荐;如果你的项目使用 unocss 或者对于 preview 下的 proxy 有特殊需求,强烈建议使用最新版本的 Vite,可通过手动配置 optimizeDeps 解决页面刷新的问题。 作者:京东保险 王升升 来源:京东云开发者社区 转载请注明来源


优秀的个人博客,低调大师

这些新玩法你一定要知道

​点击关注异步图书,置顶公众号 每天与你分享 IT好书 技术干货 职场知识​ ​参与文末话题讨论,赠送20本e读版异步图书。 ——异步小编 异步社区的老用户们可能注意到了,社区最近做了一次大的升级改版。有多大呢?答案是:很大!按照一年一个大版本来算,今年是异步社区上线运营的第三年,可以叫做异步社区3.0版。新版本的发布时间非常好记,是一个节日——3月8日,不知道开发团队是不是为了让我们记住这一天才选择这一天的。上线后经过不断的找bug、修bug、持续优化,目前不知不觉已经开始了3.2版的开发工作。那这个版本到底有哪些变化呢,下面听本掌柜的一一为您介绍。 一、系统重构 这次最大的变化是,是从底层代码和架构上重建了整个社区网站,之所以痛下决心,是由于之前存在效率低且升级难度大的情况,不利于未来的持续发展。通过这次升级,同时配合人民邮电出版社整体信息基础架构的全面改善和平台建设,社区的功能和运维有了一个极大的提升。 这次重构后的重点有: 新的域名www.epubit.com, 之前是.com.cn的域名; 部署了HTTPS,确保网站的安全性,域名更新为https://www.epubit.com; 采取了标准化的支付平台,前后台更方便安全快捷,支持主流支付模式; 增加了海外短信通知功能。 还有一个变化要提醒您的是,所有的资源下载统一放在了人民邮电出版社整体的资源云平台上,在异步社区点击下载后会跳转到企业云盘界面,这里需要输入一次提取码。这次调整,能够保证用户下载资源时的速度,避免以前出现的资源过大不易下载成功的情况。同时也减轻了社区网站的负担。 二、新增多个重磅新功能 作为一次重大版本升级,必须要有一些重要的功能改进,为用户提供更好的体验和更多的价值。 全新改进的写作环境 比原来的版本有了非常大的改善,我现在正愉快地在全新的MarkDown中奋笔疾书。欢迎喜欢写作的朋友们来试一下。 登录的便利性 全面支持微信、微博、QQ和GitHub登录。如果您关注了异步社区的服务号,可以从那儿直接登录进社区,方便用户在微信浏览器内访问社区。 e读版 全面优化了在线阅读电子书的体验,推出了e读版,让用户能更方便地阅读电子书。如果您是电子书的新用户,对于用什么软件看下载版电子书还不是很熟悉的时候,登录社区随时阅读e读版电子书,会是一个不错的选择,同时也非常便于集中管理您在异步社区购买的所有图书。我们未来会针对e读版,不断提供更多的附加服务。 如果您是电子书重度用户,习惯使用下载版,没有问题,这部分没有任何变化,您可以继续享用。 视频课程 我们开放了在线视频课程功能,在纸书、电子书之外,又提供了一种学习介质。目前视频课程正在开发制作中。 扫码关注图书 特别要提一下的,就是用户可以扫码关注图书,这样就方便了在其他渠道购买异步图书的用户,通过扫描印在图书上的二维码,将图书加入“我的书架”,就能够随时接收到这本书相关的信息推送和服务,还会有优惠购买本书电子书的专享权益。 UI优化 UI优化就不多说了,大家可以感受下,编辑同事们都表示比以前要好看了。另外在移动端包括从微信浏览器访问社区,界面和体验都做了相当多的优化。交互的优化没有止境,如果您发现有任何体验方面的问题,也欢迎随时告诉@异步君。 下一个呢,我得想想,可能是研发还没做完? 开玩笑了,但我们持续迭代改进不会停,今年会再发布三到五个小版本更新,敬请期待。如果您有兴趣作为早期体验者参与新功能测试,欢迎向@异步君 报名。 三、体验新版异步 新异步中有些地方与老异步会有不同,我们一起来看一下。 图书单品页面 这儿最大的变化是产品形态不再只是原来的纸书电子书两种,而是分成了四种。​ ​了解了e读版以后,您就可以选择适合您的方案了。当然要注意的是,敲下黑板,如果您在社区内购买纸书,是会自动获得本书的e读版的。这可是真真正正的大大福利包! 展示一下e读版的界面 ​专题页面 专题页面方便了对某一技术方向感兴趣的同学集中浏览相关信息,包括图书、文章、书评和视频课等。技术方向会包括热点领域如人工智能,以及异步社区比较有特色的方向,比如我们的经典图书。 ​视频课 我们会精选主题和讲师,开发热点技术的视频课程,涵盖C/C++,Python、深度学习、知识图谱以及软件测试等领域。如果您想学习哪方面的课程,或者您有兴趣来录制视频,也欢迎告诉我们!​ ​优惠券 其他的一些地方,基本与老异步是差不多的,比如提交勘误,样书兑换,积分等。有点变化的是购买优惠的发放形式,不再是原来以一串字符的优惠码方式,而是体现为用户帐号下的优惠券,使用更直观。 ​更多的图书品类 还有一个值得关注的变化,就是异步社区里的图书品类更丰富了!出版社兄弟编辑部门的一些图书也在社区内上架,虽然他们没有打异步图书的品牌,但都是品质非常优秀的图书,掌柜的我也是精挑严选,希望大家能喜欢。目前主要选了以下几个分类,与异步图书形成了很好的互补。一是IT相关图书品类,包括产品与运营、平面设计,以及产业经济类。二是丰富程序员业余的两个品类,也是邮电出版社的两个非常有影响力的出版领域。 健身类图书 希望社区的用户在学习和敲代码之余,不要忘记锻炼身体。 严选标准:内容严谨科学,实现起来不会太复杂。比如这些图书:无器械健身、微拉伸治疗酸疼、跑步等。 格物致知的科普图书 严选标准:内容严肃、有深度,达到烧脑的效果。第一批上架的涵盖天文、宇宙、进化以及量子物理等领域的精品图书,希望可以帮助爱学习爱思考的您,扩展知识面,拓展思维力。 这些图书是否合您口味,也希望听到大家的反馈。 鸣谢 虽然我们的研发小伙伴们奋战了几个月上线这个版本,但由于是重新构架系统,难免存在一些小问题。欢迎您来报告bug!确认后我们会向您赠送积分或优惠券以表谢意。 今日互动 你喜欢异步社区的哪些新功能?截止时间4月22日17时,留言+转发本活动到朋友圈,小编将抽奖选出20名读者赠送e读版100元异步社区代金券一张,(留言点赞最多的自动获得一张)。 ​ 推荐阅读 2018年4月新书书单 异步图书最全Python书单 一份程序员必备的算法书单 第一本Python神经网络编程图书 ​ ​长按二维码,可以关注我们哟 每天与你分享IT好文。 在“异步图书”后台回复“关注”,即可免费获得2000门在线视频课程;推荐朋友关注根据提示获取赠书链接,免费得异步e读版图书一本。赶紧来参加哦! 阅读原文

优秀的个人博客,低调大师

16个获奖名额,总奖池33万,“地心飞行”AIGC大赛全网征集创意视频

如果硬盘里正好躺着一部做完的超现实题材片子,或者你一直想用 AI 拍一段扣人心弦的冒险,现在有一场大赛正在等你的作品。 第四届开放原子大赛·2026 开源行业解决方案创新赛(下称北京开源创新赛)的赛道三,是「地心飞行」AIGC 创作赛道。它面向沉浸式飞行影院这类文旅场景,征集 2-5 分钟的超高清视频,主题围绕地底世界的奇观展开。怎么抵达、用谁的视角看、地心长什么样,都由创作者自己定。 16 个获奖名额,33.6 万元 本赛道共设 16 个获奖名额,总奖金价值 336000 元,现金与 Token 各占一半。 一等奖 1 名,每队 5 万元现金加 5 万元 Token 二等奖 2 名,每队 2.5 万元现金加 2.5 万元 Token 三等奖 3 名,每队 1 万元现金加 1 万元 Token 潜力奖 4 名,每队 5000 元现金加 5000 元 Token 地心探索奖 6 名,每队 3000 元现金加 3000 元 Token 获奖选手还将额外获得 Shotlab 新片场提供的额外创作币奖励。 前面四档是基础奖,10 个名额合计 30 万元。地心探索奖是这条赛道独有的特设奖,6 个名额合计 3.6 万元,只颁给做地心飞行主题的作品。放在同类 AI 创作征集里,这个名额数量和奖池规模都算靠前。 可以挑战主题,也可以直接提交成品 这条赛道为参赛选手提供了两条参赛路径,可根据自身条件任意选择: 第一条路,围绕「地心飞行」主题重新做一部片子。成片分辨率要求 1920×1440,评审时将额外获得主题契合度加分,权重 15%,6 个地心探索奖也只有这条路能争。适合愿意从头搭一个地心世界、奔高分去的参赛选手。 第二条路,题材不限。任何有超现实想象力的视频都能投稿,分辨率 1080p 即可。手头已经有完成度不错的奇幻题材作品,不用改也不用重做,直接交上来参赛。代价只有一点,不享受地心主题加分,也不参与地心探索奖,其余评审一视同仁。 不限制是否采用开源模型或工具 本次大赛的 AIGC 赛道对作品是否用开源大模型生成没有要求,工具链是否为开源软件也不做限制。至于开源体现在哪,看的是过程,提示词原样分享出来,用了哪些模型和工具列清楚,从构思到成片的工作流写明白,就视作开源。 一段反复打磨的提示词、一条跑顺畅的工作流,只要把创作过程讲清楚,本身也是一种「开源」。 大赛报名节点 2026 北京开源创新赛由开放原子开源基金会主办、开源中国承办。大赛报名截止 10 月 31 日 24 点,11 月 6 日公布入围名单,11 月 13 日 - 14 日在北京亦庄通明湖会议中心举办线下总决赛。

优秀的个人博客,低调大师

每日一博 | 还在用 ES 查日志吗,快看看石墨文档 Clickhouse 日志架构玩法

1 背景 石墨文档全部应用部署在Kubernetes上,每时每刻都会有大量的日志输出,我们之前主要使用SLS和ES作为日志存储。但是我们在使用这些组件的时候,发现了一些问题。 成本问题: SLS个人觉得是一个非常优秀的产品,速度快,交互方便,但是SLS索引成本比较贵 我们想减少SLS索引成本的时候,发现云厂商并不支持分析单个索引的成本,导致我们无法知道是哪些索引构建的不够合理 ES使用的存储非常多,并且耗费大量的内存 通用问题: 如果业务是混合云架构,或者业务形态有SAAS和私有化两种方式,那么SLS并不能通用 日志和链路,需要用两套云产品,不是很方便 精确度问题:SLS存储的精度只能到秒,但我们实际日志精度到毫秒,如果日志里面有traceid,SLS中无法通过根据traceid信息,将日志根据毫秒时间做排序,不利于排查错误 我们经过一番调研后,发现使用Clickhouse能够很好的解决以上问题,并且Clickhouse省存储空间,非常省钱,所以我们选择了Clickhouse方案存储日志。但当我们深入研究后,Clickhouse作为日志存储有许多落地的细节,但业界并没有很好阐述相关Clickhouse采集日志的整套流程,以及没有一款优秀的Clickhouse日志查询工具帮助分析日志,为此我们写了一套Clickhouse日志系统贡献给开源社区,并将Clickhouse的日志采集架构的经验做了总结。先上个Clickhouse日志查询界面,让大家感受下石墨最懂前端的后端程序员。 2 架构原理图 我们将日志系统分为四个部分:日志采集、日志传输、日志存储、日志管理。 日志采集:LogCollector采用Daemonset方式部署,将宿主机日志目录挂载到LogCollector的容器内,LogCollector通过挂载的目录能够采集到应用日志、系统日志、K8S审计日志等 日志传输:通过不同Logstore映射到Kafka中不同的Topic,将不同数据结构的日志做了分离 日志存储:使用Clickhouse中的两种引擎数据表和物化视图 日志管理:开源的Mogo系统,能够查询日志,设置日志索引,设置LogCollector配置,设置Clickhouse表,设置报警等 以下我们按照这四大部分,阐述其中的架构原理 3 日志采集 3.1 采集方式 Kubernetes容器内日志收集的方式通常有以下三种方案 DaemonSet方式采集:在每个 node 节点上部署LogCollector,并将宿主机的目录挂载为容器的日志目录,LogCollector读取日志内容,采集到日志中心。 网络方式采集:通过应用的日志 SDK,直接将日志内容采集到日志中心 。 SideCar方式采集:在每个 pod 内部署LogCollector,LogCollector只读取这个 pod 内的日志内容,采集到日志中心。 以下是三种采集方式的优缺点: DaemonSet方式 网络方式 SideCar方式 采集日志类型 标准输出+文件 应用日志 部署运维 一般,维护DaemonSet 低,维护配置文件 日志分类存储 可通过容器/路径等映射 业务独立配置 支持集群规模 取决于配置数 无限制 适用场景 日志分类明确、功能较单一 性能要求极高的场景 资源消耗 中 低 我们主要采用DaemonSet方式和网络方式采集日志。DaemonSet方式用于ingress、应用日志的采集,网络方式用于大数据日志的采集。以下我们主要介绍下DeamonSet方式的采集方式。 ​ 3.2 日志输出 从上面的介绍中可以看到,我们的DaemonSet会有两种方式采集日志类型,一种是标准输出,一种是文件。 引用元乙的描述:虽然使用 Stdout 打印日志是 Docker 官方推荐的方式,但大家需要注意:这个推荐是基于容器只作为简单应用的场景,实际的业务场景中我们还是建议大家尽可能使用文件的方式,主要的原因有以下几点: Stdout 性能问题,从应用输出 stdout 到服务端,中间会经过好几个流程(例如普遍使用的JSON LogDriver):应用 stdout -> DockerEngine -> LogDriver -> 序列化成 JSON -> 保存到文件 -> Agent 采集文件 -> 解析 JSON -> 上传服务端。整个流程相比文件的额外开销要多很多,在压测时,每秒 10 万行日志输出就会额外占用 DockerEngine 1 个 CPU 核; Stdout 不支持分类,即所有的输出都混在一个流中,无法像文件一样分类输出,通常一个应用中有 AccessLog、ErrorLog、InterfaceLog(调用外部接口的日志)、TraceLog 等,而这些日志的格式、用途不一,如果混在同一个流中将很难采集和分析; Stdout 只支持容器的主程序输出,如果是 daemon/fork 方式运行的程序将无法使用 stdout; 文件的 Dump 方式支持各种策略,例如同步/异步写入、缓存大小、文件轮转策略、压缩策略、清除策略等,相对更加灵活。 从这个描述中,我们可以看出在docker中输出文件在采集到日志中心是一个更好的实践。所有日志采集工具都支持采集文件日志方式,但是我们在配置日志采集规则的时候,发现开源的一些日志采集工具,例如fluentbit、filebeat在DaemonSet部署下采集文件日志是不支持追加例如pod、namespace、container_name、container_id等label信息,并且也无法通过这些label做些定制化的日志采集。 agent类型 采集方式 daemonset部署 sidecar部署 ilogtail 文件日志 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集 fluentbit 文件日志 无法追加label信息,无法根据label过滤采集 能够追加abel信息,能够根据label过滤采集 filebeat 文件日志 无法追加label信息,无法根据label过滤采集 能够追加label信息,能够根据label过滤采集 ilogtail 标准输出 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集 fluentbit 标准输出 能够追加label信息,能够根据label过滤采集 能够追加abel信息,能够根据label过滤采集 filebeat 标准输出 能够追加label信息,能够根据label过滤采集 能够追加label信息,能够根据label过滤采集 基于无法追加label信息的原因,我们暂时放弃了DeamonSet部署下文件日志采集方式,采用的是基于DeamonSet部署下标准输出的采集方式。 ​ 3.3 日志目录 以下列举了日志目录的基本情况 目录 描述 类型 /var/log/containers 存放的是软链接,软链到/var/log/pods里的标准输出日志 ​标准输出 /var/log/pods 存放标准输出日志 ​标准输出 /var/log/kubernetes/ master存放Kubernetes 审计输出日志 标准输出 /var/lib/docker/overlay2 存放应用日志文件信息 文件日志 /var/run 获取docker.sock,用于docker通信 文件日志 /var/lib/docker/containers 用于存储容器信息 两种都需要 因为我们采集日志是使用的标准输出模式,所以根据上表我们的LogCollector只需要挂载/var/log,/var/lib/docker/containers两个目录。 3.3.1 标准输出日志目录 应用的标准输出日志存储在/var/log/containers目录下,​文件名是按照K8S日志规范生成的。这里以nginx-ingress的日志作为一个示例。我们通过ls /var/log/containers/ | grep nginx-ingress指令,可以看到nginx-ingress的文件名。 nginx-ingress-controller-mt2wx_kube-system_nginx-ingress-controller-be3741043eca1621ec4415fd87546b1beb29480ac74ab1cdd9f52003cf4abf0a.log ​ 我们参照K8S日志的规范:/var/log/containers/%{DATA:pod_name}_%{DATA:namespace}_%{GREEDYDATA:container_name}-%{DATA:container_id}.log。可以将nginx-ingress日志解析为: pod_name:nginx-ingress-controller-mt2w namespace:kube-system container_name:nginx-ingress-controller container_id:be3741043eca1621ec4415fd87546b1beb29480ac74ab1cdd9f52003cf4abf0a 通过以上的日志解析信息,我们的LogCollector 就可以很方便的追加pod、namespace、container_name、container_id的信息。 ​ 3.3.2 容器信息目录 应用的容器信息存储在/var/lib/docker/containers目录下,目录下的每一个文件夹为容器ID,我们可以通过cat config.v2.json获取应用的docker基本信息。 3.4 LogCollector采集日志 3.4.1 配置 我们LogCollector采用的是fluent-bit,该工具是cncf旗下的,能够更好的与云原生相结合。通过Mogo系统可以选择Kubernetes集群,很方便的设置fluent-bit configmap的配置规则。 3.4.2 数据结构 ​fluent-bit的默认采集数据结构 @timestamp字段:string or float,用于记录采集日志的时间 log字段:string,用于记录日志的完整内容 Clickhouse如果使用@timestamp的时候,因为里面有@特殊字符,会处理的有问题。所以我们在处理fluent-bit的采集数据结构,会做一些映射关系,并且规定双下划线为Mogo系统日志索引,避免和业务日志的索引冲突。 _time_字段:string or float,用于记录采集日志的时间 _log_字段:string,用于记录日志的完整内容 例如你的日志记录的是{"id":1},那么实际fluent-bit采集的日志会是{"_time_":"2022-01-15...","_log_":"{\"id\":1}" 该日志结构会直接写入到kafka中,Mogo系统会根据这两个字段_time_、_log_设置clickhouse中的数据表。 3.4.3 采集 如果我们要采集ingress日志,我们需要在input配置里,设置ingress的日志目录,fluent-bit会把ingress日志采集到内存里。 然后我们在filter配置里,将log改写为_log_ 然后我们在ouput配置里,将追加的日志采集时间设置为_time_,设置好日志写入的kafka borkers和kafka topics,那么fluent-bit里内存的日志就会写入到kafka中 日志写入到Kafka中_log_需要为json,如果你的应用写入的日志不是json,那么你就需要根据fluent-bit的parser文档,调整你的日志写入的数据结构:https://docs.fluentbit.io/manual/pipeline/filters/parser 4 日志传输 Kafka主要用于日志传输。上文说到我们使用fluent-bit采集日志的默认数据结构,在下图kafka工具中我们可以看到日志采集的内容。 在日志采集过程中,会由于不用业务日志字段不一致,解析方式是不一样的。所以我们在日志传输阶段,需要将不同数据结构的日志,创建不同的Clickhouse表,映射到Kafka不同的Topic。这里以ingress为例,那么我们在Clickhouse中需要创建一个ingress_stdout_stream的Kafka引擎表,然后映射到Kafka的ingress-stdout Topic里。 5 日志存储 我们会使用三种表,用于存储一种业务类型的日志。 Kafka引擎表:将数据从Kafka采集到Clickhouse的ingress_stdout_stream数据表中 createtablelogger.ingress_stdout_stream ( _source_String, _pod_name_String, _namespace_String, _node_name_String, _container_name_String, _cluster_String, _log_agent_String, _node_ip_String, _time_Float64, _log_String ) engine=KafkaSETTINGSkafka_broker_list='kafka:9092',kafka_topic_list='ingress-stdout',kafka_group_name='logger_ingress_stdout',kafka_format='JSONEachRow',kafka_num_consumers=1; 物化视图:将数据从ingress_stdout_stream数据表读取出来,_log_根据Mogo配置的索引,提取字段在写入到ingress_stdout结果表里 CREATEMATERIALIZEDVIEWlogger.ingress_stdout_viewTOlogger.ingress_stdoutAS SELECT toDateTime(toInt64(_time_))AS_time_second_, fromUnixTimestamp64Nano(toInt64(_time_*1000000000),'Asia/Shanghai')AS_time_nanosecond_, _pod_name_, _namespace_, _node_name_, _container_name_, _cluster_, _log_agent_, _node_ip_, _source_, _log_AS_raw_log_,JSONExtractInt(_log_,'status')ASstatus,JSONExtractString(_log_,'url')ASurl FROMlogger.ingress_stdout_streamwhere1=1; 结果表:存储最终的数据 createtablelogger.ingress_stdout ( _time_second_DateTime, _time_nanosecond_DateTime64(9,'Asia/Shanghai'), _source_String, _cluster_String, _log_agent_String, _namespace_String, _node_name_String, _node_ip_String, _container_name_String, _pod_name_String, _raw_log_String, statusNullable(Int64), urlNullable(String), ) engine=MergeTreePARTITIONBYtoYYYYMMDD(_time_second_) ORDERBY_time_second_ TTLtoDateTime(_time_second_)+INTERVAL7DAY SETTINGSindex_granularity=8192; 6 总结流程 日志会通过fluent-bit的规则采集到kafka,在这里我们会将日志采集到两个字段里 _time_字段用于存储fluent-bit采集的时间 _log_字段用于存放原始日志 通过mogo,在clickhouse里设置了三个表 app_stdout_stream: 将数据从Kafka采集到Clickhouse的Kafka引擎表 app_stdout_view: 视图表用于存放mogo设置的索引规则 app_stdout:根据app_stdout_view索引解析规则,消费app_stdout_stream里的数据,存放于app_stdout结果表中 最后mogo的UI界面,根据app_stdout的数据,查询日志信息 7 Mogo界面展示 查询日志界面 设置日志采集配置界面 以上文档描述是针对石墨Kubernetes的日志采集,想了解物理机采集日志方案的,可以在下文中找到《Mogo使用文档》的链接,运行docker-compose体验Mogo 全部流程,查询Clickhouse日志。限于篇幅有限,Mogo的日志报警功能,下次在讲解。 ​ 8 资料 github地址: https://github.com/shimohq/mogo Mogo文档:https://mogo.shimo.im Mogo使用文档:https://mogo.shimo.im/doc/AV62KU4AABMRQ fluent-bit文档:https://docs.fluentbit.io/ K8S日志 6 个 K8S 日志系统建设中的典型问题,你遇到过几个:https://developer.aliyun.com/article/718735 一文看懂 K8S 日志系统设计和实践:https://developer.aliyun.com/article/727594 9 个技巧,解决 K8S 中的日志输出问题:https://developer.aliyun.com/article/747821 直击痛点,详解 K8S 日志采集最佳实践:https://developer.aliyun.com/article/749468?spm=a2c6h.14164896.0.0.24031164UoPfIX Clickhouse Clickhouse官方文档:https://clickhouse.com/ Clickhouse作为Kubernetes日志管理解决方案中的存储:http://dockone.io/article/9356 Uber 如何使用 ClickHouse 建立快速可靠且与模式无关的日志分析平台?:https://www.infoq.cn/article/l4thjgnr7hxpkgpmw6dz 干货 | 携程ClickHouse日志分析实践:https://mp.weixin.qq.com/s/IjOWAPOJXANRQqRAMWXmaw 为什么我们要从ES迁移到ClickHouse:https://mp.weixin.qq.com/s/l4RgNQPxvdNIqx52LEgBnQ ClickHouse 在日志存储与分析方面作为 ElasticSearch 和 MySQL 的替代方案:https://mp.weixin.qq.com/s/nJXorcgi0QfXPCKr_HdUZg 快手、携程等公司转战到 ClickHouse,ES 难道不行了?:https://mp.weixin.qq.com/s/hP0ocT-cBCeIl9n1wL_HBg 日志分析下ES/ClickHouse/Loki比较与思考:https://mp.weixin.qq.com/s/n2I94X6tz2jOABzl1djxYg

优秀的个人博客,低调大师

【金融客服AI新玩法】语言学运用、LSTM+DSSM算法、多模态情感交互

目前,人工智能已经在金融领域渗透:智能客服、智能投顾、人脸支付、智能安防等,已经进入商业化阶段。在这些应用场景中,智能客服属于获客机会最大的业务。 埃森哲(Accenture)去年的《全球消费者消费渠道与市场调研》显示,在银行、保险等金融行业,有七成的消费者愿意选择人工智能客服为他们的消费决策提供建议。正因如此,市场上涌现出大量的智能客服创业公司。 创业公司广泛存在一方面说明行业整体技术壁垒较低,另一方面,也说明智能客服的在金融领域的应用商业场景还有巨大的开发空间。如何在构建技术壁垒的同时开发更多的商业场景,是创业公司能够脱颖而出关键。 三大痛点:传统NLP方法对意图和语意理解不足、缺少深度学习训练模型数据、无法精确感知用户情绪 通常意义上的智能客服系统有语音客服、文字客服两大形态,其核心技术主要由语音识别、自然语言处理、语音合成组成(部

优秀的个人博客,低调大师

ASP.NET Core中如影随形的”依赖注入”[下]: 历数依赖注入的N种玩法

在对ASP.NET Core管道中关于依赖注入的两个核心对象(ServiceCollection和ServiceProvider)有了足够的认识之后,我们将关注的目光转移到编程层面。在ASP.NET Core应用中基于依赖注入的编程主要涉及到两个方面,它们分别是将服务注册到ServiceCollection中,和采用注入的方式利用ServiceProvider提供我们所需的服务。我们先来讨论ASP.NET Core应用中如何进行服务注册。[本文已经同步到《ASP.NET Core框架揭秘》之中] 目录 一、服务注册 系统自动注册的服务 手工注册的服务 二、以注入的形式提取服务 启动类型的构造函数和Configure方法种注入服务 中间件类型的构造函数和Invoke方法中注入服务 Controller类型的构造函数中注入服务 View中注入服务 三、与第三方DI框架的整合 一、服务注册 就注册的主体来划分,ASP.NET Core应用中注册的服务大体可以分为两种类型,一种是WebHostBuilder在创建WebHost之前自动注册的服务,这些服务确保了后续管道能够顺利构建并能提供基本的请求处理能力。另一种则是用户根据自身的需要注册的,如果系统自动注册的服务不符合我们的需求,我们也可以注册自己的服务来覆盖它。 系统自动注册的服务 那么系统在构建ASP.NET Core管道的时候到底自行注册了那些服务呢?对于这个问题,我们不用去查看相关的源代码如何编写,而只需要编写如下一个简单的程序就可以将这些服务输出来。 1: publicclass Program 2: { 3: publicstaticvoid Main() 4: { 5: Console.WriteLine("{0,-30}{1,-15}{2}", "Service Type", "Lifetime", "Implementation"); 6: Console.WriteLine("-------------------------------------------------------------"); 7: 8: new WebHostBuilder() 9: .UseKestrel() 10: .Configure(app => { }) 11: .ConfigureServices(svcs => 12: { 13: IServiceProvider serviceProvider = svcs.BuildServiceProvider(); 14: foreach (var svc in svcs) 15: { 16: if (null != svc.ImplementationType) 17: { 18: Console.WriteLine("{0,-30}{1,-15}{2}", svc.ServiceType.Name, svc.Lifetime, svc.ImplementationType.Name); 19: continue; 20: } 21: object instance = serviceProvider.GetService(svc.ServiceType); 22: Console.WriteLine("{0,-30}{1,-15}{2}", svc.ServiceType.Name, svc.Lifetime, instance.GetType().Name); 23: } 24: 25: }) 26: .Build(); 27: } 28: } 如上面的代码片断所示,我们利用WebHostBuilder创建了一个WebHost对象。在此之前,我们调用扩展方法UseKestrel注册了一个KestrelServer类型的服务器,指定一个空的Action<IApplicationBuilder>对象作为参数调用了它的Configure方法,我们只得到这样的方法调用会创建了一个DelegateStartup对象。我们直接利用ConfigureServices方法得到所有自动注册的服务,并打印出每个服务的注册类型、生命周期模式和实现类型。当我们运行这个程序之后,控制台上将打印出如下图所示的服务列表。对于列出的这些服务,我们是不是看到很多熟悉的身影? 手工注册的服务 如果具体的项目需要采用依赖注入的方式来完成一些业务功能的实现,那就需要在应用初始化的过程中手工注册相应的服务。初次之外,我们也可以采用手工注册服务的方式来覆盖系统自动注册的服务。总的来说,我们可以采用种方式实现对服务的手工注册,其中一种就是按照如下的形式调用WebHostBuilder的ConfigureServices方法来注册服务,而另一种则是将服务注册实现在启动类的ConfigureServices方法中。 注册方式1: 1: new WebHostBuilder() 2: .ConfigureServices(svcs => svcs 3: 4: .AddScoped<IBar, IBar>() 5: .AddSingleton<IBaz, Baz>()) 6: … 注册方式2: 1: publicclass Startup 2: { 3: publicvoid ConfigureServices(IServiceCollection svcs) 4: { 5: svcs.AddTransient<IFoo, Foo>() 6: .AddScoped<IBar, IBar>() 7: .AddSingleton<IBaz, Baz>(); 8: } 9: … 10: } 通过前面的介绍,我们知道这两种方式真正执行服务注册的时机是不同的。第一种形式的服务注册发生在WebHostBuilder创建WebHost之前,包含这些服务的ServiceCollection以及由此创建的ServiceProvider将直接提供给后续创建的WebHost。而第二种形式的服务注册则发生在WebHost初始化过程中,实际上是借助一个ConventionBasedStartup对象来完成的。 二、以注入的形式提取服务 依赖注入的最终目录在于实现以注入的形式来消费预先注册的服务。在一个ASP.NET Core应用中,我们在很多地方都可以采用这种编程方式,我们在前一章中对此也有所提及。经过我的总结,我们常用的依赖注入编程主要应用在如下几个方面: 启动类型的构造函数和Configure方法中定义相应参数以注入的形式获取注册的服务。 中间件类型的构造函数和Invoke方法定义任何参数以注入的形式获取注册的服务。 ASP.NET Core MVC应用中Controller类型的构造函数中定义任何参数以注入的形式获取注册的服务。 ASP.NET Core MVC应用的View中通过@inject指令直接获取注册的服务。 启动类型的构造函数和Configure方法种注入服务 当我们在定义启动类型的时候,通过调用WebHostBuilder的ConfigureServices方法注册的服务可以在启动类的构造函数中进行注入,而启动类的Configure方法不但可以注入调用WebHostBuilder的ConfigureServices方法注册的服务,也可以注入自身ConfigureServices方法注册的服务。如下所示的代码片断展示了一个比较典型的例子。 1: new WebHostBuilder() 2: .UseKestrel() 3: .ConfigureServices(svcs => svcs 4: 5: ) 6: .UseStartup<Startup>() 7: … 8: 9: publicclass Startup 10: { 11: public Startup() 12: { 13: Debug.Assert(typeof(Foo).IsInstanceOfType(foo)); 14: Debug.Assert(typeof(Bar).IsInstanceOfType(bar)); 15: } 16: 17: publicvoid ConfigureServices(IServiceCollection svcs) 18: { 19: svcs.AddTransient<IBaz, Baz>() 20: .AddTransient<IGux, Gux>(); 21: } 22: 23: publicvoid Configure(IApplicationBuilder app, ) 24: { 25: Debug.Assert(typeof(Foo).IsInstanceOfType(foo)); 26: Debug.Assert(typeof(Bar).IsInstanceOfType(bar)); 27: Debug.Assert(typeof(Baz).IsInstanceOfType(baz)); 28: Debug.Assert(typeof(Gux).IsInstanceOfType(gux)); 29: } 30: } 中间件类型的构造函数和Invoke方法中注入服务 当我们按照约定定义中间件类型的时候,我们可以在构造函数定义相应的参数来注入通过任何形式注册的服务。如下面的代码片断所示,中间件类型的构造函数和Invoke方法都定义了相应的参数来以注入的形式和获取通过调用WebHostBuilder的ConfigureServices方法注册的两个服务。 1: new WebHostBuilder() 2: .UseKestrel() 3: .ConfigureServices(svcs => svcs 4: 5: ) 6: .Configure(app=>app.UseMiddleware<FoobarMiddleware>()) 7: ... 8: 9: publicclass FoobarMiddleware 10: { 11: private RequestDelegate _next; 12: public FoobarMiddleware(RequestDelegate next, ) 13: { 14: _next = next; 15: Debug.Assert(typeof(Foo).IsInstanceOfType(foo)); 16: Debug.Assert(typeof(Bar).IsInstanceOfType(bar)); 17: } 18: 19: public async Task Invoke(HttpContext context, ) 20: { 21: Debug.Assert(typeof(Foo).IsInstanceOfType(foo)); 22: Debug.Assert(typeof(Bar).IsInstanceOfType(bar)); 23: await _next(context); 24: } 25: } Controller类型的构造函数中注入服务 在ASP.NET Core MVC应用中,我们经常在Controller类型的构造函数定义相应的参数来以注入的方式获取预先注册的服务。如下所示的这个HomeController就采用构造器注入的方式获取通过调用WebHostBuilder的ConfigureServices方法注册的两个服务。 1: new WebHostBuilder() 2: .UseKestrel() 3: .ConfigureServices(svcs => svcs 4: 5: 6: .AddMvc()) 7: .Configure(app => app.UseMvc()) 8: ... 9: 10: publicclass HomeController 11: { 12: public HomeController() 13: { 14: Debug.Assert(typeof(Foo).IsInstanceOfType(foo)); 15: Debug.Assert(typeof(Bar).IsInstanceOfType(bar)); 16: } 17: ... 18: } View中注入服务 如果我们在ASP.NET Core MVC应用的View中以注入的方式进行服务消费,我们有两种解决方案。第一种方案就是先按照上面这种方式将服务注入到Controller中,在将注入的服务通过ViewData或者ViewBag传递到View。另一种方式就是按照如下的方式直接使用@inject指令将注入的服务定义成当前View类型的属性。 1: new WebHostBuilder() 2: .UseKestrel() 3: .UseContentRoot(Directory.GetCurrentDirectory()) 4: .ConfigureServices(svcs => svcs 5: 6: 7: .AddMvc()) 8: .Configure(app => app.UseMvc()) 9: ... 10: 11: @using System.Reflection 12: @using System.Diagnostics 13: 14: 15: @{ 16: Debug.Assert(typeof(Foo).IsInstanceOfType()); 17: Debug.Assert(typeof(Bar).IsInstanceOfType()); 18: } 三、与第三方DI框架的整合 我们知道启动类型的ConfigureServices方法是可以返回一个ServiceProvider对象的,并且这个对象将直接作为WebHost的Services属性,成为一个全局单例的服务提供者。这个特性可以帮助我们实现与第三方DI框架的整合(比如Castle、Ninject、Autofac等)。在这里我不想“节外生枝”地引入某一个DI框架,而是自行创建一个简单的DI容器来演示这个主题。这个DI容器通过如下所示的Cat类型(这么名字来源于“机器猫”),它直接实现了IServiceProvider接口,所以一个Cat对象同时也是一个ServiceProvider对象。 1: publicclass Cat : IServiceProvider 2: { 3: privatestaticreadonly Cat _instance = new Cat(); 4: private ConcurrentDictionary<Type, Func<Cat, object>> _registrations = new ConcurrentDictionary<Type, Func<Cat, object>>(); 5: private IServiceProvider _backup; 6: 7: private Cat() 8: { 9: _backup = new ServiceCollection().BuildServiceProvider(); 10: } 11: 12: publicstatic Cat Instance 13: { 14: get { return _instance; } 15: } 16: 17: public Cat Register(IServiceCollection svcs) 18: { 19: _backup = svcs.BuildServiceProvider(); 20: returnthis; 21: } 22: 23: public Cat Register(Type serviceType, Func<Cat, object> instanceAccessor) 24: { 25: _registrations[serviceType] = instanceAccessor; 26: returnthis; 27: } 28: 29: publicobject GetService(Type serviceType) 30: { 31: Func<Cat, object> instanceAccessor; 32: return _registrations.TryGetValue(serviceType, out instanceAccessor)? instanceAccessor(this): _backup.GetService(serviceType); 33: } 34: } 如上面的代码片断所示,Cat具有一个类型为ConcurrentDictionary<Type, Func<Cat, object>>类型的字段(_registrations)用来保存注册的服务,而服务的注册体现为服务类型与一个提供服务实例的委托对对象的映射,该映射通过调用第一个Register方法重载进行注册。除此之外,我还为这个类型定义了一个IServiceProvider接口类型的字段(_backup),如果实现的GetService方法不能根据指定的服务类型找到一个对应的Func<Cat, object>对象来提供服务对象,它将使用这个作为“后备”的ServiceProvider来提供这个服务。我们采用单例模式来使用Cat,这个单例对象通过只读属性Instance返回。 针对Cat这个DI容器的整体体现在如下这段程序中。如下面的代码片段所示,我们一共注册了三个服务,其中针对IFoo接口的服务直接注册在Cat单例对象上,针对IBar接口的服务通过调用ConfigureServices方法注册到WebHostBuilder上,而针对IBaz接口的服务则通过启动类的ConfiguresServices进行注册。值得注意的是,启动类的ConfigureServices方法返回的ServiceProvider正是这个Cat单例对象,在这之前我们调用它的Register方法将当前的ServiceCollection进行了注册。 1: publicclass Program 2: { 3: publicstaticvoid Main() 4: { 5: 6: new WebHostBuilder() 7: .UseKestrel() 8: .ConfigureServices(svcs => 9: .UseStartup<Startup>() 10: .Build() 11: .Run(); 12: } 13: } 14: 15: publicclass Startup 16: { 17: public IServiceProvider ConfigureServices(IServiceCollection svcs) 18: { 19: return Cat.Instance.Register(); 20: } 21: 22: publicvoid Configure(IApplicationBuilder app, ) 23: { 24: app.Run(async context =>{ 25: context.Response.ContentType = "text/html"; 26: await context.Response.WriteAsync($"IFoo => {foo.GetType().Name}<br/>"); 27: await context.Response.WriteAsync($"IBar => {bar.GetType().Name}<br/>"); 28: await context.Response.WriteAsync($"IBaz => {baz.GetType().Name}<br/>"); 29: }); 30: } 31: } 我们为启动类的Configure方法定了三个参数以注入的形式获取预先注册的这三个服务对象,并利用注册的中间件将服务的接口类型和真实类型之间的映射作为了响应的内容。我们启动应用并利用浏览器访问目标地址,这个类型映射关系将会按照如图5所示的形式出现在浏览器上。 作者:蒋金楠 微信公众账号:大内老A 微博: www.weibo.com/artech 如果你想及时得到个人撰写文章以及著作的消息推送,或者想看看个人推荐的技术资料,可以扫描左边二维码(或者长按识别二维码)关注个人公众号(原来公众帐号 蒋金楠的自媒体将会停用)。 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。 原文链接

优秀的个人博客,低调大师

开创IaaS+PaaS新玩法 CloudIn云英完成Pre-A轮4000万元融资

IT全流程云化和自动化成为云计算的下一形态。在这样的背景之下,能够提供完整IaaS+PaaS服务云平台的需求逐渐浮出水面。日前,CloudIn云英宣布完成Pre-A轮4000万元融资,这是国内提供完整IaaS+PaaS平台化服务的一个信号,是中国云计算产业进入3.0阶段的重要标志。 本轮融资由专注于技术驱动的投资机构云启资本、晨兴创投等参与投资,融资金额规模达4000万元人民币。作为投资方之一的云启资本,是一家技术驱动 的投资机构,专注于云计算及大数据、智能硬件、金融科技和企业间交易服务(B2B)的早、中期投资的创投基金。另一家投资方晨兴创投,曾经成功投资小米公 司、携程、搜狐等公司。 CloudIn云英成立于2015年9月,核心技术团队来自Google、百度、腾讯、AWS,以国际成熟技术衍生云英产品,创造中国业界首家具有国际水准架构的IaaS+PaaS云服务平台。 云计算正在成为软件部署的默认选择 全 球云计算应用进程突飞猛进,正在变得无处不在,Gartner今年六月发布的数据显示,自2011年以来,基础设施即服务(IaaS)市场的收入每年增长 超过40%,预计一直到2019年每年增长仍将超过25%。到2019年,大多数虚拟机将是通过IaaS提供商交付的。到2020年,IaaS的收入将超 过550亿美元——可能超过服务器的收入。也就是说,到2020年,通过IaaS和PaaS云提供商提供的计算能力将超过部署到企业数据中心的计算能力。 Gartner研究副总裁Jeffrey Mann表示:“云计算将日益成为软件部署的默认选择。对于定制软件来说也是如此,将越来越多地针对各种公有云或者私有云进行设计。” 与全球云计算进程同步的是,中国的云计算的大幕正在徐徐拉开。根据贝恩咨询公司(Bain & Company)的报告,中国的云计算市场2013年价值15亿美元。但是,预计到2020年,这个数字会增长至200亿美元,复合年增长率达到近40%。 在规模迅速扩大的过程中,市场对于云计算的期待也更为清晰和严格。 附加价值将成为云平台选择的重要依据 云计算市场规模激增,但是竞争更盛。作为黑马杀出重围的CloudIn云英有什么特殊之处? “我 们的创始团队来自谷歌,深切感受到自动化在整个IT开发过程中的重要,特别是最近几年在国内做IT,对大量公司的基础架构有全面了解。我们踩过很多坑,正 因为如此,我们有能力构建一个大家需要的技术平台,帮助to B客户从技术陷阱和运维泥沼中脱离出来,专注自己的业务。”CloudIn云英创始人兼CEO王江表示。 CloudIn 云英并不局限在传统的某一层,而是致力于通过自动化一体化云,让企业专注自身业务。CloudIn云英能够为用户提供从IaaS层到PaaS层的一体化技 术栈产品。在CloudIn云英的产品平台上,用户看到的不仅仅是主机、硬盘、网络,同时还有资产管理、自动化运维平台、开发管理平台、数据库及大数据等 服务,覆盖从资源采购、部署到管理的全流程。CloudIn云英云平台不仅帮助用户管理IaaS层资源,同时为上层产品提供支持。在自动化运维平台 上,CloudIn云英为用户提供端到端的自动化基础设施,可满足不同角色的自动化需求。 “未来比拼的不仅仅是计算资源的 价格,用户会越来越看重云平台提供的附加价值,PaaS这层会有差异化。”作为Pre-A轮融资的主要投资方,云启资本副总裁陈昱这样评价为何要投资云 英,“云计算在很长的一段时间内都会是群雄割据的局面,但随着时间的推移,市场会演变成寡头市场,即头部几家公司占据大部分市场份额,但是小公司永远有其 生存的空间。此外,规模用户永远不会把鸡蛋放在一个篮子里,这里有处于容灾备份的考虑,也有对平台附加特性的考虑。” 后发制人 云英开启加速跑 在 IaaS以及PaaS领域,云英并不具有先发优势。但是,也正因此减少了在概念推广和技术选型的困难,所以可以跑的更快。云英在短短两个月内,发布了公有 云1.0,成立第三个月,发布了私有云1.0。在今年的上半年,上线了智能云监控、文档中心、DDoS高防服务、自动化运维平台、云数据库RDS服务等多 个功能服务。 当前,云英已经完成基础的技术积累,公有云和私有云都聚集了大量先锋用户。在云英的技术蓝图上,今年9月将发布公有云2.0,呈现更多PaaS功能,引领差异化云平台的发展。 “在规划里,未来还有很多功能会加入云英云平台。”王江表示,“我们追求完美架构,通过解放技术生产能力,帮助客户能够更专注于核心业务的扩展。 原文发布时间为:2016年7月29日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

《可穿戴创意设计:技术与时尚的融合》一一1.6 研究中的可穿戴技术

1.6 研究中的可穿戴技术1996年,美国国防部组织了名为“2005年的可穿戴设备”的研讨会,集中工业、大学和军事领域有远见的人士,研究向个人交付计算能力的共同主题。DARPA投资的重要项目之一是佐治亚理工大学开发的可穿戴主板(亦称智能衬衫)。图1-6是这种衬衫的照片。智能衬衫按照“纺织品即电脑”的范式开发,集工程、纺织品和医疗应用于一身。智能衬衫被公认为第一种“智能”服装,因为它是第一种可穿戴集成化信息基础设施,开发小组称其为个性化移动信息处理(PMIP)。它使用了嵌入在织物内的光纤来检测枪伤,并使用嵌入式传感器监测战斗期间的心率和其他生命特征。随着项目的持续,开发出来更多的不是一种军用服装,而是民用服装,因为它体现出医学领域中监视生命特征的许多新机会。开发小组持续重新设计和开发架构和纺织品,试图达到他们的目标―创建一种可以到达

优秀的个人博客,低调大师

亚马逊云科技玩法:用 S3 + CloudFront,给你的静态网站上个全球 CDN 加速 ✈️

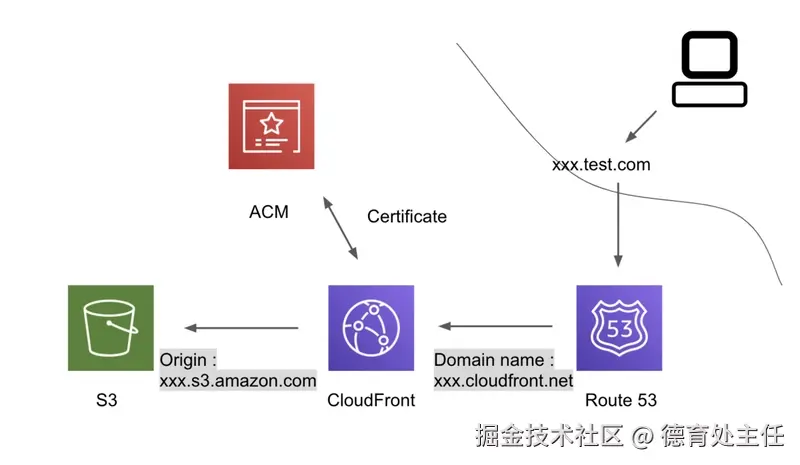
你可能已经用 React、Vue 或者就是纯粹的 HTML/CSS/JavaScript 精心打造了一个漂亮的静态网站。现在,是时候让全世界看到你的作品了。传统的做法可能是购买虚拟主机,然后用 FTP 客户端颤颤巍巍地上传文件。这种方式不仅过程繁琐,而且当你的访客来自世界各地时,访问速度往往不尽人意。 我用了一种现代、专业的方式来解决这个问题。采用一套被全球顶尖公司广泛使用的云原生架构来托管我的静态网站。这个架构的核心是三项亚马逊云科技的服务: - **Amazon S3 (Simple Storage Service)** :它将作为网站文件的“存储仓库”。Amazon S3 提供了行业领先的持久性和可用性,你可以把它想象成一个几乎永远不会丢失数据的、无限大的硬盘 。 - **Aamzon CloudFront**:这是一个全球内容分发网络(CDN)。它会在全球数百个边缘节点缓存你的网站内容。当用户访问你的网站时,内容会从离他们最近的节点提供,从而极大地降低延迟,实现飞一般的加载速度 。 - **Amazon Route 53**:这是一个高可用、可扩展的域名系统(DNS)服务。它将扮演“地址簿”的角色,将你酷炫的自定义域名(例如 `www.your-awesome-site.com`)指向 CloudFront,让用户可以通过友好的地址访问你的网站 。 这套架构并非遥不可及的复杂技术,恰恰相反,它是当今托管高性能静态网站的黄金标准。跟着这篇分享,你会发现,即便是个人开发者,也能轻松地为自己的项目搭建起这套企业级的网站基础设施。 ![](https://developer.qcloudimg.com/http-save/yehe-100000/7bc4e50fa71133370068e4fbe0d8d899.webp) ## 第1步:用 Amazon S3 当的“网站硬盘” 📁 第一步,使用 Amazon S3 来存放网站的所有文件。 ### A. 创建和上传 1. [登录亚马逊云管理控制台}([aws.amazon.com/cn/free?trk…](https://link.juejin.cn/?target=https%3A%2F%2Faws.amazon.com%2Fcn%2Ffree%3Ftrk%3Dd0a200fd-0331-451c-b145-bab98ddc9611%26sc_channel%3Dsm)%25EF%25BC%258C%25E5%25AF%25BC%25E8%2588%25AA%25E5%2588%25B0) Amazon **S3** 服务。 ![](https://developer.qcloudimg.com/http-save/yehe-100000/b745b28b6bb32ebf326eaff3fc3f1dac.webp) 1. 点击 **创建存储桶**。 ![](https://developer.qcloudimg.com/http-save/yehe-100000/2dbfc4b7e0449d47eadd83463f9e9909.webp) 1. **存储桶名称**:输入一个全球唯一的名称。Amazon S3 存储桶名称是全局共享的,所以你可能需要加上一些独特的前缀或后缀,例如 `my-static-website-` 加上你的名字和日期。 1. **亚马逊云区域**:选择一个离你或你的主要用户群体最近的区域。 1. 其他设置保持默认,滚动到底部,点击 **创建存储桶** 。 ![](https://developer.qcloudimg.com/http-save/yehe-100000/0f11b9529d21ca12b9268a63b38cb1d9.webp) 1. 创建成功后,点击进入你的存储桶。点击 **上传** 按钮,然后通过“添加文件”和“添加文件夹”将你本地网站的所有文件(如 `index.html`、`error.html`、CSS 文件、JavaScript 文件和图片文件夹等)上传到这个存储桶中。 ![](https://developer.qcloudimg.com/http-save/yehe-100000/5d287b805f96fd2c26916c8c8d6ee09c.webp) ### B. 启用静态网站托管 默认情况下,Amazon S3 只是一个对象存储服务。需要明确告诉它,这个存储桶里的内容要作为一个网站来对外提供服务。 1. 在你的存储桶页面,点击 **属性** 标签。 1. 滚动到页面最下方,找到 **静态网站托管** 卡片,点击 **编辑**。 1. 选择 **启用** 静态网站托管。 1. 在“托管类型”中,选择 **托管静态网站**。 1. 在 **索引文档** 字段中,输入你的网站入口文件名,通常是 `index.html`。 1. (可选)在 **错误文档** 字段中,输入你的自定义 404 错误页面文件名,例如 `error.html`。 1. 点击 **保存更改** 。 ### C. 配置公开访问权限 这是整个 Amazon S3 配置中最关键也最容易出错的一步。为了让互联网上的任何人都能访问你的网站文件,需要授予他们公共读取权限。这需要两步操作:“解锁”和“授权”。 1. **解锁:关闭“阻止公开访问”** 亚马逊云出于安全考虑,默认会阻止对 Amazon S3 存储桶的所有公开访问。需要先为这个特定的存储桶解除这个限制。 1. 在你的存储桶页面,点击 **权限** 标签。 1. 找到 **阻止公开访问(存储桶设置)** 卡片,点击 **编辑**。 1. **取消勾选** “阻止所有公开访问”复选框。 1. 系统会提示你确认此操作,勾选确认框,然后点击 **保存更改** 。 这一步操作本身并不会让你的存储桶变公开,它只是允许你接下来通过存储桶策略来设置精细化的公开访问权限。这个“先解锁,再授权”的流程是理解 Amazon S3 权限模型的关键,它能有效防止因误操作导致整个存储桶内容被意外暴露。 1. **授权:应用存储桶策略** 现在已经“解锁”了,接下来需要明确地“授权”公共读取权限。 1. 在“权限”标签页下,滚动到 **存储桶策略** 部分,点击 **编辑**。 1. 在策略编辑器中,粘贴以下 JSON 代码。**请务必将 `YourBucketName` 替换为你自己的存储桶名称**。 ``` { "Version": "2012-10-17", "Statement": } ``` 1. 点击 **保存更改** 。 这个策略的含义是:允许(`Effect: "Allow"`)任何主体(`Principal: "*"`)对你存储桶(`Resource`)中的所有对象(`/*`)执行读取操作(`Action: "s3:GetObject"`)。 完成以上步骤后,你的 S3 存储桶就已经配置成一个可以公开访问的网站了。你可以回到“属性”标签页,在“静态网站托管”部分找到你的网站端点 URL,它看起来像 `http://your-bucket-name.s3-website.your-region.amazonaws.com`。在浏览器中打开它,你应该能看到你的网站了! ## 第2步:套上 CloudFront CDN - 让网站“飞”一会儿 💨 虽然网站已经上线,但它的访问速度受限于 Amazon S3 存储桶所在的单个亚马逊云区域。为了给全球用户提供最佳体验,需要引入 CloudFront。 ### A. 创建 CloudFront 分发 1. 在亚马逊云管理控制台,导航到 Amazon **CloudFront** 服务。 1. 点击 **创建 Amazon CloudFront 分发**。 ### B. 配置源 (Origin) “源”就是 CloudFront 获取内容的服务器,在这个案例中,它就是刚刚配置好的 S3 存储桶。这里有一个重要的选择,推荐使用更安全、更专业的方式。 |特性|S3 网站端点|S3 REST API 端点 (配合 OAC)| | --- | --- | --- | |存储桶隐私|必须公开|可保持私有| |源站协议|仅 HTTP|支持 HTTPS| |安全性|较低|推荐/更高| |配置复杂度|更简单|略微复杂(但更安全)| 采用 **S3 REST API 端点** 配合 **源访问控制 (OAC)** 的方式。这种方式允许 S3 存储桶保持私有,只允许 CloudFront 通过一个特殊的身份来访问,从而杜绝了直接访问 S3 的可能性,更加安全 。 1. 在“源域”字段的下拉菜单中,**选择你的 Amazon S3 存储桶**。控制台会自动填充 Amazon S3 的 REST API 端点(例如 `your-bucket-name.s3.your-region.amazonaws.com`)。 1. 在“源访问”部分,选择 **源访问控制设置 (推荐)** 。 1. 点击 **创建控制设置**,在弹出的窗口中保持默认设置并点击 **创建**。 1. 创建后,你会看到一条提示信息,告诉你需要更新 Amazon S3 存储桶策略。**点击“复制策略”按钮**,然后点击“转到 Amazon S3 存储桶权限”链接,在新标签页中打开你的 Amazon S3 存储桶策略编辑器,将刚刚复制的策略粘贴进去并保存。这个策略会自动替换掉之前设置的公共读策略,只允许 CloudFront 访问。 ### C. 关键设置 在创建分发的页面继续向下滚动,配置以下关键选项: - **查看器协议策略**:选择 **Redirect HTTP to HTTPS**。这将强制所有用户使用安全的 HTTPS 连接访问你的网站 。 - **默认根对象**:输入 `index.html`。这样当用户访问你的根域名(如 `https://www.your-awesome-site.com`)时,CloudFront 会自动提供 `index.html` 文件 。 - 其他设置保持默认,滚动到页面底部,点击 **创建分发**。 Amazon CloudFront 分发的创建过程需要一些时间(通常是 5-15 分钟)。在此期间,你可以看到状态为“正在部署”。部署完成后,状态会变为“已启用”。 ## 第3步:安排上 Route 53 - 绑定专属域名 🌐 当 Amazon CloudFront 分发部署完成后,你可以在分发列表中看到一个“分发域名”,形如 `d12345abcdefg.cloudfront.net`。现在,要将域名指向这个地址。 1. 在亚马逊云管理控制台,导航到 **Route 53** 服务。 1. 在左侧导航栏中选择 **托管区**,然后点击你的域名对应的托管区。 1. 点击 **创建记录**。 1. 在这里,将创建一个 **别名 (Alias) 记录**。这是 Route 53 的一个强大功能,它允许你将域名指向亚马逊云资源,并且比传统的 CNAME 记录更优越,特别是它可以用于根域名(例如 `example.com` 而非 `www.example.com`)。 1. **记录名称**:如果你想配置 `www.your-awesome-site.com`,就在这里输入 `www`。如果你想配置根域名 `your-awesome-site.com`,则将此字段留空。 1. **记录类型**:保持为 **A – 将流量路由到 IPv4 地址和部分亚马逊云资源**。 1. 打开 **别名** 开关。 1. 在“将流量路由到”下拉菜单中,选择 Amazon **CloudFront 分发的别名**。 1. 在下方的输入框中,选择或粘贴你刚刚创建的 Amazon CloudFront 分发域名。 1. 点击 **创建记录** 。 如果你想让根域名和 `www` 子域名都能访问你的网站,你可以为它们分别创建别名记录,都指向同一个 CloudFront 分发。 ## 总结两句 大功告成!现在,在浏览器中输入你的自定义域名,稍等 DNS 传播生效后,你就能看到一个通过全球 CDN 加速、并由 HTTPS 加密保护的专业网站了。 来看看刚刚搭好的这套架构有多牛: - **安全可靠**:内容存储在设计持久性高达 99.999999999% 的 S3 中,并通过 HTTPS 加密传输。 - **全球高速**:CloudFront 的全球网络确保了世界各地的用户都能获得极速的加载体验。 - **可扩展且经济**:这套架构可以从容应对从个人博客到大型商业网站的流量,而你只需为实际用量付费。 --- 以上就是本文的全部内容啦。**最后提醒一下各位工友,如果后续不再使用相关服务,别忘了在控制台关闭,避免超出免费额度产生费用~**

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册