首页 文章 精选 留言 我的

精选列表

搜索[AIPC技术],共10000篇文章
优秀的个人博客,低调大师

GaussDB技术解读系列:数据实例的连接

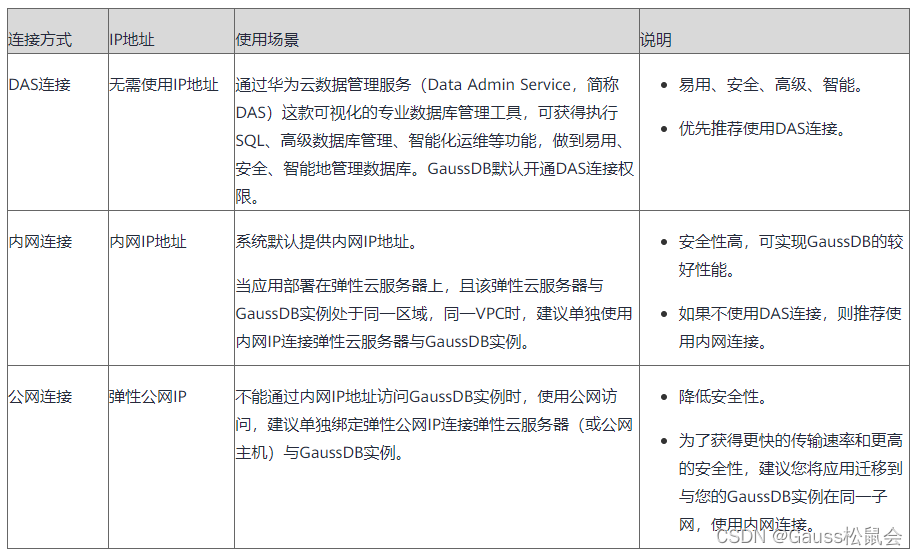
GaussDB是华为公司倾力打造的自研企业级分布式关系型数据库,该产品具备企业级复杂事务混合负载能力,同时支持优异的分布式事务,同城跨AZ部署,数据0丢失,支持1000+扩展能力,PB级海量存储等企业级数据库特性。 GaussDB支持的连接方式 GaussDB提供使用内网、公网和数据管理服务(Data Admin Service,简称DAS)的连接方式。 各连接方式的使说明如下,您可以根据需要选择。 GaussDB连接方式如下: 一、通过DAS来连接实例。 前提条件 需要已有GaussDB实例,实例购买指导请参考购买实例。 操作步骤 步骤 1:进入DAS服务。 在服务列表,选择数据库中的数据库管理服务DAS。 步骤 2:设置DAS连接服务。 1.选择“进入标准版”。 2.点击“新增数据库登录”。 3.在此设置页面,“数据库引擎”选择GaussDB,然后在“数据库来源”中就会出现当前账号下已有的GaussDB数据库实例。选中想要连接的实例。 4.填写登录用户名及密码,单击“测试连接”。 测试连接成功后会提示“连接成功”。成功后,可以选择勾选“记住密码”、“定时采集”功能,勾选完成后单击“立即新增”。 步骤 3:新增完成 通过单击“登录”可以进入到相应的数据库实例。 步骤 4:登录完成后 即可在DAS中完成数据库操作。 二、通过内网连接。 GaussDB提供gsql工具远程连接数据库实例。您需要提前下载gsql工具并在ECS上安装gsql,通过gsql远程连接数据库实例。gsql工具下载请单击此处。 前提条件 需要已有GaussDB实例,实例购买指导请参考购买实例。 已经下载gsql工具。 操作步骤 步骤 1:ECS,用于安装gsql工具。 购买ECS指导请参考购买ECS。 gsql支持的操作系统版本如下: X86:EulerOS V2.5。 鲲鹏服务器:EulerOS V2.8。 步骤 2:在购买的弹性云服务器上,上传软件包并配置环境变量。 以root用户登录弹性云服务器。 创建“/tmp/tools”目录。 mkdir /tmp/tools 3.单击此处获取GaussDB软件包并解压。 unzip GaussDB_opengauss_client_tools.zip 4.根据申请的弹性云服务器的操作系统架构进入不同目录,获取“GaussDB-Kernel-xxx-EULER-64bit-gsql.tar.gz”,并上传到申请的弹性云服务器“/tmp/tools”路径下。 5.软件包相对位置为安装时所放位置,根据实际情况填写。 解压文件。 cd /tmp/tools tar -zxvf GaussDB-Kernel-V500R001C00-EULER-64bit-gsql.tar.gz 6.设置环境变量。 打开“~/.bashrc”文件。 vi ~/.bashrc 按下i键进入INSERT模式,在其中输入如下内容后,单击“ESC”退出编辑模式,使用“:wq!”命令保存并退出。 export PATH=/tmp/tools/bin:$PATH export LD_LIBRARY_PATH=/tmp/tools/lib:$LD_LIBRARY_PATH 使环境变量配置生效。 source ~/.bashrc 步骤 3: 判断实例与ECS是否可以通过内网连接。 如果ECS和实例在同一区域,同一可用区,说明ECS和实例网络互通,可以通过内网直接远程连接。 数据库实例的区域、可用区和VPC查看方法如下: ECS的区域、可用区和VPC查看方法如下: 步骤 4:内网连接数据库实例。 查看GaussDB数据库的IP地址,具体如下: 然后在ECS服务器执行如下命令进行连接: gsql -d postgres -h 192.168.0.15 -U root -p 8000 -r 192.168.0.15为内网IP,要替换为自己实例的IP。 输入数据库root用户密码,成功登录。 `[root@ecs-a4e7 ~]# gsql -d postgres -h 192.168.0.168 -U root -p 8000 -r Password for user root: gsql ((GaussDB Kernel V500R001C10 build 23636d1b) compiled at 2020-09-24 22:23:07 commit 905 last mr 1150 ) SSL connection (cipher: DHE-RSA-AES128-GCM-SHA256, bits: 128) Type "help" for help. postgres=>` 步骤 5:数据库使用。 `postgres=> \dbs List of tablespaces Name | Owner | Location ------------+----------+---------- pg_default | rdsAdmin | pg_global | rdsAdmin | (2 rows) postgres=>` 三、通过公网连接。 GaussDB提供gsql工具远程连接数据库实例。您需要提前下载gsql工具并在ECS上安装gsql,通过gsql远程连接数据库实例。gsql工具下载请单击此处。 公网连接的判断方式:如果安装gsql的ECS和数据库实例不在同一区域,同一可用区,则需要通过绑定弹性公网IP进行连接。 前提条件 需要已有GaussDB实例。 已经下载gsql工具。 操作步骤 步骤 1:购买ECS,用于安装gsql工具。 gsql支持的操作系统版本如下: X86:EulerOS V2.5。 鲲鹏服务器:EulerOS V2.8。 步骤 2: 1.在购买的弹性云服务器上,上传软件包并配置环境变量。 2.以root用户登录弹性云服务器。 3.创建“/tmp/tools”目录。 mkdir /tmp/tools 单击此处获取GaussDB软件包并解压。 unzip GaussDB_opengauss_client_tools.zip 4.根据申请的弹性云服务器的操作系统架构进入不同目录,获取“GaussDB-Kernel-xxx-EULER-64bit-gsql.tar.gz”,并上传到申请的弹性云服务器“/tmp/tools”路径下。 5.解压文件。 cd /tmp/tools tar -zxvf GaussDB-Kernel-V500R001C00-EULER-64bit-gsql.tar.gz 6.设置环境变量。 打开“~/.bashrc”文件。 vi ~/.bashrc 7.按下i键进入INSERT模式,在其中输入如下内容后,单击“ESC”退出编辑模式,使用“:wq!”命令保存并退出。 export PATH=/tmp/tools/bin:$PATH export LD_LIBRARY_PATH=/tmp/tools/lib:$LD_LIBRARY_PATH 使环境变量配置生效。 source ~/.bashrc 步骤 3:判断实例与ECS是否需要通过公网连接。 如果安装gsql的ECS和数据库实例不在同一区域,同一可用区,则需要通过绑定弹性公网IP进行连接。 数据库实例的区域、可用区和VPC查看方法如下。 ECS的区域、可用区和VPC查看方法如下: 步骤 4 :为实例绑定公网IP。 在实例基本信息页单击“绑定”,选择IP后进行绑定,如果账户下没有公网IP,需要去购买。 步骤 5 :为ECS绑定公网IP。 步骤 6 :公网连接数据库实例。 查看GaussDB数据库的公网IP地址,具体如下: 然后通过公网登录ECS,并在ECS服务器执行如下命令进行连接: gsql -d postgres -h 10.154.217.136 -U root -p 8000 -r 10.154.217.136为公网IP,要替换为自己实例绑定的公网IP。 输入数据库root用户密码,成功登录。 `[root@ecs-a4e7 ~]# gsql -d postgres -h 10.154.217.136 -U root -p 8000 -r Password for user root: gsql ((GaussDB Kernel V500R001C10 build 23636d1b) compiled at 2020-09-24 22:23:07 commit 905 last mr 1150 ) SSL connection (cipher: DHE-RSA-AES128-GCM-SHA256, bits: 128) Type "help" for help. postgres=>` 步骤 7:数据库使用。 `postgres=> \dbs List of tablespaces Name | Owner | Location ------------+----------+---------- pg_default | rdsAdmin | pg_global | rdsAdmin | (2 rows) postgres=>` 今天就为大家介绍到这里啦,欢迎交流~

优秀的个人博客,低调大师

玩转Spring状态机 | 京东云技术团队

说起Spring状态机,大家很容易联想到这个状态机和设计模式中状态模式的区别是啥呢?没错,Spring状态机就是状态模式的一种实现,在介绍Spring状态机之前,让我们来看看设计模式中的状态模式。 1. 状态模式 状态模式的定义如下: 状态模式(State Pattern)是一种行为型设计模式,它允许对象在内部状态发生变化时改变其行为。在状态模式中,一个对象的行为取决于其当前状态,而且可以随时改变这个状态。状态模式将对象的状态封装在不同的状态类中,从而使代码更加清晰和易于维护。当一个对象的状态改变时,状态模式会自动更新该对象的行为,而不需要在代码中手动进行判断和处理。 通常业务系统中会存在一些拥有状态的对象,而且这些状态之间可以进行转换,并且在不同的状态下会表现出不同的行为或者不同的功能,比如交通灯控制系统中会存在红灯、绿灯和黄灯,再比如订单系统中的订单会存在已下单、待支付、待发货、待收货等状态,这些状态会通过不同的行为进行相互转换,这时候在系统设计时就可以使用状态模式。 下面是状态模式的类图: 可以看到状态模式主要包含三种类型的角色: 1、上下文(Context)角色:封装了状态的实例,负责维护状态实例,并将请求委托给当前的状态对象。 2、抽象状态(State)角色:定义了表示不同状态的接口,并封装了该状态下的行为。所有具体状态都实现这个接口。 3、具体状态(Concrete State)角色:具体实现了抽象状态角色的接口,并封装了该状态下的行为。 下面是使用状态模式实现红绿灯状态变更的一个简单案例: 抽象状态类: /** * @description: 抽象状态类 */ public abstract class MyState { abstract void handler(); } 具体状态类A /** * @description: 具体状态A */ public class RedLightState extends MyState{ @Override void handler() { System.out.println("红灯停"); } } 具体状态类B /** * @description: 具体状态B */ public class GreenLightState extends MyState{ @Override void handler() { System.out.println("绿灯行"); } } 环境类:维护当前状态对象,并提供了切换状态的方法。 /** * @description: 环境类 */ public class MyContext { private MyState state; public void setState(MyState state) { this.state = state; } public void handler() { state.handler(); } } 测试类 /** * @description: 测试状态模式 */ public class TestStateModel { public static void main(String[] args) { MyContext myContext = new MyContext(); RedLightState redLightState = new RedLightState(); GreenLightState greenLightState = new GreenLightState(); myContext.setState(redLightState); myContext.handler(); //红灯停 myContext.setState(greenLightState); myContext.handler(); //绿灯行 } } 下面是对应的执行结果  可以发现,使用状态模式中的状态类在一定程度上也消除了if-else逻辑校验,看到这里, 有些人可能会有疑问:状态模式和策略模式的区别是什么呢? 状态模式更关注对象在不同状态的行为和状态之间的流转,而策略模式更关注对象不同策略的选择。 上面我们介绍了设计模式中的状态模式,接下来我们来看看Spring状态机。 2. Spring状态机 状态机,也就是 State Machine ,不是指一台实际机器,而是指一个数学模型 。说白了,就是指一张状态转换图。 状态机是状态模式的一种应用,相当于上下文角色的一个升级版。在工作流或游戏等各种系统中有大量使用,如各种工作流引擎,它几乎是状态机的子集和实现,封装状态的变化规则。Spring也提供了一个很好的解决方案。Spring中的组件名称就叫作状态机(StateMachine)。状态机帮助开发者简化状态控制的开发过程,让状态机结构更加层次化。 通过定义,我们很容易分析得到状态机应当具备一下几个要素: 1. 当前状态:也就是状态流转的起始状态。 2. 触发事件:引起状态之间流转的一些列动作。 3. 响应函数:触发事件到下一个状态之间的规则。 4. 目标状态:状态流转的目标状态。 对于组件化的状态机,当前使用较多的主要是两种:一种是Spring 状态机,一种是COLA状态机,这两种状态机的对比如下表所示:  Spring 状态机 COLA 状态机 API 调用 使用 Reactive 的 Mono、Flux 方式进行 API 调用 同步的 API 调用,如果有需要也可以将方法通过 消息队列、定时任务、多线程等方式进行异步调用 代码量 core 包 284 个接口和类 36 个接口和类 生态 非常丰富 较为贫瘠 定制化难度 困难 简单 可以看到,Spring状态机锁提供的内容较为丰富,当然对于自定义的支持就不如COLA状态机好,如果对自定义的需求比较高,那建议使用COLA状态机。 本文以Spring状态机为例,展示如何在业务系统中使用状态机。 为了便于大家了解Spring状态机的实现原理和使用方式以及其提供的功能,下面列出了官方文档和源码,感兴趣的同学可以阅读阅读。 官方文档: https://docs.spring.io/spring-statemachine/docs/4.0.0/reference/index.html#statemachine-config-states 源代码: https://github.com/spring-projects/spring-statemachine 3. Spring状态机实现订单状态流转 对于状态模式,Spring封装好了一个组件,就叫状态机(StateMachine)。Spring状态机可以帮助我们开发者简化状态控制的开发过程,让状态机结构更加层次化。下面用Spring状态机模拟一个订单状态流转的过程。 3.1 环境准备 首先,如果要使用spring状态机,需要引入对应的jar包,这里我的springboot版本是:2.2.1.RELEASE <dependency> <groupId>org.springframework.statemachine</groupId> <artifactId>spring-statemachine-core</artifactId> <version>${springboot.version}</version> </dependency> 下面是简化的订单的定义,以及订单状态和订单转换行为的枚举 /** * @description: 模拟订单类 */ @Data public class Order { private Long orderId; private OrderStatusEnum orderStatus; } /** * @description: 订单状态 */ public enum OrderStatusEnum { // 待支付 WAIT_PAYMENT, // 待发货 WAIT_DELIVER, // 待收货 WAIT_RECEIVE, // 完成 FINISH; } /** * @description:订单状态转换行为 */ public enum OrderStatusChangeEventEnum { //支付 PAYED, //发货 DELIVERY, //收货 RECEIVED; } 3.2 构造订单状态机 在引入jar包之后,需要构建一个针对订单状态流转的状态机 订单状态机配置类如下: /** * @description: 订单状态机 */ @Configuration @EnableStateMachine public class OrderStatusMachineConfig extends StateMachineConfigurerAdapter<OrderStatusEnum, OrderStatusChangeEventEnum> { /** * 配置状态 */ @Override public void configure(StateMachineStateConfigurer<OrderStatusEnum, OrderStatusChangeEventEnum> states) throws Exception { states.withStates() .initial(OrderStatusEnum.WAIT_PAYMENT) .end(OrderStatusEnum.FINISH) .states(EnumSet.allOf(OrderStatusEnum.class)); } /** * 配置状态转换事件关系 */ @Override public void configure(StateMachineTransitionConfigurer<OrderStatusEnum, OrderStatusChangeEventEnum> transitions) throws Exception { transitions.withExternal().source(OrderStatusEnum.WAIT_PAYMENT).target(OrderStatusEnum.WAIT_DELIVER) .event(OrderStatusChangeEventEnum.PAYED) .and() .withExternal().source(OrderStatusEnum.WAIT_DELIVER).target(OrderStatusEnum.WAIT_RECEIVE) .event(OrderStatusChangeEventEnum.DELIVERY) .and() .withExternal().source(OrderStatusEnum.WAIT_RECEIVE).target(OrderStatusEnum.FINISH) .event(OrderStatusChangeEventEnum.RECEIVED); } } 3.3 编写状态机监听器 监听状态变更事件,完成状态转换。 /** * @description: 状态监听 */ @Component @WithStateMachine @Transactional public class OrderStatusListener { @OnTransition(source = "WAIT_PAYMENT", target = "WAIT_DELIVER") public boolean payTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.WAIT_DELIVER); System.out.println("支付,状态机反馈信息:" + message.getHeaders().toString()); return true; } @OnTransition(source = "WAIT_DELIVER", target = "WAIT_RECEIVE") public boolean deliverTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.WAIT_RECEIVE); System.out.println("发货,状态机反馈信息:" + message.getHeaders().toString()); return true; } @OnTransition(source = "WAIT_RECEIVE", target = "FINISH") public boolean receiveTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.FINISH); System.out.println("收货,状态机反馈信息:" + message.getHeaders().toString()); return true; } } 3.4 编写订单服务类 模拟对订单的一些业务操作 /** * @description: 订单服务 */ @Service public class OrderServiceImpl implements OrderService { @Resource private StateMachine<OrderStatusEnum, OrderStatusChangeEventEnum> orderStateMachine; private long id = 1L; private Map<Long, Order> orders = Maps.newConcurrentMap(); @Override public Order create() { Order order = new Order(); order.setOrderStatus(OrderStatusEnum.WAIT_PAYMENT); order.setOrderId(id++); orders.put(order.getOrderId(), order); System.out.println("订单创建成功:" + order.toString()); return order; } @Override public Order pay(long id) { Order order = orders.get(id); System.out.println("尝试支付,订单号:" + id); Message message = MessageBuilder.withPayload(OrderStatusChangeEventEnum.PAYED). setHeader("order", order).build(); if (!sendEvent(message)) { System.out.println(" 支付失败, 状态异常,订单号:" + id); } return orders.get(id); } @Override public Order deliver(long id) { Order order = orders.get(id); System.out.println(" 尝试发货,订单号:" + id); if (!sendEvent(MessageBuilder.withPayload(OrderStatusChangeEventEnum.DELIVERY) .setHeader("order", order).build())) { System.out.println(" 发货失败,状态异常,订单号:" + id); } return orders.get(id); } @Override public Order receive(long id) { Order order = orders.get(id); System.out.println(" 尝试收货,订单号:" + id); if (!sendEvent(MessageBuilder.withPayload(OrderStatusChangeEventEnum.RECEIVED) .setHeader("order", order).build())) { System.out.println(" 收货失败,状态异常,订单号:" + id); } return orders.get(id); } @Override public Map<Long, Order> getOrders() { return orders; } /** * 发送状态转换事件 * @param message * @return */ private synchronized boolean sendEvent(Message<OrderStatusChangeEventEnum> message) { boolean result = false; try { orderStateMachine.start(); result = orderStateMachine.sendEvent(message); } catch (Exception e) { e.printStackTrace(); } finally { if (Objects.nonNull(message)) { Order order = (Order) message.getHeaders().get("order"); if (Objects.nonNull(order) && Objects.equals(order.getOrderStatus(), OrderStatusEnum.FINISH)) { orderStateMachine.stop(); } } } return result; } } 3.5 测试入口 这里编写一个controller模拟c端用户请求,为了便于展示,这里使用一个测试方法完成所有的操作 @RestController public class OrderController { @Resource private OrderService orderService; @RequestMapping("/testOrderStatusChange") public String testOrderStatusChange(){ orderService.create(); orderService.create(); orderService.pay(1L); orderService.deliver(1L); orderService.receive(1L); orderService.pay(2L); orderService.deliver(2L); orderService.receive(2L); System.out.println("全部订单状态:" + orderService.getOrders()); return "success"; } } 下面是对应的执行结果  可以看到spring状态机很好的控制了订单在各个状态之间的流转。 4. 思考与总结 思考:针对状态机的特点,还有其他思路实现一个状态机吗?下面是一些常规思路,如果还有其他方法欢迎在评论区留言。 1. 消息队列方式 订单状态的流转可以通过MQ发布一个事件,消费者根据业务条件把订单状态进行流转,可以根据不同的事件发送到不同的Topic。 2. 定时任务驱动 每隔一段时间启动一下job,根据特定的状态从数据库中拿对应的订单记录,然后判断订单是否有条件到达下一个状态。 3. 规则引擎方式 业务团队可以在规则引擎里编写一系列的状态及其对应的转换规则,由规则引擎根据已经加载的规则对输入数据进行解析,根据解析的结果执行相应的动作,完成状态流转。 总结: 本文主要介绍了设计模式中的状态模式,并在此基础上介绍了Spring状态机相关的概念,并根据常见的订单流转场景,介绍了Spring状态机的使用方式。文中如有不当之处,欢迎在评论区批评指正。 5. 参考内容 https://docs.spring.io/spring-statemachine/docs/4.0.0/reference/index.html#statemachine-config-states https://cloud.tencent.com/developer/article/2198477?areaId=106001 https://cloud.tencent.com/developer/article/2360708?areaId=106001 https://juejin.cn/post/7087064901553750030 https://my.oschina.net/u/4090830/blog/10092135 https://juejin.cn/post/7267506576448929811 作者:京东科技 孙扬威 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅谈SQL优化小技巧 | 京东云技术团队

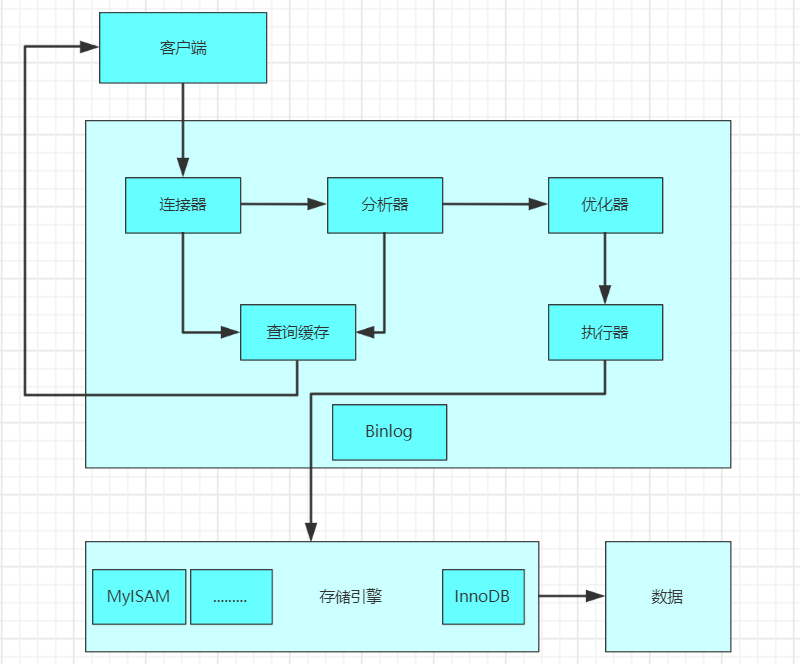
回顾MySQL的执行过程,帮助介绍如何进行sql优化。 (1)客户端发送一条查询语句到服务器; (2)服务器先查询缓存,如果命中缓存,则立即返回存储在缓存中的数据; (3)未命中缓存后,MySQL通过关键字将SQL语句进行解析,并生成一颗对应的解析树,MySQL解析器将使用MySQL语法进行验证和解析。 ​ 例如,验证是否使用了错误的关键字,或者关键字的使用是否正确; (4)预处理是根据一些MySQL规则检查解析树是否合理,比如检查表和列是否存在,还会解析名字和别名,然后预处理器会验证权限; ​ 根据执行计划查询执行引擎,调用API接口调用存储引擎来查询数据; (5)将结果返回客户端,并进行缓存;  SQL语句性能优化常用策略 1、 为 WHERE 及 ORDER BY 涉及的列上建立索引 对查询进行优化,应尽量避免全表扫描,首先应考虑在 WHERE 及 ORDER BY 涉及的列上建立索引。 2、where中使用默认值代替null 应尽量避免在 WHERE 子句中对字段进行 NULL 值判断,创建表时 NULL 是默认值,但大多数时候应该使用 NOT NULL,或者使用一个特殊的值,如 0,-1 作为默认值。 为啥建议where中使用默认值代替null,四个原因: (1)并不是说使用了is null或者 is not null就会不走索引了,这个跟mysql版本以及查询成本都有关; (2)如果mysql优化器发现,走索引比不走索引成本还要高,就会放弃索引,这些条件 !=,<>,is null,is not null经常被认为让索引失效; (3)其实是因为一般情况下,查询的成本高,优化器自动放弃索引的; (4)如果把null值,换成默认值,很多时候让走索引成为可能,同时,表达意思也相对清晰一点; 3、慎用 != 或 <> 操作符。 MySQL 只有对以下操作符才使用索引:<,<=,=,>,>=,BETWEEN,IN,以及某些时候的 LIKE。 所以:应尽量避免在 WHERE 子句中使用 != 或 <> 操作符, 会导致全表扫描。 4、慎用 OR 来连接条件 使用or可能会使索引失效,从而全表扫描; 应尽量避免在 WHERE 子句中使用 OR 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描, 可以使用 UNION 合并查询: select id from t where num=10 union all select id from t where num=20 一个关键的问题是否用到索引。他们的速度只同是否使用索引有关,如果查询需要用到联合索引,用 UNION all 执行的效率更高。多个 OR 的字句没有用到索引,改写成 UNION 的形式再试图与索引匹配。 5、慎用 IN 和 NOT IN IN 和 NOT IN 要慎用,否则会导致全表扫描。对于连续的数值,能用 BETWEEN 就不要用 IN:select id from t where num between 1 and 3。 6、慎用 左模糊like ‘%…’ 模糊查询,程序员最喜欢的就是使用like,like很可能让索引失效。 比如: select id from t where name like‘%abc%’ select id from t where name like‘%abc’ 而select id from t where name like‘abc%’才用到索引。 所以: 首先尽量避免模糊查询,如果必须使用,不采用全模糊查询,也应尽量采用右模糊查询, 即like ‘…%’,是会使用索引的; 左模糊like ‘%…’无法直接使用索引,但可以利用reverse + function index的形式,变化成 like ‘…%’; 全模糊查询是无法优化的,一定要使用的话建议使用搜索引擎,比如 ElasticSearch。 备注:如果一定要用左模糊like ‘%…’检索, 一般建议 ElasticSearch+Hbase架构 7、WHERE条件使用参数会导致全表扫描。 如下面语句将进行全表扫描: select id from t where num=@num 因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推 迟到 运行时; 它必须在编译时进行选择。然而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。 所以, 可以改为强制查询使用索引: select id from t with(index(索引名)) where num=@num 8、用 EXISTS 代替 IN 是一个好的选择 很多时候用exists 代替in 是一个好的选择: select num from a where num in(select num from b) 用下面的语句替换: select num from a where exists(select 1 from b where num=a.num) 9、索引并不是越多越好 索引固然可以提高相应的 SELECT 的效率,但同时也降低了 INSERT 及 UPDATE 的效。 因为 INSERT 或 UPDATE 时有可能会重建索引,所以怎样建索引需要慎重考虑,视具体情况而定。 一个表的索引数最好不要超过 6 个,若太多则应考虑一些不常使用到的列上建的索引是否有必要。 10、尽量使用数字型字段 (1)因为引擎在处理查询和连接时会逐个比较字符串中每一个字符; (2)而对于数字型而言只需要比较一次就够了; (3)字符会降低查询和连接的性能,并会增加存储开销; 所以:尽量使用数字型字段,若只含数值信息的字段尽量不要设计为字符型,这会降低查询和连接的性能,并会增加存储开销。 11、尽可能的使用 varchar, nvarchar 代替 char, nchar (1)varchar变长字段按数据内容实际长度存储,存储空间小,可以节省存储空间; (2)char按声明大小存储,不足补空格; (3)其次对于查询来说,在一个相对较小的字段内搜索,效率更高; 因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。 14、查询SQL尽量不要使用select *,而是具体字段 最好不要使用返回所有:select * from t ,用具体的字段列表代替 “*”,不要返回用不到的任何字段。 select *的弊端: (1)增加很多不必要的消耗,比如CPU、IO、内存、网络带宽; (2)增加了使用覆盖索引的可能性; (3)增加了回表的可能性; (4)当表结构发生变化时,前端也需要更改; (5)查询效率低; 15、将需要查询的结果预先计算好 将需要查询的结果预先计算好放在表中,查询的时候再Select,而不是查询的时候进行计算。 16、IN后出现最频繁的值放在最前面 如果一定用IN,那么:在IN后面值的列表中,将出现最频繁的值放在最前面,出现得最少的放在最后面,减少判断的次数。 17、尽量使用 EXISTS 代替 select count(1) 来判断是否存在记录。 count 函数只有在统计表中所有行数时使用,而且 count(1) 比 count(*) 更有效率。 18、用批量插入或批量更新 当有一批处理的插入或更新时,用批量插入或批量更新,绝不会一条条记录的去更新。 (1)多条提交 INSERT INTO user (id,username) VALUES(1,'xx'); INSERT INTO user (id,username) VALUES(2,'yy'); (2)批量提交 INSERT INTO user (id,username) VALUES(1,'xx'),(2,'yy'); 默认新增SQL有事务控制,导致每条都需要事务开启和事务提交,而批量处理是一次事务开启和提交,效率提升明显,达到一定量级,效果显著,平时看不出来。 19、将不需要的记录在 GROUP BY 之前过滤掉 提高 GROUP BY 语句的效率,可以通过将不需要的记录在 GROUP BY 之前过滤掉。 下面两个查询返回相同结果,但第二个明显就快了许多。 低效: SELECT JOB, AVG(SAL) FROM EMP GROUP BY JOB HAVING JOB = 'PRESIDENT' OR JOB = 'MANAGER' 高效: SELECT JOB, AVG(SAL) FROM EMP WHERE JOB = 'PRESIDENT' OR JOB = 'MANAGER' GROUP BY JOB 20、避免死锁 在你的存储过程和触发器中访问同一个表时总是以相同的顺序;事务应经可能地缩短,在一个事务中应尽可能减少涉及到的数据量;永远不要在事务中等待用户输入。 21、索引创建规则: 表的主键、外键必须有索引; 数据量超过 300 的表应该有索引; 经常与其他表进行连接的表,在连接字段上应该建立索引; 经常出现在 WHERE 子句中的字段,特别是大表的字段,应该建立索引; 索引应该建在选择性高的字段上; 索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引; 复合索引的建立需要进行仔细分析,尽量考虑用单字段索引代替; 正确选择复合索引中的主列字段,一般是选择性较好的字段; 复合索引的几个字段是否经常同时以 AND 方式出现在 WHERE 子句中?单字段查询是否极少甚至没有?如果是,则可以建立复合索引;否则考虑单字段索引; 如果复合索引中包含的字段经常单独出现在 WHERE 子句中,则分解为多个单字段索引; 如果复合索引所包含的字段超过 3 个,那么仔细考虑其必要性,考虑减少复合的字段; 如果既有单字段索引,又有这几个字段上的复合索引,一般可以删除复合索引; 频繁进行数据操作的表,不要建立太多的索引; 删除无用的索引,避免对执行计划造成负面影响; 表上建立的每个索引都会增加存储开销,索引对于插入、删除、更新操作也会增加处理上的开销。 另外,过多的复合索引,在有单字段索引的情况下,一般都是没有存在价值的;相反,还会降低数据增加删除时的性能,特别是对频繁更新的表来说,负面影响更大。 尽量不要对数据库中某个含有大量重复的值的字段建立索引。 22、在写 SQL 语句时,应尽量减少空格的使用 查询缓冲并不自动处理空格,因此,在写 SQL 语句时,应尽量减少空格的使用,尤其是在 SQL 首和尾的空格(因为查询缓冲并不自动截取首尾空格)。 23、每张表都设置一个 ID 做为其主键 我们应该为数据库里的每张表都设置一个 ID 做为其主键,而且最好的是一个 INT 型的(推荐使用 UNSIGNED),并设置上自动增加的 AUTO_INCREMENT 标志。 24、使用explain分析你SQL执行计划 (1)type system:表仅有一行,基本用不到; const:表最多一行数据配合,主键查询时触发较多; eq_ref:对于每个来自于前面的表的行组合,从该表中读取一行。这可能是最好的联接类型,除了const类型; ref:对于每个来自于前面的表的行组合,所有有匹配索引值的行将从这张表中读取; range:只检索给定范围的行,使用一个索引来选择行。当使用=、<>、>、>=、<、<=、IS NULL、<=>、BETWEEN或者IN操作符,用常量比较关键字列时,可以使用range; index:该联接类型与ALL相同,除了只有索引树被扫描。这通常比ALL快,因为索引文件通常比数据文件小; all:全表扫描; 性能排名:system > const > eq_ref > ref > range > index > all。 实际sql优化中,最后达到ref或range级别。 (2)Extra常用关键字 Using index:只从索引树中获取信息,而不需要回表查询; Using where:WHERE子句用于限制哪一个行匹配下一个表或发送到客户。除非你专门从表中索取或检查所有行,如果Extra值不为Using where并且表联接类型为ALL或index,查询可能会有一些错误。需要回表查询。 Using temporary:mysql常建一个临时表来容纳结果,典型情况如查询包含可以按不同情况列出列的GROUP BY和ORDER BY子句时; 25、当只要一行数据时使用 LIMIT 1 当你查询表的有些时候,你已经知道结果只会有一条结果,但因为你可能需要去fetch游标,或是你也许会去检查返回的记录数。 在这种情况下,加上 LIMIT 1 可以增加性能。 这样一来,MySQL 数据库引擎会在找到一条数据后停止搜索,而不是继续往后查少下一条符合记录的数据。 26、将大的DELETE,UPDATE、INSERT 查询变成多个小查询 能写一个几十行、几百行的SQL语句是不是显得逼格很高?然而,为了达到更好的性能以及更好的数据控制,你可以将他们变成多个小查询。 27、合理分表 尽量控制单表数据量的大小,建议控制在500万以内 500万并不是MySQL数据库的限制,过大会造成修改表结构,备份,恢复都会有很大的问题。 可以用历史数据归档(应用于日志数据),分库分表(应用于业务数据)等手段来控制数据量大小。 作者:京东科技 梁发文 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册