首页 文章 精选 留言 我的

精选列表

搜索[k],共10000篇文章
优秀的个人博客,低调大师

k8s的pod容器中微服务无法创建新线程unable to create new native thread
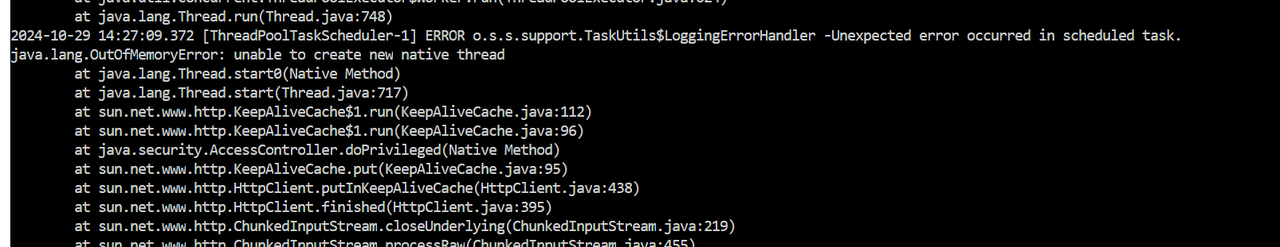
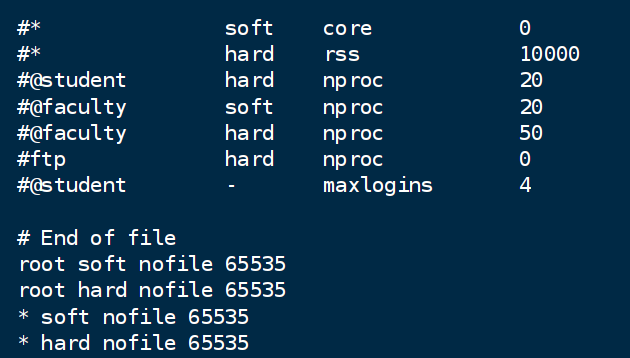
![](https://developer.qcloudimg.com/http-save/audit-1148529/b5c39534cd9fc680300cbd5752a0dd49.png) ## 问题 ![](https://developer.qcloudimg.com/http-save/audit-1148529/36e8cd8fb900e10c627ca2510e1a72d5.png) > Caused by: java.lang.OutOfMemoryError: unable to create new native thread 这是困扰了我们一个很久的OOM问题,经常在一个节点上面多服务压力上来时出现,表面上是一个程序OOM,但具体又是里面的一个分支 线程问题。 出现的症状是不只是说一个服务,是跑在同一个节点上的所有服务而且是需要创建新线程的服务都出现无法创建新线程的异常日志,从节点的资源上看CPU和内存资源都还比较充足,只使用到了一半。 我们查看这个节点上的总线程数如下图趋势: ![](https://developer.qcloudimg.com/http-save/audit-1148529/e1a25144e3c93d033fc88343f7ecfa95.png) 经常性出现,从经验上来看节点的总线程数到达32000后无不例外就有服务出现了unable to create new native thread的异常,而且比较坑的是此异常对服务的/actuator/health 健康检测接口无法探测,即此接口状态返回UP,导致服务不会重启,但服务又无法接收新请求。 接下来查看节点的总线程数设置(未设置之前)。 ```javascript # 宿主机上执行 # 内核级最大线程数,如果不文件不存在,则手动加一个 cat /proc/sys/kernel/threads-max 返回32768 # 最大PID值 cat /proc/sys/kernel/pid_max 返回32768 # 当前用户可创建的最大进程/线程数(nproc) ulimit -u 返回32768 #查看最大线程数内核参数 通常 32768 sysctl kernel.pid_max 返回32768 ``` *cat /etc/security/limits.conf(设置之后的)* ![](https://developer.qcloudimg.com/http-save/audit-1148529/1dea961387ce7b2e7e82e5e767e3c232.png) 从以上几个指令查看结果来看确实是总线程数限制到了32000。 ## 解决 用户可创建的最大线程数 = min (max user processes, threads-max, pid_max); 当然先止血,先调大宿主机节点的总线程数都拉到最大655350 ```javascript # 提升系统级线程数上限(当前 32768 可能不够) sysctl -w kernel.threads-max=655350 sysctl -w kernel.pid_max=655350 # 持久化 echo "kernel.threads-max = 655350" >> /etc/sysctl.conf echo "kernel.pid_max = 655350" >> /etc/sysctl.conf sysctl -p ``` **调整用户级 nproc 限制** /etc/security/limits.conf 追加 ```javascript root soft nofile 655350 root hard nofile 655350 * soft nofile 655350 * hard nofile 655350 ``` **调整系统进程数配置**,在/etc/sysctl.conf添加最大进程和线程数量配置: ```javascript kernel.pid_max=655350 kernel.threads-max=655350 ``` 执行sysctl -p加载并应用内核参数,执行sysctl -a |grep threads-max和sysctl -a |grep pid_max进行验证。 目前根据运维提供的资料将系统里面能改的参数都改了,但……将服务启动过了不久,仍然还有服务报无法创建新线程的异常。 至此开始怀疑是不是配置没生效,但从ulimit -a的一些指令来看都是没问题的,那就唯一一条路:重启大法。也许是需要将服务器重启才能生效。 于是建议将服务器进行了重启,结果总线程数终于能突破32000,至此配置生效。 当然 也要同时优化程序代码,从宿主机上统计应用时发现有多个java应用线程数达到4000以上甚至到了8000多,多个服务加一起总数肯定会超32000。
优秀的个人博客,低调大师

分享 Github 上收获 4k stars 的 12 条原则

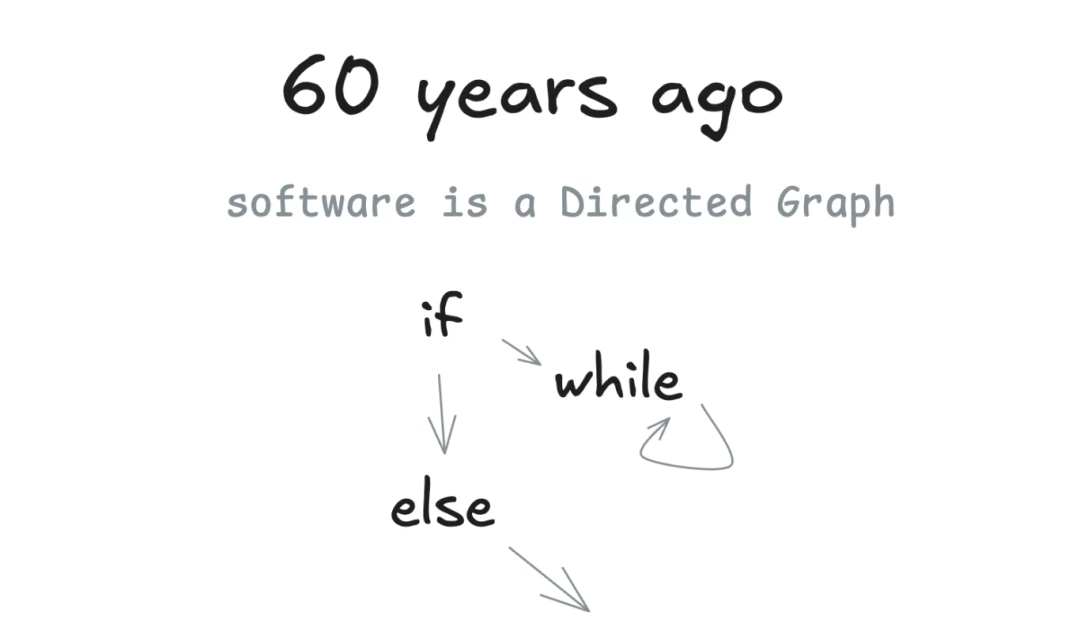
编者按: AI 智能体到底应该如何构建?是追求复杂的端到端解决方案,还是回归软件工程的本质思维? 我们今天为大家带来的文章,作者的观点是:智能体本质上就是软件,应该用严谨的软件工程原则来构建,而非盲目追求"黑箱式"的复杂框架。 文章从智能体的发展历程出发,深入剖析了从有向图到 DAG 编排工具,再到今天 AI 智能体的技术演进脉络。随后,作者系统性地提出了构建可靠 LLM 应用的12个核心原则。 这篇文章为正在构建 AI 应用的开发者提供了一套完整而实用的方法论,特别适合那些希望摆脱框架束缚、追求技术本质的工程师。相信通过这12个原则的指导,我们能够构建出更加可靠、可控、可扩展的智能体系统。 01 AI Agent 是如何走到今天的 1.1 我的观点仅供参考 无论您是智能体领域的新手,还是像我这样固执的老兵,我都将试图说服您摒弃对 AI Agent 的大部分固有认知,退一步,从第一性原理(first principles)出发重新思考它们。(如果你错过了不久前 OpenAI 发布的内容,这里有个剧透预警:把更多智能体逻辑塞进 API 后面并非正解) 02 智能体本质上是软件,让我们简要追溯其发展历程 让我们回溯智能体的发展脉络。 2.1 60 年前 这个阶段重点探讨的是有向图(DGs)及其无环版本 ------ 有向无环图(DAGs)。首先要指出的是...软件本质上就是有向图。这就是为什么我们过去常用流程图表示程序的原因。 2.2 20 年前 约 20 年前,DAG 编排工具开始流行。我们开始谈论 Airflow[1]、Prefect[2] 等经典工具,以及它们的前辈,还有 dagster[3]、inggest[4]、windmill[5] 等新秀。这些编排工具沿用了相同的图模式,同时增加了可观测性(observability)、模块化(modularity)、重试机制(retries)、管理界面(administration)等功能优势。 2.3 10-15 年前 当机器学习模型开始展现出实用价值时,我们开始看到融入 ML 模型的 DAG 工作流。一些典型的步骤可能包括"将此列中的文本汇总到一个新列中"或"按严重程度/情感对支持工单进行分类"。 但归根结底,这些软件在很大程度上还是确定性软件(deterministic software)。 2.4 智能体技术带来的根本性变革 我并非第一个提出此观点[6]的人,但当我开始研究智能体时,最深刻的领悟是:你可以彻底摒弃 DAG 架构。无需软件工程师针对每个步骤和边界条件进行编码,只需赋予智能体一个目标和一组状态转移规则: 让 LLM 实时做出决策,找出路径。 这样做的好处是可以减少代码编写量。你只需为 LLM 定义图的"边",由其自主推导"节点"。借此,系统可具备错误自恢复能力,大幅减少代码量,甚至可能发现 LLM 独创的问题解决方案。 2.5 智能体(Agents)的核心运行机制是一个循环体系 换个角度看,这是一个包含 3 个步骤的循环体系: 1)LLM 通过结构化 JSON 输出确定工作流的下一步("工具调用") 2)由确定性代码执行工具调用 3)将工具运行结果追加至上下文窗口 4)不断循环直至判定下一步为"完成"状态 初始上下文仅是起始事件(可能是用户消息、定时触发任务或 webhook 等),然后我们要求 LLM 选择下一步(工具)或判断任务是否完成。 下面是一个多步骤示例: 而生成的"materialized" DAG 结构示例如下: 2.6 "循环往复,直至问题解决"模式的缺陷 该模式最显著的弊端: 当上下文窗口过长时,智能体会迷失方向,他们陷入反复尝试同一种错误方法的循环 字面意思就是这样,仅此一项就足以使该方法失效 即使你没有手动构建过智能体,在使用自动化编程工具时也应当遭遇过这种长上下文问题。系统往往在多次交互后陷入混乱,迫使您重启对话。 我还想提出一个我经常听到的观点,你可能已深有体会: 即使模型支持的上下文窗口越来越大,精准、简洁的提示词始终能获得更优的结果 与我交流过的多数开发者都放弃了"工具调用循环(tool calling loop)"方案,皆因发现超过 10-20 次交互后,LLM 便无法恢复任务状态。即便智能体准确率达 90%,这仍与"可交付客户使用"的标准相去甚远。试想一个网页应用若在 10% 的访问中崩溃,会是一种怎样的用户体验? 2.7 真正有效的方法 ------ 微智能体(micro agents) 我在实际应用中观察到一种比较常见的方法,使用智能体架构并将其嵌入到更宏观的、更具确定性的有向无环图(DAG)系统中。 您可能会问:"为什么在这种情况下还要使用智能体?"我们稍后会详细解释。简而言之,让语言模型管理限定范围明确的任务集合,可以轻松整合实时的人类反馈,并将这些反馈转化为工作流步骤,而不会陷入上下文错误循环(即后文所提到的 factor 1、factor 3、factor 7)。 2.8 现实生活中的微智能体案例 下面这个示例展示了如何使用确定性代码运行微智能体,处理部署过程中的人工介入步骤: 人工将 PR 合并到 GitHub 主分支 使用确定性代码将修改后的项目部署到预发布环境 使用确定性代码运行预发布环境的端到端(e2e)测试 使用确定性代码将初始上下文"将 SHA 4af9ec0 部署到生产环境"移交智能体进行生产环境的部署 智能体调用 deploy_frontend_to_prod(4af9ec0) 使用确定性代码请求人工批准此操作 人工拒绝操作并反馈"能否先部署后端部分?" 智能体调用 deploy_backend_to_prod(4af9ec0) 使用确定性代码请求人工批准此操作 人工批准进行操作 使用确定性代码执行后端部分的部署 智能体调用 deploy_frontend_to_prod(4af9ec0) 使用确定性代码请求人工批准此操作 人工批准进行操作 使用确定性代码执行前端部分的部署 智能体判定任务成功完成,流程结束! 使用确定性代码运行生产环境的端到端测试 确定性代码任务完成后,若检测到异常,则转交回滚智能体进行故障审查,必要时执行版本回退 这个示例基于我们为管理 Humanlayer 的部署流程而部署的一个开源智能体(OSS agent),以下是我上周与它的真实对话记录: 我们没有让这个智能体拥有过多的功能或复杂的职责。LLM 的核心价值在于解析人类的自然语言反馈,并提出更新的行动方案。我们尽可能避免让它同时处理过多无关的任务或记忆冗长的历史记录,使 LLM 专注于 5-10 步的小型工作流。 这里有另一个更经典的客户支持/ chatbot 示例[7]。 2.9 那么,智能体的本质究竟是什么? prompt - 告诉 LLM 如何行动,以及它可以使用哪些"工具"。prompt 的输出是一个 JSON 对象,用于描述工作流程中的下一步("工具调用"或"函数调用")。(factor 2) switch 语句 - 根据 LLM 返回的 JSON 内容决定后续操作。(factor 8 的一部分) 累积的上下文 - 记录已执行的操作步骤及其运行结果(factor 3) for 循环 - 循环执行以下操作,直至大语言模型(LLM)返回终止信号(如标记为"Terminal"的工具调用或自然语言响应):将 switch 语句的执行结果加入上下文窗口,并让 LLM 决定下一步动作。(factor 8) 以"deploybot"为例,我们通过自主掌控流程逻辑和上下文积累,获得了以下优势: 在 switch 语句和 for 循环中,我们可以随时拦截控制流来暂停等待人工输入,或等待长时间运行的任务完成 我们能将上下文窗口轻松序列化存储,实现「断点续传」式的任务暂停与恢复 在 prompt 的设计中,我们可以优化任务指令的传递方式和"当前任务进度"的说明方式 03 factor 01:自然语言转工具调用(Tool Calls) 智能体(agent)构建最常见的模式之一就是将自然语言转换为结构化的工具调用。这是一种功能强大的模式,可以构建能够推理任务并执行任务的智能体。 这种模式的核心原理,就是实现从自然语言到结构化指令的精准转换: 请为 Terri 生成 750 美元的赞助支付链接,用于支付二月份 AI 创客大会的赞助费用。 最终输出一个结构化对象,用于描述 Stripe API 的调用参数,例如: 注:实际场景中 Stripe API 的调用更为复杂。一个成熟的智能体需要先获取客户列表、产品目录和价目表等数据,通过关联 ID 构建有效请求参数 ------ 当然,这些 ID 也可以直接预置在提示词/上下文窗口中(本质上这两种方式是相通的,下文将具体说明)。 后续可由确定性代码接管该请求参数,并执行相应的业务逻辑。(更多细节将在 factor 3 中说明) 请注意:完整版的智能体在接收到 API 的调用结果后,会通过循环处理机制最终返回类似这样的信息: 已成功为 Terri 创建 750 美元的支付链接,用于赞助二月份 AI 创客见面会。链接如下:https://buy.stripe.com/test_1234567890 但本节将跳过该环节,将其保留至后续章节实现 ------ 开发者可根据实际需求决定是否集成该功能。 04 factor 02:自主掌控提示词 不要直接套用框架自动生成的提示词。 某些框架会提供这种'黑箱式'方案: 这种方案能帮你快速套用顶尖的提示词模板上手,但后期很难精准调整或实施逆向工程,难以确保模型接收的指令完全符合预期。 相反,你要像对待核心业务代码一样对待提示词: 虽然上面这个示例是用 BAML 工具生成提示词的,但其实你可以根据自己的需求选择任何提示词设计工具,甚至完全不需要借助工具,直接按照模板格式手动编写提示词也是可行的。 自主掌控提示词的核心优势: 完全的控制权:可以精准定制 AI Agent 所需的指令,彻底摆脱"黑箱操作"的束缚 可测试和可评估:像测试普通代码一样,为你的提示词建立完整的测试评估体系 快速迭代:根据实际使用效果,随时灵活调整优化提示词 透明可控:清楚掌握 AI Agent 执行的具体指令内容,没有隐藏逻辑 角色突破:利用那些支持自定义用户/助手角色设定的 API 接口 ------ 比如 OpenAI 已弃用的旧版 'completions' 非对话型 API,甚至可以实现一些特殊的模型引导技巧 请记住:提示词(prompts)是连接你的业务逻辑与大语言模型的主要接口。 完全掌控提示词,才能提供生产级 AI Agent 所需的灵活性和提示词控制能力。 虽然没人能断言什么是最佳提示词,但有一点很明确 ------ 你需要的是能自由尝试各种可能性。 05 factor 03:自主掌控上下文窗口 与大语言模型交互时,上下文传递不必拘泥于标准消息格式。 在智能体(agent)中,每次向 LLM 提供输入的实质是:"这是目前情况,接下来该干嘛?" 一切皆上下文工程。大语言模型本质上是无状态函数(stateless functions)[8],只负责将输入转化为输出。想要获得优质输出,就必须提供优质输入。 构建优质上下文需包含以下要素: 提示词与指令:给模型的明确操作指引 外部数据源:检索到的文档或知识(例如使用 RAG 技术) 历史状态:过往的工具调用记录、执行结果等操作痕迹 记忆系统:有关联但独立的对话/事件历史记录(Memory) 输出结构化指令:规定模型返回数据的格式规范 本指南聚焦如何最大限度挖掘现有模型的潜力,以下内容不在讨论范围内: 调整模型参数(如 temperature、top_p、frequency_penalty、presence_penalty 等) 训练自定义的生成模型(completion models)或嵌入模型 对现有模型进行微调 在此重申:虽然无法断言最佳的上下文传递方式,但我知道你希望能够灵活地尝试各种方式。 5.1 标准上下文格式与自定义上下文格式 大多数 LLM 客户端采用如下这种标准消息格式: 虽然这种格式适用于大多数场景,但若想极致压榨现有 LLM 的性能,就必须以最高效的 token 利用率和注意力分配机制来传递上下文。 若希望突破基于消息的标准格式限制,您可以创建专为你个人的应用场景优化的上下文组织形式。例如,通过自定义数据结构将相关内容整合,根据实际需求打包或拆分到一个或多个用户、系统、助手或工具消息中(具体组合视业务逻辑而定)。 以下示例演示了如何将完整的上下文信息封装于单条用户消息中: 虽然模型可能通过你提供的工具定义自动推导后续操作步骤,但我们仍建议在提示词模板中明确声明任务目标 ------ 主动说明需求始终是更稳妥的做法。 5.2 code example 我们可以采用如下方式构建: 上下文窗口示例 下面是使用这种方法后上下文窗口的样子: 初始的 Slack 请求: 列出 Git 标签后: 错误发生与恢复后: 此时你的下一步可能是: 上文那些 XML 格式的内容仅是一个参考示例 ------ 您可以根据实际业务需求,自定义最合适的数据结构。通过灵活尝试不同的上下文组织形式、存储内容和输入大模型的内容,最终输出质量会显著提升。 自主控制上下文窗口的好处: 信息密度:以最适配 LLM 认知的方式组织信息 错误处理:采用有助于 LLM 自主恢复的格式记录错误信息(已修复的错误和失败调用可从上下文中移除) 安全性:主动过滤敏感数据,精准控制输入内容 灵活性:根据使用情况持续优化调整上下文格式 token 效率:优化上下文格式,提高 token 效率与模型理解能力 上下文可包含: 提示词(prompts)、指令(instructions)、RAG 文档(RAG documents)、交互历史(history)、工具调用记录(tool calls)、记忆(memory) 请记住,上下文窗口是你与 LLM 交互的主要界面,其结构设计与信息呈现方式将直接决定智能体的效能。 示例 - 信息密度优化(相同的语义信息,更少的 token 消耗量): 虽然无法预知最优方案,但必须确保系统具备无限试错的可能性------任何可能的尝试路径都应向你开放。 06 factor 04:「工具」本质上只是 LLM 生成的结构化输出 「工具」无需进行复杂设计。其本质是大语言模型生成的结构化输出,用于触发确定性代码的执行。 以 CreateIssue 和 SearchIssues 这两个工具为例,让大模型(LLM)"调用工具",本质上就是让它输出一个可解析的 JSON 对象,该对象对应我们要执行的具体工具操作。 这种模式很简单: 1)LLM 生成结构化的 JSON 输出 2)使用确定性代码执行对应操作(如调用外部 API) 3)捕获执行结果并反馈到上下文中 这种设计实现了 LLM 决策逻辑与应用程序执行逻辑的清晰分离 ------ LLM 负责决定『做什么』,而你的代码掌控『怎么做』。即便 LLM 调用了某个工具,具体执行方式也不必每次都严格对应单一函数。 如果你还记得前文提及的 switch 语句 注:关于"plain prompting" vs. "tool calling" vs. "JSON mode"的性能权衡已有诸多讨论。在此附上相关资源链接(参见《Prompting vs JSON Mode vs Function Calling vs Constrained Generation vs SAP》[9]、《When should I use function calling, structured outputs, or JSON mode?》[10]及《OpenAI JSON vs Function Calling》[11]),此处不展开论述。 所谓的"下一步操作"未必只是简单地"运行一个纯函数并返回结果"。当你把"工具调用"单纯视为模型输出的一段 JSON 指令(用于描述确定性代码该执行什么)时,就能解锁极大的灵活性。结合 factor 08 ,这种设计将带来更强大的可能性。 07 factor 05:执行状态与业务状态的统一 即便在 AI 领域之外,许多基础设施系统也试图将"执行状态"与"业务状态"分离。对 AI 应用而言,这种分离可能涉及复杂的抽象机制来追踪当前步骤、下一步骤、等待状态、重试次数等。这种分离带来的复杂性可能是值得的,但对你的使用场景而言可能是过度设计。 你可以自行决定什么最适合你的应用。但不要认为必须将这两者分开管理。 更清晰的定义: 执行状态(Execution state):当前步骤、下一步骤、等待状态、重试次数等 业务状态(Business state):智能体工作流中已发生的事件(如 OpenAI 消息列表、工具调用及结果列表等) 如果可能,尽量简化 ------ 尽可能将它们统一起来。 实际上,你可以通过工程化设计,直接从上下文窗口推断所有执行状态。多数情况下,执行状态(当前步骤、等待状态等)不过是已发生事件的元数据(metadata)。 当然,有些内容无法放入上下文窗口(如会话 ID、密码上下文等),但你的目标应该是尽量减少这类例外。通过遵循 factor 3,你可以精准控制哪些信息真正输入给 LLM。 该方法具有以下优势: 简洁性:所有状态只有一个真实来源 序列化:工作流可轻松实现序列化/反序列化 调试便捷:完整的历史记录一目了然 扩展灵活:仅需新增事件类型即可扩展新的状态 断点续传:通过加载工作流可从任意节点恢复执行 流程复刻(Forking) :可以在任何时间点复制工作流子集至新上下文/状态ID,实现在工作流的复刻(fork) 人机交互和可观测性:工作流可轻松转换为 Markdown 文档或可视化 Web 界面 08 factor 06:通过简单的 API 实现启动/暂停/恢复 智能体的本质是程序,其生命周期管理应符合我们对常规程序的预期 ------ 能够便捷地启动、查询、恢复和终止。 需确保终端用户、应用程序、业务管道及其他智能体均可通过轻量级 API 接口快速部署新智能体实例。 智能体及其编排的确定性代码须具备长时操作自暂停能力。 需支持通过 Webhook 等外部触发器实现智能体断点续执,且无需深度对接智能体编排系统。 factor 6 与 factor 5 和 factor 8 存在较强的关联,但可独立实现。 需特别注意,多数现有的 AI 编排系统虽支持暂停恢复功能,但在『工具选定』与『工具执行』两个状态节点之间的临界区间,多数系统无法保持状态持久化能力(详见 factor 7 和 factor 11 的技术解析)。 09 factor 07:通过工具调用实现人机协同 默认情况下,LLM API 在生成模型响应时,首先会面临一个关键的、高风险的词元选择:是返回纯文本内容,还是返回结构化数据? 系统将大量决策权重放在首个词元的选择上。例如在查询"东京天气"时,首个词元可能是: "东京" 而在 fetch_weather(获取天气)功能中,则可能是表示 JSON 对象开头的特殊词元。 |JSON> 更优方案是让大语言模型始终输出 JSON 结构化数据,然后通过自然语言词元(如 request_human_input 或 done_for_now)来声明意图,而不是使用像 check_weather_in_city 这样的"标准"工具。 需特别注意:此方案可能不会直接提升系统性能指标,但必须通过持续实验验证 ------ 工程师应保留尝试非常规手段的自由度,这是获得最优解的必经之路。 后续,您可能会收到来自处理 Slack、电子邮件、短信或其他事件的系统的 webhook 通知。 上文整合了 factor 3、4、5、8 的方案特征。 若采用 factor 3 中的类 XML 格式,那么经过数次交互后,上下文窗口可能会是这样的: 优势亮点: 清晰的指令:针对不同人机交互场景的工具设计,可大幅提升大语言模型(LLM)输出的精准度。 内循环与外循环机制:该机制使智能体工作流突破传统 ChatGPT 式交互框架,支持逆向流程触发 ------ 控制流与上下文初始化可由智能体主动发起至用户(例如:通过定时任务或事件自动激活的智能体服务)。 多用户协同:依托结构化事件机制,可高效追踪并协调多用户输入数据流。 多智能体协作:通过轻量级抽象层设计,快速扩展智能体间的请求与响应能力 持久化运行:结合 factor 6 的启停控制能力,可构建高稳定、可观测的多角色持久化工作流。 有关外循环智能体(Outer Loop Agents)的更多信息,请点击此处[12]。 与 factor 11 完美结合 ------ 随时随地触发,满足用户需求。 10 factor 08:掌控你的控制流 如果你能掌握你的控制流,就可以实现更灵活、强大的功能。 根据具体应用场景构建专属控制逻辑,精准匹配业务场景。当特定类型的工具调用需要中断循环等待人工响应或长时任务(如训练流水线)时,您可设计灵活的中断机制。建议集成以下自定义功能: 工具调用结果的摘要与缓存 使用 LLM 对结构化输出进行校验、评估 上下文窗口压缩或其他内存管理方案 全链路日志追踪与性能监控 客户端速率限制策略 持久化的休眠/暂停/事件等待机制 下方示例展示了三种典型的控制流模式: request_clarification:模型请求补充信息时,中断当前循环流程,等待人工响应 fetch_git_tags:当模型请求 Git 标签列表时,系统会实时获取标签数据并更新上下文,直接将结果反馈给模型 deploy_backend:模型发起后端部署请求时,因涉及高风险操作,中断流程等待人工审核确认 这种模式允许你根据需要中断和恢复智能体的工作流程,从而创建更自然的对话和工作流。 举个例子,我对所有 AI 框架的首要功能需求就是:正在工作的智能体能够中断操作并在之后恢复运行,特别是在工具选择和工具调用之间的时刻。 如果缺乏这种可恢复性/精细控制能力,就无法在工具调用执行前进行审核(review/approve),这意味着您被迫只能选择以下方案: 1)在等待长时间任务完成时,将任务及其上下文状态(变量、堆栈等)保留在内存中(类似while...sleep),如果进程中断则必须从头开始 2)限制智能体只能执行低风险、低影响的调用,如研究和摘要 3)允许智能体执行更重要、更有用的操作,然后只能祈祷它不会搞砸 您可能会注意到,这一点与 factor 5 及 factor 6 密切相关,但也可以独立实现。 11 factor 09:将错误信息压缩至上下文窗口 这一点虽然简短,但值得一提。智能体的优势之一在于"自我修复"------对于短任务,大语言模型(LLM)可能会调用某个失败的工具。优秀的 LLM 通常能够读取错误信息或 Stack Trace 信息,并在后续工具调用中调整策略。 大多数框架已实现这一功能,但你也可以只做到这一点,而无需实现其他 11 个 factor。例如: 你可能需要为特定的工具调用实现一个错误计数器(errorCounter),将单个工具的重试次数限制在 ~ 3次以内,或者根据实际需求调整业务逻辑。 当连续错误次数达到某个阈值时,无论是模型自主决策还是通过预编程规则强制接管控制流,都可以选择升级至人工处理。 优势: 自我修复能力:大语言模型能够解读错误信息,并在后续工具调用中自动调整执行策略 持久运行机制:单一工具调用失败不会导致系统中断,智能体程序可持续执行任务 需要提醒的是,智能体过度依赖这种自我修复机制时,可能导致智能体在错误处理过程中无法有效突破现有逻辑框架,出现反复报错的情况。 此时,factor 8 和 factor 3 就派上用场了 ------ 你不必直接把原始错误丢回给系统,而是重构错误表达方式、从上下文窗口移除冗余的历史记录,避免干扰后续决策,或者采用其他有效的确定性策略(只要能确保智能体程序回归正轨)。 防范陷入错误循环的最核心策略,是遵循 factor 10。 12 factor 10:小型化、功能聚焦的智能体 与其构建试图包办一切的大型智能体,不如开发专注于某一单一功能的小型智能体。智能体只是一个更大的、主要由确定性因素决定的系统中的基础组件之一。 这里的关键之处在于大语言模型(LLM)的局限性:任务越庞大复杂,所需任务步骤就越多,就意味着需要更长的上下文窗口。随着上下文增长,大语言模型更容易迷失方向或偏离重点。通过将智能体的功能限定在特定领域(3-10 个步骤,最多 20 个任务步骤),我们可以保持上下文窗口的可管理性,确保大语言模型的高效运行。 小型化、功能聚焦的智能体的优势: 1)可管理的上下文:更小的上下文窗口意味着更优的大语言模型表现 2)职责明确:每个智能体都有清晰的功能边界和设计目标 3)可靠性更高:在复杂的工作流程中迷失方向的可能性更低 4)更易于测试:更简单地测试和验证特定功能 5)调试优化:问题发生时更容易定位和修复 12.1 如果 LLM 变得更聪明了呢? 如果大语言模型的智能程度足够高,能处理 100+ 步骤的工作流,我们还需要这种设计吗? tl;dr:需要。虽然智能体和大模型进步后可能自然而然地拥有处理更长上下文的能力,这意味着能处理更多更大的 DAG。但采用小型化、功能聚焦的架构设计,既能确保你在第一时间获得可靠的结果,又为未来大模型的上下文窗口扩容时逐步扩展智能体范围做好准备。(如果你重构过大型的确定性代码库,此刻应该会心一笑) 有意识地确定智能体的规模/范围,并且只在能够保证质量的情况下扩展,这是关键所在。正如 NotebookLM 开发团队所言[13]: "在 AI 开发中,那些最惊艳的突破时刻往往发生在我将将触及模型能力边界的时候" 无论这个能力边界在哪里,如果你能找到边界并始终如一地把握住它,你就能打造出惊艳的用户体验。这个领域有很多技术护城河可以构建,但一如既往,这需要严谨的工程实践。 13 factor 11:智能体系统支持多入口触发,且响应与触发渠道保持一致 当您已落实 factor 6 和 factor 7 后,便可无缝集成本原则方案。 支持用户通过 Slack、邮件、短信等任意渠道唤醒智能体,并确保响应始终在原对话流中完成。 优势: 满足用户需求:打造拟人化的 AI 应用体验,让用户感受如真人协作或至少达到数字同事般的自然交互 外循环智能体:支持非人工触发(系统事件/定时任务/故障告警等),可自主运行5-90分钟,关键决策节点自动请求人工介入(需审批/获取反馈/请求协助) 高风险操作授权机制:通过快速人工复核机制,可授权智能体执行高风险操作(如外发邮件、生产数据更新等)。明确、标准化的管控体系既保障操作可追溯,又能提升智能体执行复杂任务的可靠性。 14 factor 12:将智能体设计为符合"无状态归约器"模式 END 本期互动内容 🍻 ❓文中多次强调"没人知道什么是最佳实践,但必须保留试错自由"。你最近在 AI Agent 项目中做过哪些不符常规但有效的技术决策? 文中链接 [1]https://airflow.apache.org/ [2]https://www.prefect.io/ [3]https://dagster.io/ [4]https://www.inngest.com/ [5]https://www.windmill.dev/ [6]https://youtu.be/Dc99-zTMyMg?si=bcT0hIwWij2mR-40&t=73 [7]https://x.com/chainlit_io/status/1858613325921480922 [8]https://thedataexchange.media/baml-revolution-in-ai-engineering/ [9]https://www.boundaryml.com/blog/schema-aligned-parsing [10]https://www.vellum.ai/blog/when-should-i-use-function-calling-structured-outputs-or-json-mode#:~:text=We+don%27t+recommend+using+JSON,always+use+Structured+Outputs+instead [11]https://docs.llamaindex.ai/en/stable/examples/llm/openai_json_vs_function_calling/ [12]https://theouterloop.substack.com/p/openais-realtime-api-is-a-step-towards [13]https://open.substack.com/pub/swyx/p/notebooklm?selection=08e1187c-cfee-4c63-93c9-71216640a5f8&utm_campaign=post-share-selection&utm_medium=web 原文链接: https://github.com/humanlayer/12-factor-agents

优秀的个人博客,低调大师

13.3k Star! 别让NAS吃灰了! 一款导航聚合控制面板 — Dashy

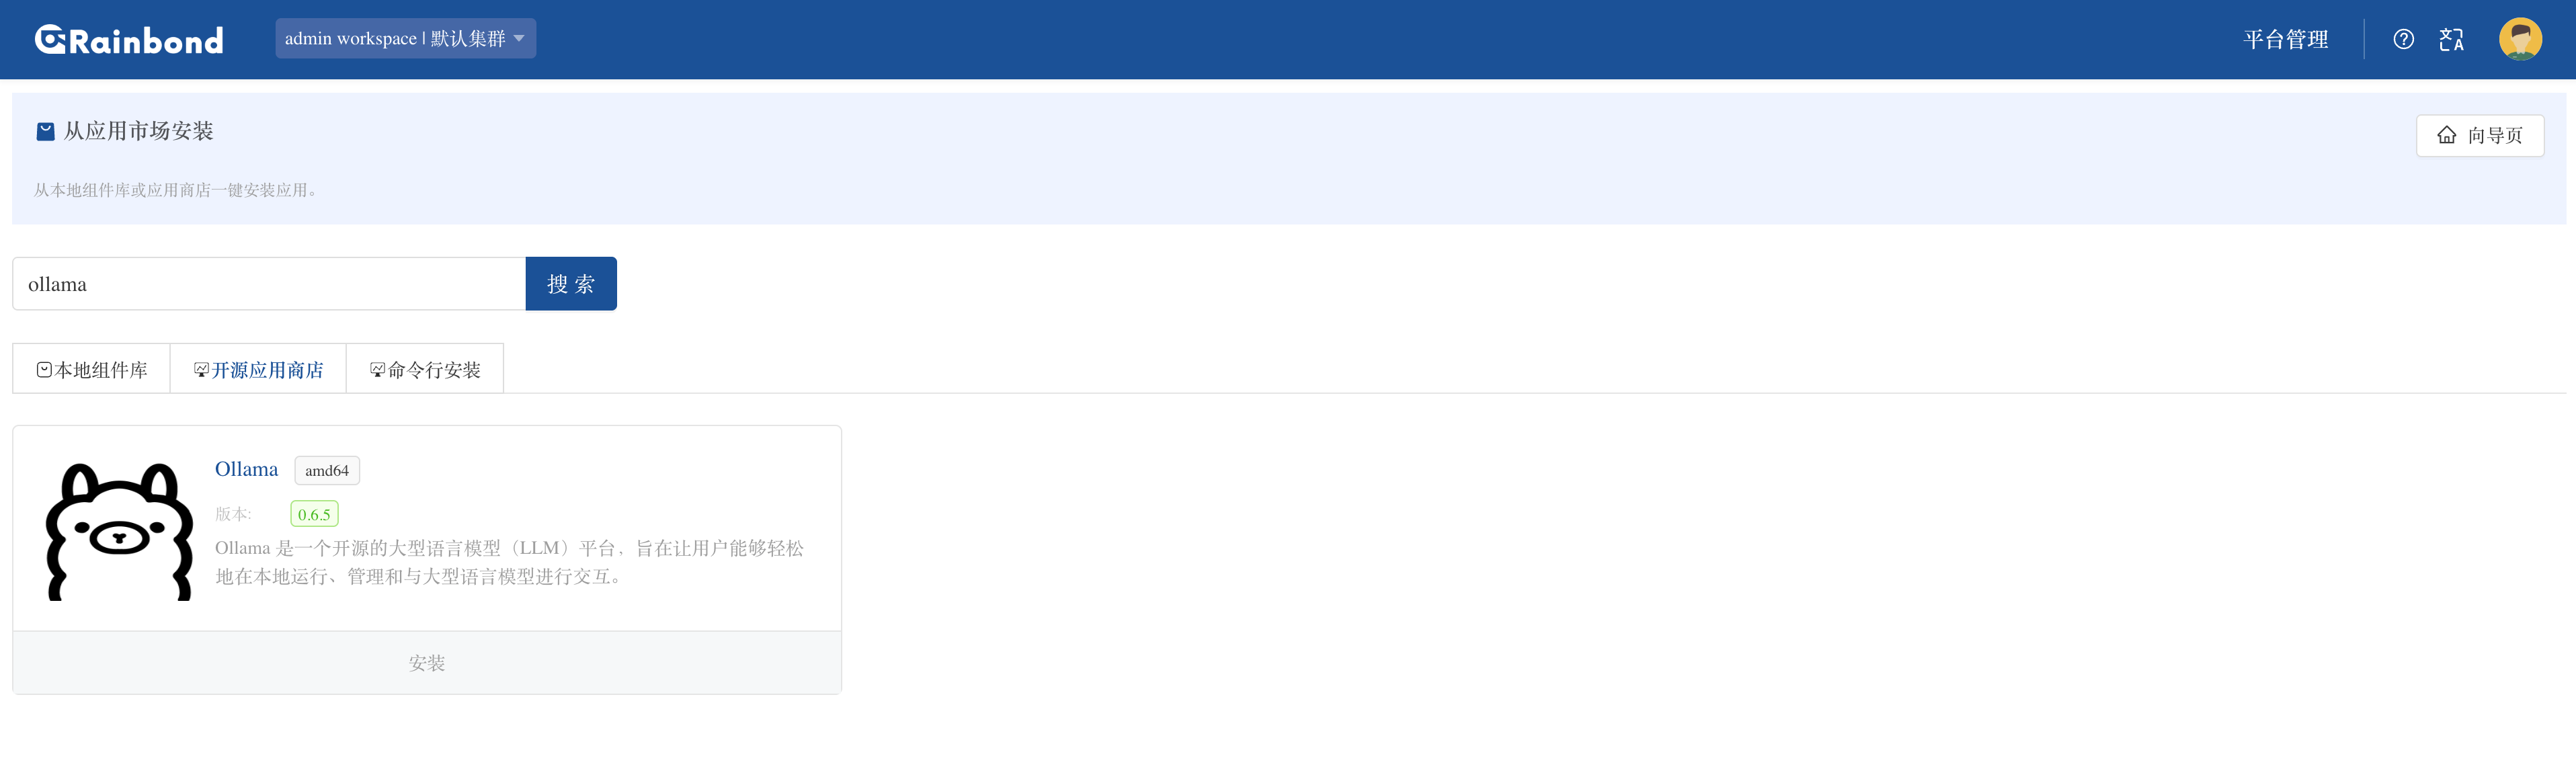
对于NAS爱好者来说,导航页面并不陌生。在安装各种套件和Docker应用后,如何快速找到所需的应用一直是一个挑战。通常有三种方式:依赖记忆、使用收藏夹或利用导航页。前两种方法大家都熟知,但今天我们要介绍一款新的导航页应用——Dashy 应用简览 Dashy 是一款非常酷炫并且科技感十足的面板系统(不单单是导航页)。集成了多个网站的页面,在这个页面上,你可以快速访问你经常使用的网站。Dashy具有高度的自定义性,你可以自己添加和删除网站,也可以自己更换主题和背景。 主要功能 📃 支持多页面 🚦 每个应用程序/链接的实时状态监控 📊 使用小部件显示来自自托管服务的信息和动态内容 🔎 按名称、域名或标签进行即时搜索 + 可自定义的热键和键盘快捷键 🎨 许多内置颜色主题,带有 UI 颜色编辑器并支持自定义 CSS 🧸 许多图标选项 - Font-Awesome、homelab 图标、自动获取 Favicon、图像、表情符号等。 💂 具有多用户访问、可配置权限和 SSO 支持的可选身份验证 🌎 多语言支持,包括 10 多种人工翻译的语言,以及更多即将推出的语言 ☁ 提供可选的、加密的、免费的异地云备份和恢复功能 💼 工作区视图,可同时在多个应用程序之间轻松切换 🛩️ 最小视图,用作快速加载的浏览器起始页 🖱️ 选择应用程序启动方式:新选项卡、同一选项卡、剪贴板、弹出模式或在工作区视图中打开 📏 可定制的布局、大小、文本、组件可见性、排序顺序、行为等。 🖼️ 全屏背景图像、自定义导航栏链接、HTML 页脚、标题等选项。 🚀 使用 Docker、裸机或一键式云部署即可轻松设置 ⚙️ 基于 YAML 的简单单文件配置,以及通过 UI 配置应用程序的选项 ✨ 正在积极开发中,定期添加改进和新功能 🤏 小捆绑包大小、完全响应式 UI 和用于基本离线访问的 PWA 🆓 100% 免费和开源 🔐 高度重视隐私 应用特色 一、多种语言支持 Dashy支持多种语言,包括10多种人工翻译的语言,以及更多即将推出的语言。 二、多种UI主题 Dashy 带有 20 多个内置主题,可以从 UI 的下拉菜单中应用。你还可以添加自己的主题、应用自定义样式和修改颜色。以及可以通过编写自己的 CSS 来自定义 Dashy,它可以作为外部样式表加载、直接通过 UI 设置或在配置文件中指定。大多数样式选项可以通过 CSS 变量设置。 三、编辑态可配置项 Dashy允许用户对编辑态进行配置,以满足个性化需求。 四、多种布局方式和大小尺寸 Dashy提供多种可定制的布局、大小、文本、组件可见性、排序顺序、行为等选项。 五、主菜单设置选项 Dashy允许用户进行主菜单设置选项,以满足个性化需求。 六、云备份&恢复 Dashy提供可选的、加密的、免费的异地云备份和恢复功能。 安装指南 进入云原生应用商店 搜索 Dashy 进入详情,选择包类型(本应用支持,docker安装,ram安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档 或加入社区 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。 官网:https://hub.grapps.cn/ 微信群:关注 云原生应用市场 公众号加入技术交流群

优秀的个人博客,低调大师

1.9k Star! 一款简单、强大且无需数据库的图床程序-EasyImages

应用简览 在互联网时代,图片分享和存储已经成为不可或缺的一部分。使用第三方图床程序存在数据隐私风险、可用性依赖、数据安全问题,可能导致图片加载延迟,以及服务限制。这些缺点与 EasyImages 自托管的特点形成对比,EasyImages 提供更高的数据隐私、控制、数据安全,具备更快的图片加载速度,并可根据需要进行自定义,减少了对第三方服务商的依赖性。 主要特性 支持批量上传,返回多种形式URL:EasyImages 支持批量上传图片,同时返回图片直链、Markdown格式URL、BBCCode、Html、缩略图等链接。 在线管理图片:EasyImages提供了一个在线图片管理界面,您可以在其中方便地查看和管理上传的图片。这节省了大量时间,使您能够轻松维护您的图片库。 支持上传限制和转换格式:EasyImages 支持限制最低宽度和高度,确保上传的图片达到一定的标准,同时还可以自动将上传的图片转换为不同的格式。 支持文字/图片水印:EasyImages支持自动为上传的图片添加文字或图片水印,确保它们不会被滥用。 资源占用少:EasyImages 对于安装环境和服务器性能要求非常低,甚至不需要数据库。这意味着即使在较小的服务器上也可以轻松运行,而且不会占用太多资源。 支持API:EasyImages 提供了全面的API支持,使开发者能够在其项目中方便地上传和管理图片。 支持仅登录后上传:EasyImages可以仅允许已登录用户上传图片,确保图片库保持整洁。 支持设置图片质量和大小:EasyImages 允许您灵活地设置图片的质量和大小。这意味着您可以根据需要调整图片的清晰度和文件大小,以适应不同的用途。 支持网站统计:EasyImages还提供了网站统计功能,帮助您跟踪图片的上传、存储占用,以及其他有用的统计信息。 支持图片鉴黄:EasyImages 还内置了图片鉴黄功能,以确保不良内容不会被上传到您的图床。这对于维护一个安全的平台非常重要。 支持自定义网站代码:您可以自定义网站的页首、页尾、标题、公告等,充分满足自定义需求。 支持上传IP黑白名单:允许您设置IP黑名单和白名单,以进一步保护图床免受恶意活动的侵害。 支持上传日志IP定位:EasyImages 还提供了上传日志IP定位和限制每日上传次数的功能,以帮助您管理和跟踪上传活动。 应用特色 一、支持批量上传、返回多种形式的URL EasyImages 突出特色之一是其出色的批量上传功能。无论您需要上传一张图片还是成千上万张,EasyImages 都能轻松胜任。同时,它能够返回多种形式的URL,满足不同需求。您可以获得原始图片链接、缩略图链接、甚至自动生成的多种规格图片链接,以便在不同场景中使用。 二、在线图片管理 EasyImages 提供了直观的在线图片管理界面,让您能够轻松查看、编辑和组织上传的图片。您可以创建文件夹、排序图片、批量删除或打包图片,从而维护一个整洁有序的图片库。这一特色极大地简化了图片管理的任务,无需手动处理文件或代码。 三、支持上传限制和自动转换图片格式 为了满足不同的使用情境,EasyImages 提供了丰富的上传限制选项。您可以轻松设置上传的图片尺寸、质量和文件大小的限制,以确保上传的图片满足您的需求。此外,EasyImages 还支持自动转换图片格式。这意味着,无论用户上传了哪种图片格式,您都可以将其自动转换为您网站所需的格式,从而提高网站性能和加载速度。 四、支持自动增加文字/图片水印 图片水印对于品牌保护和内容认证至关重要。EasyImages 提供了方便的水印功能,您可以自动为上传的图片添加文字水印或图片水印。这有助于确保您的图片不会被滥用,同时提高了内容的专业性。 五、支持数据统计 数据是图床管理的重要一环。通过 EasyImages 提供的数据统计功能,您能够轻松跟踪图片的上传情况,资源占用情况、存储使用情况等。 六、支持黑白名单上传 保持控制权对于维护图床安全至关重要。EasyImages 提供了黑白名单上传功能,使您能够明确指定哪些用户或IP地址可以上传图片,以及哪些不允许上传。这有助于保护您的图床免受恶意上传和滥用。 安装指南 进入云原生应用市场 搜索 EasyImages 进入详情,选择包类型(本应用支持,docker安装,ram安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档 或加入社区 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。 官网:https://hub.grapps.cn/ 微信群:关注 云原生应用市场 公众号加入技术交流群

优秀的个人博客,低调大师

36.8k Star! 一款小而美的自动化运维监控工具——Uptime Kuma

自动化运维是指利用计算机科学和信息技术来实现系统和应用程序的自动化管理、监控、维护以及问题解决的过程。它的目标是减少人工干预、提高效率、降低错误率,并确保系统的稳定性和可靠性。 应用简览 Uptime-Kuma 是一个轻量级的监控工具,其独特之处在于其优美的监控 Dashboard 面板。仅需几分钟的时间,便可快速搭建一个高效的监控应用。该工具具备开源免费的特性,并支持基于 Docker 的部署方式。总之,Uptime-Kuma 是一个出色的监控工具,为用户提供了简便、美观且高效的监控解决方案。 主要功能 监控 HTTP(s) / TCP / HTTP(s) 关键字 / Ping / DNS 记录 / 推送 / Steam 游戏服务器的正常运行时间。 花哨的、反应式的、快速的 UI/UX。 通过 Telegram、Discord、Gotify、Slack、Pushover、电子邮件 (SMTP) 和 70 多种通知服务发送通知。 提供代理支持。 支持多种语言。 Ping 图(Ping Chart)。 证书信息(Certificate Info)。 应用特色 一、外观精美:令人赏心悦目的用户界面设计,为操作体验增添视觉享受。 Uptime-Kuma在外观设计方面精雕细琢,致力于为用户提供令人愉悦的操作界面。其界面布局优雅简洁,元素排列有序,确保用户能够迅速找到所需功能。精心挑选的配色方案不仅令人眼前一亮,还有助于减少用户疲劳感。同时,交互元素的动画和效果恰到好处,使用户与应用的互动更加流畅自然。无论是初次使用者还是有经验的开发者,都能在Uptime-Kuma的界面中感受到专业与美学的完美融合。这样的精致设计不仅提升了用户的使用体验,还为应用增添了一层视觉的享受。 二、监控多样:广泛支持多种监控类型配置 Uptime-Kuma为您提供了丰富多样的监控类型配置选项,无论您需要监控网络服务的HTTP(s)、TCP、Ping、DNS状态,还是对其他系统指标进行监测,都能轻松实现。您可以根据具体需求,自定义监控任务,并设置阈值以触发警报。这种多元化的监控类型配置,让您能够深入了解应用和系统的运行状况,从而更好地管理和维护。 三、多种通知方式:便捷的警报通知机制 Uptime-Kuma提供丰富的监控配置选择,同时还支持透过Telegram、Discord、Gotify、Slack、Pushover、电子邮件(SMTP)等90多种通知服务进行通知。无论您选择将警报信息通过Webhook传送至其他系统,还是通过电子邮件通知关键人员,甚至将多种通知方式结合使用,您都可以根据需求进行定制。这样多元的通知机制,确保您在关键时刻能够即时获得重要信息,从而迅速采取适当措施,保障系统的稳定性和可靠性。 四、多语言支持:50+种全球主要语言的支持 Uptime Kuma独具特色的功能之一是其覆盖范围广泛的多语言支持,涵盖了50多种全球主要语言。这项功能的重要性在于,用户可以根据自己的母语偏好,进行监控工具的操作和配置。通过消除语言障碍,Uptime Kuma极大地提升了用户界面的易用性和人性化体验,为用户带来了便捷无比的使用过程。这个特性不仅使用户能够更轻松地掌握工具的使用,还确保了他们能够更准确地设置监控,从而最大程度地发挥其功能,提升工作效率。Uptime Kuma 提供了50+种语言的支持,这意味着用户可以使用自己的母语来操作和配置监控工具,极大地提高了用户的易用性和便利性。 安装指南 进入云原生应用商店 搜索Uptime Kuma 进入详情,选择包类型(本应用支持,docker安装,helm安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码