首页 文章 精选 留言 我的

精选列表

搜索[产业分析],共10000篇文章
优秀的个人博客,低调大师

java.lang.System源码分析

1.final修饰,不能被继承。构造函数使用private修饰,不能被其他类实例化 public final class System { ... private System() { } ... } 2.成员变量:final修饰,不能被重新赋值 public final static InputStream in = null;//标准输入流,默认已经打开,一般用来响应键盘或者其他用户指定的输入 public final static PrintStream out = null;//标准输出流,默认已经打开,一般用来展示输出 public final static PrintStream err = null;//标准错误输出流,默认已经打开,按照约定,用来输出错误信息 private static native void setIn0(InputStream in);//初始化这些流的工作由本地native方法实现,由系统连接的共享库去实现 private static native void setOut0(PrintStream out); private static native void setErr0(PrintStream err); private static volatile SecurityManager security = null;//系统安全管理器,使用volatile修饰该变量。在初始化IO流时,需要使用安全器校验权限 private static volatile Console cons = null;// 标准输出控制台 3.SecurityManager,安全管理器,用来做访问权限校验 public staticvoid setSecurityManager(final SecurityManager s) { try { s.checkPackageAccess("java.lang"); } catch (Exception e) { // no-op } setSecurityManager0(s); } private static synchronizedvoid setSecurityManager0(final SecurityManager s) { SecurityManager sm = getSecurityManager(); if (sm != null) { // ask the currently installed security manager if we // can replace it. sm.checkPermission(new RuntimePermission("setSecurityManager")); } if ((s != null) && (s.getClass().getClassLoader() != null)) { // New security manager class is not on bootstrap classpath. // Cause policy to get initialized before we install the new // security manager, in order to prevent infinite loops when // trying to initialize the policy (which usually involves // accessing some security and/or system properties, which in turn // calls the installed security manager's checkPermission method // which will loop infinitely if there is a non-system class // (in this case: the new security manager class) on the stack). AccessController.doPrivileged(new PrivilegedAction<Object>() { public Object run() { s.getClass().getProtectionDomain().implies (SecurityConstants.ALL_PERMISSION); return null; } }); } security = s; } private static void checkIO() { SecurityManager sm = getSecurityManager(); if (sm != null) { sm.checkPermission(new RuntimePermission("setIO")); } } public void checkPermission(Permission perm) { java.security.AccessController.checkPermission(perm); } 4.Console只能用在标准输入、输出流未被重定向的原始控制台中使用 public static Console console() { if (cons == null) { synchronized (System.class) { cons = sun.misc.SharedSecrets.getJavaIOAccess().console();// console是通过sun.misc.SharedSecrets 类获取得到的(作用是从JVM里面获取实例对象) } } return cons; } 5.获取系统时间,都是通过本地native方法实现 public static native long currentTimeMillis();//获取毫秒级的时间戳(1970年1月1日0时起的毫秒数) public static native long nanoTime();//获取纳秒,返回的可能是任意时间(主要用于衡量时间段) 6.数组拷贝 public static native void arraycopy(Object src, int srcPos,Object dest, int destPos,int length); 此方法在Collection的实现类里面扩容的时候经常被遇到,例如 ArrayList.add(int, E)。 还有另外一个比较常用的数组拷贝的方法:Arrays.copyOf,通过看源码会发现,最后实际调用的也是 Syetem.arraycopy 。 public static <T,U> T[] copyOf(U[] original, int newLength, Class<? extends T[]> newType) { @SuppressWarnings("unchecked") T[] copy = ((Object)newType == (Object)Object[].class) ? (T[]) new Object[newLength] : (T[]) Array.newInstance(newType.getComponentType(), newLength); System.arraycopy(original, 0, copy, 0, Math.min(original.length, newLength)); return copy; } 7.获取对象的地址,本地native方法 public static native int identityHashCode(Object x); 当Object的hashCode()被重写的时候,如何获取到对象的地址呢?通过 System.identityHashCode(Object)可以获取到对象的地址。 public class OverrideHashCode { @Override public int hashCode() { //return super.hashCode(); return 0; } } OverrideHashCode overrideHash = new OverrideHashCode(); System.out.println("覆盖之后,hashCode(): " + overrideHash.hashCode()); System.out.println("通过System.identityHashCode()重新获取对象地址: " + System.identityHashCode(overrideHash)); 测试结果: 覆盖之后,hashCode(): 2018699554 //未被重写 通过System.identityHashCode()重新获取对象地址: 2018699554 覆盖之后,hashCode(): 0 //重写后的值 通过System.identityHashCode()重新获取对象地址: 2018699554 8.系统变量 private static Properties props; private static native Properties initProperties(Properties props);//初始化是通过本地方法实现的 public static Properties getProperties() { SecurityManager sm = getSecurityManager(); if (sm != null) {//获取系统变量的时候,需要做权限校验。如果没有权限,会抛出AccessControlException sm.checkPropertiesAccess(); } return props; } public static void setProperties(Properties props) { SecurityManager sm = getSecurityManager(); if (sm != null) { sm.checkPropertiesAccess(); } if (props == null) { props = new Properties(); initProperties(props); } System.props = props; } 9.获取操作系统环境变量,用户自己配置的系统变量,也做了权限校验 public static String getenv(String name) { SecurityManager sm = getSecurityManager(); if (sm != null) { sm.checkPermission(new RuntimePermission("getenv."+name)); } return ProcessEnvironment.getenv(name); } 测试使用: System.out.println(System.getenv("ROCKETMQ_HOME")); 能够获取,之前在Windows中设置的环境变量的值。 10.程序退出,接收一个参数status,0表示正常退出,非零参数表示非正常退出。不管status为何值都会退出程序。和return 相比,return是回到上一层,而System.exit(status)是回到最上层 public static void exit(int status) { Runtime.getRuntime().exit(status);//实际上通过获取Runtime运行时来退出的 } 11.手动调用gc-垃圾回收器,注意调用后不会马上发生消息回收,JVM会在适合的时候触发GC public static void gc() { Runtime.getRuntime().gc(); } 12.加载动态库(Windows下面是dll文件),用来装载库文件,不论是JNI库文件还是非JNI库文件 @CallerSensitive public static void load(String filename) {// fileName一定要是绝对路径,否则会抛出UnsatisfiedLinkError Runtime.getRuntime().load0(Reflection.getCallerClass(), filename); } @CallerSensitive public static void loadLibrary(String libname) { Runtime.getRuntime().loadLibrary0(Reflection.getCallerClass(), libname); } 好了,Syetem的代码就这么多~

优秀的个人博客,低调大师

Java面试技巧和重点分析

一.前言 虽然本人也是刚入行不久,但是之前也做过一些面试准备,刚好7--8月份,还有部分学生或者初入开发行业的潜在同行,正在找工作,所以把自己的感触分享给大家,希望能够帮助到大家,能够顺利的通过面试笔试,进入自己心仪的公司。 二.重点 做为一名应届生或者初入开发行业人员,应该注重基础知识和一些框架工具的使用。 2.1:基础知识是系统原理和算法之类的,对这些原理理解的深度很重要,因为这是一种思维方式,所有的语言底层原理都差不多;一个人的技术上限是由他的基础决定的,在面试官面前展现的基础越扎实给面试官留下的印象更好。 2.2:对框架工具的了解不说是所有的,但是针对目前主流的框架不说了解的很清楚,但是也应该知道一些,比如SSH、SpringBoot、SpringCloud这些框架你需要知道他们的使用和他们核心的实现原理。比如Spring,你要知道 ioc , aop 和他的工厂是怎么实现的吧?这个东西你平时不去深究,你使用再久Spring可能都不知道原理。但是你不去了解先进技术的实现原理你怎么可能研究出新的技术和框架? 2.3:知识的了解不应该只浮于表面,应该有深度和广度。这点在我进入公司工作之前我没有任何认知,但是在进入公司后和领导、同事接触后,深深的发现自己对知识积累点的单薄,可能有的人会说,这些基础的东西这么简单,我早就学会了,平时一直都在写,没必要去专门再学。但是这样的,请问,天天在用String的你,知道它的实现,能理解应用那些设计模式吗? 在面对面试官的时候,你永远不会知道他的下一个问题是什么,所以对知识点的储存,深挖永远都没有错,总结一下就是,打好基础底子,千万不要飘,深入学习,这样你面对面试官的时候,才能有更多的可以聊的话题,从容面对面试官的话题,更快的融入公司。 三.总结 以上我个人看法,并不一定是正确的。每个人的想法都不一样,毕竟自己目前也还是一个菜鸟,希望和大家在学习的道路上共同进步,另外以下是总结的一些面试题目,有兴趣可以看下,谢谢 1、 面向对象的特征有哪些方面?答:面向对象的特征主要有以下几个方面:- 抽象:抽象是将一类对象的共同特征总结出来构造类的过程,包括数据抽象和行为抽象两方面。抽象只关注对象有哪些属性和行为,并不关注这些行为的细节是什么。- 继承:继承是从已有类得到继承信息创建新类的过程。提供继承信息的类被称为父类(超类、基类);得到继承信息的类被称为子类(派生类)。继承让变化中的软件系统有了一定的延续性,同时继承也是封装程序中可变因素的重要手段。- 封装:通常认为封装是把数据和操作数据的方法绑定起来,对数据的访问只能通过已定义的接口。面向对象的本质就是将现实世界描绘成一系列完全自治、封闭的对象。我们在类中编写的方法就是对实现细节的一种封装;我们编写一个类就是对数据和数据操作的封装。可以说,封装就是隐藏一切可隐藏的东西,只向外界提供最简单的编程接口。- 多态性:多态性是指允许不同子类型的对象对同一消息作出不同的响应。简单的说就是用同样的对象引用调用同样的方法但是做了不同的事情。多态性分为编译时的多态性和运行时的多态性。如果将对象的方法视为对象向外界提供的服务,那么运行时的多态性可以解释为:当A系统访问B系统提供的服务时,B系统有多种提供服务的方式,但一切对A系统来说都是透明的。方法重载(overload)实现的是编译时的多态性(也称为前绑定),而方法重写(override)实现的是运行时的多态性(也称为后绑定)。运行时的多态是面向对象最精髓的东西,要实现多态需要做两件事:1). 方法重写(子类继承父类并重写父类中已有的或抽象的方法);2). 对象造型(用父类型引用引用子类型对象,这样同样的引用调用同样的方法就会根据子类对象的不同而表现出不同的行为)。 2、 float f=3.4;是否正确?答:不正确。3.4是双精度数,将双精度型(double)赋值给浮点型(float)属于下转型(down-casting,也称为窄化)会造成精度损失,因此需要强制类型转换float f =(float)3.4; 或者写成float f =3.4F;。 3、 :成员变量与局部变量的区别? 成员变量:有类成员变量(有static修饰)和实例成员变量(无static修饰)两种 局部变量:有代码块局部变量,形参,方法局部变量三种 区别:作用范围不同,成员变量对整个类有效,局部变量只对该方法或代码块有用定义成员变量是可以不初始化,局部变量除了形参之外,必须初始化 4、 Equals与 == 的区别 ==既可以比较基本类型,也可以比较引用类型,比较引用类型时,必须是父子关系 equals只能比较引用类型,比较是地址 5、 接口与抽象类的区别 区别:相同点: 1,都不能实例化 2,都有抽象方法不同点: 1,接口只能定义常量,抽象类既可以定义常量也可以定义变量 2,接口里没有构造器和初始化块,抽象类有构造器和初始化块 3,接口里只有抽象方法,抽象类里有抽象方法和普通方法 4,接口可以实现多个,抽象类的继承只能继承一个 5,接口只能实现接口,不能实现其他类,抽象类即可实现接口,也可继承其他类 6,接口定义用interface,抽象类定义用extends

优秀的个人博客,低调大师

Python数据分析实例操作

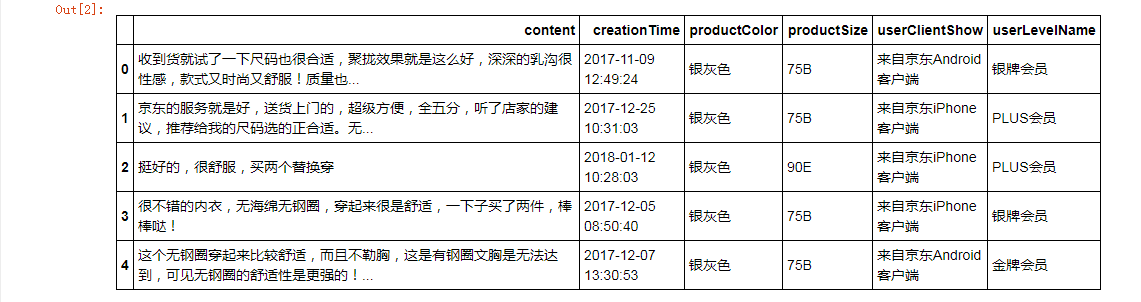
import pandas as pd #导入pandas import matplotlib.pyplot as plt #导入matplotlib from pylab import * mpl.rcParams['font.sans-serif'] = ['SimHei'] mpl.rcParams['axes.unicode_minus'] = False %matplotlib inline 数据读取与索引 bra = pd.read_csv('data/bra.csv') bra.head() 选取列 bra.content bra[['creationTime','productColor']].head() 选择行 bra[1:6] 选择行和列 bra.ix[[2,3],[1,3]] #使用ix bra.ix[1:5,['productColor']] bra.iloc[[2,3],[1,3]] #使用iloc bra.loc[1:5,['content','creationTime','productSize']] #使用loc bra.loc[1:5,'content':'userClientShow'] 数据预处理 缺失值 bra.describe() #查看数据的分布情况,可返回变量和观测的数量、缺失值和唯一值的数目、平均值、分位数等相关信息 bra['userClientShow'].unique() #userClientShow列有几种选项 bra['userClientShow'].isnull().sum() #初始缺失值数量 bra['userClientShow'].fillna('不详',inplace=True) #缺失值替换为“不详” bra['userClientShow'].isnull().sum() #赋值后的缺失值数量 新增列 bra.dtypes #查看属性 bra['creationTime'] = pd.to_datetime(bra['creationTime']) #更新类型 bra.dtypes bra['hour'] = [i.hour for i in bra['creationTime']] #新建hour列 bra 字符串操作 bra.productSize.unique() #查看productSize的唯一值 cup = bra.productSize.str.findall('[a-zA-Z]+').str[0] #新增列cup cup2 = cup.str.replace('M','B') cup3 = cup2.str.replace('L','C') cup4 = cup3.str.replace('XC','D') bra['cup'] = cup4 bra.head() bra['cup'].unique() #查看cup唯一值 数据转换 bra.productColor.unique() #查看productColor唯一值 def getColor(s): if '黑' in s: return '黑色' elif '肤' in s: return '肤色' elif '蓝' in s: return '蓝色' elif '红' in s: return '红色' elif '紫' in s: return '紫色' elif '白' in s: return '白色' elif '粉' in s: return '粉色' elif '灰' in s: return '灰色' elif '绿' in s: return '绿色' elif '青' in s: return '青色' else: return s bra['color'] = bra['productColor'].map(getColor) #从productColor列查询,赋值到定义的函数getColor,最终新增列color bra bra.color.unique() #查询color的唯一值 数据可视化 x = [1991,1992,1993,1994,1995,1996,1997] y = [23,56,38,29,34,56,92] plt.plot(x,y) #调用函数plot plt.figure(figsize=(8,6),dpi=80) #调用函数firgure plt.plot(x,y) hour = bra.groupby('hour')['hour'].count() #hour列排序 hour plt.xlim(0,25) #横轴0~25 plt.plot(hour,linestyle='solid',color='royalblue',marker='8') #颜色深蓝 cup_style = bra.groupby('cup')['cup'].count() #cup列唯一值得数量 cup_style plt.figure(figsize=(8,6),dpi=80) labels = list(cup_style.index) plt.xlabel('cup') #x轴为cup plt.ylabel('count') #y轴为count数量 plt.bar(range(len(labels)),cup_style,color='royalblue',alpha=0.7) #alpha为透明度 plt.xticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='y',alpha=0.6) plt.legend(['user-count']) for x,y in zip(range(len(labels)),cup_style): plt.text(x,y,y,ha='center',va='bottom') color_style = bra.groupby('color')['color'].count() #color列唯一值得数量 color_style plt.figure(figsize=(8,6),dpi=80) plt.subplot(facecolor='gainsboro',alpha=0.2) colors = ['brown','orange','gray','white','pink','purple','red','green','wheat','blue','gold','springgreen','black'] #颜色种类 labels = list(color_style.index) plt.xlabel('count') #x轴为count数量 plt.ylabel('color') #y轴为color plt.title('Color Distribution') #定义标题 plt.barh(range(len(labels)),color_style,color=colors,alpha=1) plt.yticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='x',alpha=0.4) bra.head(30) 知识在于点滴积累

优秀的个人博客,低调大师

技术分享 | Koa框架源码分析

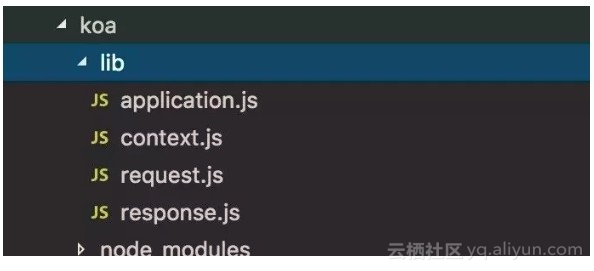
一、Why Koa ? koa 是由 Express 原班人马打造的,致力于成为一个更小、更富有表现力、更健壮的 Web 框架。 使用 koa 编写 web 应用,通过组合不同的 generator,可以免除重复繁琐的回调函数嵌套, 并极大地提升错误处理的效率。koa 不在内核方法中绑定任何中间件, 它仅仅提供了一个轻量优雅的函数库,使得编写 Web 应用变得得心应手。 async await写法,让异步更加优雅。(代码是写给人看的,顺便让机器执行而已) 良好的抽象,简洁的api,简单、吊炸天的中间件机制。 强大的社区,GayHub上数不胜数的中间件。 二、小试牛刀之源码文件一览 npm上download下koa之后打开koa/lib文件夹可以看到四个文件,足以证明koa框架是多么简洁。(不过koa框架依赖了很多node_modules) application.js 入口文件,也是骨架文件,创建一个服务。 context.js app 的 context 对象, 传入中间件的上下文对象。 request.js app 的请求对象,包含请求相关的一些属性。 response.js app 的响应对象,包含响应相关的一些属性。 下面大致总的分为三章节来分享一下koa源码。 1、Hello Koa 首先看一下原生node和koa分别是如何创建一个server。 /** *原生Node创建server */ const http = require('http'); const server = http.createServer((req, res) => { res.statusCode = 200; res.setHeader('Content-Type', 'text/plain'); res.end('Hello World\n'); }); server.listen(3000); /** *koa创建server */ const Koa = require('koa'); const app = new Koa(); app.use(ctx => { ctx.body = 'Hello Koa'; }); app.listen(3000); 看一下源码中koa究竟都做了什么 //1.首先创建了一个Application的类,继承了Emitter类,然后暴露出去。 module.exports = class Application extends Emitter { constructor() { super(); } } //2.类下面有一个listen方法,创建http服务 listen(...args) { debug('listen'); const server = http.createServer(this.callback()); return server.listen(...args); } 在Hello Koa中,引入这个类,然后实例化这个类,在使用下面的listen即搭建起了一个简单的koa服务。 然后讲一下初始化koa的时候,这个类的下面有一个use方法,也就是我们添加中间件的方法。 use(fn) { //如果use里面传的不是方法,直接错误抛出去 if (typeof fn !== 'function') throw new TypeError('middleware must be a function!'); //如果是星号函数,用一个库转成async await方法(去兼容koa1的中间件) if (isGeneratorFunction(fn)) { //如果是generator函数,用convert转成async函数,然后执行。也是就是koa2能支持koa1的中间件。 deprecate('Support for generators will be removed in v3. ' + 'See the documentation for examples of how to convert old middleware ' + 'https://github.com/koajs/koa/blob/master/docs/migration.md'); fn = convert(fn); //转async await方法 } debug('use %s', fn._name || fn.name || '-'); this.middleware.push(fn); //koa把所有的中间件都放在一个数组里面 return this; } 如代码所示,koa把所有的中间件放在一个数组里面,然后koa2也是兼容generator函数,为了兼容koa1的中间件。 callback方法Koa处理请求的方法。 callback() { const fn = compose(this.middleware); //组装中间件 if (!this.listeners('error').length) this.on('error', this.onerror); const handleRequest = (req, res) => { const ctx = this.createContext(req, res); return this.handleRequest(ctx, fn); }; return handleRequest; } 接下来就是看一下callback中compose如何处理了中间价和中间件的执行机制 Koa中间件(middleware)实现探索 首先用一段简单的代码了解一下中间件执行顺序。 const Koa = require('koa') const app = new Koa() app.use(async function m1(ctx, next) { console.log('1') await next(); console.log('1 end') }) app.use(async function m2(ctx, next) { console.log('2') await next(); console.log('2 end') }) app.use(async function m3(ctx, next) { console.log('3') ctx.body = 'Hello World' console.log('3 end') }) app.listen(3000); // 打印的顺序是 // 1、2、3、3end、2end、1end koa通过compose方法把中间件封装成一个promise对象,然后递归执行。使中间件数组变成洋葱圈,能递归线性处理上下文。 下面是官方的配图: 我们主要看一下这个库: function compose (middleware) { return function (context, next) { let index = -1 return dispatch(0) function dispatch (i) { if (i <= index) return Promise.reject(new Error('next() called multiple times')) index = i let fn = middleware[i] if (i === middleware.length) fn = next if (!fn) return Promise.resolve() try { return Promise.resolve(fn(context, dispatch.bind(null, i + 1))); /** dispatch.bind(null, i + 1) 利用了js的bind继承 其实可以写成 function() { dispatch(i + 1) } 一个等待被执行的函数,然后用next()去执行下一个中间件。 */ } catch (err) { return Promise.reject(err) } } } } //通过调用第一个函数,层层递归调用,然后达到洋葱模型 //大白话讲一下就是,compose方法把所有的中间的执行的时候,把第一个中间件封装成了一个psomise对象执行,然后同时在中间件里面写next()方法去递归执行下一个中间件。 这里的 Promise.resolve(fn(..)) 帮助我们异步执行的中间件函数,这里的next函数就解释了为什么Koa的中间件调用是递归执行的,它递归调用了 dispatch 函数来遍历数组中的,同时,所有的中间件函数享有同一个 ctx。 然后我根据compose处理后的中间件,大致中间件执行中理想的样子如图: (async function(){ // middleware1 console.log('1'); await (async function(){ // middleware2 console.log('2'); await ( async function(){ // middleware3 ... console.log('3'); console.log('3 end'); // ...middleware3 }) console.log('2 end') // ...middleware2 }) console.log('1 end'); // ...middleware1 })() 组装成promise的中间件然后赋值到fn上去执行。 fn(ctx).then(handleResponse).catch(onerror)。 来看看这一句,fn 之前说过了,是所有的中间件函数的 “集合”, 用这一个中间件来表示整个处理过程。 同时 fn 也是一个 async 函数,执行结果返回一个 promise 对象, 同时 handleResponse 作为其 resolved 函数,onerror 是 rejected 函数。 也就是说koa中捕捉错误不是用try catch 而且是用promise中的catch。 3、 context的来源 context 使用node原生的 http 的监听回调函数中的 req res 来进行进一步的封装,意味着对于每一个 http 请求,koa都会创建一个 context 并共享给所有的全局中间件使用,当所有的中间件执行完过后,会将最后要返回的所有数据统一再交还给 res 进行返回,所以我们在每一个中间件中才能够从 ctx 中取得自己所需要的 req 中的数据进行处理,最后 ctx 再把要返回的 body 给原生的 res 进行返回。 每一个请求都有唯一一个 context 对象,所有的关于请求和返回的东西都统一放在里面 createContext 方法将 req res 进一步封装。 const context = Object.create(this.context); // 创建一个对象,使之拥有context的原型方法,后面以此类推 const request = context.request = Object.create(this.request); const response = context.response = Object.create(this.response); context.app = request.app = response.app = this; context.req = request.req = response.req = req; context.res = request.res = response.res = res; request.ctx = response.ctx = context; request.response = response; response.request = request; 本着一个请求一个context的原则,context 必须是作为一个临时对象而存在,所有的东西都必须封进一个对象中,因此 app req res 三个属性就此诞生。 三、讲到最后 本文主要围绕“koa2的骨架”、“剖析koa中间件”、“ctx的来源”这三个模块来阐述了koa的原理和实现。并根据思路流程渐进梳理讲解了一些细节思路和比较关键的内容点,以及通过展示部分关键代码讲述了koa中间件的执行原理。文中肯定会有一些不够严谨的思考和错误,欢迎大家指正,有兴趣欢迎一起探讨和改进~ 最后,感谢您的阅读! 原文发布时间为:2018年06月24日 原文作者: 掘金 本文来源: 掘金 如需转载请联系原作者

优秀的个人博客,低调大师

jvm分析工具和查看命令

jinfo 可以输出并修改运行时的java 进程的opts。 jps 与unix上的ps类似,用来显示本地的java进程,可以查看本地运行着几个java程序,并显示他们的进程号。 jstat 一个极强的监视VM内存工具。可以用来监视VM内存内的各种堆和非堆的大小及其内存使用量。 jmap 打印出某个java进程(使用pid)内存内的所有'对象'的情况(如:产生那些对象,及其数量)。 jconsole 一个java GUI监视工具,可以以图表化的形式显示各种数据。并可通过远程连接监视远程的服务器VM。 详细:在使用这些工具前,先用JPS命令获取当前的每个JVM进程号,然后选择要查看的JVM。 jstat工具特别强大,有众多的可选项,详细查看堆内各个部分的使用量,以及加载类的数量。使用时,需加上查看进程的进程id,和所选参数。以下详细介绍各个参数的意义。 jstat -class pid:显示加载class的数量,及所占空间等信息。 jstat -compiler pid:显示VM实时编译的数量等信息。 jstat -gc pid:可以显示gc的信息,查看gc的次数,及时间。其中最后五项,分别是young gc的次数,young gc的时间,full gc的次数,full gc的时间,gc的总时间。 jstat -gccapacity:可以显示,VM内存中三代(young,old,perm)对象的使用和占用大小,如:PGCMN显示的是最小perm的内存使用量,PGCMX显示的是perm的内存最大使用量,PGC是当前新生成的perm内存占用量,PC是但前perm内存占用量。其他的可以根据这个类推, OC是old内纯的占用量。 jstat -gcnew pid:new对象的信息。 jstat -gcnewcapacity pid:new对象的信息及其占用量。 jstat -gcold pid:old对象的信息。 jstat -gcoldcapacity pid:old对象的信息及其占用量。 jstat -gcpermcapacity pid: perm对象的信息及其占用量。 jstat -util pid:统计gc信息统计。 jstat -printcompilation pid:当前VM执行的信息。 除了以上一个参数外,还可以同时加上 两个数字,如:jstat -printcompilation 3024 250 6是每250毫秒打印一次,一共打印6次,还可以加上-h3每三行显示一下标题。 jmap是一个可以输出所有内存中对象的工具,甚至可以将VM 中的heap,以二进制输出成文本。 命令:jmap -dump:format=b,file=heap.bin file:保存路径及文件名 pid:进程编号 •jmap -histo:live pid| less :堆中活动的对象以及大小 •jmap -heap pid : 查看堆的使用状况信息 jinfo:的用处比较简单,就是能输出并修改运行时的java进程的运行参数。用法是jinfo -opt pid 如:查看2788的MaxPerm大小可以用 jinfo -flag MaxPermSize 2788。 jconsole是一个用java写的GUI程序,用来监控VM,并可监控远程的VM,非常易用,而且功能非常强。使用方法:命令行里打 jconsole,选则进程就可以了。 JConsole中关于内存分区的说明。 Eden Space (heap): 内存最初从这个线程池分配给大部分对象。 Survivor Space (heap):用于保存在eden space内存池中经过垃圾回收后没有被回收的对象。 Tenured Generation (heap):用于保持已经在 survivor space内存池中存在了一段时间的对象。 Permanent Generation (non-heap): 保存虚拟机自己的静态(refective)数据,例如类(class)和方法(method)对象。Java虚拟机共享这些类数据。这个区域被分割为只读的和只写的, Code Cache (non-heap):HotSpot Java虚拟机包括一个用于编译和保存本地代码(native code)的内存,叫做“代码缓存区”(code cache) •jstack ( 查看jvm线程运行状态,是否有死锁现象等等信息) : jstack pid : thread dump •jstat -gcutil pid 1000 100 : 1000ms统计一次gc情况统计100次; 另外推荐一款查看jmap dump 的内存对象工具 MemoryAnalyzer 网址:http://www.eclipse.org/mat/,可以查看dump时对象数量,内存占用,线程情况等。 欢迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

GayHub用户及仓库分析爬虫

爬虫介绍 Github 是一个很棒的社区,这里可以找到很多优秀的项目,很多实用的库类,简直是 coder 的天堂,同时也是全球最大的同性交友社区? 爬取的数据主要分为两大类, User 类 和 Repo 类 ,也就是针对用户情况和仓库信息 User 类 先来看看 Github 全站 followers 人数 top10 都是哪些大犇 Linus 大神以压倒性的优势夺得第一名,说实在不知道 Linus 的真不好意思说自己是写代码的,这是信仰。然而大神还是很傲娇的,毕竟没有 following anybody,可能是强到了没朋友了吧,毕竟 talk is cheap, show me the code。JakeWharton 以 34000+ 位于第二,以前也看过一点 Android 的东西,不知道说什么,膜拜吧。 中国区还是有两名种子选手

优秀的个人博客,低调大师

市场分享竞品分析-Android

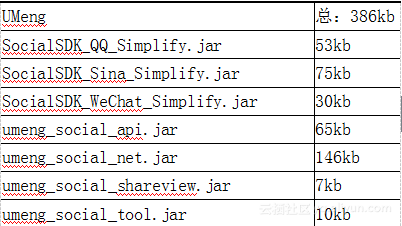
一.SDK大小对比环境说明:1.只集成社交平台 新浪微博,微信好友,QQ;2.均不包含各自的UI库,使用最简单最基础的接口实现分享;3.均新建android工程项目中集成;4.集成方式的对比;对比集成微信好友、QQ好友、微信好友的大小,基础jar包其实是比较大的,后续增加想加的平台几乎就增加几十K左右;UMeng Jar包的大小,编译后apk增加0.15M 从上下两个表格可以看出,Umeng的大小相对于下面的ShareSDK的比较小,但是整体来说都会增加太多;MobShareJar包的大小,编译后apk增加 0.27M 二、集成复杂度1、工具采用studio集成2、集成方式首先是官网注册,这个ShareSDK有流程说明,ShareSDK好些; 重点比较两种SDK的新的集成方式a)集成jar包:ShareSDK更有优势Umeng需要集成jar包,与老的集成方式一样,资源也一样; ShareSDK不需要集成jar包,只需要在gradle文件中配置需要的平台即可 b) 配置SDK及配置第三方:key ShareSDK更有优势Umeng这里可以使用生成工具来生成 (1)生成后需要配置到application中,这里可以配置第三方平台的key; (2)AndroidManifest配置代码生成,生成后可以直接复制配置到清单文件中; ShareSDK集成,只需要在gradle中配置如下即可;(1)配置MobSDK的调用,并且配置平台及keymaven { url "http://mvn.mob.com/android" }dependencies { ... classpath 'com.mob.sdk:MobSDK:+' } (2)ShareSDK不需要在manifest中进行配置 c)分享代码生成调用,友盟更有优势友盟同样可以代码生成器生成来调用,输入内容友盟会自动生成方法,调用即可; ShareSDK,方法调用,如下图所示,也是套用,只需要换个分享对象,和相应方法即可; 集成方式总结:从集成方式,友盟在代码调用和配置都可以使用生成器,但是ShareSDK不需要多余的配置,在集成方式上ShareSDK更有优势 三、其他比较集成文档:集成文档方面,友盟追求过于智能,但是讲解不够详细,ShareSDK的文档比较清晰,还分出了不同的第三方常用平台的说明;ShareSDK更有优势技术论坛:这方面ShareSDK有自己的论坛,并且有常见问题帖子。还有成百上千的用户的问题,如果遇到问题可以先看看有没有人问过,定位问题迅速;客服技术:ShareSDK提供全天的技术支持,不会的问题可以直接通过技术来解决,听说可以聊天聊地聊感情,这个方面友盟确实做的不够好;更新频率:ShareSDK基本是每个月更新一次,SDK更新及时、快,第三方有什么改动,ShareSDK都能及时发出公告并及时更新版本; 从最近半年的更新频率来看,友盟更新的是慢了些; 四、总结对比 Umeng做的主要模块不是分享,从上面的对比项上来看,确实ShareSDK更具优势,特别是技术论坛和技术支持的回复上,这些是独有的优势,有不明白的地方可以直接QQ联系技术支持来解决;当然上述是我的个人见解,欢迎留言来提出对比项,后续我们一起来补充对比说明;

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册