首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Spring 事务提交回滚源码解析

前言 在上篇文章Spring 事务初始化源码分析 中分析了 Spring 事务初始化的一个过程,当初始化完成后,Spring 是如何去获取事务,当目标方法异常后,又是如何进行回滚的,又或是目标方法执行成功后,又是怎么提交的呢?此外,事务的提交和回滚由底层数据库进行控制,而在Spring 事务使用详解中知道,Spring 事务行为可以传播,这个传播方式由 Spring 来进行控制,它是怎么控制的呢?这篇文章就来分析下 Spring 事务提交回滚的源码。 TransactionInterceptor 还记得在Spring 事务初始化源码分析 中注册了一个 bean,名字为TransactionInterceptor 吗?,它就是用来执行事务功能的,它是一个方法拦截器,如下所示: 它实现了 MethodInterceptor 接口,而该接口只有一个 invoke 方法,用来执行目标方法 public Object invoke(MethodInvocation invocation) throws Throwable { Class<?> targetClass = (invocation.getThis() != null ?AopUtils.getTargetClass(invocation.getThis()) : null); // 调用父类的方法 return invokeWithinTransaction(invocation.getMethod(), targetClass, invocation::proceed); } 父类的invokeWithinTransaction 方法定义了一个事务方法执行的框架,而每一步再细分为方法进行实现,代码如下: protected Object invokeWithinTransaction(Method method, Class<?> targetClass, final InvocationCallback invocation){ // 1. 获取事务属性 TransactionAttributeSource tas = getTransactionAttributeSource(); final TransactionAttribute txAttr = (tas != null ? tas.getTransactionAttribute(method, targetClass) : null); // 2. 获取事务管理器 final PlatformTransactionManager tm = determineTransactionManager(txAttr); // 3. 获取需要事务的方法名称:类目.方法名 final String joinpointIdentification = methodIdentification(method, targetClass, txAttr); // 4. 声明式事务 if (txAttr == null || !(tm instanceof CallbackPreferringPlatformTransactionManager)) { // 5. 获取该方法上事务的信息 TransactionInfo txInfo = createTransactionIfNecessary(tm, txAttr, joinpointIdentification); Object retVal = null; try { // 6. 目标方法执行,它是一个拦截器链 retVal = invocation.proceedWithInvocation(); } catch (Throwable ex) { // 7. 事务回滚 completeTransactionAfterThrowing(txInfo, ex); throw ex; } finally { // 8. 清除事务信息 cleanupTransactionInfo(txInfo); } // 9. 事务提交 commitTransactionAfterReturning(txInfo); return retVal; } else { // 10. 编程式事务,流程和声明式事务一致 } } 一个事务方法执行流程大概有以下几个步骤: 1. 获取事务属性 2. 获取事务管理器 3. 获取需要事务的方法名称 5. 获取该方法上事务的信息 6. 目标方法执行 7. 事务回滚 8. 清除事务信息 9. 事务提交 获取事务属性 首先去获取方法上面 Translational 注解的属性,在Spring 事务初始化源码分析中已经分析过了,即在AnnotationTransactionAttributeSource.computeTransactionAttribute 中进行获取。 获取事务管理器 每个事务都由对应的事务管理器,所以在事务开始钱需要获取对应的事务管理器 protected PlatformTransactionManager determineTransactionManager(TransactionAttribute txAttr) { if (txAttr == null || this.beanFactory == null) { return getTransactionManager(); } // 事务管理器名称 String qualifier = txAttr.getQualifier(); if (StringUtils.hasText(qualifier)) { return determineQualifiedTransactionManager(this.beanFactory, qualifier); } else if (StringUtils.hasText(this.transactionManagerBeanName)) { return determineQualifiedTransactionManager(this.beanFactory, this.transactionManagerBeanName); } else { // 默认事务管理器 PlatformTransactionManager defaultTransactionManager = getTransactionManager(); defaultTransactionManager = this.beanFactory.getBean(PlatformTransactionManager.class); // ..... return defaultTransactionManager; } } 获取需要事务的方法名称 这里主要去获取名称的名称,为 全限定类名+方法名的方式:method.getDeclaringClass().getName() + '.' + method.getName(); 获取方法上事务的信息 该部分是 Spring 事务最复杂的部分,比如说去创建一个事务,设置事务的隔离级别,超时时间,对事务传播方式的处理,事务的挂起和恢复等;事务信息 TransactionInfo 包含了目标方法执行前的所有状态信息,如果方法执行失败,则会根据该信息来进行回滚。 对应方法为: TransactionInfo txInfo = createTransactionIfNecessary(tm, txAttr, joinpointIdentification); 代码如下所示: 创建事务 protected TransactionInfo createTransactionIfNecessary(PlatformTransactionManager tm, TransactionAttribute txAttr, final String joinpointIdentification) { // 设置事务的名称,为方法全限定名joinpointIdentification if (txAttr != null && txAttr.getName() == null) { txAttr = new DelegatingTransactionAttribute(txAttr) { public String getName() { return joinpointIdentification; } }; } TransactionStatus status = null; if (txAttr != null) { if (tm != null) { // 获取事务 status = tm.getTransaction(txAttr); } } // 创建事务信息 return prepareTransactionInfo(tm, txAttr, joinpointIdentification, status); } 获取事务 在方法 getTransaction 中获取事务,是最为复杂的逻辑,在其中处理隔离级别,超时时间和传播方式等。 public final TransactionStatus getTransaction(TransactionDefinition definition){ // 获取事务 Object transaction = doGetTransaction(); // ... // 如果已经存在事务了,则处理事务的传播方式,如挂起存在的事务,新建事务等 if (isExistingTransaction(transaction)) { return handleExistingTransaction(definition, transaction, debugEnabled); } // ..... // 如果不存在事务,且事务的传播方式为 mandatory, 则抛出异常 if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_MANDATORY) { throw new IllegalTransactionStateException("...."); } else if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_REQUIRED || definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_REQUIRES_NEW || definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_NESTED) { SuspendedResourcesHolder suspendedResources = suspend(null); // 如果事务的传播方式为 requested, requestes_new,nested,则会新建一个事务 try { boolean newSynchronization = (getTransactionSynchronization() != SYNCHRONIZATION_NEVER); // 第三个参数为true表示新建事务 DefaultTransactionStatus status = newTransactionStatus(definition, transaction, true, newSynchronization, debugEnabled, suspendedResources); // 构造 transaction,包括隔离级别,timeout,如果是新连接,则绑定到当前线程 doBegin(transaction, definition); // 同步新事务 prepareSynchronization(status, definition); return status; } catch (RuntimeException | Error ex) { resume(null, suspendedResources); throw ex; } } else { boolean newSynchronization = (getTransactionSynchronization() == SYNCHRONIZATION_ALWAYS); return prepareTransactionStatus(definition, null, true, newSynchronization, debugEnabled, null); } } 获取事务doGetTransaction(),在该方法中,会根据 DataSource 获取一个连接,如下: protected Object doGetTransaction() { DataSourceTransactionObject txObject = new DataSourceTransactionObject(); //如果设置了允许嵌套事务,则开启保存点;只有嵌套事务才有保存点 txObject.setSavepointAllowed(isNestedTransactionAllowed()); // 根据 DataSource 获取连接,ConnectionHolder为一个数据库连接 ConnectionHolder conHolder = TransactionSynchronizationManager.getResource(obtainDataSource()); txObject.setConnectionHolder(conHolder, false); return txObject; } 之后,判断当前线程是否存在事务,如果存在事务,则根据事务的传播方式来处理已存在的事务,这里先不看。 如果不存在事务且事务的传播方式为 requested, requestes_new,nested,则会新建一个事务: DefaultTransactionStatus status = newTransactionStatus(definition, transaction, true, newSynchronization, debugEnabled, suspendedResources); //definition事务属性 //transaction事务 //newTransaction是否事务新事务 //suspendedResources需要挂起的事务 protected DefaultTransactionStatus newTransactionStatus( TransactionDefinition definition, Object transaction, boolean newTransaction, boolean newSynchronization, boolean debug, Object suspendedResources) { boolean actualNewSynchronization = newSynchronization && !TransactionSynchronizationManager.isSynchronizationActive(); return new DefaultTransactionStatus( transaction, newTransaction, actualNewSynchronization, definition.isReadOnly(), debug, suspendedResources); } 当获取到一个新的事务后,需要设置事务的一些信息,比如隔离级别,timeout 等,这些功能不是由 Spring 来控制,而是由底层的数据库来控制的,数据库连接的设置是在 doBegin 方法中进行处理: protected void doBegin(Object transaction, TransactionDefinition definition) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction; // 数据库连接 Connection con = null; //如果当前事务不存在数据库连接,或者,当前连接的事务同步设置为 true,则需要获取新的数据库连接 if (!txObject.hasConnectionHolder() || txObject.getConnectionHolder().isSynchronizedWithTransaction()) { // 获取新连接 Connection newCon = obtainDataSource().getConnection(); // 事务绑定新连接 txObject.setConnectionHolder(new ConnectionHolder(newCon), true); } txObject.getConnectionHolder().setSynchronizedWithTransaction(true); con = txObject.getConnectionHolder().getConnection(); // 获取和设置隔离级别 Integer previousIsolationLevel = DataSourceUtils.prepareConnectionForTransaction(con, definition); txObject.setPreviousIsolationLevel(previousIsolationLevel); // 由 Spring 来控制提交方式 if (con.getAutoCommit()) { txObject.setMustRestoreAutoCommit(true); con.setAutoCommit(false); } prepareTransactionalConnection(con, definition); // 设置当前线程存在事务的标志 txObject.getConnectionHolder().setTransactionActive(true); // 获取和设置超时时间 int timeout = determineTimeout(definition); if (timeout != TransactionDefinition.TIMEOUT_DEFAULT) { txObject.getConnectionHolder().setTimeoutInSeconds(timeout); } //如果是新连接,则绑定到当前线程 if (txObject.isNewConnectionHolder()) { TransactionSynchronizationManager.bindResource(obtainDataSource(), txObject.getConnectionHolder()); } //其他代码...... } // ====获取隔离级别 public static Integer prepareConnectionForTransaction(Connection con, TransactionDefinition definition){ // 设置只读标识 if (definition != null && definition.isReadOnly()) { con.setReadOnly(true); //.... } // 获取隔离级别 Integer previousIsolationLevel = null; if (definition != null && definition.getIsolationLevel() != TransactionDefinition.ISOLATION_DEFAULT) { // 从数据库连接获取隔离级别 int currentIsolation = con.getTransactionIsolation(); if (currentIsolation != definition.getIsolationLevel()) { previousIsolationLevel = currentIsolation; con.setTransactionIsolation(definition.getIsolationLevel()); } } return previousIsolationLevel; } 当设置完事务的信息后,需要把事务信息记录在当前线程中: protected void prepareSynchronization(DefaultTransactionStatus status, TransactionDefinition definition) { if (status.isNewSynchronization()) { TransactionSynchronizationManager.setActualTransactionActive(status.hasTransaction()); TransactionSynchronizationManager.setCurrentTransactionIsolationLevel( definition.getIsolationLevel() != TransactionDefinition.ISOLATION_DEFAULT ? definition.getIsolationLevel() : null); TransactionSynchronizationManager.setCurrentTransactionReadOnly(definition.isReadOnly()); TransactionSynchronizationManager.setCurrentTransactionName(definition.getName()); TransactionSynchronizationManager.initSynchronization(); } } 现在来处理已经存在事务的情况, if (isExistingTransaction(transaction)) { return handleExistingTransaction(definition, transaction, debugEnabled); } 判断是否存在事务,依据是事务中有连接,且TransactionActive 为 true protected boolean isExistingTransaction(Object transaction) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction; return (txObject.hasConnectionHolder() && txObject.getConnectionHolder().isTransactionActive()); } 如果已经存在事务,则会根据事务的传播方式来进行处理,比如 requires_new, nested 等是如何处理: private TransactionStatus handleExistingTransaction(TransactionDefinition definition, Object transaction){ // 如果传播方式为 never, 则抛异常 if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_NEVER) { throw new IllegalTransactionStateException("..."); } // 如果传播方式为 not_supported, 则把当前存在的事务挂起 if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_NOT_SUPPORTED) { // 挂起当前事务 Object suspendedResources = suspend(transaction); boolean newSynchronization = (getTransactionSynchronization() == SYNCHRONIZATION_ALWAYS); return prepareTransactionStatus(definition, null, false, newSynchronization, debugEnabled, suspendedResources); } // 如果传播方式为 requires_new, 则挂起当前事务,新建一个新事务 if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_REQUIRES_NEW) { // 挂起当前事务 SuspendedResourcesHolder suspendedResources = suspend(transaction); // 如果还没有激活事务,则新建事务 boolean newSynchronization = (getTransactionSynchronization() != SYNCHRONIZATION_NEVER); DefaultTransactionStatus status = newTransactionStatus(definition, transaction, true, newSynchronization, debugEnabled, suspendedResources); // 设置数据库的隔离级别,timeout等 doBegin(transaction, definition); prepareSynchronization(status, definition); return status; //.... } // 如果传播方式为 nested,则新建事务,但是不会把存在的事务挂起,它是一个子事务 if (definition.getPropagationBehavior() == TransactionDefinition.PROPAGATION_NESTED) { // 如果不支持嵌套事务,抛异常 if (!isNestedTransactionAllowed()) { throw new NestedTransactionNotSupportedException(""); } // 如果支持保存点,则创建保存点 if (useSavepointForNestedTransaction()) { DefaultTransactionStatus status = prepareTransactionStatus(definition, transaction, false, false, debugEnabled, null); // 创建保存点 status.createAndHoldSavepoint(); return status; } else { // 如果不支持保存点,则和 requires_new 是一样的 boolean newSynchronization = (getTransactionSynchronization() != SYNCHRONIZATION_NEVER); DefaultTransactionStatus status = newTransactionStatus(definition, transaction, true, newSynchronization, debugEnabled, null); doBegin(transaction, definition); prepareSynchronization(status, definition); return status; } } // 如果传播方式为 supports和required boolean newSynchronization = (getTransactionSynchronization() != SYNCHRONIZATION_NEVER); return prepareTransactionStatus(definition, transaction, false, newSynchronization, debugEnabled, null); } 挂起事务,就是把当前事务的状态记录下来,后续在对该事务进行恢复。 protected final SuspendedResourcesHolder suspend(@Nullable Object transaction) throws TransactionException { if (TransactionSynchronizationManager.isSynchronizationActive()) { List<TransactionSynchronization> suspendedSynchronizations = doSuspendSynchronization(); Object suspendedResources = null; if (transaction != null) { suspendedResources = doSuspend(transaction); } String name = TransactionSynchronizationManager.getCurrentTransactionName(); TransactionSynchronizationManager.setCurrentTransactionName(null); boolean readOnly = TransactionSynchronizationManager.isCurrentTransactionReadOnly(); TransactionSynchronizationManager.setCurrentTransactionReadOnly(false); Integer isolationLevel = TransactionSynchronizationManager.getCurrentTransactionIsolationLevel(); TransactionSynchronizationManager.setCurrentTransactionIsolationLevel(null); boolean wasActive = TransactionSynchronizationManager.isActualTransactionActive(); TransactionSynchronizationManager.setActualTransactionActive(false); return new SuspendedResourcesHolder(suspendedResources, suspendedSynchronizations, name, readOnly, isolationLevel, wasActive); } //..... } // 挂起事务doSuspend protected Object doSuspend(Object transaction) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction; // 把事务的连接置空 txObject.setConnectionHolder(null); // 从当前线程中移除 return TransactionSynchronizationManager.unbindResource(obtainDataSource()); } 当经过上面一系列操作获取到事务信息后,再根据事务信息来封装到 TransactionInfo 中: protected TransactionInfo prepareTransactionInfo(PlatformTransactionManager tm, TransactionAttribute txAttr, String joinpointIdentification, TransactionStatus status) { // 封装事务信息 TransactionInfo txInfo = new TransactionInfo(tm, txAttr, joinpointIdentification); if (txAttr != null) { // 设置事务状态 txInfo.newTransactionStatus(status); } } 事务回滚 到这里,目标方法执行之前的事务准备工作都已做好了,之后,会调用InvocationCallback.proceedWithInvocation 来执行目标方法,如果执行失败,则会进行事务的回滚操作: protected void completeTransactionAfterThrowing(TransactionInfo txInfo, Throwable ex) { if (txInfo != null && txInfo.getTransactionStatus() != null) { // 判断异常是不是 RunntimeException 和 Error if (txInfo.transactionAttribute != null && txInfo.transactionAttribute.rollbackOn(ex)) { // 回滚事务 txInfo.getTransactionManager().rollback(txInfo.getTransactionStatus()); // ......... } else { // 如果是其他类型的异常,则正常提交 txInfo.getTransactionManager().commit(txInfo.getTransactionStatus()); // ....... } } } //判断是否回滚的异常,当前可以通过rolbackFor属性来修改 public boolean rollbackOn(Throwable ex) { return (ex instanceof RuntimeException || ex instanceof Error); } 回滚事务 public final void rollback(TransactionStatus status){ // 如果事务已完成,则回滚会抛异常 if (status.isCompleted()) { throw new IllegalTransactionStateException("...."); } DefaultTransactionStatus defStatus = (DefaultTransactionStatus) status; processRollback(defStatus, false); } // 回滚事务 private void processRollback(DefaultTransactionStatus status, boolean unexpected) { try { boolean unexpectedRollback = unexpected; // 自定义触发器的调用,不知道干嘛用??? triggerBeforeCompletion(status); // 如果有保存点,则回滚到保存点 if (status.hasSavepoint()) { status.rollbackToHeldSavepoint(); } else if (status.isNewTransaction()) { // 如果当前事务为独立的事务,则回滚 doRollback(status); } else { // 如果一个事务中又有事务,如 required,该事务可以看作一个事务链, //那么当其中的一个事务需要回滚的时候,并不是立马进行回滚, //而是只是设置回滚状态,到最后再统一回滚 if (status.hasTransaction()) { if (status.isLocalRollbackOnly() || isGlobalRollbackOnParticipationFailure()) { // 只是设置回滚状态 doSetRollbackOnly(status); } } //....... } //.......... }finally { // 清空记录并恢复被挂起的事务 cleanupAfterCompletion(status); } } 事务的回滚操作,如果是嵌套事务,且有保存点的话,直接回滚到保存点,嵌套事务的回滚不会影响到外部事务,也就是说,外部事务不会回滚。回滚到保存点是根据底层数据库来操作的: public void rollbackToHeldSavepoint() throws TransactionException { Object savepoint = getSavepoint(); // 回滚到保存点 getSavepointManager().rollbackToSavepoint(savepoint); // 释放保存点 getSavepointManager().releaseSavepoint(savepoint); setSavepoint(null); } // 回滚到保存点 public void rollbackToSavepoint(Object savepoint) throws TransactionException { ConnectionHolder conHolder = getConnectionHolderForSavepoint(); conHolder.getConnection().rollback((Savepoint) savepoint); conHolder.resetRollbackOnly(); // ...... } // 释放保存点 public void releaseSavepoint(Object savepoint) throws TransactionException { ConnectionHolder conHolder = getConnectionHolderForSavepoint(); conHolder.getConnection().releaseSavepoint((Savepoint) savepoint); } 如果没有保存点,则直接回滚,也是使用数据库的API 来操作的: protected void doRollback(DefaultTransactionStatus status) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) status.getTransaction(); Connection con = txObject.getConnectionHolder().getConnection(); con.rollback(); } 还有一种情况,如果一个事务中又有事务,如 required, 该事务可以看作一个事务链,那么当其中的一个事务需要回滚的时候,并不是立马进行回滚,而是只是设置回滚状态,到最后再统一回滚。 事务回滚后需要对事务信息进行清除: private void cleanupAfterCompletion(DefaultTransactionStatus status) { // 设置完成状态 status.setCompleted(); if (status.isNewSynchronization()) { TransactionSynchronizationManager.clear(); } if (status.isNewTransaction()) { // 清除事务信息 doCleanupAfterCompletion(status.getTransaction()); } if (status.getSuspendedResources() != null) { // 恢复被挂起的事务 Object transaction = (status.hasTransaction() ? status.getTransaction() : null); resume(transaction, (SuspendedResourcesHolder) status.getSuspendedResources()); } } 清除事务信息: protected void doCleanupAfterCompletion(Object transaction) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction; // 从当前线程中移除数据库连接 if (txObject.isNewConnectionHolder()) { TransactionSynchronizationManager.unbindResource(obtainDataSource()); } //重置数据库连接 Connection con = txObject.getConnectionHolder().getConnection(); if (txObject.isMustRestoreAutoCommit()) { con.setAutoCommit(true); } DataSourceUtils.resetConnectionAfterTransaction(con, txObject.getPreviousIsolationLevel()); // 如果是新连接,则释放连接 if (txObject.isNewConnectionHolder()) { DataSourceUtils.releaseConnection(con, this.dataSource); } txObject.getConnectionHolder().clear(); } 恢复被挂起的事务: protected final void resume(Object transaction, SuspendedResourcesHolder resourcesHolder){ if (resourcesHolder != null) { Object suspendedResources = resourcesHolder.suspendedResources; if (suspendedResources != null) { doResume(transaction, suspendedResources); } List<TransactionSynchronization> suspendedSynchronizations = resourcesHolder.suspendedSynchronizations; if (suspendedSynchronizations != null) { TransactionSynchronizationManager.setActualTransactionActive(resourcesHolder.wasActive); TransactionSynchronizationManager.setCurrentTransactionIsolationLevel(resourcesHolder.isolationLevel); TransactionSynchronizationManager.setCurrentTransactionReadOnly(resourcesHolder.readOnly); TransactionSynchronizationManager.setCurrentTransactionName(resourcesHolder.name); doResumeSynchronization(suspendedSynchronizations); } } } // 恢复事务,把事务和当前线程绑定 protected void doResume(Object transaction, Object suspendedResources) { TransactionSynchronizationManager.bindResource(obtainDataSource(), suspendedResources); } 事务提交 当目标方法执行成功,没有抛出异常,则事务可以正常提交了;但是再上面分析事务回滚的时候,还有一种情况没有分析,就是如果一个事务嵌套再一个事务里面,是一个事务链,如果其中的某个事务需要回滚,它并不会真正的立马进行回滚,而是设置一个回滚标识,由最外层的事务来统一进行回滚;所以再提交事务之前,还需要进行判断。 public final void commit(TransactionStatus status) throws TransactionException { // 如果事务已完成,则不能提交 if (status.isCompleted()) { throw new IllegalTransactionStateException("..."); } // 判断嵌套事务是否设置了回滚标识,如果嵌套事务设置了回滚标识,则整个事务链都不会提交 DefaultTransactionStatus defStatus = (DefaultTransactionStatus) status; if (defStatus.isLocalRollbackOnly()) { processRollback(defStatus, false); return; } if (!shouldCommitOnGlobalRollbackOnly() && defStatus.isGlobalRollbackOnly()) { processRollback(defStatus, true); return; } // 提交事务 processCommit(defStatus); } 提交事务: private void processCommit(DefaultTransactionStatus status) throws TransactionException { try { //..... // 如果由保存点则释放保存点 if (status.hasSavepoint()) { unexpectedRollback = status.isGlobalRollbackOnly(); status.releaseHeldSavepoint(); } else if (status.isNewTransaction()) { unexpectedRollback = status.isGlobalRollbackOnly(); // 提交 doCommit(status); } } catch (RuntimeException | Error ex) { // 如果提交过程中出现异常,则还是会回滚 doRollbackOnCommitException(status, ex); throw ex; } // ......... } // 数据库连接进行回滚 protected void doCommit(DefaultTransactionStatus status) { DataSourceTransactionObject txObject = (DataSourceTransactionObject) status.getTransaction(); Connection con = txObject.getConnectionHolder().getConnection(); con.commit(); } 到这里,Spring 事务的获取,提交,回滚去分析完毕了,流程还是比较清除的 可以关注本人公众号查看更多文章:Java技术大杂烩


优秀的个人博客,低调大师

深入解析 Flutter 初始化流程

在调研 Flutter 动态化方案的时候,需要了解 Flutter 加载 dart 产物的流程,于是梳理了一遍 FLutter 的初始化流程 flutter的源码下载地址在 github 上可以找到,具体地址:github-flutter/engine FLutterMain的初始化 先从 Android 的入口开始看 在FlutterAppliation的onCreate中调用了 FlutterMain.startInitialization(this); 跟进去我们会看到调用了startInitialization方法,最后会顺序调用这几个方法 initConfig(applicationContext); initAot(applicationContext); initResources(applicationContext); 我们查看initResources方法如图 这里我们可以看到实际加载了assets里面的flutter资源。并且会把资源 copy 到本地的�路径。这里不做深究。FlutterMan的初始化基本包括了 初始化配置 初始化 AOT 编译 初始化资源 3 个部分 继续看 �Flutter的View的初始化: FLutterView的初始化 以FlutterActivity为例,在onCreate中会调用到FlutterActivityDelegate的对应方法,最终调用FlutterView的runFromBundle方法 public void runFromBundle(FlutterRunArguments args) { this.assertAttached(); this.preRun(); this.mNativeView.runFromBundle(args); this.postRun(); } 跟踪这段代码,会调用FlutterNativeView的nativeRunBundleAndSnapshotFromLibrary方法。 这里会继续进行 �jni层的调用,�查看platform_view_android_jni.cc { .name = "nativeRunBundleAndSnapshotFromLibrary", .signature = "(J[Ljava/lang/String; Ljava/lang/String;" "Ljava/lang/String;Landroid/content/res/AssetManager;)V", .fnPtr = reinterpret_cast<void*> (shell::RunBundleAndSnapshotFromLibrary), }, 查看RunBundleAndSnapshotFromLibrary,这里删除了一些我们不关心的逻辑 static void RunBundleAndSnapshotFromLibrary(JNIEnv* env, jobject jcaller, jlong shell_holder, jobjectArray jbundlepaths, jstring jEntrypoint, jstring jLibraryUrl, jobject jAssetManager) { auto asset_manager = std::make_shared<blink::AssetManager>(); for (const auto& bundlepath : fml::jni::StringArrayToVector(env, jbundlepaths)) { const auto file_ext_index = bundlepath.rfind("."); if (bundlepath.substr(file_ext_index) == ".zip") { asset_manager->PushBack( std::make_unique<blink::ZipAssetStore>(bundlepath)); } else { asset_manager->PushBack( std::make_unique<blink::DirectoryAssetBundle>(fml::OpenDirectory( bundlepath.c_str(), false, fml::FilePermission::kRead))); const auto last_slash_index = bundlepath.rfind("/", bundlepath.size()); if (last_slash_index != std::string::npos) { auto apk_asset_dir = bundlepath.substr( last_slash_index + 1, bundlepath.size() - last_slash_index); asset_manager->PushBack(std::make_unique<blink::APKAssetProvider>( env, // jni environment jAssetManager, // asset manager std::move(apk_asset_dir)) // apk asset dir ); } } } auto isolate_configuration = CreateIsolateConfiguration(*asset_manager); RunConfiguration config(std::move(isolate_configuration), std::move(asset_manager)); ANDROID_SHELL_HOLDER->Launch(std::move(config)); 首先会对资源路径进行处理 会�分为zip包或者文件夹进行分别处理。最终会调用常量ANDROID_SHELL_HOLDER的Launch函数. 最终走到engine的Run函数。 这里有 2 个函数比较重要,先是IsolateConfiguration::PrepareIsolate, 然后是RunFromLibrary或者Run函数 跟到PrepareAndLaunchIsolate函数,查看源码 bool IsolateConfiguration::PrepareIsolate(blink::DartIsolate& isolate) { if (isolate.GetPhase() != blink::DartIsolate::Phase::LibrariesSetup) { FML_DLOG(ERROR) << "Isolate was in incorrect phase to be prepared for running."; return false; } return DoPrepareIsolate(isolate); } 而有DoPrepareIsolate函数的类Configuration类有3个 AppSnapshotIsolateConfiguration KernelIsolateConfiguration KernelListIsolateConfiguration 他们分别会调用DartIsolate的 PrepareForRunningFromPrecompiledCode PrepareForRunningFromKernel 这2个方法的一个,可以�看到这里的prepare操作分成了预先加载的代码和从内核获取2种 至于RunFromLibrary函数和Run函数 我们能看到�他们最终都会调用dart:isolate和_startMainIsolate的逻辑: Dart_Handle isolate_lib = Dart_LookupLibrary(tonic::ToDart("dart:isolate")); if (tonic::LogIfError(Dart_Invoke( isolate_lib, tonic::ToDart("_startMainIsolate"), sizeof(isolate_args) / sizeof(isolate_args[0]), isolate_args))) { return false; } 这里说明我们正在执行调用Dart的入口方法。而Run和RunFromLibrary的区别,则是如果我们传入了entrypoint参数去进行 Flutter 的 bundle 初始化的时候,则会去加载我们制定的 library。 小结 到这里, Flutter 的初始化流程就就简单的分析了一遍。大致可以总结成三个部分 初始化 FlutterMain 初始化 FlutterView,开始加载 bundle 初始化Flutter Bundle,这里获取了 Flutter 的入口方法、Flutter 的 library, 以及对 Flutter 入口方法的调用。 初始化的逻辑比较复杂,对后续一些初始化相关的性能优化应该也会有不小的启发。FlutterMain中对资源的处理和写入本地的逻辑也给 Android 端研究 Flutter 动态化提供了基础。 有需要Android进阶全面系统视频资料的可以加入Android进阶交流群;701740775。免费获取 加群请备注csdn领取进阶资料

优秀的个人博客,低调大师

解析JQuery中each方法的使用

each() 方法规定为每个匹配元素规定运行的函数。写的十分的全面细致,具有一定的参考价值,对此有需要的朋友可以参考学习下。如有不足之处,欢迎批评指正。 概述: each() 方法规定为每个匹配元素规定运行的函数。 返回 false 可用于及早停止循环,相当于break。 返回 true 可以结束本次循环,相当于continue。 语法: $(selector).each(function(index,element){ }) index - 选择器的 index 位置 element - 当前的元素(也可使用 "this" 选择器) $(selector).each(function(){ }) $.each(array,function(Key,Value){ }) 1.遍历js数组 $(function(){ var array=["aaa","bbb","ccc"]; $.each(array,function(i,j){ alert(i+":"+j); //i表示索引,j代表值 }); }) 2.遍历Object对象 var obj = new Object(); obj.name="zs"; $.each(obj, function(name, value) { alert(this); //this指向当前属性的值,等价于value alert(name); //name表示Object当前属性的名称 alert(value); //value表示Object当前属性的值 });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 3.遍历JSON对象 var json ={"name":"zhangSan","role":"student"}; $.each(json,function(key,value){ alert(key+":"+value); }); 4.遍历由多个JSON对象组成的数组 var json =[{"name":"Amy","role":"student"},{"name":"Tom","role":"student"}]; $.each(json, function(index, value) { alert("index="+index+"\n" +"name:"+value.name+"\n"+"role:"+value.role+"\n"); });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 5.遍历jQuery对象 <head> <meta charset="utf-8" /> <title>遍历jQuery对象</title> <script src="js/jquery-1.12.4.js"></script> <script type="text/javascript"> $(function(){ $("input[type='button']").bind("click",function(){ $("li").each(function(){ alert($(this).text()) }); }); }); </script> </head> <body> <input type="button" value="触发事件"/> <ul> <li>first</li> <li>second</li> </ul> </body>//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

Redission分布式锁源码解析

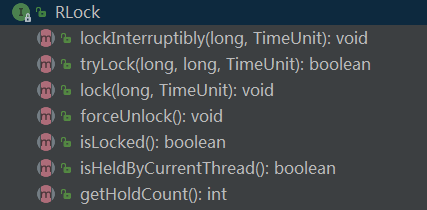
Redission锁继承Implements Reentrant Lock,所以具备 Reentrant Lock 锁中的一些特性:超时,重试,可中断等。加上Redission中Redis具备分布式的特性,所以非常适合用来做Java中的分布式锁。 下面我们对其加锁、解锁过程中的源码细节进行一一分析。 锁的接口定义了一下方法: 分布式锁当中加锁,我们常用的加锁接口: booleantryLock(longwaitTime,longleaseTime,TimeUnitunit)throwsInterruptedException; 下面我们来看一下方法的具体实现: publicbooleantryLock(longwaitTime,longleaseTime,TimeUnitunit)throwsInterruptedException{ longtime=unit.toMillis(waitTime); longcurrent=System.currentTimeMillis(); finallongthreadId=Thread.currentThread().getId(); Longttl=tryAcquire(leaseTime,unit,threadId); //lockacquired if(ttl==null){ returntrue; } time-=(System.currentTimeMillis()-current); if(time<=0){ acquireFailed(threadId); returnfalse; } current=System.currentTimeMillis(); finalRFuturesubscribeFuture=subscribe(threadId); if(!await(subscribeFuture,time,TimeUnit.MILLISECONDS)){ if(!subscribeFuture.cancel(false)){ subscribeFuture.addListener(newFutureListener(){ @Override publicvoidoperationComplete(Futurefuture)throwsException{ if(subscribeFuture.isSuccess()){ unsubscribe(subscribeFuture,threadId); } } }); } acquireFailed(threadId); returnfalse; } try{ time-=(System.currentTimeMillis()-current); if(time<=0){ acquireFailed(threadId); returnfalse; } while(true){ longcurrentTime=System.currentTimeMillis(); ttl=tryAcquire(leaseTime,unit,threadId); //lockacquired if(ttl==null){ returntrue; } time-=(System.currentTimeMillis()-currentTime); if(time=0&&ttl<time){ getEntry(threadId).getLatch().tryAcquire(ttl,TimeUnit.MILLISECONDS); }else{ getEntry(threadId).getLatch().tryAcquire(time,TimeUnit.MILLISECONDS); } time-=(System.currentTimeMillis()-currentTime); if(time<=0){ acquireFailed(threadId); returnfalse; } } }finally{ unsubscribe(subscribeFuture,threadId); } //returnget(tryLockAsync(waitTime,leaseTime,unit)); } 首先我们看到调用tryAcquire尝试获取锁,在这里是否能获取到锁,是根据锁名称的过期时间TTL来判定的(TTL 下面我们接着看一下tryAcquire的实现: privateLongtryAcquire(longleaseTime,TimeUnitunit,longthreadId){ returnget(tryAcquireAsync(leaseTime,unit,threadId)); } 可以看到真正获取锁的操作经过一层get操作里面执行的,这里为何要这么操作,本人也不是太理解,如有理解错误,欢迎指正。 get是由CommandAsyncExecutor(一个线程Executor)封装的一个Executor 设置一个单线程的同步控制器CountDownLatch,用于控制单个线程的中断信息。个人理解经过中间的这么一步:主要是为了支持线程可中断操作。 publicVget(RFuturefuture){ if(!future.isDone()){ finalCountDownLatchl=newCountDownLatch(1); future.addListener(newFutureListener(){ @Override publicvoidoperationComplete(Futurefuture)throwsException{ l.countDown(); } }); booleaninterrupted=false; while(!future.isDone()){ try{ l.await(); }catch(InterruptedExceptione){ interrupted=true; } } if(interrupted){ Thread.currentThread().interrupt(); } } //commentedoutduetoblockingissuesupto200msperminuteforeachthread:由于每个线程的阻塞问题,每分钟高达200毫秒 //future.awaitUninterruptibly(); if(future.isSuccess()){ returnfuture.getNow(); } throwconvertException(future); } 我们进一步往下看: privateRFuturetryAcquireAsync(longleaseTime,TimeUnitunit,finallongthreadId){ if(leaseTime!=-1){ returntryLockInnerAsync(leaseTime,unit,threadId,RedisCommands.EVAL_LONG); } RFuturettlRemainingFuture=tryLockInnerAsync(commandExecutor.getConnectionManager().getCfg().getLockWatchdogTimeout(),TimeUnit.MILLISECONDS,threadId,RedisCommands.EVAL_LONG); ttlRemainingFuture.addListener(newFutureListener(){ @Override publicvoidoperationComplete(Futurefuture)throwsException{ if(!future.isSuccess()){ return; } LongttlRemaining=future.getNow(); //lockacquired if(ttlRemaining==null){ scheduleExpirationRenewal(threadId); } } }); returnttlRemainingFuture; } 首先判断锁是否有超时时间,有过期时间的话,会在后面获取锁的时候设置进去。没有过期时间的话,则会用默认的 privatelonglockWatchdogTimeout=30*1000; 下面我们在进一步往下分析真正获取锁的操作: RFuturetryLockInnerAsync(longleaseTime,TimeUnitunit,longthreadId,RedisStrictCommandcommand){ internalLockLeaseTime=unit.toMillis(leaseTime); returncommandExecutor.evalWriteAsync(getName(),LongCodec.INSTANCE,command, "if(redis.call('exists',KEYS[1])==0)then"+ "redis.call('hset',KEYS[1],ARGV[2],1);"+ "redis.call('pexpire',KEYS[1],ARGV[1]);"+ "returnnil;"+ "end;"+ "if(redis.call('hexists',KEYS[1],ARGV[2])==1)then"+ "redis.call('hincrby',KEYS[1],ARGV[2],1);"+ "redis.call('pexpire',KEYS[1],ARGV[1]);"+ "returnnil;"+ "end;"+ "returnredis.call('pttl',KEYS[1]);", Collections.singletonList(getName()),internalLockLeaseTime,getLockName(threadId)); } 我把里面的重点信息做了以下三点总结: 1:真正执行的是一段具有原子性的Lua脚本,并且最终也是由CommandAsynExecutor去执行。 2:锁真正持久化到Redis时,用的hash类型key field value 3:获取锁的三个参数:getName()是逻辑锁名称,例如:分布式锁要锁住的methodName+params;internalLockLeaseTime是毫秒单位的锁过期时间;getLockName则是锁对应的线程级别的名称,因为支持相同线程可重入,不同线程不可重入,所以这里的锁的生成方式是:UUID+":"threadId。有的同学可能会问,这样不是很缜密:不同的JVM可能会生成相同的threadId,所以Redission这里加了一个区分度很高的UUID; Lua脚本中的执行分为以下三步: 1:exists检查redis中是否存在锁名称;如果不存在,则获取成功;同时把逻辑锁名称KEYS[1],线程级别的锁名称[ARGV[2],value=1,设置到redis。并设置逻辑锁名称的过期时间ARGV[2],返回; 2:如果检查到存在KEYS[1],[ARGV[2],则说明获取成功,此时会自增对应的value值,记录重入次数;并更新锁的过期时间 3:key不存,直接返回key的剩余过期时间(-2) 相关推荐:https://www.roncoo.com/course/list.html?courseName=redis

优秀的个人博客,低调大师

Linux进程关闭和后台运行解析

摘要: 在Linux中,通过信号,关闭进程,通过忽略信号,并把进程挂载到init进程下,保证进程可以后台运行 1.问题背景 Java是跨平台的,大部分程序也都是在Linux服务器上运行的。但是很多朋友其实对服务器了解并不多,对相关知识也是一知半解。很多概念可能知道,但是并不十分清楚,仅仅是基本运用。可能很多新手朋友脱离了IDE或者web容器,都不知道怎么在服务器上运行程序。 举个简单的例子,相信很多朋友刚接触Linux的时候都遇到过这个问题。我们通过终端连接上服务器,通过命令行或者脚本运行了一个程序,然后关闭了终端连接,可能程序进程就消失了。我们也可能知道,在启动命令后面加&符号,可以进程在后台运行,关闭终端后,进程依然会消失,但如果通过shell脚本去运行,关闭终端连接后,程序可能不会消失。或者我们又知道可以通过nohup命令让进程在后台运行,并且关闭连接后,程序不会消失,到底为什么呢? 下面我会用比较通俗的语言进行讲解,如果有错误,欢迎指正。 2.进程关闭分析 当我们连接到服务器以后,运行的命令,启动的程序,设置的环境变量,都会挂在当前的连接中(非特殊设置或者特殊命令),当连接关闭时,所有东西都会消失。 进程的关闭,是通过信号进行传递的。我们通过kill命令发送不同的信号,去关闭指定的进程, 当我们关闭终端连接时,会向当前终端连接的下游进程发送SIGHUP信号(就是kill -1),触发进程关闭动作。 我们可以通过ps -fe|grep XXX查询进程信息。 [work~]$ps-fe|grepTest work3113330981020:09pts/400:00:00javaTest work3127723065020:09pts/100:00:00grep--colorTest 前三个分别对应 uid / pid(进程id) / ppid(父进程id),ppid其实就是当前终端连接的进程id。如果kill -9 ppid,当前终端连接就断了。 有时候我们执行一个命令,程序会在一直在运行,我们可以通过ctrl+c,发送的SIGINT信号(就是kill -2),中断程序。也可以通过ctrl+z,发送SIGTSTP信号,挂起进程,通过jobs命令查看,通过fg命令调起。 在linux中,通过命令行方式运行,属于交互模式。通过脚本方式运行属于非交互模式。 在非交互模式下,shell会对后台进程设置SIGINT信号忽略。 所以我们采用交互模式,也就是命令行方式运行java xxx &,后台运行一个进程(在当前的终端连接下后台运行),关闭终端连接时,进程会关闭。而通过shell脚本的方式,执行java xxx &命令,关闭连接时,java进程会把父进程id,切换挂在到init进程下(父进程id为1),也就是真正的后台运行了。 nohup命令会忽略SIGHUP信号,因此通过nohup java xxx &的方式运行,不论采用交互模式或者非交互模式运行,在终端连接关闭时,都会挂到init进程下。 《Linux 技巧:让进程在后台可靠运行的几种方法》文中提到了三种后台运行的命令nohup/setsid/(xxx &),后两个命令可以直接把进程挂在init进程下,也可以通过disown命令把进程设置忽略SIGHUP信号 3.总结 在Linux中,通过信号,关闭进程,通过忽略信号,并把进程挂载到init进程下,保证进程可以后台运行。

优秀的个人博客,低调大师

深入解析React props和state属性

本文主要介绍了React props和state属性的具体使用方法,小编觉得挺不错的,现在分享给大家,也给大家做个参考。一起跟随小编过来看看吧 props 不知道大家还记不记得xml标签中的属性,就像这样: <class id="1"> <student id="1">John Kindem</student> <student id="2">Alick Ice</student> </class> 这样一个xml文件表达的意思是1班有两个学生,学号为1的学生名字为John Kindem,学号为2的学生名字为Alick Ice,其中id就是属性,你可以把它看做一个常量,它是只读的。 html继承自xml,而JSX从莫种意义上又是html和js的扩展,属性的概念自然得到了传承。 在React中,我们使用props这一概念向React组件传递只读的值,就像这样: // 假设我们已经自定义了一个叫Hello的组件 ReactDom.render( <Hello firstName={'John'} lastName={'Kindem'}/>, document.getElementById('root') ); 在调用React组件的时候,我们可以像上面一样向组件传递一些常量,以便组件在内部调用。而调用的方法,就像下面这样: class Hello extends React.Component { constructor(props) { super(props); } render() { return ( <div> <h1>Hello, {this.props.firstName + ' ' + this.props.lastName}</h1> </div> );//欢迎加入全栈开发交流圈一起学习交流:864305860 }//面向1-3年前端人员 }//帮助突破技术瓶颈,提升思维能力 ReactDom.render( <Hello firstName={'John'} lastName={'Kindem'}/>, document.getElementById('root') ); 在组件内部获取传递过来的props,只需要使用this.props对象即可,但是在使用之前,记得复写组件的构造函数,并且接受props的值以调用父类构造。 当然,props也能够设置默认值,向下面这样: class Hello extends React.Component { constructor(props) { super(props); } static defaultProps = { firstName: 'John', lastName: 'Kindem' }; render() { return ( <div> <h1>Hello, {this.props.firstName + ' ' + this.props.lastName}</h1> </div> );//欢迎加入全栈开发交流圈一起学习交流:864305860 }//面向1-3年前端人员 } //帮助突破技术瓶颈,提升思维能力 ReactDom.render( <Hello/>, document.getElementById('root') ); 只需在ES6类中声明一个static的props默认值即可,运行效果和上面一样。 props没有多复杂,稍微练习即可习得。 state、组件生命周期 你可能回想,如果我想在React组件中添加动态效果怎么办?目前学过的知识好像无法解决这一问题。 这一问题需要使用React组件的state来解决,state即状态的意思,在React中,所有会变化的控制变量都应该放入state,每当state中的内容变化时,页面的相应组件将会被重新渲染,另外,state完全是组件内部的东西,外部无法向内部传递state,也无法直接改变state的值。 先来举一个例子: import React from 'react'; import ReactDom from 'react-dom'; class Time extends React.Component { constructor(props) { super(props); // 初始化state this.state = { hour: 0, minute: 0, second: 0 } } componentDidMount() { this.interval = setInterval(() => this.tick(), 1000); } componentWillUnmount() { clearInterval(this.interval); } tick() { // 计算新时间 let newSecond, newMinute, newHour; let carryMinute = 0, carryHour = 0; newSecond = this.state.second + 1; if (newSecond > 59) { carryMinute = 1; newSecond -= 60; } newMinute = this.state.minute + carryMinute; if (newMinute > 59) { carryHour = 1; newMinute -= 60; } newHour = this.state.hour + carryHour; if (newHour > 59) newHour -= 60; // 设置新状态 this.setState({ hour: newHour, minute: newMinute, second: newSecond }); } render() { return ( <div> <h1>current time: {this.state.hour + ':' + this.state.minute + ':' + this.state.second}</h1> </div> );//欢迎加入全栈开发交流圈一起学习交流:864305860 }//面向1-3年前端人员 } //帮助突破技术瓶颈,提升思维能力 ReactDom.render( <Time/>, document.getElementById('root') ); 这样就完成了一个计数器,数值一秒钟变化一次,来讲解一下代码:首先,state的初始化是在构造函数中,像这样: constructor(props) { super(props); // 在这初始化state this.state = { ...//欢迎加入全栈开发交流圈一起学习交流:864305860 }//面向1-3年前端人员 }//帮助突破技术瓶颈,提升思维能力 而改变state是使用React组件基类中的一个自带函数: this.setState({ ... }); 使用这个函数之前一定要注意this的作用域,箭头函数中的this指向外部this,而普通函数中的this指向函数本身。 另外,这里使用到了两个React组件的生命周期回调: componentDidMount() { // React组件被加载到dom中的时候被调用 ... } componentWillUnmount() { // React组件从dom中卸载的时候被调用 ... } 所以这样一下上面的计时器代码应该就不是什么难事了,在React组件被加载到dom中的时候设置一个计时器,每秒钟更新一次state,state更新的同时页面中的组件将会被重新渲染,而当组件被卸载的时候,则需要清除定时器,就那么简单。 不过React对于state的更新频率,有一个最大的限度,超过这个限度则会导致页面渲染的性能下降,大家需要注意不要在高频函数中使用setState。 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

Java多线程——AtomicLong LongAdder源码解析

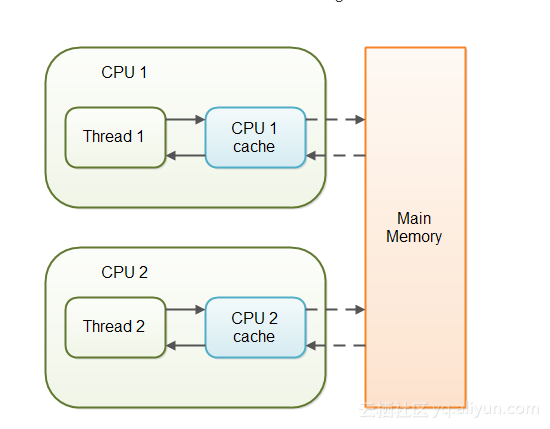
首先强调:Unsafe在JDK9开始被完全禁用了,所以不建议人为使用。 我们知道在多线程环境下,要使用一个线程安全的计数器,大家首先会想到AtomicLong(AtomicInteger),它的核心是利用volatile来修饰value使得对变量的修改对所有线程可见,同时使用Unsafe提供的多种基于底层硬件指令的配合进行compareAndSwap(CAS)操作,达到lock-free的线程安全,提高并发性能。这里的无锁指的是没有重同步锁synchronized,而使用轻量的自旋锁。实际上,在JDK不断对同步锁进行优化之后,如果线程冲突非常频繁,CAS反而不如synchronized,因为自旋实质上没有阻塞线程,长时间自旋是对资源的浪费。 如果要产生自增长序列,那么AtomicLong是非常好的方法,但是如果是一个计数器不需要每次增加都返回当前值,那么LongAdder是一个更好的选择。 volatile volatile这个关键字的作用有两个: (1)禁止进行指令重排序 指令重排的例子如下,在不影响执行结果的前提下,编译器会调整语句顺序来对指令码进行优化,isLoad = true这个语句从方法内的角度考虑,放在头部和尾部不影响,但是对于整个程序来说是有问题的,可能线程A修改了状态但还未读取context时,线程B开始初始化而此时context为null,导致抛出异常。如果以volatile来修改变量isLoad,那么isLoad出现的语句都不会被重排,就不会出现这个问题。 public class VolatileTest { private boolean isLoad = false; private Object context = null; private void readContext() { isLoad = true;//模拟指令重排 System.out.println("正在读取配置"); context = new Object(); //isLoad = true;指令重排前 } private void initContext() { if (isLoad) { System.out.println("正在初始化"); context.toString(); } else { System.out.println("未读取配置"); } } public static void main(String args[]) { VolatileTest test = new VolatileTest(); Thread t1=new Thread(new Runnable() { @Override public void run() { test.readContext(); } },"t1"); Thread t2=new Thread(new Runnable() { @Override public void run() { while (true){ if(test.isLoad){ test.initContext(); break; } } } },"t2"); t1.start(); t2.start(); } } (2)保证了不同线程对这个变量进行操作时的可见性,即一个线程修改了某个变量的值,这新值对其他线程来说是立即可见的。 为了提高运行效率,线程在操作主线程的变量时,会将变量的副本拷贝一份到线程的工作区域,避免每次到主线程读取,在更改后的一段时间内写入主内存,所以经常会出现线程不同步的问题。 比如主线程变量a=0,线程A执行一次a++操作,线程B循环判断a==1则执行操作,实际结果可能是这个操作不会开始,因为线程B去主线程取到的副本a=0,在判断时由于a已经存在于线程缓存中不会再去主线程取更新后的a=1,导致条件始终不成立。如果用volatile修饰了变量a,则线程A更新完成后,会将a=1立即复制回主内存,并且删除所有线程缓存中a的副本,线程B发现本地缓存中没有a的值,于是去主从中去a=1,此时条件成立。 但是volatile不能保证原子性。经典案例就是a++问题,即使变量a有volatile修饰,线程A和B分别执行a++,依然有可能输出1和2。原因是a=a+1获取a变量时它可能是0也可能是1。 AtomicLong 因为AtomicLong里面很多方法都是基于Unsafe提供的JNI方法,所以下面对于方法的分析会直接带入分析。从OpenJDK里面可以找到jdk/src/share/classes/sun/misc/Unsafe.java,和hotspot/src/share/vm/prims/unsafe.cpp,以及文末贴出的libjava版本。 先列一下AtomicLong里面用到的Unsafe方法,实际上这里的Long也有Object或者Integer版本: compareAndSwapLong getAndAddLong getAndSetLong putOrderedLong 构造函数与内部变量与静态块 可以看到在类加载时,需要获取Unsafe的实例,检查JVM是否支持无锁的long型CAS操作,获取类中value字段的偏移量。构造函数可以指定初始值也可以默认为0。value值用volatile变量修饰。 private static final long serialVersionUID = 1927816293512124184L; // setup to use Unsafe.compareAndSwapLong for updates private static final Unsafe unsafe = Unsafe.getUnsafe(); private static final long valueOffset; /** * 记录下层JVM是否支持无锁的long型CAS操作。当Unsafe.compareAndSwapLong在某个情况下工作, * 一些构造器需要在Java层面处理来避免锁住用于可见的锁。 */ static final boolean VM_SUPPORTS_LONG_CAS = VMSupportsCS8(); /** * 返回下层JVM是否支持无锁的long型CAS操作。只调用一次并缓存在VM_SUPPORTS_LONG_CAS。 */ private static native boolean VMSupportsCS8(); static { try { valueOffset = unsafe.objectFieldOffset (AtomicLong.class.getDeclaredField("value"));//获取类中value字段的位置 } catch (Exception ex) { throw new Error(ex); } } private volatile long value; /** * 创建一个AtomicLong指定初始值 */ public AtomicLong(long initialValue) { value = initialValue; } /** * 创建一个AtomicLong初始值为0 */ public AtomicLong() { } get与set get与set是直接获取与更新value值 public final long get() { return value; } public final void set(long newValue) { value = newValue; } 而getAndSet原子性设定为给出值并且返回旧值 public final long getAndSet(long newValue) { return unsafe.getAndSetLong(this, valueOffset, newValue); } /** * 原子性地将指定对象和偏移量位置的字段或数组元素的当前值替换为指定值并返回旧值 * * @param o object/array to update the field/element in * @param offset field/element offset * @param newValue new value * @return the previous value * @since 1.8 */ public final long getAndSetLong(Object o, long offset, long newValue) { long v; do { v = getLongVolatile(o, offset); } while (!compareAndSwapLong(o, offset, v, newValue));//自旋重复尝试更新值 return v; } /** * 如果当前值是expected,原子性地更新为x,成功的话返回true */ public final native boolean compareAndSwapLong(Object o, long offset, long expected, long x); public native long getLongVolatile(Object o, long offset); 先看compareAndSwap这个方法的实现,给出OpenJDK和libjava两种版本。libjava应当是对应不使用CPU指令的这种情况。 UNSAFE_ENTRY(jboolean, Unsafe_CompareAndSwapLong(JNIEnv *env, jobject unsafe, jobject obj, jlong offset, jlong e, jlong x)) UnsafeWrapper("Unsafe_CompareAndSwapLong"); Handle p (THREAD, JNIHandles::resolve(obj)); jlong* addr = (jlong*)(index_oop_from_field_offset_long(p(), offset)); if (VM_Version::supports_cx8())//如果底层支持,直接使用CPU指令 return (jlong)(Atomic::cmpxchg(x, addr, e)) == e;//CPU指令LOCK CMPXCHG else {//不支持则依靠JVM实现 jboolean success = false; ObjectLocker ol(p, THREAD); if (*addr == e) { *addr = x; success = true; } return success; } UNSAFE_END // Use a spinlock for multi-word accesses class spinlock { static volatile obj_addr_t lock; public: spinlock () { while (! compare_and_swap (&lock, 0, 1)) _Jv_ThreadYield ();//有线程占用锁则yield当前线程 } ~spinlock () { release_set (&lock, 0);//析构时释放锁 } }; static inline bool compareAndSwap (volatile jint *addr, jint old, jint new_val) { jboolean result = false;//操作是否成功 spinlock lock;//自旋锁竞争操作权限 if ((result = (*addr == old)))//如果当前值为old,result=true *addr = new_val;//更新值 return result; } getLongVolatile也根据硬件是否支持原子性IRIW即读即写操作分为两种 #define GET_FIELD_VOLATILE(obj, offset, type_name, v) \ oop p = JNIHandles::resolve(obj); \ if (support_IRIW_for_not_multiple_copy_atomic_cpu) { \ OrderAccess::fence(); \ } \ volatile type_name v = OrderAccess::load_acquire((volatile type_name*)index_oop_from_field_offset_long(p, offset)); UNSAFE_ENTRY(jlong, Unsafe_GetLongVolatile(JNIEnv *env, jobject unsafe, jobject obj, jlong offset)) UnsafeWrapper("Unsafe_GetLongVolatile"); { if (VM_Version::supports_cx8()) { GET_FIELD_VOLATILE(obj, offset, jlong, v);//直接通过指令读取 return v; } else { Handle p (THREAD, JNIHandles::resolve(obj)); jlong* addr = (jlong*)(index_oop_from_field_offset_long(p(), offset)); ObjectLocker ol(p, THREAD);//自旋 jlong value = *addr;//从内存获取值 return value; } } UNSAFE_END jlong sun::misc::Unsafe::getLongVolatile (jobject obj, jlong offset) { volatile jlong *addr = (jlong *) ((char *) obj + offset); spinlock lock; return *addr; } 另一个方法compareAndSet如果当前value==expect,则原子性的更新value为update,返回是否操作成功,同样借助了unsafe.compareAndSwapLong。但前面方法是强制更新,这个要比较预期值。 public final boolean compareAndSet(long expect, long update) { return unsafe.compareAndSwapLong(this, valueOffset, expect, update); } lazySet lazySet是使用Unsafe.putOrderedObject方法,这个方法在对低延迟代码是很有用的,它能够实现非堵塞的写入,这些写入不会被Java的JIT重新排序指令(instruction reordering),这样它使用快速的存储-存储(store-store) barrier, 而不是较慢的存储-加载(store-load) barrier, 后者总是用在volatile的写操作上,这种性能提升是有代价的,写后结果并不会立即被其他线程甚至是自己的线程看到,通常是几纳秒后被其他线程看到,这个时间比较短,所以代价可以忍受。 public final void lazySet(long newValue) { unsafe.putOrderedLong(this, valueOffset, newValue); } /** Ordered/Lazy version of {@link #putLongVolatile(Object, long, long)} */ public native void putOrderedLong(Object o, long offset, long x); 下面是native方法的实现,因为OpenJDK版本异常复杂,可以看下面libjava版本的。关于spinlock lock这段,个人理解是自旋等待其他线程结束占用,然后修改内存中value的值。相比直接修改value,延后了删除其他线程中的缓存这一步。 #define SET_FIELD_VOLATILE(obj, offset, type_name, x) \ oop p = JNIHandles::resolve(obj); \ OrderAccess::release_store_fence((volatile type_name*)index_oop_from_field_offset_long(p, offset), x); UNSAFE_ENTRY(void, Unsafe_SetOrderedLong(JNIEnv *env, jobject unsafe, jobject obj, jlong offset, jlong x)) UnsafeWrapper("Unsafe_SetOrderedLong"); #ifdef SUPPORTS_NATIVE_CX8 SET_FIELD_VOLATILE(obj, offset, jlong, x); #else // Keep old code for platforms which may not have atomic long (8 bytes) instructions { if (VM_Version::supports_cx8()) { SET_FIELD_VOLATILE(obj, offset, jlong, x);//指令设置 } else { Handle p (THREAD, JNIHandles::resolve(obj)); jlong* addr = (jlong*)(index_oop_from_field_offset_long(p(), offset)); ObjectLocker ol(p, THREAD); *addr = x; } } #endif UNSAFE_END void sun::misc::Unsafe::putOrderedLong (jobject obj, jlong offset, jlong value) { volatile jlong *addr = (jlong *) ((char *) obj + offset);//计算value字段地址 spinlock lock;//自旋 *addr = value;//设置值 } getAndAdd和addAndGet 下面几个方法本质上都是一个意思,原子性的增减当前值,返回新值或者旧值。全部都是基于Unsafe.getAndAddLong,实现方法是循环尝试compareAndSwapLong,如果因为有其他线程更新而失败则getLongVolatile重新获取当前值。 /** * 原子性的将当前值增加1,返回旧值 */ public final long getAndIncrement() { return unsafe.getAndAddLong(this, valueOffset, 1L); } /** * 原子性的将当前值减少1,返回旧值 */ public final long getAndDecrement() { return unsafe.getAndAddLong(this, valueOffset, -1L); } /** * 原子性的将当前值增加delta,返回旧值 */ public final long getAndAdd(long delta) { return unsafe.getAndAddLong(this, valueOffset, delta); } /** * 原子性的将当前值减少delta,返回旧值 */ public final long incrementAndGet() { return unsafe.getAndAddLong(this, valueOffset, 1L) + 1L; } /** * 原子性的将当前值减少delta,返回新值 */ public final long decrementAndGet() { return unsafe.getAndAddLong(this, valueOffset, -1L) - 1L; } /** * 原子性的将当前值增加delta,返回新值 */ public final long addAndGet(long delta) { return unsafe.getAndAddLong(this, valueOffset, delta) + delta; } //Unsafe.getAndAddLong原子性的增加delta到字段或者数组元素的当前值,返回旧值 public final long getAndAddLong(Object o, long offset, long delta) { long v; do { v = getLongVolatile(o, offset); } while (!compareAndSwapLong(o, offset, v, v + delta)); return v; } 下面这段引自桐人姥爷的公众号文章:特别留意到 Jdk1.7 中 unsafe 使用的方法是 compareAndSwapLong,它与 x86 CPU 上的 LOCK CMPXCHG 指令对应,并且在应用层使用 while(true) 完成自旋,这个细节在 Jdk1.8 中发生了变化。Jdk1.7 的 CAS 操作已经不复存在了,转而使用了 getAndAddLong 方法,它与 x86 CPU 上的 LOCK XADD 指令对应,以原子方式返回当前值并递增(fetch and add)。 public final long getAndIncrement() {//JDK1.7 while (true) { long current = get(); long next = current + 1; if (compareAndSet(current, next)) return current; } } public final boolean compareAndSet(long expect, long update) { return unsafe.compareAndSwapLong(this, valueOffset, expect, update); } 但是,从我上面对源码的分析,似乎跟上段有出入,依然是基于循环compareAndSwapLong来实现。为此,我特地求证了公众号原文作者,他的回复是:JDK版本的差异,高版本的JDK8确实是已经修改了unsafe.getAndAddLong的底层实现。 LongAdder 前面提到AtomicLong在线程碰撞不频繁时效率较高,但是如果线程碰撞频繁,长时间的自旋会浪费大量资源。对于一个计数器来说,绝大部分情况下并不关心当前值是多少,只要少量按需get即可。所以,引入了LongAdder。 LongAdder在JDK1.8新增加,继承的是Striped64,这个类是Number的子类,用于表示64位的动态条带。 Striped64内部含有一个cells数组,用于存储线程使用的计数器。并且Striped64在构造时是不会初始化数组的。Cell是一个线程间共享的计数器。 /** * AtomicLong的填补变体,只支持通过CAS访问 * JVM内联函数注意事项:如果提供了的话可能只使用一个release-only的CAS版本 */ @sun.misc.Contended static final class Cell { volatile long value;//内部实际值 Cell(long x) { value = x; } final boolean cas(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, valueOffset, cmp, val);//通过compareAndSwapLong替换value值从cmp为val } // Unsafe mechanics private static final sun.misc.Unsafe UNSAFE; private static final long valueOffset; static { try { UNSAFE = sun.misc.Unsafe.getUnsafe(); Class<?> ak = Cell.class; valueOffset = UNSAFE.objectFieldOffset (ak.getDeclaredField("value")); } catch (Exception e) { throw new Error(e); } } } /** CPU的数量用来设置表大小的范围 */ static final int NCPU = Runtime.getRuntime().availableProcessors(); /** * 存储格表。非null时大小是2的指数 */ transient volatile Cell[] cells; /** * 基础值,主要用于没有竞争的时候,但也作为表舒适化竞争时的返回值。通过CAS更新。 */ transient volatile long base; /** * 在resize和创建cells时使用的自旋锁(用CAS加锁) */ transient volatile int cellsBusy; 结合来看LongAdder的add方法,因为Striped64构造时cells是null,会先尝试CAS修改base值,cells初始化后一般不会使用base,仅在做resize操作期间有可能。前一步都失败了,则尝试从cells数组中获取当前线程对应的cell并通过CAS修改。cell未初始化或者修改没能成功,则进入Striped64.longAccumulate。注意,cell的选择是根据ThreadLocalRandom产生的随机数选择的。 public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) {//优先使用cells,cells未初始化时尝试cas修改base boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = a.cas(v = a.value, v + x)))//尝试cas修改线程对应的cell longAccumulate(x, null, uncontended);//产生冲突时尝试在cells中新增cell } } /** * CAS修改base值 */ final boolean casBase(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, BASE, cmp, val); } /** * 返回当前线程的探针值。从ThreadLocalRandom复制,因为有包限制,它们两个不在同一个包中。 */ static final int getProbe() { return UNSAFE.getInt(Thread.currentThread(), PROBE); } 来看一这个方法longAccumulate,代码比较长。大致上进行的顺序是: cells没有初始化则先竞争锁然后进行初始化 已有cells表则检查有无剩余空间,不足时竞争锁后进行resize扩容,但最大不能超过CPU总数,因为同一时间不可能有超过CPU总数的线程在运行。 表空间足够则竞争锁后新建一个Cell实例,并加入表中后返回 如果需要初始化或者resize时,会尝试CAS修改base final void longAccumulate(long x, LongBinaryOperator fn, boolean wasUncontended) { int h; if ((h = getProbe()) == 0) { ThreadLocalRandom.current(); // force initialization强制初始化 h = getProbe(); wasUncontended = true; } boolean collide = false; // True if last slot nonempty上一个位置非空时为true for (;;) { Cell[] as; Cell a; int n; long v; if ((as = cells) != null && (n = as.length) > 0) { if ((a = as[(n - 1) & h]) == null) {//最后一个位置为null if (cellsBusy == 0) { // Try to attach new Cell尝试关联新的cell Cell r = new Cell(x); // Optimistically create乐观创建 if (cellsBusy == 0 && casCellsBusy()) {//竞争锁 boolean created = false; try { // Recheck under lock在锁下再次检查 Cell[] rs; int m, j; if ((rs = cells) != null && (m = rs.length) > 0 && rs[j = (m - 1) & h] == null) { rs[j] = r; created = true;//新建成功 } } finally { cellsBusy = 0;//释放锁 } if (created) break; continue; // Slot is now non-empty这个位置现在不是空的 } } collide = false; } else if (!wasUncontended) // CAS already known to fail已知CAS失败 wasUncontended = true; // Continue after rehash rehash后继续 else if (a.cas(v = a.value, ((fn == null) ? v + x : fn.applyAsLong(v, x)))) break;//尝试cas更新cell的value值 else if (n >= NCPU || cells != as) collide = false; // At max size or stale到达了最大大小或者过时了 else if (!collide) collide = true; else if (cellsBusy == 0 && casCellsBusy()) {//竞争锁 try { if (cells == as) { // Expand table unless stale表没过时的话扩展它 Cell[] rs = new Cell[n << 1];//大小乘以2 for (int i = 0; i < n; ++i) rs[i] = as[i]; cells = rs; } } finally { cellsBusy = 0;//释放锁 } collide = false; continue; // Retry with expanded table用扩展后的表重试 } h = advanceProbe(h); } else if (cellsBusy == 0 && cells == as && casCellsBusy()) { boolean init = false; try { // Initialize table初始化表 if (cells == as) { Cell[] rs = new Cell[2];//表初始大小为2 rs[h & 1] = new Cell(x); cells = rs; init = true; } } finally { cellsBusy = 0; } if (init) break; } else if (casBase(v = base, ((fn == null) ? v + x : fn.applyAsLong(v, x))))//在初始化和resize过程中会进入这个判断 break; // Fall back on using base使用base返回 } } increment和decrement都是基于add完成的。不做赘述。 sum返回当前总数。返回值不是一个原子快照。在没有进行并发更新时调用获取的是准确值,但是在计算总数时进行并发更新可能不会包括当前增加值。sum的过程是取当前的base和cells,计算它们的总和。这种惰性求值的思想,在 ConcurrentHashMap 中的 size() 中也存在。因此LongAdder高效之处就在于,它让不同线程同时去操作不同的计数器,避免线程碰撞而长时间自旋。然后采用惰性求和的方式返回一个不完全准确的当前值,对于网站访问计数器这样的场景非常合适 public long sum() { Cell[] as = cells; Cell a; long sum = base; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) sum += a.value; } } return sum; } 参考资料 Java并发计数器探秘 [gcc-5.2.0/libjava/sun/misc/natUnsafe.cc](

优秀的个人博客,低调大师

Java多线程——Thread Runnable源码解析

Java多线程的两种实现方法大家都应该知道了:继承Thread的子类实例化和实现Runnable接口用这个接口实现类去创建Thread实例。 Java的线程在Linux平台上使用的是NPTL机制,JVM线程跟内核轻量线程(LWP)一一对应。KLT是内核线程,它提供轻量进程给程序使用,调度由操作系统内核完成,所以Java程序无法在多个线程就绪状态下预测哪个线程会获得CPU调度。 在JVM的内存分配中线程私有的部分是栈(包括Java栈和本地方法栈)和程序计数器,线程可以访问共有的Java堆和常量池、方法区(这个视虚拟机实现而定,JVM1.8里永久代被移除)。 Java线程的状态有以下这些: public enum State { NEW,//声明一个线程还没有开始 RUNNABLE,//声明一个可运行的线程。一个线程在可运行状态下在Java虚拟机中执行,但它可能在等待操作系统中的其他资源比如处理器 BLOCKED,//声明一个线程阻塞等待一个监视器锁。它需要等待监控器锁来进入一个同步的块/方法或者在调用Object.wait后重新进入一个同步的块/方法 WAITING,//声明一个等待线程。一个线程在等待状态因为调用了以下方法:Object.wait没有超时时间;Thread.join没有超时时间;LockSupport.park。一个线程在等待状态是在等待其他线程执行一个特定的行为。比如,一个线程调用Object.wait(),是在等待另一个线程对它调用Object.notify或者Object.notifyAll()。一个线程调用Thread.join()是在等待这个线程终止。 TIMED_WAITING,//线程处于限时等待状态,因为它调用了以下方法带有正数等待时间:Thread.sleep;Object.wait带有超时时间;Thread.join带有超时时间;LockSupport.parkNanos;LockSupport.parkUntil TERMINATED;//线程执行完毕,进入结束状态 } 跟系统的三状态模型相比:就绪、运行、阻塞,这是可以对应上的 Runnable Runnable是一个函数式接口@FunctionalInterface,它的实例可以通过lamda表达式,方法引用,构造器引用来创建。所谓函数式接口,该注解只能标记在"有且仅有一个抽象方法"的接口上。抽象方法是指接口中声明的方法,不包括加static关键字的静态方法和加default关键字的默认方法,也不包括重写java.lang.Object中的方法。该注解可以不加,但是如果加了编译器会对类进行检查,如果不符合要求会编译失败。 因为Runnable是一个接口,所以可以利用一个类可以实现多个接口的特点来更加灵活的构造。 Runnable接口应该被所有计划实例通过线程执行的类实现。类必须定义一个没有参数的 run方法。 此接口旨在为那些希望在它们活动时执行代码的对象提供一个通用的协议。例如,Runnable被Thread类实现。活动的意思是说一个线程已启动并且尚未停止。 此外,Runnable给不是Thread子类的类提供一个活动的手段。一个类可以通过实现Runnable,将自己传递给实例一个Thread对象的实例化来运行。在大多数情况下,Runnable接口应该是用于你只打算重写run()方法并没有重写其他Thread方法。这是重要的因为除非程序员打算修改或增强类的基本行为,否则类不应该作为子类。 ——以上是关于Runnable的Javadoc说明内容 总结一下:在不需要对Thread方法进行修改或扩展的情况下,使用Runnable接口较好,并且可以利用实现多接口的方法增大灵活性,实现类在实例化之后传给Thread构造函数然后运行。 Thread Thread是在程序中执行的一个线程。java虚拟机允许应用程序可以有多个同时执行的线程。 每一个线程都有一个优先权。具有更高优先级的线程在优先于较低优先级的线程执行。每一个线程可能会或可能不会被标记为一个守护进程。在一些线程中运行的代码创建了一个新的Thread对象时,新线程的优先级被设置为等于创建线程的优先级,新线程是守护线程的当且仅当创建线程是一个守护进程。 当一个java虚拟机启动时,通常有一个单一的非守护线程(通常调用方法为某指定的类中命名为main的)。java虚拟机持续执行线程,直到发生以下情况: Runtime类的exit方法被调用并且安全管理器允许退出操作发生。 非守护线程的所有线程都已经死了,要么从调用到run方法返回或抛出一个异常传播到run方法。 有两种方法来创建一个新的执行线程。一是声明一个类是Thread的子类。这个子类应重写类Thread的run方法。子类的一个实例可以被分配和启动。例如,一个线程计算大于规定值的素数可以写成如下: class PrimeThread extends Thread { long minPrime; PrimeThread(long minPrime) { this.minPrime = minPrime; } public void run() { // compute primes larger than minPrime . . . } } 下面的代码将创建一个线程并开始运行它: PrimeThread p = new PrimeThread(143); p.start(); 创建一个线程的另一个方法是声明一个类实现Runnable接口。该类实现run方法。这个类的一个实例可以分配,创建Thread时作为一个参数传递,并开始。同样的例子在这个方式下如下: class PrimeRun implements Runnable { long minPrime; PrimeRun(long minPrime) { this.minPrime = minPrime; } public void run() { // compute primes larger than minPrime . . . } } 下面的代码将创建一个线程并开始运行: PrimeRun p = new PrimeRun(143); new Thread(p).start(); 每一个线程都有一个用于识别的名称。可能有一个以上的线程有相同的名称。如果创建一个线程时没有指定名称,则为它生成一个新名称。 除非另有说明,通过null作为参数给类的构造函数或方法会导致一个NullPointerException被抛出。 ——以上是对Thread的Javadoc说明内容 Thread这个类比较难以分析的地方在于绝大部分方法实际上是直接与操作系统内核间的交互,因为需要直接操作轻量级的内核线程,所以绝大部分方法实现都是基于native方法的。以下分析主要是基于使用角度上的分析,native方法分析鉴于目前拙劣的系统内核知识和c++水平暂时无法开展。 构造函数 构造函数最多有4个参数: group,线程组,参数为null的话,如果有安全管理器,组由SecurityManager.getThreadGroup()来决定。如果没有安全管理器或者前面这个方法返回是null,组设为当前线程的组。 target,线程启动时哪个对象的run方法会被调用。如果该对象为null,调用这个线程的run方法。 name,新线程的名字 stackSize,为新线程请求的栈大小,如果是0的话说明这个参数可以被忽略 public Thread(ThreadGroup group, Runnable target, String name, long stackSize) { init(group, target, name, stackSize); } 根据使用参数的不同存在不同的重载,但是stackSize只有在4个参数全在时才可以使用,group不能单独使用。线程名如果不给出则自动生成一个,其它的参数默认为null,stackSize默认为0 public Thread() { init(null, null, "Thread-" + nextThreadNum(), 0); } public Thread(Runnable target) { init(null, target, "Thread-" + nextThreadNum(), 0); } public Thread(ThreadGroup group, Runnable target) { init(group, target, "Thread-" + nextThreadNum(), 0); } public Thread(String name) { init(null, null, name, 0); } public Thread(ThreadGroup group, String name) { init(group, null, name, 0); } public Thread(Runnable target, String name) { init(null, target, name, 0); } public Thread(ThreadGroup group, Runnable target, String name) { init(group, target, name, 0); } 还有一种构造函数式继承给出的AccessControlContext,这不是一个public构造函数 Thread(Runnable target, AccessControlContext acc) { init(null, target, "Thread-" + nextThreadNum(), 0, acc, false); } 从构造函数中可以看到调用了init方法来初始化线程。其实主要做的就是存储各参数到本地变量里,比较麻烦一点的是获取线程组,如果没有给定线程组的话需要从安全管理器中获得,还有从父线程继承上下文类加载器、优先级、是否是守护线程等变量。另外,线程ID和线程名是两个不同的变量。 private void init(ThreadGroup g, Runnable target, String name, long stackSize) { init(g, target, name, stackSize, null, true); } private void init(ThreadGroup g, Runnable target, String name, long stackSize, AccessControlContext acc, boolean inheritThreadLocals) { if (name == null) {//线程名不能为null throw new NullPointerException("name cannot be null"); } this.name = name;//设置线程名,这里可以看出线程名指定的话可能重复 Thread parent = currentThread();//返回当前线程 SecurityManager security = System.getSecurityManager(); if (g == null) {//没有指定线程组 /* Determine if it's an applet or not确定是否是小型应用程序 */ /* If there is a security manager, ask the security manager what to do.如果有安全管理器,询问安全管理器做什么 */ if (security != null) { g = security.getThreadGroup(); } /* If the security doesn't have a strong opinion of the matter use the parent thread group.如果安全管理器对于问题没有强硬的意见,使用父线程的线程组 */ if (g == null) { g = parent.getThreadGroup(); } } /* checkAccess regardless of whether or not threadgroup is explicitly passed in.不管线程组是否是明确被传递进来,都需要检查访问权限 */ g.checkAccess(); /* * Do we have the required permissions?是否有要求的权限 */ if (security != null) { if (isCCLOverridden(getClass())) { security.checkPermission(SUBCLASS_IMPLEMENTATION_PERMISSION); } } g.addUnstarted();//增加未开始线程的数量 this.group = g; this.daemon = parent.isDaemon();//如果父线程是守护线程,子线程也是,否则不是 this.priority = parent.getPriority();//优先级为父线程的优先级 if (security == null || isCCLOverridden(parent.getClass()))//没有安全管理器或者父类没有重写安全敏感的方法 this.contextClassLoader = parent.getContextClassLoader();//返回的还是父类的上下文类加载器 else this.contextClassLoader = parent.contextClassLoader; this.inheritedAccessControlContext = acc != null ? acc : AccessController.getContext(); this.target = target; setPriority(priority);//调用底层方法修改线程的优先级 if (inheritThreadLocals && parent.inheritableThreadLocals != null) this.inheritableThreadLocals = ThreadLocal.createInheritedMap(parent.inheritableThreadLocals);//可以从父类继承线程本地变量 /* Stash the specified stack size in case the VM cares存储给定的栈大小以免虚拟机需要 */ this.stackSize = stackSize; /* Set thread ID设置线程ID */ tid = nextThreadID(); } start start方法会令一个新的线程进入就绪状态,我们无法知道这个线程到底什么时候会被执行,由java虚拟机调用这个线程的 run方法。这个方法的结果是,两个线程同时运行:当前线程(从调用start方法返回)和其他的线程(执行run方法)。启动线程超过一次永远是不合法的。特别的,一个线程一旦已经完成执行,它不能再被重新启动。 public synchronized void start() { if (threadStatus != 0) throw new IllegalThreadStateException(); /* 通知线程组这个线程已经准备好被启动,这样它可以被添加到组的线程列表中并且组的未启动计数器会缩减 */ group.add(this); boolean started = false; try { start0();//调用底层方法启动线程 started = true; } finally { try { if (!started) { group.threadStartFailed(this);//通知线程组尝试启动线程失败了 } } catch (Throwable ignore) { /* 什么都不做,这样start0抛出的Throwable会被传递到调用栈 */ } } } run 如果这个线程使用一个单独的Runnable对象来构造运行对象,那么这个Runnable的run方法会被调用,否则这个方法什么也不做世界返回。如果是Thread的子类需要重写这个方法。不同于start是启动一个线程来执行run方法,直接调用run是由当前线程来进行同步调用run,不会创建新的线程。 public void run() { if (target != null) { target.run(); } } yield yield是另这个线程给调度器一个提示,当前线程愿意放弃当前对处理器的使用。调度器可以直接忽视这个提示。yield是一个启发式的尝试以改善线程之间的相对进展,否则将过度使用一个CPU。它的使用应结合详细的分析和确定基准,以确保它实际上有所需的效果。使用这种方法很少是恰当的。它可能是有调试或测试的目的,它可能有助于重现由于竞争环境的错误。在设计并发控制结构如在java.util.concurrent.locks包中的时候可能是有用的。yield会使线程让出当前时间片进入就绪状态,但是由于还在RUNNABLE状态,我们不能预知这个线程会不会由于调度立刻再次开始运行。 public static native void yield(); sleep 引起当前正在执行的线程休眠(暂停执行)为指定的毫秒数,根据系统定时器精度和调度的准确性。线程不失去任何监视器的所有权。也就是当前线程会进入限时等待状态但所持有的锁对象不会被释放。 public static native void sleep(long millis) throws InterruptedException; public static void sleep(long millis, int nanos) throws InterruptedException { if (millis < 0) { throw new IllegalArgumentException("timeout value is negative"); } if (nanos < 0 || nanos > 999999) { throw new IllegalArgumentException( "nanosecond timeout value out of range"); } if (nanos >= 500000 || (nanos != 0 && millis == 0)) { millis++; } sleep(millis); } wait和notify 尽管Thread并没有重写Object中的这个方法,但依然是线程的常用方法,它的作用是让线程进入等待状态,是否是限时等待取决于时间参数,和sleep相比,wait会释放线程持有的监视器锁。 notify()可以让一个等待的线程结束等待状态转入Runnable状态,如果有多个线程的话由系统内核任意选一个线程唤醒。notifyAll()则唤醒所有的等待线程。这里的唤醒代码如果退出之前在一个同步块或执行一个同步方法,需要检查当前能否获得锁。 interrupt 中断这个线程。如果当前线程中断本身,这总是允许的。否则要被中断线程的checkAccess方法被调用,这可能会导致SecurityException被抛出。如果线程在调用Object类的wait(),wait(long),或wait(long, int)方法阻塞,或者调用这个类的join(),join(long),join(long, int),sleep(long),或sleep(long, int)方法导致阻塞,那么它的中断状态将被清除,它会收到InterruptedException。如果该线程在I/O操作被阻塞是因为一个InterruptibleChannel,则通道将被关闭,该线程的中断状态将被设置,并且线程将获得ClosedByInterruptException。如果该线程是在一个Selector被阻塞,然后该线程的中断状态将被设置,它会立即从选择操作返回一个可能是非零的值,就像选择器的wakeup方法调用。如果前面的条件都没有成立,那么这个线程的中断状态将被设置。中断一个不再活动的线程没有任何效果。阻塞状态的进程调用interrupt会抛出ClosedByInterruptException,然后线程终止。 public void interrupt() { if (this != Thread.currentThread()) checkAccess(); synchronized (blockerLock) { Interruptible b = blocker; if (b != null) { interrupt0(); // 只是设置一个中断标记 b.interrupt(this); return; } } interrupt0(); } 下面两个方法检查当前线程是否被中断,区别在于是否会把这个结果重置为false。一个线程中断因为当时线程已经不再活动而被无视的情况会通过这个方法返回false来反应 public boolean isInterrupted() { return isInterrupted(false); } public static boolean interrupted() { return currentThread().isInterrupted(true); } join 假设a是一个线程,如果一个线程b调用a.join(),那么线程b会进入等待状态,直到监视到a线程终止了才会继续进行下去,不输入等待时间或者0就会在线程活动时一直等待下去。因为调用的是wait,所以会释放当前进程的监控器锁。这个方法经常用于一个线程统计多个线程计算结果这样子的情况,需要等待计算进程全部结束。 public final synchronized void join(long millis) throws InterruptedException { long base = System.currentTimeMillis(); long now = 0; if (millis < 0) { throw new IllegalArgumentException("timeout value is negative"); } if (millis == 0) { while (isAlive()) { wait(0);//只要线程还活着就wait下去 } } else { while (isAlive()) { long delay = millis - now; if (delay <= 0) { break; } wait(delay);//wait有限的时间 now = System.currentTimeMillis() - base; } } } getState getState方法获取线程的状态,设计是用于系统状态监控而不是用于同步保证。上面那个情形,如果使用这个方法,可以达到循环检测哪个线程已经结束,就先统计它的结果这样的异步操作。但这样会存在一个问题是,检测的线程一直占着时间片,如果长时间没有计算完的线程,会浪费处理器时间。 public State getState() { // get current thread state return sun.misc.VM.toThreadState(threadStatus); }

优秀的个人博客,低调大师

Java序列化 ObjectOutputStream源码解析

概述 众所周知,Java原生的序列化方法可以分为两种: 实现Serializable接口 实现Externalizable接口 其实还有一种,可以完全自己实现转为二进制内容,用Unsafe写到内存里面,然后写入文件 Serializable 可以使用ObjectStream默认实现的writeObject和readObject方法并且可以通过transit关键字来使得变量不被序列化,开发简单 除了输出协议和包名类名外,会额外输出类的变量信息 有缓存机制,对于重复对象会直接输出所在位置,所以类较大且重复内容多时反而效率高,但会消耗额外内存空间 如果父类没有无参构造函数则不会序列化父类 Externalizable 必须完全由自己来实现序列化规则所以可以直接控制哪些变量需要序列化,所以开发工作量较大 可以自己决定输出内容,只会固定输出协议和包名类名,较为简洁,对于小对象的序列化Externalizable会快一些 必须有无参构造函数否则编译会出错 ​ 但是,普遍实际项目开发中对于原生序列化的使用非常少,我觉得这里面的主要原因还是出在原生的对象流本身设计上一些是否安全的判断过多,加上缓冲区本身大小只有1K有点小,很明显一个16K的对象一次写入硬盘是比1K*16次快很多。尤其是大多数情况下重复对象判断就是在浪费时间,比如一个网站的一条用户信息,根本不会有几个重复字段。所以在很多网上的性能测试案例中,Serializable ​ 因为对象流篇幅过长,加上很多内容是系统安全或者是分隔符标志之类的东西,下面就只挑重点来说。 ObjectOutputStream 先看一眼内部变量一大堆,光看注释根本不知道是干吗用的。大致分类一下,内部类Caches用于安全审计缓存。一面一块是用于输出的部分,bout是下层输出流,两个表是用于记录已输出对象的缓存便于之前说的重复输出的时候输出上一个相同内容的位置。接下来两个是writeObject()/writeExternal()上行调用记录上下文用的。debugInfoStack用于存储错误信息。 private static class Caches { /** cache of subclass security audit results 子类安全审计结果缓存*/ static final ConcurrentMap<WeakClassKey,Boolean> subclassAudits = new ConcurrentHashMap<>(); /** queue for WeakReferences to audited subclasses 对审计子类弱引用的队列*/ static final ReferenceQueue<Class<?>> subclassAuditsQueue = new ReferenceQueue<>(); } /** filter stream for handling block data conversion 解决块数据转换的过滤流*/ private final BlockDataOutputStream bout; /** obj -> wire handle map obj->线性句柄映射*/ private final HandleTable handles; /** obj -> replacement obj map obj->替代obj映射*/ private final ReplaceTable subs; /** stream protocol version 流协议版本*/ private int protocol = PROTOCOL_VERSION_2; /** recursion depth 递归深度*/ private int depth; /** buffer for writing primitive field values 写基本数据类型字段值缓冲区*/ private byte[] primVals; /** if true, invoke writeObjectOverride() instead of writeObject() 如果为true,调用writeObjectOverride()来替代writeObject()*/ private final boolean enableOverride; /** if true, invoke replaceObject() 如果为true,调用replaceObject()*/ private boolean enableReplace; //下面的值只在上行调用writeObject()/writeExternal()时有效 /** * 上行调用类定义的writeObject方法时的上下文,持有当前被序列化的对象和当前对象描述符。在非writeObject上行调用时为null */ private SerialCallbackContext curContext; /** current PutField object 当前PutField对象*/ private PutFieldImpl curPut; /** custom storage for debug trace info 常规存储用于debug追踪信息*/ private final DebugTraceInfoStack debugInfoStack; 构造函数有两个,第一个是自身的构造需要提供一个输出流,第二个实际上是提供给子类用的,创建一个自身相关内部变量全为空的对象输出流。但是,两个构造器都会进行安全检查,检查序列化的类是否重写了安全敏感方法,如果违反了规则会抛出异常。正常的构造类还会直接输出头部信息,包括对象输出流的魔数和协议版本信息,所以即使只新建一个对象输出流就会输出头部信息。 /** * 创建一个ObjectOutputStream写到指定的OutputStream。这个构造器写序列化流头部到下层流中, * 调用者可能希望立即刷新流来确保接收的ObjectInputStreams构造器不会再读取头部时阻塞。 * 如果一个安全管理器被安装,这个构造器将会在被直接调用和被子类的构造器间接调用时检查enableSubclassImplementation序列化许可, * 如果这个子类重写了ObjectOutputStream.putFields或者ObjectOutputStream.writeUnshared方法 */ public ObjectOutputStream(OutputStream out) throws IOException { verifySubclass(); bout = new BlockDataOutputStream(out);//通过下层流out创建一个块输出流 handles = new HandleTable(10, (float) 3.00); subs = new ReplaceTable(10, (float) 3.00); enableOverride = false; writeStreamHeader(); bout.setBlockDataMode(true);//默认采用块模式 if (extendedDebugInfo) { debugInfoStack = new DebugTraceInfoStack(); } else { debugInfoStack = null; } } /** * 给子类提供一个路径完全重新实现ObjectOutputStream,不会分配任何用于实现ObjectOutputStream的私有数据 * 如果安装了一个安全管理器,这个方法会先调用安全管理器的checkPermission方法来检查序列化许可来确保可以使用子类 */ protected ObjectOutputStream() throws IOException, SecurityException { SecurityManager sm = System.getSecurityManager(); if (sm != null) { sm.checkPermission(SUBCLASS_IMPLEMENTATION_PERMISSION); } bout = null; handles = null; subs = null; enableOverride = true; debugInfoStack = null; } /** * 验证这个实例(可能是子类)可以不用违背安全约束被构造:子类不能重写安全敏感的非final方法,或者其他enableSubclassImplementation序列化许可检查 * 这个检查会增加运行时开支 */ private void verifySubclass() { Class<?> cl = getClass(); if (cl == ObjectOutputStream.class) { return;//不是子类直接返回 } SecurityManager sm = System.getSecurityManager(); if (sm == null) { return;//没有安全管理器直接返回 } processQueue(Caches.subclassAuditsQueue, Caches.subclassAudits);//从弱引用队列中出队所有类,并移除缓存中相同的类 WeakClassKey key = new WeakClassKey(cl, Caches.subclassAuditsQueue); Boolean result = Caches.subclassAudits.get(key);//缓存中是否已有这个类 if (result == null) { result = Boolean.valueOf(auditSubclass(cl));//检查这个子类是否安全 Caches.subclassAudits.putIfAbsent(key, result);//将结果存储到缓存 } if (result.booleanValue()) { return;//子类安全直接返回 } sm.checkPermission(SUBCLASS_IMPLEMENTATION_PERMISSION);//检查子类实现许可 } /** * 提供writeStreamHeader方法这样子类可以扩展或者预先考虑它们自己的流头部。 * 这个方法写魔数和版本到流中。 * * @throws IOException if I/O errors occur while writing to the underlying * stream */ protected void writeStreamHeader() throws IOException { bout.writeShort(STREAM_MAGIC);//流魔数 bout.writeShort(STREAM_VERSION);//流版本 } 接下来开始关键部分,来分析writeObject到底做了什么,首先看这个方法本身是final方法也就是说即使继承了ObjectOutputStream也不能重写这个方法而是重写writeObjectOverride并且enableOverride=true public final void writeObject(Object obj) throws IOException { if (enableOverride) { writeObjectOverride(obj);//如果流子类重写了writeObject则调用这里的方法 return; } try { writeObject0(obj, false); } catch (IOException ex) { if (depth == 0) { writeFatalException(ex); } throw ex; } } writeObject0这个方法代码很长,一部分一部分来看,首先我们注意到上面的都是缓存替换部分,第一次进入这个方法是不需要考虑的,直接看到writeOrdinaryObject这里,因为用于数据化的类是实现了Serializable接口,所以会进入这个分支。 private void writeObject0(Object obj, boolean unshared) throws IOException { boolean oldMode = bout.setBlockDataMode(false);//将输出流设置为非块模式 depth++;//增加递归深度 try { // handle previously written and non-replaceable objects处理之前写的不可替换对象 int h; if ((obj = subs.lookup(obj)) == null) { writeNull();//替代对象映射中这个对象为null时,写入null代码 return; } else if (!unshared && (h = handles.lookup(obj)) != -1) { writeHandle(h);//不是非共享模式且这个对象在对句柄的映射表中已有缓存,写入该对象在缓存中的句柄值 return; } else if (obj instanceof Class) { writeClass((Class) obj, unshared);//写类名 return; } else if (obj instanceof ObjectStreamClass) { writeClassDesc((ObjectStreamClass) obj, unshared);//写类描述 return; } // check for replacement object检查替代对象,要求对象重写了writeReplace方法 Object orig = obj; Class<?> cl = obj.getClass(); ObjectStreamClass desc; for (;;) { // REMIND: skip this check for strings/arrays? Class<?> repCl; desc = ObjectStreamClass.lookup(cl, true); if (!desc.hasWriteReplaceMethod() || (obj = desc.invokeWriteReplace(obj)) == null || (repCl = obj.getClass()) == cl) { break; } cl = repCl; } if (enableReplace) { Object rep = replaceObject(obj);//如果不重写这个方法直接返回了obj也就是什么也没做 if (rep != obj && rep != null) { cl = rep.getClass(); desc = ObjectStreamClass.lookup(cl, true); } obj = rep; } // if object replaced, run through original checks a second time如果对象被替换,第二次运行原本的检查,大部分情况下不执行此段 if (obj != orig) { subs.assign(orig, obj);//将原本对象和替代对象作为一个键值对存入缓存 if (obj == null) { writeNull(); return; } else if (!unshared && (h = handles.lookup(obj)) != -1) { writeHandle(h); return; } else if (obj instanceof Class) { writeClass((Class) obj, unshared); return; } else if (obj instanceof ObjectStreamClass) { writeClassDesc((ObjectStreamClass) obj, unshared); return; } } // remaining cases剩下的情况 if (obj instanceof String) { writeString((String) obj, unshared); } else if (cl.isArray()) { writeArray(obj, desc, unshared); } else if (obj instanceof Enum) { writeEnum((Enum<?>) obj, desc, unshared); } else if (obj instanceof Serializable) { writeOrdinaryObject(obj, desc, unshared);//传入流的对象第一次执行这个方法 } else { if (extendedDebugInfo) { throw new NotSerializableException( cl.getName() + "\n" + debugInfoStack.toString()); } else { throw new NotSerializableException(cl.getName()); } } } finally { depth--; bout.setBlockDataMode(oldMode); } } writeOrdinaryObject这个方法主要是在Externalizable和Serializable的接口出现分支,如果实现了Externalizable接口并且类描述符非动态代理,则执行writeExternalData,否则执行writeSerialData。同时,这个方法会写类描述信息。 private void writeOrdinaryObject(Object obj, ObjectStreamClass desc, boolean unshared) throws IOException { if (extendedDebugInfo) { debugInfoStack.push( (depth == 1 ? "root " : "") + "object (class \"" + obj.getClass().getName() + "\", " + obj.toString() + ")"); } try { desc.checkSerialize(); bout.writeByte(TC_OBJECT); writeClassDesc(desc, false);//写类描述 handles.assign(unshared ? null : obj);//如果是share模式把这个对象加入缓存 if (desc.isExternalizable() && !desc.isProxy()) { writeExternalData((Externalizable) obj); } else { writeSerialData(obj, desc); } } finally { if (extendedDebugInfo) { debugInfoStack.pop(); } } } writeExternalData和writeSerialData(Object, ObjectStreamClass)这里有个上下文的操作,目的是保证序列化操作同一时间只能由一个线程调用。前者直接调用writeExternal,后者如果重写了writeObject则调用它,否则调用defaultWriteFields。defaultWriteFields会先输出基本数据类型,对于非基本数据类型的部分会再递归调用writeObject0,所以这里也就会增加递归深度depth。 private void writeExternalData(Externalizable obj) throws IOException { PutFieldImpl oldPut = curPut; curPut = null; if (extendedDebugInfo) { debugInfoStack.push("writeExternal data"); } SerialCallbackContext oldContext = curContext;//存储上下文 try { curContext = null; if (protocol == PROTOCOL_VERSION_1) { obj.writeExternal(this); } else {//默认协议是2,所以会使用块输出流 bout.setBlockDataMode(true); obj.writeExternal(this);//这里取决于类的方法怎么实现 bout.setBlockDataMode(false); bout.writeByte(TC_ENDBLOCKDATA); } } finally { curContext = oldContext;//恢复上下文 if (extendedDebugInfo) { debugInfoStack.pop(); } } curPut = oldPut; } private void writeSerialData(Object obj, ObjectStreamClass desc) throws IOException { ObjectStreamClass.ClassDataSlot[] slots = desc.getClassDataLayout(); for (int i = 0; i < slots.length; i++) { ObjectStreamClass slotDesc = slots[i].desc; if (slotDesc.hasWriteObjectMethod()) {//重写了writeObject方法 PutFieldImpl oldPut = curPut; curPut = null; SerialCallbackContext oldContext = curContext; if (extendedDebugInfo) { debugInfoStack.push( "custom writeObject data (class \"" + slotDesc.getName() + "\")"); } try { curContext = new SerialCallbackContext(obj, slotDesc); bout.setBlockDataMode(true); slotDesc.invokeWriteObject(obj, this);//调用writeObject方法 bout.setBlockDataMode(false); bout.writeByte(TC_ENDBLOCKDATA); } finally { curContext.setUsed(); curContext = oldContext; if (extendedDebugInfo) { debugInfoStack.pop(); } } curPut = oldPut; } else { defaultWriteFields(obj, slotDesc);//如果没有重写writeObject则输出默认内容 } } } private void defaultWriteFields(Object obj, ObjectStreamClass desc) throws IOException { Class<?> cl = desc.forClass(); if (cl != null && obj != null && !cl.isInstance(obj)) { throw new ClassCastException(); } desc.checkDefaultSerialize(); int primDataSize = desc.getPrimDataSize(); if (primVals == null || primVals.length < primDataSize) { primVals = new byte[primDataSize]; } desc.getPrimFieldValues(obj, primVals);//将基本类型数据的字段值存入缓冲区 bout.write(primVals, 0, primDataSize, false);//输出缓冲区内容 ObjectStreamField[] fields = desc.getFields(false); Object[] objVals = new Object[desc.getNumObjFields()];//获取非基本数据类型对象 int numPrimFields = fields.length - objVals.length; desc.getObjFieldValues(obj, objVals); for (int i = 0; i < objVals.length; i++) { if (extendedDebugInfo) { debugInfoStack.push( "field (class \"" + desc.getName() + "\", name: \"" + fields[numPrimFields + i].getName() + "\", type: \"" + fields[numPrimFields + i].getType() + "\")"); } try { writeObject0(objVals[i], fields[numPrimFields + i].isUnshared());//递归输出 } finally { if (extendedDebugInfo) { debugInfoStack.pop(); } } } } 然后看一下类描述信息是怎么写的,动态代理类和普通类有一些区别,但都是先写这个类本身的信息再写入父类的信息。 private void writeClassDesc(ObjectStreamClass desc, boolean unshared) throws IOException { int handle; if (desc == null) { writeNull();//描述符不存在时写null } else if (!unshared && (handle = handles.lookup(desc)) != -1) { writeHandle(handle);//共享模式且缓存中已有该类描述符时,写对应句柄值 } else if (desc.isProxy()) { writeProxyDesc(desc, unshared);//描述符是动态代理类时 } else { writeNonProxyDesc(desc, unshared);//描述符是标准类时 } } private void writeProxyDesc(ObjectStreamClass desc, boolean unshared) throws IOException { bout.writeByte(TC_PROXYCLASSDESC); handles.assign(unshared ? null : desc);//存入缓存 //获取类实现的接口,然后写入接口个数和接口名 Class<?> cl = desc.forClass(); Class<?>[] ifaces = cl.getInterfaces(); bout.writeInt(ifaces.length); for (int i = 0; i < ifaces.length; i++) { bout.writeUTF(ifaces[i].getName()); } bout.setBlockDataMode(true); if (cl != null && isCustomSubclass()) { ReflectUtil.checkPackageAccess(cl); } annotateProxyClass(cl);//装配动态代理类,子类可以重写这个方法存储类信息到流中,默认什么也不做 bout.setBlockDataMode(false); bout.writeByte(TC_ENDBLOCKDATA); writeClassDesc(desc.getSuperDesc(), false);//写入父类的描述符 } private void writeNonProxyDesc(ObjectStreamClass desc, boolean unshared) throws IOException { bout.writeByte(TC_CLASSDESC); handles.assign(unshared ? null : desc); if (protocol == PROTOCOL_VERSION_1) { // do not invoke class descriptor write hook with old protocol desc.writeNonProxy(this); } else { writeClassDescriptor(desc); } Class<?> cl = desc.forClass(); bout.setBlockDataMode(true); if (cl != null && isCustomSubclass()) { ReflectUtil.checkPackageAccess(cl); } annotateClass(cl);//子类可以重写这个方法存储类信息到流中,默认什么也不做 bout.setBlockDataMode(false); bout.writeByte(TC_ENDBLOCKDATA); writeClassDesc(desc.getSuperDesc(), false);//写入父类的描述信息 } 最后看一下几个写方法,写字符串是写入UTF编码的二进制流数据。写枚举会额外写入一次枚举的类描述,然后将枚举名作为字符串写入。如果是写一个数组,先写入数组长度,然后如果数组是基本数据类型则可以直接写入,否则需要递归调用writeObject0 private void writeString(String str, boolean unshared) throws IOException { handles.assign(unshared ? null : str); long utflen = bout.getUTFLength(str);//获得UTF编码长度 if (utflen <= 0xFFFF) { bout.writeByte(TC_STRING); bout.writeUTF(str, utflen); } else { bout.writeByte(TC_LONGSTRING); bout.writeLongUTF(str, utflen); } } private void writeEnum(Enum<?> en, ObjectStreamClass desc, boolean unshared) throws IOException { bout.writeByte(TC_ENUM); ObjectStreamClass sdesc = desc.getSuperDesc(); writeClassDesc((sdesc.forClass() == Enum.class) ? desc : sdesc, false); handles.assign(unshared ? null : en); writeString(en.name(), false); } BlockDataOutputStream BlockDataOutputStream是一个内部类,它继承了OutputStream并实现了DataOutput接口,缓冲输出流有两种模式:在默认模式下,输出数据和DataOutputStream使用同样模式;在块数据模式下,使用一个缓冲区来缓存数据到达最大长度或者手动刷新时将内容写入下层输入流,这点和BufferedOutputStream类似。不同之处在于,块模式在写数据之前,要先写入一个头部来表示当前块的长度。 从内部变量和构造函数中可以看出,缓冲区的大小是固定且不可修改的,其中包含了一个下层输入流和一个数据输出流以及是否采用块模式的标识,在构造时默认不采用块数据模式。 /** maximum data block length 最大数据块长度1K*/ private static final int MAX_BLOCK_SIZE = 1024; /** maximum data block header length 最大数据块头部长度*/ private static final int MAX_HEADER_SIZE = 5; /** (tunable) length of char buffer (for writing strings) 字符缓冲区的可变长度,用于写字符串*/ private static final int CHAR_BUF_SIZE = 256; /** buffer for writing general/block data 用于写一般/块数据的缓冲区*/ private final byte[] buf = new byte[MAX_BLOCK_SIZE]; /** buffer for writing block data headers 用于写块数据头部的缓冲区*/ private final byte[] hbuf = new byte[MAX_HEADER_SIZE]; /** char buffer for fast string writes 用于写快速字符串的缓冲区*/ private final char[] cbuf = new char[CHAR_BUF_SIZE]; /** block data mode 块数据模式*/ private boolean blkmode = false; /** current offset into buf buf中的当前偏移量*/ private int pos = 0; /** underlying output stream 下层输出流*/ private final OutputStream out; /** loopback stream (for data writes that span data blocks) 回路流用于写跨越数据块的数据*/ private final DataOutputStream dout; /** * 在给定的下层流上创建一个BlockDataOutputStream,块数据模式默认关闭 */ BlockDataOutputStream(OutputStream out) { this.out = out; dout = new DataOutputStream(this); } setBlockDataMode可以改变当前的数据模式,从块数据模式切换到非块数据模式时,要讲缓冲区内的数据写入到下层输入流中。getBlockDataMode可以查询当前的数据模式。 /** * 设置块数据模式为给出的模式true是开启,false是关闭,并返回之前的模式值。 * 如果新的模式和旧的一样,什么都不做。 * 如果新的模式和旧的模式不同,所有的缓冲区数据要在转换到新模式之前刷新。 */ boolean setBlockDataMode(boolean mode) throws IOException { if (blkmode == mode) { return blkmode; } drain();//将缓冲区内的数据全部写入下层输入流 blkmode = mode; return !blkmode; } /** * 当前流为块数据模式返回true,否则返回false */ boolean getBlockDataMode() { return blkmode; } drain这个方法在多个方法中被调用,作用是将缓冲区内的数据全部写入下层输入流,但不会刷新下层输入流,在写入实际数据前要先用writeBlockHeader写入块头部,头部包含1字节标志位和1字节或4字节的长度大小 void drain() throws IOException { if (pos == 0) { return;//pos为0说明当前缓冲区为空 } if (blkmode) { writeBlockHeader(pos);//块数据模式下要先写入头部 } out.write(buf, 0, pos);//写入缓冲区数据 pos = 0;//缓冲区被清空 } /** * 写入块数据头部。数据块小于256字节会增加2字节头部前缀,其他会增加5字节头部。 * 第一字节是标识长度范围,因为255字节以内可以用1字节来表示长度,4字节可以表示int范围内的最大整数 */ private void writeBlockHeader(int len) throws IOException { if (len <= 0xFF) { hbuf[0] = TC_BLOCKDATA; hbuf[1] = (byte) len; out.write(hbuf, 0, 2); } else { hbuf[0] = TC_BLOCKDATALONG; Bits.putInt(hbuf, 1, len); out.write(hbuf, 0, 5); } } 下面的方法等价于他们在OutputStream中的对应方法,除了他们参与在块数据模式下写入数据到数据块中的部分有所不同。写入都需要先检查缓冲区有没有达到上限,达到时需要先刷新,然后再将数据复制到缓冲区。刷新和关闭操作都不难理解。 public void write(int b) throws IOException { if (pos >= MAX_BLOCK_SIZE) { drain();//达到块数据上限时,将缓冲区内的数据全部写入下层流 } buf[pos++] = (byte) b;//存储b到buf中 } public void write(byte[] b) throws IOException { write(b, 0, b.length, false); } public void write(byte[] b, int off, int len) throws IOException { write(b, off, len, false); } /** * 将指定的字节段从数组中写出。如果copy是true,复制值到一个中间缓冲区在将它们写入下层流之前,来避免暴露一个对原字节数组的引用 */ void write(byte[] b, int off, int len, boolean copy) throws IOException { if (!(copy || blkmode)) {// 非copy也非块数据模式直接写入下层输入流 drain(); out.write(b, off, len); return; } while (len > 0) { if (pos >= MAX_BLOCK_SIZE) { drain(); } if (len >= MAX_BLOCK_SIZE && !copy && pos == 0) { // 长度大于缓冲区非copy模式且缓冲区为空直接写,避免不必要的复制 writeBlockHeader(MAX_BLOCK_SIZE); out.write(b, off, MAX_BLOCK_SIZE); off += MAX_BLOCK_SIZE; len -= MAX_BLOCK_SIZE; } else { //剩余内容在缓冲区内放得下或者缓冲区不为空或者是copy模式,则将数据复制到缓冲区 int wlen = Math.min(len, MAX_BLOCK_SIZE - pos); System.arraycopy(b, off, buf, pos, wlen); pos += wlen; off += wlen; len -= wlen; } } } /** * 将缓冲区数据刷新到下层流,同时会刷新下层流 */ public void flush() throws IOException { drain(); out.flush(); } /** * 刷新之后关闭下层输出流 */ public void close() throws IOException { flush(); out.close(); } 上面的方法等价于他们在DataOutputStream中的对应方法,除了他们参与在块数据模式下写入数据到数据块中部分有所不同。基本上逻辑都是先检查空间是否足够,不足的话先刷新缓冲区,然后将数据存储到缓冲区中。因为篇幅原因,这里只贴几个方法为例。写一个字符串时,需要先将字符串中的字符存储到字符缓冲数组中,然后再转换成字节存储到buf中。 public void writeBoolean(boolean v) throws IOException { if (pos >= MAX_BLOCK_SIZE) { drain(); } Bits.putBoolean(buf, pos++, v); } public void writeByte(int v) throws IOException { if (pos >= MAX_BLOCK_SIZE) { drain(); } buf[pos++] = (byte) v; } /** * 写入单个字符,块未满时存储到缓冲区,块满时调用的是BlockDataOutputStream.write(int v)方法 */ public void writeChar(int v) throws IOException { if (pos + 2 <= MAX_BLOCK_SIZE) { Bits.putChar(buf, pos, (char) v); pos += 2; } else { dout.writeChar(v); } } /** * 先将String中的内容复制到字符缓冲区,再将其中的内容转为字节复制到块数据缓冲区 */ public void writeBytes(String s) throws IOException { int endoff = s.length(); int cpos = 0;//当前字符串开始位置 int csize = 0;//当前字符串大小 for (int off = 0; off < endoff; ) { if (cpos >= csize) { cpos = 0; csize = Math.min(endoff - off, CHAR_BUF_SIZE); s.getChars(off, off + csize, cbuf, 0);//将字符串中指定位置的片段复制到字符数组缓冲区 } if (pos >= MAX_BLOCK_SIZE) { drain(); } int n = Math.min(csize - cpos, MAX_BLOCK_SIZE - pos); int stop = pos + n; while (pos < stop) { buf[pos++] = (byte) cbuf[cpos++];//将字符数组中的内容复制到块数据缓冲区 } off += n; } } 下面的方法写出连贯的原始数据值。尽管和重复调用对应的原始写方法结果相同,这些方法对于写一组原始数据值进行了效率优化。优化的方式是先计算出缓冲区内的剩余大小,计算可以写入的个数,然后直接写入而不是每次写入之前检查缓冲区是否有空间,减少判断次数。写UTF编码字符串时,如果能够提前知道编码长度,可以省去一次遍历字符串确定大小的过程,因为UTF编码中单个字符可能是一个1-3个字节不等。 void writeBooleans(boolean[] v, int off, int len) throws IOException { int endoff = off + len; while (off < endoff) { if (pos >= MAX_BLOCK_SIZE) { drain(); } int stop = Math.min(endoff, off + (MAX_BLOCK_SIZE - pos)); while (off < stop) {//连续存储数据到缓冲区,减少了判断缓冲区是否满的次数 Bits.putBoolean(buf, pos++, v[off++]); } } } void writeChars(char[] v, int off, int len) throws IOException { int limit = MAX_BLOCK_SIZE - 2; int endoff = off + len; while (off < endoff) { if (pos <= limit) { int avail = (MAX_BLOCK_SIZE - pos) >> 1;//一个字符=2个字节所以要除以2 int stop = Math.min(endoff, off + avail); while (off < stop) { Bits.putChar(buf, pos, v[off++]); pos += 2; } } else { dout.writeChar(v[off++]); } } } /** * 返回给定字符串在UTF编码下的字节长度 */ long getUTFLength(String s) { int len = s.length(); long utflen = 0; for (int off = 0; off < len; ) { int csize = Math.min(len - off, CHAR_BUF_SIZE); s.getChars(off, off + csize, cbuf, 0); for (int cpos = 0; cpos < csize; cpos++) { char c = cbuf[cpos]; if (c >= 0x0001 && c <= 0x007F) { utflen++; } else if (c > 0x07FF) { utflen += 3; } else { utflen += 2; } } off += csize; } return utflen; } /** * 写给定字符串的UTF格式。这个方法用于字符串的UTF编码长度已知的情况,这样可以避免提前扫描一遍字符串来确定UTF长度 */ void writeUTF(String s, long utflen) throws IOException { if (utflen > 0xFFFFL) { throw new UTFDataFormatException(); } writeShort((int) utflen);//先写长度 if (utflen == (long) s.length()) { writeBytes(s);//没有特殊字符 } else { writeUTFBody(s);//有特殊字符 } } HandleTable HandleTable是一个轻量的hash表,它的作用是缓存写过的共享class便于下次查找,内部含有3个数组,spine、next和objs。objs存储的是对象也就是class,spine是hash桶,next是冲突链表,每有一个新的元素插入需要计算它的hash值然后用spine的大小取模,找到它的链表,新对象会被插入到链表的头部,它在objs和next中对应的数据是根据加入的序号顺序存储,spine存储它的handle值也就是在另外两个数组中的下标。 /** number of mappings in table/next available handle 表中映射的个数或者下一个有效的句柄*/ private int size; /** size threshold determining when to expand hash spine 决定什么时候扩展hash脊柱的大小阈值*/ private int threshold; /** factor for computing size threshold 计算大小阈值的因子*/ private final float loadFactor; /** maps hash value -> candidate handle value 映射hash值->候选句柄值*/ private int[] spine; /** maps handle value -> next candidate handle value 映射句柄值->下一个候选句柄值*/ private int[] next; /** maps handle value -> associated object 映射句柄值->关联的对象*/ private Object[] objs; /** * 创建一个新的hash表使用给定的容量和负载因子 */ HandleTable(int initialCapacity, float loadFactor) { this.loadFactor = loadFactor; spine = new int[initialCapacity]; next = new int[initialCapacity]; objs = new Object[initialCapacity]; threshold = (int) (initialCapacity * loadFactor); clear(); } assign就是插入操作,它会检查3个数组大小是否足够,其中spine是根据next.length*负载因子来决定阈值的,数组大小扩大是乘以2加1,这个和HashTable时同样的设计。插入的时候注意到next的值被赋为原本的spine[index]值,说明之前的链表头成为了新结点的后驱,也就是说结点被插入链表头部。 /** * 分配下一个有效的句柄给给出的对象并返回句柄值。句柄从0开始升序被分配。相当于put操作 */ int assign(Object obj) { if (size >= next.length) { growEntries(); } if (size >= threshold) { growSpine(); } insert(obj, size); return size++; } /** * 通过延长条目数组增加hash表容量,next和objs大小变为旧大小*2+1 */ private void growEntries() { int newLength = (next.length << 1) + 1;//长度=旧长度*2+1 int[] newNext = new int[newLength]; System.arraycopy(next, 0, newNext, 0, size);//复制旧数组元素到新数组中 next = newNext; Object[] newObjs = new Object[newLength]; System.arraycopy(objs, 0, newObjs, 0, size); objs = newObjs; } /** * 扩展hash脊柱,等效于增加常规hash表的桶数 */ private void growSpine() { spine = new int[(spine.length << 1) + 1];//新大小=旧大小*2+1 threshold = (int) (spine.length * loadFactor);//扩展阈值=spine大小*负载因子 Arrays.fill(spine, -1);//spine中全部填充-1 for (int i = 0; i < size; i++) { insert(objs[i], i); } } /** * 插入映射对象->句柄到表中,假设表足够大来容纳新的映射 */ private void insert(Object obj, int handle) { int index = hash(obj) % spine.length;//hash值%spine数组大小 objs[handle] = obj;//objs顺序存储对象 next[handle] = spine[index];//next存储spine[index]原本的handle值,也就是说新的冲突对象插入在链表头部 spine[index] = handle;//spine中存储handle大小 } hash值计算就是通过系统函数计算出hash值然后去有符号int的有效位 private int hash(Object obj) { return System.identityHashCode(obj) & 0x7FFFFFFF;//取系统计算出的hash值得有效整数值部分 } lookup是查找hash表中是否含有指定对象,这里相等必须是==,因为class在完整类名相等时就是== /** * 查找并返回句柄值关联给与的对象,如果没有映射返回-1 */ int lookup(Object obj) { if (size == 0) { return -1; } int index = hash(obj) % spine.length;//通过hash值寻找在spine数组中的位置 for (int i = spine[index]; i >= 0; i = next[i]) { if (objs[i] == obj) {//遍历spine[index]位置的链表,必须是对象==才是相等 return i; } } return -1; } clear是清空hash表,size返回当前表中映射对数 /** * 重置表为初始状态,next不需要重新赋值是因为插入第一个元素时,原本的spine[index]一定是-1,链表中不会出现之前存在的值 */ void clear() { Arrays.fill(spine, -1); Arrays.fill(objs, 0, size, null); size = 0; } /** * 返回当前表中的映射数量 */ int size() { return size; }

优秀的个人博客,低调大师

Kotlin 设计模式解析之单例

单例模式介绍 单例模式是一个比较简单的设计模式,同时也是挺有意思的一个模式,虽然看起来简单,但是可以玩出各种花样。比如 Java 当中的懒饿汉式单例等。 什么是单例 单例模式的定义: Ensure a class only has one instance, and provide a global point of access to it. 简单来说,确保某一个类只有一个实例,且自行实例化并向整个系统提供。 单例模式的适用场景 提供一个全局的访问,且只要求一个实例,如应用的配置信息 创建一个对象比较耗费资源,如数据库连接管理、文件管理、日志管理等 资源共享,如线程池 工具类对象(也可以直接使用静态常量或者静态方法) 要求一个类只能产生两三个实例对象,比如某些场景下,会要求两个版本的网络库实例,如公司内网和外网的网络库实例 单例模式的简单实现 Java

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册