Java集合框架源码解析之ArrayList
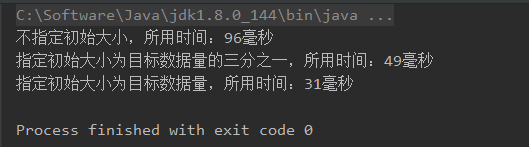
ArrayList 可能是很多人使用得最为频繁的容器类了,ArrayList 实现了 List 接口,是一个有序容器,即存放元素的顺序与添加顺序相同,允许添加相同元素,包括 null ,底层通过数组来实现数据存储,容器内存储的元素个数不能超出数组空间。所以向容器中添加元素时如果发现数组空间不足,容器会自动对底层数组进行扩容操作 ArrayList 的类声明 public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable 从其实现的几个接口可以看出来,ArrayList 是支持快速访问,可克隆,可序列化的 包含的成员变量 //序列化ID private static final long serialVersionUID = 8683452581122892189L; //集合默认的初始大小 private static final int DEFAULT_CAPACITY = 10; //如果外部为集合设置的初始化大小为 0,则 elementData 指向空数组对象 EMPTY_ELEMENTDATA private static final Object[] EMPTY_ELEMENTDATA = {}; //如果在初始化集合时使用的是无参数的构造函数,则 elementData 指向空数组对象 DEFAULTCAPACITY_EMPTY_ELEMENTDATA private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; //包含实际元素的数组 transient Object[] elementData; //集合大小 private int size; elementData 是一个 Object 类型的数组对象,即可用来存放任何对象类型,也是 ArrarList 中用来存放数据的容器。而 ArrayList 是一个泛型类,我们在初始化时就直接指定了数据类型,Java泛型只是编译器为我们提供的语法糖,方便我们在向 elementData 存取数据时,将之自动转换为特定的类型 包含的构造函数 //指定集合的初始容量,以此来进行数组的初始化操作 public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+initialCapacity); } } //使用默认的初始化大小 public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } //传入一份初始数据,以此进行初始化 public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); if ((size = elementData.length) != 0) { // c.toArray might (incorrectly) not return Object[] (see 6260652) if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } else { this.elementData = EMPTY_ELEMENTDATA; } } 可以在初始化 ArrayList 的时候传入集合的初始化大小,这通常来说都是更为高效率一些的,因为如果是让集合在赋值的过程中自动扩容,则可能会需要进行多次扩容操作,而每次扩容都需要复制原有数据到新数组,这会导致运行效率降低 添加/修改 元素 在获取指定索引处的元素时,都是直接通过坐标指向该元素 (E) elementData[index],而无需从头开始遍历集合,所以说 ArrayList 的遍历效率较高 //通过索引直接访问数组 @SuppressWarnings("unchecked") E elementData(int index) { return (E) elementData[index]; } //获取索引 index 处的元素值 public E get(int index) { rangeCheck(index); return elementData(index); } //将索引 index 出的元素值置为 element,并返回原始数值 public E set(int index, E element) { rangeCheck(index); E oldValue = elementData(index); elementData[index] = element; return oldValue; } ArrayList 在存入数据时相对来说就不是那么理想了 如果是直接向集合尾端添加数据 add(E e),则先检查是否需要扩容,需要的话则创建一个新的符合大小的数组,并将原数组中的元素移到新数组中,再向数组尾端添加待存入的元素 如果是向集合非尾端位置添加数据 add(int index, E element),一样需要先检查是否需要扩容,然后将数组中索引 index 后的所有元素向后推移一位,然后将 element 插入到空出的位置上 由此看出来,向集合添加元素由于可能会导致数组扩容,从而导致数组元素的大量移动,所以说 ArrayList 存入数据的效率并不高 //向集合添加数据 public boolean add(E e) { //检查是否需要扩容 ensureCapacityInternal(size + 1); //赋值 elementData[size++] = e; return true; } //将元素 element 添加索引 index 位置 public void add(int index, E element) { rangeCheckForAdd(index); //检查是否需要扩容 ensureCapacityInternal(size + 1); //将索引 index 后的所有数值向后推移一位 System.arraycopy(elementData, index, elementData, index + 1,size - index); //将 element 插入到空出的位置 elementData[index] = element; //集合大小加1 size++; } 以上说的是存入单个元素,此外还有存入整个集合的情况 //向集合添加数据 //如果待添加的数据不为空则返回 true,否则返回 false public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); int numNew = a.length; //检查是否需要扩容 ensureCapacityInternal(size + numNew); //将数组 a 复制到 elementData 的尾端 System.arraycopy(a, 0, elementData, size, numNew); size += numNew; return numNew != 0; } //从指定索引处添加数据 //如果待添加的数据不为空则返回 true,否则返回 false public boolean addAll(int index, Collection<? extends E> c) { rangeCheckForAdd(index); Object[] a = c.toArray(); int numNew = a.length; //检查是否需要扩容 ensureCapacityInternal(size + numNew); //需要移动的数组元素数量 int numMoved = size - index; //因为要添加的数据可能刚好是从数组最尾端开始添加,所以 numMoved 可能为 0 //所以只在 numMoved > 0 的时候才需要对数组的元素值进行移动,以此空出位置给数组 a if (numMoved > 0) System.arraycopy(elementData, index, elementData, index + numNew, numMoved); //将数组 a 包含的数据添加到 elementData 中 System.arraycopy(a, 0, elementData, index, numNew); size += numNew; return numNew != 0; } 移除元素 再看下移除元素的方法 因为数组是一种内存地址连续的数据结构,所以移除某个元素同样可能导致大量元素的移动 //移除指定索引处的元素值,并返回该值 public E remove(int index) { rangeCheck(index); modCount++; //待移除的元素值 E oldValue = elementData(index); //因为要移除元素导致需要移动的元素数量 int numMoved = size - index - 1; //因为要移除的元素可能刚好是数组最后一位,所以 numMoved 可能为 0 //所以只在 numMoved > 0 的时候才需要对数组的元素值进行移动 if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); //不管数组是否需要对元素值进行移动,数组的最后一位都是无效数据了 //此处将之置为 null 以帮助GC回收 elementData[--size] = null; return oldValue; } //移除集合中包含的第一位元素值为 o 的对象 //如果包含该对象,则返回 true ,否则返回 false public boolean remove(Object o) { if (o == null) { for (int index = 0; index < size; index++) if (elementData[index] == null) { fastRemove(index); return true; } } else { for (int index = 0; index < size; index++) if (o.equals(elementData[index])) { fastRemove(index); return true; } } return false; } 扩容机制 以上多处说到了数组的扩容,这里就来看下数组的扩容机制 实际进行扩容操作的是 grow(int grow(int minCapacity)) 方法,参数 minCapacity 用于指定要求的最小空间,在扩容前,会先判断如果将当前容量提升到当前的 1.5 倍是否能达到 minCapacity 的要求 ,如果符合要求则直接将数据扩充到当前的 1.5 倍容量,否则则扩充到 minCapacity ,构建一个新的符合大小的数组后,就将原数组中的元素复制到新数组中 由此可想到,如果在初始化 ArrayList 前已知目标数据的数据量,则最好使用 ArrayList(int initialCapacity)来进行初始化,直接让底层数组扩充到目标大小,避免之后赋值过程中多次扩容 //触发集合进行扩容操作,参数 minCapacity 表示集合扩容后的最小空间 //如果在向集合进行赋值操作前已知数据量大小,则直接调用此方法让集合直接扩容到该大小有助于提高集合的运行效率 //如果是让集合在赋值的过程中自动扩容,则可能会需要进行多次扩容操作,而每次扩容都需要复制原有数据到新数组,这会导致运行效率降低 public void ensureCapacity(int minCapacity) { //1. 如果当前数组还未进行任何赋值操作,即 elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA,则数组空间只由参数 minCapacity 影响 //2. 如果当前数组已进行过赋值操作,即 elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA,则当前数组大小可能还是在使用默认容量 DEFAULT_CAPACITY // 则此时只有当 minCapacity 大于 DEFAULT_CAPACITY 时,才需要进行扩容 int minExpand = (elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) // any size if not default element table ? 0 // larger than default for default empty table. It's already // supposed to be at default size. : DEFAULT_CAPACITY; if (minCapacity > minExpand) { ensureExplicitCapacity(minCapacity); } } //检查当前的数组容量,minCapacity 用于指定当前需要的最小空间 //如果数组容量没有达到一定标准,则需要进行扩容 private void ensureCapacityInternal(int minCapacity) { if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { //数组空间至少需要扩容到 DEFAULT_CAPACITY minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } ensureExplicitCapacity(minCapacity); } private void ensureExplicitCapacity(int minCapacity) { modCount++; //如果当前数组大小的确是比需要的最小空间 minCapacity 小,则进行扩容 if (minCapacity - elementData.length > 0) grow(minCapacity); } //数组可扩充到的最大空间 private static final int MAX_ARRAY_SIZE = Integer.MAX_VALUE - 8; //对数组进行扩容 private void grow(int minCapacity) { //扩容前的数组大小 int oldCapacity = elementData.length; //oldCapacity >> 1 的含义即为:将 oldCapacity 值除以 2 //即先假设扩容后的空间大小是原先的1.5倍 int newCapacity = oldCapacity + (oldCapacity >> 1); //如果 newCapacity 依然是达不到最小空间要求,则直接将空间扩大到由 minCapacity 指定的大小 if (newCapacity - minCapacity < 0) newCapacity = minCapacity; //如果扩容后的数组空间超出了最大容量限制,则将容量定为 Integer.MAX_VALUE if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); //构建符合容量大小的数组并复制原数组的数据 elementData = Arrays.copyOf(elementData, newCapacity); } 遍历集合的方法 //遍历集合元素 @Override public void forEach(Consumer<? super E> action) { Objects.requireNonNull(action); final int expectedModCount = modCount; @SuppressWarnings("unchecked") final E[] elementData = (E[]) this.elementData; final int size = this.size; //如果 modCount 值被改动,则直接停止遍历并抛出异常 for (int i=0; modCount == expectedModCount && i < size; i++) { //将集合元素依次传递给 accept 方法 action.accept(elementData[i]); } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } } 遍历并过滤集合的方法 //按照给定规则对集合元素进行过滤,如果元素符合过滤规则 filter 则将之移除 @Override public boolean removeIf(Predicate<? super E> filter) { Objects.requireNonNull(filter); //要移除的元素个数 int removeCount = 0; //用于标记集合是哪个索引位置需要被移除 final BitSet removeSet = new BitSet(size); final int expectedModCount = modCount; final int size = this.size; for (int i=0; modCount == expectedModCount && i < size; i++) { @SuppressWarnings("unchecked") final E element = (E) elementData[i]; //依次判断集合元素是否符合过滤规则 if (filter.test(element)) { //set 方法将导致索引位置 i 的元素变为 true removeSet.set(i); removeCount++; } } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } //只有 removeCount > 0 才说明需要移除元素 final boolean anyToRemove = removeCount > 0; if (anyToRemove) { //集合移除指定元素后的大小 final int newSize = size - removeCount; for (int i=0, j=0; (i < size) && (j < newSize); i++, j++) { //略过被标记为 true 的位置,直接跳到不需要移除元素的数组索引位 i = removeSet.nextClearBit(i); //有效数据逐渐从尾部向头部聚集 elementData[j] = elementData[i]; } //移除尾部的无效数据,帮助GC回收 for (int k=newSize; k < size; k++) { elementData[k] = null; } this.size = newSize; if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } modCount++; } return anyToRemove; } //将集合元素遍历传递给 operator,并将原始数据替换为 operator 的返回值 @Override @SuppressWarnings("unchecked") public void replaceAll(UnaryOperator<E> operator) { Objects.requireNonNull(operator); final int expectedModCount = modCount; final int size = this.size; for (int i=0; modCount == expectedModCount && i < size; i++) { //依次传递数组元素给 apply 方法,并将其返回值替换原始数据 elementData[i] = operator.apply((E) elementData[i]); } //不允许在排序的过程中集合被其它方法修改了数据结构(例如:移除元素) if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } modCount++; } 迭代器 在这里有个小细节,ArrayList 里多处使用到了 modCount 这个参数,每当集合的结构发生变化时,modCount 就会递增,当在对集合进行迭代操作时,迭代器会检查此参数值,如果检查到此参数的值发生变化,就说明在迭代的过程中集合的结构发生了变化,此时迭代的元素可能就并不是最新的了,因此会直接抛出异常 //返回集合迭代器 public Iterator<E> iterator() { return new Itr(); } //一个优化版本的迭代器 private class Itr implements Iterator<E> { //lastRet 指向的元素的下一个元素的索引 int cursor; //最后一个返回的元素的索引 //如果值为 -1,说明还未返回过元素或者改元素被移除了 int lastRet = -1; //用于验证集合的数据结构在迭代的过程中是否被修改了 int expectedModCount = modCount; //是否还有元素未被遍历 public boolean hasNext() { return cursor != size; } //获取下一个元素 @SuppressWarnings("unchecked") public E next() { checkForComodification(); int i = cursor; //如果索引值超出集合的可索引范围则抛出异常 if (i >= size) throw new NoSuchElementException(); Object[] elementData = ArrayList.this.elementData; //如果索引值超出数组的可索引范围则抛出异常 if (i >= elementData.length) throw new ConcurrentModificationException(); //游标递增 cursor = i + 1; return (E) elementData[lastRet = i]; } //移除 lastRet 位置的元素 public void remove() { if (lastRet < 0) throw new IllegalStateException(); checkForComodification(); try { ArrayList.this.remove(lastRet); //因为 lastRet 位置原始的元素被移除了,所以此时 lastRet 指向的元素是原先 lastRet+1 位置的元素 cursor = lastRet; lastRet = -1; //因为是 Itr 主动对集合进行修改,所以此处需要主动更新 expectedModCount 值,避免之后抛出异常 expectedModCount = modCount; } catch (IndexOutOfBoundsException ex) { throw new ConcurrentModificationException(); } } //遍历集合从索引 cursor 开始之后剩下的元素 @Override @SuppressWarnings("unchecked") public void forEachRemaining(Consumer<? super E> consumer) { Objects.requireNonNull(consumer); final int size = ArrayList.this.size; int i = cursor; if (i >= size) { return; } final Object[] elementData = ArrayList.this.elementData; if (i >= elementData.length) { throw new ConcurrentModificationException(); } //遍历调用 accept 方法 while (i != size && modCount == expectedModCount) { consumer.accept((E) elementData[i++]); } cursor = i; lastRet = i - 1; checkForComodification(); } //判断迭代器在遍历集合的过程中,集合是否被外部改动了(例如被其它迭代器移除了元素) //如果是的话则抛出异常 final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); } } 效率测试 最后来测试下 ArrayList 扩容次数的高低对其运行效率的影响 对三个 ArrayList 存入相同数据量的数据,但分别为 ArrayList 指定不同的初始化大小 public static void main(String[] args) { //开始时间 long startTime = System.currentTimeMillis(); List<String> stringList = new ArrayList<>(); for (int i = 0; i < 300000; i++) { stringList.add("leavesC " + i); } //结束时间 long endTime = System.currentTimeMillis(); System.out.println("不指定初始大小,所用时间:" + (endTime - startTime) + "毫秒"); //开始时间 startTime = System.currentTimeMillis(); List<String> stringList2 = new ArrayList<>(100000); for (int i = 0; i < 300000; i++) { stringList2.add("leavesC " + i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("指定初始大小为目标数据量的三分之一,所用时间:" + (endTime - startTime)+ "毫秒"); //开始时间 startTime = System.currentTimeMillis(); List<String> stringList3 = new ArrayList<>(300000); for (int i = 0; i < 300000; i++) { stringList3.add("leavesC " + i); } //结束时间 endTime = System.currentTimeMillis(); System.out.println("指定初始大小为目标数据量,所用时间:" + (endTime - startTime)+ "毫秒"); } 可以看出来,各种方式之间的运行效率差距还是很大的 关于 ArrayList 的内容就讲到这里了,一方面是篇幅所限,一方面我是觉得很多知识点其实也不需要怎么讲,直接看源码的话认知会更为深刻一点,因此我也把对 ArrayList 的详细源码注释开源到了 GitHub 上,欢迎关注 源码地址:Java_Android_Learn