首页 文章 精选 留言 我的

精选列表

搜索[openharmony],共389篇文章
优秀的个人博客,低调大师

v84.01 鸿蒙内核源码分析(TLFS算法篇) | 图表解读TLFS原理 | 百篇博客分析OpenHarmony源码

本篇关键词:TLFS 、内存池 、malloc、free 内存管理相关篇为: v31.02 鸿蒙内核源码分析(内存规则) | 内存管理到底在管什么 v32.04 鸿蒙内核源码分析(物理内存) | 真实的可不一定精彩 v33.04 鸿蒙内核源码分析(虚拟内存) | 虚拟的也是真实的 v34.03 鸿蒙内核源码分析(虚实映射) | 映射是伟大的发明 v35.02 鸿蒙内核源码分析(页表管理) | 映射关系保存在哪 v36.03 鸿蒙内核源码分析(静态分配) | 很简单的一位小朋友 v37.01 鸿蒙内核源码分析(TLFS算法) | 用图解读TLFS原理 v38.01 鸿蒙内核源码分析(内存池管理) | 如何高效切割合并内存块 v39.04 鸿蒙内核源码分析(原子操作) | 谁在守护指令执行的完整性 v40.01 鸿蒙内核源码分析(圆整对齐) | 正在制作中 ... 动态分配 本篇开始说一个耳朵听起老茧的概念 动态分配,将分成上下两篇,本篇为上篇,看完能快速理解下篇鸿蒙内核源码对动态内存的具体实现。 鸿蒙内核源码分析(TLFS算法) 结合图表从理论视角说清楚 TLFS 算法 鸿蒙内核源码分析(内存池管理) 结合源码说清楚鸿蒙内核动态内存池实现过程,个人认为这部分代码很精彩,简洁高效,尤其对空闲节点和已使用节点的实现令人称奇。 TLFS 原理 TLSF(Two-Level Segregate Fit) 是一种用于实时操作系统的内存分配算法,用两级结构对空闲块按大小进行划分,采用两级链表/索引的方式来加快查找。详细可查看 >> TLSF 论文 。 把上图看懂基本能明白 TLFS 的原理,请尝试自己先理解一遍再看本篇。 解读 为方便理解 ,将上图做成(表一),中间过程请查看图表变化 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 右边为第一级链表 First List (简称fl)。将空闲内存块的大小根据2的幂进行分类,如(32、64、128、...), 这跟伙伴算法很类似,伙伴算法是物理内存的分配算法,这样做的好处是防止外部碎片化,是否空闲用位图标识 FL_bitmap | 一维数组,0011代表 [32-64]、[64-128]这个区间有内存可以申请,例如: malloc(37) 时,查到在区间[32-64]中,为 1代表本次可能可以申请到内存,但具体行不行得进入第二级查看。 中间为第二级链表 Second List (简称sl)。第二层链表在第一层的基础上,按照一定的间隔,线性分段,图中将其分成 8等份,对于[32-64]来说 1/8为4,对于[64 - 128]来说 1/8为8,可以确定的是等份也是2的倍数,同样是否空闲用位图标识SL_bitmaps[] | 二维数组 ,每个bit代表是否空闲,图中代表 [36 - 39]有内存可供分配,再查看其空闲链表发现真正可供分配的空间有两块,38 和 36,自然将 38 给 malloc(37) 返回,此时空闲链表中还剩36节点 ,所以 一二级位图数据不会有任何的变化。 左边为空闲链表块,上面挂fl,sl都为1时的空闲内存块,块大小为区间范围值,图中有两个空闲块 38b --> 36b,109b --> 104b,在实际运行过程往往出现同样大小的内存块例如38b --> 36b--> 36b 申请过程 用二次申请说明详细过程 malloc(37) ,发现值在区间[32-64]并对应fl的位图为1,说明sl中肯定会有一个1,但并不能保证能申请到。得细看第二步sl发现区间[36 - 39]的位图为1,说明空闲链表中肯定会有一块内存,,但也不能保证大小适合37。再看最后一步,发现有两块内存38b --> 36b,只有38b符合,于是**malloc(37)**的结果是获得了一块大小38b的内存块,相差的一个 1b称为内部碎片,这种碎片无法避免。将(表一)更新为(表二) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) malloc(50),同样落在[32-64]查看fl的位图为1,查看第二步sl只有[36 - 39]的位图为1,而 50 > 39,不能满足所以没必要看第三步,得返回第一步往上走发现[64-128]的fl的位图为1,50 < 64 说明 malloc(50) 这次肯定能申请到内存了,查看[64-128]对应的sl发现[104-111]的位图为1,到第三步发现有109b --> 104b两块,选择其中更小104b的块切割成50,54两小块,此时要对54处理挂入空闲链表,54处于fl = [32-64], sl = [52-55]区间,地址为: 0x6838+50=0x686A 。所以将[52-55]区间位图置为1,并挂入空闲链表。将(表二)更新为(表三) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 注意此时[32-64]的二级位图变成了 00100010 有两个1 释放过程 同样用二次释放说明详细过程 free(0x3457) 从地址可知正是上面的 malloc(37)的内存,与分配切割相对应的是释放有合并的步骤,但malloc(37)虽然申请是37,但其实内核记录的内存块大小是38,所以会找寻地址为 0x3457 + 38 = 0x348F 的地址是否也处于空闲,如果是则合并,由表三可知 并没有 0x348F的空闲块将,而38位于fl = [32-64],sl = [36-39]区间,所以挂回该空闲链表等待后续再分配使用,由此(表三)更新为(表四) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 第四步 free(0x3457) 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625)<br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) free(0x5610) 这里假设内核记录该内存块大小为 0x15,归还的同时会找寻0x5610 + 0x15 = 0x5625 是否有空闲块,发现sl = [104-111]有一块109b空闲块,两块合成一块大小为 109 + 0x15 = 109 + 21 = 130,位于fl = [128-255],sl = [128-143]区间,由此(表四)再更新为(表五) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 第四步 free(0x3457) 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625)<br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) 第五步 free(0x5610) 0101 00000000<br>00000001<br>00000000<br>00100010 130b(0x5610) <br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) 总结 TLSF(Two-Level Segregate Fit) 有两大优点: 实时性,执行速度快,只需查询位图就能知道结果,最多查询两次一级位图,时间复杂度为O(1)。 碎片少,浪费少,利用率高,因采用2次幂的方式,切割和合并非常的方便,很少出现外部碎片。 真正的鸿蒙内存动态分配实现过程比这些要复杂些,但有了本文算法基础做铺垫看源码实现会容易很多。 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 >> 双向链表 | 内核概念 | 源码结构 | 地址空间 | 计时单位 | 宏的使用 | 钩子框架 | 位图管理 | POSIX | main函数 | 进程管理 >> 调度故事 | 进程控制块 | 进程空间 | 线性区 | 红黑树 | 进程管理 | Fork进程 | 进程回收 | Shell编辑 | Shell解析 | 任务管理 >> 任务控制块 | 并发并行 | 就绪队列 | 调度机制 | 任务管理 | 用栈方式 | 软件定时器 | 控制台 | 远程登录 | 协议栈 | 内存管理 >> 内存规则 | 物理内存 | 虚拟内存 | 虚实映射 | 页表管理 | 静态分配 | TLFS算法 | 内存池管理 | 原子操作 | 圆整对齐 | 通讯机制 >> 通讯总览 | 自旋锁 | 互斥锁 | 快锁使用 | 快锁实现 | 读写锁 | 信号量 | 事件机制 | 信号生产 | 信号消费 | 消息队列 | 消息封装 | 消息映射 | 共享内存 | 文件系统 >> 文件概念 | 文件故事 | 索引节点 | VFS | 文件句柄 | 根文件系统 | 挂载机制 | 管道文件 | 文件映射 | 写时拷贝 | 硬件架构 >> 芯片模式 | ARM架构 | 指令集 | 协处理器 | 工作模式 | 寄存器 | 多核管理 | 中断概念 | 中断管理 | 内核汇编 >> 编码方式 | 汇编基础 | 汇编传参 | 可变参数 | 开机启动 | 进程切换 | 任务切换 | 中断切换 | 异常接管 | 缺页中断 | 编译运行 >> 编译过程 | 编译构建 | GN语法 | 忍者无敌 | ELF格式 | ELF解析 | 静态链接 | 重定位 | 动态链接 | 进程映像 | 应用启动 | 系统调用 | VDSO | 调测工具 >> 模块监控 | 日志跟踪 | 系统安全 | 测试用例 | 前因后果 >> 总目录 | 源码注释 | 静态站点 | 参考手册 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:)

优秀的个人博客,低调大师

v37.01 鸿蒙内核源码分析(TLFS算法篇) | 图表解读TLFS原理 | 百篇博客分析OpenHarmony源码

本篇关键词:TLFS 、内存池 、malloc、free 内存管理相关篇为: v31.02 鸿蒙内核源码分析(内存规则) | 内存管理到底在管什么 v32.04 鸿蒙内核源码分析(物理内存) | 真实的可不一定精彩 v33.04 鸿蒙内核源码分析(虚拟内存) | 虚拟的也是真实的 v34.03 鸿蒙内核源码分析(虚实映射) | 映射是伟大的发明 v35.02 鸿蒙内核源码分析(页表管理) | 映射关系保存在哪 v36.03 鸿蒙内核源码分析(静态分配) | 很简单的一位小朋友 v37.01 鸿蒙内核源码分析(TLFS算法) | 用图解读TLFS原理 v38.01 鸿蒙内核源码分析(内存池管理) | 如何高效切割合并内存块 v39.04 鸿蒙内核源码分析(原子操作) | 谁在守护指令执行的完整性 v40.01 鸿蒙内核源码分析(圆整对齐) | 正在制作中 ... 动态分配 本篇开始说一个耳朵听起老茧的概念 动态分配,将分成上下两篇,本篇为上篇,看完能快速理解下篇鸿蒙内核源码对动态内存的具体实现。 鸿蒙内核源码分析(TLFS算法) 结合图表从理论视角说清楚 TLFS 算法 鸿蒙内核源码分析(内存池管理) 结合源码说清楚鸿蒙内核动态内存池实现过程,个人认为这部分代码很精彩,简洁高效,尤其对空闲节点和已使用节点的实现令人称奇。 TLFS 原理 TLSF(Two-Level Segregate Fit) 是一种用于实时操作系统的内存分配算法,用两级结构对空闲块按大小进行划分,采用两级链表/索引的方式来加快查找。详细可查看 >> TLSF 论文 。 把上图看懂基本能明白 TLFS 的原理,请尝试自己先理解一遍再看本篇。 解读 为方便理解 ,将上图做成(表一),中间过程请查看图表变化 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 右边为第一级链表 First List (简称fl)。将空闲内存块的大小根据2的幂进行分类,如(32、64、128、...), 这跟伙伴算法很类似,伙伴算法是物理内存的分配算法,这样做的好处是防止外部碎片化,是否空闲用位图标识 FL_bitmap | 一维数组,0011代表 [32-64]、[64-128]这个区间有内存可以申请,例如: malloc(37) 时,查到在区间[32-64]中,为 1代表本次可能可以申请到内存,但具体行不行得进入第二级查看。 中间为第二级链表 Second List (简称sl)。第二层链表在第一层的基础上,按照一定的间隔,线性分段,图中将其分成 8等份,对于[32-64]来说 1/8为4,对于[64 - 128]来说 1/8为8,可以确定的是等份也是2的倍数,同样是否空闲用位图标识SL_bitmaps[] | 二维数组 ,每个bit代表是否空闲,图中代表 [36 - 39]有内存可供分配,再查看其空闲链表发现真正可供分配的空间有两块,38 和 36,自然将 38 给 malloc(37) 返回,此时空闲链表中还剩36节点 ,所以 一二级位图数据不会有任何的变化。 左边为空闲链表块,上面挂fl,sl都为1时的空闲内存块,块大小为区间范围值,图中有两个空闲块 38b --> 36b,109b --> 104b,在实际运行过程往往出现同样大小的内存块例如38b --> 36b--> 36b 申请过程 用二次申请说明详细过程 malloc(37) ,发现值在区间[32-64]并对应fl的位图为1,说明sl中肯定会有一个1,但并不能保证能申请到。得细看第二步sl发现区间[36 - 39]的位图为1,说明空闲链表中肯定会有一块内存,,但也不能保证大小适合37。再看最后一步,发现有两块内存38b --> 36b,只有38b符合,于是**malloc(37)**的结果是获得了一块大小38b的内存块,相差的一个 1b称为内部碎片,这种碎片无法避免。将(表一)更新为(表二) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) malloc(50),同样落在[32-64]查看fl的位图为1,查看第二步sl只有[36 - 39]的位图为1,而 50 > 39,不能满足所以没必要看第三步,得返回第一步往上走发现[64-128]的fl的位图为1,50 < 64 说明 malloc(50) 这次肯定能申请到内存了,查看[64-128]对应的sl发现[104-111]的位图为1,到第三步发现有109b --> 104b两块,选择其中更小104b的块切割成50,54两小块,此时要对54处理挂入空闲链表,54处于fl = [32-64], sl = [52-55]区间,地址为: 0x6838+50=0x686A 。所以将[52-55]区间位图置为1,并挂入空闲链表。将(表二)更新为(表三) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 注意此时[32-64]的二级位图变成了 00100010 有两个1 释放过程 同样用二次释放说明详细过程 free(0x3457) 从地址可知正是上面的 malloc(37)的内存,与分配切割相对应的是释放有合并的步骤,但malloc(37)虽然申请是37,但其实内核记录的内存块大小是38,所以会找寻地址为 0x3457 + 38 = 0x348F 的地址是否也处于空闲,如果是则合并,由表三可知 并没有 0x348F的空闲块将,而38位于fl = [32-64],sl = [36-39]区间,所以挂回该空闲链表等待后续再分配使用,由此(表三)更新为(表四) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 第四步 free(0x3457) 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625)<br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) free(0x5610) 这里假设内核记录该内存块大小为 0x15,归还的同时会找寻0x5610 + 0x15 = 0x5625 是否有空闲块,发现sl = [104-111]有一块109b空闲块,两块合成一块大小为 109 + 0x15 = 109 + 21 = 130,位于fl = [128-255],sl = [128-143]区间,由此(表四)再更新为(表五) 步骤 操作 一级位图 (FL_bitmap) 二级位图 (SL_bitmaps[]) 空闲链表(大小-虚拟地址) 第一步 初始阶段 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 38b(0x3457) --> 36b(0xed31) 第二步 malloc(37)<br>返回地址0x3457 0011 00000000<br>00000000<br>00100000<br>00000010 109b(0x5625) --> 104b(0x6838) <br> 36b(0xed31) 第三步 malloc(50)<br>返回地址0x6838 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625) <br> 54b(0x686A) <br> 36b(0xed31) 第四步 free(0x3457) 0011 00000000<br>00000000<br>00100000<br>00100010 109b(0x5625)<br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) 第五步 free(0x5610) 0101 00000000<br>00000001<br>00000000<br>00100010 130b(0x5610) <br> 54b(0x686A) <br> 38b(0x3457) --> 36b(0xed31) 总结 TLSF(Two-Level Segregate Fit) 有两大优点: 实时性,执行速度快,只需查询位图就能知道结果,最多查询两次一级位图,时间复杂度为O(1)。 碎片少,浪费少,利用率高,因采用2次幂的方式,切割和合并非常的方便,很少出现外部碎片。 真正的鸿蒙内存动态分配实现过程比这些要复杂些,但有了本文算法基础做铺垫看源码实现会容易很多。 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 >> 双向链表 | 内核概念 | 源码结构 | 地址空间 | 计时单位 | 宏的使用 | 钩子框架 | 位图管理 | POSIX | main函数 | 进程管理 >> 调度故事 | 进程控制块 | 进程空间 | 线性区 | 红黑树 | 进程管理 | Fork进程 | 进程回收 | Shell编辑 | Shell解析 | 任务管理 >> 任务控制块 | 并发并行 | 就绪队列 | 调度机制 | 任务管理 | 用栈方式 | 软件定时器 | 控制台 | 远程登录 | 协议栈 | 内存管理 >> 内存规则 | 物理内存 | 虚拟内存 | 虚实映射 | 页表管理 | 静态分配 | TLFS算法 | 内存池管理 | 原子操作 | 圆整对齐 | 通讯机制 >> 通讯总览 | 自旋锁 | 互斥锁 | 快锁使用 | 快锁实现 | 读写锁 | 信号量 | 事件机制 | 信号生产 | 信号消费 | 消息队列 | 消息封装 | 消息映射 | 共享内存 | 文件系统 >> 文件概念 | 文件故事 | 索引节点 | VFS | 文件句柄 | 根文件系统 | 挂载机制 | 管道文件 | 文件映射 | 写时拷贝 | 硬件架构 >> 芯片模式 | ARM架构 | 指令集 | 协处理器 | 工作模式 | 寄存器 | 多核管理 | 中断概念 | 中断管理 | 内核汇编 >> 编码方式 | 汇编基础 | 汇编传参 | 可变参数 | 开机启动 | 进程切换 | 任务切换 | 中断切换 | 异常接管 | 缺页中断 | 编译运行 >> 编译过程 | 编译构建 | GN语法 | 忍者无敌 | ELF格式 | ELF解析 | 静态链接 | 重定位 | 动态链接 | 进程映像 | 应用启动 | 系统调用 | VDSO | 调测工具 >> 模块监控 | 日志跟踪 | 系统安全 | 测试用例 | 前因后果 >> 总目录 | 源码注释 | 静态站点 | 参考手册 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:)
优秀的个人博客,低调大师

v72.01 鸿蒙内核源码分析(Shell解析篇) | 应用窥伺内核的窗口 | 百篇博客分析OpenHarmony源码

子曰:“苟正其身矣,于从政乎何有?不能正其身,如正人何?” 《论语》:子路篇 百篇博客系列篇.本篇为: v72.xx 鸿蒙内核源码分析(Shell解析篇) | 应用窥视内核的窗口 进程管理相关篇为: v02.06 鸿蒙内核源码分析(进程管理) | 谁在管理内核资源 v24.03 鸿蒙内核源码分析(进程概念) | 如何更好的理解进程 v45.05 鸿蒙内核源码分析(Fork) | 一次调用 两次返回 v46.05 鸿蒙内核源码分析(特殊进程) | 老鼠生儿会打洞 v47.02 鸿蒙内核源码分析(进程回收) | 临终托孤的短命娃 v48.05 鸿蒙内核源码分析(信号生产) | 年过半百 活力十足 v49.03 鸿蒙内核源码分析(信号消费) | 谁让CPU连续四次换栈运行 v71.03 鸿蒙内核源码分析(Shell编辑) | 两个任务 三个阶段 v72.01 鸿蒙内核源码分析(Shell解析) | 应用窥伺内核的窗口 系列篇从内核视角用一句话概括shell的底层实现为:两个任务,三个阶段。其本质是独立进程,因而划到进程管理模块。每次创建shell进程都会再创建两个任务。 客户端任务(ShellEntry): 负责接受来自终端(控制台)敲入的一个个字符,字符按VT规范组装成一句句的命令。 服务端任务(ShellTask): 对命令进行解析并执行,将结果输出到控制台。 而按命令生命周期可分三个阶段. 编辑: 鸿蒙在这个部分实现了一个简单的编辑器功能,处理控制台输入的每个字符,主要包括了对控制字符 例如 <ESC>,\t,\b,\n,\r,四个方向键0x41 ~ 0x44 的处理。 解析: 对编辑后的字符串进行解析,解析出命令项和参数项,找到对应的命令项执行函数。 执行: 命令可通过静态和动态两种方式注册到内核,解析出具体命令后在注册表中找到对应函数回调。将结果输出到控制台。 编辑部分由客户端任务完成,后两个部分由服务端任务完成,命令全局注册由内核完成。 本篇主要说 服务端任务 和 解析/执行过程. 客户端任务 和 编辑过程 已在(Shell编辑篇)中说明,请自行翻看. 总体过程 第一步: 将支持的shell命令注册进全局链表,支持静态和动态两种方式,内容包括命令项,参数信息和回调函数. 第二步: 由独立任务解析出用户输入的命令行,拆分出命令项和参数内容 第三步: 通过命令项在全局链表中遍历找到已注册的回调函数,并执行. 结构体 鸿蒙对命令的注册用了三个结构体,个人感觉前两个可以合成一个,降低代码阅读难度. STATIC CmdModInfo g_cmdInfo;//shell 命令模块信息,上面挂了所有的命令项(ls,cd ,cp ==) typedef struct {//命令项 CmdType cmdType; //命令类型 //CMD_TYPE_EX:不支持标准命令参数输入,会把用户填写的命令关键字屏蔽掉,例如:输入ls /ramfs,传入给注册函数的参数只有/ramfs,而ls命令关键字并不会被传入。 //CMD_TYPE_STD:支持的标准命令参数输入,所有输入的字符都会通过命令解析后被传入。 const CHAR *cmdKey; //命令关键字,例如:ls 函数在Shell中访问的名称。 UINT32 paraNum; //调用的执行函数的入参最大个数,暂不支持。 CmdCallBackFunc cmdHook;//命令执行函数地址,即命令实际执行函数。 } CmdItem; typedef struct { //命令节点 LOS_DL_LIST list; //双向链表 CmdItem *cmd; //命令项 } CmdItemNode; /* global info for shell module */ typedef struct {//shell 模块的全局信息 CmdItemNode cmdList; //命令项节点 UINT32 listNum;//节点数量 UINT32 initMagicFlag;//初始魔法标签 0xABABABAB LosMux muxLock; //操作链表互斥锁 CmdVerifyTransID transIdHook;//暂不知何意 } CmdModInfo; 解读 CmdItem为注册的内容载体结构体,cmdHook为回调函数,是命令的真正执行体. 通过双向链表CmdItemNode.list将所有命令穿起来 CmdModInfo记录命令数量和操作的互斥锁,shell的魔法数字为 0xABABABAB 第一步 | Shell 注册 静态宏方式注册,链接时处理 静态注册命令方式一般用在系统常用命令注册,鸿蒙已支持以下命令. arp cat cd chgrp chmod chown cp cpup date dhclient dmesg dns format free help hwi ifconfig ipdebug kill log ls lsfd memcheck mkdir mount netstat oom partinfo partition ping ping6 pwd reset rm rmdir sem statfs su swtmr sync systeminfo task telnet test tftp touch umount uname watch writeproc 例如注册 ls命令 SHELLCMD_ENTRY(ls_shellcmd, CMD_TYPE_EX, "ls", XARGS, (CMD_CBK_FUNC)osShellCmdLs) 需在链接选项中添加链接该新增命令项参数,具体在liteos_tables_ldflags.mk文件的LITEOS_TABLES_LDFLAGS项下添加-uls_shellcmd。至于SHELLCMD_ENTRY是如何实现的在链接阶段的注册,请自行翻看(内联汇编篇),有详细说明实现细节. 动态命令方式,运行时处理 动态注册命令方式一般用在用户命令注册,具体实现代码如下: osCmdReg(CMD_TYPE_EX, "ls", XARGS, (CMD_CBK_FUNC)osShellCmdLs) { // .... //5.正式创建命令,挂入链表 return OsCmdItemCreate(cmdType, cmdKey, paraNum, cmdProc);//不存在就注册命令 } //创建一个命令项,例如 chmod STATIC UINT32 OsCmdItemCreate(CmdType cmdType, const CHAR *cmdKey, UINT32 paraNum, CmdCallBackFunc cmdProc) { CmdItem *cmdItem = NULL; CmdItemNode *cmdItemNode = NULL; //1.构造命令节点过程 cmdItem = (CmdItem *)LOS_MemAlloc(m_aucSysMem0, sizeof(CmdItem)); if (cmdItem == NULL) { return OS_ERRNO_SHELL_CMDREG_MEMALLOC_ERROR; } (VOID)memset_s(cmdItem, sizeof(CmdItem), '\0', sizeof(CmdItem)); cmdItemNode = (CmdItemNode *)LOS_MemAlloc(m_aucSysMem0, sizeof(CmdItemNode)); if (cmdItemNode == NULL) { (VOID)LOS_MemFree(m_aucSysMem0, cmdItem); return OS_ERRNO_SHELL_CMDREG_MEMALLOC_ERROR; } (VOID)memset_s(cmdItemNode, sizeof(CmdItemNode), '\0', sizeof(CmdItemNode)); cmdItemNode->cmd = cmdItem; //命令项 cmdItemNode->cmd->cmdHook = cmdProc;//回调函数 osShellCmdLs cmdItemNode->cmd->paraNum = paraNum;//`777`,'/home' cmdItemNode->cmd->cmdType = cmdType;//关键字类型 cmdItemNode->cmd->cmdKey = cmdKey; //`chmod` //2.完成构造后挂入全局链表 (VOID)LOS_MuxLock(&g_cmdInfo.muxLock, LOS_WAIT_FOREVER); OsCmdAscendingInsert(cmdItemNode);//按升序方式插入 g_cmdInfo.listNum++;//命令总数增加 (VOID)LOS_MuxUnlock(&g_cmdInfo.muxLock); return LOS_OK; } 第二步 解析 | ShellTask //shell 服务端任务初始化,这个任务负责解析和执行命令 LITE_OS_SEC_TEXT_MINOR UINT32 ShellTaskInit(ShellCB *shellCB) { CHAR *name = NULL; TSK_INIT_PARAM_S initParam = {0}; //输入Shell命令的两种方式 if (shellCB->consoleID == CONSOLE_SERIAL) { //通过串口工具 name = SERIAL_SHELL_TASK_NAME; } else if (shellCB->consoleID == CONSOLE_TELNET) {//通过远程工具 name = TELNET_SHELL_TASK_NAME; } else { return LOS_NOK; } initParam.pfnTaskEntry = (TSK_ENTRY_FUNC)ShellTask;//任务入口函数,主要是解析shell命令 initParam.usTaskPrio = 9; /* 9:shell task priority */ initParam.auwArgs[0] = (UINTPTR)shellCB; initParam.uwStackSize = 0x3000; initParam.pcName = name; initParam.uwResved = LOS_TASK_STATUS_DETACHED; (VOID)LOS_EventInit(&shellCB->shellEvent);//初始化事件,以事件方式通知任务解析命令 return LOS_TaskCreate(&shellCB->shellTaskHandle, &initParam);//创建任务 } LITE_OS_SEC_TEXT_MINOR UINT32 ShellTask(UINTPTR param1, UINTPTR param2, UINTPTR param3, UINTPTR param4) { UINT32 ret; ShellCB *shellCB = (ShellCB *)param1; (VOID)param2; (VOID)param3; (VOID)param4; while (1) { PRINTK("\nOHOS # ");//读取shell 输入事件 例如: cat weharmony.net 命令 ret = LOS_EventRead(&shellCB->shellEvent, 0xFFF, LOS_WAITMODE_OR | LOS_WAITMODE_CLR, LOS_WAIT_FOREVER); if (ret == SHELL_CMD_PARSE_EVENT) {//获得解析命令事件 ShellCmdProcess(shellCB);//处理命令 } else if (ret == CONSOLE_SHELL_KEY_EVENT) {//退出shell事件 break; } } OsShellKeyDeInit((CmdKeyLink *)shellCB->cmdKeyLink);// OsShellKeyDeInit((CmdKeyLink *)shellCB->cmdHistoryKeyLink); (VOID)LOS_EventDestroy(&shellCB->shellEvent);//注销事件 (VOID)LOS_MemFree((VOID *)m_aucSysMem0, shellCB);//释放shell控制块 return 0; } 解读 任务优先级和 客户端任务 一样同为 9 指定内核栈大小为0x3000 = 12K ,因任务负责命令的解析和执行,所以需要更大的内核空间. 任务的入口函数ShellTask,一个死循环在以LOS_WAIT_FOREVER方式死等事件发生. SHELL_CMD_PARSE_EVENT 通知开始解析事件,该事件由 客户端任务ShellEntry检测到回车键时发出. STATIC VOID ShellNotify(ShellCB *shellCB) { (VOID)LOS_EventWrite(&shellCB->shellEvent, SHELL_CMD_PARSE_EVENT); } CONSOLE_SHELL_KEY_EVENT 收到 exit命令时将发出该事件,退出shell回收资源 鸿蒙内核是如何管理和使用事件的请自行翻看(事件控制篇) 层层跟进ShellCmdProcess,解析出命令项和参数内容,最终跑到OsCmdExec中遍历 已注册的命令表,找出命令对应的函数完成回调. LITE_OS_SEC_TEXT_MINOR UINT32 OsCmdExec(CmdParsed *cmdParsed, CHAR *cmdStr) { UINT32 ret; CmdCallBackFunc cmdHook = NULL; CmdItemNode *curCmdItem = NULL; UINT32 i; const CHAR *cmdKey = NULL; if ((cmdParsed == NULL) || (cmdStr == NULL) || (strlen(cmdStr) == 0)) { return (UINT32)OS_ERROR; } ret = OsCmdParse(cmdStr, cmdParsed);//解析出命令关键字,参数 if (ret != LOS_OK) { goto OUT; } //遍历命令注册全局链表 LOS_DL_LIST_FOR_EACH_ENTRY(curCmdItem, &(g_cmdInfo.cmdList.list), CmdItemNode, list) { cmdKey = curCmdItem->cmd->cmdKey; if ((cmdParsed->cmdType == curCmdItem->cmd->cmdType) && (strlen(cmdKey) == strlen(cmdParsed->cmdKeyword)) && (strncmp(cmdKey, (CHAR *)(cmdParsed->cmdKeyword), strlen(cmdKey)) == 0)) {//找到命令的回调函数 例如: ls <-> osShellCmdLs cmdHook = curCmdItem->cmd->cmdHook; break; } } ret = OS_ERROR; if (cmdHook != NULL) {//执行命令,即回调函数 ret = (cmdHook)(cmdParsed->paramCnt, (const CHAR **)cmdParsed->paramArray); } OUT: for (i = 0; i < cmdParsed->paramCnt; i++) {//无效的命令要释放掉保存参数的内存 if (cmdParsed->paramArray[i] != NULL) { (VOID)LOS_MemFree(m_aucSysMem0, cmdParsed->paramArray[i]); cmdParsed->paramArray[i] = NULL; } } return (UINT32)ret; } 第三步 | 执行 想知道有哪些系统shell命令,可以搜索关键词SHELLCMD_ENTRY拿到所有通过静态方式注册的命令. 其中有网络的,进程的,任务的,内存的 等等,此处列出几个常用的shell命令的实现. ls 命令 SHELLCMD_ENTRY(ls_shellcmd, CMD_TYPE_EX, "ls", XARGS, (CmdCallBackFunc)osShellCmdLs); /******************************************************* 命令功能 ls命令用来显示当前目录的内容。 命令格式 ls [path] path为空时,显示当前目录的内容。 path为无效文件名时,显示失败,提示: ls error: No such directory。 path为有效目录路径时,会显示对应目录下的内容。 使用指南 ls命令显示当前目录的内容。 ls可以显示文件的大小。 proc下ls无法统计文件大小,显示为0。 *******************************************************/ int osShellCmdLs(int argc, const char **argv) { char *fullpath = NULL; const char *filename = NULL; int ret; char *shell_working_directory = OsShellGetWorkingDirtectory();//获取当前工作目录 if (shell_working_directory == NULL) { return -1; } ERROR_OUT_IF(argc > 1, PRINTK("ls or ls [DIRECTORY]\n"), return -1); if (argc == 0)//木有参数时 -> #ls { ls(shell_working_directory);//执行ls 当前工作目录 return 0; } filename = argv[0];//有参数时 -> #ls ../harmony or #ls /no such file or directory ret = vfs_normalize_path(shell_working_directory, filename, &fullpath);//获取全路径,注意这里带出来fullpath,而fullpath已经在内核空间 ERROR_OUT_IF(ret < 0, set_err(-ret, "ls error"), return -1); ls(fullpath);//执行 ls 全路径 free(fullpath);//释放全路径,为啥要释放,因为fullpath已经由内核空间分配 return 0; } task 命令 SHELLCMD_ENTRY(task_shellcmd, CMD_TYPE_EX, "task", 1, (CmdCallBackFunc)OsShellCmdDumpTask); LITE_OS_SEC_TEXT_MINOR UINT32 OsShellCmdDumpTask(INT32 argc, const CHAR **argv) { UINT32 flag = 0; #ifdef LOSCFG_KERNEL_VM flag |= OS_PROCESS_MEM_INFO; #endif if (argc >= 2) { /* 2: The task shell name restricts the parameters */ goto TASK_HELP; } if (argc == 1) { if (strcmp("-a", argv[0]) == 0) { flag |= OS_PROCESS_INFO_ALL; } else if (strcmp("-i", argv[0]) == 0) { if (!OsShellShowTickRespo()) { return LOS_OK; } goto TASK_HELP; } else if (strcmp("-t", argv[0]) == 0) { if (!OsShellShowSchedParam()) { return LOS_OK; } goto TASK_HELP; } else { goto TASK_HELP; } } return OsShellCmdTskInfoGet(OS_ALL_TASK_MASK, NULL, flag); TASK_HELP: PRINTK("Unknown option: %s\n", argv[0]); PRINTK("usage: task or task -a\n"); return LOS_NOK; } cat 命令 SHELLCMD_ENTRY(cat_shellcmd, CMD_TYPE_EX, "cat", XARGS, (CmdCallBackFunc)osShellCmdCat); /***************************************************************** cat用于显示文本文件的内容。cat [pathname] cat weharmony.txt *****************************************************************/ int osShellCmdCat(int argc, const char **argv) { char *fullpath = NULL; int ret; unsigned int ca_task; struct Vnode *vnode = NULL; TSK_INIT_PARAM_S init_param; char *shell_working_directory = OsShellGetWorkingDirtectory();//显示当前目录 pwd if (shell_working_directory == NULL) { return -1; } ERROR_OUT_IF(argc != 1, PRINTK("cat [FILE]\n"), return -1); ret = vfs_normalize_path(shell_working_directory, argv[0], &fullpath);//由相对路径获取绝对路径 ERROR_OUT_IF(ret < 0, set_err(-ret, "cat error"), return -1); VnodeHold(); ret = VnodeLookup(fullpath, &vnode, O_RDONLY); if (ret != LOS_OK) { set_errno(-ret); perror("cat error"); VnodeDrop(); free(fullpath); return -1; } if (vnode->type != VNODE_TYPE_REG) { set_errno(EINVAL); perror("cat error"); VnodeDrop(); free(fullpath); return -1; } VnodeDrop(); (void)memset_s(&init_param, sizeof(init_param), 0, sizeof(TSK_INIT_PARAM_S)); init_param.pfnTaskEntry = (TSK_ENTRY_FUNC)osShellCmdDoCatShow; init_param.usTaskPrio = CAT_TASK_PRIORITY; //优先级10 init_param.auwArgs[0] = (UINTPTR)fullpath; //入口参数 init_param.uwStackSize = CAT_TASK_STACK_SIZE;//内核栈大小 init_param.pcName = "shellcmd_cat"; //任务名称 init_param.uwResved = LOS_TASK_STATUS_DETACHED | OS_TASK_FLAG_SPECIFIES_PROCESS; init_param.processID = 2; /* 2: kProcess */ //内核任务 ret = (int)LOS_TaskCreate(&ca_task, &init_param);//创建任务显示cat内容 if (ret != LOS_OK) { free(fullpath); } return ret; } 你能看明白这些命令的底层实现吗? 如果看明白了,可能会不由得发出 原来如此 的感叹! 百篇博客分析.深挖内核地基 给鸿蒙内核源码加注释过程中,整理出以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切.确实有难度,自不量力,但已经出发,回头已是不可能的了。 😛 与代码有bug需不断debug一样,文章和注解内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 按功能模块: 前因后果 基础工具 加载运行 进程管理 总目录 调度故事 内存主奴 源码注释 源码结构 静态站点 双向链表 位图管理 用栈方式 定时器 原子操作 时间管理 ELF格式 ELF解析 静态链接 重定位 进程映像 进程管理 进程概念 Fork 特殊进程 进程回收 信号生产 信号消费 Shell编辑 Shell解析 编译构建 进程通讯 内存管理 任务管理 编译环境 编译过程 环境脚本 构建工具 gn应用 忍者ninja 自旋锁 互斥锁 进程通讯 信号量 事件控制 消息队列 内存分配 内存管理 内存汇编 内存映射 内存规则 物理内存 时钟任务 任务调度 任务管理 调度队列 调度机制 线程概念 并发并行 CPU 系统调用 任务切换 文件系统 硬件架构 文件概念 文件系统 索引节点 挂载目录 根文件系统 字符设备 VFS 文件句柄 管道文件 汇编基础 汇编传参 工作模式 寄存器 异常接管 汇编汇总 中断切换 中断概念 中断管理 百万汉字注解.精读内核源码 四大码仓中文注解 . 定期同步官方代码 鸿蒙研究站( weharmonyos ) | 每天死磕一点点,原创不易,欢迎转载,请注明出处。若能支持点赞则更佳,感谢每一份支持。

优秀的个人博客,低调大师

RS485半双工通信模块驱动开发—【万物智能之开源鸿蒙OpenHarmony系统实战开发系列教程】

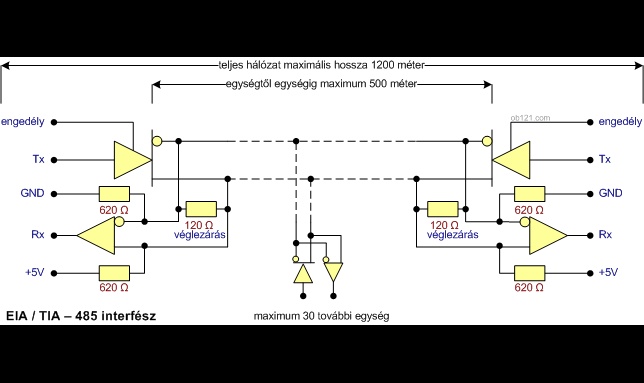
串口模块到语音为止。今天换工业现场那根差分线——RS485。半双工,单模块自发自收失败常常是正常的。半双工。单板、单模组、A/B 悬空,自发自收失败是正常的。write 返回正数只说明 UART FIFO 吃了字节。DE 有效时本地 RO 是聋的,总线上没有第二台,RX 就是空。不要当 uart 驱动 bug。三种能把 RX 做出来的办法:

优秀的个人博客,低调大师

v85.01 鸿蒙内核源码分析(内存池管理) | 如何高效切割合并内存块 | 百篇博客分析OpenHarmony源码

本篇关键词:内存池、哨兵节点、动态扩展、吃水线 内存管理相关篇为: v31.02 鸿蒙内核源码分析(内存规则) | 内存管理到底在管什么 v32.04 鸿蒙内核源码分析(物理内存) | 真实的可不一定精彩 v33.04 鸿蒙内核源码分析(虚拟内存) | 虚拟的也是真实的 v34.03 鸿蒙内核源码分析(虚实映射) | 映射是伟大的发明 v35.02 鸿蒙内核源码分析(页表管理) | 映射关系保存在哪 v36.03 鸿蒙内核源码分析(静态分配) | 很简单的一位小朋友 v37.01 鸿蒙内核源码分析(TLFS算法) | 用图解读TLFS原理 v38.01 鸿蒙内核源码分析(内存池管理) | 如何高效切割合并内存块 v39.04 鸿蒙内核源码分析(原子操作) | 谁在守护指令执行的完整性 v40.01 鸿蒙内核源码分析(圆整对齐) | 正在制作中 ... 动态分配 系列篇将动态分配分成上下两篇,本篇为下篇,阅读之前需翻看上篇偏于快速理解。 鸿蒙内核源码分析(TLFS算法) 结合图表从理论视角说清楚 TLFS 算法 鸿蒙内核源码分析(内存池管理) 结合内核源码说清楚实现过程,个人认为这部分代码很精彩,简洁高效,尤其对空闲节点和已使用节点的实现令人称奇。 为了便于理解源码,站长画了以下图,图中列出主要结构体,位图,分配和释放信息,逐一说明。 请将内存池想成一条画好了网格虚线的大白纸,会有两种角色往白纸上画东西,一个是内核画管理数据,一个外部程序画业务数据,内核先画,外部程序想画需申请大小,申请成功内核会提供个地址给外部使用,例如申请20个格子,成功后内核返回一个(5,8)坐标,表示从第五行第八列开始往后的连续20个格子你可以使用。用完了释放只需要告诉内核一个坐标(5,8)而不需要大小,内核就知道回收多少格子。但内核凭什么知道要释放多少个格子呢 ? 一定有个格子给记录下来了对不对,实际中存大小的格子坐标就是(5,7)。其值是在申请的时候或更早的时候填进去的。而且不一定是20,但一定不小于20。如果您能完全理解以上这段话,那可能已经理解了内存池的管理的方式,不用往下看了。 内存池 | OsMemPoolHead /// 内存池头信息 struct OsMemPoolHead { struct OsMemPoolInfo info; ///< 记录内存池的信息 UINT32 freeListBitmap[OS_MEM_BITMAP_WORDS]; ///< 空闲位图 int[7] = 32 * 7 = 224 struct OsMemFreeNodeHead *freeList[OS_MEM_FREE_LIST_COUNT];///< 空闲节点链表 32 + 24 * 8 = 224 SPIN_LOCK_S spinlock; ///< 操作本池的自旋锁,涉及CPU多核竞争,所以必须得是自旋锁 #ifdef LOSCFG_MEM_MUL_POOL VOID *nextPool; ///< 指向下一个内存池 OsMemPoolHead 类型 #endif }; /// 内存池信息 struct OsMemPoolInfo { VOID *pool; ///< 指向内存块基地址,仅做记录而已,真正的分配内存跟它没啥关系 UINT32 totalSize; ///< 总大小,确定了内存池的边界 UINT32 attr; ///< 属性 default attr: lock, not expand. #ifdef LOSCFG_MEM_WATERLINE UINT32 waterLine; /* Maximum usage size in a memory pool | 内存吃水线*/ UINT32 curUsedSize; /* Current usage size in a memory pool | 当前已使用大小*/ #endif }; 解读 OsMemPoolInfo.pool 是整个内存池的第一个格子,里面放的是一个内存池起始虚拟地址。 OsMemPoolInfo.totalSize 表示这张纸有多少个格子。 OsMemPoolInfo.attr 表示池子还能不能再变大。 OsMemPoolInfo.waterLine 池子水位警戒线,跟咱三峡大坝发洪水时的警戒线 175米 类似,告知上限,水一旦漫过此线就有重大风险,waterLine一词很形象,内核很多思想真来源于生活。 OsMemPoolInfo.curUsedSize 所有已分配内存大小的叠加。 freeListBitmap 空闲位图,这是tlfs算法的一二级表示,是个长度为7的整型数组 #define OS_MEM_BITMAP_WORDS ((OS_MEM_FREE_LIST_COUNT >> 5) + 1) #define OS_MEM_FREE_LIST_COUNT (OS_MEM_SMALL_BUCKET_COUNT + (OS_MEM_LARGE_BUCKET_COUNT << OS_MEM_SLI)) #define OS_MEM_LARGE_START_BUCKET 7 /// 大桶的开始下标 #define OS_MEM_SMALL_BUCKET_COUNT 31 ///< 小桶的偏移单位 从 4 ~ 124 ,共32级 #define OS_MEM_SLI 3 ///< 二级小区间级数, 这一坨坨的宏看着有点绕,简单说就是鸿蒙对申请大小分成两种情况 第一种:小桶申请** 当小于128个字节大小的需求平均分成了([0-4],[4-8],...,[124-128])共32个等级,而freeListBitmap[0]为一个UINT32,共32位刚好表示这32个等级是否有空闲块。例如: 当freeListBitmap[0] = 0b...101时,如果此时malloc(3)到来,因101对应的是12,8,4等级,而且12,4位图位为1,说明在 4的等级上有空闲内存块可以满足malloc(3),需要注意的是虽然malloc(3)但因为4等级上只有一种单位4所以malloc(3)最后实际得到的是4,而如果 malloc(7)到来时,正常需要8等级来满足,但8等级位图位为0表示没有空闲内存块,就需要向上找位图为1的12等级来申请,于是12将被分成8,4两块,8提供给malloc(7),剩下的4挂入等级为4的空闲链表上。 第二种:大桶申请** 将占用freeListBitmap的剩余6个UINT32整型变量,共可以表示32 * 6 = 192位 ,同时 192 = 24 * 8,鸿蒙将大于128个字节的申请按2次幂分成24大等级,每个等级又分成8个小等级 即 TLFS 算法 24级对应的范围为([2^7-2^8-1],[2^8-2^9-1],...,[2^30-2^31-1]) 而每大级被平均分成8小级, 例如最小的[2^7-2^8-1]将被分成每份递增 2^4 = 16 大小的八份 ([2^7-2^7+2^4],[2^7+2^4-2^7+2^4*2],...,[2^7+2^4*7-2^8-1]) 而最大的[2^30-2^31-1]将被分成每份递增 2^27 = 134 217 728大小的八份,请记住2^27这个数,后面还会说它。 ([2^30-2^30+2^27],[2^30+2^4-2^30+2^27*2],...,[2^30+2^4*7-2^31-1]) OsMemFreeNodeHead freeList[..] 是空闲链表数组,大小 224个,即每个freeListBitmap等级都对应了一个链表 /// 内存池空闲节点 struct OsMemFreeNodeHead { struct OsMemNodeHead header; ///< 内存池节点 struct OsMemFreeNodeHead *prev; ///< 前一个空闲前驱节点 struct OsMemFreeNodeHead *next; ///< 后一个空闲后继节点 }; prev,next,指向同级前后节点, 节点的内容在OsMemNodeHead中,这是一个关键结构体,需单独讲。 内存池节点 | OsMemNodeHead /// 内存池节点 struct OsMemNodeHead { UINT32 magic; ///< 魔法数字 0xABCDDCBA union {//注意这里的前后指向的是连续的地址节点,用于分割和合并 struct OsMemNodeHead *prev; /* The prev is used for current node points to the previous node | prev 用于当前节点指向前一个节点*/ struct OsMemNodeHead *next; /* The next is used for last node points to the expand node | next 用于最后一个节点指向展开节点*/ } ptr; #ifdef LOSCFG_MEM_LEAKCHECK //内存泄漏检测 UINTPTR linkReg[LOS_RECORD_LR_CNT];///< 存放左右节点地址,用于检测 #endif UINT32 sizeAndFlag; ///< 数据域大小 }; /// 已使用内存池节点 struct OsMemUsedNodeHead { struct OsMemNodeHead header;///< 已被使用节点 #if OS_MEM_FREE_BY_TASKID UINT32 taskID; ///< 使用节点的任务ID #endif }; 解读 magic 魔法数字多次提高,内核很多模块都用到了它,比如 栈顶 ,存在的意义是防止越界,栈溢出栈顶元素就一定会被修改。同理使用了大于申请的内存会导致紧挨着的内存块魔法数字被修改,从而判定为内存溢出。 出现一个联合体,其中的prev,是指向前节点的 虚拟地址 或者叫 线性地址 也可以叫 逻辑地址, 这些地址是 连续 的,注意 连续性 很重要,它是内存块合并和分割的前提,回到图中的0x1245,0x12A5,0x1305来看,三个内存块节点的地址是逻辑地址相连的,内存块节点由头体两部分组成,头部放的是该节点的信息,体是 malloc(..) 的返回地址,所以当释放 free(0xXXX) 某块内存时很容易知道本节点的起始地址是多少,但向前合并就得知道前节点prev的地址,而后节点next的地址可通过0xXXX + sizeAndFlag - 头部 = next计算得到。既然不需要next那联合体出现在的next有什么意思呢? 这个next是指该块内存的尾节点的意思,当内存池允许扩展大小时,新旧两块内存之间就会产生一个连接处,它们的线性地址是不可能连续的,所以不存在合并的问题,prev于它而言没有意义,需要记录下一个内存块的地址,这个工作就交给了联合体中的next。 一个内存池可以由多个内存块组成,每个内存块都有独立的尾节点,指向下一块内存的开始地址,最后一个内存块的尾节点也称为哨兵节点,它像个哨兵一样为整个内存池站岗,风餐露宿,固守边疆。当扩大版图之后它又跑到下一站,一个内存池只有一个哨兵,它是最可爱的人,此处应有掌声。 linkReg 用于检测内存泄漏,这部分内容在 鸿蒙内核源码分析(模块监控) 已有详细说明,此处不再赘述。 UINT32 sizeAndFlag,表示总大小 包括(头部和体部)和 标签 ,上面已经让大家记住2^27这个数,这是动态内存能分配的最大的尺寸。 UINT32 中留28位给它足以,剩下的高4位就留给Flag。每位又分别表示以下含义 #define OS_MEM_NODE_USED_FLAG 0x80000000U ///< 已使用标签 #define OS_MEM_NODE_ALIGNED_FLAG 0x40000000U ///< 对齐标签 #define OS_MEM_NODE_LAST_FLAG 0x20000000U /* Sentinel Node | 哨兵节点标签,最后一个节点*/ #define OS_MEM_NODE_ALIGNED_AND_USED_FLAG (OS_MEM_NODE_USED_FLAG | OS_MEM_NODE_ALIGNED_FLAG | OS_MEM_NODE_LAST_FLAG) 从联合体和sizeAndFlag可以看出鸿蒙的设计思想,充分利用空间,准确区分概念,一张卫生纸擦完嘴还要接着擦地,节俭之家必有余粮啊,这是非常有必要的,因为内存资源太稀缺了。在实际运行过程中,分配节点常数以万计,每个能省一个UINT32,就是一万个UINT32,约等于39KB,非常可观。 这也是为什么站长始终觉得鸿蒙是个大宝藏的原因。 OsMemUsedNodeHead.taskID已使用节点比空闲节点头部多了一个使用该节点任务的标记,由开关宏OS_MEM_FREE_BY_TASKID控制,默认是关闭的。 代码实现 有了这么长的铺垫,再来看鸿蒙内核动态内存管理的代码简直就是易如反掌,此处拆解 节点切割 ,节点合并 ,内存池扩展 三段代码。都已添加详细的注解 ,所有注解代码请前往 百万汉字注解鸿蒙内核 | kernel_liteos_a_note 仓库查看 节点切割 | OsMemSplitNode /// 切割节点 STATIC INLINE VOID OsMemSplitNode(VOID *pool, struct OsMemNodeHead *allocNode, UINT32 allocSize) { struct OsMemFreeNodeHead *newFreeNode = NULL; struct OsMemNodeHead *nextNode = NULL; newFreeNode = (struct OsMemFreeNodeHead *)(VOID *)((UINT8 *)allocNode + allocSize);//切割后出现的新空闲节点,在分配节点的右侧 newFreeNode->header.ptr.prev = allocNode;//新节点指向前节点,说明是从左到右切割 newFreeNode->header.sizeAndFlag = allocNode->sizeAndFlag - allocSize;//新空闲节点大小 allocNode->sizeAndFlag = allocSize;//分配节点大小 nextNode = OS_MEM_NEXT_NODE(&newFreeNode->header);//获取新节点的下一个节点 if (!OS_MEM_NODE_GET_LAST_FLAG(nextNode->sizeAndFlag)) {//如果下一个节点不是哨兵节点(末尾节点) nextNode->ptr.prev = &newFreeNode->header;//下一个节点的前节点为新空闲节点 if (!OS_MEM_NODE_GET_USED_FLAG(nextNode->sizeAndFlag)) {//如果下一个节点也是空闲的 OsMemFreeNodeDelete(pool, (struct OsMemFreeNodeHead *)nextNode);//删除下一个节点信息 OsMemMergeNode(nextNode);//下一个节点和新空闲节点 合并成一个新节点 } } OsMemFreeNodeAdd(pool, newFreeNode);//挂入空闲链表 } 节点合并 | OsMemMergeNode /// 合并节点,和前面的节点合并 node 消失 STATIC INLINE VOID OsMemMergeNode(struct OsMemNodeHead *node) { struct OsMemNodeHead *nextNode = NULL; node->ptr.prev->sizeAndFlag += node->sizeAndFlag; //前节点长度变长 nextNode = (struct OsMemNodeHead *)((UINTPTR)node + node->sizeAndFlag); // 下一个节点位置 if (!OS_MEM_NODE_GET_LAST_FLAG(nextNode->sizeAndFlag)) {//不是哨兵节点 nextNode->ptr.prev = node->ptr.prev;//后一个节点的前节点变成前前节点 } } 内存池扩展 /// 内存池扩展实现 STATIC INLINE INT32 OsMemPoolExpandSub(VOID *pool, UINT32 size, UINT32 intSave) { UINT32 tryCount = MAX_SHRINK_PAGECACHE_TRY; struct OsMemPoolHead *poolInfo = (struct OsMemPoolHead *)pool; struct OsMemNodeHead *newNode = NULL; struct OsMemNodeHead *endNode = NULL; size = ROUNDUP(size + OS_MEM_NODE_HEAD_SIZE, PAGE_SIZE);//圆整 endNode = OS_MEM_END_NODE(pool, poolInfo->info.totalSize);//获取哨兵节点 RETRY: newNode = (struct OsMemNodeHead *)LOS_PhysPagesAllocContiguous(size >> PAGE_SHIFT);//申请新的内存池 | 物理内存 if (newNode == NULL) return -1; newNode->sizeAndFlag = (size - OS_MEM_NODE_HEAD_SIZE);//设置新节点大小 newNode->ptr.prev = OS_MEM_END_NODE(newNode, size);//新节点的前节点指向新节点的哨兵节点 OsMemSentinelNodeSet(endNode, newNode, size);//设置老内存池的哨兵节点信息,其实就是指向新内存块 OsMemFreeNodeAdd(pool, (struct OsMemFreeNodeHead *)newNode);//将新节点加入空闲链表 endNode = OS_MEM_END_NODE(newNode, size);//获取新节点的哨兵节点 (VOID)memset(endNode, 0, sizeof(*endNode));//清空内存 endNode->ptr.next = NULL;//新哨兵节点没有后续指向,因为它已成为最后 endNode->magic = OS_MEM_NODE_MAGIC;//设置新哨兵节的魔法数字 OsMemSentinelNodeSet(endNode, NULL, 0); //设置新哨兵节点内容 OsMemWaterUsedRecord(poolInfo, OS_MEM_NODE_HEAD_SIZE);//更新内存池警戒线 return 0; } 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 >> 双向链表 | 内核概念 | 源码结构 | 地址空间 | 计时单位 | 宏的使用 | 钩子框架 | 位图管理 | POSIX | main函数 | 进程管理 >> 调度故事 | 进程控制块 | 进程空间 | 线性区 | 红黑树 | 进程管理 | Fork进程 | 进程回收 | Shell编辑 | Shell解析 | 任务管理 >> 任务控制块 | 并发并行 | 就绪队列 | 调度机制 | 任务管理 | 用栈方式 | 软件定时器 | 控制台 | 远程登录 | 协议栈 | 内存管理 >> 内存规则 | 物理内存 | 虚拟内存 | 虚实映射 | 页表管理 | 静态分配 | TLFS算法 | 内存池管理 | 原子操作 | 圆整对齐 | 通讯机制 >> 通讯总览 | 自旋锁 | 互斥锁 | 快锁使用 | 快锁实现 | 读写锁 | 信号量 | 事件机制 | 信号生产 | 信号消费 | 消息队列 | 消息封装 | 消息映射 | 共享内存 | 文件系统 >> 文件概念 | 文件故事 | 索引节点 | VFS | 文件句柄 | 根文件系统 | 挂载机制 | 管道文件 | 文件映射 | 写时拷贝 | 硬件架构 >> 芯片模式 | ARM架构 | 指令集 | 协处理器 | 工作模式 | 寄存器 | 多核管理 | 中断概念 | 中断管理 | 内核汇编 >> 编码方式 | 汇编基础 | 汇编传参 | 可变参数 | 开机启动 | 进程切换 | 任务切换 | 中断切换 | 异常接管 | 缺页中断 | 编译运行 >> 编译过程 | 编译构建 | GN语法 | 忍者无敌 | ELF格式 | ELF解析 | 静态链接 | 重定位 | 动态链接 | 进程映像 | 应用启动 | 系统调用 | VDSO | 调测工具 >> 模块监控 | 日志跟踪 | 系统安全 | 测试用例 | 前因后果 >> 总目录 | 源码注释 | 静态站点 | 参考手册 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:)
优秀的个人博客,低调大师

v74.01 鸿蒙内核源码分析(编码方式篇) | 机器指令是如何编码的 | 百篇博客分析OpenHarmony源码

本篇关键词:指令格式、条件域、类型域、操作域、数据指令、访存指令、跳转指令、SVC(软件中断) 内核汇编相关篇为: v74.01 鸿蒙内核源码分析(编码方式) | 机器指令是如何编码的 v75.03 鸿蒙内核源码分析(汇编基础) | CPU上班也要打卡 v76.04 鸿蒙内核源码分析(汇编传参) | 如何传递复杂的参数 v77.01 鸿蒙内核源码分析(可变参数) | 正在制作中 ... v78.01 鸿蒙内核源码分析(开机启动) | 正在制作中 ... v79.01 鸿蒙内核源码分析(进程切换) | 正在制作中 ... v80.03 鸿蒙内核源码分析(任务切换) | 看汇编如何切换任务 v81.05 鸿蒙内核源码分析(中断切换) | 系统因中断活力四射 v82.06 鸿蒙内核源码分析(异常接管) | 社会很单纯 复杂的是人 v83.01 鸿蒙内核源码分析(缺页中断) | 正在制作中 ... 本篇说清楚 ARM指令是如何被编码的,机器指令由哪些部分构成,指令有哪些类型,每种类型的语法又是怎样的 ? 代码案例 | C -> 汇编 -> 机器指令 看一段C语言编译(clang)成的最后的机器指令(armv7) int main(){ int a = 0; if( a != 1) a = 2*a + 1; return a; } 生成汇编代码如下: main: 60c: sub sp, sp, #8 610: mov r0, #0 614: str r0, [sp, #4] 618: str r0, [sp] 61c: ldr r0, [sp] 620: cmp r0, #1 624: beq 640 <main+0x34> 628: b 62c <main+0x20> 62c: ldr r1, [sp] 630: mov r0, #1 634: orr r0, r0, r1, lsl #1 638: str r0, [sp] 63c: b 640 <main+0x34> 640: ldr r0, [sp] 644: add sp, sp, #8 648: bx lr 汇编代码对应的机器指令如下图所示: 便于后续分析,将以上代码整理成如下表格 汇编代码 机器指令(十六进制表示) 机器指令(二进制表示) sub sp, sp, #8 e24dd008 1110 0010 0100 1101 1101 0000 0000 1000 mov r0, #0 e3a00000 1110 0011 1010 0000 0000 0000 0000 0000 str r0, [sp, #4] e58d0004 1110 0101 1000 1101 0000 0000 0000 0100 str r0, [sp] e58d0000 1110 0101 1000 1101 0000 0000 0000 0000 ldr r0, [sp] e59d0000 1110 0101 1001 1101 0000 0000 0000 0000 cmp r0, #1 e3500001 1110 0011 0101 0000 0000 0000 0000 0001 beq 640 <main+0x34> 0a000005 0000 1010 0000 0000 0000 0000 0000 0101 b 62c <main+0x20> eaffffff 1110 1010 1111 1111 1111 1111 1111 1111 ldr r1, [sp] e59d1000 1110 0101 1001 1101 0001 0000 0000 0010 mov r0, #1 e3a00002 1110 0011 1010 0000 0000 0000 0000 0001 orr r0, r0, r1, lsl #1 e1800081 1110 0001 1000 0000 0000 0000 1000 0001 str r0, [sp] e58d0000 1110 0101 1000 1101 0000 0000 0000 0000 b 640 <main+0x34> eaffffff 1110 1010 1111 1111 1111 1111 1111 1111 ldr r0, [sp] e59d1000 1110 0101 1001 1101 0001 0000 0000 0000 add sp, sp, #8 e28dd008 1110 0010 1000 1101 1101 0000 0000 1000 bx lr e12fff1e 1110 0001 0010 1111 1111 1111 0001 1110 CPSR寄存器 在理解本篇之前需了解下CPSR寄存器的高4位[31,28] 表达的含义。关于寄存器的详细介绍可翻看 系列篇的 (寄存器篇) N、Z、C、V均为条件码标志位。它们的内容可被算术或逻辑运算的结果所改变,并且可以决定某条指令是否被执行!意义重大! CPSR的第31位是 N,符号标志位。它记录相关指令执行后,其结果是否为负。 如果为负 N = 1,如果是非负数 N = 0。 CPSR的第30位是Z,0标志位。它记录相关指令执行后,其结果是否为0。 如果结果为0。那么Z = 1。如果结果不为0,那么Z = 0。 CPSR的第29位是C,进位标志位(Carry)。一般情况下,进行无符号数的运算。 加法运算:当运算结果产生了进位时(无符号数溢出),C=1,否则C=0。 减法运算(包括CMP):当运算时产生了借位时(无符号数溢出),C=0,否则C=1。 CPSR的第28位是V,溢出标志位(Overflow)。在进行有符号数运算的时候, 如果超过了机器所能标识的范围,称为溢出。 指令格式 ARM 指令流是一连串的字对齐的四字节指令流。每个 ARM 指令是一个单一的 32 位字(4字节),如图(3): 解读 图为ARM指令的编码一级格式,所有的指令都必须符合一级格式,分成三部分: 条件域: cond[31:28]表示,条件域会影响CPSR的条件码N、Z、C、V标志位。 类型域: op1[27:25], op[4],arm将指令分成了六大类型 。 操作域: 剩下的[24:5],[4:0] 即图中的空白位/保留位,这是留给下级自由发挥的,不同的类型对这些保留位有不同的定义。可以理解为因类型变化而变化的二级格式。 那有了二级格式会不会有三级格式 ? 答案是必须有, 二级格式只会对保留位定义部分位,会留一部分给具体的指令格式自由发挥。 一定要理解这种层次结构才能理解ARM指令集的设计总思路,因为RISC(精简指令集) 的指令长度是固定的16/32/64位,以32位为例,所有的指令设计必须全用32位来表示,如果只有一层结构是难以满足众多的指令设计需求的,要灵活有包容就得给适当的空间发挥。 条件域 cond 为条件域,每一条可条件执行的条件指令都有4位的条件位域,2^4能表示16种条件 cond 助记符 含义(整型) 含义(浮点型) 条件标志 0000 EQ 相等 相等 Z == 1 0001 NE 不等 不等或无序 Z == 0 0010 CS 进位 大于等于或无序 C == 1 0011 CC 进位清除 小于 C == 0 0100 MI 减、负数 小于 N == 1 0101 PL 加、正数或 0 大于等于或无序 N == 0 0110 VS 溢出 无序 V == 1 0111 VC 未溢出 有序 V == 0 1000 HI 无符号大于 大于或无序 C == 1 and Z == 0 1001 LS 无符号小于或等于 小于或等于 C == 0 or Z == 1 1010 GE 有符号大于或等于 大于或等于 N == V 1011 LT 有符号小于 小于或无序 N != V 1100 GT 有符号大于 大于 Z == 0 and N ==V 1101 LE 有符号大于或等于 小于等于或无序 Z == 1 or N != V 1110 无 无条件 无条件 任何 大部分的指令都是 1110 = e,无条件执行指令,只要看到 e开头的机器指令都属于这类 beq 640 <main+0x34> // 机器码 0a000005 <=> 0000 1010 0000 0000 0000 0000 0000 0101 0000 EQ Equal(相等) Z == 1 类型域 图(3) 的 op1 域位于 bits[27:25],占三位;op 域位于 bit[4],占一位。它们的取值组合在一起,决定指令所属的分类(Instruction Class),其值对应的关系如下 op1 op 指令类型 00x - 数据处理以及杂项指令 010 - load/store word类型 或者 unsigned byte 011 0 同上 011 1 媒体接口指令 10x - 跳转指令和块数据操作指令,块数据操作指令指 STMDA 这类,连续内存操作。 11x - 协处理器指令和 svc 指令,包括高级的 SIMD 和浮点指令。 操作域 操作域是因类型变化而变化的二级格式 ,作用于保留位。包含 00x | 数据处理类指令 上图为涉及数据处理指令的对应编码,由 op[占5位]和op2[占2位]两项来确定指令的唯一性 一般情况下只需op指定唯一性,图中 SUB指令对应为 0010x,而代码案例中的第一句 sub sp, sp, #8 // 机器码 e24dd008 <=> 1110 001`0 0100` 1101 1101 0000 0000 1000 对应[24:20]位就是0 0100,从而CPU在译码阶段将其解析为SUB指令执行 需要用到op2的是 MOV系列指令,包括逻辑/算术左移右移,例如: mov r0, #0 //e3a00000 <=> 1110 0011 1010 0000 0000 0000 0000 0000 中的op = 1 1010 ,op2 = 00 对应 MOV(register,ARM) on page A8-489 00x中的x表示数据处理分两种情况 000 无立即数参与(寄存器之间) ,图A5.2.1 表示了这种情况 [27:25]= 000 001 有立即参与的运算,例如 mov r0, #0 中的 [27:25]= 001,此处未展示图,可前往 ARM体系结构参考手册.pdf 翻看 010 | 加载存储指令 Load/store是一组内存访问指令,用来在ARM寄存器和内存之间进行数据传送,ARM指令中有3种基本的数据传送指令 单寄存器 Load/Store 内存访问指令(single register):这些指令为ARM寄存器和存储器提供了更灵活的单数据项传送方式。数据可以使字节,16位半字或32位字 多寄存器 Load/Store 内存访问指令:可以实现大量数据的同时传送,主要用于进程的进入和退出、保存和恢复工作寄存器以及复制寄存器中的一片(一块)数据 寄存器交换指令(single register swap): 实现寄存器数据和内存数据进行交换,而且是在一条指令中完成,执行过程中不会受到中断干扰 出现在代码案例中的 str r0, [sp, #4] // 机器码 e58d0004 <=> 1110 0101 1000 1101 0000 0000 0000 0100 str r0, [sp] // 机器码 e58d0000 <=> 1110 0101 1000 1101 0000 0000 0000 0000 将r0中的字数据写入以SP为地址的存储器中 ldr r0, [sp] // 机器码 e59d0000 <=> 1110 0101 1001 1101 0000 0000 0000 0000 存储器地址地址为SP的数据读入r0 寄存器 [27:25] = 010说明都属于这类指令,完成对内存的读写,包括 LDR、LDRB、LDRH、STR、STRB、STRH六条指令。 ldr 为加载指令,但是加载到内存还是寄存器,这该怎么记 ? 因为主角是CPU,加载有进来的意思,将内容加载至寄存器中。STR有出去的意思,将内容保存到内存里。 [sp]相当于C语言的 *sp ,sp 指向程序运行栈当前位置 具体可看 >> ARM的六条访存指令集---LDR、LDRB、LDRH、STR、STRB、STRH 010 | 多媒体指令 多媒体指令使用较少,但是它涉及指令却很多 10x | 跳转/分支/块数据处理 指令 出现在代码案例中的 beq 640 <main+0x34> // 机器码 0a000005 <=> 0000 1010 0000 0000 0000 0000 0000 0101 b 62c <main+0x20> // 机器码 eaffffff <=> 1110 1010 1111 1111 1111 1111 1111 1111 [27:25] = 101说明都属于这类指令 听得很多的pop,push也属于这类,成块的数据操作,例如push常用于将函数的所有参数一次性入栈。 内存 <> 寄存器 批量数据搬运指令 STMDA (STMED) LDMDA/LDMF。 11x | 软中断/协处理器 指令 其中最有名的就是svc 0,在系列篇中曾多次提及它,此处详细说下 svc, svc全称是 Supervisor Call, Supervisor是CPU的管理模式,svc导致处理器进入管理模式,很多人问的系统调用底层是怎么实现的? svc就是答案。 例如 printf是个标准库函数,在标准库的底层代码中会调用 svc 0,导致用户态的 ARM 程序通常将系统调用号传入 R7 寄存器(也被鸿蒙内核使用),然后用 SVC 指令调用 0 号中断来直接执行系统调用, 在以前的ARM架构版本中,SVC指令被称为SWI,软件中断。 描述svc功能的详细伪代码如下,请尝试读懂它 The TakeSVCException() pseudocode procedure describes how the processor takes the exception: // TakeSVCException() // ================== TakeSVCException() // Determine return information. SPSR is to be the current CPSR, after changing the IT[] // bits to give them the correct values for the following instruction, and LR is to be // the current PC minus 2 for Thumb or 4 for ARM, to change the PC offsets of 4 or 8 // respectively from the address of the current instruction into the required address of // the next instruction, the SVC instruction having size 2bytes for Thumb or 4 bytes for ARM. ITAdvance(); new_lr_value = if CPSR.T == '1' then PC-2 else PC-4; new_spsr_value = CPSR; vect_offset = 8; // Check whether to take exception to Hyp mode // if in Hyp mode then stay in Hyp mode take_to_hyp = (HaveVirtExt() && HaveSecurityExt() && SCR.NS == '1' && CPSR.M == '11010'); // if HCR.TGE is set to 1, take to Hyp mode through Hyp Trap vector route_to_hyp = (HaveVirtExt() && HaveSecurityExt() && !IsSecure() && HCR.TGE == '1' && CPSR.M == '10000'); // User mode // if HCR.TGE == '1' and in a Non-secure PL1 mode, the effect is UNPREDICTABLE preferred_exceptn_return = new_lr_value; if take_to_hyp then EnterHypMode(new_spsr_value, preferred_exceptn_return, vect_offset); elsif route_to_hyp then EnterHypMode(new_spsr_value, preferred_exceptn_return, 20); else // Enter Supervisor ('10011') mode, and ensure Secure state if initially in Monitor // ('10110') mode. This affects the Banked versions of various registers accessed later // in the code. if CPSR.M == '10110' then SCR.NS = '0'; CPSR.M = '10011'; // Write return information to registers, and make further CPSR changes: IRQs disabled, // IT state reset, instruction set and endianness set to SCTLR-configured values. SPSR[] = new_spsr_value; R[14] = new_lr_value; CPSR.I = '1'; CPSR.IT = '00000000'; CPSR.J = '0'; CPSR.T = SCTLR.TE; // TE=0: ARM, TE=1: Thumb CPSR.E = SCTLR.EE; // EE=0: little-endian, EE=1: big-endian // Branch to SVC vector. BranchTo(ExcVectorBase() + vect_offset); 这部分内容在系列篇 (寄存器篇) ,(系统调用篇) ,(标准库篇) 中都有提及。 具体指令 细看几条代码案例出现的常用指令 sub sp, sp, #8 sub sp, sp, #8 // 机器码 e24dd008 < = > 1110 0010 0100 1101 1101 0000 0000 1000 是减法操作指令,减法编码格式为 图中除了给出格式语法还有一段伪代码用于描述指令的使用条件 sp为 13号寄存器, lr为 14号寄存器 ,pc为 15号寄存器。 如果是PC寄存器(Rn = 15)且S等于0 查看 ADR指令。。 如果是SP寄存器(Rn = 13) 看 SUB(申请栈空间)。 如果是PC寄存器(Rd = 15)且S等于1 。查看 subs pc lr相关指令 套用格式结合源码 cond op1 操作码 S Rn Rd imm12(立即数) 1110 001 0010 0 1101 1101 0000 0000 1000 无条件执行 表示数据处理 SUB sp sp 8 mov r0, #0 mov r0, #0 //e3a00000 1110 0011 1010 0000 0000 0000 0000 0000 bx lr bx lr e12fff1e 1110 0001 0010 1111 1111 1111 0001 1110 Rm = 1110 对应 lr 寄存器 ,其相当于高级语言的 return,函数执行完了需切回到调用它的函数位置继续执行,lr保存的就是那个位置,从哪里来就回到哪里去。 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 >> 双向链表 | 内核概念 | 源码结构 | 地址空间 | 计时单位 | 宏的使用 | 钩子框架 | 位图管理 | POSIX | main函数 | 进程管理 >> 调度故事 | 进程控制块 | 进程空间 | 线性区 | 红黑树 | 进程管理 | Fork进程 | 进程回收 | Shell编辑 | Shell解析 | 任务管理 >> 任务控制块 | 并发并行 | 就绪队列 | 调度机制 | 任务管理 | 用栈方式 | 软件定时器 | 控制台 | 远程登录 | 协议栈 | 内存管理 >> 内存规则 | 物理内存 | 虚拟内存 | 虚实映射 | 页表管理 | 静态分配 | TLFS算法 | 内存池管理 | 原子操作 | 圆整对齐 | 通讯机制 >> 通讯总览 | 自旋锁 | 互斥锁 | 快锁使用 | 快锁实现 | 读写锁 | 信号量 | 事件机制 | 信号生产 | 信号消费 | 消息队列 | 消息封装 | 消息映射 | 共享内存 | 文件系统 >> 文件概念 | 文件故事 | 索引节点 | VFS | 文件句柄 | 根文件系统 | 挂载机制 | 管道文件 | 文件映射 | 写时拷贝 | 硬件架构 >> 芯片模式 | ARM架构 | 指令集 | 协处理器 | 工作模式 | 寄存器 | 多核管理 | 中断概念 | 中断管理 | 内核汇编 >> 编码方式 | 汇编基础 | 汇编传参 | 可变参数 | 开机启动 | 进程切换 | 任务切换 | 中断切换 | 异常接管 | 缺页中断 | 编译运行 >> 编译过程 | 编译构建 | GN语法 | 忍者无敌 | ELF格式 | ELF解析 | 静态链接 | 重定位 | 动态链接 | 进程映像 | 应用启动 | 系统调用 | VDSO | 调测工具 >> 模块监控 | 日志跟踪 | 系统安全 | 测试用例 | 前因后果 >> 总目录 | 源码注释 | 静态站点 | 参考手册 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:)

优秀的个人博客,低调大师

v82.01 鸿蒙内核源码分析(协处理器篇) | CPU的好帮手 | 百篇博客分析OpenHarmony源码

子曰:“居上不宽,为礼不敬,临丧不哀,吾何以观之哉?”《论语》:八佾篇 硬件架构相关篇为: v65.01 鸿蒙内核源码分析(CPU历史) | 正在制作中 ... v66.03 鸿蒙内核源码分析(ARM架构) | ARMv7 & Cortex(A|R|M) v67.01 鸿蒙内核源码分析(协处理器) | CPU的好帮手 v68.05 鸿蒙内核源码分析(工作模式) | 羡慕韦小宝老婆多 v69.06 鸿蒙内核源码分析(寄存器) | 真牛把世界玩出花来了 v70.03 鸿蒙内核源码分析(多核管理) | 真正并发的基础 v71.05 鸿蒙内核源码分析(中断概念) | 海公公的日常工作 v72.04 鸿蒙内核源码分析(中断管理) | 没中断太可怕 v73.01 鸿蒙内核源码分析(移值适配) | 正在制作中 ... 本篇很重要,对CP15协处理所有16个寄存器一一介绍,可能是全网介绍CP15最全面的一篇,鸿蒙内核的汇编部分(尤其开机启动)中会使用,熟练掌握后看汇编代码将如虎添翼。 协处理器 协处理器 (co-processor) 顾名思义是协助主处理器完成工作,例如浮点、图像、音频处理这一类外围工作。角色相当于老板的助理/秘书,咱皇上身边的人,专干些咱皇上又不好出面的脏活累活,您可别小看了这个角色,权利不大但能力大,是能通天的人,而且老板越大,身边这样的人还不止一个。 在 arm 的协处理器设计中,最多可以支持 16 个协处理器,通常被命名为 cp0~cp15,本篇主要说第16号协处理器 cp15 CP15 关于 cp15详细介绍见于《ARM体系结构参考手册》的 B3.17。 cp15 一共有 16个寄存器32位的寄存器,其编号为C0 ~ C15 ,用来控制cache、TCM和存储器管理。cp15 寄存器都是复合功能寄存器,不同功能对应不同的内存实体,全由访问指令的参数来决定,对于 armv7 架构而言,A 系列和 R 系列是统一设计的,A 系列带有 MMU 相关的控制,而 R 系列带有 MPU 相关控制,针对不同的功能需要做区分,同时又因为协处理器 cp15 只支持 16 个寄存器,而需要支持的功能较多,所以通过同一寄存器不同功能的方式来满足需求。 mcr | mrc 指令 armv7 中对于协处理器的访问,CP15的寄存器只能被MRC和MCR(Move to Coprocessor from ARM Register )指令访问。MCR表示将 arm 核心寄存器中的值的写到 cp15 寄存器中,MRC 从 cp15 寄存器中读到 arm 核心寄存器中,大部分指令都需要在 PL1 以及更高的特权级下才能正常执行,这是因为 cp15 协处理器大多都涉及到系统和内存的设置,user 模式没有操作权限,user 模式仅能访问 cp15 中有限的几个寄存器比如:ISB、DSB、DMB、TPIDRURW、TPIDRURO 寄存器。 从 `cp**` 寄存器中读到 `arm` 核心寄存器中 MRC<cond> <coproc>, <opc1>, <Rt>, <CRn>, <CRm>{, <opc2>} cond : 指令后缀,表示条件执行,关于条件执行可以参考 arm状态寄存器 coproc :协处理器的名称,cp0~cp15 分别对应名称 p0~p15 opc1 :对于 cp15 而言,这一个参数一般为0。 Rt :arm 的通用寄存器 CRn :与 arm 核心寄存器交换数据的核心寄存器名,c0~c15 CRm :需要额外操作的协处理器的寄存器名,c0~c15,针对多种功能的 cp15 寄存器,需要使用 CRm 和 opc2 来确定 CRn 对应哪个寄存器实体。 opc2 :可选,与 CRm搭配使用,同样是决定多功能寄存器中指定实体。 啥玩意,太抽象没看懂,后面直接上内核代码就懂了,先看16个寄存器的功能介绍表 c0 寄存器 c0 寄存器提供处理器和特征识别 ,内核宏定义为,可参考图理解 /*! * Identification registers (c0) | c0 - 身份寄存器 */ #define MIDR CP15_REG(c0, 0, c0, 0) /*! Main ID Register | 主ID寄存器 */ #define MPIDR CP15_REG(c0, 0, c0, 5) /*! Multiprocessor Affinity Register | 多处理器关联寄存器给每个CPU制定一个逻辑地址*/ #define CCSIDR CP15_REG(c0, 1, c0, 0) /*! Cache Size ID Registers | 缓存大小ID寄存器*/ #define CLIDR CP15_REG(c0, 1, c0, 1) /*! Cache Level ID Register | 缓存登记ID寄存器*/ #define VPIDR CP15_REG(c0, 4, c0, 0) /*! Virtualization Processor ID Register | 虚拟化处理器ID寄存器*/ #define VMPIDR CP15_REG(c0, 4, c0, 5) /*! Virtualization Multiprocessor ID Register | 虚拟化多处理器ID寄存器*/ c1 寄存器 c1 为系统控制寄存器 /*! * System control registers (c1) | c1 - 系统控制寄存器 各种控制位(可读写) */ #define SCTLR CP15_REG(c1, 0, c0, 0) /*! System Control Register | 系统控制寄存器*/ #define ACTLR CP15_REG(c1, 0, c0, 1) /*! Auxiliary Control Register | 辅助控制寄存器*/ #define CPACR CP15_REG(c1, 0, c0, 2) /*! Coprocessor Access Control Register | 协处理器访问控制寄存器*/ /// 读取CP15的系统控制寄存器到 R0寄存器 STATIC INLINE UINT32 OsArmReadSctlr(VOID) { UINT32 val; __asm__ volatile("mrc p15, 0, %0, c1,c0,0" : "=r"(val)); return val; } /// R0寄存器写入CP15的系统控制寄存器 STATIC INLINE VOID OsArmWriteSctlr(UINT32 val) { __asm__ volatile("mcr p15, 0, %0, c1,c0,0" ::"r"(val)); __asm__ volatile("isb" ::: "memory"); } 解读 从图中找到 c1-0-c0-0行,后边的备注是 SCTLR, System Control Register 系统控制寄存器,其操作模式是支持 Read/Write %0表示 r0 寄存器,注意这个寄存器是CPU的寄存器,: "=r"(val)意思向编译器声明,会修改R0寄存器的值,改之前提前打好招呼,都是绅士文明人。其实编译器的功能是非常强大的,不仅仅是大家普遍认为的只是编译代码的工具而已。OsArmReadSctlr的含义就是读取CP15的系统控制寄存器到R0寄存器。 volatile的意思还告诉编译器,不要去优化这段代码,原封不动的生成目标指令。 "isb" ::: "memory" 还是告诉编译器内存的内容要被更改了,需要无效所有Cache,并访问实际的内容,而不是Cache! CRn | CRm | opc2 是一套组合拳,c7-0-c10-4 c7-0-c10-5 都表示不同的功能含义 c2、c3 寄存器 /*! * Memory protection and control registers (c2 & c3) | c2 - 传说中的TTB寄存器,主要是给MMU使用 c3 - 域访问控制位 */ #define TTBR0 CP15_REG(c2, 0, c0, 0) /*! Translation Table Base Register 0 | 转换表基地址寄存器0*/ #define TTBR1 CP15_REG(c2, 0, c0, 1) /*! Translation Table Base Register 1 | 转换表基地址寄存器1*/ #define TTBCR CP15_REG(c2, 0, c0, 2) /*! Translation Table Base Control Register | 转换表基地址控制寄存器*/ #define DACR CP15_REG(c3, 0, c0, 0) /*! Domain Access Control Register | 域访问控制寄存器*/ 看段代码 STATIC INLINE UINT32 OsArmReadTtbr0(VOID) { UINT32 val; __asm__ volatile("mrc p15, 0, %0, c2,c0,0" : "=r"(val)); return val; } STATIC INLINE VOID OsArmWriteTtbr0(UINT32 val) { __asm__ volatile("mcr p15, 0, %0, c2,c0,0" ::"r"(val)); __asm__ volatile("isb" ::: "memory"); } STATIC INLINE UINT32 OsArmReadTtbr1(VOID) { UINT32 val; __asm__ volatile("mrc p15, 0, %0, c2,c0,1" : "=r"(val)); return val; } STATIC INLINE VOID OsArmWriteTtbr1(UINT32 val) { __asm__ volatile("mcr p15, 0, %0, c2,c0,1" ::"r"(val)); __asm__ volatile("isb" ::: "memory"); } c2寄存器负责存页表的基地址,即一级映射描述符表的基地址。还记得吗?每个进程的页表都是独立的!c2值一变,当前使用的页表就发生了变化,页表变化意味着虚拟地址和物理地址的映射关系发生了变化。那么什么情况下会修改里面的值呢?很容易想到只有在进程切换时发生的mmu上下文切换,直接看代码吧! /// mmu 上下文切换 VOID LOS_ArchMmuContextSwitch(LosArchMmu *archMmu) { UINT32 ttbr; UINT32 ttbcr = OsArmReadTtbcr();//读取TTB寄存器的状态值 if (archMmu) { ttbr = MMU_TTBRx_FLAGS | (archMmu->physTtb);//进程TTB物理地址值 /* enable TTBR0 */ ttbcr &= ~MMU_DESCRIPTOR_TTBCR_PD0;//使能TTBR0 } else { ttbr = 0; /* disable TTBR0 */ ttbcr |= MMU_DESCRIPTOR_TTBCR_PD0; } #ifdef LOSCFG_KERNEL_VM /* from armv7a arm B3.10.4, we should do synchronization changes of ASID and TTBR. */ OsArmWriteContextidr(LOS_GetKVmSpace()->archMmu.asid);//这里先把asid切到内核空间的ID ISB; //指令必须同步 ,清楚流水线中未执行指令 #endif OsArmWriteTtbr0(ttbr);//通过r0寄存器将进程页面基址写入TTB ISB; //指令必须同步 OsArmWriteTtbcr(ttbcr);//写入TTB状态位 ISB; //指令必须同步 #ifdef LOSCFG_KERNEL_VM if (archMmu) { OsArmWriteContextidr(archMmu->asid);//通过R0寄存器写入进程标识符至C13寄存器 ISB; } #endif } 至于具体内核哪些地方会触发到 mmu的切换,可前往翻看 (进程切换篇) c4 寄存器 c4 没有用于任何 ARMv7 实现,这么不待见4,难道原因跟中国人一样觉得数字不吉利 ,但老师教的老外是不喜欢 13 啊 , 但c13确很重要 c5 c6 寄存器 c5和c6寄存器提供内存系统故障报告。此外,c6还提供了MPU区域寄存器。这一类寄存器在软件排错时可以提供非常大的帮助,比如通过 DFSR(数据状态寄存器)、IFSR(指令状态寄存器) 的 status bits 可以查到系统 abort 类型,内核中的缺页异常就是通过该寄存器传递异常地址,从而分配页面的。 /*! * Memory system fault registers (c5 & c6) | c5 - 内存失效状态 c6 - 内存失效地址 */ #define DFSR CP15_REG(c5, 0, c0, 0) /*! Data Fault Status Register | 数据故障状态寄存器 */ #define IFSR CP15_REG(c5, 0, c0, 1) /*! Instruction Fault Status Register | 指令故障状态寄存器*/ #define DFAR CP15_REG(c6, 0, c0, 0) /*! Data Fault Address Register | 数据故障地址寄存器*/ #define IFAR CP15_REG(c6, 0, c0, 2) /*! Instruction Fault Address Register | 指令错误地址寄存器*/ c7 寄存器 c7寄存器提供高速缓存维护操作和内存屏障操作。 c8 寄存器 c8 寄存器提供 TLB 维护功能 TLB是硬件上的一个cache,因为页表一般都很大,并且存放在内存中,所以处理器引入MMU后,读取指令、数据需要访问两次内存:首先通过查询页表得到物理地址,然后访问该物理地址读取指令、数据。为了减少因为MMU导致的处理器性能下降,引入了TLB,可翻译为“地址转换后援缓冲器”,也可简称为“快表”。简单地说,TLB就是页表的Cache,其中存储了当前最可能被访问到的页表项,其内容是部分页表项的一个副本。只有在TLB无法完成地址翻译任务时,才会到内存中查询页表,这样就减少了页表查询导致的处理器性能下降。详细看 照着图说吧,步骤是这样的。 1.图中的page table的基地址就是上面TTB寄存器值,整个page table非常大,有多大接下来会讲,所以只能存在内存里,TTB中只是存一个开始位置而已。 虚拟地址是程序的地址逻辑地址,也就是喂给CPU的地址,必须经过MMU的转换后变成物理内存才能取到真正的指令和数据。 3.TLB是page table的迷你版,MMU先从TLB里找物理页,找不到了再从page table中找,从page table中找到后会放入TLB中,注意这一步非常非常的关键。因为page table是属于进程的会有很多个,而TLB只有一个,不放入就会出现多个进程的page table都映射到了同一个物理页框而不自知。一个物理页同时只能被一个page table所映射。但除了TLB的唯一性外,要做到不错乱还需要了一个东西,就是进程在映射层面的唯一标识符 - asid,具体可前往翻看 (进程切换篇) 有详细说明。 c9 寄存器 c9 寄存器主要为 cache、分之预测 和 tcm 保留功能,这些保留功能由处理的实现决定 c10 寄存器 c10 寄存器主要提供内存重映射和 TLB 控制功能 c11 寄存器 c11 寄存器主要提供 TCM 和 DMA 的保留功能,这些保留功能由处理的实现决定 c12 寄存器 c12 安全扩展寄存器 c13 寄存器 c13 寄存器提供进程、上下文以及线程ID处理功能 /*! * Process, context and thread ID registers (c13) | c13 - 进程标识符 */ #define FCSEIDR CP15_REG(c13, 0, c0, 0) /*! FCSE Process ID Register | FCSE(Fast Context Switch Extension,快速上下文切换)进程ID寄存器 位于CPU和MMU之间*/ #define CONTEXTIDR CP15_REG(c13, 0, c0, 1) /*! Context ID Register | 上下文ID寄存器*/ #define TPIDRURW CP15_REG(c13, 0, c0, 2) /*! User Read/Write Thread ID Register | 用户读/写线程ID寄存器*/ #define TPIDRURO CP15_REG(c13, 0, c0, 3) /*! User Read-Only Thread ID Register | 用户只读写线程ID寄存器*/ #define TPIDRPRW CP15_REG(c13, 0, c0, 4) /*! PL1 only Thread ID Register | 仅PL1线程ID寄存器*/ c14 寄存器 c14 寄存器提供通用定时器扩展的保留功能 c15 寄存器 ARMv7 保留 c15 用于实现定义的目的,并且不对 c15 编码的使用施加任何限制。 意思就是可以将他当通用寄存器来使用 语法: c15 0-7 c0-c15 0-7 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 >> 双向链表 | 内核概念 | 源码结构 | 地址空间 | 计时单位 | 宏的使用 | 钩子框架 | 位图管理 | POSIX | main函数 | 进程管理 >> 调度故事 | 进程控制块 | 进程空间 | 线性区 | 红黑树 | 进程管理 | Fork进程 | 进程回收 | Shell编辑 | Shell解析 | 任务管理 >> 任务控制块 | 并发并行 | 就绪队列 | 调度机制 | 任务管理 | 用栈方式 | 软件定时器 | 控制台 | 远程登录 | 协议栈 | 内存管理 >> 内存规则 | 物理内存 | 虚拟内存 | 虚实映射 | 页表管理 | 静态分配 | TLFS算法 | 内存池管理 | 原子操作 | 圆整对齐 | 通讯机制 >> 通讯总览 | 自旋锁 | 互斥锁 | 快锁使用 | 快锁实现 | 读写锁 | 信号量 | 事件机制 | 信号生产 | 信号消费 | 消息队列 | 消息封装 | 消息映射 | 共享内存 | 文件系统 >> 文件概念 | 文件故事 | 索引节点 | VFS | 文件句柄 | 根文件系统 | 挂载机制 | 管道文件 | 文件映射 | 写时拷贝 | 硬件架构 >> CPU历史 | ARM架构 | 协处理器 | 工作模式 | 寄存器 | 多核管理 | 中断概念 | 中断管理 | 移值适配 | 内核汇编 >> 汇编指令 | 汇编基础 | 汇编传参 | 可变参数 | 开机启动 | 进程切换 | 任务切换 | 中断切换 | 异常接管 | 缺页中断 | 编译运行 >> 编译过程 | 编译构建 | GN语法 | 忍者无敌 | ELF格式 | ELF解析 | 静态链接 | 重定位 | 动态链接 | 进程映像 | 应用启动 | 系统调用 | VDSO | 调测工具 >> 模块监控 | 日志跟踪 | 系统安全 | 测试用例 | 前因后果 >> 总目录 | 源码注释 | 静态站点 | 参考文档 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:-)

优秀的个人博客,低调大师

v75.01 鸿蒙内核源码分析(远程登录篇) | 内核如何接待远方的客人 | 百篇博客分析OpenHarmony源码

子曰:“不学礼,无以立 ; 不学诗,无以言 ” 《论语》:季氏篇 百篇博客分析.本篇为: (远程登录篇) | 内核如何接待远方的客人 文件系统相关篇为: v62.02 鸿蒙内核源码分析(文件概念) | 为什么说一切皆是文件 v63.04 鸿蒙内核源码分析(文件系统) | 用图书管理说文件系统 v64.06 鸿蒙内核源码分析(索引节点) | 谁是文件系统最重要的概念 v65.05 鸿蒙内核源码分析(挂载目录) | 为何文件系统需要挂载 v66.07 鸿蒙内核源码分析(根文件系统) | 谁先挂到/谁就是根总 v67.03 鸿蒙内核源码分析(字符设备) | 绝大多数设备都是这类 v68.02 鸿蒙内核源码分析(VFS) | 文件系统是个大家庭 v69.04 鸿蒙内核源码分析(文件句柄) | 你为什么叫句柄 v70.05 鸿蒙内核源码分析(管道文件) | 如何降低数据流动成本 v74.01 鸿蒙内核源码分析(控制台) | 一个让很多人模糊的概念 v75.01 鸿蒙内核源码分析(远程登录) | 内核如何接待远方的客人 什么是远程登录? 每个人都有上门做客的经历,抖音也一直在教我们做人,做客不要空手去,总得带点东西,而对中国人你就不能送钟,不能送梨,最好也别送鞋,因他们与终 离 邪谐音,犯忌讳. 这是人情世故,叫礼仪,是中华文明圈的共识,是相互交流信任的基础. 那互联网有没有这种共识呢? 当然有,互联网世界的人情世故就是协议, 种种协议映射到人类社会来说就是种种礼仪,协议有TCP,HTTP,SSH,Telnet等等,就如同礼仪分商业礼仪,外交礼仪,校园礼仪,家庭礼仪等等. 孔圣人不也说 不学礼,无以立 应该就是这个道理, 登门拜访的礼仪可类比远程登录协议Telnet. 来了就跟自己家一样, 我家的东西就是你家的,随便用,甭客气. Telnet协议的具体内容可以查看以下文档. 协议 时间 英文版 中文版 标题 Telnet 1983 rfc854<br>rfc855 rfc854<br>rfc855 TELNET PROTOCOL SPECIFICATION <br> TELNET OPTION SPECIFICATIONS Telnet协议细节不是本篇讨论的重点,后续会有专门的 Lwip协议栈 系列博客说清楚.本篇要说清楚的是内核如何接待远方的客人. Shell | 控制台 | 远程登录模型 对远程登录来有客户端和服务端的说法,跟别人来你家你是主人和你去别人家你是客人一样,身份不同,职责不同,主人要做的事明显要更多,本篇只说鸿蒙对telnet服务端的实现,说清楚它是如何接待外面来的客人.至于图中提到的客户端任务是指主人为每个客人专门提供了一个对接人的意思. 下图为看完鸿蒙内核Shell和控制台源码后整理的模型图 模型解释 通过本地的shell命令telnet on启动远程登录模块,由此创建Telnet的服务任务TelnetServer TelnetServer任务,创建socket监听23端口,接受来自远程终端的 telnet xx.xx.xx.xx 23请求 收到请求后创建一个TelnetClientLoop用于接待客户的任务,对接详细的客户需求. 在接待客户期间创建一个远程登录类型的控制台,来处理和转发远程客户的请求给shell进程最终执行远程命令. shell处理完成后通过专门的任务SendToSer回写远程终端,控制台部分详细看 系列篇的(控制台篇) 鸿蒙是如何实现的? 1. 启动 Telnet //SHELLCMD_ENTRY(telnet_shellcmd, CMD_TYPE_EX, "telnet", 1, (CmdCallBackFunc)TelnetCmd);/// 以静态方式注册shell 命令 /// 本命令用于启动或关闭telnet server服务 INT32 TelnetCmd(UINT32 argc, const CHAR **argv) { if (strcmp(argv[0], "on") == 0) { // 输入 telnet on /* telnet on: try to start telnet server task */ TelnetdTaskInit(); //启动远程登录 服务端任务 return 0; } if (strcmp(argv[0], "off") == 0) {// 输入 telnet off /* telnet off: try to stop clients, then stop server task */ TelnetdTaskDeinit();//关闭所有的客户端,并关闭服务端任务 return 0; } return 0; } 2. 创建Telnet服务端任务 STATIC VOID TelnetdTaskInit(VOID) { UINT32 ret; TSK_INIT_PARAM_S initParam = {0}; initParam.pfnTaskEntry = (TSK_ENTRY_FUNC)TelnetdMain; // telnet任务入口函数 initParam.uwStackSize = TELNET_TASK_STACK_SIZE; // 8K initParam.pcName = "TelnetServer"; //任务名称 initParam.usTaskPrio = TELNET_TASK_PRIORITY; //优先级 9,和 shell 的优先级一样 initParam.uwResved = LOS_TASK_STATUS_DETACHED; //独立模式 if (atomic_read(&g_telnetTaskId) != 0) {//只支持一个 telnet 服务任务 PRINT_ERR("telnet server is already running!\n"); return; } ret = LOS_TaskCreate((UINT32 *)&g_telnetTaskId, &initParam);//创建远程登录服务端任务并发起调度 } 3. Telnet服务端任务入口函数 //远程登录操作命令 STATIC const struct file_operations_vfs g_telnetOps = { TelnetOpen, TelnetClose, TelnetRead, TelnetWrite, NULL, TelnetIoctl, NULL, #ifndef CONFIG_DISABLE_POLL TelnetPoll, #endif NULL, }; STATIC INT32 TelnetdMain(VOID) { sock = TelnetdInit(TELNETD_PORT);//1.初始化创建 socket ,socket的本质就是打开了一个虚拟文件 TelnetLock(); ret = TelnetedRegister();//2.注册驱动程序 /dev/telnet ,g_telnetOps g_telnetDev TelnetUnlock(); TelnetdAcceptLoop(sock);//3.等待连接,处理远程终端过来的命令 例如#task 命令 return 0; } 4. 循环等待远程终端的连接请求 STATIC VOID TelnetdAcceptLoop(INT32 listenFd) { while (g_telnetListenFd >= 0) {//必须启动监听 TelnetUnlock(); (VOID)memset_s(&inTelnetAddr, sizeof(inTelnetAddr), 0, sizeof(inTelnetAddr)); clientFd = accept(listenFd, (struct sockaddr *)&inTelnetAddr, (socklen_t *)&len);//接收数据 if (TelnetdAcceptClient(clientFd, &inTelnetAddr) == 0) {// /* * Sleep sometime before next loop: mostly we already have one connection here, * and the next connection will be declined. So don't waste our cpu. | 在下一个循环来临之前休息片刻,因为鸿蒙只支持一个远程登录,此时已经有一个链接, 在TelnetdAcceptClient中创建线程不会立即调度, 休息下任务会挂起,重新调度 */ LOS_Msleep(TELNET_ACCEPT_INTERVAL);//以休息的方式发起调度. 直接申请调度也未尝不可吧 @note_thinking } else { return; } TelnetLock(); } TelnetUnlock(); } 5. 远方的客人到来,安排专人接待 鸿蒙目前只支持接待一位远方的客人,g_telnetClientFd是个全局变量,创建专门任务接待客人. STATIC INT32 TelnetdAcceptClient(INT32 clientFd, const struct sockaddr_in *inTelnetAddr) { g_telnetClientFd = clientFd; //创建一个线程处理客户端的请求 if (pthread_create(&tmp, &useAttr, TelnetClientLoop, (VOID *)(UINTPTR)clientFd) != 0) { PRINT_ERR("Failed to create client handle task\n"); g_telnetClientFd = -1; goto ERROUT_UNLOCK; } } 6. 接待员做好接待工作 因接待工作很重要,这边把所有代码贴出来,并加上了大量的注释,目的只有一个,让咱客人爽. STATIC VOID *TelnetClientLoop(VOID *arg) { struct pollfd pollFd; INT32 ret; INT32 nRead; UINT32 len; UINT8 buf[TELNET_CLIENT_READ_BUF_SIZE]; UINT8 *cmdBuf = NULL; INT32 clientFd = (INT32)(UINTPTR)arg; (VOID)prctl(PR_SET_NAME, "TelnetClientLoop", 0, 0, 0); TelnetLock(); if (TelnetClientPrepare(clientFd) != 0) {//做好准备工作 TelnetUnlock(); (VOID)close(clientFd); return NULL; } TelnetUnlock(); while (1) {//死循环接受远程输入的数据 pollFd.fd = clientFd; pollFd.events = POLLIN | POLLRDHUP;//监听读数据和挂起事件 pollFd.revents = 0; /* POLLIN 普通或优先级带数据可读 POLLRDNORM 普通数据可读 POLLRDBAND 优先级带数据可读 POLLPRI 高优先级数据可读 POLLOUT 普通数据可写 POLLWRNORM 普通数据可写 POLLWRBAND 优先级带数据可写 POLLERR 发生错误 POLLHUP 发生挂起 POLLNVAL 描述字不是一个打开的文件 poll本质上和select没有区别,它将用户传入的数组拷贝到内核空间,然后查询每个fd对应的设备状态, 如果设备就绪则在设备等待队列中加入一项并继续遍历,如果遍历完所有fd后没有发现就绪设备,则挂起当前进程, 直到设备就绪或者主动超时,被唤醒后它又要再次遍历fd。 这个过程经历了多次无谓的遍历。 poll还有一个特点是“水平触发”,如果报告了fd后,没有被处理,那么下次poll时会再次报告该fd。 poll与select的不同,通过一个pollfd数组向内核传递需要关注的事件,故没有描述符个数的限制, pollfd中的events字段和revents分别用于标示关注的事件和发生的事件,故pollfd数组只需要被初始化一次 poll的实现机制与select类似,其对应内核中的sys_poll,只不过poll向内核传递pollfd数组, 然后对pollfd中的每个描述符进行poll,相比处理fdset来说,poll效率更高。poll返回后, 需要对pollfd中的每个元素检查其revents值,来得指事件是否发生。 优点 1)poll() 不要求开发者计算最大文件描述符加一的大小。 2)poll() 在应付大数目的文件描述符的时候速度更快,相比于select。 3)它没有最大连接数的限制,原因是它是基于链表来存储的。 缺点 1)大量的fd的数组被整体复制于用户态和内核地址空间之间,而不管这样的复制是不是有意义。 2)与select一样,poll返回后,需要轮询pollfd来获取就绪的描述符 */ ret = poll(&pollFd, 1, TELNET_CLIENT_POLL_TIMEOUT);//等2秒钟返回 if (ret < 0) {//失败时,poll()返回-1 break; /* ret < 0 各值 EBADF 一个或多个结构体中指定的文件描述符无效。 EFAULTfds 指针指向的地址超出进程的地址空间。 EINTR 请求的事件之前产生一个信号,调用可以重新发起。 EINVALnfds 参数超出PLIMIT_NOFILE值。 ENOMEM 可用内存不足,无法完成请求 */ } if (ret == 0) {//如果在超时前没有任何事件发生,poll()返回0 continue; } /* connection reset, maybe keepalive failed or reset by peer | 连接重置,可能keepalive失败或被peer重置*/ if ((UINT16)pollFd.revents & (POLLERR | POLLHUP | POLLRDHUP)) { break; } if ((UINT16)pollFd.revents & POLLIN) {//数据事件 nRead = read(clientFd, buf, sizeof(buf));//读远程终端过来的数据 if (nRead <= 0) { /* telnet client shutdown */ break; } cmdBuf = ReadFilter(buf, (UINT32)nRead, &len);//对数据过滤 if (len > 0) { (VOID)TelnetTx((CHAR *)cmdBuf, len);//对数据加工处理 } } } TelnetLock(); TelnetClientClose(); (VOID)close(clientFd); clientFd = -1; g_telnetClientFd = -1; TelnetUnlock(); return NULL; } 最后结语 理解远程登录的实现建议结合 shell编辑篇 ,shell执行篇 ,控制台篇 三篇来理解,实际上它们是上中下三层. 百篇博客分析.深挖内核地基 给鸿蒙内核源码加注释过程中,整理出以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切.确实有难度,自不量力,但已经出发,回头已是不可能的了。 😛 与代码有bug需不断debug一样,文章和注解内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 按功能模块: 前因后果 基础工具 加载运行 进程管理 总目录 调度故事 内存主奴 源码注释 源码结构 静态站点 参考文档 双向链表 位图管理 用栈方式 定时器 原子操作 时间管理 ELF格式 ELF解析 静态链接 重定位 进程映像 进程管理 进程概念 Fork 特殊进程 进程回收 信号生产 信号消费 Shell编辑 Shell解析 编译构建 进程通讯 内存管理 任务管理 编译环境 编译过程 环境脚本 构建工具 gn应用 忍者ninja 自旋锁 互斥锁 进程通讯 信号量 事件控制 消息队列 内存分配 内存管理 内存汇编 内存映射 内存规则 物理内存 时钟任务 任务调度 任务管理 调度队列 调度机制 线程概念 并发并行 CPU 系统调用 任务切换 文件系统 硬件架构 文件概念 文件系统 索引节点 挂载目录 根文件系统 字符设备 VFS 文件句柄 管道文件 控制台 远程登录 汇编基础 汇编传参 工作模式 寄存器 异常接管 汇编汇总 中断切换 中断概念 中断管理 百万汉字注解.精读内核源码 鸿蒙研究站( weharmonyos ) | 每天死磕一点点,原创不易,欢迎转载,请注明出处。若能支持点赞则更佳,感谢每一份支持。

优秀的个人博客,低调大师

鸿蒙内核源码分析(管道文件篇) | 如何降低数据流动成本 | 百篇博客分析OpenHarmony源码 | v70.01

百篇博客系列篇.本篇为: v70.xx 鸿蒙内核源码分析(管道文件篇) | 如何降低数据流动成本 | 51 .c .h .o 文件系统相关篇为: v62.xx 鸿蒙内核源码分析(文件概念篇) | 为什么说一切皆是文件 | 51 .c .h .o v63.xx 鸿蒙内核源码分析(文件系统篇) | 用图书管理说文件系统 | 51 .c .h .o v64.xx 鸿蒙内核源码分析(索引节点篇) | 谁是文件系统最重要的概念 | 51 .c .h .o v65.xx 鸿蒙内核源码分析(挂载目录篇) | 为何文件系统需要挂载 | 51 .c .h .o v66.xx 鸿蒙内核源码分析(根文件系统) | 先挂到/上的文件系统 | 51 .c .h .o v67.xx 鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 51 .c .h .o v68.xx 鸿蒙内核源码分析(VFS篇) | 文件系统和谐共处的基础 | 51 .c .h .o v69.xx 鸿蒙内核源码分析(文件句柄篇) | 深挖应用操作文件的细节 | 51 .c .h .o v70.xx 鸿蒙内核源码分析(管道文件篇) | 如何降低数据流动成本 | 51 .c .h .o 什么是管道 管道 | pipes 最早最清晰的陈述来源于 McIlroy由1964年写的一份内部文件.这份文件提出像花园的水管那样把程序连接在一起.文档全文内容如下: Summary--what's most important. To put my strongest concerns into a nutshell: 1. We should have some ways of coupling programs like garden hose--screw in another segment when it becomes when it becomes necessary to massage data in another way. This is the way of IO also. 2. Our loader should be able to do link-loading and controlled establishment. 3. Our library filing scheme should allow for rather general indexing, responsibility, generations, data path switching. 4. It should be possible to get private system components (all routines are system components) for buggering around with. M. D. McIlroy October 11, 1964 Unix的缔造者肯.汤普森只花了一个小时就在操作系统中实现了管道的系统调用.他自己说这是简直小菜一碟,因为I/O的重定向机制是管道的实现基础,但效果确是很震撼.管道的本质是I/O的重定向,是对数据的不断编辑,不断流动,只有这样的数据才有价值. 在文件概念篇中提到过,Unix "一切皆文件"的说法是源于输入输出的共性,只要涵盖这两个特性都可以也应当被抽象成文件统一管理和流动. 拿跟城市的发展来举例,越是人口流动和资金流动频繁的城市一定是越发达的城市.这个道理请仔细品,城市的规划应该让流动的成本变低,时间变短,而不是到处查身份证,查户口本.对内核设计者来说也是一样,能让数据流动的成本变得极为简单,方便的系统也一定是好的架构,Unix能做到多年强盛不衰其中一个重要原因是它仅用一个|符号实现了文件之间的流动性问题.这是一种伟大的创举,必须用专门的章篇对其大书特书. 管道符号 | 管道符号是两个命令直接的一道竖杠 |,简单而优雅,例如,ls用于显示某个目录中文件,wc用于统计行数. ls | wc 则代表统计某个目录下的文件数量 再看个复杂的: $ < colors.txt sort | uniq -c | sort -r | head -3 > favcolors.txt colors.txt为原始的文件内容,输出给sort处理 sort 对 colors.txt内容进行顺序编辑后输出给 uniq处理 uniq 对 内容进行去重编辑后输出给 sort -r处理 sort -r 对内容进行倒序编辑后输出给 head -3处理 head -3 对 内容进行取前三编辑后输出到favcolors.txt文件保存. 最后 cat favcolors.txt查看结果 $ cat favcolors.txt 4 red 3 blue 2 green 经典管道案例 以下是linux官方对管道的经典案例. 查看 pipe #include <sys/types.h> #include <sys/wait.h> #include <stdio.h> #include <stdlib.h> #include <unistd.h> #include <string.h> int main(int argc, char *argv[]) { int pipefd[2]; pid_t cpid; char buf; if (argc != 2) { fprintf(stderr, "Usage: %s <string>\n", argv[0]); exit(EXIT_FAILURE); } if (pipe(pipefd) == -1) { perror("pipe"); exit(EXIT_FAILURE); } cpid = fork(); if (cpid == -1) { perror("fork"); exit(EXIT_FAILURE); } if (cpid == 0) { /* Child reads from pipe */ close(pipefd[1]); /* Close unused write end */ while (read(pipefd[0], &buf, 1) > 0) write(STDOUT_FILENO, &buf, 1); write(STDOUT_FILENO, "\n", 1); close(pipefd[0]); _exit(EXIT_SUCCESS); } else { /* Parent writes argv[1] to pipe */ close(pipefd[0]); /* Close unused read end */ write(pipefd[1], argv[1], strlen(argv[1])); close(pipefd[1]); /* Reader will see EOF */ wait(NULL); /* Wait for child */ exit(EXIT_SUCCESS); } } 解读 pipe(pipefd)为系统调用,申请了两个文件句柄,并对这两个文件进行了管道绑定. 在鸿蒙管道的系统调用为 SysPipe,具体实现往下看. main进程fork()了一个子进程,具体的fork过程请前往 v45.xx (Fork篇) | 一次调用,两次返回 翻看.子进程将复制父进程的文件资源.所以子进程cpid也拥有了pipefd两个句柄,背后的含义就是可以去操作pipefd对应的文件 if (cpid == 0)代表的是子进程的返回, close(pipefd[1])关闭了pipefd[1]文件句柄,因为程序设计成子进程负责读文件操作,它并不需要操作pipefd[1] while (read(pipefd[0], &buf, 1)子进程不断的读取文件pipefd[0]的内容. 按理说能不断的读取pipefd[0]数据说明有进程在不断的往pipefd[0]中写入数据.但管道的思想是往pipefd[1]中写入数据,数据却能跑到pipefd[0]中. (cpid > 0) 也就是代码中的} else { 代表的是父进程main的返回. close(pipefd[0])关闭了pipefd[0]文件句柄,因为程序设计成父进程负责写文件,它并不需要操作pipefd[0] write(pipefd[1], argv[1], strlen(argv[1]))父进程往pipefd[1]中写入数据.数据将会出现在pipefd[0]中供子进程读取. 鸿蒙实现 管道的实现函数级调用关系如下: SysPipe //系统调用 AllocProcessFd //分配两个进程描述符 pipe //底层管道的真正实现 pipe_allocate //分配管道 "/dev/pipe%d" //生成创建管道文件路径,用于创建两个系统文件句柄 pipecommon_allocdev //分配管道共用的空间 register_driver //注册管道设备驱动程序 open //打开两个系统文件句柄 fs_getfilep //获取两个系统文件句柄的实体对象 `file` AssociateSystemFd //进程和系统文件句柄的绑定 其中最关键的是pipe,它才是真正实现管道思想的落地代码,代码稍微有点多,但看明白了这个函数就彻底明白了管道是怎么回事了,看之前先建议看文件系统相关篇幅,有了铺垫再看代码和解读就很容易明白. int pipe(int fd[2]) { struct pipe_dev_s *dev = NULL; char devname[16]; int pipeno; int errcode; int ret; struct file *filep = NULL; size_t bufsize = 1024; /* Get exclusive access to the pipe allocation data */ ret = sem_wait(&g_pipesem); if (ret < 0) { errcode = -ret; goto errout; } /* Allocate a minor number for the pipe device */ pipeno = pipe_allocate(); if (pipeno < 0) { (void)sem_post(&g_pipesem); errcode = -pipeno; goto errout; } /* Create a pathname to the pipe device */ snprintf_s(devname, sizeof(devname), sizeof(devname) - 1, "/dev/pipe%d", pipeno); /* No.. Allocate and initialize a new device structure instance */ dev = pipecommon_allocdev(bufsize, devname); if (!dev) { (void)sem_post(&g_pipesem); errcode = ENOMEM; goto errout_with_pipe; } dev->d_pipeno = pipeno; /* Check if the pipe device has already been created */ if ((g_pipecreated & (1 << pipeno)) == 0) { /* Register the pipe device */ ret = register_driver(devname, &pipe_fops, 0660, (void *)dev); if (ret != 0) { (void)sem_post(&g_pipesem); errcode = -ret; goto errout_with_dev; } /* Remember that we created this device */ g_pipecreated |= (1 << pipeno); } else { UpdateDev(dev); } (void)sem_post(&g_pipesem); /* Get a write file descriptor */ fd[1] = open(devname, O_WRONLY); if (fd[1] < 0) { errcode = -fd[1]; goto errout_with_driver; } /* Get a read file descriptor */ fd[0] = open(devname, O_RDONLY); if (fd[0] < 0) { errcode = -fd[0]; goto errout_with_wrfd; } ret = fs_getfilep(fd[0], &filep); filep->ops = &pipe_fops; ret = fs_getfilep(fd[1], &filep); filep->ops = &pipe_fops; return OK; errout_with_wrfd: close(fd[1]); errout_with_driver: unregister_driver(devname); errout_with_dev: if (dev) { pipecommon_freedev(dev); } errout_with_pipe: pipe_free(pipeno); errout: set_errno(errcode); return VFS_ERROR; } 解读 在鸿蒙管道多少也是有限制的,也由位图来管理,最大支持32个,用一个32位的变量g_pipeset就够了,位图如何管理请自行翻看位图管理篇.要用就必须申请,由pipe_allocate负责. #define MAX_PIPES 32 //最大支持管道数 static sem_t g_pipesem = {NULL}; static uint32_t g_pipeset = 0; //管道位图管理器 static uint32_t g_pipecreated = 0; static inline int pipe_allocate(void) { int pipeno; int ret = -ENFILE; for (pipeno = 0; pipeno < MAX_PIPES; pipeno++) { if ((g_pipeset & (1 << pipeno)) == 0) { g_pipeset |= (1 << pipeno); ret = pipeno; break; } } return ret; } 管道对外表面上看似对两个文件的操作,其实是对一块内存的读写操作.操作内存就需要申请内存块,鸿蒙默认用了1024 | 1K内存,操作文件就需要文件路径/dev/pipe%d. size_t bufsize = 1024; snprintf_s(devname, sizeof(devname), sizeof(devname) - 1, "/dev/pipe%d", pipeno); dev = pipecommon_allocdev(bufsize, devname); 紧接着就是要提供操作文件/dev/pipe%d的VFS,即注册文件系统的驱动程序,上层的读写操作,到了底层真正的读写是由pipecommon_read和pipecommon_write落地. ret = register_driver(devname, &pipe_fops, 0660, (void *)dev); static const struct file_operations_vfs pipe_fops = { .open = pipecommon_open, /* open */ .close = pipe_close, /* close */ .read = pipecommon_read, /* read */ .write = pipecommon_write, /* write */ .seek = NULL, /* seek */ .ioctl = NULL, /* ioctl */ .mmap = pipe_map, /* mmap */ .poll = pipecommon_poll, /* poll */ #ifndef CONFIG_DISABLE_PSEUDOFS_OPERATIONS .unlink = pipe_unlink, /* unlink */ #endif }; pipecommon_read代码有点多,此处不放出来,代码中加了很多的信号量,目的就是确保对这块共享内存能正常操作. 要操作两个文件句柄就必须都要打开文件,只不过打开方式一个是读,一个是写,pipe默认是对fd[1]为写入,fd[0]为读取,这里可翻回去看下经典管道案例的读取过程. fd[1] = open(devname, O_WRONLY); fd[0] = open(devname, O_RDONLY); 最后绑定file的文件接口操作,在文件句柄篇中已详细说明,应用程序操作的是fd | 文件句柄,到了内核是需要通过fd找到file,再找到file->ops才能真正的操作文件. ret = fs_getfilep(fd[0], &filep); filep->ops = &pipe_fops; ret = fs_getfilep(fd[1], &filep); filep->ops = &pipe_fops; 鸿蒙内核源码分析.总目录 v08.xx 鸿蒙内核源码分析(总目录) | 百万汉字注解 百篇博客分析 | 51 .c .h .o 百万汉字注解.百篇博客分析 百万汉字注解 >> 精读鸿蒙源码,中文注解分析, 深挖地基工程,大脑永久记忆,四大码仓每日同步更新< gitee | github | csdn | coding > 百篇博客分析 >> 故事说内核,问答式导读,生活式比喻,表格化说明,图形化展示,主流站点定期更新中< 51cto | csdn | harmony | osc > 关注不迷路.代码即人生 QQ群:790015635 | 入群密码: 666 原创不易,欢迎转载,但请注明出处.

优秀的个人博客,低调大师

鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 百篇博客分析OpenHarmony源码 | v67.01

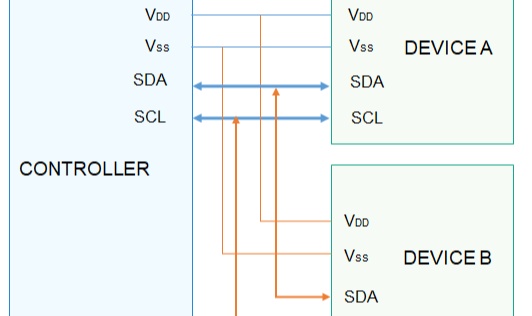
百篇博客系列篇.本篇为: v67.xx 鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 51 .c .h .o 文件系统相关篇为: v62.xx 鸿蒙内核源码分析(文件概念篇) | 为什么说一切皆是文件 | 51 .c .h .o v63.xx 鸿蒙内核源码分析(文件系统篇) | 用图书管理说文件系统 | 51 .c .h .o v64.xx 鸿蒙内核源码分析(索引节点篇) | 谁是文件系统最重要的概念 | 51 .c .h .o v65.xx 鸿蒙内核源码分析(挂载目录篇) | 为何文件系统需要挂载 | 51 .c .h .o v66.xx 鸿蒙内核源码分析(根文件系统) | 先挂到/上的文件系统 | 51 .c .h .o v67.xx 鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 51 .c .h .o 什么是设备 设备(device): 是提供输入或输出功能的一种载体,其包括物理设备(对实际存在的物理硬件的抽象)例如,键盘是一种输入设备,硬盘是输入和输出设备。也包括虚拟设备(不依赖于特定的物理硬件,仅是内核自身提供的模拟/虚拟功能). 例如:虚拟控制台是输入和输出设备。每个设备都对应一个文件(设备文件),这些设备文件统一放在一个公共位置/dev下,通过设备文件(或称设备节点)来使用驱动程序操作设备。 设备按照存取方式的不同,分为两类: 字符设备: 字符设备按字符处理。最明显的例子是键盘,其中每个键在设备上生成一个字符。还有鼠标,每一个动作或按钮点击都会发送一个字符到 /dev/mouse 设备。字符设备可理解为商品零售商,可以一件一件的卖,卖的细自然就卖的少. 块设备:以更大的块读取数据的存储设备,如IDE硬盘也叫机械硬盘(/dev/hd)、SCSI硬盘也叫固态硬盘(/dev/sd) 和 CD-ROM (/dev/cdrom) 是块设备。输入输出与块设备的交互处理数据块,允许大量数据来回移动提高效率。块设备可理解为商品批发商,必须一箱一箱的卖,卖的粗但吞吐量大. 字符设备还是块设备的定义属于内核设备访问层,与实际物理设备的特性无必然联系。设备访问层下面是驱动程序,存取方式取决于驱动程序是否支持,也可以同时支持两种方式访问物理设备,是块设备还是字符设备由使用者(往往是内核)决定。 鸿蒙系统中常见的字符设备如下: mem | 内存设备 /dev/mem 物理内存的全镜像。可以用来直接存取物理内存。 /dev/kmem 内核看到的虚拟内存的全镜像。其访问的是虚拟内存而不是物理内存。 /dev/null 空设备。也叫黑洞设备,任何写入都将被直接丢弃(但返回"成功");任何读取都将得到EOF(文件结束标志)。 /dev/port 存取I/O端口 /dev/zero 零流源。任何写入都将被直接丢弃(但返回"成功");任何读取都将得到无限多的二进制零流。 /dev/full 满设备。任何写入都将失败,并把errno设为ENOSPC(没有剩余空间);任何读取都将得到无限多的二进制零流。 这个设备通常被用来测试程序在遇到磁盘无剩余空间错误时的行为。 /dev/random 真随机数发生器。以背景噪声数据或硬件随机数发生器作为熵池,读取时会返回小于熵池噪声总数的随机字节。 若熵池空了,读操作将会被阻塞,直到收集到了足够的环境噪声为止。建议用于需要生成高强度密钥的场合。 [注意]虽然允许写入,但企图通过写入此文件来"预存"随机数是徒劳的,因为写入的数据对输出并无影响。 /dev/urandom 伪随机数发生器。更快,但是不够安全。仅用于对安全性要求不高的场合。 即使熵池空了,读操作也不会被阻塞,而是把已经产生的随机数做为种子来产生新的随机数。 [注意]虽然允许写入,但企图通过写入此文件来"预存"随机数是徒劳的,因为写入的数据对输出并无影响。 /dev/aio 异步I/O通知接口 /dev/kmsg 任何对该文件的写入都将作为printk的输出;而读取则得到printk的输出缓冲区内容。 在鸿蒙,/dev/mem 是一个字符设备, 源文件是 kernel/drivers/char/mem/src/mem.c, 这个设备文件是专门用来读写物理地址用的。里面的内容是所有物理内存的地址以及内容信息。通常只有root用户对其有读写权限。利用 mmap和/dev/mem建立起直接读写系统物理内存的渠道。利用/dev/mem和mmap导出系统物理地址,免去了用户虚拟地址到内核逻辑地址的繁琐拷贝,提升效率。 //文件和线性区的映射关系 static ssize_t MemMap(struct file *filep, LosVmMapRegion *region) { #ifdef LOSCFG_KERNEL_VM size_t size = region->range.size; PADDR_T paddr = region->pgOff << PAGE_SHIFT; VADDR_T vaddr = region->range.base; LosVmSpace *space = LOS_SpaceGet(vaddr); if ((paddr >= SYS_MEM_BASE) && (paddr < SYS_MEM_END)) { return -EINVAL; } /* Peripheral register memory adds strongly ordered attributes */ region->regionFlags |= VM_MAP_REGION_FLAG_STRONGLY_ORDERED; if (space == NULL) { return -EAGAIN; }//映射 if (LOS_ArchMmuMap(&space->archMmu, vaddr, paddr, size >> PAGE_SHIFT, region->regionFlags) <= 0) { return -EAGAIN; } #else UNUSED(filep); UNUSED(region); #endif return 0; } // vfs 接口实现 static const struct file_operations_vfs g_memDevOps = { MemOpen, /* open */ MemClose, /* close */ MemRead, /* read */ MemWrite, /* write */ NULL, /* seek */ NULL, /* ioctl */ MemMap, /* mmap */ #ifndef CONFIG_DISABLE_POLL NULL, /* poll */ #endif NULL, /* unlink */ }; // 注册/dev/mem 的驱动程序 int DevMemRegister(void) { return register_driver("/dev/mem", &g_memDevOps, 0666, 0); /* 0666: file mode */ } tty | 终端设备 TTY 是 Teletype 或 Teletypewriter 的缩写,原来是指电传打字机,后来这种设备逐渐键盘和显示器取代。不管是电传打字机还是键盘显示器,都是作为计算机的终端设备存在的,所以 TTY 也泛指计算机的终端(terminal)设备,一般分成以下几种 串行端口终端(/dev/ttySn) 伪终端(/dev/pty/) 控制终端(/dev/tty) 控制台终端(/dev/ttyn, /dev/console),将在后续 控制台篇 中详细说明 RTC | 时钟设备 /dev/rtc 实时时钟(Real Time Clock) RTC(real-time clock)为操作系统中的实时时钟设备,为操作系统提供精准的实时时间和定时报警功能。当设备下电后,通过外置电池供电,RTC继续记录操作系统时间;设备上电后,RTC提供实时时钟给操作系统,确保断电后系统时间的连续性 RTC它可以用于产生年、月、日、时、分、秒等信息。目前实时时钟芯片大多采用精度较高的晶体振荡器作为时钟源。有些时钟芯片为了在主电源掉电时还可以工作,会外加电池供电,使时间信息一直保持有效。 鸿蒙RTC设备API接口功能介绍 RtcOpen 获取RTC设备驱动句柄 RtcClose 释放RTC设备驱动句柄 RtcReadTime 读RTC时间信息,包括年、月、星期、日、时、分、秒、毫秒 RtcWriteTime 写RTC时间信息,包括年、月、星期、日、时、分、秒、毫秒 RtcReadAlarm 读RTC报警时间信息 RtcWriteAlarm 写RTC报警时间信息 RtcRegisterAlarmCallback 注册报警超时回调函数 RtcAlarmInterruptEnable 使能/去使能RTC报警中断 RtcGetFreq 读RTC外接晶振频率 RtcSetFreq 配置RTC外接晶振频率 RtcReset RTC复位 RtcReadReg 读用户自定义寄存器 RtcWriteReg 写用户自定义寄存器 I2C | 总线设备 /dev/i2c-0 第1个 I2C 适配器 ... /dev/i2c-n 第n-1个 I2C 适配器 I2C(Inter Integrated Circuit)总线是由Philips公司开发的一种简单、双向二线制同步串行总线。 I2C以主从方式工作,通常有一个主设备和一个或者多个从设备,主从设备通过SDA(SerialData)串行数据线以及SCL(SerialClock)串行时钟线两根线相连,如下图所示。 I2C数据的传输必须以一个起始信号作为开始条件,以一个结束信号作为传输的停止条件。数据传输以字节为单位,高位在前,逐个bit进行传输。 I2C总线上的每一个设备都可以作为主设备或者从设备,而且每一个设备都会对应一个唯一的地址,当主设备需要和某一个从设备通信时,通过广播的方式,将从设备地址写到总线上,如果某个从设备符合此地址,将会发出应答信号,建立传输。 I2C接口定义了完成I2C传输的通用方法集合,包括: I2C控制器管理: 打开或关闭I2C控制器 I2C消息传输:通过消息传输结构体数组进行自定义传输 鸿蒙I2C驱动API接口功能介绍 I2cOpen 打开I2C控制器 I2cClose 关闭I2C控制器 I2cTransfer 自定义传输,I2c消息传输接口 SPI | 串行外设设备 SPI是串行外设接口(Serial Peripheral Interface)的缩写,是一种高速的,全双工,同步的通信总线。 SPI是由Motorola公司开发,用于在主设备和从设备之间进行通信,常用于与闪存、实时时钟、传感器以及模数转换器等进行通信。 SPI以主从方式工作,通常有一个主设备和一个或者多个从设备。主设备和从设备之间一般用4根线相连,它们分别是: SCLK – 时钟信号,由主设备产生;(Serial Clock) MOSI – 主设备数据输出,从设备数据输入;(SPI Bus Master Output/Slave Input) MISO – 主设备数据输入,从设备数据输出;(SPI Bus Master Input/Slave Output)。 CS – 片选,从设备使能信号,由主设备控制。(Chip select) SPI主从设备连接示意图 SPI通信通常由主设备发起,通过以下步骤完成一次通信: 通过CS选中要通信的从设备,在任意时刻,一个主设备上最多只能有一个从设备被选中。 通过SCLK给选中的从设备提供时钟信号。 基于SCLK时钟信号,主设备数据通过MOSI发送给从设备,同时通过MISO接收从设备发送的数据,完成通信。 根据SCLK时钟信号的CPOL(Clock Polarity,时钟极性)和CPHA(Clock Phase,时钟相位)的不同组合,SPI有以下四种工作模式: CPOL=0,CPHA=0 时钟信号idle状态为低电平,第一个时钟边沿采样数据。 CPOL=0,CPHA=1 时钟信号idle状态为低电平,第二个时钟边沿采样数据。 CPOL=1,CPHA=0 时钟信号idle状态为高电平,第一个时钟边沿采样数据。 CPOL=1,CPHA=1 时钟信号idle状态为高电平,第二个时钟边沿采样数据。 SPI接口定义了操作SPI设备的通用方法集合,包括: SPI设备句柄获取和释放。 SPI读写: 从SPI设备读取或写入指定长度数据。 SPI自定义传输:通过消息传输结构体执行任意读写组合过程。 SPI设备配置:获取和设置SPI设备属性。 鸿蒙SPI驱动API接口功能介绍 SpiOpen 获取SPI设备句柄 SpiClose 释放SPI设备句柄 SpiRead 读取指定长度的数据 SpiWrite 写入指定长度的数据 SpiTransfer SPI数据传输接口 SpiSetCfg 根据指定参数,配置SPI设备 SpiGetCfg 获取SPI设备配置参数 UART | 串口设备 /dev/ttyS0 第1个UART串口(Serial port) ... /dev/ttyS200 第199个UART串口 串口设备是终端设备的一种,采用 /dev/ttySn 或 /dev/tts/n 来表示,分别对应于windows系统下的COM1、COM2等。若要向一个端口发送数据,可以在命令行上把标准输出重定向到这些特殊文件名上即可,例如,在命令行提示符下键入:echo test > /dev/ttyS1会把单词”test”发送到连接在ttyS1(COM2)端口的设备上。 UART(Universal Asynchronous Receiver/Transmitter)通用异步收发传输器,UART 作为异步串口通信协议的一种,工作原理是将传输数据的每个字符一位接一位地传输。是在应用程序开发过程中使用频率最高的数据总线。 UART应用比较广泛,常用于输出打印信息,也可以外接各种模块,如GPS、蓝牙等。 UART 串口的特点是将数据一位一位地顺序传送,只要 2 根传输线就可以实现双向通信,一根线发送数据的同时用另一根线接收数据。UART 串口通信有几个重要的参数,分别是波特率、起始位、数据位、停止位和奇偶检验位,对于两个使用 UART 串口通信的端口,这些参数必须匹配,否则通信将无法正常完成。UART 串口传输的数据格式如下图所示: 起始位:表示数据传输的开始,电平逻辑为 “0” 。 数据位:可能值有 5、6、7、8、9,表示传输这几个 bit 位数据。一般取值为 8,因为一个 ASCII 字符值为 8 位。 奇偶校验位:用于接收方对接收到的数据进行校验,校验 “1” 的位数为偶数(偶校验)或奇数(奇校验),以此来校验数据传送的正确性,使用时不需要此位也可以。 停止位: 表示一帧数据的结束。电平逻辑为 “1”。 波特率:串口通信时的速率,它用单位时间内传输的二进制代码的有效位(bit)数来表示,其单位为每秒比特数 bit/s(bps)。常见的波特率值有 4800、9600、14400、38400、115200等,数值越大数据传输的越快,波特率为 115200 表示每秒钟传输 115200 位数据。 UART接口定义了操作UART端口的通用方法集合,包括获取、释放设备句柄、读写数据、获取和设置波特率、获取和设置设备属性。 鸿蒙UART驱动API接口功能介绍 UartOpen UART获取设备句柄 UartClose UART释放设备句柄 UartRead 从UART设备中读取指定长度的数据 UartWrite 向UART设备中写入指定长度的数据 UartGetBaud UART获取波特率 UartSetBaud UART设置波特率 UartGetAttribute UART获取设备属性 UartSetAttribute UART设置设备属性 UartSetTransMode UART设置传输模式 LCD | 屏显设备 /dev/lcd 液晶(LCD)显示屏 LCD(Liquid Crystal Display)液晶显示驱动,对LCD进行上电,并通过接口初始化LCD内部寄存器,使LCD正常工作。Display驱动模型基于HDF( Hardware Driver Foundation)驱动框架开发,实现跨OS、跨平台,为LCD硬件提供上下电功能、发送初始化序列功能,使LCD进入正常的工作模式,显示芯片平台侧的图像数据. 基于HDF驱动框架的Display驱动模型 Touchscreen | 触摸设备 Touch(触摸芯片)是 UI 设计中进行人机交互重要的一部分,一个完整的 UI 设计应该包括输入信息和输出信息,LCD 等屏幕设备负责显示输出,那么 Touch 设备就负责触点信息采集作为信息输入。 Touch 设备与主机通讯一般都是采用 I2C 总线协议来进行数据交互,所以一个 Touch 设备,就是一个标准的 I2C 从设备,而且为了提高接收 Touch 数据的实时性,触摸芯片都会提供中断支持,当有触摸事件(抬起,按下,移动)发生时,会触发中断通知 MCU 有触摸事件。主机可以通过中断回调函数去读取触摸点信息。 Touchscreen器件的硬件接口相对简单,根据PIN脚的属性,可以简单分为如下三类: 电源接口 IO控制接口 通信接口 Touchscreen驱动用于驱动触摸屏使其正常工作,该驱动主要完成如下工作:对触摸屏驱动IC进行上电、配置硬件管脚并初始化其状态、注册中断、配置通信接口(I2C或SPI)、设定input相关配置、下载及更新固件等操作。 鸿蒙基于input驱动模型开发touchscreen器件驱动。Input驱动模型基于HDF驱动框架、PLATFORM接口、OSAL接口进行开发,向上对接规范化的驱动接口HDI(Hardware Driver Interface)层,通过Input-HDI层对外提供硬件能力,即上层input service可以通过HDI接口层获取相应的驱动能力,进而操控touchscreen等输入设备。 基于HDF驱动框架的input驱动模型 sensor | 传感设备 /dev/biometric/sensor0/fingerprint 第1个设备的第1个指纹传感器 /dev/biometric/sensor0/iris 第1个设备的第1个虹膜传感器 /dev/biometric/sensor0/retina 第1个设备的第1个视网膜传感器 /dev/biometric/sensor0/voiceprint 第1个设备的第1个声波传感器 /dev/biometric/sensor0/facial 第1个设备的第1个面部传感器 /dev/biometric/sensor0/hand 第1个设备的第1个手掌传感器 /dev/biometric/sensor1/fingerprint 第2个设备的第1个指纹传感器 /dev/biometric/sensor2/fingerprint 第3个设备的第1个指纹传感器 Sensor(传感器)是物联网重要的一部分,Sensor 之于物联网”就相当于“眼睛之于人类"。人类如果没有了眼睛就看不到这大千的花花世界,对于物联网来说也是一样。 如今随着物联网的发展,已经有大量的 Sensor 被开发出来供开发者选择了,如:加速度计(Accelerometer)、磁力计(Magnetometer)、陀螺仪(Gyroscope)、气压计(Barometer/pressure)、湿度计(Humidometer)等。这些传感器,世界上的各大半导体厂商都有生产,虽然增加了市场的可选择性,同时也加大了应用程序开发的难度。因为不同的传感器厂商、不同的传感器都需要配套自己独有的驱动才能运转起来,这样在开发应用程序的时候就需要针对不同的传感器做适配,自然加大了开发难度。 为了降低应用开发的难度,增加传感器驱动的可复用性, 鸿蒙Sensor(传感器)驱动模块为上层Sensor服务系统提供稳定的Sensor基础能力API,包括Sensor列表查询、Sensor启停、Sensor订阅及去订阅,Sensor参数配置等功能;基于HDF(Hardware Driver Foundation)驱动框架开发的Sensor驱动模型,实现跨操作系统迁移,器件差异配置等功能。 鸿蒙Sensor驱动模型图 watchdog | 看门狗 /dev/watchdog 看门狗(CONFIG_WATCHDOG) /dev/watchdogs/0 第一只看门狗 ... /dev/watchdogs/n 第n-1只看门狗 硬件看门狗(watchdog timer)是一个定时器,其定时输出连接到电路的复位端。在产品化的嵌入式系统中,为了使系统在异常情况下能自动复位,一般都需要引入看门狗。 当看门狗启动后,计数器开始自动计数,在计数器溢出前如果没有被复位,计数器溢出就会对 CPU 产生一个复位信号使系统重启(俗称 “被狗咬”)。系统正常运行时,需要在看门狗允许的时间间隔内对看门狗计数器清零(俗称“喂狗“),不让复位信号产生。如果系统不出问题,程序能够按时“喂狗”。一旦程序跑飞,没有“喂狗”,系统“被咬” 复位。 鸿蒙看门狗 API接口功能介绍 WatchdogOpen 打开看门狗设备 WatchdogClose 关闭看门狗设备 WatchdogStart 启动看门狗 WatchdogStop 停止看门狗 WatchdogSetTimeout 设置看门狗超时时间 WatchdogGetTimeout 获取看门狗超时时间 WatchdogGetStatus 获取看门狗状态 WatchdogFeed 清除看门狗定时器(喂狗) WLAN | 无线网络设备 WLAN是基于HDF(Hardware Driver Foundation)驱动框架开发的模块,该模块可实现跨操作系统迁移,自适应器件差异,模块化拼装编译等功能。各WLAN厂商驱动开发人员可根据WLAN模块提供的向下统一接口适配各自的驱动代码,实现如下能力:建立/关闭WLAN热点、扫描、关联WLAN热点等;对HDI层向上提供能力如下:设置MAC地址、设置发射功率、获取设备的MAC地址等。 WLAN框架 WLAN模块有三部分对外开放的API接口 对HDI层提供的能力接口。 驱动直接调用WLAN模块能力接口。 提供给各厂商实现的能力接口。 鸿蒙内核源码分析.总目录 v08.xx 鸿蒙内核源码分析(总目录) | 百万汉字注解 百篇博客分析 | 51 .c .h .o 百万汉字注解.百篇博客分析 百万汉字注解 >> 精读鸿蒙源码,中文注解分析, 深挖地基工程,大脑永久记忆,四大码仓每日同步更新< gitee | github | csdn | coding > 百篇博客分析 >> 故事说内核,问答式导读,生活式比喻,表格化说明,图形化展示,主流站点定期更新中< 51cto | csdn | harmony | osc > 关注不迷路.代码即人生 QQ群:790015635 | 入群请填: 666 原创不易,欢迎转载,但请注明出处.

优秀的个人博客,低调大师

v79.01 鸿蒙内核源码分析(用户态锁篇) | 如何使用快锁Futex(上) | 百篇博客分析OpenHarmony源码

百篇博客分析|本篇为:(用户态锁篇) | 如何使用快锁Futex(上) 进程通讯相关篇为: v26.08 鸿蒙内核源码分析(自旋锁) | 当立贞节牌坊的好同志 v27.05 鸿蒙内核源码分析(互斥锁) | 同样是锁它却更丰满 v28.04 鸿蒙内核源码分析(进程通讯) | 九种进程间通讯方式速揽 v29.05 鸿蒙内核源码分析(信号量) | 谁在解决任务间的同步 v30.07 鸿蒙内核源码分析(事件控制) | 多对多任务如何同步 v33.03 鸿蒙内核源码分析(消息队列) | 进程间如何异步传递大数据 v76.01 鸿蒙内核源码分析(共享内存) | 进程间最快通讯方式 v77.02 鸿蒙内核源码分析(消息封装) | 剖析LiteIpc(上)进程通讯内容 v78.01 鸿蒙内核源码分析(消息映射) | 剖析LiteIpc(下)进程通讯机制 v79.01 鸿蒙内核源码分析(用户态锁) | 如何使用快锁Futex(上) 快锁三篇 鸿蒙内核实现了Futex,系列篇将用三篇来介绍快锁,主要两个原因: 网上介绍Futex的文章很少,全面深入内核介绍的就更少,所以来一次详细整理和挖透。 涉及用户态和内核态打配合,共同作用既要说用户态的使用(一篇)又要说清楚内核态的实现(两篇)。 本篇为第一篇,用户态下如何使用Futex,并借助一个demo来说清楚整个过程。 基本概念 Futex(Fast userspace mutex,用户态快速互斥锁),系列篇简称 快锁 ,是一个在Linux上实现锁定和构建高级抽象锁如信号量和POSIX互斥的基本工具,它第一次出现在linux内核开发的2.5.7版;其语义在2.5.40固定下来,然后在2.6.x系列稳定版内核中出现,是内核提供的一种系统调用能力。通常作为基础组件与用户态的相关锁逻辑结合组成用户态锁,是一种用户态与内核态共同作用的锁,其用户态部分负责锁逻辑,内核态部分负责锁调度。 当用户态线程请求锁时,先在用户态进行锁状态的判断维护,若此时不产生锁的竞争,则直接在用户态进行上锁返回;反之,则需要进行线程的挂起操作,通过Futex系统调用请求内核介入来挂起线程,并维护阻塞队列。 当用户态线程释放锁时,先在用户态进行锁状态的判断维护,若此时没有其他线程被该锁阻塞,则直接在用户态进行解锁返回;反之,则需要进行阻塞线程的唤醒操作,通过Futex系统调用请求内核介入来唤醒阻塞队列中的线程。 存在意义 互斥锁(mutex)是必须进入内核态才知道锁可不可用,没人跟你争就拿走锁回到用户态,有人争就得干等 (包括 有限时间等和无限等待两种,都需让出CPU执行权) 或者放弃本次申请回到用户态继续执行。那为何互斥锁一定要陷入内核态检查呢? 互斥锁(mutex) 本质是竞争内核空间的某个全局变量(LosMux结构体)。应用程序也有全局变量,但其作用域只在自己的用户空间中有效,属于内部资源,有竞争也是应用程序自己内部解决。而应用之间的资源竞争(即内核资源)就需要内核程序来解决,内核空间只有一个,内核的全局变量当然要由内核来管理。应用程序想用内核资源就必须经过系统调用陷入内核态,由内核程序接管CPU,所谓接管本质是要改变程序状态寄存器,CPU将从用户态栈切换至内核态栈运行,执行完成后又要切回用户态栈中继续执行,如此一来栈间上下文的切换就存在系统性能的损耗。没看明白的请前往系列篇 (互斥锁篇) 翻看。 快锁 解决思路是能否在用户态下就知道锁可不可用,因为竞争并不是时刻出现,跑到内核态一看其实往往没人给你争,白跑一趟来回太浪费性能。那问题来了,用户态下如何知道锁可不可用呢? 因为不陷入内核态就访问不到内核的全局变量。而自己私有空间的变量对别的进程又失效不能用。越深入研究内核越有一种这样的感觉,内核的实现可以像数学一样推导出来,非常有意思。数学其实是基于几个常识公理推导出了整个数学体系,因为不如此逻辑就无法自洽。如果对内核有一定程度的了解,这里自然能推导出可以借助 共享内存 来实现! 使用过程 看个linux futex官方demo详细说明下用户态下使用Futex的整个过程,代码不多,但涉及内核的知识点很多,通过它可以检验出内核基本功扎实程度。 //futex_demo.c #define _GNU_SOURCE #include <stdio.h> #include <errno.h> #include <stdatomic.h> #include <stdint.h> #include <stdlib.h> #include <unistd.h> #include <sys/wait.h> #include <sys/mman.h> #include <sys/syscall.h> #include <linux/futex.h> #include <sys/time.h> #define errExit(msg) do { perror(msg); exit(EXIT_FAILURE); \ } while (0) static uint32_t *futex1, *futex2, *iaddr; /// 快速系统调用 static int futex(uint32_t *uaddr, int futex_op, uint32_t val, const struct timespec *timeout, uint32_t *uaddr2, uint32_t val3) { return syscall(SYS_futex, uaddr, futex_op, val, timeout, uaddr2, val3); } /// 申请快锁 static void fwait(uint32_t *futexp) { long s; while (1) { const uint32_t one = 1; if (atomic_compare_exchange_strong(futexp, &one, 0)) break; //申请快锁成功 //申请快锁失败,需等待 s = futex(futexp, FUTEX_WAIT, 0, NULL, NULL, 0); if (s == -1 && errno != EAGAIN) errExit("futex-FUTEX_WAIT"); } } /// 释放快锁 static void fpost(uint32_t *futexp) { long s; const uint32_t zero = 0; if (atomic_compare_exchange_strong(futexp, &zero, 1)) {//释放快锁成功 s = futex(futexp, FUTEX_WAKE, 1, NULL, NULL, 0);//唤醒等锁 进程/线程 if (s == -1) errExit("futex-FUTEX_WAKE"); } } /// 父子进程竞争快锁 int main(int argc, char *argv[]) { pid_t childPid; int nloops; setbuf(stdout, NULL); nloops = (argc > 1) ? atoi(argv[1]) : 3; iaddr = mmap(NULL, sizeof(*iaddr) * 2, PROT_READ | PROT_WRITE, MAP_ANONYMOUS | MAP_SHARED, -1, 0);//创建可读可写匿名共享内存 if (iaddr == MAP_FAILED) errExit("mmap"); futex1 = &iaddr[0]; //绑定锁一地址 futex2 = &iaddr[1]; //绑定锁二地址 *futex1 = 0; // 锁一不可申请 *futex2 = 1; // 锁二可申请 childPid = fork(); if (childPid == -1) errExit("fork"); if (childPid == 0) {//子进程返回 for (int j = 0; j < nloops; j++) { fwait(futex1);//申请锁一 printf("子进程 (%jd) %d\n", (intmax_t) getpid(), j); fpost(futex2);//释放锁二 } exit(EXIT_SUCCESS); } // 父进程返回执行 for (int j = 0; j < nloops; j++) { fwait(futex2);//申请锁二 printf("父进程 (%jd) %d\n", (intmax_t) getpid(), j); fpost(futex1);//释放锁一 } wait(NULL); exit(EXIT_SUCCESS); } 代码在wsl2上编译运行结果如下: root@DESKTOP-5PBPDNG:/home/turing# gcc ./futex_demo.c -o futex_demo root@DESKTOP-5PBPDNG:/home/turing# ./futex_demo 父进程 (283) 0 子进程 (284) 0 父进程 (283) 1 子进程 (284) 1 父进程 (283) 2 子进程 (284) 2 解读 通过系统调用mmap 创建一个可读可写的共享内存iaddr[2]整型数组,完成两个futex锁的初始化。内核会在内存分配一个共享线性区(MAP_ANONYMOUS | MAP_SHARED),该线性区可读可写( PROT_READ | PROT_WRITE) futex1 = &iaddr[0]; //绑定锁一地址 futex2 = &iaddr[1]; //绑定锁二地址 *futex1 = 0; // 锁一不可申请 *futex2 = 1; // 锁二可申请 如此futex1和futex2有初始值并都是共享变量,想详细了解mmap内核实现的可查看系列篇 (线性区篇) 和 (共享内存篇) 有详细介绍。 childPid = fork(); 创建了一个子进程,fork会拷贝父进程线性区的映射给子进程,导致的结果就是父进程的共享线性区到子进程这也是共享线性区,映射的都是相同的物理地址。对fork不熟悉的请前往翻看,系列篇 (fork篇)| 一次调用,两次返回 专门说它。 fwait(申请锁)与fpost(释放锁)成对出现,单独看下申请锁过程 /// 申请快锁 static void fwait(uint32_t *futexp) { long s; while (1) { const uint32_t one = 1; if (atomic_compare_exchange_strong(futexp, &one, 0)) break; //申请快锁成功 //申请快锁失败,需等待 s = futex(futexp, FUTEX_WAIT, 0, NULL, NULL, 0); if (s == -1 && errno != EAGAIN) errExit("futex-FUTEX_WAIT"); } } 死循环的break条件是 atomic_compare_exchange_strong为真,这是个原子比较操作,此处必须这么用,至于为什么请前往翻看系列篇 (原子操作篇)| 谁在为完整性保驾护航 ,注意它是理解Futex的关键所在,它的含义是 在头文件<stdatomic.h>中定义 _Bool atomic_compare_exchange_strong(volatile A * obj,C * expected,C desired); 将所指向的值obj与所指向的值进行原子比较expected,如果相等,则用前者替换前者desired(执行读取 - 修改 - 写入操作)。否则,加载实际值所指向的obj进入*expected(进行负载操作)。 什么意思 ? 来个直白的解释 : 如果 futexp == 1 则 atomic_compare_exchange_strong返回真,同时将 futexp的值变成0,1代表可以持有锁,一旦持有立即变0,别人就拿不到了。所以此处甚秒。而且这发生在用户态。 如果futexp == 0 atomic_compare_exchange_strong返回假,没有拿到锁,就需要陷入内核态去挂起任务等待锁的释放 futex(futexp, FUTEX_WAIT, 0, NULL, NULL, 0) //执行一个等锁的系统调用 最后一个参数为0代表不在内核态停留直接返回用户态,后续将在内核态部分详细说明。 childPid == 0是子进程的返回。不断地申请futex1 释放futex2 if (childPid == 0) {//子进程返回 for (int j = 0; j < nloops; j++) { fwait(futex1); printf("子进程 (%jd) %d\n", (intmax_t) getpid(), j); fpost(futex2); } exit(EXIT_SUCCESS); } 最后的父进程的返回,不断地申请futex2 释放futex1 // 父进程返回执行 for (int j = 0; j < nloops; j++) { fwait(futex2); printf("父进程 (%jd) %d\n", (intmax_t) getpid(), j); fpost(futex1); } wait(NULL); exit(EXIT_SUCCESS); 两把锁的初值为 *futex1 = 0; *futex2 = 1; ,父进程在 fwait(futex2)所以父进程的printf将先执行,*futex2 = 0;锁二变成不可申请,打印完成后释放fpost(futex1)使其结果为*futex1 = 1; 表示锁一可以申请了,而子进程在等fwait(futex1),交替下来执行的结果为 父进程 (283) 0 子进程 (284) 0 父进程 (283) 1 子进程 (284) 1 父进程 (283) 2 子进程 (284) 2 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,公众号回复 百文 可方便阅读。 按功能模块: 前因后果 >> 总目录 | 调度故事 | 内存主奴 | 源码注释 | 源码结构 | 静态站点 | 参考文档 | 基础工具 >> 双向链表 | 位图管理 | 用栈方式 | 定时器 | 原子操作 | 时间管理 | 加载运行 >> ELF格式 | ELF解析 | 静态链接 | 重定位 | 进程映像 | 进程管理 >> 进程管理 | 进程概念 | Fork | 特殊进程 | 进程回收 | 信号生产 | 信号消费 | Shell编辑 | Shell解析 | 编译构建 >> 编译环境 | 编译过程 | 环境脚本 | 构建工具 | gn应用 | 忍者ninja | 进程通讯 >> 自旋锁 | 互斥锁 | 进程通讯 | 信号量 | 事件控制 | 消息队列 | 共享内存 | 消息封装 | 消息映射 | 用户态锁 | 内存管理 >> 内存分配 | 内存管理 | 内存汇编 | 内存映射 | 内存规则 | 物理内存 | 任务管理 >> 时钟任务 | 任务调度 | 任务管理 | 调度队列 | 调度机制 | 线程概念 | 并发并行 | CPU | 系统调用 | 任务切换 | 文件系统 >> 文件概念 | 文件系统 | 索引节点 | 挂载目录 | 根文件系统 | VFS | 文件句柄 | 管道文件 | 硬件架构 >> 汇编基础 | 汇编传参 | 工作模式 | 寄存器 | 异常接管 | 汇编汇总 | 中断切换 | 中断概念 | 中断管理 | 设备驱动 >> 字符设备 | 控制台 | 远程登录 | 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | codechina > 四大码仓推送 | 同步官方源码,公众号中回复 百万 可方便阅读。 关注不迷路 | 代码即人生

优秀的个人博客,低调大师

v73.01 鸿蒙内核源码分析(注释文档篇) | 内核所有函数调用关系图 | 百篇博客分析OpenHarmony源码

百篇博客分析.本篇为: (注释文档篇) | 内核所有函数调用关系图 前因后果相关篇为: v08.03 鸿蒙内核源码分析(总目录) | 百万汉字注解 百篇博客分析 v09.04 鸿蒙内核源码分析(调度故事) | 用故事说内核调度 v10.03 鸿蒙内核源码分析(内存主奴) | 皇上和奴才如何相处 v13.05 鸿蒙内核源码分析(源码注释) | 每天死磕一点点 v18.02 鸿蒙内核源码分析(源码结构) | 内核文件各自含义 v52.05 鸿蒙内核源码分析(静态站点) | 码农都不爱写注释和文档 v73.01 鸿蒙内核源码分析(注释文档) | 内核所有函数调用关系图 工欲善其事 必先利其器 本篇尝试去摸索下鸿蒙内核毛细血管级的脉络,跟踪以下几个问题. 鸿蒙有多少个结构体,结构体中每个成员变量的含义是什么? 鸿蒙main长啥样,其是如何初始化各个模块的? 鸿蒙的任意一个函数的调用和引用关系关系是怎样的? 它已成为众多鸿蒙内核阅读者必不可少的参考手册. 鸿蒙 main 函数长啥样 前往 >> 鸿蒙研究站 | 源码文档版块 点击函数跟踪. /** * @brief * 内核入口函数,由汇编调用,见于reset_vector_up.S 和 reset_vector_mp.S * up指单核CPU, mp指多核CPU bl main * @return LITE_OS_SEC_TEXT_INIT */ LITE_OS_SEC_TEXT_INIT INT32 main(VOID)//由主CPU执行,默认0号CPU 为主CPU { UINT32 uwRet; uwRet = OsMain();// 内核各模块初始化 if (uwRet != LOS_OK) { return LOS_NOK; } CPU_MAP_SET(0, OsHwIDGet());//设置CPU映射,参数0 代表0号CPU OsSchedStart();//调度开始 while (1) { __asm volatile("wfi");//WFI: wait for Interrupt 等待中断,即下一次中断发生前都在此hold住不干活 } } 结构体/宏/枚举类型 前往 >> 鸿蒙研究站 | 查看所有结构体索引 < 任意函数关系图 | 代码实现 | 注解说明 > 三位一体 模块之间关系图 任意头文件的关系图 内核协作图 前往 >> 查看内核模块协作 百篇博客分析.深挖内核地基 给鸿蒙内核源码加注释过程中,整理出以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切.确实有难度,自不量力,但已经出发,回头已是不可能的了。 😛 与代码有bug需不断debug一样,文章和注解内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 按功能模块: so tools load process 总目录 调度故事 内存主奴 源码注释 源码结构 静态站点 注释文档 双向链表 位图管理 用栈方式 定时器 原子操作 时间管理 ELF格式 ELF解析 静态链接 重定位 进程映像 进程管理 进程概念 Fork 特殊进程 进程回收 信号生产 信号消费 Shell编辑 Shell解析 compile ipc mem task 编译环境 编译过程 环境脚本 构建工具 gn应用 忍者ninja 自旋锁 互斥锁 进程通讯 信号量 事件控制 消息队列 内存分配 内存管理 内存汇编 内存映射 内存规则 物理内存 时钟任务 任务调度 任务管理 调度队列 调度机制 线程概念 并发并行 CPU 系统调用 任务切换 fs hw 文件概念 文件系统 索引节点 挂载目录 根文件系统 字符设备 VFS 文件句柄 管道文件 汇编基础 汇编传参 工作模式 寄存器 异常接管 汇编汇总 中断切换 中断概念 中断管理 百万汉字注解.精读内核源码 四大码仓中文注解 . 定期同步官方代码 鸿蒙研究站( weharmonyos ) | 每天死磕一点点,原创不易,欢迎转载,请注明出处。若能支持点赞则更佳,感谢每一份支持。

优秀的个人博客,低调大师

v86.01 鸿蒙内核源码分析(静态分配篇) | 很简单的一位小朋友 | 百篇博客分析 OpenHarmony 源码

本篇关键词:池头、池体、节头、节块 内存管理相关篇为: v31.02 鸿蒙内核源码分析(内存规则) | 内存管理到底在管什么 v32.04 鸿蒙内核源码分析(物理内存) | 真实的可不一定精彩 v33.04 鸿蒙内核源码分析(内存概念) | RAM & ROM & Flash v34.03 鸿蒙内核源码分析(虚实映射) | 映射是伟大的发明 v35.02 鸿蒙内核源码分析(页表管理) | 映射关系保存在哪 v36.03 鸿蒙内核源码分析(静态分配) | 很简单的一位小朋友 v37.01 鸿蒙内核源码分析(TLFS算法) | 图表解读TLFS原理 v38.01 鸿蒙内核源码分析(内存池管理) | 如何高效切割合并内存块 v39.04 鸿蒙内核源码分析(原子操作) | 谁在守护指令执行的完整性 v40.01 鸿蒙内核源码分析(圆整对齐) | 正在制作中 ... 静态分配 相比动态分配,静态内存池的分配就是个小弟弟,非常的简单,两个结构体 + 一张图 就能说明白。 typedef struct {//静态内存池信息结构体 UINT32 uwBlkSize; /**< Block size | 块大小*/ UINT32 uwBlkNum; /**< Block number | 块数量*/ UINT32 uwBlkCnt; /**< The number of allocated blocks | 已经被分配的块数量*/ LOS_MEMBOX_NODE stFreeList; /**< Free list | 空闲链表*/ } LOS_MEMBOX_INFO; typedef struct tagMEMBOX_NODE { //内存池中空闲节点的结构,是个单向的链表 struct tagMEMBOX_NODE *pstNext; /**< Free node's pointer to the next node in a memory pool | 指向内存池中下一个空闲节点的指针*/ } LOS_MEMBOX_NODE; 下图来源于官网 解读 静态内存池在概念上由 池头 和 池体 两部分组成,池体由众多节块组成,节块由 节头和 节体 两部分组成 在数据结构上表现为 LOS_MEMBOX_INFO(池头) + [LOS_MEMBOX_NODE(节头) + data(节体)] + ... + [LOS_MEMBOX_NODE(节头) + data(节体)] ,在虚拟地址上它们是连在一起的。 池头 记录总信息,包括 节块大小,总节块数量,已分配节块数量,空闲节块链表表头,stFreeList将所有空闲节块链接到一起,分配内存根本不需要遍历,stFreeList指向的下一个不为null代表还有空闲节块。 节头只有一个指向下一个空闲链表的pstNext指针,简单但足以。 静态分配的优缺点是很明显的,总结下: 负责管理的结构体简单,会占用很少的空间,这点优于动态分配。 分配速度最快,一步到位。 缺点是浪费严重,僵硬不灵活,很计划经济,给每一个家庭每月口粮就这么多,高矮胖瘦都不会管。 因代码量不大,但很精彩,看这种代码是种享受,本篇详细列出静态内存代码层面的实现,关键处已添加注释。 初始化 ///初始化一个静态内存池,根据入参设定其起始地址、总大小及每个内存块大小 LITE_OS_SEC_TEXT_INIT UINT32 LOS_MemboxInit(VOID *pool, UINT32 poolSize, UINT32 blkSize) { LOS_MEMBOX_INFO *boxInfo = (LOS_MEMBOX_INFO *)pool;//在内存起始处放置控制头 LOS_MEMBOX_NODE *node = NULL; //... UINT32 index; UINT32 intSave; MEMBOX_LOCK(intSave); boxInfo->uwBlkSize = LOS_MEMBOX_ALIGNED(blkSize + OS_MEMBOX_NODE_HEAD_SIZE); //节块总大小(节头+节体) boxInfo->uwBlkNum = (poolSize - sizeof(LOS_MEMBOX_INFO)) / boxInfo->uwBlkSize;//总节块数量 boxInfo->uwBlkCnt = 0; //已分配的数量 if (boxInfo->uwBlkNum == 0) {//只有0块的情况 MEMBOX_UNLOCK(intSave); return LOS_NOK; } node = (LOS_MEMBOX_NODE *)(boxInfo + 1);//去除池头,找到第一个节块位置 boxInfo->stFreeList.pstNext = node;//池头空闲链表指向第一个节块 for (index = 0; index < boxInfo->uwBlkNum - 1; ++index) {//切割节块,挂入空闲链表 node->pstNext = OS_MEMBOX_NEXT(node, boxInfo->uwBlkSize);//按块大小切割好,统一由pstNext指向 node = node->pstNext;//node存储了下一个节点的地址信息 } node->pstNext = NULL;//最后一个为null MEMBOX_UNLOCK(intSave); return LOS_OK; } 申请 ///从指定的静态内存池中申请一块静态内存块,整个内核源码只有 OsSwtmrScan中用到了静态内存. LITE_OS_SEC_TEXT VOID *LOS_MemboxAlloc(VOID *pool) { LOS_MEMBOX_INFO *boxInfo = (LOS_MEMBOX_INFO *)pool; LOS_MEMBOX_NODE *node = NULL; LOS_MEMBOX_NODE *nodeTmp = NULL; UINT32 intSave; if (pool == NULL) { return NULL; } MEMBOX_LOCK(intSave); node = &(boxInfo->stFreeList);//拿到空闲单链表 if (node->pstNext != NULL) {//不需要遍历链表,因为这是空闲链表 nodeTmp = node->pstNext;//先记录要使用的节点 node->pstNext = nodeTmp->pstNext;//不再空闲了,把节点摘出去了. OS_MEMBOX_SET_MAGIC(nodeTmp);//为已使用的节块设置魔法数字 boxInfo->uwBlkCnt++;//已使用块数增加 } MEMBOX_UNLOCK(intSave); return (nodeTmp == NULL) ? NULL : OS_MEMBOX_USER_ADDR(nodeTmp);//返回可用的虚拟地址 } 释放 /// 释放指定的一块静态内存块 LITE_OS_SEC_TEXT UINT32 LOS_MemboxFree(VOID *pool, VOID *box) { LOS_MEMBOX_INFO *boxInfo = (LOS_MEMBOX_INFO *)pool; UINT32 ret = LOS_NOK; UINT32 intSave; if ((pool == NULL) || (box == NULL)) { return LOS_NOK; } MEMBOX_LOCK(intSave); do { LOS_MEMBOX_NODE *node = OS_MEMBOX_NODE_ADDR(box);//通过节体获取节块首地址 if (OsCheckBoxMem(boxInfo, node) != LOS_OK) { break; } node->pstNext = boxInfo->stFreeList.pstNext;//节块指向空闲链表表头 boxInfo->stFreeList.pstNext = node;//空闲链表表头反指向它,意味节块排到第一,下次申请将首个分配它 boxInfo->uwBlkCnt--;//已经使用的内存块减一 ret = LOS_OK; } while (0);//将被编译时优化 MEMBOX_UNLOCK(intSave); return ret; } 使用 鸿蒙内核目前只有软时钟处理使用了静态内存池,直接上代码 ///软时钟初始化 ,注意函数在多CPU情况下会执行多次 STATIC UINT32 SwtmrBaseInit(VOID) { UINT32 ret; UINT32 size = sizeof(SWTMR_CTRL_S) * LOSCFG_BASE_CORE_SWTMR_LIMIT; SWTMR_CTRL_S *swtmr = (SWTMR_CTRL_S *)LOS_MemAlloc(m_aucSysMem0, size); /* system resident resource */ if (swtmr == NULL) { return LOS_ERRNO_SWTMR_NO_MEMORY; } (VOID)memset_s(swtmr, size, 0, size);//清0 g_swtmrCBArray = swtmr;//软时钟 LOS_ListInit(&g_swtmrFreeList);//初始化空闲链表 for (UINT16 index = 0; index < LOSCFG_BASE_CORE_SWTMR_LIMIT; index++, swtmr++) { swtmr->usTimerID = index;//按顺序赋值 LOS_ListTailInsert(&g_swtmrFreeList, &swtmr->stSortList.sortLinkNode);//通过sortLinkNode将节点挂到空闲链表 } //想要用静态内存池管理,就必须要使用LOS_MEMBOX_SIZE来计算申请的内存大小,因为需要点前缀内存承载头部信息. size = LOS_MEMBOX_SIZE(sizeof(SwtmrHandlerItem), OS_SWTMR_HANDLE_QUEUE_SIZE);//规划一片内存区域作为软时钟处理函数的静态内存池。 g_swtmrHandlerPool = (UINT8 *)LOS_MemAlloc(m_aucSysMem1, size); /* system resident resource */ if (g_swtmrHandlerPool == NULL) { return LOS_ERRNO_SWTMR_NO_MEMORY; } ret = LOS_MemboxInit(g_swtmrHandlerPool, size, sizeof(SwtmrHandlerItem)); if (ret != LOS_OK) { return LOS_ERRNO_SWTMR_HANDLER_POOL_NO_MEM; } for (UINT16 index = 0; index < LOSCFG_KERNEL_CORE_NUM; index++) { SwtmrRunQue *srq = &g_swtmrRunQue[index]; /* The linked list of all cores must be initialized at core 0 startup for load balancing */ OsSortLinkInit(&srq->swtmrSortLink); LOS_ListInit(&srq->swtmrHandlerQueue); srq->swtmrTask = NULL; } SwtmrDebugDataInit(); return LOS_OK; } typedef VOID (*SWTMR_PROC_FUNC)(UINTPTR arg); //函数指针, 赋值给 SWTMR_CTRL_S->pfnHandler,回调处理 typedef struct {//处理软件定时器超时的回调函数的结构体 SWTMR_PROC_FUNC handler; /**< Callback function that handles software timer timeout */ //处理软件定时器超时的回调函数 UINTPTR arg; /**< Parameter passed in when the callback function that handles software timer timeout is called */ //调用处理软件计时器超时的回调函数时传入的参数 LOS_DL_LIST node; #ifdef LOSCFG_SWTMR_DEBUG UINT32 swtmrID; #endif } SwtmrHandlerItem; 关于软定时器可以查看系列相关篇,请想想为何软件定时器会使用静态内存。 百文说内核 | 抓住主脉络 百文相当于摸出内核的肌肉和器官系统,让人开始丰满有立体感,因是直接从注释源码起步,在加注释过程中,每每有心得处就整理,慢慢形成了以下文章。内容立足源码,常以生活场景打比方尽可能多的将内核知识点置入某种场景,具有画面感,容易理解记忆。说别人能听得懂的话很重要! 百篇博客绝不是百度教条式的在说一堆诘屈聱牙的概念,那没什么意思。更希望让内核变得栩栩如生,倍感亲切。 与代码需不断debug一样,文章内容会存在不少错漏之处,请多包涵,但会反复修正,持续更新,v**.xx 代表文章序号和修改的次数,精雕细琢,言简意赅,力求打造精品内容。 百文在 < 鸿蒙研究站 | 开源中国 | 博客园 | 51cto | csdn | 知乎 | 掘金 > 站点发布,鸿蒙研究站 | weharmonyos 中回复 百文 可方便阅读。 按功能模块: 基础知识 进程管理 任务管理 内存管理 双向链表 内核概念 源码结构 地址空间 计时单位 优雅的宏 钩子框架 位图管理 POSIX main函数 调度故事 进程控制块 进程空间 线性区 红黑树 进程管理 Fork进程 进程回收 Shell编辑 Shell解析 任务控制块 并发并行 就绪队列 调度机制 任务管理 用栈方式 软件定时器 控制台 远程登录 协议栈 内存规则 物理内存 内存概念 虚实映射 页表管理 静态分配 TLFS算法 内存池管理 原子操作 圆整对齐 通讯机制 文件系统 硬件架构 内核汇编 通讯总览 自旋锁 互斥锁 快锁使用 快锁实现 读写锁 信号量 事件机制 信号生产 信号消费 消息队列 消息封装 消息映射 共享内存 文件概念 文件故事 索引节点 VFS 文件句柄 根文件系统 挂载机制 管道文件 文件映射 写时拷贝 芯片模式 ARM架构 指令集 协处理器 工作模式 寄存器 多核管理 中断概念 中断管理 编码方式 汇编基础 汇编传参 链接脚本 开机启动 进程切换 任务切换 中断切换 异常接管 缺页中断 编译运行 调测工具 编译过程 编译构建 GN语法 忍者无敌 ELF格式 ELF解析 静态链接 重定位 动态链接 进程映像 应用启动 系统调用 VDSO 模块监控 日志跟踪 系统安全 测试用例 百万注源码 | 处处扣细节 百万汉字注解内核目的是要看清楚其毛细血管,细胞结构,等于在拿放大镜看内核。内核并不神秘,带着问题去源码中找答案是很容易上瘾的,你会发现很多文章对一些问题的解读是错误的,或者说不深刻难以自圆其说,你会慢慢形成自己新的解读,而新的解读又会碰到新的问题,如此层层递进,滚滚向前,拿着放大镜根本不愿意放手。 < gitee | github | coding | gitcode > 四大码仓推送 | 同步官方源码,鸿蒙研究站 | weharmonyos 中回复 百万 可方便阅读。 据说喜欢点赞分享的,后来都成了大神。:)

优秀的个人博客,低调大师

鸿蒙内核源码分析(Shell编辑篇) | 两个任务,三个阶段 | 百篇博客分析OpenHarmony源码 | v71.01

子曰:“我非生而知之者,好古,敏以求之者也。” 《论语》:述而篇 百篇博客系列篇.本篇为: v71.xx 鸿蒙内核源码分析(Shell编辑篇) | 两个任务,三个阶段 | 51 .c .h .o 进程管理相关篇为: v02.xx 鸿蒙内核源码分析(进程管理篇) | 谁在管理内核资源 | 51 .c .h .o v24.xx 鸿蒙内核源码分析(进程概念篇) | 进程在管理哪些资源 | 51 .c .h .o v45.xx 鸿蒙内核源码分析(Fork篇) | 一次调用,两次返回 | 51 .c .h .o v46.xx 鸿蒙内核源码分析(特殊进程篇) | 老鼠生儿会打洞 | 51 .c .h .o v47.xx 鸿蒙内核源码分析(进程回收篇) | 临终前如何向老祖宗托孤 | 51 .c .h .o v48.xx 鸿蒙内核源码分析(信号生产篇) | 年过半百,依然活力十足 | 51 .c .h .o v49.xx 鸿蒙内核源码分析(信号消费篇) | 谁让CPU连续四次换栈运行 | 51 .c .h .o v71.xx 鸿蒙内核源码分析(Shell编辑篇) | 两个任务,三个阶段 | 51 .c .h .o v72.xx 鸿蒙内核源码分析(Shell解析篇) | 应用窥伺内核的窗口 | 51 .c .h .o 系列篇从内核视角用一句话概括shell的底层实现为:两个任务,三个阶段。其本质是独立进程,因而划到进程管理模块。每次创建shell进程都会再创建两个任务。 客户端任务(ShellEntry): 负责接受来自终端(控制台)敲入的一个个字符,字符按VT规范组装成一句句的命令。 服务端任务(ShellTask): 对命令进行解析并执行,将结果输出到控制台。 而按命令生命周期可分三个阶段. 编辑: 鸿蒙在这个部分实现了一个简单的编辑器功能,处理控制台输入的每个字符,主要包括了对控制字符 例如 <ESC>,\t,\b,\n,\r,四个方向键0x41 ~ 0x44 的处理。 解析: 对编辑后的字符串进行解析,解析出命令项和参数项,找到对应的命令项执行函数。 执行: 命令可通过静态和动态两种方式注册到内核,解析出具体命令后在注册表中找到对应函数回调。将结果输出到控制台。 编辑部分由客户端任务完成,后两个部分由服务端任务完成,命令全局注册由内核完成。 本篇主要说 客户端任务 和 编辑过程 服务端任务 和 解析/执行过程 已在(Shell解析篇)中说明,请自行翻看. 什么是 Shell 从用户视角看,shell是用户窥视和操作内核的一个窗口,内核并非铁板一块,对应用层开了两个窗口,一个是系统调用,一个就是shell,由内核提供实现函数,由用户提供参数执行。区别是 shell是由独立的任务去完成,可通过将shell命令序列化编写成独立的,简单的shell程序,所以shell也是一门脚本语言,系统调用是依附于应用程序的任务去完成,能做的有限。通过shell窗口能看到 cpu的运行情况,内存的消耗情况,网络的链接状态等等。 鸿蒙 Shell 代码在哪 与shell对应的概念是kernel,在鸿蒙内核,这两部分代码是分开放的,shell代码在 查看 shell 代码 ,目录结构如下. ├─include │ dmesg.h │ dmesg_pri.h │ shcmd.h │ shcmdparse.h │ shell.h │ shell_lk.h │ shell_pri.h │ shmsg.h │ show.h │ └─src ├─base │ shcmd.c │ shcmdparse.c │ shell_lk.c │ shmsg.c │ show.c │ └─cmds date_shellcmd.c dmesg.c hwi_shellcmd.c shell_shellcmd.c watch_shellcmd.c Shell 控制块 跟进程,任务一样,每个概念的背后需要一个主结构体来的支撑,shell的主结构体就是ShellCB,掌握它就可以将shell拿捏的死死的,搞不懂这个结构体就读不懂shell的内核实现.所以在上面花再多功夫也不为过. typedef struct { UINT32 consoleID; //控制台ID UINT32 shellTaskHandle; //shell服务端任务ID UINT32 shellEntryHandle; //shell客户端任务ID VOID *cmdKeyLink; //待处理的shell命令链表 VOID *cmdHistoryKeyLink;//已处理的历史记录链表,去重,10个 VOID *cmdMaskKeyLink; //主要用于方向键上下遍历历史命令 UINT32 shellBufOffset; //buf偏移量 UINT32 shellKeyType; //按键类型 EVENT_CB_S shellEvent; //事件类型触发 pthread_mutex_t keyMutex; //按键互斥量 pthread_mutex_t historyMutex; //历史记录互斥量 CHAR shellBuf[SHOW_MAX_LEN]; //shell命令buf,接受键盘的输入,需要对输入字符解析. CHAR shellWorkingDirectory[PATH_MAX];//shell的工作目录 } ShellCB; //一个shell命令的结构体,命令有长有短,鸿蒙采用了可变数组的方式实现 typedef struct { UINT32 count; //字符数量 LOS_DL_LIST list; //双向链表 CHAR cmdString[0]; //字符串,可变数组的一种实现方式. } CmdKeyLink; enum { STAT_NOMAL_KEY, //普通的按键 STAT_ESC_KEY, //<ESC>键在VT控制规范中时控制的起始键 STAT_MULTI_KEY //组合键 }; 解读 鸿蒙支持两种方式在控制台输入Shell命令,关于控制台请自行翻看控制台篇. 在串口工具中直接输入Shell命令 CONSOLE_SERIAL。 在telnet工具中输入Shell命令 CONSOLE_TELNET。 shellTaskHandle和shellEntryHandle编辑/处理shell命令的两个任务ID,本篇重点说后一个. cmdKeyLink,cmdHistoryKeyLink,cmdMaskKeyLink是三个类型为CmdKeyLink的结构体,本质是双向链表,对应编辑shell命令过程中的三个功能. cmdKeyLink 待执行的命令链表 cmdHistoryKeyLink 存储命令历史记录的,即: history命令显示的内容 cmdMaskKeyLink 记录按上下方向键输出的内容,这个有点难理解,自行在shell中按上下方向键自行体验 shellBufOffset和shellBuf是成对出现的,其中存放的就是用户敲入处理后的字符. keyMutex和historyMutex为操作链表所需的互斥锁,内核用的最多的就是这类锁. shellEvent用于任务之间的通讯,比如. SHELL_CMD_PARSE_EVENT:编辑完成了通知解析任务开始执行 CONSOLE_SHELL_KEY_EVENT:收到来自控制台的CTRL + C信号产生的事件. shellKeyType 按键的类型,分三种 普通,<ESC>键,组合键 shellWorkingDirectory 工作区就不用说了,从哪个目录进入shell的 创建 Shell //shell进程的入口函数 int main(int argc, char **argv) { //... g_shellCB = shellCB;//全局变量,说明鸿蒙同时只支持一个shell进程 return OsShellCreateTask(shellCB);//初始化两个任务 } //创建shell任务 STATIC UINT32 OsShellCreateTask(ShellCB *shellCB) { UINT32 ret = ShellTaskInit(shellCB);//执行shell命令的任务初始化 if (ret != LOS_OK) { return ret; } return ShellEntryInit(shellCB);//通过控制台接收shell命令的任务初始化 } //进入shell客户端任务初始化,这个任务负责编辑命令,处理命令产生的过程,例如如何处理方向键,退格键,回车键等 LITE_OS_SEC_TEXT_MINOR UINT32 ShellEntryInit(ShellCB *shellCB) { UINT32 ret; CHAR *name = NULL; TSK_INIT_PARAM_S initParam = {0}; if (shellCB->consoleID == CONSOLE_SERIAL) { name = SERIAL_ENTRY_TASK_NAME; } else if (shellCB->consoleID == CONSOLE_TELNET) { name = TELNET_ENTRY_TASK_NAME; } else { return LOS_NOK; } initParam.pfnTaskEntry = (TSK_ENTRY_FUNC)ShellEntry;//任务入口函数 initParam.usTaskPrio = 9; /* 9:shell task priority */ initParam.auwArgs[0] = (UINTPTR)shellCB; initParam.uwStackSize = 0x1000; initParam.pcName = name; initParam.uwResved = LOS_TASK_STATUS_DETACHED; ret = LOS_TaskCreate(&shellCB->shellEntryHandle, &initParam);//创建任务 #ifdef LOSCFG_PLATFORM_CONSOLE (VOID)ConsoleTaskReg((INT32)shellCB->consoleID, shellCB->shellEntryHandle);//将任务注册到控制台 #endif return ret; } 解读 main为shell进程的主任务,每个进程都会创建一个默认的线程(任务),这个任务的入口函数就是大家熟知的main函数,不清楚的自行翻看任务管理各篇有详细的说明. 由main任务再创建两个任务,即本篇开头说的两个任务,本篇重点说其中的一个 ShellEntry,任务优先级为9,算是较高优先级. 指定内核栈大小为0x1000 = 4K ,因任务只负责编辑处理控制台输入的字符,命令的执行在其他任务,所以4K的内核空间足够使用. ShellEntry为入口函数,这个函数的实现为本篇的重点 ShellEntry | 编辑过程 LITE_OS_SEC_TEXT_MINOR UINT32 ShellEntry(UINTPTR param) { CHAR ch; INT32 n = 0; ShellCB *shellCB = (ShellCB *)param; CONSOLE_CB *consoleCB = OsGetConsoleByID((INT32)shellCB->consoleID);//获取控制台 if (consoleCB == NULL) { PRINT_ERR("Shell task init error!\n"); return 1; } (VOID)memset_s(shellCB->shellBuf, SHOW_MAX_LEN, 0, SHOW_MAX_LEN);//重置shell命令buf while (1) { #ifdef LOSCFG_PLATFORM_CONSOLE if (!IsConsoleOccupied(consoleCB)) {//控制台是否被占用 #endif /* is console ready for shell ? */ n = read(consoleCB->fd, &ch, 1);//从控制台读取一个字符内容,字符一个个处理 if (n == 1) {//如果能读到一个字符 ShellCmdLineParse(ch, (pf_OUTPUT)dprintf, shellCB); } if (is_nonblock(consoleCB)) {//在非阻塞模式下暂停 50ms LOS_Msleep(50); /* 50: 50MS for sleep */ } #ifdef LOSCFG_PLATFORM_CONSOLE } #endif } } //对命令行内容解析 LITE_OS_SEC_TEXT_MINOR VOID ShellCmdLineParse(CHAR c, pf_OUTPUT outputFunc, ShellCB *shellCB) { const CHAR ch = c; INT32 ret; //不是回车键和字符串结束,且偏移量为0 if ((shellCB->shellBufOffset == 0) && (ch != '\n') && (ch != '\0')) { (VOID)memset_s(shellCB->shellBuf, SHOW_MAX_LEN, 0, SHOW_MAX_LEN);//重置buf } //遇到回车或换行 if ((ch == '\r') || (ch == '\n')) { if (shellCB->shellBufOffset < (SHOW_MAX_LEN - 1)) { shellCB->shellBuf[shellCB->shellBufOffset] = '\0';//字符串结束 } shellCB->shellBufOffset = 0; (VOID)pthread_mutex_lock(&shellCB->keyMutex); OsShellCmdPush(shellCB->shellBuf, shellCB->cmdKeyLink);//解析回车或换行 (VOID)pthread_mutex_unlock(&shellCB->keyMutex); ShellNotify(shellCB);//通知任务解析shell命令 return; } else if ((ch == '\b') || (ch == 0x7F)) { /* backspace or delete(0x7F) */ //遇到删除键 if ((shellCB->shellBufOffset > 0) && (shellCB->shellBufOffset < (SHOW_MAX_LEN - 1))) { shellCB->shellBuf[shellCB->shellBufOffset - 1] = '\0';//填充`\0` shellCB->shellBufOffset--;//buf减少 outputFunc("\b \b");//回调入参函数 } return; } else if (ch == 0x09) { /* 0x09: tab *///遇到tab键 if ((shellCB->shellBufOffset > 0) && (shellCB->shellBufOffset < (SHOW_MAX_LEN - 1))) { ret = OsTabCompletion(shellCB->shellBuf, &shellCB->shellBufOffset);//解析tab键 if (ret > 1) { outputFunc("OHOS # %s", shellCB->shellBuf);//回调入参函数 } } return; } /* parse the up/down/right/left key */ ret = ShellCmdLineCheckUDRL(ch, shellCB);//解析上下左右键 if (ret == LOS_OK) { return; } if ((ch != '\n') && (ch != '\0')) {//普通的字符的处理 if (shellCB->shellBufOffset < (SHOW_MAX_LEN - 1)) {//buf范围 shellCB->shellBuf[shellCB->shellBufOffset] = ch;//直接加入 } else { shellCB->shellBuf[SHOW_MAX_LEN - 1] = '\0';//加入字符串结束符 } shellCB->shellBufOffset++;//偏移量增加 outputFunc("%c", ch);//向终端输出字符 } shellCB->shellKeyType = STAT_NOMAL_KEY;//普通字符 } 解读 ShellEntry内部是个死循环,不断的读取控制台输入的每个字符,注意是按字符处理. 处理四个方向,换行回车,tab,backspace,delete,esc 等控制键,相当于重新认识了下Ascii表.可以把shell终端理解为一个简单的编辑器. 按回车键 表示完成前面的输入,进入解析执行阶段. 按方向键 要显示上/下一个命令的内容,一直按就一直显示上上/下下命令. 按tab键 是要补齐命令的内容,目前鸿蒙支持如下命令: arp cat cd chgrp chmod chown cp cpup date dhclient dmesg dns format free help hwi ifconfig ipdebug kill log ls lsfd memcheck mkdir mount netstat oom partinfo partition ping ping6 pwd reset rm rmdir sem statfs su swtmr sync systeminfo task telnet test tftp touch umount uname watch writeproc 例如:当在控制台按下 ch和 tab键后会输出以下三个 chgrp chmod chown 内容,这些功能对使用者而已看似再平常不过,但都需要内核一一实现. shellBuf存储编辑结果,当按下回车键时,将结果保存并交付给下一个阶段使用. 鸿蒙内核源码分析.总目录 v08.xx 鸿蒙内核源码分析(总目录) | 百万汉字注解 百篇博客分析 | 51 .c .h .o 关注不迷路.代码即人生 QQ群:790015635 | 入群密码: 666 原创不易,欢迎转载,但请注明出处.

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册