首页 文章 精选 留言 我的

精选列表

搜索[VR 全景],共3932篇文章
优秀的个人博客,低调大师

生成学习全景:从基础理论到GANs技术实战

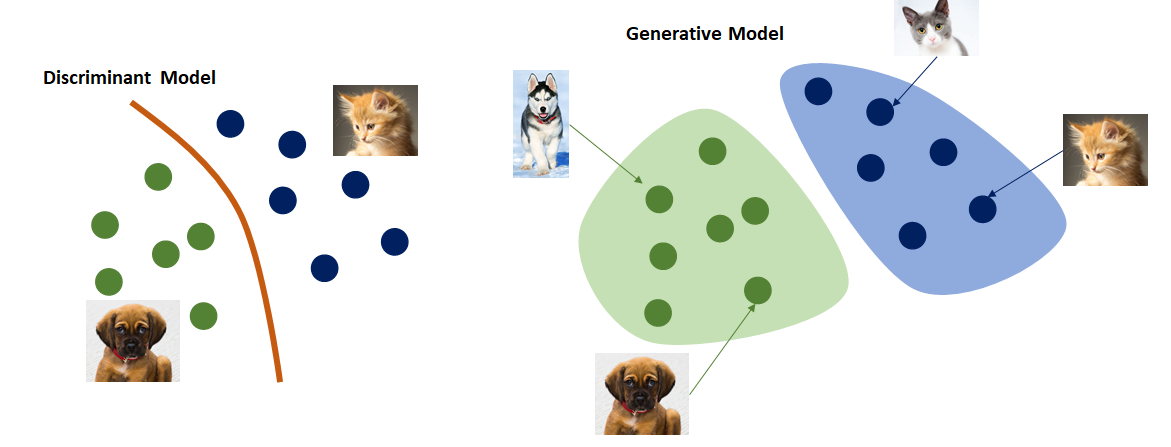
本文全面探讨了生成学习的理论与实践,包括对生成学习与判别学习的比较、详细解析GANs、VAEs及自回归模型的工作原理与结构,并通过实战案例展示了GAN模型在PyTorch中的实现。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人 一、生成学习概述 生成学习(Generative Learning)在机器学习领域中占据了重要的位置。它通过学习数据分布的方式生成新的数据实例,这在多种应用中表现出了其独特的价值。本节将深入探讨生成学习的核心概念,明确区分生成学习与判别学习,并探索生成学习的主要应用场景。 生成学习与判别学习的区别 生成学习和判别学习是机器学习中两种主要的学习方式,它们在处理数据和学习任务时有本质的区别。 判别学习(Discriminative Learning) 目标:直接学习决策边界或输出与输入之间的映射关系。 应用:分类和回归任务,如逻辑回归、支持向量机(SVM)。 优势:通常在特定任务上更加高效,因为它们专注于区分数据类别。 生成学习(Generative Learning) 目标:学习数据的整体分布,能够生成新的数据实例。 应用:数据生成、特征学习、无监督学习等,如生成对抗网络(GANs)和变分自编码器(VAEs)。 优势:能够捕捉数据的内在结构和分布,适用于更广泛的任务,如数据增强、新内容的创造。 生成学习的应用场景 生成学习由于其能力在模拟和学习数据的分布方面,使其在许多场景中都非常有用。 图像和视频生成 概述:生成学习模型能够产生高质量、逼真的图像和视频内容。 实例:GANs在这一领域尤其突出,能够生成新的人脸图像、风景图片等。 语音和音乐合成 概述:模型可以学习音频数据的分布,生成自然语言语音或音乐作品。 实例:深度学习技术已被用于合成逼真的语音(如语音助手)和创造新的音乐作品。 数据增强 概述:在训练数据有限的情况下,生成学习可以创建额外的训练样本。 实例:在医学图像分析中,通过生成新的图像来增强数据集,提高模型的泛化能力。 异常检测 概述:模型通过学习正常数据的分布来识别异常或偏离标准的数据。 实例:在金融领域,用于识别欺诈交易;在制造业,用于检测产品缺陷。 文本生成 概述:生成模型能够编写逼真的文本,包括新闻文章、诗歌等。 实例:一些先进的模型(如GPT系列)在这一领域显示了惊人的能力。 二、生成学习模型概览 在机器学习的众多领域中,生成学习模型因其能够学习和模拟数据的分布而显得尤为重要。这类模型的核心思想是理解和复制输入数据的底层结构,从而能够生成新的、类似的数据实例。以下是几种主要的生成学习模型及其关键特性的综述。 生成对抗网络(GANs) 生成对抗网络(GANs)是一种由两部分组成的模型:一个生成器(Generator)和一个判别器(Discriminator)。生成器的目标是产生逼真的数据实例,而判别器的任务是区分生成的数据和真实数据。这两部分在训练过程中相互竞争,生成器努力提高生成数据的质量,而判别器则努力更准确地识别真伪。通过这种对抗过程,GANs能够生成高质量、高度逼真的数据,尤其在图像生成领域表现出色。 变分自编码器(VAEs) 变分自编码器(VAEs)是一种基于神经网络的生成模型,它通过编码器将数据映射到一个潜在空间(latent space),然后通过解码器重建数据。VAEs的关键在于它们的重建过程,这不仅仅是一个简单的复制,而是对数据分布的学习和理解。VAEs在生成图像、音乐或文本等多种类型的数据方面都有出色的表现,并且由于其结构的特点,VAEs在进行特征学习和数据降维方面也显示了巨大的潜力。 自回归模型 自回归模型在生成学习中占有一席之地,尤其是在处理序列数据(如文本或时间序列)时。这类模型基于先前的数据点来预测下一个数据点,因此它们在理解和生成序列数据方面表现出色。例如,PixelRNN通过逐像素方式生成图像,每次生成下一个像素时都考虑到之前的像素。这种方法使得自回归模型在生成图像和文本方面表现出细腻且连贯的特性。 三、生成对抗网络(GANs)模型技术全解 生成对抗网络(GANs)是一种引人注目的深度学习模型,以其独特的结构和生成高质量数据的能力而著称。在这篇解析中,我们将深入探讨GANs的核心概念、结构、训练方法和关键技术点。 GANs的核心概念 GANs由两个主要部分组成:生成器(Generator)和判别器(Discriminator)。生成器的目的是创建逼真的数据实例,而判别器则试图区分真实数据和生成器产生的数据。这两部分在GANs的训练过程中形成一种对抗关系,相互竞争,从而推动整个模型的性能提升。 生成器(Generator) 目标:学习数据的分布,生成逼真的数据实例。 方法:通常使用一个深度神经网络,通过随机噪声作为输入,输出与真实数据分布相似的数据。 判别器(Discriminator) 目标:区分输入数据是来自真实数据集还是生成器。 方法:同样使用深度神经网络,输出一个概率值,表示输入数据是真实数据的可能性。 GANs的结构 GANs的核心在于其生成器和判别器的博弈。生成器试图生成尽可能逼真的数据以“欺骗”判别器,而判别器则努力学习如何区分真伪。这种结构创造了一个动态的学习环境,使得生成器和判别器不断进化。 网络结构 生成器:通常是一个反卷积网络(Deconvolutional Network),负责从随机噪声中生成数据。 判别器:通常是一个卷积网络(Convolutional Network),用于判断输入数据的真实性。 GANs的训练方法 GANs的训练过程是一个迭代过程,其中生成器和判别器交替更新。 训练过程 判别器训练:固定生成器,更新判别器。使用真实数据和生成器生成的数据训练判别器,目标是提高区分真假数据的能力。 生成器训练:固定判别器,更新生成器。目标是生成更加逼真的数据,以使判别器更难以区分真伪。 损失函数 判别器损失:通常使用交叉熵损失函数,量化判别器区分真实数据和生成数据的能力。 生成器损失:同样使用交叉熵损失函数,但目标是使生成的数据被判别器误判为真实数据。 GANs的关键技术点 训练稳定性 GANs的训练过程可能会非常不稳定,需要仔细调整超参数和网络结构。常见的问题包括模式崩溃(Mode Collapse)和梯度消失。 模式崩溃 当生成器开始产生有限类型的输出,而忽略了数据分布的多样性时,就会发生模式崩溃。这通常是因为判别器过于强大,导致生成器找到了欺骗判别器的“捷径”。 梯度消失 在GANs中,梯度消失通常发生在判别器过于完美时,生成器的梯度 变得非常小,导致学习停滞。 解决方案 架构调整:如使用深度卷积GAN(DCGAN)等改进的架构。 正则化和惩罚:如梯度惩罚(Gradient Penalty)。 条件GANs:通过提供额外的条件信息来帮助生成器和判别器的训练。 四、变分自编码器(VAEs)模型技术全解 变分自编码器(VAEs)是一种强大的生成模型,在机器学习和深度学习领域中得到了广泛的应用。VAEs通过学习数据的潜在表示(latent representation)来生成新的数据实例。本节将全面深入地探讨VAEs的工作原理、网络结构、训练方法及其在实际应用中的价值。 VAEs的工作原理 VAEs的核心思想是通过潜在空间(latent space)来表示数据,这个潜在空间是数据的压缩表示,捕捉了数据的关键特征。VAEs由两个主要部分组成:编码器(Encoder)和解码器(Decoder)。 编码器(Encoder) 编码器的作用是将输入数据映射到潜在空间。它输出潜在空间中的两个参数:均值(mean)和方差(variance)。这些参数定义了一个概率分布,从中可以抽取潜在表示。 解码器(Decoder) 解码器的任务是从潜在表示重构数据。它接收潜在空间中的点并生成与原始输入数据相似的数据。 VAEs的网络结构 VAEs的网络结构通常包括多层全连接层或卷积层,具体结构取决于输入数据的类型。对于图像数据,通常使用卷积层;对于文本或序列数据,则使用循环神经网络(RNN)或变换器(Transformer)。 潜在空间 潜在空间是VAEs的关键,它允许模型捕捉数据的内在结构。在这个空间中,相似的数据点被映射到靠近的位置,这使得生成新数据变得可行。 VAEs的训练方法 VAEs的训练涉及最大化输入数据的重构概率的同时,确保潜在空间的分布接近先验分布(通常是正态分布)。 重构损失 重构损失测量解码器生成的数据与原始输入数据之间的差异。这通常通过均方误差(MSE)或交叉熵损失来实现。 KL散度 KL散度用于量化编码器输出的概率分布与先验分布之间的差异。最小化KL散度有助于保证潜在空间的平滑和连续性。 VAEs的价值和应用 VAEs在多种领域都有显著的应用价值。 数据生成 由于VAEs能够捕捉数据的潜在分布,它们可以用于生成新的、逼真的数据实例,如图像、音乐等。 特征提取和降维 VAEs在潜在空间中提供了数据的紧凑表示,这对特征提取和降维非常有用,尤其是在复杂数据集中。 异常检测 VAEs可以用于异常检测,因为异常数据点通常不会被映射到潜在空间的高密度区域。 五、自回归模型技术全解 自回归模型在生成学习领域中占据了独特的位置,特别是在处理序列数据如文本、音乐或时间序列分析等方面。这些模型的关键特性在于利用过去的数据来预测未来的数据点。在本节中,我们将全面深入地探讨自回归模型的工作原理、结构、训练方法及其应用价值。 自回归模型的工作原理 自回归模型的核心思想是利用之前的数据点来预测下一个数据点。这种方法依赖于假设:未来的数据点与过去的数据点有一定的相关性。 序列数据的处理 对于序列数据,如文本或时间序列,自回归模型通过学习数据中的时间依赖性来生成或预测接下来的数据点。这意味着模型的输出是基于先前观察到的数据序列。 自回归模型的网络结构 自回归模型可以采用多种网络结构,具体取决于应用场景和数据类型。 循环神经网络(RNNs) 对于时间序列数据或文本,循环神经网络(RNNs)是常用的选择。RNN能够处理序列数据,并且能够记忆先前的信息,这对于捕捉时间序列中的长期依赖关系至关重要。 卷积神经网络(CNNs) 在处理像素数据时,如图像生成,卷积神经网络(CNNs)也可以用于自回归模型。例如,PixelCNN通过按顺序生成图像中的每个像素来创建完整的图像。 自回归模型的训练方法 自回归模型的训练通常涉及最大化数据序列的条件概率。 最大似然估计 自回归模型通常使用最大似然估计来训练。这意味着模型的目标是最大化给定之前观察到的数据点后,生成下一个数据点的概率。 序列建模 在训练过程中,模型学习如何根据当前序列预测下一个数据点。这种方法对于文本生成或时间序列预测尤其重要。 自回归模型的价值和应用 自回归模型在许多领域都显示出了其独特的价值。 文本生成 在自然语言处理(NLP)中,自回归模型被用于文本生成任务,如自动写作和语言翻译。 音乐生成 在音乐生成中,这些模型能够基于已有的音乐片段来创建新的旋律。 时间序列预测 在金融、气象学和其他领域,自回归模型用于预测未来的数据点,如股票价格或天气模式。 六、GAN模型案例实战 在本节中,我们将通过一个具体的案例来演示如何使用PyTorch实现一个基础的生成对抗网络(GAN)。这个案例将重点放在图像生成上,展示如何训练一个GAN模型以生成手写数字图像,类似于MNIST数据集中的图像。 场景描述 目标:训练一个GAN模型来生成看起来像真实手写数字的图像。 数据集:MNIST手写数字数据集,包含0到9的手写数字图像。 输入:生成器将接收一个随机噪声向量作为输入。 输出:生成器输出一张看起来像真实手写数字的图像。 处理过程: 数据准备:加载并预处理MNIST数据集。 模型定义:定义生成器和判别器的网络结构。 训练过程:交替训练生成器和判别器。 图像生成:使用训练好的生成器生成图像。 PyTorch实现 1. 导入必要的库 import torch import torch.nn as nn import torch.optim as optim from torchvision import datasets, transforms from torch.utils.data import DataLoader import matplotlib.pyplot as plt 2. 数据准备 transform = transforms.Compose([ transforms.ToTensor(), transforms.Normalize((0.5,), (0.5,)) ]) train_dataset = datasets.MNIST(root='./data', train=True, download=True, transform=transform) train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True) 3. 定义模型 生成器 class Generator(nn.Module): def __init__(self): super(Generator, self).__init__() self.model = nn.Sequential( nn.Linear(100, 256), nn.LeakyReLU(0.2), nn.Linear(256, 512), nn.LeakyReLU(0.2), nn.Linear(512, 1024), nn.LeakyReLU(0.2), nn.Linear(1024, 784), nn.Tanh() ) def forward(self, x): return self.model(x).view(-1, 1, 28, 28) 判别器 class Discriminator(nn.Module): def __init__(self): super(Discriminator, self).__init__() self.model = nn.Sequential( nn.Linear(784, 1024), nn.LeakyReLU(0.2), nn.Dropout(0.3), nn.Linear(1024, 512), nn.LeakyReLU(0.2), nn.Dropout(0.3), nn.Linear(512, 256), nn.LeakyReLU(0.2), nn.Linear(256, 1), nn.Sigmoid() ) def forward(self, x): x = x.view(x.size(0), -1) return self.model(x) 4. 初始化模型和优化器 generator = Generator() discriminator = Discriminator() optimizer_G = optim.Adam(generator.parameters(), lr=0.0002) optimizer_D = optim.Adam(discriminator.parameters(), lr=0.0002) criterion = nn.BCELoss() 5. 训练模型 epochs = 50 for epoch in range(epochs): for i, (images, _) in enumerate(train_loader): # 真实图像标签是1,生成图像标签是0 real_labels = torch.ones(images.size(0), 1) fake_labels = torch.zeros(images.size(0), 1) # 训练判别器 outputs = discriminator(images) d_loss_real = criterion(outputs, real_labels) real_score = outputs z = torch.randn(images.size(0), 100) fake_images = generator(z) outputs = discriminator(fake_images.detach()) d_loss_fake = criterion(outputs, fake_labels) fake_score = outputs d_loss = d_loss_real + d_loss_fake optimizer_D.zero_grad() d_loss.backward() optimizer_D.step() # 训练生成器 outputs = discriminator(fake_images) g_loss = criterion(outputs, real_labels) optimizer_G.zero_grad() g_loss.backward() optimizer_G.step() print(f'Epoch [{epoch+1}/{epochs}], d_loss: {d_loss.item():.4f}, g_loss: {g_loss.item():.4f}') 6. 生成图像 z = torch.randn(1, 100) generated_images = generator(z) plt.imshow(generated_images.detach().numpy().reshape(28, 28), cmap='gray') plt.show() 七、总结 在深入探讨了生成学习的核心概念、主要模型、以及实际应用案例后,我们可以对这一领域有一个更加全面和深入的理解。生成学习不仅是机器学习的一个分支,它更是开启了数据处理和理解新视角的关键。 生成学习的多样性和灵活性 生成学习模型,如GANs、VAEs和自回归模型,展示了在不同类型的数据和应用中的多样性和灵活性。每种模型都有其独特的特点和优势,从图像和视频的生成到文本和音乐的创作,再到复杂时间序列的预测。这些模型的成功应用证明了生成学习在捕捉和模拟复杂数据分布方面的强大能力。 创新的前沿和挑战 生成学习领域正处于不断的创新和发展之中。随着技术的进步,新的模型和方法不断涌现,推动着这一领域的边界不断扩展。然而,这也带来了新的挑战,如提高模型的稳定性和生成质量、解决训练过程中的问题(如模式崩溃),以及增强模型的解释性和可控性。 跨学科的融合和应用 生成学习在多个学科之间架起了桥梁,促进了不同领域的融合和应用。从艺术创作到科学研究,从商业智能到社会科学,生成学习的应用为这些领域带来了新的视角和解决方案。这种跨学科的融合不仅推动了生成学习技术本身的进步,也为各领域的发展提供了新的动力。 未来发展的趋势 未来,我们可以预见生成学习将继续在模型的复杂性、生成质量、以及应用领域的广度和深度上取得进步。随着人工智能技术的发展,生成学习将在模仿和扩展人类创造力方面发挥越来越重要的作用,同时也可能带来关于伦理和使用的新讨论。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人 如有帮助,请多关注 TeahLead KrisChang,10+年的互联网和人工智能从业经验,10年+技术和业务团队管理经验,同济软件工程本科,复旦工程管理硕士,阿里云认证云服务资深架构师,上亿营收AI产品业务负责人。

优秀的个人博客,低调大师

Google Agent Skills 的构建、测试与规模化全景解析

## 引言:那个"教不会"的 AI 同事 如果你在过去一年里认真用过 AI 编码助手,大概率经历过这样的时刻: 你让 Agent 帮你在 Google Cloud 上部署一个服务。它热情满满地开始干活,然后——用了一个三年前就废弃的 API,写出一段看起来无比自信、跑起来必然报错的命令。你纠正它,它道歉,然后换一种方式继续错。你只好把官方文档复制粘贴进对话框,像给实习生划重点一样逐条叮嘱:不要这样做,要那样做,这个参数必须带,那个接口已经下线了。 第二天,新对话,它全忘了。你又要重新教一遍。 这不是某个模型的个例,而是整个 Agent 时代的集体困境:**模型很聪明,但它不懂你所在的"江湖"。** 它不知道你公司内部的部署规范,不知道某个云服务最新的最佳实践,不知道哪些命令在你团队里是红线。通用大模型的知识停留在训练数据截止的那一天,而真实世界的 API、文档、规范每天都在演进。 过去的解法是什么?写 Prompt。更长的 Prompt,更精细的 Prompt,把注意事项一条条塞进系统提示词里。结果呢?上下文窗口越来越臃肿,提示词越来越像一坨没人敢动的祖传代码,而且——换个任务就不灵了。 2026 年 8 月 3 日,Google AI 官方发布了一篇"幕后揭秘"文章,首次完整披露了他们如何构建、测试和规模化 **[Google Agent Skills](https://github.com/google/skills) ** ——一个托管在 GitHub 上、上线即斩获超过 15,000 stars 的开源项目。这套体系的核心主张朴素而锋利:**别再手搓 Prompt 了,把领域知识做成标准化的"技能包",用软件工程的方式去治理它。** 这篇文章值得你逐字读完,因为它回答的不是"AI 能做什么",而是一个更现实的问题:**当你真的要把 Agent 用进生产环境,工程上到底该怎么干?** --- ## 核心观点速览 赶时间?先把这六条带走: - **范式已变**:Agent 指令正在从"Prompt 工程"走向"产品工程",指令需要与代码同等级别的工程化治理——版本控制、CI/CD、评估、所有权。 - **SKILL.md 不是文档,是接口**:它面向的读者是 Agent 而非人类,本质上更接近 API 定义,写法必须结构化、无歧义、可执行。 - **MCP 优先是战略选择**:Google 明确要求 Skill 尽可能引用远程 MCP 工具,"能力通道"与"使用知识"两层解耦,各自独立演进。 - **质量防线是三层叠加**:提交时 CI 检查、提交时+每周持续评估、强制 Owner 制度,三者协同才能让"开放贡献"不滑向"质量失控"。 - **评估即合约**:每个 Skill 诞生时必须自带"什么算成功"的定义(EVAL.yaml),评估不是事后补救,而是合并的前置条件。 - **Skill 是产品,不是片段**:开源项目最常见的死法是维护者倦怠,Google 用 Repo Maintainer + Skill Owner 双层所有权把责任钉死到人。 --- ## 一、为什么 Agent 需要"技能包":从 Prompt 到 Skill 的范式演进 要理解 Google 为什么大张旗鼓地做 Agent Skills,先得看清 Prompt 工程撞上的那堵墙。 ### Prompt 的三宗罪 **第一宗:不可复用。** 你在 Claude Code 里精心调教出的那段"如何在 GKE 上正确部署"的提示词,没法一键迁移给同事,更没法迁移到另一个 Agent 框架。它长在你的对话框里,死了也埋在你的对话框里。 **第二宗:上下文肥胖症。** 想让 Agent 懂得多,就得往上下文里塞更多指令。但上下文窗口是稀缺资源——塞满了规则,就没地方放代码了。更何况研究表明,过长的指令上下文反而会稀释模型的注意力,让它抓不住重点。 **第三宗:无人维护。** API 更新了,最佳实践变了,谁去改那段躺在某个 Wiki 页面里的提示词?没人。它有作者,但没有 Owner。这是它失效的开始。 有一个场景你一定不陌生:团队里最资深的工程师,把自己的"Agent 调教心得"写成了一篇飞书文档,标题叫《AI 编码助手使用指南 V3.2》。大家看了都说好,转发、点赞、收藏。三个月后,云服务商改版了控制台、废弃了两个参数,这篇文档静静地变成了误导新人的陷阱——它甚至比没有文档更糟糕,因为错误的指令会被 Agent 忠实地放大执行。**Prompt 的腐败是静默的,而静默的腐败最难被发现。** ### Skill 的解法:渐进式披露 Agent Skills 是一个轻量级开放格式——最初由 Anthropic 发起并作为开放标准发布(规范见 agentskills.io),核心简单到令人意外:**一个装着 SKILL.md 的文件夹**。真正精妙的是它的工作方式,叫做**渐进式披露(Progressive Disclosure)**: - **Discovery(发现)**:Agent 启动时,只加载每个 Skill 的 name 和 description——大约几十个 token。Agent 像翻目录一样扫一眼:"哦,这里有 200 个技能可用。" - **Activation(激活)**:当用户任务与某个 Skill 匹配时,才读取完整的 SKILL.md 指令。用到谁,才加载谁。 - **Execution(执行)**:按指令执行任务,按需调用文件夹里捆绑的脚本和参考资料。 这个设计用一个词概括就是:**按需加载**。它让 Agent 可以"持有"成百上千个技能而上下文窗口分毫不增——就像你的手机装了 100 个 App,但内存里只跑着当前打开的这一个。 下面这张图展示了 Agent 与一个大型 Skill 库交互时的渐进式披露流程,注意上下文开销只发生在激活之后: ![Agent Skills 渐进式披露机制.png](https://developer.qcloudimg.com/http-save/yehe-7660620/a476e816602834f7ac79ee7e773aa60e.png) ### 从"写提示词"到"做产品" 这就是范式转变的关键一跃。Prompt 工程的单位是"一段话",Skill 工程的单位是"一个产品"。一段话写完就完了;一个产品有结构、有版本、有测试、有负责人、有生命周期。 Google 在文章里说得很直白:这个项目最初是作为 Google Cloud Next 2026 之前的一次 "swarm" 快速行动启动的,由 Developer Advocates 和 Technical Writers 组成的跨职能团队牵头,目标是把 Google Cloud 的领域知识编码为**结构化、Agent 可读的指令**,让 AI 编码 Agent 更智能、更安全、更准确。 注意这三个词的排序。不是"更强大",而是"更智能、更安全、更准确"——这是工程思维,不是炫技思维。 还有一个值得品味的细节:牵头团队不是研究院的科学家,而是 **Developer Advocates(开发者布道师)和 Technical Writers(技术文档工程师)**。这个人事安排本身就是信号——Google 认为 Skill 的核心竞争力不在模型能力,而在**知识的结构化表达能力**。谁能把领域专家脑子里的隐性知识,翻译成 Agent 可执行的无歧义指令,谁就握住了 Agent 时代的关键产能。技术文档工程师这个长期被视为"支持岗"的角色,正在悄悄走向舞台中央。 --- ## 二、解剖一个 Skill:标准化结构背后的工程哲学 打开 Google 的 Skill 仓库,你会发现每个技能都长一个样子。这种"无聊"的一致性,恰恰是工程化的精髓。 ### 标准目录结构 ```text {skill-name}/ ├── SKILL.md # 必需: 主指令和 frontmatter 元数据 ├── OWNERS # 必需: Skill 维护者(内部) ├── EVAL.yaml # 必需: 评估提示套件和评分标准(内部) ├── reference/ # 可选: 深度技术文档和 schemas ├── scripts/ # 可选: 可执行辅助脚本 ├── assets/ # 可选: 静态资源和图表 └── _internal/ # 可选: 测试 mocks 和内部数据(内部) ``` 三个"必需"文件,每一个都值得掰开看。 ### SKILL.md:不是文档,是接口 很多团队写内部文档的痛苦在于:写给人看的东西,充满了"一般来说""通常情况下""视情况而定"这类弹性表达。人类读者可以脑补,Agent 不行。 **SKILL.md 的真正身份是一份程序化指令**,它的读者是 Agent,本质是接口定义。这意味着: - **指令必须无歧义**。"建议先检查配额"不行,要写清楚"执行部署前,调用 X 工具检查配额,若不足则停止并提示用户"。 - **边界情况必须显式覆盖**。失败了怎么办?权限不够怎么办?这些在人类文档里是"附录",在 Skill 里是"主逻辑"。 - **frontmatter 元数据是机器可读的契约**。name、description 这些字段直接参与 Discovery 阶段的任务匹配,写得好不好,决定 Agent 能不能在正确的时候找到它。 把 SKILL.md 当 API 文档来写,而不是当博客来写——这是第一个认知升级。 我们不妨做个思想实验。同样是"在 GKE 上部署服务"这个需求,两种写法的差距是巨大的: **文档式写法**(写给人看):"部署前最好先确认一下集群状态和资源配额,避免失败。"——人类读者会心一笑,知道去查哪个页面;Agent 读到这句话,只会礼貌地点头,然后继续按自己的方式蛮干。 **接口式写法**(写给 Agent 执行):"步骤 1:调用 `list_clusters` 工具确认目标集群存在且状态为 RUNNING,若不存在则停止并告知用户;步骤 2:调用 `get_quota` 检查 CPU 与内存配额,余量不足时输出缺口数值并停止;步骤 3:……"——每一步都是可执行、可验证、失败有明确出口的程序化指令。 看出区别了吗?前者是"建议",后者是"合约"。**Skill 写作的本质,是把领域知识编译成 Agent 的指令集。** 这也解释了为什么可选目录里会有 `reference/`(深度技术文档和 schemas)、`scripts/`(可执行辅助脚本)和 `assets/`(静态资源)——复杂知识放不下正文就放进参考文档,确定性操作写成脚本比让模型现场生成命令可靠得多。让模型做它擅长的(理解意图、编排步骤),让脚本做它擅长的(精确执行、幂等操作),这是 Skill 设计的分工美学。 ### OWNERS:把责任钉死到人 OWNERS 文件记录的是这个 Skill 的长期维护者。为什么这是"必需"而非"可选"?因为 Google 太清楚开源项目的死法了:**不是死于没人贡献,而是死于没人维护。** 产品 API 变更了,谁更新 Skill?OWNERS 里的人。每周评估发现质量退化了,谁修?OWNERS 里的人。没有这个名字,Skill 就会像无数无人维护的开源库一样,慢慢腐烂成技术负债——而且是有毒的负债,因为 Agent 会自信地执行过时的指令。 ### EVAL.yaml:评估即合约 三个必需文件里,EVAL.yaml 是最具革命性的一个。它要求**每个 Skill 在诞生时就必须定义"什么算成功"**——评估提示套件(一组测试任务)加评分标准,缺一不可。 这意味着"评估"从事后的质量抽查,变成了合并的前置条件。你没法先提交 Skill 再补测试,就像成熟的工程团队不允许先合并代码再补单测。**评估不是 Skill 的附属品,而是 Skill 定义的一部分。** 这个设计背后是一个冷静的判断:文档和 API 会演进,LLM 模型和 Agent 框架也会变化,**今天能用的 Skill,明天可能就失效**。没有评估合约的 Skill,就是一颗不知道什么时候爆的雷。 把三个必需文件连起来看,一个完整的治理闭环浮现了:**SKILL.md 定义"做什么",OWNERS 回答"谁负责",EVAL.yaml 规定"怎么算好"。** 这恰恰是任何一个成熟软件产品的三要素——功能定义、责任人、验收标准。Google 没有发明新理论,它只是坚持把软件工业几十年验证过的常识,原封不动地搬到了 Agent 指令这个新兴领域。常识往往是稀缺品。 --- ## 三、MCP 优先:一条影响深远的架构路线 在 Skill 的具体写法上,Google 给出了一条明确的架构指导原则:**尽可能引用远程 MCP(Model Context Protocol)工具,仅在必要时才回退到 CLI 或 API 调用。** 这句话看似是个技术偏好,实则是一次深思熟虑的架构站队。 ### 两层解耦:能做什么 vs 怎么做 MCP 是 Anthropic 发起的开放协议,如今已成为 Agent 生态的事实标准。MCP 服务器提供四类能力:Tools(可调用函数)、Resources(可读数据)、Prompts(提示模板)、Notifications(事件通知)。经过一年多的生态演化,社区沉淀出的最佳实践已经相当清晰:单一职责服务器(一个服务器只干一件事)、资源优先设计(能读的数据暴露为 Resource,而不是包成 Tool)、分层工具组织、凭证隔离。这些原则与 Google 的"远程 MCP 优先"路线互为呼应——都在回答同一个问题:**如何让 Agent 的能力接入像微服务一样可治理。** 把 MCP 和 Skills 放在一起看,一个清晰的两层架构浮现出来: - **MCP 层是"能力通道"**——它回答"Agent 能做什么":能查数据库、能创建虚拟机、能读取日志。 - **Skills 层是"使用知识"**——它回答"应该怎么做":先查配额再创建实例、用这个命令组合排查问题、遵循这套发布流程。 下面的架构图展示了这两层如何协同,以及为什么远程 MCP 服务器处于枢纽位置: ![MCP + Skills 两层架构.png](https://developer.qcloudimg.com/http-save/yehe-7660620/134ba553f83303756d7707089c7579f8.png) ### 为什么"远程"二字是重点 Google 强调的不仅是 MCP,而是**远程** MCP 服务器。区别在于:本地 MCP 服务器把凭证、权限、审计的负担都压在了每个开发者的机器上;而远程 MCP 服务器在服务端提供工具的同时,**内置了认证和 IAM 治理**。 对企业来说,这是 Agent 能不能进生产环境的分水岭。没有 IAM 治理的 Agent,就像一个拿着全员共享 root 密码的实习生——能力越强,风险越大。把鉴权收敛到服务端,Agent 的每一次工具调用都在企业既有的权限体系内运转,安全团队才睡得着觉。 ### 解耦的红利:各自独立演进 两层架构的深层红利在于演进自由度。API 升级了?改 MCP 服务器,200 个引用它的 Skill 一行不动。最佳实践变了?改 Skill 的指令,MCP 工具层无感知。团队可以并行建设:平台团队维护 MCP 工具矩阵,领域专家团队编写 Skill 知识,互不阻塞。 对比一下反面教材:如果 Skill 里直接硬编码 CLI 命令,那么 API 每一次变更都会引发全仓库的连锁修改——这正是 Google 用一条架构原则提前拆掉的地雷。 对于正在规划内部 Agent 平台的架构师,这里有一个可以直接抄走的推论:**先建 MCP 工具矩阵,再养 Skill 知识库,顺序不能反。** 很多团队的失败路径是反过来的——先兴致勃勃写了一大堆 Skill,里面塞满直接调 CLI、调 API 的指令,结果能力层没有任何统一治理,权限发散、审计缺失,安全评审过不去,最后全部推倒重来。能力通道是地基,使用知识是上层建筑,地基不稳,楼盖得越快塌得越惨。 --- ## 四、三层质量防线:CI/CD、持续评估、所有权模型如何协同 项目上线后,Google 遇到了一个"幸福的烦恼":15,000+ stars 带来了巨大的关注度,各产品团队——不限于 Cloud,还有 Ads 等——纷纷要求贡献 Skills。 开放的闸门一开,质量的洪水就可能灌进来。Google 在文章里坦言:**不同团队贡献的 Skills 很难保持一致标准,而一个劣质 Skill——指令模糊、链接失效、缺失边界情况——会拉低整个 Agent 的体验。** 用户的逻辑很简单:他不会区分"这个 Skill 是某团队贡献的次品",他只会说"Google 的 Agent 不行"。 怎么在开放贡献的同时守住开发者体验?Google 的答案是三道防线层层设卡。 ### 第一道防线:提交时的 CI/CD 自动化检查 每个 Skill 提交时,流水线自动执行三类检查: 1. **Linters(静态检查)**:验证 frontmatter 元数据是否完整、行数是否合规、目录布局是否符合标准、命名是否规范。结构层面的"形状错误",机器一秒钟就能拦住。 2. **Link Checkers(链接检查)**:测试文档中的每一个 URL,消灭 404 和"幻觉链接"——大模型时代的新特产,看起来很像真的、实际不存在的链接。Google 推荐了 lychee,一个用 Rust 编写的高性能链接检查器。对公共仓库,还可以用 GitHub Action 配合 skills-ref 工具(`pip install skills-ref`,然后 `agentskills validate`)完成校验。 3. **AI 辅助检查清单**:自动验证指令是否遵循所需的结构模式和护栏。用 AI 检查给 AI 写的指令——套娃,但有效。 这一层防线的哲学是:**能用机器拦的问题,绝不留给人肉 review。** ### 第二道防线:持续评估,和时间作战 CI 检查管的是"形状对不对",但管不了"效果好不好"。一个格式完美的 Skill,可能教 Agent 走了一条又贵又慢的弯路。这就需要第二道防线——持续评估体系,分两个节奏运行: - **提交时评估**:作者必须自带评估套件(就是前面说的 EVAL.yaml),每个新 Skill 先过内部评估,证明它真的有用。 - **每周质量检查**:定期跑评估任务,检测回归——上周还 90 分的 Skill,这周可能因为上游 API 变更掉到 60 分。 评估在两个维度上展开:**准确性**(响应质量和任务完成率)和**效率**(token 消耗和完成时间)。方法上有一个关键设计:**对比 Agent 有 Skill 和没有 Skill 时的表现**,量化提升幅度;并且对不同的 Agent 框架多次运行,以获得统计显著性。 为什么要强调"统计显著性"?因为大模型的输出天然带随机性——同一个任务跑五次,可能成功四次失败一次。单次评估的"通过"可能只是运气好。多次运行、多框架交叉验证,本质上是把软件测试里" flaky test(不稳定测试)不可信"的常识,贯彻到了概率性系统的评估中。这个细节很能体现团队的工程素养:**他们没有被 AI 的新奇冲昏头脑,而是清醒地知道自己在和一个概率系统打交道。** 最终,每个 Skill 被放进一个 **2×2 矩阵**里检验:准确性提升了吗?效率提升了吗?只有两个维度都有可衡量的正向提升,这个 Skill 才证明了自己的存在价值。这个矩阵还藏着一个反直觉的洞察:**一个 Skill 让 Agent 更"准"但更"贵",算不算好 Skill?** 按照矩阵的严格标准,不算——因为效率退化意味着生产环境成本上升,而成本失控的 Agent 系统注定无法规模化。质量与成本必须同时为正,这是把"能用"和"能上线"区分开的关键一刀。 这套评估并非空中楼阁。Google Codelabs 已经放出了可复现的教程:用 inspect-ai + inspect-swe + google-genai 的组合,遍历 Skills 文件夹找到每个 SKILL.md,定义测试问题集,通过 gemini_cli solver 执行任务,最后用 model_graded_qa(模型评分问答)自动打分。整套流程可以脚本化运行——**评估不是一次性的仪式,而是可以无限重放的流水线环节。** 下面的流程图展示了一个 Skill 从提交到每周巡检的完整质量流水线,三道防线的位置一目了然: ![Skill 质量三层防线流水线.png](https://developer.qcloudimg.com/http-save/yehe-7660620/552b41db72297e682306223ca176a056.png) ### 第三道防线:所有权模型,把"产品"二字落到实处 自动化能拦住格式问题,评估能发现质量问题,但**修复问题永远需要人**。Google 的所有权模型分两层: - **Repo Maintainers(仓库维护者)**:监督仓库整体健康、CI 管道、架构标准——管"场子"。 - **Skill Owners(技能所有者)**:长期维护各自的 Skills。产品 API 变更时更新它;评估发现质量退化时修复它——管"摊子"。 "Skills 是产品,不是片段(Skills are products, not snippets)"——这是整篇文章里我最想加粗划线的一句话。片段(snippet)的生命周期在粘贴那一刻就结束了;产品的生命周期从发布那一刻才开始。承认这一点,才谈得上后面的维护、评估和迭代。 ### 内外分离:质量门控式开源 还有一个值得一提的机制设计:**公共导出**。所有 Skills 先在内部构建和评估,确保真的work、真的经过验证;准备就绪后,通过自动化导出规则发布到 GitHub,过程中自动剥离内部资产、所有权信息和评估套件,保持公共仓库的干净。 这个"内部验证、自动导出、公开交付"的机制,优雅地化解了开源治理的经典张力:**既要开放贡献的红利,又要质量把控的底线**。社区拿到的是经过实战检验的成品,Google 保留的是完整的质量证据链。 --- ## 五、用 Agent 造 Skill:自我进化的工具链 如果说前面的内容是"怎么管 Skills",那么 Google 在作者支持工具上的投入,则回答了"怎么让造 Skill 本身也变得更聪明"。 答案颇有点"用魔法打败魔法"的味道:**Google 内部有专门的 Skills,用来辅助作者构建新 Skills 和编写评估。** 这些工具基于 ADK(Agent Development Kit)构建,运行多 Agent 循环:一个 Agent 负责编写,另一个 Agent 负责自我批评(self-critique),迭代打磨后可以导出到主仓库。 ### 为什么"编写-批评"循环是关键 写过技术文档的人都知道一个残酷事实:**初稿永远是自我感动的。** 作者对自己写的东西有天然的盲区——你觉得表述清晰,是因为你已经知道答案。这正是 Agent 指令的大忌。 多 Agent 架构把"作者"和"评审"拆成两个角色:编写 Agent 产出指令草稿,批评 Agent 以"另一个立场"审视它——指令有没有歧义?边界情况覆盖了吗?这个步骤 Agent 真的能执行吗?一轮轮对抗下来,质量收敛的速度远超单人憋稿。 这其实是把人类工程团队里"代码评审"的最佳实践,移植到了 Agent 工作流内部。 ### 更深的启示:工具链即护城河 很多团队做 Agent 应用时,把全部精力花在"让 Agent 干活"上,却忽视了"让造 Agent 工具的人更高效"。Google 的做法提示了一个战略级认知:**当 Skill 成为核心资产,生产 Skill 的工具链就成了核心基础设施。** 此外,Google 还并行运营着一个 **DevRel Skills 内部计划**——把内部流程(内容转换、SEO 优化、内部报告等)同样编码为 Skills。这个细节容易被忽略,但它透露了一个重要信号:Skills 的适用范围远不止编码场景。**凡是"有标准流程的知识工作",都可以被 Skill 化。** 你的团队有多少这样的流程还躺在 Wiki 里吃灰? 把视线再拉高一层。当"造 Skill 的 Agent"和"用 Skill 的 Agent"同时存在,一个自我强化的飞轮开始转动:Agent 使用 Skill 完成任务 → 实践中发现 Skill 的不足 → 编写 Agent 改进 Skill → 改进后的 Skill 让 Agent 更强。这个飞轮目前还需要人类在关键环节把关(评估标准、合并决策),但它的方向已经足够清晰——**知识资产的生产和消费,正在同一个 Agent 生态内闭环。** 这可能是 Agent Skills 体系里最容易被低估、却最具长期价值的设计。 --- ## 六、15,000 stars 之后:生态现状与成熟度判断 热度是虚荣指标,生态才是价值指标。让我们冷静盘点一下 google/skills 仓库的家底。 ### 现状盘点 截至文章素材统计,这个 Apache 2.0 协议的开源仓库已有 **201+ 次提交**,覆盖范围相当可观: - **Google Cloud 基础设施**:GKE 一个产品就有 20+ 个 Skills; - **数据与数据库**:BigQuery、AlloyDB、Spanner 等; - **Agent Platform 全生命周期**:从开发到部署; - **Google Ads API**:证明这不是 Cloud 的独角戏; - **Flutter/Dart、安全运维**等更多领域。 接入层面,它支持多种 Agent 客户端插件——Claude Code(`claude plugin marketplace add google/skills`)、Codex、Antigravity CLI,也可以通过 `npx skills add google/skills` 一键安装。**跨客户端兼容**这一点很重要:它意味着 Skills 正在成为 Agent 生态的"通用弹药",而不是某家厂商的私有格式。 评估工具链也在跟上:Google Codelabs 已提供完整教程,演示如何用 inspect-ai + inspect-swe + google-genai 评估 Skills——遍历 Skills 文件夹找到 SKILL.md,定义测试问题集,用 gemini_cli solver 运行,再用 model_graded_qa 打分。**评估不再是内部黑盒,而是社区可复现的开卷考试。** ### 冷静剂:这套体系的三个局限 作为技术人,我们有义务在掌声中保持清醒。这套体系至少有三个值得注意的局限: **其一,2×2 矩阵的评估盲区。** 准确性×效率的评估框架主要覆盖单次任务表现,但真实世界的 Agent 使用往往是多轮交互、复杂编排的场景。一个 Skill 在单次任务里表现出色,在十个 Skill 串联的长链路里可能引入累积误差。这类系统性风险的评估,目前还是空白地带。 **其二,评分标准的人为偏差。** EVAL.yaml 的评分标准是人定义的,"什么算成功"本身就携带定义者的偏见。如果评估套件只覆盖了作者想到的场景,那评估通过只能证明"作者自洽",不能证明"真实有效"。这和"开发者给自己写的代码写测试"是同一个陷阱。 **其三,开放标准的采纳率悬念。** Agent Skills 格式由 Anthropic 发起,Google 是重量级采纳者,但整个行业的碎片化风险仍在。如果各家厂商最终演化出互不兼容的 Skill 方言,今天的投入可能面临迁移成本。当然,从 MCP 的先例看,头部玩家围绕开放标准收敛的概率更大——Anthropic 发起、Google 重仓、多客户端兼容,这个组合的向心力不容小觑。 ### 成熟度判断:从"能跑"到"敢用"的中场战事 综合看家底,可以给这个项目一个阶段性判词:**它已经过了"证明可行"的阶段,正处在"证明可持续"的中场。** 201+ 次提交、覆盖云、数据库、广告、移动端多领域、CI/CD 与评估体系完备——这些说明工程基建已经成型。而真正的考验在接下来的两件事:一是社区贡献的质量能否在规模扩大后守住(GitHub 上的外部贡献者不会像内部团队那样遵守 EVAL.yaml 纪律);二是当底层模型代际更替时(比如下一代 Gemini 发布),整个 Skill 库能否经受住一次大规模的回归评估而不至于大面积返修。 换句话说,**Google 建起了一座工厂,证明了流水线的价值;但流水线能否穿越技术周期,还需要时间来回答。** 对观察者而言,这恰恰是最好的研究窗口期——方法论已经开源,踩坑成本由 Google 垫付,跟进的门票从未如此便宜。 --- ## 七、架构师的行动清单:趋势展望与决策建议 分析至此,最实际的问题是:**这套打法对你意味着什么?** 分角色给建议。 ### 未来 3-6 个月的三个推演 **推演一:Skill 仓库将成为企业的"知识中台"。** 今天的 Skills 主要服务编码 Agent,但 Google 的 DevRel 内部计划已经指明了方向——市场、运营、销售、客服的标准化流程都会被 Skill 化。企业里那些"只有老员工知道怎么做"的隐性知识,第一次有了可执行、可评估、可传承的载体。 **推演二:评估基础设施会成为新的兵家必争之地。** 当"评估即合约"成为共识,谁来提供评估框架、评估数据集、评估基准,谁就掌握了 Agent 生态的质量定义权。inspect-ai 这类工具只是开始,围绕 Agent 效果度量的创业窗口正在打开。 **推演三:MCP + Skills 组合将成为企业 Agent 平台的默认架构。** 能力层与知识层分离、IAM 治理收敛到服务端、跨客户端复用——这三个特性叠加,几乎是为企业级需求量身定制的。还在用"一个大 Prompt 走天下"的团队,会在未来半年内明显感到工程债务的利息。 **推演四:"Skill 工程师"将成为一个真实的新岗位。** 就像 DevOps 工程师诞生于开发与运维的交界处,未来会出现一批专职人才:他们既懂领域业务,又懂 Agent 行为特性,核心职责是编写、评估、维护 Skill 资产。Google 让技术文档工程师和开发者布道师牵头这个项目,已经预演了这种人才画像。现在开始积累"为 Agent 写作"的经验,就是在为这个职业窗口期占座。 ### 给三类读者的行动建议 **如果你是高级开发者:** 1. **今天就去装一个试试。** `npx skills add google/skills`,在真实任务里跑一遍,亲身体会"有 Skill 的 Agent"和"裸 Agent"的差距。体感比任何文章都有说服力。 2. **把你团队的"祖传 Prompt"盘点一遍。** 那些散落在 Wiki、聊天记录、个人收藏夹里的提示词,是最适合 Skill 化的存量资产。挑一个最痛的场景,按 SKILL.md 的标准结构改造它——记得带上评估用例。 3. **学习"给 Agent 写指令"的新文体。** 它的写作标准接近 API 文档:无歧义、覆盖边界、机器可读。这是未来两年最值钱的写作技能之一。 **如果你是架构师:** 1. **按两层架构规划你的 Agent 平台。** 能力接入走 MCP(优先远程、带 IAM 治理),使用知识走 Skills,严禁把两者搅在一起。今天的解耦是明天的演进自由度。 2. **把"评估前置"写进你的工程规范。** 没有评估用例的 Skill 不许合并,就像没有单测的代码不许上线。先从核心场景做起,哪怕评估套件只有五个用例,也强过没有。 3. **设计所有权机制时,先解决"人"的问题。** 每个 Skill 必须有具名 Owner,Owner 的职责(API 变更跟进、质量退化修复)必须写进团队的工作定义里,而不是靠自觉。 **如果你是技术管理者:** 1. **把 Agent 指令资产纳入工程治理的版图。** 它的重要性正在逼近代码资产,需要的治理手段也一样:版本控制、CI/CD、评估、所有权。预算和人力规划要跟上这个判断。 2. **警惕"Demo 很惊艳,上线就翻车"的陷阱。** Agent 项目的失败大多不是模型不行,而是知识供给和工程治理不行。评估一下你的团队:有多少精力花在"让 Agent 演示成功",又有多少花在"让 Agent 持续可靠"? 3. **关注 Skills 标准生态,但避免过早重注。** 开放标准的格局尚未完全定型,保持架构的可迁移性——Skill 内容与具体 Agent 框架解耦,是对冲碎片化风险的最佳姿势。 --- ## 结语:把 AI 当员工,就要用管理员工的方式对待它 回看 Google 这套体系,最打动我的不是某个具体技术,而是一个贯穿始终的隐喻:**他们真的把 Agent 当员工在带。** 新员工入职,发一本岗位手册(SKILL.md);手册的每一页有人负责更新(OWNERS);上岗前要通过考核,考核标准入职时就讲清楚(EVAL.yaml);定期有绩效评估,能力退化了有人跟进辅导(每周回归 + Owner 修复);而员工能调动多少公司资源,由权限系统说了算(远程 MCP + IAM)。 听起来是不是一点都不"AI"?恰恰如此。**当一项技术开始用管理学的逻辑解决工程问题,说明它真的要走入生产环境了。** Prompt 工程时代的狂热正在退潮,取而代之的是更朴素的问题:你的 Agent 知识体系,有版本控制吗?有评估吗?有 Owner 吗?能扛住上游 API 的一次变更吗? 如果答案都是"没有",那么 15,000 个 star 指向的方向,值得你认真走一趟。 最后留一个问题给你:如果你的团队明天就要把最核心的业务流程交给 Agent 执行,你手里的"岗位手册",敢拿出来给它看吗? 如果答案是犹豫的——那么恭喜,你已经找到了下一个季度最值得投入的工程方向。 --- *本文基于 Google AI 官方博客文章、agentskills.io 开放规范、github.com/google/skills 仓库公开信息及 Google Codelabs 评估教程等多个来源综合分析,关键信息可追溯到原始出处。文中局限性分析为作者独立观点。*

优秀的个人博客,低调大师

Kruskal Count原理中的数学与魔术——历史发展全景(一)

**🃏 Kruskal Count 历史发展全**景 从 1957 年 Alexander Kraus 的 "Sum Total" 到 2019 年的现代变体 25 条记录 近 70 年 3 次独立发现 ## 📖 一、什么是 Kruskal Count? Kruskal Count(克鲁斯卡尔计数)是一种基于**概率耦合(Coupling)**原理的数学魔术。 *参与者从一副牌中任选一张作为起点,根据牌面数值向前数若干张牌,重复此过程直到走到牌组末端。无论起点如何选择,多条路径以**指数级速度收敛**,最终落在同一张牌上的概率超过 90%。* 这一原理本质上是**马尔可夫链的收敛性**在魔术中的体现,属于概率论中耦合理论的应用。 ## 👥 二、核心人物 |人物|身份|核心贡献| | --- | --- | --- | |Alexander F. Kraus|魔术师|1957年最早发表类似程序,后被称为"Kraus 原理"| |Martin D. Kruskal (1925–2006)|美国数学家(孤立子理论)|1970年代初独立发现该原理并以其名字命名| |Evgenii B. Dynkin|俄罗斯数学家|1950-60年代独立发现类似概念用于耦合效应演示| |Martin Gardner|科普作家/魔术爱好者|1975年正式将该原理发表到魔术界,以 Kruskal 命名| |Ronald A. Wohl (Ravelli)|魔术师/数学分析者|1961年对该原理进行了深入的数学分析| |Karl Fulves|魔术作者|1975年起持续创作变体与文献整理| |Jim Steinmeyer|魔术设计师|2002年创作了三个经典拼写变体| |Diaconis & Graham|数学家|2012年追溯了 Kruskal 与 Gardner 的通信历史| ## 📅 三、历史发展时间线 **1** **孕育期** 1950s 1957年12月 **"Sum Total" — 问题提出** Alexander F. Kraus | *Ibidem* 第12期,第7页 Kraus 提出了一个挑战性问题——设计一个计数程序,使最终所有面朝上的牌的数值之和等于 52。这是魔术文献中**最早公开的 Kruskal 计数程序**,比 Kruskal 本人的发现早了约 15 年。 1958年3月 **"Sum Total" 解答与变体** Kraus / Tom Ransom / Max Katz | *Ibidem* 第13期 Kraus 自己给出解答(第13页);Tom Ransom 提出 "Sum More" 变体(第17页),引入部分牌组堆叠;Max Katz 同时提出另一变体(第17页)。 1950s-1960s **Dynkin 的独立发现(学术界)** Evgenii B. Dynkin | 莫斯科大学概率论课堂 Dynkin 在莫斯科大学的概率论课堂上使用类似的"魔术"作为**耦合效应**的教学演示。1952年与 Uspenskii 出版俄语著作《数学对话》。这一发现当时仅在学术界流传,未与魔术界产生联系。 **⚠️ 关键发现:**Kraus 的 Sum Total 系列虽然使用了与 Kruskal Count 相同的数学原理,但当时并未引起魔术界广泛关注。这一原理后来被称为"Kraus 原理",与"Kruskal 原理"实质上是同一数学现象的独立发现。 **2** **深化分析期** 1960s 1961年3月 **"Sum Fun" — 数学深入分析** Ronald A. Wohl (Ravelli) | *Ibidem* 第23期,第25页 对 Kruskal 计数程序进行了**系统性的数学分析**,将其分解为五种循环模式:数字循环、拼写循环、结束循环、诱导循环、逆向循环。这是第一次有人从数学角度对这一原理进行系统化分类和分析。 1972年 **"The Mazatlan Mystery"** Tieneblas, El Brujo Viejo | *Magick* 第55期,第271页 使用**四张重复牌**的 Kruskal 变体——牌叠被切,底部牌的数字用于计数到目标牌进行预测。将 Kruskal 原理与完整堆叠牌组结合,拓展了应用场景。 **3** **正式命名与推广期** 1970s 1971-1974 **Kruskal 致信 Gardner** Martin D. Kruskal ↔ Martin Gardner 据 Persi Diaconis 和 Ron Graham (2012) 追溯:Gardner 曾写信给 Kruskal,推荐 Diaconis 申请研究生院。Kruskal 在回信中**附上了这个魔术的说明**。Kruskal 一家三兄弟(Martin、William、Joseph)都是 Gardner 的朋友。Kruskal 当时是在研究另一个数学问题时,作为**副产品**重新发现了这一原理。 **⚡ 关键转折:**Kruskal 的发现虽然与 Kraus (1957) 和 Dynkin (1950s-60s) 的研究在数学上本质相同,但三者是完全独立的发现。正是因为 Kruskal 通过 Gardner 的渠道将其带入魔术界,这个原理最终以他的名字命名。 1975年6月 **★ "The Kruskal Principle" 正式发表 ★** Martin D. Kruskal(Gardner 描述)| *The Pallbearers Review* 第10卷第8期,第967页 正式向魔术界介绍了 Kruskal 原理,包含使用**两副牌**的方法。第985页引用了 *Ibidem* 上的早期相关文献。**这一发表标志着"Kruskal 原理"正式进入魔术界主流视野。** 1975年6月 **"Kruskal Phone Effect"** Karl Fulves | *The Pallbearers Review* 第10卷第8期,第970页 将 Kruskal 原理应用于**电话表演场景**——魔术师通过电话指导观众操作。首次将原理扩展到扑克牌以外的表演形式。 1978年2月 **Gardner 在《科学美国人》推广** Martin Gardner | *Scientific American* 2月号 向大众推广该原理。后在 1989 年著作 *Penrose Tiles to Trapdoor Ciphers* 第19章中详细讨论(1997年修订版扩展内容)。 **4** **多样化发展期** 1980s–1990s 1984年1月 **"Das Kruskal-Prinzip" 德语版** Martin D. Kruskal | *Intermagic* 第10卷第3&4期,第125页 1975年文章的德语再版,将该原理推广到德语魔术圈。 1986年1月 **"Double Predict-A-Count"** Al Thatcher | *Precursor* 第10期,第11页 引入**双重预测**——同时预测两张牌。灵感来自 Charlie Hudson 在 *The Linking Ring* 上关于 Kruskal 和 Kraus 的文章。 1996年 **"K Kards" & "Snibbets"** Karl Fulves | *13 Prophets* K Kards(第54页):五次中有四次成功(~80% 命中率)。Snibbets(第55页):结合 **Si Stebbins 堆叠**的变体。 1998年 **Kruskal 原理应用于文字** 里程碑 Martin Gardner / Mel Bennett / Karl Fulves 三位创作者同时将 Kruskal 原理从扑克牌扩展到**文字/书籍测试**: |作品|创作者|发表| | --- | --- | --- | |The K Diaries|Martin Gardner|Underworld #8, p.103| |K-Plus|Mel Bennett|Underworld #9, p.123| |Informant|Karl Fulves|The Fine Print #8, p.226| Kruskal 原理不再局限于扑克牌,进入**书籍测试(book test)**领域。 1999年 **"A Labyrinth in a Labyrinth"** Gordon Bean | *Labyrinth* 第11期,第4页 牌以**蛇形方式发出**,观众自由选择并随机化,表演者展示蛇形路径恰好是所选牌的首字母形状。受 Tony Koynini 的 "Koynini's Karpet" (1953) 启发。 **5** **成熟与创新期** 2000s–2010s 2002年 **Steinmeyer 三大经典变体** Jim Steinmeyer | *Impuzzibilities* |作品|页码|机制| | --- | --- | --- | |The One O'clock Mystery|p.12|拼写小时数,最终到达"1"| |The Three Mystery|p.14|拼写数字,最终到达"3"| |The King Mystery|p.14|拼写牌的数值,最终到达"King"| 启发了后续 Marty Kane 的 Spelling Bee Round (2006)、Sevendipity (2006) 和 Cursed by an Evil Spell (2008)。 2004年 **"Prediction à la Kruskal" (Mnemonica版)** Antonio José Arenillas | *Mnemonica*,第68页 将 Kruskal 原理应用于 **Tamariz 的 Mnemonica 记忆牌组**进行预测。首次将 Kruskal 原理与高端记忆牌组系统结合。 2007年 **"The Fiend Stack" 系统** Paul Lesso | *Miraculous Minds*,第53、58页 构建了一个完整的 **Power/Stay 堆叠组合系统**,将 Kruskal 强迫作为核心功能之一,整合了数字强迫、Kruskal 强迫、序列强迫、恶魔算法(1小时记忆牌组)。将 Kruskal 原理从单一魔术效果提升为**完整牌组系统的核心组件**。 2011年 **"Descartes" — 双重匹配** Luis Otero | *El Manuscrito* 第4卷第15期,第428页 形成两位数并写在牌背;从另一副牌选牌并按值计数,重复至无法继续;翻开的牌总数匹配该数字;最后一张牌与预测牌相同。将**数字预测**与**牌面预测**双重效果融合。 2019年 **最新发展** Harapan Ong / Patrick G. Redford |作品|创作者|发表| | --- | --- | --- | |Prediction à la Kruskal (Ong版)|Harapan Ong|A Stack to Forget, p.70| |Your Luck Is In The Cards|Patrick G. Redford|Sleightly Out Of Order, p.70| 分别将 Kruskal 原理应用于 Ong 堆叠牌组和 Redford 堆叠牌组系统。 ## 🗺️ 四、发展脉络总览 **1957** — Kraus "Sum Total" 最早发表(魔术界) **1958** — Kraus / Ransom / Katz "Sum More" 变体涌现 **1961** — Ravelli "Sum Fun" 数学系统分析 **1972** — Tieneblas "Mazatlan Mystery" 完整堆叠应用 **1971-74** — Kruskal 致信 Gardner 独立发现(学术界→魔术界桥梁) **1975 ★** — Gardner 发表 "The Kruskal Principle" 正式命名 **1975** — Fulves "Kruskal Phone Effect" 电话表演 **1984** — 德语版 国际化推广 **1986** — Thatcher "Double Predict-A-Count" 双重预测 **1996** — Fulves "K Kards" / "Snibbets" 概率优化与堆叠结合 **1998** — Gardner / Bennett / Fulves 文字/书籍测试拓展 **1999** — Bean "Labyrinth" 蛇形发牌创新 **2002** — Steinmeyer 三大变体 拼写应用经典化 **2004** — Arenillas Mnemonica 记忆牌组结合 **2007** — Lesso "Fiend Stack" 系统化整合 **2011** — Otero "Descartes" 双重效果融合 **2019** — Ong / Redford 新堆叠系统应用 ## ∑ 五、数学本质 Kruskal Count 的核心数学原理是**概率耦合(Probabilistic Coupling)**: • **马尔可夫链性质**:每一步的选择仅取决于当前位置,与历史无关。 • **指数收敛**:两条不同起点的路径在每一步有约 1/13 的概率合并,合并后不再分离。对于52张牌的标准牌组,两条路径在牌组末端汇聚的概率 **> 90%**。 • **与输入无关**:最终输出位置与初始选择基本无关,这正是魔术师可以进行预测的基础。 **数学应用领域** 密码学与密码破解 软件防篡改保护 代码自同步与控制流重同步 Pollard 袋鼠算法 可变长度编码与指令集设计 ## 💡 六、历史启示 **独立发现现象:**Kruskal Count 被至少三次独立发现(Kraus 1957、Dynkin 1950s-60s、Kruskal 1970s),体现了数学之美的普适性。 **命名与传播:**原理最终以 Kruskal 命名,并非因为他最早发现,而是因为通过 Gardner 的渠道有效传播到了魔术界——传播渠道决定了命名权。 **从魔术到数学:**Kraus 的早期版本主要被视为魔术技巧,直到 Ravelli (1961) 和后续学者才系统揭示其数学本质。 **持续创新:**从 1957 年至今近 70 年,该原理仍在持续产生新变体,说明其数学结构的丰富性和可扩展性。 整理自 Conjuring Archive (conjuringarchive.com/list/category/1808) 及相关公开文献 · 2026年7月

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册