彻底搞定HashMap面试问题!!!
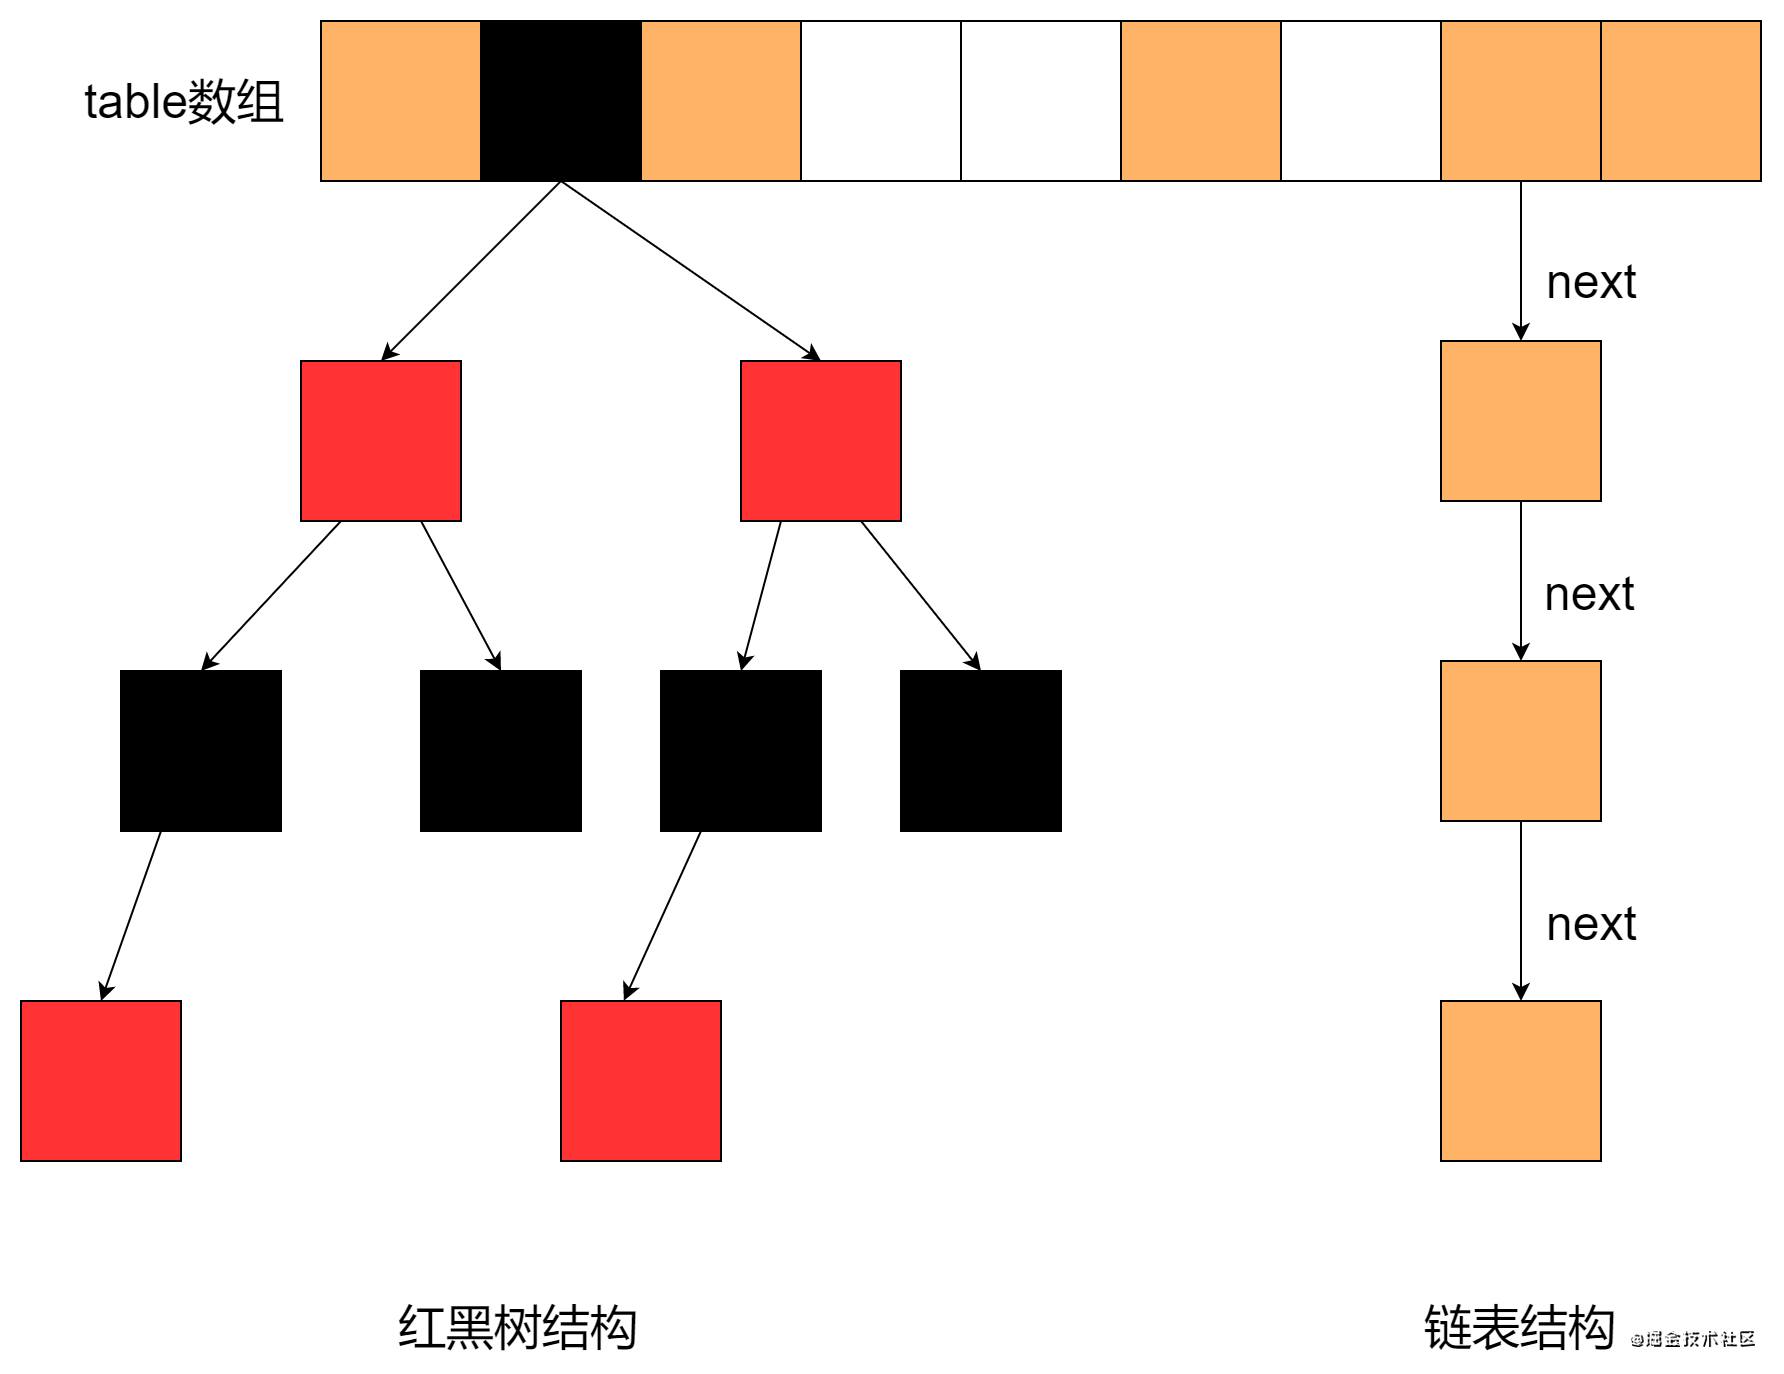
本文目录 HashMap的设计思想 HashMap的底层结构 为什么不一开始就使用HashMap结构 为什么Map中的节点超过8个时才转换成红黑树 为什么HashMap不是线程安全的 同时put碰撞导致数据丢失 扩容期间取出的值不准确 HashMap在java7和java8中的区别 底层数据结构对比 插入方式对比 扩容方式对比 ConcurrentHashMap在java7和java8中的区别 数据结构 并发程度 遇到Hash碰撞 HashMap的设计思想 HashMap的底层结构 本文主要是讲解jdk1.8中的HashMap源码,会对jdk1.7中的HashMap做一些简单的讲解用来和jdk1.8中的HashMap进行对比。 我们先通过下图来理解HashMap的底层结构: 首先我们通过上面的内容我们可以看到HashMap结构都是这样一个特点:最开始Map时空的,然后往里面放元素时会计算hash值,计算hash值之后,第一个value值会占用一个桶(也就是槽点),以后再来相同hash值的value那么便会用链表的形式在该槽点后继续延伸这就是拉链法。 当链表的长度大于或者等于阙值的(默认是8)的时候,并且同时还满足当前HashMap的容量大于或等于MIN_TREEIFY_CAPACITY(默认64)的要求,就会把链表转成红黑树结构,如果后续由于删除或者其它原因调整了大小,当红黑树的节点小于或等于6个以后,又会恢复链表结构。 为什么不一开始就使用HashMap结构 官方给出的解释是: Because TreeNodes are about twice the size of regular nodes, we use them only when bins contain enough nodes to warrant use (see TREEIFY_THRESHOLD). And when they become too small (due to removal or resizing) they are converted back to plain bins. 翻译就是:因为TreeNodes的大小大约是普通Node节点的两倍,所以只有在节点足够多的情况下才会把Nodes节点转换成TreeNodes节点,是否足够多又由TREEIFY_THRESHOLD决定,而当桶中的节点的数量由于移除或者调整大小变少后,它们又会被转换回普通的链表结构以节省空间。 通过源码中得知,当链表长度达到8就转成红黑树结构,当树节点小于等于6时就转换回去,此处体现了时间和空间的平衡思想。 为什么Map中的节点超过8个时才转换成红黑树 这个问题官方给的解释是: In usages with well-distributed user hashCodes, tree bins are rarely used. Ideally, under random hashCodes, the frequency of nodes in bins follows a Poisson distribution (http://en.wikipedia.org/wiki/Poisson_distribution) with a parameter of about 0.5 on average for the default resizing threshold of 0.75, although with a large variance because of resizing granularity. Ignoring variance, the expected occurrences of list size k are (exp(-0.5) * pow(0.5, k) / factorial(k)). The first values are: 0: 0.60653066 1: 0.30326533 2: 0.07581633 3: 0.01263606 4: 0.00157952 5: 0.00015795 6: 0.00001316 7: 0.00000094 8: 0.00000006 more: less than 1 in ten million 上面的意思是:在使用分布良好的用户的hashCodes时,很少使用红黑树结构,因为在理想情况下,链表的节点频率遵循泊松分布(意思就是链表各个长度的命中率依次递减),当命中第8次的时候,链表的长度是8,此时的概率仅为0.00000006,小于千万分之一。 但是,HashMap中决定某一个元素落到哪一个桶中,是和某个对象的hashCode有关的,如果我们自己定义一个极其不均匀的hashCode,例如: public int hashCode(){ return 1; } 由于上述的hashCode方法返回的hash值全部都是1,那么就会导致HashMap中的链表比那的很长,如果数据此时我们向HashMap中放很多节点的话,HashMap就会转换成红黑树结构,所以链表长度超过8就转换成红黑树的设计更多的是为了防止用户自己实现了不好的哈希算法而导致链表过长,影响查询效率,而此时通过转换红黑树结构用来保证极端情况下的查询效率。 HashMap初始化 HashMap的默认初始化大小是16,加载因子是0.75,扩容的阙值就是12(16*0.75),如果进行HashMap初始化的时候传入了自定义容量大小参数size,那么初始化的大小就是正好大于size的2的整数次方,比如传入10,大小就是16,传入30大小就是32,源码如下: static final int tableSizeFor(int cap) { int n = cap - 1; n |= n >>> 1;//n>>>1表示n的二进制向右移动1位,以下同理,然后跟移动前的n进行异或操作 n |= n >>> 2; n |= n >>> 4; n |= n >>> 8; n |= n >>> 16; return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1; } 上述源码中,通过将n的高位第一个1不断的右移,然后把高位1后面的全变为1,在最后return的时候返回n+1,就符合HashMap容量都是2的整数次幂了。例如下图: 为什么HashMap初始化的容量一定是2的整数次幂 不管我们传入的参数是怎么样的数值,HashMap内部都会通过tableSizeFor方法计算出一个正好大于我们传入的参数的2的整数次幂的数值,那么为什么一定要是2的整数次幂呢?我们先来看看计算key的hash方法如下: //计算key的hash值,hash值是32位int值,通过高16位和低16进行&操作计算。 static final int hash(Object key) { int h; return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 得到了key的hash值后,在计算key在table中的位置索引的时候,代码如下: if ((p = tab[i = (n - 1) & hash]) == null) 正是因为n是2的整数次幂,比如当n是2时,它的二进制是10,4时是100,8时是1000,16时是10000....,那么(n-1)的二进制与之对应就是(2-1)是1,(4-1)是11,(8-1)是111,(16-1)是1111,为什么要用(n - 1) & hash来计算数组的位置索引呢,正是因为(n - 1) & hash的索引一定是落在0~(n-1)之间的位置,而不用管hash值是多少,因为“与”操作的结果就是散列值的高位全部归零,只保留低位值,用来做数组下标访问。以初始长度16为例,16-1=15,2进制表示是00000000 00000000 00001111。和某散列值做“与”操作如下,结果就是截取了最低的四位值。 为什么HashMap不是线程安全的 我们先来看HashMap中的put方法的源码,如下: final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; //如果table容量为空,则进行初始化 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; //计算hash值在表table中的位置,这里采用&操作是为了更快的计算出位置索引, //而不是取模运算,如果该位置为空,则直接将元素插入到这个位置 //此处也会发生多线程put,值覆盖问题。 if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); else { Node<K,V> e; K k; //判断tab表中存在相同的key。 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; //判断是否是红黑树节点,如果是则插入到红黑树中 else if (p instanceof TreeNode) e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { //遍历链表寻找链表尾部插入新值,如果发现存在相同的key,则停止遍历此时e指向重复的key for (int binCount = 0; ; ++binCount) { //jdk1.7采用的是头差法,jdk1.8采用的是尾差法 if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); //判断链表的长度是否大于TREEIFY_THRESHOLD,如果大于则转换红黑树结构 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } //发现了重复的key,判断是否覆盖,如果覆盖返回旧值, if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } //继续更新次数,不是原子操作,多线程put存在并发安全问题 ++modCount; //如果大于阙值(这个阙值和上面那个不一样,这个等于当前容量*加载因子,默认是16*0.75 = 12),进行扩容。 if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 上图部分源码中可以看出HashMap的put方法中有一行代码是++modCount,我们都知道这段代码并不是一个原子操作,它实际上是三个操作,执行步骤分为三步:读取、增加、保存,而且每步操作之间可以穿插其它线程的执行,所以导致线程不安全。 另外还有导致线程不安全的情况还有: 同时put碰撞导致数据丢失 //put方法中部分源码 if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); 比如上面的源码中,假如现在有两个线程A和B,它们的key的hash值正好一样,然后它们同时执行到了这个if判断,并且都发现tab中i的位置是空,那么线程A就将自己的元素放到该位置,但是线程B之前也是判断到这个位置为空,所以他在A之后也将自己的元素放到了该位置而覆盖了之前线程A的元素,这就是多线程同时put碰撞导致数据丢失的场景,所以HashMap是非线程安全的 扩容期间取出的值不准确 我们先来看看HashMap的取值方法get的源码,源码如下: public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } final Node<K,V> getNode(int hash, Object key) { Node<K,V>[] tab; Node<K,V> first, e; int n; K k; //如果数组时空的,或者当前槽点是空的,说明key所对应的value不存在,直接返回null if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { //判断第一个节点是否是我们需要的节点,如果是则直接返回 if (first.hash == hash && // always check first node ((k = first.key) == key || (key != null && key.equals(k)))) return first; if ((e = first.next) != null) { //判断是否是红黑树节点,如果是的话,就从红黑树中查找 if (first instanceof TreeNode) return ((TreeNode<K,V>)first).getTreeNode(hash, key); //遍历链表,查找key do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } 上面的get方法的源码中可以看出get方法主要是以下步骤: 计算Hash值,并由此值找到对应的槽点。 如果数组是空的或者该位置为null,那么直接返回null就可以了。 如果该位置处的节点刚好就是我们需要的,直接返回该节点的值。 如果该位置节点是红黑树或者正在扩容,就用find方法继续查找。 否则那就是链表,就进行遍历链表查找。 首先HashMap的get方法是从table中查询我们要查找的key是否存在,如果存在则返回,不存在则直接返回null,那么如果是在扩容期间,为什么获取的结果不准确呢?我们再来看看HashMap的扩容方法resize(),部分源码如下: if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { //重点在这里 oldTab[j] = null; if (e.next == null) newTab[e.hash & (newCap - 1)] = e; . . .//此处忽略 } } } 上面的源码是HashMap的resize方法的一小部分,首先我们知道HashMap的扩容会把旧数组的数据迁移到新数组中(怎么迁移的我们后面再说),在搬迁的过程中会把旧数组正在迁移的桶置为空比如,正如上面代码oldTab[j] = null这一行代码,正是把索引j的桶(或者槽点)置为空了,但是如果此时还没有完成所有的数据的迁移,那么HashMap中仍然是使用的旧数组,此时我们通过get方法查询的key的所以正好在这个旧数组中索引位置是oldTab[j]的位置,因为这个位置已经置空了,所以就会返回null,所以发生了扩容期间读取数据不准确。 HashMap在java7和java8中的区别 底层数据结构对比 java7的HashMap的结构示意图如下: 上图中可以看出jdk1.7中HashMap采用的数据结构是数组+链表的结构。 java8中的HashMap结构示意图如下: 从图中我们可以看出,java8中的HashMap有三种数据结构: 第一种结构是就是数组,数组中空着的位置(槽)代表当前没有数据来填充 第二种是和jdk1.7HashMap类似的拉链结构,在每一个槽中会首先填入第一个节点,后续如果计算出相同的Hash值,就用链表的形式往后延伸 第三种是红黑树结构,这个是java7中HashMap中没有的数据结构,当第二种情况的链表长度大于某一个阙值(默认为8)的时候,HashMap便会把这个链表从链表结构转化为红黑树的形式,目的是为了保证查找效率, 这里简单介绍一下红黑树,红黑树是一种不严格的平衡二叉查找树,主要解决二叉查找树因为动态更新导致的性能退化,其中的平衡的意思代表着近似平衡,等价于性能不会退化.红黑树中的节点分为两类:黑色节点和红色节点,一颗红黑树需要满足: 根节点是黑色。 每个叶子节点都是黑色的空节点(null)。 任何相邻的节点都不能同时为红色,也就是说红色节点是被黑色分开的。 每个节点,从该节点到达其可达到的叶子节点的所有路径,都包含相同数目的黑色节点。 由于红黑树的自平衡特点,所以其查找性能近似于二分查找,时间复杂度是O(log(n)),相比于链表结构,如果发生了最坏的情况,可能需要遍历整个链表才能找到目标元素,时间复杂度为O(n),远远大于红黑树的O(log(n)),尤其是在节点越来越多的情况下,O(log(n)) 插入方式对比 jdk1.7中插入新节点采用的是头查法,就是如果来了新节点,将新节点插入到数组中,原数组中的原始节点作为新节点的后继节点,而且是先判断是否需要扩容,在插入。 jdk1.8中插入新节点的方式是尾查法,就是将新来的节点插入到数组中对应槽点的尾部,插入时先插入,在判断是否需要扩容。 扩容方式对比 jdk1.8中采用的是原位置不变或者位置变为索引+旧容量大小,resize()方法部分源码如下: //jdk1.8代码扩容方式 //其中的loHead开头的表示低位链表开头节点,loTail表示低位链表尾部节点,hiHead开头的表示高位链表开头节点,hiTail表示高位链表尾部节点 //因为扩容时,容量为之前的两倍,而扩容的方法又是原位置不变或者位置变为索引+旧容量大小,所以这里把扩容的容量分为两部分 //一部分是原容量大小,用loHead和loTail表示首尾位置节点,一部分是新扩容的容量大小,用hiHead和hiTail表示首尾位置节点 Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { //该方法是扩容时采用的尾查法 next = e.next; //如果判断等于0,则节点在下面插入新数组中的位置索引等于其在旧数组中的位置索引 if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } //如果不能于0,节点在下面插入新数组中的位置索引等于在旧数组中的位置索引+旧数组容量大小 else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); //插入位置不变 if (loTail != null) { loTail.next = null; newTab[j] = loHead; } //插入位置变为旧数组容量大小+旧数组中的索引 if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } jdk1.7中的HashMap扩容的时候需要对原数组中的元素进行重新Hash定位在新数组中的位置,transfer方法的源码如下:。 //jdk1.7HashMap的扩容方法 void resize(int newCapacity) { Entry[] oldTable = table; int oldCapacity = oldTable.length; if (oldCapacity == MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return; } Entry[] newTable = new Entry[newCapacity]; // transfer()方法把原数组中的值放到新数组中,同时依据initHashSeedAsNeeded(newCapacity)返回的boolean值决定是否重新hash transfer(newTable, initHashSeedAsNeeded(newCapacity)); //设置hashmap扩容后为新的数组引用 table = newTable; //设置hashmap扩容新的阈值 threshold = (int)Math.min(newCapacity * loadFactor, MAXIMUM_CAPACITY + 1); } void transfer(Entry[] newTable, boolean rehash) { int newCapacity = newTable.length; for (Entry<K,V> e : table) { while(null != e) { //保存e的后继节点。 Entry<K,V> next = e.next; //重新hash在新数组中的位置 if (rehash) { e.hash = null == e.key ? 0 : hash(e.key); } //计算节点e在新数组中的位置索引 int i = indexFor(e.hash, newCapacity); //将原节点e的后继节点指向newTable[i],采用的是头插法 e.next = newTable[i]; //将节点e放到newTable[i]数组中, newTable[i] = e; //将next付给e,开始下一次循环 e = next; } } } 同时因为jdk1.7中HashMap的扩容方法中调用的transfer方法内采用的是头插法,头插法会使链表发生反转,多线程环境下,会产生循环链表,上面代码我们结合图来理解头插法和为什么多线程环境下会产生循环链表:首先假设此时有原HashMap表的内部数据存储如下图: 此时达到了扩容要求,然后线程1和线程2此时同时进行扩容,线程1和线程2扩容时的新数组(newTable)如下图: 假设线程2先执行transfer方法,并且当它正好执行完了Entry<K,V> next = e.next;这行代码后,cpu时间片切换到了线程1来执行,并且线程1执行完了transfer方法,如下图: 线程1插入A节点到自己的新表中 线程1插入B节点到自己的新表中 线程1插入C节点到自己的新表中 当线程1执行完了transfer方法后,还没有执行table = newTable这行代码,此时cpu时间片有切换到了线程2,那么线程2继续接着之前的位置执行,此处需要注意由于由于之前线程2切换线程1之前已经执行完了Entry<K,V> next = e.next这行代码,因此在线程2中变量e存的是A节点了,变量next存的是B节点,而且又由于线程1执行完了transfer方法后,原数组的节点指向如上图可以看出是C指向B,B是指向A的,所以切换到线程2的时候,线程2中的节点指向如下图: 线程2插入A节点到自己的新表中 线程2插入B节点到自己的新表中 由于B节点指向A节点,所以下次插入产生了链表循环,如下图: 综上就是HashMap采用头插法的时候产生链表循环的场景。 jdk1.8中在对HashMap进行扩容的时候放弃头插法而改为尾插法了,扩容代码我已经在上面的扩容方式代码中标出,通过尾插法就避免了因为链表反转导致多线程环境下产生链表循环的情况。 ConcurrentHashMap在java7和java8中的区别 数据结构 我们先看一下jdk1.7中ConcurrentHashMap的底层数据结构,如下图: 图中我们可以看出concurrentHashMap内部进行了Segment分段,Segment继承了ReentrantLock,可以理解为一把锁,各个Segment之间相互独立上锁,互不影响,相比HashTable每次操作都需要锁住整个对象而言,效率大大提升,正是因为concurrentHashMap的锁粒度是针对每个Segment而不是整个对象。 每个Segment的底层数据结构又和HashMap类似,还是数组和链表组成的拉链结构,默认有0~15共16个Segment,所以最多可以同时支持16个线程并发操作(每个线程分别分布在不同的Segment上)。16这个默认值可以在初始化的时候设置为其他值,一旦设置确认初始化之后,是不可以扩容的。 jdk1.8中的ConcurrentHashMap的底层数据结构,如下图: 通过上面两个图中可以看出,jdk1.8中的ConcurrentHashMap在数据结构上比jdk1.7中多了红黑树结构,引入红黑树结构是为了防止查询效率降低。 并发程度 这里我们简单通过java7和java8的ConcurrentHashMap的含参构造函数看一下对比,首先java7的ConcurrentHashMap的构造函数代码如下: //通过指定的容量,加载因子和并发等级创建一个新的ConcurrentHashMap public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { //对构造参数做判断 if (!(loadFactor > 0) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); //限制并发等级不可以大于最大等级 if (concurrencyLevel > MAX_SEGMENTS) concurrencyLevel = MAX_SEGMENTS; //sshift用来记录向左按位移动的次数 int sshift = 0; //ssize用来记录Segment数组的大小 int ssize = 1; //Segment的大小为大于等于concurrencyLevel的第一个2的n次方的数 while (ssize < concurrencyLevel) { ++sshift; //2的幂次方,2^1,2^2.... ssize <<= 1; } this.segmentShift = 32 - sshift; this.segmentMask = ssize - 1; //限制最大初始化容量 if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; //c统计每个Segment内有多少元素 int c = initialCapacity / ssize; //如果有余数,则Segment数量加1 if (c * ssize < initialCapacity) ++c; int cap = MIN_SEGMENT_TABLE_CAPACITY; while (cap < c) cap <<= 1; //创建第一个Segment,并放入Segment[]数组中,作为第一个Segment Segment<K,V> s0 = new Segment<K,V>(loadFactor, (int)(cap * loadFactor), (HashEntry<K,V>[])new HashEntry[cap]); //初始化Segment数组大小 Segment<K,V>[] ss = (Segment<K,V>[])new Segment[ssize]; UNSAFE.putOrderedObject(ss, SBASE, s0); // ordered write of segments[0] this.segments = ss; } jdk1.7中的并发等级(concurrencyLevel)用Segment的数量来确定,Segment的个数为大于等于concurrencyLevel的第一个2的n次方的整数,例如当concurrencyLevel为12,13,14,15,16时,此时的Segment的数量为16 java8中的源码汇总保留了Segment片段,但是并没有使用,构造函数如下: public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); //如果并发等级大于初始化容量,则限制初始化容量, //这样的话就是一个槽点对应一个线程,那么理想情况下,最大的并发程度就是数组长度 if (initialCapacity < concurrencyLevel) // Use at least as many bins initialCapacity = concurrencyLevel; // as estimated threads long size = (long)(1.0 + (long)initialCapacity / loadFactor); int cap = (size >= (long)MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : tableSizeFor((int)size); this.sizeCtl = cap; } 通过上面的代码的对比可以得出一下结论: java7中采用Segment分段锁来保证安全,每个Segment独立加锁,最大并发数就是Segment的个数,默认是16。 java8中放弃了Segment设计,采用Node+CAS+synchronized保证线程安全,锁粒度更新,理想情况下table数组元素的个数(也就是数组长度)就是支持并发的最大个数。 遇到Hash碰撞 java7中遇到Hash冲突,采用拉链法,查找时间复杂度是O(n),n是链表的长度。 java8中遇到Hash冲突,先采用拉链法,查找时间复杂度是O(n),当链表长度超过一定阙值时,将链表转换为红黑树结构,来保证查找效率,查找时间复杂度降低为O(log(n)),n为树中的节点个数。