首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10008篇文章
优秀的个人博客,低调大师

学习了《python网络爬虫实战》第一个爬虫,爬取新浪新闻

请安装anaconda,其中附带的spyder方便运行完查看变量 1.进入cmd控制台, 输入 pip install BeautifulSoup4 pip install requests 2.编写代码,代码已经很清晰了,直接运行不会报错并有成功的结果 def getNewsDetail(newsUrl): import requests from bs4 import BeautifulSoup from datetime import datetime newsWeb = requests.get(newsUrl) newsWeb.encoding = 'utf-8' soup = BeautifulSoup(newsWeb.text,'lxml') result = {} result['title'] = soup.select('.main-title')[0].text result['newsSource'] = soup.select('.source')[0].text timeSource = soup.select('.date')[0].text result['datetime'] = datetime.strptime(timeSource,'%Y年%m月%d日 %H:%M') result['article'] = soup.select('.article')[0].text result['editor'] = soup.select('.show_author')[0].text.strip('责任编辑:') result['comment'] = soup.select('.num')[0].text return result def parseListLinks(url): import requests import json newsDetails = [] request = requests.get(url) jsonLoad = json.loads(request.text.lstrip(' newsloadercallback(').rstrip(');')) newsUrls = [] for item in jsonLoad['result']['data']: newsUrls.append(item['url']) for url in newsUrls: newsDetails.append(getNewsDetail(url)) return newsDetails if __name__ == '__main__': #获取单个新闻页面的信息 newsUrl = 'http://news.sina.com.cn/s/wh/2018-01-08/doc-ifyqkarr7830426.shtml' newsDetail = getNewsDetail(newsUrl) #获取整个列表各个新闻页面的信息 rollUrl='http://api.roll.news.sina.com.cn/zt_list?channel=news&cat_1=gnxw\ &cat_2==gdxw1||=gatxw||=zs-pl||=mtjj&level==1||=2&show_ext=1&show_all=1&\ show_num=22&tag=1&format=json&page=23&callback=newsloadercallback&_=1515911333929' newsDetails = parseListLinks(rollUrl)

优秀的个人博客,低调大师

Python爬虫入门教程 55-100 python爬虫高级技术之验证码篇

验证码探究 如果你是一个数据挖掘爱好者,那么验证码是你避免不过去的一个天坑,和各种验证码斗争,必然是你成长的一条道路,接下来的几篇文章,我会尽量的找到各种验证码,并且去尝试解决掉它,中间有些技术甚至我都没有见过,来吧,一起Coding吧 数字+字母的验证码 我随便在百度图片搜索了一个验证码,如下 今天要做的是验证码识别中最简单的一种办法,采用pytesseract解决,它属于Python当中比较简单的OCR识别库 库的安装 使用pytesseract之前,你需要通过pip 安装一下对应的模块 ,需要两个 pytesseract库还有图像处理的pillow库了 pip install pytesseract pip install pillow 如果你安装了这两个库之后,编写一个识别代码,一般情况下会报下面这个错误 pytesseract.pytes

优秀的个人博客,低调大师

Python爬虫入门教程 44-100 Charles的安装与使用-手机APP爬虫部分

1. 第二款抓包工具Charles安装与使用 Charles和Fiddler一样,也是一款抓包工具,比Fiddler界面更加清晰,支持多平台 1.1 官方网址 https://www.charlesproxy.com/ 1.2 下载地址 Charles工具下载地址:https://www.charlesproxy.com/download/ 自己去百度一款,我找了2个百度网盘的 链接挂了就不补了啊~ 链接: https://pan.baidu.com/s/1pMawsEv 密码:meuk 链接: https://pan.baidu.com/s/1kV3h0gf 密码: nqaa 下载之后,安装就比较简单了,常规操作即可 2. Charles基本操作 打开Charles在电脑上就可以使用了 2.1 PC设置抓包,包括HTTP和HTTPS 软件安装好了之

优秀的个人博客,低调大师

Python爬虫入门教程 51-100 Python3爬虫通过m3u8文件下载ts视频-Python爬虫6操作

什么是m3u8文件 M3U8文件是指UTF-8编码格式的M3U文件。M3U文件是记录了一个索引纯文本文件,打开它时播放软件并不是播放它,而是根据它的索引找到对应的音视频文件的网络地址进行在线播放。 原视频数据分割为很多个TS流,每个TS流的地址记录在m3u8文件列表中 比如我这里有一个m3u8文件,文件内容如下 #EXTM3U #EXT-X-VERSION:3 #EXT-X-MEDIA-SEQUENCE:0 #EXT-X-ALLOW-CACHE:YES #EXT-X-TARGETDURATION:15 #EXTINF:6.916667, out000.ts #EXTINF:10.416667, out001.ts #EXTINF:10.416667, out002.ts #EXTINF:1.375000, out003.ts #EXTIN

优秀的个人博客,低调大师

爬虫数据库MongoDB的介绍

MongoDB (名称来自「humongous (巨大无比的)」), 是一个可扩展的高性能,开源,模式自由,面向文档的NoSQL,基于 分布式 文件存储,由 C++ 语言编写,设计之初旨在为 WEB 应用提供可扩展的高性能数据存储解决方案。 MongoDB使用的是内存映射存储引擎,它会把磁盘IO操作转换成内存操作,如果是读操作,内存中的数据起到缓存的作用,如果是写操作,内存还可以把随机的写操作转换成顺序的写操作,大幅度提升性能。 MongoDB 既拥有Key-Value存储方式的高性能和高度伸缩性,也拥有传统的RDBMS系统的丰富的功能,集两者的优势于一身。 介于关系数据库和NoSQL之间,也是功能最丰富、最像关系数据库的的NoSQL。 MongoDB官方文档:https://docs.mongodb.com MongoDB中文社区:http://www.mongoing.com MongoDB特点: 模式自由 :可以把不同结构的文档存储在同一个数据库里 面向集合的存储:适合存储 JSON风格文件的形式, 完整的索引支持:对任何属性可索引, 复制和高可用性:支持服务器之间的数据复制,支持主-从模式及服务器之间的相互复制。复制的主要目的是提供冗余及自动故障转移。 自动分片:支持水平的数据库集群,可动态添加额外的机器。 丰富的查询:支持丰富的查询表达方式,查询指令使用JSON形式的标记,可轻易查询文档中的内嵌的对象及数组。 快速就地更新:查询优化器会分析查询表达式,并生成一个高效的查询计划。 高效的传统存储方式:支持二进制数据及大型对象(如图片等...)。 根据DB-Engines的排名统计,MongoDB综合排名第五(2017年10月数据,前四名分别是Oracle,MySQL,SQL Server,PostgreSQL),在NoSQL领域(非RDBMS)里排名第一。适用场景 网站数据: 适合实时的插入,更新与查询,并具备网站实时数据存储所需的复制及高度伸缩性。 缓存: 由于性能很高,也适合作为信息基础设施的缓存层。在系统重启之后,搭建的持久化缓存可以避免下层的数据源过载。 高伸缩性的场景: 非常适合由数十或者数百台服务器组成的数据库。用于对象及JSON数据的存储: MongoDB的BSON数据格式非常适合文档格式化的存储及查询。 不适用的场景 高度事物性的系统: 例如银行或会计系统。传统的关系型数据库目前还是更适用于需要大量原子性复杂事务的应用程序。 需要使用SQL语句解决的场景: MongoDB不支持SQL语句。 下载mongodb的版本,两点注意 根据业界规则,偶数为稳定版,如3.2.X;奇数为开发版,如3.3.X32bit的mongodb最大只能存放2G的数据,64bit就没有限制。MongoDB官网安装包下载地址:http://www.mongodb.org/downloads MongoDB安装文档:https://docs.mongodb.com/getting-started/shell/installation/ Ubuntu下安装MongoDB: python@ubuntu:~$ sudo apt-get install mongodb 使用MongoDB,需要先启动服务端,再使用客户端连接数据库。服务端 MongoDB 默认的存储数据目录为 /data/db,默认端口27017 服务的命令为mongod,可以通过help查看所有参数 python@ubuntu:~$ mongod --help 相关文件存放路径:默认各个文件存放路径如下所示: 可执行文件存放路径:/usr/bin/mongod 和 /usr/bin/mongo 数据库文件存放路径:/data/db 日志文件存放路径:/var/log/mongodb/mongod.log 配置文件存放路径:/etc/mongod.conf 启动注意事项: 首次启动: 启动MongoDB服务: sudo mongod报出如下错误,表示默认的存储数据目录 /data/db 不存在: [initandlisten] exception in initAndListen: 29 Data directory /data/db not found., terminating 创建 /data目录和 /data/db 目录,并指定 读/写/执行 权限 python@ubuntu:~$ sudo mkdir -p /data/db python@ubuntu:~$ sudo chmod 777 /data/db 再次启动: 再次启动MongoDB服务: sudo mongod启动成功,但是可能会有如下警告: #### 此乃 Warning 1: [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/enabled is 'always'. [initandlisten] ** We suggest setting it to 'never' [initandlisten] [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/defrag is 'always'. [initandlisten] ** We suggest setting it to 'never' #### 此乃 Warning 2: [initandlisten] ** WARNING: soft rlimits too low. rlimits set to 1024 processes, 64000 files. Number of processes should be at least 32000 : 0.5 times number of files. #### 此乃 Warning 3: [initandlisten] ** WARNING: You are running this process as the root user, which is not recommended. 注意:这里的三个Warning并非必须处理,大家了解即可:Warning 1: [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/enabled is 'always'. [initandlisten] ** We suggest setting it to 'never' [initandlisten] [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/defrag is 'always'. [initandlisten] ** We suggest setting it to 'never' Linux的内存分配默认由内核动态分配,而不是由程序自行管理。而MongoDB对内存占用有那么点...严重,所以为了防止MongoDB占用内存过大而被内核"管理",官方推荐关闭动态分配。 默认"always"表示允许动态分配,对应的"never"就是不允许,所以我们将这两个文件内容修改为"naver"后就没有warning了。 # Ctrl + c 退出 MongoDB 数据库服务 # 然后进入 root 用户下,执行修改命令 python@ubuntu:~$ sudo su [sudo] python 的密码: root@ubuntu:~# sudo echo "never" > /sys/kernel/mm/transparent_hugepage/enabled root@ubuntu:~# sudo echo "never" > /sys/kernel/mm/transparent_hugepage/defrag 实际上,除非网站DBA对数据库性能有极限要求,在通常情况下系统动态分配的内存页大小足够我们正常使用,而且更能优化整个系统,所以一般不必理会这个warning。而且这样只是临时修改Linux内核的设置,在Linux服务器重启后则会失效。Warning 2: [initandlisten] ** WARNING: soft rlimits too low. rlimits set to 1024 processes, 64000 files. Number of processes should be at least 32000 : 0.5 times number of files. 这个WARNING(如果有的话)含义为: 表示默认分配给MongoDB的进程和文件数量限制过低,需要重新分配值: mongodb当前限制:1024 processes, 64000 files mongodb建议要求:processes = 0.5*files=32000(至少)咱们学习阶段默认用不着这么多的进程和文件,所以也可以不必理会。 # 打开 相关配置文件: root@ubuntu:~# vi /etc/security/limits.conf # 在打开的 文件最下方,添加,然后保存退出 mongod soft nofile 64000 mongod hard nofile 64000 mongod soft nproc 32000 mongod hard nproc 32000 Warning 3: [initandlisten] ** WARNING: You are running this process as the root user, which is not recommended. 意思是我们在用root权限做这些事,理论上是不安全的。我们可以通过附加--auth参数,来使用用户认证来处理这个情况,这个后面会讲到。 再再次启动: 再再次启动MongoDB服务: sudo mongod启动后查看进程,以确定是否启动成功 python@ubuntu:~$ ps aux | grep mongod 如果进程中没有mongod的项则没有启动成功,可以通过查看日志来确定错误原因,默认日志文件为 /var/log/mongodb/mongod.log,最新的信息在最后面显示。 客户端 客户端命令为 mongo,可以通过help查看所有参数。 这个shell即是mongodb的客户端,用来对MongoDB进行操作和管理的交互式环境。 python@ubuntu:~$ mongo --help 终端退出连接 > exit (或Ctrl+C) 本文最终解释权归本文作者所有,未经允许不得私自转载

优秀的个人博客,低调大师

爬虫实战——百度贴吧

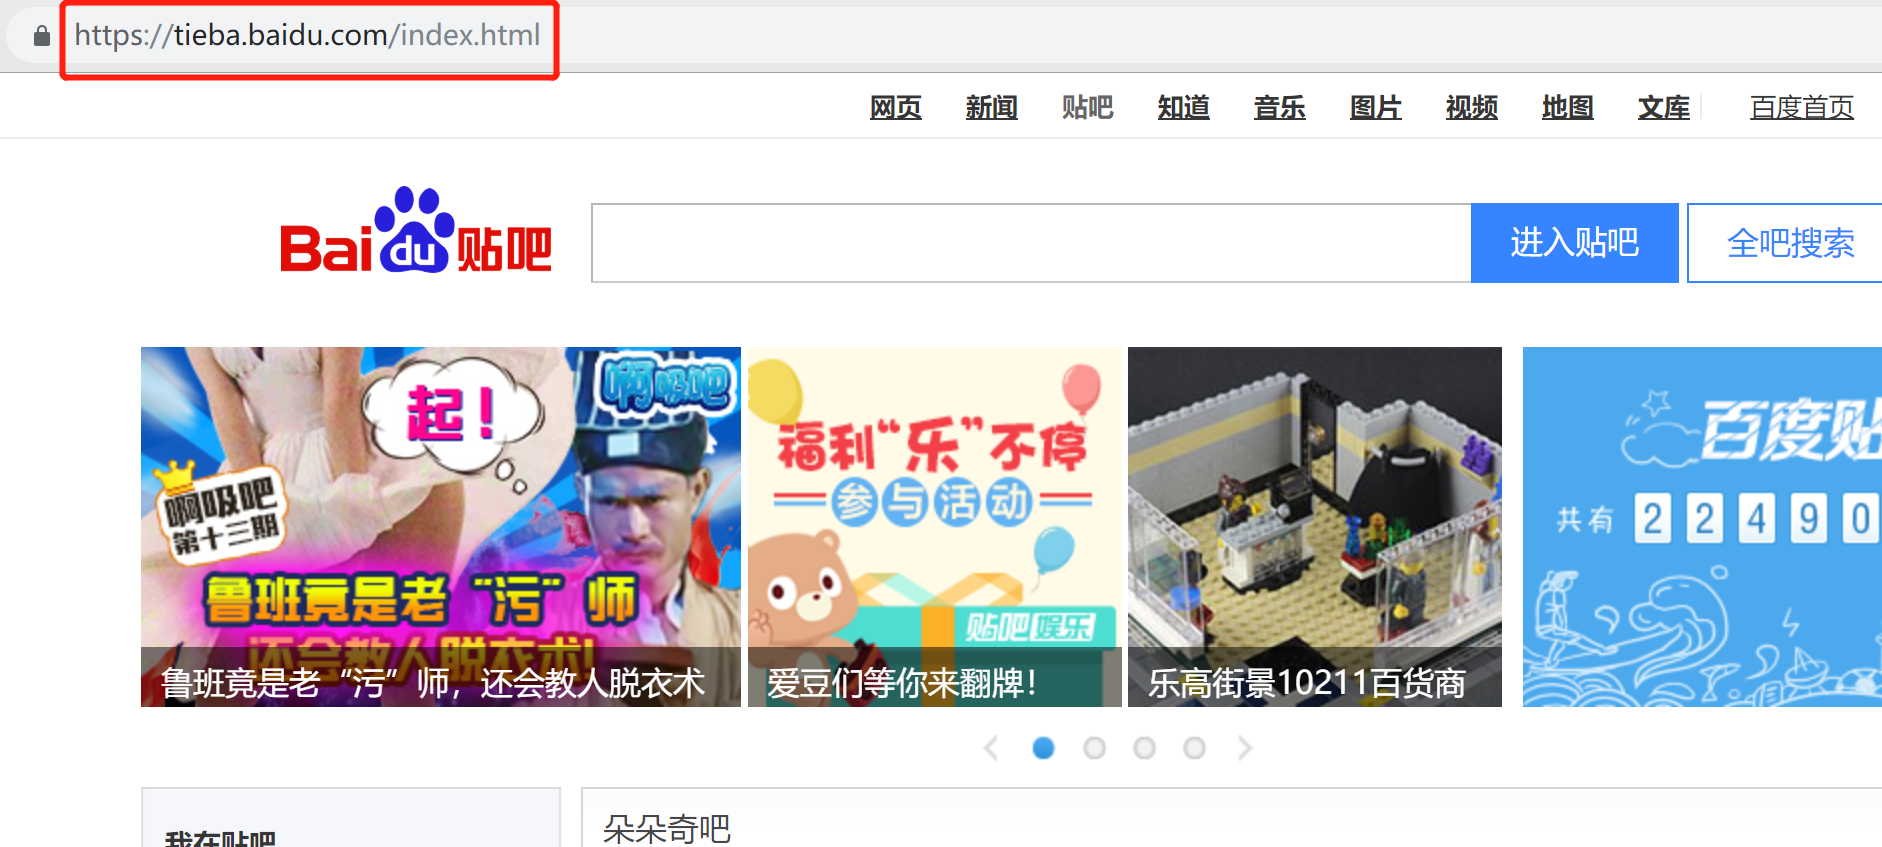
开始 首先使用chrome浏览器,进入百度贴吧 注意输入框中的url 分析 为了进行具体的url分析,我在搜索框中输入"Python",看一下url的变化 观察url变化 这时url变成了: http://tieba.baidu.com/f?ie=utf-8&kw=python&fr=search&red_tag=b2531475437 通过分析,做一个测试, 删除url一些东西: http://tieba.baidu.com/f?&kw=python 依旧可以得到正常的页面 下面进行翻页测试: 得到这样的一条url: http://tieba.baidu.com/f?kw=python&ie=utf-8&pn=50 通过分析,再进行一次测试,删除url中的一些东西: 得到下面的url http://tieba.baidu.com/f?kw=python&pn=50 依旧可以得到相应的页面,因此可以得出结论: kw 和 pn 是这个页面中最重要的关键词,kw控制关键词(其实就是keyword的缩写), pn(其实就是page_number的缩写)控制翻页,每翻一页,pn增加50,也就是说一页有50条数据。 分析结束,开始代码 初始url先用这个,之后再慢慢修改: http://tieba.baidu.com/f?kw=python&pn=50 直接上代码,注意看代码中的注释 # 爬取百度贴吧 import requests class BdTieba(): def __init__(self, name, pn): # 保存贴吧名 self.name = name # 初始url self.base_url = "http://tieba.baidu.com/f?kw={}&pn=".format(name) # 构造请求头 self.headers = { "User-Agent": "Mozilla / 5.0(Windows NT 10.0;Win64;x64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/69.0.3497.100Safari/537.36" } # 2. 批量生成url # 使用列表推导式生成了url列表 self.url_list = [self.base_url + str(i*50) for i in range(pn)] # 打印测试 # print(self.url_list) # 3. 批量发送请求,封装发送请求 def get_data(self, url): response = requests.get(url, headers=self.headers) return response.content def save_data(self, data, index): filename = self.name + "_{}.html".format(index) with open(filename, "wb") as f: f.write(data) def run(self): # 1.请求初始url,测试使用 # response = requests.get(url=self.base_url, headers=self.headers) # 打印测试,测试成功返回结果 # print(response.text) # 2.批量生成url for url in self.url_list: data = self.get_data(url) # 3.批量发送请求 # 4.保存网页,为了保存的网页名字不重复,且有顺序,这里使用index进行区分 # 获取当前url的index index = self.url_list.index(url) # 保存 self.save_data(data, index) if __name__ == '__main__': bdspider = BdTieba("python", 10) bdspider.run() 这里我只通过批量生成url,并批量获取url响应,并保存了url响应数据,这里测试了10页数据,如果想要爬取每个url中的数据,还需要进行页面分析和提取,这里就需要使用xpath,作为新手入门的一个教程,后续我会拿这个项目继续改进,增加xpath解析,爬取每页的文字信息,这里就先到这了。 后面我会写一篇关于xpath的简单快速上手文章,然后再对这个实战进行下一步的更新 over~ peace~ 个人博客: www.limiao.tech 微信公众号:TechBoard
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册